Машинное зрение на Python. Учим нейросеть отличать медведей от слонов

Ты наверняка слышал, что нейросети в последнее время стали чертовски хорошо справляться с распознаванием объектов на картинках. Наша же задача — научиться пользоваться этими нейросетями, ведь их мощь может пригодиться в самых разных случаях. В этой статье я расскажу, как задействовать ее при помощи самых распространенных инструментов: Python и библиотек Tensorflow и Keras.

INFO
В предыдущей статье я показывал примеры простейших нейросетей и демонстрировал, как научить нейронку распознавать цифры. А из статьи «Исходный кот. Как заставить нейронную сеть ошибиться» ты узнаешь, как обмануть машинное зрение.
Бинарная классификация
Научим нашу нейросеть распознавать, кошка или собака изображены на фото. Это классический пример, и к нему в Keras Datasets уже есть необходимый для обучения набор картинок. Иначе нам пришлось бы вручную создать и классифицировать несколько тысяч фотографий.
Подключим необходимые библиотеки.
from tensorflow import keras from tensorflow.keras import layers from tensorflow.keras import Sequential from tensorflow.keras.layers import Conv2D, MaxPooling2D, Flatten, Dense, Dropout, Activation, BatchNormalization, AveragePooling2D from tensorflow.keras.optimizers import SGD, RMSprop, Adam ## pip install tensorflow-datasets import tensorflow_datasets as tfds import tensorflow as tf import logging import numpy as np import time Создадим модель нейросети.
def dog_cat_model(): model = Sequential() model.add(Conv2D(32, (3, 3), input_shape=(128, 128, 3), activation='relu')) model.add(MaxPooling2D(pool_size=(2, 2))) model.add(Conv2D(32, (3, 3), activation='relu')) model.add(MaxPooling2D(pool_size=(2, 2))) model.add(Flatten()) model.add(Dense(units=128, activation='relu')) model.add(Dense(units=1, activation='sigmoid')) model.compile(optimizer=Adam(), loss='binary_crossentropy', metrics=['accuracy']) return model У нашей нейронки только один выход, поскольку результатом ее работы будет бинарная величина: единица — собака, ноль — кошка.
Теперь нейросеть следует обучить. В исходном датасете — 25 тысяч изображений. Мы разделим его на две части для обучения и верификации, а каждое изображение обработаем. Размер изображения должен быть 128 × 128 пикселей, а цвет в диапазоне от нуля до единицы.
def dog_cat_train(model): splits = tfds.Split.TRAIN.subsplit(weighted=(80, 10, 10)) (cat_train, cat_valid, cat_test), info = tfds.load('cats_vs_dogs', split=list(splits), with_info=True, as_supervised=True) def pre_process_image(image, label): image = tf.cast(image, tf.float32) image = image/255.0 image = tf.image.resize(image, (128, 128)) return image, label BATCH_SIZE = 32 SHUFFLE_BUFFER_SIZE = 1000 train_batch = cat_train.map(pre_process_image) .shuffle(SHUFFLE_BUFFER_SIZE) .repeat().batch(BATCH_SIZE) validation_batch = cat_valid.map(pre_process_image) .repeat().batch(BATCH_SIZE) t_start = time.time() model.fit(train_batch, steps_per_epoch=4000, epochs=2, validation_data=validation_batch, validation_steps=10, callbacks=None) print("Training done, dT:", time.time() - t_start) Теперь мы запускаем обучение модели и сохраняем результаты в файл:
model = dog_cat_model() dog_cat_train(model) model.save('dogs_cats.h5') На моем компьютере с видеокартой GeForce 1060 обучение сети заняло примерно восемь минут.
Теперь мы можем использовать обученную сеть. Напишем функцию распознавания изображения.
def dog_cat_predict(model, image_file): label_names = ["cat", "dog"] img = keras.preprocessing.image.load_img(image_file, target_size=(128, 128)) img_arr = np.expand_dims(img, axis=0) / 255.0 result = model.predict_classes(img_arr) print("Result: %s" % label_names[result[0][0]]) 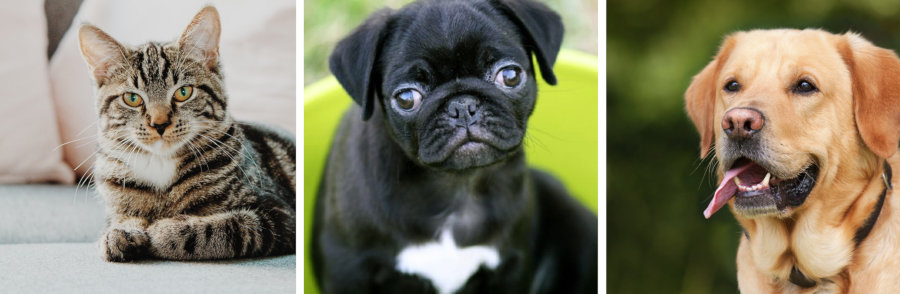
model = tf.keras.models.load_model('dogs_cats.h5') dog_cat_predict(model, "cat.png") dog_cat_predict(model, "dog1.png") dog_cat_predict(model, "dog2.png") 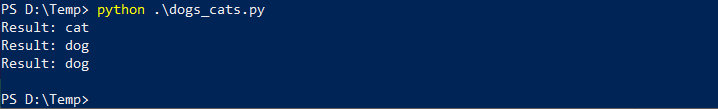
Этот способ можно использовать и для распознавания других изображений, сложность только в поиске данных для обучения сети.
Присоединяйся к сообществу «Xakep.ru»!
Членство в сообществе в течение указанного срока откроет тебе доступ ко ВСЕМ материалам «Хакера», позволит скачивать выпуски в PDF, отключит рекламу на сайте и увеличит личную накопительную скидку! Подробнее
Распознавание образов с помощью искусственного интеллекта
Пожалуй, самая популярная и перспективная задача нейросетей – технологии распознавания образов. Они либо по отдельности, либо в интегрированном виде используются в таких сферах, как безопасность и наблюдение, сканирование и создание изображений, маркетинг и реклама, дополненная реальность и поиск изображений.
Сегодня создаются и уже используются сети, в которых машины способны распознавать символы на бумаге и банковских картах, подписи на официальных документах, детектировать объекты и т.д. Эти функции облегчают труд человека и повышают точность и надежность различных рабочих процессов благодаря исключению из задачи человеческого фактора. Но научить компьютер распознавать объекты не так уж и просто. Одна из сложностей заключается в том, что компьютер видит не так же, как люди. У компьютера нет жизненного опыта и способности так же, как человеческий мозг идентифицировать объекты на изображения и видео. Изначально он не способен отличить дом от дерева, не имея каких‑то исходных данных. Чтобы научить компьютер видеть и понимать, что находится на изображении, люди используют технологии машинного обучения.
Для этого собирают большие базы данных, из которых формируют дата‑сеты. Выделив признаки и их комбинации для идентификации похожих объектов, можно натренировать модель машинного обучения распознавать нужные типы закономерностей. Конечно, даже после загрузки нескольких дата‑сетов модели могут неверно распознавать некоторые объекты. Если такое случается, модели «дообучают» на новых наборах данных.
Если, например, рассматривать сферу видеонаблюдения, то ее основой является анализ, первой фазой которого будет распознавание изображения (объекта). Затем искусственный интеллект с помощью машинного обучения распознает действия и классифицирует их. Но для того, чтобы распознать изображение, нейронная сеть должна быть прежде обучена на данных. Это очень похоже на нейронные связи в человеческом мозге — мы обладаем определенными знаниями, получаемыми в течение жизни, видим объект, анализируем его и идентифицируем. Также нейросети очень требовательны к размеру и качеству датасета, на котором она будет обучаться. Датасет можно загрузить из открытых источников или собрать самостоятельно. На практике это означает, что до определённого предела чем больше скрытых слоев в нейронной сети, тем точнее будет распознано изображение. Как это реализуется: картинка разбивается на маленькие участки, вплоть до нескольких пикселей, каждый из которых будет входным нейроном. С помощью синапсов сигналы передаются от одного слоя к другому. Во время этого процесса сотни тысяч нейронов с миллионами параметров сравнивают полученные сигналы с уже обработанными данными.
Другими словами, если мы просим машину распознать фотографию кошки, мы разобьем фото на маленькие кусочки и будем сравнивать эти слои с миллионами уже имеющихся изображений кошек, значения признаков которых сеть выучила.
Распознавание образов — важная задача компьютерного зрения, используемая для обнаружения экземпляров визуальных объектов определенных классов (например, людей, животных, автомобилей и зданий) в цифровых изображениях, таких как фотографии или видеокадры. Целью обнаружения объектов является разработка вычислительных моделей, которые предоставляют наиболее фундаментальную информацию, необходимую приложениям компьютерного зрения: «Какие объекты находятся где?».
Как работает распознавание образов
Распознавание образов может выполняться с использованием либо традиционных (1) методов обработки изображений, либо современных (2) сетей глубокого обучения.
1) Методы обработки изображений, как правило, не требуют исторических данных для обучения и по своей природе неконтролируемы. OpenCV — популярный инструмент для задач обработки изображений.
Плюсы: следовательно, эти задачи не требуют аннотированных изображений, где люди маркировали данные вручную (для контролируемого обучения).
Минусы: эти методы ограничены несколькими факторами, такими как сложные сценарии (без одноцветного фона), окклюзия (частично скрытые объекты), освещение и тени, и эффект беспорядка.
2) Методы глубокого обучения обычно зависят от контролируемого или неконтролируемого обучения, при этом контролируемые методы являются стандартом в задачах компьютерного зрения. Производительность ограничена вычислительной мощностью графических процессоров, которая стремительно растет с каждым годом.
Плюсы: Обнаружение объектов с помощью глубокого обучения значительно более устойчиво к окклюзии, сложным сценам и сложному освещению.
Минусы: требуется огромное количество обучающих данных; процесс аннотации изображений является трудоемким и дорогостоящим. Например, маркировка 500 000 изображений для обучения пользовательского алгоритма обнаружения объектов глубокого обучения считается небольшим набором данных. Однако многие эталонные наборы данных (MS COCO, Caltech, KITTI, PASCAL VOC, V5) обеспечивают доступность помеченных данных.
Сегодня обнаружение объектов глубокого обучения широко признано исследователями и используется компаниями, занимающимися компьютерным зрением, для создания коммерческих продуктов.
Где используется распознавание образов
Распознавание лиц и людей
Большинство систем распознавания лиц основаны на распознавании объектов. Его можно использовать для обнаружения лиц, классификации эмоций или выражений и подачи полученного поля в систему поиска изображений для идентификации конкретного человека из группы.
Обнаружение лица — один из самых популярных вариантов использования обнаружения объектов, и вы, вероятно, уже используете его всякий раз, когда разблокируете телефон своим лицом.
Обнаружение людей также обычно используется для подсчета количества людей в розничных магазинах или обеспечения показателей социального дистанцирования.
Интеллектуальная видео аналитика
Обнаружение объектов используется в интеллектуальной видеоаналитики (IVA) везде, где в торговых точках присутствуют камеры видеонаблюдения, чтобы понять, как покупатели взаимодействуют с продуктами. Эти видеопотоки проходят через конвейер анонимизации, чтобы размыть лица людей и обезличить их. Некоторые варианты использования IVA сохраняют конфиденциальность, глядя только на обувь людей, размещая камеры ниже уровня колен и гарантируя, что система фиксирует присутствие человека, без необходимости непосредственно смотреть на его идентифицируемые черты. IVA часто используется на заводах, в аэропортах и транспортных узлах для отслеживания длины очередей и доступа в зоны ограниченного доступа.
Автономные транспортные средства
Беспилотные автомобили используют обнаружение объектов, чтобы обнаруживать пешеходов, другие автомобили и препятствия на дороге, чтобы безопасно передвигаться. Автономные транспортные средства, оснащенные LIDAR, иногда используют 3D-обнаружение объектов, при котором вокруг объектов применяются прямоугольные формы.
Интеллектуальная видео хирургия
Хирургическое видео — это очень зашумленные данные, которые снимаются с эндоскопов во время ответственных операций. Обнаружение объектов можно использовать для обнаружения трудно различимых объектов, таких как полипы или поражения, которые требуют немедленного вмешательства хирурга. Он также используется для информирования персонала больницы о статусе операции.
Проверка дефектов
Компании-производители могут использовать обнаружение объектов для выявления дефектов на производственной линии. Нейронные сети можно научить обнаруживать мельчайшие дефекты, от складок на ткани до вмятин или вспышек в литьевых пластмассах.
В отличие от традиционных подходов к машинному обучению, обнаружение объектов на основе глубокого обучения также может обнаруживать дефекты в сильно различающихся объектах, таких как продукты питания.
Обнаружение пешеходов
Это одна из важнейших задач компьютерного зрения, которая применяется в робототехнике, видеонаблюдении и автомобильной безопасности. Обнаружение пешеходов играет ключевую роль в исследованиях обнаружения объектов, поскольку оно предоставляет фундаментальную информацию для семантического понимания видеоматериалов.
Однако несмотря на относительно высокую производительность, эта технология по-прежнему сталкивается с такими проблемами, как различные стили одежды по внешнему виду или наличие закрывающих аксессуаров, которые снижают точность существующих детекторов.
AI-навигация дрона
В наши дни дроны оснащены невероятными камерами и могут использовать модели, размещенные в облаке, для оценки любого объекта, с которым они сталкиваются.
Например, их можно использовать для осмотра труднодоступных участков мостов на наличие трещин и других структурных повреждений или для осмотра линий электропередач, заменяя опасные рутинные вертолетные операции.
Методы распознавания образов
R-CNN
Первые модели интуитивно начинают с поиска области, а затем выполняют классификацию. В R-CNN метод выборочного поиска, разработанный Дж.Р.Р. Уйлингс и др. (2012) является альтернативой полному поиску на изображении для фиксации местоположения объекта. Он инициализирует небольшие области изображения и объединяет их в иерархическую группу. Таким образом, последняя группа представляет собой блок, содержащий все изображение. Обнаруженные области объединяются в соответствии с различными цветовыми пространствами и показателями сходства. Результатом является несколько предложений регионов, которые могут содержать объект путем слияния небольших регионов.

Модель R-CNN (Р. Гиршик и др., 2014) сочетает в себе метод выборочного поиска для обнаружения предложений регионов и глубокое обучение для обнаружения объекта в этих регионах. Размер каждого предложения региона изменяется, чтобы соответствовать входным данным CNN, из которых мы извлекаем вектор признаков с 4096 измерениями. Вектор признаков передается в несколько классификаторов для получения вероятностей принадлежности к каждому классу. Каждый из этих классов имеет классификатор SVM, обученный делать выводы о вероятности обнаружения этого объекта для заданного вектора признаков. Этот вектор также передает линейный регрессор, чтобы адаптировать формы ограничивающей рамки для предложения региона и, таким образом, уменьшить ошибки локализации.
Модель CNN, описанная авторами, обучена на наборе данных ImageNet 2012 года для исходной задачи классификации изображений. Он настраивается с использованием предложений по регионам, соответствующих IoU больше 0,5. Выпускаются две версии: в одной версии используется набор данных PASCAL VOC 2012 года, а в другой — набор данных ImageNet 2013 года с ограничивающими рамками. Классификаторы SVM также обучаются для каждого класса каждого набора данных.
Лучшие модели R-CNN достигли оценки mAP 62,4% по сравнению с набором тестовых данных PASCAL VOC 2012 (увеличение на 22,0 балла по сравнению со вторым лучшим результатом в таблице лидеров) и 31,4% оценки mAP по сравнению с набором данных ImageNet 2013 года (увеличение на 7,1 балла по сравнению с 2013 годом). второй лучший результат в таблице лидеров). [Источник: J. Xu’s Blog]

Минусы R-CNN
- Обучение сети по-прежнему занимает огромное количество времени, так как вам придется классифицировать 2000 предложений регионов для каждого изображения.
- Его нельзя реализовать в режиме реального времени, так как для каждого тестового изображения требуется около 47 секунд.
- Алгоритм выборочного поиска является фиксированным алгоритмом. Поэтому на этом этапе обучения не происходит. Это может привести к созданию плохих предложений регионов-кандидатов.
Fast R-CNN
Цель быстрой сверточной сети на основе регионов (Fast R-CNN), разработанной Р. Гиршиком (2015), состоит в том, чтобы сократить затраты времени, связанные с большим количеством моделей, необходимых для анализа всех предложений регионов.
Основная CNN с несколькими сверточными слоями принимает все изображение в качестве входных данных вместо использования CNN для каждого предложения региона (R-CNN). Области интересов (RoI) обнаруживаются с помощью метода выборочного поиска, применяемого к созданным картам объектов. Формально размер карт объектов уменьшается с использованием слоя пула RoI, чтобы получить допустимую область интересов с фиксированной высотой и шириной в качестве гиперпараметров. Каждый слой области интереса передает полностью связанные слои¹, создавая вектор признаков. Вектор используется для прогнозирования наблюдаемого объекта с помощью классификатора softmax и для адаптации локализации ограничительной рамки с помощью линейного регрессора.
Лучшие Fast R-CNN достигли оценки mAp 70,0% для набора тестовых данных PASCAL VOC 2007 г., 68,8% для набора тестовых данных PASCAL VOC 2010 г. и 68,4% для набора тестовых данных PASCAL VOC 2012 г. [Источник: J. Xu’s Blog]

Faster R-CNN
Предложения регионов, обнаруженные с помощью метода выборочного поиска, по-прежнему были необходимы в предыдущей модели, которая требовала значительных вычислительных ресурсов. С. Рен и др. (2016) представили Сеть предложений по регионам (RPN) для прямого создания предложений по регионам, прогнозирования ограничивающих рамок и обнаружения объектов. Более быстрая сверточная сеть на основе регионов (Faster R-CNN) представляет собой комбинацию между RPN и моделью Fast R-CNN.
Модель CNN принимает в качестве входных данных все изображение и создает карты характеристик. Окно размером 3×3 скользит по всем картам объектов и выводит вектор признаков, связанный с двумя полностью связанными слоями, один для блочной регрессии и один для блочной классификации. Предложения нескольких регионов предсказываются полностью связанными слоями. Фиксируется максимум k областей, поэтому выходные данные слоя регрессии блоков имеют размер 4k (координаты блоков, их высота и ширина), а выходные данные слоя классификации блоков имеют размер 2k («объективность» баллов чтобы обнаружить объект или нет в коробке). Предложения области k, обнаруженные скользящим окном, называются якорями. [Источник S. Ren and al. (2016)]

Когда блоки привязки обнаружены, они выбираются путем применения порога к показателю «объективности», чтобы оставить только соответствующие блоки. Эти блоки привязки и карты объектов, вычисленные исходной моделью CNN, подают модель Fast R-CNN.
Быстрее R-CNN использует RPN, чтобы избежать метода выборочного поиска, ускорить процессы обучения и тестирования и повысить производительность. RPN использует предварительно обученную модель набора данных ImageNet для классификации и точно настраивает набор данных PASCAL VOC. Затем сгенерированные предложения регионов с якорными полями используются для обучения Fast R-CNN. Этот процесс является итеративным.
Лучшие Faster R-CNN получили оценки mAP 78,8% по сравнению с набором данных теста PASCAL VOC 2007 года и 75,9% по сравнению с набором данных теста PASCAL VOC 2012 года. Они прошли обучение с наборами данных PASCAL VOC и COCO. Одна из этих моделей² работает в 34 раза быстрее, чем Fast R-CNN при использовании метода выборочного поиска. [Источник S. Ren and al. (2016)]

Region-based Fully Convolutional Network (R-FCN)
Методологии Fast и Faster R-CNN заключаются в обнаружении предложений регионов и распознавании объекта в каждом регионе. Региональная полностью сверточная сеть (R-FCN)) представляет собой модель только со свёрточными слоями, обеспечивающую полное обратное распространение для обучения и логического вывода. Авторы объединили два основных шага в одну модель, чтобы одновременно учитывать обнаружение объекта (инвариант местоположения) и его положение (вариант местоположения).
Модель ResNet-101 принимает исходное изображение в качестве входных данных. Последний слой выводит карты объектов, каждая из которых специализируется на обнаружении категории в каком-либо месте. Например, одна карта признаков специализируется на обнаружении кошки, другая — на банане и так далее. Такие карты объектов называются картами оценки с учетом положения, поскольку они учитывают пространственную локализацию конкретного объекта. Он состоит из k*k*(C+1) карт оценок, где k — размер карты оценок, а C — количество классов. Все эти карты образуют банк очков. По сути, мы создаем патчи, которые могут распознавать часть объекта. Например, при k=3 мы можем распознать 3×3 части объекта.
Параллельно нам нужно запустить RPN для создания области интереса (RoI). Наконец, мы разделяем каждую область интереса на ячейки и сверяем их с банком результатов. Если активировано достаточное количество этих частей, то патч голосует «да», я распознал объект. [Источник S. Ren and al. (2016)]

Дж. Дай и др. (2016) подробно описали пример, показанный ниже. На рисунках показана реакция модели R-FCN, специализирующейся на обнаружении человека. Для области интереса в центре изображения (рис. 3) субрегионы на картах признаков специфичны для паттернов, связанных с человеком. Таким образом, они голосуют за «да, в этом месте есть человек». На рисунке 4 область интереса смещена вправо и больше не сосредоточена на человеке. Субрегионы на картах объектов не согласны с обнаружением человека, поэтому они голосуют «нет, в этом месте нет человека». [Источник S. Ren and al. (2016)]
Лучшие R-FCN достигли оценки mAP 83,6% для набора тестовых данных PASCAL VOC 2007 года и 82,0%, они были обучены с наборами данных PASCAL VOC 2007, 2012 годов и набором данных COCO. По набору тестовых данных COCO Challenge 2015 они получили 53,2% для IoU = 0,5 и 31,5% для официальной метрики mAP. Авторы заметили, что R-FCN в 2,5–20 раз быстрее, чем аналог Faster R-CNN. [Источник S. Ren and al. (2016)]
You Only Look Once (YOLO)
Модель YOLO (J. Redmon et al., 2016)) напрямую предсказывает ограничивающие рамки и вероятности классов с помощью одной сети в одной оценке. Простота модели YOLO позволяет делать прогнозы в реальном времени.
Первоначально модель принимает изображение в качестве входных данных. Он делит его на сетку SxS. Каждая ячейка этой сетки предсказывает B ограничивающих прямоугольников с показателем достоверности. Эта уверенность представляет собой просто вероятность обнаружения объекта, умноженную на IoU между предсказанным и наземным полем истинности. [Источник S. Ren and al. (2016)]

Используемая CNN вдохновлена моделью GoogLeNet, в которой представлены начальные модули. Сеть имеет 24 сверточных слоя, за которыми следуют 2 полносвязных слоя. Слои сокращения с фильтрами 1×1⁴, за которыми следуют сверточные слои 3×3, заменяют исходные начальные модули. Модель Fast YOLO — это более легкая версия, в которой всего 9 сверточных слоев и меньше фильтров. Большинство сверточных слоев предварительно обучены с использованием набора данных ImageNet с классификацией. К предыдущей сети добавляются четыре сверточных слоя, за которыми следуют два полносвязных слоя, и она полностью переобучается с наборами данных PASCAL VOC 2007 и 2012 годов.
Последний слой выводит тензор S*S*(C+B*5), соответствующий прогнозам для каждой ячейки сетки. C — количество предполагаемых вероятностей для каждого класса. B — фиксированное количество блоков привязки на ячейку, каждый из этих блоков связан с 4 координатами (координаты центра блока, ширина и высота) и доверительным значением.
В предыдущих моделях предсказанные ограничивающие рамки часто содержали объект. Однако модель YOLO предсказывает большое количество ограничивающих рамок. Таким образом, есть много ограничивающих рамок без какого-либо объекта. Метод не максимального подавления (NMS) применяется в конце сети. Он заключается в объединении сильно перекрывающихся ограничивающих рамок одного и того же объекта в одну. Авторы заметили, что ложных срабатываний по-прежнему мало.

Модель YOLO имеет показатель mAP 63,7% по сравнению с набором данных PASCAL VOC 2007 года и показатель mAP 57,9% по сравнению с набором данных PASCAL VOC 2012 года. Модель Fast YOLO имеет более низкие оценки, но обе они работают в режиме реального времени.

Плюсы YOLO алгоритма:
- Скорость: Этот алгоритм повышает скорость обнаружения, поскольку он может прогнозировать объекты в режиме реального времени.
- Высокая точность: YOLO — это метод прогнозирования, который обеспечивает точные результаты с минимальными фоновыми ошибками.
- YOLO может обобщать изображение, не нагружая память обработки.
Минусы YOLO алгоритма:
- YOLO страдает от значительно большего количества ошибок локализации и имеет проблемы с идентификацией ближайших предметов.
Single-Shot Detector (SSD)
Подобно модели YOLO, W. Liu et al. (2016) разработали однократный детектор (SSD) для одновременного прогнозирования всех ограничительных рамок и вероятностей классов с помощью сквозной архитектуры CNN.
В качестве входных данных модель принимает изображение, которое проходит через несколько сверточных слоев с различными размерами фильтров (10×10, 5×5 и 3×3). Карты объектов из сверточных слоев в разных положениях сети используются для прогнозирования ограничивающих рамок. Они обрабатываются специальными сверточными слоями с фильтрами 3×3, называемыми дополнительными слоями объектов, для создания набора ограничивающих рамок, подобных якорным рамкам Fast R-CNN.

Каждый “ящик” имеет 4 параметра: координаты центра, ширину и высоту. В то же время он создает вектор вероятностей, соответствующий доверию к каждому классу объектов.

Метод немаксимального подавления также используется в конце модели SSD, чтобы сохранить наиболее релевантные ограничивающие рамки. Затем используется Hard Negative Mining (HNM), потому что все еще прогнозируется много отрицательных полей. Он заключается в выборе только части этих блоков во время обучения. Ящики упорядочены по достоверности, а вершина выбирается в зависимости от соотношения между отрицательным и положительным значением, которое не превышает 1/3.
В. Лю и соавт. (2016) различают модель SSD300 (архитектура подробно показана на рисунке выше) и модель SSD512, которая представляет собой SSD300 с дополнительным сверточным слоем для прогнозирования для повышения производительности. Лучшие SSD алгоритмы обучаются на наборах данных PASCAL VOC 2007, 2012 и наборе данных COCO 2015 с дополнением данных. Они получили оценки mAP 83,2% по сравнению с набором данных теста PASCAL VOC 2007 года и 82,2% по сравнению с набором данных теста PASCAL VOC 2012 года. По набору тестовых данных COCO Challenge 2015 они получили 48,5% для IoU = 0,5, 30,3% для IoU = 0,75 и 31,5% для официальной метрики mAP.
Минусы метода SSD:
- Степень точности SSD немного снижается при идентификации более мелких вещей. Если модель очень большая, скорость может значительно упасть.
Mask Region-based Convolutional Network (Mask R-CNN)
Еще одно расширение модели Faster R-CNN добавленной параллельной ветви к обнаружению ограничивающей рамки, чтобы предсказать маску объекта. Маска объекта — это его сегментация по пикселям на изображении. Эта модель превосходит современную в четырех задачах COCO: сегментация экземпляра, обнаружение ограничивающей рамки, обнаружение объекта и обнаружение ключевой точки.

Сверточная сеть на основе области маски (Mask R-CNN) использует более быстрый конвейер R-CNN с тремя выходными ветвями для каждого объекта-кандидата: метка класса, смещение ограничивающей рамки и маска объекта. Он использует сеть региональных предложений (RPN) для создания предложений ограничивающей рамки и одновременно создает три результата для каждой интересующей области (RoI).
Начальный слой RoIPool, используемый в Faster R-CNN, заменяется слоем RoIAlign. Он удаляет квантование координат исходной области интереса и вычисляет точные значения местоположений. Слой RoIAlign обеспечивает масштабную эквивалентность и трансляционную эквивалентность предложениям региона.
Модель принимает изображение в качестве входных данных и передает сеть ResNeXt со 101 слоем. Эта модель похожа на ResNet, но каждый остаточный блок разрезается на более легкие преобразования, которые объединяются для добавления разреженности в блок. Модель обнаруживает области интереса, которые обрабатываются с использованием уровня RoIAlign. Одна ветвь сети связана с полносвязным слоем для вычисления координат ограничивающих прямоугольников и вероятностей, связанных с объектами. Другая ветвь связана с двумя сверточными слоями, последний вычисляет маску обнаруженного объекта.
Суммируются три функции потерь, связанные с каждой решаемой задачей. Эта сумма сведена к минимуму и дает отличные результаты, поскольку решение задачи сегментации улучшает локализацию и, следовательно, классификацию.
Mask R-CNN достиг оценки mAP 62,3% для IoU = 0,5, 43,4% для IoU = 0,7 и 39,8% для официальной метрики по набору данных COCO test-dev за 2016 год.

Сравнение алгоритмов распознавания образов
Наиболее популярным эталоном является набор данных Microsoft COCO. Различные модели обычно оцениваются в соответствии с показателем средней точности (MAP). Далее мы сравним лучшие алгоритмы обнаружения объектов в реальном времени. Важно отметить, что выбор алгоритма зависит от варианта использования и приложения; разные алгоритмы превосходно справляются с разными задачами (например, Beta R-CNN показывает лучшие результаты для обнаружения пешеходов).
Лучшим алгоритмом обнаружения объектов в реальном времени в 2022 году является YOLOv7, за которым следует Vision Transformer (ViT), такой как Swin и DualSwin, PP-YOLOE, YOLOR, YOLOv4 и EfficientDet.

Обнаружение объектов в реальном времени в тесте COCO: самое современное по средней точности (AP) Самый быстрый алгоритм обнаружения объектов в реальном времени (время вывода) Кроме того, в наборе данных MS COCO важным показателем теста является время вывода (мс/кадр, чем меньше, тем лучше) или кадров в секунду (кадров в секунду, чем выше, тем лучше). Быстрый прогресс в технологии компьютерного зрения очень заметен при сравнении времени логического вывода. Основываясь на текущем времени вывода (чем меньше, тем лучше), YOLOv7 достигает 3,5 мс на кадр по сравнению с YOLOv4 12 мс или популярным YOLOv3 29 мс. Обратите внимание, как введение YOLO (одноэтапный детектор) привело к значительному сокращению времени вывода по сравнению с любыми ранее установленными методами, такими как двухэтапный метод Mask R-CNN (333 мс). С технической точки зрения довольно сложно осмысленно сравнивать различные архитектуры и версии моделей. И Edge AI становится неотъемлемой частью масштабируемых решений AI, новые алгоритмы поставляются с облегченной версией, оптимизированной для Edge (см. YOLOv7-lite или TensorFlow Lite).

Современное состояние по кадрам в секунду (FPS): ведущий алгоритм компьютерного зрения для обнаружения объектов в реальном времени на COCO может обрабатывать 286 кадров в секунду (YOLOv7) и быстрее, чем YOLOv5, YOLOv4, YOLOR и YOLOv3.

Заключение
Распознавание объектов по-прежнему остается одной из самых важных сфер применения для глубокого обучения и компьютерного зрения на сегодняшний день. Мы увидели много улучшений и достижений в методологиях обнаружения объектов.
Все началось с таких алгоритмов, как гистограмма ориентированных градиентов, введенных еще в 1986 году для выполнения простых обнаружений объектов на изображениях с приличной точностью. Теперь у нас есть современные архитектуры, такие как Faster R-CNN, Mask R-CNN, YOLO и RetinaNet.
Распознавание объектов не ограничивается статическими изображениями, поскольку они могут эффективно выполняться на видео и кадрах в реальном времени с высокой точностью. В будущем нас ждет еще много удачных алгоритмов и библиотек для обнаружения объектов.
- Распознавание образов
- компьютерное зрение
- искусственный интеллект
- искусственные нейронные сети
- алгоритмы
Учим нейросети распознавать изображения и лица

Бесплатный вебинар «Учим нейросети распознавать изображения и лица». Вы узнаете, как с помощью нейросетей распознавать объекты на фото и видео. Познакомитесь с основами языка Python и машинного обучения и научите компьютер «видеть».
Этот вебинар подойдёт тем, кто интересуется Data Science или анализом данных, и тем, кто выбирает направление в IT или восхищается нейросетями.
В эфире расскажем:
- что такое компьютерное зрение и для чего оно нужно;
- как определить, что изображено на картинке;
- где используется классификация изображений;
- как нейронная сеть преобразует изображения.
На интенсиве вы сразу же отработаете новые знания в мини-проекте — научитесь распознавать объекты и лица на картинке с помощью нейросети.
Спикер — Андрей Макаровский, Data Scientist в Сбербанке. Работает в области науки о данных уже 3 года. Внедрял компьютерное зрение в работу предприятия тяжёлой промышленности. Участвовал в исследовании по генерации изображений для маркетинговых кампаний.
Другие видео интенсива

Обнаруживаем объекты на изображении с помощью нейросетей
30.05.2023 842

Введение в компьютерное зрение: подводим итоги
31.05.2023 727
Рекомендованные

Автоматизируем рутину с помощью Python
13.09.2023 1327

Data Mining: выделяем тренды в описании вакансий с помощью Python
12.09.2023 1256

Что умеет Python-фрилансер. Учимся собирать информацию в интернете
11.09.2023 2948

1С-разработчик: подведение итогов
09.09.2023 519

Решаем бизнес-задачи в 1С
08.09.2023 875

Кто такой программист 1С и чем он занимается
07.09.2023 1261

Telegram-бот на Java: подводим итоги
02.08.2023 873

Пишем универсального бота для тестов на Java
01.08.2023 1712

Знакомимся с Java и продумываем логику Telegram-бота
31.07.2023 1133

Анализ данных в Data Science: подводим итоги
26.07.2023 878

Анализ данных в Data Science: техники исследования
25.07.2023 1442

Анализ данных в Data Science: знакомимся с Python
24.07.2023 1725

Карьера в IT: готовимся к собеседованию и учимся составлять резюме
07.06.2023 538

Пробуем себя в анализе данных и мобильной разработке
06.06.2023 528

Знакомимся с Java, Python, фронтенд-разработкой и тестированием
05.06.2023 1338
36 комментариев
Skillbox.Live
Телеграм-чат интенсива — https://u.to/DWCyHw | Это бот — нажмите «Начать», и появится ссылка на чат
Анастасия Соломина
Сергей Кузнецов
Александр Мукминов
Дмитрий Саютин

Vera Rusakova
Skillbox.Live
Телеграм-чат интенсива — https://u.to/DWCyHw | Это бот — нажмите «Начать», и появится ссылка на чат
Andrey Frolov
У жирафа не распознал(
Skillbox.Live
Запись останется на этой же странице, нажимайте Поделиться, чтобы сохранить её и пересмотреть позднее. Также будет в Телеграм-чате, в который пригласим в конце вебинара
Unknown Name
стоп стоп, ошибочка
Skillbox.Live
Darya Fomicheva
Acil Nova
Немножко звук заело разве что
Илдус Гилязов
Илдус Гилязов
Добрый день! Цифар 10 и цифар 100 это последние готовые наборы или есть новые тестовые наборы для обучения нейронных сетей
Василий Антонов
Чубчик у ведущего довольно таки прикольный!) Респект.
Victor Awerin
первый раз, 2+
Старый Нуб

David Oganesyan
смотрю первый раз
David Oganesyan
Добрый вечер, где то от 1 до 2)
Дмитрий Лукин
Добрый вечер всем!
Сергей Кузнецов
Добрый день
Acil Nova
Про платформу давно знаю, но на вебинар впервые хватило смелости. Собственно, в теме на троечку, конечно, пока сложно, хотя учусь на программиста 🙂
Vera Rusakova
Здравствуйте
Старый Нуб
Второй раз, полный нуб)
Victor Awerin
Всем привет. +++
Александр Мукминов
Acil Nova
Дмитрий Саютин
Старый Нуб
Алексей Ефименко
Skillbox.Live
Мы стартовали! Если не начался эфир — обновите, пожалуйста, страницу
Skillbox.Live
Всем привет, стартуем в 19:00 мск! Длительность вебинара примерно 1,5-2 часа | Запись сохраним на этой же странице | Телеграм-чат дадим в конце вебинара
- Все вебинары
- Программирование
- Учим нейросети распознавать изображения и лица
- 8 (800) 500-05-22 Контактный центр
- +7 499 444 90 36 Отдел заботы о пользователях
Есть вопрос или предложение? Напишите Сергею Попкову — ответственному за качество курсов
г. Москва, ул. Тимура Фрунзе, дом 11, корпус 2, этаж 1, помещение 1, комната 75
- Оферта
- Оплата
- Правила пользования Платформой
- Политика конфиденциальности
- Рекомендательные технологии
Мы используем файлы cookie, для персонализации сервисов и повышения удобства пользования сайтом. Если вы не согласны на их использование, поменяйте настройки браузера.
Образовательные услуги оказываются ЧОУ ДПО «Образовательные технологии «Скилбокс (Коробка навыков)» на основании Лицензии № Л035-01298-77/00179609 от 19 января 2022 года.
Правообладатель ПО LMS «Skillbox 2.0» ООО «Скилбокс».
- Премии Рунета
2018, 2019, 2020, 2021, 2022
** деятельность компании Meta Platforms Inc., которой принадлежит Инстаграм / Фейсбук, запрещена на территории РФ в части реализации данной (-ых) социальной (-ых) сети (-ей) на основании осуществления ею экстремистской деятельности
Распознавание объектов с помощью нейронных сетей

В процессе исследовательской работы по информатике «Распознавание объектов с помощью нейронных сетей» учащейся 9 класса была поставлена цель, написать нейронную сеть на языке Python в среде jupyter notebook, которая будет распознавать образы кошек и собак.
Подробнее о проекте:
В процессе исследовательской работы по информатике «Анимация в PascalABC.NET» ученицей 9 класса было дано определение искусственной нейронной сети и представлено описание сверточной нейронной сети для распознавания двух классов объектов. Для выполнения поставленной цели автор проекта изучил и реализовал работу нейросети в среде jupyter notebook.
В учебном проекте по информатике «Анимация в PascalABCNET» автор подобрал подходящую нейросетевую библиотеку, написал программу, распределяющую dataset на выбранные классы для обучения нейронной сети, написал нейронную сеть, которая определяет объекты, такого же класса, как из dataset, провел обучение нейронной сети классификации предложенных объектов, дал оценку точности (%), осуществил отладку и тестирование полученной нейронной сети.
Оглавление
Введение
1. Искусственная нейронная сеть.
2. Описание сверточной нейронной сети для распознавания двух классов объектов.
3. Обучение нейронной сети.
Заключение
Источники
Приложение
Введение
Нейронные сети возникли из исследований в области искусственного интеллекта. Искусственный интеллект – свойство интеллектуальных систем выполнять творческие функции, которые традиционно считаются прерогативой человека; наука и технология создания интеллектуальных машин, особенно интеллектуальных компьютерных программ.
Существуют различные подходы к определению. Моя работа опирается на проблематику машинного обучения – процесса самостоятельного получения знаний интеллектуальной системой в процессе её работы. К области машинного обучения относится большой класс задач, в том числе на распознавание образов. Теория распознавания образа – раздел информатики и смежных дисциплин, развивающий основы и методы классификации и идентификации предметов, явлений, процессов, сигналов, ситуаций и т.п. объектов, которые характеризуются конечным набором некоторых свойств и признаков.
Цель моей работы — написать нейронную сеть на языке Python в среде jupyter notebook, которая будет распознавать образы кошек и собак.
- Понять и реализовать работу нейросети в среде jupyter notebook.
- Описание сверточной нейронной сети для распознавания двух классов объектов.
- Подобрать подходящую нейросетевую библиотеку.
- Написать программу, распределяющую dataset на выбранные классы для обучения нейронной сети.
- Написать нейронную сеть, которая будет определять объекты, такого же класса, как из dataset.
- Обучение нейронной сети классификации предложенных объектов.
- Оценка точности (%).
- Отладка и тестирование полученной нейронной сети.
Гипотеза: при многократном повторении классификации для другой группы объектов обучение нейронной сети дает более высокий результат опознавания объектов из незнакомого фоторяда.
Искусственная нейронная сеть
Искусственная нейронная сеть — математическая модель, а также её программное или аппаратное воплощение, построенная по принципу организации и функционирования биологических нейронных сетей — сетей нервных клеток живого организма. Нейронные сети можно классифицировать по многим параметрам. Например, по характеру обучения.
Бывает обучение с учителем — выходное пространство решений нейронной сети известно; без учителя — нейронная сеть формирует выходное пространство решений только на основе входных воздействий, такие сети называют самоорганизующимися; обучение с подкреплением — система назначения штрафов и поощрений от среды.
Также бывают разные типы нейросетей, причем их достаточно много, вот некоторые из них: сети адаптивного резонанса, свёрточная нейронная сеть, осцилляторная нейронная сеть, неокогнитрон и многие другие. Для данной нейронной сети подойдет обучение с учителем, потому что у меня нет достаточно знаний, чтобы написать программу с другим видом обучения. Обучение с учителем будет быстрее и не так затратно по времени, по сравнению с другими вариантами.
Я выбрала сверточную нейронную сеть — специальная архитектура искусственных нейронных сетей, она нацеленная на эффективное распознавание образов, входит в состав технологий глубокого обучения. Под глубоким обучением для нейронных сетей понимают — совокупность методов машинного обучения (с учителем, без учителя, с подкреплением), основанных на обучении представлениям, а не специализированным алгоритмам под конкретные задачи.
Нейросетевая библиотека — программное обеспечение, которое позволяет собрать нейронную сеть под конкретную задачу, визуализировать ее архитектуру, запустить обучение этой нейронной сети и выгрузить обученную сеть для дальнейшего использования. В данном случае, я буду использовать библиотеку Keras — открытая нейросетевая библиотека, написанная на языке Python. Нацелена на оперативную работу с сетями глубинного обучения, при этом спроектирована так, чтобы быть компактной, модульной и расширяемой.
Dataset – это набор данных. В моем случае, это выборка из 25000 фотографий с кошками и собаками (по 12500 на каждый класс). Такой большой dataset нужен для повышения качества распознавания при обучении нейронной сети.
Описание сверточной нейронной сети для распознавания двух классов объектов
Архитектура включает в себя укладку сверточных слоев с небольшими фильтрами 3×3 с последующим максимальным объединением слоев. Вместе эти слои образуют блок, и эти блоки могут быть повторены, где количество фильтров в каждом блоке увеличивается с глубиной сети по степени двойки в геометрической прогрессии.
Для первых четырех блоков модели — 32, 64, 128, 256. Заполнение используется на сверточных слоях для обеспечения соответствия форм высоты и ширины выходных карт объектов входным данным. Модель будет соответствовать стохастическому градиентному спуску. Начало обучения будем осуществлять со скоростью 0,001 при импульсе равном 0,9.
Задача представляет собой задачу бинарной классификации, требующую предсказания одного значения — либо 0, либо 1. Будет использован выходной слой с 1 узлом и сигмовидной активацией, а модель будет оптимизирована с использованием бинарной функции потерь кросс-энтропии — используется для количественной оценки разницы между двумя вероятностными распределениями.
Затем мы можем подогнать модель с помощью train iterator (train_it) и использовать test iterator (test_it) в качестве набора данных проверки во время обучения. Модель будет подходить обучение 10 раз (то есть 10 эпох – одна итерация в процессе обучения, включающая предъявление всех примеров из обучающего множества и, возможно, проверку качества обучения на контрольном множестве.), это необходимо для большей точности нейросети.
После подбора окончательная модель может быть оценена непосредственно на наборе тестовых данных и сообщена точность классификации. Затем мы можем загрузить модель и вызвать функцию предсказания, чтобы предсказать содержимое изображения в виде числа между «0» и «1» для «кошка» и «собака» соответственно. Нам же будет выводить «IT’S A CAT» или «IT’S A DOG».
Обучение нейронной сети
Классифицировать объекты можно не только с помощью нейросетей, но и с помощью других программ. В моем случае это проблематичнее, и точность результата значительно уменьшается. Чтобы научить нейросеть различать объекты, понадобится большой dataset. В результате поиска dataset в сети Интернет на сайте был найден смешанный dataset. Для обучения мне необходимы были образцы классов.
Потребовалось написать программу, которая будет распределять фотографии по папкам test и train, а в этих папках создаст подкаталоги, cat и dog. Листинг программы в приложении 1.
Причем в папке test будут не все фотографии, а некоторая часть, по которым нейросеть будет определять точность. После приступила к написанию нейронной сети. Листинг — приложение 2. После описания нейросети на языке Python, я должна была приступить к ее обучению.
По техническим характеристикам и быстродействию мой компьютер не подходит для обучения, я обучала бы на свое компьютере око трех дней нейросеть. Для обучения потребуется компьютер с ОП не менее — 16, Тактовой частотой не менее — 3,7 Ггц, Разрядностью не менее — 64
Можно выбрать три варианта действий. Первый, все равно тренировать нейросеть на моем компьютере. Второй, воспользоваться другим компьютером.
Третий — арендовать облачный сервер. Облачный сервер -мощная физическая или виртуальная инфраструктура, выполняющая приложения и служащая хранилищем обрабатываемой информации. Аренда 1 часа около 55 рублей. Первый вариант меня не устраивал по причине долгого ожидания. Второй тоже не подходил, так как пришлось бы устанавливать много дополнительных приложений, что заняло бы тоже много времени.
Поэтому пришлось выбрать третий вариант. Обучение прошло достаточно быстро для такой выборки и для такого количества эпох, примерно за 15 минут. Нейронная сеть во время обучения показывала, на сколько процентов она точна, после первой части обучения, ее точность была около 50%, а в конце же 98%, что очень хорошо. Обычно в подобных нейросетях точность от 89% до 95%. Была вероятность перетренировать нейросеть из-за большого количества эпох, к счастью, этого не случилось.
Данную нейронную сеть можно проверить с помощью командной строки — это специальная программа, которая позволяет управлять компьютером путем ввода текстовых команд с клавиатуры. Я пользуюсь Power Shell. Нужно ввести команду, тогда она после некоторых действий скажет, кто изображен на картинке. После обучения необходима отладка — этап разработки компьютерной программы, на котором обнаруживают, локализуют и устраняют ошибки, но в конечном продукте ошибок не оказалось.
Заключение
В результате работы в среде jupyter notebook на языке Python, была написана простейшая нейронная сверточная сеть, которая распознает образы двух объектов — кошек и собак. Распознавание объектов достоверно в 98% Поставленная цель достигнута, выдвинутая гипотеза подтверждена в допустимом расхождениях статистических показателях.
Созданную нейронную сеть можно обучить распознавать объекты других классов. Это будет аналог программ для индикации объектов по графическому изображению среди объектов разного класса при наличии математических навыков и навыков программирования можно достигнуть результата определения определенного объекта по изображению неограниченного множества, что может быть способом поиска в сети.
Для написания данной работы были использованы ресурсы Сети Интернет
Приложение 1
from os import listdir
from os import makedirs
from shutil import copyfile
from random import seed
from random import random
from numpy import asarray
from numpy import save
from keras.preprocessing.image import load_img
from keras.preprocessing.image import img_to_array
from tqdm import tqdm_notebook
for subdir in subdirs:
# создание подкаталогов с определенными именами
for labldir in labeldirs:
newdir = dataset_home + subdir + labldir
# генерация случайных чисел
# определение соотношения изображений, используемых для проверки
# копирование изображений обучающего набора данных в подкаталоги
for file in tqdm_notebook(listdir(src_directory)):
src = src_directory + ‘/‘ + file
dst = dataset_home + dst_dir + ‘cats/‘ + file
dst = dataset_home + dst_dir + ‘dogs/‘ + file
Приложение 2
# vgg16 модель, используемая для переноса обучения dataset из кошек и собак
from matplotlib import pyplot
from keras.utils import to_categorical
from keras.applications.vgg16 import VGG16
from keras.models import Model
from keras.layers import Dense
from keras.layers import Flatten
from keras.optimizers import SGD
from keras.preprocessing.image import ImageDataGenerator
# определение модели cnn
model = VGG16(include_top=False, input_shape=(224, 224, 3))
# отмечаем загруженные слои как не поддающиеся обучению
for layer in model.layers:
# добавляем новые слои классификатора
class1 = Dense(128, activation=’relu‘, kernel_initializer=’he_uniform‘)(flat1)
output = Dense(1, activation=’sigmoid‘)(class1)
# определение новой модели
model = Model(inputs=model.inputs, outputs=output)
opt = SGD(lr=0.001, momentum=0.9)
model.compile(optimizer=opt, loss=’binary_crossentropy‘, metrics=[‘accuracy‘])
# диагностика учебной модели
pyplot.title(‘Cross Entropy Loss‘)
pyplot.plot(history.history[‘loss‘], color=’blue‘, label=’train‘)
pyplot.plot(history.history[‘val_loss‘], color=’orange‘, label=’test‘)
pyplot.plot(history.history[‘acc‘], color=’blue‘, label=’train‘)
pyplot.plot(history.history[‘val_acc‘], color=’orange‘, label=’test‘)
# сохранение в файл
# запуск тестовой программы для оценки
# указание средних значений картинок для работы с ними
datagen.mean = [123.68, 116.779, 103.939]
class_mode=’binary‘, batch_size=64, target_size=(224, 224))
class_mode=’binary‘, batch_size=64, target_size=(224, 224))
history = model.fit_generator(train_it, steps_per_epoch=len(train_it),
validation_data=test_it, validation_steps=len(test_it), epochs=10, verbose=1)
_, acc = model.evaluate_generator(test_it, steps=len(test_it), verbose=0)
# кривая обучаемости — графическое представление изменения скорости обучения определённому знанию или виду деятельности