Kubeflow: учимся устанавливать и запускать Kubeflow на локальной машине
Пошаговое руководство по установке и конфигурированию всех компонентов kubeflow на локальной машине.
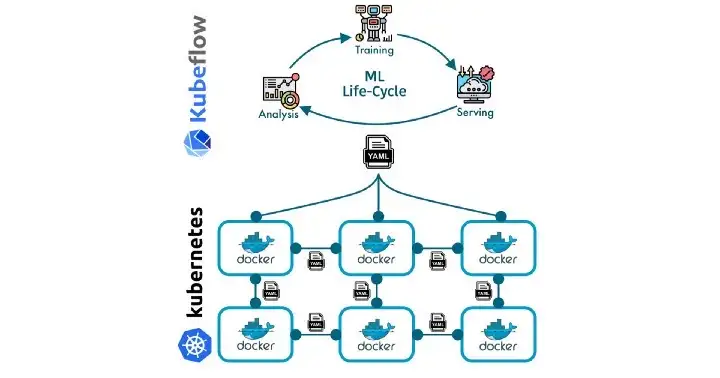
Рис. 1. Взаимодействие Kubeflow и Kubernetes | рисунок автора |иконки от Eucalyp
Kubeflow [1] – это созданная Google опенсорсная платформа, на которой разворачивается весь жизненный цикл разрабатываемой модели машинного обучения. Kubeflow представляет собой инструментарий, каждый компонент которого применяется для отработки каждой из стадий жизненного цикла при машинном обучении, а именно: исследования данных, конструирования признаков, преобразования признаков, обучения модели, оценки модели, тонкой настройки модели, предоставления модели и версионирования модели. Главный атрибут kubeflow заключается в том, что он предназначен для работы на базе kubernetes [2]. Таким образом, kubeflow пользуется именно теми преимуществами, которые предоставляет кластер kubernetes, в частности, оркестрацией контейнеров и автомасштабированием.
Тогда как kubernetes является стандартной технологией оркестрацией контейнеров, исследователям данных и специалистам по машинному обучению бывает сложно напрямую координировать жизненный цикл системы машинного обучения непосредственно в кластере kubernetes (к тому же, на это уходит много времени). Соответственно, kubeflow выступает в качестве платформы, оснащённой инструментами для конфигурирования, разработки, автоматизации и развёртывания каждой стадии жизненного цикла машинного обучения в кластере kubernetes. Так у исследователей данных и специалистов по машинному обучению высвобождается время, которое не приходится тратить на конфигурирование и применение изменений непосредственно в кластере kubernetes.
В этой статье рассмотрено, как установить и сконфигурировать kubeflow на локальной машине, чтобы на этой же машине можно было бы приступить к локальному использованию kubeflow, не нуждаясь в облачном провайдере. Вот какие подразделы будут в этой статье:
- Требования
- Установка Minikube
- Установка Kubeflow
- Создание проекта Kubeflow
- Обращение к пользовательскому интерфейсу Kubeflow
❯ Требования
Чтобы установить и запустить kubeflow на локальной машине, необходим набор ключевых компонентов. Прежде всего, нам понадобится кластер kubernetes, на котором сервис kubeflow будет устанавливаться и развёртываться. Поскольку устанавливать kubernetes как таковой на локальной машине не рекомендуется (учитывая, сколько ресурсов он требует). Более лёгкая альтернатива, ориентированная на локальные тесты – это эмуляция кластера kubernetes, для чего и существует minikube [3] (а также его альтернативы: microk8s, kind и k3s). В дополнение к minikube нам понадобится гипервизор, при помощи которого мы сможем сгенерировать виртуальные окружения внутри нашего мини-кластера. В данном случае воспользуемся hyperkit [4] (хотя и у него есть альтернативы — VirtualBox, kvm2 под Linux и Hyper-V под Windows). Наконец, нам понадобится пакет kubeflow.
Дисклеймер: поскольку я работаю с MacOS, команды из этого поста приведены именно к MacOS. Но в документации по каждому компоненту также рассмотрены эквиваленты для Linux или Windows.
❯ Установка Minikube
Чтобы установить minikube для MacOS, просто введите:
$ brew install minikubeПо завершении установки команда kubectl будет добавлена в путь $PATH . kubectl . Это команда для взаимодействия с мини-кластером kubernetes. Ещё нам понадобится гипервизор, при помощи которого мы будем создавать окружения в мини-кластере kubernetes, для этого мы воспользуемся hyperkit , который можно установить вот так:
$ brew install hyperkitОтлично. Для запуска нашего мини-кластера kubernetes введите:
$ minikube start --driver=hyperkitВышеприведённая команда инициализирует мини-кластер kubernetes. Для этого мы применим hyperkit в качестве гипервизора для виртуальных окружений. Чтобы проверить информацию о нашем кластере, нужно просто ввести следующую команду:
$ kubectl cluster-infoТогда получим примерно следующий вывод:
> Kubernetes control plane is running at https://192.168.64.5:8443Отлично. На данном этапе у нас есть все необходимые компоненты, позволяющие приступить к установке и конфигурированию kubeflow – давайте же этим займёмся!
❯ Установка Kubeflow
Для установки kubeflow нам потребуется определить несколько переменных окружения. Далее мы скачаем проект kubeflow, а после этого перейдём к его установке. Итак, давайте определим переменные:
$ PLATFORM=$(uname) $ export PLATFORM $ mkdir -p ~/bin $ export KF_TAG=1.0.1 $ KF_BASE="https://api.github.com/repos/kubeflow/kfctl/releases"Переменная KF_TAG указывает ту версию образа, которую мы собираемся использовать. Мы воспользуемся самой свежей, в данном случае это будет версия 1.2.0 . Затем определим URL , скачаем и распакуем проект, а затем перенесём бинарник kfctl в каталог с бинарниками, созданный на предыдущем шаге.
$ KFCTL_URL=$(curl -s $ |\ grep http |\ grep "$" |\ grep -i "$" |\ cut -d : -f 2,3 |\ tr -d '\" ' ) $ wget "$" $ KFCTL_FILE=$ $ tar -xvf "$" $ mv ./kfctl ~/bin/Наконец, требуется удалить пакет kubeflow (хранить его больше незачем). Мы добавим путь к kubeflow ~/bin (содержащий команду kfctl ) в наш $PATH :
$ rm "$" $ export PATH=$PATH:~/binДолжно быть, команда kfctl уже готова. Чтобы её протестировать, введём:
$ kfctl version kfctl v1.2.0-0-gbc038f9При помощи команды kfctl мы сможем взаимодействовать с компонентами kubeflow, в частности, чтобы определять и применять манифесты в нашем кластере kubernetes. Пока у нас подготовлены мини-кластер kubernetes, а также установка kubeflow. Следующий этап – сгенерировать наш первый проект kubeflow при помощи команды kfctl , давайте так и сделаем!
❯ Создание проекта Kubeflow
Как мы уже знаем, kubeflow работает поверх kubernetes. Следовательно, взаимодействие между двумя этими платформами осуществляется на уровне манифестов или файлов yaml . Таким образом, чтобы сгенерировать проект kubeflow, требуется проработать файл yaml , в котором определяются все те сервисы, что необходимо развернуть в мини-кластере kubernetes.
Сначала сгенерируем несколько переменных окружения, определяющих ту версию kubeflow, что мы устанавливаем. Затем зададим каталог, в котором будут выделяться все конфигурационные файлы и yaml -файлы, относящиеся к каждому из сервисов, развёрнутых в проекте kubeflow. Наконец, получим yaml для развёртывания проекта kubeflow в нашем мини-кластере kubernetes.
Приступаем к определению тех переменных окружения, которые соответствуют установленной нами версии kubeflow:
$ MANIFEST_BRANCH=$ $ export MANIFEST_BRANCH $ MANIFEST_VERSION=$ $ export MANIFEST_VERSIONЗатем определяем имя проекта и создаём каталог, в котором будут выделяться все конфигурационные файлы и yaml -файлы для каждого сервиса:
$ KF_PROJECT_NAME=$> $ export KF_PROJECT_NAME $ mkdir "$" $ pushd "$"Далее определяем тот репозиторий, из которого возьмём манифест, и присваиваем его переменной окружения:
$ manifest_root=https://raw.githubusercontent.com/kubeflow/manifests $ FILE_NAME=kfctl_k8s_istio.$.yaml $ KFDEF=$$/kfdef/$
Как видите, здесь мы используем манифест для ISTIO (это реализация сервисной сети для kubernetes). Наконец, применяем манифест, чтобы развернуть наш проект kubeflow.
$ kfctl apply -f $KFDEF -VПроцесс развёртывания может занять около 30 минут.
Чтобы убедиться, что установка прошла успешно, воспользуемся следующей командой, удостоверяющей, что все сервисы работают в режиме RUNNING или COMPLETED .
$ kubectl get pods --all-namespaces -wВ случае, если у некоторых сервисов окажется статус error , может потребоваться выделить побольше памяти под ваш мини-кластер kubernetes (minikube) и повторно применить манифест развёртывания. Если всё пройдёт успешно, то мы сможем просмотреть наш проект kubeflow в браузере. Давайте так и сделаем!
❯ Доступ к пользовательскому интерфейсу Kubeflow
Поскольку мы всё устанавливаем на локальном сервере, для доступа к UI kubeflow требуется всего лишь пробросить порты следующим образом:
$ kubectl port-forward svc/istio-ingressgateway -n istio-system 7777:80Вышеприведённая команда выполняется при помощи kubectl , которая предоставляет порт 7777 сервиса istio-ingressgateway с пространством имён istio-system – именно через него мы получаем доступ к пользовательскому интерфейсу kubeflow. Наконец, если вы перейдёте по http://localhost:7777, то будете перенаправлены в графический интерфейс kubeflow, как показано на рисунке 2.

Рис. 2. Kubeflow UI | скриншот автора
❯ Заключение
В этой статье было рассмотрено, как скачать, сконфигурировать и установить kubeflow, а также требования к этому инструменту в операционной системе MacOS.
Это руководство поможет вам начать работу с kubeflow через графический пользовательский интерфейс. Как видите, в kubeflow предоставляется инструментарий для разработки полноценного жизненного цикла модели машинного обучения.
Что такое Kubeflow? Основы машинного обучения с Kubeflow
У фотографов есть Photoshop, у архитекторов — AutoCAD, а у инженеров машинного обучения — Kubeflow. Каждый получает свои преимущества от использования специализированного программного обеспечения, инженеры ML — не исключение.
В этой статье разберем чем полезен и как работает Kubeflow.
Что такое Kubeflow?
Kubeflow — это бесплатная платформа для машинного обучения с открытым исходным кодом, которая позволяет пайплайнам/конвейерам машинного обучения управлять комплексными рабочими процессами Kubernetes. Kubeflow был выпущен в 2017-ом разработчиками из Google, Cisco, IBM, Red Hat и других компаний. Официальный выпуск версии 1.0 был осуществлен в этом году.
Набор инструментов Kubeflow облегчает работу инженерам по следующим параметрам:
- Разработка моделей машинного обучения
- Анализ производительности модели
- Настройка гиперпараметров
- Тестирование моделей
- Управление вычислительными мощностями
- Развертывание моделей в рабочей среде
Все это можно сделать на любом облачном провайдере и в любом месте, где есть Kubernetes.
«Kube» в Kubeflow перешел от инструмента оркестровки контейнезированных приложений Kubernetes. Kubeflow работает в кластерах Kubernetes локально или в облаке, позволяя с легкостью обучать модели машинного обучения на нескольких компьютерах, ускоряя время обучения модели. «Flow» означает, что Kubeflow стоит наряду с другими планировщиками рабочих процессов, такими как ML Flow, FBLearner Flow и Airflow.
Kubeflow и машинное обучение
Kubeflow является основным продуктом для команд MLOps. Она помогает организовывать ход работы в проектах, эффективно осуществлять облачные вычисления и позволяет инженеру ML по-настоящему погрузиться в работу и создавать максимально впечатляющие модели. Менеджер Kubeflow коммьюнити Теа Ламкин отмечает:
«Цель Kubeflow — облегчить инженерам машинного обучения (ML) и экспертам по аналитическим данных использование облачных ресурсов (общедоступных или локальных) в рабочих процессах ML».
По словам участников команды Kubeflow, для создания модели машинного обучения требуется многое, что выходит далеко за рамки простого понимания статистики и нейронных сетей. Это не просто написание ML-кода. Kubeflow помогает управлять всем этим в пределах всего лишь одной платформы.
К примеру, все эти аспекты являются частью построения модели машинного обучения:

«Благодаря Kubeflow, один из моих инженеров сократил срок развертывания модели с 8-ми недель до одного дня» — ML-инженер Spotify.
Выпуск Kubeflow 1.0
Kubeflow официально запустил версию 1.0 в марте 2020. Результаты работы команды отображены на доске Kanban.
Варианты применения Kubeflow
Kubeflow можно использовать для:
- Ведения документации
- Платформы Multi-cloud
- Инструментов мониторинга
- Управления рабочим flow
- Внедрения модели
Давайте рассмотрим каждый пункт по отдельности.
Ведение документации
Во-первых, платформы с открытым исходным кодом не обязательно должны иметь документацию. Если его создатели хотят, чтобы другие использовали его, то документация помогает рассказать людям о возможностях их библиотеки программного обеспечения и дать инструкции по ее применению. Документация полезна для сообществ с открытым исходным кодом, где проекты часто передаются из уст в уста, подбираются и используются просто так, из любопытства. Если упаковку можно использовать, разработчики найдет ей применение. Если нет — двигаемся дальше.
Kubeflow обладает поразительным качеством документации, обычно несвойственным проектам на начальном этапе. Стандарт совершенства, которого придерживаются авторы, поразителен, что положительно сказывается на эффективности выполнения поставленных задач.
Документация Kubeflow проста как для понимания, так и для применения. Вне зависимости от того, какая задача стоит перед девелопером — начать процесс, настроив свой первый конвейер/пайплайн или приняться за более сложную задачу в виде отката своей модели к предыдущим настройкам — с документацией Kubeflow максимально просто работать и находить то, что необходимо.
Платформа Multi-cloud
Kubeflow — это инструмент с открытым исходным кодом. Изначально он был разработан как инструмент внутреннего пользования Google в Google Tensorflow, в виде расширения на Kubernetes. Так как это довольно молодой проект, Kubeflow еще не получил своего финансирования от Google, но создатели, участники и инженеры ML-инженеры, использующие его, уже убедились в его уникальных преимуществах и продолжают расширять платформу.
С момента создания Kubeflow работает везде, где есть Kubernetes, и позволяет работать с любыми архитектурами. Для использования на облачном провайдере, Kubeflow предполагает особую документацию по настройке:
- Kubeflow на AWS
- Kubeflow на Azure
- Kubeflow на GCP
- Kubeflow в облаке IBM
- Kubeflow на OpenShift
Инструменты мониторинга
Kubeflow интегрирует Tensorboard в свои функции. Tensorboard предоставляет инструменты для визуализации процесса машинного обучения. Как учат в Хаос-инжиниринг, визуализация процесса помогает избежать возникновения неполадок. Возможность контролировать тренировочный процесс помогает командам MLOps:
- Точно настроить параметры модели.
- Сэкономить ресурсы, остановив обучение, если будет видно, что модель неэффективна.
- Ускорить время сборки за счет быстрой итерации.


Управление рабочими процессами
На этой диаграмме показано выполненное задание в Kubeflow.

Аналогично мониторингу, инструмент управления рабочими процессами позволяет инженерам самостоятельно управлять своим временем. Подобно тому, как рендеринг служит видеоредакторам, Kubeflow помогает ML-инеженерам сэкономить время на перемещении данных и обучении моделей. Kubeflow показывает, где находится необходимое задание в списке задач, а когда задания завершены, все участники процесса получат Slack-уведомление о завершении работы над пайплайном.
Благодаря инструментам управления flow работы, инженер сможет организовать порядок машинного обучения гораздо более эффективно, сэкономив время для решения дополнительных задач.
Развертывание модели
И наконец, важно отметить, что ни одна модель не является завершенной/полной, если она просто стоит на полке или осталась в планах Jupyter. Модели должны быть развернуты, чтобы можно было делать конкретные выводы.
Существует несколько способов развертывания модели из Kubeflow, к примеру, инструмент KFserving tool. Наряду со многими другими, KFserving работает в облаке и в режиме реального времени. Данный инструмент интегрируется с несколькими платформами машинного обучения, включая:
Поскольку он использует Kubernetes в качестве базы, ресурсы будут автоматически масштабироваться по мере увеличения использования модели.
Опыт внедрения Kubeflow в кластере Kubernetes
В статье мы рассказали о внедрении ML-платформы Kubeflow в кластере Kubernetes на площадке заказчика.
Инструменты, которые мы использовали в рамках проекта, являются программным обеспечением с открытым исходным кодом, поддерживаются авторами и сообществом. Платформа виртуализации — Hyper-V. Инструменты, созданные для облаков, не всегда быстро и легко разворачиваются, а предугадать все риски невозможно. В статье мы рассказали про поиск подходящей архитектуры, подбор версий компонентов, общие технические аспекты установки кластера Kubernetes, OKD и настройки Kubeflow. Мы описали исследование и опыт внедрения, выделив проблемные места и моменты, на которые стоит обратить внимание.
Список статей и материалов по теме можно найти в секции “Дополнительные материалы” в заключении статьи.
Требования к платформе
Во-первых, банку было важно перейти от хаоса в жизненном цикле моделей к вменяемому ModelOps с описанием, гайдлайнами и методологией без сильной привязки к языку программирования. Во-вторых, иметь четкую и прозрачную ролевую модель и разграничение ресурсов, дабы никто не смог положить работу всех подразделений или убить Prod одной неудачной строчкой кода. Ну и напоследок, бесперебойно работать и иметь SLA с поддержкой более компетентных товарищей. Из дополнительных требований со стороны информационной безопасности была работа on-prem. Ряд моделей работал на персональных данных и производных из них, поэтому их передача в облако была невозможна (или сопряжена с долгими циклами согласования и процедурами обезличивания).
На рынке представлено много поставщиков целевых решений. Начиная от таких дорогостоящих тяжеловесов, как SAS и IBM, заканчивая стартапами с достаточно перспективными разработками наподобие Hopsworks. И вот цена — это главное ограничение, с которым мы столкнулись. У банка на тот момент не было большого количества моделей, и не было предпочтений в выборе какого-то конкретного поставщика. Поэтому было принято решение остановиться на опенсорсных решениях, которые не требуют ежегодных подписок или единовременных крупных платежей вендорам. Кроме того, т.к. направление машинного обучения — достаточно новое для банка, никто не готов был вкладываться в дорогие решения вендоров. Поэтому решили начать с малого, а в дальнейшем масштабироваться по мере появления новых задач и ресурсов.
Все эти требования, и по нашему мнению, и по мнению привлеченных для анализа контрагентов, вполне закрывались решением на основе Kubernetes: OKD (как бесплатная замена OpenShift) в качестве оркестратора, KubeFlow + Jupyter как среда ModelOps. KubeFlow прекрасно интегрируется с системами версионирования кода, что позволит нам закрыть такие задачи, как ускоренный повторный запуск и Code Review. Кроме того, функционал Pipelines позволяет проводить множество параллельных экспериментов, не отвлекаясь на ожидание завершения расчетов. Интегрированный Katib также позволяет не ждать и заниматься подбором гиперпараметров моделей в параллели с основной работой. Jupyter — де-факто стандартная IDE при работе с машинным обучением, к тому же, поддерживающая расширение функционала через плагины и сниппеты.
ML платформа
Работа с Kubeflow предусматривает сопровождение полного жизненного цикла модели, от момента ее создания, переобучения, подбора гиперпараметров до вывода в промышленную эксплуатацию. Единый веб-интерфейс, простой запуск Jupyter ноутбуков с выделением ресурсов, пайплайны c визуализацией в веб интерфейсе, ролевая модель для многопользовательской работы. Микросервисная архитектура, на которой построен Kubeflow — это плюс к масштабируемости и отказоустойчивости. Заказчик хотел единую среду разработки и развертывания моделей, одновременно удобную для работы и обслуживания, Kubeflow отлично подходит под данные требования.
Kubeflow пригоден в облаках и on premise, для работы нужен только кластер Kubernetes или OpenShift. Как многие отличные решения, Kubeflow разрабатывали инженеры из команды Google первоначально для работы в GCP, но, как показала наша практика, работает платформа в Azure и AWS и на земле. Но сначала нужно ее установить.
Kubeflow Pipelines
Очень важный компонент платформы, ради этого функционала нам и пришлось пройти путь от OKD до Kubernetes и посмотреть все возможные варианты архитектуры.
Kubeflow Pipelines — это система для построения ML процессов в виде асинхронных графов задач (исполняемого кода). С первого взгляда может показаться, что это очередной аналог Aifrlow, однако, KP специализируется именно на ML задачах. Он позволяет максимально скрыть от DS разработчика инфраструктурные задачи и проблемы, при этом предоставляя ему доступ к k8s кластеру и его ресурсам из своего Jupyter ноутбука для запуска процессов моделирования.
Пайплайны позволяют выстроить процесс, в котором каждая задача исполняется на кластере, при этом сохраняя входные/выходные артефакты своей работы внутри Kubeflow. Все артефакты визуализируются и их можно просматривать через UI, что позволяет проводить эксперименты и сравнивать разные модели.
Каждая задача процесса — это некоторый Python код, обернутый в Kubeflow Component (декларативное описание задачи — входы, выходы, сохраняемые артефакты, параметры запуска), работающий в отдельном контейнере на кластере. Для создания такого компонента приходится немного спускаться в инфраструктуру и создавать образ контейнера, в котором будет работать код, спецификацию компонента (yaml с описанием параметров k8s) и, собственно, декорировать код в Kubeflow Component. Это может показаться достаточно сложным для обычного DS разработчика, но на деле все сводится к заполнению конфигурационного файла по шаблону и не требует глубоких познаний в k8s. А взамен мы получаем полностью переиспользуемые компоненты ML процесса, в которых нам не надо ничего настраивать, чтобы их запустить. Мы можем создать компонент «Подготовка и очистка данных», параметризировать его в части используемых данных и применять его во всех наших пайплайнах, импортировав и заполнив параметры.
Также, стоит упомянуть про базовые функции оркестратора процессов: запуск по расписанию, параметризация вызова, параллельные задачи, циклы из задач и тп.; все они реализованы в KP.
OKD vs. Kubernetes
В первоначальной архитектуре, как инструмент для оркестрации контейнеров, был заложен OKD 3.11. OKD — это опенсорсный аналог Openshift, функционал аналогичный, но нет издержек на подписку. Необходимы были специалисты с хорошим знанием Kubernetes, инфраструктурная часть в общей массе на Windows. У OKD в данных условиях ниже порог вхождения для обслуживающего персонала, всю систему можно обслуживать через веб-интерфейс. Плюс много полезных функций в OKD работают из коробки, Kubernetes коллег сильно настораживал.
Наш роудмап
По инфраструктурной составляющей
Благодаря заказчику у нас были очень комфортные условия, все, что было выше железа, можно было устанавливать и настраивать. На старте у нас было два железных сервера и задача установить на нем OKD 3.11 + Kubeflow. В промежуточной архитектуре сервера были переделаны в гипервизоры, а в итоговой архитектуре три гипервизора.
В поисках наилучшего решения мы прошли путь от OKD 3.11 до OKD 4.4, а потом вернулись к истокам и развернули Kubernetes. Ниже таблица релизов, в ней представлены описания тестовых и боевых стендов, а также причина, по которой конфигурация была отвергнута. Я виртуально разделил варианты архитектуры на релизы, в зависимости от кардинальной смены компонентов.
Опускаю описание фазы RND между релизами, чтобы не вылететь за рамки данной статьи. В нашем случае RND заключалось в изучении документации, форумов и всех возможных ресурсов, связанных с установкой Kubeflow, промежуточные инсталляции на стендах, перебор версий, перепиливание конфигурации и тесты, тесты, тесты. На архитектуру и размер боевых стендов также влияла готовность инфраструктуры заказчика, коллеги наращивали мощности, мы готовили полнофункциональное решение, постоянно шли друг другу навстречу.
Релиз 1.х
Мы стартанули с двух железных серверов, это были хосты с Oracle Linux, на них развернули OKD 3.11 и начали эксперименты со средой исполнения контейнеров, различные варианты хранилища для кластера NFS, Gluster, Ceph. Разные сборки и версии Kubeflow.
Здесь мы по очереди уперлись в ряд несовместимостей, то старая версию Kubernetes под капотом у OKD не работает с нужной версией Kubeflow, то среда исполнения контейнеров не работает со сборкой Agro в развернутой версии Kubeflow. Для Argo мы перебрали несколько вариантов Argo executor: docker, kubelet, kubernetes api, pns. Кроме траблшутинга мисматча версий и компонентов, мы опробовали и разные варианты хранилища для кластера. В условиях такой инсталляции победил NFS. В итоге, простая установка OKD на два хоста себя исчерпала, полный функционал с данным набором компонент реализовать не удалось, да и версия OKD 3.11 сильно устарела.
Релиз 2.х
После фазы RND, следующий релиз тестового стенда мы собрали в облаке AWS. Он получился удачным: кластер OKD 4.4 из шести машин, среда исполнения контейнеров CRi-O, модифицированная установка Kubeflow с изменением бэкенда запуска пайплайнов KFP-Tekton. Но и в этом релизе у нас были некоторые ограничения, мы были жестко завязаны на версиях компонентов.
На стенде у заказчика все также было два сервера, но OKD 4.x на два хоста невозможно, сервера было решено виртуализировать. Платформа для виртуализации в реалиях проекта была Hyper-V, нам предстояло настроить виртуальные машины и установить на них кластер OKD.
Установить OKD 4.x в облаке (AWS или Azure) — это просто и быстро, нужно всего лишь скачать пакеты для установки, внести данные аккаунта, доменное имя, ssh ключ, и в сгенерированном yaml файле прописать характеристики и количество мастер и воркер нод кластера.
Дальше установщик работает с api облака, сам качает нужный образ ОС, нарезает виртуальные машины, подкидывает им необходимые конфигурации, не нужно думать о балансировщике, настройке DNS и хранилище, все терраформирует инсталлятор. Через 20 минут получаем готовый кластер.
Я специально так подробно остановился на данном пункте — в реалиях UPI(User Provided Infrastructure) установки, bare-metal или на виртуальные машины часть этой коробочной автоматизации просто не работает.
Вернемся к боевому стенду, после виртуализации у нас в распоряжении были два хоста на Hyper-V, управляемые через веб интерфейс локального облака Azure. С такой платформой установщик OKD нативно работать отказался, необходимые технические пререквизиты для установки были выполнены руками.
Мы определили и создали необходимые записи DNS, нарезали все необходимые виртуальные машины, подготовили и загрузили образы Fedora CoreOS(далее FCOS), развернули Gluster на трех дополнительных узлах, подготовили балансировщик.
Далее механика развертывания кластера была следующая: запускаем установщик, генерируем yaml файл с шаблоном кластера, модифицируем его под наши нужды, генерируем на базе данного файла ignition конфиги для FCOS, закидываем их на веб сервер, запускаем виртуальные машины, прописываем что и откуда тянуть, Федора подхватывает конфигурацию, установка пошла.
Кратко пробегусь по трудностям, с которыми мы столкнулись на этом этапе
В данном сегменте сети не было dhcp сервера, свой мы развернуть не могли из-за политик безопасности. Для всех виртуальных машин с FCOS адреса и настройки пришлось прописывать руками, было несколько попыток установки и каждый раз много ручного вмешательства. Мы работаем в инфраструктуре банка, все сервера за прокси, все сетевые доступы необходимо согласовывать. В документации платформы описаны далеко не все адреса, которые необходимо добавить в вайтлист, некоторое время ушло на траблшутинг и новые согласования. Траблшутинг UPI установки тоже был с “сюрпризами”, логи установки OKD можно собрать только через инсталлятор, подключение на хосты через ssh в момент установки не даст ощутимой пользы, FCOS — минималистичный дистрибутив, набор доступных инструментов ограничен, система собрана для запуска контейнеров, сбор метрики для анализа был не очень удобный и прозрачный. Для установки OKD нужной версии необходима FCOS определенной версии с двумя наборами образов, один для загрузки самой ос, другой для установки с конфигурацией, которую система берет по сети. OKD определенной версии использует под капотом определенную версию Kubernetes и определенную версию среды запуска контейнеров, что важно для запуска пайплайнов KFP-tekton в модифицированной под работу в OKD версии Kubeflow. Шаг влево, шаг вправо и ничего не работает.
Несмотря на то, что все технические условия были соблюдены и тестовый стенд успешно работал, на земле кластер не собрался: анализ логов показал, что часть образов очень долго скачиваются и еще часть не может стартовать, установщик уходит в таймаут, и попытка установки повторяется по кругу. Коллеги проблем с сетью не диагностировали, мы провели несколько попыток с различными настройками, итог был один, инициализация мастер узлов не проходит, кластер не взлетает.
В бэклоге еще куча работы, накопились задачи, которые необходимо проверять на боевом кластере: интеграции с внешними системами, подготовка образов Jupyter, проброс GPU, много мелких настроек. Кластер не готов, причину установить не удается.
Итог: Сроки горят, заказчик расстроен, команда демотивирована. На RND и долгие тесты времени нет, решение нужно вчера.
Релиз 3.0
Все рано или поздно возвращаются домой. Виртуальные машины на Ubuntu Server 20.04, система оркестрации контейнеров Kubernetes 1.19, среда исполнения контейнеров Docker. Коллеги для удобства обслуживания просили удобный интерфейс, в качестве UI мы использовали Rancher 2.5. Платформа для ML — Kubeflow версии 1.2.0. В кластере был развернут Nexus и классический стек для мониторинга Prometheus, Grafana, Alertmanager. Затем настроены интеграции внешними системами и источниками данных. Gluster был уже настроен со времен прошлого захода.
В данном релизе весь функционал заработал из коробки. Kubernetes кластер мы развернули с помощью известного инструмента Kubespray, немного его доработав под нашу установку. В кластере есть виртуальные машины с GPU, нам пригодился кластер оператор, воспользовались наработками коллег из Nvidia, необходимые ansible роли для установки драйверов и NVIDIA GPU Operator мы взяли из проекта DeepOps и официальной документации.
Были некоторые проблемы с пробросом GPU, по большей части, со стороны Hyper-V, все успешно решилось на стороне обслуживающей команды.
Все проходило нормально, мы спешили разобрать бэклог, начали активно работать с подготовкой контейнеров. При операциях с большими образами Jupyter, а у нас есть сборки с Cuda и они достигают 16Гб, явно начало проседать быстродействие кластера, ноутбуки спаунились очень долго, PV в Glaster отрастали по 3-5 минут. Мы грешили на сеть, развернули Nexus в кластере, но проблема не решилась.
Это был рейд, точнее Storage Pool. При настройке гипервизора не самые быстрые 10-терабайтные жесткие диски объединили в storage pool получив показатели по емкости, но не по скорости чтения записи. Виртуальные машины с мастер нодами с самого начала находились на ssd — это было одно из требований на старте проекта, которое немного сбило нас с толку, кластер местами работал нормально, местами не очень. Разбирать кто и почему так сделал времени уже не было, потратив некоторое время на перенос виртуальных машин с гипервизора на гипервизор и пересборку дисков в Raid 10 мы получили нормальную производительность.
Как переехать на Kubeflow в качестве ML-платформы?
В статье рассказываем о том, как перейти на Kubeflow в качестве ML-платформы. По мотивам доклада компании Mediascope.
Эта инструкция — часть курса «Выстраиваем работу с ML».
Смотреть весь курс
В этом материале мы поделимся докладом Сергея Савватеева о переходе сервиса Mediascope на Kubeflow, который он подготовил к ML MeetUp.
Поговорим о роли команды в компании, как был устроен процесс разработки до перехода на Kubeflow. Разберем подробно сам переход, какие архитектурные решения принимались. С какими сложностями столкнулись и какие наметили шаги.
Если вам интересна тема статьи, присоединяйтесь к нашему сообществу «MLечный путь» в Telegram. Там мы вместе обсуждаем проблемы и лучшие практики организации production ML-сервисов, а также делимся собственным опытом. А еще там раз в неделю выходят дайджесты по DataOps и MLOps.
О компании
Mediascope занимается измерением аудитории различных медиа, мониторингом рекламы и исследованиями потребительских предпочтений, то есть опросами.
Что такое измерение аудитории? Например, это нужно для мобильных приложений или для сайтов, сколько человек ими пользуется, как эти люди распределяются по полу, по возрасту, по географической принадлежности, по доходу, семейному положению и так далее.
Исторически компания выросла из измерения аудитории TV. На текущий момент рейтинги Mediascope являются валютой рынка, по которой определяется стоимость рекламы. Затем измерения распространились на другие медиа. Сейчас самым динамично развивающимися каналами являются интернет и мобайл. Мы получаем данные от устройств наших панелистов, от интернет-счетчиков, от внешних компаний-партнеров и многих других источников. Все это многообразие потоков данных обрабатывается нашей big data платформой на основе Hadoop, в которой есть разные слои хранения данных.
Данные поступают из источников в разных форматах и как есть попадают во входной слой. Затем они обогащаются внутренними справочниками и раскладываются в корпоративную модель данных.
На ее основе уже строятся общие или специальные витрины данных. Далее происходит поставка данных клиентам в виде API, дашбордов или готовых датасетов. Конвейеры производства данных оркестрируются с помощью Airflow. Иногда на разных этапах возникает необходимость каких-то вероятностных методов обогащения или фильтрации данных, или, например, интеграции различных источников данных на основе статистических моделей. Именно в этих точках вызываются наши сервисы.
Специфика задач и немного рекурсии
Основа измерений компании — это панели. Панель — это случайная выборка из генеральной совокупности. Что такое генеральная совокупность? Например, для мобильной панели — это множество жителей России от 12 лет и старше, которые пользуются мобильным интернетом. Для того, чтобы панель хорошо репрезентировала генеральную совокупность, каждому панелисту назначается вес. Вес — это то, сколько людей в генеральной совокупности он собой репрезентирует.
В генеральной совокупности нам для различных социально-демографических переменных известно распределение количества людей по их значениям. Например, мы знаем долю людей с высшим образованием или, если это касается пола/возраста, то мы знаем долю в генеральной совокупности женщин от 25 до 34 лет. Эти доли являются целями для процедуры взвешивания.
Процедура взвешивания расставляет веса таким образом, что они сходятся на все цели по всем значениям всех социально-демографических переменных, которые в этой процедуре участвуют. Процедура проводится один раз в сутки. Во многом из-за этого большое количество процессов обработки данных происходит за последние сутки, то есть это такая batch-обработка.
Важно, что после того, как данные поставлены клиентам, они не должны изменяться. ML-модели должны быть так устроены, что если их запустят ровно на тех же данных, то они должны воспроизводить тот же результат на выходе.
Создавайте и используйте кластеры Managed Kubernetes
Вы можете добавить к ним графические процессоры — для этого выберите фиксированную конфигурацию ноды с GPU.
Как был устроен ML-сервис
Для каждого сервиса использовался свой git-репозиторий. Там был Dockerfile с необходимыми библиотеками и тегированные версии образов. Также был скрипт, который по соглашениям внутри команды назывался runner.py. Он отвечал за всю логику работы сервиса от начала до конца: за обработку входного задания, подгрузку данных, обучение или подтягивание готовой модели, за сохранение результатов и отправку метрик качества.
Для этого пришлось «изобрести велосипед». Речь идет про обертку, которая позволяет асинхронно запускать расчеты по REST API. Airflow отправляет POST-запрос с JSON-заданием на обработку, получает в ответ id запуска и по нему может отслеживать статус выполнения задачи.
Все это происходит в docker-контейнере. Метрики качества моделей попадают на дашборды с настроенными порогами. Если метрики выходят за границу допустимых порогов, происходит оповещение. Команда эксплуатации следит за работоспособностью конвейеров данных и может по этим дашбордам отслеживать качество производимых данных.
Есть еще внутренние дашборды на Kibana, они побогаче. Помимо графиков, отображается информация про каждый запуск сервиса: когда стартовал, когда завершил работу, с каким статусом, какая версия кода крутится на проде и пр. Логи из Elasticsearch также подтягиваются на эти дашборды.
Хочется также отметить возможность разработки в удаленных контейнерах Visual Studio Code. Контейнер поднимается в удаленной среде на сервере в условиях, максимально приближенных к проду. Так мы можем быстрее релизить наработки на прод без каких-либо изменений. Роль Visual Studio Code в том, что он делает удаленную разработку максимально эффективной.
Если разработка ведется на основе тестов, то как только появляется функция теста, с префиксом test_, Visual Studio Code ее обнаруживает и прямо над ней появляются кнопки отладки или запуска, что достаточно удобно. Как дополнительная и очень полезная опция: можно взять json-задание для сервиса с production. Затем подгрузить его и по шагам отлаживаться и разбираться, что произошло, если возникла проблема или просто хочется посмотреть, что происходило внутри сервиса.
Как устроен процесс релиза
Data scientist или ML-инженер ведет разработку в удаленном контейнере, коммитит свои изменения в GitLab. Мы используем GitLab CI. Когда он ставит тег на версию, запускается пайплайн CI, собирается образ и прогоняются тесты. В случае успешного прохождения пайплайна, появляется кнопка «Deploy to prod». По этой кнопке контейнер со свежим образом, соответствующим новому тегу, запускается в Kubernetes. У сервиса есть фиксированный адрес, который знает Airflow, и туда он отправляет задания для запуска расчетов.
Промежуточный итог
Первый момент. Сервис представляет собой монолит, в котором внутри может быть свой пайплайн из десятка шагов, несколько ML-моделей, с отсутствием observability. Снаружи это похоже на черный ящик: если ML-сервис упал, то только его разработчик может разобраться в причинах.
Сервер, который отвечает на запросы, также запускает и расчеты. Все это происходит в одном контейнере. То есть нарушается идеология «один контейнер — один процесс». Если процесс с логикой был завершен OOM-killer’ом, то очень сложно отловить такую проблему снаружи.
Второй момент. Чтобы не нарушить работу больших конвейеров Airflow, релизы нужно было проводить строго в определенное время. Так происходило потому, что за фиксированным URL сервиса всегда стоит какая-то одна конкретная версия кода, соответствующая тегу образа. Это немного затрудняло процесс релиза новых версий в прод.
Переход на Kubeflow
На этот момент Kubernetes в компании уже был развернут. Оставалось найти подходящее решение. Тогда в поле зрения попал Kubeflow.
Kubeflow инструмент не новый, про него достаточно сказано, поэтому я остановлюсь на двух моментах, которые имеют отношение непосредственно к нам.
Во-первых, это удобная среда для проведения экспериментов. Можно открыть соответствующую вкладку в UI, выбрать параметры: сколько CPU, сколько памяти, какой volume к нему примонтировать, какие дополнительные параметры указать. После этого нажать кнопку и запустится персональный jupyter-ноутбук дата-саентиста с ограничением по ресурсам.
У нас в компании есть RnD-команда, которая разрабатывает методологию решения задач интеграции различных панелей, и они предпочитают работать в R. Они, например, могут использовать ноутбуки с RStudio. Из коробки там также есть VSCode Online и возможность запуска каких-то кастомных образов. Это удобно, потому что так к jupyter-ноутбуку и VSCode Online можно добавить какие-то свои внутренние библиотеки. Просто указываем адрес образа в Artifactory, и ноутбук запускается сразу с нужными библиотеками.
Во-вторых, Kubeflow — это движок для запуска ML-пайплайнов, UI для управления ими и отслеживания статусов эксперимента. Каждый шаг пайплайна — отдельный под. Они независимы и никак не связаны друг с другом, только передают друг другу данные. Выходы одних шагов подаются на вход других.
Kubernetes развернут поверх облака, поэтому есть возможность легко масштабировать ресурсы. При необходимости можно подключать GPU к подам, если нужно что-то запустить на GPU.
Как это все это устроено архитектурно
Есть dev-среда, в который развернут Kubeflow для экспериментов. Здесь также, как и раньше, используется GitLab CI, но есть разница. Помимо образов в Artifactory улетают еще и сами пайплайны. Дальше в production-среде эти пайплайны попадают в Argo, и Airflow запускает Argo-workflow. Получается, что одновременно могут работать несколько версий, то есть в Argo находятся несколько версий пайплайна.
Как изменился процесс релиза
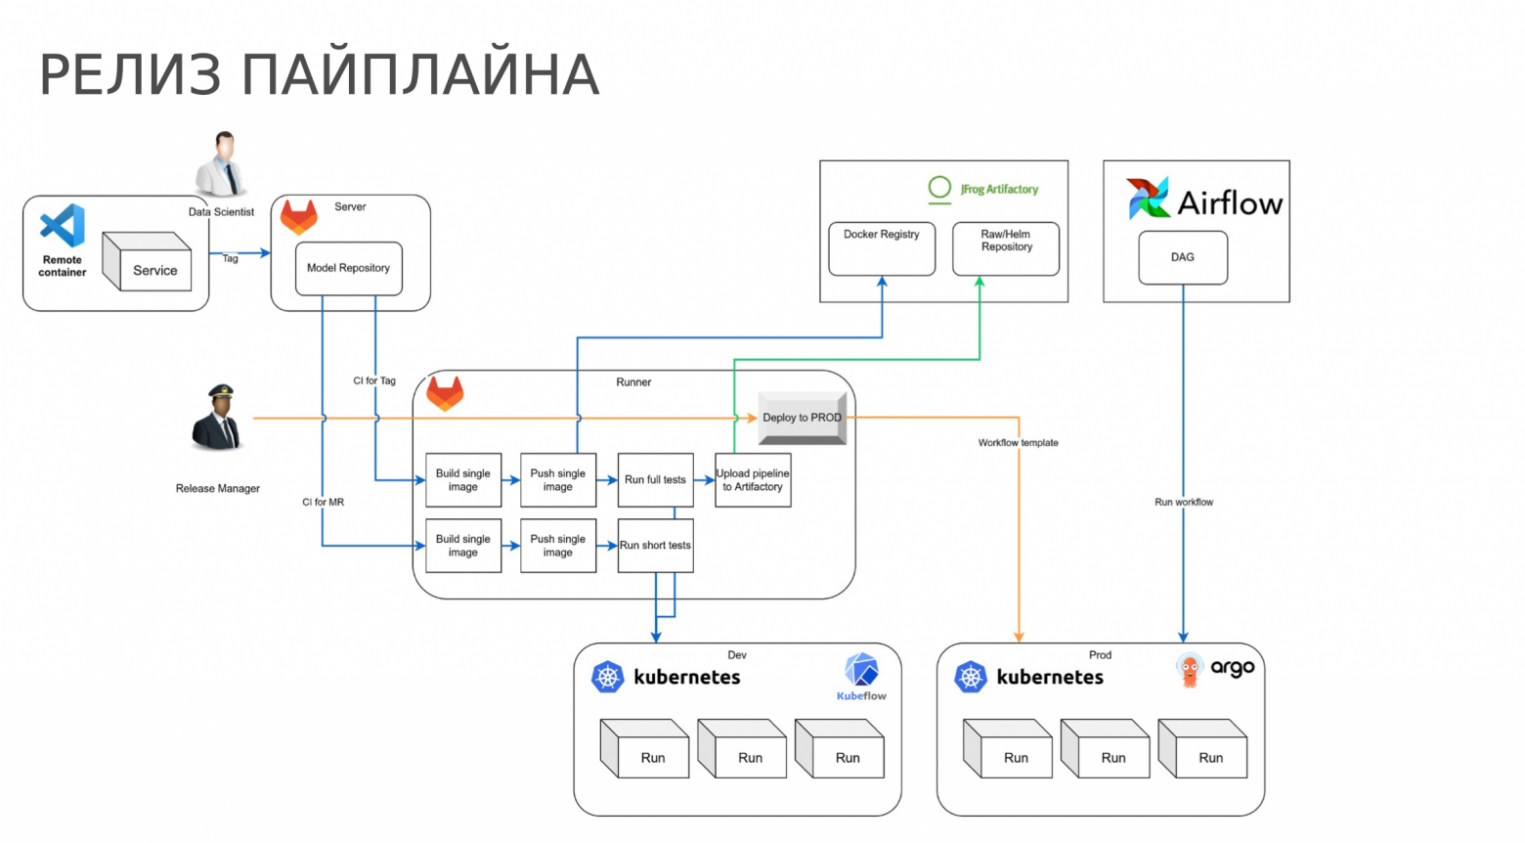
Сначала появилась вторая ветка CI для merge-requests. Когда создается merge request в master-ветку, то прогоняются короткие тесты, чтобы убедиться, что мы ничего не сломали. Если проставить тег, то происходит прогон полных тестов, весь пайплайн тестируется целиком. В случае успеха пайплайн в виде yaml-файла улетает в Artifactory. Также используется кнопка «Deploy to prod», но теперь при нажатии она скачивает соответствующий yaml-пайплайн из Artifactory и отправляет его в production Argo.
Airflow дальше может запускать версию, для которой состоялся релиз.
Преимущество такого подхода
Раньше ML-инженер отвечал за ручной релиз. То есть в релизное окно, чаще всего вечером, появлялась новая версия сервиса, и в целях проверки воспроизводимости больших конвейеров запускались тесты на них. Если что-то пошло не так, то ML-инженер должен был нажать на кнопку Deploy to prod предыдущей версии и таким образом все откатить.
Сейчас в Argo одновременно находятся несколько версий пайплайнов. Если что-то идет не по плану, есть возможность самостоятельного переключения на предыдущую версию со стороны эксплуатации без привлечения ML-инженеров.
Как устроены пайплайны
Получается, пайплайн — это последовательность логических шагов. В Kubeflow шаги создаются из компонентов.
Есть два способа создания компонентов:
- Создание прямо из python-функции, при этом она заворачивается в компонент Kubeflow.
- Создание из yaml-спецификации — вариант, который мы рассмотрим далее.
Как это было устроено? Был питоновский скрипт с командным интерфейсом, для которого вручную создавался yaml-файл. В нем указывался образ, какой модуль вызвать и какие входные и выходные параметры передать модулю. В Kubeflow параметры типизированы и типы InputPath и OutputPath имеют специальное значение.
Если мы указываем тип параметра OutputPath, то Kubeflow сам берет артефакт по указанному пути и сохраняет его в S3. Когда артефакт нужен другому шагу (указывается в качестве InputPath), он автоматически подгружает его из S3 и монтирует в под по определенному пути. Далее эти пути передаются как аргументы на вход скрипта, и скрипт может загрузить данные. То есть в этом случае обмен данными между шагами Kubeflow берет на себя.
Таким образом, все компоненты создавались из yaml-файлов. Далее из них как можно быстрее собирался работающий пайплайн с простой baseline-моделью внутри, чтобы там считались метрики. После этого уже усложняли модель и растили метрики. Пожалуй, сейчас это стандартный подход для всех.
Как выглядит теперь фрагмент реального пайплайна?
Сначала из yaml-файлов загружаются компоненты. Далее компоненты вызываются, на вход им передаются аргументы, и они превращаются уже в шаги. На вход шагам могут передаваться выходы других шагов.
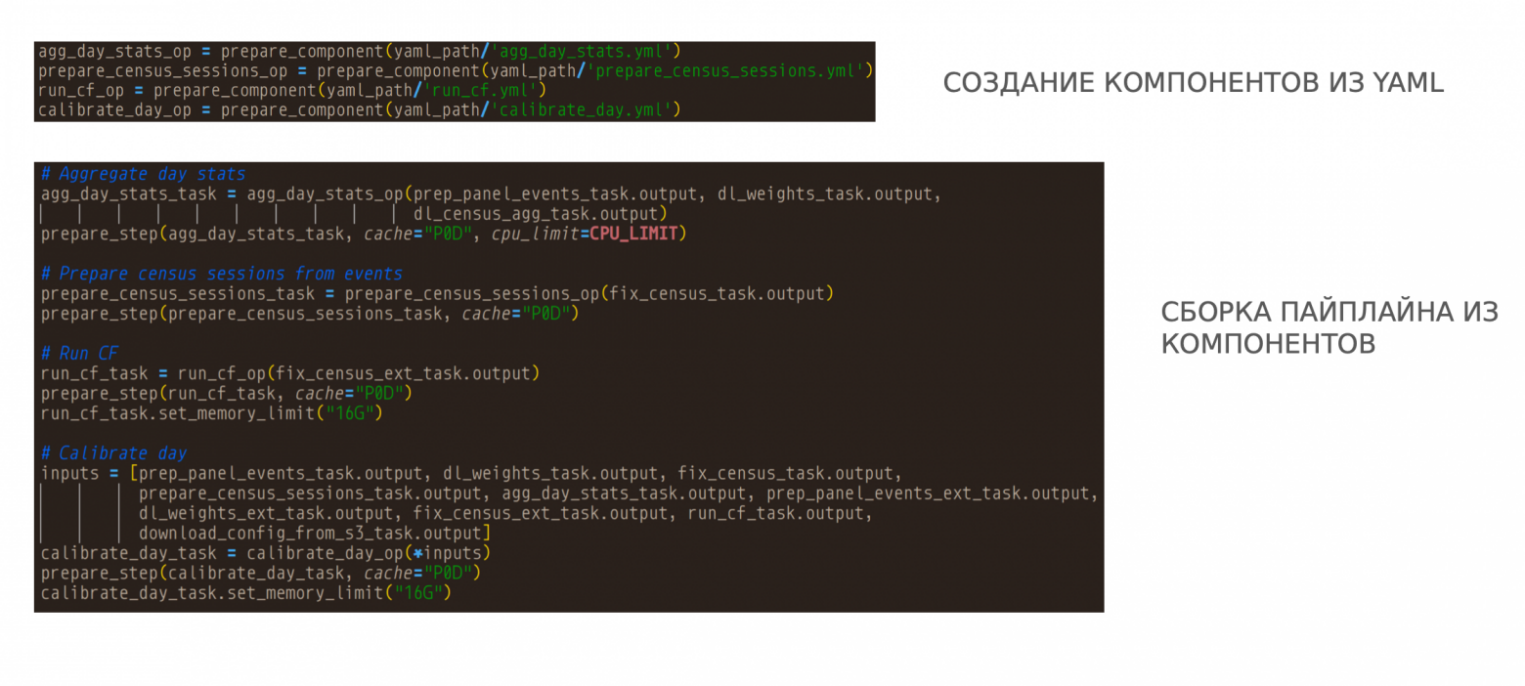
На основе этих зависимостей Kubeflow неявно понимает, как связать эти шаги в DAG. Если мы хотим поменять последовательность шагов, мы можем явно это указать. Для этого у шага есть атрибут .after.
Некоторым шагам может понадобиться сходить в HDFS за данными, для этого им нужно примонтировать соответствующие секреты. Или, например, может понадобиться указать режим кэширования или выставить лимиты по CPU и по памяти. Когда это делается прямо в коде пайплайна, он получается громоздким — создали шаг, а далее указываем множество модификаций, большая часть из которых достаточно типовые.
Что дало такое разделение, когда у нас шаги пайплайна в отдельных модулях?
Во-первых, так получается более правильный ход с точки зрения архитектуры. Каждый шаг реализует какую-то свою логическую задачу. В результате получается, что и сам пайплайн выглядит более наглядно. Если новый человек видит пайплайн, он сразу понимает, что там происходит, потому что логически все шаги отделены, и видно, как они выстроены.
Во-вторых, так можно параллелить разработку. Можно давать нескольким дата-саентистам в разработку разные параллельные компоненты. Также благодаря этому удобно покрывать компонент тестами и отлаживать компоненты по отдельности.
Первые впечатления от работы с Kubeflow
Самый первый вопрос — это как к вычислениям подтянуть данные? Самый простой способ — примонтировать туда persistent volume. Это по сути получается единая обменная папка для всех шагов. С точки зрения скорости работы, решение на первый взгляд выглядит как оптимальное. Как только шаг поднимается в виде пода, к нему сразу примонтированы данные для вычислений, и начинается работа.
При этом на практике наблюдались разные side-эффекты. Например, если CPU-шаги используют persistent volume, то они работают параллельно. Если для тех же шагов запросить использование GPU, то они работают строго последовательно, ждут друг друга, и параллельная обработка фактически не функционирует.
Также шаги, которые используют persistent volume, могут по неизвестной причине очень долго инициализироваться.
Это все, безусловно, можно решать на уровне инфраструктуры, но главный минус в том, что логика обработки получается опять непрозрачная. Почему так?
Есть большой пайплайн, в котором определенные шаги пишут данные в том, какие-то — читают из него. Нет ясности, что нужно для работы конкретным шагам.
Из минусов перехода
- После перехода на Kubeflow порог вхождения нового DS в проект не стал ниже.
- Между шагами постоянно происходит выгрузка данных на S3 и загрузка обратно. Казалось, это должно увеличивать время работы, но поскольку компоненты достаточно крупные, то этого overhead практически не заметно.
- Иногда нужно подключиться к поду для отладки, чтобы понять, что происходит внутри. Возможность такая есть, но пользоваться этим не очень удобно.
Как дорабатывали решение
Поработав с этим, у коллег появились идеи, как решить часть проблем. Конечно же, появился свой велосипед — обертка над Kubeflow. Что получилось в результате — при разработке и отладке пайплайна он выглядит как обычный скрипт на питоне.
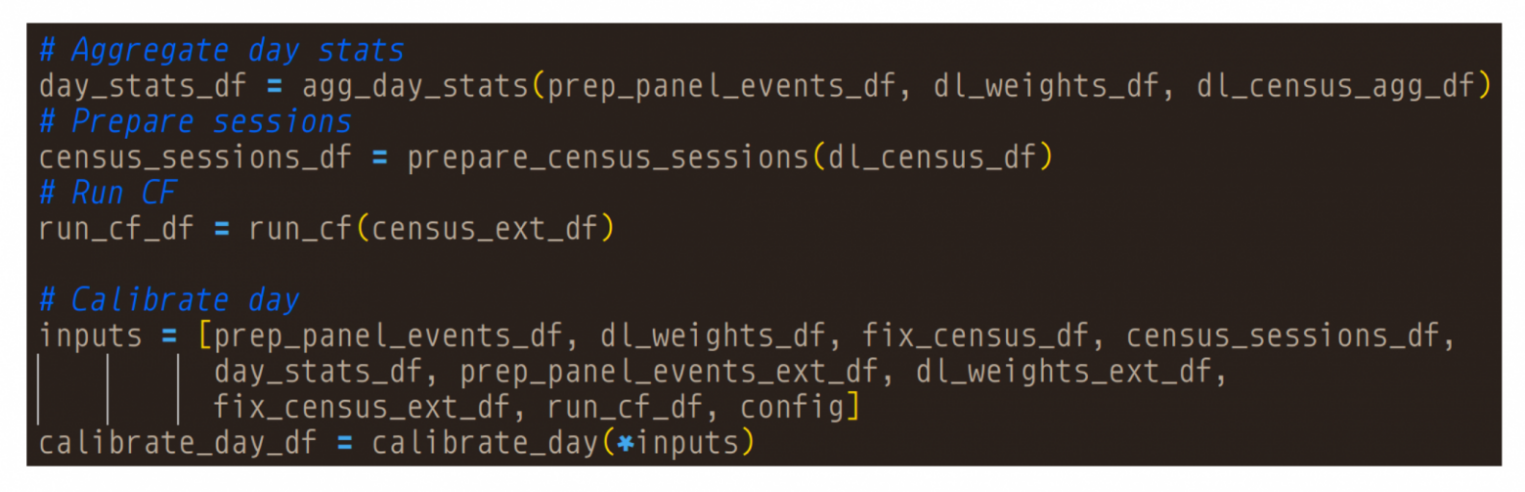
Как видно на иллюстрации, есть функции, которые принимают на вход pandas DataFrame и возвращают DataFrame. Все также есть возможность работать с Visual Studio Code в удаленном контейнере и отлаживать код локально.
В зависимости от настроек среды пайплайн может запускаться локально (в удаленном контейнере) или компилироваться в пайплайн Kubeflow, и это абсолютно прозрачно для пользователей.
За счет чего это достигается? Большая часть логики по монтированию секретов, настройке кэширования и т.д. была перенесена в специальный декоратор kubeflow_step. За счет аннотаций входов и выходов, при локальном запуске автоматически определяется — как сохранять результаты работы и как загружать входные аргументы в оперативную память. Для этого в нашей библиотеке kfrun появились свои кастомные типы. Это могут быть не только pandas DataFrame, а обученные модели, словари и другие объекты.
Если режим работы — компиляция в Kubeflow-пайплайн, то функция шага не запускается, а компилируется в yaml. Если раньше yaml составлялся вручную, то сейчас он создается автоматически.
Во-первых, это избавляет от лишней ручной работы. Во-вторых, при ручном создании yaml возникали ошибки, которые трудно обнаружить, а здесь все происходит автоматом по заданной спецификации функции.
Кейс на каждый день
Недавно возникла задача объединения нескольких источников данных. Нужно было объединить просмотр телевизора в TV-панели с просмотром того же телеэфира, но в интернете, когда смотрят телевизор с мобильных или десктопных устройств. Панели имеют некоторое пересечение, но все-таки разные. Если бы это была одна панель, никаких проблем бы не было. Мы просто сложили бы веса всех уникальных панелистов и получили бы оценку охвата аудитории. Но здесь получается сложный пайплайн и несколько точек, где можно выбрать различные опции. Например, как отбирать активных? У нас есть TV-панель и нужно выбрать определенное количество активных панелистов, которым мы перенесем эту активность, потому что активны не все каждый день, а лишь небольшой процент. Здесь своя опция для модели.
Как переносить активность? Нужно не просто перенести, а сохраняя исходное распределение социально-демографических переменных. Тут есть свои опции, как переносить. И это не разовая операция, а конвейер, который работает день за днем. И здесь нужно учитывать историю предыдущих переносов, чтобы наши данные оставались консистентными на длительном периоде.
Сначала мы собрали пайплайн с baseline-моделью в каждой точке, а затем над задачей в параллель работало четыре дата-саентиста. Каждый из них в своей точке улучшал модель, глядя на финальные метрики. Каждому удалось улучшить — кому-то больше, кому-то меньше, но когда мы все эти улучшения собрали в итоговом пайплайне, то получили дополнительный прирост метрик.
Получился достаточно обширный пайплайн, который работает около получаса. Стоит отметить, что Kubeflow не подводит в этом месте и позволяет запускать сложные пайплайны без проблем.
Какими будут следующие шаги
Новая обертка существенно упростила разработку, но нам все еще есть куда развиваться.
- Сами авторы Kubeflow продвигают концепцию reusable components, чтобы компоненты были переиспользованы в разных пайплайнах. Пока эта концепция у нас широкого распространения не получила.
- Если мы хотим оптимизировать потребление ресурсов в облаке, то нам надо ставить лимиты для шагов по процессу и/или по памяти. Сейчас это происходит так, что все шаги по умолчанию занимают минимум ресурсов. Каким-то отдельным шагам, которые делают сложные вычисления, мы вручную наращиваем лимиты. Это не очень удобно делать руками, поэтому хотелось бы наладить процесс автоматизации.
- Мы хотим продолжать работать над тем, чтобы это был максимально удобный инструмент для разработки ML-пайплайнов.
Платформы обработки данных: какие бывают и всем ли нужны