Как убрать символ новой строки (\n) при чтении строк из файла
стоит заметить, что .rstrip() также удаляет любой пробел в конце строки, а не только символы новой строки как .rstrip(‘\n’) (это может и быть желаемым поведением).
30 апр 2017 в 20:22
Если хочется поддерживать и Юникодные окончания строк, то можно str.splitlines() метод использовать:
>>> file.read().splitlines() ['12', '10', '9', '15', '10', '120'] Отслеживать
ответ дан 30 апр 2017 в 20:20
52.2k 11 11 золотых знаков 108 108 серебряных знаков 311 311 бронзовых знаков
file = "file.txt" open(file).read().split('\n') Отслеживать
ответ дан 30 ноя 2016 в 19:13
vadim vaduxa vadim vaduxa
8,932 14 14 серебряных знаков 24 24 бронзовых знака
-
Важное на Мете
Связанные
Похожие
Подписаться на ленту
Лента вопроса
Для подписки на ленту скопируйте и вставьте эту ссылку в вашу программу для чтения RSS.
Дизайн сайта / логотип © 2023 Stack Exchange Inc; пользовательские материалы лицензированы в соответствии с CC BY-SA . rev 2023.10.27.43697
Нажимая «Принять все файлы cookie» вы соглашаетесь, что Stack Exchange может хранить файлы cookie на вашем устройстве и раскрывать информацию в соответствии с нашей Политикой в отношении файлов cookie.
Удаление переноса строки при чтении из файла
Я считываю строчку с помощью readlines
При выводе на кран он выдает строчку + перенос строки
Как убрать это?
Лучшие ответы ( 1 )
94731 / 64177 / 26122
Регистрация: 12.04.2006
Сообщений: 116,782
Ответы с готовыми решениями:
Удаление переноса строки в конце файла
Доброго времени суток. Создаю файл стримрайтером записываю только одну строку — файл создается но.
Не переносятся строки при чтении файла
Всем привет. Сразу к делу. Создаю программно edit, затем зная путь к файлу, считываю данные и.

Перевод строки при чтении из файла
Всем привет в LinkLabel берется текст из файла, но у него есть ограничение по ширине, при котором.
Пропуск строки при чтении из файла
Здравствуйте! Подскажите пожалуйста, существует ли какая-нибудь функция, позволяющая пропустить.
При чтении из файла появляются фантомные строки
Добрый вечер. При использовании BufferedReader с аргументом виду FileReader каждое второе чтение.
Регистрация: 21.01.2016
Сообщений: 10
если я не ошибаюсь, то один из модераторов, предлагал такой вариант.
f.readlines() — читает линии в список. Если у Вас 1 строка то достаточно f.readline().strip()(чтоб убрать перевод строки)
1 2 3 4 5 6 7 8 9 10 11 12 13
# -*- coding: UTF-8 -*- File = 'Путь к файлу .txt' f = open(File, 'r') #открываем файл, путь к которому указываю выше name = f.readlines() #читаю строку и присваиваю ее к name f.close() #В вашем случае будет f = open(File, 'r') #открываем файл, путь к которому указываю выше name = f.readline().strip()#читаю строку и присваиваю ее к name f.close()
Как удалить \n\r из документа?

С помощью Python закидываю данные в текстовый документ, предварительно отформатировав его.
Получается такой текст:
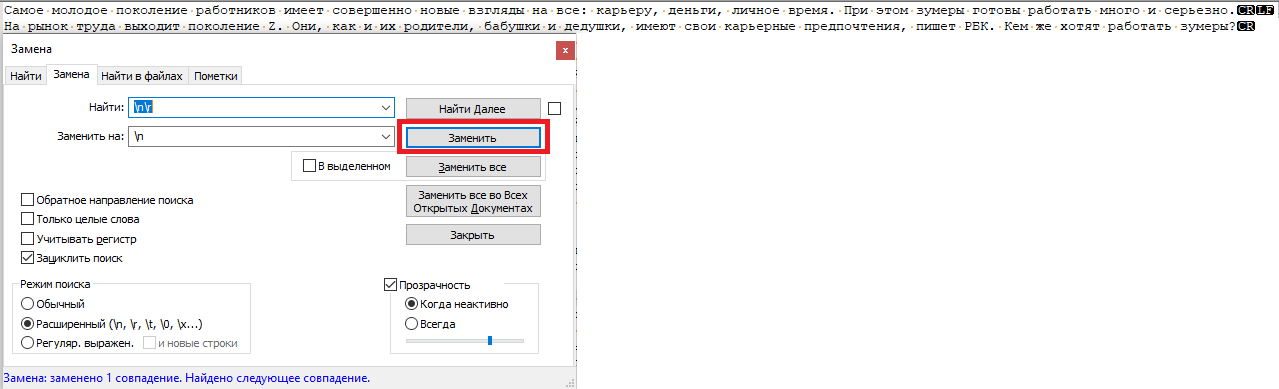
Хочу убрать \n\r оставив просто \n, заменяю таким образом, в Notepad++ все работает норм:
Но когда пытаюсь исправить текст в Python до записи в документ, ничего не происходит. Пробовал таких два варианта:
articleContent = articleContent.replace('\n\r', '\n') #или это articleContent = articleContent.replace('\n\r', '')
P.S. Может быть это как-то связано с самим Notepad? Т.к. при копирование этих строк в другое место, он делает некоторые изменения:
- Вопрос задан более трёх лет назад
- 790 просмотров
Python: удалить переносы строк и лишние пробелы из строки?
Всем привет. Подскажите плз, как решить задачу с минимальным изобретанием велосипедов. Нужно очистить строку от символов переноса (заменить на пробелы) и убрать лишние пробелы и пустые строки.
Сейчас это делается вот так:
‘ ‘.join(filter(None, map(unicode.strip, input_string.splitlines())))
Может есть более стандартный способ?
Попытки привлечь либу textwrap приводят только к раздутию кода… Может, я не умею ее готовить?
- Вопрос задан более трёх лет назад
- 94394 просмотра
Комментировать
Решения вопроса 1
Регуляркой:
import re
mystr = » balabla\n zzz »
re.sub(«^\s+|\n|\r|\s+$», », mystr)
В этом примере удаляем пробелы в начале и конце строки и символы переноса строки. Отредактируйте под свои нужды.
Ответ написан более трёх лет назад
Нравится 9 3 комментария
Fak3 @Fak3 Автор вопроса
Спасибо за наводку!
Задача решается так:
re.sub(«\s*\n\s*», ‘ ‘, s.strip())
re.sub(«\s+», » «, s)
все норм, только вот так:
import re
mystr = » balabla\n zzz »
mystr = re.sub(«^\s+|\n|\r|\s+$», », mystr)
PS Спасибо за способ, помогло
Ответы на вопрос 4
' '.join(s.split())не подойдёт?
Ответ написан более трёх лет назад
Нравится 5 1 комментарий
Правда при этом не только переносы и пробелы будут обработаны, но вообще все пробельные символы (табы например). Но в обычных юзкейсах это именно то что нужно.
php программист
Регулярка \s+ отличный способ =)
Ответ написан более трёх лет назад
Нравится 1 3 комментария
Fak3 @Fak3 Автор вопроса
Что-то мне фантазии не хватает, как это регуляркой решить. Поподробней можно?
Рустам Сафин @snegovikufa
Подозреваю через re.match (вроде?) создаешь список кандидатов на замену, а затем применяешь your_string.replace(what_from, what_to)
Fak3 @Fak3 Автор вопроса
А как регуляркой найти список кандидатов на замену?
__author__ = 'dikkini@gmail.com' from itertools import groupby def lines_filter(iterable): """ input: any iterable output: generator or list """ wait_chr = False is_begin = True #======================================================================================================== # You can delete "groupby" and the result will not change, but will increase the length of the input list. #======================================================================================================== for item, i in groupby(iterable): if item: is_begin = False if wait_chr: wait_chr = False yield '' yield item elif not is_begin and not wait_chr: wait_chr = True if __name__ == '__main__': list1 =['','','','i','hgf', '','','','9876','','','7','','9','','',''] # Input list print [i for i in lines_filter(list1)] # Output to the list Ответ написан более трёх лет назад
Комментировать
Нравится Комментировать
string.rstrip()
или
string = string.replace(«\n»,»»)
Ответ написан более трёх лет назад
Комментировать
Нравится Комментировать
Ваш ответ на вопрос
Войдите, чтобы написать ответ

- Python
Как получить url страницы и какие есть способы изменять html код через python?
- 2 подписчика
- 4 часа назад
- 63 просмотра