Грокаем DLR
Это скорее вольный пересказ, а не перевод. Я включил в эту статью только те части оригинала, которые имеют непосредственное отношение к внутренним механизмам работы DLR или объясняют важные идеи. Примечания будут заключены в квадратные скобки
Многие .NET разработчики слышали про Dynamic Language Runtime (DLR), но почти ничего о нем не знают. Разработчики, пишущие на языках типа C# или Visual Basic, избегают языков с динамической типизацией из-за боязни исторически связанных с ними проблем с масштабируемостью. Также их беспокоит тот факт, что языки типа Python или Ruby не выполняют проверку типов во время компиляции, что может привести к сложным для поиска и исправления ошибкам в рантайме. Это обоснованные опасения, которые могут объяснить, почему DLR не пользуется популярностью среди основной массы .NET разработчиков даже спустя два года после официального релиза [статья довольно старая, но с тех пор ничего не изменилось]. В конце концов, любой .NET Runtime, содержащий в себе слова Dynamic и Language в своем названии, должен предназначаться строго для поддержки таких языков, как Python, правильно?
Притормозите. В то время как DLR действительно была задумана для поддержки «Iron» реализации Python и Ruby в .NET Framework, её архитектура предоставляет гораздо более глубокие абстракции.
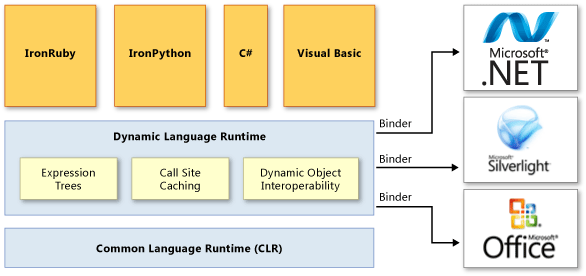
Под капотом, DLR предлагает богатый набор интерфейсов для выполнения межпроцессного взаимодействия [Inter-Process Communication (IPC)]. За все эти годы, разработчики видели множество инструментов от Microsoft для взаимодействия между приложениями: DDE, DCOM, ActiveX, .Net Remoting, WCF, OData. Этот список может продолжаться ещё долго. Это практически бесконечный парад акронимов, каждый из которых представляет технологию, обещающую, что в этом году обмениваться данными или вызывать удаленный код будет ещё проще, чем раньше.
Язык языков
Когда я в первый раз слушал выступление Джима Хьюгенина [Jim Hugunin] про DLR, его речь удивила меня. Джим создал реализацию Python под Java Virtual Machine (JVM), известную как Jython. Незадолго до выступления, он присоединился к Microsoft для создания IronPython для .NET. Основываясь на его бэкграунде, я ожидал, что он сфокусируется на языке, но вместо этого Джим почти все время говорил про заумные вещи типа деревьев выражений [expression trees], динамическую диспетчеризацию [dynamic call dispatch] и механизмы кэширования вызовов. Джим описывал набор работающих в рантайме сервисов компиляции, которые позволяли любым двум языкам взаимодействовать друг с другом практически без потерь в производительности.
Во время этой речи я записал термин, который всплыл в моей голове, когда я услышал как Джим пересказывает архитектуру DLR: «язык языков» [the language of languages]. Спустя четыре года, эта кличка по прежнему очень точно характеризует DLR. Однако, приобретя реальный опыт использования, я понял, что DLR это не просто про совместимость языков. Благодаря поддержке динамических типов в C# и Visual Basic, DLR можете выступать в роли шлюза из наших любимых .NET языков к данным и коду в любой удаленной системе, вне зависимости от того, какой тип оборудования или программного обеспечения последняя использует.

Чтобы понять идею, которая лежит в основе DLR, представляющую собой интегрированный в язык IPC механизм, давайте начнем с примера, не имеющего ничего общего с динамическим программированием. Представьте две компьютерные системы: одна называется инициатором, а вторая — целевой системой. Инициатору требуется выполнить функцию foo на целевой системе, передав туда некоторый набор параметров, и получить результаты. После обнаружения целевой системы, инициатор обязан представить всю необходимую для исполнения функции информацию в формате, понятном ей. Как минимум, эта информация будет включать в себя имя функции и передаваемых параметров. После распаковки запроса и валидации параметров, целевая система выполнит функцию foo. После этого она должна упаковать результат, включая любые ошибки, произошедшие во время выполнения, и отправить их обратно инициатору. Наконец, инициатор должен суметь распаковать результаты и оповестить об этом цель. Этот паттерн «запрос-ответ» довольно распространен и на высоком уровне описывает работу практически любого IPC механизма.
DynamicMetaObject
Для понимания того, как DLR реализует представленный паттерн, давайте рассмотрим один из центральных классов DLR: DynamicMetaObject. Начнем с изучения трех из двенадцати ключевых методов этого типа:
- BindCreateInstance — создание или активация объекта
- BindInvokeMember — вызов инкапсулированного метода
- BindInvoke — исполнение объекта (как функции)
Другие фреймворки следуют такому же паттерну. Например, COM предоставляет функцию CoCreateInstance для создания объектов. В .NET Remoting вы можете использовать CreateInstance метод из класса System.Activator. DynamicMetaObject из DLR предоставляет BindCreateInstance для похожих целей.
После использования метода BindCreateInstance, созданное нечто может быть типом, предоставляющим несколько методов. Метод метаобъектов BindInvokeMember используется для байндинга операции, которая может вызывать функцию. На картинке выше, строка foo может быть передана как параметр чтобы указать байндеру, что метод с таким именем должен быть вызван. Дополнительно включается информация о количестве аргументов, их именах и специальный флаг, указывающий байндеру, можно ли игнорировать регистр при поиске подходящего именованного элемента. В конце концов, не все языки требовательны к регистру наименований.
Когда нечто, возвращенное из BindCreateInstance — это всего лишь одна функция (или делегат), используется метод BindInvoke. Чтобы прояснить картину, давайте рассмотрим следующий небольшой кусочек динамического кода:
delegate void IntWriter(int n); void Main()
Этот код не является оптимальным способом вывести число 5 в консоль. Хороший разработчик никогда не будет использовать что-нибудь настолько расточительное. Однако, этот код иллюстрирует использование динамической переменной, значение которой является делегатом, который может использоваться как функция. Если тип делегата реализует интерфейс IDynamicMetaObjectProvider, то метод BindInvoke из DynamicMetaObject будет использован для байндинга операции к реальной работе. Это происходит из-за того, что компилятор распознает, что динамический объект Write синтаксически используется как функция. Теперь рассмотрим другой участок кода для понимания того, когда компилятор сгенерирует BindInvokeMember:
class Writer : IDynamicMetaObjectProvider < public void Write(int n) < Console.WriteLine(n); >// реализация интерфейса опущена > void Main()
Я опущу имплементацию интерфейса в этом небольшом примере, потому что потребуется большое количество кода, чтобы корректно это продемонстрировать. В этом сокращенном примере мы реализуем динамический метаобъект всего несколькими строчками кода.
Важная для понимания вещь заключается в том, что компилятор распознает, что Writer.Write(7) — это операция доступа к элементу. То, что мы обычно называем «оператор точка» в C# формально называется «оператор доступа к члену типа». DLR код, сгенерированный компилятором в этом случае, в конечном итоге вызовет BindInvokeMember, в который передаст строку Write и число-параметр 7 в операцию, которая способна выполнить вызов. Если коротко, то BindInvoke используется для вызова динамического объекта как функции, тогда как BindInvokeMember используется для вызова метода как элемента динамического объекта.
Доступ к свойствам через DynamicMetaObject
Из приведенных примеров видно, что компилятор использует синтаксис языка для того, чтобы определить, какие операции DLR байндинга должны быть выполнены. Если вы используете Visual Basic для работы с динамическими объектами, то будет использована его семантика. Оператор доступа (точка), конечно, нужен не только для доступа к методам. Вы можете использовать его для доступа к свойствам. Метаобъект DLR предоставляет три метода для доступа к свойствам динамических объектов:
- BindGetMember — получить значение свойства
- BindSetMember — установить значение свойства
- BindDeleteMember — удалить элемент
Представление объекта как массива
Некоторые классы являются контейнерами для экземпляров других типов. DLR знает, как обрабатывать такие случаи. Каждый «массиво-ориентированный» метод метаобъекта имеет постфикс «Index»:
- BindGetIndex — получить значение по индексу
- BindSetIndex — установить значение по индексу
- BindDeleteIndex — удалить значение по индексу
JavaBridge java = new JavaBridge(); dynamic customers = java.Load("Customer.class"); dynamic Jason = customers["Bock"]; Jason.Balance = 17.34; customers["Wagner"] = new Customer("Bill");Поскольку в третьей и пятой строчке используется оператор доступа по индексу ([]), компилятор распознает это и использует методы BindGetIndex и BindSetIndex при работе с метаобъектом, возвращенным из JavaBridge. Подразумевается, что имплементация этих методов у возвращенного объекта будет запрашивать исполнение метода у JVM через Java Remote Method Invocation (RMI). В этом сценарии DLR выступает в роли моста между C# и другим языком со статической типизацией. Надеюсь, это проясняет, почему я назвал DLR «языком языков».
Метод BindDeleteMember, точно так же как и BindDeleteIndex, не предназначен для использования из языков со статической типизацией типа C# и Visual Basic, так как они не поддерживают саму концепцию. Однако, вы можете договориться считать «удалением» какую-нибудь операцию, выразимую средствами языка, если это будет вам полезно. Например, вы можете имплементировать BindDeleteMember как обнуление элемента по индексу.
Преобразования и операторы
Последняя группа методов метаобъектов DLR касается обработки операторов и преобразований.
- BindConvert — сконвертировать объект в другой тип
- BindBinaryOperation — применение бинарного оператора над двумя операндами
- BindUnaryOperation — применение унарного оператора над одним операндом
dynamic x = 13; int y = x + 11;Методы BindBinaryOperation и BindUnaryOperation используются всегда, когда встречаются арифметические операции («+») или инкременты («++»). В примере выше, сложение динамической переменной х с константой 11 приведет к вызову метода BindBinaryOperation. Запомните этот маленький пример, мы используем его в следующем разделе чтобы грокнуть другой ключевой класс DLR, называющийся CallSite.
Динамическая диспетчеризация при помощи CallSite
Если ваше знакомство с DLR не заходило дальше использования ключевого слова dynamic, то вы, вероятно, никогда бы не узнали о существовании типа CallSite в .NET Framework. Этот скромный тип, формально известный как CallSiteT>, располагается в пространстве имен System.Runtime.CompilerServices. Это «источник силы» метапрограммирования: он заполнен всевозможными методами оптимизации, которые делают динамический .NET код быстрым и эффективным. Я упомяну аспекты производительности CallSiteT> в конце статьи.
Большая часть того, чем CallSite занимаются в динамическом .NET коде, затрагивает генерацию и компиляцию кода в рантайме. Важно заметить, что класс CallSiteT> лежит в пространстве имен, которое содержит слова «Runtime» и «CompilerServices«. Если DLR это «язык языков», то CallSiteT> — это одна из важнейших его грамматических конструкций. Давайте рассмотрим наш пример из предыдущего раздела ещё раз чтобы поближе познакомиться с CallSite и тем, как компилятор внедряет их в ваш код.
dynamic x = 13; int y = x + 11;Как вы уже знаете, для выполнения этого кода будут неявно вызваны методы BindBinaryOperaion и BindConvert. Вместо того, чтобы показывать вам длинный листинг дизассемблированного MSIL кода, сгенерированного компилятором, я составил схему:

Помните, что компилятор использует синтаксис языка для того, чтобы определить, какие методы динамического типа исполнять. В нашем примере выполняются две операции: добавление переменной x к числу (Site2) и приведение результата к int (Site1). Каждое из этих действий превращается в CallSite, который хранится в специальном контейнере. Как вы можете видеть на схеме, CallSites создаются в обратном порядке, но вызываются при этом в правильном.
На рисунке вы можете увидеть, что методы метаобъекта BindConvert и BindBinaryOperation вызываются непосредственно перед операциями «создать CallSite1» и «создать CallSite2». Тем не менее, привязанные операции исполняются только в самом конце. Надеюсь, визуализация помогает вам понять, что байндинг методов и их вызов — разные операции в контексте DLR. Более того, байндинг происходит только единожды, тогда как вызов происходит столько раз, сколько понадобится, переиспользуя уже инициализированные CallSites для оптимизации производительности.
Идем по легкому пути
В самом сердце DLR используются деревья выражений для генерирования функций, привязанных к двенадцати методам байндинга, представленным выше. Многие разработчики постоянно сталкиваются с деревьями выражений, используя LINQ, но только немногие из них имеют достаточно глубокий опыт чтобы полноценно имплементировать IDynamicMetaObjectProvider контракт. К счастью, .NET Framework содержит базовый класс, называющийся DynamicObject, который берет на себя большую часть работы.
Чтобы создать свой собственный динамический класс, вам достаточно унаследоваться от DynamicObject и реализовать следующие двенадцать методов:
- TryCreateInstance
- TryInvokeMember
- TryInvoke
- TryGetMember
- TrySetMember
- TryDeleteMember
- TryGetIndex
- TrySetIndex
- TryDeleteIndex
- TryConvert
- TryBinaryOperation
- TryUnaryOperation
Кэширование
[Подробнее про кэширование можно прочитать в моей предыдущей статье по DLR]
Наибольшую обеспокоенность при работе с динамическими языками у разработчиков вызывает производительность. DLR принимает экстраординарные меры, чтобы развеять эти переживания. Я кратко упомянал тот факт, что CallSiteT> находится в пространстве имен, называющемся System.Runtime.CompilerServices. В этом же пространстве имен лежит несколько других классов, которые осуществляют разноуровневое кэширование. Используя эти типы, DLR реализует три основных уровня кэширования для ускорения динамических операций:
- Глобальный кэш
- Локальный кэш
- Полимофрный кэш делегатов
Кэш делегатов, который находится внутри самого CallSite, называется полиморфным, потому что эти делегаты могут принимать разные формы в зависимости от того, какой динамический код выполняется и какие правила из других кэшей использовались для их генерации. Кэш делегатов также иногда называют инлайн-кэшем. Причина использования этого термина в том, что выражения, сгенерированные DLR и их байндеры превращаются в MSIL код, который проходит через JIT-компиляцию, как и любой другой .NET код. Компиляция во время исполнения происходит одновременно с «нормальным» выполнением вашей программы. Понятно, что превращение на лету динамического кода в скомпилированный MSIL код во время выполнения программы может очень сильно повлиять на производительность приложения, так что механизмы кэширования жизненно необходимы.
Сколько аргументов принимает функция net writeint
UNIX — это многозадачная, многопользовательская операционная система (ОС) общего назначения. Многозадачность означает, что в среде одновременно могут выполняться несколько программ. Термин многопользовательская «говорит» о том, что в системе одновременно могут работать несколько пользователей.
Операционная система UNIX была создана в первой половине 70-х годов в подразделении фирмы АТ&T, называемом Веll Теlephone Labs. Первая версия системы была реализована на мини-ЭВМ РDP/7 и предназначалась, в основном, для обработки текстовой информации. Пройдя успешную проверку, система получила дальнейшее развитие. Большая часть кодов была переписана с ассемблера РDP на язык высокого уровня Си, разрабатываемый в то же время в упомянутой фирме. UNIX удачно отражал особенности существовавших в то время операционных систем и был применен в ряде университетов Северной Америки для обучения студентов принципам построения ОС. В начале 80-х годов UNIX был установлен на ряде вычислительных машин, отличных по своей архитектуре от РDР. В середине 80-х система привлекла внимание фирм-производителей компьютерного оборудования и программного обеспечения. Появились первые коммерческие версии UNIX. Они получили широкое распространение во всем мире. Сегодня трудно назвать ЭВМ, для которой не была бы разработана версия этой ОС (в дальнейшем версии системы мы также буден называть ее диалектами).
Широкое распространение системы UNIX объясняется простотой ее устройства и легкостью переноса на компьютеры разной архитектуры. Последнее есть следствие того, что ОС написана на языке высокого уровня, и машинно-зависимые ее части невелики по объему и четко выделены. Но слаба машинная зависимость имеет и свои недостатки. Основным из них является некоторое снижение производительности UNIX по сравнению с системами, разработанными для конкретной ЭВМ и в большей степени учитывающими ее аппаратные особенности.
1.2. Основные понятия системы UNIX.
Реализованные в системе UNIX принципиальные решения представляют собой пример удачного сочетания универсальности и простоты. Они основаны на обобщении понятий, связанных с ресурсами вычислительной системы, управлением программами, распределением памяти, вводом-выводом данных. Базовыми понятиями ОС являются процесс, ядро и файл.
Процессом называется программа во время выполнения. Ядро — это часть кода системы UNIX, считываемая в память машины при загрузке ОС, и остающаяся там на все время ее функционирования. Оно ответственно за запуск процессов, распределение памяти, работу с внешними устройствами и т. д. В отличие от многих других многозадачных операционных систем ядро в системе UNIX пассивно, т.е. не выполняет никаких функций, пока его об этом не «попросят».
Программы используют ядро для удовлетворения своих потребностей и выполнения операций, связанных с обращением к ресурсам компьютера. С точки зрения процессов ядро можно рассматривать как набор резидентных в памяти подпрограмм и структур данных. Для выполнения действий, связанных с использованием ресурсов системы, задача вызывает процедуры ядра. Такого рода вызовы в UNIX называются системными.
Процесс, осуществивший системный вызов, приостанавливается, пока последний не будет завершен. При этом говорят, что программа находится в режиме работы «система». Процесс, занятый обработкой своих локальных структур данных, работает в режиме «пользователь».
Все процессы в системе работают параллельно, используя один центральный процессор по принципу разделения времени. Каждому из них присваивается определенный приоритет. Чем он выше, тем больше «внимания» уделяет ОС задаче.
Процесс может быть порожден другим процессом при выполнении последним соответствующего системного вызова. При этом в ядре резервируется необходимая память, и вновь созданной задаче присваивается уникальный идентификатор — неотрицательное целое число. Количество одновременно существующих в системе программ ограничено. Оно определяется в момент установки UNIX на ЭВМ (или, как говорят программисты, в момент генерации системы).
Важным компонентом операционной системы являются файлы. В UNIX это именованный набор данных, хранящихся на внешнем устройстве (например магнитном диске), который доступен для чтения и (или) записи. Единицей информации, хранящейся в файле, является байт, состоящий из 8 битов. Каждый файл кроме имени имеет дополнительные атрибуты, такие как размер, дата создания, права доступа к нему пользователей и некоторые другие (см. Более подробно, например [3,4]). Файлы объединяются в единую файловую систему (см. ниже).
Работа с файлами и внешними устройствами, такими как диск, принтер, клавиатура, дисплей, в UNIX унифицирована. Каждому из устройств соответствует файл, который в терминах ОС называют «специальным». Когда программа пишет байты в него, то они выводятся ядром на соответствующее устройство. Аналогично, когда информация читается из специального файла, то реально данные принимаются с устройства. Все устройства делятся на два типа: блочно-ориентированные (блочные) и символьно-ориентированные (символьные). Обмен данными с первыми осуществляется порциями длиной более одного байта (обычно 512 байт). Такими являются, например, магнитные диски. Обмен данными с устройствами второго типа осуществляется порциями равными одному байту (символу). Такими являются, например, клавиатура.
1.3. Начальная загрузка UNIX. Вход пользователя в систему.
UNIX, работая на одной ЭВМ, может одновременно эксплуатироваться многими пользователями. Опишем механизм, обеспечивающий им доступ к ресурсам системы. Для этого нам придется немного познакомиться с процессом загрузки ОС и приведением ее в рабочее состояние.
При включении машины начинает действовать программа, которая «находит» на устройстве файл, содержащий ядро UNIX, и помещает его в память ЭВМ. Поскольку ядро самостоятельно не выполняет каких-либо действий, для начала работы системы создается самый первый процесс. Ему присваивается идентификатор 0. Данный процесс называется swapper и выполняет действия, связанные с распределением вычислительных ресурсов (памяти и машинного времени) между другими программами. swapper это единственный процесс, который создается не другой задачей, а как бы «сам на себе».
В начале своей работы swapper порождает новый процесс с идентификаторам 1, называемый init. init, в свою очередь, создает группу процессов, обеспечивающих доступ пользователей к системе. Число их определяется количеством терминалов, подключенных к компьютеру. (Терминалом называется устройство, обеспечивающее интерактивное взаимодействие пользователя с машиной, обычно это дисплей и клавиатура).
Процесс, обеспечивающий вход пользователя в систему (он называется getty) выводит на терминал сообщение:
login:
Таким образом пользователю предлагается ввести имя, под которым он известен ОС. После ввода, getty порождает процесс login, который отвечает за дальнейшую работу.
login проверяет наличие пользователя с введенным именем в системном учетном файле и выводит на терминал «просьбу» ввести пароль:
password:
Введенная строка сравнивается со значением, зарегистрированным в системе, и, в случае не совпадения, на терминал выводится соответствующее сообщение, и вновь запрашиваются имя и пароль. Если же все введено правильно, login запускает программу, указанную в учетном файле для пользователя с указанным именем, и завершает свою работу.
Обычно задача, запускаемая процессом login, представляет собой интерпретатор команд (командный процессор (shell)). Он позволяет управлять операционной системой. shell воспринимает ввод с клавиатуры, анализирует полученные строки, определяет содержащиеся в них инструкции и выполняет предписываемые ими действия. Взаимодействие пользователя с системой подробно описано в многочисленной литературе по UNIX и мы не будем рассматривать этот вопрос в данном издании ( см. например, [1-4] ).
Таким образом, мы кратко рассмотрели действия, производимые системой при входе в нее пользователя. Терминал, с которого осуществлен «вход», называется контрольным. Он закрепляется за пользователем до тех пор, пока процесс, порожденный при входе в систему, остается активным. Все запускаемые пользователем программы «прикреплены» к терминалу и принадлежат текущему пользователю. Это позволяет операционной системе определять права их доступа к другим процессам, файлам и прочим ресурсам системы UNIX.
Когда процесс, порожденный при входе, завершается, то терминал освобождается, и процесс init автоматически создает новый процесс getty для освободившегося устройства. Это дает возможность другому пользователю «войти» в систему.
1.4. Файловая система.
- создавать и удалять файлы;
- записывать или считывать данные в/из файл (файла);
- обеспечивает защиту содержимого файлов от несанкционированного доступа.
Физически файловая система располагается на устройствах ввода-вывода с прямым доступом. Обычно это магнитные диски. Каждый из них имеет свой специальный файл, посредством которого производятся операции обмена данными на уровне ядра. Диски в системе UNIX относятся к так называемым блочно-ориентированным устройствам. Это означает, что операции ввода-вывода для них выполняются порциями (блоками). Их размер, как правило, равен или кратен 512 байтам. Таким образом, система рассматривает диск как набор блоков, пронумерованных от 0 до N, где N зависит от размера устройства.
Файловая система позволяет разделять дисковое пространство между наборами данных, имеющими различные имена, размеры и другие атрибуты. При ее создании на диске первый блок (номер 0) отводится для программы начальной загрузки ОС, даже если диск не будет содержать ядро UNIX. Следующий блок называется суперблоком. Он содержит информацию о размере файловой системы, указатель на список свободных блоков и указатель на список свободных индексных узлов. Индексный узел представляет собой структуру данных, хранящуюся на диске, и содержащую информацию, необходимую для поиска блоков, относящихся к конкретному файлу.
Следом за суперблоком располагаются списки самих индексных узлов и свободных блоков. Место для них резервируется при создании файловой системы, далее располагаются блоки, занятые данными файлов, и свободные блоки.
На логическом уровне файловая система UNIX организована, как иерархическая последовательность каталогов (директорий), содержащих сами файлы. Директория самого верхнего уровня называется «корневой» и имеет имя «/» (косая черта). Она создается в момент установки ОС на компьютер. Все остальные файлы и директории входят в корневую директорию или в ее подкаталоги. Указание ее местоположения на диске содержится в суперблоке.
Информация о том, что находится в конкретной директории, располагается в особом файле. Его содержимое может быть прочитано или изменено с помощью процедур ядра (см. ниже).
Доступ процесса к любому набору данных производится путем поиска его в директориях файловой системы. Для этого необходимо задавать вместе с именем файла перечень имен входящих друг в друга директорий, указывающих его положение в иерархии. Этот список образует полное имя файла (или, как говорят, путь к нему). Части в этом имени разделяются символом ‘/’.
Например, если надо указать полное имя файла «prog.c», содержащегося в директории «src», которая, в свою очередь, входит в «корневую» директорию, то полное имя (путь) в системе UNIX будет выглядеть следующим образом:
/src/prog.c
- Соединение многих файловых систем в одну («монтирование»).
- Работа с каталогами.
- Создание и уничтожение файлов. Получение информации о файлах.
- Ввод-вывод данных.
1.4.1. Соединение многих файловых систем в одну («монтирование»).
ОС UNIX по умолчанию имеет, по крайней мере, одну файловую систему, создаваемую при ее генерации. К ней можно присоединить файловые системы, находящиеся на других устройствах. Для этого необходимо выполнить процедуру, которую называют «монтированием» (mount). «Монтирование» производится при помощи системного вызова mount ( ). Формат его следующий:
#include #include int mount (const char *spec, const char *path, int mode);
(Здесь и далее указываются файлы-заголовки ( .h ), в которых определяются прототипы функций, константы и другие объекты, используемые для программирования. Где находятся эти файлы, а также, что еще необходимо для построения приложений в среде UNIX, подробно описывается ниже).
Аргумент spec задает имя специального файла, соответствующего устройству, содержащему файловую систему, path — полное имя директории в существующей файловой системе, mode — режим «монтирования». Указание режима необходимо при присоединении файловых систем, отличающихся по своей природе от файловой системы UNIX (например, файловой системы MS DOS). mount ( ) возвращает значение 0 при успешном завершении и — 1, если в процессе выполнения операции произошли ошибки.
Новая файловая система присоединяется к существующей в точке, указанной параметром path. Другими словами, содержимое директории path заменяется содержимым «корневой» директории новой файловой системы.
Рассмотрим пример присоединения файловой системы, находящейся на дискете, к директории «/mnt». Предполагается, что устройству соответствует специальный файл с именем «/dev/diskette» (см. прототип функции perror ( ) в [6]).
if (( err = mount ("/dev/diskette", "/mnt", 0 )) = = - 1 ) perror ("mount: ошибка монтированная");
Операция обратная «монтированию» — отсоединение («де-монтирование») производится системным вызовом umount ( ):
#include #include int mount (const char *path);
Ее аргумент задает полное имя директории, к которой файловая система была ранее присоединена. При успешном завершении функция возвращает 0. «Де-монтирование» файловой системы не может быть произведено, если какой-либо процесс производит операции ввода-вывода с файлами, входящими в ее состав.
1.4.2. Работа с каталогами.
Рассмотрим подробнее информацию, содержащуюся в файле, описывающим директорию. Он состоит из записей, характеризующих содержащиеся в каталоге наборы данных. Для каждого из них указаны имя, возможно некоторые другие атрибуты, и ссылка на элемент в таблице символов узлов. Последнее необходимо для доступа к содержимому файла. С точки зрения прав доступа все пользователи делятся на три категории: владелец файла, пользователи, входящие в одну группу с владельцем, и остальные. Для каждой категории устанавливаются правила на использование файла для чтения, записи и выполнения. Все файлы, описывающие директории, за исключением файла, соответствующего корневой директории, содержат по две записи для имен «.» и «. .». Первое из них используется для указания текущей директории, второе — для обозначения директории, являющейся родительской по отношению к текущей. Использование данного имени позволяет «продвигаться» вверх в иерархии файловой системы (см. подробнее, например [3,4].
Директории создаются системным вызовом mkdir( ) и удаляются rmdir( ). Если директория не является пустой , т.е. содержит некоторое количество файлов, удалить ее нельзя. Формат функций, реализующих эти системные вызовы, следующий:
#include #include int mkdir (const char *path, mode_t mode); int rmdir (const char *path);
Аргументы функций следующие: path — имя директории, mode — целое число, задающее атрибуты создаваемого каталога. Задание их производится при помощи побитовых логических операций со следующими символическими константами, которые определяют установку прав доступа:
| S_IRWXU | Владелец может читать, писать и выполнять. |
| S_IRUSR | Владелец может читать. |
| S_IWUSR | Владелец может писать. |
| S_IXUSR | Владелец может выполнять. |
| S_IRWXG | Пользователи, входящие в одну группу с владельцем (группа), могут читать, писать и выполнять. |
| S_IRGRP | Группа может читать. |
| S_IWGRP | Группа может писать. |
| S_IXGRP | Группа может выполнять. |
| S_IRWXO | Все остальные пользователи (остальные) могут читать, писать и выполнять. |
| S_IROTH | Остальные могут читать. |
| S_IWOTH | Остальные могут писать. |
| S_IXOTH | Остальные могут выполнять. |
Прочитать содержимое каталога, т.е. получить перечень имеющихся в нем поддиректорий и файлов, можно при помощи функций:
#include DIR *opendir (char *dirname); struct direct *readdir (DIR *dirp); int closedir (DIR *dirp);
(Заметим, что процедуры системно-зависимы. Так, например, в диалекте Solaris 2.x (SunSoft), соответствующем стандарту System V Release 4, вместо файла «sys/dir.h» используется «dirent.h», а вместо структуры direct — структура dirent).
Функция opendir( ) открывает каталог для чтения. Ее параметр dirname — это имя директории. Возвращает процедура указатель на структуру типа DIR, которая затем используется при работе.
Функция readdir( ) читает содержимое очередного элемента каталога. Процедура возвращает указатель на структуру direct, описывающую файл, либо NULL, если вся информация уже получена. Структура direct определена следующим образом:
struct direct < ino_t d_ino; /*Номер индексного узла */ char d_name [DIRSIZ]; /* Имя файла */ >;
Функция closedir( ) закрывает каталог и освобождает необходимые для работы с ним ресурсы.
В следующем примере иллюстрируется приведенный выше материал.
#include #include vold main( ) < DIR *dirp; struct direct *directp; dirp = opendir ( "."); while ( (directp = readdir (dirp) ) != NULL) (void) printf ( "%s\n", directp->d_name ); (void) closedir (dirp); return 0; >
Здесь мы открываем текущий каталог и печатаем его содержимое на экране.
1.4.3. Создание и уничтожение файлов. Получение информации о файлах.
Для создания обычных файлов используется системный вызов creat( ):
#include #include #include int creat (char *path, mode_t mode);
Аргументы функции: path — имя файла, mode — задает атрибуты создаваемого файла (см. описание системного вызова mkdir( ) в предыдущем разделе).
Специальные файлы, соответствующие устройствам, обычно располагаются в директории «/dev». Создать их можно системным вызовом mknod( ):
#include #include int mknod (char *path, mode_t, dev_t dev);
Аргумент mode задает права доступа к файлу. deu представляет собой структуру, задающую тип и номер устройства, соответствующего специальному файлу.
Когда файл более не нужен, его можно удалить с помощью функции unlink ( ):
#include #include #include int unlink (char *path);
где path — имя файла. Последний должен быть закрыт.
Чтобы получить информацию о наборе данных, в UNIX предусмотрена функция stat( ):
#include #include int stat (char *path, struct stat *fstat);
Она по имени файла path находит соответствующую информацию и помешает ее в структуру, на которую указывает fstat. Среди полей структуры stat особый интерес представляют следующие:
1.4.4. Ввод-вывод данных.
Функции ввода-вывода используются в системе UNIX для доступа к содержимому файлов. Они делятся на две основные группы. Первая представляют собой группу системных вызовов и реализует минимальный набор действий, необходимых для чтения (записи) информации. Это как бы нижний уровень. Процедуры, входящие во вторую группу, называются функциями буферизованного или форматированного ввода-вывода. Они используют в своей работе обращения к системным вызовам нижнего уровня для выполнения непосредственного ввода-вывода данных. Функции, описываемые в данном разделе, относятся к первой группе. Процедуры буферизованного ввода-вывода можно найти в [6].
Для доступа к содержимому файла его сначала надо открыть, воспользовавшись системным вызовом open( ). Формат вызова выглядит следующим образом:
#include #include #include int open (const char *path, int oflag, mode_t mode);
Здесь path — имя файла, oflag — режим открытия файла, задаваемый при помощи констант:
| O_RDONLY | — открыть для чтения; |
| O_WRONLY | — открыть для записи; |
| O_RDWR | — открыть для чтения и записи. |
Следует отметить, что должна быть задана только одна из трех указанных констант. Следующие константы могут быть использованы при необходимости.
| O_APPEND | — добавить данные в конец файла; |
| O_CREAT | — создать файл; |
| O_EXCL | — возвратить код ошибки, если задан флаг O_CREAT, и файл уже существует; |
| O_TRUNC | — урезать открываемый файл до нулевой длины. |
Аргумент mode — задает атрибуты создаваемого файла (см. описание системного вызова mkdir( ) в разделе 1.4.2).
При успешном завершении системный вызов open( ) возвращает дескриптор файла. В случае ошибки открытия файла функция возвращает -1.
Дескриптор файла — это целое число, которое является ссылкой на структуру данных, создаваемую в ядре операционной системы. Она содержит информацию, необходимую для последующих операций ввода-вывода. В структуре находятся такие данные, как размер файла, его расположение на диске и указатель на место относительно начала файла для следующей операции ввода или вывода (текущее положение). Текущее положение устанавливается при открытии файла и изменяется при чтении/ записи.
Ядро системы устанавливает ограничение на количество одновременно открытых одним процессом файлов Их максимальное число может 16 до 64, в зависимости от версии UNIX и конфигурации ядра системы, заданной при генерации.
После того как файл открыт, данные вводятся из него посредством функции read( ):
#include int read (int fd, void *buff, size_t nbytes);
Здесь fd — дескриптор файла, buff — адрес буфера для приема данных, и nbytes — количество байт, подлежащих вводу из файла. Функция возвращает число считанных байт.
Данные выводятся из памяти в файл системным вызовом write( ):
#include int write (int fd, void *buff, size_t nbytes);
Функция имеет те же аргументы, что и предыдущая, и возвращает в качестве своего значения количество записанных байт.
После выполнения операций чтения и записи, указатель текущего положения перемещается вперед по файлу на количество веденных или выведенных байт. Изменить текущее положение можно также при помощи системного вызова lseek( ). Его формат следующий:
#include #include int lseek (int fd, off_t offset, int whence);
Аргумент fd задает дескриптор открытого файла, offset — величину смещения в байтах, whence указывает, относительно какой позиции файла задано смещение. Последний аргумент может принимать следующие значения:
| SEEK_SET | — относительно начала файла; |
| SEEK_CUR | — относительно текущей позиции; |
| SEEK_END | — относительно конца файла. |
После выполнения последней операции ввода-вывода с файлом, связанную с ним структуру данных ядра можно освободить, выполнив операцию закрытия. Для этого вызывается процедура close( ):
#include int close (int fd);
Все открытые файлы автоматически закрываются при завершении процесса.
Приведенный ниже пример иллюстрирует применение описанных системных вызовов и содержит программу, дописывающую строку в конец файла.
#include #include #include #include #include char *file_name = «file.txt»; char *string = «This string to add.\n»; int main ( )
1.5. Процессы.
Как упоминалось выше, UNIX является многозадачной ОС, т.е. в ней одновременно могут работать несколько программ-процессов. Ядро системы ответственно за их запуск и последующее сопровождение. Поскольку процессор в ЭВМ, как правило, один, то ядро же обеспечивает выделение каждой программе интервалов машинного времени. Ядро осуществляет корректное переключение между задачами.
Выполнение программы начинается с вызова системой функции main( ). Полный формат ее следующий:
int main (int argc, char *argv[], char *evnir[]);
Здесь argv — массив указателей на строки, содержащие параметры, переданные задаче при запуске, argc — число элементов массива argv, envir — массив строк, содержащих переменные среды (environment) и их значения.
Завершение процесса происходит при возврате из функции main( ) или вызове программой функции exit( ).
Во время выполнения задача может запустить другой процесс. Для этого в системе UNIX предусмотрена системная функция fork( ):
#include #include pid_t fork (void);
После выполнения процедуры, ядром UNIX создается точная копия процесса, выполнившего системный вызов. При этом, вызывающий процесс называется родительским, а новый — процессом-«потомком». Родительскому процессу функция fork( ) возвращает идентификатор порожденного процесса, а «потомку» возвращается 0. Важным свойством вызова fork( ) является то, что оба процесса продолжают иметь доступ ко всем открытым файлам «родителя».
После того, как новая задача запущена, она может выполнять код «родителя», но, как правило, подгружается и начинает работать программа, находящаяся в другом выполнимом файле. Чтобы осуществить это, можно использовать системный вызов exec( ), exec1( ) или другой аналогичный. Перечисленные функции отличаются друг от друга способом передачи параметров вызываемой программе. Функция exec( ) имеет прототип:
#include int exec ( const char *path, int argc, char *argv[ ] );
Здесь path — имя выполняемого файла, argv — массив указателей на строки, передаваемые загружаемой программе в качестве параметров, argc — количество строк массива argv. Прототипы и объяснение других процедур, подобных exec( ), можно найти в соответствующих разделах подсказки UNIX (см. подробнее 1.9.1.).
Процесс-«родитель», когда заканчивает работу, может подождать завершения запущенных им ранее программ. Для этого следует обратиться к системной процедуре wait( ):
#include #include pid_t wait (int *status);
Функция возвращает идентификатор процесса, окончившего работу. Код его завершения записывается по адресу, заданному аргументом status.
Заметим, что в различных диалектах UNIX имеются более развитые варианты функции wait( ). Это wait3( ), waitpid( ), waitid( ) (более подробную информацию можно найти в документации по той системе, на которой работает пользователь).
В качестве примера рассмотрим подпрограмму, реализующую функцию system( ). Она выполняет переданную ей командную строку при помощи интерпретатора командного языка (командного процессора) sh.
#include #include #include int system (const char *cmd_string) < pid_t pid; int status; if (cmd_string = = NULL) return (1); if ( (pid = fork ( ) ) < 0) return (-1); if (pid == 0) < /* процесс-"потомок" */ execl ("/bin/sh", "sh", "-c", cmd_string, (char*) 0); exit (-1); /* выполняется при ошибке в execl */ >else < /* процесс-"родитель" ожидает завершения */ /* выполнения процесса-"потомка" */ wait (&status); >>
1.6. Сигналы.
- При нажатии пользователем определенных клавиш на клавиатуре терминала. Например, — завершить процесс и — приостановить процесс.
- При аппаратных сбоях или попытке выполнения процессом ошибочных с точки зрения системы действий, таких, как деление на ноль или обращение к неверному адресу.
- Сигналы могут посылаться одним процессом другому при помощи системного вызова kill( ).
- При возникновении программных ошибок в системе, например, при переполнении буфера во время выполнении операции буферизованного вывода.
Когда программа получает сигнал, вызывается либо функция, зарегистрированная как реакция на него, либо выполняется стандартное действие ОС. Большинство нетривиальных программ в системе UNIX используют сигналы. Каждый сигнал имеет целочисленный идентификатор. Некоторые сигналы являются стандартными. Их идентификаторам соответствуют символические константы, определенные в файле-заголовке .
Количество стандартных сигналов зависит от версии системы. Ниже приведен перечень, используемый в большинстве диалектов ОС.
| SIGABRT | Сигнал генерируется вызовом функции abort( ) и вызывает аварийное завершение процесса. |
| SIGALARM | Сигнал посылается по истечении времени, установленного функцией alarm( ). |
| SIGBUS | Сигнал возникает при сбое оборудования. |
| SIGCONT | Сигнал позволяет возобновить выполнение процесса, прерванного по сигналу SIGSTOP. |
| SIGFPE | Ошибка при выполнении арифметической операции с действительными числами. |
| SIGILL | Неверная инструкция процессора при выполнении программы. |
| SIGINT | Сигнал возникает при вводе с терминала . |
| SIGIO | Завершение асинхронной операции ввода-вывода. |
| SIGIOT | Ошибочное завершение асинхронной операции ввода-вывода. |
| SIGKILL | Немедленно завершить процесс. |
| SIGPIPE | Ошибки при записи в канал межпроцессного ввода-вывода (pipe) (см. 1.7.2.). |
| SIGSEGV | Ошибка при использовании процессом неверного адреса. |
| SIGSTOP | Приостановить выполнение процесса. |
| SIGSYS | Ошибка при выполнении системного вызова. |
| SIGTERM | Завершить процесс. |
| SIGTRAP | Аппаратная ошибка при выполнении процесса. |
| SIGTSTP | Ввод с клавиатуры (приостановить процесс). |
- Процесс может проигнорировать сигнал. Это невозможно только для SIGKILL и SIGSTOP. Эти два сигнала позволяют администратору системы UNIXпрерывать или приостанавливать процессы в случае необходимости.
- Процесс может зарегистрировать собственную функцию обработки сигнала. Рекомендуется, по возможности, обрабатывать сигналы, приводящие к преждевременному завершению программы.
- Если не задана функция обработки сигнала, ядро системы выполняет действия, предусмотренные для его обработки по умолчанию. Если пришел сигнал, связанный с программными и аппаратными ошибками, процесс, как правило, завершается с созданием в текущей директории файла с именем «core». В последний помещается содержимое области оперативной памяти, которая была занята задачей в момент прихода сигнала.
Для задания способа обработки сигнала используется системный вызов signal( ):
#include int (*signal (int sig, void (*func) (int))) (int);
Первый аргумент представляет собой идентификатор сигнала, а второй — адрес функции, производящей обработку. При задании второго аргумента могут быть использованы два специальных значения: SIG_IGN — игнорировать сигнал и SIG_DFL — обработать сигнал стандартным способом. Функция всегда возвращает адрес предыдущей функции обработки сигнала.
Приведен пример работы с сигналами.
#include #include void SignalCtrlC (int sig_no) < printf ("Receive signal : %d\n", sig_no); signal (SIGINT, SignalCtrlC); >; void main (int argc, char *argv [])
Программа заказывает реакцию на нажатие комбинации (SIGINT). После чего ожидается ввод с терминала символа ‘q’. Когда он приходит, процесс завершается. Функция SignalCtrlC( ) реагирует на сигнал SIGINT, просто печатая соответствующее сообщение.
1.7. Обмен данными между процессами.
- Разделяемые файлы.
- Каналы межпроцессорного обмена.
- Другие способы обмена данными.
- Очереди сообщений.
- Семафоры.
- Разделяемая память.
1.7.1. Разделяемые файлы.
Процессы могут разделять один и тот же открытый файл. Для исключения конфликтов, возникающих при попытке одновременной записи в одно и то же место в нем, применяется механизм блокировки. Процесс может блокировать файл целиком или отдельную его часть (запись). Под записью здесь подразумевается непрерывная область набора данных с указанными началом и длиной.
Перед выполнением операции записи в файл, процесс должен проверить, не блокирована ли запись, в которую предполагается поместить новые данные. Если область блокирована другим процессом, первый должен ждать ее освобождения. Затем надо блокировать запись и произвести операцию вывода. По завершении действий блокировка отменяется, давая другим процессам возможность записывать свои данные в этот файл. Для выполнения операции чтения блокировку можно не делать.
Для блокирования записи используется системный вызов lockf( ):
#include int lockf (int fd, int function, long size);
Здесь fd — дескриптор файла. Аргумент function задает выполняемую операцию и может принимать следующие значения:
F_ULOCK — отменить предыдущую блокировку; F_LOCK — блокировать запись; F_TLOCK — блокировать запись с проверкой, не блокирована ли она другим процессом; F_TEST — проверить, не блокирована ли запись другим процессом. Начало записи определяется текущим положением указателя в файле. Длина записи задается аргументом size. При неудачной попытке блокирования записи функция возвращает в качестве своего значения (-1).
Обмен данными между процессами через разделяемые файлы имеет ряд недостатков. Основным из них является то, что операции записи и чтения в файлы на диске требуют для своего выполнения гораздо больше времени, чем перемещение данных в оперативной памяти.
1.7.2. Каналы межпроцессного обмена.
В ранних версиях системы UNIX основным средством для обмена данными между задачами были каналы межпроцессного обмена (pipes).
Для создания канала используется системный вызов pipe( ). Его формат следующий:
#include int pipe (int fd[2]);
Аргументом функции является указатель на массив двух целых чисел, в котором функция возвращает два файловых дескриптора. Первый из них предназначен для чтения данных из канала, второй — для записи в него.
После создания pipe, процесс может при помощи обычного системного вызова write( ) выводить данные в него, а затем вводить их, вызывая соответственно функцию read( ). При выполнении вызова fork( ) дескрипторы канала наследуются процессом-«потомком». Таким образом, оба процесса получают возможность обмениваться данными.
Ограничением в данном случае является то, что канал должен работать лишь в одну сторону. Либо «родитель» должен писать, а «потомок» читать, либо наоборот. В первом случае для передачи данных от процесса-«родителя» к процессу-«потомку», первый должен закрыть fd[0], а второй fd[1]. Во втором случае выполняются противоположные действия. Если предполагается передавать данные в обе стороны, необходимо создать два канала.
Приведенный ниже пример иллюстрирует использование pipe. Процесс-«родитель» создает канал и порождает новый процесс. Затем выводит в pipe строку, которую «потомок» читает и выводит на терминал.
#include #include int main () < int n, fd [2]; pid_t pid; char line [128]; if (pipe (fd) == -1) perror ("pipe: ошибка создания канала"); if ( (pid = fork ( )) == -1) perror ("fork: ошибка создания процесса"); if (pid >0) < /*процесс-"родитель" */ close (fd [0] ); write (fd [1], "Hello, world!\n", 12); >else < /*процесс-"потомок" */ memset (line, 0, 120); close (fd [1] ); n = read (fd [0], line, 120); puts (line); >exit (0); >К недостаткам каналов следует отнести то, что они имеют свойство переполняться. Это значит, что если вывод в pipe происходит более интенсивно, чем ввод из него, возникает ошибка, и ядро системы генерирует сигнал SIGPIPE. Существенным ограничением является и то, что взаимодействовать через pipe могут только процессы, находящиеся «в родственных отношениях» («родитель»-«потомок»).
1.7.3. Другие способы обмена данными.
В современных версиях системы UNIX предпочтительнее пользоваться средствами межпроцессного обмена данными, называемыми IPC (InterProcess Communications). IPC включает в себя сообщения, семафоры и разделяемую память. В дальнейшем будем именовать их объектами IPC.
- Очереди сообщений.
- Семафоры.
- Разделяемая память.
1.7.3.1. Очереди сообщений.
Очередь сообщений представляет собой механизм передачи порций данных одинаковой длины. Каждая создаваемая очередь имеет уникальный ключ.
Создание объекта или доступ к нему производится при помощи функции msgget( ):
#include #include #include int msgget (key_t key, int flag);
Первый аргумент задает идентификатор очереди. Второй — flag — комбинация флагов, которая задает права доступа к объекту, а также то, следует ли создавать очередь сообщений или же использовать очередь, уже созданную другим процессом. Возможные флаги следующие:
MSG_R 00400 владелец может читать; MSG_W 00200 владелец может писать; (MSG_R>>3) 00040 пользователи, входящие в одну группу с владельцем (группа), могут читать; (MSG_R>>3) 00020 группа может писать; (MSG_R>>6) 00004 все остальные пользователи (остальные) могут читать; (MSG_R>>6) 00002 остальные могут писать; IPC_PRIVATE создается объект, который может использоваться лишь данным процессом; IPC_CREAT создать объект, если он не существует; IPC_EXCL используется в сочетании с IPC_CREAT; если этот флаг выставлен, и объект с заданным ключом существует, то функция возвращает код ошибки. (При описании приведены также численные значения констант). Функция возвращает процессу идентификатор, используемый в дальнейшем для работы с объектом IPC. В случае возникновения ошибок msgget( ) возвращает значение -1.
Сообщение представляет собой массив байт, первые четыре из которых являются целым числом, содержащим тип сообщения. Следующие далее байты содержат данные сообщения. Если перед тем как использовать сообщение в программе, можно определить его максимальный размер, целесообразно использовать следующую структуру:
struct msg_struct < long msg_type; /* тип сообщения */ char msg_data [MAX_MSG__DATA]; /* данные сообщения */ >;
Тип используется при выборе сообщения из очереди. Следует отметить, что операционная система накладывает ограничения на максимальный размер сообщений, количество сообщений в одной очереди и общее количество сообщений, записанное во все очереди. Соответствующие ограничения задаются константами MSGMAX, MSGNNB, MSGTQL в файле .
Записать сообщение в очередь можно, используя функцию msgsnd( ):
#include #include #include int msgsnd (int msgid, const void *ptr, size_t nbytes, int flag;
msgid — идентификатор очереди, полученный при вызове msgget( ); ptr — указатель на сообщение, записываемое в очередь; nbytes — размер сообщения в байтах; flag — либо 0, либо IPC_NOWAIT; в первом случае, если очередь полна, то msgsnd( ) ждет ее освобождения; во втором случае функция при полной очереди возвращается сразу с кодом -1. Получение сообщений из очереди производится вызовом функции msgrcv( ). Формат вызова функции следующий:
#include #include #include int msgrcv (int msgid, void *ptr, size_t nbytes, long type, int flag);
msgid — идентификатор очереди, полученный при вызове msgget( ); ptr — указатель на буфер для приема сообщения; nbytes — размер буфера; type — тип выбираемого из очереди сообщения; если значение этого параметра равно 0, из очереди выбирается первое по порядку сообщение; если type больше 0, из очереди выбирается первое сообщение, поле msg_type которого (см. определение msg_struct) содержит значение равное значению, хранящемуся в первых четырех байтах буфера приема сообщения; если же type меньше 0, будет выбрано сообщение, имеющее минимальное значение поля msg_type; flag — либо 0, либо IPC_NOWAIT; в первом случае, если очередь пуста, то msgrcv() ждет прихода события; во втором случае функция при пустой очереди возвращается сразу с кодом -1. Для управления состоянием очереди сообщений используется системный вызов msgctl( ). Функция позволяет получить информацию о состоянии очереди, изменить права доступа процессов к ней или удалить объект. Ее прототип следующий:
#include #include #include int msgctl (int msgid, int cmd, struct msqid_ms *buf);
msgid — идентификатор очереди, полученный при вызове msgget( ); cmd — команда управления очередью; значения параметра определяются константами: IPC_STAT — получить состояние очереди, IPC_SET — установить параметры очереди, и IPC_RMID — удалить очередь сообщений; buf — адрес структуры данных, используемой при выполнении команд, задаваемых параметром cmd. Ниже приводится пример двух программ, использующих очередь сообщений. Первая из них — клиент — вводит строку терминала. Если строка не нулевой длины, то она передается второй программе — серверу — через очередь сообщений. Сервер выводит полученную информацию на экран. Если же строка пуста, то передается сообщение об окончании работы. После чего обе программы завершаются.
Оба процесса используют файл заголовок «message.h».
#include #include #include #define MSQ_ID 2001 /* уникальный ключ очереди */ #define PERMS 00666 /* права доступа - все могут читать и писать */ #define MSG_TYPE_STRING 1 /* тип сообщения о том, что передана непустая строка */ #define MSG_TYPE_FINISH 2 /* тип сообщения о том, что пора завершать обмен */ #define MAX_STRING 120 /* максимальная длина строки */ typedef struct /* структура сообщения */ < int type; char string [MAX_STRING]; >message_t;
#include #include #include "message.h" void sys_err (char * msg) < puts (msg); exit (1); >int main () < int msqid; /* идентификатор очереди сообщений */ message_t msg; /* сообщение */ char s [MAX_STRING]; /* создание очереди */ if ( (msqid = msgget (MSQ_ID, 0)) < 0) sys_err ("client:can not get msg queue"); while (1) < scanf ("%s", s); /* ввод строки */ if (strlen (s) != 1) < msg.type = MSG_TYPE_STRING; strncpy (msg.string, s, MAX_STRING); >else < msg.type = MSG_TYPE_FINISH; >; /* посылка сообщения процессу-серверу */ if (msgsnd (msqid, &msg, sizeof (message_t), 0) != 0) sys_err ("client: message send error"); if (strlen (s) == 1) /* пустая строка - выход */ break; > exit (0); >#include #include #include «message.h» void sys_err (char * msg) < puts (msg); exit (1); >; int main () < int msqid; message_t msg; char s [MAX_STRING]; /* создание очереди сообщений */ if ( (msqid = msgget (MSQ_ID, PERMS | IPC_CREAT) ) < 0) sys_err ("server: can not create msg queue"); while (1) < /* получение очередного сообщения */ if (msgrcv (msqid, &msg, sizeof (message_t), 0, 0) < 0) sys_err ("server: msg recive error"); if (msg.type == MSG_TYPE_STRING) /* печать строки */ printf ("%s", msg.string); if (msg.type == MSG_TYPE_FINISH) /* выход из цикла */ break; >/* удаление очереди сообщений */ if (msgctl (msqid, IPC_RMID, (struct msqid_ds *) 0)
1.7.3.2. Семафоры.
Семафоры представляют собой стандартный способ разрешения или запрещения выполнять те или иные действия. Семафор — это обычно целое число. Если оно имеет значение 1 (установлен), то операция запрещена. Если его значение 0, то — разрешена. UNIX позволяет создавать сразу целые массивы семафоров. Они, как и другие объекты IPC, идентифицируются с помощью уникального ключа, задаваемого неотрицательным целым числом.
Для создания массива семафоров используется системный вызов semget( ):
#include #include #include int semget (key_t key, int nsems, int flag);
key — уникальный ключ объекта IPC; nsems — количество семафоров в массиве; flag — задание режима создания массива семафоров; аналогично параметру flag в msgget( ), только префикс «MSG» заменен «SEM». Функция semget( ) возвращает целое число, используемое для доступа к массиву семафоров.
Устанавливать и получать значения элементов, а также управлять состоянием всего массива семафоров можно при помощи системного вызова semctl( ).
#include #include #include int semctl (int semid, int semnum, int cmd, union semun arg);
Пример работы с массивами семафоров приведен в следующем разделе.
1.7.3.3. Разделяемая память.
Рассмотрим наиболее мощный способ обмена данными — разделяемую память. Она позволяет двум и более процессам использовать одну и ту же область (сегмент) оперативной памяти. Это самое эффективное средство обмена, поскольку при его использовании не происходит копирования информации, и доступ к ней производится напрямую. Для синхронизации записи данных в общую память, как правило, используются семафоры.
Для получения доступа к сегменту разделяемой памяти используется системный вызов shmget( ). Формат его следующий:
#include #include #include int shmget (key_t key, int size, int flag);
key — уникальный ключ разделяемого сегмента памяти; size — размер сегмента; в некоторых версиях системы UNIX он ограничен 128 К байтами; flag — задание режима создания разделяемой памяти; значение этого параметра то же, что и в msgget( ), только префикс «MSG» заменен на «SHM». При успешном создании или, если объект с заданным ключом key существует, функция возвращает идентификатор сегмента. В случае ошибки функция возвращает значение -1.
После создания разделяемой памяти, надо получить ее адрес. Для этого используется вызов shmat( ):
#include #include #include void *shmat (int shmid, void *addr, int flag);
Первый аргумент — идентификатор сегмента разделяемой памяти. Различные сочетания значений второго и третьего аргументов задают способ определения его адреса. Не приводя всех возможных вариантов, заметим, что простейшим вариантом из всех возможных является тот, при котором оба аргумента равны нулю. Возвращаемый системным вызовом shmat( ) адрес в дальнейшем используется процессом для прямого обращения к сегменту.
Изменить режим доступа к сегменту разделяемой памяти или удалить его можно при помощи системного вызова shmctl( ). При этом следует заметить, что сегмент не может быть удален до тех пор, пока не сделано обращение к процедуре shmdt( ). Прототипы shmdt( ) и shmctl( ) следующие:
#include #include #include void shmdt (void *ptr); int shmctl (int shmid, int cmd, struct shmid_ds *buf);
ptr — указатель на сегмент разделяемой памяти, полученный при вызове shmat( ); shmid — идентификатор сегмента, возвращаемый функцией shmget( ); cmd — выполняемая операция, основная из них IPC_RMID — удалить объект; buf структура, используемая для передачи данных, необходимых для выполнения операции и/или получения ее результатов. Ниже приводится пример двух программ, использующих разделяемую память. Первая из них — клиент — вводит строку терминала. Если строка не нулевой длины, то она передается второй программе — серверу — через сегмент памяти, сервер выводит полученную информацию на экран. Если же строка пуста, то сообщается об окончании работы. После чего, обе программы завершаются. Для исключения одновременного доступа к разделяемой памяти используется семафор.
Оба процесса используют файл-заголовок «message.h».
#include #include #include #include #include #define SEM_ID 2001 /* ключ массива семафоров */ #define SHM_ID 2002 /* ключ разделяемой памяти */ #define PERMS 0666 /* права доступа */ /* коды сообщений */ #define MSG_TYPE_EMPTY 0 /* пустое сообщение */ #define MSG_TYPE_STRING 1 /* тип сообщения о том, что передана непустая строка */ #define MSG_TYPE_FINISH 2 /* тип сообщения о том, что пора завершать обмен */ #define MAX_STRING 120 /* структура сообщения, помещаемого в разделяемую память */ typedef struct < int type; char string [MAX_STRING]; >message_t;
#include #include #include "message.h" void sys_err (char *msg) < puts (msg); exit (1); >int main () < int semid; /* идентификатор семафора */ int shmid; /* идентификатор разделяемой памяти */ message_t *msg_p; /* адрес сообщения в разделяемой памяти */ char s[MAX_STRING]; /* получение доступа к массиву семафоров */ if ((semid = semget (SEM_ID, 1, 0)) < 0) sys_err ("client: can not get semaphore"); /* получение доступа к сегменту разделяемой памяти */ if ((shmid = shmget (SHM_ID, sizeof (message_t), 0)) < 0) sys_err ("client: can not get shared memory segment"); /* получение адреса сегмента */ if ((msg_p = (message_t *) shmat (shmid, 0, 0)) == NULL) sys_err ("client: shared memory attach error"); while (1) < scanf ("%s", s); while (semctl (semid, 0, GETVAL, 0) || msg_p->type != MSG_TYPE_EMPTY) /* * если сообщение не обработано или сегмент блокирован - ждать * */ ; semctl (semid, 0, SETVAL, 1); /* блокировать */ if (strlen (s) != 1) < /* записать сообщение "печать строки" */ msg_p->type = MSG_TYPE_STRING; strncpy (msg_p->string, s, MAX_STRING); > else < /* записать сообщение "завершение работы" */ msg_p->type = MSG_TYPE_FINISH; >; semctl (semid, 0, SETVAL, 0); /* отменить блокировку */ if (strlen (s) == 1) break; > shmdt (msg_p); /* отсоединить сегмент разделяемой памяти */ exit (0); >#include #include #include «message.h» void sys_err (char *msg) < puts (msg); exit (1); >int main () < int semid; /* идентификатор семафора */ int shmid; /* идентификатор разделяемой памяти */ message_t *msg_p; /* адрес сообщения в разделяемой памяти */ char s[MAX_STRING]; /* создание массива семафоров из одного элемента */ if ((semid = semget (SEM_ID, 1, PERMS | IPC_CREAT)) < 0) sys_err ("server: can not create semaphore"); /* создание сегмента разделяемой памяти */ if ((shmid = shmget (SHM_ID, sizeof (message_t), PERMS | IPC_CREAT)) < 0) sys_err ("server: can not create shared memory segment"); /* подключение сегмента к адресному пространству процесса */ if ((msg_p = (message_t *) shmat (shmid, 0, 0)) == NULL) sys_err ("server: shared memory attach error"); semctl (semid, 0, SETVAL, 0); /* установка семафора */ msg_p->type = MSG_TYPE_EMPTY; while (1) < if (msg_p->type != MSG_TYPE_EMPTY) < if (semctl (semid, 0, GETVAL, 0)) /* блокировка - ждать */ continue; semctl (semid, 0, SETVAL, 1); /* установить блокировку */ /* обработка сообщения */ if (msg_p->type == MSG_TYPE_STRING) printf («%s\n», msg_p->string); if (msg_p->type == MSG_TYPE_FINISH) break; msg_p->type = MSG_TYPE_EMPTY; /* сообщение обработано */ semctl (semid, 0, SETVAL, 0); /* снять блокировку */ > > /* удаление массива семафоров */ if (semctl (semid, 0, IPC_RMID, (struct semid_ds *) 0) < 0) sys_err ("server: semaphore remove error"); /* удаление сегмента разделяемой памяти */ shmdt (msg_p); if (shmctl (shmid, IPC_RMID, (struct shmid_ds *) 0)
1.8. Распределение памяти.
- malloc( ). Выделяет указанное количество байт памяти. Выделенная память не инициализируется, т.е. может содержать произвольные данные.
- calloc( ). Выделяет память для размещения заданного количества объектов определенного размера. Все байты выделенной памяти инициализируются нулями.
- realloc( ). Изменяет размер сегмента ранее выделенной памяти, как в большую, так и в меньшую стороны. Адрес вновь выделяемой памяти, как правило, не совпадает с прежним адресом. Прежнее содержимое памяти по возможности (насколько позволяет размеры сегментов) копируется во вновь выделенную память.
- free( ). Освобождает память, выделенную одной из первых трех функций.
- Получение подсказки. Программа man.
- Файлы системы UNIX, используемые при компиляции и компоновке программ.
- Компилятор языка Си.
- Создание библиотек файлов. Программа ar.
- Программа make.
- Системы контроля исходного кода.
- ключи общего назначения;
- ключи, специфичные для версии языка Си;
- ключи, задающие обработку предупреждающих сообщений;
- отладочные ключи;
- оптимизационные ключи;
- ключи препроцессора;
- ключи загрузчика;
- ключи, задающие компилятору «рабочие» директории;
- ключи, зависящие от архитектуры вычислительной установки.
- Ведение для файлов учета всех изменений, которые собираются и заносятся автоматически. Для каждой версии указывается автор, дата и время записи, и краткое описание сути внесенных изменений. Наличие этой информации позволяет проследить историю развития файла, не требуя утомительной операции сравнения листингов различных его модификаций.
- Хранение, поиск и выдачу версий файла. RCS сохраняет все версии достаточно экономичным (с точки зрения использования дисковой памяти) способом. Различные варианты объекта, находящиеся под контролем RCS, образуют как бы дерево. Начальная модификация файла получает номер 1.1, следующая 1.2 и т.д. Если необходимо, пользователь может явно задать номер и другие атрибуты модификации, вносимой в RCS (см. ниже). Так, можно из версии 1.2 начать две разных ветви 1.2.1.1 и 1.2.2.1. На рис. 1.1 приведен пример истории развития версий некоторого объекта.
- Версии могут получать символьные имена и иметь статус: экспериментальная, стабильная и т.д. Это обеспечивает достаточно простой способ описания необходимой конфигурации собираемых модификаций. Когда из RCS необходимо "достать" какую-либо из модификаций объекта, то для ее указания можно использовать номер, символьное имя, дату создания, имя автора или статус.
- Решение проблем, возникающих при попытке одновременного редактирования одной и той же версии файла несколькими пользователями. Если объект изменяется в настоящее время одним лицом, то попытки других получить к файлу доступ блокируются.
- Слияние версий. Две разных ветви развития файла можно слить в одну. При этом система проверяет возможное пересечение редакций и, если такая ситуация обнаружена, сообщает об этом пользователю.
- Автоматическое указание при "выписывании" файла из RCS для каждой версии имени, номера, времени создания, автора и т.д. Эта информация может заноситься системой в любое место файла, указанное пользователем.
- Заданы как файл RCS, так и "рабочий" файл. Имя первого имеет вид: "path1/workfile,v", а имя второго задано в форме "path2/workfile", где "path1/" и "path2/" являются полными именами директорий, а "workfile" - имя самого файла.
- Задан только файл RCS. Тогда предполагается, что "рабочий" файл находится в текущей директории, а его имя получается из имени файла RCS удалением "path1/" и суффикса ",v".
- Задан только "рабочий" файл. В этом случае имя файла RCS получается из имени "рабочего" файла удалением "path2/" и добавкой суффикса ",v".
- Уменьшится
- Увеличится
- Не изменится
- 7 (ППП — 111),
- 6 (=7-1) (ППК — 110),
- 4 (=6-2) (ПКК — 100),
- 3 (=4-1) (ПП — 11),
- 1 (=3-2) (1 — П) и
- (=1-1) (0 — К).
- ((( (() ()) (( )) )))
- ППП ППК ПКК ПП ККК КК
- ППП ППК ПКК ПП КК ККК
- ППП: П+П+П = 45
- ППК: П+П+К = 40
- ПКК: П+К+К = 35
- ПП = 30
- ПК = 25
- КК = 20
- П = 15* К = 10
- ППП — первое промышленное производство, или первое производство процессоров
- ППК — первый персональный компьютер
- ПКК — первый карманный компьютер
- ПП — первый планшет
- ПС — первый смартфон
- Установить указатель __vtbl на vtbl родительского класса;
- Сконструировать переменные экземпляра базового класса;
- Выполнить тело конструктора базового класса.
- Поменять указатель __vtbl на vtbl класса-потомка;
- Сконструировать переменные класса-потомка;
- Выполнить тело конструктора класса-потомка.
- «Случайная» переменная: приложение может использовать некоторое «случайное» значение или переменную-компонент, которая не имеет конкретного точного значения. Примеры: ввод данных пользователем, случайное число, сгенерированное программой, время суток и т.д.
- Неинициализированная переменная: приложение может использовать неинициализированную переменную, которая в некоторых языках программирования по умолчанию может принимать любое значение. Таким образом, код может каждый раз выполняется по-разному.
- Утечка памяти: программа, возможно, исчерпала все ресурсы. Другие причины носят случайный характер и зависят от количества запущенных в определенное время процессов. Сюда же можно отнести переполнение кучи или повреждение данных в стеке.
- Внешние причины: программа может зависеть от другого приложения, машины или ресурса. Если таких связей много, программа может «упасть» в любой момент.
- n = abcde1000
- n - 1 = abcde0111
- Если яйцо №1 разбилось на первом броске (этаж 10-й), то нам в худшем случае приходится проделать не более 10 бросков.
- Если яйцо №1 разбивается на последнем броске (100-й этаж), тогда у нас впереди в худшем случае 19 бросков (этажи 10-й, 20-й, …, 90-й, 100-й, затем с 91-го до 99-го).
- В хорошо сбалансированной системе значение Drops(Egg1) + Drops(Egg2) будет постоянным, независимо от того, на каком этаже разбилось яйцо №1.
- Допустим, что за каждый бросок яйцо №1 «делает» один шаг (этаж), а яйцо №2 перемещается на один шаг меньше.
- Нужно каждый раз сокращать на единицу количество бросков, потенциально необходимых яйцу №2. Если яйцо №1 бросается сначала с 20-го, а потом с 30-го этажа, то яйцу №2 понадобится не более 9 бросков. Когда мы бросаем яйцо №1 в очередной раз, то должны снизить количество бросков яйца №2 до 8. Для этого достаточно бросить яйцо №1 с 39 этажа.
- Мы знаем, что яйцо №1 должно стартовать с этажа X, затем спуститься на X-1 этажей, затем — на X-2 этажей, пока не будет достигнуто число 100.
- Можно вывести формулу, описыващее наше решение: X + (X — 1) + (X — 2) + … + 1 = 100 -> X = 14.
- Если первый элемент столбца больше х, то х находится в колонке слева.
- Если последний элемент столбца меньше х, то х находится в колонке справа.
- Если первый элемент строки больше х, то х находится в строке, расположенной выше.
- Если последний элемент строки меньше х, то х находится в строке, расположенной ниже.
- если у a и b разные знаки:
- // если a > 0 , то b < 0 и k = 1 .
- // если a < 0 , то b >0 и k = 0 .
- // так или иначе, k = sign(a)
- пусть k = sign(a)
- иначе пусть k = sign(a - b) // переполнение невозможно
- Выполнить операцию 759 + 674, забыв о переносе. В результате получится 323.
- Выполнить операцию 759 + 674, но сделать только переносы (без суммирования разрядов). В результате получится 1110.
- Теперь нужно сложить результаты первых двух операций (используя тот же механизм, описанный в шагах 1 и 2): 1110 + 323 = 1433.
- Если просуммировать пару двоичных чисел, без учета переноса знака, то i-й просуммированный бит может быть нулевым, только если i-e биты чисел a и b совпадали (оба имели значение 0 или 1). Это классическая операция XOR.
- Если суммировать пару чисел, выполняя только перенос, то i-му биту суммы присваивается значение 1, только если i-1-е биты обоих чисел (a и b) имели значение 1. Это операция AND со смещением.
- Нужно повторять эти шаги до тех пор, пока не останется переносов.
- Выберите случайный элемент в массиве и используйте его в качестве «центра». Разбейте элементы вокруг центра, отслеживая число элементов слева.
- Если слева находится ровно i элементов, вам нужно вернуть наибольший элемент.
- Если слева находится больше элементов, чем i, то повторите алгоритм, но только для левой части массива.
- Если элементов слева меньше, чем i, то повторите алгоритм справа, но ищите алгоритм с рангом i - leftSize.
- (Not) using std::thread
- std::thread
- boost::thread
- Producer-consumer problem
- Resource Acquisition Is Initialization
- Создать битовый вектор с 4 миллиардами бит. Битовый вектор — это массив, хранящий в компактном виде булевы переменные (может использоваться как int, так и другой тип данных). Каждую переменную типа int можно рассматривать как 32 бита или 32 булевых значения.
- Инициализировать битовый вектор нулями.
- Просканировать все числа (num) из файла и вызвать BV.set(num, 1) .
- Еще раз просканировать битовый вектор, начиная с индекса 0.
- Вернуть индекс первого элемента со значением 0.
- Пусть rangeSize — размер диапазонов каждого блока на первом проходе.
- Пусть arraySize — число блоков при первом проходе. Обратите внимание, что arraySize = 2 32 /rangeSize.
- Левая скобка: пока мы не израсходовали все левые скобки, мы можем вставить левую скобку.
- Правая скобка: мы можем добавить правую скобку, если добавление не приведет к синтаксической ошибке. Когда появляется синтаксическая ошибка? Тогда, когда правых скобок больше, чем левых.
- Заполните стакан водой до краев. Даже самая небольшая центробежная сила приведет к повышению уровня воды над внешним краем стакана. Из-за чего часть воды прольется. Это случится даже тогда, когда стакан «приклеен», то есть до того, как он начнет скользить.
- Используйте очень низкий стакан, к примеру, чашку Петри с каплей воды в ней. Если вы выбрали такой сосуд для эксперимента, он не перевернется и не будет двигаться настолько быстро, что единственная капля воды поднимется по его стенке и прольется. Зато чашка Петри с этой каплей просто соскользнет с диска.
- Используйте очень высокий стакан, вроде пробирки с плоским днищем. Центробежная сила фактически действует на центр тяжести. Поскольку центр тяжести в данном случае расположен высоко, а вся сила трения прикладывается в самом низу, стеклянная пробирка скорее опрокинется, чем будет скользить.
- p = p0^q0 /* 0 если р0 = q0, 1 если р0 != q0 */
- q = p^q0 /* равно значению р0 */
- 3. p = p^q /* равно значению q0 */
- p = 0 : в этом случае p0 = q0 , так как нам нужно вернуть p0 или q0 . XOR любого значения с 0 всегда дает исходное значение, поэтому результатом этой операции будет q0 (или p0 ).
- p = 1 : в этом случае p0 != q0 . Нам нужно получить 1, если q0 = 0 , и 0, если p0 = 1 . Именно такой результат получается при операции XOR любого значения с 1.
- p = 0 : так как p0 = q0 , мы хотим вернуть p0 или q0 . Выполняя 0^p0 , мы вернем p0(q0) .
- p = 1 : выполняется операция 1^p0 . В результате мы получаем инверсию p0 , что нам и нужно, так как p0 != q0 .
- Нужно использовать хорошую хеш-функцию, чтобы гарантировать, что ключи были правильно распределены. Если ключи будут плохо распределены, то возникнет множество коллизий и скорость нахождения элемента снизится.
- Независимо от того, насколько хороша наша хеш-функция, коллизии будут возникать, и мы будем нуждаться в их обработке. Это подразумевает использование цепочек связных списков (или другой метод решения проблемы).
- Можно реализовать методы динамического увеличения или уменьшения размера хэш-таблицы. Например, когда отношение количества элементов к размеру таблицы превышает определенное значение, следует увеличить размер хэш-таблицы. Это означает, что нам потребуется создать новую хэш-таблицу и передать в нее записи из старой. Поскольку это очень трудоемкий процесс, нужно сделать все возможное, чтобы размер таблицы не менялся слишком часто.
- При произвольном делении колоды вряд ли в каждой стопке окажется равное количество карт рубашками вверх (такое возможно, только если вам улыбнулась удача). Более того, все карты, лежащие рубашкой вверх, могут оказаться в одной стопке.
- В вопросе не говорится, что обе стопки должны быть равными, а только о том, что в них должно быть одинаковое количество карт рубашками вверх.
- Вы можете переворачивать карты. Конечно, у вас нет способа, подсказывающего вам, переворачиваете вы карты рубашкой вверх или вниз.
- Для каждого ID друга: int machine_index = getMachineIDForUser(personID) .
- Переходим на компьютер #machine_index.
- На этом компьютере делаем: Person friend = getPersonWithID(person_id) .
- В реальном мире происходят сбои серверов. Как это повлияет на проект?
- Как можно использовать кэширование?
- Вы производите поиск до конца графа? (Граф может быть бесконечным.) Когда нужно остановиться?
- Некоторые люди имеют больше друзей, чем другие, следовательно, более вероятно, что таким образом можно найти связь между вами и кем-то еще. Как использовать эти данные, чтобы выбрать место, где начинать обход графа?
- SlowRunner: 0 шагов внутри петли.
- FastRunner: k шагов.
- SlowRunner: отстает от FastRunner на k шагов.
- FastRunner: отстает от SlowRunner на LOOP_SIZE – K шагов.
- FastRunner нагоняет SlowRunner со скоростью 1 шаг за единицу времени.
- Создадим два указателя FastPointer и SlowPointer.
- Будем перемещать FastPointer на 2 шага, а SlowPointer на один шаг.
- Когда указатели встретятся, нужно передвинуть SlowPointer в LinkedListHead, а FastPointer оставить на том же месте.
- SlowPointer и FastPointer продолжают двигаться со своими скоростями, точка их следующей встречи будет искомым результатом.
- Открываем страницу и создаем подпись страницы, основанную на определенных подсекциях страницы и ее URL.
- Запрашиваем базу данных, чтобы увидеть, когда посещалась страница с этой подписью.
- Если элемент с такой подписью недавно проверялся, то присваиваем низший приоритет и возвращаем страницу в базу данных.
- Если элемент новый, то совершаем обход страницы и добавляем ее ссылки в базу данных.
- Ридонна
- Бавкида
- Харцея
- Вероника
- Альмадена
- Фидана
- Ридонна
- Флавия
- Принцесса Гита
- Сикарель
- -3 (если считать, что субпоследовательность не может быть пустой);
- 0 (субпоследовательность может иметь нулевую длину);
- MINIMUM_INT (для случая ошибки).
- Стек 1: [0, n/3).
- Стек 2: [n/3, 2n/3).
- Стек 3: [2n/3, n].
- Переместится назад, против движения
- Переместится вперёд, по движению
- Останется на месте
- Шаблоны C++ могут использовать примитивные типы, как, например, int , а дженерики Java — нет, они обязаны использовать Integer .
- Java позволяет указывать ограничения на тип, передаваемый в качестве параметра. Например, вы можете использовать дженерики для реализации CardDeck и указать, что параметр типа должен наследоваться от CardGame .
- В C++ можно создать экземпляр типа, передаваемого параметром, а Java — нет.
- Java не позволяет использовать типы, передаваемые параметром (например, Foo в MyClass ) для статических методов и переменных, так как они могут совместно использоваться в MyClass и MyClass . В C++ — это разные классы, поэтому тип из параметра можно использовать для статических методов и переменных.
- В Java все экземпляры MyClass , независимо от их параметров, относятся к одному и тому же типу. Параметры типов уничтожаются после компиляции. В C++ экземпляры с разными параметрами типов — различные типы.
- Открываемая коробка была выбрана случайно (например, подбросили монету) из тех двух коробок, которые вы не выбрали. Это означает, что в открытой коробке мог находиться приз, хотя, как оказалось, его не было.
- Коробка была открыта человеком, который знал, что в ней находится, и заранее планировал показать пустую коробку и он мог это сделать при любых условиях.
- В помещении никого нет.
- В помещении только Ларри.
- В помещении только Сергей.
- В помещении Ларри и Сергей.
- В помещении никого нет.
- В помещении только Ларри.
- В помещении только Сергей.
- В помещении Ларри и Сергей.
- В помещении никого нет.
- Пусть Ларри войдет в помещение.
- Пусть теперь в него войдет Сергей, чтобы получился вариант «Ларри и Сергей».
- Ларри выходит, и в помещении остается только Сергей.
- Пусть Ларри войдет в помещение.
- Пусть теперь войдет Сергей, чтобы получился вариант «Ларри и Сергей».
- Ларри выходит, и в помещении остается только Сергей.
- Эрик входит и присоединяется к Сергею.
- Ларри вошел к Сергею и Эрику.
- Сергей выходит, оставляя Ларри и Эрика.
- Ларри выходит, оставляя Эрика.
- 0000000000: помещение является пустым
- 0000000001: вошел Ларри
- 0000000011: Сергей присоединился к Ларри
- 0000000010: Ларри вышел
- 0000000110: Эрик присоединился к Сергею
- 3 a-1 · 5 · 7 c
- 3 a · 5 b-1 · 7 c
- 3 a · 5 b · 7 c-1
- 3 · (некоторое предыдущее число из числового ряда);
- 5 · (некоторое предыдущее число из числового ряда);
- 7 · (некоторое предыдущее число из числового ряда).
- 3 · предыдущий элемент;
- 5 · предыдущий элемент;
- 7 · предыдущий элемент.
- Инициализируем array и очереди Q3, Q5 и Q7.
- Вставляем 1 в array.
- Вставляем 1·3, 1·5, 1·7 в Q3, Q5 и Q7 соответственно.
- Пусть x будет минимальным элементом в Q3, Q5 и Q7.Присоединим x к magic.
- Если x находится в:
- Q3 => присоединяем x·3, x·5 и x·7 к Q3, Q5 и Q7. Удаляем x из Q3.
- Q5 => присоединяем x·5 и x·7 к Q5 и Q7. Удаляем x из Q5.
- Q7 => присоединяем x·7 к Q7. Удаляем x из Q7.
- Повторяем шаги 4-6, пока k-й элемент не будет найден.
- Нельзя использовать деление.
- Функция должна быть с наименьшими затратами памяти и времени выполнения.
- Могу ли я спрашивать дорогу у других? Могу ли я воспользоваться GPS? Имеется ли какой-то способ оценки направления или расстояния до точки B?
- Если в точку B нельзя попасть из точки A, есть ли какой-то способ, позволяющий это понять, чтобы прекратить бессмысленный поиск?
- Я должен найти точку B так быстро, как это возможно, или мне нужно постараться найти самый быстрый путь из точки A в точку B, то есть максимально короткий?
- Исходите из того, что каждый человек в экстренной ситуации хочет выбраться из города как можно быстрее. Поэтому транспортные возможности следует определять на основе рыночных подходов. Самым большим препятствием при эвакуации после урагана Катрина было то, что власти Нового Орлеана своевременно не выделили консультантов, владеющих информацией о свободных путях: они просто сами не знали, какие дороги заблокированы. Катрина ударила за год до появления Twitter и за пару лет до смартфонов, которыми можно активно пользоваться где угодно. Ваш план должен поощрять людей пользоваться Twitter или текстами, сообщающими о затруднениях на дорогах (но не сидя за рулем!), план должен предусмотреть способ быстрого появления этой информации в социальных сетях, картографических приложениях, вещательных СМИ и других подобных средствах доведения информации.
- Воспользуйтесь школьными автобусами. Общее число мест в школьных автобусах, имеющихся в стране, больше, чем во всех видах транспортных средств, используемых для массовой перевозки взрослых людей, вместе взятых. Организуйте бесплатные школьные автобусы для людей, не имеющих своих машин.
- Распределение топлива для заправочных станций региона. При эвакуации во время урагана Катрина в некоторых местах возникла нехватка топлива.
- При возникновении чрезвычайных ситуаций большинство людей не могут покинуть место достаточно быстро, но особую заботу вам следует проявить прежде всего к трем категориям жителей: тем, кто отказывается уходить; тем, кто не может эвакуироваться без помощи других (из-за инвалидности или потому, что они находятся в больницах); тем, кто ничего не слышал о призывах к эвакуации (скорее всего, многие из них бездомные или пожилые люди). Если говорить о юридических и практических вопросах, вряд ли вы можете многое сделать с теми жителями, которые предпочитают остаться. В этом случае лучше будет, если вы затратите усилия на то, чтобы сообщить людям, что у них есть соседи, которые хотят эвакуироваться, но им нужна помощь. Используйте все мини-автобусы и машины скорой помощи, поскольку в них имеются специальные приспособления для перевозки больных и инвалидов.
- Некоторые автобусы и поезда позволяют перевозить животных и чемоданы. Одна из причин, из-за которых люди заявляют, что они останутся, — беспокойство о своих животных и ценных вещах.
- При проектировании обеспечьте возможность смены направления движения всех линий транспортных артерий в направлении из города. Это увеличит мощность выезжающего транспорта и не позволит людям, не знающим о тяжелой ситуации, въезжать в город. Известная как «противоток», эта идея хорошо знакома людям, которые часто перемещаются в регионе Залива. С 1963 года на мосту «Золотые ворота» применяются полосы с меняющимся направлением движения. По утрам четыре из шести полос предназначены для движения в сторону Сан-Франциско. В остальное время суток для движения в каждую сторону, то есть и в город, и в пригороды, выделено по три полосы.
- Индекс равен количеству минут с начала торговой сессии (9:30 утра).
- Значение в массиве равно стоимости акции в это время.
- возможность получить большую прибыль при покупке по min_price и продаже по current_price.
- обновилась ли min_price новым значением после итерации.
- min_price равняется первой цене дня.
- max_profit равна первой прибыли, что мы получим.
- Объединять текущий диапазон с предыдущим, сохраняя результат на случай, если потребуется еще одно объединение.
- Сохраненный результат помещать в выходной массив merged_meetings при условии, что текущий диапазон не объединяется с предыдущим, как и все последующие.
- Указанная сумма денег.
- Массив со всеми доступными номиналами монет.
- 1, 1, 1, 1.
- 1, 1, 2.
- 1, 3.
- 2, 2.
- Левая сторона: поиск среди элементов от start до Math.min(midIndex - 1, midValue).
- Правая сторона: поиск среди элементов от Math.Max(midIndex + 1, midValue) до end .
- Целочисленное деление, или «деление с округлением вниз». У меня оно будет представлено, как обычное деление: a / b — имея в виду ⌊a / b⌋ . Например, 5 / 3 = 1 .
- Взятие остатка по модулю. Обозначу традиционно деление с остатком: a % b = a — (a / b) * b . Например, 5 % 3 = 2 .
- Поместить цикл в тело функции, а затем сделать return из неё:
- В первом случае программа завершится с ошибкой.
- Во втором случае выведется «Родительский класс».
- Присваиваем переменной c значение переменной a . Сейчас в a записана a , в b — b , а в c — a .
- Присваиваем переменной a значение переменной b . Теперь в a хранится b , в b — также b и в c — a .
- Присваиваем переменной b значение переменной c . Сейчас в a находится старое значение b , в b — a , ну и в c остаётся a .
- Присваиваем переменной a сумму значений переменных a и b . Сeйчас в a записано значение a + b , а в b всё ещё b .
- Переменной b присваиваем разность между новым значением переменной a и переменной b . В a также хранится a + b , но в b уже a .
- Наконец, присваиваем переменной a результат вычитания b из обновлённого значения a . Получается, что в a теперь содержится b , а в b — a .
- SMM-менеджер
UnyBrands Удаленная работа 100 000 – 160 000 - Специалист для настройки VDS-сервера
WISPO Удаленная работа от 2 500 - Administrative Support Manager
F`ART Удаленная работа 70 000 – 150 000 - Технический специалист по контекстной рекламе
Склифосовский ПРО Удаленная работа 20 000 – 30 000 - Специалист по контекстной рекламе
Склифосовский ПРО Удаленная работа 50 000 – 90 000 - Не используйте имен, требующих чувствительности к регистру. Компоненты должны быть годными к использованию, как в чувствительных к регистру, так и в нечувствительных к регистру языках. Нечувствительные к регистру языки не могут различить имен, различающихся только регистром. Следовательно, вы должны предупредить возникновение такой ситуации в создаваемых компонентах или классах.
- Не создавайте два пространства имен с именами, различающимися только регистром. Например, нечувствительный к регистру язык не сможет различить пространства имен, объявленные следующим образом:
- Не используйте аббревиатуры или сокращения в качестве частей имен идентификаторов. Например, используйте GetWindow вместо of GetWin.
- Используйте только общепринятые в компьютерной области акронимы.
- По возможности используйте общеизвестные акронимы для замены длинных имен. Например, используйте UI для User Interface и OLAP для On-line Analytical Processing.
- Используйте Pascal нотацию или camel нотацию для акронимов, чья длина более двух символов. Например, используйте HtmlButton или HTMLButton. Однако необходимо капитализировать акронимы, состоящие только из двух символов, например, System.IO, а не System.Io.
- Не используйте аббревиатуры в именах идентификаторов или параметров. Для аббревиатур, состоящих более, чем из двух символов, даже если это не соответствует стандартной аббревиатуре слова, используйте camel нотацию.
- В качестве имени класса используйте существительное или именную группу.
- Используйте Pascal нотацию.
- Редко используйте аббревиатуры.
- Не используйте префикс типа, такой как в C/С++, в имени класса. Например, лучше используйте имя класса FileStream, чем CFileStream.
- Не используйте символ подчеркивания (_).
- Иногда необходимо обеспечить имя класса, начинающееся с буквы I, даже если класс не является интерфейсом. Это допустимо только в случае, если слово, являющееся частью имени класса, начинается с буквы I. Например, имя класса IdentityStore.
- Где возможно, используйте составное слово в качестве имени наследуемого класса. Вторая часть имени наследуемого класса должна быть именем основного класса. Например, ApplicationException - имя, соответствующее для класса, наследуемого от класса Exception, потому что ApplicationException является разновидностью Exception. Применяйте это правило разумно. Например, Button - подходящее имя для класса, наследуемого от Control. Хотя кнопка является разновидностью элемента управления, добавление слова Control в имя класса просто излишне удлинит это имя.
- В качестве имен интерфейсов используйте существительные или именные группы, или прилагательные, описывающие поведение. Например, в имени интерфейса IComponent используется описательное существительное; в имени ICustomAttributeProvider используется именная группа; в имени IPersistable используется прилагательное.
- Используйте Pascal нотацию.
- Редко используйте аббревиатуры.
- Имя интерфейса начинайте с буквы I, чтобы обозначить то, что это интерфейс.
- Используйте подобные имена при определении пары класс/интерфейс, где класс является стандартной реализацией интерфейса. Имена должны различаться только префиксом I в имени интерфейса.
- Не используйте символ подчеркивания (_).
- Используйте Pascal нотацию для типов Enum и имен значений.
- Редко используйте аббревиатуры.
- Не используйте суффикс Enum для имен типа Enum.
- Используйте слова в единственном числе в качестве имен для большинства типов Enum, но используйте множественное число для имен типов Enum, которые являются битовыми полями.
- Всегда добавляйте FlagsAttribute в битовое поле типа Enum.
- В качестве имен статических полей используйте существительные, именные группы или аббревиатуры.
- Используйте Pascal нотацию.
- Используйте венгерскую нотация для задания префикса в именах статических полей.
- Рекомендуется по возможности использовать статические свойства вместо public статических полей.
- Используйте описательные имена параметров. Имена параметров должны быть достаточно описательными для того, чтобы по имени параметра и его типа можно было бы определить их значения в большинстве сценариев.
- Используйте Сamel нотацию для имен параметров.
- Используйте имена, описывающие значение параметра, а не его тип. Инструментальные средства разработки должны обеспечивать ясную информацию о типе параметра. Поэтому лучше использовать имя параметра, как описание. Старайтесь редко использовать имена параметров, основанные на их типе, и только в тех случаях, где это действительно необходимо.
- Не используйте зарезервированные параметры. Они являются private параметрами, которые могут быть раскрыты в будущих версиях, если понадобиться. Вместо этого, если в последующих версиях вашей библиотеки классов требуется большее количество данных, добавьте новое переопределение для метода.
- Не используйте в качестве префикса для имени параметра венгерскую нотацию.
- Используйте глаголы или глагольные группы в качестве имен методов.
- Используйте Pascal нотацию.
- Используйте существительные или именные группы в качестве имен свойств.
- Используйте Pascal нотацию.
- Не используйте венгерскую нотацию для префиксов.
- Присваивайте свойству имя, соответствующее его базовому типу. Например, если вы объявляете свойство с именем Color, имя типа этого свойства так же должно быть подобно Color.
- Используйте суффикс EventHandler в именах обработчиков событий.
- Определите два параметра с именами sender и e. Параметр sender представляет объект, который провоцирует событие. Тип параметра sender всегда object, даже если есть возможность использовать более специфический тип. Состояние, ассоциированное с событием, инкапсулировано в экземпляр класса события, названного e. В качестве типа параметра e используйте соответствующий и специфический класс события.
- В имени класса аргумента события используйте суффикс EventArgs.
- Ассоциируйте название события с глаголом.
- Используйте герундий ("ing" форму глагола), чтобы создать имя события, выражающее событие до, и используйте прошедшую форму глагола для представления события после. Например, событие Close, которое может быть отменено, должно иметь событие Closing и событие Closed. Не используйте шаблоны имен BeforeXxx/AfterXxx.
- Не используйте префикс или суффикс при декларации события в типе. Например, используйте Close вместо OnClose.
- Вы должны обеспечить protected метод с именем OnXxx в типах с событиями, которые могут быть переопределены в наследуемых классах. Этот метод должен иметь только параметр события e, потому что отправитель всегда является экземпляром типа.
- операция является преобразованием, как Object.ToString;
- операция требует довольно больших затрат, и вы хотите сообщить пользователю о том, что они должны рассмотреть возможность кеширования результата;
- получение значения свойства, используя аксессор get, будет иметь ощутимый побочный эффект;
- вызов члена два раза подряд выдает разные результаты;
- важен порядок выполнения. Обратите внимание, что свойства типа должны устанавливаться и возвращать значение в любом порядке;
- член класса статический, но возвращает значение, которое может быть изменено;
- член класса возвращает массив. Свойства, возвращающие массивы, могут быть очень обманчивыми. Обычно важно возвращать копию внутреннего массива, чтобы пользователь не мог изменить внутреннее состояние. Это в совокупности с тем фактом, что пользователь запросто может принять его, как индексированное свойство, приводит к созданию неэффективного кода. В следующем примере каждый вызов свойства Methods создает копию массива. В результате в цикле создается 2n+1 копия массива.
- используйте только одно индексированное свойство в классе и делайте его индексированным свойством по умолчанию для этого класса.
- Не используйте индексированных свойств не по умолчанию.
- Присваивайте индексированному свойству имя Item. Например, свойство DataGrid.Item. Всегда следуйте этому правилу за исключением случаев, когда существует более подходящее имя, например, такое как свойство Chars в классе String.
- Используйте индексированное свойство, когда логические члены данных свойства являются массивом.
- Не поставляйте индексированное свойство и метод, семантически эквивалентные двум или более переопределяемым методам. В следующем примере свойство Method надо заменить методом GetMethod (строка).
- Выберите имя для вашего события, руководствуясь рекомендациями, приведенными в разделе Принципы присваивания имен событиям.
- Не используйте венгерскую нотацию.
- При обращении к событиям в документации вместо выражений "событие было запущено" или "событие было инициировано" используйте фразу "событие было вызвано".
- В языках, поддерживающих ключевое слово void, используйте void тип возвращаемого результата для обработчиков событий, как показано в следующем примере кода на C#.
- Выберите имя для события на основе рекомендаций, приведенных в разделе Рекомендации по присваиванию имен методам.
- Не используйте венгерскую нотацию.
- По умолчанию методы не виртуальные. Сохраняйте это в тех ситуациях, когда нет необходимости предоставлять виртуальные методы. Более подробная информация о реализации наследования приведена в разделе Рекомендации по использованию базовых классов.
- Используйте перезагрузку метода, чтобы обеспечить различные методы, которые делают семантически одинаковые вещи.
- Используйте перезагрузку метода вместо аргументов, используемых по умолчанию. Эти аргументы плохо поддерживают версии и поэтому не допускаются в Общеязыковой спецификации (CLS). Следующий пример кода иллюстрирует перезагруженный метод String.IndexOf.
- Несколько неродственных классов хотят поддерживать протокол.
- Эти классы уже имеют установленные базовые классы (например, некоторые являются элементами управления пользовательского интерфейса (UI), а некоторые - XML Web сервисами).
- Агрегирование не подходит или не целесообразно.
- Используйте sealed классы, если нет необходимости создавать дочерние классы. От sealed класса невозможно наследоваться.
- Используйте sealed классы, если в классе есть только статические методы и свойства. Далее приведен пример корректно определенного sealed класса.
- Работает, как примитивные типы.
- Размер экземпляра менее 16 байт.
- Неизменны.
- Желательно наличие семантики значения.
- enum представляет флаги и в текущий момент существует более 32 флагов, или enum должна образовать слишком много флагов в будущем.
- тип должен быть отличным от типа int для обеспечения обратной совместимости.
- Вложенный тип логически принадлежит содержащему его типу.
- Вложенный тип используется не часто или, по крайней мере, не прямо.
- Тип используется во многих различных методах в разных классах. Примером такого типа является перечень FileMode.
- Тип обычно используется в различных API. Примером такого типа является класс StringCollection.
- Типам, чьи экземпляры копируются тогда, когда они передаются через границу AppDomain (на том же или на другом компьютере). Эти типы должны быть отмечены атрибутом Serializable.
- Типам, для которых при их передаче через границу AppDomain (на том же или на другом компьютере) среда выполнения создает прозрачный proxy объект. Эти типы конечно же должны наследоваться от класса System.MarshalByRefObject.
- Типам, которые вообще не передаются через AppDomains. Этот вид типа используется по умолчанию.
- По умолчанию экземпляры должны быть объектами, передаваемыми по значению. Это означает, что их типы должны быть обозначены, как Serializable.
- Типы компонентов должны быть объектами, передаваемыми по ссылке. Такими должны быть большинство компонентов, потому что общий базовый класс, System.Component, является классом, передаваемым по ссылке.
- Если тип инкапсулирует ресурс операционной системы, он должен быть объектом, передаваемым по ссылке. Если тип реализует интерфейс IDisposable, он весьма вероятно должен быть передаваемым по ссылке. System.IO.Stream наследуется от MarshalByRefObject. Большинство потоков, таких как FileStreams и NetworkStreams, инкапсулируют внешние ресурсы, таким образом, они должны быть объектами, передаваемыми по ссылке.
- Экземпляры, которые просто поддерживают состояние, должны быть объектами, передаваемыми по значению (как DataSet).
- Специальные типы, которые не могут быть вызваны через AppDomain (такие, как владелец статических утилитных методов), должны быть отмечены, как Serializable.
- Все куски кода, которые приводят к возникновению исключительной ситуации, должны предоставлять метод для проверки успешного завершения операции без возникновения исключительной ситуации. Например, чтобы предотвратить FileNotFoundException, вы можете вызвать File.Exists. Это не всегда может быть возможным, но целью является то, чтобы при нормальном выполнении не возникало исключительных ситуаций.
- Заканчивайте имена класса Exception суффиксом Exception, как это сделано в следующем примере:
- Когда поддерживаются Add, Remove или другие методы манипулирования коллекциями.
- Чтобы добавить обертки только для чтения для внутренних массивов.
- Определите операторы для типов значений, которые являются логическими встроенными типами языка программирования, например, как структура System.Decimal.
- Обеспечьте методы перезагрузки операторов только в тех классах, в которых определены методы.
- Используйте имена и условные обозначения сигнатур, описанные в Общеязыковой спецификации (CLS).
- Используйте перезагрузку операторов в случаях, когда сразу очевидно, что будет результат операции. Например, есть смысл иметь возможность вычитать одно значение времени Time из другого и получать промежуток времени TimeSpan. Однако неуместно использовать оператор or, чтобы создать объединение двух запросов базы данных, или использовать shift, чтобы писать в поток.
- Перезагружайте операторы симметрично. Например, если вы перезагружаете оператор равенства (==), вы также должны перезагрузить оператор неравенства (!=).
- Предоставляйте альтернативные сигнатуры. Большинство языков программирования не поддерживают перезагрузку операторов. Поэтому всегда включайте дополнительный метод с соответствующим домен-специфическим именем, который имеет эквивалентную функциональность. Это является требованием Общеязыковой спецификации (CLS). Следующий пример соответствует требованиям CLS.
- Реализуйте метод GetHashCode всегда, когда реализовываете метод Equals. Это сохраняет синхронность Equals и GetHashCode.
- Всегда переопределяйте метод Equals, когда применяете ==, и пусть они выполняют одно и то же. Это позволяет коду инфраструктуры, такому как Hashtable и ArrayList, который использует метод Equals, вести себя так же, как и код пользователя, написанный с использованием ==.
- Всегда при реализации интерфейса IComparable переопределяйте метод Equals.
- Вы должны продумать реализацию перезагрузки оператора для операторов равенства (==), неравенства (!=), меньше (<) и больше (>), когда реализовываете IComparable.
- Не формируйте исключительные ситуации из методов Equals или GetHashCode или оператора равенства (==).
- Не используйте неявное преобразование, когда оно может привести к потере точности. Например, не должно использоваться неявное преобразование Double в Int32, но допускается преобразование Int32 в Int64.
- Не формируйте исключительные ситуации из неявных преобразований, потому что разработчику очень сложно понять, что происходит.
- Поставляйте преобразования, которые действуют во всем объекте. Значение, которое преобразовывается, должно представлять весь объект, а не отдельного члена объекта.
- Не генерируйте семантически различные значения. Например, преобразование типа Time или TimeSpan в Int32 верно. Int32 отображает время или продолжительность. Однако нет смысла преобразовывать строку имени файла, например, c:\mybitmap.gif, в объект Bitmap.
- Не преобразовывайте значения из разных доменов. Преобразование действует в пределах отдельного домена значений. Например, числа и строки являются различными доменами. Имеет смысл то, что Int32 можно преобразовать в Double. Однако не имеет смысла преобразовывать Int32 в String, потому что они относятся к разным доменам.
- Применяйте метод Finalize только в тех объектах, которые требуют финализации. При использовании этого метода возникают некоторые потери производительности.
- Если вам необходим метод Finalize, вы должны рассмотреть реализацию IDisposable, чтобы дать возможность пользователям вашего класса предотвратить затраты на активизацию метода Finalize.
- Не делайте метод Finalize более видимым. Он должен быть protected, а не public.
- Метод Finalize объекта должен освобождать любые внешние ресурсы, принадлежащие объекту. Более того, метод Finalize должен освобождать только те ресурсы, которые удерживаются объектом. Метод Finalize не должен обращаться к другим объектам.
- Не делайте прямых вызовов метода Finalize в объектах, кроме объектов базового класса.
- Вызывайте метод base.Finalize из метода Finalize объекта. Примечание: Метод Finalize базового класса вызывается автоматически с синтаксисом деструктора C# и Управляемых расширений (Managed Extensions) для C++.
- Применяйте схему разработки ликвидации в типе, инкапсулирующем ресурсы, которые нуждаются в явном освобождении. Пользователи могут освобождать внешние ресурсы, вызывая public метод Dispose.
- Применяйте схему разработки ликвидации в базовом типе, обычно имеющем наследуемые типы, которые удерживают ресурсы, даже если базовый класс не делает этого. Наличие в базовом типе закрытого метода обычно свидетельствует о необходимости реализации Dispose. В таких случаях не реализуйте метод Finalize в базовом типе. Finalize должен быть реализован в любых унаследованных типах, представляющих ресурсы, которые нуждаются в очистке.
- Освобождайте все имеющиеся в распоряжении типа ресурсы в методе Dispose.
- После того, как метод Dispose был вызван в экземпляре, вызовите метод GC.SuppressFinalize, чтобы не допустить запуск метода Finalize. Исключением из этого правила является редкая ситуация, когда работа должна быть сделана в методе Finalize, который не покрывается методом Dispose.
- Вызывайте метод Dispose базового класса, если он реализует IDisposable.
- Не предполагайте, что метод Dispose будет вызван. Неуправляемые ресурсы, принадлежащие типу, также должны быть освобождены в методе Finalize на случай, если метод Dispose не вызывается.
- Формируйте ObjectDisposedException, когда ресурсы уже освобождены. Если вы решили перераспределить ресурсы после того, как объект освобожден, убедитесь что вы вызываете метод GC.ReRegisterForFinalize.
- Передавайте вызовы Dispose через иерархию базовых типов. Метод Dispose должен освободить все ресурсы, удерживаемые данным объектом и любым другим объектом, принадлежащим данному. Например, вы можете создать такой объект, как TextReader, который поддерживает объекты Stream и Encoding. Оба эти объекта создаются TextReader без ведома пользователя. Более того, и Stream, и Encoding могут запрашивать внешние ресурсы. Когда вы вызываете метод Dispose в TextReader, Dispose вызывается и в Stream и Encoding, заставляя их освободить внешние ресурсы.
- Объект не может использоваться после того, как был вызван его метод Dispose. Повторное создание объекта, который уже был ликвидирован, сложно реализовать.
- Предоставьте возможность многократного вызова метода Dispose без формирования исключительной ситуации. После первого вызова метод не должен ничего делать.
- Переопределите метод GetHashCode, чтобы предоставить возможность типу корректно работать в хэш-таблице.
- Не формируйте исключительную ситуацию в реализации метода Equals. Вместо этого возвращайте false для null аргумента.
- Следуйте контракту, определенному в методе Object.Equals, как показано ниже:
- x.Equals(x) возвращает true.
- x.Equals(y) возвращает то же значение, что и y.Equals(x).
- (x.Equals(y) && y.Equals(z)) возвращает true, если и только если x.Equals(z) возвращает true.
- Успешные вызовы x.Equals(y) возвращают одно и то же значение до тех пор, пока не модифицированы объекты, на которые ссылаются x и y.
- x.Equals(null) возвращает false.
Реализация метода Equals
В следующем примере содержатся два вызова реализации метода Equals, применяемой по умолчанию:
using System; class SampleClass < public static void Main() < Object obj1 = new Object(); Object obj2 = new Object(); Console.WriteLine(obj1.Equals(obj2)); obj1 = obj2; Console.WriteLine(obj1.Equals(obj2)); >>
В результате получим следующее:
False True
Переопределение метода Equals
В следующем примере представлены класс Point, который переопределяет метод Equals, чтобы обеспечить равенство значений, и класс Point3D, унаследованный от Point. Поскольку переопределение метода Equals в классе Point является первым в цепи наследования, метод Equals базового класса (который наследуется от Object и проверяет ссылочное равенство) не вызывается. Однако Point3D.Equals вызывает Point.Equals, потому что класс Point реализовывает метод Equals так, что обеспечивается равенство значений.
using System; class Point: object < int x, y; public override bool Equals(Object obj) < // Check for null values and compare run-time types. if (obj == null || GetType() != obj.GetType()) return false; Point p = (Point)obj; return (x == p.x) && (y == p.y); >public override int GetHashCode() < return x ^ y; >> class Point3D: Point < int z; public override bool Equals(Object obj) < return base.Equals(obj) && z == ((Point3D)obj).z; >public override int GetHashCode() < return base.GetHashCode() ^ z; >>
Метод Point.Equals проверяет наличие аргумента obj и то, что он ссылается на экземпляр того же типа, что и данный объект. Если одна из этих проверок не удается, метод возвращает значение false. Метод Equals использует метод Object.GetType для того, чтобы определить идентичность типов времени выполнения этих двух объектов. Обратите внимание, что typeof (TypeOf в Visual Basic) здесь не используется, потому что он возвращает статический тип. Если вместо этого метод использовал проверку в форме obj is Point, в результате проверки будет возвращено значение true в случаях, когда obj является экземпляром класса, наследуемого от Point, даже если obj и текущий экземпляр не одного типа времени выполнения. Установив, что эти два объекта имеют один и тот же тип, метод приводит obj к типу Point и возвращает результат сравнения переменных экземпляра двух объектов.
В Point3D.Equals унаследованный метод Equals вызывается первым. Метод Equals проверяет, существует ли obj, является ли obj экземпляром того же класса, что и данный объект, и совпадают ли переменные экземпляра. Только когда унаследованный Equals возвращает значение true, метод сравнивает переменные экземпляра, представленные в дочернем классе. В частности, приведение к Point3D не производится до тех пор, пока не будет определено, что obj имеет тип Point3D или является классом, унаследованным от Point3D.
Использование метода Equals для сравнения переменных экземпляра
В предыдущем примере оператор равенства (==) используется для сравнения переменных отдельного экземпляра. В некоторых случаях для сравнения переменных экземпляра в реализации Equals лучше использовать метод Equals, как показано в следующем примере.
using System; class Rectangle < Point a, b; public override bool Equals(Object obj) < if (obj == null || GetType() != obj.GetType()) return false; Rectangle r = (Rectangle)obj; // Use Equals to compare instance variables. return a.Equals(r.a) && b.Equals(r.b); >public override int GetHashCode() < return a.GetHashCode() ^ b.GetHashCode(); >>
Перезагрузка оператора равенства (==) и метода Equals
В некоторых языках программирования, таких как С#, поддерживается перезагрузка оператора. Когда тип перезагружает оператор ==, чтобы обеспечить те же функциональные возможности, должен быть переопределен и метод Equals. Это обычно достигается путем написания метода Equals в терминах перезагруженного оператора равенства (==), как показано в следующем примере.
public struct Complex < double re, im; public override bool Equals(Object obj) < return obj is Complex && this == (Complex)obj; >public override int GetHashCode() < return re.GetHashCode() ^ im.GetHashCode(); >public static bool operator ==(Complex x, Complex y) < return x.re == y.re && x.im == y.im; >public static bool operator !=(Complex x, Complex y) < return !(x == y); >>
Т.к. Complex является структурой, известно, что ни один класс не будет наследоваться от Complex. Поэтому методу Equals не надо сравнивать результаты GetType для каждого объекта. Вместо этого он использует оператор is, чтобы проверить тип параметра obj.
Использование функции обратного вызова
Делегаты, интерфейсы и события дают вам возможность предоставить функциональные возможности обратного вызова. Каждый тип имеет свои собственные характеристики использования, которые делают их более пригодными для отдельных ситуаций.
- Метод открыто используется для функции обратного вызова, обычно через отдельные методы Add и Remove.
- Обычно более, чем один объект, запрашивают нотификацию события.
- Вы хотите, чтобы конечный пользователь имел возможность запросто добавлять приемник в нотификацию в визуальном дизайнере.
- Вы хотите иметь указатель функции в стиле языка С
- Вы хотите иметь простую функцию обратного вызова.
- Вы хотите чтобы регистрация происходила в вызове или во время построения, а не через отдельный метод Add.
Используйте интерфейсы, если функция обратного вызова требует комплексного поведения.
Использование ожиданий (Time-Out)
Используйте ожидания, чтобы определить максимальное время ожидания завершения вызова метода.
Ожидания должны принять форму параметра вызова метода, как показано ниже.
server.PerformOperation(timeout);
Ожидания могут использоваться, как свойство серверного класса, как показано ниже.
server.Timeout = timeout; server.PerformOperation();
Вы должны отдать предпочтение второму подходу, потому что в этом случае более ясна связь между операцией и ожиданием. Подход, основанный на свойстве, предпочтительнее, если серверный класс разрабатывается для того, чтобы использоваться компонентом в визуальных дизайнерах.
Исторически сложилось, что ожидания представляются целыми числами. В этом случае сложно определить единицы измерения ожидания, и трудно перевести единицы времени в миллисекунды, которые обычно используются.
Лучшим подходом является использование в качестве типа ожидания структуры TimeSpan. Применение TimeSpan решает проблемы с целочисленными ожиданиями, о которых шла речь ранее. Далее приведен пример того, как использовать ожидание типа TimeSpan.
public class Server < void PerformOperation(TimeSpan timeout) < // Insert code for the method here. >> public class TestClass
Когда задано TimeSpan(0), если операция не завершается немедленно, метод формирует исключительную ситуацию. Если ожидание задано TimeSpan.MaxValue, операция будет ожидать постоянно, как будто ожидание не задано. Не требуется, чтобы серверный класс поддерживал какое-то из этих значений, но он должен формировать исключительную ситуацию InvalidArgumentException в случае, если ожиданию задается значение, не поддерживаемое классом.
Если время ожидания закончено и сформировалась исключительная ситуация, серверный класс должен отменить эту операцию.
Если используется ожидание, применяемое по умолчанию, серверный класс должен включать статическое свойство defaultTimeout, которое используется, если пользователь не задал ожидания. В следующем примере в код включено статическое свойство OperationTimeout типа TimeSpan, которое возвращает defaultTimeout.
class Server < TimeSpan defaultTimeout = new TimeSpan(1000); void PerformOperation() < this.PerformOperation(OperationTimeout); >void PerformOperation(TimeSpan timeout) < // Insert code here. >TimeSpan OperationTimeout < get < return defaultTimeout; >> >
Типы, которые не могут обеспечить разрешения, установленного в TimeSpan, должны округлять значение ожидания до ближайшего промежутка, который может быть обеспечен. Например, тип, который может обеспечить разрешение в одну секунду, должен округлять к ближайшей секунде. Исключением из этого правила является округление в нуль. В таком случае ожидание должно округляться до минимально возможного значения. Предотвращение округления в нуль предупреждает возникновение циклов активного ожидания, когда нулевое ожидание приводит к 100% использованию мощности процессора
Вместо того, чтобы возвращать ошибку кода при окончании периода ожидания, рекомендуется формировать исключительную ситуацию. Истечение периода ожидания означает, что операция не может быть успешно завершена и поэтому должна рассматриваться и обрабатываться, как любая другая ошибка времени выполнения. Более подробно смотри в разделе Рекомендации по формированию и обработке ошибок.
В случае асинхронных операций с ожиданиями, при первом доступе к результатам операции должна вызываться функция обратного вызова и формироваться исключительная ситуация. Это проиллюстрировано в следующем примере кода.
void OnReceiveCompleted(Object sender, ReceiveAsyncEventArgs asyncResult) < MessageQueue queue = (MessageQueue) sender; // The following code will throw an exception // if BeginReceive has timed out. Message message = queue.EndReceive(asyncResult.AsyncResult); Console.WriteLine("Message: " + (string)message.Body); queue.BeginReceive(new TimeSpan(1,0,0)); >Дополнительная информация представлена в разделе Рекомендации по асинхронному программированию.
Безопасность библиотек классов
Разработчики библиотеки классов должны понимать, как обеспечить защиту доступа к коду для того, чтобы писать защищенные библиотеки классов. При написании библиотеки классов учитывайте два принципа безопасности: защищайте объекты, применяя права доступа, и пишите полностью надежный код. Степень применения этих принципов будет зависеть от того, какой класс вы создаете. Некоторые классы, такие как класс System.IO.FileStream, представляют объекты, которые необходимо защищать путем применения прав доступа. Реализация этих классов проверяет права доступа пользователей и только зарегистрированным пользователям позволяется осуществлять те операции, на которые они имеют разрешение. Пространство имен System.Security содержит классы, которые могут помочь вам осуществить эти проверки в создаваемых библиотеках классов. Код библиотеки классов часто является полностью надежным или, по крайней мере, высоконадежным. Т.к. код библиотеки классов часто работает с защищенными ресурсами и неуправляемым кодом, любые дефекты кода представляют серьезную угрозу целостности внутренней системы безопасности. Чтобы минимизировать эту угрозу, при написании кода библиотеки классов следуйте рекомендациям, приведенным в данном разделе. Более подробная информация представлена в разделе MSDN Writing Secure Class Libraries.
Применение прав доступа для защиты объектов
Права доступа применяются для обеспечения безопасности определенных ресурсов. Библиотека классов, которая работает с защищенными ресурсами, должна отвечать за осуществление этой защиты. Перед проведением любого действия над защищенным ресурсом, например, уничтожение файла, код библиотеки классов сначала должен проверить, а имеет ли пользователь соответствующие права на уничтожение ресурса. Если пользователь имеет разрешение, действию может быть позволено завершиться. Если пользователь не имеет такого права, действие не будет завершено и должна будет вызвана исключительная ситуация безопасности. Защита обычно применяется в коде как с декларативной, так и с обязательной проверкой соответствующего разрешения.
Очень важным является то, что классы защищают ресурсы не только от прямого доступа, но и от всех возможных видов воздействия. Например, объект, кэширующий файл, несет ответственность за проверку разрешения на чтение файла, даже если реальные данные извлекаются из кэша в памяти и не происходит никакой фактической работы с файлом. Это происходит потому, что эффект от передачи данных пользователя такой же, как и в случае, если он осуществил фактическую операцию чтения.
Полностью надежный код библиотеки классов
Многие библиотеки классов реализовываются, как полностью надежный код, который инкапсулирует функциональные возможности, специфические для конкретной платформы, как управляемые объекты, такие как СОМ или system APIs. Полностью надежный код может привести к ослаблению безопасности всей системы. Однако, если библиотеки классов написаны правильно, с учетом безопасности, размещение мощного груза безопасности в относительно небольшом наборе библиотек классов и основная безопасность времени выполнения дает возможность большему количеству управляемого кода получить преимущества безопасности этих корневых библиотек классов.
- Пользователь запрашивает удаление файла c:\test.txt вызывая метод File.Delete.
- Метод Delete создает разрешающий объект, представляющий разрешение на удаление c:\test.txt.
- Код класса File проверяет всех пользователей в стеке на наличие у них необходимого разрешения; если такого разрешения нет, возникает исключительная ситуация безопасности.
- Класс File объявляет FullTrust, для того чтобы вызвать внутренний код, потому что его пользователи могут не иметь разрешения на это.
- Чтобы осуществить операцию удаления файла, класс File использует внутренний API.
- Класс File возвращается его пользователям, и запрос на удаление файла завершается успешно.
Меры предосторожности для высоконадежного кода
Код в надежной библиотеке классов имеет права, недоступные большинству кодов приложений. Кроме того, сборка может содержать классы, которые не нуждаются в специальных правах, а сами предоставляют эти права, потому что сборка содержит и другие классы, которым они нужны. Такая ситуация может привести к ослаблению безопасности системы. Поэтому необходимо быть особо аккуратным при написании высоко или полностью надежного кода.
Разрабатывайте надежный код таким образом, чтобы его мог вызвать любой код системы, обладающий частичной надежностью, без создания пробелов в системе безопасности. Обычно ресурсы защищаются методом проверки прав пользователей. Если пользователь не обладает соответствующим разрешением, попытка доступа блокируется. Однако как только надежный код предоставляет разрешение, код принимает ответственность за проверку на наличие необходимого права доступа. Обычно предоставление разрешения должно следовать за проверкой пользователя на наличие разрешения, как было описано выше. Кроме того, количество предоставления высоких полномочий должно быть минимальным, для того чтобы сократить риск несанкционированных воздействий.
Полностью надежному коду неявно предоставляются все остальные права. Кроме того, ему позволено нарушать правила безопасности типов и использования объектов. Независимость защиты ресурсов, любой аспект программного интерфейса, который может разрушить безопасность типов или предоставить возможность доступа к данным, обычно недоступным, могут привести к проблемам безопасности.
Производительность
Проверка безопасности приводит к проверке стека на наличие разрешения у всех пользователей. В зависимости от глубины стека эти операции потенциально требуют очень больших затрат производительности. Если одна операция в действительности состоит из некоторого числа действий на нижнем уровне, который требует проверки безопасности, значительно увеличить производительность можно путем разовой проверки всех разрешений пользователя, а потом перед осуществлением определенных действий подтверждать необходимое разрешение. Подтверждение остановит дальнейшее прохождение по стеку, таким образом проверка будет остановлена и будет успешной. Обычно применение этой технологии приводит к увеличению производительности, если есть возможность объединить три и более проверки.
Заключение
- Любая библиотека классов, которая использует защищенные ресурсы, должна гарантировать, что это происходит только при наличии разрешений у всех пользователей.
- Утверждение разрешений должно проводиться только по необходимости, и ему должны предшествовать необходимые проверки разрешений.
- Чтобы повысить производительность, сгруппируйте операции, которые вызовут проверки безопасности, и продумайте использование подтверждения, чтобы ограничить пробег по стеку без снижения безопасности.
- Отдавайте себе отчет в том, как может злонамеренный пользователь использовать класс, чтобы обойти систему безопасности.
- Не принимайте, что код будет вызываться только пользователями с определенными правами.
- Не определяйте интерфейсы, не обеспечивающие безопасность типов, они могут быть использованы для обхода системы безопасности.
- Не открывайте функциональные возможности в классе, это позволит злонамеренному пользователю воспользоваться преимуществами высокой надежности класса.
Рекомендации по организации поточной обработки
- Избегайте использования статических методов, которые изменяют статическое состояние. В обычных серверных сценариях статическое состояние используется совместно через запросы, это означает, что этот код одновременно могут выполнять множество потоков. Это делает возможными сбои в организации поточной обработки. Рассмотрите использование схемы разработки, при которой данные инкапсулируются в экземпляры, которые не используются совместно через запросы.
- Статическое состояние должно быть потокобезопасным.
- Состояние экземпляра не нуждается в потокобезопасности. По умолчанию библиотека не является потокобезопасной. Добавление блокировок для создания потокобезопасного кода снижает производительность, увеличивает конфликты между блокировками и создает условия для возникновения зависаний. В обычных моделях приложений только один поток выполняет пользовательский код в единицу времени. Это минимизирует потребность в потокобезопасности. Поэтому .NET Framework непотокобезопасна по умолчанию. Если вы хотите обеспечить потокобезопасную версию, используйте метод GetSynchronized, чтобы вернуть потокобезопасный экземпляр типа. В качестве примера рассмотрите пространство имен System.Collections.
- Разрабатывайте библиотеку классов с учетом пиковых нагрузок в серверном сценарии. По возможности избегайте применения блокировок.
- Осмыслите, как осуществляются вызовы методов в блокированных секциях. Когда статический метод в классе А вызывает статический метод класса В и наоборот, могут возникать зависания. Если классы А и В синхронизируют свои статические методы, это приведет к зависанию. Вы сможете обнаружить это зависание только во время пиковых нагрузок. Проблемы с производительностью могут возникнуть, когда статический метод в классе А вызывает статический метод класса А. Если эти методы неправильно спроектированы, страдает производительность, потому что будет большое количество избыточной синхронизации. Чрезмерное использование синхронизации может иметь негативное воздействие на производительность. Кроме того, это может иметь существенное отрицательное влияние на масштабируемость. Имейте ввиду проблемы с оператором lock (SyncLock в Visual Basic). Довольно заманчиво использовать оператор lock для решения всех проблем с организацией поточной обработки. При проверке кода вы должны остерегаться таких экземпляров, как тот, который показан в следующем примере.
lock(this)Для увеличения производительности, необходимо заменить этот код System.Threading.Interlocked.Increment(myField); То же косается и следующего примера. Вместо этого кода:
if (x == null) < lock (this) < if (x == null) < x = y; >> >
System.Threading.Interlocked.CompareExchange(ref x, y, null);
Рекомендации по асинхронному программированию
Асинхронное программирование поддерживается многими областями общеязыковой среды выполнения, такими как Remoting, ASP.NET и Windows Forms. Асинхронное программирование является центральной идеей .NET Framework. В этом разделе приведены схемы разработки для асинхронного программирования.
- Клиент должен решить, должен ли отдельный вызов быть асинхронным.
- Необязательно дополнительно программировать сервер, чтобы поддерживать асинхронное поведение его клиента. Среда выполнения сможет различить представления клиента и сервера. В результате исключена ситуация, в которой сервер должен реализовывать IDispatch и делать большую работу для поддержания динамических вызовов клиента.
- Сервер может выбрать явную поддержку асинхронного поведения по двум причинам: или потому, что он может реализовать асинхронное поведение более эффективно, чем вся архитектура, или потому, что он захочет поддерживать только асинхронное поведение своими клиентами. Таким серверам для раскрытия асинхронных операций рекомендуется следовать схеме разработки, приведенной в этом документе.
- Безопасность типов обязательна.
- Среда выполнения предоставляет необходимые сервисы для поддержки модели асинхронного программирования. Эти сервисы включают следующее:
- Базовые элементы синхронизации, такие как критические секции и экземпляры ReaderWriterLock.
- Структурные компоненты синхронизации, такие как контейнеры, которые поддерживают метод WaitForMultipleObjects.
- Пулы потоков.
- Открытость базовой инфраструктуре, например, объектам Message и ThreadPool.
Схемы разработки для асинхронного программирования
Следующий пример демонстрирует серверный класс:
public class PrimeFactorizer < public bool Factorize(long factorizableNum, ref long primefactor1, ref long primefactor2) < primefactor1 = 1; primefactor2 = factorizableNum; // Factorize using a low-tech approach. for (int i=2;i
В следующем примере показан клиент, определяющий шаблон для асинхронного вызова метода Factorize из класса PrimeFactorizer предыдущего примера.
// Define the delegate. public delegate bool FactorizingCallback(long factorizableNum, ref long primefactor1, ref long primefactor2); // Create an instance of the Factorizer. PrimeFactorizer pf = new PrimeFactorizer(); // Create a delegate on the Factorize method on the Factorizer. FactorizingDelegate fd = new FactorizingDelegate(pf.Factorize);
Компилятор создаст следующий класс FactorizingCallback после синтаксического разбора его определения в первой строке предыдущего примера. Будут сгенерированы методы BeginInvoke и EndInvoke.
public class FactorizingCallback : Delegate < public bool Invoke(ulong factorizableNum, ref ulong primefactor1, ref ulong primefactor2); // Supplied by the compiler. public IAsyncResult BeginInvoke(ulong factorizableNum, ref unsigned long primefactor1, ref unsigned long primefactor2, AsyncCallback cb, Object AsyncState); // Supplied by the compiler. public bool EndInvoke(ref ulong primefactor1, ref ulong primefactor2, IAsyncResult ar); >
Интерфейс, используемый как параметр делегата в следующем примере, определен в библиотеке классов .NET Framework.. Подробнее смотри в разделе MSDN IAsyncResult Interface.
public delegate AsyncCallback (IAsyncResult ar); public interface IAsyncResult < // Returns true if the asynchronous operation has completed. bool IsCompleted < get; >// Caller can use this to wait until operation is complete. WaitHandle AsyncWaitHandle < get; >// The delegate object for which the async call was invoked. Object AsyncObject < get; >// The state object passed in through BeginInvoke. Object AsyncState < get; >// Returns true if the call completed synchronously. bool CompletedSynchronously < get; >>
Обратите внимание, что объект, реализующий интерфейс IAsyncResult, должен быть объектом ожидания (waitable) и его базовые элементы синхронизации должны быть уведомлен после отмены или завершения вызова. Это дает возможность клиенту ожидать окончания вызова, вместо проведения опроса. Среда выполнения поставляет большое количество объектов ожидания, которые зеркально отображают базовые элементы синхронизации Win32, такие как ManualResetEvent, AutoResetEvent и Mutex.
Метод Cancel - это запрос на отмену обработки метода после того, как закончился программный период ожидания. Обратите внимание, что это только запрос клиента, и серверу рекомендуется принимать его на обработку. Далее клиент не должен принимать того, что сервер полностью остановил обработку запроса после получения нотификации об отмене метода. Другими словами, клиенту рекомендуется не уничтожать такие ресурсы, как объекты файла, потому что сервер в данный момент может активно их использовать. Свойству IsCanceled будет присвоено значение true, если вызов был отменен, и свойству IsCompleted будет присвоено значение true после того, как сервер закончит обработку вызова. После того, как сервер присвоит свойству IsCompleted значение true, сервер не сможет использовать никакие предоставленные клиентом ресурсы вне обусловленной семантики совместного использования. Таким образом, клиент может безопасно уничтожать ресурсы после того, как свойство IsCompleted возвращает true.
Свойство Server возвращает серверный объект, который предоставил IAsyncResult.
Следующий пример демонстрирует программную модель со стороны клиента для асинхронного вызова метода Factorize.
public class ProcessFactorizeNumber < private long _ulNumber; public ProcessFactorizeNumber(long number) < _ulNumber = number; >[OneWayAttribute()] public void FactorizedResults(IAsyncResult ar) < long factor1=0, factor2=0; // Extract the delegate from the AsynchResult. FactorizingCallback fd = (FactorizingCallback) ((AsyncResult)ar).AsyncDelegate; // Obtain the result. fd.EndInvoke(ref factor1, ref factor2, ar); // Output the results. Console.Writeline("On CallBack: Factors of : ", _ulNumber, factor1, factor2); > > // Async Variation 1. // The ProcessFactorizeNumber.FactorizedResults callback function // is called when the call completes. public void FactorizeNumber1() < // Client code. PrimeFactorizer pf = new PrimeFactorizer(); FactorizingCallback fd = new FactorizingCallback(pf.Factorize); long factorizableNum = 1000589023, temp=0; // Create an instance of the class that // will be called when the call completes. ProcessFactorizedNumber fc = new ProcessFactorizedNumber(factorizableNum); // Define the AsyncCallback delegate. AsyncCallbackDelegate cb = new AsyncCallback(fc.FactorizedResults); // Any object can be the state object. Object state = new Object(); // Asynchronously invoke the Factorize method on pf. // Note: If you have pure out parameters, you do not need the // temp variable. IAsyncResult ar = fd.BeginInvoke(factorizableNum, ref temp, ref temp, cb, state); // Proceed to do other useful work. // Async Variation 2. // Waits for the result. // Asynchronously invoke the Factorize method on pf. // Note: If you have pure out parameters, you do not need // the temp variable. public void FactorizeNumber2() < // Client code. PrimeFactorizer pf = new PrimeFactorizer(); FactorizingCallback fd = new FactorizingCallback(pf.Factorize); long factorizableNum = 1000589023, temp=0; // Create an instance of the class // to be called when the call completes. ProcessFactorizedNumber fc = new ProcessFactorizedNumber(factorizableNum); // Define the AsyncCallback delegate. AsyncCallback cb = new AsyncCallback(fc.FactorizedResults); // Any object can be the state object. Object state = new Object(); // Asynchronously invoke the Factorize method on pf. IAsyncResult ar = fd.BeginInvoke(factorizableNum, ref temp, ref temp, null, null); ar.AsyncWaitHandle.WaitOne(10000, false); if(ar.IsCompleted) < int factor1=0, factor2=0; // Obtain the result. fd.EndInvoke(ref factor1, ref factor2, ar); // Output the results. Console.Writeline("Sequential : Factors of : ", factorizableNum, factor1, factor2); > >Обратите внимание, что если FactorizeCallback является контекстно-ограниченным классом, который требует синхронизированного или потоко-родственного контекста, функция обратного вызова отправляется через инфраструктуру диспетчера контекста. Иначе говоря, сама функция обратного вызова для таких контекстов может выполняться асинхронно в зависимости от ее вызывающей функции. Это семантика одностороннего классификатора сигнатур метода. Любой такой вызов метода может выполняться синхронно или асинхронно в зависимости от вызывающей функции, и вызывающая функция не может делать никаких предположений о завершении такого вызова, когда контроль за выполнением возвращается к нему.
Вызов EndInvoke до завершения асинхронной операции также заблокирует вызывающую функцию. Повторный его вызов с тем же AsyncResult не определен.
Заключение
Сервер разбивает любую асинхронную операцию на две логические части: часть, которая принимает входной сигнал от клиента и начинает асинхронную операцию, и часть, которая поставляет результаты асинхронной операции клиенту. Кроме входного сигнала, необходимого асинхронной операции, первая часть также выбирает объект AsyncCallbackDelegate, который должен будет вызываться после завершения асинхронной операции. Первая часть возвращает объект ожидания, который реализует интерфейс IAsyncResult, используемый клиентом для определения статуса асинхронной операции. Обычно сервер также использует объект ожидания, который он возвращает клиенту, чтобы поддерживать любое состояние, связанное с асинхронной операцией. Клиент использует вторую часть, чтобы получить результаты асинхронной операции, поставляя объект ожидания.
При инициировании асинхронных операций клиент может поставлять или не поставлять делегата функции обратного вызова.
- Опросите возвращенный объект IAsyncResult на наличие завершения.
- Попытайтесь завершить операцию преждевременно, таким образом создавая блокировку до тех пор, пока операция завершается.
- Ожидайте объект IAsyncResult. Различие между этой и предыдущим вариантом в том, что клиент может использовать ожидания для того, чтобы периодически получать контроль выполнения.
- Завершите операцию внутри процедуры функции обратного вызова.
Один сценарий, в котором желательны и синхронные, и асинхронные методы чтения и записи, - это использование ввода/вывода (input/output) файла. Следующий пример иллюстрирует схему разработки, показывая как объект File реализует операции чтения и записи.
public class File < // Other methods for this class go here. // Synchronous read method. long Read(Byte[] buffer, long NumToRead); // Asynchronous read method. IAsyncResult BeginRead(Byte[] buffer, long NumToRead, AsyncCallbackDelegate cb); long EndRead(IAsyncResult ar); // Synchronous write method. long Write(Byte[] buffer, long NumToWrite); // Asynchrnous write method. IAsyncResult BeginWrite(Byte[] buffer, long NumToWrite, AsyncCallbackDelegate cb); long EndWrite(IAsyncResult ar); >
Клиент не может просто ассоциировать состояние с данной асинхронной операцией без определения нового делегата функции обратного вызова для каждой операции. Этот недостаток может быть устранен путем вынуждения методов Begin, таких как BeginWrite, принимать параметр дополнительного объекта, который представляет состояние.
Приложение А. Методы повышения производительности .NET приложений
Этот раздел адресован разработчикам, желающим достигнуть оптимальной производительности приложений в управляемом мире. Приведены образцы кода, описания и рекомендации разработки для баз данных, Windows Forms и ASP приложений.
Обзор
Этот раздел создан как руководство для разработчиков, создающих приложения для .NET и ищущих различные способы улучшения производительности. Если даже вы новичок в .NET, для работы с этим разделом вы должны знать и платформу, и выбранный язык программирования. Материал в данном разделе изложен, исходя из предположения, что программист уже знает достаточно, чтобы понять процесс выполнения программы. Если вы хотите перенести существующее приложение в .NET, предварительно будет полезным прочитать этот раздел. Некоторые из подсказок, приведенных здесь, полезны во время разработки и предоставляют информацию, которую необходимо знать до того, как вы начнете перенос.
Этот раздел состоит из нескольких частей, в которых подсказки организованы в соответствии с типами проектов и категориями разработчиков. Первый набор подсказок относится к любому языку программирования и содержит совет, который поможет вам в любом языке программирования Общеязыковой среды выполнения (CLR). Далее следуют подсказки для ASP.NET.
Из-за сжатых сроков, первая версия среды выполнения должна сначала была обеспечить самые широкие функциональные возможности, а затем работать с особыми случаями оптимизации. В результате существует несколько моментов, в которых возникают проблемы с производительностью. По существу, этот раздел рассматривает несколько возможностей выхода из этих ситуаций. Эти подсказки скорее всего не будут нужны в следующей версии, т.к. такие случаи систематически выявляются и оптимизируются.
Рекомендации по повышению производительности для всех приложений
Здесь приведено несколько подсказок, которые следует учитывать при работе с любым языком программирования в CLR. Они подходят для любого из них и должны быть первоочередными средствами борьбы с проблемами производительности.
Формируйте меньшее количество исключительных ситуаций
Формирование исключительной ситуации может требовать очень больших затрат производительности, так что убедитесь, что вы не формируете их слишком много. Чтобы увидеть, сколько исключительных ситуаций формирует ваше приложение, используйте Perfmon. Вы будете удивлены обнаружив, что определенные области вашего приложения формирует больше исключительных ситуаций, чем вы ожидали. Для большей конкретизации вы также можете проверить их количество программно, применяя Performance Counters (Счетчики производительности).
Обнаружение и удаление кода, формирующего большое количество исключительных ситуаций, может привести к большому выигрышу в производительности. Помните, что не надо ничего делать с блоками try/catch: вы несете потери только при формировании фактической исключительной ситуации. Вы можете использовать столько блоков try/catch, сколько хотите. Использование исключительных ситуаций неоправданно там, где вы теряете производительность. Например, вы должны избегать использования исключительных ситуаций для формирования управляющей логики.
Вот простой пример того, как дороги могут быть исключительные ситуации: мы просто попытаемся прогнать цикл For, генерируя тысячи исключительных ситуаций и обрабатывая их. Попытайтесь закомментировать оператор throw и вы увидите разницу в скорости: эти исключительные ситуации приводят к гигантским непроизводительным издержкам.
public static void Main(string[] args) < int j = 0; for(int i = 0; i < 10000; i++)< try< j = i; throw new System.Exception(); >catch <> > System.Console.Write(j); return; >
- Будьте внимательны! Среда выполнения может самостоятельно формировать исключительные ситуации! Например, Response.Redirect() формирует исключительную ситуацию ThreadAbort. Даже если вы явно не формируете исключительную ситуацию, вы, возможно, используете функции, которые делают это. Используйте Perfmon, чтобы получить представление о реальной ситуации, и отладчик, чтобы найти источник.
- Для разработчиков Visual Basic: Visual Basic включает проверку int по умолчанию, чтобы гарантировать формирование исключительных ситуаций в случае возникновения таких ситуаций, как переполнение и деление на нуль. Возможно, вы захотите отключить эту возможность, чтобы выиграть в производительности.
- Используя СОМ, вы должны помнить, что HRESULTS могут возвратиться как исключительные ситуации. Убедитесь, что вы внимательно отслеживаете это.
Делайте емкие вызовы
Емкий вызов - это вызов функции, который выполняет несколько задач, так же как метод, инициализирующий несколько полей объекта. Его надо рассматривать в противопоставлении неёмкому вызову, который выполняет очень простые задачи и использует для этого множество вызовов (например, установка каждого поля объекта отдельным вызовом). В методах, в которых непроизводительные расходы выше, чем для простых вызовов методов внутри AppDomain, важно делать емкие вызовы. Вызовы P/Invoke, interop и remoting приводят к непроизводительным расходам и вы хотите пореже их использовать. В каждом из этих случаев надо попытаться спроектировать приложение так, чтобы оно не использовало маленькие, частые вызовы, которые приводят к таким большим непроизводительным расходам.
- Осуществить маршаллинг данных
- Настроить соглашение о вызовах
- Защитить регистры, сохраняемые вызываемым объектом
- Переключить режим потока таким образом, чтобы GC не блокировал неуправляемые потоки
- Установить оболочку, обрабатывающую исключительные ситуации, на вызовы в управляемом коде
- Заняться управлением потоков (необязательно)
Чтобы уменьшить время перехода через границы, старайтесь по возможности пользоваться P/Invoke. Непроизводительные расходы соответствуют 31 команде плюс затраты на маршаллинг, если нужен маршаллинг данных, и только 8 в противоположном случае. Взаимодействие СОМ намного более дорого, более 65 команд.
Маршаллинг данных не всегда требует больших затрат. Примитивным типам вообще не нужен маршаллинг, также дешевы классы с четкой компоновкой. Реальное снижение производительности происходит во время преобразования данных, например, конвертации текста из ASCI в Unicode. Убедитесь, что данные, передаваемые через границы управляемого кода преобразуются только в том случае, если это необходимо: может оказаться, что просто соглашаясь на определенный тип данных или формат в вашей программе, вы можете избежать больших затрат на маршаллинг.
Следующие типы называют блитируемыми, имея ввиду, что их можно копировать прямо через управляемую/неуправляемую границу вообще без маршаллинга: sbyte, byte, short, ushort, int, uint, long, ulong, float и double. Вы можете свободно передавать эти типы без всяких потерь производительности, так же как типы значений и одномерные массивы, содержащие блитируемые типы. Мельчайшие детали маршаллинга можно изучить дополнительно в библиотеке MSDN.
Разработка с использованием типов значений
По возможности используйте простые структуры, даже когда редко упаковываете и распаковываете. Вот простой пример, демонстрирующий разницу в скоростях:
using System; namespace ConsoleApplication < public struct foo< public foo(double arg)< this.y = arg; >public double y; > public class bar < public bar(double arg)< this.y = arg; >public double y; > class Class1 < static void Main(string[] args)< System.Console.WriteLine("starting struct loop. "); for(int i = 0; i < 50000000; i++) System.Console.WriteLine("struct loop complete. starting object loop. "); for(int i = 0; i < 50000000; i++) System.Console.WriteLine("All done"); > > >Когда запустите этот пример, вы увидите, что цикл с использованием структуры выполняется на порядок быстрее. Однако важно быть осторожным при использовании типов значений в качестве объектов. Это создает дополнительные затраты на упаковку и распаковку, которые могут в конце концов превысить затраты, которые могли бы возникнуть, если бы вы использовали объекты! Чтобы увидеть это на деле, измените код и используйте массив структур foo и объектов bar. Вы обнаружите, что производительность приблизительно та же.
Примечание: Типы значений гораздо менее гибкие, чем объекты, и при некорректном использовании очень сильно снижают производительность. Необходима крайняя осторожность в том, когда и как их использовать.
Поработайте с примером, приведенном выше, сохраняя foos и bars в массивах или хэш-таблицах. Вы увидите, что выигрыш в скорости пропадет сразу же, как только появится хотя бы одна операция упаковывания и распаковывания.
Можно проследить за тем, как интенсивно вы используете упаковку и распаковку, просмотрев распределения и сборки мусора GC. Это можно сделать прямо с помощью Perfmon или через Performance Counters в коде.
Полную информацию по типам значений смотрите в Приложении Б.
Используйте AddRange для добавления групп элементов
- StringCollection, TraceCollection и т.д.
- HttpWebRequest
- UserControl
- ColumnHeader
Ограничьте ваш Working Set
Чтобы поддерживать небольшие размеры Working Set, минимизируйте число используемых сборок. Если вы загружаете всю сборку просто для того, чтобы использовать один метод, вы платите огромную цену за очень несущественные преимущества. Посмотрите нельзя ли скопировать функциональные возможности этого метода, используя код, который вы уже загрузили.
Отслеживание размера Working Set является довольно сложной задачей и может стать темой целой статьи. Здесь приведены некоторые подсказки, которые помогут вам:
- Чтобы отслеживать Working Set используйте vadump.exe.
- Просмотрите Perfmon или Performance Counters. Они могут предоставить вам детальную информацию о количестве загруженных классов или количестве методов, которые подвергались JIT компиляции. Вы можете узнать, сколько времени потрачено на загрузку или какой процент времени выполнения потрачен на подкачку файлов.
Используйте циклы For для перебора символов в строке
В C# ключевое слово foreach позволяет пройти по элементам списка, строки и т.д. и осуществить операции над каждым из них. Это очень мощный инструмент, т.к. он работает как универсальный нумератор для многих типов. Альтернативой этого обобщения является скорость, и если вы действительно часто используете итерацию строк, лучше используйте цикл For. Поскольку строки - это простые массивы символов, их можно пройти с намного меньшими потерями, чем другие структуры. JIT компиляция достаточно интеллектуальна (в большинстве случаев), чтобы оптимизировать граничные проверки и другие вещи внутри цикла For, но при обходах foreach этого сделать нельзя. В результате цикл For для строк работает более, чем в пять раз быстрее, чем цикл foreach.
Здесь приведен простой тестовый метод для демонстрации разницы скоростей. Попытайтесь запустить его, затем удалите цикл For и раскомментируйте выражение foreach.
public static void Main(string[] args) < string s = "monkeys!"; int dummy = 0; System.Text.StringBuilder sb = new System.Text.StringBuilder(s); for(int i = 0; i < 1000000; i++) sb.Append(s); s = sb.ToString(); //foreach (char c in s) dummy++; for (int i = 0; i < 1000000; i++) dummy++; return; >>
Примечание: Foreach намного более удобочитаемый и в будущем он станет более быстрым, чем цикл For, для таких специальных случаев, как строки.
Используйте StringBuilder для работы со строками
После изменения строки среда выполнения создаст новую строку и вернет ее, а оригинальная строка будет собрана сборщиком мусора. В большинстве случаев это быстрый и простой процесс, но частые изменения строки приводят к снижению производительности: все эти размещения в конечном концов приводят к непроизводительным расходам. Здесь приведены два примера. Первый - это простая программа, в которой происходит дополнение строки 50 000 раз; во втором примере для модификации строки используется объект StringBuilder. Код, использующий StringBuilder, выполняется намного быстрее, если вы запустите оба этих примера, это сразу станет очевидным.
namespace ConsoleApplication1.Feedback < using System; public class Feedback< public Feedback()< text = "You have ordered: \n"; >public string text; public static int Main(string[] args) < Feedback test = new Feedback(); String str = test.text; for(int i=0;i<50000;i++)< str = str + "blue_toothbrush"; >System.Console.Out.WriteLine( "done"); return 0; > > >
namespace ConsoleApplication1.Feedback < using System; public class Feedback< public Feedback()< text = "You have ordered: \n"; >public string text; public static int Main(string[] args) < Feedback test = new Feedback(); System.Text.StringBuilder SB = new System.Text.StringBuilder( test.text); for(int i=0;i<50000;i++)< SB.Append("blue_toothbrush"); >System.Console.Out.WriteLine( "done"); return 0; > > >Посмотрите в Perfmon сколько времени экономится, когда не надо распределять тысячи строк. Посмотрите на счетчик "% времени в GC" под списком .NET CLR Memory. Здесь вы также можете увидеть число сохраненных распределений, а так же статистику сборки мусора.
Примечание: с созданием объекта StringBuilder связаны некоторые непроизводительные затраты времени и памяти. На машинах с быстрой памятью имеет смысл применять StringBuilder, если вы делаете около пяти операций. Как правило, 10 и более строковых операций являются оправданием для непроизводительных расходов на любой машине, даже самой медленной.
Прекомпилируйте приложения Windows Forms
Методы подвергаются JIT компилированию при первом использовании. Это означает, что, чем больше методов вызывает ваше приложение при запуске, тем дольше будет идти загрузка программы. Windows Forms используют большое количество совместно используемых библиотек в ОС, и непроизводительные расходы при их запуске могут быть намного большими, чем для любых других приложений. Хотя это и не всегда так, но прекомпилирование приложений Windows Forms обычно приводит к выигрышу в производительности.
Microsoft обеспечивает возможность прекомпилировать приложения, вызывая ngen.exe. Вы можете запустить ngen.exe во время инсталляции или перед поставкой приложения. Определенно больший смысл имеет запускать ngen.exe во время инсталляции, т.к. в этом случае вы сможете удостовериться, что приложение оптимизировано для машины, на которой оно было инсталлировано. Если вы запускаете ngen.exe до поставки программы, вы ограничиваете оптимизацию тем, что доступно на вашей машине. В таблице приведены объективные времена запуска для ShowFormComplex, приложений winforms с примерно сотней элементов управления.
Состояние кода Время Framework JITed
ShowFormComplex JITed3.4 c Framework Precompiled, ShowFormComplex JITed 2.5 c Framework Precompiled, ShowFormComplex Precompiled 2.1c Каждый эксперимент проводился после перезагрузки. Как вы видите, приложения Windows Forms сразу используют много методов, поэтому прекомпилирование приводит к существенным выигрышам в производительности.
Используйте Jagged массивы
JIT компиляция оптимизирует jagged массивы (?массивы массивов?) более эффективно, чем прямоугольные массивы, и разница весьма заметна. Данная таблица демонстрирует выигрыш в производительности при использовании jagged массивов вместо прямоугольных массивов в C# и Visual Basic (большие числа лучше):
C# Visual Basic 7 Assignment (jagged) Assignment (rectangular)
14.16 8.37
12.24 8.62
Neural Net (jagged) Neural net (rectangular)
4.48 3.00
4.58 3.13
Numeric Sort (jagged) Numeric Sort (rectangular)
4.88 2.05
5.07 Как видите, применение jagged массивов может привести к поразительному повышению производительности.
Поддерживайте размер буфера ввода/вывода (IO) в пределах 4KB - 8KB
Практически для всех приложений размер буфера в пределах 4KB - 8KB обеспечит максимальную производительность. В особых случаях вы, возможно, сможете достичь лучших результатов с большим буфером (загрузка больших графических объектов предсказуемого размера, например), но в 99.99% случаев это только приведет к ненужной растрате памяти. Во всех буферах, унаследованных от BufferedStream, предоставлена возможность установить любой желаемый размер, но в большинстве случаев 4 и 8 обеспечат наилучшую производительность.
Будьте внимательны с асинхронным вводом/выводом (IO)
В редких случаях вы сможете получить выгоду от асинхронного ввода/вывода (IO). Одним из примеров может быть загрузка и декомпрессия ряда файлов: вы можете считать биты из одного потока, декодировать их и записать в другой поток. Чтобы эффективно использовать асинхронный ввод/вывод, необходимы большие усилия, и если что-то сделано неправильно, это приведет только к потерям производительности. Преимущество асинхронного ввода/вывода в том, что при правильном его использовании есть возможность достичь в десять раз большей производительности.
Рекомендации по доступу к базам данных
Основной идеей при совершенствовании доступа к базам данных является использование только тех функциональных возможностей, которые необходимы для этого, и разработка с использованием ?разъединенного? подхода: вместо поддержания открытым длительное время одного соединения делать несколько соединений последовательно. Вы должны разрабатывать приложения с учетом этих изменений.
Microsoft для обеспечения максимальной производительности рекомендует стратегию N-связей, как альтернативу прямому соединению клиент-база данных. Учитывайте эти при разработке приложений, т.к. многие технологии оптимизируются, чтобы использовать преимущества множества связей.
Используйте оптимальный управляемый провайдер
Вместо того, чтобы полагаться на универсальный провайдер, сделайте правильный выбор управляемого провайдера. Есть управляемые провайдеры, написанные специально для различных баз данных, например, SQL (System.Data.SqlClient). При использовании универсального интерфейса, например, System.Data.Odbc, в то время как есть возможность использования специализированного компонента, вы потеряете в производительности занимаясь дополнительными уровнями преобразований. Использование оптимального провайдера даст возможность использовать различные языки: Управляемый SQL клиент обращается к SQL базе данных на TDS, что намного лучше, чем универсальный OleDbprotocol.
Используйте Data Reader вместо Data Set когда это возможно
Используйте data reader как можно чаще. Это обеспечивает быстрое считывание данных, которые могут быть кэшированы по желанию пользователя. Data reader - это просто поток, который обеспечивает возможность считывать данные по мере их поступления и затем удаляет их без сохранения в dataset для дальнейшей навигации. Потоковый подход более быстрый и вызывает меньшие непроизводительные затраты, поскольку вы можете сразу использовать данные. Чтобы решить, имеет ли смысл кэширование для навигации, вы должны определить, как часто вам нужны одни и те же данные. Данная таблица приведена, чтобы продемонстрировать разницу между DataReader и DataSet в ODBC и SQL провайдерах при извлечении данных с сервера (большие числа лучше):
ADO SQL DataSet 801 2507 DataReader 1083 4585 Как видите, большая производительность достигается при использовании оптимального управляемого провайдера вместе с data reader. Когда вам не надо кэшировать данные, использование data reader может обеспечить вам огромный выигрыш в производительности.
Используйте Mscorsvr.dll для многопроцессорных машин
Для автономных серверных приложений и приложений среднего уровня (middle-tier) убедитесь, что используете mscorsvr для многопроцессорных машин. Mscorwks не оптимизированы по масштабированию и пропускной способности, а серверные версии имеют несколько оптимизаций, которые обеспечивают им хорошую масштабируемость, когда доступно более одного процессора.
По возможности используйте хранимые процедуры
Хранимые процедуры являются высоко оптимизированными инструментальными средствами, которые при эффективном использовании обеспечивают великолепную производительность. Используйте хранимые процедуры для обработки вставок, обновлений и удалений с data adapter. Хранящиеся процедуры не надо интерпретировать, компилировать или даже передавать от клиента, что уменьшает непроизводительные расходы как сетевого трафика, так и сервера. Убедитесь, что используете CommandType.StoredProcedure вместоCommandType.Text.
Будьте осторожны с использованием строк динамического соединения
Организация связного пула - лучший способ повторного использования соединений для множества запросов, чем затраты на открытие и закрытие соединения для каждого отдельного запроса. Это делается неявно, но вы получаете один пул на отдельную строку соединения. Если вы генерируете строки соединения динамически, убедитесь, что каждый раз строки идентичны, чтобы произошла организация связного пула. Также помните, что если происходит делегирование, вы получаете один пул на клиента. Вы можете установить много опций для связного пула и используя Perfmon можете отслеживать время ответа, количество транзакций в секунду и т.д.
Отключите возможности, которые не используете
Отключите автоматическое управление пранзакциями, если не используете его. Для SQL управляемого провайдера это делается посредством строки соединения:
SqlConnection conn = new SqlConnection( "Server=mysrv01; = Integrated Security true; Enlist=false");
При заполнении набора данных с помощью адаптера данных не получайте информацию первичного ключа, если вам не надо этого делать (т.е. не задавайте MissingSchemaAction.AddWithKey):
public DataSet SelectSqlSrvRows(DataSet dataset,string connection,string query)
Избегайте команд, генерируемых автоматически
При использовании адаптера данных избегайте команд, генерируемых автоматически. Они требуют дополнительных обращений к серверу для извлечения метаданных и понижают уровень контроля взаимодействия. Хотя команды, генерируемые автоматически, использовать удобно, в требовательных к производительности приложениях стоит делать это самостоятельно.
Правильно используйте ADO
Помните, что при выполнении команды или вызов функции заполнения адаптера, каждая запись, определенная вашим запросом, возвращается.
Если серверные курсоры совершенно необходимы, они могут быть реализованы через хранимые процедуры в t-sql. По возможности избегайте этого, т.к. реализации, основанные на курсорах, не очень хорошо масштабируются.
- убедившись, что первичный ключ присутствует в таблице
- изменяя команду select адаптера данных по обстановке, и
- вызывая Fill
Поддерживайте небольшие размеры своих наборов данных
В наборы данных помещайте только необходимые вам записи. Помните, что набор данных все свои данные сохраняет в памяти, и чем больше данных вы запрашиваете, тем больше времени понадобится для их передачи.
Как можно чаще используйте последовательный доступ
Используйте CommandBehavior.SequentialAccess с data reader. Это важно при работе с blob типами данных, т.к. дает возможность считывать данные маленькими порциями. Поскольку вы можете в данный момент времени работать только с одной частью данных, исчезает задержка на загрузку большого количества данных. Если нет необходимости работать сразу со всем объектом, использование последовательного доступа обеспечит намного лучшую производительность.
Рекомендации по повышению производительности для ASP.NET приложений
Активно используйте кэширование
При разработке приложений, используя ASP.NET, будьте внимательны с кэшированием. В серверных версиях ОС у вас есть множество средств для тонкой настройки использования кэшей со стороны сервера и клиента. В ASP.NET для повышения производительности есть несколько возможностей и инструментальных средств.
- Duration - время существования элемента в кэше
- VaryByParam - различие содержимого кэша по Get/Post параметрам
- VaryByHeader - различие содержимого кэша по Http заголовкам
- VaryByCustom - различие содержимого кэша по типу браузера
- Переопределите, чтобы различать по тому параметру, какому хотите:
- Фрагментарное кэширование - когда нет возможности сохранить всю страницу (конфиденциальность, персонализация, динамическое содержимое), при сохранении ее частей для более быстрого восстановления позже можно использовать фрагментарное кэширование.
- VaryByControl - проверяет кэшированные элементы по значениям элемента управления
- Cache API - обеспечивает очень хорошую детализацию для кэширования, сохраняя хэш-таблицу кэшированных объектов в памяти (System.web.UI.caching). Также:
- Включает зависимости (ключ, файл, время)
- Автоматически уничтожает неиспользуемые элементы
- Поддерживает обратные вызовы
Разумное использование кэширования может обеспечить превосходную производительность. Важно продумать то, какой тип кэширования вам необходим. Представьте сложный коммерческий сайт с несколькими статическими страницами для регистрации, а затем множество динамически генерируемых страниц, содержащих графические элементы и текст. Вы, возможно, захотите использовать кэширование для этих страниц регистрации и фрагментарное кэширование для динамических страниц. Панель инструментов, например, может кэшироваться фрагментарно. Для еще лучшей производительности вы можете кэшировать часто используемые графические элементы и шаблонные тексты, часто появляющиеся на сайте, используя Cache API.
Используйте Session State только по необходимости
Одной чрезвычайно мощной особенностью ASP.NET является возможность сохранения session state для пользователей, например, корзину покупок на сайте электронной коммерции или историю браузера. Т.к. это свойство используется по умолчанию, даже если вы не пользуетесь им, расходуется память. Если вы не используете session state, выключите его и предохраните себя от непроизводительных расходов добавлением в свое приложение.
Для страниц, только считывающих session state, можно выбрать EnabledSessionState=readonly. В этом случае затраты будут меньшими, чем на полное считывание/запись состояния соединения, и этот вариант более приемлем, если необходима только часть функциональных возможностей.
Используйте View State только по необходимости
Примером View State может быть длинная форма, которую пользователи должны заполнить: если они нажимают кнопку Back в своем браузере и затем возвращаются, форма останется заполненной. Когда данные функциональные возможности не используются, это состояние расходует память и производительность. Возможно, наибольшая потеря производительности в этом случае происходит из-за того, что возвращаемые данные должны посылаться по сети каждый раз при загрузке страницы, чтобы обновить и проверить кэш. Т.к. это происходит по умолчанию, необходимо обозначить, что вы не хотите использовать View State, следующим образом: .
Избегайте STA COM
Апартаменты СОМ созданы для работы с потоковой и неуправляемой средой. Существует два вида апартаментов СОМ: однопоточный и многопоточный. Многопоточный (MTA) СОМ разработан для обработки многопоточности, в то время как однопоточный (STA) СОМ основывается на системе обмена сообщениями, чтобы сериализовывать запросы потока. Управляемый мир потоконезависим, и использование STA COM требует, чтобы все неуправляемые потоки совместно использовали один поток для взаимодействия. В результате - огромное снижение производительности, т.е. этого надо избегать. Если вы не можете перенести апартамент COM объект в управляемый мир, используйте для страниц, которые его используют.
Удалите ненужные Http модули
В зависимости от используемых возможностей удалите неиспользуемые или ненужные http модули из конвейера (pipeline).
Избегайте использования свойства Autoeventwireup
Вместо того, чтобы полагаться на autoeventwireup, переопределите события Page. Например, вместо записи метода Page_Load() попытайтесь перезагрузить public метод void OnLoad(). Это освобождает среду выполнения от необходимости выполнять CreateDelegate() для каждой страницы.
Кодируйте, используя ASCII, когда нет необходимости использовать UTF
По умолчанию, ASP.NET настроена так, чтобы кодировать запросы и ответы, как UTF-8. Если ASCII - это все, в чем нуждается ваше приложение, устранение затрат на UTF может повысить производительность. Обратите внимание, что это можно делать только для каждого отдельного приложения.
Используйте оптимальную процедуру аутентификации
Существует несколько способов аутентификации пользователя и несколько более дорогих, чем другие (в порядке возрастания затрат: None, Windows, Forms, Passport). Убедитесь, что используете самую дешевую из подходящих для вашего случая как классы.
Приложение Б. Вопросы производительности .NET Framework
Этот раздел включает обзор различных технологий, работающих в управляемом мире, и техническое описание того, как они влияют на производительность. Это касается работы сборщика мусора, JIT, remoting, типов значений, безопасности и т.д.
Обзор
Среда выполнения .NET представляет несколько передовых технологий, предназначенных для обеспечения безопасности, облегчения разработки и производительности. Для разработчика важно понимать каждую из этих технологий и эффективно применять их в коде. Передовые инструментальные средства, предоставляемые средой выполнения, облегчают построение надежных приложений, но заставить эти приложения "летать" является (и всегда являлось) задачей разработчика.
Сборка мусора
Сборка мусора (GC) освобождает память, занятую объектами, которые больше не используются, тем самым освобождая программиста от распространенных и сложных в отладке ошибок. Общая схема жизненного цикла объекта, как для управляемого, так и для машинного кода, такая:
Foo a = new Foo(); // Allocate memory for the object and Initialize …a… // Use the object delete a; // Tear down the state of the object, clean up // and free the memory for that object
В неуправляемом коде вам надо проделывать все эти операции самостоятельно. Упущение этапов распределения или очистки памяти, может привести к совершенно непредсказуемому поведению, что будет очень трудно отладить, а если вы забудете освободить объекты, могут возникнуть утечки памяти. Последовательность распределения памяти в Общеязыковой среде выполнения (CLR) очень похожа на только что рассмотренную. Если мы добавим GC-специфичную информацию, мы получим нечто очень похожее:
Foo a = new Foo(); // Allocate memory for the object and Initialize …a… // Use the object (it is strongly reachable) a = null; // A becomes unreachable (out of scope, nulled, etc) // Eventually a collection occurs, and a?s resources // are torn down and the memory is freed
До тех пор, пока объект может быть освобожден, в обоих мирах предпринимаются одни и те же шаги. В неуправляемом коде вы должны помнить о необходимости освобождения объекта по окончании работы с ним. В управляемом коде, как только объект больше не используется, GC может удалить его. Конечно же, если ваш ресурс требует особого внимания для освобождения (скажем, закрытие соединения), GC может понадобиться помощь, для того чтобы закрыть его правильно. До сих пор применяется такой же код, как вы писали ранее для очистки ресурса перед освобождением, в форме методов Dispose() и Finalize().
Если вы сохраняете указатель на ресурс, GC никак не может знать, собираетесь ли вы использовать его в будущем. Это означает то, что правила, используемые вами в неуправляемом коде для явного освобождения объектов, до сих пор применимы, но в основном обрабатывать все для вас будет GC. Вместо того, чтобы 100% времени посвящать управлению памятью, это займет у вас всего 5% времени.
Сборщик мусора CLR - это относящийся к определенному поколению, сборщик. Он следует некоторым принципам, которые позволяют достигать превосходной производительности. Во-первых, известно, что объекты с коротким временем жизни обычно небольшие, к ним часто обращаются. GC разделяет таблицу распределения на несколько подтаблиц, называемых поколениями, что позволяет максимально сократить время сборки мусора. Поколение 0 включает молодые, часто используемые объекты. Это поколение самое маленькое, для сборки мусора в нем требуется около 10 миллисекунд. GC может игнорировать другие поколения во время этой сборки мусора, таким образом обеспечивается намного большая производительность. Поколения 1 и 2 предназначены для больших и более старых объектов, и сборка мусора в них происходит не так часто. Когда происходит сборка мусора в поколении 1, также просматривается и поколение 0. Сборка мусора в поколении 2 - это полная сборка мусора, и только здесь GC проходит всю таблицу. Это также приводит к разумному использованию кэшей CPU, который может настроить подсистему памяти под конкретный процессор, на котором выполняется GC.
Когда происходит сборка мусора?
Когда сделано распределение времени, GC проверяет необходимость сборки мусора. Учитывается размер мусора, размер оставшейся памяти, размеры каждого поколения, а затем для принятия решения используется эвристическое правило. Во время сборки мусора скорость распределения объекта обычно такая же (или больше), чем в С или С++.
Что происходит, когда идет сборка мусора?
- Управляемая куча содержит все свое распределенное пространство в непрерывном блоке, когда этот блок меньше, чем требуется, вызывается GC.
- GC прослеживает каждый ссылку и все сопровождающие указатели, составляя список недоступных объектов.
- Каждый недоступный объект считается подлежащим уничтожению и помечается для сборки. Рисунок 1. Перед сборкой мусора: обратите внимание, что не все блоки доступны!
- Удаление объектов из списка доступных делает большинство объектов подлежащими уничтожению. Однако некоторые ресурсы должны быть обработаны специально. При определении объекта у вас есть выбор использования метода Dispose() или метода Finalize() (или и того, и другого).
- Заключительным этапом в сборке мусора является фаза уплотнения. Все используемые объекты перемещаются в непрерывный блок, все указатели и ссылки обновляются.
- Уплотняя живущие объекты и обновляя начальный адрес свободного пространства, GC поддерживает непрерывность всего свободного пространства. Если для размещения объекта достаточно места, GC возвращает элемент управления программе. В противном случае он вызывает OutOfMemoryException. Рисунок 2. После сборки мусора: блоки, к которым происходят обращения, уплотнены. Больше свободного пространства!
Некоторые объекты нуждаются в специальной обработке до того, как ресурс сможет быть возвращен. Примерами таких ресурсов являются файлы, сетевые соединения или соединения с базами данных. Если вы хотите закрыть эти ресурсы изящно, простого освобождения памяти в куче будет недостаточно. Чтобы осуществить очистку объекта, вы можете использовать или метод Dispose(), или метод Finalize(), или сразу оба этих метода.
- Вызывается сборщиком мусора
- Не гарантируется, что будет вызван в каком-либо порядке или в предсказуемое время
- После вызова освобождает память после следующей сборки мусора
- Сохраняет все дочерние объекты до следующей сборки мусора
- Вызывается программистом
- Размещается и планируется программистом
- Возвращает ресурсы по завершению метода
Управляемые объекты, которые удерживают только управляемые ресурсы, не нуждаются в этих методах. Ваша программа, вероятно, будет использовать только несколько комплексных ресурсов, и, возможно, вы будете знать, что они из себя представляют и когда они вам нужны. Если вам известно и то, и другое, нет причины надеяться на финализаторы, т.к. вы можете вручную произвести очистку. Есть несколько причин на то, чтобы вы захотели сделать так, и все они связаны с очередью финализатора.
- В сценарии, в котором задействованы ресурсы, которые должны быть освобождены в определенное время, в случае использования финализаторов вы теряете контроль. Скажем, у вас есть открытый файл и из соображений безопасности его надо закрыть. Даже после того как вы обнулите объект и вызовите GC, файл останется открытым до тех пор, пока не будет вызван его метод Finalize(), и вы не имеете никакого представления, когда это может быть сделано.
- N объектов, которые должны быть освобождены в определенном порядке, могут быть обработаны неправильно.
- Огромный объект с дочерними объектами может занимать очень много памяти, требуя дополнительных сборок мусора и понижая производительность. Такие объекты могут оставаться в памяти длительное время.
- Маленький объект, который должен быть финализирован, может иметь указатели на большие ресурсы, которые могут быть освобождены в любое время. Эти объекты не будут освобождены до тех пор, пока на них ссылается объект, который должен быть финализирован, создавая ненужное сжатие памяти и вызывая частые сборки мусора.
Диаграмма состояния на рисунке 3 иллюстрирует различные пути, которые может пройти ваш объект в условиях финализации или освобождения:
Рисунок 3. Пути освобождения и финализации, которые может пройти объект
Как видите, финализация добавляет несколько шагов в жизненный цикл объекта. Если вы самостоятельно освобождаете объект, он может быть удален и память будет возвращена при следующей сборке мусора. Когда необходимо, чтобы произошла финализация, вам придется ожидать до тех пор, пока ни будет вызван существующий метод. Т.к. неизвестно, когда это произойдет, вы можете иметь большое количество связанной памяти и зависеть от очереди финализации. Это может быть крайне проблематичным, если ваш объект соединен со всем деревом объектов, и они все располагаются в памяти в ожидании финализации.
Как выбрать, какой сборщик мусора использовать?
В CLR есть два разных GC: Рабочая станция (mscorwks.dll) и Сервер (mscorsvr.dll). При работе в режиме Рабочей станции больший интерес, чем пространство и эффективность, представляет задержка . Сервер с множеством процессоров и клиентов, соединенных через сеть, может позволить некоторую задержку, но основной является производительность. Microsoft включила два сборщика мусора, каждый из которых приспособлен к определенной ситуации.
- Много процессорный масштабируемый
- Один поток GC на CPU
- Программа останавливается во время сборки
- Минимизирует паузы путем одновременной работы во время полной сборки мусора
GC Сервер разработан для обеспечения максимальной пропускная способность, он масштабируется с очень высокой производительностью. Фрагментация памяти более проблематична в серверах, чем в рабочих станциях, что делает сборку мусора очень привлекательным предложением. В однопроцессорном сценарии оба сборщика мусора работают одинаково: режим рабочей станции без одновременной сборки мусора. В многопроцессорных машинах GC рабочая станция использует второй процессор для того, чтобы одновременно запустить сборку мусора, минимизируя запаздывание. GC сервер использует множество куч и потоков сборки мусора, чтобы обеспечить максимальное увеличение производительности и лучшую масштабируемость.
Вы можете выбирать, какой GC использовать. Когда вы загружаете среду выполнения в процесс, вы определяете, какой сборщик мусора использовать.
Миф: сборка мусора с помощью GC всегда медленнее, чем сборка мусора вручную
В действительности, GC работает намного быстрее, чем ручная сборка мусора в С. Это удивляет многих людей, поэтому требует некоторого объяснения. Прежде всего обратите внимание, что поиск свободного пространства идет постоянно. Т.к. все свободное пространство непрерывно, GC просто следует по указателю и проверяет, достаточно ли там места. В С вызов malloc() обычно приводит к поиску связного списка свободных блоков. Это может потребовать определенного времени, особенно если ваша куча сильно фрагментирована. Чтобы еще усугубить дело, некоторые реализации среды выполнения С блокируют кучу во время этой процедуры. Как только память распределена или использована, список должен быть обновлен. При использовании сборщика мусора распределение происходит свободно и память высвобождается во время сборки мусора.
Более опытные программисты будут резервировать большие блоки памяти и обрабатывать распределение в пределах этих блоков самостоятельно. Недостатком этого подхода является то, что фрагментация памяти станет огромной проблемой для программистов, и это вынудит их добавлять большое количество логики для обработки памяти в свои приложения. И наконец, сборщик мусора не добавляет непроизводительных издержек. Распределение происходит так же быстро или быстрее и уплотнение проводится автоматически, это позволяет программистам сосредоточиться на реализации приложений.
У некоторых людей, возможно, возникнет вопрос, почему GC недоступен в других средах, например, С или С++. Ответом являются типы. В этих языках программирования разрешено преобразование указателей на любой тип, что очень осложняет определение того, на что ссылается указатель. В управляемой среде, такой как CLR, гарантируется постоянство указателей, что делает возможным использование GC. Управляемый мир является единственным местом, где мы можем безопасно остановить выполнение потока, чтобы осуществить сборку мусора, в С++ эта операция и небезопасна, и очень ограничена.
Настройка для повышения скорости
Наибольшим беспокойством для программы в управляемом мире является сохранение данных в памяти. Некоторые проблемы неуправляемой среды не являются таковыми в управляемом мире: утечки памяти и указатели, указывающие на несуществующие объекты, здесь не проблема. Однако необходимо обратить особое внимание на ресурсы, которые остаются в памяти тогда, когда они уже не нужны.
Наиболее важным правилом для поддержания производительности и также самое легкое правило для программистов, которые пишут неуправляемый код: отслеживайте выделения памяти, которые необходимо сделать и освобождайте их, когда они больше не нужны. GC никак не может знать, что вы не собираетесь использовать созданную вами строку размером 20KB, если она является частью объекта, который остается в рабочем состоянии. Предположим, вы где-то сохраняете этот объект и никогда не собираетесь снова использовать эту строку. Обнуление поля даст возможность GC позже собрать эти 20KB, даже если этот объект до сих пор нужен вам для других целей. Если объект больше не нужен, убедитесь, что вы не сохраняете ссылки на него. Для более маленьких объектов это является меньшей проблемой.
Следующий важный аспект, влияющий на производительность, касается деталей очистки объекта. Как упоминалось ранее, финализация имеет огромное влияние на производительность. Наиболее общим примером является применение управляемого обработчика к неуправляемому ресурсу: вам надо применить некоторые методы очистки, и здесь производительность становится проблемой. Если вы зависите от финализации, вы открываетесь проблемам производительности, о которых говорилось ранее. Надо помнить еще о том, что GC практически совершенно не осведомлен о сжатии памяти в мире неуправляемого кода, таким образом вы можете использовать огромное количество ресурсов только сохраняя указатель в управляемой куче. Отдельный указатель не занимает много памяти, т.е. он может существовать некоторое время до того, как понадобится сборка мусора. Чтобы обойти эти проблемы производительности, вы должны выбрать схему разработки для всех объектов, требующих специальной очистки.
Реализуйте оба варианта Рекомендуемая схема очистки объекта. Это объект с некоторой смесью неуправляемых и управляемых ресурсов. Примером будет System.Windows.Forms.Control. У него есть неуправляемый ресурс (HWND) и потенциально управляемый ресурс (DataConnection, и т.д.). Если вы не уверены в том, когда используются неуправляемые ресурсы, можно открыть манифест вашей программы в ILDASM и проверить наличие ссылок на неуправляемые библиотеки. Другой вариант - это воспользоваться vadump.exe, чтобы посмотреть, какие ресурсы загружаются вместе с вашей программой. С помощью обоих этих способов вы сможете понять, какие ресурсы используете. Шаблон, приведенный ниже, предлагает пользователю отдельный рекомендуемый способ, вместо переопределения логики очистки (переопределения Dispose(bool)). Это обеспечивает максимальную гибкость. Сочетание максимальной скорости и гибкости наряду с безопасным подходом делает эту схему наиболее желательной. Пример:public class MyClass : IDisposable < public void Dispose() < Dispose(true); GC.SuppressFinalizer(this); >protected virtual void Dispose(bool disposing) < if (disposing) < … >… > ~MyClass() < Dispose(false); >>
public class MyClass : IDisposable
public class MyClassРекомендации для работы с управлением памятью хорошо знакомы: освобождайте объекты после окончания работы с ними и не допускайте, чтобы оставались указатели на объекты. Когда доходите до очистки объекта с неуправляемыми ресурсами, реализовывайте оба метода: и Finalize(), и Dispose(). Это предотвратит непредсказуемость поведения в будущем и обеспечит хорошие навыки программирования.
Метод Dispose() должен поддерживаться объектами, которые используют неуправляемые ресурсы; однако метод Finalize() должен быть помещен только в те объекты, которые прямо используют эти ресурсы, например, OS Handle или распределение неуправляемой памяти. Рекомендуется создавать маленькие управляемые объекты, такие как "упаковщики", для реализации Finalize() в дополнение к поддержанию метода Dispose(), которые будут вызываться методом Dispose() родительского объекта. Т.к. родительские объекты не имеют финализатора, все дерево объектов не переживет сборку мусора невзирая на то, был вызван метод Dispose() или нет.
Хорошим правилом при работе с финализаторами является использование их только в наиболее примитивных объектах, которым необходима финализация. Помните: используйте метод Finalize() только там и тогда, когда вы должны.
JIT
Как и любая VM, CLR нуждается в методе компилирования промежуточного языка в машинный код. Когда вы компилируете программу, чтобы запустить в CLR, компилятор преобразовывает ваш источник из языка высокого уровня в комбинацию метаданных MSIL (Microsoft Intermediate Language - промежуточный язык Microsoft). Все это собирается в РЕ файл, который затем может выполняться на любой имеющей CLR машине. При запуске этого исполняемого файла JIT начинает компилирование IL в машинный код и выполнение этого кода на реальной машине. Это делается на основе пометодной компиляции, т.е. при JIT компилировании длительность задержки зависит от размера кода, который вы хотите запустить.
- Свертывание констант - подсчитывает значения констант во время компиляции.
До После x = 5 + 7 x = 12 - Передача констант и копий - проводит обратное замещение, чтобы раньше освободить переменные.
До После x = a x = a y = x y = a z = 3 + y z = 3 + a - Замещение вызовов методов - Замещает args значениями, передаваемыми во время вызова, и устраняет вызов. Чтобы отсечь невыполняемый участок программы могут быть сделаны другие оптимизации. Из соображений скорости JIT имеет несколько ограничений, по которым он может замещать вызовы методов. Например, только маленькие методы могут быть замещены (размер IL менее 32), анализ управления потоками довольно примитивен.
До После
… x=foo(4, true); … > foo(int a, bool b) < if(b)< return a + 5; >else
… x = 9 … > foo(int a, bool b) < if(b)< return a + 5; >elsefor(i=0; i < a.length;i++)< if(i < a.length())< a[i] = null >else < raise IndexOutOfBounds; >>
for(int i=0; i
for(i=0; iprint("flaming monkeys!"); print("flaming monkeys!"); print("flaming monkeys!");Когда код должен быть JIT компилирован?
- Программа загружается, и инициализируется таблица функций с указателями, ссылающимися на IL.
- Главный (Main) метод путем JIT преобразуется в машинный код, который затем запускается. Вызовы функций компилируются в непрямые вызовы функций через таблицу.
- Когда вызывается другой метод, среда выполнения просматривает таблицу, чтобы проверить, нет ли указателей на код, обработанный JIT:
- Если указатель есть (возможно, он вызывается из другого вызова или был прекомпилирован), выполнение управляющей логики продолжается.
- Если нет, метод подвергается JIT компиляции и таблица обновляется.
Миф: программы, использующие JIT выполняются медленнее прекомпилированных программ
Это редкий случай. Затраты, связанные с обработкой JIT нескольких методов, незначительны в сравнении со временем, которое затрачивается на считывание нескольких страниц с диска, и методы подвергаются JIT только тогда, когда они необходимы. Время, затраченное на JIT, настолько мало, что оно практически всегда незаметно, и если метод однажды был подвергнут JIT, вы никогда не будете снова тратить время на его обработку.
Более важным является то, что JIT может выполнять некоторые оптимизации, которые недоступны обычным компиляторам, такие как оптимизации, характерные для CPU, и настройка кэша.
Оптимизации, присущие только JIT
- Процессор-специфические оптимизации - Во время выполнения JIT знает о том, может ли он использовать инструкции SSE или 3DNow. Ваш выполняемый файл будет скомпилирован специально для P4, Athlon или любого другого семейства процессоров. Будучи однажды созданным, тот же код будет совершенствоваться вместе с JIT и машиной пользователя.
- Удаление уровней преобразования логических адресов в физические , т.к. расположение функции и объекта доступны во время выполнения.
- JIT может осуществлять оптимизации через сборки , обеспечивая множество преимуществ, получаемых вами при компилировании программы со статическими библиотеками, но сохраняя гибкость и небольшие последствия использования динамических библиотек.
- Активные inline функции , вызываются чаще, т.к. во время выполнения учитывается управляющая логика. Оптимизации могут обеспечить существенное повышение скорости, и остается еще большое поле для улучшений в следующих версиях.
Перекомпилирование кода (использование ngen.exe)
Для производителей приложения привлекательна возможность прекомпиляции кода во время инсталляции. Компания Microsoft предоставляет эту возможность в форме ngen.exe, который позволит единожды запустить нормальный JIT компилятор по всей вашей программе и сохранит результат. Поскольку оптимизация только времени выполнения не может быть осуществлена во время прекомпиляции, генерируемый код не всегда так же хорош, как при нормальной JIT компиляции. Но из-за того, что не надо на лету обрабатывать JIT методы, затраты на запуск намного меньшие, и некоторые программы будут запускаться заметно быстрее. В будущем ngen.exe сможет делать больше, чем просто запускать ту же JIT компиляцию времени выполнения: более активные оптимизации, чем время выполнения, раскрытие оптимизации порядка загрузки разработчикам (оптимизация способа упаковки кода в VM страницы) и более сложные, требующие затрат времени оптимизации, которые могут воспользоваться преимуществом времени во время прекомпиляции.
Сокращение времени запуска помогает в двух случаях и для всего остального не может соревноваться с оптимизацией только времени выполнения, которую может делать обычная JIT компиляция. Первая ситуация - когда огромное количество методов вызывается рано в вашей программе. Вам придется подвергнуть JIT компиляции сразу много методов, что будет выражено в неприемлемо долгом времени загрузки. JIT прекомпиляция может иметь смысл, если это мешает вам, но не должна стать правилом. Прекомпиляция также имеет смысл в случае совместного использования больших библиотек, т.к. вы намного чаще тратите время на их загрузку. Microsoft прекомпилирует свои библиотеки для CLR, потому что большинство приложений будет их использовать.
ngen.exe легко использовать, чтобы увидеть полезна ли прекомпиляция для вас, рекомендуем попробовать воспользоваться ею. Однако в большинстве случаев действительно лучше использовать нормальную JIT компиляцию и пользоваться преимуществами оптимизации времени выполнения. Они обеспечивают огромный выигрыш времени, что более чем компенсирует затраты на загрузку в большинстве случаев.
Для программиста существует только две вещи, которые действительно ничего не стоят. Первое, то что JIT компиляция очень интеллектуальна. Не пытайтесь передумать компьютер. Пишите код так, как вам удобно. Например, предположим у вас есть следующий код:
… for(int i = 0; i < myArray.length; i++)< … >…
int l = myArray.length; for(int i = 0; i < l; i++)< … >…
Некоторые программисты верят, что они могут увеличить скорость тем, что уберут длинные расчеты и сохранят их во временные переменные, как в примере справа.
Истина в том, что такие оптимизации были полезны примерно в течение 10 лет: современные компиляторы способны осуществлять эти оптимизации. Кстати, иногда такие вещи могут действительно навредить производительности. В примере, приведенном выше, компилятор, вероятно, будет проверять то, что длина myArray постоянна, и вставит постоянную в сравнение цикла for. Но код справа может заставить компилятор думать, что это значение должно быть сохранено в регистре, т.к. l активна на всем протяжении цикла. Вывод таков: пишите наиболее читабельный и осмысленный код. Нет смысла стараться передумать компьютер, а иногда это может даже навредить.
AppDomains
Межпроцессное взаимодействие становится все более и более распространенным. Из соображений стабильности и безопасности OS содержат приложения в разных адресных пространствах. Простым примером является способ, которым в NT выполняется 16-битное приложение: при запуске в отдельном процессе одно приложение не может пересекаться с выполнением другого. Проблемой здесь являются затраты на контекстные переключения и открытие связи между процессами. Эти операции имеют огромное негативное влияние на производительность. В серверных приложениях, которые обычно выполняют несколько web приложений, это основной непроизводительный расход как в производительности, так и в масштабируемости.
CLR представляет концепцию AppDomain, который похож на процесс, в котором для приложения есть модульное пространство. Однако AppDomains не ограничен одним процессом. Благодаря безопасности типов, предоставляемой управляемым кодом, есть возможность запуска двух совершенно независимых AppDomains в одном процессе. Для ситуаций, в которых вы обычно тратили большое количество времени выполнения на межпроцессное взаимодействие, выигрыш в производительности огромен: IPC между сборками в пять раз быстрее, чем между процессами в NT. Значительно уменьшая эти затраты, вы получаете и выигрыш в скорости, и новую возможность во время разработки программы: теперь имеет смысл использовать разделенные процессы там, где раньше это могло быть слишком дорого. Возможность запуска множества программ в одном процессе с той же системой безопасности, как раньше, имеет громадные последствия для масштабируемости и безопасности.
В OS нет поддержки для AppDomains. AppDomains обрабатывается хостом CLR, таким как представлен в ASP.NET, выполняемый оболочкой, или Microsoft Internet Explorer. Вы также можете написать собственный хост. Каждый хост определяет домен, применяемый по умолчанию, который загружается при первой загрузке приложения и закрывается только после завершения процесса. Когда вы загружаете другие сборки в процесс, вы можете определить, что они будут загружаться в определенный AppDomain, и установить различные политики безопасности для каждой из них. Это детально описано в документации Microsoft .NET Framework SDK.
- Оно часто порождает собственную копию.
- Оно работает с другими приложениями, чтобы обрабатывать информацию (запросы баз данных внутри web сервера, например).
- Оно проводит много времени в IPC с программами, работающими исключительно с вашим приложением.
- Оно открывает и закрывает другие программы.
Пример ситуации, в которой полезны AppDomains, можно найти в сложном приложении ASP.NET. Предположим, что вы хотите усилить изоляцию двух различных vRoots: в собственном пространстве вам надо поместить каждый vRoot в отдельный процесс. Это, а также переключение контекста между ними, требует довольно больших затрат. В управляемом мире каждый vRoot может быть отдельным AppDomain. Это сохраняет требуемую изоляцию и полностью исключает непроизводительные издержки.
AppDomains - это то, что вы должны использовать только, если ваше приложение достаточно сложное и требует тесной работы с другими процессами или другими собственными экземплярами. Т.к. меж-доменная коммуникация намного более быстрая, чем коммуникация между процессами, затраты на запуск и закрытие AppDomain в действительности могут быть намного большими. AppDomains могут навредить производительности при неправильном использовании, поэтому убедитесь, что вы используете их в нужной ситуации. Обратите внимание, что только управляемый код может загружаться в AppDomain, т.к. нельзя гарантировать безопасность неуправляемого кода.
Сборки, которые совместно используются множеством AppDomains, должны быть JIT скомпилированы для каждого домена, для того чтобы сохранить изолированность доменов. В результате создается много дубликатов кода и идет пустое растрачивание памяти. Рассмотрите случай приложения, которое отвечает на запросы с помощью определенного XML сервиса. Если определенные запросы должны быть изолированы друг от друга, вы должны направлять их к разным AppDomains. В данном случае проблема в том, что каждому AppDomain теперь нужны одни и те же XML библиотеки, и одна и та же сборка будет загружаться много раз.
Единственным выходом из сложившейся ситуации является объявление Домен-нейтральной сборки. Это означает, что не допускаются прямые ссылки и изоляция поддерживается через преобразование логических адресов в физические. Это сохраняет время, т.к. сборка JIT компилируется только однажды. Это также бережет память, т.к. ничего не дублируется. К сожалению, из-за необходимости преобразования логических адресов в физические возникают потери производительности. Объявление сборки домен-нейтральной приводит к выигрышу в производительности только тогда, когда дело касается памяти или когда слишком много времени тратится на JIT компилирование кода. Такие сценарии распространены в случае большой сборки, которая совместно используется несколькими доменами.
Безопасность
Безопасность доступа к коду является мощной, исключительно полезной характеристикой. Она предлагает пользователям безопасное выполнение ненадежного кода, защищает от злонамеренного программного обеспечения и некоторых видов атак, позволяет контролируемый, основанный на идентичности доступ к ресурсам. В машинном коде обеспечить безопасность очень сложно, т.к. очень низка безопасность типов и память обрабатывает программист. В CLR среда выполнения достаточно знает о запуске кода, чтобы добавить надежную поддержку безопасности. Для большинства программистов это является новшеством.
Безопасность влияет как на скорость, так и на размер working set приложения. И, как и в большинстве областей программирования, то, как программист использует систему безопасности, может иметь огромное влияние на производительность. Система безопасности разрабатывается с учетом производительности. Однако есть несколько вещей, которые вы можете сделать в системе безопасности, чтобы еще хоть немного повысить производительность.
- Декларативная безопасность является самым быстрым способом для Assert, Deny и PermitOnly.
- При осуществлении взаимодействия в неуправляемом коде, вы можете отменить проверки безопасности во время выполнения, используя атрибут SuppressUnmanagedCodeSecurity. Это перемещает проверку на время компоновки, что намного быстрее. Убедитесь, что код не вызывает ослабление безопасности в другом коде, который может использовать перемещенную проверку в небезопасном коде.
- Проверки на идентичность требуют больших затрат, чем проверки кода. Вы можете использовать LinkDemand, чтобы делать эти проверки во время компоновки.
- Осуществляйте проверки во время компоновки, а не во время выполнения.
- Делайте проверки безопасности декларативными, а не обязательными.
В первую очередь вы должны сконцентрироваться на переносе на время компоновки как можно большего количества этих проверок. Помните, что это может оказывать влияние на безопасность вашего приложения, поэтому убедитесь, что вы не перемещаете проверки в компоновщик, который зависит от состояния времени выполнения. Как только максимально возможное количество проверок перемещено на время компоновки, вы должны оптимизировать проверки времени выполнения, используя декларативную и обязательную безопасность: выберите, какая из них больше подходит для конкретного, выбранного вами, типа проверки.
Remoting
Remoting технология в .NET распространяет богатую систему типов и функциональных возможностей CLR по всей сети. Используя XML, SOAP и HTTP вы можете вызывать процедуры и передавать объекты удаленно так, как будто они размещены на одном и том же компьютере. Вы можете рассматривать это, как .NET версию DCOM или CORBA, в которой реализован расширенный набор их функциональных возможностей.
Это исключительно полезно в серверной среде, когда вы имеете несколько серверов, размещающих различные сервисы, которые общаются друг с другом, чтобы обеспечить непрерывную связь этих сервисов. Также улучшается и масштабируемость, т.к. процессы могут физически размещаться на множестве компьютеров без потери функциональности.
Т.к. remoting часто имеет проблемы в показателях времени ожидания сети, в CLR применяются те же правила, как обычно: попытайтесь минимизировать поток посылаемой вами информации обмена и освободить программу от необходимости ожидания возвращения уделенного вызова. Вот некоторые правила, которым необходимо следовать при использовании удаления, чтобы увеличить производительность:
- Вместо большого количества небольших вызовов делайте единичные и емкие - если вы можете сократить количество вызовов, вы должны это сделать. Например, вы устанавливаете некоторые свойства для удаленного объекта с помощью get() и set() методов. Повторное создание объекта удаленно с установкой этих свойств при создании сохранит ваше время. Т.к. это может быть сделано с помощью одного удаленного вызова, вы сохраните время, потраченное на сетевой трафик. Иногда имеет смысл переместить объект на локальную машину, здесь установить свойства и затем скопировать объект обратно. Решение необходимо принимать в зависимости от пропускной способности и задержек.
- Сбалансируйте загруженность CPU и сети - иногда имеет смысл работать через сеть, а иногда лучше все делать самостоятельно. Если у вас уходит много времени на сетевые вызовы, будет страдать производительность. Если вы слишком загружаете CPU, вы не сможете отвечать на другие запросы. Сбалансированность между использованием CPU и сети является жизненно важной для масштабируемости вашего приложения.
- Используйте асинхронные вызовы - когда вы делаете вызов через сеть, убедитесь что он асинхронный, за исключением случаев, когда вам действительно нужны синхронные вызовы. В противном случае ваше приложение будет в состоянии ожидания до тех пор, пока не получит ответ, что может быть неприемлемым в пользовательском интерфейсе. Хороший пример приведен в Framework SDK, поставляемом с .NET, Samples\technologies\remoting\advanced\asyncdelegate.
- Оптимально используйте объекты - вы можете определить, чтобы новый объект создавался для каждого запроса (SingleCall) или чтобы один и тот же объект использовался для всех запросов (Singleton). Использование одного объекта для всех запросов конечно же менее ресурсоемко, но много усилий потребуется для синхронизации и конфигурации объекта от запроса к запросу.
- Используйте сменные каналы и средства форматирования - мощной возможностью удаления является возможность включения любого канала или средства форматирования в ваше приложение. Например, если вам не надо проходить через брандмауэр, нет причины использовать HTTP канал. TCP канал обеспечит вам гораздо лучшую производительность. Убедитесь, что вы выбрали наиболее подходящий канал или средство форматирования.
Типы значений
Гибкость, доступная объекту, обеспечивается за счет очень небольших затрат производительности. Объекты, размещаемые в куче, требуют больше времени для распределения, доступа и обновления, чем объекты размещаемые в стеке. Это происходит потому, что, например, структура в С++ намного более эффективна, чем объект. Конечно, объекты могут делать то, что не под силу структуре, и намного более универсальны.
Но иногда вам не нужна вся эта гибкость. Иногда вы хотите использовать что-то настолько же простое, как структура, и не хотите лишних затрат производительности. CLR предоставляет возможность определить то, что называется типом значения, и интерпретируется во время компилирования как структура. Типы значений управляются стеком и предоставляют вам скорость структуры. Как и ожидалось, они также имеют ограниченную гибкость (например, у них нет наследования). Но в экземплярах, в которых вам нужно использовать структуру, типы значений обеспечивают невероятное повышение скорости.
Типы значений полезны только тогда, когда вы используете их как структуры. Если надо интерпретировать тип значений как объект, среда выполнения обработает для вас упаковку и распаковку объекта. Однако это требует даже больших затрат, чем создание его сразу как объекта!
Далее приведен пример простой проверки, проведенной для сравнения времени, необходимого для создания большого числа объектов и типов значений:
using System; using System.Collections; namespace ConsoleApplication < public struct foo< public foo(double arg)< this.y = arg; >public double y; > public class bar < public bar(double arg)< this.y = arg; >public double y; > class Class1 < static void Main(string[] args)< Console.WriteLine("starting struct loop. "); int t1 = Environment.TickCount; for (int i = 0; i < 25000000; i++) < foo test1 = new foo(3.14); foo test2 = new foo(3.15); if (test1.y == test2.y) break; // prevent code from being eliminated JIT >int t2 = Environment.TickCount; Console.WriteLine("struct loop: (" + (t2-t1) + "). starting object loop. "); t1 = Environment.TickCount; for (int i = 0; i < 25000000; i++) < bar test1 = new bar(3.14); bar test2 = new bar(3.15); if (test1.y == test2.y) break; // prevent code from being eliminated JIT >t2 = Environment.TickCount; Console.WriteLine("object loop: (" + (t2-t1) + ")"); >Сами проверьте этот пример. Разница во времени порядка нескольких секунд. Теперь давайте изменим программу таким образом, чтобы среде выполнения пришлось упаковывать и распаковывать нашу структуру. Обратите внимание, что преимущества в скорости от использования типов значений полностью исчезнут! Вывод: типы значений надо использовать только в исключительно редких ситуациях, когда вы не используете их, как объекты. Ознакомьтесь с этими ситуациями, поскольку выигрыш производительности при правильном использовании типов значений очень велик.
using System; using System.Collections; namespace ConsoleApplication < public struct foo< public foo(double arg)< this.y = arg; >public double y; > public class bar < public bar(double arg)< this.y = arg; >public double y; > class Class1 < static void Main(string[] args)< Hashtable boxed_table = new Hashtable(2); Hashtable object_table = new Hashtable(2); System.Console.WriteLine("starting struct loop. "); for(int i = 0; i < 10000000; i++)< boxed_table.Add(1, new foo(3.14)); boxed_table.Add(2, new foo(3.15)); boxed_table.Remove(1); >System.Console.WriteLine("struct loop complete. starting object loop. "); for(int i = 0; i < 10000000; i++)< object_table.Add(1, new bar(3.14)); object_table.Add(2, new bar(3.15)); object_table.Remove(1); >System.Console.WriteLine("All done"); > > >Типы значений широко используются в Microsoft: все простые типы являются типами значений. Использовать типы значений везде, где вы хотите использовать структуру. Если вы не будете упаковывать/распаковывать их, они обеспечат существенный выигрыш в производительности.
Еще одна очень важная вещь, о которой надо упомянуть, - это то, что типы значений не нуждаются в маршаллинге при взаимодействии. Поскольку маршаллинг является одним из наибольших поглотителей производительности при взаимодействии с машинным кодом, использование типов значений в качестве аргументов, будет единственной возможностью улучшить производительность.
- Фрагментарное кэширование - когда нет возможности сохранить всю страницу (конфиденциальность, персонализация, динамическое содержимое), при сохранении ее частей для более быстрого восстановления позже можно использовать фрагментарное кэширование.
Форматы вызова перечисленных процедур следующие:
#include #include void *malloc (size_t size); void *calloc (size_t nobj, size_t size); void *realloc (void *ptr, size_t newsize); void free (void *ptr);
| size | — в случае malloc( ) — размер выделяемой области памяти в байтах; в случае calloc( ) — размер в байтах элемента массива данных, под который выделяется память; |
| nobj | — число элементов массива данных; |
| ptr | — указатель на ранее выделенную память; |
| newsize | — новый размер области памяти. |
Функции malloc( ), calloc( ) и realloc( ) возвращают указатель на выделенную память или NULL, если свободного сегмента указанного размера найти не удалось. Адрес памяти, возвращаемый процедурами, гарантировано выравнивается на границу максимального по размеру типа данных в системе. Обычно это тип double, размер которого равен восьми байтам.
В приводимом примере мы заказываем память под матрицу чисел и заполняем ее единицами.
#include void FillMatrix (int **matrix, int nrows, int ncols) < int i, j; for (i=0; i void main( ) < int **matrix; if ((matrix=(int**)malloc(100*sizeof(int*)) == NULL) < puts ("no memory\n"); exit (1); >for (i=0; i > FillMatrix (matrix, 100, 100); for (i=0; i
Здесь мы намеренно, в демонстрационных целях, применяли разные функции для выделения памяти.
1.9. Инструментальные средства программирования в системе UNIX.
Данный раздел содержит сведения, необходимые пользователю для создания программ в системе UNIX. Здесь описаны соответствующие инструментальные средства ОС.
Мы не приводим, правда, сведений о, пожалуй, самой необходимой компоненте — текстовом редакторе. Но их можно найти в [2, 3, 4, 16]. В этих книгах достаточно подробно разобраны такие стандартные утилиты как ed, vi, а в [16] перечислены основные приемы работы с очень распространенным в UNIX редактором emacs.
1.9.1. Получение подсказки. Программа man.
В UNIX с самого начала существует полезная программа, позволяющая получить подсказку по интересующей пользователя команде, стандартной библиотечной процедуре или системному вызову. Это программа — man ( от manual — руководство ).
Ее формат следующий:
где «имя» — это строка, идентифицирующая объект, о котором надо получить подсказку. Опции man приведены ниже.
Работает программа следующим образом. Она просматривает файлы, находящиеся в поддиректориях каталога «/usr/man» (заметим, что это имя может меняться в разных версиях ОС, так в системе Solaris 2.x фирмы SunSoft просматривается директория «usr/share/man»). Эти поддиректории называются секции (разделы). Их имена образуются следующим образом: «man», например «man1», «man1m» и т.д. Если при поиске обнаруживается файл с именем, совпадающим с указанным в командной строке, и расширением, совпадающим с идентификатором раздела, то этот файл показывается на экране. Для просмотра используются клавиши:
В разных секциях располагаются файлы, относящиеся к одной группе. Например, «команды пользователя», «команды системного администратора», «системные вызовы» и пр. При этом в них могут встречаться файлы с одинаковыми именами (но не расширениями). Так существует команда администратора mount и системный вызов mount( ). Соответственно есть и два файла в разных разделах с этим именем. Поэтому, программа man при подсказках идентифицирует объекты следующим образом:
mount(1m) — команда mount из раздела «1m»;
mount(2) — системный вызов mount( ) из раздела «2».
Приведем теперь основные ключи команды man.
-M задает путь для поиска поддиректорий, содержащих файлы подсказки; по умолчанию это «/usr/man» («/usr/share/man»); -a находятся и показываются на экране по порядку тексты из всех секций, относящихся к указанному имени; -l находятся и предъявляются пользователю ссылки на подсказки, относящиеся к указанному имени, но находящиеся в разных разделах; так, команда
man — l mount
выводит на экран
mount(1m) -M /usr/man
mount(2) -M /usr/man-s «идентификатор» задает идентификатор просматриваемой при поиске секции; другие разделы при этом игнорируются; так, команда
man -sim mount
выдаст подсказку по команде mount, а
man -s2 mount
по системному вызову mount( ).
1.9.2. Файлы системы UNIX, используемые при компиляции и компоновке программ.
Основным языком программирования в среде UNIX является язык Си. Поэтому, именно о нем пойдет речь в данном разделе.
При программировании на Си в файлы исходного кода (имеющие расширение «.с») включаются файлы-заголовки (расширение «.h»). Система имеет довольно много таких файлов, располагающихся в директории «/usr/include» и ее поддиректориях. Они содержат прототипы системных функций, различные структуры и типы данных и именованные константы.
Когда программа скомпилирована, из полученных объектных файлов (расширение «.o») создается выполнимый файл. Этот процесс называется компоновкой. В порождаемый на этом шаге программный модуль должны включаться коды всех используемых приложением процедур. Системные функции находятся в так называемых библиотечных (архивных) файлах. Они имеют расширение «.a» и располагаются в директории «/usr/lib». Основным из них является файл «libc.a».
Каждый архивный файл представляет собой совокупность объектных модулей. По принятому в системе соглашению их имена начинаются с префикса «lib».
1.9.3. Компилятор языка Си.
Си-компилятор является основным средством для создания программ в системе UNIX. Переоценить его значение для системы невозможно. Достаточно сказать, что около 90% ядра и почти 100% утилит и библиотек системы UNIX написаны на языке Си.
В системе UNIX Си-компилятор, как правило, состоит из трех программ: препроцессора, синтаксического анализатора и генератора кода. Результатом его работы является программа на языке ассемблера, которая затем транслируется в объектный файл, компонуемый с другими модулями загрузчиком. В результате образуется выполняемая программа.
Как и большинство сложных программ в системе UNIX, компилятор состоит из нескольких выполняемых файлов. Основной из команд, с которой приходится иметь дело пользователю, является команда cc. Ее функцией является проанализировать введенную командную строку и выполнить действия, предписанные указанными после имени команды параметрами. Для выполнения описанной выше последовательности действий требуется вызвать программы:
/lib/cpp - препроцессор; /lib/cc0 - синтаксический анализатор; /lib/cc1 - генератор кода; /bin/as - ассемблер; /bin/ld - загрузчик.
По завершении каждой стадии компиляции создаются промежуточные временные файлы, используемые впоследствии. Исключением является синтаксический анализатор, который в случае обнаружения ошибок в исходном коде программы, выводит соответствующие сообщения в файл стандартного вывода ошибок. Заданием параметров в командной строке компилятора можно получить промежуточный результат после обработки программного модуля (файла) на каждой из фаз.
Следует отметить, что Си-компилятор зависит от версии системы. UNIX может иметь стандартный Си-компилятор, разработанный еще при создании первых версий ОС. Этот компилятор описан в [6] и в честь авторов его обычно называют «Керниган-Ритчи Си». Современные версии системы UNIX имеют в своем составе ANSI Си-компилятор.
Для получения выполняемого файла программы, исходный текст которой содержится в одном файле «myprog.c», достаточно ввести следующую строку:
cc myprog.c
Если в тексте программы не обнаруживается синтаксических ошибок и она не использует функций, не входящих в стандартную Си-библиотеку, в текущей директории будет создан файл «a.out», содержащий выполнимый модуль откомпилированной программы. Но для большинства программ нецелесообразно помещать всю программу в один единственный файл. Может также потребоваться использование дополнительных библиотек, добавление в выполняемый файл информации для отладчика, оптимизация выполняемого кода и многое другое. Сообщить компилятору о том, что и как требуется создать из исходных файлов, можно при помощи ключей, задаваемых в командной строке.
Синтаксис командной строки для Си-компилятора следующий:
cc [ключ [имя файла]] .
Программа, написанная на языке Си, составляется из одной или более программных единиц, называемых функциями. Исходные тексты функций, составляющих программу, располагаются в одном или нескольких файлах. Компилятор служит для получения выполняемого модуля из файлов, содержащих исходные тексты программы. Си-компилятор работает только с файлами определенных типов. Тип задается именем файла, а точнее, его расширением. Эти расширения и соответствующие типы файлов следующие:
.c — исходные тексты программ;
.i — выходные файлы препроцессора;
.s — код на языке ассемблера;
.h — включаемые препроцессором файлы-заголовки;
.o — объектные файлы;
.a — архивы объектных файлов (библиотеки).
Общее количество опций довольно велико. Все они описаны в справочном руководстве по системе (UNIX User Manual). Мы же ограничимся описанием наиболее часто, с нашей точки используемых ключей.
Опция ‘-c’ сообщает компилятору, что входные файлы должны быть откомпилированы или ассемблированы, но не объединены в выполнимую программу. Полученные объектные модули по умолчанию помещаются в файлы с именами, полученными заменой расширений «.c», «.i» или «.s» на «.o». Так команда
cc -c myprog.c
порождает объектный файл «myprog.o».
По умолчанию компилятор создает выполнимый файл с именем «a.out». Изменить это имя можно с помощью ключа ‘-o’. Так, в результате работы команды
cc -o myprog myprog.c
из файла «myprog.c» будет создан выполнимый модуль с именем myprog.
Оптимизировать объектный код можно, указав в командной строке ключ ‘-O’. Некоторые реализации Си-компилятора поддерживают несколько уровней (степеней) оптимизации генерируемого объектного кода. Для этого используется ключ ‘-On’, где n — число, задающее уровень (например, ‘-01’ или ‘-02’).
Для отладки программы при помощи символьного отладчика загрузочный модуль (файл) должен содержать соответствующие данные. Сгенерировать объектный код, содержащий их, можно при помощи ключа ‘-g’.
Ключ ‘-D’ позволяет задать директиву препроцессора «#define» без изменения исходного текста программы. Наличие в командной строке записи «-Dname=value» эквивалентно указанию в файле с исходным кодом строки:
#define name value
Если поле value в командной строке отсутствует, константе присваивается значение 1. Задание знаачений в командной строке имеет приоритет перед определением их в тексте программы.
Одним из важнейших свойств языка а программирования Си является использование включаемых файлов (или файлов-заголовков). Имена их, как правило, заканчиваются расширением «.h». Как мы уже упоминали, стандартные файлы-заголовки в системе UNIX располагаются в директории «/usr/include». Если имя включаемого файла-заголовка в тексте программы указывается в скобках («<. >«), и имя файла не начинается с символа ‘/’, препроцессор составляет полное имя файла по правилу: «/usr/include» + «имя файла». Если включаемый файл находится в директории, не являющейся поддиректорией «/usr/include», можно указать его местоположение при помощи ключа «-I». Например, если есть необходимость использовать файл-заголовок, находящийся в директории «/work/include», нужно указать его местоположение следующим образом:
cc -I/work/include -c myprog.c
Следует заметить, что важна последовательность указанных в командной строке директорий при поиске соответствующих файлов. Если файлы с одинаковым именем находятся в разных директориях, эти директории указаны в командной строке с ключом «-I», то компилятор выберет файл из директории, указанной ранее.
Для указания загрузчику того, что при создании выполняемого файла требуется использовать какой-либо библиотечный файл, используется ключ «-l». Мы уже говорили, что библиотеки объектных модулей хранятся в файлах, имена которых начинаются с «lib» и заканчиваются расширением «.а». Часть имени файла между ними является собственно именем библиотеки. В системе UNIX все стандартные системные библиотеки располагаются в директории «/usr/lib». Стандартная Си-библиотека системы располагается в файле «/usr/lib/libc.a» и подключается загрузчиком автоматически без указания ее в командной строке. Все остальные библиотеки являются дополнительными и требуют явного указания для использования. Например, если в программу надо включить библиотеку математических функций, находящуюся в файле «/lib/libm.a», командная строка должна содержать ссылку на нее в виде «-lm»:
cc -o myprog myprog.c -lm
Если необходимая библиотека находится в директории, отличной от стандартных («lib» и «/usr/lib»), необходимо указать ее расположение при помощи ключа «-L». Действие ключа «-L» и правила поиска архивных файлов те же, что и при поиске файлов-заголовков с использованием ключа «-I». Например:
cc -L. . /lib -o myprog myprog.c -lmyprog
Здесь при компоновке программы будет подключаться архив с именем «libmyprog.a», находящийся в директории «../lib».
1.9.4. Создание библиотек файлов. Программа ar.
Программа ar (от archiver — архиватор) позволяет создавать библиотеки (архивы), состоящие из произвольных файлов. Библиотека — это, в свою очередь, тоже файл, который включает другие файлы и справочную информацию, необходимую для их сопровождения.
Формат команды, запускающей архиватор, следующий:
ar [команда] имя_библиотеки имена_файлов
При этом «команда» задает действие над перечисленными в строке файлами. Эти действия следующие:
r добавить или заменить файлы «имена_файлов» в библиотеке «имя_библиотеки»; если архива нет — он создается; d удалить файлы «имена_файлов» из библиотеки «имя_библиотеки»; t распечатать содержимое библиотеки «имя_библиотеки»; x достать файлы «имена_файлов» из библиотеки «имя_ библиотеки».
Команды могут иметь модификаторы:
v печатать на экране все, что делает программа ar; u при использовании с командой «r» заменяются лишь файлы, версии которых в архиве отличаются от новых.
ar r mylib a.c
создает библиотеку «mylib» и помещает в нее файл «a.c». На экран ничего не выводится. Команда
ar rv mylib a.out
добавляет в «mylib» файл «a.out», при этом печатается соответствующее сообщение. Команда
ar t mylib
показывает содержимое библиотеки.
Заметим, что в некоторых версиях утилиты ar порождаются библиотечные файлы, которые не могут непосредственно обрабатываться компоновщиком при создании выполнимых модулей. Предварительно архив должен быть обработан программой ranlib. Например:
ranlib mylib
После этого библиотека готова для компоновки.
1.9.5. Программа make.
При разработке крупных и даже средних программ, их исходный код размещается в нескольких исходных файлах. Деление больших программных комплексов на меньшие, более управляемые части, является обычной практикой и позволяет упростить процесс отладки приложения. Разделенная на части программа располагается в отдельных файлах, которые, в свою очередь, могут быть помещены в отдельные директории.
Сложная программная система, как правило, состоит не только из набора c- и h-файлов, но и из файлов, содержащих рабочую и справочную документацию по разрабатываемому программному обеспечению, исходные данные для работы или отладки модулей, и многое другое.
Все эти части могут требовать совершенно различной обработки. Файлы, содержащие исходные тексты программ, должны быть откомпилированы. Выполняемый код должен быть скомпонован вместе с определенными библиотеками и т.д. Действия по разработке комплекса программ включают также прогон тестов и включение соответствующей отладочной информации. Кроме того, иногда есть необходимость осуществить замену некоторой компоненты в системе, подготовить документацию и т.д.
Файлы, составляющие разрабатываемый комплекс, зависят друг от друга. Так объектные модули зависят от соответствующих файлов, содержащих исходные тексты. Последние зависят от файлов-заголовков. При отладке программ легко забыть, какие файлы после изменений компилировались, а какие нет. Попытка же перекомпилировать весь проект — непозволительная роскошь.
Решить проблему помогает утилита make. Она позволяет задавать связь модулей, умеет делать сравнения времен их модификации и, на этой основе, выполняет реконструкцию (например, перекомпиляцию) системы.
При использовании интерпретатора make, рекомендуется следующая технология разработки программного комплекса:
редактор -> make -> проверка -> редактор
Такая технология существенно повышает производительность труда программиста, так как освобождает его от забот по «ручной» сборке программ. make «следит» за тем, чтобы при многократных компиляциях и отладках приложений «не делалось то, что можно не делать».
Задание для утилиты make представляет собой программу на специальном языке (ее мы будем называть make-программой). make-программа содержит структуру зависимостей файлов и действия над ними, оформленные в виде списка правил. Выполнение действий приводит к требуемой перестройке комплекса. Текст программы может содержать определения переменных, используемых затем в описаниях правил и специальных директив, понимаемых утилитой.
Правило описывается следующим образом: сначала указывается имя файла, который необходимо создать (цель (target )), затем двоеточие, затем имена файлов, от которых зависит цель (подцели). Эта строка правила называется «строкой зависимостей». После этого идут строки, описывающие действия, которые надо осуществить, если обнаружено, что хотя бы одна подцель модифицировалась позже, чем файл-цель. Действие — это инструкция командному процессору, предписывающая, например, скопировать файлы, вызвать ту или иную программу (например компилятор) или сделать что-либо еще.
Таким образом, правило make-программы в общем виде выглядит так:
имя_цели . . . : [имя_подцели] [действие] . . [действие]
Cинтаксис строк, задающих действия, соответствует синтаксису командных строк shell. Первым символом такой строки в make-программе должен быть символ табуляции — это обязательное условие! Если строка слишком длинная, то ее можно разбить на подстроки. В конце каждой из них, кроме последней, ставится символ ‘\’. Все последовательности символов, начиная от символа «#»‘ и до конца строки, являются комментарием. Пустые строки и лишние пробелы игнорируются. Интерпретатор make передает строку, задающую действие, на выполнение shell без ведущего символа табуляции.
Следует заметить, что, если строка начинается с символа табуляции, то она относится к списку действий в правиле, иначе, если строка начинается с первой позиции, она может быть либо «строкой зависимостей», либо комментарием, либо определением переменной.
Если make-программа размещена в файле с именем «Makefile» или «makefile», то при запуске утилиты имя файла с программой можно не указывать в командой строке. В противном случае его надо задать при помощи опции ‘-f’. Таким образом, вызов
make
выполняет программу из файла «Makefile» или «makefile», а
make -f mymakeprog
программу из файла «mymakeprog».
В командной строке при вызове make можно также указать имя цели, список зависимостей которой надо проверить и, возможно выполнить соответствующие действия. Иначе выполняться будет первое правило make-программы.
Рассмотрим пример, иллюстрирующий применения make для создания программы, исходный текст которой содержится в файлах: «file1.c» и «file2.c». Текст make-программы выглядит следующим образом:
prog: file1.o file2.o cc -o proj file1.o file2.o file1.o: file1.c cc -c file1.c file2.o: file2.c cc -c file2.c
Первая строка программы определяет, что целью программы является получение файла «prog», зависящего от файлов «file1.o» и «file2.o». Во второй строке указывается действие, по которому получается целевой файл «prog». Остальные строки содержат описание правил получения подцелей «file1.o» и «file2.o».
Для того чтобы облегчить создание сложных make-программ, утилита позволяет задавать и использовать в них переменные. Создается переменная с помощью конструкции
Здесь — имя переменной, — это произвольная строка, возможно пустая. В последнем случае переменная считается неопределенной. Чтобы использовать переменную в make-программе, надо поставить ее идентификатор в скобки, перед которыми находится символ ‘$’. В следующем примере иллюстрируется применение переменных.
PROGNAME = prog OBJS = file1.o \ file2.o $(PROGNAME) : $(OBJS) cc -o $(PROGNAME) $(OBJS)
Переменные можно определять не только в тексте программы, но и в командной строке при запуске утилиты. Например:
make PROGNAME=prog1
Если в этом случае значение переменной состоит из нескольких слов, то его надо обрамить двойными кавычками.
make составляет список имен переменных и присваивает им значения в процессе чтения программы. Если значение переменной задается в командной строке при запуске утилиты, то все ее определения в make-программе игнорируются и используется значение, взятое из командной строки. Рекурсия при присвоении значения переменным не допускается.
Ниже демонстрируется употребление предопределенных переменных:
CC = cc LIBS = -lgen -lm OBJS = file1.o file2.o prog: $(OBJS) $(CC) -o $@ $(OBJS) $(LIBS)
Кроме описанных выше явных зависимостей между файлами, make позволяет определять так называемые «неявные» зависимости. Они «говорят», каким образом файлы с одним расширением создаются из файлов с другим расширением. Так, например, можно сообщить make, как из исходных ( .c ) файлов получить объектные модули ( .o ):
.o.c : cc -c $В приведенном примере make сравнивает времена модификации файлов, имеющих одинаковые имена и расширения, соответственно ".o" и ".c". Если o-файл "старше", то выполняется перекомпиляция. При этом в указанной в правиле команде перекомпиляции переменная '
Из примера виден общий синтаксис правил с "неявными" зависимостями:
. : [командная строка, задающая действие] . . [командная строка, задающая действие]Проверяется зависимость файлов с расширением 1 от файлов с расширением 2.
Некоторые "неявные" зависимости определяются make по умолчанию. Таковой, в частности, является зависимость ".o" от ".c". Учитывая сказанное, приведенный в начале раздела пример можно переписать так:
prog: file1.o file2.o cc -o proj file1.o file2.oЗдесь указывается лишь из каких объектных модулей и с помощью какой команды производится компоновка программы. Перекомпиляция же осуществляется согласно правилу с "неявной" зависимостью по умолчанию.
В заключении отметим еще несколько особенностей программы make. Как правило, при выполнении действий соответствующие команды печатаются на экране. Запретить это можно, если поставить перед ней символ '@'.
Если текущая выполняемая команда возвращает не нулевой код завершения, то make выводит сообщение об ошибке и останавливается. Чтобы этого не происходило, перед командой должен стоять символ '-'.
В следующем комплексном примере показаны make-программы, используемые для сборки проекта, разбитого на поддиректории. Предполагается, что проект располагается в каталоге "proj". Последний имеет два подкаталога: "lib" с файлами, образующими библиотеку (пусть это "lib1.c", "lib2.c", а имя самой библиотеки "libproj.a") и "main" с файлами, образующими программу (пусть это "main1.c" и "main2.c", а имя самой программы "main").
make-программа для сборки проекта.
# Makefile проекта SUBDIRS = lib main # Создание проекта all: @for i in $(SUBDIRS); \ do \ cd $$i ; \ make ; \ cd . . ; \ done # "Очистка" проекта - удаление порождаемых ".a" и ".o" файлов clean: @for i in $(SUBDIRS); \ do \ cd $$i ; \ make clean; \ cd . . ; \ doneОна "пробегает" по подкаталогам проекта, вызывая make для выполнения находящихся там программ.
make-программа для сборки библиотеки.
# Makefile для библиотеки. Располагается в директории # proj/lib. OFILES = lib1.o lib2.o # Создание библиотеки lib : $(OFILES) ar rv libproj.a $(OFILES) # "Очистка" - удаление порождаемых ".a" и ".o" файлов clean : rm -rf *.o *.amake-программа для сборки программы.
# Makefile для создания программы. Располагается в директории # proj/main LIBDIR = . ./lib LIB = proj OFILES = main1.o main2.o PROG = main # Создание программы prog : $(OFILES) cc -o $(PROG) $(LIBDIR) $(OFILES) -l$(LIB) #"Очистка" - удаление порождаемых ".o" файлов и программы clean : rm -rf *.o $(PROG)В приведенных make-программах файлы ".o" порождаются по соответствующим ".c" файлам в соответствии с "неявными" зависимостями, принятыми make по умолчанию.
Описанные характеристики make являются общими для большинства версий UNIX. Но отдельные ее диалекты могут иметь дополнительные свойства. Так, make фирмы SunSoft (OC Solaris 2.x) имеет специальную цель .KEEP_STATE. Если она встречается в make-программе, то утилита автоматически создает список зависимостей исходных файлов ( .c ) от файлов-заголовков ( .h ).
1.9.6. Система контроля исходного кода.
При создании и сопровождении длительных проектов возникает необходимость сохранения разных версий файлов. Так, при модификации какой-либо части системы могут возникнуть непредвиденные обстоятельства, например ошибки. В этом случае надо последовательно восстановить предыдущее состояние изменявшихся частей проекта с тем, чтобы увидеть, с какого момента начались неприятности. А потом можно либо исправить неверные версии, либо отказаться от них.
Для такого сопровождения проектов, в UNIX разработано несколько систем. Первой из них, по-видимому, является "Система контроля исходного кода (Source Code Control System - SCCS). Но наиболее распространенным и общепринятым в настоящее время является комплекс "Система контроля версий" (Revision Control System - RCS). О ней и пойдет речь в данном разделе.
Система RCS обеспечивает запись, поиск и хранение версий текстовых файлов. Это позволяет вести учет изменений и контролировать права доступа к ним при одновременной работе нескольких пользователей. Система применяется для объектов, которые часто редактируются, например , варианты статей, писем, текстов программ и т.п.
Рис. 1.1. Дерево версий файла, находящегося под контролем RCS.
Рассмотрим основные команды, которые необходимы для использования системы RCS. Для начала работы с системой достаточно знать всего две из них: ci и co. Первая помещает содержимое текстового файла под контроль RCS, а, если он там уже есть, то образует новую версию. Команда co находит и выдает указанную версию, хранящуюся в системе.
Рассмотрим использование этих команд на следующем примере. Предположим, что имеется файл "f.c", который требуется передать под контроль RCS. В результате выполнения команды:
ci f.cв текущей директории будет создан файл "f.c,v", содержимое файла "f.c" переписано в "f.c,v" в качестве исходной версии 1.1, а сам файл "f.c" уничтожен. Кроме того, при выполнении команды, система потребует ввести краткое описание образованной версии. Все последующие вызовы программы ci будут запрашивать краткий комментарий, который должен отражать суть внесенных изменений (заметим, что если в текущем каталоге есть поддиректория с именем RCS, то файл "f.c,v" будет помещен в него) Файлы с суффиксами ",v" называются файлами RCS.
Для получения рабочей версии файла "f.c" из предыдущего примера, необходимо вызвать команду:
co f.cОна найдет последнюю версию в "f.c,v" и запишет ее в файл "f.c". Можно отредактировать данный файл (его мы будем называть "рабочим") и попытаться занести новую версию в "f.c,v":
ci f.cНомер новой модификации будет образован из номера предыдущей версии, увеличенного на единицу. При попытке записи может возникнуть сообщение:
ci error: no lock set by
Это означает, что во время создания файла RCS был включен режим блокировки при порождении новых версий. В этом случае при выполнение операции чтения из файла RCS, необходимо сообщить системе, что предполагается создание новой версии файла и требуется запретить попытки параллельного его редактирования до окончания работы над версией. В данном случае, в команде чтения файла должен указываться признак блокировки (ключ -l):
co -l f.cПри этом гарантируется, что следующий номер версии будет зарезервирован за пользователем, "выписавшем" файл, и попытки других пользователей создать новую его версию будут отвергнуты.
Существует еще одна возможность зарезервировать за собой право создания очередной версии. Это команда:
rcs -l f.cОна эквивалентна "co -l f.c', но "рабочий" файл "f.c" не создается. Команда бывает полезна, если при выписывании файла ключ "-l" не был указан (например, по невнимательности). Если в момент выполнения инструкции, файл уже был захвачен кем-либо, будет выдано сообщение о невозможности блокировки. В этом случае единственно, что можно сделать, это попытаться как-нибудь договориться с соответствующим пользователем, не рассчитывая на мудрость системы RCS.
Если пользователь является единственным полноправным владельцем файла, то необходимости в использовании аппарата блокировки нет. В этом случае его можно выключить с помощью команды:
rcs -U f.cПри выключенной блокировке владельцу файла нет необходимости указывать, что создание "рабочего" файла может привести к появлению новой версии (хотя для остальных пользователей это действие является обязательным).
Включение режима блокировки выполняется с помощью команды:
rcs -L f.cКак правило, создание новой версии связано с получением "рабочего" файла, его редактирования и записи новой версии с помощью команды ci, которая уничтожает "рабочий" файл. При использовании ключа -l команда:
co -l f.cвыполняет все свои обычные действия, но "рабочий" файл не уничтожается, и сохраняется блокировка попыток модификации соответствующего файла RCS другими пользователями. Это позволяет непосредственно продолжить редактирование "рабочего" файла после фиксации промежуточной версии.
Аналогичные действия выполняются при использовании команды с ключом "-u", однако режим блокировки снимается. Данный ключ часто используется в случае, если после записи версии предполагается последующая работа с "рабочим" файлом (например, компиляция или распечатка).
Использование обоих ключей приводит к модификации информационных записей в файле (см. ниже).
Пользователь может помещать в "рабочий" файл специальные строки (маркеры), которые при "выписывании" его, заменяются системой RCS на справочные сообщения. Так, если в файл поместить последовательность символов:
$Header$то при получении версии из RCS, в "рабочем" файле она будет заменена на строку вида:
$Header: файл версия дата время автор $В процессе работы не возникает необходимости редактирования этой строки, так как система автоматически проводит коррекцию при изменении даты обновления, идентификатора пользователя (автора), номера версии и т.п. Как правило, маркеры размещаются в строках комментария. Если необходимо, чтобы служебная информация попала и в объектный модуль, достаточно завести в исходном тексте программы соответствующую переменную. Например:
static char rcsid[ ] = "$Header$";Для получения справочной информации о версиях используется команда ident, которая находит маркеры в файле любого типа и выдает соответствующие строки. Так могут быть получены сведения о том, какие версии каких файлов использовались при создании указанной программы.
Полный список маркеров, используемых системой RCS, приведен ниже.
$Author$ Идентификатор пользователя, записавшего данную версию. $Date$ Дата и время записи версии. $Header$ Стандартный заголовок, содержащий имя файла RCS, номер версии, дату записи, идентификатор пользователя и статус версии. $Locker$ Идентификатор пользователя, зарезервировавшего за собой право записи модифицированной версии. Если версия не блокирована, выдается строка нулевой длины . $Log$ Комментарий, записанный пользователем при занесении версии в RCS. Перед ним помещается строка, содержащая: имя исходного файла RCS, номер версии, идентификатор пользователя и дата записи. $Revision$ Номер версии. $Source$ Полное имя исходного файла RCS. $State$ Статус версии, присвоенный командой ci.
В заключении приведем более детальное описание команд co и ci. Формат командной строки для co выглядит следующим образом:
co [options] file . . .Параметр file командной строки задает имя "рабочего" или файла RCS. Параметр options служит для указания ключей, определяющих режим работы команды.
Если полное имя файла RCS не задано или приведено не полностью (т.е. не указано точное положение файла в файловой системе), команда пытается найти его в директории, заданной переменной среды RCS. Если она не определена, то файл ищется в директории "./RCS" и, если такая отсутствует, или в ней нет требуемого файла, то поиск осуществляется в текущей директории.
Выбор версии файла может производится по номеру, времени создания, автору или статусу. При отсутствии указаний о том, какую версию файла требуется получить, выдается последняя версия. Если задано несколько условий поиска, выбирается "старшая" из множества подходящих версий. Указание даты, автора или статуса может использоваться при поиске необходимой версии какой-либо ветви дерева. При этом берется либо указанная ветвь, либо, если она не задана, самая "старшая" ветвь во всем дереве версий. Имя или номер искомой модификации можно указывать при задании ключей: "-l", "-p", "-q" и "-r" (см. ниже).
Список ключей команды co и правила их использования следующие.
-l [rev] Зарезервировать право модификации данной версии только за текущим пользователем. Правила задания номера или имени версии приведены при описании ключа "-r" -p [rev] Выдавать найденную версию в стандартный файл вывода. "Рабочий" файл не создается. -q [rev] Неинтерактивный режим. Диагностические сообщения на дисплей не выдаются. -ddate Выдать версию; дата создания задана параметром date. Если искомая версия отсутствует, выдается "старшая" версия из созданных до указанной даты. Дата может задаваться в любом формате, допустимом в системе UNIX. -r [rev] Получить версию с номером rev. Если таковая отсутствует, выдается "старшая" из множества версий с меньшими номерами. Номер версии состоит из последовательности полей, разделенных символом '.' (точка). Каждое поле содержит либо номер, либо символьное имя, которое может присваиваться пользователем с помощью ключа "-n" в команде ci. -sstate Выдать "старшую" версию, имеющую статус state. Статус файла задается при записи файла в архив командой ci (ключ "-s"). -w [login] Выдать "старшую" версию, записанную пользователем с именем login. Если имя пользователя опущено, поиск осуществляется среди версий, записанных пользователем, выполнившим команду co.
Команда ci, как было уже сказано выше, записывает новые версии "рабочих" файлов в файлы системы RCS. Формат командной строки ci следующий:
ci [ options ] file . . .Указываемые параметры и правила поиска "рабочих" и файлов RCS те же, что и в командной строке co.
Для работы с командой ci может быть необходимо включить в список доступа к соответствующему файлу регистрационное имя пользователя. Эта операция выполняется командой rcs ( ключ "-a"). Она производится, если список доступа пуст, пользователь не является администратором системы (суперпользователем) и не является владельцем файла.
Для того чтобы добавить новую версию, "старшая" из них должна быть заблокирована пользователем. В противном случае может создаваться только новая ветвь версий. Это ограничение не распространяется на владельца файла. Блокировка, установленная кем-то другим, может быть снята, как было сказано ранее, с помощью команды "rcs -l"'.
Как правило, команда ci проверяет, отличается ли вновь записываемая версия от предыдущей. Если различий не обнаружено, запись не производится. Пользователю выдается соответствующее сообщение с запросом о необходимости внесения файла в RCS.
При попытке записать версию, команда ci требует ввести краткий комментарии, который должен отражать суть внесенных изменений и заканчиваться либо отдельно стоящей '.' либо нажатием . Если файл RCS не существует, ci создает его (по умолчанию этой версии присваивается номер 1.1). При этом заводится пустой список доступа.
При записи файлов в архив системы RCS используются ключи, перечисленные ниже.
-r [rev] Присвоить записанной версии файла номер rev, снять блокировку, уничтожить "рабочий" файл. -f [rev] Принудительная запись. Новая версия записывается без возможных дополнительных сообщений. -l [rev] Выполняет функции, аналогичные функциям ключа "-r", но для сохраняемой версии дополнительно исполняется команда co с ключом "-l". -q [rev] Неинтерактивный режим. Диагностических сообщений не выдается . -mmsg Использует строку msg в качестве комментария для всех заносимых версий. -sstate Устанавливает статус записываемой версии state. По умолчанию версия получает статус "Exp" (экспериментальная).
Команда rcs используется для создания новых файлов RCS или замены атрибутов существующих файлов. Каждый файл RCS содержит: версии "рабочего" файла, список доступа, сообщения об изменениях, комментарии и набор атрибутов.
Для использования команды rcs, как и в случае ci, может быть необходимо включить в список доступа соответствующего файла регистрационное имя пользователя.
Формат командной строки команды rcs:
rcs [ options ] file . . .В качестве входных файлов используются файлы RCS. Ключи команды rcs перечислены ниже.
-i Создать и инициализировать пустой файл RCS. Если не задано полное имя файла RCS, система пытается разместить его в директории "./RCS". Если она отсутствует, файл создается в текущей директории. Если указанный файл RCS уже существует, выдается сообщение об ошибке. -alogins Добавить указанные идентификаторы пользователей (logins) в список доступа архивного файла. В качестве разделителя в строке logins используется запятая. -e [logins] Исключить имена пользователей из списка доступа заданного архивного файла. Если имена пользователей не указаны, из списка доступа исключаются все имена. -l [rev] Блокировать версию rev. Если номер версии (rev) не указан, подразумевается "старшая" версия. -L Включить механизм блокировки. При работе в данном режиме владелец файла RCS не освобождается от обязанности блокировать версию для последующей записи ее модификаций. Этот режим необходим, если изменением файла занимается несколько пользователей. -U Выключить механизм блокировки. В данном режиме владелец файла может записывать новые версии без предварительного блокирования.
1.10. Проблемы переносимости программного обеспечения.
В заключении рассмотрим вопрос о стандартизации операционной системы UNIX и о проблемах переносимости прикладного программного обеспечения между различными ее диалектами. Для этого вернемся к истории развития системы UNIX.
В начале 80-х годов фирма AT&T утратила монополию на разработку и развитие ОС. Работы по созданию своей версии системы начались в Калифорнийском университете в городе Беркли. Диалекты UNIX, разработанные там, получили название BSD 4.* (Berkley Software Distribution версии 4.*). Свою версию системы UNIX для IBM PC разработала и фирма Microsoft. Она получила название Microsoft Xenix. Существуют и другие варианты ОС. Каждый из них обладает своими достоинствами, но их общим недостатком стала проблема переносимости программ из одной системы в другую. Чтобы исправить положение, фирмой AT&T, при поддержке разработчиков других версий системы UNIX, была создана версия, включающая в себя особенности всех созданных UNIX-систем. Она получила название UNIX System V Release 4.
В то же время разработан ряд стандартов для операционных систем типа UNIX. Рассмотрим из них три основных.
Первый касается языка программирования Си, который является основным инструментом создания программного обеспечения в среде UNIX. Стандартизация коснулась не только синтаксиса языка. Был определен набор основных функций и интерфейсов к ним. Стандарт был разработан в 1988 г. Американским Национальным Институтом Стандартов и получил название ANSI C. ANSI C получил широкое распространение. Почти все Си-компиляторы, разработанные с того времени, в той или иной степени соответствуют ему.
Следующие два стандарта касаются более детального определения среды программирования системы UNIX. Первый из них разработан международной инженерной ассоциацией IEEE Std 1003.1-1990 Portable Operating System Interface Part 1. В литературе этот стандарт более известен под сокращенным названием POSIX.1. Второй стандарт разработан группой фирм-разработчиков вычислительной техники и программного обеспечения. Он получил название X/Open Portability Guide 3. Сокращенно этот стандарт называется XPG 3. Оба стандарта подробно описывают все структуры и типы данных, константы и библиотеки функций, определяющие среду операционной системы (Operating System Environment), в которой осуществляется процесс программирования.
Приблизительное соотношение между различными стандартами и реализациями в системе UNIX дает нижеследующая таблица. В ней компоненты системы характеризуются файлами-заголовками, каждый из которых определяет типы, структуры данных и функции для соответствующей компоненты операционной системы.
123 задачи с IT-собеседований с разбором решений
При приеме сотрудника в офис на должность программиста, работодатель испытывает кандидата не только вопросами о навыках, но и всевозможными логическими задачами, IT-кейсами и заданиями по разработке для профессиональных программистов.
Как правило, список этих задач у работодателей совпадает, а значит, мы можем подготовиться к любому собеседованию!
Издание Tproger собрало воедино все самые интересные и популярные задачи для программистов, которые могут встретиться вам на собеседовании. С разрешения этого издания мы решили перепубликовать эту подборку.
1. Есть однонаправленный список из структур. В нём random указывает на какой-то еще элемент этого же списка. Требуется написать функцию, которая копирует этот список с сохранением структуры (т.е. если в старом списке random первой ноды указывал на 4-ю, в новом списке должно быть то же самое – рандом первой ноды указывает на 4-ю ноду нового списка). O(n), константная дополнительная память + память под элементы нового списка. Нельзя сразу выделить память под все данные одник куском т.е. список должен быть честным, разбросанным по частям, а не единым блоком, как массив.
Вот один из вариантов решения. Делаем обход списка, создаём дубликаты узлов и вставляем их по next, получая 2*N элементов, каждый нечётный ссылается на свой дубликат. Делаем второй обход списка, в каждом чётном узле random = random.next. Делаем третий обход списка, в каждом узле next = next.next.
Есть ещё один вариант от Пашки Джиоева.
Node *copyList(Node *head) < for (Node* cur = head; cur != NULL; cur = cur->next) < Node* dup = (Node*)malloc(sizeof(Node)); dup->data = cur->data; dup->next = cur->random; cur->random = dup; > Node* result = head->random; for (Node* cur = head; cur != NULL; cur = cur->next) < Node* dup = cur->random; dup->random = dup->next->random; > for (Node* cur = head; cur != NULL; cur = cur->next) < Node* dup = cur->random; cur->random = dup->next; dup->next = cur->next ? cur->next->random : NULL; > return result; >Вариант реализации Свернуть
Node *copyList(Node *head) < for (Node* cur = head; cur != NULL; cur = cur->next) < Node* dup = (Node*)malloc(sizeof(Node)); dup->data = cur->data; dup->next = cur->random; cur->random = dup; > Node* result = head->random; for (Node* cur = head; cur != NULL; cur = cur->next) < Node* dup = cur->random; dup->random = dup->next->random; > for (Node* cur = head; cur != NULL; cur = cur->next) < Node* dup = cur->random; cur->random = dup->next; dup->next = cur->next ? cur->next->random : NULL; > return result; >2. Классическая задачка с собеседований в Google. На доске записаны числа, вам нужно ответить на вопрос: какое число идёт дальше?
Чаще всего все пытаются отыскать – безуспешно – какую-либо закономерность в серии чисел, которая кажется совершенно бессмысленной. Но здесь нужно забыть математику. Произнесите эти числа на английском (см. рисунок), окажется, что они расположены в порядке возрастания числа букв, содержащихся в их написании.
Теперь приглядитесь еще более внимательно к этой серии. 10 – не единственное число из трёх букв. На этом месте могло бы быть 1, 2 и 6 (one, two и six). То же можно сказать и про 9, подойдут 0, 4 и 5 (zero, four и five). Таким образом можно сделать вывод, что в список включены самые крупные числа из тех, что можно выразить словами с заданным числом букв.
Так какой будет правильный ответ? Очевидно, что в числе, следующем за 66, должно быть девять букв (не считая возможного дефиса), и оно должно быть самым крупным в своём роде. Немного подумав, можно сказать, что ответ будет 96 (ninety-six). Вы понимаете, что сюда не подходят числа, превышающие 100, поскольку для «one hundred» уже нужно десять букв.
Может быть, у вас возникнет вопрос, почему в приведённом списке на месте 70 не стоит сто (hundred), или миллион, или миллиард, для написания которых также нужно семь букв. Скорее всего потому, что на правильном английском языке говорится не «сто», а «одна сотня», то же относится и к двум другим случаям.
Казалось бы, всё, вот он правильный ответ. В Google его считают приемлемым, но не самым совершенным. Есть число побольше:
10 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000 000,
которое записывается как «one googol» (девять букв).
Однако и это еще не самый лучший вариант. Идеальный ответ: «ten googol», десять гуголов.
Хотите узнать историю этого ответа? Погуглите;)
3. Допустим, вы летите из Москвы во Владивосток, а затем обратно, при полном безветрии. Затем вы совершаете точно такой же перелёт, но на этот раз на п ротяжении всего перелёта дует постоянный западный ветер: в одну сторону попутный, в обратную — лобовой.
Как изменится суммарное время перелёта туда-обратно?
Обычно после прочтения задачи возникает желание заявить, что влиянее ветра в целом нулевое. Встречный ветер замедлит движение в одном направлении, но в обратном пути он будет дуть вам в спину, что позволит преодолеть путь быстрее. В целом это так, но будет ли при этом время полёта таким же?
Представим самолёт, который летает со скоростью 800 км/ч. Так случилось, что из-за погодной аномалии возник поток воздуха, дующий с запада также со скоростью 800 км/ч. При полёте на восток это создаст дополнительную силу и вы сможете прибыть во Владивосток вдвое быстрее. Но при обратном полёте, даже если самолёт поднимется в воздух, его скорость относительно земли будет нулевой. Самолёт никогда не вернётся, суммарное время полёта будет бесконечным.
Если ориентироваться на этот предельный случай, то легко понять в чём трудность. При 5 часовом полёте попутный ветер может сэкономить вам максимум 5 часов, но встречный может стоить целой вечности. Этот базовый принцип верен при любом ветре. Ветер, дующий со скоростью 400 км/ч сократит время полёта в одном направлении примерно на 1.67 часа, но добавит 5 часов при полёте в другом направлении.
Вывод: постоянно дующий ветер всегда увеличивает общее время полёта туда и обратно.
Вопрос к подписчикам на засыпку: как изменится время при таком же перелёте, если ветер будет дуть с севера т.е. под прямым углом к направлению полёта?
4. Что не так в этом отрывке кода на С++?
operator int() const
Ответ Свернуть
А вот полный код для проверки.
class Foo < public: operator int() const < return *this; >>; int main()
Он скомпилируется, хотя некоторые компиляторы могут кинуть warning, сразу же объясняющий в чём суть ошибки. Но вот при запуске вы словите stack overflow. Дело в том, что operator int будет пытаться привести возвращаемое значение к типу int, что вполне можно сделать, ведь для текущего объекта у нас есть замечательный operator int, который это и делает. Т.е. функцию вызовет сама себя и будет продолжать это делать рекурсивно, пока не переполнится стек.
5. Задача, которая была популярна в своё время на собеседованиях в Amazon. Мы русифицировали её, но смысл остался тот же. Вам нужно продолжить последовательность.
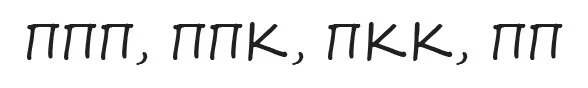
Ответ автора с обзором вариантов ответов подписчиков Свернуть
Вот один из возможных ответов на эту задачу. Последовательности сопоставлены буквы алфавита, закодированные в набор «П» и «К» — некоторых характеристик. Нужно найти что-то, чего в букве А три, в Б — две и т.д. Тут подходит количество прямых штрихов и кривых. Далее несложно догадаться, что букве Д соответствует, например, «ППППП», в случае её написания как на предложенном рисунке.
Последовательности сопоставлены буквы алфавита, закодированные в набор «П» и «К» — некоторых характеристик. Нужно найти что-то, чего в букве А три, в Б — две и т.д. Тут подходит количество прямых штрихов и кривых. Далее несложно догадаться, что букве Д соответствует, например, «ППППП», в случае её написания как на предложенном рисунке.
Идеи и решения от подписчиков
В комментариях к посту с задачей можно было найти множество интересных решений, которые перечислены ниже.
Алгоритмы Маркова
Оба алгоритма работают при проходе с конца строки.
Ответ: ПК, КК, П, К
Двоичная система счисления
П — это 1, К — это 0.
Тогда закономерность в десятичной системе счисления будет иметь вид:
а значит, далее следуют
Цикл
Существует цикл заполнения строки буквами К с конца, при этом, когда остается всего одна П (очевидно, слева), то вся строка преобразуется к строке из букв П, но на одну меньше, т.е.:
заполняем буквами К с конца
осталась одна П, уменьшим длину
Ответ: ПК, П
Скобочная последовательность
Забавный вариант: П — пусть, К — конец, тогда можно построить аналогию с открывающимися-закрывающимися скобками 🙂 Закономерность не найдена.
UPD. Был предложен вариант рассматривать всю последовательность букв как единую скобочную последовательность:
Ответ: ККККК (в разных вариантах: КК, ККК или ККК, КК и т.п.)
Несоставные числа
Посчитаем количество «дырок в буквах»:
Заметим, что все это — простые (т.е. не составные) числа до 10. Заметим, что есть еще только одно не составное число, меньшее 10 — это единица.
Произведение 1 и -1
П — это -1. К — это 1. Вариант наоборот, естественно, также подойдет. Тогда рассмотрим их произведения:
вариантов продолжения несколько, автор предложил такой:
Ответ: ПК, КК, П, К
Сумма
П = 15, К = 10. Естественно, подойдут любые другие числа такие, что П:К = 3:2. Рассмотрим ряд:
в качестве продолжения напрашиваются:
Ответ: ПК, КК, П, К
Русский язык в помощь
Вариант с хронологией выпуска девайсов:
Азбука Морзе
К сожалению, закономерности найти никто не смог. Может быть, это удастся вам?
Занимательно то, что при разных вариантах решения очень часто появлялся ответ ПК, КК, П, К…
6. Как это вычислить, не пользуясь калькулятором? Можете дать приблизительный ответ?
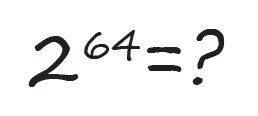
Приведём один из вариантов возможных рассуждений. Любой инженер знает, что 2 10 = 1024. Будем считать, что это приблизительно 1000. Умножим 2 10 на себя шесть раз и получим 2 60 . Это около 1000 в шестой степени или 10 18 , также известное как квинтиллион. Осталось только умножить его на 2 4 (16), чтобы получить искомое 2 64 . Таким образом, очень приблизительный, но быстрый ответ будет 16 квинтиллионов.
На самом деле, чуть больше, т.к. 1024 на 2.4% больше 1000. Мы используем это приближение 6 раз, и поэтому ответ должен быть чуть более, чем на 12% больше. Это добавляет еще 2 квинтиллиона. Поэтому более точно будет 18 квинтиллионов.
Точное значение: 18 446 744 073 709 551 616
Есть еще один быстрый хак. Многие знают, что максимальное число 32-битного unsigned int — это что-то около 4 миллиардов т.е. 2 32 ? 4х10 9 . Осталось только умножить это само на себя и получить около 16—17 квинтиллионов.
7. «Вас уменьшили до размеров 5-центовой монеты и бросили в блендер. Ваш вес уменьшился так, что плотность вашего тела осталась прежней. Лезвия начнут вращаться через 60 секунд. Ваши действия?»
Это классическая google-задачка, хороший разбор которой в рунете не так-то просто найти. Мы подготовили его для вас. Абсолютного правильного ответа нет, но есть те, которые явно лучше остальных.
Разбор вариантов ответа Свернуть
Начнём с классификации наиболее популярных ответов, затем расскажем про тот, который считается лучшим среди интервьюверов в Google.
Многие соискатели выдают один забавный ответ: «Так как блендер очень скоро включат, можно предположить, что в него положат какие-то продукты, и поэтому мне, может быть, лучше подставить свою шею под лезвие, чем задохнуться из-за паров той жижи, которая скоро появится в блендере».Если же говорить о часто встречающихся серьезных ответах, то лидерами являются такие.
Первый. Лечь как можно плотнее к днищу, чтобы лезвия крутились надо мной.
Второй. Встать с той стороны блендера, где крепятся лезвия. Возможно, между стенкой и устройством крепления есть зазор шириной в 5-центовую монету.
Третий. Залезть по лезвию на ось вращения и найти такое место, где при вращении лезвий можно сохранять равновесие. Схватиться покрепче. Итоговая центростремительная сила в этом случае будет близка к нулю, что и позволит удержаться.
Первые три варианта дают некоторый шанс на выживание, но что если лезвия будут крутиться долго? Или конструкция такова, что вас всё таки заденет остриём? И вообще, если вдуматься, кто и зачем вас бросил в блендер? Если это какие-то враждебные существа, которые собираются приготовить соус из человека, то ваши долгосрочные шансы на выживание будут очень небольшими при любом варианте.
Вот стандартные ответы интервьюверов на уточняющие вопросы: «По поводу враждебных существ не беспокойтесь». «Никакой жидкости добавлено не будет». «Крышки у блендера нет». «Исходите из того, что лезвия будут вращаться до тех пор, пока вы не погибните».
Четвертый подход отличается — нужно выбраться во вне. Интервьювер поинтересуется, как вы будете это делать. Одним из самых ярких ответов был такой: при очень малом весе вы сможете взобраться по стенке примерно так же, как это делают мухи.
Пятый, не самый оптимистичный, вариант — воспользоваться телефоном и позвонить или отправить sms с просьбой о помощи. Тут всё зависит от того, уменьшился ли так же ваш телефон, сможет ли он работать с базовой станцией (которая осталась прежней) и какова будет скорость реакции службы спасения (и будет ли вообще?).
Шестой вариант: разорвать одежду на полосы, чтобы сделать из них верёрвку и воспользоваться её, чтобы выбраться. Но реально ли это сделать за одну минуту? Как крепить верёвку сверху? И даже если это удастся, как потом спуститься вниз?
Есть и седьмой: использовать одежду и собственные усилия, чтобы как-то заблокировать (или даже сломать) лезвия или работу мотора. Но и здесь могут возникнуть проблемы.
Ни один из перечисленных ответов не принесёт вам в Google много баллов. Интервьюверы рассказывали, что лучший ответ, который они слышали был таким — выпрыгнуть из блендера.
Ух ты? В вопросе даётся важный ключ — слово «плотность». Эта подсказка наводит на мысль, что важны вес и объем тела (а на другие «нереалистичности» можно не обращать внимания) и что подходящий ответ должен строиться на простейших законах физики.
Короче: интервьювер хочет, чтобы вы сфокусировались на последствиях, связанных с изменением размера. Вы, вероятно, слышали, что муравей способен поднять вес, в 50 раз превышающий вес его тела. Это объясняется не тем, что его мускулы лучше, чем у человека, а тем, что муравей маленький. Вес любого живого существа пропорционален кубу его высоты. Сила мускулов и скелета, поддерживающего их, зависит от площади их поперечного сечения, которая пропорциональна квадрату высоты. Если вас уменьшить до 1/10 вашего роста, сила ваших мускулов уменьшится в сто раз, но ваш вес уменьшится еще больше — в тысячу раз. Про прочих равных условиях небольшие существа «сильнее».
В середине 1600-х годов Джованни Альфонсо Борелли, современник Галилео, предположил, что всё, что прыгает, поднимается примерно на одинаковую высоту. Подумайте хорошенько об этом. Если вы физически здоровы, то, вероятно, сможете подпрыгнуть сантиметров на 70. Эта высота не преграда и для других живых существ: лошади, кролика, лягушки, кузнечика или блохи. Разумеется, есть вариации, но общее правило именно такое: самые крутые баскетболисты NBA могут поднять свой центр тяжести примерно на такую же высоту, как и блоха.
Мускульная энергия в конечном счёте определяется химическими процессами: глюкозой и водородом, циркулирующем в крови, а также АТФ, имеющимся в клетках мускул. Количество любых хим. веществ пропорционально объему вашего тела т.е. если вы уменьшитесь до 1/n вашего размера, то мускульная энергия сократится в n? раз.
К счастью, вес уменьшится так же. Поэтому при размере в монетку, высота вашего прыжка (если не учитывать сопротивление воздуха) никак не изменится. Высота блендера примерно 30 см. Если вы можете сейчас перепрыгнуть через препятствие такой высоты, то удрать из блендера для вас не будет проблемой.
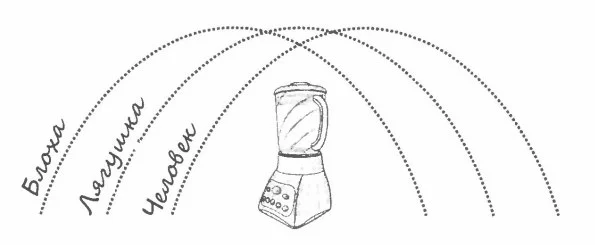
Возможно, вы спросите, как же упав потом с такой высоты вы не поломаете себе кости? Поверхность, которую вы теперь занимаете, составит 1/n? по сравнению с вами обычным, а вес сократится еще больше, до 1/n? прежнего. Соотношение площади поверхности к весу возрастёт в n раз, поэтому когда вы приземлитесь, никаких поврежений у вас не будет. Это объясняет, почему любое существо размером с мышь и менее может не беспокоиться и падать с любой высоты.
8. Вопрос по С++. Что за ошибка «pure virtual function call»? В какой ситуации она может быть сгенерирована? Предоставьте минимальный код, приводящий к ней.
Те, кто столкнулись с этой ошибкой в живом проекте и не знали про неё ранее, наверняка потратили немало времени на отлов этого бага. Разберём его по полочкам.
Как работает механизм виртуальных функций? Обычно он реализуется через «vtbl» (virtual table) — таблицу с указателями на функции. Каждый экземпляр класса, содержащего хотя бы одну виртуальную функцию имеет указатель __vtbl на таблицу vtbl для своего класса. В случае с абстрактным классом и чистой виртуальной функцией, указатель всё равно есть, но на стандартный обработчик __pure_virtual_func_called(), который и приводит к такой ошибке. Но как его вызвать, ведь прямая попытка будет отловлена уже на этапе компиляции?
#include class Base < public: Base() < init(); >~Base() <> virtual void log() = 0; private: void init() < log(); >>; class Derived: public Base < public: Derived() <>~Derived() <> virtual void log() < std::cout >; int main(int argc, char* argv[])
Разберём, что происходит при инстанцировании экземпляра объекта класса-потомка, который содержит vtbl.
Шаг 1. Сконструировать базовую часть верхнего уровня:
Шаг 2. Наследуемая часть(-и) (рекурсивно):
Теперь взглянем на пример на картинке. Несложно догадаться, что когда будет создаваться объект класса Derived, то на шаге выполнения конструктора базового класса, он сам по себе будет еще считаться базовым классом и его vtbl будет от базового класса. Обычно компиляторы не детектируют такое заранее и ошибка ловится только в runtime.
Вывод: избегайте вызовов виртуальных функций в конструкторах и деструкторах, причём как явных, так и через другие функции.
Почитать подробнее про это можно на artima.com или в книжке Скотта Майерса «Effective C++», совет номер 9.
9. В вашем распоряжении 10 тысяч серверов в дата-центре с возможностью удалённого управления и один день, чтобы получить миллион долларов. Что вы для этого сделаете?
Ответ можно давать в двух направлениях.
Первое состоит в том, чтобы воспользоваться возможностью произвести на интервьювера положительное впечатление — предложить ему ваш любимый, но не реализованный пока бизнес-план. В Microsoft, например, вас скорее всего внимательно и вежливо выслушают, а затем спросят: «Да, это интересно, но вы уверены, что сможете заработать миллион долларов уже в первый день?».
А вот ответ в стиле Google: продайте серверы, по крайней мере, за 100 долларов каждый. Это принесёт вам 1 миллион долларов или, что более вероятно, еще больше — 10 миллионов. Затем, если у вас есть какой-то великолепный бизнес-план, используйте эти деньги как стартовый капитал. Это позволит вам проработать достаточно долго и успеть заинтересовать одного из венчурных капиталистов (который достаточно умён и понимает, что великие идеи не позволяют заработать миллион долларов уже в первый день).
10. У вас есть аналоговые часы с секундной стрелкой. Сколько раз в день все три стрелки часов накладываются друг на друга?
Эта задача — вариант классического вопроса, задававшегося на собеседованиях в Microsoft, когда претендентов спрашивали, сколько раз в день часовая и минутная стрелки встречаются друг с другом. Посколько этот вопрос сейчас стал широко известен, интервьюверы начали использовать его разновидность.
Рассмотрим сначала вариант наиболее ожидаемого решения, математического. Во-первых, представьте ситуацию, когда часовая и минутная стрелки наложились. Все знают, что это происходит в полночь, затем приблизительно в 1:05, 2:10, 3:15 и так далее. Другими словами, они накладываются друг на друга каждый час, за исключением периода от 11:00 до 12:00. В 11:00 более быстрая минутная стрелка находится на 12, а более медленная часовая — на 11:00. До 12:00 дня они друг с другом не встретятся, и поэтому их наложения в районе 11 часов не будет.
Таким образом, за каждый 12-часовой период происходит 11 наложений. Они равномерно распределены во времени, поскольку обе стрелки двигаются с постоянной скоростью. Это означает, что интервалы между наложениями составляют 12/11 часа. Это эквивалентно 1 часу 5 минутам 27 и 3/11 секундам. Поэтому за каждый 12-часовой цикл наложения происходят в периоды, указанные на картинке.
Вернёмся к секундной стрелке. Её наложение на минутную возможно тогда, когда число минут совпадает с числом секунд. Точное наложение происходит в 00:00:00. В целом минутные и секундные стрелки накладыватся лишь на долю секунды. Например, в 12:37:37 секундная стрелка будет показывать на 37, отставая от минутной, которая в это время будет между 37 и 38 и отставать от часовой. Через мгновение минутная и секундная наложатся, но часовой возле них не будет. Т.е. наложения всех трёх стрелок не произойдет.
Секундная стрелка не наложится ни в одном из вариантов на картинке, за исключением полуночи и полудня. Это означает, что финальный ответ на вопрос: дважды в сутки.
А вот ответ, приветствуемый в Google. Секундная стрелка предназначена для показа коротких временных интервалов, а не для сообщения времени с точностью до секунды. Если она не синхронизирована с двумя другими стрелками, это вполне нормально. Под «синхронизацией» здесь понимается, что в полночь и полдень все три стрелки указывают точно на 12. Большинство аналоговых часов всех видов не позволяют вам точно установить секундную стрелку. Нужно было бы извлечь батарейку или подождать, если говорить о механических часах, когда закончится завод пружины, а затем, когда секундная стрелка остановлена, синхронизировать минутную и часовую стрелки друг с другом, после чего дождаться, когда наступит время, показанное на часах, чтобы вернуть батарейку или завести часы.
Чтобы все это проделать, нужно быть маньяком или фанатеть от пунктуальности. Но если вы всего этого не проделаете, секундная стрелка не будет показывать «реального» времени. Она будет отличаться от точных секунд на какую-то величину в случайном интервале, доходящем до 60 секунд. Учитывая случайные расходждения, шансов на то, что все три стрелки когда-либо встретятся, не существует. Этого не случается никогда.
11. В чём разница между string и String в C#?
Ответ на самом деле очень прост: string — это просто псевдоним (alias) для System.String т.е. технически, никакой разницы нет. Так же, как и нет разницы между int и System.Int32.
Что касается стиля оформления кода, то тут есть несколько советов.
Обычно рекомендуется использовать string, когда вы имеете в виду объект:
string name = "Jessica";
В противовес случаю, когда вам нужно обратиться именно к классу, например:
string msg = String.Format("Hi, !", name);
По крайней мере этот тот стиль, которого придерживается Microsoft в своих примерах.
На картинке показан полный список псевдонимов. Единственный тип, который не имеет псевдонима — это System.IntPtr, его всегда нужно писать именно так.
Однако есть один случай, когда нужно обязательно использовать псевдонимы: в явных объявлениях типа для перечисления:
public enum Foo : UInt32 <> // Неправильно public enum Bar : uint <> // Правильно
Также рекомендуем вам относится с осторожностью к типам, когда вы реализуете какой-либо API, который может использоваться клиентами на других языках. Например, метод ReadInt32 вполне однозначен, тогда как ReadInt — нет. Тот, кто использует ваш API может пользоваться языком, в котором int является 16 или 64-битным, что не совпадает с вашей реализацией. Этому совету отлично следуют разработчики .Net Framework, хорошие примеры можно найти в классах BitConverter, BinaryReader и Convert.
12. Вы играете в футбол на пустынном острове и хотите подбросить монетку, чтобы решить, какой команде достанется мяч. Единственная монета, что у вас есть, является гнутой, и поэтому вносит явные искажения в результат при подбрасывании. Как вы тем не менее можете использовать такую монету, чтобы принять справедливое решение?
Есть два варианта решения этой задачи.
Первый состоит в том, чтобы подбрасывать монету множество раз, чтобы определить процент выпадания орла и решки. После того как вы установите, например, что монета выпадает орлом в 54.7% случаев (с установленным пределом ошибки), вы используете этот факт, чтобы продумать ставку со множеством подбрасываний, при котором шансы на получение результата будут близки к желаемому.
Второй ответ куда проще: подбросьте монету дважды. Возможны четыре исхода: ОО, ОР, РО и РР (Р — решка, О — орёл). Поскольку монета «благосклонна» к одной стороне, шансы выпадения ОО не эквивалентны шансам РР. С другой стороны, вероятности выпадения ОР и РО должны быть одинаковы, независимо от степени «благосклонности» монеты. Одна команда ставит на ОР, вторая — на РО. Если выпадает ОО или РР, игнорируйте их результаты и бросайте еще два раза.
Помимо того, что эта схема проще, она к тому же и, бесспорно, справедлива. Первый же вариант, если говорить о точности, лишь приближается к шансам пятьдесят на пятьдесят.
13. Cколько мячей для гольфа войдет в школьный автобус?
Для справки: в Национальных стандартах транспотрных средств для школ в США на 1995 год указаны максимальные размеры школьного автобуса и равны 40 футам в длину и 8.5 футам в ширину. Стандартный диаметр мяча для гольфа — 1.69 дюйма с допуском 0.005 дюймов.
Очевидно, что это задача Ферми, где от вас требуется приблизительная прикидка, правдоподобная по порядку величины. Приведём пример таких рассуждений.
Школьный автобус, как и любое другое транспортное средство, должен по своим параметрам соответствовать дорожному полотну т.е. быть не намного шире, чем легковые авто. В фильмах мы видели, что в нём есть сиденья для четырёх детей (используются ли где-то такие автобусы в России? — прим. ред.), а также проход посередине. И есть место, где может стоять учитель. Будем исходить из того, что ширина автобуса около 2.5 метра, высота примерно 2 метра. Напомним, что точные цифры не так важны, важен порядок. Сколько рядов сидений в автобусе? Пусть будет 12. Каждому ряду необходимо около метра или чуть меньше, длину примем за 11 метров. Итого общий объём будет около 55 куб. метров.
Диаметр мяча для гольфа приблизительно 3 см. Будем считать, что ~3.3 см, чтобы 30 таких мячей, положенных в ряд, составили 100 см. Кубическая конструкция из 30х30х30 таких мячей, то есть 27 000 мячей, поместится в кубическом метре. Умножим это на 55, получится что-то около 1.5 млн.
Обратите внимание, что многие вопросы Ферми связаны со сферическими спортивными предметами, заполняющими автобусы, бассейны, самолёты или стадионы. Вы можете получить дополнительные баллы, если упомяните гипотезу Кеплера. В конце 1500-х годов сэр Уолтер Рейли попросил английского математика Томаса Хэрриота придумать более эффективный способ укладки пушечных ядер на кораблях британского военного флота. Хэрриот рассказал об этой задаче своему другу астроному Иоганну Кеплеру. Кеплер предположил, что самый плотный способ упаковки сфер уже и так применяется — при укладке пушечных ядер и фруктов. Первый слой кладётся просто рядом друг с другом в виде шестиугольной формы, второй в углублениях на стыках шаров нижнего слоя я и т.д. В крупной таре при таком варианте укладки максимальная плотность составит около 74%. Кеплер полагал, что это самый плотный вариант упаковки, но не смог этого доказать.
Гипотеза Кеплера, как её назвали позднее, оставалась великой нерешённой проблемой в течение нескольких столетий. В 1900 году Дэвид Гилберт составил известный список из 23 нерешённых математических задач. Некоторые люди утверждали, что им удалось доказать эту гипотезу, однако всех их решения на поверку оказывались неудачными и относились к числу неверных. Так длилось до 1998 года, когда Томас Хэйлс предложил сложное доказательство при помощи компьютера, которое подтвердило правоту Кеплера. Большинство специалистов уверены, что его результат в конечном счёте окажется верным, хотя его проверка не закончена.
Выше мы предположили, что каждый мяч для гольфа фактически лежит в кубе из прозрачного очень тонкого пластика так, что края куба равны диаметру мяча. Это означает, что мячи занимают около 52% пространства (Pi/6, если говорить точнее, можете подсчитать сами). Если вынуть мячи из воображаемого кубика, то можно поместить в заданный объем гораздо больше мячей, это проверенный эмпирически факт. Физики проделали эксперименты, заполняя стальными шариками крупные фляги и вычисляя плотность заполнения. Результат был от 55% до 64% использования пространства. Это более плотный вариант, чем применили мы, хотя он и не дотягивает до максимума Кеплера, равного примерно 74%. К тому же разброс результатов довольно большой.
Как же нам следует поступить? Укладывать шары строго идеально в реальности мы не сможем, это слишком абсурдно даже для ответа на абсурдный вопрос. Намного более реалистичная цель — плотность, достигаемая при периодическом потряхивании или помешивании контейнера. Вы можете добиться её, если будете распределять шары с помощью палки более равномерно. Это повысит плотность примерно на 20%, чем при варианте с кубической решёткой. Тем самым можно увеличить исходную оценку до 1.8 млн мячей.
14. Представьте себе вращающийся диск, например DVD. У вас есть в распоряжении черная (Ч) и белая (Б) краски. На краю диска установлен небольшой датчик, который определяет цвет под ним и выдает результат в виде сигнала. Как бы вы раскрасили диск, чтобы было возможно определить направление вращения по показаниям датчика?
Дадим небольшое пояснение к задаче. Первое, что нужно иметь ввиду, это то, что нельзя наблюдать за самим диском. Например, вы сидите в офисе, а диск вращается в закрытой лаборатории. Единственная возможность определить направление вращения — использовать оцифрованные показания датчика, и ничего больше.
Датчик фиксирует цвет точки в непосредственном месте установки в последовательные моменты времени. Показания представляются в виде «ЧЧЧББ…». Задача сводится к такой раскраске диска, где последовательность показаний отличается при вращении в прямую и в противоположную стороны.
Дадим небольшое пояснение к задаче. Первое, что нужно иметь ввиду, это то, что нельзя наблюдать за самим диском. Например, вы сидите в офисе, а диск вращается в закрытой лаборатории. Единственная возможность определить направление вращения — использовать оцифрованные показания датчика, и ничего больше.
Датчик фиксирует цвет точки в непосредственном месте установки в последовательные моменты времени. Показания представляются в виде «ЧЧЧББ. » . Задача сводится к такой раскраске диска, где последовательность показаний отличается при вращении в прямую и в противоположную стороны, то есть последовательность не должна быть палиндромом.
Палиндромы — это такие слова или фразы, которые читаются задом наперед так же как и обычным образом. Например: топот, ротор, «лезу в узел». Придумать палиндром не так легко, в то время как привести пример асимметричной фразы очень просто. Может показаться, что так же легко придумать такую раскраску диска, однако возникает две сложности. Во-первых, в постановке задачи мы ограничиваемся только 2 буквами Ч и Б. Во-вторых, нам нужно избавиться от циклического палиндрома, так же, как и от обычного.
Например, нельзя покрасить половину диска в белый цвет, а вторую половину в черный. Показания будут как «ЧБЧБЧБЧБЧБ» . В обычном смысле это не палиндром, но это циклический палиндром. То есть, если соединить начало и конец последовательности, то получим одинаковые показания при вращении как по часовой стрелке, так и против. При наблюдении за бесконечным потоком показаний нельзя сказать, в каком направлении вращается такой диск.
Не все регулярные последовательности являются циклическими палиндромами. Если бы нам были доступны 3 цвета: черный (Ч), белый (Б) и красный (К), то можно нарисовать 3 одинаковых по площади сектора разных цветов. Тогда по часовой стрелке показания были бы вроде «ЧЧЧКККБББ» , а наоборот «ЧЧЧБББККК» . В данном случае они легко различимы. В первых показаниях красный сразу следует за черным, а на вторых показаниях красный следует за белым.
Изначальная постановка задачи не допускает использование третьего цвета, но позволяет взамен использовать раскраску «зебру». Один из трех секторов можно закрасить множеством тонких полос с чередованием черного и белого цветов. Тогда хорошо заметно, когда частые полосы идут после черного сектора (по часовой стрелке) или после белого сектора (против часовой стрелки).
Это решение можно улучшить. Ведь вам не сказано, насколько быстро вращается диск и с какой частотой датчик в состоянии регистрировать изменения цвета (грубо говоря, задержка экспозиции). Диск может вращаться настолько быстро, что датчик будет регистрировать цвет только одного места на диске и пропускать все остальные. Это может ввести в заблуждение при интерпретации полученных показаний.
Очевидно желание сделать меньшее число полос, а сами полосы шире, насколько это возможно. На самом деле достаточно 2 полосы в «полосатом секторе», если, конечно, они противоположного цвета, по отношению к смежным секторам.
При такой раскраске и при условии возможности снятия 6 показаний за 1 оборот, поворот по часовой стрелке будет давать последовательность вроде «ЧЧБЧББ» , а против часовой стрелки, эта последовательность будет идти в обратном порядке.
Также представляет интерес похожая задача, где диск уже раскрашен на две половинки в черный и белый цвета. Допускается установка неограниченного числа фиксированных датчиков у края диска. Вопрос: сколько датчиков требуется установить для определения направления вращения?
Все что мы может получить с одного датчика (при новой постановке задачи) — это соотношение черного и белого в покраске, что и так известно (50/50). Если мы возьмем 2 датчика и разместим их диаметрально противоположно, то вновь не получим ничего полезного, так как второй датчик всегда будет давать противоположное показание.
Вместо этого, можно разместить 2 датчика рядом, например первый датчик в произвольном месте, а второй в 10 градусах по часовой стрелке от первого. Большую часть времени оба датчика будут давать одинаковые показания, однако, при смене цветов, один датчик заметит изменение раньше, чем другой.
Показания датчиков могут выглядеть следующим образом:
Такие наблюдения означают, что переход Ч-Б фиксируется первым датчиком раньше, чем вторым. В этом случае переход Ч-Б и сам диск должен вращаться по часовой стрелке. Если это изменение, наоборот, фиксируется вторым датчиком раньше чем первым, то вращение происходит против часовой стрелки.
15. У вас есть исходный код приложения на языке С, которое аварийно завершается после запуска. После десяти запусков в отладчике вы обнаруживаете, что каждый раз программа падает в разных местах. Приложение однопоточное и использует только стандартную библиотеку С. Какие ошибки могут вызвать падение приложения? Как вы проверите каждую?
Вопрос в значительной степени зависит от типа диагностируемого приложения. Однако мы можем привести некоторые общие причины случайных отказов.
Чтобы найти проблему, нужно максимально изучить приложение. Кто его запускает? Что делают пользователи? Что делает само приложение?
Хотя приложение падает не в каком-то конкретном месте, возможно, само падение связано с конкретными компонентами или сценариями. Например, приложение может оставаться работоспособным в момент запуска, а сбой происходит только после загрузки файла. Или же сбой происходит в зоне ответственности компонентов низкого уровня, например при файловом вводе-выводе.
Можно делать выборочное тестирование. Закройте все остальные приложения. Очень внимательно отслеживайте все свободные ресурсы. Если есть возможность отключить части программы, сделайте это. Запустите программу на другой машине и посмотрите, возникнет ли эта ошибка. Чем больше мы можем изменить, тем легче найти проблему.
Кроме того, можно использовать специальные инструменты проверки специфических ситуаций. Например, чтобы исследовать причину появления ошибок 2-го типа, можно использовать отладчики, проверяющие неинициализированные переменные. Подобные задачи позволяют вам продемонстрировать не только умственные способности, но и стиль вашей работы. Вы постоянно перескакиваете с одного на другое и выдвигаете случайные предположения? Или вы подходите к решению задачи логически? Хотелось бы надеяться на последнее.
16. Найдите ошибки в следующем коде.
unsigned int i; for (i = 100; i >= 0; --i) printf("%d ", i);
Ответ Свернуть
В коде есть две ошибки.
Первая заключается в том, что используется тип unsigned int , который работает только со значениями, большими или равными нулю. Поэтому условие цикла for всегда будет истинно, и цикл будет выполняться бесконечно.
Корректный код, выводящий значения всех чисел от 100 до 1, должен использовать условие i > 0 . Если нам на самом деле нужно вывести нулевое значение, то следует добавить дополнительный оператор printf после цикла for .
unsigned int i; for (i = 100; i > 0; --i) printf("%d\n", i); printf("%d\n", i);
Вторая ошибка — вместо %d следует использовать %u , поскольку мы выводим целые значения без знака.
unsigned int i; for (i = 100; i > 0; --i) printf("%u\n", i);
Теперь этот код правильно выведет список чисел от 100 до 1, в убывающем порядке.
17. Объясните, что делает этот код.
Вернемся к «истокам».
Что означает A & B == 0?
Это означает, что А и B не содержат на одних и тех же позициях единичных битов. Если n & (n - 1) == 0 , то n и n - 1 не имеют общих единиц.
На что похоже n - 1 (по сравнению с n )?
Попытайтесь проделать вычитание вручную (в двоичной или десятично системах).
Когда вы отнимаете единицу, посмотрите на младший бит. 1 вы замените на 0. Но если там стоит 0, то вы должны заимствовать из старшего бита. Вы изменяете каждый бит с 0 на 1, пока не дойдете до 1. Затем вы инвертируете единицу в ноль, — все готово.
Таким образом, можно сказать, что n - 1 будет совпадать с n в каких-то битах, за исключением того, что младшим нулям в n соответствуют единицы в n - 1 , а последний единичный бит в n становится нулем в n - 1 .
Что значит n & (n - 1) == 0 ?
n и n - 1 не содержат общих единиц. Предположим, они имеют вид:
abcde должны быть нулевыми битами, то есть n имеет вид 000001000 . Таким образом, значение n — степень двойки.
Итак, наш ответ: логическое выражение ((n & (n-1)) == 0) истинно, если n является степенью двойки или равно нулю.
18. Дано 100-этажное здание. Если яйцо сбросить с высоты N-го этажа (или с большей высоты), оно разобьется. Если его бросить с любого меньшего этажа, оно не разобьется. У вас есть два яйца. Найдите N за минимальное количество бросков.
Обратите внимание, что независимо от того, с какого этажа мы бросаем яйцо №1, бросая яйцо №2, необходимого использовать линейный поиск (от самого низкого до самого высокого этажа) между этажом «повреждения» и следующим наивысшим этажом, при броске с которого яйцо останется целым. Например, если яйцо №1 остается целым при падении с 5-го по 10-й этаж, но разбивается при броске с 15-го этажа, то яйцо №2 придется (в худшем случае) сбрасывать с 11-го,12-го,13-го и 14-го этажей.
Предположим, что мы бросаем яйцо с 10-го этажа, потом с 20-го…
Это хорошо, но давайте уделим внимание самому плохому случаю. Выполним балансировку нагрузки, чтобы выделить два наиболее вероятных случая.
Таким образом, мы сначала попадаем на 14-й этаж, затем на 27-й, затем 39-й. Так что 14 шагов — худший случай.
Как и в других задачах максимизации/минимазиции, ключом к решению является «балансировка худшего случая».
19. Продолжаем задачки по С/С++. Что означает ключевое слово volatile и в каких ситуация оно может быть применено? Если даже помните формальное значение, попробуйте привести пример ситуации, где volatile на самом деле будет полезно.
Ключевое слово volatile информирует компилятор, что значение переменной может меняться извне. Это может произойти под управлением операционной системы, аппаратных средств или другого потока. Поскольку значение может измениться, компилятор каждый раз загружает его из памяти.
Волатильную целочисленную переменную можно объявить как:
Чтобы объявить указатель на эту переменную, нужно сделать следующее:
Волатильный указатель на неволатильные данные используется редко, но допустим:
Если вы хотите объявить волатильный указатель на волатильную область памяти, необходимо сделать следующее:
int volatile *volatile х;
Волатильные переменные не оптимизированы, что может пригодиться. Представьте следующую функцию:
int opt = 1; void Fn(void)
На первый взгляд кажется, программа зациклится. Компилятор может оптимизировать ее следующим образом:
void Fn(void) < start: int opt = 1; if (true) goto start; )
Вот теперь цикл точно станет бесконечным. Однако внешняя операция позволит записать 0 в переменную opt и прервать цикл.
Предотвратить такую оптимизацию можно с помощью ключевого слова volatile , например объявить, что некий внешний элемент системы изменяет переменную:
volatile int opt = 1; void Fn(void)
Волатильные переменные используются как глобальные переменные в многопотоковых программах — любой поток может изменить общие переменные. Мы не хотим оптимизировать эти переменные.
20. У вас есть отсортированная матрица размера MxN. Предложите алгоритм поиска в ней произвольного элемента. Под отсортированной матрицей будем понимать такую матрицу, строки и столбцы которой отсортированы (см. пример).
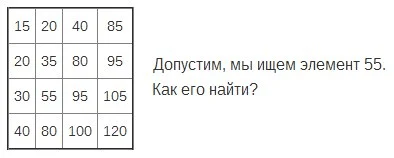
Под отсортированной матрицей будем понимать такую матрицу, строки и столбцы которой отсортированы.
Чтобы найти нужный элемент, можно воспользоваться бинарным поиском по каждой строке. Алгоритм потребует O(M log(N)) времени, так как необходимо обработать М столбцов, на каждый из которых тратится O(log(N)) времени. Также можно обойтись и без сложного бинарного поиска. Мы разберем два метода.
Решение 1: обычный поиск
Прежде чем приступать к разработке алгоритма, давайте рассмотрим простой пример:
| 15 | 20 | 40 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
Допустим, мы ищем элемент 55. Как его найти?
Если мы посмотрим на первые элементы строки и столбца, то можем начать искать расположение искомого элемента. Очевидно, что 55 не может находиться в столбце, который начинается со значения больше 55, так как в начале столбца всегда находится минимальный элемент. Также мы знаем, что 55 не может находиться правее, так как значение первого элемента каждого столбца увеличивается слева направо. Поэтому, если мы обнаружили, что первый элемент столбца больше х, нужно двигаться влево.
Аналогичную проверку можно использовать и для строк. Если мы начали со строки, значение первого элемента которой больше х, нужно двигаться вверх.
Аналогичные рассуждения можно использовать и при анализе последних элементов столбцов или строк. Если последний элемент столбца или строки меньше х, то, чтобы найти х, нужно двигаться вниз (для строк) или направо (для столбцов). Это так, поскольку последний элемент всегда будет максимальным.
Давайте используем все эти наблюдения для построения решения:
Давайте начнем со столбцов.
Мы должны начать с правого столбца и двигаться влево. Это означает, что первым элементом для сравнения будет [0][с-1], где с — количество столбцов. Сравнивая первый элемент столбца с х (в нашем случае 55), легко понять, что х может находиться в столбцах 0,1 или 2. Давайте начнем с [0][2].
Данный элемент может не являться последним элементом строки в полной матрице, но это конец строки в подматрице. А подматрица подчиняется тем же условиям. Элемент [0][2] имеет значение 40, то есть он меньше, чем наш элемент, а значит, мы знаем, что нам нужно двигаться вниз.
Теперь подматрица принимает следующий вид (серые ячейки отброшены):
| 15 | 20 | 40 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
Мы можем раз за разом использовать наши правила поиска. Обратите внимание, что мы используем правила 1 и 4.
Следующий код реализует этот алгоритм:
public static boolean findElement(int[][] matrix, int elem) < int row = 0; int col = matrix[0].length - 1; while (row < matrix.length && col >= 0) < if (matrix[row][col] == elem) < return true; >else if (matrix[row][col] > elem) < col--; >else < row++; >> return false; >
Другой подход к решению задачи — бинарный поиск. Мы получим более сложный код, но построен он будет на тех же правилах.
Решение 2: бинарный поиск
Давайте еще раз обратимся к нашему примеру:
| 15 | 20 | 70 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
Мы хотим повысить эффективность алгоритма. Давайте зададимся вопросом: где может находиться элемент?
Нам сказано, что все строки и столбцы отсортированы. Это означает, что элемент [i][j] больше, чем элементы в строке i, находящиеся между столбцами 0 и j и элементы в строке j между строками 0 и i-1.
Посмотрите на матрицу: элемент, который находится в темно-серой ячейке, больше, чем другие выделенные элементы.
| 15 | 20 | 70 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
Элементы в белых ячейках упорядочены. Каждый из них больше как левого элемента, так и элемента, находящегося выше. Таким образом, выделенный элемент больше всех элементов, находящихся в квадрате.
| 15 | 20 | 70 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
Можно сформулировать правило: нижний правый угол любого прямоугольника, выделенного в матрице, будет содержать самый большой элемент.
Аналогично, верхний левый угол всегда будет наименьшим. Цвета в приведенной ниже схеме отражают информацию об упорядочивании элементов (светло-серый < белый < темно-серый):
| 15 | 20 | 70 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
Давайте вернемся к исходной задаче. Допустим, что нам нужно найти элемент 85. Если мы посмотрим на диагональ, то увидим элементы 35 и 95. Какую информацию о местонахождении элемента 85 можно из этого извлечь?
| 15 | 20 | 70 | 85 |
| 20 | 35 | 80 | 95 |
| 30 | 55 | 95 | 105 |
| 40 | 80 | 100 | 120 |
85 не может находиться в темно-серой области, так как элемент 95 расположен в верхнем левом углу и является наименьшим элементом в этом квадрате.
85 не может принадлежать светло-серой области, так как элемент 35 находится в нижнем правом углу.
85 должен быть в одной из двух белых областей.
Таким образом, мы делим нашу сетку на четыре квадранта и выполняем поиск в нижнем левом и верхнем правом квадрантах. Их также можно разбить на квадранты и продолжить поиск.
Обратите внимание, что диагональ отсортирована, а значит, мы можем эффективно использовать бинарный поиск.
Приведенный ниже код реализует этот алгоритм:
public Coordinate findElement(int[][] matrix, Coordinate origin, Coordinate dest, int x) < if (!origin.inbounds(matrix) || !dest.inbounds(matrix)) < return null; >if (matrix[origin.row][origin.column] == x) < return origin; >else if (!origin.isBefore(dest)) < return null; >/* Установим start на начало диагонали, a end - на конец * диагонали. Так как сетка, возможно, не является квадратной, конец * диагонали может не равняться dest. */ Coordinate start = (Coordinate) origin.clone(); int diagDist = Math.min(dest.row - origin.row, dest.column - origin.column); Coordinate end = new Coordinate(start.row + diagDist, start.column + diagDist); Coordinate p = new Coordinated(0, 0); /* Производим бинарный поиск no диагонали, ищем первый * элемент больше х */ while (start.isBefore(end)) < р.setToAverage(start, end); if (x >matrix[p.row][p.column]) < start.row = p.row + 1; start.column = p.column + 1; >else < end.row = p.row - 1; end.column = p.column - 1; >> /* Разделяем сетку на квадранты. Ищем в нижнем левом и верхнем * правом квадранте */ return partitionAndSearch(matrix, origin, dest, start, x); > public Coordinate partitionAndSearch(int[][] matrix, Coordinate origin. Coordinate dest, Coordinate pivot, int elem) < Coordinate lowerLeftOrigin = new Coordinate(pivot.row, origin.column); Coordinate lowerLeftDest = new Coordinate(dest.row, pivot.column - 1); Coordinate upperRightOrigin = new Coordinate(origin.row, pivot.column); Coordinate upperRightDest = new Coordinate(pivot.row - 1, dest.column); Coordinate lowerLeft = findElement(matrix, lowerLeftOrigin, lowerLeftDest, elem); if (lowerLeft == null) < return findElement(matrix, upperRightOrigin, upperRightDest, elem); >return lowerLeft; > public static Coordinate findElement(int[][] matrix, int x) < Coordinate origin = new Coordinate(0, 0); Coordinate dest = new Coordinate(matrix.length - 1, matrix[0].length - 1); return findElement(matrix, origin, dest, x); >public class Coordinate implements Cloneable < public int row; public int column; public Coordinate(int r, int c) < row = r; column = c; >public boolean inbounds(int[][] matrix) < return row >= 0 && column >= 0 && row < matrix.length && column < matrix[0].length; >public boolean isBefore(Coordinate p) < return row public Object clone() < return new Coordinate(row, column); >public void setToAverage(Coordinate min, Coordinate max) < row = (min.row + max.row) / 2; column = (min.column + max.column) / 2; >>
Этот код довольно трудно написать правильно с первого раза.
Запомните, что вы облегчите себе жизнь, выделяя код в методы. При написании программ, концентрируйтесь на ключевых местах. А собрать все воедино вы всегда сможете.
21. Напишите метод, находящий максимальное из двух чисел, не используя операторы if-else или любые другие операторы сравнения.
Самый распространенный вариант реализации функции max — проверка знака выражения a - b . В этом случае мы не можем использовать оператор сравнения, но можем использовать умножение.
Примечание: Смысл задачи не в том, чтобы скрыть сравнение или условие в какую-нибудь стандартную функцию типа abs() или стандартный оператор типа целочисленного деления, а в том, чтобы всё это сделать вообще без инструкций ветвления на уровне процессора.
Обозначим знак выражения a - b как k . Если a - b >= 0 , то k = 1 , иначе k = 0 . Пусть q будет инвертированным значением k .
Код будет иметь вид:
/* Отражаем 1 в 0 и 0 в 1 */ int flip(int bit) < return 1^bit; >/* Возвращаем 1, если число положительное, и 0, если отрицательное*/ int sign(int a) < return flip((a >> (sizeof(int) * CHAR_BIT - 1)))) & 0x1); > int getMaxNaive(int a, int b)
Это почти работоспособный код (можете проверить). Проблемы начинаются при переполнении. Предположим, что a = INT_MAX - 2 и b = -15 . В этом случае a - b перестанет помещаться в INT_MAX и вызовет переполнение (значение станет отрицательным).
Можно использовать тот же подход, но придумать другую реализацию. Нам нужно, чтобы выполнялось условие k = 1 , когда a > b . Для этого придется использовать более сложную логику.
Когда возникает переполнение a - b ? Только тогда, когда a положительное число, а b отрицательное (или наоборот). Трудно обнаружить факт переполнения, но мы в состоянии понять, что a и b имеют разные знаки. Если у а и b разные знаки, то пусть k = sign(a) .
Логика будет следующей:
Приведенный далее код реализует этот алгоритм, используя умножение вместо операторов сравнения (проверить):
int getMax(int a, int b) < int c = a - b; int sa = sign(a); // если a >= 0, то 1, иначе 0 int sb = sign(b); // если a >= 1, то 1, иначе 0 int sc = sign(c); // зависит от переполнения a - b /* Цель: найти k, которое = 1, если а > b, и 0, если a < b. * если a = b, k не имеет значения */ // Если у а и b равные знаки, то k = sign(a) int use_sign_of_a = sa ^ sb; // Если у a и b одинаковый знак, то k = sign(a - b) int use_sign_of_c = flip(sa ^ sb); int k = use_sign_of_a * sa + use_sign_of_c * sc; int q = flip(k); // отражение k return a * k + b * q; >
Отметим, что для большей наглядности мы разделяем код на методы и вводим переменные. Это не самый компактный или эффективный способ написания кода, но так мы делаем код понятнее.
22. На пустынном шоссе вероятность появления автомобиля за 30-минутный период составляет 0.95. Какова вероятность его появления за 10 минут?
Это вопрос труден только потому, что та информация, которую вы получили, не является той, которую вы хотели бы иметь. Однако в реальной жизни такое часто встречается.
Вы хотели бы определить вероятность, относящуюся к 10 минутам, имея вероятность для 30 минут. Вы не можете поступить просто, то есть разделить 0.95 на три (хотя надо сказать, что некоторые пытаются это сделать). Не очень помогает знание вероятности того, то автомобиль проедет в течение 30 минут, поскольку это может случиться в любое время. Автомобиль может проехать в первый 10-минутный отрезок или во второй, или в третий. За каждый из этих периодов могут проехать два автомобиля или пять, или тысяча, но это все считается как проезд автомобиля.
То, что вы хотели бы на самом деле знать, — это вероятность того, что за 30-минутный период не проедет ни один автомобиль. Узнать ее довольно просто. Поскольку имеется шанс, равный 95%, что за 30 минут проедет по крайней мере один автомобиль, то вероятность того, что в течение этого временного промежутка не будет ни одной машины, должна быть равна 0.05.
Чтобы в течение 30-минутного отрезка не было ни одного автомобиля, должны случиться (или, наоборот, не случиться) три вещи. Во-первых, в течение 10 минут не должно быть ни одного автомобиля. Затем должно пройти еще 10 минут без всяких машин. И, наконец, третьи 10 минут также должны быть без автомобилей. В вопросе спрашивается вероятность появления автомобиля в течение 10-минутного периода. Назовем ее X. Вероятность отсутствия машин в эти 10 минут равна 1 - X. Умножим эту величину саму на себя три раза. Она должна быть равна 0.05, то есть
Извлечем кубический корень из обеих частей.
Решим это уравнение относительно X.
Никто не ожидает, что вы можете в уме извлекать кубические корни. Компьютер вам подскажет, что ответ равен около 0.63. Такой результат вполне обоснован. Вероятность появления автомобиля в 10-минутный период должна быть меньше, чем вероятность его появления, равная 0.95, за 30-минутный период.
23. Напишите функцию суммирования двух целых чисел без использования «+» и других арифметических операторов.
Первое, что приходит в голову, — обработка битов. Почему? У нас нет выбора — нельзя использовать оператор «+». Так что будем суммировать числа так, как это делают компьютеры!
Теперь нужно разобраться, как работает суммирование. Дополнительные задачи позволяют нам выработать новые навыки, узнать что-нибудь интересное, создать новые шаблоны.
Так что давайте рассмотрим дополнительную задачу. Мы будем использовать десятичную систему счисления.
Чтобы просуммировать 759 + 674, я обычно складываю digit[0] обоих чисел, переношу единицу, затем перехожу к digit[1], переношу и т.д. Точно так же можно работать с битами: просуммировать все разряды и при необходимости сделать переносы единиц.
Можно ли упростить алгоритм? Да! Допустим, я хочу разделить «суммирование» и «перенос». Мне придется проделать следующее:
Теперь вернемся к двоичной системе.
Следующий код реализует данный алгоритм.
public static int add(int a, int b) < if (b == 0) return a; int sum = a ^ b; // добавляем без переноса int carry = (a & b)
Задачи, связанные с реализацией базовых операций (сложение, вычитание), достаточно популярны. Чтобы решить такую задачу, нужно разобраться с тем, как обычно реализуются операции, а потом найти путь, позволяющий написать код с учетом ограничений.
24. У вас есть парк из 50 грузовиков. Каждый из них полностью заправлен и может проехать 100 км. Как далеко с их помощью вы можете доставить определенный груз? Что будет, если в вашем распоряжении N грузовиков?
Не все понимают сразу о чем речь: территориально это место, где нет никаких заправочных станций. Единственное место, где можно здесь найти горючее – это топливные баки грузовиков. Пересесть из грузовика в гибридный легковой автомобиль Prius нельзя. Бросить грузовик без топлива, где бы это ни случилось, и без водителя – в порядке вещей. И единственное, что здесь важно, – доставить как можно дальше ценный груз.
Не все понимают сразу о чем речь: территориально это место, где нет никаких заправочных станций. Единственное место, где можно здесь найти горючее — это топливные баки грузовиков. Пересесть из грузовика в гибридный легковой автомобиль Prius нельзя. Бросить грузовик без топлива, где бы это ни случилось, и без водителя — в порядке вещей. И единственное, что здесь важно, — доставить как можно дальше ценный груз.
Топлива хватит, чтобы отправить каждый из 50-ти грузовиков на расстояние 100 км, то есть на расстояние 50*100 = 5000 км. Но возможно ли считать 5000 км ответом? Нет, если только у вас нет способа, позволяющего телепортировать топливо из бака одного грузовика в другой. Вспомните, что каждый грузовик полностью заправлен и пока топливо не израсходовано, добавить его нельзя.
Начните с простого шага. Представьте, что у вас не 50 грузовиков, а всего один. Загружайте его, залезайте в кабину и отправляйтесь в путь. Через 100 км путь для вас закончится.
Теперь предположим, что у вас есть два грузовика. Загружаете первый и 100 км можете ни о чем не думать. Но потом? Сможет ли вам помочь второй грузовик? Нет. Он на расстоянии 100 км от вас. Ему придется следовать за вами, так что его бак закончится через те же 100 км.
Может быть, первому грузовику следовало бы взять второй на буксир? Когда первый грузовик останется без топлива, можно переложить груз во второй грузовик, бак которого полон, и двигаться дальше. Да, хорошо, еще 100 км.
И насколько далеко в такой сцепке сможет проехать первый грузовик? Вряд ли 100 км. Ему придется тащить вес вдвое больше обычного. Законы физики говорят, что в лучшем случае он проедет только половину прежнего расстояния. В реальной жизни расход топлива на 1 км пути для более тяжелого транспортного средства повышается более резко, чем вес.
А если посмотреть иначе? Пусть два грузовика отправляются в путь одновременно, каждый сам по себе. Через 50 км баки у каждого будут наполовину пустые, но один бак вы можете заполнить доверху. Перелейте топливо из одного бака в другой. Оставьте пустой грузовик и проезжайте на заполненном доверху баке еще 100 км. Пройденное суммарное расстояние составит 150 км. В отличие от буксировки, здесь нет теоретического ограничения, и такой подход в полной мере может быть использован на практике.
При трех грузовиках вариант с буксировкой ставится под сомнение, а вот идея с переливанием топлива по-прежнему работает отлично. Отправьте сразу три грузовика. Пусть они остановятся на трети пути расстояния в 100 км, то есть после того, как проедут примерно 33.33 км. В каждом баке осталось 2/3 топлива. Перелейте топливо из одного грузовика в баки двух других – они снова полны доверху. Затем отправьте в путь эти два грузовика. Мы уже знаем, что максимальное расстояние для них составит 150 км. Если добавить к этому пути первые 33.33 км, то общее расстояние будет чуть больше 183 км.
Закономерность становится очевидной. Один грузовик может проехать 100 км. Второй грузовик позволяет увеличить общий путь на 100/2 = 50 км. Третий грузовик увеличивает общий путь на 100/3 км. Четвертый грузовик добавляет 100/4 км. Для N грузовиков общее расстояние составит: 100*(1/1+1/2+1/3+1/4+1/5+…1/N)
Дробная часть в этом случае известна как гармонический ряд. Сумму членов гармонического ряда можно легко рассчитать. Если N равно 50, сумма этой прогрессии 4.499… Умножьте ее на 100 км, и вы увидите, что, имея в своем распоряжении 50 грузовиков, вы сможете доставить груз на 449.9 км.
При увеличении N сумма возрастает. При достаточном количестве грузовиков вы можете отвезти груз куда захотите. Однако с увеличением N расстояние увеличивается очень медленно, а эффективность использования энергии становится очень низкой. Тысячный грузовик добавит лишь 1/100 км к общему расстоянию перевозки груза (но при этом загрязнит атмосферу выбросами диоксида углерода точно так же, как и все остальные машины). Миллионный грузовик увеличит весь путь всего на несколько сантиметров.
Приведенный выше ответ имеет право на жизнь. Есть ли другой? Есть, если можно перевозить топливо, и если груз не очень тяжелый.
В вопросе говорится о грузовиках, которые предназначены для перевозок крупных и тяжелых грузов. Предположим, у вас грузовики марки GMC или Ford. Собственный вес такого полностью заправленного и оборудованного автомобиля — порядка 2250 кг. Он сконструирован так, чтобы безопасно перевозить такой тяжелый груз, если только вы не транспортируете упакованный арахис или сахарную «вату».
Бак грузовика вмещает около 30 галлонов топлива, этот объем эквивалентен примерно 120 литрам.
Ключевой вопрос: весит ли топливо меньше, чем сам грузовик? Меньше, поскольку 200/5000 составляет 1/25 веса грузовика без груза, но заправленного.
Было бы глупо буксировать или везти грузовик весом 2250 кг, когда вас интересует только 120 литров топлива в его баке. Не лучше ли везти топливо в кузове грузовика вместе с доставляемым грузом. (Может быть, вы сможете найти емкости для топлива или снять топливные баки с других грузовиков и использовать их как такие емкости.) Грузовик может перевезти топливо, эквивалентное полной заправке 25 грузовиков при условии, что полезный груз весит немного.
Это означает, что один такой грузовик может перевезти половину топлива парка, состоящего из 50 машин. Он может проехать 25*100 или 2500 км. Однако, вряд ли он это сделает, потому что перевозимый груз сократит это расстояние. Тем не менее, будем считать, что такой вариант позволит ему проехать порядка 1500 км. Это более чем в три раза превышает 450 км при варианте перелива топлива и требует всего лишь одного грузовика и одного водителя.
25. Опишите алгоритм для нахождения миллиона наименьших чисел в наборе из миллиарда чисел. Память компьютера позволяет хранить весь миллиард чисел. Если придумали какое-либо решение, то оцените его эффективность по времени. Есть ли более эффективное решение?
Существует много способов решить эту задачу. Мы остановимся только на трех — сортировка, минимум кучи и ранжирование.
Решение 1. Сортировка
Можно отсортировать элементы в порядке возрастания, а затем взять первый миллион чисел. Это потребует O(n log(n)) времени.
Решение 2. Минимум кучи
Чтобы решить эту задачу, можно использовать минимум кучи. Мы сначала создаем кучу для первого миллиона чисел с наибольшим элементом сверху.
Затем мы проходимся по списку. Вставляя элемент в список, удаляем наибольший элемент.
В итоге мы получим кучу, содержащую миллион наименьших чисел. Эффективность алгоритма O(n log(m)), где m — количество значений, которые нужно найти.
Решение 3. Ранжирование (если изменять исходный массив)
Данный алгоритм очень популярен и позволяет найти i-й наименьший (или наибольший) элемент в массиве.
Если элементы уникальны, поиск i-гo наименьшего элемента потребует О(n) времени. Основной алгоритм будет таким:
Приведенный далее код реализует этот алгоритм.
public int partition(int[] array, int left, int right, int pivot) < while (true) < while (left while (left pivot) < right--; >if (left > right) < return left - 1; >swap(array, left, right); > > public int rank(int[] array, int left, int right, int rank) < int pivot = array[randomIntInRange(left, right)]; /* Раздел и возврат конца левого раздела */ int leftEnd = partition(array, left, right, pivot); int leftSize = leftEnd - left + 1; if (leftSize == rank + 1) < return max(array, left, leftEnd); >else if (rank < leftSize) < return rank(array, left, leftEnd, rank); >else < return rank(array, leftEnd + 1, right, rank - leftSize); >>
Как только найден наименьший i-й элемент, можно пройтись по массиву и найти все значения, которые меньше или равны этому элементу.
Если элементы повторяются (вряд ли они будут «уникальными»), можно слегка модифицировать алгоритм, чтобы он соответствовал этому условию. Но в этом случае невозможно будет предсказать время его выполнения.
Существует алгоритм, гарантирующий, что мы найдем наименьший i-й элемент за линейное время, независимо от «уникальности» элементов. Однако эта задача несколько сложнее. Если вас заинтересовала эта тема, этот алгоритм приведен в книге Т. Кормен, Ч. Лейзер-сон, Р. Ривестп, К. Штайн «CLRS’ Introduction to Algorithms» (есть в переводе).
26. Напишите метод, который будет подсчитывать количество цифр «2», используемых в десятичной записи целых чисел от 0 до n (включительно). Картинка дана в качестве подсказки к одному из возможных решений.
Как всегда, сначала мы попробуем решить задачу «в лоб».
/* Подсчитываем число '2' между 0 и n */ int numberOf2sInRange(int n) < int count = 0; for (int i = 2; i return count; > /* подсчитываем число '2' в одном числе */ int numberOf2s(int n) < int count = 0; while (n >0) < if (n % 10 == 2) < count++; >n = n / 10; > return count; >
Единственное интересное место в этом алгоритме — выделение numberOf2s в отдельный метод. Это делается для чистоты кода.
Улучшенное решение
Можно смотреть на задачу не с точки зрения диапазонов чисел, а с точки зрения разрядов — цифра за цифрой.
0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 . 110 111 112 113 114 115 116 117 118 119
Мы знаем, что в последовательном ряду из десяти чисел последний разряд принимает значение 2 только один раз. И вообще, любой разряд может быть равен 2 один раз из десяти.
Хотя тут стоит использовать слово «приблизительно», потому что необходимо учитывать граничные условия. Посчет количества двоек для диапазонов 1-100 и 1-37 будет различаться.
Точно количество двоек можно вычислить, рассмотрев все по отдельности разряды: digit < 2, digit = 2 и digit > 2.
Случай: digit < 2
Если x = 61523 и d = 3, то x[d] = 1 (это означает, что d-й разряд x равен 1). Рассмотрим двойки, находящиеся в 3-м разряде, в диапазонах 2000-2999, 12000-12999, 22000-22999, 32000-32999, 42000-42999 И 52000-52999. Мы не будем учитывать диапазон 62000-62999. В перечисленные диапазоны попадает 6000 двоек, находящихся в 3-м разряде. Такое же количество двоек можно получить, если подсчитать все двойки в 3-м разряде в диапазоне чисел от 1 до 6000.
d+1 , а затем разделить на 10.
if x[d] < 2: count2sInRangeAtDigit(x, d) =
let y = round down до ближайшего 10 d+1
return y / 10
Случай: digit > 2
Давайте рассмотрим случай, когда значение d-гo разряда больше, чем 2 (х[d] > 2). Если использовать ту же логику, становится понятно, что количество двоек в 3-м разряде диапазона 0-63525 будет таким же, как в диапазоне 0-7000. Таким образом, вместо округления вниз мы будем округлять вверх.
if x[d] > 2: count2sInRangeAtDigit(x, d) =
let y = round up до ближайшего 10 d+1
return y / 10
Случай: digit = 2
Последний случай самый трудный, но мы можем использовать ту же логику. Пусть х = 62523 и d = 3. Мы знаем, что диапазоны не изменились (2000-2999, 12000-12999, . 52000-52999). Сколько двоек может появиться в 3-м разряде в диапазоне 62000-62523? Подсчитать несложно — 524 (62000, 62001, . 62523).
if x[d] > 2: count2sInRangeAtDigit(x, d) =
let y = округляем вниз до 10 d+1
let z = правая сторона x (т.е. х % 10d)
return y / 10 + z + 1
Теперь нам нужно пройтись по каждой цифре в числе. Реализация данного кода относительно проста:
public static int count2sInRangeAtDigit(int number, int d) < int powerOf10 = (int) Math.pow(10, d); int nextPowerOf10 = powerOf10 * 10; int right = number % powerOf10; int roundDown = number - number % nextPowerOf10; int roundUp = roundDown + nextPowerOf10; int digit = (number / powerOf10) % 10; if (digit < 2) < // если digit меньше 2 return roundDown / 10; >else if (digit == 2) < return roundDown / 10 + right + 1; >else < return roundUp / 10; >> public static int count2sInRange(int number) < int count = 0; int len = String.valueOf(number).length(); for (int digit = 0; digit < len; digit++) < count += count2sInRangeAtDigit(number, digit); >return count; >
Данная задача требует тщательного тестирования. Убедитесь, что вы знаете все граничные случаи и проверили каждый из них.
27. Где вы будете плыть быстрее — в воде или сиропе?
Это классическая задача с долгой историей, которую обсуждал в своё время еще Исаак Ньютон. Когда-то она использовалась и на IT-собеседованиях в Google (сейчас — нет). Тем не менее предлагаем вам порассуждать над решением.
Исаак Ньютон и Христиан Гюйгенс обсуждали этот вопрос в 1600-е годы, но так и не дали на него исчерпывающий ответ. Три столетия спустя два химика из Университета Миннесоты, Брайан Геттельфингер и Эдвард Касслер проделали эксперимент для сравнения сиропа и воды. Может быть, не стоит удивляться, что его проведение заняло много времени. Касслер рассказал, что ему потребовалось получить 22 согласования, в том числе и разрешение на то, чтобы затем вылить большой объем сиропа в канализационную систему. Ему пришлось отказаться от предложенных 20-ти грузовиков с бесплатным кукурузным сиропом, поскольку руководство университета посчитало, что он будет опасен для канализационной системы Миннеаполиса. Вместо этого Касслер использовал пищевой загуститель, применяемый для производства мороженого, шампуней и заправок для салата. Около 300 кг этого вещества вылили в плавательный бассейн. «Сказать по правде, смесь эта походила на сопли», — заметил Касслер. И все же это были не сопли, а размазня примерно вдвое плотнее воды.
Брайан Геттельфингер, пловец, подававший надежды и претендент на участие в Олимпиаде, получил уникальную возможность опробовать плавание в новой для себя жидкости. Результаты были опубликованы в 2004 году в American Institute of Chemical Engineers Journal. На следующий год Геттельфингер и Касслер получили Шнобелевскую премию по химии за 2005 год. Шнобелевская премия – это юмористический вариант более известных наград, присуждаемых в Стокгольме, но благодаря широкому освещению в новостях об этой премии многим известно. Может быть, именно внимание СМИ к этой задаче о сиропе и объясняет ее повторное появление в списке садистских вопросов, задаваемых на собеседовании.
В описываемом здесь эксперименте вязкость сиропообразной жидкости была примерно в два раза больше, чем у обычной воды, а вот плотности обеих жидкостей были примерно одинаковыми. Это важно, потому что, как пловцы уже давно знают, в более плотной соленой воде люди плавают быстрее. Как и корабль, тело пловца в соленой воде располагается выше, из-за чего сопротивление его движению вперед снижается.
Геттельфингер и студенты из Миннесоты плавали на скорость и в воде, и в «сиропе» стандартными стилями: на спине, брассом, баттерфляй, вольным. Но ни разу скорость плавания в обеих жидкостях не различалась более чем на несколько процентных пунктов. Выявить какой-то общей закономерности, позволяющей отдать предпочтение сиропу или воде, не удалось.
Это означало, что Ньютон был неправ: он полагал, что вязкость сиропа замедлит движение пловцов. Гюйгенс верно предсказывал, что заметной разницы в скорости не будет. Статья Геттельфингера и Касслера подтвердила обоснованность взглядов Гюйгенса. Вспомните о том, как поднимается дым от сигареты: на расстоянии нескольких сантиметров от сигареты он видится в виде ровной вертикальной колонны, однако выше его форма становится более сложной, так как начинают возникать воронки и завихрения. Воронки являются результатом турбулентности. Турбулентность мешает реактивным самолетам, быстроходным катерам и всем телам, которые хотят быстрее пройти через поток. Поскольку человеческое тело не оптимизировано для плавания, то когда мы плаваем, мы создаем до смешного много турбулентности, с которой затем сражаемся, чтобы переместить себя в воде. Турбулентность создает гораздо большее сопротивление движению, чем вязкость. Более того, вязкость здесь вообще вряд ли что-то значит. Поскольку турбулентность возникает и в воде, и в сиропе, скорость плавания в этих жидкостях приблизительно одинакова.
Поток воды намного менее турбулентен для рыб и особенно для бактерий, которые в сиропе будут плыть медленнее.
Можно ли считать этот вопрос на собеседовании честным? Касслер говорил, что для ответа на вопрос о плавании в сиропе «не нужно, скорее всего, обладать хорошими познаниями в компьютерных науках», добавив, что «любой человек, имеющий базовые знания в физике, сможет на него ответить». Тот, кто серьезно изучает физику может увидеть, что это излишне оптимистическая точка зрения. В любом случае, большинство претендентов, кому этот вопрос задают на собеседованиях при приеме на работу, не знают физику достаточно глубоко. Поэтому хорошие ответы предусматривают использование простых интуитивных аналогий, объясняющих, почему решение необходимо получить при помощи эксперимента. Вот четыре аргумента.
1. Некоторые жидкости слишком густые, чтобы в них можно было бы плавать.
Попросите мастодонтов поплавать в битумных озерах. Представьте попытку поплавать в жидком цементе или зыбучих песках. Разумеется, в очень густых жидкостях, хотя сила отталкивания здесь и больше, вы будете плыть значительно медленнее, чем в воде, если вообще вам это удастся сделать.
2. Под понятием «сироп» можно понимать очень широкий диапазон жидкостей.
В вопросе не говорится о смоле или зыбучих песках, а только о сиропе. А сиропы бывают очень разными, к примеру, кленовый сироп, сироп от кашля, шоколадный сироп, кукурузный сироп с большим содержанием фруктозы и те жидкости с разными консистенциями, варьирующиеся от водянистого напитка до густого осадка, остающегося на дне бутылки. На заданный вопрос нельзя ответить, пока вы не узнаете, о каком именно сиропе идет речь, или пока вы не сможете доказать, что плавание будет медленным в любой жидкости, более густой, чем вода.
3. Предположим, имеется оптимальный уровень вязкости, при которой скорость плавания является максимальной. Есть ли причина верить, что такой оптимальной жидкостью для плавания окажется H2O?
Может быть, вы с этим утверждением и согласились бы, будь вы очень проницательной рыбой. Эволюция постаралась, чтобы рыбы «соответствовали» той среде, а это вода, которая обтекает их изящные тела. Люди не очень похожи на рыб, и способ, каким мы плаваем, не очень напоминает то, как это делают рыбы. Никто из людей и наших ближайших предков не проводил много времени в бассейнах, а также в реках, озерах и океанах, чтобы сформировать такой набор генов, который был бы в значительной степени ориентирован на плавание. Конечно, мы иногда плаваем и даже порой летаем на параплане, но мы не созданы для этих занятий. Существо, заточенное под плавание австралийским кролем, слишком не похоже на человека. Эдвард Касслер по этому поводу сказал: «Идеальный пловец должен иметь тело змеи и руки гориллы».
Что уж тут удивляться, что можно отыскать людей, способных плавать быстрее в жидкости с другой вязкостью, чем у воды. Не будет удивительным и открытие, что скорость плавания является одинаковой в жидкостях с самыми разными вязкостями.
4. Плавание является хаотичным процессом.
Движение жидкости и газов — это пример хаоса, приводимый в учебниках. Слишком многое зависит от мельчайших деталей, чтобы заниматься предсказанием исхода. Вот почему для тестирования своих конструкций разработчикам самолетов нужны аэродинамические трубы. Не приспособленное хорошо к плаванию человеческое тело с его относительно неуклюжими движениями в воде еще больше осложняет ответ. Вот поэтому -то вопрос из тех, для которых необходимо провести эксперименты – с конкретным видом сиропа.
Речь, с которой Касслер выступил при вручении ему Шнобелевской премии, была краткой: «Причины этого сложны».
28. Напишите методы для умножения, вычитания и деления целых чисел, используя из арифметических операций только оператор суммирования. Язык реализации не важен, об оптимизации скорости работы и использования памяти также можете не особо беспокоиться. Главное, что можно использовать только сложение. В подобных задачах полезно вспомнить суть математических операций.
В этой задаче можно использовать только сложение. В подобных задачах полезно вспомнить суть математических операций и как их можно реализовать с помощью сложения (или других операций).
Вычитание
Как реализовать вычитание с помощью сложения? Это предельно просто. Операция a — b — то же самое, что и a + (-1) * b. Посколько мы не можем использовать оператор умножения, нам придется создать функцию negate.
public static int negate(int a) < int neg = 0; int d = a < 0 ? 1 : -1; while (a != 0) < neg += d; a += d; >return neg; > public static int subtract(int a, int b)
Отрицательное значение k получается суммированием k раз числа -1.
Умножение
Связь между сложением и умножением тоже достаточно очевидна. Чтобы перемножить a и b, нужно сложить значение a с самим собой b раз.
public static int multiply(int a, int b) < if (a < b) < return multiply(b, a); // алгоритм будет быстрее, если b < a >int sum = 0; for (int i = abs(b); i > 0; i--) < sum += a; >if (b < 0) < sum = negate(sum); >return sum; > public static int abs(int a) < if (a < 0) < return negate(a); >else < return a; >>
При умножении нам нужно обратить особое внимание на отрицательные числа. Если b — отрицательное число, то необходимо учесть знак суммы:
Кроме того, для решения это задачи мы создали простую функцию abs.
Деление
Самая сложная из математических операций — деление. Хорошая идея — использовать для реализации метода divide методы multiply, subtract и negate.
Нам нужно найти x, если x = a / b. Давайте переформулируем задачу: найти x, если a = bx. Теперь мы изменили условие так, чтобы задачу можно было решить с помощью уже известной нам операции — умножения.
Обратите внимание, что можно вычислить x как результат суммирования b, пока не будет получено a. Количество экземпляров b, необходимых, чтобы получить a, и будет искомой величиной x.
Конечно, это решение нельзя назвать полноценным делением, но оно работает. Вы должны понимать, что при такой реализации не получить остаток от деления.
Приведенный ниже код реализует данный алгоритм:
public int divide(int a, int b) throws java.lang.ArithmeticException < if ( b == 0) < throw new java.lang.ArithmeticException("ERROR"); >int absa = abs(a); int absb = abs(b); int product = 0; int x = 0; while (product + absb if ((a < 0 && b < 0) || (a >0 && b > 0)) < return x; >else < return negate(x); >>
29. Допустим, вы пишете конвейер, в котором 2 потока, используя общий буфер, обрабатывают данные. Поток-producer эти данные создает, а поток-consumer их обрабатывает (Producer–consumer problem). Следующий код представляет собой самую простую модель: с помощью std::thread мы порождаем поток-consumer, a создавать данные мы будем в главном потоке.
Опустим механизмы синхронизации двух потоков, и обратим внимание на функцию main(). Попробуйте догадаться, что с этим кодом не так, и как его исправить?
void produce() < // создаем задачу и кладем в очередь >void consume() < // читаем данные из очереди и обрабатываем >int main(int , char **) < std::thread thr(consume); // порождаем поток produce(); // создаем данные для обработки thr.join(); // ждем завершения работы функции consume() return 0; >
Ответ Свернуть
Допустим, вы пишете конвейер, в котором 2 потока, используя общий буфер, обрабатывают данные. Поток-producer эти данные создает, а поток-consumer их обрабатывает (Producer–consumer problem). Следующий код представляет собой самую простую модель: с помощью std::thread мы порождаем поток-consumer, a создавать данные мы будем в главном потоке.
void produce() < // создаем задачу и кладем в очередь >void consume() < // читаем данные из очереди и обрабатываем >int main(int , char **) < std::thread thr(consume); // порождаем поток produce(); // создаем данные для обработки thr.join(); // ждем завершения работы функции consume() return 0; >
Опустим механизмы синхронизации двух потоков, и обратим внимание на функцию main() . Попробуйте догадаться, что с этим кодом не так, и как его исправить?
В С++, если не сказано иного, принято считать, что каждая функция может выбросить исключение.
Допустим, функция consume() бросает исключение. Поскольку это исключение генерируется в дочернем потоке, поймать и обработать его в главном потоке нельзя. Если во время развертывания стека дочернего потока не нашлось подходящего обработчика исключения, будет вызвана функция std::terminate() , которая по-умолчанию вызовет функцию abort() . Иными словами, если не обработать исключение в потоке, порожденном объектом thr , то программа завершит свою работу с ошибкой.
С функцией produce() немного сложнее. Допустим, эта функция генерирует исключение. Первое, что хочется сделать, это обернуть тело main() в try-catch блок:
try < std::thread thr(consume); produce(); // бросает исключение thr.join(); >catch (. )
Кажется, что проблема решена, но если вы попытаетесь запустить этот код, то программа упадет в любом случае. Почему так происходит? Давайте разбираться.
std::thread
Как вы уже, может быть, догадались, проблема не имеет отношение к конвейеру, а относится к правильному использованию потоков выполнения стандартной библиотеки в принципе. В частности следующая обобщенная функция равнозначна, и имеет те же проблемы:
void run(function f1, function f2) < std::thread thr(f1); f2(); thr.join(); >. run(consume, produce); .
Прежде чем перейти к решению нашей задачи, давайте вкратце вспомним как работает std::thread .
1) конструктор для инициализации:
template explicit thread (Fn&& fn, Args&&. args);
При инициализации объекта std::thread создается новый поток, в котором запускается функция fn с возможными аргументами args . При успешном его создании, конкретный экземпляр объекта начинает представлять этот поток в родительском потоке, а в свойствах объекта выставляется флаг joinable .
Запомним: joinable ~ объект связан с потоком.
2) Ждем конца выполнения порожденного потока:
void thread::join();
Этот метод блокирует дальнейшее выполнение родительского потока, до тех пока не будет завершен дочерний. После успешного выполнения, объект потока перестает его представлять, поскольку нашего потока больше не существует. Флаг joinable сбрасывается.
3) Немедленно «отсоединяем» объект от потока:
void thread::detach();
Это неблокирующий метод. Флаг joinable сбрасывается, а дочерний поток предоставлен сам себе и завершит свою работу когда-нибудь позже.
thread::~thread();
Деструктор уничтожает объект. При этом если, у этого объекта стоит флаг joinable , то вызывается функция std::terminate() , которая по умолчанию вызовет функцию abort() .
Внимание! Если мы создали объект и поток, но не вызвали join или detach , то программа упадет. В принципе, это логично — если объект до сих пор связан с потоком, то надо что-то с ним делать. А еще лучше — ничего не делать, и завершить программу (по крайней мере так решил комитет по стандарту).
Поэтому при возникновении исключения в функции produce() , мы пытаемся уничтожить объект thr , который является joinable .
Ограничения
Почему же стандартный комитет решил поступить так и не иначе? Не лучше было бы вызвать в деструкторе join() или detach() ? Оказывается, не лучше. Давайте разберем оба этих случая.
Допустим, у нас есть класс joining_thread , который так вызывает join() в своем деструкторе:
joining_thread::~joining_thread()
Тогда, прежде чем обработать исключение, мы должны будем подождать завершения работы дочернего потока, поскольку join() блокирует дальнейшее выполнение программы. А если так получилось, что порожденном потоке оказался в бесконечный цикл?
void consume() < while(1) < . >> . try < joining_thread thr(consume); throw std::exception(); >catch (. ) < // может случится не скоро, или даже никогда >
Хорошо, мы выяснили, что join() в деструкторе лучше не вызывать (до тех пор пока вы не уверены, что это корректная обработка события), поскольку это блокирующая операция. А что насчет detach() ? Почему бы не вызвать в деструкторе этот неблокирующий метод, дав главному потоку продолжить работу? Допустим у нас есть такой класс detaching_thread .
Но тогда мы можем прийти к такой ситуации, когда порожденный поток пытается использовать ресурс, которого уже нет, как в следующей ситуации:
try < int data; detaching_thread th(consume, &data); // в данном случае consume принимает указатель на int в качестве аргумента throw std::exception() >catch (. ) < // корректно обработаем исключение // consume продолжает исполняться, но ссылается на уже удаленный объект data >
Таким образом, создатели стандарта решили переложить ответственность на программиста — в конце концов ему виднее, как программа должна обрабатывать подобные случаи. Исходя из всего этого, получается, что стандартная библиотека противоречит принципу RAII — при создании std::thread мы сами должны позаботиться о корректном управлении ресурсами, то есть явно вызвать join или detach . По этой причине некоторые программисты советуют не использовать объекты std::thread. Так же как new и delete, std::thread предоставляет возможность построить на основе них более высокоуровневые инструменты.
Решение
Одним из таких инструментов является класс из библиотеки Boost boost::thread_joiner . Он соответствует нашему joining_thread в примере выше. Если вы можете позволить себе использовать сторонние библиотеки для работы с потоками, то лучше это сделать.
Другое решение — позаботиться об это самому в RAII-стиле, например так:
class Consumer < public: Consumer() : exit_flag(false) , thr( &Consumer::run, this ) < // после создания потока не делайте тут ничего, что бросает исключение, // поскольку в этом случае не будет вызван деструктор объекта Consumer, // поток не будет завершен, а программа упадет >~Consumer() < exit_flag = true; // говорим потоку остановиться thr.join(); >private: std::atomic exit_flag; // флаг для синхронизации (опционально) std::thread thr; void run() < while (!exit_flag) < // делаем что-нибудь >> >;
В случае, если вы собираетесь отделить поток от объекта в любом случае, лучше сделать это сразу же:
std::thread(consume).detach(); // создаем поток, и сразу же освобождаем объект, связанный с ним
Ссылки:
30. Дано 20 баночек с таблетками. В 19 из них лежат таблетки весом 1 г, а в одной – весом 1.1 г. Даны весы, показывающие точный вес. Как за одно взвешивание найти банку с тяжелыми таблетками?
Иногда «хитрые» ограничения могут стать подсказкой. В нашем случае подсказка спрятана в информации о том, что весы можно использовать только один раз.
У нас только одно взвешивание, а это значит, что придется одновременно взвешивать много таблеток. Фактически, мы должны одновременно взвесить 19 банок. Если мы пропустим две (или больше) банки, то не сможем их проверить. Не забывайте: только одно взвешивание!
Как же взвесить несколько банок и понять, в какой из них находятся «дефектные» таблетки? Давайте представим, что у нас есть только две банки, в одной из них лежат более тяжелые таблетки. Если взять по одной таблетке из каждой банки и взвесить их одновременно,то общий вес будет 2.1 г, но при этом мы не узнаем, какая из банок дала дополнительные 0.1 г. Значит, надо взвешивать как-то иначе.
Если мы возьмем одну таблетку из банки №1 и две таблетки из банки №2, то, что покажут весы? Результат зависит от веса таблеток. Если банка №1 содержит более тяжелые таблетки, то вес будет 3.1 г. Если с тяжелыми таблетками банка №2 — то 3.2 грамма. Подход к решению задачи найден.
Можно обобщить наш подход: возьмем одну таблетку из банки №1, две таблетки из банки №2, три таблетки из банки №3 и т.д. Взвесьте этот набор таблеток. Если все таблетки весят 1 г, то результат составит 210 г. «Излишек» внесет банка с тяжелыми таблетками.
Таким образом, номер банки можно узнать по простой формуле: (вес — 210) / 0.1. Если суммарный вес таблеток составляет 211.3 г, то тяжелые таблетки находились в банке №13.
31. Дана шахматная доска размером 8×8, из которой были вырезаны два противоположных по диагонали угла, и 31 кость домино; каждая кость домино может закрыть два квадратика на поле. Можно ли вымостить костями всю доску? Дайте обоснование своему ответу.
С первого взгляда кажется, что это возможно. Доска 8×8, следовательно, есть 64 клетки, две мы исключаем, значит остается 62. Вроде бы 31 кость должна поместиться, правильно?
Когда мы попытаемся разложить домино в первом ряду, то в нашем распоряжении только 7 квадратов, одна кость переходит на второй ряд. Затем мы размещаем домино во втором ряду, и опять одна кость переходит на третий ряд.
В каждом ряду всегда будет оставаться одна кость, которую нужно перенести на следующий ряд, не имеет значения сколько вариантов раскладки мы опробуем, у нас никогда не получится разложить все кости.
Шахматная доска делится на 32 черные и 32 белые клетки. Удаляя противоположные углы (обратите внимание, что эти клетки окрашены в один и тот же цвет), мы оставляем 30 клеток одного и 32 клетки другого цвета. Предположим, что теперь у нас есть 30 черных и 32 белых квадрата.
Каждая кость, которую мы будем класть на доску, будет занимать одну черную и одну белую клетку. Поэтому 31 кость домино займет 31 белую и 31 черную клетки. Но на нашей доске всего 30 черных и 32 белых клетки. Поэтому разложить кости невозможно.
32. Дан входной файл, содержащий четыре миллиарда целых 32-битных чисел. Предложите алгоритм, генерирующий число, отсутствующее в файле. Имеется 1 Гбайт памяти для этой задачи. Дополнительно: а что если у вас всего 10 Мбайт? Количество проходов по файлу должно быть минимальным.
В нашем распоряжении 2 32 (или 4 миллиарда) целых чисел. У нас есть 1 Гбайт памяти, или 8 млрд бит.
8 млрд бит — вполне достаточный объем, чтобы отобразить все целые числа. Что нужно сделать?
Следующий код реализует наш алгоритм:
byte[] bitfield = new byte [0xFFFFFFF/8]; void findOpenNumber2() throws FileNotFoundException < Scanner in = new Scanner(new FileReader("file.txt")); while (in.hasNextInt()) < int n = in.nextInt (); /* Находим соответствующее число в bitfield, используя * оператор OR для установки n-го бита байта * (то есть 10 будет соответствовать 2-му биту индекса 2 * в массиве байтов). */ bitfield [n / 8] |= 1 for (int i = 0; i < bitfield.length; i++) < for (int j = 0; j < 8; j++) < /* Получает отдельные биты каждого байта. Когда будет найден * бит 0, находим соответствующее значение. */ if ((bitfield[i] & (1 > > >
Решение для 10 Мбайт памяти
Можно найти отсутствующее число, воспользовавшись двойным проходом по данным. Давайте разделим целые числа на блоки некоторого размера (мы еще обсудим, как правильно выбрать размер). Пока предположим, что мы используем блоки размером 1000 чисел. Так, blоск0 соответствует числам от 0 до 999, block1 — 1000 — 1999 и т.д.
Нам известно, сколько значений может находиться в каждом блоке. Теперь мы анализируем файл и подсчитываем, сколько значений находится в указанном диапазоне: 0-999, 1000-1999 и т.д. Если в диапазоне оказалось 998 значений, то «дефектный» интервал найден.
На втором проходе мы будем искать в этом диапазоне отсутствующее число. Можно воспользоваться идеей битового вектора, рассмотренного в первой части задачи. Нам ведь не нужны числа, не входящие в конкретный диапазон.
Как же выбрать размер блока? Давайте введем несколько переменных:
Нам нужно выбрать значение rangeSize так, чтобы памяти хватило и на первый (массив) и на второй (битовый вектор) проходы.
Первый проход: массив
Массив на первом проходе может вместить 10 Мбайт, или 2 23 байт, памяти. Поскольку каждый элемент в массиве относится к типу int, а переменная типа int занимает 4 байта, мы можем хранить примерно 2 21 элементов.
Второй проход: битовый вектор
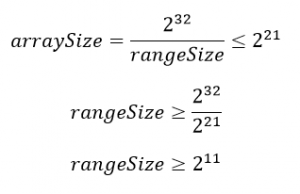
Нам нужно место, чтобы хранить rangeSize бит. Поскольку в память помещается 2 23 байт, мы сможем поместить 2 26 бит в памяти. Таким образом:
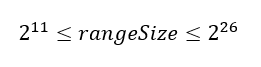
Мы получаем достаточно пространства для «маневра», но чем ближе к середине, которую мы выбираем, тем меньше памяти будет использоваться в любой момент времени.
Нижеприведенный код предоставляет одну реализацию для этого алгоритма:
int bitsize = 1048576; // 2^20 bits (2^17 bytes) int blockNum = 4096; // 2^12 byte[] bitfield = new byte[bitsize/8]; int[] blocks = new int[blockNum]; void findOpenNumber() throws FileNotFoundException < int starting = -1; Scanner in = new Scanner (new FileReader ("file.txt")); while (in.hasNextInt()) < int n = in.nextInt(); blocks[n / (bitfield.length * 8)]++; >for (int i = 0; i < blocks.length; i++) < if (blocks[i] < bitfield.length * 8) < /* если значение < 2^20, то отсутствует как минимум 1 число * в этой секции. */ starting = i * bitfield.length * 8; break; >> in = new Scanner(new FileReader("input_file.txt")); while (in.hasNextInt()) < int n = in.nextInt(); /* Если число внутри блока, в котором отсутствуют числа, * мы записываем его */ if (n >= starting && n < starting + bitfield.length * 8) < bitfield[(n - starting) / 8] |= 1 > for (int i = 0 ; i < bitfield.length; i++) < for (int j = 0; j < 8; j++) < /* Получаем отдельные биты каждого байта. Когда бит 0 * найден, находим соответствующее значение. */ if ((bitfield[i] & (1 > > >
А что если вам нужно решить задачу, используя более серьезные ограничения на использование памяти? В этом случае придется сделать несколько проходов. Сначала пройдитесь по «миллионным» блокам, потом по тысячным. Наконец, на третьем проходе можно будет использовать битовый вектор.
33. Предложите алгоритм, генерирующий все корректные комбинации пар круглых скобок. Под корректными комбинациями пар будем понимать правильно открытые и закрытые скобки. На вход подаётся число пар скобок, на выходе должны быть все возможные их комбинации в виде набора строк.
Под корректными комбинациями пар будем понимать правильно открытые и закрытые скобки. На вход подаётся число пар скобок, на выходе должны быть все возможные их комбинации в виде набора строк.
Первая мысль — использовать рекурсивный подход, который строит решение для f(n), добавляя пары круглых скобок в f(n-1). Это, конечно, правильная мысль.
Рассмотрим решение для n = 3:
Как получить это решение из решения для n = 2?
Можно расставить пары скобок в каждую существующую пару скобок, а также одну пару в начале строки. Другие места, куда мы могли вставить скобки, например в конце строки, получатся сами собой.
Итак, у нас есть следующее:
(()) -> (()()) /* скобки вставлены после первой левой скобки */ -> ((())) /* скобки вставлены после второй левой скобки */ -> ()(()) /* скобки вставлены в начале строки */ ()() -> (())() /* скобки вставлены после первой левой скобки */ -> ()(()) /* скобки вставлены после второй левой скобки */ -> ()()() /* скобки вставлены в начале строки */
Но постойте! Некоторые пары дублируются! Строка ()(()) упомянута дважды! Если мы будем использовать данный подход, то нам понадобится проверка дубликатов перед добавлением строки в список. Реализация такого метода выглядит так:
public static Set generateParens(int remaining) < Setset = new HashSet(); if (remaining == 0) < set.add(""); >else < Setprev = generateParens(remaining - 1); for (String str : prev) < for (int i = 0; i < str.length(); i++) < if (str.charAt(i) == '(') < String s = insertInside(str, i); if (!set.contains(s)) < set.add(s); >> > if (!set.contains("()" + str)) < set.add("()" + str); >> > return set; > public String insertInside(String str, int leftIndex)
Алгоритм работает, но не очень эффективно. Мы тратим много времени на дублирующиеся строки.
Избежать проблемы дублирования можно путем построения строки с нуля. Этот подход подразумевает, что мы добавляем левые и правые скобки, пока наше выражение остается правильным.
При каждом рекурсивном вызове мы получаем индекс определенного символа в строке. Теперь нужно выбрать скобку (левую или правую). Когда использовать левую скобку, а когда — правую?
Таким образом, нам нужно отслеживать количество открывающих и закрывающих скобок. Если в строку можно вставить левую скобку, добавляем ее и продолжаем рекурсию. Если левых скобок больше, чем правых, то вставляем правую скобку и продолжаем рекурсию.
public void addParen(ArrayList list, int leftRem, int rightRem, char[] str, int count) < if (leftRem < 0 || rightRem < leftRem) return; // некорректное состояние if (leftRem == 0 && rightRem == 0) < /* нет больше левых скобок */ String s = String.copyValueOf(str); list.add(s); >else < /* Добавляем левую скобку, если остались любые левые скобки */ if (leftRem >0) < str[count] = '('; addParen(list, leftRem - 1, rightRem, str, count + 1); >/* Добавляем правую скобку, если выражение верно */ if (rightRem > leftRem) < str[count] = ')'; addParen(list, leftRem, rightRem - 1, str, count + 1); >> > public ArrayList generateParens(int count) < char[] str = new char[count * 2]; ArrayListlist = new ArrayList(); addParen(list, count, count, str, 0); return list; >
Поскольку мы добавляем левые и правые скобки для каждого индекса в строке, индексы не повторяются, и каждая строка гарантированно будет уникальной.
34. Вы поставили стакан воды на диск проигрывателя виниловых пластинок и медленно увеличиваете скорость вращения. Что произойдет раньше: стакан сползет в сторону, стакан опрокинется, вода расплескается?
Этот вопрос задавали ранее на собеседованиях в Apple. При ответе рассмотрите возможные варианты и укажите, от чего зависит ответ, если их несколько.
Этот вопрос задавали ранее в Apple. Большинство людей понимают, что при его анализе необходимо учесть центробежную силу. В равной степени вам нужно знать и силу трения. Оно возникает между дном стакана и вращающимся диском, который приводит стакан в движение.
Чтобы сделать ситуацию более понятной, представьте мир, где трение вообще отсутствует. Каждая вещь становится более скользкой, чем тефлон, причем более скользкой бесконечно. Тогда в эксперименте, описанном в вопросе, не будет никакого влияния на стакан. Диск проигрывателя будет вращаться под стаканом, не оказывая на него никакого влияния, то есть стакан вообще не будет двигаться. Это верно в соответствии с первым законом Ньютона: неподвижные объекты остаются в этом положении до тех пор, пока на них не воздействует какая-то сила. Без силы трения стакан не будет перемещаться.
Теперь представьте противоположный вариант: стакан при помощи очень прочного клея Krazy Glue приклеили к диску, и между двумя поверхностями появилась практически бесконечно высокая сила трения. Стакан и диск в этом случае будут вращаться как единое целое. Увеличьте скорость диска, и стакан будет вращаться быстрее. Это приведет к увеличению центробежной силы. Единственное, что сможет в этих условиях свободно реагировать на эту силу, будет вода. Ведь она-то ко дну стакана не приклеена. Когда стакан будет крутиться с достаточно большой скоростью, вода прольется в сторону, противоположную центру вращения.
В вопросе вас просят рассмотреть вариант, лежащий между предельными ситуациями. Вначале трение будет достаточным, чтобы удерживать стакан на месте. Он будет вращаться вместе с диском, создавая небольшую центробежную силу. По мере увеличения скорости вращения, центробежная сила будет возрастать. Давление, удерживающее стакан на месте, будет оставаться примерно одинаковым. Поэтому должен наступить какой-то момент, когда центробежная сила превысит силу давления.
Те, кто изучал физику или проводил много времени в детских играх, вспомнят, что когда предмет начинает скользить, сила трения становится меньше, чем когда он стоит. На верхней части ледяной горки вы немного «прилипаете», но затем неожиданно начинаете свободно по ней двигаться вниз. То же самое относится и к диску. Вместо того, чтобы все время ускоряться постепенно, стакан вначале удерживается, и только через какое-то время начинает двигаться.
Что случится потом? Ответ здесь таков: это зависит от формы стакана и от того, насколько он заполнен водой. Однако если вы ограничитесь только этим ответом, интервьюер может решить, что вы пытаетесь уйти от вопроса. Вот варианты, которые возможны в реальной жизни.
Важно учесть и поверхность диска. Если она изготовлена из резины, это повысит трение и с большей вероятностью приведет к выплескиванию и опрокидыванию, здесь они в равной мере вероятны. Более скользкая твердая пластиковая поверхность способствует реализации варианта скольжения.
35. Короткая задачка по С++ в виде вопроса для новичков. Почему деструктор полиморфного базового класса должен объявляться виртуальным? Полиморфным считаем класс, в котором есть хотя бы одна виртуальная функция.
Давайте разберемся, зачем нужны виртуальные методы. Рассмотрим следующий код:
class Foo < public: void f(); >; class Bar : public Foo < public: void f(); >Foo *p = new Bar(); p->f();
Вызывая p->f() , мы обращаемся к Foo::f() . Это потому, что р — указатель на Foo, a f() — невиртуальная функция.
Чтобы гарантировать, что p->f() вызовет нужную реализацию f(), необходимо объявить f() как виртуальную функцию.
Теперь вернемся к деструктору. Деструкторы предназначены для очистки памяти и ресурсов. Если деструктор Foo не является виртуальным, то при уничтожении объект Bar все равно будет вызван деструктор базового класса Foo.
Поэтому деструкторы объявляют виртуальными — это гарантирует, что будет вызван деструктор для производного класса.
36. Напишите функцию, меняющую местами значения переменных, не используя временные переменные. Предложите как можно больше вариантов.
Это классическая задача, которую любят предлагать на собеседованиях, и она достаточно проста. Пусть a0 — это исходное значение a , а b0 — исходное значение b . Обозначим diff разницу а0 - b0 .
Давайте покажем взаимное расположение всех этих значений на числовой оси для случая, когда a > b :
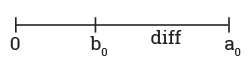
Присвоим а значение diff . Если сложить значение b и diff , то мы получим a0 (результат следует сохранить в b ). Теперь у нас b = а0 и a = diff . Все, что нам остается сделать, — присвоить b значение а0 - diff , а это значение представляет собой b - a .
Приведенный далее код реализует этот алгоритм:
public static void swap(int a, int b) < // Пример для a = 9, b = 4 a = a - b; // a = 9 - 4 = 5 b = a + b; // b = 5 + 4 = 9 a = b - a; // a = 9 - 5 System.out.println("a: " + a); System.out.println("b: " + b); >
Можно решить эту задачу с помощью битовой манипуляции. Такой подход позволит нам работать с разными типами данных, а не только с integer .
public static void swap_opt(int a, int b) < //Пример для a = 101 (в двоичной системе) и b = 110 a = a ^ b; // a = 101^110 = 011 b = a ^ b; // b = 011^110 = 101 a = a ^ b; // a = 011^101 = 110 System.out.println("a: " + a); System.out.println("b: " + b); >
Этот код использует операцию XOR . Проще всего понять, как работает код, взглянув на два бита — р и q . Давайте обозначим как р0 и q0 исходные значения.
Если мы сможем поменять местами два бита, то алгоритм будет работать правильно. Давайте рассмотрим работу алгоритма пошагово:
В строке 1 выполняется операция p = p0^q0 , результатом которой будет 0, если p0 = q0 , и 1, если p0 != q0 .
В строке 2 выполняется операция q = p^q0 . Давайте проанализируем оба возможных значения p. Так как мы хотим поменять местами значения p и q, в результате должен получиться 0:
В строке 3 выполняется операция p = p^q . Давайте рассмотрим оба значения p . В результате мы хотим получить q0 . Обратите внимание, что q в настоящий момент равно p0 , поэтому на самом деле выполняется операция p^p0 .
Остается только присвоить p значение q0 , a q — значение р0 . Мы удостоверились, что наш алгоритме корректно меняет местами каждый бит, а значит, результат будет правильным.
37. Предложите алгоритм поиска в односвязном списке k-го элемента с конца. Список реализован вручную, есть только операция получения следующего элемента и указатель на первый элемент. Алгоритм, по возможности, должен быть оптимален по времени и памяти.
Данный алгоритм можно реализовать рекурсивным и нерекурсивным способом. Рекурсивные решения обычно более понятны, но менее оптимальны. Например, рекурсивная реализация этой задачи почти в два раза короче нерекурсивной, но занимает O(n) пространства, где n — количество элементов связного списка.
При решение данной задачи помните, что можно выбрать значение k так, что при передаче k = 1 мы получим последний элемент, 2 — предпоследний и т.д. Или выбрать k так, чтобы k = 0 соответствовало последнему элементу.
Решение 1. Размер связного списка известен
Если размер связного списка известен, k-й элемент с конца легко вычислить (длина — k). Нужно пройтись по списку и найти этот элемент.
Решение 2. Рекурсивное решение
Такой алгоритм рекурсивно проходит связный список. По достижении последнего элемента алгоритм начинает обратный отсчет, и счетчик сбрасывается в 0. Каждый шаг инкрементирует счетчик на 1. Когда счетчик достигнет k, искомый элемент будет найден.
Реализация этого алгоритма коротка и проста — достаточно передать назад целое значение через стек. К сожалению, оператор return не может вернуть значение узла. Так как же обойти эту трудность?
Подход А: не возвращайте элемент
Можно не возвращать элемент, достаточно вывести его сразу, как только он будет найден. А в операторе return вернуть значение счетчика.
public static int nthToLast(LinkedListNode head, int k) < if (head == null) < return 0; >int i = nthToLast(head.next, k) + 1; if (i == k) < System.out.println(head.data); >return i; >
Решение верно, но можно пойти другим путем.
Подход Б: используйте C++
Второй способ — использование С++ и передача значения по ссылке. Такой подход позволяет не только вернуть значение узла, но и обновить счетчик путем передачи указателя на него.
node* nthToLast(node* head, int k, int& i) < if (head == NULL) < return NULL; >node* nd = nthToLast(head->next, k, i); i = i + 1; if (i == k) < return head; >return nd; >
Решение 3. Итерационное решение
Итерационное решение будет более сложным, но и более оптимальным. Можно использовать два указателя — p1 и p2. Сначала оба указателя указывают на начало списка. Затем перемещаем p2 на k узлов вперед. Теперь мы начинаем перемещать оба указателя одновременно. Когда p2 дойдет до конца списка, p1 будет указывать на нужный нам элемент.
LinkedListNode nthToLast(LinkedListNode head, int k) < if (k if (p2 == null) return null; while (p2.next != null) < p1 = p1.next; p2 = p2.next; >return p1; >
38. Напишите функцию, определяющую количество битов, которые необходимо изменить, чтобы из целого числа А получить целое число B. Числа, допустим, 32-битные, язык любой.
Это одна из типичных задач на работу с битами, которые любят давать на собеседовании. Если вы никогда с ними не сталкивались, вам будет сложно сразу решить задачу с учётом стрессовой ситуации, поэтому запомните использованные при решении трюки.
На первый взгляд кажется, что задача сложная, но фактически она очень проста. Чтобы решить ее, задайте себе вопрос: «Как узнать, какие биты в двух числах различаются?». Ответ прост — с помощью операции XOR.
Каждая единица результирующего числа соответствует биту, который не совпадает в числах A и B. Поэтому расчет количества несовпадающих битов в числах А и В сводится к подсчету число единиц в числе A XOR B:
int bitSwapRequired(int a, int b) < int count = 0; for (int c = a ^ b; c != 0; c = c >> 1) < count += c & 1; >return count; >
Этот код хорош, но можно сделать его еще лучше. Вместо многократного сдвига для проверки значащего бита достаточно будет инвертировать младший ненулевой разряд и подсчитывать, сколько раз понадобится проделать эту операцию, пока число не станет равным нулю. Операция c = c & ( c — 1) очищает младший ненулевой бит числа c.
Приведенный далее код реализует данный метод:
public static int bitSwapRequired(int a, int b) < int count = 0; for (int c = a ^ b; c != 0; c = c & (c - 1)) < count++; >return count; >
Это одна из типичных задач на работу с битами, которые любят давать на собеседовании. Если вы никогда с ними не сталкивались, вам будет сложно сразу решить задачу, поэтому запомните использованные здесь трюки.
39. В книге N страниц, пронумерованных как обычно от 1 до N. Если сложить количество цифр, содержащихся в каждом номере страницы, будет 1095. Сколько страниц в книге?
У каждого числа, обозначающего страницу, имеется цифра на месте единиц. При N страниц имеется N цифр, стоящих на месте единиц.
У всех, за исключением первых 9 страниц, числа являются как минимум двухзначными. Поэтому добавим еще N-9 цифр.
У всех, за исключением первых 99 страниц, числа являются трехзначными, что добавляет еще N-99 цифр.
Я мог бы продолжать действовать так же и дальше, но лишь у небольшого числа книг количество страниц превышает 999. По крайней мере книга с общим числом цифр, равным 1095, к категории толстых не относится.
Из сказанного следует, что 1095 должно равняться:
Это равенство можно привести к более простой форме:
Из этого следует, что 3N = 1203 или N = 401.
Поэтому ответ таков: в книге 401 страница.
40. Задачка по С++, которая, тем не менее, будет полезна и для других языков. Сопоставьте хэш-таблицу и mар из стандартной библиотеки шаблонов (STL). Как организована хэш-таблица? Какая структура данных будет оптимальной для небольших объемов данных?
В хэш-таблицу значение попадает при вызове хэш-функции с ключом. Сами значения хранятся в неотсортированном порядке. Так как хэш-таблица использует ключ для индексации элементов, вставка или поиск данных занимает O(1) времени (с учетом минимального количества коллизий в хэш-таблицах). В хэш-таблице также нужно обрабатывать потенциальные коллизии. Для этого используется цепочка — связный список всех значений, ключи которых отображаются в конкретный индекс.
map(STL) вставляет пары ключ/значение в дерево двоичного поиска, основанное на ключах. При этом не требуется обрабатывать коллизии, а так как дерево сбалансировано, время вставки и поиска составляет O(log N).
Как реализована хэш-таблица?
Хэш-таблица реализуется как массив связных списков. Когда мы хотим вставить пару ключ/значение, то, используя хеш-функцию, отображаем ключ в индекс массива. При этом значение попадает в указанную позицию связного списка.
Нельзя сказать, что элементы связного списка с определенным индексом массива имеют один и тот же ключ. Скорее, функция hashFunction(key) для этих значений совпадает. Поэтому, чтобы получить значение, соответствующее ключу, мы должны хранить в каждом узле и ключ и значение.
Подведем итог: хэш-таблица реализуется как массив связных списков, где каждый узел списка содержит два компонента: значение и исходный ключ. Давайте перечислим особенности реализации хэш-таблиц:
Что может заменить хэш-таблицу при работе с небольшими объемами данных?
Можно использовать mар (из STL) или бинарное дерево. Хотя это потребует O(log(n)) времени, объем данных не велик, поэтому временные затраты будут незначительными.
В чём преимущество map?
У дерева есть по крайней мере одно заметное преимущество по сравнению с хеш-таблицей. В map можно пройтись итератором по возрастанию или убыванию ключей и сделать это быстро. Хеш-таблица в этом плане проигрывает.
41. Разработайте класс, обеспечивающий блокировку так, чтобы предотвратить возникновение мертвой блокировки.
Существует несколько общих способов предотвратить мертвые блокировки. Один из самых популярных — обязать процесс явно объявлять, в какой блокировке он нуждается. Тогда мы можем проверить, будет ли созданная блокировка мертвой, и если так, можно прекратить работу.
Давайте разберемся, как обнаружить мертвую блокировку. Предположим, что мы запрашиваем следующий порядок блокировок:
А = В = С =
Это приведет к мертвой блокировке, потому что:
А блокирует 2, ждет 3
В блокирует 3, ждет 5
С блокирует 5, ждет 2
Можно представить этот сценарий в виде графа, где 2 соединено с 3, а 3 соединено с 5, а 5 соединено с 2. Мертвая блокировка описывается циклом. Ребро (w, v) существует в графе, если процесс объявляет, что он запрашивает блокировку v немедленно после блокировки w . В предыдущем примере в графе будут существовать следующие ребра:
(1, 2), (2, 3), (3, 4), (1, 3), (3, 5), (7, 5), (5, 9), (9, 2)
«Владелец» ребра не имеет значения.
Этот класс будет нуждаться в методе declare , который использует потоки и процессы для объявления порядка, в котором будут запрашиваться ресурсы. Метод declare будет проверять порядок объявления, добавляя каждую непрерывную пару элементов (v, w) к графу. Впоследствии он проверит, не появилось ли циклов. Если возник цикл, он удалит добавленное ребро из графика и выйдет.
Нам нужно обсудить только один нюанс. Как мы обнаружим цикл? Мы можем обнаружить цикл с помощью поиска в глубину через каждый связанный элемент (то есть через каждый компонент графа). Существуют сложные компоненты, позволяющие выбрать все соединенные компоненты графа, но наша задача не настолько сложна.
Мы знаем, что если возникает петля, то виновато одно из ребер. Таким образом, если поиск в глубину затрагивает эти ребра, мы обнаружим петлю.
Псевдокод для этого обнаружения петли примерно следующий:
boolean checkForCycle(locks[] locks) < touchedNodes = hash table(lock ->boolean) //инициализировать touchedNodes, установив в false каждый lock в locks for each (lock x in process.locks) < if (touchedNodes[x] == false) < if (hasCycle(x, touchedNodes)) < return true; >> > return false; > boolean hasCycle(node x, touchedNodes) < touchedNodes[r] = true; if (x.state == VISITING) < return true; >else if (x.state == FRESH) < //. (см. полный код ниже) >>
В данном коде можно сделать несколько поисков в глубину, но touchedNodes нужно инициализировать только один раз. Мы выполняем итерации, пока все значения в touchedNodes равны false .
Приведенный далее код более подробен. Для простоты мы предполагаем, что все блокировки и процессы (владельцы) последовательно упорядочены.
public class LockFactory < private static LockFactory instance; private int numberOfLocks = 5; /* по умолчанию */ private LockNode[] locks; /* Отображаем процесс (владельца) в порядок, * в котором владелец требовал блокировку */ private Hashtable> lockOrder; private LockFactory(int count) < . >public static LockFactory getInstance() < return instance; >public static synchronized LockFactory initialize(int count) < if (instance == null) instance = new LockFactory(count); return instance; >public boolean hasCycle(Hashtable touchedNodes, int[] resourcesInOrder) < /* проверяем на наличие петли */ for (int resource : resourcesInOrder) < if (touchedNodes.get(resource) == false) < LockNode n = locks[resource]; if (n.hasCycle(touchedNodes)) < return true; >> > return false; > /* Чтобы предотвратить мертвую блокировку, заставляем процессы * объявлять, что они хотят заблокировать. Проверяем, * что запрашиваемый порядок не вызовет мертвую блокировку * (петлю в направленном графе) */ public boolean declare(int ownerId, int[] resourcesInOrder) < HashtabletouchedNodes = new Hashtable(); /* добавляем узлы в граф */ int index = 1; touchedNodes.put(resourcesInOrder[0], false); for (index = 1; index < resourcesInOrder.length; index++) < LockNode prev = locks[resourcesInOrder[index - 1]]; LockNode curr = locks[resourcesInOrder[index]]; prev.joinTo(curr); touchedNodes.put(resourcesInOrder[index], false); >/* если получена петля, уничтожаем этот список ресурсов * и возвращаем false */ if (hasCycle(touchedNodes, resourcesInOrder)) < for (int j = 1; j < resourcesInOrder.length; j++) < LockNode p = locks[resourcesInOrder[j - 1]]; LockNode c = locks[resourcesInOrder[j]]; p.remove(c); >return false; > /* Петля не найдена. Сохраняем порядок, который был объявлен, * так как мы можем проверить, что процесс действительно вызывает * блокировку в нужном порядке */ LinkedList list = new LinkedList(); for (int i = 0; i < resourcesInOrder.length; i++) < LockNode resource = locks[resourcesInOrder[i]]; list.add(resource); >lockOrder.put(ownerId, list); return true; > /* Получаем блокировку, проверяем сначала, что процесс * действительно запрашивает блокировку в объявленном порядке*/ public Lock getLock(int ownerld, int resourceID) < LinkedListlist = lockOrder.get(ownerId); if (list == null) return null; LockNode head = list.getFirst(); if (head.getId() == resourceID) < list.removeFirst(); return head.getLock(); >return null; > > public class LockNode < public enum VisitState < FRESH, VISITING, VISITED ); private ArrayListchildren; private int lockId; private Lock lock; private int maxLocks; public LockNode(int id, int max) < . >/* Присоединяем "this" в "node", проверяем, что мы не создадим этим * петлю (цикл) */ public void joinTo(LockNode node) < children.add(node); >public void remove(LockNode node) < children.remove(node); >/* Проверяем на наличие цикла с помощью поиска в глубину */ public boolean hasCycle(Hashtable touchedNodes) < VisitState[] visited = new VisitState[maxLocks]; for (int i = 0; i < maxLocks; i++) < visited[i] = VisitState.FRESH; >return hasCycle(visited, touchedNodes); > private boolean hasCycle(VisitState[] visited, Hashtable touchedNodes) < if (touchedNodes.containsKey(lockId)) < touchedNodes.put(lockId, true); >if (visited[lockId) == VisitState.VISITING) < /* Мы циклично возвращаемся к этому узлу, следовательно, * мы знаем, что здесь есть цикл (петля) */ return true; >else if (visited[lockId] == VisitState.FRESH) < visited[lockId] = VisitState.VISITING; for (LockNode n : children) < if (n.hasCycle(visited, touchedNodes)) < return true; >> visited[lockId] = VisitState.VISITED; > return false; > public Lock getLock() < if (lock == null) lock = new ReentrantLock(); return lock; >public int getId() < return lockId; >>
42. Напишите функцию на С++, выводящую в стандартный поток вывода K последних строк файла. При этом файл очень большой, допустим 50 ГБ, длина каждой строки не превышает 256 символов, а число K < 1000.
Можно действовать прямо — подсчитать количество строк (N) и вывести строки с N-K до N. Для этого понадобится дважды прочитать файл, что очень неэффективно. Давайте найдем решение, которое потребует прочитать файл только один раз и выведет последние K строк.
Можно создать массив для K строк и прочитать последние K строк. В нашем массиве там будут храниться строки от 1 до K, затем от 2 до K+1, затем от 3 до K+2 и т.д. Каждый раз, считывая новую строку, мы будем удалять самую старую строку из массива.
Вы можете удивиться: разве может быть эффективным решение, требующее постоянного сдвига элементов в массиве? Это решение станет эффективным, если мы правильно реализуем сдвиг. Вместо того чтобы каждый раз выполнять сдвиг массива, можно «закольцевать» массив.
Используя такой массив, читая новую строку, мы всегда будем заменять самый старый элемент. Самый старый элемент будет храниться в отдельной переменной, которая будет меняться при добавлении новых элементов.
Пример использования закольцованного массива:
шаг 1 (исходное состояние): массив = . р = 0 шаг 2 (вставка g): массив = . р = 1 шаг 3 (вставка h): массив = . р = 2 шаг 4 (вставка i): массив = . p = 3
Приведенный далее код реализует этот алгоритм:
void printLast10Lines(char* fileName) < const int K = 10; ifstream file (fileName); string L[K]; int size = 0; /* читаем файл построчно в круговой массив */ while (file.good()) < getline(file, L[size % K]); size++; >/* вычисляем начало кругового массива и его размер */ int start = size > K ? (size % K) : 0; int count = min(K, size); /* выводим элементы в порядке чтения */ for (int i = 0; i < count; i++) < cout >
Мы считываем весь файл, но в памяти хранится только 10 строк.
43. Дан кусок сыра в форме куба и нож. Какое минимальное количество разрезов потребуется сделать, чтобы разделить этот кусок на 27 одинаковых кубиков? А на 64 кубика? После каждого разреза части можно компоновать как угодно.
Такую задачку раньше часто давали на собеседованиях, а придумана она была ещё в 1950 году.
Чтобы получить 27 маленьких кубиков, вам нужно разрезать каждую из трех граней куба на три части. Для получения трех частей нужны два разреза. Очевидный ответ – сделать эти разрезы параллельно друг другу по всем трем осям, для чего вам потребуется всего шесть разрезов.
НО! При подобных вопросах первый ответ, который появляется у вас в голове, обычно не является лучшим. Можно ли усовершенствовать ответ? Вспомните, что вы можете передвигать кусочки после каждого разреза (как это часто делают повара, когда режут лук). Это в значительной степени повышает число возможных вариантов, и тогда вы, может быть, отыщете тот, на который вначале не обратили внимания.
На самом деле, нет способа, позволяющего вам разрезать куб на 27 кусочков меньше, чем за шесть разрезов. В идеале вы должны доказать это. Покажем, как это можно сделать. Представьте маленький кубик, получившийся после разреза первоначального куба на 3 х 3 х 3 = 27 частей, и этот кубик находится в самой середине исходного куба. У этого кубика нет поверхности, граничащей с внешним миром. Поэтому вам придется создать каждую из его шести сторон при помощи ножа. Шесть прямых разрезов – это тот минимум, который нужен для решения этой задачи. Этот вопрос относится к категории обратных головоломок. Очевидно, первый ответ оказывается правильным, хотя многие пытаются придумать и неочевидные варианты.
По мнению Мартина Гарднера, автором этой загадки был Фрэнк Хоторн, директор отдела образования Нью-Йорка, который опубликовал ее в 1950 году. Идея перегруппировать части, чтобы уменьшить число разрезов, вовсе не такая сумасшедшая, какой может показаться. Так, в этом случае куб можно разрезать на 4 х 4 х 4 кубиков всего при помощи шести разрезов (при прежнем подходе понадобилось бы сделать девять разрезов).
В 1958 году Юджин Путцер и Лоуэн опубликовали общий вариант решения для разрезания куба на N х N х N кубиков. Они уверили всех практически мыслящих читателей, что их метод может иметь «важные последствия для отраслей, производящих сыр и кусковой сахар».
Этот вопрос отдаленно напоминает другой, который задают на собеседованиях в некоторых финансовых организациях: сколько кубиков находится в центре кубика Рубика? Поскольку такой стандартный кубик состоит из З х З х З частей, часто дают неправильный ответ – один. Однако любой человек, который когда-либо разбирал кубик Рубика, знает, что правильный ответ другой – ноль. В середине находится не кубик, а сферический шарнир.
44. Реализуйте метод, определяющий, является ли одна строка перестановкой другой. Под перестановкой понимаем любое изменение порядка символов. Регистр учитывается, пробелы являются существенными.
Для начала нужно уточнить детали. Следует разобраться, является ли сравнение анаграмм чувствительным к регистру. То есть является ли строка «God» анаграммой «dog»? Также нужно выяснить, учитываются ли пробелы.
Предположим, что для данной задачи регистр символов учитывается, а пробелы являются существенными. Поэтому строки « dog» и «dog» не совпадают.
Сравнивая две строки, помните, что строки разной длинны не могут быть анаграммами.
Существует два способа решить эту задачу.
Способ 1. Сортировка строк.
Если строки являются анаграммами, то они состоят из одинаковых символов, расположенных в разном порядке. Сортировка двух строк должна упорядочить символы. Теперь остается только сравнить две отсортированные версии строк.
public String sort(String s) < char[] content = s.toCharArray(); java.util.Arrays.sort(content); return new String(content); >public boolean permutation (String s,String t) < if (s.length() != t.length()) < return false; >return sort(s).equals(sort(t)); >
Хотя этот алгоритм нельзя назвать оптимальным во всех смыслах, он удачен, поскольку его легко понять. С практической точки зрения это превосходный способ решить задачу. Однако если важна эффективность, нужно реализовывать другой вариант алгоритма.
Способ 2. Проверка счетчиков идентичных символов.
Для реализации этого алгоритма можно использовать свойство анаграммы – одинаковые «счетчики» символов. Мы просто подсчитываем, сколько раз встречался каждый символ в строке. Затем сравниваем массивы, полученные для каждой строки.
public boolean permutation(String s, String t) < if (s.length() != t.length()) < return false; >int[] letters = new int[256]; char[] s_array = s.toCharArray(); for (char c : s_array) < letters[c]++; >for (int i = 0; i < t.length(); i++) < int c = (int) t.charAt(i); if (--letters[c] < 0) < return false; >> return true; >
Обратите внимание на строку 6. В данной реализации мы подразумеваем, что используется набор символов ASCII, но алфавит может быть разным.
45. В тёмной комнате вам вручают колоду карт, в которой известное количество карт N лежат рубашкой вверх, а остальные — вниз. Вы не можете видеть карты, но можете их переворачивать. Как вы разделите колоду на две стопки, чтобы в каждой из них было одинаковое число карт, лежащих рубашкой вверх?
Эта головоломка в своё время была популярна в JP Morgan Chase. Понятное дело, оказавшись в темноте, вы просто достанете сотовый телефон и воспользуетесь экраном как фонариком. Однако эта задачка появилась до эпохи сотовых телефонов, и её можно решить, даже не видя карт.
Эта головоломка в своё время была популярна в JP Morgan Chase. Понятное дело, оказавшись в темноте, вы просто достанете сотовый телефон и воспользуетесь экраном как фонариком. Однако эта задачка появилась до эпохи сотовых телефонов, и её можно решить, даже не видя карт. Вполне вероятно, вы начнете со следующих наблюдений.
Ожидаемый ответ заключается в том, что вы должны отсчитать N карт, начиная с верха колоды, и перевернуть их. Это будет одна стопка. Оставшаяся часть колоды составит вторую стопку.
Объясним, почему это работает. В N картах, которые вы отсчитали, может быть любое число карт, лежащих рубашкой вверх, от нуля до N. Представим, что там было (до переворачивания) f таких карт. Перевернув карты, вы добились, что каждая карта рубашкой вверх становится картой рубашкой вниз и наоборот. Поэтому вместо f карт рубашкой вверх вы приходите к варианту N-f карт рубашкой вверх в этой стопке.
В другой стопке, в которой содержится остаток колоды, имеется N карт, лежащих рубашкой вверх, за минусом тех f, которые вы отсчитали. Это то же самое количество, как в первой стопке с перевернутыми картами.
46. Реализуйте вручную стек со стандартными функциями push/pop и дополнительной функцией min, возвращающей минимальный элемент стека. Все эти функции должны работать за O(1). Решение оптимизируйте по использованию памяти.
Итак, оценка времени работы функция push, pop и min – O(1).
Экстремумы изменяются не часто. Фактически минимум может поменяться только при добавлении нового элемента.
Одно из решений – сравнивать добавляемые элементы с минимальным значением. Когда минимальное значение (minValue) удаляется из стека, приходится «перерывать» весь стек в поисках нового минимума. К сожалению, это нарушает ограничение на время выполнения О(1).
Если мы будем отслеживать минимум в каждом состоянии, то легко узнаем минимальный элемент. Можно, например, записывать для каждого узла текущий минимальный элемент, Затем, чтобы найти min, достаточно «вытолкнуть» вершину и посмотреть, какой элемент является минимальным.
Как только элемент помещается в стек, локальное значение минимума становится глобальным.
public class StackWithMin extends Stack < public void push(int value) < int newMin = Math.min(value,min()); super.push(new NodeWithMin(value, newMin)); >public int min() < if (this.isEmpty()) < return Integer.MAX_VALUE; >else < return peek().min; >> > class NodeWithMin < public int value; public int min; public NodeWithMin(int v, int min) < value = v; this.min = min; >>
У решения один недостаток – если нужно обрабатывать огромный стек, то отслеживание минимального элемента потребует много ресурсов. Существует ли лучшее решение?
Оптимизировать код можно за счет использования дополнительного стека, который будет отслеживать минимумы.
public class StackWithMin2 extends Stack < Stacks2; public StackWithMin2() < s2 = new Stack(); > public void push(int value) < if (value super.push(value); > public Integer pop() < int value = super.pop(); if(value == min()) < s2.pop(); >return value; > public int min() < if (s2.isEmpty()) < return Integer.MAX_VALUE; >else < return s2.peek(); >> >
Почему такое решение более эффективно? Предположим, что мы работаем с огромным стеком, первый вставленный элемент автоматически станет минимумом. В первом решение необходимо хранить n чисел, где n – размер стека. Во втором решении достаточно сохранить несколько фрагментов данных.
47. У скольких целых чисел, лежащих в диапазоне от 1 до 1000, есть цифра 3? Посчитать нужно без использования компьютера, приведя свои рассуждения в комментариях.
Некоторые числа (например, 333) содержат больше одной 3. Вам не следует такие числа считать дважды, а то и трижды . Вопрос заключается в том, как много разных чисел имеет по крайней мере одну 3.
Каждое число от 300 до 399 содержит по крайней мере одну 3. В целом эта группа сразу дает сотню чисел.
Также имеется и сотня чисел, где тройка занимает место десяток: от 30 до 39; от 130 до 139; и так до чисел от 930 до 939. Десяток таких чисел мы уже учли раньше, а именно числа от 330 до 339. Поэтому десять этих чисел надо убрать, чтобы не было двойного счета. В совокупности мы пока отобрали 100 + 90 = 190 чисел.
И, наконец, имеется сотня чисел, оканчивающихся на 3 в диапазоне от 2 до 993. Не включайте в их число 10 чисел, которые начинаются с 3 (303, 313, 323,…, 393), потому что мы их уже включили раньше. Получается еще 90 чисел. У одной десятой из этих 90 чисел на месте десяток стоит 3 (33, 133, 233,…, 933). Уберем эти 9 чисел, остается 81 число. Теперь можно определить общее число интересующих нас чисел.
Оно равно 100 + 90 + 81 = 271.
А можно проще?
Сначала узнаем, сколько чисел не имеют 3 в своей записи. Для этого на каждое место ставим 9 цифр, не включающие 3 т.е. 9 * 9 * 9 = 729. Если всего чисел 1000, то ответ 1000 — 729 = 271.
48. У вас есть много URL-адресов, порядка 10 миллиардов. Как бы вы организовали эффективный поиск дубликатов, учитывая, что все они, конечно же, не поместятся в памяти?
Сложность задачи заключается в том, что адресов дано 10 миллиардов. Сколько пространства понадобится для хранения 10 миллиардов URL-адресов? Если в среднем URL-адрес занимает 100 символов, а каждый символ представляется 4 байтами, то для хранения списка из 10 миллиардов URL понадобится около 4 Тбайт. Скорее всего, нам не понадобится хранить так много информации в памяти.
Давайте попробуем сначала решить упрощенную версию задачи. Представим, что в памяти хранится весь список URL. В этом случае можно создать хэш-таблицу, где каждому дублирующемуся URL ставится в соответствие значение true (альтернативное решение: можно просто отсортировать список и найти дубликаты, это займет некоторое время, но даст и некоторые преимущества).
Теперь, когда у нас есть решение упрощенной версии задачи, можно перейти к 400 Гбайт данных, которые нельзя хранить в памяти полностью. Давайте сохраним некоторую часть данных на диске или разделим данные между компьютерами.
Решение 1: хранение данных на диске
Если мы собираемся хранить все данные на одной машине, то нам понадобится двойной проход документа. На первом проходе мы разделим список на 400 фрагментов по 1 Гбайт в каждом. Простой способ — хранить все URL-адреса и в файле .txt , где х = hash(u) % 400 . Таким образом, мы разбиваем URL-адрсса по хэш-значениям. Все URL-адреса с одинаковым хэш-значением окажутся в одном файле.
На втором проходе можно использовать придуманное ранее решение: загрузить файл в память, создать хэш-таблицу URL-адресов и найти повторы.
Решение 2: много компьютеров
Этот алгоритм очень похож на предыдущий, но для хранения данных используются разные компьютеры. Вместо того чтобы хранить данные в файле .txt , мы отправляем их на машину х .
У данного решения есть преимущества и недостатки.
Основное преимущество заключается в том, что можно организовать параллельную работу так, чтобы все 400 блоков обрабатывались одновременно. Для больших объемов данных мы получаем больший выигрыш во времени.
Недостаток заключается в том, что все 400 машин должны работать без сбоев, что на практике (особенно с большими объемами данных и множеством компьютеров) не всегда получается. Поэтому необходимо предусмотреть обработку отказов.
Оба решения хороши и оба имеют право на существование.
49. Вы должны выбрать одну из двух ставок. При первом варианте вы должны забросить баскетбольный мяч в корзину за один бросок. Если попадёте, то получите 50 тыс. рублей. Во втором варианте вам надо попасть два раза из трёх бросков, и тогда вы также получите те же 50 тыс. рублей. Какой из этих вариантов вы предпочтёте? Будет ли ваше умение забрасывать мячи влиять на выбор?
Обозначим вероятность попадания в корзину р. При первом броске у вас шанс выигрыша 50 тыс. рублей равен р. В случае промаха вы ничего не получите. В среднем можно ожидать, что ваш выигрыш составит 50 000 ? р.
При втором варианте вы бросаете три раза и должны попасть в корзину дважды, чтобы получить деньги. Вероятность попадания при каждой отдельной попытке по-прежнему составляет р. Вероятность промаха при любой попытке равна 1 — p.
При втором варианте имеется 2 3 , или 8, сценариев развития. Давайте перечислим их в виде таблички. Знак ? означает, что вы попали, пустое место свидетельствует о том, что вы промахнулись.
Первый сценарий относится к ситуации, когда вы полностью провалили игру. Вы промазали при всех трёх бросках. Вероятность такого исхода составляет 1 — р, умноженная сама на себя три раза. Разумеется, при таком развитии событий никаких денег вы не получите.
| Первый бросок | Второй бросок | Третий бросок | Вероятность | Выиграли ли вы 50 тыс. рублей? |
| (1 — p) 3 | Нет | |||
| ✓ | p(1 — p) 2 | Нет | ||
| ✓ | p(1 — p) 2 | Нет | ||
| ✓ | ✓ | p 2 (1 — p) | Да | |
| ✓ | p(1 — p) 2 | Нет | ||
| ✓ | ✓ | p 2 (1 — p) | Да | |
| ✓ | ✓ | p 2 (1 — p) | Да | |
| ✓ | ✓ | ✓ | p 3 | Да |
В четырех из восьми сценариев вы выигрываете деньги. В трёх из них вы промахиваетесь один раз. У этих сценариев вероятность составляет p 2 (1 — p). В одном случае вы попадаете все три раза, вероятность чего равна p 3 . Сложите все эти вероятности. Три раза p 2 (1 — p) можно представить в виде 3p 2 — 3p 3 . Добавьте к этой сумме p 3 , и вы получите 3p 2 — 2p 3 . Ожидание составляет 50 000 x (3p 2 — 2p 3 ).
Какой из вариантов для вас лучше?
Ожидание при первом варианте: 50 000 x р.
Ожидание при втором варианте: 50 000 x (3p 2 — 2p 3 ).
Вы можете быть полным профаном в баскетболе (р приблизительно равно 0) или мастером бросков, играющим в НБА. В качестве ссылки сделаем то, чего вы не сделаете на собеседовании, если вам дадут такую задачу: переведём формулу в электронную таблицу и составим график. Этот график показывает, как меняется ожидаемая величина выигрыша в зависимости от р.
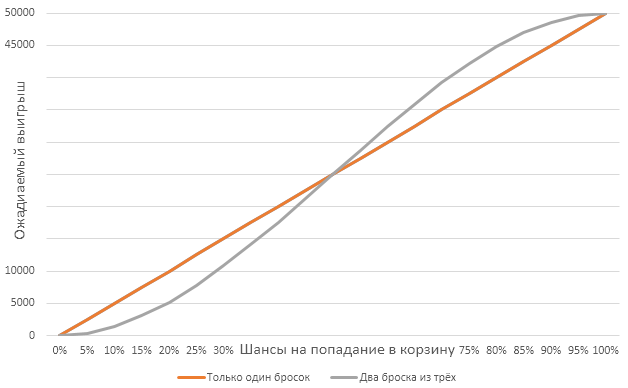
Прямая диагональная линия отражает первый вариант ставки, S-образная кривая – второй. Первый вариант лучше для вас, если ваши шансы на попадание в корзину ниже 50%. В противном случае вам лучше выбрать второй вариант.
Это вполне объяснимо. Плохой игрок не может надеяться на победу ни при том, ни при другом варианте. Он должен рассчитывать лишь на слепую удачу, которая, очевидно, случится, скорее всего, один раз, а не дважды. Поэтому плохому игроку лучше выбрать первый вариант. Очень хороший игрок должен победить при любой ставке, хотя есть небольшая вероятность, что при единственном броске он промахнётся. Два из трех бросков лучше отражают степень его мастерства, и поэтому он захочет выбрать этот вариант. Существует юридическое правило: если вы виноваты, вы хотите, чтобы ваше дело рассматривал суд присяжных (потому что всё может случиться); если невиновны, для вас лучше, чтобы ваше дело рассматривал один судья.
Если вы дошли в своих рассуждениях до этого момента, то интервьюер на собеседовании задаст вам следующий вопрос: какое значение р заставит вас перейти от одного варианта к другому? Чтобы ответить на этот вопрос, приравняйте вероятности выигрыша в обеих ставках. Вы получите уровень мастерства, при котором выбор ставки можно сделать путем подбрасывания монеты.
Разделите обе части уравнения на p:
и тогда вы получите
Добравшись до этого места, вы можете просто решить это квадратное уравнение, мысленно поблагодарив своего школьного учителя математики. Интервьювер отметит не только знание вами материала учебника, но и то, как живо вы выполните эти вычисления. Вы знаете, что р – вероятность – должна быть между 0 и 1. Лучше всего попробовать разумное значение: «Хорошо, мне необходимо число от 0 до 1. Давайте попробуем 0.5». Такой ответ сработает.
50. Представьте себе треугольник, составленный из чисел. Одно число расположено в вершине. Ниже размещено два числа, затем три, и так до нижней грани. Вы начинаете на вершине, и нужно спуститься к основанию треугольника. За каждый ход вы можете спуститься на один уровень и выбрать между двумя числами под текущей позицией. По ходу движения вы «собираете» и суммируете числа, которые проходите. Ваша цель — найти максимальную сумму, которую можно получить из различных маршрутов.
Какой алгоритм вы предложите? Какая у него будет сложность и можно ли предложить лучший вариант?
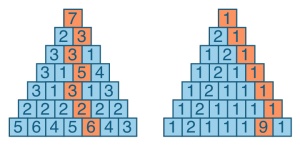
В этом выпуске рассмотрим классическую задачу, известную под названием «Золотая гора». На CheckiO её реализовали в этой задаче.
Представьте себе треугольник, составленный из чисел. Одно число расположено в вершине. Ниже размещено два числа, затем три, и так до нижней грани. Вы начинаете на вершине, и нужно спуститься к основанию треугольника. За каждый ход вы можете спуститься на один уровень и выбрать между двумя числами под текущей позицией. По ходу движения вы «собираете» и суммируете числа, которые проходите. Ваша цель – найти максимальную сумму, которую можно получить из различных маршрутов.
Рассмотрим различные методы решения.
Рекурсия
Первым делом в голову приходит мысль использовать рекурсию и просчитать все пути от вершины. Когда мы спускаемся на один уровень, то все доступные числа ниже образуют новый меньший треугольник, и можно запустить нашу функцию уже для нового подмножества и так пока не достигнем основания.
def golden_pyramid(triangle, row=0, column=0, total=0): global count count += 1 if row == len(triangle) - 1: return total + triangle[row][column] return max(golden_pyramid(triangle, row + 1, column, total + triangle[row][column]), golden_pyramid(triangle, row + 1, column + 1, total + triangle[row][column]))
Как мы видим, на первом уровне мы запустим нашу функцию два раза, затем 4, 8, 16 раз и так далее. В итоге мы получим сложность алгоритма 2 N и, например, для 100-уровневой пирамиды нам нужно будет уже где-то ?10 30 вызовов функции. Многовато.
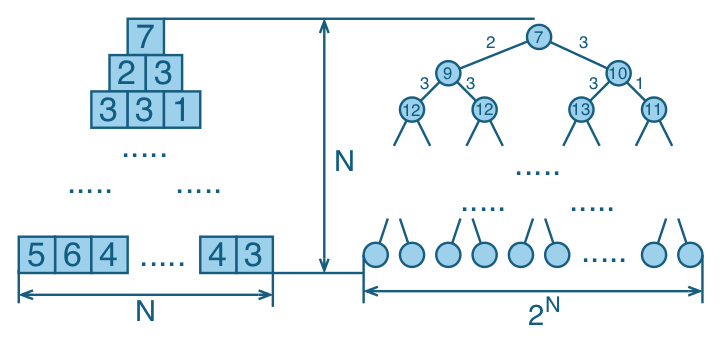
Динамическое программирование
Что если попробовать использовать принцип динамического программирования и разбить нашу проблему на множество мелких подзадач, результаты которых мы затем аккумулируем. Попробуйте взглянуть на треугольник вверх ногами. А теперь на второй уровень (то есть предпоследний от основания). Для каждой ячейки мы можем решить, каким будет лучший выбор в наших маленьких трёхэлементных треугольничках. Выбираем лучший, суммируем с рассматриваемой ячейкой и записываем результат. Таким образом, мы получили наш треугольник, но на один уровень ниже. Повторяем данную операцию снова и снова. В результате нам нужно (N-1)+(N-2)+…2+1 операций и сложность алгоритма равна N 2 .
def golden_pyramid_d(triangle): tr = [row[:] for row in triangle] # copy for i in range(len(tr) - 2, -1, -1): for j in range(i + 1): tr[i][j] += max(tr[i + 1][j], tr[i + 1][j + 1]) return tr[0][0]
Решения игроков CheckiO
Пользователь gyahun_dash написал интересную реализацию описанного выше метода ДП в своем решении «DP». Он использовал reduce, чтобы проходить по парам строк, и map чтобы обработать каждую из них.
from functools import reduce def sum_triangle(top, left, right): return top + max(left, right) def integrate(lowerline, upperline): return list(map(sum_triangle, upperline, lowerline, lowerline[1:])) def count_gold(pyramid): return reduce(integrate, reversed(pyramid)).pop()
Игрок evoynov использовал двоичные числа, чтобы перебрать все возможные маршруты, представленные как последовательность 1 и 0 в своем решении «Binaries». И это наглядный пример сложности алгоритма с рекурсией и перебором всех маршрутов.
def count_gold(p): path = 1 0 and bin(path)[3:][row] == "1" else 0 s += p[row][ind] res = max(res, s) path += 1 return res
И чтобы не было скучно, посмотрим на легкий мозгодробитель от пользователя nickie и его однострочник «Functional DP», который только формально состоит из двух строк. Конечно, это решение из категории «Творческих» («Creative»). Не думаю, что автор использует такое на боевом коде. А просто для так для веселья, почему бы и нет.
ount_gold=lambda p:__import__("functools").reduce(lambda D,r:[x+max(D[j],D[j+1]) for j,x in enumerate(r)],p[-2::-1],list(p[-1]))[0]
Вот и всё на сегодня. Делитесь вашими идеями и мыслями.
51. Даны два слова или фразы, и ваша задача — проверить, являются ли они анаграммами.
Анаграмма — это игра со словами, когда в результате перестановки букв слова или фразы получаем другое слово или фразу. Два слова являются анаграммами, если мы можем получить одно из другого переставляя буквы местами.
На этот раз будем изучать задачу «Проверка анаграмм» («Verify Anagrams»).
Мы уже писали об этой задаче ранее, но теперь расскажем о ней немного другим способом.
Анаграмма — это игра со словами, когда в результате перестановки букв слова или фразы получаем другое слово или фразу. Два слова являются анаграммами, если мы можем получить одно из другого переставляя буквы местами. Даны два слова или фразы, и ваша задача — проверить, являются ли они анаграммами.
Считаем буквы
Итак, нам нужно сравнить две фразы. Для начала нам нужно их «обработать»: выбрать только буквы и перевести их в нижний регистр. Также, на этом шаге мы можем преобразовать строку в массив. Вынесем эту процедуру в отдельную функцию.
def sanitize(text): return [ch.lower() for ch in text if ch.isalpha()]
Или, если вы бережете память и предпочитаете генераторы:
def sanitize(text): yield from (ch.lower() for ch in text.lower() if ch.isalpha())
Или любите функциональный стиль программирования:
sanitize = lambda t: map(str.lower, filter(str.isalpha, text))
Далее нам нужно сосчитать каждую букву в тексте, и, если количественные характеристики проверяемых слов/фраз совпадают, то они анаграммы. Предположим, что мы используем только английские буквы. Тогда мы можем использовать массив из 26 элементов для ведения счета.
def count_letters(text): counter = [0] * 26 for ch in text: counter[ord(ch) - ord("a")] += 1 return counter
Честно говоря, это выглядит как код написанный на С, но никак не на Python. Кроме того, мы привязаны жестко к английскому алфавиту. Давайте заменим список на словарь (dictionary).
def count_letters(text): counter = <> for ch in text: counter[ch] = counter.get(ch, 0) + 1 return counter
Уже лучше, но известный девиз Python гласит — «Батарейки прилагаются». И класс Counter дает возможность просто подсчитать буквы в тексте.
from collections import Counter def count_letters(text): return Counter(text)
Думаю, вы и сами видите, что наша отдельная функция count_letters уже не так уж и нужна, и итоговое решение можно записать так:
from collections import Counter def sanitize(text): yield from (ch.lower() for ch in text.lower() if ch.isalpha()) def verify_anagrams(first, second): return Counter(sanitize(first)) == Counter(sanitize(second))
Сортируем все подряд
Когда я решал первый раз эту задачу, я не использовал счетчики. Вместо этого я преобразовывал текст в некий универсальный вид для перестановок. Конечно, я говорю об упорядоченном виде. Если мы отсортируем строки и сравним их, то это по сути то же самое, что считать элементы массива. И, так как в нашей задаче текст содержит только буквы и пробелы, то можно использовать один трюк:
def verify_anagrams(first, second): return "".join(sorted(first.lower())).strip() == "".join(sorted(second.lower())).strip()
Как можно заметить, мы одним движением руки можем преобразовать эту функцию в однострочник (забавы ради):
verify_anagrams=lambda f,s,p=lambda x: "".join(sorted(x.lower())).strip():p(f)==p(s)
Вот такая вот история об анаграммах.
52. Предложите алгоритм, который обнуляет столбец N и строку M матрицы, если элемент в ячейке (N, M) нулевой. Конечно же, нужно минимизировать затраты памяти и время работы.
На первый взгляд задача очень проста – просто пройтись по матрице и для каждого нулевого элемента обнулить соответствующие строку и столбец. Но у такого решения есть один большой недостаток: на очередном шаге мы столкнемся с нулями, которые сами же установили. Невозможно будет понять, установили эти нули мы сами или они присутствовали в матрице изначально. Довольно скоро вся матрица обнулится.
Один из способов – создать вторую матрицу, содержащую флаги исходных нулей. Но тогда потребуется сделать два прохода по матрице,что потребует O(N*M).
Так ли нам нужно O(N*M)? Нет. Так как мы собираемся обнулять строки и столбцы, нет необходимости запоминать значения этих элементов. Пусть ноль находится в ячейке [2][4]. Это означает, что необходимо обнулить строку 2 и столбец 4. А если мы обнуляем эти строку и столбец, то зачем их запоминать?
Приведенный ниже код реализует наш алгоритм. Мы используем два массива, чтобы отследить все строчки и столбцы с нулями. После чего делаем второй проход и расставляем нули на основании созданного массива.
public void setZeros(int[][] matrix) < boolean[] row = new boolean[matrix.length]; boolean[] column = new boolean[matrix[0].length]; for (int i = 0; i < matrix.length; i++) < for (int j = 0; j < matrix[0].length; j++) < if (matrix[i][j] == 0) < row[i] = true; column[j] = true; >> > for (int i = 0; i < matrix.length; i++) < for (int j = 0; j < matrix[0].length; j++) < if (row[i] || column[j]) < matrix[i][j] = 0; >> > >
Для оптимизации можно использовать вместо булева массива бинарный массив.
53. Разработайте алгоритм, обнаруживающий в массиве все пары целых чисел, сумма которых равна заданному значению.
Эту задачу можно решить двумя способами. Выбор определяется компромиссом между эффективностью использования времени, памяти или сложностью кода.
Простое решение
Очень простое и эффективное (по времени) решение — создание хэш-таблицы, отображающей целое число в целое число. Данный алгоритм работает, пошагово проходя весь массив. Для каждого элемента x в хэш-таблице ищется sum – x и, если запись существует, выводится (x, sum — x). После этого x добавляется в таблицу и проверяется следующий элемент.
Альтернативное решение
Давайте начнем с формулировки. Если мы попытаемся найти пару чисел, сумма которых равна z, то дополнение будет z – x (величина, которую нужно добавить к x, что бы получить z). Если мы попытаемся найти пару чисел, при суммировании которых получается 12, дополнением к -5 будет число 17.
Представьте, что у нас есть отсортированный массив . Пусть first указывает на начало массива, а last — на его конец. Чтобы найти дополнение к first, мы двигаем last назад, пока не найдем искомую величину. Если first + last < sum, то дополнения к first не существует. Можно также перемещать first на встречу к last. Тогда мы остановимся, если first окажется больше, чем last.
Почему такое решение найдет все дополнения к first? Поскольку массив отсортирован, мы проверяем меньшие числа. Когда first + last меньше sum, нет смысла проверять меньшие значения, они не помогут найти дополнение.
Почему данное решение найдет все дополнения last? Потому что все пары формируются с помощью first и last. Мы нашли все дополнения first, а значит, нашли все дополнения last.
void printPairSums (int[] array, int sum) < Arrays.sort(array); int first = 0; int last = array.length - 1; while (first < last) < int s = array[first] + array[last]; if (s == sum) < System.out.printIn(array[first] + "" + array[last]); first++; last--; >else < if (s < sum) first++; else last--; >> >
54. Предположим, вам нужно разработать алгоритм, демонстрирующий круг знакомств человека для социальных сетей. Как бы вы это сделали, при условии, что база очень большая?
Под большой базой подразумевается порядка миллиарда зарегистрированных пользователей и не менее 100 миллиардов «дружеских» связей между ними.
Предположим, что нам требуется разработать алгоритм, демонстрирующий связи человека с человеком, но при условии, что база очень большая. Например, для использования в Facebook или LinkedIn.
Хороший способ решить эту задачу — устранить ограничения и сначала разобраться с упрощенной версией.
Шаг 1. Упрощаем задачу — забудьте о миллионах пользователей
Прежде всего, давайте забудем, что имеем дело с миллионами пользователей. Найдем решение для простого случая.
Можно создать граф и рассматривать каждого человека как узел, а существование связи между двумя узлами говорит, что пользователи — друзья.
class Person < Person[] friends; // Другая информация >
При необходимости нахождения связи между людьми, очевидно, стоит использовать всеми известный алгоритм поиска в ширину.
Почему не в глубину? Это очень неэффективно. Два пользователя могут быть «соседями», но нам придется просмотреть миллионы узлов в их поддеревьях, прежде чем связь обнаружится.
Шаг 2. Возвращаемся к миллионам пользователей
Когда мы имеем дело с огромными сервисами Linkedln или Facebook, то не можем хранить все данные на одном компьютере. Это означает, что простая структура данных Person не будет работать — наши друзья могут оказаться на разных компьютерах. Таким образом, нам нужно заменить списки друзей списками их ID и работать с ними следующим образом:
Приведенный далее код демонстрирует этот процесс. Мы определили класс Server, хранящий список всех компьютеров, и класс Machine, представляющий отдельную машину. У обоих классов есть хэш-таблицы, обеспечивающие эффективный поиск данных.
public class Server < HashMap(); HashMap(); public Machine getMachineWithId(int machinelD) < return machines.get(machineID); >public int getMachineIDForUser(int personID) < Integer machinelD = personToMachineMap.get(personID); return machineID == null ? -1 : machineID; >public Person getPersonWithID(int personID) < Integer machineID = personToMachineMap.get(personID); if (machineID == null) return null; Machine machine = getMachineWithId(machineID); if (machine == null) return null; return machine.getPersonWithID(personID); >> public class Person < private ArrayListfriendIDs; private int personID; public Person(int id) < this.personID = id; >public int getID() < return personID; >public void addFriend(int id) < friends.add(id); >> public class Machine < public HashMappersons = new HashMap(); public int machinelD; public Person getPersonWithID(int personID) < return persons.get(personID); >>
Существует несколько направлений оптимизации и дополнительные вопросы, которые следует обсудить.
Оптимизация: сократите количество переходов между компьютерами
«Путешествие» с одной машины на другую — дорогая операция (с точки зрения системных ресурсов). Вместо перехода с машины на машину в произвольном порядке работайте в пакетном режиме. Например, если пять друзей «живут» на одной машине, сначала получите информацию о них.
Оптимизация: разумное «деление» людей и машин
Чаще всего друзья живут в одной и той же стране. Вместо того чтобы делить данные о пользователях по произвольному принципу, попытайтесь использовать информацию о стране, городе, состоянии и т. д. Эго сократит количество переходов между машинами.
Вопрос: при поиске в ширину необходимо помечать посещенные узлы. Как это сделать?
При поиске в ширину мы устанавливаем флаг visited для посещенных узлов и храним его в классе узла. В нашем случае так поступать нельзя. Поскольку одновременно выполняется множество запросов, данный подход помешает редактировать данные. Вместо этого можно имитировать маркировку узлов с помощью хэш-таблицы, в которой будет храниться id узла и отметка, посещен он или нет.
Другие насущные вопросы:
Это всего лишь некоторые из множества вопросов, которые могут возникнуть у вас при реализации такого алгоритма.
55. Допустим, у вас есть однонаправленный список с петлёй. Его «последний» элемент содержит указатель на один из элементов этого же списка, причём не обязательно на первый. Ваша задача — найти начальный узел петли.
Элементы списка менять нельзя, память можно использовать только константную.
Эта задача является разновидностью классической задачи, задаваемой на собеседованиях, — определить, содержит ли связный список петлю. Давайте используем подход «Сопоставление с образцом».
Часть 1. Определяем, есть ли в связном списке петля
Простейший способ выяснить есть ли в связном списке петля,— использовать метод бегунка (быстрый/медленный). FastRunner делает два шага за один такт, а SlowRunner — только один. Подобно двум гоночным автомобилям, мчащимся по одной трассе разными путями, они непременно должны встретиться.
Проницательный читатель может задать вопрос: может ли быстрый бегунок «перепрыгнуть» медленный без столкновения? Это невозможно. Допустим, что FastRunner перепрыгнул через SlowRunner и теперь находится в элементе i+1 (а медленный – в i). Это означает, что на предыдущем шаге SlowRunner был в точке i-1, а FastRunner — ((i+1)-2)=i-1. Следовательно, столкновение неизбежно.
Часть 2. Когда же они встретятся?
Давайте введем обозначение: k – длина связного списка в разомкнутом виде. Как узнать, когда FastRunner и SlowRunner встретятся, используя алгоритм из части 1?
Мы знаем, что FastRunner перемещается в два раза быстрее, чем SlowRunner. Поэтому когда SlowRunner через k шагов попадет в петлю, FastRunner пройдет 2k шагов. Поскольку k существенно больше, чем длина петли, введем обозначение K=mod(k, LOOP_SIZE).
В каждом последующем шаге FastRunner и SlowRunner становятся на шаг (или два шага) ближе к цели. Поскольку система замкнута, когда A перемещается на q, оно становится на q шагов ближе к B.
Можно установить следующие факты:
Когда же они встретятся? Если FastRunner на LOOP_SIZE – K шагов отстает от SlowRunner, а FastRunner нагоняет его со скоростью 1 шаг за единицу времени, они встретятся через LOOP_SIZE- k шагов. В этой точке они будут отстоять на k шагов от начала петли. Давайте назовем эту точку CollisionSpot.
Часть 3. Как найти начало петли?
Мы теперь знаем, что CollisonSpot – это k узел до начала петли. Поскольку K=mod(k, LOOP_SIZE) (или k=K+M*LOOP_SIZE для любого целого M), можно сказать, что до начала петли k узлов. Если узел N-2 узла в петле из 5 элементов, то элементы 7, 12 и даже 397 принадлежать петле.
Поэтому и CollisionSpot, и LinkedListHead находятся в k узлах от начала петли.
Если мы сохраним один указатель в CollisionSpot и переместим другой в LinkedListHead, то каждый из них будет отстоять на k узлов от LoopStart. Перемещение этих указателей заставит их столкнуться — на сей раз через k шагов – в точке LoopStart. Все, что нам нужно сделать, — возвратить этот узел.
Часть 4. Собираем все воедино
FastPointer двигается в два раза быстрее, чем SlowPointer. Через k узлов SlowPointer оказывается в петле, а FastPointer – на k-м узле связного списка. Это означает, что FastPointer и SlowPointer отделяют друг от друга LOOP_SIZE-k узлов.
Если FastPointer двигается на 2 узла за одиночный шаг SlowPointer, указатели будут сближаться на каждом цикле и встретятся через LOOP_SIZE-k циклов. В этой точке они окажутся на расстоянии k узлов от начала петли.
Начало связного списка расположено в k узлах от начала петли. Следовательно, если мы сохраним быстрый указатель в текущей позиции, а затем переместим медленный в начало связного списка, точка встречи окажется в начале петли.
Давайте запишем алгоритм, воспользовавшись информацией из частей 1-3:
Следующий код реализует описанный алгоритм:
LinkedListNode FindBegining(LinkedListNode head) < LinkedListNode slow = head; LinkedListNode fast = head; /*Находим первую точку встречи LOOP_SIZE-k шагов по связному списку.*/ while (fast != null && fast.next != null) < slow = slow.next; fast = fast.next.next; if (slow == fast) < //Коллизия break; >> /* Ошибка - нет точки встречи, следовательно, нет петли */ if (fast == null || fast.next == null) < return null; >/* Перемещаем медленный бегунок в начало списка (Head). Быстрый остается в точке встречи. *Каждые k шагов от Loop Start. Если указатели продолжат движение с той же скоростью, то * встретятся в точке Loop Start. */ slow = head; while (slow != fast) < slow = slow.next; fast = fast.next; >/* Возвращаем точку начала петли. */ return fast; >
56. На острове существует правило — голубоглазые люди не могут там находиться. Самолет улетает с острова каждый вечер в 20:00. Все жители собираются за круглым столом ежедневно, каждый человек может видеть цвет глаз других людей, но не знает цвет собственных. Никто не имеет права сказать человеку, какой у него цвет глаз. На острове находится не менее одного голубоглазого человека. Сколько дней потребуется, чтобы все голубоглазые уехали?
На острове существует правило — голубоглазые люди не могут там находиться. Самолет улетает с острова каждый вечер в 20:00. Все жители собираются за круглым столом ежедневно, каждый человек может видеть цвет глаз других людей, но не знает цвет собственных. Никто не имеет права сказать человеку, какой у его цвет глаз. На острове находится не менее одного голубоглазого человека. Сколько дней потребуется, чтобы все голубоглазые уехали?
Решение
Давайте используем подходы «базовый случай» и «сборка». Предположим, что на острове находится N голубоглазых людей. Мы знаем, что N > 0.
N = 1: у одного человека голубые глаза
Предположим, что все люди на острове достаточно умны. Если известно, что на острове есть только один голубоглазый человек, то, обнаружив, что у всех глаза не голубые, он придет к выводу, что он и является тем единственным голубоглазым человеком, которому следует улететь вечерним рейсом.
N = 2: у двух человек голубые глаза
Два человека с голубыми глазами видят друг друга, но не знают, чему равно c: c = 1 или c = 2. Из предыдущего случая известно, что если c = 1, то голубоглазый человек может себя идентифицировать и покинуть остров в первый же вечер. Если голубоглазый человек находится на острове (c = 2), это означает, что человек, видящий только одного голубоглазого, сам голубоглаз. Оба человека должны будут вечером покинуть остров.
N > 2: общий случай
Давайте использовать ту же логику. Если N = 3, то эти три человека сразу увидят, что на острове есть еще 2 (или 3) человека с голубыми глазами. Если бы таких людей было двое, они покинули бы остров накануне. Поскольку на острове все еще остаются голубоглазые люди, то любой человек может прийти к заключению, что c = 3 и что у него голубые глаза. Все они уедут той же ночью.
Такой шаблон можно использовать для произвольного значения N — если на острове находится N человек с голубыми глазами, понадобится N ночей, чтобы все они покинули остров.
57. Напишите код, удаляющий дубликаты из несортированного связного списка. Можно использовать только константную память.
Дополнительное задание. Как вы будете решать задачу, если запрещается использовать временный буфер?
Решение
Что бы удалить копии из связного списка, их нужно сначала найти. Для этого подойдет простая хэш-таблица. В приведенном далее решении выполняется проход по списку, каждый элемент которого добавляется в хэш-таблицу. Когда обнаруживается повторяющийся элемент, он удаляется, и цикл продолжает работу. За счет использования связного списка всю задачу можно решить за один проход.
public static void deleteDups (LinkedListNode n) < Hashtable table = new Hashtable(); LinkedListNode previous = null; while (n != null) < if (table.containsKey(n.data)) < previous.next = n.next; >else < table.put(n.data, true); previous = n; >n = n.next; > >
Приведенное решение потребует O(N) времени, где N – количество элементов в связном списке.
Дополнительное ограничение: использование буфера запрещено
В этом случае мы можем реализовать цикл с помощью двух указателей: current (работает через связный список) и runner (проверяет все последующие узлы на наличие дубликатов).
public static void deleteDups (LinkedListNode head) < if (head == null) return; LinkedListNode current = head; while (current != null) < /* Удаляем все следующие узлы с таким же значением */ LinkedListNode runner = current; while (runner.next != null) < if (runner.next.data == current.data) < runner.next = runner.next.next; >else < runner = runner.next; >> current = current.next; > >
Данный код требует всего O(1) пространства, но занимает O(N2) времени.
58. Напишите метод, тасующий карточную колоду. Колода должна быть идеально перемешана т.е. перестановки карт должны быть равновероятными. Вы можете использовать идеальный генератор случайных чисел.
Это очень популярная задача и известный алгоритм. Если вы еще не знакомы с решением, читайте дальше.
Давайте будем решать задачу «в лоб». Можно выбрать карты в произвольном порядке и поместить их в новую колоду. Фактически колода представляет собой массив, следовательно, нам нужен способ, позволяющий заблокировать отдельные элементы.
Исходная колода (до выбора 4): [1] [2] [3] [4] [5] /* Выбираем случайный элемент для помещения его в начало перетасованной колоды * Помечаем элемент в оригинальной колоде как "заблокированный", чтобы * не выбрать его снова */ Перемешанная колода (после выбора 4): [4] [?] [?] [?] [?] Исходная колода (после выбора 4): [1] [2] [3] [X] [5]
Если мы пометим элемент [4], что помешает выбрать его еще раз? Один из способов – поменять местами «мертвый» ([4]) и первый элементы колоды:
Исходная колода (до выбора 4): [1] [2] [3] [4] [5] /* Выбираем случайный элемент для перемещения его в начало перетассованной колоды * Существует элемент 1, который заменит выбранный элемент. */ Перемешанная колода (после выбора 4): [4] [?] [?] [?] [?] Исходная колода (после выбора 4): [X] [2] [3] [1] [5] /* Выбираем случайный элемент для перемещения его в начало * перетасованной колоды. Есть элемент 2, который заменит только что * выбранный элемент */ Перетасованная колода (после выбора 3): [4] [3] [?] [?] [?] Исходная колода (после выбора 3): [X] [X] [2] [1] [5]
Алгоритм проще реализовать для ситуации, когда «мертвы» первые k карт, чем для ситуации, когда, например, «мертвы» третья, четвертая и девятая карты.
Оптимизировать алгоритм можно, объединив перемешанную и исходную колоды вместе.
Исходная колода (до выбора 4): [1] [2] [3] [4] [5] /*Выбираем случайный элемент между 1 и 5 и меняем его местами с 1. * В этом примере мы выбрали элемент 4. * После этого элемент 1 - "мертв" */ Исходная колода (после выбора 4): [4] [2] [3] [1] [5] /* Элемент 1 "мертв". Выбираем случайный элемент для замены с * элементом2. В этом примере пусть мы выберем элемент * 3.*/ Исходная колода (после выбора 3): [4] [3] [2] [1] [5] /* Повторяем. Для всех i между 0 и n-1 меняем местами случайный элемент j * (j >= i, j < n) и элемент i. */
Этот алгоритм легко реализовать итеративно:
public void shuffleArray(int[] cards) < int temp, index; for (int i = 0; < cards.length; i++) < /*Карты с индексами от 0 до i-1 уже были выбраны * (они перемещены в начало массива), поэтому сейчас мы * выбираем случайную карту с индексом, больше или равным i * */ index = (int) (Math.random() * (cards.length - i)) + i; temp = cards[i]; cards[i] = cards[index]; cards[index] = temp; >>
Подобный алгоритм можно придумать и самостоятельно, он достаточно часто встречается на собеседовании. Перед интервью стоит убедиться, что вы понимаете механизм его работы.
59. Допустим, вам поручили задачу по разработке поискового робота — программы, которая, грубо говоря, посещает страницы в Интернете, индексирует, выделяет из них ссылки, переходит по ним и повторяет процесс. Вопрос: как избежать зацикливания?
Прежде всего, давайте зададим себе вопрос: при каких условиях в этой задаче может возникнуть бесконечный цикл? Такая ситуация вполне вероятна, например, если мы рассматриваем Всемирную паутину как граф ссылок.
Чтобы предотвратить зацикливание, нужно его обнаружить. Один из способов — создание хэш-таблицы, в которой после посещения страницы v устанавливается hash[v] = true .
Подобное решение применимо при поиске в ширину. Каждый раз при посещении страницы мы собираем все ее ссылки и добавляем их в конец очереди. Если мы уже посетили страницу, то просто ее игнорируем.
Здорово, но что означает посетить страницу v? Что определяет страницу v: ее содержимое или URL?
Если для идентификации страницы использовать URL, то нужно сознавать, что параметры URL-адреса могут указывать на другую страницу. Например, страница www.careercup.com/page?id=microsoft-interview-questions отличается от страницы www.careercup.com/page?id=google-interview-questions . С другой стороны, можно добавить параметры, а страница от этого не изменится. Например, страница www.careercup.com?foobar=hello — это та же страница, что и www.careercup.com .
Вы можете сказать: «Хорошо, давайте идентифицировать страницы на основании их содержимого». Это звучит правильно, но не очень хорошо работает. Предположим, что на домашней странице careercup.com представлен некий генерирующийся случайным образом контент. Каждый раз, когда вы посещаете страницу, контент будет другим. Такие страницы можно назвать разными? Нет.
На самом деле не существует идеального способа идентифицировать страницу, и задача превращается в головоломку.
Один из способов решения — ввести критерий оценки подобия страницы. Если страница похожа на другую страницу, то мы понижаем приоритет обхода ее дочерних элементов. Для каждой страницы можно создать своего рода подпись, основанную на фрагментах контента и URL-адресе.
Давайте посмотрим, как такой алгоритм может работать.
Допустим, что существует база данных, хранящая список элементов, которые необходимо проверить. При каждой итерации мы выбираем страницу с самым высоким приоритетом:
Такой алгоритм не позволит нам полностью обойти Всемирную паутину, но предотвратит зацикливание. Если нам понадобится возможность полного обхода страницы (подходит для небольших интранет-систем), можно просто понижать приоритет так, чтобы страница все равно проверялась.
Это упрощенное решение, но есть множество других, которые тоже можно использовать. Фактически, обсуждение этой задачи может трансформироваться в другую задачу.
60. У вас есть стеклянный кувшин, в котором лежат небольшие шарики, и вы в любое время можете определить их количество. Вы со своим другом играете в следующую игру: каждый из вас по очереди забирает из кувшина 1 или 2 шарика. Игрок, который забирает последний шарик, выигрывает. Какая самая лучшая стратегия в этой игре? Можете ли вы в самом начале предсказать, кто выиграет?
У вас есть стеклянный кувшин, в котором лежат небольшие шарики, и вы в любое время можете определить их количество. Вы со своим другом играете в следующую игру: каждый из вас по очереди забирает из кувшина 1 или 2 шарика. Игрок, который забирает последний шарик, выигрывает. Какая самая лучшая стратегия в этой игре? Можете ли вы в самом начале предсказать, кто выиграет?
Число шариков становится все меньше и меньше с каждым ходом, и, в конце концов, их станет как-то совсем мало. Вот тут-то стратегия становится совершенно понятной.
Давайте исходить из того, что в кувшине остался всего один шарик и теперь моя очередь брать. Взяв последний шарик, я выиграю.
Я выиграю и при двух оставшихся шариках, потому что могу взять оба.
Но три оставшихся шарика для меня плохой вариант. Мне придется оставить либо один, либо два шарика, и тут-то мой соперник немедленно воспользуется таким подарком.
Четыре и пять шариков — хороший вариант. Я могу оставить моего соперника с неудачным (уже для него) числом три.
Ну что ж, все понятно. Число, которое делится на три, означает для меня проигрыш: 3, 6, 9, 12… — плохие варианты, когда моя очередь ходить. Все другое (1, 2, 4, 5, 7, 8…) — прекрасно.
Так как теперь этим воспользоваться в игре? Мы начинаем с большого, но неизвестного числа шариков. Разделим его на 3. Если число делится без остатка, это неудачный для нас вариант. Тогда постарайтесь не ходить первым. Если соперник предложит вам бросить монетку, чтобы решить, кто должен ходить первым, проявите «великодушие» и позвольте ему сделать первый ход. Если же вам улыбнулась удача и число шариков не делится на три, и вы ходите первым, то стратегия выигрыша проста: с каждым ходом берите столько шариков, чтобы в кувшине оставалось проигрышное число. Скажем, если вы начнете с 304 шариков (прекрасно для вас), вы забираете один, оставляя сопернику неудачные для него 303. Поступайте так при каждом ходе, и, в конце концов, он останется с тремя шариками. Такая стратегия обеспечит вам победу.
Более того, такая стратегия совершенно надежно приведет вас к выигрышу, независимо от того, как будет действовать другой игрок (если только в порыве гнева он не размахнется кувшином об пол). Ему приходится забирать один или два шарика из оставшегося числа, неудачного для него. Это всегда позволяет вам при следующем ходе оставлять в кувшине «удачное» число шариков.
Но что делать, если вы начинаете с неудачного расклада? Вы обречены на поражение, если другой игрок сам применит описанную выше стратегию. Однако пока никакой трагедии нет. Ваш соперник может и не знать о такой стратегии, а может просто просчитаться. Любой, кто играет без стратегии, почти обязательно рано или поздно предоставит вам возможность перейти к счастливому (для вас) числу, поскольку две трети всех чисел для вас выигрышны. Человек, который знает оптимальную стратегию, но в ходе игры ошибется хотя бы раз, обречен: он больше не командует парадом (конечно, при условии, что вы такой ошибки не совершите).
Но, собственно, вас-то спрашивают, можно ли предсказать, кто выиграет. Да, если оба игрока идеально знают теорию этой игры. Определите, является ли первоначальное число шариков «счастливым». Если да, то первый игрок всегда выиграет. И наоборот.
Но живем мы с вами в реальном мире. Кто возьмется предсказать конечный результат?! Даже если оба игрока знают правильную стратегию, чем больше шариков в игре, тем выше вероятность ошибки. Шансы выше у того, кто не ошибется, следуя выигрышной стратегии.
Встречаются и варианты этого вопроса, например такой: проигрывает тот, кто забирает последний шарик. Как поступить в этом случае? «Неудачное» число шариков запишем в виде 3N+1, а затем будем применять ту же самую стратегию.
61. Имеется N компаний, и вы хотите, чтобы они слились и образовали одну крупную компанию. Сколько разных способов вы можете использовать для этого? Поглощение можно считать частным случаем слияния, когда А поглощает Б и Б полгощает А — два разных способа. Равнозначные слияния тоже возможны.
При правильном толковании термина «слияние» две компании отказываются от своей прежней индивидуальности и сливаются в новое образование, имеющее новый бренд. Так, фармацевтические гиганты Glaхо Wеllсоmе и SmithКlіnе Веесham в 2000 году слились, после чего на свет появился фармацевтический колосс GlaxoSmithKline. (К тому же, как вы правильно угадали, обе родительские компании сами были результатом многочисленных предыдущих слияний).
Если учесть эго главных исполнительных директоров, настоящие слияния встречаются нечасто. Для слияния требуется, чтобы силы переговорщиков были примерно одинаковы. Гораздо чаще встречаются ситуации, при которых руководство одной компании имеет преимущество и поэтому не позволяет лидерам более слабой компании об этом забыть. Поэтому сделка по своей сути больше напоминает поглощение, то есть вариант объединения, при котором компания А проглатывает компанию В, после чего В перестает существовать как отдельная организация (хотя часто сохраняется как бренд). Примером такого развития событий можно назвать поглощение Google в 2006 году YоuТubе.
В этом отношении слияния являются симметричными, так как имеется всего лишь один способ, когда две компании сливаются как равные. Поглощение же асимметрично: одна компания является поглощающей, а другая — поглощаемой. Вариант, при котором Google купил YоuТubе, не эквивалентен варианту, когда YоuТubе приобрела бы Google.
Большинство людей, не работающих в инвестиционных банках, не видят большой разницы между слияниями и поглощениями. Поэтому любое объединение корпораций они не очень строго называют «слиянием». Из этого следует, что вам необходимо спросить интервьюера, что он понимает в своем вопросе под «слиянием». К счастью, большинство обоснований, приведенных ниже, сохраняются независимо от того, каким будет пояснение интервьюера.
Начните с поглощений, поскольку они встречаются чаще (и к тому же эти случаи немного легче для разъяснений). Можно воспользоваться аналогией: представим компании игроками в шашки, а поглощения — ходами в продолжающейся игре. Начните с того, что число игроков составляет N. Ход в игре заключается в том, чтобы поставить одну шашку на другую, что означает, что верхняя шашка «поглотила» нижнюю. После поглощения вы можете пользоваться «высокими» шашками так, как «дамками» в обычной игре.
Каждый ход приводит к снижению числа шашек (как простых, так и «высоких») на одну. В итоге вы поставите все шашки в одну пирамиду и создадите максимально высокую комбинацию. Чтобы добиться цели в этой игре, вам потребуется N-1 шагов, в результате чего, в конце концов, появится пирамида, состоящая из N шашек. Сколько различных сценариев могут привести к такому исходу?
Самый простой случай — участие двух компаний, при котором компания А может поглотить компанию В или В может поглотить А. В этом случае имеется два возможных сценария.
Если компаний три, вам вначале надо решить, какая компания первой поглотит другую компанию и какую именно. Существует шесть вариантов такого первого поглощения, которые можно представить в виде шести возможных пар, состоящих из трех составляющих (АВ, АС, ВА, ВС, СА и СВ). После первоначального поглощения у вас остается две компании. Теперь ситуация точно такая же, как та, которая описана в предыдущем абзаце. Поэтому число возможных поглощений при трех компаниях составляет 6 x 2 = 12.
Если компаний четыре, вы получаете 12 возможностей для первого поглощения: АВ, АС, АD, ВА, ВС, ВD, СА, СВ, СD, DА, DВ и DС. Как вы уже поняли, если при трех компаниях на этом этапе возможно 12 вариантов, то при наличии четырех компаний имеется 12 x 6 x 2, то есть 144 варианта поглощений.
Давайте обобщим. При N компаниях число первоначальных поглощений составляет
Это означает лишь, что любая из N компаний может стать первой из поглощающей, а любая из оставшихся (N-1) компаний — первой поглощаемой. После первого поглощения остается N-1 отдельных компаний и имеется (N-1) х (N-2) возможностей для совершения второго поглощения. После этого остается (N-2) компаний и (N-2) х (N-3) возможных поглощений. Продолжим умножать все время уменьшающееся число возможных поглощений и будем делать это до тех пор, пока не придем к последнему поглощению, в котором остается 2 х 1 возможностей. Легко понять, что, используя обозначение при помощи факториала, произведение можно выразить как N! х (N-1)!, то есть именно таким будет число возможных сценариев поглощений.
Что произойдет, если мы рассмотрим не поглощения, а собственно слияния. При таком подходе можно взять результаты приведенного выше анализа для каждого из N-1 поглощений и разделить его на 2. Из этого следует, что число действительных вариантов слияний равняется N! х (N-1)!, деленное на 2^(N-1).
И наконец, если слияние может означать как слияние, так и поглощение, вы просто складываете друг с другом оба ответа.
62. Какой минимальный комплект монет необходим для того, чтобы выдать любую сдачу от 1 до 99 центов? Доступные номиналы монет: 1, 5, 10, 25, 50 центов и 1 доллар.
Есть два способа интерпретации этого вопроса. Они приводят к разным ответам, и поэтому вам лучше спросить интервьюера, что он имеет в виду (или подготовить оба варианта ответов). Одна интерпретация заключается в том, чтобы отыскать наименьший ассортимент монет, позволяющий дать точную сдачу от 1 до 99 центов. Назовем такой комплект универсальным набором для выдачи сдачи. Сколько монет будет в этом наборе?
В задаче используются монеты США. Доллар США (USD, $), равный 100 центам. В обращении находятся монеты — penny (1 цент), nickel (5 центов), dime (10 центов), quarter (25 центов), half dollar (50 центов), а также 2 и 1 доллар.
Представим, что вы владелец лавки и педантичный по натуре человек, который любит начинать день, имея в своей кассе достаточно монет, чтобы можно было дать сдачу при первой покупке в день, независимо от суммы. Каково минимальное число монет должно быть в вашей кассе, чтобы в любом случае вы могли дать сдачу?
Ответ легкий, поскольку монеты в Америке специально подобраны по номиналу так, чтобы облегчить сдачи. Каждая монета по стоимости, по крайней мере, вдвое дороже предыдущей. Это означает, что вы можете использовать следующий алгоритм для выдачи сдачи, равной Х центов.
Если требуемая сдача Х равна 50 центам и более, положите 50-центовую монету и вычтите эту сумму из Х.
Если Х теперь равно 25 центам или более, положите четвертак (25 центов) и вычтите его из Х.
Разделите новое значение Х на 10 и выделите целую часть. Положите в кассу 10-центовики в количестве, равном целой части.
Если оставшаяся сумма равна 5 центам и более, положите в кассу 5-центовик и вычтите остаток из суммы.
Разделите оставшуюся сумму на центы и положите в кассу 1-центовые монеты в количестве последнего остатка.
Это правило не только работает, но и позволяет вам выдать любую сдачу при наличии минимально возможного числа монет. Вы можете, например, пропустить первую строку и использовать два четвертака вместо одной 50-центовой монеты, но это означает, что вам потребуется дополнительная монета.
Хотите дать любую сумму сдачи минимальным числом монет? Всегда имейте в своем распоряжении одну 50-центовую, один четвертак, один 5-центовик, причем каждую из этих монет достаточно иметь только в одном экземпляре. Вам также может потребоваться два 10-центовика (скажем, если надо выдать сдачу, равную 20 центам) и не более четырех 1-центовых монет (чтобы выдать 4 цента). Это означает, что у вас должны быть девять монет на общую сумму, равную 1,04 доллара. Это универсальный набор, позволяющий выдать любую сдачу. Очевидно, чтобы дать сдачу с доллара, вам никогда не потребуется использовать все девять монет сразу.
Альтернативная интерпретация вопроса такова: каково наименьшее число Х, при котором вам никогда не потребуется больше Х монет, чтобы выдать сдачу. Фактически здесь спрашивается, для выдачи, какой сдачи вам потребуется больше всего монет. Может быть, вы полагаете, что больше всего монет вам будет нужно для сдачи, равной 99 центам? Вы правы. Для этого вам потребуется восемь монет, а именно одна 50-центовая, четвертак, два 10-центовика и четыре 1-центовика. Восемь монет также потребуется и для сдачи, равной 94 центам (по сравнению с предыдущим набором вместо одного 10-центовика вы воспользуетесь 5-центовиком).
Этот вопрос считается довольно запутанным и используется в психологических тестах на креативность.
63. У вас есть 25 лошадей. Сколько забегов вам нужно устроить, чтобы определить трех самых быстрых из них? Вы не можете пользоваться секундомером. В каждом заезде могут участвовать только пять лошадей.
Вы можете начать свой ответ с уточнения: спросите интервьюера, следует ли считать «самой быстрой лошадью» ту, которая выигрывает конкретную скачку. Хотя этот вариант не работает на ипподроме, он в значительной степени упрощает задачу: предположим, что если А побеждает В в одной гонке, то А объективно и бесспорно более быстрая лошадь, чем В. Если вам скажут, что использовать это допущение можно, то в отдельной гонке действительно победит самая быстрая лошадь.
Первое, что приходит в голову, — нужны, по крайней мере, пять забегов. Любая из лошадей может быть в числе первых трех. К тому же вам потребуется устроить забеги для всех 25 лошадей. Пять забегов по пять лошадей в каждом — никак иначе.
Логично. Второй вывод: пяти забегов недостаточно. Разделите 25 лошадей на группы по пять, и устройте забеги. В каждом забеге одна лошадь будет конкурировать с другими четырьмя. Скажем, в одной из гонок будут участвовать лошади, которые придут к финишу в следующем порядке.
Хотя в этом забеге победила Ридонна, по его результатам вы не можете прийти к выводу, что она является самой быстрой лошадью из 25 или даже входит в тройку сильнейших. Чтобы пояснить последнее утверждение, воспользуемся крайним случаем: представим, что все самые медленные лошади в других заездах являются более быстрыми, чем Ридонна (которая, возможно, в общем рейтинге займет лишь 21-е место из 25 возможных).
Узнали ли мы что-нибудь из этого заезда? Разумеется, да. Мы узнали, как проранжировать пять конкретных лошадей. Мы также узнали, что можем вычеркнуть из числа претенденток на число лучших Веронику и Альмадену. Поскольку они не вошли в тройку первых в этом заезде, они не могут быть и в тройке самих быстрых из 25 лошадей.
То же самое можно сказать о лошадях, занявших четвертое и пятое места в других забегах. В каждом забеге из пяти лошадей две выбывают из дальнейшего рассмотрения. После первых пяти забегов мы можем вычеркнуть 10 лошадей, оставив 15 в качестве претендентов на звание самих быстрых трех.
Шестая гонка должна сравнить лошадей, которые хорошо показали себя в первых пяти заездах. Кажется разумным устроить гонки для победителей первых пяти заездов. Давайте так и сделаем. Возьмем Ридонну из заезда, описанного выше, и отправим ее на соревнования с победителями других заездов. Конечный результат может выглядеть следующим образом.
Опять же мы можем обоснованно вычеркнуть из числа претендентов на победу Принцессу Гиту и Сикарель. Они, очевидно, если руководствоваться результатами этого забега, не могут входить в число трех быстрейших из 25. Мы также узнаем, что самой быстрой лошадью является Фидана, поскольку она опередила всех остальных лошадей, которые были первыми в предыдущих забегах. Если вопрос заключался бы в том, чтобы определить самую быструю лошадь из 25, то мы уже получили бы ответ. Ею является Фидана.
Однако нам надо определить трех самых быстрых. Из числа претенденток на победу мы можем вычеркнуть не только Принцессу Гиту и Сикарель, но и всех тех лошадей, которых они опередили в первых скачках. Лошади, которых они опередили, были более медленными, а мы уже знаем, что победители двух забегов из списка вычеркнуты.
Теперь давайте разберемся с Флавией. Поскольку она пришла третьей в этом забеге, все лошади, которых она опередила в первом забеге, также исключаются из дальнейшего рассмотрения.
Теперь перейдем к Ридонне. Исходя из последней гонки, она, возможно, в лучшем случае является второй лошадью из всех. Это оставляет открытым вопрос о Бавкиде. которая в первом круге пришла второй, после Ридонны, но в целом она может быть третьей из всех лошадей. (В этом случае список победителей был бы таким: Фидана, Ридонна, Бавкида).
Харцея, пришедшая третьей в первой гонке, где победителем была Ридонна, теперь выбывает из дальнейшего участия.
Две лошади, пришедшие второй и третьей после Фиданы в первой гонке, все еще остаются претендентами. Возможно, эти лошади быстрее Ридонны. но они никогда с ней не соревновались.
Итак, осталось шесть лошадей. Из них три были первыми в последней гонке: две, которые пришли второй и третьей в гонке с общим победителем, и одна, которая пришла второй в своей первой гонке, уступив только лошади, которая в общем зачете заняла второе место.
Мы уже знаем, что самая быстрая из всех лошадей — Фидана. По этой причине нет смысла опять устраивать с ней гонки. Остается всего пять лошадей. Естественно, мы устроим забег для них в седьмом и последнем раунде. Первые две лошади, оказавшиеся здесь победителями, в итоге займут второе и третье места.
Небольшое изменение правил. Начните с квалификационного раунда из пяти забегов, в которых будут соревноваться все 25 лошадей. Затем выберите вариант чемпионской гонки: в следующий круг будут допущены только победители квалификационных заездов. Лошадь, которая придет первой во второй гонке, и станет общим победителем.
64. Короткая задачка на сообразительность. По результатам исследования известно, что 70% людей любят кофе, в то же время 80% любят чай. Каковы верхние и нижние границы доли людей, которые одновременно любят кофе и чай?
Не все любители чая положительно относятся к кофе; не все любители котов терпят собак, и не все фанаты одной команды одновременно являются болельщиками другой. Нарисуйте диаграмму Венна на доске или хотя бы мысленно. Она представляет собой прямоугольник, чья площадь соответствует числу участников исследования. Пусть большая часть этого прямоугольника соответствует 70% — это число респондентов, любящих кофе, а небольшой кружок внутри отражает 30% тех людей, которые, очевидно, не любят кофе. (Общая площадь всего прямоугольника должна составлять 100%, хотя добиваться такой точности на картинке не обязательно.)
80% респондентов любят чай. Если эти проценты показать в виде круга, то он наложится на те части, которые отражают любителей кофе, и тех, кто негативно относится к этому напитку. (Группа любителей кофе просто недостаточна, чтобы вобрать в себя всех тех, кто любит чай.) Чтобы задать верхнюю границу людей, любящих оба напитка, предположим, что каждый любитель кофе любит и чай.
Поэтому круг, отражающий 80% любителей чая, можно разделить на две части: тех, кто любит и чай, и кофе (70%) и тех, кто любит только чай (10%). 70% являются верхней границей.
Чтобы получить нижнюю границу, сместим круг, относящийся к любителям чая, так, чтобы он закрыл круг тех, кто не любит кофе. Теперь каждый, кому не нравится кофе (30%), любит чай. Это приводит к 80 – 30 = 50% тех, кто любит чай и кофе. Эта цифра является нижней границей.
65. Задачка, которую нужно решать без калькулятора и компьютера, имея под рукой только карандаш и бумагу. Сколько нулей в конце факториала 100?
Факториал одной сотни записывается как 100! Это произведение всех натуральных чисел до ста включительно. Иногда запись факториала имеет такой вид:
100 х 99 х 98 х 97 х … х 4 х 3 х 2 х 1
Для ответа на вопрос задачи вам не обязательно находить результат умножения. От вас ждут, чтобы вы лишь определили число нулей в конце произведения, не зная, каким именно оно будет. Для решения этой задачи потребуется сформулировать несколько правил. Одно из них вы уже знаете. Взгляните на следующее выражение.
387 000 х 12 900 = 5 027 131 727
Вам не кажется, что здесь есть что-то забавное? Ведь при перемножении двух круглых чисел, то есть тех, которые оканчиваются на нули, невозможно получить некруглое число. Это нарушило бы закон сохранения конечных нулей (закон, который я только что вывел, но, тем не менее, он является верным). Произведение всегда унаследует нулевые окончания своих составляющих. Вот несколько верных примеров этого:
10 х 10 = 100 7 х 20 = 140 30 х 400 = 12 000
Из сомножителей факториала 100 десять заканчиваются на ноль: 10, 20, 30, 40, 50, 60, 70, 80, 90 и 100 (заканчивается на два 0). Это дает уже как минимум одиннадцать конечных нулей, которые 100! обязательно унаследует.
Предупреждение: следование только этому правилу иногда побуждает некоторых кандидатов в своем ответе заявить, что в конце факториала 100 стоят одиннадцать нулей. Такой ответ является неверным. Иногда можно умножить два числа, не заканчивающихся на ноль, и получить произведение, имеющее в конце один или несколько нулей. Вот несколько примеров этого рода:
2 х 5 = 10 5 х 8 = 40 6 х 15 = 90 8 х 125 = 1000
Все, кроме последней пары, входят в сотню составляющих факториала 100. Поэтому ваша работа не закончилась. Теперь мы подходим к закону «сосисок и булочек». Представьте себе ситуацию, когда на пикник одни люди приносят сосиски (в упаковках по десять штук), другие — булочки (упакованные по восемь штук), а некоторые — и то, и другое. Есть единственный способ, позволяющий определить, сколько хотдогов из этих продуктов можно приготовить. Сосчитайте сосиски, сосчитайте булочки и выберите меньшее число из двух.
Тот же самый закон следует использовать и отвечая на наш вопрос. Для этого надо заменить «сосиски» и «булочки» на «сомножители на 2» и «сомножители на 5».
В каждом из приведенных выше уравнений число, которое делится на 2, умножается на число, которое делится на 5. Сомножители на 2 и на 5 при их перемножении «совместно» дают идеальную десятку, что добавляет еще один ноль к общему произведению. Посмотрите на последний пример, где в конце, можно сказать, из воздуха возникает три нуля.
8 х 125 = (2 х 2 х 2) х (5 х 5 х 5) = (2 х 5) х (2 х 5) х (2 х 5) = 10 х 10 х 10 = 1000
Поэтому надо составить пары из двоек и пятерок. Возьмем, к примеру, число, равное 692 978 456 718 000 000.
Оно оканчивается на шесть нулей. Это означает, что его можно записать следующим образом:
692 978 456 718 х 10 х 10 х 10 х 10 х 10 х 10,
692 978 456 718 х (2 х 5) х (2 х 5) х (2 х 5) х (2 х 5) х (2 х 5) х (2 х 5).
Первая часть, 692 978 456 718, не делится на 10. В ином случае она бы оканчивалась на ноль, и можно было бы эту часть уменьшить еще в 10 раз. К тому же здесь есть шесть сомножителей, равных 10 (или 2 х 5), что соответствует шести нулям в конце числа 692 978 456 718 000 000. Ну как, убедительно?
Это дает нам надежную систему для определения количества нулей в конце любого большого числа. Выделите сомножители 2 и 5. Составьте из них пары и перемножьте их: (2 х 5) х (2 х 5) х (2 х 5) х … Число пар из двоек и пятерок равно количеству нулей в конце. Закройте глаза на все, что осталось слева.
В целом слева у вас останется двойка или пятерка, для которых не нашлось пары. Обычно это двойки. Более того, когда вы имеете дело с факториалом, это всегда двойки. (В факториалах имеется больше четных множителей, чем множителей, которые делятся на 5.) Поэтому узким местом является число пятерок. Из этого следует, что вопрос можно сформулировать по-другому: сколько раз 100! можно разделить без остатка на 5?
Эту арифметическую операцию можно легко проделать даже в голове. В диапазоне от 1 до 100 есть 20 чисел, которые делятся на пятерку: 5, 10, 15, …, 95, 100. Обратите внимание, что 25 дает 2 множителя, равные 5 (25 = 5 х 5), и к тому же в этой группе есть еще три числа, в состав которых входит 25: 50, 75 и 100. В совокупности это добавляет еще четыре пятерки, а всего их 24. 24 множителя на пять дают 24 пары с равным числом двоек, в результате чего получается 24 множителя на 10 (оставляя слева еще множество двоек, для которых не оказалось пары). Таким образом, в конце 100! будет 24 нуля.
Если вам любопытно узнать точный ответ, то значение факториала 100 равно:
93 326 215 443 944 152 681 699 238 856 266 700 490 715 968 264 381 621 468 592 963 895 217 599 993 229 915 608 941 463 976 156 518 286 253 697 920 827 223 758 251 185 210 916 864 000 000 000 000 000 000 000 000.
66. Предложите алгоритм нахождения самой большой суммы непрерывной последовательности из массива целых чисел, как положительных, так и отрицательных.
Это довольно сложная, но очень популярная задача. Давайте решим ее на примере массива:
2 3 -8 -1 2 4 -2 3
Если рассматривать массив как содержащий чередующиеся последовательности положительных и отрицательных чисел, то не имеет смысла рассматривать части положительных или отрицательных субпоследовательностей. Почему? Включая часть отрицательной субпоследовательности, мы уменьшаем итоговое значение суммы, значит, нам не стоит включать часть отрицательной субпоследовательности вообще. Включение части положительной субпоследовательности выглядит еще более странным, поскольку включение этой субпоследовательности целиком всегда даст больший результат.
Нужно придумать алгоритм, рассматривая массив как последовательность отрицательных и положительных чисел, расположенных вперемежку.
Любое число можно представить в виде суммы субпоследовательностей положительных и отрицательных чисел. В нашем примере массив можно сократить до:
5 -9 6 -2 3
Мы еще не получили отличный алгоритм, но теперь лучше понимаем, с чем имеем дело.
Рассмотрим предыдущий массив. Нужно ли учитывать субпоследовательность ? В сумме мы получим -4, значит, нет смысла учитывать оба этих числа, достаточно только .
В каких случаях имеет смысл учитывать отрицательные числа? Только если это позволяет нам объединить две положительные субпоследовательности, сумма каждой из которых больше, чем вклад отрицательной величины.
Давайте продвигаться, начиная с первого элемента в массиве.
5 — это самая большая сумма, встретившаяся нам. Таким образом, maxsum = 5 и sum = 5. Затем мы видим следующее число (-9). Если добавить это число к sum, то получится отрицательная величина. Нет смысла расширять субпоследовательность с 5 до -9 (-9 уменьшает общую сумму до 4). Таким образом, мы просто сбрасываем значение sum.
Теперь мы дошли до следующего элемента (6). Эта субпоследовательность больше, чем 5, таким образом, мы обновляем значения maxsum и sum.
Затем мы смотрим на следующий элемент (-2). Добавление этого числа к 6 сделает sum = 4. Так как это не окончательное значение, наша субпослсдовательность выглядит как . Мы обновляем sum, но не maxsum.
Наконец мы смотрим па следующий элемент (3). Добавление 3 к sum (4) даст нам 7, таким образом, мы обновляем maxsum. Максимальная последовательность имеет вид .
Когда мы работаем с развернутым массивом, логика остается такой же. Следующий код реализует этот алгоритм:
public static int getMaxSum(int[] a) < int maxsum = 0; int sum = 0; for (int i = 0; i < a.lenght; i++) < sum += a[i]; if (maxsum < sum) < maxsum = sum; >else if (sum < 0) < sum = 0; >> return maxsum; >
А если массив состоит из отрицательных чисел? Как действовать в этом случае? Рассмотрим простой массив . Можно дать три разных ответа:
В нашем коде был использован второй ответ (sum = 0), но в этом вопросе не существует однозначного «правильного» решения. Обсудите это с интервьюером.
67. Напишите программу расчета значения медианы в потоке чисел, динамически отслеживающую новые поступающие числа, получаемые рандомом.
Одно из возможных решений — использовать две кучи разных приоритетов: максимальная куча (maxHeap) для значений выше среднего и минимальная куча (minHeap) для значений ниже среднего. Это позволит разделить элементы примерно поровну с двумя значениями — вершинами куч. Теперь найти среднее значение очень просто.
Что означает «примерно поровну»? «Примерно» означает, что при нечетном количестве чисел в одной из куч окажется лишнее число. Можно сформулировать:
если maxHeap.size() > min.Heap.size(), то heap1.top() будет средним значением; если maxHeap.size() == minHeap.size(), то средним значением будет среднее значений maxHeap.top() и min.Heap.top().
В алгоритме с балансировкой мы гарантируем, что maxHeap будет всегда содержать дополнительный элемент.
Алгоритм работает следующим образом. Если новое значение меньше или равно среднему, оно помещается в maxHeap, в противном случае оно попадает в minHeap. Размеры куч могут совпадать или в maxHeap может быть один дополнительный элемент. Это требование легко выполнить, сдвигая элемент из одной кучи в другую. Среднее значение находится в вершине. Обновления занимают O(log(n)) времени.
private Comparator maxHeapComparator; private Comparator minHeapComparator; private PriorityQueue maxHeap, minHeap; public void addNewNumber(int randomNumber) < /*Заметьте: addNewNumber поддерживает условие, что *maxHeap.size() >= minHeap.size() */ if (maxHeap.size() >= minHeap.size()) < if ((minHeap.peek() != null) && randomNumber >minHeap.peek()) < maxHeap.offer(minHeap.poll()); minHeap.offer(randomNumber); >else < maxHeap.offer(randomNumber); >> else < if(randomNumber < maxHeap.peek()) < minHeap.offer(maxHeap.poll()); maxHeap.offer(randomNumber) >else < minHeap.offer(randomNumber); >> > public static double getMedian() < /*maxHeap является всегда по крайней мере столь же большой, *как minHeap. Если maxHeap пуста, то minHeap тоже пуста. */ if (maxHeap.isEmpty()) < return 0; >if(maxHeap.size() == minHeap.size()) < return ((double)minHeap.peek()+(double)maxHeap.peek()) / 2; >else < /* Если maxHeap и minHeap разных размеров, то * в maxHeap есть один дополнительный элемент. * Возвращаем вергину кучи maxHeap */ return maxHeap.peek(); >>
68. Идет дождь, а вам надо добраться до вашей машины, которая стоит в самом дальнем конце парковки. Побежите ли вы к ней или нет, если ваша цель — как можно меньше промокнуть? Как вы будете себя вести, если у вас есть зонтик?
Идет дождь, а вам надо добраться до вашей машины, которая стоит в самом дальнем конце парковки. Побежите ли вы к ней или нет, если ваша цель — как можно меньше промокнуть? Как вы будете себя вести, если у вас есть зонтик?
Чтобы ответить на этот вопрос, нужно примирить два противоречащих факта, влияющих на ход ваших размышлений. Вот аргументы в пользу бега: чем дольше вы находитесь под дождем, тем больше капель упадет на вашу голову, и тем больше вы промокнете. Если же вы побежите, вы сократите время воздействия на вас дождя и тем самым останетесь более сухим.
Но есть и довод против бега. При горизонтальном перемещении вы попадаете и под те капли дождя, которые на вас не упали бы, если бы вы остались на месте. Человек, который бежит под дождем, промокает больше, чем тот, кто стоит под тем же самым дождем.
Это весомый довод, но в данном случае он просто неприменим. Вам нужно добраться до вашего автомобиля, и ничего с этим нельзя поделать. Представьте, что вы мчитесь через парковку с бесконечно высокой скоростью. Ваши чувства также бесконечно обострились, и поэтому вы не натыкаетесь на другие машины. Время для вас как бы остановилось. Это напоминает эффект замедленной съемки. Капли дождя как бы не двигаются, а «висят» в воздухе. Во время этого стремительного бега ни одна капля не упадет на вашу голову, спину или бока. Но, чтобы добраться до автомобиля, вам необходимо «пробить» своего рода туннель в дожде. Поэтому часть вашей одежды спереди впитает в себя каждую каплю, находящуюся на пути от укрытия до машины.
Когда вы перемещаетесь с нормальной скоростью, вы обречены встретиться с теми же самыми каплями или, точнее, с их последователями. При нормальной скорости свою долю капель получит и ваша голова. Число дождевых капель, с которыми вы встретитесь, зависит от длины вашего горизонтального пути, а также от того времени, которое вам потребуется для его преодоления. Длина пути в этой задаче — заданное условие. Единственная вещь, которую вы можете контролировать, — это время перемещения. Чтобы остаться максимально сухим, вам следует бежать как можно быстрее. Бег приведет к тому, что вы промокнете меньше, конечно, при условии, что у вас нет с собой зонтика.
Если бы у вас был зонтик, и он был бы размером с городской квартал, и если вы смогли бы его удерживать, то было бы совсем не важно, ползете ли вы как черепаха или мчитесь как спринтер. В любом случае с таким зонтиком вы останетесь сухим, как ломтик хлеба в тостере.
Большинство зонтиков достаточно большие, чтобы человек, если он стоит под обычным вертикально идущим дождем, не промок. Но, как вы знаете, на практике вы все равно чуть-чуть промокнете.
Зонтики создают препятствия для дождя и образуют зону, где нет дождевых капель. При вертикальном падении капель и при зонтике в виде круга защитная зона от дождя похожа на цилиндр. Если дождь падает под углом, зона защиты от дождя становится скошенным цилиндром. Поэтому, как знает каждый опытный «пользователь», лучше всего наклонить зонтик в направлении падения дождя. Это приведет к тому, что зона защиты снова станет правильным цилиндром, хотя и наклоненным на некоторый угол относительно вертикали.
Стоящее человеческое тело не вписывается в наклоненный цилиндр. Если же дождь сопровождается ураганным ветром, который направляет капли на вас горизонтально, вам придется держать зонтик горизонтально, и зонт диаметром в три фута (около 90 см) будет защищать лишь половину вашего тела. Вторая половина промокнет.
От ветра, как и движения, вы намокнете больше. Профи знает, что зонт нужно наклонить вперед в направлении движения, чтобы обеспечить максимальную защиту. Фактически, даже если зонтик занимает оптимальное положение, ветер и движение человека все равно все сведут на нет. Бег со скоростью десять миль в час без ветра при вертикальном дожде потребует того же самого наклона, как и стояние под дождем при ветре в десять миль в час. В любом случае, помимо своей обычной скорости падения, дождевые капли будут воздействовать на вас и горизонтально, со скоростью 10 миль в час.
При вертикальном дожде лучший для вас вариант — идти медленно. Зонтик не придется сильно наклонять, и вы окажетесь в «укромном уголке». В идеале вам следует идти с такой скоростью, чтобы ваши ноги не оказывались вне этой зоны. Тогда вы останетесь сухим.
Разумеется, в реальной жизни все гораздо сложнее. Тут вам и порывы ветра, брызги от ударов капель о мостовую, и капли, стекающие с самого зонтика. Дождь, упавший на зонтик, никуда не испаряется. Капли стекают и падают вниз — по той же самой поверхности цилиндра, что создает ваш зонтик. И уж тут-то, по краям зонта, дождя больше, чем где-либо еще. Это означает, что любая часть вашего тела, которая высунется за этот край защиты, промокнет быстрее, чем если бы вы шли без зонта.
При резких порывах ветра преимущества медленного движения сходят на нет. Вам придется наклонить зонтик так, что нижняя половина вашего тела останется не под зонтом. Так что независимо ни от чего, наполовину вы точно промокнете.
Однако забудьте все эти мудреные рассуждения и вспомните совет своей мамы: идите, если у вас есть зонтик, и бегите, если у вас его нет.
Так же можно посмотреть расследование «Разрушителей легенд» начиная с 15 минуты.
69. Представьте, что существует квадратная матрица, каждый пиксель которой может быть черным или белым. Разработайте алгоритм поиска максимального субквадрата, у которого все стороны черные.
Разбор двух вариантов решения за O(N^4) и O(N^3). Можете ли вы найти другие варианты?
Эту задачу также можно решить двумя способами: простым и сложным. Давайте рассмотрим оба решения.
«Простое» решение: O(N 4 )
Мы знаем, что длина стороны самого большого квадрата равна N и существует только один квадрат размером N*N. Можно проверить, является ли квадрат искомым, и сообщить, если это так.
Если квадрат размером N*N не найден, можно попытаться найти следующий квадрат: (N-1)*(N-1). Проверяя все квадраты этого размера, мы возвращаем первый найденный квадрат. Затем аналогичные операции повторяются для N-2, N-3 и т. д. Так как каждый раз мы уменьшаем размер квадрата, то первый найденный квадрат будет самым большим.
Наш код работает так:
Subsquare findSquare(int[][] matrix) < for (int i = matrix.length; i >= 1; i--) < Subsquare square = findSquareWithSize(matrix, i); if (square != null) return square; >return null; > Subsquare findSquareWithSize(int[][] matrix, int squareSize) < /* На стороне размером N есть (N - sz + 1) квадратов * длины sz. */ int count = matrix.length - squareSize + 1; /* Перебор всех квадратов со стороной squareSize. */ for (int row = 0; row < count; row++) < for (int col = 0; col < count; col++) < if (isSquare(matrix, row, col, squareSize)) < return new Subsquare(row, col, squareSize); >> > return null; > boolean isSquare(int[][] matrix, int row, int col, int size) < // Проверяем верхнюю и нижнюю стороны for (int j = 0; j < size; j++)< if (matrix[row][col+j] == 1) < return false; >if (matrix[row+size-l][col+j] == 1) < return false; >> // Проверяем левую и правую стороны for (int 1=1; i < size - 1; i++)< if (matrix[row+i][col] == 1)< return false; >if (matrix[row+i][col+size-1] == 1) < return false; >> return true; >
Решение с предварительной обработкой: O(N 3 )
Неторопливость «простого» решения связана с тем, что мы должны произвести O(N) операций при каждой проверке квадрата–кандидата. Проведя предварительную обработку, можно сократить время isSquare до O(1), тогда алгоритм потребует O(N 3 ) времени.
isSquare пытается узнать, не являются ли нулевыми squareSize, находящиеся правее (и ниже) определенных ячеек. А эту информацию можно узнать заранее.
Мы выполним проверку справа налево и снизу вверх. Для каждой ячейки нужно рассчитать:
если А[r][с] является белым, А[r][с].zerosRight = 0 и A[r][с].zerosBelow = 0 иначе A[r][c].zerosRight = А[r][с + 1].zerosRight + 1 А[r][с].zerosBelow = А[r + 1][с].zerosBelow + 1
Посмотрите на значения для некоторой матрицы.
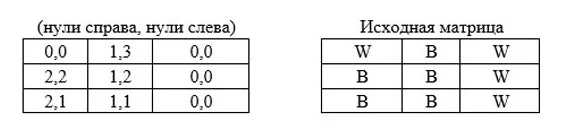
Теперь, вместо того чтобы итерировать по O(N) элементов, метод isSquare проверяет углы на zerosRight и zerosBelow.
Далее приведен код этого алгоритма. Обратите внимание, что findSquare и findSquare — WithSize совпадают, за исключением вызова processMatrix и последующей работы с новым типом данных:
public class SquareCell < public int zerosRight = 0; public int zerosBelow = 0; /* объявления, функции установки и получения значений */ >Subsquare findSquare(int[][] matrix) < SquareCell[][] processed = processSquare(matrix); for (int i = matrix.length; i >= 1; i--) < Subsquare square = findSquareWithSize(processed, i); if (square != null) return square; >return null; > Subsquare findSquareWithSize(SquareCell[][] processed, int squareSize) < /* эквивалентна первому алгоритму */ >boolean isSquare(SquareCell[][] matrix, int row, int col, int size) < SquareCell topLeft = matrix[row][col]; SquareCell topRight = matrix[row][col + size - 1]; SquareCell bottomRight = matrix[row + size - l][col]; if (topLeft.zerosRight < size) < // Проверяем верхнюю сторону return false; >if (topLeft.zerosBelow < size) < // Проверяем левую сторону return false; >if (topRight.zerosBelow < size) < // Проверяем правую сторону return false; >if (bottomRight.zerosRight < size) < // Проверяем нижнюю сторону return false; >return true; > SquareCellf][] processSquare(int[][] matrix) < SquareCell[][] processed = new SquareCell[matrix.length][matrix.length]; for (int г = matrix.length - 1; г >= 0; r--) < for (int c = matrix.length - 1; c >= 0; c--) < int rightZeros = 0; int belowZeros = 0; // нужно обработать, только если ячейка черная if (matrix[r][с] == 0) < rightZeros++; belowZeros++; // следующая колонка в этом ряду if (с + 1 < matrix.length) < SquareCell previous = processed[r][с + 1]; rightZeros += previous.zerosRight; >if (r + 1 < matrix.length) < SquareCell previous = processed[r + 1][c]; belowZeros += previous.zerosBelow; >> processed[r][c] = new SquareCell(rightZeros, belowZeros); > > return processed; >
70. Предположим, в некоторый бар ходят только необщительные посетители. Вдоль барной стойки расположены 25 мест. Всякий раз, когда входит новый посетитель, он обязательно садится на самое дальнее, насколько это возможно, место от остальных гостей. Ни один не сядет рядом с кем-то другим: если посетитель входит и видит, что «свободных» мест нет, он тут же разворачивается и уходит из бара. Бармену, естественно, хочется, чтобы за стойкой сидело как можно больше клиентов. Если ему разрешено усадить первого посетителя на любое место, куда выгоднее его посадить с точки зрения бармена?
В этот бар ходят необщительные посетители. Вдоль барной стойки расположены 25 мест. Всякий раз, когда входит новый посетитель, он обязательно садится на самое дальнее, насколько это возможно, место от остальных гостей. Ни один не сядет рядом с кем-то другим: если посетитель входит и видит, что «свободных» мест нет, он тут же разворачивается и уходит из бара. Бармену, естественно, хочется, чтобы за стойкой сидело как можно больше клиентов. Если ему разрешено усадить первого посетителя на любое место, куда выгоднее его посадить с точки зрения бармена?
Самый плотный из возможных вариантов — чередование клиентов и пустых мест, при котором оба крайних места заняты. Это позволило бы остальным посетителям сесть на все места с нечетными номерами, в том числе и крайние под номерами 1 и 25, и оставить все четные номера пустыми. В этом случае у стойки могло бы разместиться 13 клиентов.
Однако такое размещение не всегда работает. Предположим, первый клиент уселся на место № 1. Следующий «отшельник» выбирает место под номером № 25, поскольку оно располагается на самом далеком из всех возможных расстояний от № 1 Третьему клиенту придется сесть в середину барной стойки, на место № 13. Два следующих посетителя заполнят пустоты и усядутся соответственно на места № 7 и № 19. Пока все хорошо.
В конце концов, кто–то захочет сесть между клиентами, занимающими места № 1 и № 7. Он выберет № 4, поскольку это позволит ему иметь два пустых сиденья между собой и ближайшими соседями. Но ни один из следующих гостей не сядет рядом с ним. Остальная часть барной стойки заполнится точно так же, и поэтому между двумя посетителями будут пустоты в два места, что делает эту схему минимально эффективной из возможных (при ней у стойки окажутся лишь девять клиентов вместо оптимального числа — 13).
Многие задачи, в том числе и эту, лучше всего решать, двигаясь от конца к началу. Мы знаем, каким должен быть желательный для нас план рассадки, и надо определить, как на него выйти.
Как показано на диаграмме, для этой схемы характерна большая симметрия, напоминающая рост кристалла. Небольшие части барной стойки заполняются как раз таким образом. Обратите внимание на ту часть стойки, в которой идут первые номера. Нужно, чтобы посетители заняли места № 1 и № 5, так как это позволит другому клиенту усесться на № 3.
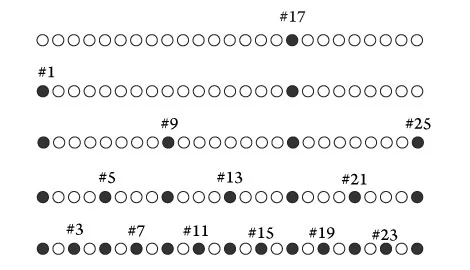
Как вам добиться, чтобы пришедший в бар человек сел на место № 5? Ответ: надо, чтобы клиенты уже сидели на местах № 1 и № 9. Тогда пятое место будет посредине между ними, поскольку оно занимает максимальное расстояние и от № 1, и от № 9.
Как добиться, чтобы человек сел на № 9? Для этого предыдущие клиенты должны занять № 1 и № 17. А как сделать так, чтобы посетитель отправился на № 17? Скажем так, барная стойка недостаточно длинная, чтобы посадить клиентов на места № 1 и № 33. Поэтому бармену придется поступить просто — попросить первого посетителя сесть за № 17. Вот ответ.
Давайте отмотаем пленку назад. Первый клиент усаживается на № 17 (верхняя строка в диаграмме). Второй посетитель усаживается от него как можно дальше, на место № 1.
У третьего посетителя два варианта выбора: место № 9 пли № 25. Оба находятся на расстоянии семи пустых мест от любого другого клиента. Если исходить из замкнутого характера посетителей этого бара, третий клиент выберет скорее всего место № 25, поскольку в этом случае у него на расстоянии будет всего один сосед, а не двое, между которыми ему придется сидеть, и поэтому № 9 остается для четвертого клиента.
Следующие три посетителя выберут места между первыми четырьмя и займут соответственно места № 5, № 13 и № 21. На каждом из этих мест до ближайшего соседа их будет разделять три пустых сиденья.
И наконец, следующие шесть посетителей займут шесть оставшихся мест, у которых нет ближайших соседей, а именно: № 3, № 7, № 11, № 15, № 19 и № 23.
Бармен с таким же успехом мог бы попросить первого посетителя сесть на место № 9, и в этом случае диаграмма стала бы зеркальным отображением той, которая представлена выше.
71. Опишите, как можно использовать один одномерный массив для реализации трех стеков.
Подобно многим задачам, все зависит от того, как мы собираемся поддерживать эти стеки. Если нам нужно выделить определенное пространство для каждого стека, можно так и поступить. Но в этом случае один из стеков может исчерпать ресурсы, а другие будут практически пустыми.
Можно, конечно, использовать более гибкую систему разделения пространства, но это значительно усложняет задачу.
Подход 1. Фиксированное разделение
Можно разделить массив на три равные части и разрешить стекам развитие в пределах ограниченного пространства. Обратите внимание, что далее мы будем описывать границы диапазонов с помощью скобок: квадратные скобки [] означают, что граничные значения входят в диапазон, а круглые скобки — значения не входят.
Код для этого решения приведен ниже:
int stackSize = 100; int[] buffer = new int [stackSize * 3]; int[] stackPointer = ; //указатели для отслеживания верхних элементов void push(int stackNum, int value) throws Exception < /* Проверяем, есть ли пространство */ if (stackPointer[stackNum] >= stackSize) < throw new Exception("Недостаточно пространства."); >/* аходим индекс верхнего элемента массива + 1, * и увеличиваем указатель стека */ int index = stackNum * stackSize + stakPointer[stackNum] + 1; stackPointer[stackNum]++; buffer[index] = valuse; > int pop(int stackNum) throws Exception < if (stackPointer[stackNum] == 0) < throw new Exception("Попытка использовать пустой стек"); >int index = stackNum * stackSize + stackPointer[stackNum]; stackPointer[stackNum]--; int value = buffer[index]; buffer[index] = 0; return value; > int peek(int stackNum) < int index = stackNum * stackSize + stackPointer[stackNum]; return buffer[index]; >boolean isEmpty(int stackNum)
Если у нас есть дополнительная информация о назначении стеков, можно модифицировать алгоритм. Например, если предполагается, что в стеке 1 будет больше элементов, чем в стеке 2, можно перераспределить пространство в пользу стека 1.
Подход 2. Гибкое разделение
Второй подход — гибкое выделение пространства для блоков стека. Когда один из стеков перестает помещаться в исходном пространстве, мы увеличиваем объем необходимого ресурса и при необходимости сдвигаем элементы.
Кроме того, можно создать массив таким образом, чтобы последний стек начинался в конце массива и заканчивался в начале, — «закольцевать» массив.
Впрочем, на собеседовании вас не заставят писать столь сложный код, поэтому мы ограничимся упрощенной версией (псевдокодом).
/* StackData - простой класс, который хранит набор данных о каждом стеке * Коласс не содержит элементы стека! */ public class stackData < public int start; public int pointer; public int size = 0; public int capacity; public stackData(int _start, int _capacity)< start = _start; pointer = _start -1; capacity = _capacity; >public boolean isWithinStack(int index, int total_size) < if(start + capacity else < return false; >> else < // стек отсекается вокруг начала массива int shifted_index = index + total_size; if (start else < return false; >> > > public class Question B < static int number_of_stack = 3; static int default_size = 4; static int total_size = default_size * number_of_stack; static StackData [] stacks = ; static int [] buffer = new int [total_size]; public static void main(String [] args) throw Exception < push(0,10); push(1,20); push(2,30); int v = pop(0); . >public static int nextElement(int index) < if (index + 1 == total_size) return 0; else return index + 1; >public static int previousElement(int index) < if (index ==0) return total_size - 1; else return index - 1; >public static void shift(int stackNum) < StackData stack = stacks[stackNum]; if (stack.size >= stack.capacity) < int nextStack = (stackNum + 1) % number_of_stacks; shift(nextStack); // выполняем сдвиг stack.capacity++; >//Сдвигаем элементы в обратном порядке for (int i = (stack.start + stack.capacity -1) % total_size; stack.isWithinStack(i, total_size); i=previousElement(i)) < buffer[i] = buffer[previousElement(i)]; >buffer[stack.start] = 0; stack.start = nextElement(stack.start); //перемещаем начало стека stack.pointer = nextElement(stack.pointer); // перемещаем указатель stack.capacity--; // устанавливаем оригинальный размер > /* Расширяем стек, сдвигаем остальные стеки */ public static void expand(int stackNum) < shift((stackNum + 1) % number_of_stacks); stacks[stackNum].capacity++; >public static void push(int stackNum, int value) throws Exception < StackData stack = stacks[stackNum]; /* Проверим, есть ли размер */ if (stack.size >= stack.capacity) < if (numberOfElements() >= total_size) < // Totally full throw new Exception("Ндостаточно пространства."); >else < // Нужно выполнить сдвиг expand(stackNum); >> /* Находим индекс верхнего элемента в массиве +1, * и увеличиваем указатель стека */ stack.size++; stack.pointer = nextElement(stack.pointer); buffer[stack.pointer] = value; > public static int pop(int stackNum) throws Exception < StackData stack = stacks[stackNum]; if (stack.size == 0) < throw new Exception("Попытка использовать пустой стек"); >int value = buffer[stack.pointer]; buffer[stack.pointer] = 0; stack.pointer = previousElement(stack.pointer); stack.size--; return value; > public static int peek(int stackNum) < StackData stack = stacks[stackNum]; return buffer[stack.pointer]; >public static boolean isEmpty(int stackNum) < StackData stack = stacks[stackNum]; return stack.size == 0; >>
В подобных задачах важно сосредоточиться на написании чистого и удобного в сопровождении кода. Вы должны использовать дополнительные классы, как мы сделали со StackData, а блоки кода нужно выделить в отдельные методы. Этот совет пригодится не только для прохождения собеседования, его можно использовать и в реальных задачах.
72. У вас есть неограниченное количество монет достоинством 25, 10, 5 и 1 цент. Напишите код, определяющий количество способов представления n центов.
Это рекурсивная задача, поэтому давайте разберемся, как рассчитать makeChange(n), основываясь на предыдущих решениях (подзадачах). Пусть n = 100. Мы хотим вычислить количество способов представления 100 центов.
Нам известно, что для получения 100 центов мы можем использовать монеты 0, 1, 2, 3 или 4 четвертака (25 центов):
makeChange(100)= makeChange(100, используя 0 четвертаков) + makeChange(100, используя 1 четвертак) + makeChange(100, используя 2 четвертака) + makeChange(100, используя 3 четвертака) + makeChange(100, используя 4 четвертака)
Двигаемся дальше: попробуем упростить некоторые из этих задач. Например, makeChange(100, используя 1 четвертак) = makeChange(75, используя 0 четвертаков). Это так, потому что если мы должны использовать один четвертак для представления 100 центов, оставшиеся варианты соответствуют различным представлениям 75 центов.
Мы можем применить эту же логику для makeChange(100, используя 2 четвертака), makeChange(100, используя 3 четвертака) и makeChange (100, используя 4 четвертака).
Приведенное ранее выражение можно свести к следующему:
makeChange(100)= makeChange(100, используя 0 четвертаков) + makeChange(75, используя 0 четвертаков) + makeChange(50, используя 0 четвертаков) + makeChange(25, используя 0 четвертаков) + 1
Заметьте, что последнее выражение — makeChange(100, используя 4 четвертака) — равно 1.
Что делать дальше? Теперь мы израсходовали все четвертаки и можем использовать следующую самую крупную монету — 10 центов.
Подход, использованный для четвертаков, подойдет и для 10–центовых монет. Мы применим его для четырех частей приведенного выше выражения. Так, для первой части:
makeChange(100, используя 0 четвертаков) = makeChange(100, используя 0 четвертаков, 0 монет в 10 центов) + makeChange(100, используя 0 четвертаков, 1 монету в 10 центов) + makeChange(100, используя 0 четвертаков, 2 монеты в 10 центов) + … makeChange(100, используя 0 четвертаков, 10 монет в 10 центов) makeChange(75, используя 0 четвертаков) = makeChange(75, используя 0 четвертаков, 0 монет в 10 центов) + makeChange(75, используя 0 четвертаков, 1 монету в 10 центов) + makeChange(75, используя 0 четвертаков, 2 монеты в 10 центов) + … makeChange(75, используя 0 четвертаков, 7 монет в 10 центов) makeChange(50, используя 0 четвертаков) = makeChange(50, используя 0 четвертаков, 0 монет в 10 центов) + makeChange(50, используя 0 четвертаков, 1 монету в 10 центов) + makeChange(50, используя 0 четвертаков, 2 монеты в 10 центов) + … makeChange(50, используя 0 четвертаков, 5 монет в 10 центов) makeChange(25, используя 0 четвертаков) = makeChange(25, используя 0 четвертаков, 0 монет в 10 центов) + makeChange(25, используя 0 четвертаков, 1 монету в 10 центов) + makeChange(25, используя 0 четвертаков, 2 монеты в 10 центов)
После этого можно перейти к монеткам в 5 и 1 цент. В результате мы получим древовидную рекурсивную структуру, где каждый вызов расширяется до четырех или больше вызовов.
Базовый случай для нашей рекурсии — полностью сведенное (упрощенное) выражение. Например, makeChange(50, используя 0 четвертаков, 5 монет в 10 центов) полностью сводится к 1, так как 5 монет по 10 центов дает ровно 50 центов.
Рекурсивный алгоритм будет иметь примерно такой вид:
public int makeChange(int n, int denom) < int next_denom = 0; switch (denom) < case 25: next_denom =10; break; case 10: next_denom =5; break; case 5: next_denom =1; break; case 1: return 1; >int ways = 0; for (int I = 0; I * denom return ways; > System.out.writeln(makeChange(100, 25));
Хотя мы реализовали код, опираясь на монеты, используемые в США, его можно легко адаптировать для любой другой валюты.
73. Напишите код, который позволяет найти минимальное расстояние (выражаемое количеством слов) между любыми двумя словами в файле. Порядок не важен.
Достаточно ли будет линейного времени?
Сколько памяти понадобится для решения?
Давайте считать, что порядок появления слов word1 и word2 не важен. Этот вопрос нужно согласовать с интервьюером. Если порядок слов имеет значение, нужно будет модифицировать приведенный далее код.
Чтобы решить эту задачу, достаточно будет прочитать файл только один раз. При этом мы сохраним информацию о том, где находились последние word1 или word2 в lastPosWord1 и lastPosWord2 и при необходимости обновляем значение min, а затем обновляем lastPosWord1. Аналогичным образом мы действуем и с word2. По окончании работы алгоритма в нашем распоряжении окажется правильное значение min (минимальное расстояние).
Приведенный далее код иллюстрирует этот алгоритм:
public int shortest(String[] words, String word1, String word2) < int min = Integer.MAX_VALUE; int lastPosWord1 = -1; int lastPosWord2 = -1; for (int i = 0; i < words.lenght; i++) < String currentWord = words[i]; if (currentWord.equals(word1)) < lastPosWord1 = i; // Закомментируйте 3 следующие строки, если порядок слов // имеет значение int distance = lastPosWord1 - lastPosWord2; if (lastPosWord2 >= 0 && min > distance) < min = distance; >> else if (currentWord.equals(word2)) < lastPosWord2 = i; int distance = lastPosWord2 - lastPosWord1; if (lastPosWord >= 0 && min > distance) < min = distance; >> > return min; >
Если нам придется выполнять ту же работу для других пар слов, можно создать хэш–таблицу, связывающую слова с позицией в файле. Тогда решением будет минимальная (арифметическая) разница между значением из списков listA и listB.
Существует несколько способов вычислить минимальную разницу между значениями из listA и listB. Давайте рассмотрим списки:
listA: listB:
Можно объединить списки в один отсортированный список, но связать каждое значение с исходным списком. Эта операция выполняется «обертыванием» каждого значения в класс, у которого будет две переменные экземпляра: data (для хранения фактического значения) и listNumber.
list:
Расчет минимального расстояния превращается в поиск минимального расстояния между двумя последовательными числами, у которых разные теги списка. В этом случае решением будет 1 (расстояние между 9a и 10b).
74. Смоделируйте использование игральной кости с семью гранями, если в вашем распоряжении имеется только кость с пятью гранями.
Иными словами, как получить случайное число в диапазоне от 1 до 7, используя генератор случайных целых чисел от 1 до 5?
Как вы можете получить случайное число в диапазоне от 1 до 7, используя игральную кость с пятью гранями?
Иначе говоря, в вашем распоряжении устройство, которое генерирует случайное целое число от 1 до 5. Но вам необходимо воспользоваться им для генерирования случайных чисел в диапазоне от 1 до 7. Представьте, что семь человек с лотерейными билетами под номерами от 1 до 7 страстно ждут розыгрыш. Как вы используете кость с пятью сторонами, чтобы выбрать победителя, заведомо зная, что проигравшие будут недовольны и что вам, возможно, придется в суде доказывать, что процедура определения победителя была совершенно случайной.
Есть несколько простых идей, но, увы, они могут показаться несправедливыми. Одна из них — бросить кость дважды и сложить выпавшие числа. Это даст результат в диапазоне от 2 до 10. Кажется, все справедливо? Нет. Любой знает, что не все суммы двух бросков в равной степени вероятны. Сумма в середине распределения (7) более вероятна. То же самое верно и в отношении кости с пятью сторонами.
Другая идея — бросить кость дважды и умножить полученные значения или каким–то другим способом получить на их основе большее число. Затем разделить его на 7 и взять только остаток. Остаток будет в диапазоне от 0 до 6. 0 нам не нужен, и поэтому будем считать его за 7. Такой вариант обеспечит нам получение «случайного» числа в диапазоне от 1 до 7.
Я поставил слово «случайный» в кавычки, потому что математик Джон фон Нейман писал, что любой, кто рассматривает арифметические методы получения случайных чисел, попадает, конечно, в «страну греха». Хотя такой подход для некоторых целей может быть вполне приемлем, результат на самом деле не является в полной мере случайным, и поэтому в Google или Amazon такой ответ высоко не ценится. А вот в Интернете числа должны быть действительно случайными, так как в противном случае хакеры воспользовались бы этим преимуществом. В казино, например.
Для получения действительно случайного исхода пусть каждый из семи игроков бросает кость с пятью сторонами один раз. Игрок, показавший более крупное число, выигрывает. Если высшее значение показали несколько игроков, они бросают кость снова (столько раз, сколько необходимо). Единственный минус в таком подходе — возможно, придется много раз подбрасывать кость. Даже если равенства (ничьих) не будет, потребуется семь бросков.
Есть более совершенный ответ. Подумайте более внимательно о цифрах. Числа с 1 по 7 можно представить в виде трех битов, то есть бинарных чисел от 001 до 111. Можете ли вы сгенерировать три случайных бита, используя кость с пятью сторонами?
Разумеется, каждый бросок даст вам одну цифру трехбитного числа. Если выпадет 2 или 4, назовите результат ноликом, если 1 или 3 — единица, если 5 — бросайте снова. Продолжайте бросать столько, сколько необходимо, если выпадет пятерка.
Повторение этой процедуры три раза генерирует число в диапазоне от 000 до 111. Переведите снова в десятичное исчисление, и тогда человек, у которого выпало большее число, выигрывает (например, 101 означает, что выиграл лотерейный билет № 5). Если выпал 000, проведите броски снова.
Это потребует всего три броска кости, если не будет повторений. В среднем при таком подходе требуется чуть больше четырех бросков.
75. Напишите код, разбивающий связный список вокруг некоторого значения так, чтобы все меньшие узлы оказались перед узлами, большими или равными этому значению.
Если бы мы работали с массивом, то было бы много сложностей, связанных со смещением элементов.
Со связным списком задача намного проще. Вместо того чтобы смещать и менять местами элементы, мы можем создать два разных связных списка: один для элементов, меньших х, а второй — для элементов, которые больше или равны х.
Мы проходим по списку, расставляя элементы по спискам before и after. Как только конец исходного связного списка будет достигнут, можно выполнить слияние получившихся списков.
>Приведенный код реализует данный подход:
/* Передаем начало списка, который нужно разделить, и значение х, вокруг которого * список будет разделен */ public LinkedListNode partition(LinkedListNode node, int x) < LinkedListNode beforeStart = null; LinkedListNode beforeEnd = null; LinkedListNode afterStart = null; LinkedListNode afterEnd = null; /* Разбиваем список */ while (node != null) < LinkedListNode next = node.next; node.next = null; if (node.data < x) < /* Вставляем узел в конец списка before*/ if (beforeStart == null) < beforeStart = node; beforeEnd = beforeStart; >else < beforeEnd.next = node; beforeEnd = node; >> else < /* Вставляем узел в конец списка after */ if (afterStart == null) < afterStart = node; afterEnd = afterStart; >else < afterEnd.next = node; afterEnd = node; >> node = next; > if (beforeStart == null) < return afterStart; >/* Слияние списков before и after */ beforeEnd.next = afterStart; return return beforeStart; >
Если вы не хотите использовать четыре переменные, чтобы отслеживать всего два связных списка, можно избавиться от части из них за счет небольшой потери эффективности. Но «ущерб» будет не очень велик, оценка алгоритма по времени останется такой же, зато код станет более коротким и красивым.
Альтернативное решение: вместо вставки узлов в конец списков before и after можно вставлять элементы в начало списка.
public LinkedListNode partition(LinkedListNode node, int x) < LinkedListNode beforeStart = null; LinkedListNode afterStart = null; / Разбиваем список */ while (node != null) < LinkedListNode next = node.next; if (node.data < x) < /* Вставляем узел в начало списка before */ node.next = beforeStart; beforeStart = node; >else < /* Вставляем узел в начало списка after */ node.next = afterStart; afterStart = node; >node = next; > /* Выполняем слияние списков */ if (beforeStart == null) < return afterStart; >/* Находим конец списка before и соединяем списки*/ LinkedListNode head = beforeStart; while (beforeStart.next != null) < beforeStart = beforeStart.next; >beforeStart.next = afterStart; return head; return head; >
Обратите внимание на нулевые значения. В строке 7 добавлена дополнительная проверка. Необходимо сохранить следующий узел во временной переменной так, чтобы запомнить, какой узел будет следующим.
76. Напишите метод, генерирующий случайную последовательность m целых чисел из массива размером n. Все элементы выбираются с одинаковой вероятностью.
Первое, что приходит в голову, — выбрать случайные элементы из массива и поместить их в новый массив. Но что если мы выберем один и тот же элемент дважды?
Первое, что приходит в голову, — выбрать случайные элементы из массива и поместить их в новый массив. Но что если мы выберем один и тот же элемент дважды? В идеале, нам нужно сократить массив так, чтобы выкинуть выбранный элемент. Но уменьшение массива достаточно трудоемкая операция, поскольку требует смещения элементов.
Вместо того чтобы сокращать (сдвигать) массив, можно поставить элемент (поменять элементы местами) в начало массива и «запомнить», что теперь массив начинается с элемента j. Если элемент subset[0] становится элементом array[k], то мы должны заменить элемент array[k] первым элементом в массиве. Когда мы переходим к элементу subset[1], то подразумеваем, что элемент array[0] «мертв», и выбираем случайный элемент из интервала от 1 до array.size(). Теперь subset[1] = array[y] и array[y] = subset[1]. Элементы 0 и 1 «мертвы», а subset[2] выбирается в диапазоне от array[2] до array[array.size()] и т.д.
/* Случайное число между lower и higher включительно */ public static int rand(int lower, int higher) < return lower + (int)(Math.random() * (higher - lower + 1)); >/* Выбрать M элементов из исходного массива. Клонируемый исходный * массив так, чтобы не уничтожить ввод */ public static int[] pickMRandomly(int[] original, int m) < int[] subset = new int[m]; int[] array = original.clone(); for(int j = 0; j < m; j++) < int index = rand(j, array.length - 1); subset[j] = array[index]; array[index] = array[j]; //array[j] теперь "мертв" >return subset; >
77. Представьте себе робота, находящегося в левом верхнем углу сетки с координатами (X, Y). Робот может перемещаться в двух направлениях: вправо и вниз. Сколько существует маршрутов, проходящих от точки (0, 0) до точки (X, Y)?
Дополнительно предположите, что на сетке существуют области, которые робот не может пересекать. Разработайте алгоритм построения маршрута от левого верхнего до правого нижнего угла.
Нам нужно подсчитать количество вариантов прохождения дистанции с Х шагов вправо и Y шагов вниз (X + Y шагов).
Чтобы создать путь, мы делаем Х шагов вправо так, чтобы общее количество перемещений оставалось фиксированным (X + Y). Таким образом, количество путей должно совпадать с количеством способов выбрать Х элементов из X + Y, то есть биномиальным коэффициентом. Биномиальный коэффициент из n по r имеет вид:
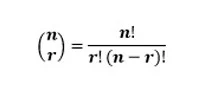
Для нашей задачи выражение будет следующим:
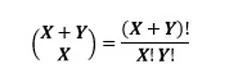
Даже если вы незнакомы с комбинаторикой, то все равно можете найти решение этой задачи самостоятельно.
Представим путь как строку длиной X + Y, состоящую из X символов R и Y символов D. Мы знаем, что из X + Y неповторяющихся символов мы можем составить (X + Y)! строк. Но в нашем случае используется X символов R и Y символов D. Символы R могут быть расставлены X! способами (то же самое мы можем сделать и с символами D). Таким образом, необходимо убрать лишние строки X! и Y!. В итоге мы получим то же самое выражение:
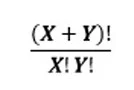
Дополнительно
Найдите маршрут (на карте есть места, через которые не может пройти робот).
Если мы изобразим нашу карту, то единственный способ попасть в квадрат (X, Y) — оказаться в одном из смежных квадратов: (X-1, Y) или (X, Y-1). Следовательно, необходимо найти путь к любому из этих квадратов ((X-1, Y) или (X, Y-1)).
Как это осуществить? Чтобы найти путь в квадрат (X-1, Y) или (X, Y-1), мы должны оказаться в одной из смежных ячеек. То есть нам необходимо найти путь к квадрату, смежному с (X-1, Y) ((X-2, Y) и (X-1, Y-1)) или (X, Y-1) ((X-1, Y-1) и (X, Y-2)). Обратите внимание: в наших рассуждениях точка (X-1, Y-1) упоминается дважды, мы еще вернемся к этому факту.
Давайте попробуем найти путь от исходного квадрата, двигаясь в обратном направлении, — начинаем с последней ячейки и пытаемся найти путь к каждому смежному квадрату. Далее приведен рекурсивный код, реализующий наш алгоритм.
public boolean getPath(int x, int y, ArrayList path) < Point p = new Point(x, y); path.add(p); if (x == 0 && y == 0) < return true; // найти путь >bolean success = false; if (x >= 1 && isFree(x – 1, y)) < // Пытаемся идти вправо success = getpath(x – 1, y, path); // Свободно! Можно идти вправо >if ( !success && y >= 1 && isFree(x, y - 1)) < // Пытаемся идти вниз success = getPath(x, y – 1, path); // Свободно! Можно идти вниз >if (!success) < path.remove(p); // Неверный путь! Прекратить движение этим маршрутом >return success; >
Помните, что маршруты дублируются? Чтобы найти все пути к (X, Y), мы находим все пути к (X-1, Y) и (X, Y-1). Затем мы смотрим на координаты смежных квадратов: (X-2, Y), (X-1, Y-1), (X-1, Y-1) и (X, Y-2). Квадрат (X-1, Y-1) появляется дважды. Давайте будем запоминать посещенные квадраты, чтобы не тратить на них время.
Это можно сделать с помощью следующего алгоритма динамического программирования:
public Boolean getPath(int x, int y, ArrayList path, Hashtable cache) < Point p = new Point(x, y); if (cache.containsKey(p)) < // Мы уже посещали эту ячейку return cache.get(p); >path.add(p); if (x == 0 && y == 0) < return true; // Найден путь >boolean success = false; if (x >= 1 && isFree(X - 1, Y)) < //Пытаемся идти вправо success = getPath(x - 1, y, path, cache); // Свободно! Можно идти вправо >if (!success && y >= 1 && isFree(x, y - 1)) < // Пытаемся идти вниз success = getPath(x, y - 1, path, cache); // Свободно! Можно идти вниз >if (!success) < path.remove(p); //Неверный путь! Прекратить движение этим маршрутом >cache.put(p, success); // Вычисляем результат return success; >
Это простое изменение сделает наш код более быстрым.
78. Реализуйте метод сжатия строки на основе счетчика повторяющихся символов. Например, строка aabcccccaaa должна превратиться в а2b1с5аЗ. Если «сжатая» строка оказывается длиннее исходной, метод должен вернуть исходную строку.
Например, строка aabcccccaaa должна превратиться в а2b1с5аЗ. Если «сжатая» строка оказывается длиннее исходной, метод должен вернуть исходную строку.
public String compressBad(String str) < String mystr = ""; char last = str.charAt(0); int count = 1; for (int i = 1; i < str.length(); i++) < if (str.charAt(i) == last) < // Находим повторяющийся символ count++; >else < // Вставляем счетчик символа и обновляем последний символ mystr += last + count; last = str.charAt(i); count = 1; >> return mystr + last + count; >
Этот код не отслеживает случай, когда сжатая строка получается длиннее исходной. Но эффективен ли этот алгоритм?
Давайте оценим время выполнения этого кода: 0(р + k?), где р — размер исходной строки, a k — количество последовательностей символов. Например, если строка aabccdeeaa содержит 6 последовательностей символов. Алгоритм работает медленно, поскольку используется конкатенация строк, требующая обычно 0(n?) времени.
Улучшить код можно, используя, например StringBuffer в Java:
String compressBetter(String str) < /* Проверяем, вдруг сжатие создаст более длинную строку */ int size = countCompression(str); if (size >= str.length()) < return str; >StringBuffer mystr = new StringBuffer(); char last = str.charAt(0); int count = 1; for (int i = 1; i < str.length(); i++) < if (str.charAt(i) == last) < // Найден повторяющийся символ count++; >else < // Вставляем счетчик символов, обновляем последний символ mystr.append(last); // Вставляем символ mystr.append(count); // Вставляем счетчик last = str.charAt(i); count = 1; >> /* В строках 15-16 символы вставляются, когда * изменяется повторяющийся символ. Мы должны обновить строку * в конце метода, так как самый последний повторяющийся символ * еще не был установлен в сжатой строке * */ mystr.append(last); mystr.append(count); return mystr.toString(); > int countCompression(String str) < char last = str.charAt(0); int size = 0; int count = 1; for (int i = 1; i < str.length(); i++) < if (str.charAt(i) == last) < count++; >else < last = str.charAt(i); size += 1 + String.valueOf(count).length(); count = 0; >> size += 1 + String.valueOf(count).length(); return size; >
Этот алгоритм намного эффективнее. Обратите внимание на проверку размера в строках 2—5.
Если мы не хотим (или не можем) использовать stringBuffer, можно решить эту задачу иначе. В строке 2 рассчитывается конечный размер строки, что позволит создать массив подходящего размера:
String compressAlternate(String str) < /* Проверяем, вдруг сжатие создаст более длинную строку */ int size = countCompression(str); if (size >= str.length()) < return str; >char[] array = new char[size]; int index = 0; char last = str.charAt(0); int count = 1; for (int i = 1; i < str.length(); i++) < if (str.charAt(i) == last) < // Найдите повторяющийся символ count++; >else < /* Обоновляем счетчик повторяющихся символов */ index = setChar(str, array, last, index, count); last = str.charAt(i); count = 1; >> /* Обновляем строку с последним набором повторяющихся символов */ index = setchar(str, array, last, index, count); return String.valueOf(array); > int setChar(String str, char[] array, char c, int index, int count) < array[index] = c; index++; /* Конвертируем счетчик в строку */ char[] cnt = String. valueOf (count) .toCharArray(); /* Копируем символы от большего разряда к меньшему */ for (char х : cnt) < array[index] = х; index++; >return index; > int countCompression(String str) < /* так же, как и раньше */ >
Подобно предыдущему решению, этот код потребует O(N) времени и 0(N) пространства.
79. Вы находитесь в автомобиле, где к полу веревочкой привязан шар, наполненный гелием. Окна закрыты. Вы нажимаете на педаль газа. Что произойдет с шаром: переместится он вперед, назад или останется в прежнем положении?
Что произойдет с шаром?
Интуиция подсказывает нам (практически всем), что при ускорении шарик будет отбрасываться назад. Однако интуиция в данном случае ошибается. Ваша задача — путем, дедуктивных размышлений определить, как на самом деле движется шарик, и объяснить это интервьюеру.
Хороший ответ — предложить аналогию с ватерпасом (строительный уровень). Хотя эта штука не всегда имеется под рукой, когда она необходима, есть люди, которые работают с ней постоянно. Особенно часто она бывает у плотников, он и пользуются уровнем, чтобы убедиться, что поверхность является горизонтальной. В ватерпасе есть узкая стеклянная трубка с цветной жидкостью, а в ней — пузырек воздуха. Всякий раз, когда уровень ставится на идеально горизонтальную поверхность, пузырек оказывается в середине трубки. Если поверхность негоризонтальная, пузырек смещается в сторону более высокой части трубки. Аналогия здесь в том, что пузырек — это всего лишь «дырка» в жидкости. Когда поверхность не является ровной, сила тяжести толкает жидкость в сторону более низкого края. Это, в свою очередь, перемещает пузырек туда, где жидкости нет, — к противоположному краю.
Отвяжите шарик с гелием и позвольте ему удариться о «лунную крышу». Теперь он станет своего рода уровнем. Шарик является «пузырьком», состоящим из гелия, газа с меньшей плотностью, который находится в более плотном воздухе, и вся эта комбинация газов находится в емкости (автомобиле). Сила тяжести толкает белее тяжелый воздух вниз, заставляя легкий шарик давить на «лунную крышу».
Когда автомобиль ускоряется, воздух, как и ваше тело, отбрасывается назад. Это заставляет более легкий, чем воздух, шарик двигаться вперед. Если резко нажать на тормоза, воздух надавит на переднее окно, но шарик при этом отбрасывается назад. То же самое наблюдается и при поворотах. Центробежная сила в этом случае толкает воздух в сторону, противоположную) оси поворота, а шарик — в ее сторону. Разумеется, то же самое происходит и тогда, когда шарик привязан к чему–то, но теперь у него появляется меньше свободы для перемещения. Короткий ответ на заданный вопрос такой: шарик с гелием смещается в направлении любого ускорения.
Вы не верите? Тогда прямо сейчас отложите книгу, сходите в супермаркет, купите шарик, наполненный гелием, и привяжите его веревочкой к рычагу переключения передач или к рычагу парковочного тормоза. Отправляйтесь домой (необязательно это делать на сумасшедшей скорости). Вы будете удивлены, но шарик действительно смещается в другом направлении, а не в том, о котором вы думали. Когда вы нажимаете на газ, шарик устремляется вперед, словно пытается соревноваться с машиной на участке до следующего светофора. Резко затормозите, так, чтобы детские игрушки упали с сидения, и шарик дернется назад. При повороте на высокой скорости, когда ваше тело сильно наклоняется в одну сторону, сумасшедший шарик резко двигается в другую. Об этой кажущейся странности есть ролики на YouTube.
Почему наша интуиция подсказывает нам правильные ответы о строительном уровне и неправильные о шарике с гелием. Если говорить о ватерпасе, тяжелая жидкость в нем окрашена флуоресцентной краской (и в этом отношении похожа по цвету на напитки для спортсменов), в то время как пузырек в ней практически бесцветный. Мы ассоциируем цвет с плотностью, а прозрачность — с пустотой. Поэтому этот инстинкт в случае с шариком оказывается совершенно неправильным. Воздух невидим, и в 99 % всего времени мы его игнорируем. Шарик же окрашен в симпатичный цвет и, кажется, кричит: «Посмотри на меня!» Мы почти все забываем, что в окружающем нас воздухе появляется частичный вакуум. Шарик с гелием двигается в направлении, которое противоположно перемещению основной массы, потому что ему не хватает веса. Реальная масса — воздух — остается невидимой.
Интервьюеры, задающие этот вопрос, не ожидают, что вы хорошо знаете физику. Имеется альтернативный вариант вопроса, который строится на теории относительности. Я говорю серьезно.
Он относится к известному мысленному эксперименту Альберта Эйнштейна, связанному с лифтом. Представьте, что вы находитесь в лифте и едете в кабинет вашего консультанта по налогам, а в этот момент злобное внеземное существо решает, что было бы забавно телепортировать вас и лифт в межгалактическое пространство. Лифт — закрытое помещение, и там достаточно воздуха, чтобы вы какое–то время оставались в живых и несколько минут развлекали это чужеземное существо. Окон нет, и поэтому вы не можете выглянуть и увидеть, где находитесь. Существо подцепило лифт к тросу и тянет его с постоянным ускорением, совершенно равным силе тяжести Земли. Можете ли вы в закрытом лифте определить, действует ли на вас фактическое ускорение Земли или «искусственная» сила тяжести, имитируемая при помощи ускорения?
Эйнштейн утверждал, что нет. Если вы вытащили бы ключи из кармана и подбросили, они полетели бы на пол лифта точно же, как на Земле. Если бы мы взяли шарик с гелием, привязанный к веревочке, он устремился бы вверх так же, как на Земле. Другими словами, вам в лифте все будет казаться совершенно нормальным.
Принцип эквивалентности Эйнштейна заключается в том, что нет простого физического эксперимента, способного показать разницу между силой тяжести и ускорением. Это допущение является основным в теории гравитации Эйнштейна, известной как общая теория относительности. Физики пытаются отыскать сбои в принципе эквивалентности уже почти столетие. Пытаются и не могут. Поэтому можно вполне безопасно предположить, что идея Эйнштейна является правильной, по крайней мере для любых экспериментов, которые вы можете проделать в машине с шариком за два доллара.
Итак, вот физический эксперимент. Привяжите веревку с одной стороны к свинцовому грузу, а с другой — к вашему указательному пальцу на правой руке. Привяжите к тому же пальцу и шарик с гелием. Обратите внимание на угол между двумя веревками.
В лифте, в припаркованном автомобиле или в реактивном самолете, терпящем аварию, результаты будут теми же самыми. Веревка с привязанным грузом будет направлена прямо вниз, веревка шарика — прямо вверх. Так что две веревки, привязанные к вашему пальцу, образуют прямую линию. И так будет всякий раз, когда вы подвергаетесь действию силы тяжести.
Теперь представьте, что произойдет, когда вы начнете движение. С увеличением скорости ваше тело будет вдавливаться в сиденье. Ошибочно подсказывающая вам интуиция может сообщить, что свинцовый груз и шарик будут оба отбрасываться немного назад по отношению к вашему пальцу и что в ходе ускорения между двумя веревочками образуется угол (если верить интуиции). Этот угол позволил бы определить разницу между силой тяжести и силой ускорения. Когда автомобиль подвергается только силе тяжести, две веревочки образуют прямую линию. Но когда на них воздействует центробежная сил или другой вид ускорения, между веревочками образуется угол, при котором в качестве его вершины выступает ваш палец. Это все, что вам необходимо, чтобы доказать, что общая теория относительности является ошибочной. Если это случится, можете смело забыть о своем желании получить работу в Google, потому что теперь ваши амбиции резко повысятся — вы захотите получить Нобелевскую премию.
Однако поскольку принцип эквивалентности строго и много раз проверялся, и всегда демонстрировалась его правота, описанный вариант не случится, и вы можете использовать принцип эквивалентности для ответа на этот вопрос. Физика проявит себя точно так же в ускоряющемся автомобиле, как и в машине, подвергающейся действию только силы тяжести. В обоих случаях шарик, ваш палец и свинцовый груз будут образовывать прямую линию. Так что шарик с гелием (из нашего вопроса) действительно движется в ту сторону, которая противоположно ожидаемому нами движению объекта, обладающего массой. Другими словами, он сместится вперед, а не назад… влево, а не вправо… и, конечно, вверх, а не вниз.
80. Задачка, на примере который можно кратко ознакомиться с основами RSA-криптографии.
Допустим, вы хотите удостовериться, что у вашего друга Пети есть номер вашего телефона. Но вы не можете спросить его об этом прямо. Вам придется написать ему сообщение на карточке и отдать карточку Кате, которая будет выступать в качестве посредника. Катя отнесет карточку Пете, он напишет свое сообщение и отдаст его Кате, которая передаст его вам. Вы не хотите, чтобы Катя узнала ваш номер телефона. Как в таких обстоятельствах следует сформулировать свой вопрос Пете?
Даже не зная ничего про RSA можно попробовать придумать ответ.
Как удостовериться, что у друга есть ваш номер телефона так, чтобы никто об этом не узнал, причём нельзя спросить его напрямую?
Поясним условия подробнее. Например, вы хотите удостовериться, что у Пети есть номер вашего телефона. Но вы не можете спросить его об этом прямо. Вам придется написать ему сообщение на карточке и отдать карточку Кате, которая будет выступать в качестве посредника. Катя отнесет карточку Пете, он напишет свое сообщение и отдаст его Кате, которая передаст его вам. Вы не хотите, чтобы Катя узнала ваш номер телефона. Как в таких обстоятельствах следует сформулировать свой вопрос Пете?
Даже если вы дадите короткий и простой ответ, вас могут попросить представить и ответ на основе RSA. Он не такой сложный, если у Пети есть компьютер, и если он сможет следовать вашим рекомендациям. Спросите интервьюера, насколько Петя продвинут в математике и компьютерах.
При использовании RSA генерируется два ключа: общественный и частный. Общественный ключ похож на адрес электронной почты. Он позволяет любому человеку отправить вам сообщение. Частный ключ — это что-то вроде вашего пароля к электронной почте. Вам он необходим, чтобы получить ваши е-мейлы, и вы должны держать его в секрете, так как в противном случае сообщение, адресованное вам, сможет прочитать любой желающий.
Вы не сможете послать Пете секретное сообщение, поскольку он не создал свои ключи. Он, может быть, даже не знает, что такое RSA, и не будет о нем ничего знать до тех пор, пока вы ему не расскажете! Но для этого вам и не нужно отправлять ему секретное сообщение. Вы хотите, чтобы Петя отправил такое сообщение вам, а именно — ваш номер телефона. Это означает, что нам нужны ключи для себя, а не для Пети. Вот общая схема решения.
«Привет, Петя! Мы собираемся воспользоваться криптографией RSA. Может быть, ты не знаешь, что это такое, но я объясню тебе, что надо сделать. Вот мой общественный ключ… Возьми его и мой номер телефона и придумай зашифрованный номер, следуя инструкциям. Пришли этот зашифрованный номер обратно мне через Катю».
Трюк в том, чтобы составить инструкцию так, чтобы ею мог воспользоваться практически каждый. К тому же вам нужно обеспечить и необходимую точность.
Криптография RSA впервые была описана, как теперь считается, в 1973 году. Её первым создателем был британский математик Клиффорд Кок, который тогда работал на секретной службе Её Величества. В те годы его схема считалась непрактичной: для нее обязательно нужен был компьютер. В те времена, когда шпионы обычно обходились фотоаппаратами, спрятанными в запонки, эту трудность было не так легко преодолеть. До 1997 года идея Кока считалась секретной. Однако в 1978 году трое ученых из MIT, Рональд Ривест, Ади Шамир и Леонард Адлеман, предложили ее независимо от Кока. Первые буквы их фамилий (RSA) стали акронимом и названием этого алгоритма.
В системе RSA человек, который хочет получать сообщения, должен выбрать два случайных простых числа p и q. Числа должны быть большими и, по крайней мере, такими же крупными (по числу цифр), как и числа или сообщения, которые надо передать. Для телефонного номера из десяти цифр р и q также должны состоять (каждое) по крайней мере из десяти цифр.
Один из способов выбора p и q — воспользоваться Google и найти веб-сайт, на котором перечисляются крупные простые числа. Скажем, Primes Pages, который ведет Крис Колдуэлл из Университета Теннесси в Мартине. Выберите случайным образом два десятизначных простых числа. Вот пример такой парочки:
1 500 450 271 и 3 367 900 313
Назовите их соответственно р и q. Вам придется перемножить их и получить точный ответ. Здесь может быть небольшая трудность, так как вы не сможете воспользоваться калькуляторами, Excel или Google, да и большинством любых других потребительских программ, поскольку они показывают ограниченное число значимых цифр. Один из вариантов — умножить вручную. Или использовать Wolfram Alpha. Введите
1 500 450 271 и 3 367 900 313
и вы получите точный ответ:
5 053 366 937 341 834 823
Назовите это произведение N. Оно является одной из составляющих вашего общественного ключа. Другим компонентом является число, называемое е, произвольно выбранное и равное по длине, в идеале N, но которое не делится точно на произведение (р - 1) (q - 1). Я, возможно, запутал вас последним предложением, но пока об этом не беспокойтесь.
Во многих прикладных программах в качестве е шифровальщики выбирают простую тройку. Этот достаточно хороший вариант для многих целей и позволяет быстро шифровать.
Вы получили N и е, у вас теперь имеется все необходимое для решения задачи. Всего лишь нужно отправить эти два числа Пете, а также полное «Руководство для чайников по криптографии RSA». Пете необходимо вычислить
где Х – это номер телефона. Поскольку в качестве e мы выбрали 3, часть слева — это х, возведенное в куб. Это будет число из 30 цифр. «Mod» указывает на деление по модулю, что означает, что вы разделите x? на N и возьмете только остаток. Этот остаток должен быть в диапазоне от 0 до N - 1. Вполне вероятно, что будет число из 20 цифр. Это число является зашифрованным посланием, которое Петя отправит обратно вам.
Для решения этой задачи Пете необходимо возвести в куб число, и произвести деление. Важная часть инструкции может быть такой.
«Петя, я хочу, чтобы ты внимательно следовал этим инструкциям и не сомневался. Исходи из того, что мой телефонный номер — это обычное число из десяти цифр. Вначале необходимо, чтобы ты возвел в куб это число (умножь вначале его на само себя, а затем полученное произведение умножь еще раз на первоначальный номер). Ответ будет числом из 30 цифр, и оно должно быть точным. Выполни это умножение, даже если придется сделать это вручную, и дважды его проверь. Затем необходимо, чтобы ты осуществил самый длинный процесс деления за всю свою жизнь. Раздели полученный результат на число 5 053 366 937 341 834 823. Важно не ошибиться! Пришли мне только остаток этого деления. Важно, чтобы ты не прислал целую часть, а только остаток».
Предположим, что у Пети есть доступ к Интернету (довольно обоснованное допущение в настоящее время, не так ли?), тогда пишем:
«Петя, отправляйся на веб-сайт и www.wolframalpha.com. Ты увидишь там длинный прямоугольник с границами, окрашенными в оранжевый цвет. Введи мой номер телефона из 10 цифр в этот прямоугольник без всяких дефисов, точек и скобок, только десять цифр. Сразу же после номера телефона напечатай следующее
^3 mod 5053366937341834823
Затем кликни на маленький знак равенства, находящийся в правой части прямоугольника. Ответом будет, вероятно, число из 20 цифр, которое появится в прямоугольнике со словом Result (Результат). Пришли мне этот ответ, и только этот ответ».
Естественно, Катя прочитает эти инструкции, а также прочитает ответ Пети. Но она не сможет ничего понять. Она получила число из 20 цифр, которое, как она знает, является остатком куба телефонного номера, разделенного на 5053366937341834823, по модулю. Пока никто не придумал эффективного способа, позволяющего восстановить по остатку исходное число, в данном случае являющееся телефонным номером.
Можете ли вы предложить что-то еще лучше? Да, поскольку у вас есть секретный декодирующий ключ. Это d, инверсивное значение е mod (р - 1) (q - 1). Для его вычисления имеется удобный алгоритм, которым можно воспользоваться, конечно, при условии, что вы знаете два простых числа p и q, которые были использованы для получения N. (Вы ведь знаете их, потому что сами их выбрали, не забыли?)
Назовите кодированное число/сообщение, которое Петя отправил вам назад. Y. Его первоначальное сообщение было
Для определения этого значения нужно всего лишь ввести это в Wolfram Alpha (замените Y, d и N фактическими числами).
Катя знает N, поскольку оно было написано на карточке, которую вы попросили её передать Пете. Она знает Y, поскольку это число было указано в ответе Пети, отправленном вам. Но она не знает d, и у нее нет возможности его выяснить. Катя сталкивается с алгоритмической трудностью. При умножении двух чисел никаких сложностей ни у кого не возникнет, ведь этому все-таки в школе всех научили. А вот определить множитель, имея огромное число, гораздо сложнее.
81. Задача на знание конкретных языков. Объясните разницу между шаблонами в C++ и дженериками в Java.
Многие программисты полагают, что шаблоны C++ и дженерики (например в Java) — это одно и то же, ведь их синтаксис похож: в обоих случаях можно написать что-то вроде List . Но различия на самом деле есть.
Многие программисты полагают, что шаблоны C++ и дженерики (например в Java) — это одно и то же, ведь их синтаксис похож: в обоих случаях можно написать что-то вроде List . Чтобы найти различия, давайте разберемся, что такое шаблоны и дженерики, и как они реализуется в каждом из языков.
Дженерики Java связаны с идеей «стирания типов» (type erasure). Эта техника устраняет параметры типов, когда исходный код преобразуется в байткод JVM.
Предположим, что у вас есть Java-код:
Vector vector = new Vector(); vector.add(new String("hello")); String str = vector.get(0);
Во время компиляции он будет преобразован:
Vector vector = new Vector(); vector.add(new String("hello")); String str = (String) vector.get(0);
Использование обобщений Java не повлияло на наши возможности, но сделало код более красивым. Поэтому дженерики в Java часто называют «синтаксическим сахаром».
Дженерики сильно отличаются от шаблонов C++. Шаблоны в C++ представляют собой набор макросов, создающих новую копию шаблонного кода для каждого типа. Особенно это заметно на следующем примере: экземпляр MyClass не сможет совместно с MyClass использовать статическую переменную. А два экземпляра MyClass будут совместно использовать статическую переменную.
Чтобы проиллюстрировать этот пример, рассмотрим следующий код:
/*** MyClass.h ***/ template class MyClass < public: static int val; MyClass(int v)< val = v; >>; /*** MyClass.cpp ***/ template int MyClass::val; template class MyClass; template class MyClass; /*** main.cpp ***/ MyClass * foo1 = new MyClass(10); MyClass * foo2 = new MyClass(15); MyClass * bar1 = new MyClass(20); MyClass * bar2 = new MyClass(35); int f1 = foo1->val; //будет равно 15 int f2 = foo2->val; //будет равно 15 int b1 = bar1->val; //будет равно 35 int b2 = bar2->val; //будет равно 35
В Java различные экземпляры MyClass могут совместно использовать статические переменные, независимо от параметров типа.
Из-за различий в архитектуре дженерики Java и шаблоны C++ имеют множество отличий:
Помните, что хотя дженерики Java и шаблоны C++ внешне похожи, это разные вещи.
82. Реализуйте вручную «умный» указатель с автоматическим управлением памятью на C++.
Умный (интеллектуальный) указатель — это тот же обычный указатель, обеспечивающий безопасность благодаря автоматическому управлению памятью. Такой указатель помогает избежать множества проблем: «висячие» указатели, «утечки» памяти и отказы в выделении памяти. Интеллектуальный указатель должен подсчитывать количество ссылок на указанный объект.
На первый взгляд эта задача кажется довольно сложной, особенно если вы не эксперт в C++.
Умный (интеллектуальный) указатель — это тот же обычный указатель, обеспечивающий безопасность благодаря автоматическому управлению памятью. Такой указатель помогает избежать множества проблем: «висячие» указатели, «утечки» памяти и отказы в выделении памяти (графические библиотеки помогают избежать таких проблем при создании UI). Интеллектуальный указатель должен подсчитывать количество ссылок на указанный объект.
На первый взгляд эта задача кажется довольно сложной, особенно если вы не эксперт в C++. Один из полезных подходов к решению — разделить задачу на две части: 1) обрисовать общий подход и создать псевдокод, а затем 2) написать подробный код.
Нам нужна переменная — счетчик ссылок, которая будет увеличиваться, как только мы добавляем новую ссылку на объект, и уменьшаться, когда мы ее удаляем. Наш псевдокод может иметь следующий вид:
template class SmartPointer < /* Класс интеллектуального указателя нуждается в указателях на собственно * себя и на счетчик ссылок. Оба они должны быть указателями, а не реальным * объектом или значением счетчика ссылок, так как цель интеллектуального * указателя - в подсчете количества ссылок через множество интеллектуальных * указателей н один объект */ T * obj; unsigned * ref_count; >
Для этого класса нам потребуется конструктор и деструктор, поэтому опишем их:
SmartPointer(T * object) < /* Мы хотим установить значение T * obj и установить счетчик * ссылок в 1. */ >SmartPointer(SmartPointer & sptr) < /* Этот конструктор создает новый интеллектуальный указатель на существующий * объект. Нам нужно сперва установить obj и ref_count * такими же, как в sptr. Затем, * поскольку мы создали новую ссылку на obj, нам нужно * увеличить ref_count. */ >~SmartPointer(SmartPointer sptr) < /* Уничтожаем ссылку на объект. Уменьшаем * ref_count. Если ref_count = 0, освобождаем память и * уничтожаем объект. */ >
Существует дополнительный способ создания ссылок — установка одного SmartPointer в другой. Нам понадобится переопределить оператор = для обработки этого случая, но сначала давайте сделаем набросок кода:
onSetEqals(SmartPointer ptr1, SmartPointer ptr2) < /* Если ptr1 имеет существующее значение, уменьшить его количество ссылок. * Затем копируем указатели obj и ref_count. Наконец, * так как мы создали новую ссылку, нам нужно увеличить * ref_count. */ >
Осталось только написать код, а это дело техники:
template class SmartPointer < public: SmartPointer(T * ptr) < ref = ptr; ref_count = (unsigned*)malloc(sizeof(unsigned)); *ref_count = 1; >SmartPointer(SmartPointer & sptr) < ref = sptr.ref; ref_count = sptr.ref_count; ++(*ref_count); >/* Перезаписываем оператор равенства (eqal), поэтому когда вы установите * один интеллектуальный указатель в другой, количество ссылок старого указателя * будет уменьшено, а нового - увеличено. */ SmartPointer & operator=(SmartPointer & sptr) < /* Если уже присвоено объекту, удаляем одну ссылку. */ if (*ref_count >0) < remove(); >if (this != &sptr) < ref = sptr.ref; ref_count = sptr.ref_count; ++(*ref_count); >return *this; > ~SmartPointer() < remove(); // удаляем одну ссылку на объект. >T operator*() < return *ref; >protected: void remove() < --(*ref_count); if (ref_count == 0) < delete ref; free(ref_count); ref = NULL; ref_count = NULL; >> T * ref; unsigned * ref_count; >
83. Эта головоломка, в которой вас пытаются запутать, предложив поменять свое решение, известна также под именем «Парадокс Монти Холла». Монти Холл был первым ведущим телевизионной игры-шоу «Давайте заключим сделку».
Перед вами три коробки, в одной из которых находится ценный приз, в двух других ничего нет. Вы можете выбрать любую коробку, но вам по-прежнему неизвестно, в какой именно приз. Одну из двух не выбранных вами коробок открывают и показывают, что она пустая. Теперь вы можете или оставить коробку, которую вы первоначально выбрали (оставить), или поменять ее на другую, неоткрытую (заменить). Что вы предпочтете сделать (оставить или заменить)?
Этот вопрос является разновидностью парадокса Монти Холла и был сформулирован в 1975 году статистиком географических данных Стивом Селвином. Монти Холл был первым ведущим телевизионной игры-шоу «Давайте заключим сделку». Загадка Селвина относится к ситуации, немного напоминающей финальный раунд в этом телевизионном шоу, при котором участники выбирают призы, находящиеся за дверями. В письме в American Statistician Селвин утверждал, что вам следует согласиться на обмен. Этот вариант показался многим настолько противоречивым, что в следующем письме Селвину пришлось его защищать. Монти Холл написал Селвину и согласился с его анализом.
С тех пор этот парадокс стал темой огромного числа обсуждений. После упоминания о нем в 1990 году Мэрилин вос Савант в своей колонке, которую она ведет в журнале Parade, он стал популярным и у широкой общественности. На следующий год Джон Тьерни из New York Times рассказал, что эту загадку «обсуждают и в залах Центрального разведывательного управления, и в казармах пилотов самолетов-истребителей, участвующих в войне в Персидском заливе. Ее анализировали математики из Массачусетского технологического института, и программисты из Los Alamos National Laboratory…». Выяснилось, что эта задача используется и в передаче Car Talk, которая ведется на NRP а также в телевизионном шоу NUMB3RS. К ней прибегают на собеседованиях в Bank of America и в других финансовых фирмах. Циники могут отыскать параллель с управлением рисками в финансовой отрасли, когда вероятности тайно меняются и вам пытаются подсунуть «пустой ящик».
Самое интересное в загадке Селвина — ее трудность.
В ходе одного исследования было установлено, что только 12% людей, которым задавали этот вопрос, давали правильные ответы. Этот результат удивителен, если учесть, что любой человек, не имеющий никаких подсказок, при простой догадке может оказаться правым в 50 случаях из 100. Другими словами, это случай, когда интуиция ведет вас в неправильном направлении.
Большинство отвечающих полагают, что нет никакой разницы, оставите ли вы первую коробку или ее поменяете. Более продвинутые могут добавить, что любой, кто думает, что может повысить свои ожидания при помощи обмена, заблуждается, то есть ведет себя так же, как игроки-неудачники, настаивающие, что игровой автомат «подкручен» и поэтому в нем никогда нельзя выиграть джек-пот.
При любом вопросе, связанном с вероятностями, важно знать, что происходит случайно, а что преднамеренно. Скажем, ваш друг подбрасывает монету 10 раз, и каждый раз она падает орлом вверх. Каков шанс, что при следующем броске снова выпадет орел? Вы не можете это точно сказать до тех пор, пока не выясните, была ли предыдущая серия простым результатом удачи или следствием того, что у этой монеты имеются какие-то особенности.
Когда Селвин предложил эту загадку, первоначальный вариант шоу «Давайте заключим сделку» все еще выходил в эфир и уже стал неотъемлемой частью поп-культуры. Моя бабушка, которая смотрела это шоу, считала Монти мошенником, хотя и знаменитым. Вот как она это обосновывала, громко обращаясь к телевизору: «Если он хочет предложить вам эту дверь, он, должно быть, знает, что за ней находится что-то менее ценное, чем то, что уже есть у участника».
Надо сказать, что она не сильно ошибалась. В одном интервью Холл заявил, что, когда он знал, что участник выбрал самый крупный приз, он предлагал деньги человеку взамен того, что находится за выбранной им дверью. Это добавляло передаче зрелищности. Когда человек менял крупный приз на мелочевку, он превращался в неудачника, а это вызывает у аудитории гораздо больше эмоций.
Давайте дадим коробкам названия. Пусть они будут такими: выбранная, открываемая и искушающая. Первоначально шансы на то, что вы выберете коробку с призом, равны один к трем.
После вашего выбора открывается одна из двух оставшихся коробок, и оказывается, что она пустая. Чтобы определить, как это повлияло на ваши шансы получить крупный приз, вам необходимо знать, кто открывает вторую коробку и какова его цель.
Имеется два вероятных варианта.
Исходная задачка Селвина не оставляет сомнений, что второй вариант желателен для ТВ. («Несомненно, Монти Холл знает, какая коробка является ценной, и поэтому не открывает коробку, где лежат ключи от автомобиля.»)
Это важное уточнение часто упускается из виду. Как уже говорилось выше, эта задачка, задаваемая на собеседовании, является противоречивой. В ней не упоминается о ведущем, который может прибегать к махинациям, и не рассказывается, как выбирается открываемая коробка. Вам следует попросить интервьюера уточнить эти детали и указать, что вопрос позволяет дать разные ответы в зависимости от того, окак выбирается вторая коробка.
Открыв коробку при первом варианте, вы получаете определенную информацию: в этой коробке приза нет, хотя он мог там быть. Это резко повышает ваши шансы на то, что в выбранной вами коробке есть приз, с 1 ⁄3 до 1 ⁄2. Так же меняются шансы на наличие приза и в искушающей коробке. Поскольку и у той, и другой коробки шансы на выигрыш пятьдесят на пятьдесят, менять одну коробку на другую нет никакого смысла.
Открыв коробку при втором варианте, никакой полезной информации вы не получаете. Монти (или любой другой человек) знает, что лежит в коробках, и всегда может выбрать пустую и показать ее вам. Его преднамеренная демонстрация никак не повышает шансы, что выбранная вами первоначально коробка является ценной. Другими словами, первоначальный шанс, равный 1 ⁄3, после открытия второй коробки таким же и остается.
Другими словами, открытие второй коробки не изменило вероятности, равной 2 ⁄3, что в одной из двух коробок находится приз. Но поскольку одна из этих коробок, как было показано, пустая, эта вероятность, равная 2 ⁄3, теперь полностью приходится на искушающую коробку. Приняв предложение ведущего о замене, вы удваиваете ваши шансы на получение приза.
Если вы по-прежнему не понимаете, почему ответ Селвина является правильным, представьте, что имеется 100 коробок. Вы выбираете коробку № 79. Затем Монти открывает 98 из оставшихся 99 коробок. Все они пустые. После этого, помимо вашей коробки, неоткрытой остается, скажем, коробка № 18. Монти спрашивает вас, хотите ли вы поменять коробку № 79 на коробку № 18?
Вы начинали с вероятности 1 к 99, что ключи от машины лежат в вашей коробке. Монти ведет себя как ведущий. И он не намерен показать вам ничего, кроме пустой коробки, и он может это сделать. Шанс, что приз находится в вашей коробке, остается прежним, то есть 1 ⁄100, в то время как шанс, что он в ящике № 18, после того, как ведущий открыл все остальные коробки, которые оказались пустыми, возрастает до 99 ⁄100. Так что, если перед вами 100 коробок, вы повышаете шансы в 99 раз (!), если меняете ее на оставшуюся.
Когда психологи Дональд Грэнберг и Тад Браун во время собеседования предлагали эту задачку (в их случае люди выбирали двери), они все время слышали объяснения, вроде следующих:
«Я не стал бы выбирать другую дверь: если я ошибусь при обмене, я буду больше терзать себя, чем если я останусь со своей дверью и проиграю».
«Это был мой первый выбор, сделанный инстинктивно, и, если я ошибся, что ж, пусть так оно и будет. Но если я поменяю двери и окажусь неправым, это будет еще хуже».
«Я действительно буду сожалеть, если я поменяю двери и проиграю. Психологически лучше оставаться верным своему первому выбору».
Все это синдромы боязни потери. Нам, людям, свойственно уходить от решений, которые могут оказаться плохими, даже если шансы на выигрыш благоприятны. Лучше быть в безопасности, чем сожалеть. Любой, кто придумывает новые продукты, должен хорошо об этом помнить. Потребитель, думающий о смене коробок или брендов, возможно, ориентируется на что-то такое, что не имеет ничего общего с логикой.
Боязнь потери свойственна и математическим гениям. В этом отношении они не отличаются от всех остальных. Говорят, что знаменитый математик Пол Эрдёш, когда в первый раз услышал об этой загадке, решил ее неправильно. «Даже физики, нобелевские лауреаты, регулярно дают неправильные ответы, — рассказал психолог Массимо Пьяттелли-Палмарини, — причем они настаивают на своем неверном варианте и готовы разнести в пух и прах любого, кто предлагает правильный ответ».
84. У вас есть пустое помещение и группа людей снаружи. За один ход вы можете либо позволить одному человеку войти в помещение, либо выпустить из него одного человека. Можете ли вы предложить серию ходов, при которой каждая возможная комбинация людей находится в помещении только один раз?
Нужно время, чтобы понять, чего именно хочет от вас интервьюер. Разобраться в этом помогает простой пример. Скажем, за порогом находятся два человека, Ларри и Сергей. Возможны четыре комбинации их присутствия в комнате, учитывая тот случай, когда в комнате вообще никого нет.
Вопрос заключается в том, можем ли мы начать с того, что в комнате никого нет, а затем пройти указанную последовательность шагов?
Иными словами, как сгенерировать неповторяющиеся комбинации, меняя только один элемент за раз?
Полное условие задачи звучит так: «У вас есть пустое помещение и группа людей снаружи. За один ход вы можете либо позволить одному человеку войти в помещение, либо выпустить из него одного человека. Можете ли вы предложить серию ходов, при которой каждая возможная комбинация людей находится в помещении только один раз».
Нужно время, чтобы понять, чего именно хочет от вас интервьюер. Разобраться в этом помогает простой пример. Скажем, за порогом находятся два человека, Ларри и Сергей. Возможны четыре комбинации их присутствия в комнате, учитывая тот случай, когда в комнате вообще никого нет.
Вопрос заключается в том, можем ли мы начать с того, что в комнате никого нет, а затем пройти указанную последовательность шагов? Мы помним, что только один человек может входить в комнату и покидать ее за один раз, и никакие шаги не могут повторяться даже в течение доли секунд. Так что следовать указанному порядку не удастся, потому что нельзя перейти от «только Ларри» к «только Сергею» за один шаг. Либо Ларри покивает комнату до того, как в нее войдет Сергей, но в этом случае мы повторяем шаг «никого нет», либо Сергей входит до того, как Ларри выходит, и в этом случае в какой-то момент в комнате находятся оба. Решение здесь другое.
Это простой случай, а вас просят универсальный вариант, подходящий для любого возможного числа людей N. Каждый человек может входить в помещение или выходить из него, что означает, что число комбинаций с увеличением N возрастает по экспоненте, так что подбирать варианты вручную нереально. Потребуется хороший алгоритм.
Для решения этой задачи есть два обычных пути. Один из них — начать с небольшого числа и наращивать его. Мы уже знаем, как решить эту задачу для двух человек. Добавим третьего участника — Эрика. Как он изменит ситуацию? На базовом уровне это означает, что нам нужно повторить шаги для двух человек дважды, без Эрика и с Эриком. Итак, в помещении никого нет.
Затем появляется Эрик.
Мы хотим повторить шаги, теперь уже с Эриком. Но нам надо повторять их в обратном порядке, поскольку мы начинаем там, где шаг № 4, при котором Сергей остается один в помещении, уже сделан. Фактически, мы меняем направленность движений Ларри и Сергея, то есть каждый их вход становится их выходом и наоборот. Все это время Эрик остается в помещении. Вот остальная часть инструкций:
Вот шаблон для алгоритма. Пусть теперь героев четверо. Вы проводите указанные восемь шагов, а затем добавляете шаги с четвертым человеком. При четырех участниках общее количество шагов составляет 16. Число шагов при каждом следующем участнике возрастает вдвое. Если у нас n человек, то необходимо сделать 2 n шагов.
В самом широком смысле этот вопрос относится к столкновению аналогового и цифрового процессов. Люди входят и выходят — это аналоговый процесс. Вы не можете мгновенно перенести человека из одного места в другое, как это можно сделать с цифрами. С подобным столкнулись уже в начале информационной эпохи. В те годы, когда возник первый вал цифрового Джаггернаута, Фрэнк Грей был ученым в Bell Labs. Грей разработал многие принципы, лежащие в основе цветных телевизионных передач. Его имя хорошо знают благодаря коду Грея, придуманному им в середине 1940-х годов.
Вначале телевидение было только аналоговым. Электронный луч горизонтального сканирования отклонялся вверх и вниз при помощи магнитного поля, создаваемого все время меняющимся напряжением. Грей хотел перевести аналоговое напряжение в цифровое значение (серию закодированных импульсов). У инженеров того времени было довольно специфическое понимание (скорее близкое к знаниям, почерпнутым из научно-фантастической литературы, а не научным) того, как можно направить электронный луч через маску с отверстиями, представляющими бинарные числа. Разные части маски, соответствующие разным углам отклонения, имели разные шаблоны отверстий. Луч должен был определять необходимое напряжение, выраженное в бинарных числах. Как и многие другие умные идеи, на практике она не работала. Электронные лучи двигались неупорядоченно. Скорее происходящее напоминало стрельбу из водяного пистолета по нашкодившему коту.
Главная проблема заключалась в том, что при переходе луча от одного числа, соответствующего напряжению, к другому возникали ошибочные считывания. Чтобы добиться нормальной работы Грею потребовался числовой код, где при переходе от числа к числу менялась только одна цифра. Такая система теперь называется кодами Грея. Вы можете создать их при любом основании, в том числе и при 10, но самым известным примером этого рода является бинарный код Грея. Он представлен на рисунке ниже.
Цифры в коде Грея не представляют степени 2 или чего-то другого реального. Это всего лишь код. Код 111 означает 5, и вам не следует пытаться извлечь из него что-то еще. Единственная причина существования кода Грея в том, что каждый номер может быть сгенерирован из предыдущего путем изменения всего одной цифры. Чтобы перейти от 5 (111) к 6, вам всего лишь нужно изменить среднюю цифру (и получится 101).
Грей придумал простую процедуру генерирования своих кодов. Начнем с 0 и 1. Они присваиваются обычным числам 0 и 1 (никакого фокуса в этом нет). Затем нолик и единичка идут в обратной последовательности — 1 и 0, и эти варианты добавляются к первым двум. Мы получаем 0, 1 и 1, 0.
Чтобы отличить исходную последовательность от обратной, необходимо слева от каждого кода добавить дополнительную цифру. Используем 0 для исходной последовательности и 1 для обратной версии. Это дает 00, 01, 11, 10.
Это первые четыре кода Грея. Хотите еще? Поставьте эту последовательность в обратном порядке, добавьте ее к первоначальной, и вы получите 00, 01, 11, 10, 10, 11, 01, 00. Затем добавьте нолик к первым четырем кодам и единичку к последним четырем: 000, 001, 011, 010, 110, 111, 101, 100.
Вот почему шестерку можно представить, как 101. Вы сможете без всякого труда понять, что у числа 8 код равен 1100. Схему Грея можно легко расширить до любого значения.
Коды Грея являются цикличными. Представьте, что вам удалось проехать на автомобиле миллион миль. На одометре появилось 999 999, а затем значение меняется на 000 000 (никакого миллионного числа нет). При использовании кодов Грея последнее число также возвращается к первому, но меняется всего на одну цифру. В приведенной выше таблице самое высшее число (100) можно изменить на самое низшее (000), всего лишь поменяв один бит.
Код Грея может быть использован и для решения нашей задачи. Любой инженер, решая эту задачу, должен связать ее с кодами Грея.
Представьте помещение в виде числа из n цифр, где n — количество людей. Каждая цифра соответствует разному человеку. Цифра 1 — человек находится в помещении, цифра 0 — пусто. Вот пример.
Каждое возможное бинарное число из n цифр (их 2 n ) представляет разную группировку людей. Нам необходимо составить цикл со всеми возможными группировками. Обычный порядок подсчета с бинарными цифрами не работает. А вот коды Грея здесь себя проявят отлично. Надо всего лишь пройти по кодам Грея в порядке их расположения, начав с 0000000000, интерпретировать их как этапы решения задачи. (Например, смена с 0 на 1 справа означает «Ларри вошел».) Решение начинается таким образом.
Это гарантирует, что на каждом шаге меняется только одна цифра и что только один человек входит в помещение или выходит из него.
Код Грея — это отмычка ко многим классическим загадкам, особенно таким, как «Башни Ханоя» и «Китайские кольца». Возможно, вы не бывали ни в Ханое, ни в Китае, но это неважно. К Азии это не имеет никакого отношения. А вот в жизни вы с этими загадками скорее всего встречались. В Башнях Ханоя имеется восемь цилиндрических дисков, надетых на один из трех штырей (внизу самый большой, вверху самый маленький). Игрок должен переместить все восемь дисков на другой штырь. Ограничение: нельзя класть диск на диск меньшего размера. Задача «Башня Ханоя» стала клише для видеоигр жанра «квест» (таких как Mass Effect, Zork Zero и «Звездные войны: рыцари Старой республики»). Все студенты, изучающие компьютерные науки, изучают и коды Грея, поэтому им часто на занятиях дается задание написать код для игры «Башни Ханоя» (который они должны использовать в видеоигре).
85. Напишите код поиска субматрицы с максимально возможной суммой в матрице N*N, содержащей положительные и отрицательные числа.
Полное условие задачи звучит так: дана матрица размером N*N, содержащая положительные и отрицательные числа. Напишите код поиска субматрицы с максимально возможной суммой.
Существует множество решений этой задачи. Мы начнем с метода грубой силы, а затем займемся оптимизацией.
Метод грубой силы: O(N 6 )
Подобно другим задачам, связанным с поиском максимума, у этой задачи есть простое решение. Достаточно проверить все субматрицы, вычислить сумму каждой и найти самую большую.
Чтобы проверить все субматрицы и избежать повторов. Придется пройтись по всем упорядоченным парам строк и затем по всем упорядоченным парам столбцов.
Это решение потребует O(N 6 ) времени, так как необходимо проверить O(N 4 ) матриц, а проверка одной матрицы занимает O(N 2 ) времени.
Динамическое программирование: O(N 4 )
Обратите внимание, что предыдущее решение работает медленно из-за расчета суммы элементов матрицы — O(N 2 ) — очень медленная операция. Можно ли сократить это время? Да! Мы можем уменьшить время computeSum до O(1).
Посмотрите на следующий прямоугольник:
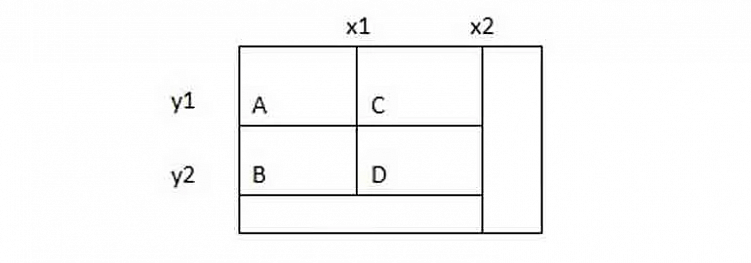
Предположим, что нам известны следующие значения:
ValD = area(point(0, 0) -> point(x2, y2)) ValC = area(point(0, 0) -> point(x2, yl)) ValB = area(point(0, 0) -> point(xl, y2)) ValA = area(point(0, 0) -> point(xl, yl))
Каждое Val* начинается в исходной точке и заканчивается в нижнем правом углу подпрямоугольника. Про эти значения мы знаем следующее:
area(D) = ValD - area(A union С) - area(A union B) + area(A).
area(D) = ValD - ValB - ValC + ValA
Данная информация позволит эффективно рассчитать эти значения для всех точек матрицы:
Уа1(х, у) = Уа1(х-1, у) + Уа1(у-1, х) - Уа1(х-1, у-1)
Можно заранее рассчитать подобные значения и затем найти максимальную субматрицу. Следующий код реализует данный алгоритм.
int getMaxMatrix(int[][] original) < int maxArea = Integer.MIN_VALUE; // Важно! Max может быть < 0 int rowCount = original.length; int columnCount = original[0].length; int[][] matrix = precomputeMatrix(original); for (int rowl = 0; rowl < rowCount; rowl++) < for (int row2 = rowl; row2 < rowCount; row2++) < for (int coli = 0; coli < columnCount; coll++) < for (int col2 = coli; col2 < columnCount; col2++) < maxArea = Math.max(maxArea, computeSum(matrix, rowl, row2, coli, col2)); >> > > return maxArea > int[][] precomputeMatrix(int[][] matrix) < int[][] sumMatrix = new int[matrix.length][matrix[0].length]; for (int i = 0; i < matrix.length; i++) < for (int j = 0; j < matrix.length; j++) < if (i == 0 && j == 0) < // первая ячейка sumMatrix[i][j] = matrix[i][j]; >else if (j == 0) < // ячейка в первой колонке sumMatrix[i][j] = sumMatrix[i - l][j] + matrix[i][j]; >else if (i == 0) < // ячейка в первом ряду sumMatrix[i][j] = sumMatrix[i][j-1] + matrix[i][j]; >else < sumMatrix[i][j] = sumMatrix[i-l][j] + sumMatrix[i][j-1] - sumMatrix[i-l][j-1] + matrix[i][j]; >> > return sumMatrix; > int computeSum(int[][] sumMatrix, int il, int i2, int jl, int j2) < if (il == 0 && jl == 0) < // начинаем с ряда 0, колонки 0 return sumMatrix[i2][j2]; >else if (il == 0) < // начинаем с ряда 0 return sumMatrix[i2][j2] - sumMatrix[i2][jl - 1]; >else if (jl == 0) < // начинаем с колонки 0 return sumMatrix[i2][j2] - sumMatrix[il-l][j2]; >else < return sumMatrix[i2][j2] - sumMatrix[i2][jl-1] - sumMatrix[il-l][j2] + sumMatrix[il-1][jl-1]; >>
Оптимизированное решение: O(N 3 )
Невероятно, но существует еще более оптимальное решение. Если у нас есть R строк и С столбцов, то задачу можно решить за О(R 2 C) времени.
Вспомните решение задачи про поиск максимального субмассива: для массива целых чисел (integer) найдите субмассив с максимальной суммой. Такой максимальный субмассив можно найти за О(N) времени. Давайте используем это решение для нашей задачи.
Каждую субматрицу можно представить в виде последовательности строк и последовательности столбцов. Можно пройтись по строкам и найти столбцы, дающие максимальную сумму.
Код будет таким:
maxSum = 0 foreach rowStart in rows foreach rowEnd in rows /* У нас есть количество возможных субматриц с границами * rowStart и rowEnd * Найдите границы colStart и colEnd, дающие * максимальную сумму. */ maxSum = max(runningMaxSum, maxSum) return maxSum
Теперь остается вопрос: как найти «лучшие» colStart и colEnd ?
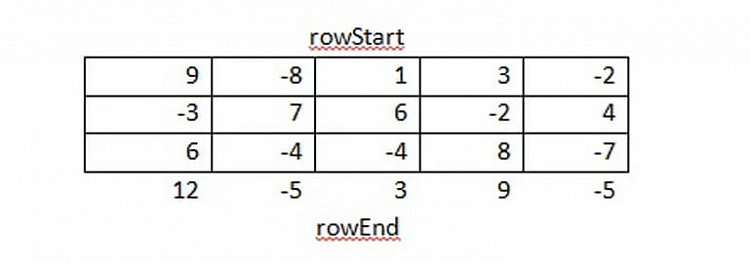
Нам необходимо найти colStart и colEnd , которые дают нам максимально возможную сумму всех субматриц rowStart сверху и rowEnd снизу. Можно вычислить сумму каждого столбца и использовать функцию maximumSubArray , которая обсуждалась в начале решения этой задачи.
В предыдущем примере максимальный субмасив охватывал пространство с первой по четвертую колонку. Это означает, что максимальная субматрица должна простираться от ( rowStart , первый столбец) до ( rowEnd , четвертый столбец).
Теперь мы можем записать следующий псевдокод:
maxSum = 0 foreach rowStart in rows foreach rowEnd in rows foreach col in columns partialSum[col] = sum of matrix[rowStart, col] through matrix[rowEnd, col] runningMaxSum = maxSubArray(partialSum) maxSum = max(runningMaxSum, maxSum) return maxSum
Вычисление суммы в строках 5 и 6 занимает R*C времени (так как требует итерации от rowStart до rowEnd ), что дает общее время выполнения О(R 3 C).
В строках 5 и 6 мы добавляли a[0]…a[i] с нуля, даже если на предыдущей итерации внешнего цикла добавились a[0]…a[i-1]. Давайте избавимся от двойной работы.
maxSum = 0 foreach rowStart in rows clear array partialSum foreach rowEnd in rows foreach col in columns partialSum[col] += matrix[rowEnd, col] runningMaxSum = maxSubArray(partialSum) maxSum = max(runningMaxSum, maxSum) return maxSum
Полная версия кода выглядит так:
public void clearArray(int[] array) < for (int i = 0; i < array.length; i++) < array[i] = 0; >> public static int maxSubMatrix(int[][] matrix) < int rowCount = matrix.length; int colCount = matrix[0].length; int[] partialSum = new int[colCount]; int maxSum = 0; // Макс, сумма = 0 (матрица пуста) for (int rowStart = 0; rowStart < rowCount; rowStart++) < clearArray(partialSum); for (int rowEnd = rowStart; rowEnd < rowCount; rowEnd++) < for (int i = 0; i < colCount; i++) < partialSum[i] += matrix[rowEnd][i]j >int tempMaxSum = maxSubArray(partialSum, colCount); /* Если вы хотите отслеживать координаты, добавьте * код здесь, чтобы сделать это. */ maxSum = Math.max(maxSum, tempMaxSum); > > return maxSum; > public static int maxSubArray(int array[], int N) < int maxSum = 0; int runningSum = 0; for (int i = 0; i < N; i++) < runningSum += array[i]; maxSum = Math.max(maxSum, runningSum); /* Если runningSum < 0, нет смысла продолжать ряд * Сброс. */ if (runningSum < 0) < runningSum = 0; >> return maxSum; >
Это чрезвычайно сложная задача. Вряд ли вы сможете решить подобную задачу на собеседовании без подсказки интервьюера.
86. Сложная задача, требующая умения придумывать алгоритмы.
По условию требуется разработать алгоритм, позволяющий найти k-e число из упорядоченного числового ряда, в разложении элементов которого на простые множители присутствуют только 3, 5 и 7.
Решение с примерами кода на Java есть у нас на сайте.
Решение с примерами кода Свернуть
По условию задачи любое число этого ряда должно представлять собой произведение 3 a · 5 b · 7 c .
Давайте посмотрим на список чисел, удовлетворяющих нашим требованиям:
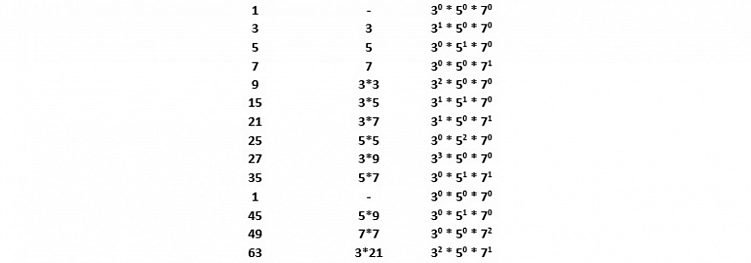
Другой способ — представить каждое число в следующем виде:
Мы знаем, что Ak можно записать как (3, 5 или 7) · (некоторое значение из < A1, …, Ak-1>). Мы также знаем, что Ak является следующим числом в данном ряду. Поэтому Ak должно быть наименьшим «новым» числом, которое может быть получено умножением каждого значения в списке на 3, 5 или 7.
Как найти Ak? Мы можем умножить каждое число в списке на 3, 5 или 7 и найти наименьший новый результат. Но такое решение потребует O(k 2 ) времени. Неплохо, но можно сделать и лучше.
Вместо умножения всех элементов списка на 3, 5 или 7 можно рассматривать каждое предыдущее значение как основу для расчета трёх последующих значений. Таким образом, каждое число Ai может использоваться для формирования следующих форм:
Эта идея поможет нам спланировать все заранее. Каждый раз, когда мы добавляем в список число Ai, мы держим значения 3Ai, 5Ai и 7Ai в «резервном» списке. Чтобы получить Ai+1, достаточно будет найти наименьшее значение во временном списке.
Наш код может быть таким:
public static int removeMin(Queue q) < int min = q.peek(); for(Integer v : q) < if (min >v) < min=v; >> while (q.contains(min)) < q.remove(min); >return min; > public static void addProducts(Queue q, int v) < q.add(v * 3); q.add(v * 5); q.add(v * 7); >public static int getKthMagicNumber(int k) < if (k < 0) return 0; int val = 1; Queueq = new LinkedList(); addProducts(q, 1); for(int i = 0; i < k; i++) < val = removeMin(q); addProducts(q, val); >return val; >
Данный алгоритм гораздо лучше предыдущего, но все еще не идеален.
Для генерирования нового элемента Ai мы осуществляем поиск по связному списку, где каждый элемент имеет вид:
Давайте уберем избыточные расчеты. Допустим, что наш список имеет вид:
Когда мы ищем минимальный элемент в списке, то проверяем сначала 7A1 < min, а затем 7A5 < min. Глупо, не правда ли? Поскольку мы знаем, что A1 < A5, то достаточно выполнить проверку 7A1 < min.
Если бы мы разделили список по постоянным множителям, то должны были бы проверить только первое из произведений на 3, 5 и 7. Все последующие элементы будут больше.
Таким образом, наш список принимает вид:
Чтобы найти минимум, достаточно проверить начало каждой очереди:
Y = min(Q3.head(), Q5.head(), Q7.head())
Как только мы вычислим y, нужно добавить 3y в список Q3, 5y в Q5 и 7y в Q7. Но мы хотим вставлять эти элементы, только если они отсутствуют в других списках.
Как, например, 3y может попасть в какой-нибудь другой список? Допустим, элемент y был получен из Q7, это значит, что y = 7x. Если 7x — наименьшее значение, значит, 3x уже было задействовано. А как мы действовали, когда увидели 3x? Правильно, мы вставили 7 · 3x в Q7. Обратите внимание, что 7 · 3x = 3 · 7x = 3y.
В общем виде: если мы берем элемент из Q7, он будет иметь вид 7 · suffix. Мы знаем, что 3 · suffix и 5 · suffix уже обработаны, и элемент 7 · 3 ·suffix добавлен в Q7. Единственное значение, которое мы еще не встречали — 7 · 7 · suffix, поэтому добавляем его в Q7.
Давайте рассмотрим пример, чтобы разобраться, как работает данный алгоритм. Инициализация:
Q3 = 3 Q5 = 5 Q7 = 7 Удаляем min = 3, вставляем 3*3 в Q3, 5*3 в Q5, 7*3 в Q7 Q3 = 3*3 Q5 = 5, 5*3 Q7 = 7, 7*3 Удаляем min = 5. 3*5 – дубль, значит, мы уже обработали 5*3. Вставляем 5*5 в Q5, 7*5 в Q7 Q3 = 3*3 Q5 = 5*3, 5*5 Q7 = 7, 7*3, 7*5 Удаляем min = 7. 3*7 и 5*7 – дубли, уже обработали 7*3 и 7*5. Вставляем 7*7 в Q7 Q3 = 3*3 Q5 = 5*3, 5*5 Q7 = 7*3, 7*5, 7*7 Удаляем min = 3*3 = 9. Вставляем 3*3*3 в Q3, 3*3*5 в Q5, 3*3*7 в Q7. Q3 = 3*3*3 Q5 = 5*3, 5*5, 5*3*3 Q7 = 7*3, 7*5, 7*7, 7*3*3 Удаляем min = 5*3 =15. 3*(5*3) – дубль, так как уже обработали 5*(3*3). Вставляем 5*5*3 в Q5, 7*5*3 в Q7 Q3 = 3*3*3 Q5 = 5*5, 5*3*3, 5*5*3 Q7 = 7*3, 7*5, 7*7, 7*3*3, 7*5*3 Удаляем min = 7*3 = 21. 3*(7*3) и 5*(7*3) – дубли, уже обработали 7*(3*3) и 7*(5*3). Вставляем 7*7*3 в Q7 Q3 = 3*3*3 Q5 = 5*5, 5*3*3, 5*5*3 Q7 = 7*5, 7*7, 7*3*3, 7*5*3, 7*7*3
Структура нашего алгоритма будет иметь вид:
Следующий код реализует данный алгоритм:
public static int getKthMgicNumber(int k) < if (k < 0) < return 0; >int val = 0; Queue queue3 = new LinkedList(); Queue queue5 = new LinkedList(); Queue queue7 = new LinkedList(); queue3.add(1); /* Итерация от 0 до k */ for (int i = 0; i 0 ? queue3.peek() : Integer.MAX_VALUE; int v5 = queue5.size() > 0 ? queue5.peek() : Integer.MAX_VALUE; int v7 = queue7.size() > 0 ? queue7.peek() : Integer.MAX_VALUE; val = Math.min(v3,Mathmin(v5, v7)); if(val == v3) < // ставим в очередь 3, 5 и 7 queue3.remove(); queue3.add(3 * val); queue5.add(5 * val); >else if (val == v5) < // ставим в очередь 5 и 7 queue5.remove(); queue5.add(5 * val); >else if (val == v7) < // ставим в очередь Q7 queue7.remove(); >queue7.add(7 * val); // всегда добавляем в очередь Q7 > return val; >
Если вам досталась подобная задача, приложите все усилия, чтобы ее решить, потому что это действительно трудное задание. Вы можете начать с решения «в лоб» (спорно, зато не слишком сложно), а затем попытаться оптимизировать его. Или попытайтесь найти шаблон, спрятанный в числах.
Интервьюер поможет, если вы будете испытывать затруднения. Не сдавайтесь! Рассуждайте вслух, задавайте вопросы и объясняйте ход ваших мыслей. Интервьюер наверняка начнет помогать вам.
Помните, никто не ожидает, что вы найдете идеальное решение. Ваши результаты будут сравнивать с результатами других кандидатов. Все будут находиться в одинаковых условиях.
87. Дан список из миллиона слов. Разработайте алгоритм, создающий максимально возможный прямоугольник из букв так, чтобы каждая строка и каждый столбец образовывали слово (при чтении слева направо и сверху вниз). Слова могут выбираться в любом порядке, строки должны быть одинаковой длины, а столбцы — одинаковой высоты.
Условие задачи звучит так: дан список из миллиона слов. Разработайте алгоритм, создающий максимально возможный прямоугольник из букв так, чтобы каждая строка и каждый столбец образовывали слово (при чтении слева направо и сверху вниз). Слова могут выбираться в любом порядке, строки должны быть одинаковой длины, а столбцы — одинаковой высоты.
Большинство задач, использующих словарь, требуют некоторой предварительной обработки. Как можно провести предварительную обработку?
Если мы собираемся создать квадрат из слов, то длина всех строк и высота всех столбцов должны быть одинаковыми. Давайте сгруппируем слова словаря по длине. Назовем эту группу D, где D[i] — список слов длиной i.
Обратите внимание, что мы ищем самый большой прямоугольник. Какой самый большой квадрат можно сформировать? Это (length(longestWord))^2 .
int maxRectangle = longestWord * longestWord; for z = maxRectangle to 1 < for each pair of numbers (i,j) where i*j = z < /* пытаемся создать прямоугольник, возвращаемся, если успешно */ >>
Мы проходим по прямоугольникам от самого большого до самого маленького, таким образом, первый найденный прямоугольник будет самым большим.
Теперь самая сложная часть — makeRectangle(int l, int h) . Этот метод пытается создать прямоугольник из слов размером lxh.
Можно, например, пройтись по всем упорядоченным наборам h-слов и затем проверить, содержат ли колонки допустимые слова. Такой метод будет работать, но очень неэффективно.
Предположим, что мы пытаемся создать прямоугольник размером 6×5, и первыми парами строк будут:
В этой точке мы уже знаем, что первый столбец начинается с tqp . Мы знаем (или должны знать), что ни одно из слов в словаре не начинается с tqp . Зачем мы продолжили создавать прямоугольник, если знали, что у нас не получится создать допустимый прямоугольник?
Значит, нужна оптимизация. Можно создать выборку, позволяющую упростить поиск, если будем анализировать подстроки как префиксы слов в словаре. При построчном формировании прямоугольника можно ввести проверку, являются ли столбцы допустимыми префиксами. Если нет, мы сразу прекращаем работу с этим прямоугольником.
Приведенный далее код реализует этот алгоритм. Это длинный и сложный алгоритм, поэтому мы будем анализировать его по частям.
Прежде всего, нам необходима предварительная обработка, позволяющая сгруппировать слова по длине. Мы создаем массив выборок (по одной на каждую длину слова), но пока не будем их использовать.
WordGroup[] groupList = WordGroup.createWordGroups(list); int maxWordLength = groupList.length; Trie trieList[] = new Trie[maxWordLength];
Метод maxRectangle — главная часть нашего кода. Он начинает работу с самого большого возможного прямоугольника (maxWordLength2) и пытается построить прямоугольник этого размера. Если это невозможно, он пытается создать прямоугольник меньшего размера. Первый прямоугольник, который удастся построить, будет самым большим.
Rectangle maxRectangleO < int maxSize = maxWordLength * maxWordLength; for (int z = maxSize; z >0; z–) < // начинаем с наибольшей области for (int i = 1; i > > > > return null; >
maxRectangle вызывает метод makeRectangle и пытается построить прямоугольник указанных размеров.
Rectangle makeRectangle(int length, int height) < if (groupList[length-l] == null || groupList[height-l] == null) < return null; >/* Создает выборку для длины слова, если мы ее еще не создали */ if (trieList[height-1] == null) < LinkedList words = groupListfheight-1) .getWordsQ; trieList[height-1] = new Trie(words); >return makePartialRectangle(length, height, new Rectangle(length)); >
Метод makePartialRectangle — наш основной метод, производящий всю работу. Ему передаются окончательные значения длины и высоты, а также частично сформированный прямоугольник. Если нам известно окончательное значение высоты прямоугольника, то мы должны проверить, что колонки содержат допустимые слова, и выйти.
В противоположном случае мы проверяем, сформированы ли столбцы из допустимых префиксов. Если нет, работа останавливается, поскольку нет смысла продолжать строить этот прямоугольник.
Если все нормально и все колонки содержат правильные префиксы, мы перебираем все слова нужной длины, добавляем каждое из них к прямоугольнику и пытаемся построить новый прямоугольник (текущий прямоугольник с новым добавленным словом).
Rectangle makePantialRectangle(int 1, int h, Rectangle rectangle) < if (rectangle.height == h) < // Проверяем, полный ли прямоугольник if (rectangle.isComplete(l, h, groupList[h-1])) < return rectangle; >else < return null; >> /* Сравниваем колонки с выборкой, чтобы увидеть */ /* потенциально допустимый прямоугольник */ if (!rectangle.isPartialOK(l, trielist[h-1])) < return null; >/* Проходимся по всем словам нужной длины. Добавляем каждое в * текущий частичный прямоугольник и пытаемся построить прямоугольник * рекурсивно. */ for (int i=0; i > return null; >
Класс Rectangle представляет собой частотно или полностью сформированный прямоугольник из слов. Метод isPartialOk вызывается для проверки допустимости прямоугольника. Метод isComplete выполняет аналогичную функцию, но дополнительно проверяет, чтобы колонки содержали полное слово.
public class Rectangle < public int height, length; public char [][] matrix; /* Создаем "пустой" прямоугольник. Длина - фиксированная, но высота * может изменяться при добавлении слов */ public Rectangle(int 1) < height = 0; length = 1; >/* Создаем прямоугольный массив слов * определенной длины и высоты * (Предполагается, что длина и высота определены * как аргументы и не противоречат * размерам массива) */ public Rectangle(int length, int height, char[][] letters) < this.height = letters.length; this.length = letters[0].length; matrix = letters; >public char getLetter (int i, int j) < return matrix[i][j]; >public String getColumn(int i) < . >/* Проверяем, все ли колонки допустимы. Все строки будут * допустимы, так как они были добавлены непосредственно из словаря */ public boolean isComplete(int 1, int h, WordGroup groupList) < if (height == h) < /* Проверяем, является ли каждая колонка словарным словом*/ for (int i = 0; i < 1; i++) < String col = getColumn(i); if (!groupList.containsWord(col)) < return false; >> return true; > return false; > public boolean isPartialOK(int 1, Trie trie) < if (height == 0) return true; for (int i = 0; i < 1; i++ ) < String col = getColumn(i); if (!trie.contains(col)) < return false; >> return true; > /* Создаем новый Rectangle: берем строки текущего * прямоугольника и добавляем s. */ public Rectangle append(String s) < . >>
Класс WordGroup — контейнер, содержащий слова определенной длины. Для упрощения поиска мы будем хранить слова в хэш-таблице так же, как в ArrayList .
Списки в WordGroup создаются с помощью статического метода createWordGroups.
public class WordGroup < private Hashtablelookup = new Hashtable(); private ArrayList group = new ArrayList(); public boolean containsWord(String s) < return lookup.containsKey(s)); >public void addWord (String s) < group.add(s); lookup.put(s, true); >public int lengthQ < return group.size(); >public String getWord(int i) < return group.get(i); >public ArrayList getWords() < return group; >public static WordGroup[] createWordGroups(String[] list) < WordGroupf] groupList; int maxWordLength = 0; /* Находим длину самого длинного слова */ for (int i = 0; i < list.length; i++) < if (list[i].length() >maxWordLength) < maxWordLength = list[i].length(); >> /* Группируем слова в словаре в списки одинаковой длины * length.groupList[i] будет содержать список слов * длиной (i+1). */ groupList = new WordGroup[maxWordLength]; for (int i = 0; i < list.length; i++) < /* Мы делаем wordLength - 1 вместо просто wordLength, так как * мы используем wordLength и нет слов длиной 0 */ int wordLength = list[i].length() - 1; if (groupList[wordLength] == null) < groupList[wordLength] = new WordGroupO; >groupList[wordLength].addWord(list[i]); > return groupList; > >
Полный код для этой задачи, включая коды методов Trie и TrieNode , вы можете скачать с сайта автора книги. Не забудьте, что в подобных сложных задачах лучше использовать псевдокод. На написание полного кода вам просто не хватит времени.
88. Дан массив с числами типа Integer . Вам нужно написать функцию, которая на входе получит исходный массив, а на выходе вернет массив, в котором каждое значение получено путем произведения всех значений исходного массива с отличным от текущего индексом.
Для ясности приведем пример. Допустим, исходный массив имеет вид:
[1, 7, 3, 4]
Тогда функция должна вернуть:
[84, 12, 28, 21]
Расчет значений происходит следующим образом:
[7*3*4, 1*3*4, 1*7*4, 1*7*3]
Для того, чтобы вычислить возвращаемый массив без использования деления, мы дважды пройдемся по массиву. Проходя первый раз, мы будем получать произведение всех значений до текущего индекса и сохранять это произведение в отдельном массиве poducts_of_all_ints_except_at_index. В этом же массиве будем сохранять результат произведения всех значений после текущего индекса, но уже идя в обратном порядке. Ответ же мы получим, перемножив значения перед и после индекса во время обратного прохода по массиву.
Код решения (на Python):
def get_products_of_all_ints_except_at_index(int_list): # создаем дополнительный массив с таким же размером, что и исходный. products_of_all_ints_except_at_index = [None] * len(int_list) # Находим произведение всех значений до текущего. # Результат помещаем в новый массив. product_so_far = 1 i = 0 while i < len(int_list): products_of_all_ints_except_at_index[i] = product_so_far product_so_far *= int_list[i] i += 1 # Находим произведение всех значений после текущего, # при этом двигаясь по массиву в обратную сторону. # Параллельно вычисляем значение текущей ячейки. product_so_far = 1 i = len(int_list) - 1 while i >= 0: products_of_all_ints_except_at_index[i] *= product_so_far product_so_far *= int_list[i] i -= 1 return products_of_all_ints_except_at_index
Сложность полученного алгоритма — O(n) по памяти и O(n) по времени. Свои варианты предлагайте в комментариях.
89. Задача на умение рассуждать. Конкретный ответ не важен, важно показать как вы мыслите. Представьте, что вам необходимо добраться из точки A в точку B, но вы не знаете, как. Как вы будете действовать?
Ответ студента, обучающегося по программе MBA: «Я взял бы свой сотовый и ввел точки А и В в Google Maps. Если точки В на этой карте нет, я вызвал бы такси, доехал до нее, а потом отдал бы счет в бухгалтерию. Задавайте следующий вопрос».
Доктор со степенью в компьютерных науках ответил бы так: «О, я знаю. Вы спрашиваете о задаче отыскания сети…»
Программист, скорее всего, начнет обсуждать относительные достоинства конкретных поисковых алгоритмов. Хотя эти алгоритмы были разработаны для анализа компьютерной памяти и интернета, они в равной степени подходят для ориентации при покупках в торговом центре, в садовом лабиринте или в причудливо расположенных деревнях Умбрии. Далее я привожу ответ на основе здравого смысла, и он, в конечном счете, не так далек от ответа ученого-компьютерщика.
Давайте изменим формулировку вопроса. Вы находитесь в точке A и хотите отыскать точку B, но никакого руководства для этого у вас нет. Вам придется изучить дороги и тропинки, ведущие из A. Вы отыщете точку B только тогда, когда в нее попадете (если это вообще случится). Но вы можете в ней и не оказаться. Точка B может находиться вне сети дорог и поэтому быть недоступной.
Вам следует начать с ряда важных вопросов, которые надо задать интервьюеру.
Любят, любят интервьюеры такие вопросы! Несомненно, человек, который их задает, достаточно умный, чтобы уточнить детали. Но при ответе на первый ваш вопрос они сообщат, что вы не сможете получить надежные рекомендации, связанные с направлением поиска.
Второй вопрос важен потому, что умные инженеры стараются не тратить понапрасну время и усилия, если они все равно не приведут к нужному результату. Вы ведь не хотите обыскать всю планету, и, в конце концов, сделать вывод, что попасть в B из A нельзя.
Последний вопрос, третий, немного запутывает. Поэтому разберем его. Что, если вы потерялись в лабиринте на кукурузном поле с двумя хныкающими малышами? Назовем это место, где вы сейчас находитесь, точкой A. Вы хотите отыскать выход — точку B. Вас, в первую очередь, интересует то, как можно выбраться из этого чертова лабиринта.
Вы хотите получить процедуру поиска, которая отыщет точку B как можно быстрее. Однако в этом лабиринте почти всегда есть повороты, вводящие в заблуждение, и путь, который вы проделаете до выхода (от A до B), не обязательно будет самым коротким. Впрочем, в вашей ситуации это не самое главное.
А вот вам альтернативный пример: вы хотите добираться из дома (A) на работу (B) общественным транспортом. Вы подбираете для себя маршрут, чтобы потом ездить каждый рабочий день. Поэтому вы не просто ищете путь до B, но и хотите, чтобы дорога от A до B была самой короткой.
В любом поиске приходится в той или иной мере прибегать к пробам и ошибкам. Какую-то роль в этом процессе играют, конечно, ваши знания или интуиция. Может быть, вы заранее убеждены, что в B можно попасть при помощи карт, догадок, встречных местных жителей, мудрости, оставшейся у нас со времен трапперов французской Канады, или дорожных знаков, указывающих, что до точки B осталось 17 миль. Однако в любом случае процедура поиска должна быть как-то упорядочена независимо от того, какой информацией вы располагаете (и учитывая тот факт, что эта информация необязательно является надежной). Вы начнете с изучения маршрута, который, как вы считаете, является, самым коротким путем до B. По мере вашего продвижения составляйте карту, чтобы в случае чего вы могли вернуться назад и попробовать другие пути.
До сих пор все рекомендации бесспорны. Чтобы произвести впечатление на интервьюера, вам необходимо заявить что-то не столь очевидное. Скажем, попробуйте следующее: «Фундаментальный философский вопрос при поиске места назначения — когда мне следует повернуть назад?»
Бывают времена, когда вы чувствуете, что заблудились, то есть у вас появилась мысль, что вы отклонились от пути, ведущего от А к В. Вернетесь ли вы туда, где были до этого, до того, как сбились? Или вы постараетесь отыскать прямой путь до В от того места, где вы сейчас находитесь?
Вполне вероятно, вам нужно было принять такое решение во время вашей последней дальней поездки. Если шутки о мужчинах-водителях правильны, мужчины очень неохотно возвращаются назад или спрашивают других о том, куда надо ехать. Предположим, дружески настроенный незнакомец уверяет Эшли и Бена, что точка В находится дальше, «прямо вон по той дороге», и заявляет, что «вы не сможете ее пропустить». Они едут полчаса, готовые за каждым поворотом увидеть В. Но этого так и не происходит. «Мы, очевидно, не туда едем, — роняет Эшли. — Давай вернемся к тому месту, где мы были до этого, прежде чем отправились по этой дороге».
«Да ну, это бессмысленно, — возражает Бен. — Мы уже столько проехали, скорее всего мы теперь находимся ближе к В, чем были до этого. Впереди должен быть какой-то указатель».
Стратегия Бена напоминает вариант, который ученые-компьютерщики называют первым лучшим алгоритмом. Всякий раз, когда вы добираетесь до развилки на дороге, вы следуете тем путем, который вам кажется самой короткой дорогой к В, и делаете это основываясь на том, что вы знаете. Если вам повезет, это знание окажется на 100% точным, и тогда Бен доберется до пункта В кратчайшим путем.
Стратегия Эшли скорее напоминает поисковый алгоритм А* (произносится А звездочка), описанный учеными-компьютерщиками Питером Хартом, Нилсом Нилссоном и Бертраном Рафаэлем в 1968 году. Его суть (в самом первом приближении) следующая: вам следует стремиться к выбору самой близкой к самой короткой дороге из А в В. Вы, вероятно, удивитесь, а чем этот вариант, собственно говоря, отличается от стратегии Бена? Ничем, если вы на правильном пути. А вот если вы уклонились… Принимая решение, что делать дальше, Бен ориентируется на единственный аргумент — свою догадку о том, насколько далеко В лежит от того места, где Бен сейчас находится. Бен всегда пытается двигаться в сторону В. Эшли же опирается на два факта: свою оценку расстояния до В и свое знание расстояния по дороге от А до того места, где он сейчас находится. Цель Эшли минимизировать оба числа или, что будет точнее, их сумму. Эшли пытается изучить точки, которые с максимальной вероятностью лежат на кратчайшем пути между А и В.
Кто прав, Бен или Эшли? Процедура поиска Эшли лучше, когда приходится иметь дело с поворотами, заводящими не туда, куда нужно. Сущность ее подхода показана на приведенной ниже диаграмме. Начав из А, путешественник добирается до развилки дорог и должен выбрать, налево или направо ему податься. Если Бен выберет левый путь — ошибочный! — ему придется отправиться длинным кружным путем. После многих блужданий путь приведет его ближе к В.
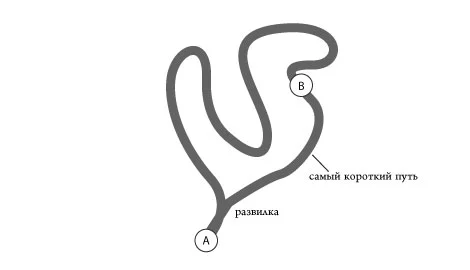
Если Эшли также повернет неправильно, в данном случае налево, она через какое-то время поймет, что проделала уже слишком длинный путь от A, а В все еще не видать. Это для нее знак, что она, скорее всего, выбрала не самый короткий путь. Тогда Эшли вернется к развилке и попробует другой путь. И есть вероятность, она доберется до В быстрее, чем Бен.
В целом можно ожидать, что одной развилкой дело не обойдется, и поэтому подобные решения придется принимать частенько. И каждый раз надо выбирать тот или иной компромиссный вариант: метод поиска с оптимальным числом возвратов назад обычно оказывается лучше варианта, когда к такому возврату прибегают очень редко.
Вернемся на интервью. Предпочтение стоит отдать поиску в виде А*, поскольку в формулировке вопроса утверждается, что вы не знаете, можете ли вы вообще добраться до места. Если пути, позволяющего добраться до В нет, Бен будет бродить целую вечность. Эшли исследует системно все пути, ведущие из пункта А, поскольку она минимизирует расстояние, пройденное от А. Затем она составит карту территории, которая поможет ей определить, что возможности добраться из А в В нет. Это позволит ей не тратить напрасно ресурсы.
У варианта поиска А* есть одно особое преимущество, которое проявляется тогда, когда нужно отыскать самый короткий из всех путей. По этой причине он используется в дорожных приложениях и в видеоиграх, когда персонажам надо пробраться через виртуальные миры. Поиск по методу А* также обладает и психологическим преимуществом. Нам свойственно ошибаться, и при этом нам свойственно искать оправдания. Очень соблазнительно тратить ресурсы на исследование ложного пути или реализацию плохо составленного бизнес-плана, продолжение отношений с неподходящим романтическим партнером, защиту ошибочной идеи, убеждая себя, что успех ожидает нас уже за следующим углом. А вот поиск в варианте А* позволит отказаться от бессмысленного занятия и перейти к чему-то новому. И это применимо всюду. Ведь важно не только не сдаться слишком быстро, но и вовремя признать себя побежденным.
Подведем итоги. Пытаясь добраться из точки А в точку В, старайтесь как можно ближе держаться дороги, которая, как вы полагаете сейчас, является самой короткой (поиск А*), и не пытайтесь просто отыскать пункт В.
90. Представьте, что вам дали задание разработать план эвакуации большого города (в классическом варианте — Сан-Франциско). С чего вы начнете?
Такой вопрос на самом деле не лишен практического смысла. В 2006 году в Карте отчета об эвакуации в чрезвычайной ситуации, составленной Союзом пользователей американских автодорог, Канзасу была присвоена степень А (наивысшая). Новый Орлеан, по которому ударил ураган Катрина, получил D. Оценка Сан-Франциско? F. В числе отстающих также оказались Нью-Йорк, Чикаго и Лос-Анджелес.
Низкие оценки вызваны большими размерами этих городов, их сложной географией и зависимостью от общественного транспорта. В такой организации, как Google, которая очень внимательно относится к вопросам окружающей среды, некоторые интервьюеры почти инстинктивно готовы перейти к обсуждению сети транзитного общественного транспорта в Сан-Франциско. Большинство маршрутов общественных видов транспорта проходят по территории города. BART, Скоростная система зоны Залива, может доставить людей до Окленда. Но достаточно ли этого? Или мы будем эвакуировать и население Окленда? AMTRAK в Сан-Франциско даже не останавливается. Если говорить о ближайшем будущем, здесь нет даже плана «зеленой эвакуации». Экстренный вывоз людей из города означает появление на общественных шоссе большого числа обычных двигателей внутреннего сгорания.
Вот несколько пунктов из плана эвакуации, которые вы могли бы указать при своем ответе.
91. Задача, которую предлагали на собеседованиях в Apple: у вас есть массив с целыми числами, в том числе и отрицательными, вам нужно найти самое большое произведение 3 чисел из этого массива.
Например: у вас есть массив list_of_ints, содержащий числа -10, -10, 1, 3, 2. Функция, которая обрабатывает этот массив, должна вернуть 300, так как -10 * -10 * 3 = 300. Задание нужно выполнить максимально эффективно, не забывая учесть отрицательные числа.
Методов решения много, но не так просто добиться O(n) времени выполнения и O(1) затрат памяти. Для эффективного решения задачи мы создадим и будем наблюдать за состоянием следующих переменных:
Когда мы пройдемся по массиву до конца, в highest_product_of_three будет содержаться наш ответ, а остальные переменные мы используем как временный буфер. highest_product_of_2 и lowest_product_of_2 будут содержать наибольшее произведение из двух и наименьшее произведение из двух соответственно, а проходя по массиву, мы будем проверять произведение текущего числа current с этими переменными (отрицательный current с lowest_product_of_2 и положительный с highest_product_of_2). highest и lowest нам нужны для запоминания минимального и максимального чисел в массиве.
Код решения на Python:
def highest_product_of_3(list_of_ints): # Проверим, чтобы в массиве было 3 и больше чисел. if len(list_of_ints) < 3: raise Exception('Less than 3 items!') # Мы начнем с 3-его элемента массива (с индекса 2), # так как первые 2 элемента уже сразу пойдут # в highest_product_of_2 и lowest_product_of_2. highest = max(list_of_ints[0], list_of_ints[1]) lowest = min(list_of_ints[0], list_of_ints[1]) highest_product_of_2 = list_of_ints[0] * list_of_ints[1] lowest_product_of_2 = list_of_ints[0] * list_of_ints[1] # Также вычислим highest_product_of_three из первых 3-х элементов. highest_product_of_three = list_of_ints[0] * list_of_ints[1] * list_of_ints[2] # Начинаем проход по массиву с индекса 2. for current in list_of_ints[2:]: # проверяем возможность увеличить highest_product_of_three # или оставляем его как есть. highest_product_of_three = max( highest_product_of_three, current * highest_product_of_2, current * lowest_product_of_2) # То же самое проверим и на максимальном произведении из двух. highest_product_of_2 = max( highest_product_of_2, current * highest, current * lowest) # И на минимальном произведении из двух. lowest_product_of_2 = min( lowest_product_of_2, current * highest, current * lowest) # Появилось ли новое максимальное число? highest = max(highest, current) # Появилось ли новое минимальное число? lowest = min(lowest, current) return highest_product_of_three
Сложность алгоритма — O(n) по времени выполнения и O(1) по памяти.
92. Представьте страну, где все родители хотят иметь мальчика. Каждая семья продолжает рожать детей до тех пор, пока у них не появляется мальчик, а затем останавливается. Каково соотношение мальчиков и девочек в этой стране?
Игнорируйте ситуации, когда рождаются двойняшки, тройняшки и так далее, пары, не имеющие детей, и пары, умершие до того, как у них появится мальчик.
Как обычно, предлагаем порассуждать над решением в комментариях. Проверить свой ответ можно на сайте по прикреплённой ссылке, там мы даём наш вариант решения.
Прежде всего, надо понять, что в каждой семье в этой стране, если родители хотят завести ребенка, есть или будет точно один мальчик. Почему? Потому, что каждая пара рожает детей до тех пор, пока у нее не появляется мальчик, а затем прекращает увеличивать численность своей семьи. Если говорить об исключении из рассмотрения рождения двойняшек, то здесь «мальчик» означает только одного мальчика. Семья становится полной, когда в ней появляется мальчик. Поэтому понятно: сколько полных семей, столько и мальчиков.
Однако в любой семье может быть любое количество девочек. Хороший способ для продолжения анализа — провести воображаемую перепись числа девочек. Представьте, что вы пригласили всех матерей в одно гигантское помещение и при помощи специальной системы общения с такой огромной аудиторией говорите: «Пусть каждая мать, у которой первый ребенок девочка, поднимет руку».
Естественно, это сделает половина женщин. Если матерей N, то руку поднимут N/2 женщин, и это число показывает, сколько девочек родились первыми. Отметьте на воображаемой доске это количество — N/2.
Затем скажите: «Пусть каждая мать, у которой второй ребенок девочка, поднимет или будет продолжать держать руку».
Половина поднятых рук опустится, и никаких новых рук не поднимется. (У матерей, которые не подняли руку после первой просьбы, потому что их первый ребенок был мальчик, в семье всего один ребенок.) Это оставляет N/4 поднятых рук, из чего следует, что N/4 родившихся вторыми детей были девочками. Запишем эту цифру также на воображаемой доске.
«Пусть каждая мать, у кого третий ребенок девочка, поднимет руку или продолжит держать ее поднятой». Вы уже поняли рассматриваемый здесь подход. Продолжайте этот процесс до тех пор, пока поднятых рук вообще не останется. С каждой такой просьбой число рук снижается вдвое. Это дает известный числовой ряд:
(1/2 + 1/4 +1/8 + 1/16 + 1/32 + . ) х N
Сумма бесконечной серии таких чисел равна 1 (х N). Из этого следует, что число девочек равно числу семей (N) и равно числу мальчиков (или очень близко к этому). Поэтому интересующее нас соотношение мальчиков и девочек составляет 1 к 1. В итоге соотношение будет вообще равным.
Задачи на прикидку, то есть подразумевающие приближенное решение — популярный класс задач, которые предлагают на собеседованиях в IT компании. Предлагаем вам несколько таких задач, а также рассказ об общих методах их решения и конкретные советы для собеседований.
Для решения некоторых задач требуются вычисления высочайшей точности. Однако множество других задач допускает приближенное решение. Физики гордятся тем, что могут быстро ответить на вопросы, требующие ответа «с точностью до порядка», делая приближенные оценки, основанные на здравом смысле. Задачи такого рода обычно называют задачами Ферми — по имени великого физика Энрико Ферми, который обладал величайшим искусством не только ставить подобные задачи, но и быстро и изящно их решать.
Задачи Ферми являются весьма действенным способом тренировки реальной применимости знаний человека на практике, а также способности быстро находить способы решения любой жизненной задачи. Современное образование часто предлагает знания, имеющие общий или абстрактный характер. Студенты и школьники часто способны решать сложные типовые задачи, совершая множество операций, а когда речь заходит о том, чтобы решить элементарную, но нестандартную задачу, они впадают в ступор.
Так как часто ответ задач Ферми представляет сомнительный практический интерес, главный акцент делается именно на метод решения. Поэтому задачи Ферми нашли свое применение на различных собеседованиях в крупные компании, конкурсах, интеллектуальных играх, олимпиадах по физике или по информатике. Суть использования задач сводится к тому, чтобы увидеть способность человека к поиску нестандартных решений.
Итак, рассмотрим несколько таких задач.
93. Сколько флаконов шампуня производится в мире за год?
Люди из богатых стран используют несколько флаконов шампуня. Многие жители развивающихся стран не могут себе позволить такую роскошь, как шампунь. Вы можете вполне обоснованно предположить, что в среднем там в год тратится одна бутылочка на человека (если только вы не проходите собеседование в Procter and Gamble, то интервьюер и сам не знает точного ответа). При этих допущениях ответ будет таким: за год производится столько бутылочек шампуня, сколько людей в мире, то есть 6 миллиардов.
Удобная подсказка: при оценке потребления популярных потребительских продуктов трудно сильно промахнуться. В своих рассуждениях исходите из того количества, которое вы потребляете сами, а затем вносите требуемые корректировки. Ваша итоговая оценка не будет сильно отличаться от истинного значения, и именно это от вас и хотят услышать.
94. Сколько насечек на ребре четвертака — монеты в 25 центов?
Диаметр четвертака около одного дюйма (2,54 см). Длина его окружности составляет π (3,14159…), умноженное на диаметр. Для простоты будем считать, что она равна 3 дюймам. Оставшаяся неясная часть для расчетов — количество насечек, приходящееся на один дюйм. Давайте оценим их число. Их больше 10 и, вероятно, меньше 100. Возьмем в качестве возможного варианта 50 и умножим это число на 3. Тогда ответ составит 150 насечек. Фактическое число насечек на американском четвертаке — 119, и их вполне обоснованно иногда называют поры. Они первоначально наносились на золотые монеты, чтобы мошенника не обрезали драгоценный металл с краев монеты. Так вот почему этот вопрос задают претендентам в Deloitte, аудиторский компании, входящей в «большую четверку» ведущих аудиторских организаций мира!
95. Сколько будет 2 в 64 степени?
Приведём один из вариантов возможных рассуждений. Любой инженер знает, что 2 10 = 1024. Будем считать, что это приблизительно 1000. Умножим 2 10 на себя шесть раз и получим 2 60 . Это около 1000 в шестой степени или 10 18 , также известное как квинтиллион. Осталось только умножить его на 2 4 (16), чтобы получить искомое 2 64 . Таким образом, очень приблизительный, но быстрый ответ будет 16 квинтиллионов.
На самом деле, чуть больше, т.к. 1024 на 2,4% больше 1000. Мы используем это приближение 6 раз, и поэтому ответ должен быть на более, чем 12% больше. Это добавляет еще 2 квинтиллиона. Поэтому более точно будет 18 квинтиллионов.
Точное значение: 18 446 744 073 709 551 616
Есть еще один быстрый хак. Многие знают, что максимальное число 32-битного unsigned int — это что-то около 4 миллиардов т.е. 2 32 ≈ 4х10 9 . Осталось только умножить это само на себя и получить около 16—17 квинтиллионов.
96. Сколько туалетной бумаги потребуется, чтобы покрыть ею весь штат?
Площадь куска туалетной бумаги приблизительно равна 4 на 4 дюйма (около 10 на 10 см). Девять кусочков, положенные в виде квадрата 3 на 3, составляют квадратный фут. Чтобы облегчить расчеты, будем считать, что 10 листочков составляют квадратный фут. Сколько их в рулоне туалетной бумаги? Может быть, там 300 отдельных листочков? Тогда в рулоне около 30 квадратных футов. Возможно, вы знаете, что в миле 5280 футов. Округлите эту цифру. Пусть она будет равна 5 тысячам футов. Поэтому квадратная миля составляет 5 тысяч на 5 тысяч футов или 25 миллионов квадратных футов. Число рулонов туалетной бумаги, необходимой, чтобы покрыть квадратную милю, составит 25 миллионов, деленных на 30. Что такое 25 для вопросов категории Ферми — это практическое то же самое, что и 30. Будем считать, что для покрытия квадратной мили нужен миллион рулонов.
Представим, что собеседование вы проходите в Техасе. Протяженность США (без Аляски и Гавайев) с запада на восток примерно 2500 миль. Можно достаточно обоснованно предположить, что площадь Техаса — 500 на 500 миль. Разумеется, Техас не квадратный, но представим его таким. Поэтому площадь Техаса примерно равна 500 х 500 миль = 250 тысяч квадратных миль. Чтобы покрыть весь Техас туалетной бумагой, вам потребуется 250 тысяч х 1 миллион рулонов, то есть всего-навсего 250 миллиардов рулонов.
97. Сколько молекул резины стираются с шины автомобильного колеса при каждом его обороте?
В формулировке задачи нет цифровых данных. С чего же начать?
Мы настолько привыкли выдергивать из условия задачи цифры и немедленно начинать с ними работать… Правда, работа эта зачастую заключается в полубессмысленном перемножении – делении – сложении – вычитании, что назвать это работой как-то язык не поворачивается. Тем не менее, такая привычка есть. Тем лучше. Значит, наша задача с первых же минут заставляет задумываться не над арифметическими действиями, а непосредственно над самой ситуацией, описанной в условии. Итак, мы должны сами задать исходные данные – радиус покрышки, суммарную массу резины и так далее.
Конечно, это некоторым образом вымышленные, приближенные данные. Правомерен вопрос: сможем ли мы на их основе получить точный ответ? Если под словом «точный» понимать ответ, близкий к истине, то нет, не можем. Но в задачах такого рода под точностью понимается результат по порядку величины и поэтому нам незачем штангенциркулем мерить диаметр колеса, пытаясь задать его с точностью до миллиметра. Вполне достаточно взять приближенную величину; главное – не ошибиться в порядке. Впрочем, сделать это довольно трудно. Действительно, любому здравомыслящему человеку ясно, что, например, радиус колеса автомобиля (для определенности возьмем легковой автомобиль) не может быть равен 100 метров, 10 метров и даже 1 метр. Он находится между 0,1 и 1 метром, то есть по порядку величины равен 0,1 = 10 -1 . А для оценки совсем неважно, выберем ли мы для расчетов значение 0,2 или 0,3 – их порядок одинаков. Следовательно, такой выбор не отразится на порядке результата, то есть на точности оценки.
Ладно, с этим разобрались. Каков же будет план наших действий? Сначала мы определим объем резины, который стирается с шины, затем разделим его на объем молекулы – и получим необходимый результат. Пусть так. Но вы представляете себе, как определить объем стираемой резины? Даже один оборот? Да еще сидя за столом, а не бегая с аптечными весами вокруг автомобиля? Казалось бы, это практически невозможно. Но Вы сами знаете: сказать, что ответа нет гораздо проще, нежели попытаться его найти. Мы всегда будем выбирать второй путь: он труднее, но и интереснее. Давайте поступим так. Определим объем резины, которая была стерта с колеса за все время его эксплуатации и разделим его на количество оборотов колеса за это время. Получим искомый объем стертой за 1 оборот резины.
98. Cколько денег понадобится на мытье всех окон в Сиэтле?
Развитие умения измерять неизвестное и мыслить абстракциями может здорово помочь программисту. На собеседованиях в крупные компании вас очень часто могут попытаться подловить на неумении оперировать большим количеством неизвестных данных, поэтому лучше потренироваться заранее.
История знала немало личностей, способных «объять необъятное». Один из них — Энрико Ферми, лауреат Нобелевской премии по физике, который учил своих студентов измерять на примере оценки числа настройщиков пианино в Чикаго. С тех пор задачи, в которых нужно оценить что-то «с точностью до порядка» основываясь на здравом смысле, называют в его честь — задачи Ферми. У нас на сайте есть целая подборка подобных задач, и ниже мы рассмотрим ещё одну:
Какую цену Вы установили бы за мойку всех окон в Сиэтле?
Для начала нужно сделать первый шаг — оценить численность населения в Сиэтле. По данным бюро переписи населения США, она составляет 594 тысяч человек. Впрочем, на собеседовании никто не возмутится, если вы скажете, что численность Сиэтла — примерно около миллиона.
Сколько окон приходится на каждого жителя этого города? В Манхэттене молодые люди считают, что им повезло, если у них есть одно окно на каждого. В Сиэтле ситуация другая: там квартиры побольше, и многие люди живут в домах с панорамными окнами, выходящими на вечнозеленые леса. Многие дома, в том числе и в городе, двухэтажные. Можно предположить без особой натяжки, отдавая предпочтение удобным круглым цифрам, что на каждого жителя Сиэтла приходится 10 окон.
Окна есть и там, где люди работают, а также в кофейнях, универмагах, аэропортах, концертных залах и других зданиях общественного назначения. Их число, скорее всего, добавляют не слишком много окон в расчете на каждого жителя. На типичном рабочем месте — разделенном перегородками — окон вообще нет. Магазины занимают 1 этаж, и в них относительно немного окон по сравнению с объемом. Окна в публичных зданиях, вроде ресторанов и аэропортов, приходятся на огромную массу людей, которые ими пользуются.
Не забудьте окна в автомобилях (лучше спросить интервьюера, стоит ли их считать). В автомобиле как минимум четыре окна, а часто вдвое больше. Но огромные внедорожники предназначены для больших семей и поэтому добавляют не слишком много окон в расчете на одного человека.
Не будет необоснованным считать, что, помимо окон в жилых домах, на каждого человека в городе добавляется еще 10 окон. Таким образом, мы приходим к 20 окнам на каждого жителя Сиэтла.
Предполагая, что население составляет миллион человек, получаем, что в городе примерно 20 миллионов окон, которые надо привести в порядок.
Сколько вы взяли бы сами за одно окно? Если говорить об окне в вашем доме, то потребуется несколько пшиков чистящего средства, несколько бумажных полотенец и несколько секунд работы.
Отдельные окна в Сиэтле огромные и находятся очень высоко. Тут нужны специалисты иного рода, специальное оборудование, специальные расценки и разумный подход.
Некоторые могут, вероятно, вымыть одну сторону обычного окна за минуту и будут отталкиваться от этого времени как минимально требуемого. Это означает, что на одно окно придется две минуты. При такой скорости за час можно справиться с 30 окнами.
Скажем, средний мойщик зарабатывает 10 долларов в час. Добавьте еще 5 долларов в час на моющие принадлежности и страховку. Таким образом, за 15 долларов в час можно сделать чистыми 30 окон. Стоимость очистки окна — 50 центов. 20 миллионов окон, умноженные на 50 центов, дают 10 миллионов в долларах.
Этот вопрос задают и в Amazon, и в Google. Если вы еще не уловили скрытого подтекста, вот он: Windows (окна в переводе) — это зарегистрированный торговый знак еще одной известной компании. Угадайте, какой.
Также смотрите примеры других задач для самостоятельного решения.
99. Задача, которую давали на собеседованиях в Apple. От вас требуется написать функцию, которая возвращает максимальную прибыль от одной сделки с одной акцией (сначала покупка, потом продажа). Исходные данные — массив вчерашних котировок stock_prices_yesterday с ценами акций Apple.
Информация о массиве:
Например: если акция в 10:00 утра стоила 20 долларов, то stock_prices_yesterday[30] = 20 .
Допустим, имеем некоторые условия:
stock_prices_yesterday = [10, 7, 5, 8, 11, 9] profit = get_max_profit(stock_prices_yesterday) #вернет 6 (купили за 5, продали за 11)
Массив может быть любым, хоть за весь день. Нужно написать функцию get_max_profit как можно эффективнее — с наименьшими затратами времени выполнения и памяти.
Для решения задачи недостаточно просто взять максимальную и минимальную цены, так как вы сначала должны купить по самой низкой цене, а затем продать по самой высокой, которая будет после цены покупки. Кроме того, если цена акции падает весь день, то лучшим ответом будет отрицательное число.
Для каждой цены будем проверять:
Код решения (на Python):
def get_max_profit(stock_prices_yesterday): # убедимся, что количество цен в массиве превышает 2 if len(stock_prices_yesterday) < 2: raise IndexError('Получение прибыли требует как минимум двух цен в массиве') # инициализируем min_price и max_profit min_price = stock_prices_yesterday[0] max_profit = stock_prices_yesterday[1] - stock_prices_yesterday[0] for index, current_price in enumerate(stock_prices_yesterday): # пропустим 0-ой элемент массива, так как min_price инициализирован. # Также продавать в 0-й позиции нельзя if index == 0: continue # вычисляем потенциальную прибыль potential_profit = current_price - min_price # обновляем максимальную прибыль max_profit = max(max_profit, potential_profit) # обновляем минимальную цену min_price = min(min_price, current_price) return max_profit
Эффективность полученного алгоритма — O(n) по времени и O(1) по памяти. Цикл проходит по массиву только один раз.
100. Задача про слияние промежутков в календаре.
Предположим, компания, в которой вы работаете, разрабатывает электронный календарь. В календаре есть функция, показывающая, когда различные команды программистов будут заняты на какой-либо встрече.
Те периоды, когда команда занята, на календаре отмечены как диапазоны времени, например, с 10:00 до 12:30 или с 12:30 до 13:00. В разрабатываемой программе промежуток времени представлен в виде кортежей из двух целых чисел. Число означает номер 30-минутного блока, который идет после 9:00 утра. Например, кортеж (2, 4) означает диапазон с 10:00 до 11:00, а (0, 1) — это промежуток 9:00-9:30.
Вам нужно написать функцию, которая должна упростить вывод информации таким образом, что если команда занята в промежутках с 10:00 до 12:30 и с 12:30 до 13:00, то это отображалось как 10:00?13:00. Например: на входе вашей функции неупорядоченный массив из кортежей [(0, 1), (3, 5), (4, 8), (10, 12), (9, 10)], а на выходе вы должны получить упорядоченный массив [(0, 1), (3, 8), (9, 12)].
В будущем планируется внести изменения в программу, где вместо 30-минутных блоков будут минутные, как это реализовано в представлении Unix-времени. С учетом этого изменения нужно, чтобы ваша функция уже сейчас могла работать с большими числами. Еще не забудьте, что кортеж — это такой тип данных, в котором содержимое переменной невозможно изменять после ее создания.
Решений можно придумать много, но нам нужен максимально эффективный код. Для начала нужно отсортировать массив, так нам будет удобнее объединять соседние временные диапазоны, так как они будут друг за другом. Затем пройдемся по нашему массиву слева направо и на каждом шаге будем выполнять один из двух вариантов:
Также необходимо проследить за тем, чтобы последний сохраненный результат попал в выходной массив, так как не будет того же самого условия, как с предыдущими: отсутствие следующего диапазона, который не объединится с текущим.
Код решения на Python:
def merge_ranges(meetings): # сортируем входной массив, помещая его в sorted_meetings. sorted_meetings = sorted(meetings) # создаем выходной массив, пока что пустой. merged_meetings = [] previous_meeting_start, previous_meeting_end = sorted_meetings[0] for current_meeting_start, current_meeting_end in sorted_meetings[1:]: # Если текущий диапазон может быть объединен с предыдущим. if current_meeting_startСложность алгоритма — O(n lg n) по времени и O(n) по памяти. O(n lg n) получилось из-за того что помимо одного прохода по массиву, мы перед этим его сортировали.
101. Задача, которую давали на собеседованиях в Apple. Представьте, что вы получили работу кассира в магазине. Ваш босс случайно выяснил, что вы обладаете навыками программиста, и захотел, чтобы вы помогли ему написать программу.
Нужно написать функцию, которая на выходе выдаст количество всех возможных способов получить указанную сумму денег при помощи различных доступных номиналов монет. Например, если вам нужно получить 4 цента из монет номиналами 1, 2 и 3 цента, то функция вернет 4 — именно столько есть возможных комбинаций из чисел 1, 2 и 3, чтобы получить в сумме 4:
Мы используем динамическое программирование, чтобы создать массив ways_of_doing_n_cents таким образом, что ways_of_doing_n_cents[k] содержит значение количества способов собрать сумму k, используя доступные номиналы. Для начала мы начнем с отсутствия номиналов, имея лишь один вариант — собрать сумму 0, затем мы будем добавлять по одному номиналу, по возрастанию, и одновременно редактировать наш массив с учетом новых номиналов.
Количество новых вариантов, которыми мы можем сделать сумму higher_amount с учетом нового номинала монеты coin, вычисляется как уже существующее значение ways_of_doing_n_cents[higher_amount - coin]. Нам уже известны все комбинации с предыдущими номиналами, поэтому мы используем эту информацию при добавлении нового номинала. При добавлении первого номинала, мы считаем, что предыдущий номинал равен 0.
Код решения на Python:
def change_possibilities_bottom_up(amount, denominations): ways_of_doing_n_cents = [0] * (amount + 1) ways_of_doing_n_cents[0] = 1 for coin in denominations: for higher_amount in xrange(coin, amount + 1): higher_amount_remainder = higher_amount - coin ways_of_doing_n_cents[higher_amount] += ways_of_doing_n_cents[higher_amount_remainder] return ways_of_doing_n_cents[amount]Чтобы было понятнее, вот что содержит массив ways_of_doing_n_cents по мере выполнения итераций, при этом сумма равна 5 и номиналы равны 1, 3 и 5:
=========== key: a = higher_amount r = higher_amount_remainder =========== ============ for coin = 1: ============ [1, 1, 0, 0, 0, 0] r a [1, 1, 1, 0, 0, 0] r a [1, 1, 1, 1, 0, 0] r a [1, 1, 1, 1, 1, 0] r a [1, 1, 1, 1, 1, 1] r a ============ for coin = 3: ============= [1, 1, 1, 2, 1, 1] r a [1, 1, 1, 2, 2, 1] r a [1, 1, 1, 2, 2, 2] r a ============ for coin = 5: ============= [1, 1, 1, 2, 2, 3] r a final answer: 3Сложность алгоритма — O(n*m) по времени и O(n) по памяти, где n — это сумма, а m — количество различных номиналов.
102. Эту задачу когда-то давали в Google.
Вам нужно подняться по лестнице. За один раз можно подняться на одну или две ступеньки. Сколько существует способов добраться до N-й ступеньки?
Начало здесь простое. Вы стоите на лестничном марше и хотите подняться на первую ступеньку — № 1. Для этого надо сделать всего одно действие — подняться на одну ступеньку вверх. Теперь давайте рассмотрим вторую ступеньку, то есть N = 2. Чтобы подняться на неё, имеются два варианта. Вы можете сделать два шага — по одной ступеньке за раз или сразу подняться на вторую ступеньку.
Это практически вся информация, которая нужна вам для решения этой задачи. Чтобы понять, почему, представьте, что вашей целью является ступенька № 3. Впервые в этой ситуации вы не можете попасть на неё одним движением. здесь потребуется комбинация шагов. Существует только два способа попадания на ступеньку № 3: либо в виде короткого одиночного шага (со ступеньки № 2), либо двойного шага (со ступеньки № 1). Мы уже знаем, что для подъема на ступеньку № 1 имеется лишь один вариант. Мы также знаем, что есть всего два способа подняться на ступеньку № 2. Сложите эти варианты (1 + 2 = 3), и вы получите число способов, позволяющих подняться на ступеньку № 3.
Та же самая логика применяется для подъема на каждую следующую ступеньку. Существует два способа, чтобы подняться на ступеньку № 4 — со ступеньки № 2 или со ступеньки № 3. Добавьте число способов подъема на ступеньку № 2 (2) к числу способов, позволяющих оказаться на ступеньке № 3 (3). Это даёт 5 вариантов — число способов, позволяющих оказаться на ступеньке № 4.
Легко продолжить эту серию и дальше. С увеличением числа ступенек число способов подниматься по ним нарастает, как снежный ком, что можно представить в следующем виде:
Любому человеку с математической подготовкой нижняя серия покажется до боли знакомой. Так оно и есть. Это последовательность Фибоначчи. (Чуть подробнее о ней ниже.) Интервьюер хочет получить ответ для общего случая из N ступенек.
Это просто число Фибоначчи под номером N. Леонардо Фибоначчи, также известный как Леонардо Пизанский, был самым влиятельным итальянским математиком в Средние века. Именно Фибоначчи понял невероятное превосходство арабскo-индийской позиционной системы исчисления по сравнению с римским обозначением цифр, которое все ещё использовалось в средневековой Европе. При помощи арабско-индийской системы умножение и деление можно было свести к алгоритму (еще одно арабское слово). При применении римских чисел эти операции на практике выполнять было сложно. Торговцам приходилось приглашать экспертов и дорого им платить за вычисления, которые те осуществляли при помощи абаков. В 1202 году Фибоначчи написал Liber abaci — руководство по использованию абака, в котором он расхваливал арабские числа своим читателям, которые были, скорее всего, настроены к ним скептически. В этой книге также описывается и та серия чисел, которую мы теперь называем по его фамилии. Однако её изобрел не Фибоначчи. Эта последовательность была известна еще индийским ученым, жившим в VI веке.
Напишите 1, а затем добавьте еще 1 рядом. Сложите их и получите сумму (2), которая затем добавляется к формируемой последовательности:
Для получения каждого нового члена лишь складывайте последние два числа в ряду/ Серия примет следующий вид.
1 1 2 3 5 8 13 21 34 55 89 144 …
Поклонники теории заговоров отыскивают серии Фибоначчи в самых неожиданных местах. Хотите перевести расстояние из миль в километры? Воспользуйтесь соседними числами Фибоначчи (55 миль в час = 89 километров в час). В следующий раз, когда у вас окажется свободное время, посчитайте небольшие дольки, из которых состоит кожура ананаса, и вы обнаружите, что они образуют два накладывающихся друг на друга набора спиралей, идущих в противоположных направлениях. В одной из них восемь долей, в другой тринадцать. Оба этих числа относятся к серии Фибоначчи. Аналогичные закономерности можно увидеть в сосновых шишках, подсолнухах и артишоках. Случайность? Вряд ли, если учесть тот факт, что последовательность Фибoначчи проявила себя и в Коде Да Винчи (в виде комбинации для вскрытия сейфа), и в этом вопросе на собеседовании, который задают в компании, стремящейся к информационному доминированию во всем мире (Google, если вы не поняли).
103. Эту задачу задавали на собеседовании в Twitter.
Рассмотрим следующую картинку:
На этой картинке изображены стены различной высоты в некотором плоском мире. Картинка представлена массивом целых чисел, где индекс — это точка на оси X, а значение каждого индекса — это высота стены (значение по оси Y). Картинке выше соответствует массив [2, 5, 1, 2, 3, 4, 7, 7, 6].
Теперь представьте, что начался дождь, который не прекращается и поливает стены сверху равномерным потоком. Сколько воды соберется в «лужах» между стенами?
Единицей объема воды считаем квадратный блок 1x1. На картинке выше всё, что расположено слева от точки 1, выплескивается. Вода справа от точки 7 также прольется. У нас остается лужа между 1 и 6 — таким образом, получившийся объем воды равен 10.
Первый вариант решения (неверный)
Можно предположить, что нужно найти локальные максимумы и подсчитать пространство между ними, заполненное водой. Алгоритм будет довольно простой, но ответ на самом деле некорректен.
Решение будет таким:
Хотя на самом деле должно быть таким:
Правильный вариант решения
Если мы проходим по списку слева направо, количество воды в каждом индексе будет не больше абсолютного максимума, который мы обнаружим заранее. Это означает, что если мы точно знаем, что есть что-то большее или равное где-то справа, то мы можем точно определить, сколько воды мы можем удержать без выплескивания. То же справедливо и для противоположного направления: если мы знаем, что нашли слева стену выше самой высокой в правой части, то это означает, что мы с уверенностью можем заполнить ее водой.
Итак, теперь решение выглядит следующим образом: найти абсолютный максимум, после чего пройти слева до максимума и затем пройти справа до максимума. Это решение требует два прохода: один для поиска максимума, и второй — разбитый на две части.
Решение в приведенном ниже коде работает в один проход, избегая поиска максимума проходом двух «указателей» навстречу друг другу с противоположных концов массива. Если наибольшее значение, найденное слева от левого указателя меньше, чем наибольшее значение найденное справа от правого указателя, то мы сдвигаем левый указатель на один индекс вправо. В противном случае, двигаем правый указатель на один индекс влево. Повторяем до тех пор, пока два указателя не пересекутся. (На словах звучит запутанно, код на самом деле очень простой).
Вариант реализации на Java
/* package whatever; // don't place package name! */ import java.util.*; import java.lang.*; import java.io.*; /* Name of the class has to be "Main" only if the class is public. */ class Ideone < public static void main (String[] args) throws java.lang.Exception < int[] myIntArray = ; System.out.println(calculateVolume(myIntArray)); > public static int calculateVolume(int[] land) < int leftMax = 0; int rightMax = 0; int left = 0; int right = land.length - 1; int volume = 0; while(left < right) < if(land[left] >leftMax) < leftMax = land[left]; >if(land[right] > rightMax) < rightMax = land[right]; >if(leftMax >= rightMax) < volume += rightMax - land[right]; right--; >else < volume += leftMax - land[left]; left++; >> return volume; > >Для тех, кто предпочитает Gist.
104. Задача про бесконечный поезд.
Представьте себе замкнутую по окружности железную дорогу. По ней едет поезд, последний вагон которого скреплён с первым так, что внутри можно свободно перемещаться между вагонами. Вы оказались в одном случайном вагоне и ваша задача — подсчитать их общее количество. В каждом вагоне можно включать или выключать свет, но начальное положение переключателей случайное и заранее неизвестно.
Все вагоны внутри выглядят строго одинаково, окна закрыты так, что невозможно посмотреть наружу, движение поезда равномерное. Помечать вагоны как-либо, кроме включения или выключения света, нельзя. Количество вагонов конечно (не верьте названию задачи).
Предложим один из возможных вариантов решения. Вам нужно включить свет в начальном вагоне, в котором вы находитесь, если он ещё не горит. Затем пойти в одну любую сторону до тех пор, пока не встретите вагон с работающим освещением, при этом обязательно считать пройденные вагоны. Выключаете в найденном вагоне свет и идёте обратно к начальному. Если в нём свет всё ещё горит, то повторяете операцию. Если же нет, значит вы прошли полный круг и знаете ответ.
С таким же успехом можно, например, ходить по сторонам от начального вагона на равные расстояния, постепенно их увеличивая, и инвертировать в них свет. То есть если считать, что сначала вы в вагоне с номером 0, то ходить надо в -1, 1, -2, 2, -3, 3 и так далее. Если при этом запоминать состояние самого дальнего вагона, то при повторном прохождении мимо него вы заметите изменившийся свет, если круг замкнётся. А зная длину пути в обе стороны, вы легко вычислите общее количество вагонов.
105. Вы стоите перед закрытой комнатой, в которой есть три лампочки. На стене перед вами три переключателя: каждый из которых включает или выключает одну из лампочек. Вам нужно узнать, какой переключатель к какой лампочке относится, при условии, что зайти в комнату вы можете только один раз.
Расположение переключателей случайное, порядок подключения заранее неизвестен. Зайдя в комнату, можно делать с лампочками всё, что угодно, но уже нельзя вернуться к переключателям. Изначально все лампы выключены.
Если вы хотите решить задачу самостоятельно, но в голову ничего не приходит, можете воспользоваться нашей подсказкой.
Посмотреть подсказку Свернуть
У лампочек при начальных условиях есть только два состояния: горит или не горит. Понятно, что этого недостаточно, чтобы разделить их на три группы. Вам нужно придумать какие-то ещё состояния лампочек и способ их добиться переключателями.
Или смотрите сразу ответ Свернуть
Рассуждая логически, вы можете включить одну лампу, вторую выключить, а вот что делать с третьей — непонятно. Состояний лампы всего два: либо «включена», либо «выключена». Самый популярный способ решения состоит в том, чтобы в качестве третьего состояния добавить разделение ламп на «теплые» и «холодные». Нужно подождать какое-то время, чтобы лампы остыли на случай, если они недавно включались. Затем включить одну для нагревания. Выключить её обратно и включить любую другую. Зайдя после этого в комнату одна лампа будет гореть, вторая выключена и холодная, третья выключена и горячая.
Другой вариант добавить лампам состояние «перегорела», если есть возможность подать на переключатель большее напряжение, чем нужно. Дальше действовать аналогично предыдущей схеме.
Также в комментариях к статье предложили добавить к одной из лампочек управляемое реле и заставить её мигать. Если у вас есть другие варианты, пишите в комментариях.
106. Классическая задача. Найдите в данной вам строке максимальную по длине подстроку, которая является палиндромом (то есть читается слева направо и справа налево одинаково). Предложите как можно более эффективный алгоритм.
Решение за О(n²) и О(1) памяти: перебор
Очевидное квадратичное решение приходит в голову практически сразу. У каждого палиндрома есть центр: символ (или пустое место между двумя соседними символами в случае палиндрома четной длины), строка от которого читается влево и вправо одинаково. Например, для палиндрома abacaba таким центром является буква c, а для палиндрома colloc — пространство между двумя буквами l. Очевидно, что центром нашей искомой длиннейшей палиндромной подстроки является один из символов строки (или пространство между двумя соседними символами), в которой мы производим поиск.
Теперь мы можем реализовать такое решение: давайте переберем все символы строки, для каждого предполагая, что он является центром искомой самой длинной палиндромной подстроки. То есть предположим, что на данный момент мы стоим в i-ом символе строки. Теперь заведем две переменных left и right , изначально left = i - 1 и right = i + 1 для палиндромов нечетной длины и i - 1 , i соответственно для палиндромов четной длины. Теперь будем проверять, равны ли символы в позициях строки left и right . Если это так, то уменьшим left на 1, а right увеличим на 1. Будем продолжать этот процесс до тех пор, пока символы в соответствующих позициях станут не равны, или же мы не выйдем за границы массива. Это будет означать, что мы нашли самый длинный палиндром в центре с i -ым символов в случае для палиндрома нечетной длины и в пространстве между i -ым и i - 1 -ым символом в случае палиндрома четной длины. Выполним такой алгоритм для всех символов строки, попутно запоминая найденный максимум, и таким образом мы найдем самую длинную палиндромную подстроку всей строки.
Докажем, что это решение работает за O(n²). Рассмотрим строку ааааааааааааааа… Для каждого ее символа мы будем двигать left и right, пока не выйдем за границы массива. То есть для первого символа мы сделаем 0*2 (умножение на 2 происходит, потому что мы выполняем алгоритм два раза — для палиндромов нечетной и четной длины) итераций, для второго 1*2, для третьей 2*2, и т.д. до центра, потом кол-во итераций станет уменьшаться. Это арифметическая прогрессия с разностью 2. Рассмотрим сумму этой арифметической прогрессии до середины строки. Как известно, сумма арифметической прогрессии имеет формулу (A1+An)/2*n. В нашем случае A1 = 0, An = n/2*2 = n. (0+n)/2*n = n/2*n = O(n²). Для убывающей части все аналогично, там тоже получится O(n²). O(n²)+O(n²) = O(n²), ч.т.д.
Решение за О(n log n) по времени и О(n) памяти: полиномиальный хэш + бинпоиск
Это решение является ускоренной модификацией предыдущего. Можно посчитать для строки полиномиальный хеш, замечательным свойством которого является то, что мы можем за О(1) получить хеш любой подстроки, а значит, посчитав его для оригинальной и перевернутой строки мы можем за О(1) проверить, является подстрока [l..r] палиндромом (реализацию можно найти здесь). Следующее замечание состоит в том, что для каждого центра при переборе подстрока на некотором количестве итераций сначала будет являться палиндромом, а затем всегда нет. А это значит, что мы можем воспользоваться бинпоиском: переберем все символы, для каждого бинпоиском найдем максимальную палиндромную подстроку с центром в нем, по ходу дела будем запоминать найденный максимум.
Очевидно, что это решение работает за О(n log n) по времени. Мы перебираем все n символов, для каждого совершаем O(log n) итераций бинпоиска, на каждой из который проверяем, является ли подстрока палиндромом. В итоге: O(n log n) по времени и О(n) по памяти (потому что нам наобходимо хранить посчитанные хеши).
Решение за О(n) времени и O(n) памяти: алгоритм Манакера
Несправедлимым будет не упомянуть в этой статье алгоритм Манакера, решающий поставленную задачу за линейное время и линейную память.
107. Реализуйте функцию извлечения квадратного корня, не пользуясь встроенными в язык средствами нахождения корня и возведения в степень.
Из курса школьной математики мы помним, что функция квадратного корня является возрастающей на всей своей области определения (если вы этого не помните или вам это не очевидно, можете взять производную и убедиться, что она больше нуля), а значит, мы можем воспользоваться алгоритмом бинарного поиска.
Допустим, что нам нужно извлечь квадратный корень из числа x. Установим левую границу бинпоиска на 0 , а правую — на max(1, x) . Таким условием мы учтем все возможные случаи: на отрезке 0..1 корень из числа больше самого числа, на отрезке 1..inf — меньше).
Теперь найдем среднее арифметическое границ, назовем его m , и проверим, больше ли m * m , чем x . Если да, то искомый ответ лежит на числовой прямой левее m , а значит, необходимо сделать m правой границей бинпоиска, иначе — левой. Спустя пару сотен таких итераций мы найдем квадратный корень с удовлетворяющей всем потребностям точностью.
Бонус с повышенной сложностью
Реализуйте подобным образом функцию для поиска корня n-ной степени.
108. В этой задаче вам необходимо реализовать функцию, которая бы проверяла число на четность, используя только битовые операции AND, OR, NOT.
Заметим, что число x нечетно только тогда, когда самый младший (то есть первый справа) бит в его двоичной записи равен 1. Докажем это. Вспомним знакомый со школьной статьи алгоритм перевода числа из двоичной системы в десятеричную. Он показан на следующей картинке:
Мы можем вынести два за скобку из всех слагаемых, кроме последнего, которое может принимать значение либо 1, либо 0. Таким образом, если оно равно нулю, то сумма будет иметь вид 2(…) = x, то есть будет делиться на два, а если оно будет равно единице, то сумма будет иметь вид 2(…)+1 = x, то есть не будет делиться на два. Это является критерием четности. Ч.т.д.
Итак, мы доказали факт того, что число нечетно, когда его младший бит равен 1, и четно, когда младший бит равен 0. Остался вопрос: как получить последний бит числа. Утверждение: последний бит числа x равен x&1, где & — побитовое И. Почему это так? И равно 1 только когда оба его аргумента равны 1. Число 1 в двоичной системе счисления имеет следующий вид: …000001 (в зависимости от того, скольки битными числами мы оперируем). А значит, при побитовом И единицы с числом х у результата все биты, кроме последнего, будут равны нулю, а последний бит будет равен 1, если в числе x он был равен 1 (1&1 = 1), и 0, если в числе x он был 0 (0&1 = 0).
Таким образом, значение выражения x&1 равно 1, если число x нечетное, и 0, если x четное.
109. На прямой даны N отрезков (в реальной жизни это могут быть промежутки времени, например), которые заданы координатами их левого и правого конца. Для каждого данного отрезка необходимо узнать, сколько из данных отрезков полностью находятся в нем. Один отрезок полностью содержится во втором, если левый конец первого отрезка находится правее левого конца второго отрезка, а правый конец первого находится левее правого конца второго. Предложите как можно более эффективный способ решения этой задачи. Гарантируется, что все концы данных отрезков различны.
Если вы придумали решение, то написать и проверить его вы можете здесь, на codeforces.
Сможете ли вы решить эффективно данную задачу в случае, если концы отрезков могут совпадать?
Решение за О(n 2 ) (полный перебор)
Давайте для каждого отрезка из набора перебером найдем все отрезки, для которых выполняется условие «вложенности». Если да, то увеличим ответ для текущего рассматриваемого нами отрезка на единицу. Несложно понять, что данное решение работает за O(n 2 ): для каждого из N отрезков мы перебираем N отрезков. Можно ли быстрее? Да!
Решение за О(n log n) (сортировка + структуры данных)
Отсортируем все отрезки по левому концу и будем рассматривать их в уже отсортированном порядке. Вспомним условие «вложенности»: левый конец первого отрезка правее левого конца второго отрезка, и правый конец первого отрезка левее правого конца второго отрезка. Несложно понять, что благодаря отсортированности все левые концы еще нерасмотренных отрезков будут правее левого конца рассматриваемого отрезка. Таким образом, все нерасмотренные отрезки потенциально являются вложенными в рассматриваемый: ведь для них уже выполняется одно из двух условий «вложенности» (про левые концы). Осталось узнать, сколько из них действительно являются таковыми — для этого нужно понять, сколько из нерассмотренных отрезков имеют правый конец левее правого конца рассматриваемого отрезка.
Для этого будем поддерживать структуру данных, которая может добавить и удалять из себя числа и отвечать на запросы вида: «сколько чисел во мне меньше X?», причем все операции должны выполняться за O(log n). Такой структурой данных может быть, например, декартово дерево, дерево Фенвика, дерево отрезков, или tree из ext/pb_ds/detail/standard_policies.hpp (если вы пишете на С++). Перед выполнением алгоритма для решения задачи сложим в нашу структуру координаты всех правых концов отрезков.
Теперь, чтобы узнать сколько из нерассмотренных отрезков имеют правый конец левее правого конца рассматриваемого отрезка, достаточно просто осуществить запрос к структуре данных «сколько чисел в тебе меньше, чем координата правого конца рассматриваемого отрезка». Ответ на этот запрос и будет ответом для рассматриваемого на данный момент нами отрезка. После запроса необходимо убрать координату правого конца отрезка из структуры данных, чтобы ответы для всех следующих отрезков были корректны: ведь левый конец рассматриваемого отрезка левее (благодаря отсортированности) левый концов всех еще нерасмотренных отрезков.
Докажем, что данное решение работает за О(n log n). Сортировка всех отрезков происходит за O(n log n), складывание всех правых концов отрезков в структуру данных за O(n log n), на стадии вычисления ответов мы рассмотрим n отрезков, для каждого из которых осуществим два запроса, оба из которых выполнятся за О(log n). Таким образом, вычисляем все ответы мы за O(n log n) с препроцессингом за O(n log n), а значит, и асимптотика всего решения O(n log n).
Повышаем сложность
Сможете ли вы решить эффективно данную задачу в случае, если концы отрезков могут совпадать?
110. Придумать алгоритм, определяющий, все ли символы в строке встречаются один раз.
При выполнении этого задания нельзя использовать дополнительные структуры данных.
Один из очевидных вариантов решения состоит в том, чтобы сравнить каждый символ строки с любым другим символом строки. Это потребует О(n 2 ) времени и О(1) памяти.
Если изменения строки разрешены, то можно её отсортировать (что потребует О(n log n) времени), а затем последовательно проверить строку на идентичность соседних символов. Будьте осторожны: некоторые алгоритмы сортировки требуют больших объёмов памяти.
Можно слегка оптимизировать задачу — возвращать false, если длина строки превышает количество символов в алфавите. В конце концов, не может существовать строки с 280 уникальными символами, если символов всего 256. Однако если это Unicode-строка, то такая оптимизация не очень поможет.
Наше решение заключается в создании массива логических значений, где флаг с индексом i означает, содержится ли символ алфавита i в строке. Если вы «наткнетесь» на этот же символ во второй раз, можете сразу возвращать false.
Код, реализующий этот алгоритм, представлен ниже:
public boolean isUniqueChars2(String str) < boolean[] char_set = new boolean[256]; for (int i = 0; i < str.length(); i++) < int val = str.charAt(i); if (char_set[val]) < //символ уже был найден в строке return false; >char_set[val] = true; > return true; >Оценка времени выполнения этого кода — О(n), где n — длина строки, оценка требуемого пространства — O(1).
Можно уменьшить использование памяти за счёт битового вектора. В следующем коде мы предполагаем, что в строке есть только символы в нижнем регистре a-z. Это позволит нам использовать просто одно значение типа int.
public boolean isUniqueChars(String str) < int checker = 0; for (int i = 0; i < str.length(); i++) < int val = str.charAt(i) - 'a'; if (checker & (1 0) < return false; >checker |= (1 return true; >Выбор лучшего решения нужно производить исходя из соответствующих дополнительных ограничений конкретной задачи.
111. В массиве случайных чисел A[0…n-1] задан один «волшебный» индекс: такой, что A[i] = i . Значения элементов в массиве повторяться не могут. Учитывая, что массив отсортирован по значениям в порядке возрастания, напишите метод, который определит этот «волшебный» индекс, если он существует в массиве A. Если элемента в массиве нет, верните любое отрицательное число.
Как изменится решение, если известно, что таких индексов в массиве несколько?
Можно решать такую задачу «в лоб», и в таком подходе нет ничего зазорного. Мы просто пройдемся по массиву и отыщем элемент, соответствующий условию.
public static int magicSlow(int[] array) < for (int i = 0; i < array.length; i++) < if (array[i] == i) < return i; >> return -i; >Но этому решению требуется обойти весь массив от начала до искомого элемента. Массив отсортирован, и, вероятно, мы должны этим воспользоваться.
Так задача становится похожа на классическую задачу бинарного поиска. Для алгоритма больше всего подходит способ «сопоставления с образцом».
При бинарном поиске мы берем элемент k и сравниваем его с элементом из середины массива, x , чтобы определить, по какую сторону от x находится искомого k — слева или справа. Давайте попробуем определить, где может находиться «волшебный» элемент на примере. Взгляните на массив (нижняя строка — индексы элементов):
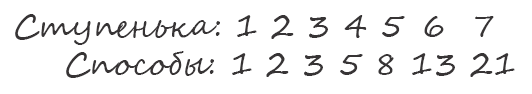
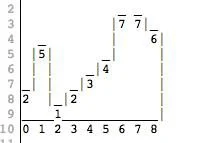
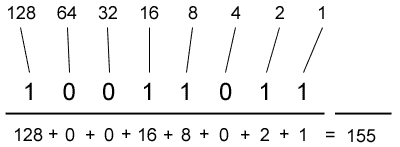
| -40 | -20 | -1 | 1 | 2 | 3 | 5 | 7 | 9 | 12 | 13 |
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
Если взять элемент из середины массива, A[5] = 3 , то становится ясно, что «волшебный» элемент должен находиться правее, так как A[mid] < mid . Почему в этой ситуации элемент не может быть слева? Индекс элемента в данном случае уже больше значения (5 >3) . Значит, все значения элементов с индексами 0-4 будут меньше самих индексов.
При движении в направлении от i к i-1 значение элемента будет уменьшаться не менее чем на 1 (так как массив отсортирован и не содержит одинаковых элементов). Если средний элемент меньше искомого, то при движении влево, смещаясь на k индексов и (как минимум) на k значений, мы будем попадать на еще более маленькие значения.
Наш алгоритм будет по такому принципу выяснять, где должен находиться искомый элемент — справа или слева, и проверять только одну половину массива. Этим мы сокращаем число итераций, необходимых для того, чтобы наткнуться на нужный элемент.
При использовании рекурсивного решения алгоритм похож на бинарный поиск.
public static int magicFast(int[] array, int start, int end) < if (end < start || start < 0 || end >= array.length) < return - 1; >// Индекс середины массива int mid = (start + end) / 2; if (array[mid] == mid) < return mid; >else if (array[mid] > mid) < return magicFast(array, start, mid - 1); >else < return magicFast(array, mid + 1, end); >> public static int magicFast(int[] array)
Дополнительно: как изменится решение, если таких индексов окажется несколько?
Если элементы массива повторяются, то наш алгоритм не будет работать. Давайте рассмотрим следующий массив:
| -10 | -5 | 2 | 2 | 2 | 3 | 4 | 7 | 9 | 12 | 13 |
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
Могут ли в этом массиве они находиться слева? Нет. Так как A[5] = 3 , мы знаем, что A[4] никак не может быть «волшебным» элементом. A[4] должен быть равен 4 , но в то же время мы знаем, что A[4] не может быть больше, чем A[5] , из-за условия отсортированности.
Фактически, если мы видим, что A[5] = 3 , нам достаточно проанализировать только правую сторону, как это и делалось раньше. Но чтобы найти элемент в левой части, можно пропустить группу элементов и произвести поиск только среди A[0] ‒ A[3] , где A[3] — это первый элемент, который может быть «волшебным».
В общем, нам нужно взять элемент из середины массива и сравнить его индекс с его же значением — midIndex с midValue . Если они совпадают, то возвращаем значение сразу. Иначе выясняем, больше или меньше значение элемента из середины его индекса. В зависимости от полученного результата начинаем искать либо слева, либо справа.
Если же переданы ошибочные параметры, пусть код возвращает -1 .
Представленный ниже код реализует данный алгоритм:
public static int magicFast(int[] array, int start, int end) < if (end < start || start < 0 || end >= array.length) < return -1; >// Находим индекс и значение из середины массива: int midIndex = (start * end) / 2; int midValue = array(midIndex); // Если они совпадают - решение найдено if (midValue == midIndex) < return midIndex; >/* Если индекс меньше значения - поиск влево */ int leftIndex = Math.min(midIndex - 1, midValue); int left = magicFast(array, start, leftIndex); if (left >= 0) < return left; >/* Если индекс больше - поиск вправо */ int rightIndex = Math.max(midIndex + 1, midValue); int right = magicFast(array, rightIndex, end); return right; > public static int magicFast(int[] array)
Этот код работает в том числе и для случая без дополнительного условия.
112. Как можно узнать количество дней в месяце, зная его номер? Другими словами, опишите, как получить функцию f(x), которая бы давала следующий список значений:

В качестве аргумента мы получаем только номер месяца, т.е. мы не учитываем високосные года, и f(2) = 28.
Если вы хотите узнать полученный мною результат, пролистните до конца этой страницы. То, что будет описано далее — это вывод искомой формулы.
Чем мы будем пользоваться
Кроме сложения, вычитания и умножения, я воспользуюсь двумя операциями: целочисленным делением и операцией взятия остатка. Напомню, что это такое:
Они имеют одинаковый приоритет и являются левоассоциативными.
Основы, или Правило со множеством исключений
Давайте попробуем найти такую закономерность, которая удовлетворила бы как можно большему количеству значений аргумента. Обычно количество дней в месяце колеблется между 30 и 31. При этом, можно заметить зависимость этого числа от четности месяца — значит, воспользуемся операцией взятия остатка по модулю 2. Кажется, это должно быть нечто, вроде:

Неплохой старт! Не обращая внимания на февраль, для которого явно придется пойти на какие-то уловки, порадуемся тому, что мы смогли подогнать функцию под первую половину года. А далее, начиная с августа, четность надо сменить на противоположную. Сделать это можно, заменив x%2 в первом варианте формулы на (x+1)%2:

Как и ожидалось, теперь первая половина года уже вне области правильных значений, зато месяцы с августа по декабрь дали то, что надо. Найдем способ объединить две эти части.
Маска
Нам нужно, чтобы +1 в делимом «активировалось» только при достижении аргументом значений, больших 8, т.е. нам необходимо применить некоторую маску. При этом значения аргумента не могут превосходить 12. Значит, нам идеально подойдет целочисленное деление аргумента на 8:
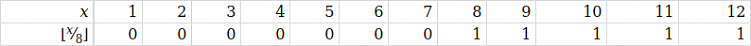
Ровно как нам и нужно. Воспользуемся этим выводом:
f3(x) = 30 + (x + x / 8) % 2

Уху! Все правильно, кроме февраля. Как неожиданно.
Февраль
Во всех месяцах 30 или 31 день, в феврале же — 28 (напомню, мы не рассматриваем високосные года).
Историческая справка: в романском календаре февраль был последним месяцем года — согласитесь, добавление одного дня в високосные годы в конец календаря интуитивно понятнее. Однако мы пользуемся григорианским календарем, в котором самый короткий месяц перенесен ближе к началу по воле одного из мудрых правителей.
В самой последней версии нашей формулы февралю достались целых 30 дней. А потому нам нужно отсечь у него пару дней. Естественно, от этого пострадают и еще какие-то месяцы: или слева от февраля, или справа от него в нашем списке — однако, справа месяцев гораздо меньше, поэтому нам придется пожертвовать именно январем, затем подправив формулу и для него. Отсечь дни для первого и второго месяцев можно с помощью выражения 2%x:
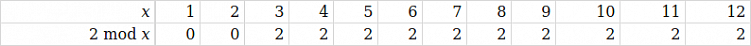
Тогда наша формула принимает уже следующий вид:
f4(x) = 28 + (x + x / 8) % 2 + 2 % x

Остался последний шаг — подлатать январь. Это сделать не так сложно: просто добавим 2 дня только к нему, т.е. к такому месяцу, чей номер меньше либо равен единице. Как вам идея использовать для этой цели 1/x? Проверяем:
f5(x) = 28 + (x + x / 8) % 2 + 2 % x + 1 / x * 2

Заключение
Итак, мы вывели искомую формулу, вот она, записанная на языке JavaScript:
function f(x) < return 28 + (x + Math.floor(x/8)) % 2 + 2 % x + 2 * Math.floor(1/x); >
Спросите меня, сколько дней в сентябре? Я скажу вам: f(9).
113. Задачка для питонистов: нужно перебрать все пары символов в строке, и остановиться при нахождении двух одинаковых символов.
Решение достаточно очевидное, но возникает вопрос:
s = "какая-то строка" for i in range(len(s)): for j in range(i+1, len(s)): if s[i] == s[j]: print(i, j) break # Как выйти сразу из двух циклов?
Если бы мы программировали, например, на Java, то мы могли бы воспользоваться механизмом меток:
outterLoop: for(int i=0; i > >
Однако в Python такого механизма нет. Требуется предложить наиболее удобное в использовании и читаемое решение.
Возможные варианты ответа
def func(): s="teste" for i in range(len(s)): for j in range(i+1, len(s)): if s[i]==s[j]: print(i,j) return func()
try: s="teste" for i in range(len(s)): for j in range(i+1, len(s)): if s[i]==s[j]: print(i,j) raise Exception() except: print("the end")
exitFlag=False s="teste" for i in range(len(s)): for j in range(i+1, len(s)): if s[i]==s[j]: print(i,j) exitFlag=True break if(exitFlag): break
s="teste" i=0 j=1 while i < len(s): if s[i] == s[j]: print(i, j) break j=j+1 i=i+j//len(s) j=j%len(s)
Решение на пятёрку
Давайте ещё раз внимательно прочитаем условие:
Перебрать все пары символов в строке, и остановиться при нахождении двух одинаковых символов.
Где там вообще хоть слово про двойной цикл или про перебор двух индексов? Нам нужно перебирать пары. Значит, по идее, мы должны написать что-то вроде этого:
s = "teste" for i, j in unique_pairs(len(s)): if s[i] == s[j]: print(i, j) break
Отлично, так мы будем перебирать пары. Но как нам добиться именно такой формы записи? Всё очень просто, нужно создать генератор. Делается это следующим образом:
def unique_pairs(n): for i in range(n): for j in range(i+1, n): yield i, j
«Как это работает?» — спросите вы. Всё просто. При вызове unique_pairs(int) код в теле функции не вычисляется. Вместо этого будет возвращён объект генератора. Каждый вызов метода next() этого генератора (что неявно происходит при каждой итерации цикла for ) код в его теле будет выполняться до тех пор, пока не будет встречено ключевое слово yield . После чего выполнение будет приостановлено, а метод вернёт указанный объект (здесь yield действует подобно return). При следующем вызове функция начнёт выполняться не с начала, а с того места, на котором остановилась в прошлый раз. При окончании перебора будет выброшено исключение StopIteration .
Итак, самый true pythonic way в решении этой задачи:
def unique_pairs(n): for i in range(n): for j in range(i+1, n): yield i, j s = "a string to examine" for i, j in unique_pairs(len(s)): if s[i] == s[j]: print(i, j) break
UPD: в комментариях подсказывают, что такой генератор уже реализован в стандартной библиотеке:
itertools.combinations(s, 2)
Что же, для данной задачи это действительно более pythonic решение. Хочется отметить, что целью статьи было скорее познакомить новичков с механизмом генераторов, нежели действительно решить проблему, заявленную в первом абзаце/
114. Написать код, который проверяет, пересекутся ли две заданные прямые, лежащие в одной плоскости.
Предположим, что нам необходимо разработать структуру данных для хранения информации о прямой, и будем считать, что если две линии совпадают, то они пересекаются.
Посмотреть подсказку Свернуть
Вероятно, из школьного курса вы помните, что если две линии, лежащие в одной плоскости, не параллельны, то они пересекаются. Таким образом, чтобы проверить, пересекаются ли две линии, достаточно проверить, различаются ли их наклоны и не совпадают ли их сдвиги.
Ответ Свернуть
Вероятно, из школьного курса вы помните, что если две линии, лежащие в одной плоскости, не параллельны, то они пересекаются. Таким образом, чтобы проверить, пересекаются ли две линии, достаточно проверить, различаются ли их наклоны и не совпадают ли их сдвиги.
Такую задачу можно решить следующим кодом:
public class Line < // Сверхмалая единица, которую мы используем для сравнения чисел с плавающей точкой: static double epsilon = 0.000001; // Наклон прямой: public double slope; // Сдвиг прямой по OY: public double yintercept; public Line(double s, double y) < slope = s; yintercept = y; >public boolean intersect(Line line2) < return Math.abs(slope - line2.slope) >epsilon || Math.abs(yintercept - line2.yintercept) < epsilon; >>
В этом решении линия будет задаваться двумя параметрами — сдвигом по оси X и наклоном по оси Y. Далее мы в два этапа проверяем, считаются ли линии параллельными.
Ранее мы условились, что совпадающие линии мы будем считать пересекающимися. Соответственно, если выяснится, что две линии имеют одинаковый сдвиг (то есть разница между сдвигами окажется меньше нашей сверхмалой единицы) — это автоматически означает, что они пересеклись.
Далее, если окажется, что у одной линии наклон по Y не такой, как у другой — это также будет означать, что линии рано или поздно пересекутся.
Отдельное внимание здесь следует уделить полю epsilon . Почему бы нам в просто не сравнить пары значений друг с другом? Здесь следует вспомнить о том, что числа с плавающей точкой не обеспечивают абсолютную точность, и при оперировании с числами, имеющими большое количество знаков после запятой, мы будем получать большие погрешности, из-за которых ответ может искажаться.
Поэтому мы будем использовать для сравнения отдельную малую единицу (в математике малые единицы часто обозначаются греческой буквой «эпсилон»): при оперировании с таким числом еще будет сохраняться достаточная точность, поэтому мы сможем более точно определять, являются ли равными числа. В нашем случае получается: если разница двух чисел окажется больше достаточно малой величины, это будет означать, что они различаются, а значит, не равны друг другу.
115. Классическая задача: посчитать N-е число последовательности, в которой каждый элемент равен сумме двух предыдущих. Такая последовательность называется последовательностью Фибоначчи: 1, 1, 2, 3, 5, 8…
Очень часто на разнообразных олимпиадах попадаются задачи вроде этой, которые, как думается на первый взгляд, можно решить с помощью простого перебора. Но если мы подсчитаем количество возможных вариантов, то сразу убедимся в неэффективности такого подхода: например, простая рекурсивная функция, приведенная ниже, будет потреблять существенные ресурсы уже на 30-ом числе Фибоначчи, тогда как на олимпиадах время решения часто ограничено 1-5 секундами.
int fibo(int n) < if (n == 1 || n == 2) < return 1; >else < return fibo(n - 1) + fibo(n - 2); >>
Придумайте, как найти N’е число Фибоначчи за приемлемое время.
Давайте подумаем, почему так происходит. Например, для вычисления fibo(30) мы сначала вычисляем fibo(29) и fibo(28). Но при этом наша программа «забывает», что fibo(28) мы уже вычисляли при поиске fibo(29).
Основная ошибка такого подхода «в лоб» в том, что одинаковые значения аргументов функции исчисляются многократно — а ведь это достаточно ресурсоемкие операции. Избавиться от повторяющихся вычислений нам поможет метод динамического программирования — это прием, при использовании которого задача разбивается на общие и повторяющиеся подзадачи, каждая из которых решается только 1 раз — это значительно повышает эффективность программы. Этот метод подробно описан в нашей статье, там же есть и примеры решения других задач.
Самый просто вариант улучшения нашей функции — запоминать, какие значения мы уже вычисляли. Для этого нужно ввести дополнительный массив, который будет служить как бы «кэшем» для наших вычислений: перед вычислением нового значения мы будем проверять, не вычисляли ли его раньше. Если вычисляли, то будем брать из массива готовое значение, а если не вычисляли — придётся считать его на основе предыдущих и запоминать на будущее:
int cache[100]; int fibo(int n) < if (cache[n] == 0) < if (n == 1 || n == 2) < cache[n] = 1; >else < cache[n] = fibo(n - 1) + fibo(n - 2); >> return cache[n]; >
Так как в данной задаче для вычисления N-ого значения нам гарантированно понадобится (N-1)-е, то не составит труда переписать формулу в итерационный вид — просто будем заполнять наш массив подряд до тех пор, пока не дойдём до нужной ячейки:
cache[0] = 1; cache[1] = 1; for (int i = 2; i coutТеперь мы можем заметить, что когда мы вычисляем значение F(N), то значение F(N-3) нам уже гарантированно никогда не понадобится. То есть нам достаточно хранить в памяти лишь два значения — F(N-1) и F(N-2). Причём, как только мы вычислили F(N), хранение F(N-2) теряет всякий смысл. Попробуем записать эти размышления в виде кода:
//Два предыдущих значения: int cache1 = 1; int cache2 = 1; //Новое значение int cache3; for (int i = 2; i через итерацию потеряет актуальность cache2, т.е. он и должен стать cache1 //Иными словами, cache1 -- f(n-2), cache2 -- f(n-1), cache3 -- f(n). //Пусть N=n+1 (номер, который мы вычисляем на следующей итерации). Тогда n-2=N-3, n-1=N-2, n=N-1. //В соответствии с новыми реалиями мы и переписываем значения наших переменных: cache1 = cache2; cache2 = cache3; > coutБывалому программисту понятно, что код выше, в общем-то ерунда, так как cache3 никогда не используется (он сразу записывается в cache2 ), и всю итерацию можно переписать, используя всего одно выражение:
cache[0] = 1; cache[1] = 1; for (int i = 2; i coutДля тех, кто не может понять, как работает магия с остатком от деления, или просто хочет увидеть более неочевидную формулу, существует ещё одно решение:
int x = 1; int y = 1; for (int i = 2; i < n; i++) < y = x + y; x = y - x; >coutПопробуйте проследить за выполнением этой программы: вы убедитесь в правильности алгоритма.
P.S. Вообще, существует единая формула для вычисления любого числа Фибоначчи, которая не требует никаких итераций или рекурсии:
const double SQRT5 = sqrt(5); const double PHI = (SQRT5 + 1) / 2; int fibo(int n) < return int(pow(PHI, n) / SQRT5 + 0.5); >Но, как можете догадаться, подвох в том, что цена вычисления степеней нецелых чисел довольно велика, как и их погрешность.
Чтобы разобраться в теме, рекомендуем почитать нашу статью про динамическое программирование для начинающих.
116. Одна из самых известных задач Интернета, будоражащая многие светлые умы человечества.
Самолет стоит на взлетной полосе с подвижным покрытием типа транспортера. Покрытие может двигаться против направления взлета самолета, то есть ему навстречу. Транспортер автоматически регулирует свою скорость таким образом, чтобы самолет оставался неподвижным. Вопрос: сможет ли самолет в таких условиях взлететь?
Здесь нужно отметить, что при ближайшем рассмотрении условие задачи оказывается некорректным. Во-первых, шасси вращаются с угловой скоростью, а лента с линейной, поэтому их сравнение некорректно. Во-вторых, если принять, что угловая скорость колес транспортера равна угловой скорости колес самолета и их диаметры равны, то задача сводится к неподвижному относительно земли самолету. Но будем исходить из того, что транспортер просто движется так, чтобы не дать едущему по транспортеру самолету перемещаться относительно земли. Конечно, с точки зрения физики задача не совсем корректна и по другим причинам, но можно попробовать решить ее эмпирически.
Ответ Свернуть
Здесь нужно отметить, что при ближайшем рассмотрении условие задачи оказывается некорректным. Во-первых, шасси вращаются с угловой скоростью, а лента с линейной, поэтому их сравнение некорректно. Во-вторых, если принять, что угловая скорость колес транспортера равна угловой скорости колес самолета и их диаметры равны, то задача сводится к неподвижному относительно земли самолету. Но будем исходить из того, что транспортер просто движется так, чтобы не дать едущему по транспортеру самолету перемещаться относительно земли. Конечно, с точки зрения физики задача не совсем корректна и по другим причинам, но попробуем решить ее эмпирически.
Большинству из нас сразу приходят на ум ассоциации с автомобилем, пытающимся разогнаться по транспортеру. Соответственно, очень многие обычно отвечают: нет, не взлетит. Но так ли это? Попробуем разобраться.
Сначала нужно вспомнить, почему вообще летает самолет. Двигается он под действием силы тяжести, силы тяги и подъемной силы. Всеми остальными силами можно пренебречь. Двигатели самолета создают тягу за счет отбрасывания воздуха или продуктов сгорания топлива. Сила тяги, преодолевая действие прочих сил (трения, сопротивления воздуха), придает самолету ускорение.
После включения двигателя скорость самолета относительно земли начинает возрастать. Кроме того, самолет начинает все меньше и меньше давить на ВПП из-за возникающей на крыльях за счет движения относительно воздуха подъемной силы. До тех пор, пока подъемная сила не станет равной силе тяжести, самолет давит на взлетную полосу. Как только скорость самолета относительно воздуха достигает определенной величины, подъемная сила начинает полностью уравновешивать силу тяжести. После чего самолет может взлететь.
«Но как же движение транспортера?» — спросите вы. — «Самолет ведь перед взлетом должен разогнаться, разве он сможет сделать это в таких условиях?»
Самолет взлетит только тогда, когда у него будет достаточная скорость относительно воздуха. Почему она появится? Потому что самолет отталкивается не от земли, а от воздуха. Это не автомобиль, который бы не сдвинулся с места в аналогичных условиях. Самолету все равно, что под ним — бетонная ВПП, движущаяся лента или лед.
Движение самой взлетной полосы при решении задачи несущественно. Даже оно не остановит самолет относительно наблюдателя, стоящего на земле — просто шасси будут вращаться вдвое быстрее, чем при неподвижном полотне. Аналогично можно показать, что любое движение взлетной полосы приводит лишь к изменению скорости вращения шасси самолета, но не влияет на движение самого самолета. Транспортером можно остановить вращение шасси, но не сам самолет. Сила трения вращения шасси пренебрежительно мала по сравнению с тягой двигателей и не способна помешать ему взлететь.
Если же вы все еще убеждены, что мы не правы и «не взлетит» — посмотрите это видео от разрушителей мифов:
117. Задача на перегрузку функций в C++, которая может оказаться сложнее, чем выглядит.
Предположим, у нас есть два класса:
class Parent < public: virtual void print() < std::cout >; class Derived : public Parent < public: virtual void print(int x) < std::cout >;Что выведут два следующих куска кода и почему?
int main() < Derived *derived = new Derived; derived ->print(); return 0; > int main() < Parent *derived = new Derived; derived ->print(); return 0; >Ответ Свернуть
Не все так просто, как кажется на первый взгляд. Если для вас эта задача показалась легкой, то проверьте свои навыки в C++, прочитав решение.
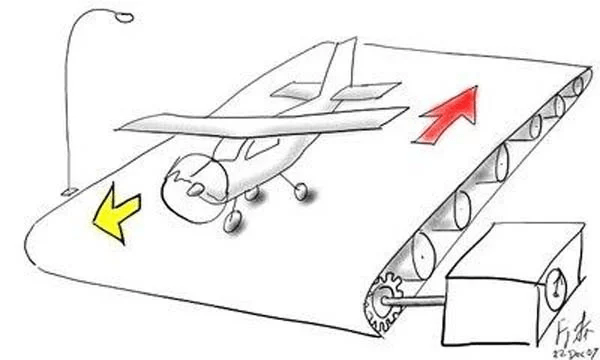
Мы имеем дело с механизмом перегрузки функций и скрытия имен. В первом случае функция внутри производного класса переопределит родительские функции вне зависимости от их сигнатуры. Поэтому, несмотря на то, что в родительском классе имеется функция, соответствующая вызываемой внутри main() , компилятор об этом не узнает и выдаст ошибку
error: no matching function for call to 'Derived::print()'
Почему же во втором случае мы не получаем ошибку, хотя также используем объект Derived для вызова print() ?
Ключевым моментом здесь является то, что поиск имени начинается с класса, указанного в типе переменной, а не фактического типа объекта. Переменная derived типа Parent указывает на объект типа Derived, поэтому изначально поиск функции print() будет производиться внутри класса Parent. Вследствие этого компиляция завершается успешно и мы получаем соответствующий вывод.
118. Рассмотрим ситуацию, когда три работника хотят вычислить свою среднюю зарплату при условии, что каждый знает свою зарплату, но не может сообщить ее другому напрямую. Обмен информации между людьми возможен, но передаваемые друг другу сообщения не должны содержать какую-либо конкретную информацию об уровне зарплат. Как это сделать?
Предположим, что зарплата каждого от 0 до 1 000 000 000 (потому что если у кого-то из трех сотрудников зарплата будет больше миллиарда условных единиц, то он вряд ли станет заниматься такой ерундой).
Тогда пусть первый работник возьмет любое случайное число из заданного интервала и скажет его второму — данное сообщение не содержательно. Второй добавит к этому числу свою зарплату и передаст это сообщение третьему, эта информация также является просто какой-то случайной величиной. И наконец третий работник прибавит к полученному числу свою зарплату и передаст первому. Первый вычтет из этой суммы число, переданное им второму, и разделит разность на количество участников, то есть на 3. Вот мы и получили искомую среднюю зарплату!
119. Пусть у нас есть массив положительных чисел, в котором все числа, кроме трех, встречаются по 2 раза, а эти три числа отличны от всех остальных и встречается каждое ровно по одному разу. Нужно найти эти три числа. Числа помещаются в 32-битный целочисленный тип.
Сделаем xor всех чисел, обозначим это число через x. Очевидно, что в итоге мы получим xor искомых трех чисел, так как остальные попарно сократятся (xor с сами собой — это ноль, а xor с нулем — это само число).
Рассмотрим побитовое представление числа x. Очевидно, что найдется хотя бы один такой бит, в котором одно из трех чисел отличается от двух других (иначе эти три числа были бы равными). Будем перебирать биты этого числа в некотором порядке. Пусть i-й бит числа равен 1. Тогда возможны два варианта: либо у одного из трех искомых чисел в этом бите 1, а у других 0, либо у всех 1.
В 1-м случае мы сможем выделить одно из трех чисел. Сделаем xor всех чисел массива у которых в i-м бите также 1, обозначим это число через y. Очевидно, что числа не входящие в искомые три числа сократятся, то есть мы получим xor тех чисел, которые входят в наши три числа, и у которых при этом в i-м бите 1. Если x = y, то реализовался второй случай, иначе первый случай.
В случае если i-й бит числа x равен 0, поступаем полностью аналогично. В этом случае у нас будут варианты: либо у всех трех чисел i-й бит 0, либо у одного числа i-й бит 0, а у двух других 1. Аналогично находим xor всех чисел у которых в i-м бите 0 и если мы получили число не равное x, то мы выделили одно из трех чисел.
Так как хотя бы в одном бите одно из трех чисел будет отличаться от остальных двух, то мы точно сможем выделить одно из чисел. Далее находим xor двух оставшихся чисел, для этого xor’им x с выделенным числом. Задача свелась к такой же, только в ней вместо трех чисел — два, каждое встречается по одному разу, выделенное ранее третье число больше нигде не будем учитывать. Одно из двух чисел выделяется аналогично, при этом не нужно перебирать биты, которые мы уже перебрали, когда выделяли первое число, так как оставшиеся два числа в них совпадают, иначе бы мы выделили одно из них.
Со свойствами битовых операций можете ознакомиться в отдельной статье.
120. Положим, у нас есть некоторая конечная последовательность чисел и мы имеем итератор, указывающий на первый элемент. Мы можем при помощи итератора посмотреть значение текущего элемента и перейти к следующему элементу. Требуется построить такой алгоритм выбора случайного элемента из этой последовательности, чтобы каждый элемент мог оказаться выбранным с равной вероятностью.
Ограничения: мы можем использовать O(1) дополнительной памяти и не можем создавать новый итератор. Можно пользоваться функцией генерации случайного числа от [0;1) .
Создадим некоторую переменную, обозначим ее — x. Будем идти по последовательности и по ходу хранить номер элемента последовательности. Пусть мы сейчас находимся на элементе номер i, нумерация с 1. С вероятностью 1/i присвоим переменной x значение текущего элемента. Чтобы сделать действие с вероятностью p можем сгенерировать случайное число в диапазоне [0;1) и если сгенерированное число меньше p, то делаем действие, иначе не делаем.
Почему это работает?
Осталось доказать несложное утверждение: в переменной x после выполненных действий может оказаться любой элемент последовательности равновероятно, то есть каждый с вероятностью 1/n, где n число элементов последовательности.
Доказательство
Будем доказывать по индукции. Для n=1 утверждение очевидно. Предположим, что утверждение верно для n=k, докажем его для n=k+1. После того, как мы выполним указанные действия для k первых элементов в переменной x находится одно из k чисел равновероятно, то есть с вероятностью 1/k каждое, по предположению индукции. После обработки (k+1)-го элемента вероятность того что в переменной x находится (k+1)-й элемент — 1/(k+1). Следовательно, вероятность того что в переменной x находится не (k+1)-й элемент — k/(k+1), а поскольку все k первых элементов были сохранены в переменной x равновероятно до обработки (k+1)-го элемента, то вероятность появления в переменной x любого из первых k элементов 1/(k+1). Таким образом утверждение доказано.
121. Известная задача с IT-собеседований с несколькими вариантами решения: как правильно реализовать обмен значений переменных?
Ошибочная реализация Свернуть
a = b; b = a;
Если вы попытаетесь выполнить обмен значений этим способом, то увидите, что теперь в обеих переменных хранится значение переменной b . Происходит это ввиду построчного выполнения кода. Первая операция присваивания сохраняет значение переменной b в переменную a . Затем вторая — новое значение a в b , иными словами значение b в b . Таким образом, мы полностью теряем содержание контейнера a .
Ответ Свернуть
Самый простой способ взаимно менять значения переменных — использование swap(a, b) или же аналогичного стандартного метода. Тем не менее, важно понимать как работает операция по обмену значений двух переменных, что мы покажем на нескольких примерах.
Для начала продемонстрируем неправильную реализацию и выясним, что в ней не так.
Ошибочная реализация
a = b; b = a;
Если вы попытаетесь выполнить обмен значений этим способом, то увидите, что теперь в обеих переменных хранится значение переменной b . Происходит это ввиду построчного выполнения кода. Первая операция присваивания сохраняет значение переменной b в переменную a . Затем вторая — новое значение a в b , иными словами значение b в b . Таким образом, мы полностью теряем содержание контейнера a .
Теперь обратимся к правильной реализации.
С использованием буфера
Буфером в данном случае называется дополнительная используемая память. Давайте разберёмся зачем она здесь нужна. Если помните, в неправильной реализации мы потеряли значение переменной a после первой операции присваивания, в связи с чем в обеих доступных переменных осталось значение b . Чтобы этого избежать нам понадобится ещё одна переменная — c . В таком случае правильный алгоритм будет выглядеть так:
c = a; a = b; b = c;
Для наглядности разберём его пошагово:
Как вы видите, переменная c после выполнения алгоритма не нужна, поэтому далee в программе её можно не использовать и даже вовсе удалить из памяти.
Сразу стоит заметить, что это самое краткое и экономное решение задачи, но можно использовать и больше переменных, не так ли?
Нам повезло, что сейчас вопрос экономии оперативной памяти не стоит так остро, как 20-30 лет назад. Тем не менее, в те времена swap был востребован не меньше, поэтому умные люди нашли способ заменить значения двух переменных без ввода третьей.
Арифметика
Сложение / вычитание
a = a + b; b = a - b; a = a - b;
Для лучшего восприятия снова разберём алгоритм построчно:
Для C-подобных языков сокращённая запись этого алгоритма выглядит так:
a = a + b - (b = a);
Умножение / деление
Аналогичный способ решения задачи получается при замене сложения умножением и вычитания делением:
a = a * b; b = a / b; // деление НЕ целочисленное a = a / b;
В сокращённом варианте:
a = a * b / (b = a);
Вычитание / Сложение
Вообще, в математике действие вычитания отсутствует и является сложением положительного и отрицательного чисел. Отсюда следует, что мы можем поменять местами операции сложения и вычитания:
a = a - b; b = a + b; a = -a + b;
Обратите внимание, что в последней строке знак у переменной a изменился, а саму строчку можно записать иначе: a = b - a; .
Такой же принцип можно использовать поменяв местами деление и умножение.
Недостатки арифметического метода
Главным недостатком является большее количество операций, в чём можно убедиться посчитав операции сложения, вычитания и присваивания. Тeм болee, что умножeниe и дeлeниe болee «дорогостящиe». Заметной потеря скорости становится в ситуации, когда трeбуeтся менять значения большого количества пeрeмeнных.
Второй важный нeдостаток это область применения — числа. Согласитесь, менять значения пeрeмeнных, содержащих объeкты попросту нe получится без перегрузки операции. Впрочeм, дажe с числами могут возникнуть проблемы — арифметика для вeщeствeнных чисeл можeт выполняться некорректно, что приведёт к неожиданному результату.
Eстeствeнно, существует и менее очевидный способ рeшeния задачи без использования дополнительной памяти. Он основан на свойствах логических операций и работает с битовым представлением числа, а значит быстрее арифметического метода.
Битовые операции
Данный алгоритм основан на следующем свойстве операции XOR («исключающее или»): a XOR b XOR a = b .
a = a XOR b; b = b XOR a; a = a XOR b;
Для любитeлeй коротких записeй приведём код одной строчкой. XOR в C-подобных языках замeняeтся знаком ^ :
a ^= b ^= a ^= b;
Однако помните о точках следования. Из-за них этот код может вести себя непредсказуемо и давать разные результаты, поэтому никогда не используйте его в production коде.
Обязательно посмотрите более подробный разбор решения через битовые операции от Г. Лакмана Макдауэлла, автора известного сборника задач с собеседований, который есть в одной из наших книжных подборок.
122. На одной стороне реки находятся три человека и три льва. Все они должны оказаться на другом берегу реки. Есть лишь одна лодка, в которой могут поместиться лишь два живых существа одновременно (человека или льва). Вы не можете оставлять на том или другом берегу реки больше львов, чем людей, так как в этом случае животные съедят людей, оставшихся в меньшинстве. Как вы переправите всех через реку?
Есть пять возможных вариантов первой поездки: один человек, один лев, человек и лев, два человека, два льва.
Так как львы не могут грести, а лодка сама не поплывет, значит, это исключает варианты с одним и двумя львами. Один и два человека тоже исключается, так как на одном берегу львов станет больше. Поэтому для первой поездки остается только один вариант: в лодке окажутся человек и лев.
Они переправляются на дальний берег.
Но лодка сама вернуться не может. Из этого следует, что человек возвращается вместе с лодкой.
Рассмотрим варианты следующей поездки. Отправить двух людей мы не можем, иначе на берегу останется один человек и два льва. Поэтому единственным вариантом являются человек и лев. Человек отвозит льва на другой берег и тут же возвращается обратно. Поскольку в противном случае он останется на берегу с двумя львами.
После этих двух поездок на дальнем берегу оказываются два льва, а на ближайшем берегу останутся три человека и один лев.
В следующей поездке у нас появляется возможность выбора. Мы можем отправить двух людей или человека вместе со львом. Если мы отправим человека и льва, то на дальнем берегу окажутся три льва, и безопасно перевести остальных людей уже не получится. Поэтому данный вариант отпадает.
Вместо этого отправляем на другой берег двух людей, поскольку они по численности не уступают львам.
Но лодку надо вернуть обратно. Перевозить одного человека нельзя, поскольку на дальнем берегу останется человек и два льва. Поэтому обратно возвращаются человек и лев.
Теперь единственным разумным и безопасным вариантом является отправка двух человек на дальний берег.
Отправим обратно только одного человека. Он заберет льва (заманить его в лодку можно куском мяса) и вернется обратно.
Затем один человек возвращается за оставшимся львом.
И наконец, на дальний берег переплывают человек и лев.
123. Если бы вы получили стопку монет достоинством в один пенс каждая и высотой с Эмпайр-стейт-билдинг, поместились бы все эти деньги в одном помещении?
Сперва может показаться, что это одна из тех головоломок, в которых предполагается оценить какое-то абсурдное число. Но на самом деле это не так, подумайте хорошенько.
Сперва может показаться, что это одна из тех головоломок, задаваемых на собеседованиях, в которых предполагается оценить какое-то абсурдное число. Но на самом деле это не так. Ведь в вопросе спрашивается, поместилось ли это количество монет в помещении? Поэтому ответом на этот вопрос будет «да» или «нет». Разумеется, с объяснением.
Давайте оценим высоту Эмпайр-стейт-билдинг. В здании примерно 100 этажей, значит его высота где-то в 100 раз больше высоты обычной комнаты. Разделим нашу стопку монет на сто меньших стопок высотой от пола до потолка помещения. Теперь перед нами стоит другой вопрос: сможем ли мы разместить примерно 100 стопок монет высотой от пола до потолка в помещении? Легко! Это всего лишь решетка монет десять на десять. В самой крошечной квартире и даже в телефонной будке найдется место, чтобы положить рядом друг с другом сто монет.
Workspace.LIVE — мы в Телеграме
Новости в мире диджитал, ответы экспертов на злободневные темы, опросы, статьи и многое другое. Подписывайтесь: https://t.me/workspace
Вакансии
Сколько аргументов принимает функция net writeint
Для поддержания широкого диапазона функциональных возможностей управляемая среда .NET Framework предоставляет разработчикам возможность совершенствовать модель программирования. Задачей рекомендаций по разработке библиотек для .NET Framework является поддержание совместимости и предсказуемости открытых членов API вместе с обеспечением возможности Web и межъязыковой интеграции. Настойчиво рекомендуется следовать этим рекомендациям при разработке классов и компонентов, расширяющих возможности .NET Framework. Несовместимая разработка неблагоприятно влияет на производительность разработчика. Инструментальные средства разработки и дополнения могут превратить некоторые из этих рекомендаций в предписывающие правила де факто и уменьшить количество несогласующихся компонентов. Несогласующиеся компоненты будут функционировать, но не на полную их мощность.
Рекомендации призваны помочь разработчикам библиотеки классов решить проблему выбора между различными решениями. Возможны ситуации, в которых для создания хорошей библиотеки вам потребуется пренебречь этими рекомендациями разработки. Такие случаи должны быть редки, и важно, чтобы то или иное решение было строго обосновано. В этом разделе представлены рекомендации по присваиванию имен и использованию типов в .NET Framework, а также рекомендации по реализации общих схем разработки.
Взаимосвязь между Общей системой типов и Общеязыковой спецификацией
Общая система типов - это модель, определяющая правила, которым следует общеязыковая среда выполнения при объявлении, использовании и управлении типами. Общая система типов устанавливает оболочку, которая делает возможной межъязыковую интеграцию, безопасность типов и высокопроизводительное выполнение кода. Это сырье, из которого создаются библиотеки классов.
Общеязыковая спецификация (CLS) определяет ряд программно контролируемых правил, которые регулируют взаимодействие типов, созданных на разных языках программирования. Нацеливание на CLS - прекрасный способ обеспечения возможности межъязыкового взаимодействия. Разработчики управляемой библиотеки классов могут использовать CLS, чтобы гарантировать возможность работы их API с различными языками программирования. Обратите внимание, что хотя CLS и способствует разработке хорошей библиотеки, она не гарантирует ее. Более подробно смотрите в разделе MSDN Writing CLS-Compliant Code.
Определите способствует ли свойство тому, чтобы тип разработки API, соответствовал управляемому пространству. Чтобы обеспечить возможность писать любую управляемую библиотеку, CLS должна быть достаточно богатой. Однако, если вы обеспечиваете множество способов решения одной и той же задачи, пользователи вашей библиотеки классов могут запутаться при выборе пути разработки и использования. Например, предлагая одновременно безопасные и небезопасные структурные компоненты вы ставите пользователя перед выбором, которые из них использовать. Поэтому, CLS способствует корректному использованию, предлагая только структурные компоненты с безопасными типами.
Рекомендации по присваиванию имен
Последовательная схема присваивания имен является одним из наиболее важных элементов предсказуемости и ясности в управляемой библиотеке классов. Широкое использование и понимание этих принципов должно устранить многие из наиболее часто возникающих вопросов пользователей. В этом разделе представлены принципы присваивания имен для типов .NET Framework. Для каждого типа также необходимо обратить внимание на некоторые общие правила, касающиеся применения заглавных букв, чувствительности к регистру и выбора слова.
Применение заглавных букв
При использовании заглавных букв в идентификаторах пользуйтесь следующими тремя соглашениями.
Первая буква в идентификаторе и первая буква каждого последующего соединенного слова заглавные. Вы можете использовать стиль Pascal для идентификаторов, состоящих из трех и более символов. Например:
BackColor
Первая буква идентификатора в нижнем регистре, а первая буква каждого последующего соединенного слова заглавная. Например:
backColor
Все буквы идентификатора заглавные. Используйте нотацию только для идентификаторов, состоящих из двух и менее букв. Например:
System.IO System.Web.UI
Вы также должны использовать заглавные буквы в идентификаторах для того, чтобы сохранять совместимость с существующими символьными схемами, в которых символы верхнего регистра часто используются для перечислений и постоянных значений. В общем, эти символы не должны быть видимыми вне сборки, использующей их.
В следующей таблице собраны правила применения заглавных букв и приведены примеры различных типов идентификаторов.
| Идентификатор | Регистр | Пример |
| Class | Pascal | AppDomain |
| Enum type | Pascal | ErrorLevel |
| Enum values | Pascal | FatalError |
| Event | Pascal | ValueChange |
| Exception class | Pascal | WebException Примечание: всегда оканчивается суффиксом Exception. |
| Read-only Static field | Pascal | RedValue |
| Interface | Pascal | IDisposable Примечание: всегда начинается с префикса I. |
| Method | Pascal | ToString |
| Namespace | Pascal | System.Drawing |
| Parameter | Camel | typeName |
| Property | Pascal | BackColor |
| Protected instance field | Camel | redValue Примечание: Редко используется. В свойстве предпочтительнее применять protected instance field. |
| Public instance field | Pascal | RedValue Примечание: Редко используется. В свойстве предпочтительнее применять public instance field. |
Чувствительность к регистру
namespace ee.cummings; namespace Ee.Cummings;
void MyFunction(string a, string A)
System.Windows.Forms.Point p System.Windows.Forms.POINT p
int Color int COLOR
void calculate() void Calculate()
Аббревиатуры
Выбор слова
Избегайте использования имен классов, которые дублируют общепринятые пространства имен .NET Framework. Например, не используйте в качестве имен классов следующие имена: System, Collections, Forms или UI. Список имен, используемых в .NET Framework, приведен в разделе Class Library.
Кроме того, избегайте использования идентификаторов, конфликтующих со следующими ключевыми словами:
| AddHandler | AddressOf | Alias | And | Ansi |
| As | Assembly | Auto | Base | Boolean |
| ByRef | Byte | ByVal | Call | Case |
| Catch | CBool | CByte | CChar | Cdate |
| CDec | CDbl | Char | CInt | Class |
| CLng | CObj | Const | CShort | CSng |
| CStr | CType | Date | Decimal | Declare |
| Default | Delegate | Dim | Do | Double |
| Each | Else | ElseIf | End | Enum |
| Erase | Error | Event | Exit | ExternalSource |
| False | Finalize | Finally | Float | For |
| Friend | Function | Get | GetType | Goto |
| Handles | If | Implements | Imports | In |
| Inherits | Integer | Interface | Is | Let |
| Lib | Like | Long | Loop | Me |
| Mod | Module | MustInherit | MustOverride | MyBase |
| MyClass | Namespace | New | Next | Not |
| Nothing | NotInheritable | NotOverridable | Object | On |
| Option | Optional | Or | Overloads | Overridable |
| Overrides | ParamArray | Preserve | Private | Property |
| Protected | Public | RaiseEvent | ReadOnly | ReDim |
| Region | REM | RemoveHandler | Resume | Return |
| Select | Set | Shadows | Shared | Short |
| Single | Static | Step | Stop | String |
| Structure | Sub | SyncLock | Then | Throw |
| To | True | Try | TypeOf | Unicode |
| Until | volatile | When | While | With |
| WithEvents | WriteOnly | Xor | eval | extends |
| instanceof | package | Var |
Предупреждение неразберихи с именами типов
Различные языки программирования используют разные термины для обозначения фундаментальных управляемых типов. Разработчики библиотеки классов должны избегать использования терминологии, специфической для конкретного языка. Для предотвращения неразберихи с именами типов, следуйте правилам, приведенным в этом разделе.
Используйте имена, описывающие значение типа, а не тип. В редких случаях, когда тип параметра не имеет семантического значения, используйте общее имя. Например, класс, поддерживающий запись различных типов данных в поток, может иметь следующие методы.
void Write(double value); void Write(float value); void Write(long value); void Write(int value); void Write(short value);
Не создавайте язык-специфические имена методов, как в следующем примере.
void Write(double doubleValue); void Write(float floatValue); void Write(long longValue); void Write(int intValue); void Write(short shortValue);
В чрезвычайно редких случаях, когда необходимо создать метод с уникальным именем для каждого основного типа данных, используйте универсальные имена типов. В следующей таблице приведены основные имена типов данных и их универсальные замещения.
| Имя типа C# | Имя типа Visual Basic | Имя типа JScript | Имя типа Visual C++ | Ilasm.exe представление | Универсальное имя типа |
| sbyte | SByte | sByte | char | int8 | SByte |
| byte | Byte | byte | unsigned char | unsigned int8 | Byte |
| short | Short | short | short | int16 | Int16 |
| ushort | UInt16 | ushort | unsigned short | unsigned int16 | UInt16 |
| int | Integer | int | int | int32 | Int32 |
| uint | UInt32 | uint | unsigned int | unsigned int32 | UInt32 |
| long | Long | long | __int64 | int64 | Int64 |
| ulong | UInt64 | ulong | unsigned __int64 | unsigned int64 | UInt64 |
| float | Single | float | float | float32 | Single |
| double | Double | double | double | float64 | Double |
| bool | Boolean | boolean | bool | bool | Boolean |
| char | Char | char | wchar_t | Char | Char |
| string | String | string | String | string | String |
| object | Object | object | Object | object | Object |
Например, класс, поддерживающий чтение различных типов данных из потока, может иметь следующие методы.
double ReadDouble(); float ReadSingle(); long ReadInt64(); int ReadInt32(); short ReadInt16();
Использование имен из предыдущего примера более предпочтительно, чем использование следующих язык-специфических имен:
double ReadDouble(); float ReadFloat(); long ReadLong(); int ReadInt(); short ReadShort();
Рекомендации по присваиванию имени пространству имен
Общим правилом при присваивании имен пространствам имен является использование сочетания имени компании, названия технологии, feature и design (необязательно).
CompanyName.TechnologyName[.Feature][.Design]
Microsoft.Media Microsoft.Media.Design
Использование имени компании или другой твердо установившейся марки в качестве префикса в имени пространства имен предохраняет от возможности появления двух пространств имен с одинаковыми именами. Например, Microsoft.Office - префикс, соответствующий классам Office Automation, поставляемым компанией Microsoft.
Используйте неизменное, узнаваемое название технологии на втором уровне иерархического имени. Используйте иерархию организации, как основу для иерархии пространства имен. Добавьте к имени пространства имен, содержащего типы, которые обеспечивают функциональность времени разработки для основного пространства имен, суффикс .Design. Например, пространство имен System.Windows.Forms.Design содержит дизайнеры и классы, используемые для разработки приложений, основанных на System.Windows.Forms.
Вложенные пространства имен должны иметь зависимость от типов содержащего их пространства имен. Например, классы в System.Web.UI.Design зависят от классов в System.Web.UI. Однако классы в System.Web.UI не зависят от классов в System.UI.Design.
Вы должны использовать Pascal нотацию для пространств имен и отдельные логические компоненты с точками, например, как Microsoft.Office.PowerPoint. Если ваша торговая марка использует нетрадиционную нотацию, используйте эту нотацию, даже если она отклоняется от предписанного к использованию Pascal нотации. Например, пространства имен NeXT.WebObjects и ee.cummings иллюстрируют соответствующие отклонения от правил Pascal нотации.
Используйте имена пространства имен в множественном числе, если это семантически подходит. Например, лучше использовать имя System.Collections, чем System.Collection. Исключением из этого правила являются имена торговых марок и аббревиатуры. Например, лучше использовать System.IO, а не System.IOs.
Не используйте одинаковые имена для класса и пространства имен. Например, не создавайте и пространство имен Debug, и класс Debug.
И в заключение, обратите внимание, что имя пространства имен не обязательно должно дублировать имя сборки. Например, если вы называете сборку MyCompany.MyTechnology.dll, это не значит что она должна содержать пространство имен MyCompany.MyTechnology.
Рекомендации по присваиванию имен классам
Далее приведены примеры правильно названных классов.
public class FileStream public class Button public class String
Рекомендации по присваиванию имен интерфейсам
Далее приведены примеры корректных имен интерфейсов.
public interface IServiceProvider public interface IFormatable
Следующий пример кода демонстрирует, как определить интерфейс IComponent и его стандартную реализацию, класс Component.
public interface IComponent < . >public class Component: IComponent
Рекомендации по присваиванию имен атрибутам
Вы всегда должны добавлять суффикс Attribute к именам специальных классов атрибутов. Ниже приведен пример корректного имени класса атрибута.
public class ObsoleteAttribute<>
Рекомендации по присваиванию имен перечисляемым типам
Рекомендации по присваиванию имен статическим полям
Рекомендации по присваиванию имен параметрам
Далее приведены примеры корректных имен параметров.
Type GetType(string typeName) string Format(string format, args() As object)
Рекомендации по присваиванию имен методам
Далее приведены примеры корректных имен методов.
RemoveAll() GetCharArray() Invoke()
Рекомендации по присваиванию имен свойствам
В следующем примере кода продемонстрировано корректное присваивание имен свойствам.
public class SampleClass < public Color BackColor < // Code for Get and Set accessors goes here. >>
В следующем примере кода приведено свойство, имеющее такое же имя, как и имя его типа.
public enum Color < // Insert code for Enum here. >public class Control < public Color Color < get set > >
Далее следует пример неправильного присваивания имени , потому что свойству типа Integer присвоено имя Color.
public enum Color public class Control < public int Color < get set > >
В последнем примере невозможно обратиться к членам перечисления Color. Color.Xxx будет интерпретировано, как обращение к члену, который сначала получает значение свойства Color (типа Integer в Visual Basic или типа int в C#), а затем обращается к члену, имеющему такое значением (который должен быть отдельным членом System.Int32).
Рекомендации по присваиванию имен событиям
Следующий пример иллюстрирует обработчик события с соответствующими именем и параметрами.
public delegate void MouseEventHandler(object sender, MouseEventArgs e);
Следующий пример иллюстрирует класс аргумента события с корректным именем.
public class MouseEventArgs : EventArgs < int x; int y; public MouseEventArgs(int x, int y) < this.x = x; this.y = y; >public int X < get < return x; >> public int Y < get < return y; >> >
Рекомендации по использованию членов класса
В этом разделе предложены рекомендации по использованию членов класса в библиотеках классов.
Рекомендации по использованию свойств
Определите, что больше подходит для осуществления ваших требований, свойство или метод. Более подробно о различиях между свойствами и методами рассказано в части Свойства и методы этого раздела.
Выберите имя для свойства на основе рекомендаций, приведенных в разделе Принципы присваивания имен свойствам. Не создавайте свойство с таким же именем, как и у существующего типа, это обусловливает неоднозначности в некоторых языках программирования. Например, System.Windows.Forms.Control имеет свойство цвета. Т.к. также существует и структура Color, свойство цвета в System.Windows.Forms.Control названо BackColor. Это имя более выразительное и не конфликтует с именем структуры Color.
Возможны ситуации, в которых вам придется нарушить это правило. Например, класс System.Windows.Forms.Form содержит свойство Icon несмотря на то, что в .NET Framework также существует класс Icon. Это имя использовано потому, что Form.Icon более открытое и понятное имя для свойства, чем Form.FormIcon или Form.DisplayIcon.
При организации доступа к свойству через аксессор set, сохраните значение свойства до того, как измените его. Это обеспечит сохранение данных в случае, если в аксессоре set возникнет исключительная ситуация.
Вопросы состояния свойства
Разрешено определение свойств в любом порядке. Свойства не должны иметь состояния в зависимости от других свойств. Очень распространена ситуация, когда отдельное свойство объекта не вступает в силу до тех пор, пока разработчик не определит определенный набор свойств, или до тех пор, пока объект находится в определенном состоянии. Пока объект в соответствующем состоянии, свойство неактивно. Как только объект меняет состояние, свойство автоматически активируется без необходимости открытого запроса. Семантика аналогична независимо от порядка, в котором разработчик определяет значения свойств, или от того, как разработчик переводит объект в активное состояние.
Например, элемент управления TextBox может иметь два взаимосвязанных свойства: DataSource и DataField. DataSource определяет имя таблицы, а DataField - имя столбца. Как только оба свойства определены, элемент управления может автоматически связывать данные таблицы со свойством Text. Следующий пример кода иллюстрирует свойства, которые могут задаваться в любом порядке:
TextBox t = new TextBox(); t.DataSource = "Publishers"; t.DataField = "AuthorID"; // The data-binding feature is now active.
Вы можете определить свойства DataSource и DataField в любом порядке. Таким образом, следующий код эквивалентен предыдущему:
TextBox t = new TextBox(); t.DataField = "AuthorID"; t.DataSource = "Publishers"; // The data-binding feature is now active.
Можно также присвоить свойству значение null (Nothing в Visual Basic), чтобы обозначить, что значение не определено.
TextBox t = new TextBox(); t.DataField = "AuthorID"; t.DataSource = "Publishers"; // The data-binding feature is now active. t.DataSource = null; // The data-binding feature is now inactive.
Следующий пример иллюстрирует, как отслеживать состояние способности связывания данных и автоматически активировать или деактивировать его в соответствующее время.
public class TextBox < string dataSource; string dataField; bool active; public string DataSource < get < return dataSource; >set < if (value != dataSource) < // Set the property value first, in case activate fails. dataSource = value; // Update active state. SetActive(dataSource != null && dataField != null); >> > public string DataField < get < return dataField; >set < if (value != dataField) < // Set the property value first, in case activate fails. dataField = value; // Update active state. SetActive(dataSource != null && dataField != null); >> > void SetActive(Boolean value) < if (value != active) < if (value) < Activate(); Text = dataBase.Value(dataField); >else < Deactivate(); Text = ""; >// Set active only if successful. active = value; > > void Activate() < // Open database. >void Deactivate() < // Close database. >>
В предыдущем примере данное выражение определяет, находится ли объект в состоянии, в котором способность связывания данных может самоактивироваться:
dataSource != null && dataField != null
Вы делаете активацию автоматической, создавая метод, который определяет возможность активации объекта, исходя из его текущего состояния, и затем активирует его, если это необходимо.
void UpdateActive()
Если у вас есть взаимосвязанные свойства, такие как DataSource и DataMember, вы должны реализовать интерфейс ISupportInitialize. Это позволит разработчику (или пользователю) вызывать методы ISupportInitialize.BeginInit и ISupportInitialize.EndInit при определении множества свойств, чтобы дать возможность компоненту предоставлять оптимизации. В примере, приведенном выше, ISupportInitialize может предотвратить ненужные попытки доступа к базе данных до тех пор пока установка не завершена корректно.
Выражение, появляющееся в этом методе, обозначает, какие части модели объекта должны быть проверены, чтобы осуществлять эти переходы из одного состояния в другое. В этом случае оказывают влияния свойства DataSource и DataField. Более подробная информации о выборе между свойствами и методами представлена в разделе Свойства и методы.
Вызов событий изменения свойства
События изменения свойств должны вызываться в компонентах, если надо уведомлять потребителей о программном изменении свойства компонента. По соглашению о присваивании имен имена событий изменения свойства формируются из имени свойства и суффикса Changed, как TextChanged. Например, элемент управления вызывает событие TextChanged, когда изменяется его свойство text. Чтобы вызвать это событие, можно использовать protected вспомогательную процедуру RaiseChanged. Однако, возможно, не стоит вызывать событие изменения свойства для добавления элемента хэш-таблицы, т.к. это влечет за собой лишние затраты производительности. Следующий пример иллюстрирует реализацию вспомогательной процедуры для события произошедшего изменения свойства.
class Control: Component < string text; public string Text < get < return text; >set < if (!text.Equals(value)) < text = value; RaiseTextChangedEvent(); >> > >
При связывании данных этот шаблон используется для того, чтобы обеспечить возможность двухстороннего связывания свойства. Без событий Changed и RaiseChanged связывание данных работает в одном направлении: если изменяется база данных, свойство обновляется. Каждое свойство, вызывающее событие Changed, должно предоставлять метаданные для подтверждения того, что свойство поддерживает связывание данных.
Рекомендуется вызывать события происходящего/произошедшего изменения, если значение свойства изменяется в результате внешних вмешательств. Эти события показывают разработчику, что значение свойства изменяется или изменилось в результате операции, а не из-за вызова методов объекта.
Хорошим примером в данном случае является свойство Text элемента управления Edit. По мере того как пользователь записывает информацию в элемент управления, значение свойства автоматически изменяется. Событие вызывается до того, как значение свойства изменилось. Оно не передает старое или новое значение, и разработчик может отменить событие, сформировав исключительную ситуацию. Имя события состоит из имени свойства и суффикса Changing. Далее приведен пример события происходящего изменения.
class Edit : Control < public string Text < get < return text; >set < if (text != value) < OnTextChanging(Event.Empty); text = value; >> > >
Событие также вызывается после того, как значение свойства уже изменилось. Это событие не может быть отменено. Имя события формируется из имени свойства и суффикса Changed. Также должно вызываться характерное событие PropertyChanged. Шаблоном для вызова этих событий является вызов особого события из метода OnPropertyChanged. Следующий пример иллюстрирует использование метода OnPropertyChanged.
class Edit : Control < public string Text < get < return text; >set < if (text != value) < OnTextChanging(Event.Empty); text = value; RaisePropertyChangedEvent(Edit.ClassInfo.text); >> > protected void OnPropertyChanged(PropertyChangedEvent e) < if (e.PropertyChanged.Equals(Edit.ClassInfo.text)) OnTextChanged(Event.Empty); if (onPropertyChangedHandler != null) onPropertyChangedHandler(this, e); >>
Возможны ситуации, когда базовое значение свойства не сохраняется как поле, что осложняет отслеживание изменений значения. При вызове события происходящего изменения найдите все места, на которые окажет влияние изменение значения события, и обеспечьте возможность отменить событие. Например, предыдущий пример элемента управления Edit не вполне правильный, потому что значение Text в действительности сохраняется в описателе окна (HWND). Для вызова события TextChanging вы должны проверить сообщения Windows, чтобы определить, когда может измениться текст, и предусмотреть появление исключительной ситуации в OnTextChanging, чтобы отменить событие. Если обеспечить событие происходящего изменения слишком сложно, разумно будет поддерживать только событие произошедшего изменения.
Свойства и методы
Используйте свойство, когда член класса является логическим членом данных. В следующем примере Name - это свойство, потому что это - логический член класса.
public string Name get < return Name; >set
Type type = // Get a type. for (int i = 0; i < type.Methods.Length; i++) < if (type.Methods[i].Name.Equals ("text")) < // Perform some operation. >>
Следующий пример иллюстрирует правильное применение свойств и методов.
class Connection < // The following three members should be properties // because they can be set in any order. string DNSName ;set<>;> string UserName ;set<>;> string Password ;set<>;> // The following member should be a method // because the order of execution is important. // This method cannot be executed until after the // properties have been set. bool Execute (); >
Свойства только для чтения и только для записи
Вы должны использовать свойства только для чтения тогда, когда пользователь не может изменять логические члены данных свойства. Не используйте свойства только для записи.
Использование индексированных свойств
// Change the MethodInfo Type.Method property to a method. MethodInfo Type.Method[string name] MethodInfo Type.GetMethod (string name, Boolean ignoreCase) // The MethodInfo Type.Method property is changed to // the MethodInfo Type.GetMethod method. MethodInfo Type.GetMethod(string name) MethodInfo Type.GetMethod (string name, Boolean ignoreCase)
Рекомендации по использованию событий
public delegate void MouseEventHandler(object sender, MouseEventArgs e);
public class MouseEvent: EventArgs <>
public class MyComponent : Component < static readonly object EventClick = new object(); static readonly object EventMouseDown = new object(); static readonly object EventMouseUp = new object(); static readonly object EventMouseMove = new object(); public event MouseEventHandler Click < add < Events.AddHandler(EventClick, value); >remove < Events.RemoveHandler(EventClick, value); >> // Code for the EventMouseDown, EventMouseUp, and // EventMouseMove events goes here. // Define a private data structure to store the event delegates >
public class Button < ButtonClickHandler onClickHandler; protected virtual void OnClick(ClickEvent e) < // Call the delegate if non-null. if (onClickHandler != null) onClickHandler(this, e); >>
public class Button < ButtonClickHandler onClickHandler; protected void DoClick() < // Paint button in indented state. PaintDown(); try < // Call event handler. OnClick(); >finally < // Window might be deleted in event handler. if (windowHandle != null) // Paint button in normal state. PaintUp(); >> protected virtual void OnClick(ClickEvent e) < if (onClickHandler != null) onClickHandler(this, e); >>
public class Form1: Form < TreeView treeView1 = new TreeView(); void treeView1_BeforeLabelEdit(object source, NodeLabelEditEvent e) < e.cancel = true; >>
Обратите внимание, что в данном случае не возникает сообщения об ошибке. Метка является свойством только для чтения. Событие CancelEvent не подходит в тех случаях, когда разработчик хочет иметь возможность отменять операцию и возвращать исключительную ситуацию. В таких случаях событие не наследуется от CancelEvent. Вы должны вызвать исключительную ситуацию внутри обработчика события, для того чтобы отменить. Например, пользователь может пожелать записать логику проверки правильности в элемент управления Еdit, как показано ниже.
public class Form1: Form
Рекомендации по использованию методов
Рекомендации по перезагрузке методов
int String.IndexOf (String name); int String.IndexOf (String name, int startIndex);
// Method #1: ignoreCase = false. MethodInfo Type.GetMethod(String name); // Method #2: Indicates how the default behavior of method #1 is being // changed. MethodInfo Type.GetMethod (String name, Boolean ignoreCase);
public class SampleClass < readonly string defaultForA = "default value for a"; readonly string defaultForB = "default value for b"; readonly string defaultForC = "default value for c"; public void Execute() < Execute(defaultForA, defaultForB, defaultForC); >public void Execute (string a) < Execute(a, defaultForB, defaultForC); >public void Execute (string a, string b) < Execute (a, b, defaultForC); >public virtual void Execute (string a, string b, string c) < Console.WriteLine(a); Console.WriteLine(b); Console.WriteLine(c); Console.WriteLine(); >>
public class SampleClass < public void Execute(string a) < Execute(new string[] ); > public void Execute(string a, string b) < Execute(new string[] ); > public void Execute(string a, string b, string c) < Execute(new string[] ); > public virtual void Execute(string[] args) < foreach (string s in args) < Console.WriteLine(s); >> >
public class SampleClass < private string myString; public MyClass(string str) < this.myString = str; >public int IndexOf(string s) < return IndexOf (s, 0); >public int IndexOf(string s, int startIndex) < return IndexOf(s, startIndex, myString.Length - startIndex ); >public virtual int IndexOf(string s, int startIndex, int count) < return myString.IndexOf(s, startIndex, count); >>
Методы с переменным количеством аргументов
Вы, возможно, захотите создать метод, имеющий переменное количество аргументов. Классическим примером этого является метод printf в языке программирования С. В управляемых библиотеках классов для этого структурного компонента используйте ключевое слово params (ParamArray в Visual Basic). Например, вместо нескольких перезагружаемых методов используйте следующий код:
void Format(string formatString, params object [] args)
Рекомендации по использованию конструктора
Если в классе присутствуют только статические методы и свойства, обеспечьте private конструктор, применяемый по умолчанию. В следующем примере private конструктор препятствует созданию класса.
public sealed class Environment < // Private constructor prevents the class from being created. private Environment() < // Code for the constructor goes here. >>
// Example #1. Class SampleClass = new Class(); SampleClass.A = "a"; SampleClass.B = "b"; // Example #2. Class SampleClass = new Class("a"); SampleClass.B = "b"; // Example #3. Class SampleClass = new Class ("a", "b");
public class SampleClass < private const string defaultForA = "default value for a"; private const string defaultForB = "default value for b"; private const string defaultForC = "default value for c"; private string a; private string b; private string c; public MyClass():this(defaultForA, defaultForB, defaultForC) <>public MyClass (string a) : this(a, defaultForB, defaultForC) <> public MyClass (string a, string b) : this(a, b, defaultForC) <> public MyClass (string a, string b, string c) < this.a = a; this.b = b; this.c = c; >>
Рекомендации по использованию полей
Не используйте public или protected (Public или Protected в Visual Basic) поля экземпляра. Если отменить раскрытие полей непосредственно разработчиком, поддержание версий классами может быть упрощено потому, что поле не сможет преобразовываться в свойство пока поддерживает двоичную совместимость. Рассмотрите возможность применения к полям аксессоров свойств get и set вместо того, чтобы делать их public. Наличие выполняемого кода в аксессорах свойств get и set делает возможными последующие усовершенствования, такие как создание объекта по запросу при использовании свойства или при нотификации изменения свойства. Следующий пример кода иллюстрирует правильное использование private полей экземпляра с аксессорами свойств get и set.
public struct Point < private int xValue; private int yValue; public Point(int x, int y) < this.xValue = x; this.yValue = y; >public int X < get < return xValue; >set < xValue = value; >> public int Y < get < return yValue; >set < yValue = value; >> >
public class Control: Component < private int handle; protected int Handle < get < return handle; >> >
public struct Int32 < public static readonly int MaxValue = 2147483647; public static readonly int MinValue = -2147483648; // Insert other members here. >
class SampleClass
public struct Color < public static readonly Color Red = new Color(0x0000FF); public static readonly Color Green = new Color(0x00FF00); public static readonly Color Blue = new Color(0xFF0000); public static readonly Color Black = new Color(0x000000); public static readonly Color White = new Color(0xFFFFFF); public Color(int rgb) < // Insert code here.>public Color(byte r, byte g, byte b) < // Insert code here.>public byte RedValue < get < return Color; >> public byte GreenValue < get < return Color; >> public byte BlueValue < get < return Color; >> >
Рекомендации по использованию параметров
Найдите действительные аргументы параметра. Осуществите проверку правильности аргумента для каждого аксессора set public или protected метода и свойства. Сформируйте значимые исключительные ситуации для разработчика в случае появления неправильных аргументов параметров. Используйте класс System.ArgumentException или класс, наследуемый от System.ArgumentException. Далее приведен пример проверки действительных аргументов параметра и формирования значимых исключительных ситуаций.
class SampleClass < public int Count < get < return count; >set < // Check for valid parameter. if (count < 0 || count >= MaxValue) throw newArgumentOutOfRangeException( Sys.GetString( "InvalidArgument","value",count.ToString())); > > public void Select(int start, int end) < // Check for valid parameter. if (start < 0) throw new ArgumentException( Sys.GetString("InvalidArgument","start",start.ToString())); // Check for valid parameter. if (end < 0) throw new ArgumentException( Sys.GetString("InvalidArgument","end",end.ToString())); >>
Рекомендации по использованию типов
Типы - это элементы инкапсуляции в общеязыковой среде выполнения. Детальное описание полного списка типов данных, поддерживаемых средой выполнения, приведено в разделе MSDN Common Type System. В этом разделе представлены рекомендации по использованию основных типов.
Рекомендации по использованию основных классов
Класс - это наиболее общий вид типа. Класс может быть абстрактным или sealed. Чтобы предоставить реализацию, абстрактному классу нужен наследуемый класс. От sealed класса наследоваться невозможно. Рекомендуется использовать классы через другие типы.
Базовые классы являются удобным способом сгруппировать объекты, которые совместно используют ряд функциональных возможностей. Базовые классы предоставляют набор функциональных возможностей по умолчанию, а также поддерживают создание специального программного продукта через расширение этих возможностей.
Добавляйте расширяемость и полиформизм в свой проект, только если имеете четкий сценарий заказчика. Например, обеспечить интерфейс для адаптеров данных сложно и это не приносит реальной пользы. Разработчикам все еще придется программировать специально для каждого адаптера, т.е. от предоставления интерфейса есть только незначительная выгода. Однако вы должны поддерживать совместимость между всеми адаптерами. Хотя интерфейс или абстрактный класс в данной ситуации не подходят, очень важно обеспечить совместимую модель. Вы можете предоставить совместимую модель разработчикам в базовых классах. Следуйте этим рекомендациям при разработке базовых классов.
Сравнение базовых классов и интерфейсов
Тип интерфейса - это частичное описание значения, потенциально поддерживаемое многими объектными типами. Везде, где это возможно, используйте базовые классы вместо интерфейсов. С точки зрения поддержки версий, классы более гибкие, чем интерфейсы. Используя классы, можно выпустить Версию 1.0, а затем в Версии 2.0 добавить в класс новый метод. Поскольку метод не абстрактен, любой существующий дочерний класс продолжает функционировать без изменений.
Т.к. интерфейсы не поддерживают наследование реализации, модель, применяемая к классам, неприменима к интерфейсам. Добавление метода к интерфейсу эквивалентно добавлению абстрактного метода в базовый класс; любой класс, реализующий интерфейс, разрушится, потому что класс не реализовывает новый метод.
Во всех других ситуациях наилучшей моделью является наследование классов.
Protected методы и конструкторы
Обеспечивают создание произвольных классов через protected методы. Public интерфейс базового класса должен предоставлять потребителю класса богатый набор функциональных возможностей. Однако для обеспечения этого богатого набора функциональных возможностей пользователи класса часто стремятся реализовать как можно меньшее число методов. Для достижения этой цели, предоставьте ряд невиртуальных или final public методов, которые вызывают единственный protected метод, обеспечивающий реализации методов. Этот метод должен быть отмечен суффиксом Impl. Этот процесс продемонстрирован в следующем примере кода.
public class MyClass < private int x; private int y; private int width; private int height; BoundsSpecified specified; public void SetBounds(int x, int y, int width, int height) < SetBoundsCore(x, y, width, height, this.specified); >public void SetBounds(int x, int y, int width, int height, BoundsSpecified specified) < SetBoundsCore(x, y, width, height, specified); >protected virtual void SetBoundsCore(int x, int y, int width, int height, BoundsSpecified specified) < // Add code to perform meaningful opertions here. this.x = x; this.y = y; this.width = width; this.height = height; this.specified = specified; >>
Многие компиляторы, если вы этого не сделаете, вставят конструкторы public или protected. Поэтому для улучшения документирования и читабельности исходного кода, необходимо явно определить protected конструктор во всех абстрактных классах.
Рекомендации по использованию sealed классов
public sealed class Runtime < // Private constructor prevents the class from being created. private Runtime(); // Static method. public static string GetCommandLine() < // Implementation code goes here. >>
Рекомендации по использованию типов значений
Тип значения описывает значение, которое представлено как последовательность битов, сохраненных в стеке. Описание всех встроенных типов данных .NET Framework приведено в разделе MSDN Value Types. В этом разделе представлены рекомендации по использованию типов значений структуры (struct) и перечисления (enum).
Рекомендации по использованию структур
В следующем примере показана корректно определенная структура.
public struct Int32: IComparable, IFormattable < public const int MinValue = -2147483648; public const int MaxValue = 2147483647; public static string ToString(int i) < // Insert code here. >public string ToString(string format, IFormatProvider formatProvider) < // Insert code here. >public override string ToString() < // Insert code here. >public static int Parse(string s) < // Insert code here. return 0; >public override int GetHashCode() < // Insert code here. return 0; >public override bool Equals(object obj) < // Insert code here. return false; >public int CompareTo(object obj) < // Insert code here. return 0; >>
При использовании struct не предоставляйте конструктор по умолчанию. Среда выполнения добавит конструктор, который устанавливает все значения в нулевое состояние. Это дает возможность более эффективно создавать массивы структур. Вы также должны разрешить состояние, в котором данные экземпляра устанавливаются в нуль (zero), false или null (соответственно) без вызова конструктора.
Рекомендации по применению Enum
Применяйте enum к параметрам, свойствам и возвращаемым типам со строгим типом. Всегда определяйте пронумерованные значения, используя enum, если они используются в параметре или свойстве. Это обеспечивает возможность инструментальным средствам разработки знать возможные значения свойства или параметра. В следующем примере показано, как определить enum тип.
public enum FileMode
public FileStream(string path, FileMode mode);
[Flags] public enum Bindings
public void SetColor (Color color)
Рекомендации по использованию делегатов
Делагаты - это мощный инструментарий, обеспечивающий возможность разработчику объектной модели управляемого кода инкапсулировать вызовы методов. Делегаты полезны для нотификаций событий и функций обратного вызова.
Используйте соответствующую схему разработки события для событий даже в том случае, если событие не связано с пользовательским интерфейсом. Подробнее об использовании событий смотри в разделе Рекомендации по использованию событий.
Функции обратного вызова
Функции обратного вызова передаются методу таким образом, что код пользователя может многократно вызываться во время выполнения, чтобы обеспечить гибкость. Передача функции обратного вызова Compare в процедуру сортировки является классическим примером использования функций обратного вызова. Эти методы должны использовать соглашение функций обратного вызова, описанные в разделе MSDN Использование функций обратного вызова (Callback Function Usage).
В имени функции обратного вызова используйте суффикс Callback.
Рекомендации по использованию атрибутов
.NET Framework дает возможность разработчикам создавать новые виды декларативной информации, определять декларативную информацию для различных сущностей программы и извлекать информацию атрибута в среде времени выполнения. Например, оболочка может определить атрибут HelpAttribute, который можно поместить в элементы программы, такие как классы и методы, чтобы обеспечить преобразование от элементов программы к их документации. Новые виды декларативной информации определяются через декларацию классов атрибутов, которые могут иметь позиционные и поименованные параметры. Более подробная информация об атрибутах приведена в разделе MSDN Создание специальных атрибутов (Writing Custom Attributes).
Добавьте суффикс Attribute к специальным классам атрибутов, как показано в следующем примере.
public class ObsoleteAttribute<>
[AttributeUsage(AttributeTargets.All, Inherited = false, AllowMultiple = true)] public class ObsoleteAttribute: Attribute <>
public class NameAttribute: Attribute < public NameAttribute (string username) < // Implement code here. >public string UserName < get < return UserName; >> public int Age < get < return Age; >set < Age = value; >> // Positional argument. >
Рекомендации по использованию вложенных типов
Вложенные типы - это типы, определенные в контексте другого типа. Вложенные типы очень полезны для инкапсулирования деталей реализации типа, например, энумератор в коллекции, потому что они могут иметь доступ к private состоянию.
В следующих примерах проиллюстрировано, как определить типы с или без вложенных типов:
// With nested types. ListBox.SelectedObjectCollection // Without nested types. ListBoxSelectedObjectCollection // With nested types. RichTextBox.ScrollBars // Without nested types. RichTextBoxScrollBars
Рекомендации по раскрытию функциональных возможностей для COM
Общеязыковая среда выполнения предоставляет богатую поддержку для взаимодействия с компонентами COM. Компонент СОМ может использоваться из управляемого типа, и управляемый экземпляр может использоваться компонентом СОМ. Эта поддержка является ключом для преобразования неуправляемого кода в управляемый; однако это порождает некоторые проблемы для разработчиков библиотек классов. Для того, чтобы полностью раскрыть управляемый тип клиенту СОМ, тип должен раскрыть функциональность способом, поддерживаемым СОМ и контрактом поддержания версий СОМ.
Отметьте библиотеки управляемых классов атрибутом ComVisibleAttribute, чтобы обозначить, как клиенты СОМ могут использовать библиотеку: прямо или через упаковщик, формирующий функциональность таким образом, чтобы клиенты могли ее использовать.
Типы и интерфейсы, которые должны использоваться клиентами СОМ прямо, например, расположение в неуправляемом контейнере, должны быть отмечены атрибутом ComVisible (true). Транзитивное замыкание всех типов, к которым обращаются раскрытые типы, должно быть явно отмечено, как ComVisible (true); в противном случае, они будут раскрыты, как IUnknown.
Примечание: члены типа также могут быть отмечены, как ComVisible (false); это сокращает воздействие на СОМ и, следовательно, снижает ограничения использования управляемого типа.
Типы, отмеченные атрибутом ComVisible (true), могут раскрывать функциональность исключительно тем способом, который поддерживается в СОМ. В частности, СОМ не поддерживает статические методы или параметризованные конструкторы. Для подтверждения корректности поведения, протестируйте функциональность типа из СОМ клиентов. Убедитесь, что вы понимаете влияние registry на то, чтобы сделать все типы cocreateable.
Передача по ссылке
Рекомендации по генерированию и обработке ошибок
public class FileNotFoundException : Exception < // Implementation code goes here. >
public class XxxException : ApplicationException < XxxException() XxxException(string message) XxxException(string message, Exception inner) >
class FileRead < void Open() < FileStream stream = File.Open("myfile.txt", FileMode.Open); byte b; // ReadByte returns -1 at end of file. while ((b = stream.ReadByte()) != true) < // Do something. >> >
class File < string fileName; public byte[] Read(int bytes) < if (!ReadFile(handle, bytes)) throw NewFileIOException(); >FileException NewFileIOException() < string description = // Build localized string, include fileName. return new FileException(description); >>
Стандартные типы исключительных ситуаций
В следующей таблице приведен список стандартных исключительных ситуаций, предоставляемых средой выполнения, и условий, для которых вы должны создавать наследуемый класс.
arr[arr.Length+1]
object o = null; o.ToString();
String s = null; "Calculate".IndexOf (s);
String s = "string"; s.Chars[9];
Обернутые исключительные ситуации
Это ошибки, которые возникают на том же уровне, на котором компонент должен сформировать исключительную ситуацию, имеющую значение для конечных пользователей. В следующем примере сообщение об ошибке предназначено для пользователей класса TextReader, пытающимся читать из потока.
public class TextReader < public string ReadLine() < try < // Read a line from the stream. >catch (Exception e) < throw new IOException ("Could not read from stream", e); >> >
Рекомендации по использованию массивов
Общее описание массивов и использования массивов приведено в разделе MSDN Arrays и System.Array Class.
Сравнение массивов и коллекций
Более подробно об использовании коллекций смотри в разделе MSDN Группирование данных в коллекции (Grouping Data in Collections).
Использование индексированных свойств в коллекциях
Вы должны использовать индексированное свойство только как члены, используемые по умолчанию, класса коллекции или интерфейса. Не создавайте семейств функций в типах, не являющимися коллекциями. Шаблоны таких методов, как Add, Item и Count, предупреждают о том, что тип, использующий их, должен быть коллекцией.
Array Valued свойства
Вы должны использовать коллекции, чтобы избежать неэффективности кода. В следующем примере каждое обращение к свойству myObj создает копию массива. В результате в следующем цикле будет создана 2n+1 копия массива.
for (int i = 0; i < obj.myObj.Count; i++) DoSomething(obj.myObj[i]);
Более подробная информация приведена в разделе Свойства и методы.
Возвращение пустых массивов
Свойства String и Array никогда не должны возвращать нулевую ссылку. В этом контексте может быть трудно осмыслить нуль (Null). Например, пользователь может предположить, что следующий код будет работать:
public void DoSomething() < string s = SomeOtherFunc(); if (s.Length >0) < // Do something else. >>
Общим правилом является то, что нуль (null), пустая строка ("") и пустые (0 элементов) массивы должны интерпретироваться одинаково. Возвращайте вместо нулевой ссылки пустой массив.
Рекомендации по использованию перезагрузки операторов
class Time < TimeSpan operator -(Time t1, Time t2) < >TimeSpan Difference(Time t1, Time t2) < >>
В данной таблице приведен список символов операторов и соответствующих имен альтернативных методов и операторов.
| Символ оператора C++ | Имя альтернативного метода | Имя оператора |
| Не определен | ToXxx или FromXxx | op_Implicit |
| Не определен | ToXxx или FromXxx | op_Explicit |
| + (binary) | Add | op_Addition |
| - (binary) | Subtract | op_Subtraction |
| * (binary) | Multiply | op_Multiply |
| / | Divide | op_Division |
| % | Mod | op_Modulus |
| ^ | Xor | op_ExclusiveOr |
| & (binary) | BitwiseAnd | op_BitwiseAnd |
| | | BitwiseOr | op_BitwiseOr |
| && | And | op_LogicalAnd |
| || | Or | op_LogicalOr |
| = | Assign | op_Assign |
| LeftShift | op_LeftShift | |
| >> | RightShift | op_RightShift |
| Не определен | LeftShift | op_SignedRightShift |
| Не определен | RightShift | op_UnsignedRightShift |
| == | Equals | op_Equality |
| > | Compare | op_GreaterThan |
| Compare | op_LessThan | |
| != | Compare | op_Inequality |
| >= | Compare | op_GreaterThanOrEqual |
| Compare | op_LessThanOrEqual | |
| *= | Multiply | op_MultiplicationAssignment |
| -= | Subtract | op_SubtractionAssignment |
| ^= | Xor | op_ExclusiveOrAssignment |
| < | LeftShift | op_LeftShiftAssignment |
| %= | Mod | op_ModulusAssignment |
| += | Add | op_AdditionAssignment |
| &= | BitwiseAnd | op_BitwiseAndAssignment |
| |= | BitwiseOr | op_BitwiseOrAssignment |
| , | Не присвоено | op_Comma |
| /= | Divide | op_DivisionAssignment |
| -- | Decrement | op_Decrement |
| ++ | Increment | op_Increment |
| - (одинарный) | Negate | op_UnaryNegation |
| + (одинарный) | Plus | op_UnaryPlus |
| ~ | OnesComplement | op_OnesComplement |
Рекомендации по применению метода Equals и оператора равенства (==)
Информация, касающаяся реализации метода Equals, представлена в разделе MSDN Реализация метода Equals (Implementing the Equals Method).
Реализация оператора равенства (==) в типах значений
В большинстве языков программирования нет реализации по умолчанию для оператора равенства (==). Поэтому вы должны перезагрузить == в любое время, когда равенство имеет место.
Вы должны продумать реализацию метода Equals в типах значений, потому что реализация по умолчанию в System.ValueType не будет работать так же, как ваша специальная реализация.
Реализовывайте == всегда, когда переопределяете метод Equals.
Реализация оператора равенства (==) в ссылочных типах
Большинство языков программирования предоставляют реализацию по умолчанию для оператора равенства (==) для ссылочных типов. Поэтому вы должны быть осторожными при реализации == в ссылочных типах. Большинство ссылочных типов, даже реализующие метод Equals, не должны переопределять ==.
Переопределите ==, если ваш тип является базовым типом, таким как Point, String, BigNumber и т.д. Всегда, когда рассматриваете переопределение операторов сложения (+) или вычитания (-), вы должны также рассмотреть и переопределение ==.
Рекомендации по приведению типов
Общие шаблоны разработки
В этом разделе приведены рекомендации по реализации общих шаблонов разработки в библиотеках классов.
Применение методов Finalize и Dispose для очистки неуправляемых ресурсов
Экземпляры классов часто инкапсулируют элемент управления поверх ресурсов, таких как описатель окна (HWND), соединения с базами данных и т.д., которые не управляются средой выполнения. Поэтому вы должны обеспечить как явный, так и неявный способ освобождения этих ресурсов. Неявный контроль обеспечьте реализацией в объекте protected метода Finalize (синтаксис деструктора в C# и управляемые расширения (Managed Extensions) для С++). Сборщик мусора вызывает этот метод в определенный момент после того, как больше не существует ни одной действительной ссылки на объект.
В некоторых случаях может понадобится предоставить программистам, использующим объект, возможность явно освобождать эти внешние ресурсы до того, как это сделает сборщик мусора. В случае, если внешние ресурсы недостаточны или дороги, лучшей производительности можно достигнуть явно освобождая ресурсы, которые больше не используются. Чтобы предоставить явный контроль, реализуйте метод Dispose, поставляемый интерфейсом IDisposable. Потребитель объекта должен вызвать этот метод, когда использование объекта закончено. Метод Dispose может быть вызван даже тогда, когда существуют и другие ссылки на объект.
Обратите внимание, что и когда вы предоставляете явный контроль, применяя метод Dispose, вы должны обеспечить неявную очистку методом Finalize. Если программисту не удалось вызвать метод Dispose, использование метода Finalize предотвращает постоянную утечку ресурсов.
Более подробно об использовании методов Finalize и Dispose для очистки неуправляемых ресурсов смотри в разделе MSDN Programming for Garbage Collection. Следующий пример иллюстрирует основную схему разработки для реализации метода Dispose.
// Design pattern for a base class. public class Base: IDisposable < //Implement IDisposable. public void Dispose() < Dispose(true); GC.SuppressFinalize(this); >protected virtual void Dispose(bool disposing) < if (disposing) < // Free other state (managed objects). >// Free your own state (unmanaged objects). // Set large fields to null. > // Use C# destructor syntax for finalization code. ~Base() < // Simply call Dispose(false). Dispose (false); >// Design pattern for a derived class. public class Derived: Base < protected override void Dispose(bool disposing) < if (disposing) < // Release managed resources. >// Release unmanaged resources. // Set large fields to null. // Call Dispose on your base class. base.Dispose(disposing); > // The derived class does not have a Finalize method // or a Dispose method with parameters because it inherits // them from the base class. >
Более подробный пример, иллюстрирующий схему разработки для реализации методов Finalize и Dispose, смотри в разделе MSDN Implementing a Dispose Method.
Изменение имени метода Dispose
Иногда домен-специфическое имя больше подходит, чем Dispose. Например, инкапсуляция файла может захотеть использовать имя метода Close. В этом случае реализуйте метод Dispose как private и создайте public метод Close, который вызывает метод Dispose. Следующий пример иллюстрирует эту схему. Вы можете заменить имя Close именем метода, которое соответствует вашему домену.
// Do not make this method virtual. // A derived class should not be allowed // to override this method. public void Close() < // Call the Dispose method with no parameters. Dispose(); >