Отправить get запрос и получить ответ
Вот такой метод я использую для вытягивания xml с новостями:
public String getXMLString() < String xml2String = null; try< URL rssURL = new URL("http://адрес_скрыт/rss.xml"); URLConnection yc = rssURL.openConnection(); BufferedReader bufReader = new BufferedReader(new InputStreamReader(yc.getInputStream())); StringBuilder sb = new StringBuilder(); String line = bufReader.readLine(); while( line != null)< sb.append(line).append("\n"); line = bufReader.readLine(); >bufReader.close(); xml2String = sb.toString(); >catch(Exception ex) < logger.error(ex.getMessage()); >return xml2String; > Отслеживать
ответ дан 11 июн 2017 в 20:01
Vlad Vetrov Vlad Vetrov
636 1 1 золотой знак 6 6 серебряных знаков 13 13 бронзовых знаков
Отслеживать
ответ дан 11 июн 2017 в 9:51
1,138 5 5 серебряных знаков 14 14 бронзовых знаков
- java
- android
-
Важное на Мете
Похожие
Подписаться на ленту
Лента вопроса
Для подписки на ленту скопируйте и вставьте эту ссылку в вашу программу для чтения RSS.
Дизайн сайта / логотип © 2023 Stack Exchange Inc; пользовательские материалы лицензированы в соответствии с CC BY-SA . rev 2023.10.27.43697
Нажимая «Принять все файлы cookie» вы соглашаетесь, что Stack Exchange может хранить файлы cookie на вашем устройстве и раскрывать информацию в соответствии с нашей Политикой в отношении файлов cookie.
Чем отличаются HTTP-методы GET и POST
HTTP-методы GET и POST — самые распространённые способы отправить или получить данные с сервера. Но в разных случаях оба метода могут быть небезопасными или неудобными в использовании. В этой заметке рассмотрим, какой метод когда использовать.
GET — метод для чтения данных с сайта. Например, для доступа к указанной странице. Он говорит серверу, что клиент хочет прочитать указанный документ. На практике этот метод используется чаще всего, например, в интернет-магазинах на странице каталога. Фильтры, которые выбирает пользователь, передаются через метод GET .
:authority: htmlacademy.ru :method: GET :path: /tutorial/php/http-header POST — метод для отправки данных на сайт. Чаще всего с помощью метода POST передаются формы.
URL-адрес запроса: https://htmlacademy.ru/ Метод запроса: POST Код состояния: 200 Формат запроса
Протокол HTTP очень прост и состоит, по сути, из двух частей — заголовков и тела запроса или ответа.
Тело запроса — это информация, которую передал браузер при запросе страницы. Но тело запроса присутствует только если браузер запросил страницу методом POST . Например, если отправлена форма, то телом запроса будет содержание формы.

Пример GET-запроса. Информация передаётся прямо в заголовке.
GET /blog/?name1=value1&name2=value2 HTTP/1.1 Host: htmlacademy.ru Пример POST-запроса. Информация передаётся в теле запроса:
POST /blog/ HTTP/1.1 Host: htmlacademy.ru name1=value1&name2=value2 GET для безопасных действий, POST для опасных
Говоря совсем просто, GET-запросы лучше не использовать с приватной информацией. Вот почему:
- Они кешируются. Это значит, что логин и пароль, переданные через GET-запрос, могут остаться в интернете навсегда, например, в веб-архиве или кеше Гугла.
- Остаются в истории браузера. Чтобы узнать, какие данные отправлялись, достаточно нажать Ctrl+H.
- Сохраняются в закладках и пересылаются. Можно не обратить внимания и опубликовать в соцсетях или отправить ссылку с приватной информацией в GET-запросе.
- Сохраняются в логах сервера. Например, нельзя отправлять данные банковских карт через GET-запрос, так как это создаёт риски для пользователей.
Таким образом, любые важные данные — логины, пароли, данные карты, персональные данные — лучше передавать с помощью метода POST . Также метод POST поддерживает тип кодирования данных multipart/form-data , что позволяет передавать файлы.
Ещё раз коротко
GET
- Фильтры в интернет-магазинах
- Передача параметров через ссылку
- Другие безопасные запросы
POST
- Любые формы с паролями или банковскими картами
- Формы заявок с персональными данными
- Отправка файлов
Полезные материалы
- Тренажёр по работе с методом GET
- Протокол HTTP
- Где смотреть запросы. Вкладка Network в Chrome DevTools
- Механизм безопасной переадресации после POST-запроса (англ.)
«Доктайп» — журнал о фронтенде. Читайте, слушайте и учитесь с нами.
Читать дальше

Как работает протокол HTTP
HTTP был разработан в 1990-х годах для создания первого интерактивного текстового веб-браузера. За эти годы протокол менялся и совершенствовался, становился более гибким и постепенно превратился в современный интернет. В статье рассмотрим принцип работы протокола и что важно знать о нём разработчику.
- 8 февраля 2023

10 популярных функций в MYSQL, которые вам нужно знать
Без лишних слов принесли вам некоторые популярные функции MySQL, без которых вы точно не обойдётесь в работе.
- 17 января 2023

Подключение файлов в PHP. Метод require()
Способность вызывать сценарий из отдельного файла по его имени называется в PHP подключением файлов. Подключают PHP-сценарии, любые текстовые файлы или HTML-страницы.
- 21 ноября 2022

Массивы в PHP
Массив — это ещё один тип данных, вроде числа или строки. Главное отличие массива от остальных типов данных заключается в его способности хранить в переменной больше одного значения. В предыдущих примерах имя переменной всегда ассоциировалось только с одним значением:
- $name = «Иннокентий»
- $age = 42
А если мы хотим узнать не только пол, имя и возраст пользователя, но и, допустим, любимые сериалы? Очень непросто назвать один самый любимый сериал, а вот вспомнить несколько — намного легче. Сохранение в переменную-массив нескольких значений выглядит так:
$fav_shows = ["game of thrones", "american horror story", "walking dead"];
В этом примере мы сохранили в переменной $fav_shows сразу три значения. Но сохранить эти данные — это только половина дела. Как с ними потом работать? Уже знакомый вам способ вывода переменной на экран не будет работать с массивами:
Так увидеть список любимых сериалов не получится. Дело в том, что массив — это не обычная переменная. Массив хранит не простые типы, вроде текста или чисел (их ещё называют «скалярными типами»), а более сложную структуру данных, поэтому здесь нужен особый подход.
Внутри массива у каждого значения есть адрес, по которому к нему можно обратиться. Такой адрес называется индексом. Индекс — это просто порядковый номер значения внутри массива. Индексация начинается с нуля, так что первый элемент получает индекс — 0 , второй — 1 , и так далее.
Чтобы получить определенный элемент массива, необходимо знать его индекс (ключ). Напечатаем названия всех сериалов из массива через запятую:
Теперь можно дать определение массива: Массив — это совокупность множества элементов вида «ключ: значение».
Массивы позволяют перезаписывать существующие значения и добавлять новые. Добавить новое значение в массив можно так:
$fav_shows[] = "the big bang theory"; Новый элемент автоматически получит индекс равный максимальному индексу из существующих + 1. «Теория большого взрыва» сохранится в массиве под индексом 3 .
Если нам перестал нравиться один из сериалов, так как новый сезон оказался очень плох или появился новый фаворит, значения в массиве можно заменить. Чтобы вычеркнуть старое значение и заменить его новым, нужно присвоить новое значение любому из существующих в массиве индексов:
$fav_shows[4] = "fargo"; Для полного удаления (без замены на другое) значения по его индексу существует функция unset :
unset($fav_shows[4]); - 10 ноября 2022

Синтаксис PHP
Разберёмся, из чего состоит любой язык программирования.
У каждого языка есть правила и конструкции, следуя которым мы выражаем мысли и делаем их понятными для другого человека. В программировании всё точно так же. Но вместо человеческого языка мы используем язык программирования PHP, а в роли нашего собеседника выступает PHP-интерпретатор. Поэтому, чтобы выразить свою мысль, мы должны сделать её понятной для интерпретатора.
- 27 октября 2022
Массивы $_POST и $_GET в PHP. Обработка форм
Формы — это часть языка HTML. Формы нужны для передачи данных от клиента на сервер. Чаще всего формы используются для регистрации пользователей, заполнения анкет, оформления заказа в интернет магазине, и так далее.
Через формы можно отправлять как простую текстовую информацию, так и файлы.
Большую часть времени программирования на PHP вы будете так или иначе работать с формами и данными из них.
HTML описывает то, из каких элементов состоит форма, и как она выглядит. Но без принимающей стороны, то есть сервера, который принимает эти данные и обрабатывает их нужным образом, создавать формы нет никакого смысла.
PHP содержит множество средств для работы с формами. Это позволяет очень просто решать типичные задачи, которые часто возникают в веб-программировании:
- Регистрация и аутентификация пользователя;
- Отправка комментариев на форумах и социальных сетях;
- Оформление заказов.
Практически любой современный сайт содержит как минимум несколько разных HTML-форм.
- 20 октября 2022
Учебник по PHP
- Знакомство с языком
- Что такое PHP
- Синтаксис PHP
- Массивы
- Циклы
- Функции
- Шаблонизация и подключение файлов
- Подключение файлов
- Шаблонизация
- Протокол HTTP и формы
- Протокол HTTP
- Формы
- Уязвимости
- Идентификация пользователя на сайте
- Аутентификация пользователя
- Базы данных
- База данных
- SQL
- MySQL в PHP
- Безопасность в MySQL
- Объекты и использование библиотек
- Объекты
- Библиотеки
- Composer
- 10 сентября 2022

Протокол HTTP и работа с заголовками
Весь современный веб построен на модели взаимодействия клиента и сервера. Как она работает:
- браузер пользователя (клиент) отправляет на сервер запрос с адресом сайта (URL);
- сервер получает запрос и отдаёт клиенту запрошенный контент.
Для реализации процесса используется универсальный протокол HTTP.
- 10 сентября 2022

Защита от SQL-инъекций
Внедрение SQL-кода (SQL инъекция) — один из распространённых способов взлома сайтов, работающих с базами данных. Способ основан на внедрении в запрос произвольного SQL-кода. Внедрение SQL позволяет хакеру выполнить произвольный запрос к базе данных (прочитать содержимое любых таблиц, удалить, изменить или добавить данные).
Атака этого типа возможна, когда недостаточно фильтруются входные данные при использовании в SQL-запросах.
- 10 сентября 2022

Объекты и классы в PHP
Объекты в PHP — это просто ещё один тип данных. Объект позволяет хранить в переменной набор из свойств и их значений, а также встроенные функции. Это делает объекты похожими по своей структуре на ассоциативные массивы. Но отличие от массивов всё-таки есть, и при этом достаточно важное — объекты могут иметь внутреннее состояние.
- 10 сентября 2022
Протокол HTTP и работа с заголовками
Весь современный веб построен на модели взаимодействия клиента и сервера. Как она работает:
- браузер пользователя (клиент) отправляет на сервер запрос с адресом сайта (URL);
- сервер получает запрос и отдаёт клиенту запрошенный контент.
Для реализации процесса используется универсальный протокол HTTP.
Как работает HTTP
Программировать на PHP можно и без знания протокола HTTP. Но для решения ряда задач нужно знать, как именно работает веб-сервер. Ведь PHP — это в первую очередь серверный язык программирования.
���� Протокол HTTP очень прост и состоит из двух частей:
- Заголовков запроса/ответа;
- Тела запроса/ответа.
Сначала идёт список заголовков, затем пустая строка, после неё (если есть) тело запроса/ответа.
И клиент, и сервер могут посылать друг другу заголовки и тело ответа. У клиента доступные заголовки будут одни, у сервера — другие. Рассмотрим, как выглядит работа по протоколу HTTP, когда пользователь хочет загрузить главную страницу социальной сети «ВКонтакте».
-
Браузер пользователя устанавливает соединение с сервером vk.com и отправляет следующий запрос:
GET / HTTP/1.1 Host: vk.com HTTP/1.1 200 OK Server: ApacheВКонтакте
Нам интересен самый первый шаг, где браузер инициирует запрос к серверу vk.com.
Здесь определяется несколько важных параметров:
- Метод, которым будет запрошен контент;
- Адрес страницы;
- Версия протокола.
GET — это метод (глагол), который применяется для доступа к указанной странице. GET используется очень часто, потому что говорит серверу о том, что клиент хочет прочитать указанный документ. Есть и другие методы, один из них мы рассмотрим уже в следующем разделе.
После метода идёт указание на адрес страницы — URI (универсальный идентификатор ресурса). Мы запрашиваем главную страницу сайта, поэтому используется просто слэш — / . В конце строки указана версия протокола, почти всегда это будет HTTP/1.1 .
После строки с указанием основных параметров следует перечисление заголовков. Они передают серверу дополнительную полезную информацию: название и версию браузера, язык, кодировку, параметры кэширования и так далее.
Среди заголовков, которые передаются при каждом запросе, есть один обязательный и самый важный — это заголовок Host . Он определяет адрес домена, который запрашивает браузер клиента.
Сервер, получив запрос, ищет у себя сайт с доменом из заголовка Host , а также указанную страницу. Если запрошенный сайт и страница найдены, клиенту отправляется ответ: HTTP/1.1 200 OK . Такой ответ означает, что документ найден и будет отправлен клиенту.
�� Общая структура стартовой строки ответа:
HTTP/Версия Код состояния Пояснение
Больше всего здесь интересен именно код состояния, он же код ответа сервера. В этом примере код ответа — 200, что означает: сервер работает, документ найден и будет передан клиенту.
Не всегда всё идёт гладко.
Например, запрошенный документ отсутствует или сервер перегружен. В таком случае клиент не получит контент, а код ответа будет отличным от 200.
- 404 — если сервер доступен, но запрошенный документ не найден;
- 503 — если сервер не может обрабатывать запросы по техническим причинам.
Спецификация HTTP 1.1 определяет 40 различных кодов HTTP.
После стартовой строки следуют заголовки, а затем тело ответа.
Работа с заголовками в PHP
В PHP есть все возможности для взаимодействия с HTTP:
- Получение тела запроса;
- Получение заголовков запроса;
- Добавление/изменение заголовков ответа;
- Управление телом ответа.
Разберём всё по порядку.
Получение тела запроса
Тело запроса — это информация, которую передал браузер при запросе страницы. Но тело запроса присутствует только, если браузер запросил страницу методом POST . Дело в том, что POST — это метод, специально предназначенный для отправки данных на сайт. Чаще всего метод POST браузер задействует в момент отправки формы. В этом случае телом запроса будет содержимое формы.
В PHP-сценарии все данные отправленной формы будут доступны в специальном массиве $_POST . Более подробно об этом написано в следующей главе, посвящённой формам.
Получение заголовков запроса
Напомним ещё раз, что заголовки запроса — это метаинформация, отправленная браузером при запросе сценария.
PHP автоматически извлекает такие заголовки и помещает их в специальный массив — $_SERVER . Стоит отметить, что в этом массиве, помимо заголовков, есть и другая информация. Значения заголовков запроса находятся под ключами, которые начинаются с HTTP_ . Подробно всё содержимое этого массива описано в официальной документации.
Пример, как получить предыдущую страницу, с которой перешёл пользователь:
print($_SERVER['HTTP_REFERER']); Добавление/изменение заголовков ответа
В PHP-сценарии можно управлять всеми заголовками ответа, которые попадут к пользователю вместе с контентом страницы. Это возможно, потому что PHP работает на стороне веб-сервера и имеет с ним очень тесную интеграцию. Вот примеры сценариев, когда пригодится управление заголовками ответа:
- Кэширование;
- Переадресация пользователя;
- Установка cookies;
- Отправка файлов;
- Передача дополнительной информации браузеру.
Заголовки ответа нужны для выполнения множества важных задач.
В PHP есть функция для отправки или смены заголовков: header() .
Она принимает имя и значение заголовка и добавляет его в список из всех заголовков, которые уйдут в браузер пользователя после окончания работы сценария.
Например, так выполняется перенаправление пользователя на другую страницу:
header("Location: /index.php"); За переадресацию отвечает заголовок с именем Location , а через двоеточие задаётся значение — адрес страницы для перехода.
Важное замечание по использованию заголовков
Есть одно ограничение: заголовки нельзя отправлять, если пользователю к этому моменту уже отправили любой контент. То есть если показать что-то на экране, например, через функцию print() , то после этого заголовки поменять уже не получится.
Управление телом ответа
Всё, что PHP выводит на экран, является содержимым ответа. Иными словами, вызовы функций print , echo или показ текста через шорт-теги являются телом ответа, которое попадает в браузер пользователю.
Параметры запроса
Мы привыкли, что на нашем сайте каждый PHP-сценарий отвечает за одну страницу. Посетитель сайта вводит в адресную строку путь, который состоит из имени домена и имени PHP-сценария. Например, так: http://weather-diary.ru/day.php .
Но как быть, если одна страница должна показывать разную информацию?
На сайте дневника наблюдений за погодой мы сделали отдельную страницу, чтобы показывать на ней информацию о погоде из истории за один конкретный день. То есть страница одна, но показывает разные данные, в зависимости от выбранного дня.
Также пользователи хотят добавить в закладки адреса страниц с нужными им днями. Получается, что, имея только один сценарий, сделать страницу, способную показывать дневник погоды за любой день невозможно? Вовсе нет!
Из чего состоит URI
URI — это уникальный идентификатор ресурса. Ресурс в нашем случае — это полный путь до страницы сайта. И вот как может выглядеть ресурс для показа погоды за конкретный день:
Разберём, из чего состоит этот URI.
Здесь есть имя домена: weather-diary.ru .
Затем идёт имя сценария: day.php .
А всё, что идёт после — это параметры запроса.
Параметры запроса — это как бы дополнительные атрибуты адреса страницы. Они отделяются от имени страницы знаком запроса. В примере выше параметр запроса только один: date=2017-10-30.
Имя этого параметра: date , значение: 2017-10-15 .
Параметров запроса может быть несколько, тогда они разделяются знаком амперсанда: ?date=2017-10-15&tscale=celsius .
В примере выше указывается два аргумента: дата и единица измерения температуры.
Параметры запроса — как внешние переменные
Теперь в адресе страницы используются параметры запроса, но какая нам от этого польза? Она состоит в том, что если имя страницы вызывает к исполнению соответствующий PHP-сценарий, то параметры запроса превращаются в специальные внешние переменные в этом сценарии. То есть если в адресе присутствуют такие параметры, то их легко получить внутри кода сценария и выполнить с ними какие-нибудь действия. Например, показать погоду за конкретный день в выбранных единицах измерения.
Получение параметров запроса
Если есть внешние переменные, то как их прочитать?
Все параметры запроса находятся в специальном, ассоциативном массиве $_GET , а значит, сценарий, вызванный с таким адресом: day.php?date=2017-10-15&tscale=celsius будет иметь в этом массиве два значения с ключами date и scale .
Запрос на получение данных за выбранный день выглядит так:
В первой строчке примера выше мы получаем значение параметра date , а если он отсутствует, то используем текущую дату в качестве выбранного дня.
Никогда не полагайтесь на существование параметра в массиве $_GET и делайте проверку либо функцией isset() , либо как в этом примере.
В этом задании вы сможете потренироваться использовать $_GET .
Формирование URI с параметрами запроса
Иногда нужно совершить обратную операцию: сформировать адрес страницы, включив туда нужные параметры запроса из массива.
Скажем, на странице погодного дневника надо поставить ссылку на следующий и предыдущий день. Нужно также сохранить выбранную единицу измерений. То есть необходимо сохранить текущие параметры запроса, поменять значение одного из них (день), и сформировать новую ссылку.
Вот как это можно сделать:
Здесь мы использовали две функции:
- basename(__FILE__) — получает имя текущего сценария;
- http_build_query() — преобразует ассоциативный массив в строку запроса.
«Доктайп» — журнал о фронтенде. Читайте, слушайте и учитесь с нами.
Как работает веб-сервер и что такое HTTP-взаимодействие?
В этой статье мы рассказываем о том, как работает веб-сервер, какие данные отправляются и принимаются между вашим браузером и веб-сервером.
Принцип работы веб-сервера
Веб-сервер – это компьютер, который отвечает за хранение файлов веб-сайта и обмен ими с другими компьютерами. Он обычно используется для приема от клиентов запросов на веб-документы и возвращения ответов на них с определенной информацией.
Сайт становится доступен на веб-сервере после того, как зарегистрировано его доменное имя и службой DNS (Domain Name System) выполнено преобразование адресов — то есть связывание IP-адреса, обозначенного набором цифр (например, 192.168.5.12), и доменного имени ( www.site.com ).
С одним IP-адресом может быть связано несколько доменных имен. В этом случае переадресация запроса к нужному сайту происходит за счет программного обеспечения сервера, которое определяет, из какой папки запускать программу или загружать файл.
На веб-сервере хранятся файлы сайта, а именно все HTML-документы и связанные с ними ресурсы, включая изображения, стили CSS, файлы JavaScript, шрифты и видео.
Ресурсы представляют собой не только реальные файлы на сервере (HTML, js, png и т. д.). Часть содержимого генерируется в момент поступления запроса специальным программным кодом с помощью шаблонов и баз данных — например: список новостей, сводка погоды, результаты поиска по сайту, корзина покупок и прочее. Соответственно различают статические (неизменяемые) ресурсы и динамические (изменяемые и адаптированные под конкретного пользователя). Получив запрос на динамическое содержимое, веб-приложение извлекает данные из БД и заполняет ими указанный в запросе шаблон.
Как происходит взаимодействие между клиентом и веб-сервером?
Клиент, которым обычно является веб-браузер, передает веб-серверу запросы на получение ресурсов, обозначенных URL-адресами. Ресурсы — это HTML-страницы, изображения, файлы, медиа-потоки или другие данные, которые необходимы клиенту. В ответ веб-сервер передаёт клиенту запрошенную информацию.
Более детально этот процесс можно описать следующим образом:
- Браузер делит запрошенный URL на три части: протокол, доменное имя, название файла. Например, URL:https:// www.site.com/ file.html будет разделен на следующие части:
- Протокол («https»).
- Доменное имя («www.site.com»).
- Имя файла («file.html»).
- Браузер при помощи сервисов DNS преобразует доменное имя в IP адрес, который используется для связи с серверной машиной.
- Используя полученный IP адрес, браузер связывается с нужным веб-сервером и посылает на него запрос, требующий отправки файла «www.site.com / file.html».
- Веб-сервер получает запрос и ищет указанную в нём HTML-страницу. Если страница существует, сервер отправляет браузеру ответ, в котором будет HTML-код веб-страницы и заголовок с информацией о запрошенном содержимом. Он предназначен для браузера и нужен, чтобы правильно определить размер, язык переданного файла и другие параметры. Пользователь не видит эту информацию. В заголовке передается и код ответа сервера – например, 200 ОК, когда страница найдена, или сообщение об ошибке 404, если сервер не может найти запрошенную страницу. Подробнее о кодах ответа читайте ниже — в разделе «Коды состояния http».
- Браузер читает полученную от сервера HTML-страницу и подгружает другие необходимые ресурсы, которые с ней связаны — изображения, файлы стилей CSS и JavaScript, отвечающие за оформление и функционал страницы, и т. д.
- После того, как браузер закончит загрузку всех этих ресурсов, веб-страница будет отображена на экране монитора.
Схематично взаимодействие между браузером и веб-сервером можно представить так:
Рассмотрим это же взаимодействие на уровне HTTP-протокола.
Что такое HTTP-взаимодействие?
Обмен данными между клиентом и веб-сервером происходит по протоколу HTTP.
HTTP (HyperText Transfer Protocol, то есть «протокол передачи гипертекста») — это протокол, предназначенный для передачи гипертекстовых документов (то есть документов, которые могут содержать ссылки, позволяющие организовать переход к другим документам). Правила HTTP лежат в основе передачи информации в сети Интернет.
Задача, которая традиционно решается с помощью протокола HTTP — обмен данными между пользовательским приложением, осуществляющим доступ к веб-ресурсам (обычно это веб-браузер) и веб-сервером.
Клиентское приложение формирует HTTP-запрос и отправляет его на сервер, после чего серверное программное обеспечение обрабатывает данный запрос, формирует HTTP-ответ и передаёт его обратно клиенту, как правило, вместе с HTML-страницей или другими запрошенными данными.
Каждое HTTP-сообщение состоит из трех частей:
- Стартовая строка (Starting line) — включает служебные данные, определяет тип сообщения.
- Заголовки (Headers) — описывают клиента и сервер, содержимое сообщения, параметры передачи и др. Все заголовки HTTP разделяются на четыре основных группы:
- General Headers («Основные заголовки») — могут включаться в любое сообщение клиента и сервера. Например, заголовок Date используется для хранения даты и времени запроса/ответа.
- Request Headers («Заголовки запроса») — используются только в запросах клиента. Например, заголовки Host, Referer и User-Agent.
- Response Headers («Заголовки ответа») — предназначены только для ответов от сервера. Например, заголовок Server указывает название и версию веб-сервера.
- Entity Headers («Заголовки сущности») — могут находиться как в запросах, так и в ответах. Передают мета-информацию об объекте, отправленном в теле сообщения. Например, все заголовки с префиксом Content- предоставляют информацию о структуре, кодировке и размере тела сообщения. Заголовок Last-Modified содержит время и дату последнего изменения документа.
Больше узнать о заголовках можно в спецификации протокола HTTP.
Стартовая строка и заголовок являются обязательными элементами, а тело сообщения может отсутствовать.
Структура HTTP-запроса от клиента
Если клиент хочет загрузить, например страницу «About», HTTP-запрос может включать следующие элементы:
GET /about.html HTTP/1.1 Host: www.site.com Referer: https://www.google.com/ User-Agent: Mozilla/5.0 (Windows NT 6.3; Win64; x64) Accept-Language: en-us
GET /about.html HTTP/1.1
Стартовая строка, в которой содержатся:
GET — метод запроса, указывающий на основную операцию, которую необходимо осуществить над ресурсом;
/ about.html — запрашиваемый документ;
HTTP – протокол передачи данных;
/1.1 – версия протокола 1.1.
Заголовок Host содержит имя сайта, с которого нужно загрузить документ.
В заголовке Referer прописан URL страницы, откуда сделан запрос.
User-Agent: Mozilla/5.0 (Windows NT 6.3; Win64; x64)
Заголовок User-Agent включает:
Mozilla/5.0 – название и версию браузера, отправившего запрос;
Windows NT 6.3; Win64; x64 – название и версию операционной системы.
Заголовок Accept-Language указывает язык, используемый в браузере.
Структура HTTP-ответа веб-сервера
- Стартовая строка в HTTP-ответе указывает версию протокола передачи данных (HTTP/1.1), код статуса ответа (трехзначное число — например, 200), описание статуса (короткое пояснение к коду ответа – например, OK).
- Заголовки – предоставляют информацию об ответе, сервере или об объекте, отправленном в теле сообщения. Например, в заголовках Content-Type и Content-Length будут указаны тип и размер контента (в байтах).
- Тело ответа – при запросе содержимого веб-ресурса в нём содержится HTML-код запрошенной страницы или выгружаемые файлы. Отделяется от заголовков пустой строкой.
HTTP/1.1 200 OK Server: nginx/1.4.6 (Ubuntu) Date: Mon, 25 Jan 2021 16:54:33 GMT Content-Type: text/html; charset=UTF-8 Content-Length: 98 Last-Modified: Mon, 25 Jan 2021 16:22:21 GMT
An Example Page Hello World
Стартовая строка, в которой прописаны:
HTTP – протокол передачи данных;
/1.1 – версия протокола 1.1;
200 – код ответа сервера (страница доступна);
ОК — пояснение к коду ответа.
Server: nginx/1.4.6 (Ubuntu)
Заголовок Server указывает название и версию сервера, который ответил — nginx/1.4.6 (Ubuntu).
Date: Mon, 25 Jan 2021 16:54:33 GMT
Заголовок Date используется для указания даты и времени ответа.
Content-Type: text/html; charset=UTF-8
В заголовке Content-Type прописаны тип отправленного контента (text/html) и его кодировка (charset=UTF-8).
Заголовок Content-Length указывает размер контента (в байтах) – 98.
Last-Modified: Mon, 25 Jan 2021 16:22:21 GMT
Заголовок Last-Modified содержит дату и время последнего изменения документа.
Тело ответа, в котором содержится HTML-код запрошенной страницы.
Коды состояния HTTP
Трехзначный код, возвращаемый сервером в стартовой строке ответа, называется кодом состояния HTTP. Он определяет результат совершения запроса. Коды состояния HTTP разработаны в соответствии со стандартами, определенными Инженерным советом Интернета (IETF).
Первая цифра кода указывает на класс состояния. В настоящее время выделено пять классов состояния:
- 1xx — Информационное сообщение (информирует о процессе передачи).
- 2xx — Сообщение об успехе (запрос получен и обработан).
- 3xx — Сообщение о перенаправлении (запрашиваемый ресурс был перемещен на другой адрес).
- 4xx — Сообщения об ошибках со стороны клиента (запрос содержит ошибки или не отвечает протоколу).
- 5xx — Сообщения об ошибках, относящихся к серверу (сервер не смог обработать запрос, хотя тот был составлен правильно).
Вторая и третья цифры в коде детализируют статус ответа. Например:
- 200 OK — запрос получен и успешно обработан.
- 201 Created — запрос получен и успешно обработан, в результате чего создан новый ресурс или его экземпляр.
- 301 Moved Permanently — запрашиваемый ресурс был перемещен навсегда, и последующие запросы к нему должны происходить по новому адресу. Адрес, по которому клиенту следует произвести запрос, сервер указывает в заголовке Location.
- 302 Moved Temporarily — ресурс перемещен временно.
- 401 Unauthorized (Неавторизованный запрос) — для доступа к документу необходимо вводить пароль или быть зарегистрированным пользователем.
- 404 Not Found — сервер не нашел ресурс по этому адресу.
- 500 Internal Server Error — сервер столкнулся с непредвиденным условием, которое не позволяет ему выполнить запрос.
- 503 Service Unavailable — сервис недоступен из-за временной перегрузки или отключения на техническое обслуживание.
Набор кодов состояния описан в соответствующих документах RFC («Request for Comments»), содержащих технические спецификации и стандарты, установленные IETF.
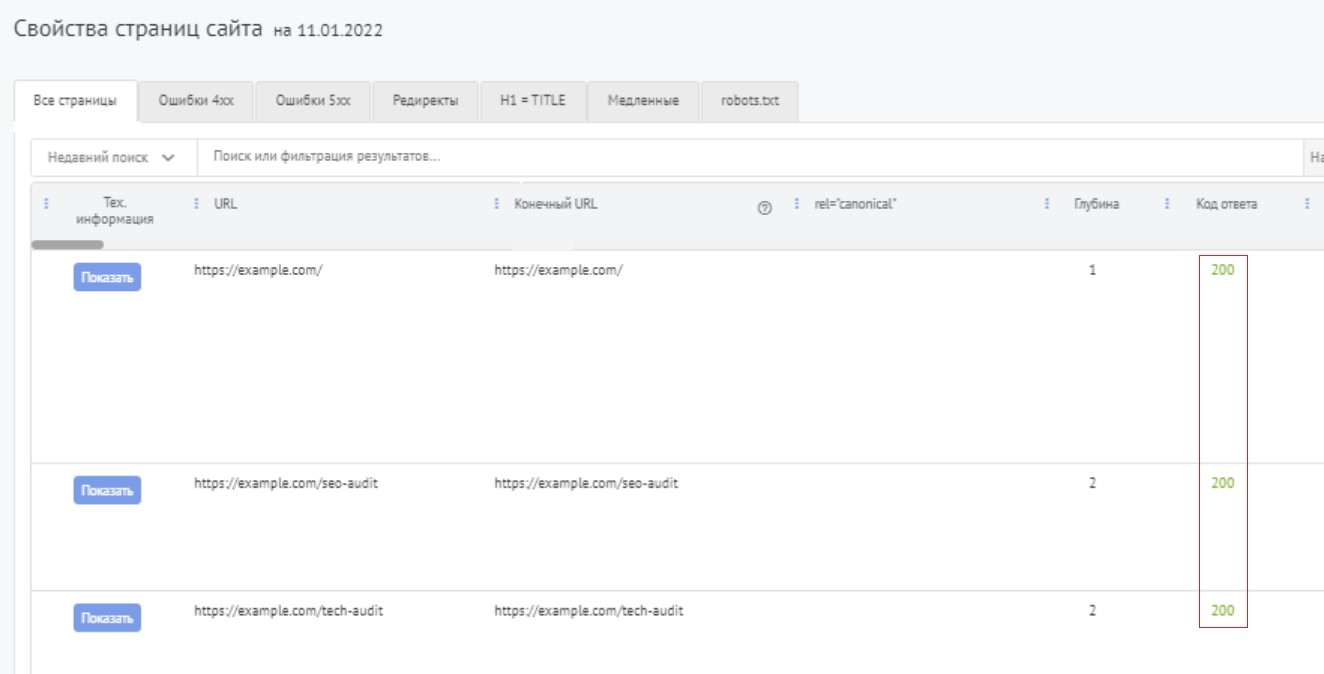
Вы можете проверить код статуса ответа страниц вашего сайта на сервисе Labrika в таблице «Свойства страниц сайта», расположенной в разделе «Инструменты».
Что такое куки (сookie)?
Куки или cookie (от англ. «печенье») — это небольшой текстовый файл с набором служебных данных о посещении сайтов, который веб-сервер отправляет для сохранения в браузере пользователя.
Браузер всякий раз при попытке открыть страницу сайта пересылает cookie обратно веб-серверу.
Примеры использования cookie:
- Автоматическая авторизация — с помощью cookie будут «запоминаться» логин и пароль.
- Для сохранения информации о товарах, добавленных в корзину.
- Для персонализации страниц с помощью cookie сохраняются личная информация и персональные настройки пользователя.
- В инструментах веб-аналитики — для отслеживания действий пользователей и сбора статистики.
От сервера браузеру cookie передаются в составе HTTP-ответа с помощью заголовка Set-Cookie:
HTTP/1.1 200 OK Content-type: text/html Set-Cookie: имя=значение
Браузер отправляет их серверу в HTTP-запросе в заголовке Cookie:
GET /spec.html HTTP/1.1 Host: www.example.org Cookie: имя=значение
Например, cookie могут содержать пароль, если пользователь авторизован на данном сайте:
GET /cart HTTP/1.1 Host: www.site.com Referer: https://www.google.com/ User-Agent: Mozilla/5.0 (Windows NT 6.3; Win64; x64) Accept-Language: en-us Cookie: login=joe@example.com; password=a497f4d4h7b956
Параметры HTTP-заголовков Cookie и Set-Cookie определяются в спецификации RFC 6265.
Без cookie каждый просмотр веб-страницы является изолированным действием, не связанным с другими просмотрами страниц того же сайта. Сookie позволяют выявить связь между просмотрами веб-страниц одним и тем же пользователем.
Аутентификация пользователей (то есть проверка их подлинности) с помощью cookie происходит следующим образом:
- Пользователь вводит логин и пароль в соответствующих полях на странице входа и отправляет их на сервер.
- Сервер получает имя пользователя и пароль, проверяет их и, если они верные, отправляет страницу успешного входа, прикрепив cookie с неким идентификатором сессии. Эти cookie могут быть действительны не только для текущей сессии браузера, но и быть настроены на длительное хранение.
- Каждый раз, когда пользователь запрашивает страницу с сервера, браузер автоматически отправляет cookie с идентификатором сессии серверу. Сервер проверяет идентификатор по своей базе и, при наличии в ней такого идентификатора, «узнаёт» пользователя.
HTTP и HTTPS
При передаче по протоколу HTTP данные не защищаются и передаются в открытом виде.
Расширение HTTPS (аббр. от англ. HyperText Transfer Protocol Secure) создано для того, чтобы соединение было безопасным, а данные передавались в зашифрованном виде по криптографическому протоколу SSL (secure sockets layer) или TLS (transport layer security). Это специальная «обертка» поверх HTTP, которая шифрует данные, делая их недоступными для злоумышленников.
Чтобы сайт стал работать по протоколу безопасного соединения HТТPS, нужен SSL-сертификат, который содержит криптографические ключи, а также данные о веб-сайте и подтверждает его подлинность. Надежные сертификаты выдаются специальными удостоверяющими центрами. Подробнее о том, как получить SSL-сертификат, вы можете прочитать в отдельной статье на нашем сайте.
Схема передачи данных по протоколу HTTPS
- Браузер пользователя просит сайт предоставить SSL-сертификат для подтверждения подлинности веб-ресурса.
- Сайт, поддерживающий HTTPS, отправляет сертификат.
- Браузер проверяет легальность сертификата в центре сертификации.
- Браузер и сайт договариваются о секретном ключе для шифрования данных. Они делают это при помощи асимметричного шифрования, которое предполагает использование двух ключей — открытого (для шифровки отправляемого сообщения) и закрытого (для расшифровки полученного сообщения).
- Браузер и сайт передают информацию, используя симметричное шифрование, при котором данные зашифровываются и расшифровываются с помощью одного и того же общего ключа.
Синтаксически HTTPS идентичен протоколу HTTP, то есть использует те же стартовые строки и заголовки.
Значение HTTPS для SEO
Использование протокола HTTPS является значимым фактором ранжирования сайтов в результатах поиска. Ещё в 2015 году специалист Google Гэри Иллис заявил, что повышение рейтинга компании по протоколу HTTPS может стать решающим фактором, когда в остальном сигналы качества для двух результатов поиска равны. Если поисковый робот обнаружит две одинаковые страницы — одну с HTTP, а вторую с HTTPS, он добавит в индекс страницу с безопасным протоколом.
Сайт, который не использует HTTPS-протокол, со временем может потерять свои позиции в поиске. Отсутствие HTTPS говорит пользователям и поисковым системам, что безопасность их данных находится под угрозой, а значит, отображать такой сайт на первых страницах выдачи и переходить на него не стоит.
Кроме того, в строке браузера, например, Google Chrome, рядом с адресом сайта без HTTPS ставится отметка «Не защищено».
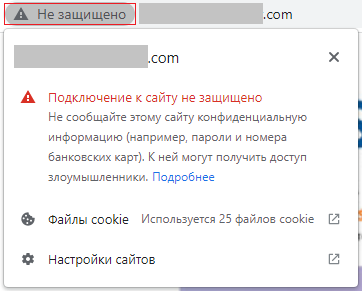
Тогда как сайты, использующие безопасный протокол HTTPS, помечаются значком в виде замка.
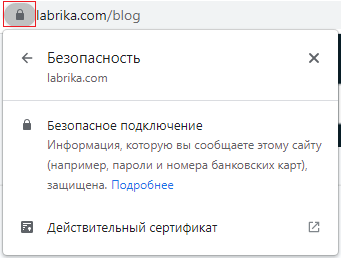
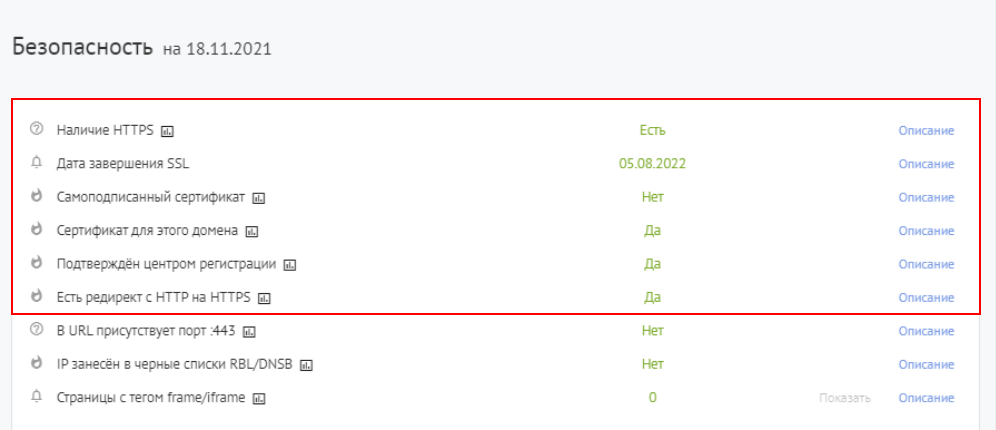
Посмотреть данные о наличии на вашем сайте протокола HTTPS и SSL-сертификата, позволяющего использовать зашифрованное соединение, вы можете на сервисе Labrika в отчете «Безопасность» раздела «Технический аудит».
Протокол HTTPS обязательно должен быть на тех сайтах, которые запрашивают конфиденциальные данные пользователей: логины и пароли от аккаунтов, номера банковских карт, адреса электронной почты и т. п. В первую очередь это касается коммерческих ресурсов, социальных сетей, почтовых сервисов, сайтов с регистрацией пользователей.
Читать дальше подобные статьи
- Проверка сайта на ошибки 404. Как исправить ссылки на страницу?
- Что такое внутренние ошибки сервера 500 Internal server error и как их исправить?
- Веб-страница сайта временно недоступна или перемещена — что делать с долгим ответом сервера?
- Зачем нужны SSL и TLS сертификаты для SEO сайта?