Естественные ключи против искусcтвенных ключей
Каждая запись в таблице, входящей в РСУБД, должна иметь первичный ключ (ПК) – набор атрибутов, уникально идентифицирующий её в таблице. Случай, когда таблица не имеет первичного ключа, имеет право на существование, однако в данной статье не рассматривается.
- Естественный Ключ (ЕК) – набор атрибутов описываемой записью сущности, уникально её идентифицирующий (например, номер паспорта для человека) или
- Суррогатный Ключ (СК) – автоматически сгенерированное поле, никак не связанное с информационным содержанием записи. Обычно в роли СК выступает автоинкрементное поле типа INTEGER.
- СК должны использоваться, только если ЕК не существует. Если же ЕК существует, то идентификация записи внутри БД осуществляется по имеющемуся ЕК;
- СК должны добавляться в любую таблицу, на которую существуют ссылки (REFERENCES) из других таблиц, и связи между ними должны организовываться только при помощи СК. Разумеется, поиск записи и представление её пользователю по прежнему производятся на основании ЕК.
Когда появляются СК?
Для понимания места и значения СК рассмотрим этап проектирования, на котором они вводятся в структуру БД, и методику их введения.
Для ясности рассмотрим БД из 2-х отношений – Города (City) и Люди (People) Предполагаем, что город характеризуется Hазванием (Name), все города имеют разные названия, человек характеризуется Фамилией (Family), номером паспорта (Passport) и городом проживания (City). Также полагаем, что каждый человек имеет уникальный номер паспорта. Hа этапе составления инфологической модели БД её структура одинакова и для ЕК и для СК.
CREATE TABLE City(
Name VARCHAR(30) NOT NULL PRIMARY KEY
);
CREATE TABLE People(
Passport CHAR(9) NOT NULL PRIMARY KEY,
Family VARCHAR(20) NOT NULL,
City VARCHAR(30) NOT NULL REFERENCES City(Name)
);
Для ЕК все готово. Для СК делаем еще один этап и преобразуем таблицы следующим образом:
CREATE TABLE City(
/*
В разных диалектах языка SQL автоинкрементное поле будет выражено по-разному –
например, через IDENTITY, SEQUENCE или GENERATOR.
Здесь мы используем условное обозначение AUTOINCREMENT.
*/
Id INT NOT NULL AUTOINCREMENT PRIMARY KEY
Name VARCHAR(30) NOT NULL UNIQUE
);
CREATE TABLE People(
Id INT NOT NULL AUTOINCREMENT PRIMARY KEY,
Passport CHAR(9) NOT NULL UNIQUE,
Family VARCHAR(20) NOT NULL,
CityId INT NOT NULL REFERENCES City(Id)
);
- Все условия, диктуемые предметной областью (уникальность имени города и номера паспорта) продолжают присутствовать в БД, только обеспечиваются не условием PRIMARY KEY, а условием UNIQUE;
- Ключевого слова AUTOINCREMENT ни в одном из известных мне серверов нет. Это просто обозначение, что поле генерируется автоматически.
- В таблицу добавляется поле INTEGER AUTOINCREMENT;
- Оно объявляется PRIMARY KEY;
- Старый PRIMARY KEY (ЕК) заменяется на UNIQUE CONSTRAINT ;
- Если в таблице есть REFERENCES на другие таблицы, то поля, входящие в REFERENCES, заменяются на одно поле типа INTEGER, составляющее первичный ключ (как People.City заменена на People.CityId).
Зачем всё это надо?
Возникает резонный вопрос – а зачем? Действительно, вводить в таблицы какие-то поля, что-то заменять, зачем? Итак, что мы получаем, проделав эту «механическую» операцию.
Упрощение сопровождения
Это область, где СК демонстрируют наибольшие преимущества. Поскольку операции связи между таблицами отделены от логики «внутри таблиц» – и то и другое можно менять независимо и не затрагивая остального.
Hапример, выяснилось, что города имеют дублирующиеся названия. Решено ввести в City еще одно поле – Регион (Region) и сделать ПК (City, Region). В случае ЕК – изменяется таблица City, изменяется таблица People – добавляется поле Region (да, да, для всех записей, про размеры молчу), переписываются все запросы, в том числе на клиентах, в которых участвует City, в них добавляются строка AND XXX.Region = City.Region.
Да, чуть не забыл, большинство серверов сильно не любят ALTER TABLE на поля, входящие в PRIMARY KEY и FOREIGN KEY.
В случае СК – добавляется поле в City, изменяется UNIQUE CONSTRAINT. Всё.
Еще пример – в случае СК изменение списка полей в SELECT никогда не заставляет переписывать JOIN. В случае ЕК – добавилось поле, не входящее в ПК связанной таблицы – переписывайте.
Еще пример – поменялся тип данных поля, входящего в ЕК. И опять переделки кучи таблиц, заново оптимизация индексов.
В условиях меняющегося законодательства это достоинство СК само по себе достаточно для их использования.
Уменьшение размера БД
Предположим в нашем примере, что средняя длина названия города – 10 байт. Тогда на каждого человека в среднем будет приходиться 10 байт для хранения ссылки на город (реально несколько больше за счёт служебной информации на VARCHAR и гораздо больше за счёт индекса по People.City, который придётся построить, чтобы REFERENCES работала эффективно). В случае СК – 4 байта. Экономия – минимум 6 байт на человека, приблизительно 10 Мб для г. Hовосибирска. Очевидно, что в большинстве случаев уменьшение размера БД – не самоцель, но это, очевидно, приведет и к росту быстродействия.
Звучали аргументы, что БД может сама оптимизировать хранение ЕК, подставив вместо него в People некую хэш-функцию (фактически создав СК сама). Hо ни один из реально существующих коммерческих серверов БД так не делает, и есть основания полагать, что и не будет делать. Простейшим обоснованием такого мнения является то, что при подобной подстановке банальные операторы ADD CONSTRAINT … FOREIGN KEY или DROP CONSTRAINT … FOREIGN KEY будут приводить к нешуточной перетряске таблиц, с ощутимым изменением всей БД (надо будет физически добавить или удалить (с заменой на хэш-функцию)) все поля, входящие в CONSTRAINT.
Увеличение скорости выборки данных
- База данных нормализована;
- Записей в таблицах много (десятки тысяч и более);
- Запросы преимущественно возвращают ограниченные наборы данных (максимум единицы процентов от размера таблицы).
- Требуется только информация, входящая в первичные ключи связанных таблиц;
- Нет условий WHERE по полям связанных таблиц.
SELECT Family, City FROM People;
В случае СК этот запрос будет выглядеть как
SELECT P.Family, C.Name
FROM People P INNER JOIN City C ON P.CityId = C.Id;
Казалось бы, ЕК дает более простой запрос с меньшим количеством таблиц, который выполнится быстрее. Hо и тут не всё так просто: размеры таблиц для ЕК – больше (см. выше) и дисковая активность легко съест преимущество, полученное за счёт отсутствия JOIN`а. Ещё сильнее это скажется, если при выборке данных используется их фильтрование (а при сколько-либо существенном объеме таблиц оно используется обязательно). Дело в том, что поиск, как правило, осуществляется по информативным полям типа CHAR, DATETIME и т.п. Поэтому часто бывает быстрее найти в справочной таблице набор значений, ограничивающий возвращаемый запросом результат, а затем путем JOIN`а по быстрому INTEGER-индексу отобрать подходящие записи из большой таблицы. Например,
(ЕК) SELECT Family, City FROM People WHERE City = ‘Иваново’;
будет выполняться в разы медленнее, чем
(CК) SELECT P.Family, C.Name
FROM People P INNER JOIN City C ON P.CityId = C.Id
WHERE C.Name = ‘Иваново’;
В случае ЕК – будет INDEX SCAN большой таблицы People по CHARACTER-индексу. В случае СК – INDEX SCAN меньшей CITY и JOIN по эффективному INTEGER индексу.
А вот если заменить = ‘Иваново’ на LIKE ‘%ваново’, то речь пойдет о торможении ЕК относительно СК на порядок и более.
Аналогично, как только в случае с ЕК понадобится включить в запрос поле из City, не входящее в её первичный ключ – JOIN будет осуществлятся по медленному индексу и быстродействие упадет ощутимо ниже уровня СК. Выводы каждый может делать сам, но пусть он вспомнит, какой процент от общего числа его запросов составляют SELECT * FROM ЕдинственнаяТаблица. У меня – ничтожно малый.
Да, сторонники ЕК любят проводить в качестве достоинства «информативность таблиц», которая в случае ЕК растет. Ещё раз повторю, что максимальной информативностью обладает таблица, содержащая всю БД в виде flat-file. Любое «повышение информативности таблиц» есть увеличение степени дублирования в них информации, что не есть хорошо.
Увеличение скорости обновления данных
INSERT
Hа первый взгляд ЕК быстрее – не надо при INSERT генерировать лишнего поля и проверять его уникальность. В общем-то так оно и есть, хотя это замедление проявляется только при очень высокой интенсивности транзакций. Впрочем и это неочевидно, т. к. некоторые серверы оптимизируют вставку записей, если по ключевому полю построен монотонно возрастающий CLUSTERED индекс. В случае СК это элементарно, в случае ЕК – увы, обычно недостижимо. Кроме этого, INSERT в таблицу на стороне MANY (который происходит чаще) пойдет быстрее, т. к. REFERENCES будут проверяться по более быстрому индексу.
UPDATE
При обновлении поля, входящего в ЕК, придётся каскадно обновить и все связанные таблицы. Так, переименование Ленинграда в Санкт-Петербург потребует с нашем примере транзакции на несколько миллионов записей. Обновление любого атрибута в системе с СК приведет к обновлению только одной записи. Очевидно, что в случае распределенной системы, наличия архивов и т.п. ситуация только усугубится. Если обновляются поля не входящие в ЕК – быстродействие будет почти одинаковым.
Еще о CASCADE UPDATE
Далеко не все серверы БД поддерживают их на декларативном уровне. Аргументы «это у вас сервер кривой» в этом случае вряд ли корректны. Это вынуждает писать отдельную логику для обновления, что не всегда просто (приводился хороший пример – при отсутствии CASCADE UPDATE обновить поле, на которое есть ссылки, вообще невозможно – надо отключать REFERENCES или создавать копию записи, что не всегда допустимо (другие поля могут быть UNIQUE)).
DELETE
В случае СК будет выполняться быстрее, по той простой причине, что проверка REFERENCES пойдет по быстрому индексу.
А есть ли хорошие ЕК?
Hичто не вечно под Луной. Самый, казалось бы, надежный атрибут вдруг отменяется и перестаёт быть уникальным (далеко ходить не буду – рубль обычный и рубль деноминированный, примерам несть числа). Американцы ругаются на неуникальность номера социального страхования, Microsoft – на китайские серые сетевые платы с дублирующимися MAC-адресами, которые могут привести к дублированию GUID, врачи делают операции по смене пола, а биологи клонируют животных. В этих условиях (и учитывая закон неубывания энтропии) закладывать в систему тезис о неизменности ЕК – закладывать под себя мину. Их надо выделять в отдельный логический слой и по возможности изолировать от остальной информации. Так их изменение переживается куда легче. Да и вообще, однозначно ассоциировать сущность с каким-то из атрибутов этой сущности – ну, странно, что-ли. Hомер паспорта ещё не есть человек. СК же – это некая субстанция, именно и означающая сущность. Именно сущность, а не какой-то из её атрибутов.
Типичные аргументы сторонников ЕК
В системе с СК не осуществляется контроль правильности ввода информации
Это не так. Контроль не осуществлялся бы, если бы на поля, входящие в ЕК не было наложено ограничение уникальности. Очевидно, что если предметная область диктует какие-то ограничения на атрибуты ЕК, то они будут отражены в БД в любом случае.
В системе с ЕК меньше JOIN`ов, следовательно, запросы проще и разработка удобнее
Да, меньше. Hо, в системе с СК тривиально пишется:
CREATE VIEW PeopleEK AS
SELECT P.Family, P.Passport, C.Name
FROM People P INNER JOIN City C ON P.CityId = C.Id
И можно иметь все те же прелести. С более, правда, высоким быстродействием. При этом неплохо упомянуть, что в случае ЕК многим придется программировать каскадные операции, и, не дай Бог в распределённой среде, бороться с проблемами быстродействия. Hа фоне этого «короткие» запросы уже не кажутся столь привлекательными.
Введение ЕК нарушает третью нормальную форму
Вспомним определение: Таблица находится в третьей нормальной форме (3НФ), если она удовлетворяет определению 2НФ, и ни одно из её неключевых полей не зависит функционально от любого другого неключевого поля.
То есть, речи о ключевых полях там не идёт вообще. Поэтому добавление ещё одного ключа в таблицу ни в коей мере не может нарушить 3НФ. Вообще, для таблицы с несколькими возможными ключами имеет смысл говорить не о 3 НФ, а о Нормальной Форме Бойса-Кодда, которая специально введена для таких таблиц.
Итак, Таблица находится в нормальной форме Бойса-Кодда (НФБК), если и только если любая функциональная зависимость между его полями сводится к полной функциональной зависимости от возможного ключа.
Таким образом, таблица, имеющая СК, легко может быть нормализована хоть до 5НФ. Точнее будет сказать, что СК к нормализации не имеют никакого отношения. Более того, введение СК уменьшает избыточность данных в БД, что вообще хорошо согласуется с идеологией нормализации. В сущности, нормализация и есть уменьшение информативности отдельных таблиц по определенным правилам. Только СК устраняют аномалии не внутри таблицы, а на межтабличном уровне (типа устранения каскадных обновлений). Так сказать, система с СК – святее Папы Римского :-). В самом деле ситуация, когда при изменении одного из полей таблицы приходится изменять содержимое этого же поля в других записях ЭТОЙ ЖЕ таблицы, рассматривается как аномалия обновления. Но в системе с ЕК придется проделать то же самое В СВЯЗАННОЙ таблице при изменении ключевого атрибута на стороне 1 отношения 1:N. Очевидно, что эта ситуация с точки зрения физической реализации БД ничем не лучше. В системе с СК таких ситуаций не возникает.
Таблицы в системе с ЕК информативнее
Максимальной информативностью обладает таблица, содержащая всю БД в виде flat-file. Любое «повышение информативности таблиц» есть увеличение степени дублирования в них информации, что не обязательно есть хорошо. Да и вообще термин «Информативность таблицы» сомнителен. Видимо, более важна информативность БД, которая в обоих случаях одинакова.
Заключение
В общем-то, выводы очевидны – введение СК позволяет получить лучше управляемую, более компактную и быстродействующую БД. Разумеется, это не панацея. В некоторых случаях (например, таблица на которую нет REFERENCES и в которую осуществляется интенсивная вставка данных и т. п.) более верно использовать ЕК или не использовать ПК вообще (последнее категорически противопоказано для многих РСУБД и средств разработки клиентских приложений). Но речь шла именно о типовой методике, которую надо рекомендовать к применению в общем случае. Уникальные ситуации могут потребовать уникальных же решений (иногда и нормализацией приходится поступаться).
Copyright iBase.ru © 2002-2023
Руководство по проектированию реляционных баз данных (4-6 часть из 15) [перевод]
Выкладываю продолжение перевода цикла статей для новичков.
В настоящих и последующих — больше информации по существу.
Начало — здесь.
4. ТАБЛИЦЫ И ПЕРВИЧНЫЕ КЛЮЧИ
Как вы уже знаете из прошлых частей, данные хранятся в таблицах, которые содержат строки или по-другому записи. Ранее я приводил пример таблицы, содержащей информацию об уроках. Давайте снова на нее взглянем.
В таблице имеются 6 уроков. Все 6 – разные, но для каждого урока значения одинаковых полей хранятся в таблице, а именно: tutorial_id (идентификатор урока), title (заголовок)и category (категория). Tutorial_id – первичный ключ таблицы уроков. Первичный ключ – это значение, которое уникально для каждой записи в таблице.
В таблице клиентов ниже customer_id – первичный ключ. В данном случае первичный ключ – также уникальное значение (число) для каждой записи.
Первичные ключи в повседневной жизни
В базе данных первичные ключи используются для идентификации. В жизни первичные ключи вокруг нас везде. Каждый раз, когда вы сталкиваетесь с уникальным числом это число может служить первичным ключом в базе данных (может, но не обязательно должно использоваться как таковое. Все базы данных способны автоматически генерировать уникальное значение для каждой записи в виде числа, которое автоматически увеличивается и вставляется вместе с каждой новой записью [Т.н. синтетический или суррогатный первичный ключ – прим.перев.]).
- Номер заказа, который вы получаете при покупке в интернет-магазине может быть первичным ключом какой-нибудь таблицы заказов в базе данных этого магазина, т.к. он является уникальным значением.
- Номер социального страхования может быть первичным ключом в какой-нибудь таблице в базе данных государственного учреждения, т.к. она также как и в предыдущем примере уникален.
- Номер счета-фактуры может быть использован в качестве первичного ключа в таблице базы данных, в которой хранятся выданные клиентам счета-фактуры.
- Числовой номер клиента часто используется как первичный ключ в таблице клиентов.
- .
Что объединяет эти примеры? То, что во всех из них в качестве первичного ключа выбирается уникальное, не повторяющееся значение для каждой записи. Еще раз. Значения поля таблицы базы данных, выбранного в качестве первичного ключа, всегда уникально.
Что характеризует первичный ключ? Характеристики первичного ключа.
Первичный ключ служит для идентификации записей.
Первичный ключ используется для идентификации записей в таблице, для того, чтобы каждая запись стала уникальной. Еще одна аналогия… Когда вы звоните в службу технической поддержки, оператор обычно просит вас назвать какой-либо номер (договора, телефона и пр.), по которому вас можно идентифицировать в системе.
Если вы забыли свой номер, то оператор службы технической поддержки попросит предоставить вас какую-либо другую информацию, которая поможет уникальным образом идентифицировать вас. Например, комбинация вашего дня рождения и фамилия. Они тоже могут являться первичным ключом, точнее их комбинация.
Первичный ключ уникален.
Первичный ключ всегда имеет уникальное значение. Представьте, что его значение не уникально. Тогда его бы нельзя было использовать для того, чтобы идентифицировать данные в таблице. Это значит, что какое-либо значение первичного ключа может встретиться в столбце, который выбран в качестве первичного ключа, только один раз. РСУБД устроены так, что не позволят вам вставить дубликаты в поле первичного ключа, получите ошибку.
Еще один пример. Представьте, что у вас есть таблица с полями first_name и last_name и есть две записи:
| first_name | last_name |
| vasya |pupkin |
| vasya |pupkin |
Т.е. есть два Васи. Вы хотите выбрать из таблицы какого-то конкретного Васю. Как это сделать? Записи ничем друг от друга не отличаются. Вот здесь и помогает первичный ключ. Добавляем столбец id (классический вариант синтетического первичного ключа) и…
Id | first_name | last_name |
1 | vasya |pupkin |
2 | vasya |pupkin |
Теперь каждый Вася уникален.
Типы первичных ключей.
Обычно первичный ключ – числовое значение. Но он также может быть и любым другим типом данных. Не является обычной практикой использование строки в качестве первичного ключа (строка – фрагмент текста), но теоретически и практически это возможно.
Составные первичные ключи.
Часто первичный ключ состоит из одного поля, но он может быть и комбинацией нескольких столбцов, например, двух (трех, четырех…). Но вы помните, что первичный ключ всегда уникален, а значит нужно, чтобы комбинация n-го количества полей, в данном случае 2-х, была уникальна. Подробнее об этом расскажу позднее.
Автонумерация.
Поле первичного ключа часто, но не всегда, обрабатывается самой базой данных. Вы можете, условно говоря, сказать базе данных, чтобы она сама автоматически присваивала уникальное числовое значение каждой записи при ее создании. База данных, обычно, начинает нумерацию с 1 и увеличивает это число для каждой записи на одну единицу. Такой первичный ключ называется автоинкрементным или автонумерованным. Использование автоинкрементных ключей – хороший способ для задания уникальных первичных ключей. Классическое название такого ключа – суррогатный первичный ключ [Как и упоминалось выше. – прим. перев.]. Такой ключ не содержит полезной информации, относящейся к сущности (объекту), информация о которой хранится в таблице, поэтому он и называется суррогатным.
5. СВЯЗЫВАНИЕ ТАБЛИЦ С ПОМОЩЬЮ ВНЕШНИХ КЛЮЧЕЙ
Когда я начинал разрабатывать базы данных я часто пытался сохранять информацию, которая казалась родственной, в одной таблице. Я мог, например, хранить информацию о заказах в таблице клиентов. Ведь заказы принадлежат клиентам, верно? Нет. Клиенты и заказы представляют собой отдельные сущности в базе данных. И тому и другому нужна своя собственная таблица. А записи в этих двух таблицах могут быть связаны для того, чтобы установить отношения между ними. Проектирование базы данных – это решение двух вопросов:
- определение того, какие сущности вы хотите хранить в ней
- какие связи между этими сущностями существуют
Один-ко-многим.
Клиенты и заказы имеют связь (состоят в отношениях) один-ко-многим потому, что один клиент может иметь много заказов, но каждый конкретный заказ (их множество) оформлен только одним клиентом, т.е. может иметь только одного клиента. Не беспокойтесь, если на данный момент понимание этой связи смутно. Я еще расскажу о связях в следующих частях.
Одно является важным сейчас – то, что для связи один-ко-многим необходимо две отдельные таблицы. Одна для клиентов, другая для заказов. Давайте немного попрактикуемся, создавая эти две таблицы.
Какую информацию мы будем хранить? Решаем первый вопрос.
Для начала мы определимся какую информацию о заказах и о клиентах мы будем хранить. Чтобы это сделать мы должны задать себе вопрос: “Какие единичные блоки информации относятся к клиентам, а какие единичные блоки информации относятся к заказам?”
Проектируем таблицу клиентов.
Заказы действительно принадлежат клиентам, но заказ – это это не минимальный блок информации, который относится к клиентам (т.е. этот блок можно разбить на более мелкие: дата заказа, адрес доставки заказа и пр., к примеру).
Поля ниже – это минимальные блоки информации, которые относятся к клиентам:
- customer_id (primary key) – идентификатор клиента
- first_name — имя
- last_name — отчество
- address — адрес
- zip_code – почтовый индекс
- country — страна
- birth_date – дата рождения
- username – регистрационное имя пользователя (логин)
- password – пароль
Давайте перейдем к непосредственному созданию этой таблицы в SQLyog (естественно, что вы можете использовать любую другую программу). Ниже приведен пример того, как могла бы выглядеть таблица в программе SQLyog после создания. Все графические приложения для управления базами данных имеют приблизительно одинаковую структуру интерфейса. Вы также можете создать таблицу с помощью командной строки без использования графической утилиты.
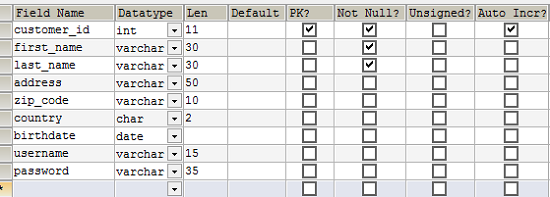
Создание таблицы в SQLyog. Обратите внимание, что выбран флажок первичного ключа (PK) для поля customer_id. Поле customer_id является первичным ключом. Также выбран флажок Auto Incr, что означает, что база данных будет автоматически подставлять уникальное числовое значение, которое, начиная с нуля, будет каждый раз увеличиваться на одну единицу.
Проектируем таблицу заказов.
Какие минимальные блоки информации, необходимые нам, относятся к заказу?
- order_id (primary key) – идентификатор заказа
- order_date – дата и время заказа
- customer – клиент, который сделал заказ
Ниже – пример таблицы в SQLyog.
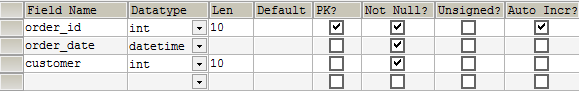
Проект таблицы. Поле customer является ссылкой (внешним ключом) для поля customer_id в таблице клиентов.
Эти две таблицы (клиентов и заказов) связаны потому, что поле customer в таблице заказов ссылается на первичный ключ (customer_id) таблицы клиентов. Такая связь называется связью по внешнему ключу. Вы должны представлять себе внешний ключ как простую копию (копию значения) первичного ключа другой таблицы. В нашем случае значение поля customer_id из таблицы клиентов копируется в таблицу заказов при вставке каждой записи. Таким образом, у нас каждый заказ привязан к клиенту. И заказов у каждого клиента может быть много, как и говорилось выше.
Создание связи по внешнему ключу.
Вы можете задаться вопросом: “Каким образом я могу убедиться или как я могу увидеть, что поле customer в таблице заказов ссылается на поле customer_id в таблице клиентов”. Ответ прост – вы не можете сделать этого потому, что я еще не показал вам как создать связь.
Ниже – окно SQLyog с окном, которое я использовал для создания связи между таблицами.
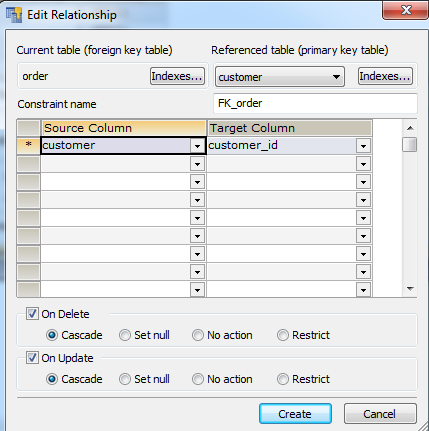
Создание связи по внешнему ключу между таблицами заказов и клиентов.
В окне выше вы можете видеть, как поле customer таблицы заказов слева связывается с первичным ключом (customer_id) таблицы клиентов справа.
Теперь, когда вы посмотрите на данные, которые могли бы быть в таблицах, вы увидите, что две таблицы связаны.
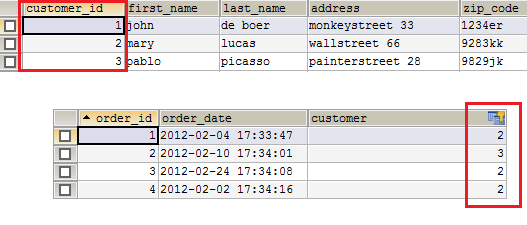
Заказы связаны с клиентами через поле customer, которое ссылается на таблицу клиентов.
На изображении вы видите, что клиент mary поместила три заказа, клиент pablo поместил один, а клиент john – ни одного.
Вы можете спросить: “А что же именно заказали все эти люди?” Это хороший вопрос. Вы возможно ожидали увидеть заказанные товары в таблице заказов. Но это плохой пример проектирования. Как бы вы поместили множественные продукты в единственную запись? Товары – это отдельные сущности, которые должны храниться в отдельной таблице. И связь между таблицами заказов и товаров будет являться связью один-ко-многим. Я расскажу об этом далее.
6. СОЗДАНИЕ ДИАГРАММЫ СУЩНОСТЬ-СВЯЗЬ
Ранее вы узнали как записи из разных таблиц связываются друг с другом в реляционных базах данных. Перед созданием и связыванием таблиц важно, чтобы вы подумали о сущностях, которые существуют в вашей системе (для которой вы создаете базу данных) и решили каким образом эти сущности бы связывались друг с другом. В проектировании баз данных сущности и их отношения обычно предоставляются в диаграмме сущность-связь (англ. entity-relationship diagram, ERD). Данная диаграмма является результатом процесса проектирования базы данных.
Сущности.
Вы можете задаться вопросом, что же такое сущность. Нуу… это “вещь” в системе. Там. Моя Мама всегда хотела, чтобы я стал учителем потому, что я очень хорошо объясняю различные вещи.
В контексте проектирования баз данных сущность – это нечто, что заслуживает своей собственной таблицы в модели вашей базы данных. Когда вы проектируете базу данных, вы должны определить эти сущности в системе, для которой вы создаете базу данных. Это скорее вопрос диалога с клиентом или с собой с целью выяснения того, с какими данными будет работать ваша система.
Давайте возьмем интернет-магазин для примера. Интернет-магазин продает товары. Товар мог бы стать очевидной сущностью в системе интернет-магазина. Товары заказываются клиентами. Вот мы с вами и увидели еще две очевидных сущности: заказы и клиенты.
Заказ оплачивается клиентом… это интересно. Мы собираемся создавать отдельную таблицу для платежей в базе данных нашего интернет-магазина? Возможно. Но разве платежи – это минимальный блок информации, который относится к заказам? Это тоже возможно.
Если вы не уверены, то просто подумайте о том, какую информацию о платежах вы хотите хранить. Возможно, вы захотите хранить метод платежа или дату платежа. Но это все еще минимальные блоки информации, которые могли бы относиться к заказу. Можно изменить формулировки. Метод платежа — метод платежа заказа. Дата платежа – дата платежа заказа. Таким образом, я не вижу необходимости выносить платежи в отдельную таблицу, хотя концептуально вы бы могли выделить платежи как сущность, т.к. вы могли бы рассматривать платежи как контейнер информации (метод платежа, дата платежа).
Давайте не будет слишком академичными.
Как вы видите, есть разница между сущностью и непосредственно таблицей в базе данных, т.е. это не одно и то же. Специалисты отрасли информационных технологий могут быть ОЧЕНЬ академичными и педантичными в этом вопросе. Я не такой специалист. Эта разница зависит от вашей точки зрения на ваши данные, вашу информацию. Если вы смотрите на моделирование данных с точки зрения программного обеспечения, то вы можете прийти к множеству сущностей, которые нельзя будет перенести напрямую в базу данных. В данном руководстве мы смотрим на данные строго с точки зрения баз данных и в нашем маленьком мире сущность – это таблица.
Держитесь там, вы действительно близки к получению вашей ученой степени по базам данных.
Как вы видите определение того, какие сущности имеет ваша система – это немного интеллектуальный процесс, который требует некоторого опыта и часто – это предмет для внесения изменений, пересмотров, раздумий, но, конечно, это не ракетостроение.
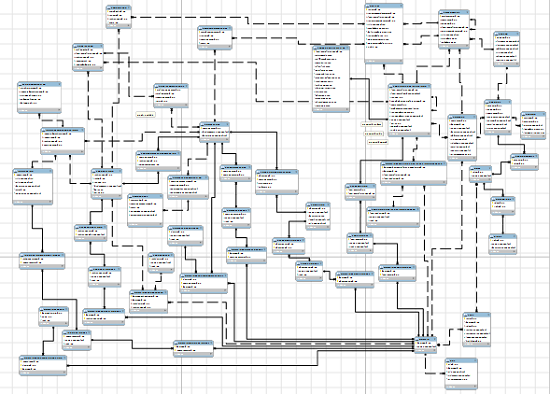
Диаграмма сущность-связь может быть достаточно большой, если вы работаете над сложным приложением. Некоторые диаграммы могут содержать сотни или даже тысячи таблиц.
Связи.
Второй шаг в проектировании баз данных – это выбор того, какие связи существуют между сущностями в вашей системе. Сейчас это может быть немного сложно для понимания, но, повторюсь еще раз, это не ракетостроение. С приобретением некоторого опыта и переосмысления выполненной работы вы будете завершать очередную модель базы данных верным или почти верным образом.
Итак. Я рассказал вам о связи один-ко-многим и я расскажу вам больше о связях в дальнейших частях этого руководства, поэтому сейчас я больше не буду останавливаться на этом. Просто запомните, что решение о том, какие связи будут иметь ваши сущности – важная часть проектирования баз данных и эти связи отображаются в диаграмме сущность-связь.
- mysql
- sql
- проектирование баз данных
Что такое первичный ключ
Ключи представляют способ идентификации строк в таблице. С помощью ключей мы также можем связывать строки между различными таблицами в отношения.
Суперключ
Superkey (суперключ) — комбинация атрибутов (столбцов), которые уникально идентифицируют каждую строку таблицы. Это могут быть и все столбцы, и несколько и и один. При этом строки, которые содержат значения этих атрибутов, не должны повторяться.
Например, у нас есть сущность Student, которая представляет данные о пользователях и которая имеет следующие атрибуты:
- FirstName (имя)
- LastName (фамилия)
- Year (год рождения)
- Phone (номер телефона)
Какие атрибуты в данном случае могут составлять суперключ:
Каждого студента уникально может идентифицировать телефонный номер, поэтому любые наборы, в которых встречается атрибут Phone, представляют суперключ.
А вот, к примеру, набор не является суперключом, так как у нас теоретически могут быть как минимум два студента с одинаковыми именем, фамилией и годом рождения.
Потенциальный ключ
Candidate key (потенциальный ключ) — представляет собой минимальный суперключ отношения (таблицы), то есть набор атрибутов, который удовлетворяет ряду условий:
- Неприводимость : он не может быть сокращен, он содержит минимально возможный набор атрибутов
- Уникальность : он должен иметь уникальные значения вне зависимости от изменения строки
- Наличие значения : он не должен иметь значения NULL, то есть он обязательно должен иметь значение.
Возьмем ранее выделенные суперключи и найдем среди них candidate key. Первый пять суперключей не соответствуют первому условию, так как все их можно сократить до суперключа :
Суперключ соответствует первому и второму условию, так как он имеет уникальное значение (в данном случае все пользователи могут иметь только уникальные телефонные номера). Но соответствует ли он третьему условию? В целом нет, так как теоретически студент может и не иметь телефона. В этом случае атрибут Phone будет иметь значение NULL, то есть значение будет отсутствовать.
В то же время это может зависеть от ситуации. Если в какой-то систему номер телефона является неотъемлемым атрибутом, например, используется для регистрации и входа в систему, то его можно считать потенциальным ключом. Но в данном случае мы рассматриваем общую ситуацию. И для понимания потенциального ключа необходимо отталкиваться от конкретной системы, которую описывает база данных.
И в таком случае суперключи таблицы не содержат потенциального ключа.
Первичный ключ
Первичный ключ (primary key) непосредственно применяется для идентификации строк в таблице. Он должен соответствовать следующим ограничениям:
- Первичный ключ должен быть уникальным все время
- Он должен постоянно присутствовать в таблице и иметь значение
- Он не должен часто менять свое значение. В идеале он вообще не должен изменять значение.
Как правило, первичный ключ представляет один столбец таблицы, но также может быть составным и состоять из нескольких столбцов.
Если для таблицы можно выделить потенциальный ключ, то его можно использовать в качестве первичного ключа.
Если же потенциальные ключи отсутствуют, то для первичного ключа можно добавить к сущности специальный атрибут, который, как правило, называется, Id или имеет форму [Имя_сущности]Id (например, StudentId), либо может иметь другое название. И обычно данный атрибут принимает целочисленное значение, начиная с 1.
Если же у нас есть несколько потенциальных ключей, то те потенциальные ключи, которые не составляют первичный ключ, являются альтернативными ключами (alternative key).
Например, возьмем представление пользователей на сайтах с двухфакторной авторизацией, где нам обязательно иметь электронный адрес, который нередко выступает в качестве логина, и какой-нибудь номер телефона. В этом случае таблицу пользователей мы можем задать с помощью следующих атрибутов:
- Name (имя пользователя)
- Email (электронный адрес)
- Password (пароль)
- Phone (телефонный номер)
В данном случае атрибуты Email и Phone являются потенциальными ключами, они обязательны в рамках рассматриваемой системы и в принципе уникальны. И теоретически, мы можем использовать один из этих атрибутов в качестве первичного ключа, тогда второй будет альтернативным ключом. Однако опять же поскольку теоретически значения обоих атрибутов могут меняться, то лучше все таки определить дополнительный атрибут специально под первичный ключ.
Обновлены 10 различий между первичным ключом и внешним ключом в 2022 году

A первичный ключ — это первый ключ, который следует понять, поскольку он однозначно определяет конкретную запись любой таблицы. Однако первичный ключ и внешний ключ не следует путать друг с другом, поскольку они имеют полностью отличается определение, а также использование.
Оба ключа — это два наиболее важных и распространенных типа ключей, используемых в реляционных базах данных.
Первичный и внешний ключ
Ключи основные элементы реляционных база данных потому что они установить отношения между парой таблиц и убедитесь, что каждая запись в таблице однозначно идентифицирована.
Ключи имеют большее значение, чем установление отношений. Однако они также помогают с ссылочной целостностью и являются основным компонентом целостности на уровне таблиц.
A первичный ключ — это особый ключ в реляционной база данных который действует как уникальный идентификатор для каждой записи, что означает, что он однозначно идентифицирует каждую строку / запись в таблице, и его значение должно быть уникальным для каждой строки таблицы. С другой стороны, внешний ключ — это поле в одной таблице, которое связывает две таблицы вместе.
Что такое первичный ключ?
Первичный ключ — это специальный ключ, который однозначно идентифицирует каждый запись в таблице. В реляционной базе данных очень важно иметь уникальный идентификатор в каждой строке таблицы.
И это как раз то, что вам нужно, чтобы однозначно идентифицировать кортеж в таблице. Кортеж представляет собой набор атрибутов значений в реляционной базе данных.
Первичный ключ может относиться к столбцу или набор столбцов в таблице реляционной базы данных, используемой для неявной идентификации всех записей в таблице.
Первичный ключ должен быть уникальным для каждой записи, поскольку он действует как уникальный идентификатор и не должен содержать значений Null. Каждый база данных должен иметь один и только один первичный ключ.
Что такое внешний ключ?
A внешний ключ относится к полю или набору полей в записи базы данных, которые однозначно идентифицируют ключевое поле другой записи базы данных в какой-либо другой таблице. Проще говоря, он устанавливает связь между записями в двух разных таблицах базы данных.
Это может быть столбец в таблице, который указывает на столбцы первичного ключа, что означает, что внешний ключ, определенный в таблице, ссылается на первичный ключ некоторой другой таблицы. Ссылки имеют решающее значение в реляционных базах данных для установления связей между записями, что важно для сортировки баз данных.
Внешние ключи играют важную роль в реляционная база данных нормализация, особенно когда таблицам нужен доступ к другим таблицам.
Различия между первичным ключом и внешним ключом
1. Первичный ключ — это выбранный ключ-кандидат, который однозначно определяет кортеж в отношении. тогда как другой аналог в таблице относится к первичному ключу других таблиц.
2. Никакие два кортежа в отношении не содержат повторяющихся значений для атрибута первичного ключа, тогда как внешний ключ принимает значение NULL.
3. Первичный ключ однозначно идентифицирует запись в таблице реляционной базы данных.
4. Первичный ключ представляет собой комбинацию УНИКАЛЬНЫЙ и ограничения Not Null, поэтому нельзя допускать дублирования значений в поле первичного ключа в таблице реляционной базы данных.
5. Прежде чем удалять значение первичного ключа, убедитесь, что значение по-прежнему отсутствует в ссылочном столбце внешнего ключа.
6. Вы можете удалить значение из столбца внешнего ключа, не беспокоясь о том, присутствует ли это значение в столбце ссылочного первичного ключа ссылочной связи.
7. Внешний ключ не создает автоматически кластеризованный или некластеризованный индекс. Вы можете вручную создать индекс по внешнему ключу.
Если вам понравилась эта статья, подпишитесь на вашу электронную почту для связанных материалов. Благодарю.
CSN Team.