Организация ввода и вывода данных с использованием файлов
Внимание! Все тесты в этом разделе разработаны пользователями сайта для собственного использования. Администрация сайта не проверяет возможные ошибки, которые могут встретиться в тестах.
Работа содержит 10 заданий, время выполнения составляет 10 минут
Система оценки: 5* балльная
Список вопросов теста
Вопрос 1
Сколько байтов памяти занимает признак конца строки в текстовом файле?
Вопрос 2
В каком виде хранятся данные на устройствах внешней памяти?
Варианты ответов
- В виде информационных структур
- В виде программ
- В виде файлов
- В виде текста
Вопрос 3
Без пробелов запишите условие описанного цикла для считывания массива чисел из файла?
Вопрос 4
Какое количество памяти занимает один символ в текстовом файле?
Варианты ответов
- 1 бит
- 1 байт
- 6 байт
- 2 байта
Вопрос 5
Укажите верный порядок следования операторов в программе?
Варианты ответов
- assign (f, s)
- reset (f)
- read (f, s)
- close (f)
Вопрос 6
Что будет записано в файл f при выполнении оператора writeln ( f )?
Варианты ответов
- Признак EOLN
- Пробел
- Ничего
- Признак EOF
Вопрос 7
Укажите соответствие между операторами и их описаниями.
Варианты ответов
- Назначает файловой переменной файл с указанным названием
- Закрывает файл
- Считывает данные из текстового файла, соответствующего переменной f
- Открывает текстовый файл для чтения
Вопрос 8
При помощи какого оператора текстовый файл открывается для перезаписи?
Варианты ответов
- assign (f, s)
- eoln (f)
- rewrite (f)
- close (f)
Вопрос 9
Какие разновидности файлов существуют?
Варианты ответов
- Текстовые
- Рекурсивные
- Типизированные
- Нетипизированные
Вопрос 10
Какой тип в языке Pascal имеет файловая переменная, для обращения к текстовому файлу?
Работа с файлами
В большинстве своем файлы представляют собой именованные области внешней (дисковой) памяти, с которыми программы могут обмениваться информацией. Необходимость в таких обменах, во-первых, возникает, когда объем оперативной памяти недостаточен для хранения нужной информации. Во-вторых, программа может воспользоваться данными, полученными ранее другой программой и предусмотрительно записанными на диск . Наконец, в программах, требующих во время своей работы ввод исходных данных достаточно большого объема, целесообразно считывать эти данные из файла – данные в файле можно подготовить заблаговременно и тщательно выверить.
К числу абонентов, которые могут участвовать в обмене данными, относятся и файлы-устройства ( дисплей , принтер, графопостроитель , сканер , клавиатура, каналы связи и т.п.). Данный раздел посвящен работе с дисковыми файлами, хотя технология обслуживания файлов- устройств ничем принципиально не отличается.
10.1.Файлы в операционной системе
Система управления файлами является одним из важнейших компонентов операционной системы. На нижнем (физическом) уровне поддержку работы с файлами и устройствами обеспечивает BIOS ( Basic Input Output System – базовая система ввода-вывода). Если на ранних моделях IBM-совместимых ПК программы BIOS «прошивались» в постоянном запоминающем устройстве ( ПЗУ ), то в современных компьютерах программы BIOS можно обновлять. Как правило, программисты напрямую к функциям BIOS не обращаются, предпочитая иметь дело с функциями среднего уровня, которые предоставляются пользователям операционной системой или функциями более высокого уровня, предусмотренными соответствующей системой программирования.
Файловая подсистема рассматривает внешние запоминающие устройства (жесткие и гибкие магнитные диски) как совокупность логических дисков, обозначаемых буквами латинского алфавита – a, b, c, d, . (или A, B, C, . ). На каждом логическом диске может быть создано корневое оглавление (каталог), где хранится информация о содержимом логического раздела. Минимальной единицей хранения является файл – набор данных, снабженных следующей информацией:
- имя файла, состоящее из букв латинского алфавита, цифр и некоторых символов (максимальная длина имени – 8 символов);
- расширение имени, отделяемое от имени точкой и содержащее до 3 символов;
- дата и время создания файла или момента его последней модификации;
- длина файла в байтах;
- атрибуты файла (A – архивируемый, R – только для чтения, S – системный, H – скрытый);
- ссылка на начало данных – адрес первого кластера, с которого на диске расположена первая порция информационного содержимого файла.
Кластер – это несколько следующих друг за другом секторов дискового пространства ( по умолчанию объем каждого физического сектора – 512 байт ). Размер кластера зависит от общей емкости накопителя на магнитном диске. Если объем информации в файле превышает объем одного кластера, то следующая порция данных располагается на ближайшем свободном кластере, который физически может не быть смежным с первой порцией данных. Таким образом, большой набор данных оказывается разбросанным по разным не обязательно соседним участкам диска. Для сборки этих разрозненных цепочек и определения адреса последнего кластера с данными используется специальная таблица FAT (File Allocation Table – таблица размещения файлов), где для каждого кластера записана либо ссылка на номер следующего кластера, либо указан признак конца файла ( EOF – End-of-File). Чем больше емкость винчестера , тем больше секторов в кластере. Поэтому последний кластер файла обычно бывает заполнен только частично, следовательно, система FAT не самым лучшим образом использует дисковое пространство . В современных операционных системах типа Windows XP поддерживается более эффективная система хранения файловой информации NTFS . Однако и в ней соблюдается древообразное построение каталогов и подкаталогов логических разделов диска .
Кроме информации о файлах в корневом каталоге содержатся сведения о вложенных подкаталогах, устроенных по тому же принципу, что и корневой каталог. Вложенные каталоги имеют индивидуальные имена. Поэтому, чтобы добраться до какого-то конкретного набора данных приходится указывать так называемую полную спецификацию файла, состоящую из имени логического диска, цепочки вложенных подкаталогов и собственно имени файла:
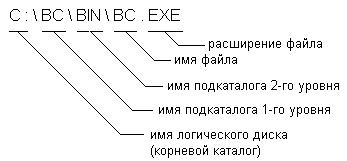
При использовании имен файлов в программах на языках C, C++ следует помнить об одном соглашении – спецификация файла задается строкой, в которой знак «обратного слэша» заменяется удвоенным обратным слэшем:
char namef[]="c:\\bc\\bin\\bc.exe"
Файловая подсистема обеспечивает возможность создания новых подкаталогов, создания и удаления файлов, копирования и переименования файлов. Средства операционной системы обеспечивают некоторую защиту наборов данных – например, системные и скрытые файлы не всегда предоставляются взору пользователя, файлы, снабженные атрибутом Read -Only (только для чтения) уничтожаются не по первому нажатию соответствующей клавиши. Однако соответствующие оболочки операционных систем (типа Far , Disco Commander, Windows Commander и т.п.) с легкостью преодолевают такую защиту.
Оценивая ключевые аспекты процесса обмена данными, можно сказать, что работа с файлами, в основном, ограничивается тремя-четырьмя операциями:
- выделение ресурсов и приведение файла в состояние готовности к обмену (именно это скрывается за термином » открыть файл «);
- чтение ( ввод из файла ) или запись ( вывод в файл ) очередной порции данных;
- возврат выделенных ресурсов и завершение неоконченных операций (этому соответствует термин » закрыть файл «).
Несмотря на кажущуюся простоту процесса обмена данными, файловые операции достаточно сложны в освоении. Во-первых, не следует забывать о трех уровнях доступа к файловым данным ( BIOS , операционная система , система программирования ). Во-вторых, операционные системы MS-DOS , Windows и Linux пытаются достичь совместимости в выполнении файловых операций. Все это приводит к появлению довольно большого количества различных обслуживающих программ. Так, системная библиотека BC 3.1 насчитывает более 120 функций для работы с файлами и свыше 60 констант, задающих режимы работы файловых процедур.
При работе с файлами приходится учитывать многочисленные форматы представления данных того или иного типа на разных носителях информации. Так, например, цепочка из k символов, представляющая текстовую строку, может храниться в одном из следующих форматов:
- «S1S2S3. Sk» (переменное число символов, заключенных в одинарные или двойные кавычки);
- kS1S2. Sk ( k – однобайтовый или двухбайтовый счетчик числа символов, предшествующий тексту);
- S1S2. Sk\0 ( \0 – однобайтовый признак конца строки, расположенный вслед за последним символом текста);
- S1S2. Sk 0D 0A (двухбайтовый признак конца строки, 0D –»возврат каретки», 0A – «перевод строки»).
Числовая информация может быть записана в дисковый файл либо в машинном формате (а в языках С, С++ количество разных типов числовых данных достигает десятка), либо с предварительным преобразованием из машинного представления в символьное.
Кроме числовых и текстовых данных в файлах может храниться информация и другого происхождения. Например, графические изображения, которые в процессах обмена данными выступают как двоичные коды, условно разделенные на байты. Естественно, что на содержимое этих байтов нельзя реагировать так же, как на некоторые управляющие коды типа «Возврат каретки», «Перевод строки», «Признак конца файла», влияющие на передачу текстовой информации.
Далее, существует несколько способов доступа к файловым данным, из которых на практике чаще всего используют два – последовательный и произвольный. Последний иногда называют прямым ( DIRECT ACCESS ) или случайным ( RANDOM ACCESS ).
Последовательный доступ при записи на диск характерен тем, что очередная записываемая порция пристраивается в хвост к предыдущей. Размеры смежных порций при этом могут оказаться разными по длине. При чтении такой набор данных начинает извлекаться с самой первой порции и очередность считываемых данных повторяет их последовательность во время записи.
Файлы с произвольным доступом состоят из данных, разбитых на порции фиксированной длины. При этом имеется возможность записывать или читать данные в произвольном порядке, указывая дополнительно номер нужной порции.
Наконец, необходимо учитывать и способы разделения отдельных числовых или символьных значений в дисковых наборах данных. В некоторых ситуациях роль таких разграничителей могут выполнять кавычки, запятые, пробелы и различные управляющие байты ( «табуляторный пропуск», «возврат каретки», «перевод строки», «признак конца файла» ). В других ситуациях для каждого данного может быть выделено поле фиксированной длины.
Системы программирования BC 3.1 и BCB поддерживает работу с файлами и потоками, данные в которых представлены либо в символьном, либо в двоичном формате.
10.1.1. Текстовые (строковые) файлы
Содержимое текстового файла очень напоминает то, что мы видим на экране дисплея, когда программа отображает на нем результаты вычислений. Разница только в том, что на экран дисплея только выводят, а текстовый файл можно использовать как хранилище информации, в которое не только пишут, но из которого еще и читают.
Текстовые файлы относятся к файлам последовательного доступа, т.к. единицей хранения информации в них являются строки переменной длины. Каждая строка заканчивается специальным признаком, обычно его функцию выполняет пара символов 0D0A – «возврат каретки» и «перевод строки». Самым важным преимуществом текстовых файлов является универсальность формата хранения информации – числовые данные в символьном виде доступны на любом компьютере, при необходимости их может прочитать и человек. Однако это преимущество имеет и обратную сторону медали – преобразование числовых данных из машинных форматов в символьный вид при выводе и обратное преобразование при вводе сопряжено с дополнительными расходами . Кроме того, объем числовых данных в символьном формате занимает в несколько раз больше памяти по сравнению с их машинным представлением.
Текстовый файл может быть создан путем записи на диск символьных и/или числовых данных по заданному формату с помощью оператора fprintf . В качестве признака конца строки здесь заносятся те же самые байты 0D0A , которые появляются на диске в результате вывода управляющего символа \n.
Для инициализации текстового файла необходимо завести указатель на структуру типа FILE и открыть файл по оператору fopen в одном из нужных режимов – «rt» (текстовый для чтения), «wt» (текстовый для записи), «at» (текстовый для дозаписи в уже существующий набор данных):
FILE *f1; . f1=fopen(имя_файла, "режим");
Формат оператора обмена с текстовыми файлами мало чем отличается от операторов форматного ввода ( scanf ) и вывода ( printf ). Вместо них при работе с файлами используются функции fscanf и fprintf , у которых единственным дополнительным аргументом является указатель на соответствующий файл:
fscanf(f1,"список_форматов", список_ввода); fprintf(f1,"список_форматов \n",список_вывода);
Если очередная строка текстового файла формируется из значения элементов символьного массива str , то вместо функции fprintf проще воспользоваться функцией fputs(f1, str) . Чтение полной строки из текстового файла удобнее выполнить с помощью функции fgets(str,n,f1) . Здесь параметр n означает максимальное количество считываемых символов, если раньше не встретится управляющий байт 0A .
Библиотека C предусматривает и другие возможности для работы с текстовыми файлами – функции open, create, read, write .
Пример 1. Рассмотрим программу, которая создает в текущем каталоге (т.е. в каталоге, где находится наша программа) текстовый файл с именем c_txt и записывает в него 10 строк. Каждая из записываемых строк содержит символьное поле с текстом «Line» (5 байт, включая нулевой байт – признак конца строки), пробел, поле целочисленного значения переменной j , пробел и поле вещественного значения квадратного корня из j . Очевидно, что числовые поля каждой строки могут иметь разную длину. После записи информации файл закрывается и вновь открывается, но уже для чтения. Для контроля содержимое записываемых строк и содержимое считанных строк дублируется на экране.
#include #include #include #include main( ) < FILE *f; //указатель на блок управления файлом int j,k; double d; char s[]="Line"; f=fopen("c_txt","wt"); //создание нового или открытие существующего // файла для записи for(j=1;j<11;j++) < fprintf(f,"%s %d %lf\n",s,j,sqrt(j)); //запись в файл printf("%s %d %lf\n",s,j,sqrt(j)); //вывод на экран >fclose(f); //закрытие файла printf("\n"); f=fopen("c_txt","rt"); //открытие файла для чтения for(j=10; j>0; j--) < fscanf(f,"%s %d %lf",s,&k,&d); //чтение из файла printf("%s %d %lf\n",s,k,d); //вывод на экран >getch(); return 0; > //== Результат работы === Line 1 1.000000 Line 2 1.414214 Line 3 1.732051 Line 4 2.000000 Line 5 2.236068 Line 6 2.449490 Line 7 2.645751 Line 8 2.828427 Line 9 3.000000 Line 10 3.162278 Line 1 1.000000 Line 2 1.414214 Line 3 1.732051 Line 4 2.000000 Line 5 2.236068 Line 6 2.449490 Line 7 2.645751 Line 8 2.828427 Line 9 3.000000 Line 10 3.162278
Обратите внимание на возможную ошибку при наборе этой программы. Если между форматными указателями %s и %d не сделать пробел, то в файле текст «Line» склеится с последующим целым числом. После этого при чтении в переменную s будут попадать строки вида «Line1», «Line2», , «Line10» , в переменную k будут считываться старшие цифры корня из j (до символа «точка»), а в переменной d окажутся дробные разряды соответствующего корня. Тогда результат работы программы будет выглядеть следующим образом:
Line1 1.000000 Line2 1.414214 Line3 1.732051 Line4 2.000000 Line5 2.236068 Line6 2.449490 Line7 2.645751 Line8 2.828427 Line9 3.000000 Line10 3.162278 Line11 0.000000 Line21 0.414214 Line31 0.732051 Line42 0.000000 Line52 0.236068 Line62 0.449490 Line72 0.645751 Line82 0.828427 Line93 0.000000 Line103 0.162278
При считывании данных из текстового файла надо следить за ситуацией, когда данные в файле исчерпаны. Для этой цели можно воспользоваться функцией feof :
if(feof(f1)). //если данные исчерпаны
Функции обработки строк в Cи
В программе строки могут определяться следующим образом:
- как строковые константы;
- как массивы символов;
- через указатель на символьный тип;
- как массивы строк.
Кроме того, должно быть предусмотрено выделение памяти для хранения строки.
Любая последовательность символов, заключенная в двойные кавычки «» , рассматривается как строковая константа .
Для корректного вывода любая строка должна заканчиваться нуль-символом ‘\0’ , целочисленное значение которого равно 0. При объявлении строковой константы нуль-символ добавляется к ней автоматически. Так, последовательность символов, представляющая собой строковую константу, будет размещена в оперативной памяти компьютера, включая нулевой байт.
Под хранение строки выделяются последовательно идущие ячейки оперативной памяти. Таким образом, строка представляет собой массив символов. Для хранения кода каждого символа строки отводится 1 байт.
Для помещения в строковую константу некоторых служебных символов используются символьные комбинации. Так, если необходимо включить в строку символ двойной кавычки, ему должен предшествовать символ «обратный слеш»: ‘\»‘ .
Строковые константы размещаются в статической памяти. Начальный адрес последовательности символов в двойных кавычках трактуется как адрес строки. Строковые константы часто используются для осуществления диалога с пользователем в таких функциях, как printf() .
При определении массива символов необходимо сообщить компилятору требуемый размер памяти.
Компилятор также может самостоятельно определить размер массива символов, если инициализация массива задана при объявлении строковой константой:
char m2[]= «Горные вершины спят во тьме ночной.» ;
char m3[]=< 'Т','и','х','и','е',' ','д','о','л','и','н','ы',' ','п','о','л','н','ы',' ','с','в','е','ж','е','й',' ','м','г','л','о','й','\0' >;
В этом случае имена m2 и m3 являются указателями на первые элементы массивов:
- m2 эквивалентно &m2[0]
- m2[0] эквивалентно ‘Г’
- m2[1] эквивалентно ‘o’
- m3 эквивалентно &m3[0]
- m3[2] эквивалентно ‘x’
При объявлении массива символов и инициализации его строковой константой можно явно указать размер массива, но указанный размер массива должен быть больше, чем размер инициализирующей строковой константы:
char m2[80]= «Горные вершины спят во тьме ночной.» ;
Для задания строки можно использовать указатель на символьный тип .
В этом случае объявление массива переменной m4 может быть присвоен адрес массива:
m4 = m3;
*m4 эквивалентно m3[0]= ‘Т’
*(m4+1) эквивалентно m3[1]= ‘и’
Здесь m3 является константой-указателем. Нельзя изменить m3 , так как это означало бы изменение положения (адреса) массива в памяти, в отличие от m4 .
Для указателя можно использовать операцию увеличения (перемещения на следующий символ):
Массивы символьных строк
Иногда в программах возникает необходимость описание массива символьных строк . В этом случае можно использовать индекс строки для доступа к нескольким разным строкам.
char *poet[4] = < "Погиб поэт!", "- невольник чести -" ,
«Пал,» , «оклеветанный молвой…» >;
В этом случае poet является массивом, состоящим из четырех указателей на символьные строки. Каждая строка символов представляет собой символьный массив, поэтому имеется четыре указателя на массивы. Указатель poet[0] ссылается на первую строку:
*poet[0] эквивалентно ‘П’,
*poet[l] эквивалентно ‘-‘.
Инициализация выполняется по правилам, определенным для массивов.
Тексты в кавычках эквивалентны инициализации каждой строки в массиве. Запятая разделяет соседние
последовательности.
Кроме того, можно явно задавать размер строк символов, используя описание, подобное такому:
char poet[4][23];
Разница заключается в том, что такая форма задает «прямоугольный» массив, в котором все строки имеют одинаковую длину.

Свободный массив
сhar *poet[4];
определяет свободный массив, где длина каждой строки определяется тем указателем, который эту строку инициализирует. Свободный массив не тратит память напрасно.
Операции со строками
Большинство операций языка Си, имеющих дело со строками, работает с указателями. Для размещения в оперативной памяти строки символов необходимо:
- выделить блок оперативной памяти под массив;
- проинициализировать строку.
Для выделения памяти под хранение строки могут использоваться функции динамического выделения памяти. При этом необходимо учитывать требуемый размер строки:
char *name;
name = ( char *)malloc(10);
scanf( «%9s» , name);
Для ввода строки использована функция scanf() , причем введенная строка не может превышать 9 символов. Последний символ будет содержать ‘\0’ .
Функции ввода строк
Для ввода строки может использоваться функция scanf() . Однако функция scanf() предназначена скорее для получения слова, а не строки. Если применять формат «%s» для ввода, строка вводится до (но не включая) следующего пустого символа, которым может быть пробел, табуляция или перевод строки.
Для ввода строки, включая пробелы, используется функция
char * gets( char *);
или её эквивалент
char * gets_s( char *);
В качестве аргумента функции передается указатель на строку, в которую осуществляется ввод. Функция просит пользователя ввести строку, которую она помещает в массив, пока пользователь не нажмет Enter.
Функции вывода строк
Для вывода строк можно воспользоваться рассмотренной ранее функцией
printf( «%s» , str); // str — указатель на строку
или в сокращенном формате
Для вывода строк также может использоваться функция
int puts ( char *s);
которая печатает строку s и переводит курсор на новую строку (в отличие от printf() ). Функция puts() также может использоваться для вывода строковых констант, заключенных в кавычки.
Функция ввода символов
Для ввода символов может использоваться функция
char getchar();
которая возвращает значение символа, введенного с клавиатуры. Указанная функция использовалась в рассмотренных ранее примерах для задержки окна консоли после выполнения программы до нажатия клавиши.
Функция вывода символов
Для вывода символов может использоваться функция
char putchar( char );
которая возвращает значение выводимого символа и выводит на экран символ, переданный в качестве аргумента.
Пример Посчитать количество введенных символов во введенной строке.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#include
#include
#include
int main() char s[80], sym;
int count, i;
system( «chcp 1251» );
system( «cls» );
printf( «Введите строку : » );
gets_s(s);
printf( «Введите символ : » );
sym = getchar();
count = 0;
for (i = 0; s[i] != ‘\0’ ; i++)
if (s[i] == sym)
count++;
>
printf( «В строке\n» );
puts(s); // Вывод строки
printf( «символ » );
putchar(sym); // Вывод символа
printf( » встречается %d раз» , count);
getchar(); getchar();
return 0;
>

Результат выполнения
Основные функции стандартной библиотеки string.h
Основные функции стандартной библиотеки string.h приведены в таблице.
char *strcat( char *s1, char *s2)
char *strncat( char *s1, char *s2, int n)
char *strсpy( char *s1, char *s2)
char *strncpy( char *s1, char *s2, int n)
int strcmp( char *s1, char *s2)
int strncmp( char *s1, char *s2, int n)
int strlen( char *s)
char *strset( char *s, char c)
char *strnset( char *s, char c, int n)
Пример использования функций
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
#define _CRT_SECURE_NO_WARNINGS
#include
#include
#include
int main() char m1[80] = «Первая строка» ;
char m2[80] = «Вторая строка» ;
char m3[80];
system( «chcp 1251» );
system( «cls» );
strncpy(m3, m1, 6); // не добавляет ‘\0’ в конце строки
puts( «Результат strncpy(m3, m1, 6)» );
puts(m3);
strcpy(m3, m1);
puts( «Результат strcpy(m3, m1)» );
puts(m3);
puts( «Результат strcmp(m3, m1) равен» );
printf( «%d» , strcmp(m3, m1));
strncat(m3, m2, 5);
puts( «Результат strncat(m3, m2, 5)» );
puts(m3);
strcat(m3, m2);
puts( «Результат strcat(m3, m2)» );
puts(m3);
puts( «Количество символов в строке m1 равно strlen(m1) : » );
printf( «%d\n» , strlen(m1));
_strnset(m3, ‘f’ , 7);
puts( «Результат strnset(m3, ‘f’ , 7)» );
puts(m3);
_strset(m3, ‘k’ );
puts( «Результат strnset(m3, ‘k’ )» );
puts(m3);
getchar();
return 0;
>

Результат выполнения
Комментариев к записи: 132
Елена,здравствуйте.Опять не могу решить задачу.Текст слов разделенных пробелами.Вывести самое короткое(самое длинное)слово. Код СИ.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
while ((c=getchar())!=EOF)
< n++; //п-число символов введенных.
a[n]=c; // массив символов.
if (c==10)c=32;
if (c==32) // i-число символов в слове(длина слова).
else continue;
n=-1;
Работает не нормально.В чем ошибка? Спасибо.
Зачем так сложно сравнивать длины слов? Набрали массив из n символов до пробела. if(n>max)
Елена,спасибо.
Елена, здравствуйте.Опять я забуксовал на книжней задаче. Учу СИ по книге Д.Ритчи.Пытаюсь скомпилировать задачу по строкам в 4-х компилятора ошибки на неё.В авторском варианте ни где запустить не смог.У меня вопрос- книга старая,сменился стандарт СИ или это ещё что-то. И главный вопрос эта задача работает с 2-мя строками или со всеми введенными? Текст задачи.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
#include
#define MAXLINE 1000
int getline( char line[], int MAXLINE);
void copy ( char to[], char from[]);
int main () < int len,max;
char line[MAXLINE];
char longest[MAXLINE];
max=0;
while ((len =getline(line,MAXLINE))>0)
if (len>max)copy(longest,line);>
if (max>0) printf( «%s» ,longest);
return 0; >
int getline ( char s[] , int lim) int c,i ;
for (i=0;i
if (c==’\n’)
s[i]=’\0′; return i; >
void copy( char to[], char from[])
< int i;i=0;
while ((to[i]=from[i])!=’\0′) i++;>
Елена,здравствуйте.Начал учить СИ и столкнулся с неприступной для меня задачей-как н-количество символов одинаковых и рядом стоящих заменить одним таким же символом? Задача книжная в самом начале,где ещё не дошли до массивов.
Как без массивов решать — не знаю, честно скажу. Скажите хотя бы, как хранятся без массива рассматриваемые символы
Елена,здравствуйте. Вчера написал сообщение, но оно так и не появляется. Выделенные символы могу выделить, но один потом вернуть не могу. Делаю через getchar i printf. Если не затруднит как реализовать это через массивы. Код не надо- на словах если можно.Спасибо.
Строки и символы
Строка представляет собой совокупность символов, например «hello, world» или «albatross» . Строки в Swift представлены типом String . К значению типа String можно получить доступ различными способами, включая и коллекцию значений типа Character .
Типы String и Character в Swift предусматривают быстрый, Unicode-совместимый способ работы с текстом в вашем коде. Синтаксис для создания и манипулирования строками легкий и читабельный, он включает синтаксис строковых литералов похожий на С. Конкатенация строк так же проста, как сложение двух строк с помощью оператора + , а изменчивостью строки можно управлять выбирая к чему присваивать значение, константе или переменной, также как в случае с любым другим значением в Swift. Вы также можете использовать строки для вставки констант, переменных, литералов и выражений в более длинные строки- процесс, известный как интерполяция строк. Это позволяет легко создавать пользовательские значения строк для отображения, хранения и вывода информации.
Несмотря на эту простоту синтаксиса, тип String в Swift имеет быструю и современную реализацию. Каждая строка состоит из независимых от кодировки символов Unicode, и обеспечивает поддержку доступа к этим символам в различных Unicode представлениях.
Заметка
Тип String в Swift бесшовно сшит с классом NSString из Foundation. Если вы работаете с фреймворком Foundation в Cocoa или Cocoa Touch, то весь API NSString доступен для каждого значения типа String создаваемого вами в Swift, включая все возможности String , которые описываются в этой главе. Вы также можете использовать значение с типом String для любых API, в которых используется NSString . Для получения дополнительной информации об использовании String с Foundation и Cocoa, обратитесь к книге «Использование Swift с Cocoa и Objective-C».
Строковые литералы
Вы можете включить предопределенные String значения в вашем коде как строковые литералы. Строковый литерал — это фиксированная последовательность текстовых символов, окруженная парой двойных кавычек ( «» ).
Используйте строковый литерал как начальное значение для константы или переменной:
let someString = "Some string literal value"Заметьте, что Swift вывел тип String для константы someString , потому что он был инициализирован строковым литеральным значением.
Многострочные литералы строк
Если вам нужно создать строку, которая поддерживает многострочный вид, используйте литерал многострочной строки — последовательность символов, обернутых в три двойные кавычки:
let quotation = """ The White Rabbit put on his spectacles. "Where shall I begin, please your Majesty?" he asked. "Begin at the beginning," the King said gravely, "and go on till you come to the end; then stop." """Многострочный литерал строки включает в себя все строки между открывающими и закрывающими кавычками. Строка начинается на первой строке после открывающих кавычек ( «»» ), а заканчивается на строке предшествующей закрывающим кавычкам, что означает, что ни одна из строк ниже ни начинается, ни заканчивается символом переноса строки:
let singleLineString = "These are the same." let multilineString = """ These are the same. """Когда ваш исходный код включает в себя символ переноса строки внутри литерала многострочной строки, то этот символ переноса строки так же появляется уже внутри значения этой строки. Если вы хотите использовать символ переноса строки для того, чтобы сделать ваш код более читаемым, но вы не хотите чтобы символ переноса строки отображался в качестве части значения строки, то вам нужно использовать символ обратного слеша ( \ ) в конце этих строк:
let softWrappedQuotation = """ The White Rabbit put on his spectacles. "Where shall I begin, \ please your Majesty?" he asked. "Begin at the beginning," the King said gravely, "and go on \ till you come to the end; then stop." """Для того, чтобы создать литерал строки, который начинается и заканчивается символом возврата каретки (\r), напишите пустую строчку в самом начале и в конце литерала строки, например:
let lineBreaks = """ This string starts with a line break. It also ends with a line break. """ Многострочная строка может иметь отступы для соответствия окружающему ее коду. Пробел до закрывающей группы двойных кавычек ( «»» ) сообщает Swift, сколько пробелов нужно игнорировать в начале каждой строки. Если же вы напишите дополнительные пробелы напротив какой-либо строки к тем, которые стоят напротив закрывающих кавычек, то эти дополнительные пробелы уже будут включены в значение строки.
let linesWithIndentation = """ Эта строка начинается без пробелов в начале. Эта строка имеет 4 пробела. Эта строка так же начинается без пробелов. """В примере выше, не смотря на то, что весь литерал многострочной строки имеет отступ, первая и последняя строка будут начинаться без пробелов. Средняя же строка будет иметь отступ, так как она начинается с дополнительными четырьмя пробелами относительно закрывающей группы двойных кавычек.
Специальные символы в строковых литералах
Строковые литералы могут включать в себя следующие специальные символы:
- экранированные специальные символы \0 (нулевой символ), \\ (обратный слэш), \t (горизонтальная табуляция), \n (новая строка), \r (возвращение каретки), \ » (двойные кавычки) и \’ (одиночные кавычки )
- Произвольные скалярные величины Юникода, записанные в виде \u , где n — 1-8 значное шестнадцатеричное число со значением, равным действительной точке кода Юникода.
Приведенный ниже код показывает все эти четыре примера специальных символов. wiseWords константа содержит два экранированных символа: двойные кавычки. DollarSign , blackHeart , и sparklingHeart константы показывают скалярный формат Юникода:
let wiseWords = "\"Imagination is more important than knowledge\" - Einstein" // "Imagination is more important than knowledge" - Einstein let dollarSign = "\u" // $, Unicode scalar U+0024 let blackHeart = "\u" // ♥, Unicode scalar U+2665 let sparklingHeart = "\u" // ![]() , Unicode scalar U+1F496
Так как многострочные строки имеют три двойные кавычки вместо одной, то вы можете включить двойную кавычку внутрь многострочной строки без знака экранирования. Для того, чтобы включить символы «»» в многострочную строку, вам нужно экранировать хотя бы одну из кавычек, например:
let threeDoubleQuotes = """ Escaping the first quote \""" Escaping all three quotes \"\"\" """ Расширенные разделители строк
Вы можете поместить строковый литерал внутрь расширенного разделителя, чтобы включить в строку специальные символы, не вызывая эффекта самих символов. Вы помещаете вашу строку в кавычки ( » ) и оборачиваете ее знаками # . Например, при печати строкового литерала #»Line 1\nLine 2″# выйдет последовательность символов с символом новой строки ( \n ), а не предложение разбитое на две строки.
Если вам нужен эффект специального символа в строковом литерале, сопоставьте количество знаков ( # ) в строке после символа экранирования ( \ ). Например, если ваша строка #»Line 1\nLine 2″# , и вы хотите перенести часть предложения на новую строку, вы можете использовать #»Line 1\#nLine 2″# вместо этого. Аналогично ###»Line1\###nLine2″### также разрывает строку.
Строковые литералы, созданные с использованием расширенных разделителей, также могут быть многострочными строковыми литералами. Вы можете использовать расширенные разделители для включения текста «»» в многострочную строку, переопределяя поведение по умолчанию, которым завершается сам строковый литерал. Например:
let threeMoreDoubleQuotationMarks = #""" Here are three more double quotes: """ """#Инициализация пустых строк
Чтобы создать пустое String значение в качестве отправной точки для создания более длинных строк, либо присвойте литерал пустой строки к переменной, либо инициализируйте объект String c помощью синтаксиса инициализации:
var emptyString = "" // empty string literal var anotherEmptyString = String() // initializer syntax // обе строки пусты и эквиваленты друг другуМожно узнать пустое ли String значение, через его Boolean свойство isEmpty :
if emptyString.isEmpty < print("Nothing to see here") >// Выведет "Nothing to see here"Изменчивость строк
Вы можете указать, может ли конкретный String быть модифицирован, путем присвоения его переменной ( в этом случае он может быть модифицирован), или присвоения его константе ( в этом случае он не может быть модифицирован):
var variableString = "Horse" variableString += " and carriage" // variableString теперь "Horse and carriage" let constantString = "Highlander" constantString += " and another Highlander" // это выдаст ошибку компиляции: строковая константа не может быть модифицированаЗаметка
Этот подход отличается от изменчивости строк в Objective-C и Cocoa, где мы выбираем между двумя классами ( NSString и NSMutableString ), чтобы указать, может ли строка быть изменена.
Строка является типом значения
Тип String в Swift является типом значения. Когда вы создаёте новое String значение, это значение копируется, когда оно передается функции или методу, или когда оно присваивается константе или переменной. В каждом случае создается новая копия существующего String значения, и передаётся либо присваивается новая копия, а не исходная версия. Типы значений описаны в главе Структуры и перечисления — типы значения.
Подход «копировать по умолчанию» для String в Swift позволяет быть уверенным в том, что когда вы передаете функции либо методу String значение, то очевидно, что вы имеете точно то же String значение, независимо от того, откуда она пришла. Вы можете быть уверены, что строка, которая вам передана, не будет модифицирована, если вы не модифицируете ее сами.
Компилятор Swift оптимизирует использование строк, так что фактическое копирование строк происходит только тогда, когда оно действительно необходимо. Это означает, что вы всегда получаете высокую производительность, при работе со строками, как с типами значений.
Работа с символами
Тип String в Swift представляет собой коллекцию значений Character в указанном порядке. Вы можете получить доступ к отдельным значениям Character в строке с помощью итерации по этой строке в for-in цикле:
for character in "Dog!" print(character) > // D // o // g // ! Цикл for-in описан в главе Циклы for-in.
Кроме того, можно создать отдельную Character константу или переменную из односимвольного строкового литерала с помощью присвоения типа Character :
let exclamationMark: Character = "!"Значения типа String могут быть созданы путем передачи массива типа [Character] в инициализатор:
let catCharacters: [Character] = ["C", "a", "t", "!"] let catString = String(catCharacters) print(catString) // Выведет "Cat!"Конкатенация строк и символов
Значения типа String могут быть добавлены или конкатенированы с помощью оператора сложения ( + ):
let string1 = "hello" let string2 = " there" var welcome = string1 + string2 // welcome равен "hello there" Вы можете добавить значение типа String к другому, уже существующему значению String , с помощью комбинированного оператора сложения и присвоения ( += ):
var instruction = "look over" instruction += string2 // instruction равен "look over there" Вы можете добавить значение типа Character к переменной типа String , используя метод String append :
let exclamationMark: Character = "!" welcome.append(exclamationMark) // welcome равен "hello there!" Заметка
Вы не можете добавить String или Character к уже существующей переменной типа Character , потому что значение типа Character должно состоять только из одиночного символа.
Если вы используете многострочные строковые литералы для построения более длинной строки, то вы захотите, чтобы каждая строка заканчивалась разрывом строки, включая последнюю. Например:
let badStart = """ one two """ let end = """ three """ print(badStart + end) // Prints two lines: // one // twothree let goodStart = """ one two """ print(goodStart + end) // Prints three lines: // one // two // threeВ коде выше конкантенация badStart вместе с end создают двухстрочную строку, которая имеет не тот результат, на который мы расчитывали. Из-за того, что последняя строка badStart не содержит символа переноса строки, она соединяется с первой строкой end . И наоборот, если оба конца строки goodStart будут заканчиваться символом переноса строки, то результат будет именно тот, что мы и хотим.
Интерполяция строк
Интерполяция строк — способ создать новое значение типа String из разных констант, переменных, литералов и выражений, включая их значения в строковый литерал. Каждый элемент, который вы вставляете в строковый литерал, должен быть помещен в скобки и находиться внутри двойных кавычек литерала, а перед открывающей скобкой должен стоять знак обратного слэша.
let multiplier = 3 let message = "\(multiplier) times 2.5 is \(Double(multiplier) * 2.5)" // message равен "3 times 2.5 is 7.5" В примере выше значение multiplier включено в строку как \(multiplier) . В свою очередь \(multiplier) заменяется на фактическое значение константы multiplier , когда вычисляется интерполяция строки для создания конечного варианта.
Значение multiplier — это так же часть большего выражения в будущей строке. Это выражение высчитывает значение Double(multiplier) * 2.5 и вставляет результат 7.5 в строку. В этом случае выражение записанное в виде \(Double(multiplier) * 2.5) является строковым литералом.
Заметка
Выражения, которые вы пишете внутри скобок в интерполируемой строке, не должны содержать неэкранированный обратный слэш, символ перевода строки ( \n ) или символ возврат каретки ( \r ). Однако выражения могут содержать другие строковые литералы.
Юникод (Unicode)
Юникод является международным стандартом для кодирования, представления и обработки текста в разных системах письма. Он позволяет представлять почти любой символ из любого языка в стандартизированную форму. А также читать и записывать эти символы во внешний источник и из него. К таким источникам относятся, например текстовый файл или веб-страница. Типы String и Character в Swift полностью совместимы с Юникодом, что описано в этом разделе.
Скалярные величины Юникода

Если посмотреть глубже, то можно увидеть, что собственный String тип в Swift построен из скалярных значений (Unicode scalar ) Юникода. Скалярная величина Юникода является уникальным 21-разрядным числом для символа или модификатора, например, U+0061 для LATIN SMALL LETTER A (» a «) , или U+1F425 для FRONT-FACING BABY CHICK ().
Заметка
Скалярная величина Юникода — это любая точка кода в диапазоне U+0000 до U+D7FF включительно, или U+E000 до U+10FFFF тоже включительно. Скалярные величины Юникода не включают Юникод суррогатные пары точек кода, т.е. точки кода в диапазоне U+D800 до U+DFFF включительно.
Обратите внимание, что не все 21-битные скалярные величины Юникода присваиваются символу. Некоторые скалярные величины содержатся в резерве для будущего присваивания. Скалярные величины, присвоенные символу, как правило имеют название, например LATIN SMALL LETTER A и FRONT-FACING BABY CHICK , что можно увидеть в примере выше.
Расширяемые наборы графем
Каждый экземпляр типа Character в Swift представляет один расширенный набор графем. Расширенный набор графем является последовательностью одного и более скалярных величин Юникода, которые (будучи объединенными) производят один читаемый символ.
Вот пример. Буква é может быть представлена в виде самостоятельной скалярной величины Юникода é ( LATIN SMALL LETTER E WITH ACUTE , или U+00E9 ). Тем не менее, та же буква может быть представлена в виде пары скалярных величин-стандартной буквой е ( LATIN SMALL LETTER E , или U+0065 ), и последующей скалярной величиной COMBINING ACUTE ACCENT ( U + 0301 ). COMBINING ACUTE ACCENT графически присоединяется к предшествующей скалярной величине, превращая e в é , в момент, когда распознающая Юникод символы система, начинает рендер.
В обоих случаях буква é представляется в виде одного значения Character , которое представляет собой расширенный набор графем. В первом случае набор содержит одну скалярную величину; во втором случае две:
let eAcute: Character = "\u" // é let combinedEAcute: Character = "\u\u" // e с последующим ́ // eAcute равен é, combinedEAcute равен é Расширенный набор графем — это удобный способ представления многих сложных печатных символов, как одного значения Character . Например, Hangul звуки из корейского алфавита могут быть представлены либо как предварительно набранные, или наоборот, как разложенные ряды символов. Оба этих варианта определяются как одно Character значение в Swift:
let precomposed: Character = "\u" let decomposed: Character = "\u\u\u" //precomposed равен "한", decomposed равен "한" Расширенный набор графем позволяет скалярам заключающих символов (например, COMBINING ENCLOSING CIRCLE , или U+20DD ), заключать другие скаляры Юникода и выглядеть как значение типа Character .
let enclosedEAcute: Character = "\u\u" // enclosedEAcute равен é⃝ Скалярные величины Юникода для региональных символов могут быть объединены в пары для создания одного Character значения, таких как эта комбинация: REGIONAL INDICATOR SYMBOL LETTER U ( U+1F1FA ) и REGIONAL INDICATOR SYMBOL LETTER S ( U+1F1F8 ):
let regionalIndicatorForUS: Character = "\u\u" // regionalIndicatorForUS равен 
Подсчет символов
Чтобы получить количество значений Character в строке, используйте count для строки:
let unusualMenagerie data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAABcAAAAUCAIAAADp3DFZAAAAA3NCSVQICAjb4U/gAAAAEHRFWHRTb2Z0d2FyZQBTaHV0dGVyY4LQCQAAAkJJREFUOMu1VDFM20AUfaQYXyBVjtKmh6pKpwpVHj1mzOjRY8aMGdnwyEa2spGt3pqNbs1GRm/xeFNrhGgsFPAFKD5jkusAakGBZCh909c/vX9f7967Ba01/hkFPAf+25RLv31+V3YPW+FEKQATGV9LNXliyuJ06yaWd7MjOY7EaVeMIwnGDMSXgSjYtRLny1XbJPc4egrJzs5Ia50OhvsH2aB/MUhV/+AyuT3rJ/1E68Hw8/7VPcr0LmoM6KB9+DXKgt4RahtdN250ip76JekyDa8U0CNlFg8jFPnTukxAcoHy5vaH3YbJq8vErrTctN062WzGATEtyxD+sbRX+Ux1CwRLNld+R1nuaxokkhS5zCOZE2o6jTUur5RVqVfN2eoCxLAdyrtHfvyu1UjarZ8KZnO7rISKgtNg90x5b+a9tMxFpAFQ5xX8Y8HXNr1KvVaiSlOrxFi54b0kcjLXLwVgAgDRmNloe3EoF3l11a1X6s6S6F4oqwiRzvMLMyxWACDCEarrTXLcaf3osiIjueilbHuDkpzKUYwVNssv6fDT3q0Xsi97J8ldM0+11nq0szVM9Pjb1veDB5zH1I2iHCgCY9lLfL7I1YLtUg4AJad2rlCgSscKIDPTqNQYAFBstldFJ7Vq9I+7bIcyZKEyLDJbXVKAmqjbmhokPGsH1/c9KfwYjXVrXhpfUGQSYADktaq9dcOo3jGqtRWGLAwy6r73qg9p8pEc5YqYf/UnpuN9dHATR5lUZadh0ul76cKz/Ji/Aa/XXre+iuw0AAAAAElFTkSuQmCC" alt="" />, Улитка ![]() , Пингвин
![]() , Верблюд
![]() " print("unusualMenagerie содержит \(unusualMenagerie.count) символов") // Выведет "unusualMenagerie содержит 39 символов"
Обратите внимание, что использование расширенных наборов графем для Character значений означает, что конкатенация и модификация не всегда могут повлиять на количество символов в строке.
Например, если вы инициализируете новую строку со словом из четырех символов cafe , а затем добавите COMBINING ACUTE ACCENT ( U+0301 ) в ее конце, то результирующая строка будет по-прежнему иметь количество символов — 4 , с четвертым символом é , а не e :
var word = "cafe" print("количество символов в слове \(word) равно \(word.count)") // Выведет "количество символов в слове cafe равно 4" word += "\u" // COMBINING ACUTE ACCENT, U+0301 print("количество символов в слове \(word) равно \(word.count)") // Выведет "количество символов в слове café равно 4" Заметка
Расширенный набор графем может состоять из одной или более скалярных величин Юникода. Это означает, что различные символы, и различное отображение одного и того же символа, могут потребовать разных объемов памяти для хранения. Из-за этого, символы в Swift не занимают одинаковый объем памяти в строке. В результате этого, количество символов в строке не может быть подсчитано без итерации в строке, для определения границ расширенного набора графем. Если вы работаете с особенно длинными значениями строк, имейте ввиду, что свойство count должно итерировать все скалярные величины Юникода в строке для того, чтобы определить символы в этой строке. Количество символов, возвращаемых значением count не всегда совпадает со свойством length у NSString , которое содержит те же символы. Длина NSString основывается на числе 16-битовых блоков кода в UTF-16 представлении строки, а не на количестве расширенных набора графем внутри строки.
Доступ и изменение строки
Вы получаете доступ и меняете строку через ее методы, и свойства, или с помощью синтаксиса сабскрипта.
Индексы строки
Каждое String значение имеет связанный тип индекса: String.Index , что соответствует позиции каждого Character в строке.
Как было упомянуто выше, различные символы могут требовать различные объемы памяти для хранения, поэтому для того, чтобы определить, какой Character в определенной позиции, необходимо итерировать каждую скалярную величину Юникода, от начала или конца этой строки. По этой причине, Swift строки не могут быть проиндексированы целочисленными значениями.
Используйте свойство startIndex для доступа позиции первого Character в String . Свойство endIndex — это позиция после последнего символа в String . В результате, endIndex свойство не является допустимым значением для сабскрипта строки. Если String пустая, то startIndex и endIndex равны.
Вы получаете доступ к индексу до и после указанного индекса при помощи методов index(before:) и index(after:) . Для доступа к индексу, расположенного не по соседству с указанным индексом, вы можете использовать метод index(_:offsetBy:) вместо многократного вызова предыдущих методов.
Вы можете использовать синтаксис индекса для доступа Character в определенном индексе String .
let greeting = "Guten Tag!" greeting[greeting.startIndex] // G greeting[greeting.index(before: greeting.endIndex)] // ! greeting[greeting.index(after: greeting.startIndex)] // u let index = greeting.index(greeting.startIndex, offsetBy: 7) greeting[index] // a Попытка доступа к Character в индексе за пределами диапазона строки выдаст сообщение об ошибке выполнения.
greeting[greeting.endIndex] // ошибка greeting.index(after: endIndex) // ошибка Используйте свойство indices , чтобы создать Range всех индексов, используемых для доступа к отдельным символам строки.
for index in greeting.indices < print("\(greeting[index]) ", terminator: " ") >// Выведет "G u t e n T a g !" Заметка
Вы можете использовать свойства startIndex , endIndex и методы index(before:) , index(after:) и index(_:offsetBy:) с любым типом, который соответствует протоколу Collection . Это включает в себя String , как и показано тут, различные типы коллекций, например Array , Dictionary и Set .
Добавление и удаление
Для того, чтобы вставить символ в строку по указанному индексу, используйте insert(_:at:) метод, а для того, чтобы вставить содержимое другой строки по указанному индексу, используйте метод insert(contentsOf:at:) .
var welcome = "hello" welcome.insert("!", at: welcome.endIndex) // welcome теперь равен "hello!" welcome.insert(contentsOf:" there", at: welcome.index(before: welcome.endIndex)) // welcome теперь равен "hello there!” Для того, чтобы удалить символ из строки по указанному индексу используйте remove(at:) , если вы хотите удалить значения по указанному диапазону индексов, используйте метод removeSubrange(_:) :
welcome.remove(at: welcome.index(before: welcome.endIndex)) // welcome теперь равно "hello there" let range = welcome.index(welcome.endIndex, offsetBy: -6).. Заметка
Вы можете использовать методы insert(_:at:) , insert(contentsOf:at:) , remove(at:) и removeSubrange(_:) с любыми типами, которые соответствуют протоколу RangeReplaceableCollection . Это включает в себя String, как показано тут, а так же коллекции, такие как Array , Dictionary и Set .
Подстроки
Вы можете получить подстроку из строки, например, используя сабскрипт или метод типа и prefix(_:) , результат которого возвращает экземпляр подстроки, а не другую строку. Подстроки в Swift имеют практически те же самые методы, что и строки, что означает, что вы можете работать с подстроками так же как и со строками. Однако, в отличие от строк, вы используете подстроки непродолжительное время, пока проводите какие-то манипуляции над строками. Когда вы готовы хранить результат более продолжительное время, то вы конвертируете подстроку в строку. Например:
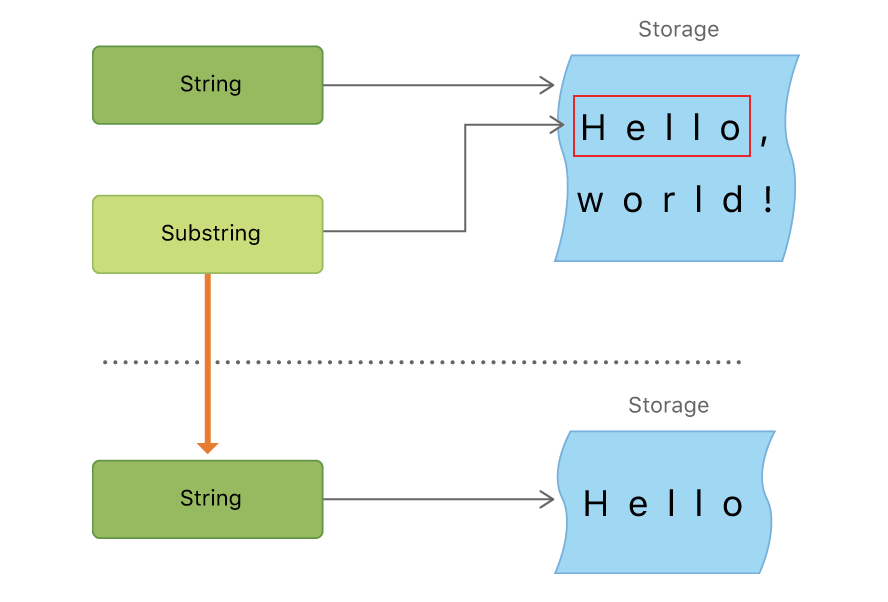
let greeting = "Hello, world!" let index = greeting.firstIndex(of: ",") ?? greeting.endIndex let beginning = greeting[.. Как и строки, каждая подстрока имеет область в памяти, где хранятся символы, создающие эту подстроку. Разница между строками и подстроками в том, что для оптимизации производительности подстрока может использовать часть памяти, используемую для хранения исходной строки или часть памяти, которая используется для хранения другой подстроки. (Строки так же имеют похожую оптимизацию, но если две строки делят между собой память, то они считаются равными.) Это оптимизация означает, что у вас не будет потери производительности через копирование памяти, если вы не изменяете строку или подстроку. Как уже было сказано ранее, подстроки не подходят для долгосрочного хранения, так как они повторно используют хранилище исходной строки. Исходная строка должна находиться в памяти до тех пор, пока одна из ее подстрок все еще используется.
В примере выше и greeting является строкой, которая имеет свою область памяти, где создающие ее символы хранятся. Так как и beginning , является подстрокой от greeting , то она переиспользует память. которую использует greeting . И наоборот, newString является строкой, которая была создана из подстроки и теперь она имеет свое хранилище. Рисунок ниже поможет нам разобраться с этими взаимоотношениями:
Заметка
И String , и Substring реализуют протокол StringProtocol , что означает, что очень часто бывает удобно для строковых манипуляций принимать значение StringProtocol . Вы можете вызывать такие функции со значением String или Substring .
Сравнение строк
Swift предусматривает три способа сравнения текстовых значений: равенство строк и символов, равенство префиксов, и равенство суффиксов.
Равенство строк и символов
Равенство строк и символов проверяется оператором "равенства" ( == ) и оператором "неравенства" ( != ), что описано в главе «Операторы сравнения»:
let quotation = "Мы с тобой похожи" let sameQuotation = "Мы с тобой похожи" if quotation == sameQuotation < print("Эти строки считаются равными") >// Выведет "Эти строки считаются равными" Два String значения (или два Character значения) считаются равными, если их расширенные наборы графем канонически эквивалентны . Расширенные наборы графем канонически эквивалентны, если они имеют один и тот же языковой смысл и внешний вид, даже если они изначально состоят из разных скалярных величин Юникода.
Например, LATIN SMALL LETTER E WITH ACUTE ( U+00E9 ) канонически эквивалентна LATIN SMALL LETTER E ( U+0065 ) , если за ней следует COMBINING ACUTE ACCENT ( U+0301 ) . Оба этих расширенных набора графем являются допустимыми вариантами представления символа é , и поэтому они считаются канонически эквивалентными:
// "Voulez-vous un café?" используем LATIN SMALL LETTER E WITH ACUTE let eAcuteQuestion = "Voulez-vous un caf\u?" // "Voulez-vous un café?" используем LATIN SMALL LETTER E и COMBINING ACUTE ACCENT let combinedEAcuteQuestion = "Voulez-vous un caf\u\u?" if eAcuteQuestion == combinedEAcuteQuestion < print("Эти строки считаются равными") >// Выведет "Эти строки считаются равными" Наоборот, LATIN CAPITAL LETTER A ( U+0041 или " A ") , используемый в английском языке, не является эквивалентом CYRILLIC CAPITAL LETTER A ( U+0410 , или " А "), используемой в русском языке. Символы визуально похожи, но имеют разный языковой смысл:
let latinCapitalLetterA: Character = "\u" let cyrillicCapitalLetterA: Character = "\u" if latinCapitalLetterA != cyrillicCapitalLetterA < print("Эти строки считаются не равными") >// Выведет "Эти строки считаются не равными" Заметка
Сравнение строк и символов в Swift не зависит от локализации.
Равенство префиксов и суффиксов
Чтобы проверить, имеет ли строка определенный строковый префикс или суффикс, вызовите hasPrefix(_:) и hasSuffix(_:) методы, оба из которых принимают единственный аргумент типа String , и возвращают логическое значение.
В приведенных ниже примерах рассмотрим массив строк, представляющих местоположение сцены в первых двух актах Ромео и Джульетты Шекспира:
let romeoAndJuliet = [ "Act 1 Scene 1: Verona, A public place", "Act 1 Scene 2: Capulet's mansion", "Act 1 Scene 3: A room in Capulet's mansion", "Act 1 Scene 4: A street outside Capulet's mansion", "Act 1 Scene 5: The Great Hall in Capulet's mansion", "Act 2 Scene 1: Outside Capulet's mansion", "Act 2 Scene 2: Capulet's orchard", "Act 2 Scene 3: Outside Friar Lawrence's cell", "Act 2 Scene 4: A street in Verona", "Act 2 Scene 5: Capulet's mansion", "Act 2 Scene 6: Friar Lawrence's cell" ] Вы можете использовать hasPrefix(_:) метод с массивом romeoAndJuliet для подсчета количества сцен в первом акте пьесы:
var act1SceneCount = 0 for scene in romeoAndJuliet < if scene.hasPrefix("Act 1 ") < act1SceneCount += 1 >> print("Всего \(act1SceneCount) сцен в Акте 1") // Выведет "Всего 5 сцен в Акте 1" Точно так же, использование hasSuffix(_:) метода для подсчета количества сцен, которые происходят внутри или вокруг особняка Капулетти и клетки монаха Лоренцо:
var mansionCount = 0 var cellCount = 0 for scene in romeoAndJuliet < if scene.hasSuffix("Capulet's mansion") < mansionCount += 1 >else if scene.hasSuffix("Friar Lawrence's cell") < cellCount += 1 >> print("\(mansionCount) сцен в особняке; \(cellCount) тюремные сцены") // выводит "6 сцен в особняке; 2 тюремные сцены" Заметка
hasPrefix(_:) и hasSuffix(_:) методы используются для символ-к-символу канонического эквивалентного сравнения между расширенными наборами графем в каждой строке, как описано в главе «Равенство строк и символов».
Юникод представления строк
Если строка Юникода записывается в текстовый файл или какое-либо другое хранилище, то скалярные величины Юникода в этой строке кодируются в одном из нескольких Юникод-определенных форм кодирования. Каждая форма кодирует строку мелкими кусками, известными как единица кода. Сюда включены: UTF-8 форма кодирования (которая кодирует строку в 8-битные блоки кода), UTF-16 форма кодирования (которая кодирует строку в качестве 16-битных блоков кода), и UTF-32 форма кодирования (которая кодирует строку в 32-битные единицы кода).
Swift предоставляет несколько разных способов доступа к отображению строк Юникода. Вы можете итерировать строки с for-in , для получения их индивидуальных Character значений, как расширенных наборов графем. Этот процесс описан в разделе "Работа с символами".
Кроме того, доступ к String значению в одном из трех других Юникод-совместимых отображений:
Набор UTF-8 единиц кода (можно получить доступ через свойство строки - utf8)
Набор UTF-16 единиц кода (можно получить доступ через свойство строки - utf16 )
Набор 21-битных скалярных значений Юникода, что эквивалентно форме кодирования UTF-32 (доступ через свойство строки - unicodeScalars)
Каждый пример, данный ниже, показывает разное отображение следующей строки, которая состоит из символов 'D' , 'o' , 'g' , '!!' ( "DOUBLE EXCLAMATION MARK" , "U+203C" ) и , ( "DOG FACE" , "U+1F436" ):
let dogString data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAABUAAAAYCAIAAACa6yEfAAAAA3NCSVQICAjb4U/gAAAAEHRFWHRTb2Z0d2FyZQBTaHV0dGVyY4LQCQAAAlhJREFUOMvdlDFsElEYx/+A2KMSeI2GPNOYEB08t9tk47aywVY22coGIyNbu9ENNrvBJpuMt9m4HIlGXod6Fw3htdJytEQevXLPodYUuaZDBxP/43vf/+Xl+33/LyClxD0UxP30n/u9u/wPfM6c7kmrNe4irCU9W0RTdK6oJKM99H1A/i1rUNoeWb1xbyqllFPr3LRmZv2wZs6lj274p9ZpbYttlo7M6VLZdPKuxDayX5s9d/EicDU/l92GvcOiRd3rkpjGf9oilMo/VhUA087emGNFU6cdtqryU4MmdgpR5Wb/hPF9F+utXUqcYEpXCGZc4LoiROByAaKtUSBXeV4hx5X2xUL/BZdUiwBIKuD2TNHXK3nF4R4AcJfknlXyYccWAmEAVFPA5YKfqCHWPhMAUYOOE2Q7B3p+6NAgAFB0Kz29cAYxA40AsDsTRVtZ5K89LYpBg3mAB2fSagmQuW0DAPh5qy2gzBj3BACbV7tr5dQffIHr/Dk/CkU3lwItJpT2MSMxPROlAHCxvze0k7FM6rJRdZPOkJdflVUf/m5z8+PLbN8H3m9N3mbNeLpv3cp/cFpKf97+cEXYNZvfarV+vXk+uro1+xvpgyX+i/M3aB5ubB0NpJSjo2zcLNXt1/FPtZ6Ucv5++8ub+mTpU4v5ofknOnPa7AIkXixGWGdC84lMEoIdtw2lUHh0Z35i5eo4tzukuQhJhgkDVUO2cWIYI1J+oSvL8Qn47L/9hmUwl2uJghZ02EnDCCbVWLW85mP39QMALm1jZNhSoauZTJTcmv/AP96/vwD8Rd/hvd/dJQAAAABJRU5ErkJggg==" alt="" />" Отображение UTF-8
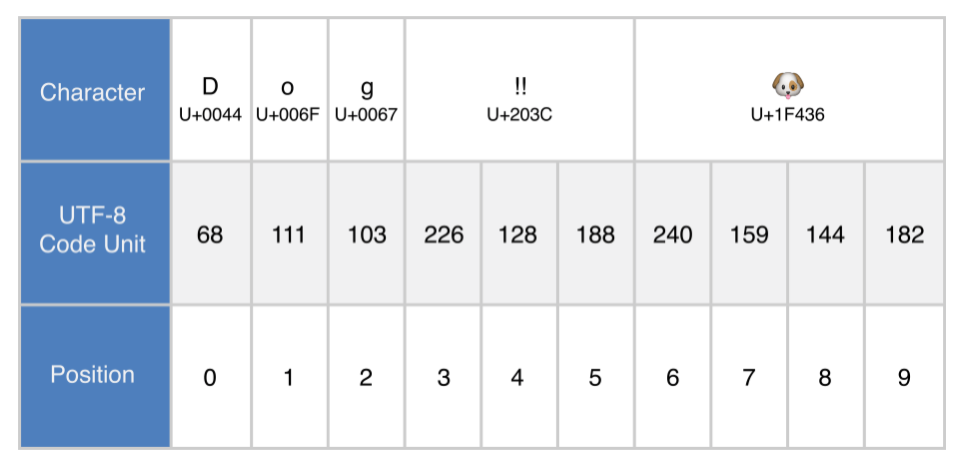
Вы можете получить доступ к UTF-8 строке, итерируя его свойство utf8. Это свойство имеет тип String.UTF8View, который представляет собой набор значений unsigned 8-bit (UInt8), по одному для каждого байта в представлении UTF-8 строки:
for codeUnit in dogString.utf8 < print("\(codeUnit) ", terminator: " ") >print("") // 68 111 103 226 128 188 240 159 144 182В приведенном выше примере, первые три десятичных codeUnit значения ( 68 , 111, 103 ) отображают символы D , o , и g , чье UTF-8 отображение такое же, как и в ASCII отображении. Следующие три десятичных codeUnit значения ( 226 , 128 , 188 ) являются трех байтным UTF-8 отображением символа DOUBLE EXCLAMATION MARK . Последние четыре codeUnit значения ( 240 , 159 , 144 , 182 ) являются четырех байтным UTF-8 отображением символа DOG FACE .
Отображение UTF-16
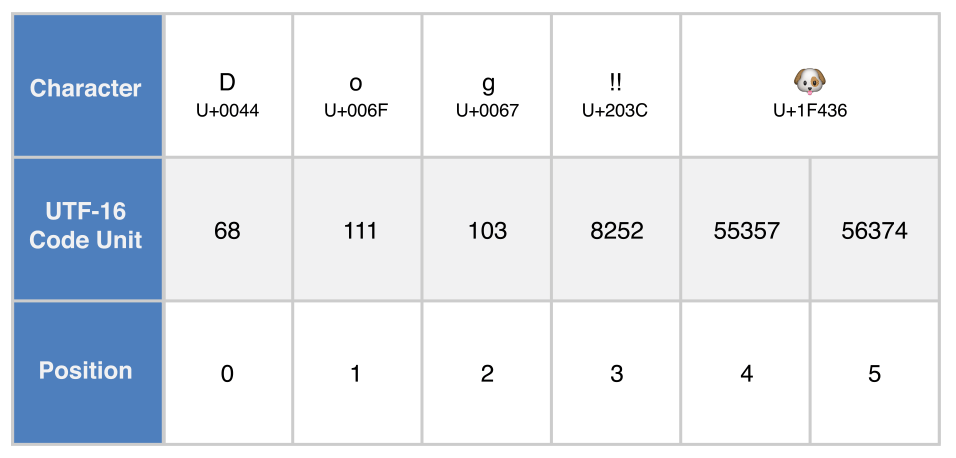
Вы можете получить доступ к UTF-16 строки, итерируя его свойство utf16. Это свойство имеет тип String.UTF16View, который представляет собой набор значений unsigned 16-bit (UInt16), по одному для каждого 16-разрядного блока кода в представлении UTF-16 строки:
for codeUnit in dogString.utf16 < print("\(codeUnit) ", terminator: " ") >print("") // Выведет "68 111 103 8252 55357 56374 "И опять первые три десятичных codeUnit значения ( 68 , 111 , 103 ) отображают символы D , o , и g , чье UTF-16 отображение такое же, как и в строковом отображении UTF-8 (потому что эти скалярные величины Юникода отображают ASCII символы).
Четвертое codeUnit значение ( 8252 ) является десятичным эквивалентом шестнадцатеричного 203C , которое отображает скалярную величину Юникода U+203C для символа DOUBLE EXCLAMATION MARK . Этот символ может быть отображен в виде самостоятельной единицы кода в UTF-16.
Пятое и шестое codeUnit значение ( 55357 и 56374 ) являются суррогатной парой UTF-16 отображения символа DOG FACE . Эти значения имеют «высоко суррогатное» значение U+D83D (с десятичным значением 55357 ) и «низко суррогатное» значение U+DC36 (с десятичным значением 56374 ).
Отображение скалярных величин Юникода 
Вы можете получить доступ к скалярному представлению Unicode значения String путем повторения его свойства unicodeScalars. Это свойство имеет тип UnicodeScalarView , который представляет собой коллекцию значений типа UnicodeScalar .
Каждый UnicodeScalar имеет свойство value , которое возвращает 21-битное значение скаляра, представленное в пределах UInt32 :
for scalar in dogString.unicodeScalars < print("\(scalar.value) ", terminator: " ") >print("") // Выведет "68 111 103 8252 128054 "Свойство value для первых трех десятичных codeUnit значений ( 68 , 111 , 103 ) снова отображают символы D , o , и g .
Четвертое codeUnit значение ( 8252 ) снова является десятичным эквивалентом шестнадцатеричного 203C , которое отображает скалярную величину Юникода U+203C для символа DOUBLE EXCLAMATION MARK .
Свойство value для пятого и последнего UnicodeScalar , 128054 , является десятичным эквивалентом шестнадцатеричного значения 1F436 , которое отображает скалярную величину Юникода U+1F436 для символа DOG FACE .
В качестве альтернативы обращения к свойствам value , каждое UnicodeScalar значение также может быть использовано для построения нового String значения, например, с помощью интерполяции строк:
for scalar in dogString.unicodeScalars < print("\(scalar) ") >// D // o // g // ‼ // ![]()
Если вы нашли ошибку, пожалуйста, выделите фрагмент текста и нажмите Ctrl+Enter.
Если вы нашли ошибку, пожалуйста, выделите фрагмент текста и нажмите Ctrl+Enter.