4.3.2 Виды функциональных зависимостей
Функциональная взаимозависимость. Если существует функциональная зависимость вида А—>В и В—>А, то между А и В имеется взаимно однозначное соответствие, или функциональная взаимозависимость, обозначаемая как АВ или ВА. Если отношение находится в 1НФ, то все неключевые атрибуты функционально зависят от ключа с различной степенью зависимости. Частичной функциональной зависимостью (частичной ФЗ) называется зависимость неключевого атрибута от части составного ключа. В рассматриваемом отношении атрибут Должн находится в функциональной зависимости от атрибута ФИО, являющегося частью ключа. Тем самым атрибут Должн находится в частичной зависимости от ключа отношения. Альтернативным вариантом является полная функциональная зависимость неключевого атрибута от всего составного ключа. В нашем примере атрибут ВидЗан находится в полной функциональной зависимости от составного ключа. Атрибут С зависит от атрибута А транзитивно (существует транзитивная зависимость), если для атрибутов А, В, С выполняются условия А—>В и В—>С, но обратная зависимость отсутствует. В отношении на рис. 4.4 транзитивной зависимостью связаны атрибуты: Ф И О —>Д олжн —> Оклад Между атрибутами может иметь место многозначная зависимость. В отношении R атрибут В многозначно зависит от атрибута А, если каждому значению А соответствует множество значений В, не связанных с другими атрибутами из R, Многозначные зависимости могут быть «один ко многим» (1:М), «многие к одному» (М:1) или «многие ко многим» (М:М), обозначаемые соответственно: А=>Б, АБ. Например, пусть преподаватель ведет несколько предметов, а каждый предмет может вестись несколькими преподавателями, тогда имеет местозависимость ФИОПредмет. Так, из таблицы, приведенной на рис. 4.4, видно, что преподаватель Иванов И.М. ведет занятия по двум предметам, а дисциплина СУБД — читается двумя преподавателями: Ивановым И.М. и Петровым М.И. Замечание. В общем случае между двумя атрибутами одного отношения могут существовать зависимости: 1:1, 1:М, М:1 и М:М. Поскольку зависимость между атрибутами является причиной аномалий, стараются расчленить отношения с зависимостями атрибутов на несколько отношений. В результате образуется совокупность связанных отношений (таблиц) со связями вида 1:1, 1:М, М:1 и М:М (подраздел 3.2). Связи между таблицами отражают зависимости между атрибутами различных отношений. Взаимно независимые атрибуты. Два или более атрибута называютсявзаимно независимыми, если ни один из этих атрибутов не является функционально зависимым от других атрибутов. В случае двух атрибутов отсутствие зависимости атрибута А от атрибута В можно обозначить так: A¬—>B. Случай, когда A¬—>В и B¬—>A, можно обозначить А¬В.
4.3.3 Аксиомы Армстронга
Чтобы определить ключи и понять логические следствия функциональных зависимостей в общем случае, необходимо вычислить замыкание F + изF или по крайней мере знать для заданногоF и функциональной зависимостиX Y, содержится лиX YвF + . Для этого необходимо иметь правила вывода, которые указывают, как из одной или более зависимостей выводить другие зависимости. Множество таких правил называют аксиомами Армстронга. Предположим, что задана некоторая схема отношения с множеством атрибутовМ, универсальным множеством атрибутов, и множество функциональных зависимостейF, связывающих только атрибуты, принадлежащиеМ. Тогда имеем следующие правила вывода (аксиомы): А1: (рефлексивность). ЕслиY ≤ X ≤ М, то X Y логически следует изF. Заметим, что это правило даеттривиальные зависимости, т. е. зависимости, правая часть которых содержится в левой части. Его использование не зависит отF. А2: (пополнение). ЕслиXY иZ≤ М, тоXUZ YUZ. Важно напомнить, что данная зависимостьXY либо принадлежитF, либо может быть выведена из принадлежащихF зависимостей с использованием описываемых аксиом. A3:(транзитивность). ЕслиXY иYZ, тоXZ. Относительно легко доказывается, что аксиомы Армстронга являются надежными, т. е. приводят только к истинным заключениям. Это означает, что используя их, мы не можем вывести из F какую-либо зависимость, которая не принадлежитF + . Более сложно доказать их полноту, означающую, что эти аксиомы могут быть использованы для получения каждого справедливого следствия из зависимостей. Это означает, что при заданном множестве зависимостейF правила позволяют нам вывести все зависимости, принадлежащиеF + . Из аксиом Армстронга выводятся еще 5 аксиом (расширения, продолжения, псевдотранзитивности, объединения и декомпозиции), используемых для построенияполного семейства ФЗ.
Лекция № 9. Функциональные зависимости
Ограничения уникальности, накладываемые объявлениями первичного и кандидатных ключей отношения, является частным случаем ограничений, связанных с понятием функциональных зависимостей.
Для объяснения понятия функциональной зависимости, рассмотрим следующий пример.
Пусть нам дано отношение, содержащее данные о результатах какой-то одной конкретной сессии. Схема этого отношения выглядит следующим образом:
Сессия (№ зачетной книжки, Фамилия, Имя, Отчество, Предмет, Оценка);
Атрибуты «№ зачетной книжки» и «Предмет» образуют составной (так как ключом объявлены два атрибута) первичный ключ этого отношения. Действительно, по двум этим атрибутам можно однозначно определить значения всех остальные атрибутов.
Однако, помимо ограничения уникальности, связанной с этим ключом, на отношение непременно должно быть наложено то условие, что одна зачетная книжка выдается обязательно одному конкретному человеку и, следовательно, в этом отношении кортежи с одинаковым номером зачетной книжки должны содержать одинаковые значения атрибутов «Фамилия», «Имя» и «Отчество».

Если у нас имеется следующий фрагмент какой-то определенной базы данных студентов учебного заведения после какой-то сессии, то в кортежах с номером зачетной книжки 100, атрибуты «Фамилия», «Имя» и «Отчество» совпадают, а атрибуты «Предмет» и «Оценка» – не совпадают (что и понятно, ведь в них речь идет о разных предметах и успеваемости по ним). Это значит, что атрибуты «Фамилия», «Имя» и «Отчество» функционально зависят от атрибута «№ зачетной книжки», а атрибуты «Предмет» и «Оценка» функционально не зависят.
Таким образом, функциональная зависимость – это однозначная зависимость, затабулированная в системах управления базами данных.
Теперь дадим строгое определение функциональной зависимости.
Определение: пусть X, Y – подсхемы схемы отношения S, определяющие над схемой S схему функциональной зависимости X ? Y (читается «X стрелка Y»). Определим ограничения функциональной зависимости inv ? Y> как утверждение о том, что в отношении со схемой S любые два кортежа, совпадающие в проекции на подсхему X, должны совпадать и в проекции на подсхему Y.
Запишем это же определение в формулярном виде:
Любопытно, что в этом определении использовано понятие унарной операции проекции, с которым мы сталкивались раньше. Действительно, как еще, если не использовать эту операцию, показать равенство друг другу двух столбцов таблицы-отношения, а не строк? Поэтому мы и записали в терминах этой операции, что совпадение кортежей в проекции на какой-то атрибут или несколько атрибутов (подсхему X) непременно влечет за собой совпадение этих же столбцов-кортежей и на подсхеме Y в том случае, если Y функционально зависит от X.
Интересно заметить, что в случае функциональной зависимости Y от X, говорят также, что X функционально определяет Y или что Y функционально зависит от X. В схеме функциональной зависимости X ? Y подсхема X называется левой частью, а подсхема Y – правой частью.
На практике проектирования баз данных на схему функциональной зависимости для краткости обычно ссылаются как на функциональную зависимость.
В частном случае, когда правая часть функциональной зависимости, т. е. подсхема Y, совпадает со всей схемой отношения, ограничение функциональной зависимости переходит в ограничение уникальности первичного или кандидатного ключа. Действительно:
Просто в определении функциональной зависимости вместо подсхемы X нужно взять обозначение ключа K, а вместо правой части функциональной зависимости, подсхемы Y взять всю схему отношений S, т. е., действительно, ограничение уникальности ключей отношений является частным случаем ограничения функциональной зависимости при равенстве правой части схемы функциональной зависимости всей схеме отношения.
Приведем примеры изображения функциональной зависимости:
Данный текст является ознакомительным фрагментом.
Продолжение на ЛитРес
Читайте также
Назначение и функциональные возможности программы
Назначение и функциональные возможности программы Программа HtmlPad адресована веб-разработчикам и веб-администраторам. Ее характерной особенностью является то, что она обладает простым и понятным пользовательским интерфейсом, а также очевидным инструментарием.
6.6. Функциональные клавиши и меню Файл
6.6. Функциональные клавиши и меню Файл До сих пор мы рассказывали только о внешнем виде экрана программы Midnight Commander и о том, как изменить этот вид. Теперь пора рассказать и том, как работать с файлами с помощью этой программы.Наиболее часто выполняемые в Midnight Commander операции
Функциональные клавиши
Функциональные возможности Excel
Функциональные возможности Excel Excel 2007 позволяет формировать и выводить на печать документы, представленные в табличном виде, выполнять расчеты на основании исходных данных и др. Задачи, решаемые с помощью табличного редактора Excel, кратко перечислены ниже.• Создание,
Назначение и функциональные возможности
Назначение и функциональные возможности Программа Microsoft Outlook 2007 обладает широкими функциональными возможностями, которые кратко можно сформулировать следующим образом:• выполнение функций персонального органайзера;• работа с электронной почтой (создание,
Функциональные клавиши
Функциональные клавиши Обычно вы посылаете команду ЭВМ, нажимая на клавишу с надписью enter (ввод), с/r (возврат каретки) или return (возврат). Названия клавиш иногда обозначаются прописными буквами. Пусть клавиша [enter] — [ввод]. Здесь квадратные скобки означают, что вы должны
Функциональные объекты
Функциональные объекты Функциональные объекты — это объекты, для которых определён operator(). Они важны для эффективного использования библиотеки. В местах, где ожидается передача указателя на функцию алгоритмическому шаблону, интерфейс установлен на приём объекта с
Другие функциональные сочетания клавиш
Другие функциональные сочетания клавиш
19.2.7. Конструкторы и функциональные try-блоки
19.2.7. Конструкторы и функциональные try-блоки Можно объявить функцию так, что все ее тело будет заключено в try-блок. Такие try-блоки называются функциональными. (Мы упоминали их в разделе 11.2.) Например:int main() catch ( pushOnFull ) catch ( popOnEmpty ) Функциональный
Функциональные клавиши
Функциональные клавиши Для удобной работы с системой сохраняется возможность использования функциональных клавиш:• F1 – вызов справочной системы AutoCAD;• F2 – переключение между текстовым и графическим окнами;• F3 или Ctrl+F – включение/отключение текущих режимов объектной
3.3.1 Функциональные возможности
3.3.1 Функциональные возможности a) Установка (инсталляция)Если установка пакета может быть выполнена пользователем, то при ее проведении должна быть обеспечена возможность успешной установки программ в соответствии с информацией, содержащейся в руководстве по
4.1 Функциональные возможности (Functionality)
4.1 Функциональные возможности (Functionality) Набор атрибутов, относящихся к сути набора функций и их конкретным свойствам. Функциями являются те, которые реализуют установленные или предполагаемые потребности:Примечания1 Данный набор атрибутов характеризует то, что
А.2.1 Функциональные возможности (Functionality)
А.2.1 Функциональные возможности (Functionality) А.2.1.1 Пригодность (Suitability) Атрибут программного обеспечения, относящийся к наличию и соответствию набора функций конкретным задачам.Примечание — Примерами Соответствия является состав функций, ориентированных на задачу, из
4.1.2. Функциональные клавиши
4.1.2. Функциональные клавиши В верхней части клавиатуры размещено 12 (от F1 до F12) функциональных клавиш (рис. 30). Функции, выполняемые этими клавишами, зависят от работающей в данный момент программы, т. е. реакцию на нажатие каждой функциональной клавиши задает программист.
Введение в функциональные зависимости
В этой статье мы поговорим о функциональных зависимостях в базах данных — что это такое, где применяются и какие алгоритмы существуют для их поиска.
Рассматривать функциональные зависимости мы будем в контексте реляционных баз данных. Если говорить совсем грубо, то в таких базах данных информациях хранится в виде таблиц. Далее мы используем приближенные понятия, которые в строгой реляционной теории не являются взаимозаменяемыми: саму таблицу будем называть отношением, столбцы — атрибутами (их множество — схемой отношения), а набор значений строки на подмножестве атрибутов — кортежем.

Например, в таблице выше, (Benson, M, M organ) является кортежем по атрибутам (Пациент, Пол, Доктор).
Более формально это записывается в следующем виде: [Пациент, Пол, Доктор] = (Benson, M, M organ).
Теперь мы можем ввести понятие функциональной зависимости (ФЗ):
Определение 1. Отношение R удовлетворяет ФЗ X → Y (где X, Y ⊆ R) тогда и только тогда, когда для любых кортежей , ∈ R выполняется: если [X] = [X], то [Y ] = [Y ]. В таком случае говорят, что X (детерминант, или определяющее множество атрибутов) функционально определяет Y (зависимое множество).
Иными словами, наличие ФЗ X → Y означает, что если мы имеем два кортежа в R и они совпадают по атрибутам X, то они будут совпадать и по атрибутам Y.
А теперь по порядку. Рассмотрим атрибуты Пациент и Пол для которых хотим узнать, есть ли между ними зависимости или нет. Для такого множества атрибутов могут существовать следующие зависимости:
- Пациент → Пол
- Пол → Пациент
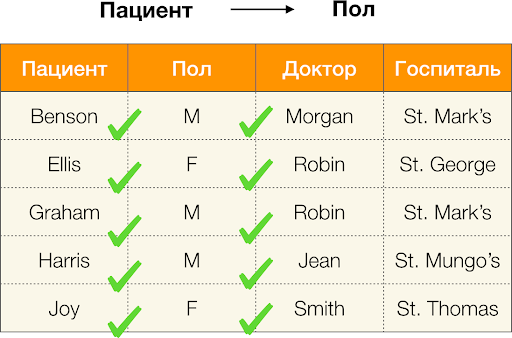
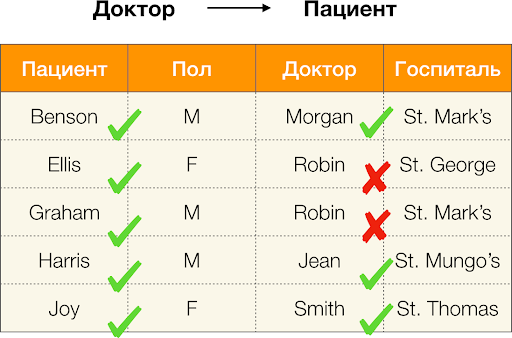
Таким образом, функциональные зависимости позволяют определить имеющиеся связи между множествами атрибутов таблицы. Отсюда и впредь мы будем рассматривать наиболее интересные связи, а точнее такие X → Y, что они являются:
- нетривиальными, то есть правая часть зависимости не является подмножеством левой (Y ̸⊆ X);
- минимальными, то есть нет такой зависимости Z → Y, что Z ⊂ X.
Посчитаем ошибку для Доктор → Пациент из примера выше. Имеем два кортежа, значения которых разнятся на атрибуте Пациент, но совпадают на Докторе: [Доктор, Пациент] = (Robin, Ellis) и [Доктор, Пациент] = (Robin, Graham). Следуя определению ошибки, мы должны учитывать все конфликтующие пары, а значит таковых будет две: (, ) и ее инверсия (, ). Подставим в формулу и получим:
А теперь попытаемся ответить на вопрос: «А зачем оно все?». На самом деле, ФЗ бывают разные. Первый тип — это такие зависимости, которые определяются администратором на этапе проектирования базы данных. Их обычно немного, они строгие, а основное применение — нормализация данных и дизайн схемы отношения.
Второй тип — зависимости, представляющие «скрытые» данные и ранее неизвестные связи между атрибутами. То есть о таких зависимостях не думали в момент проектирования и их находят уже для имеющегося набора данных, чтобы потом на основе множества выявленных ФЗ сделать какие-либо выводы о хранимой информации. Как раз с такими зависимостями мы и работаем. Ими занимается целая область дата майнинга с различными техниками поиска и построенными на их основе алгоритмами. Давайте разбираться, чем могут быть полезны найденные функциональные зависимости (точные или приближенные) в каких-либо данных.
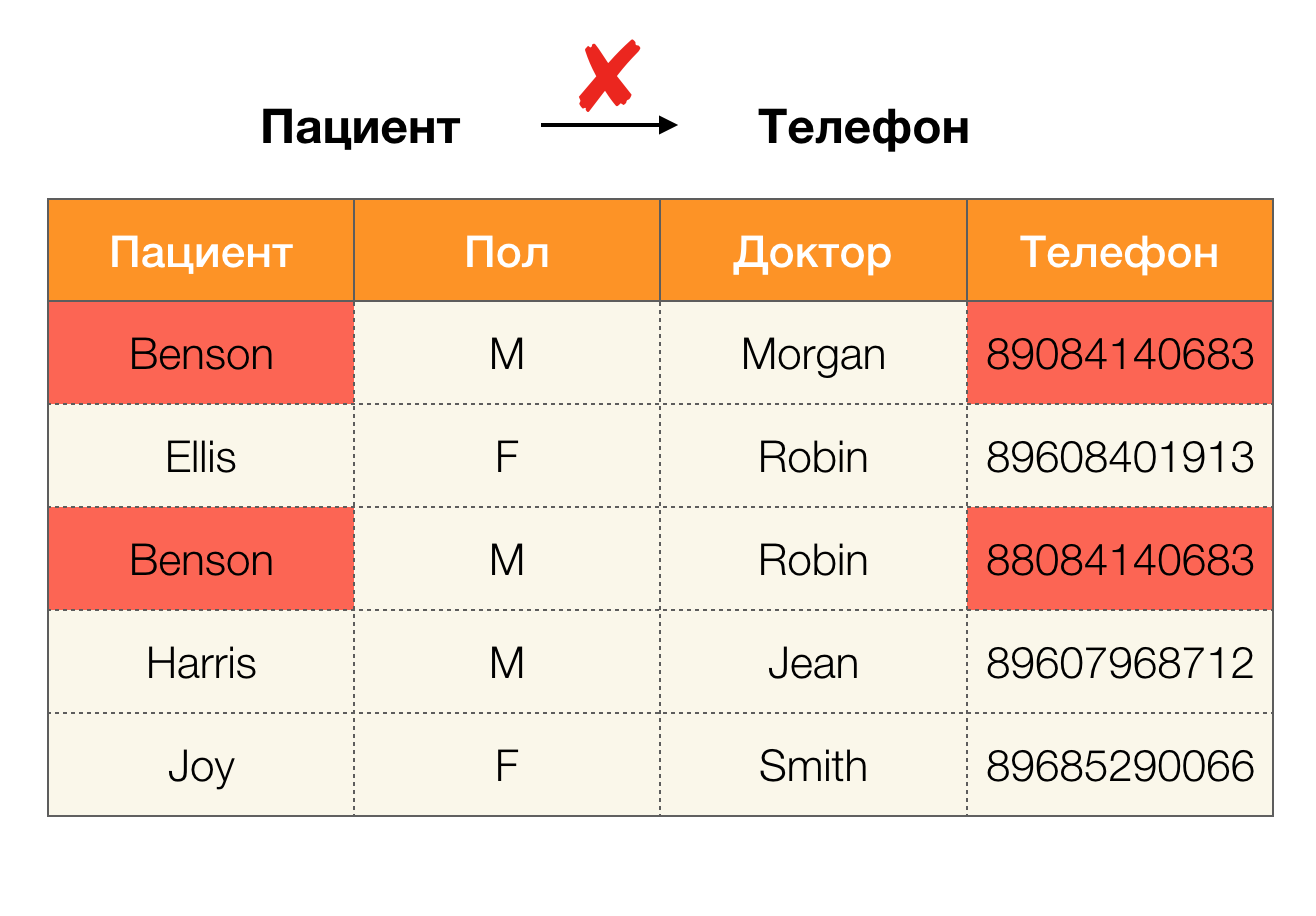
Сегодня среди основных областей применения зависимостей выделяют очистку данных. Она подразумевает разработку процессов выявления «грязных данных» с последующим их исправлением. Яркими представителями «грязных данных» являются дубликаты, ошибки в данных или опечатки, пропущенные значения, устаревшие данные, лишние пробелы и тому подобное.
Пример ошибки в данных:
Пример дубликатов в данных:
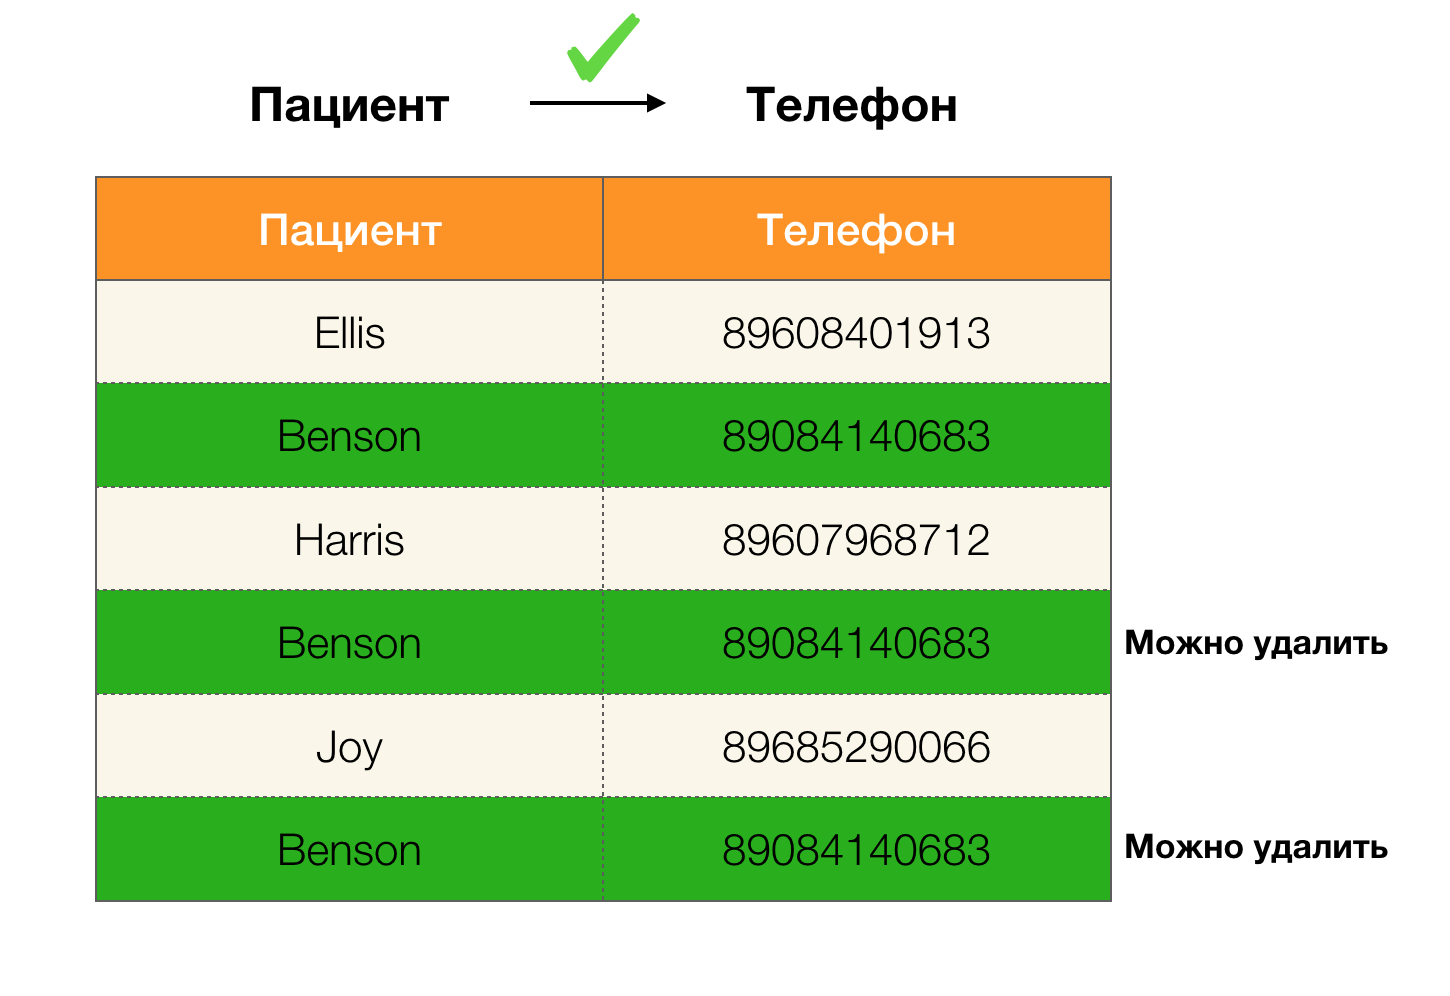
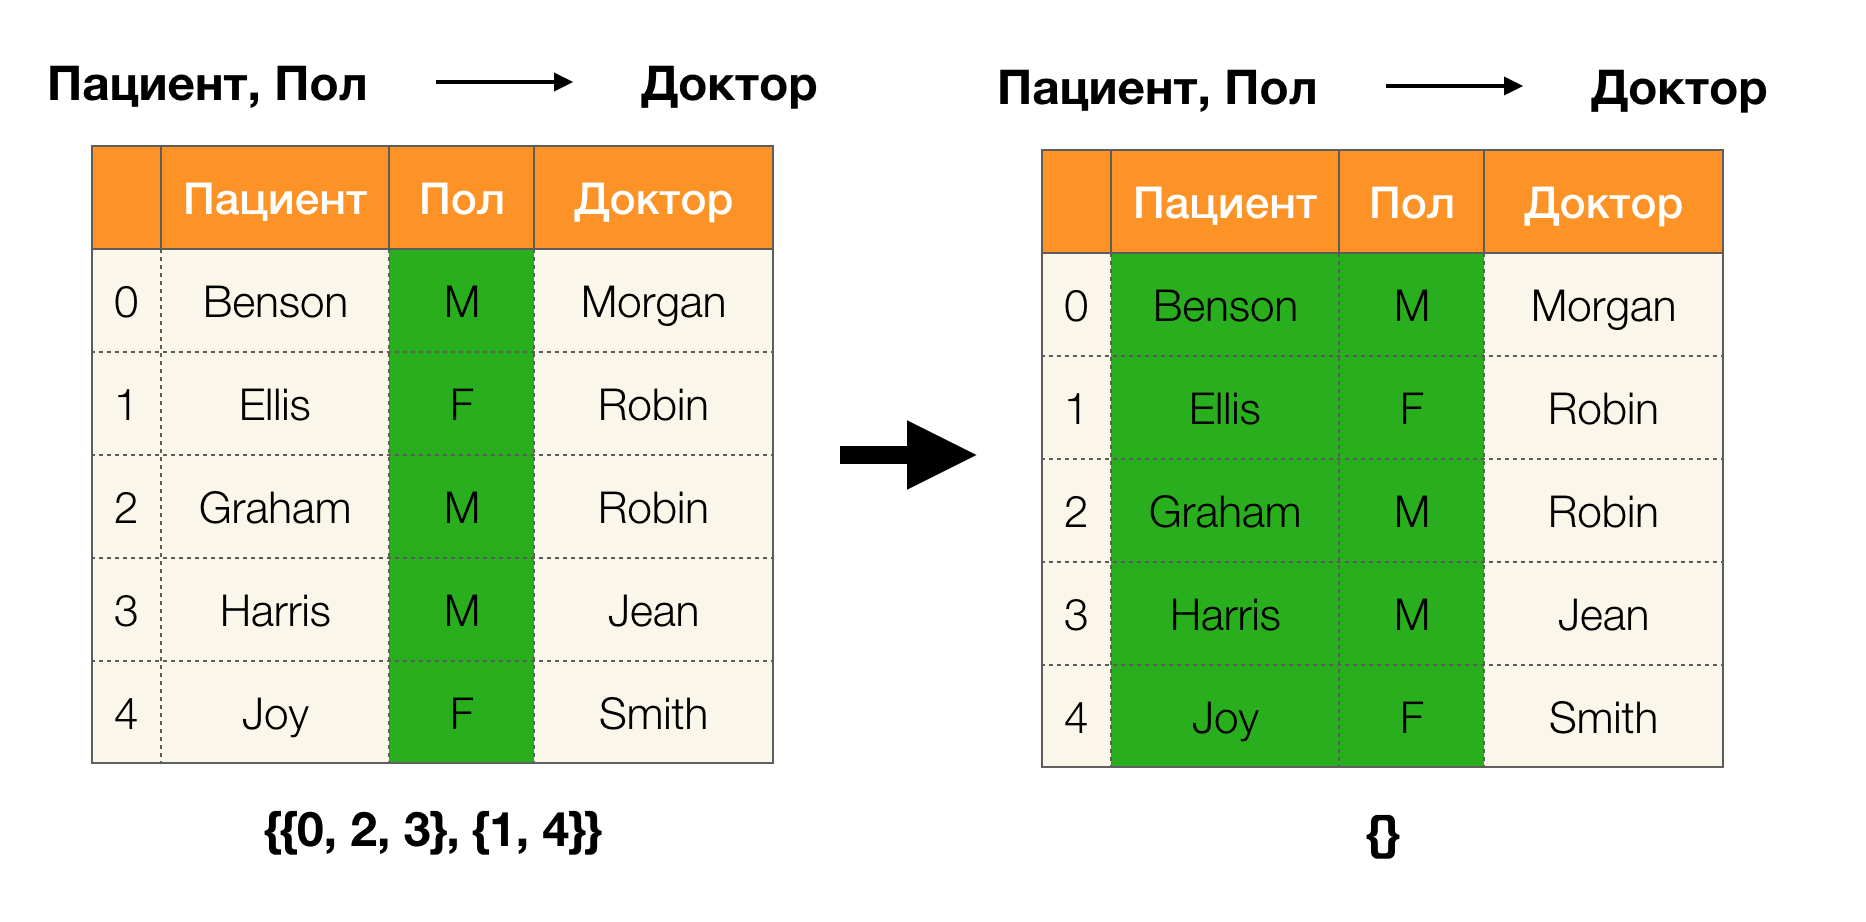
Например, мы имеем таблицу и набор ФЗ, которые должны выполняться. Очистка данных в данном случае предполагает изменить данные таким образом, чтобы ФЗ стали верны. При этом число модификаций должно быть минимально (для данной процедуры существуют свои алгоритмы, на которых мы не будем сосредотачивать внимание в данной статье). Ниже приведен пример такого преобразования данных. Слева исходное отношение, в котором, очевидно, не выполняются необходимые ФЗ (красным цветом выделен пример нарушения одной из ФЗ). Справа представлено обновленное отношение, в котором зеленые ячейки показывают измененные значения. После проведения такой процедуры необходимые зависимости стали удерживаться.
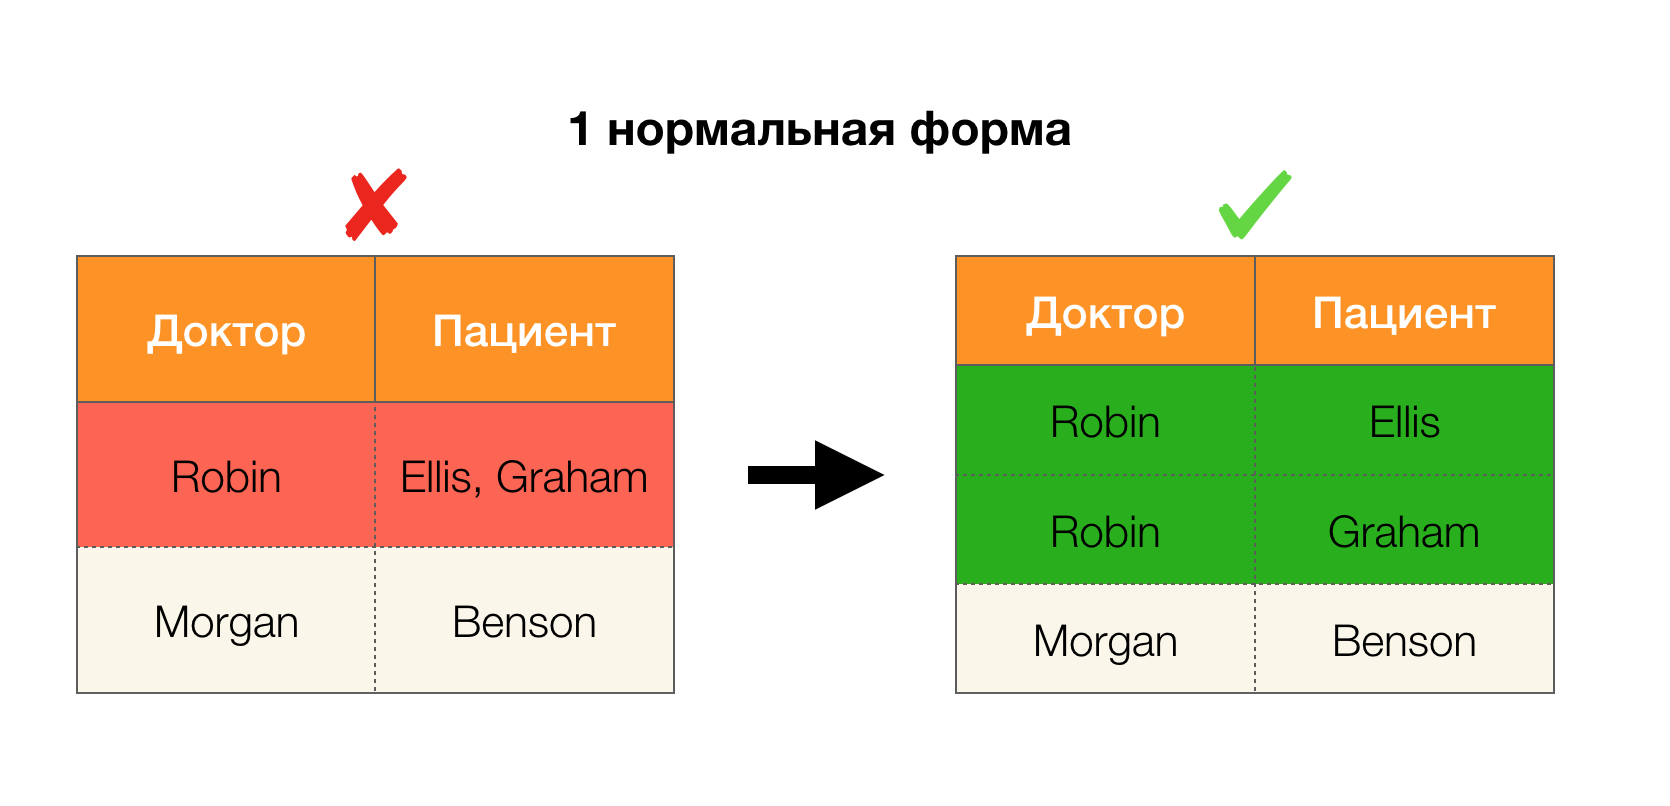
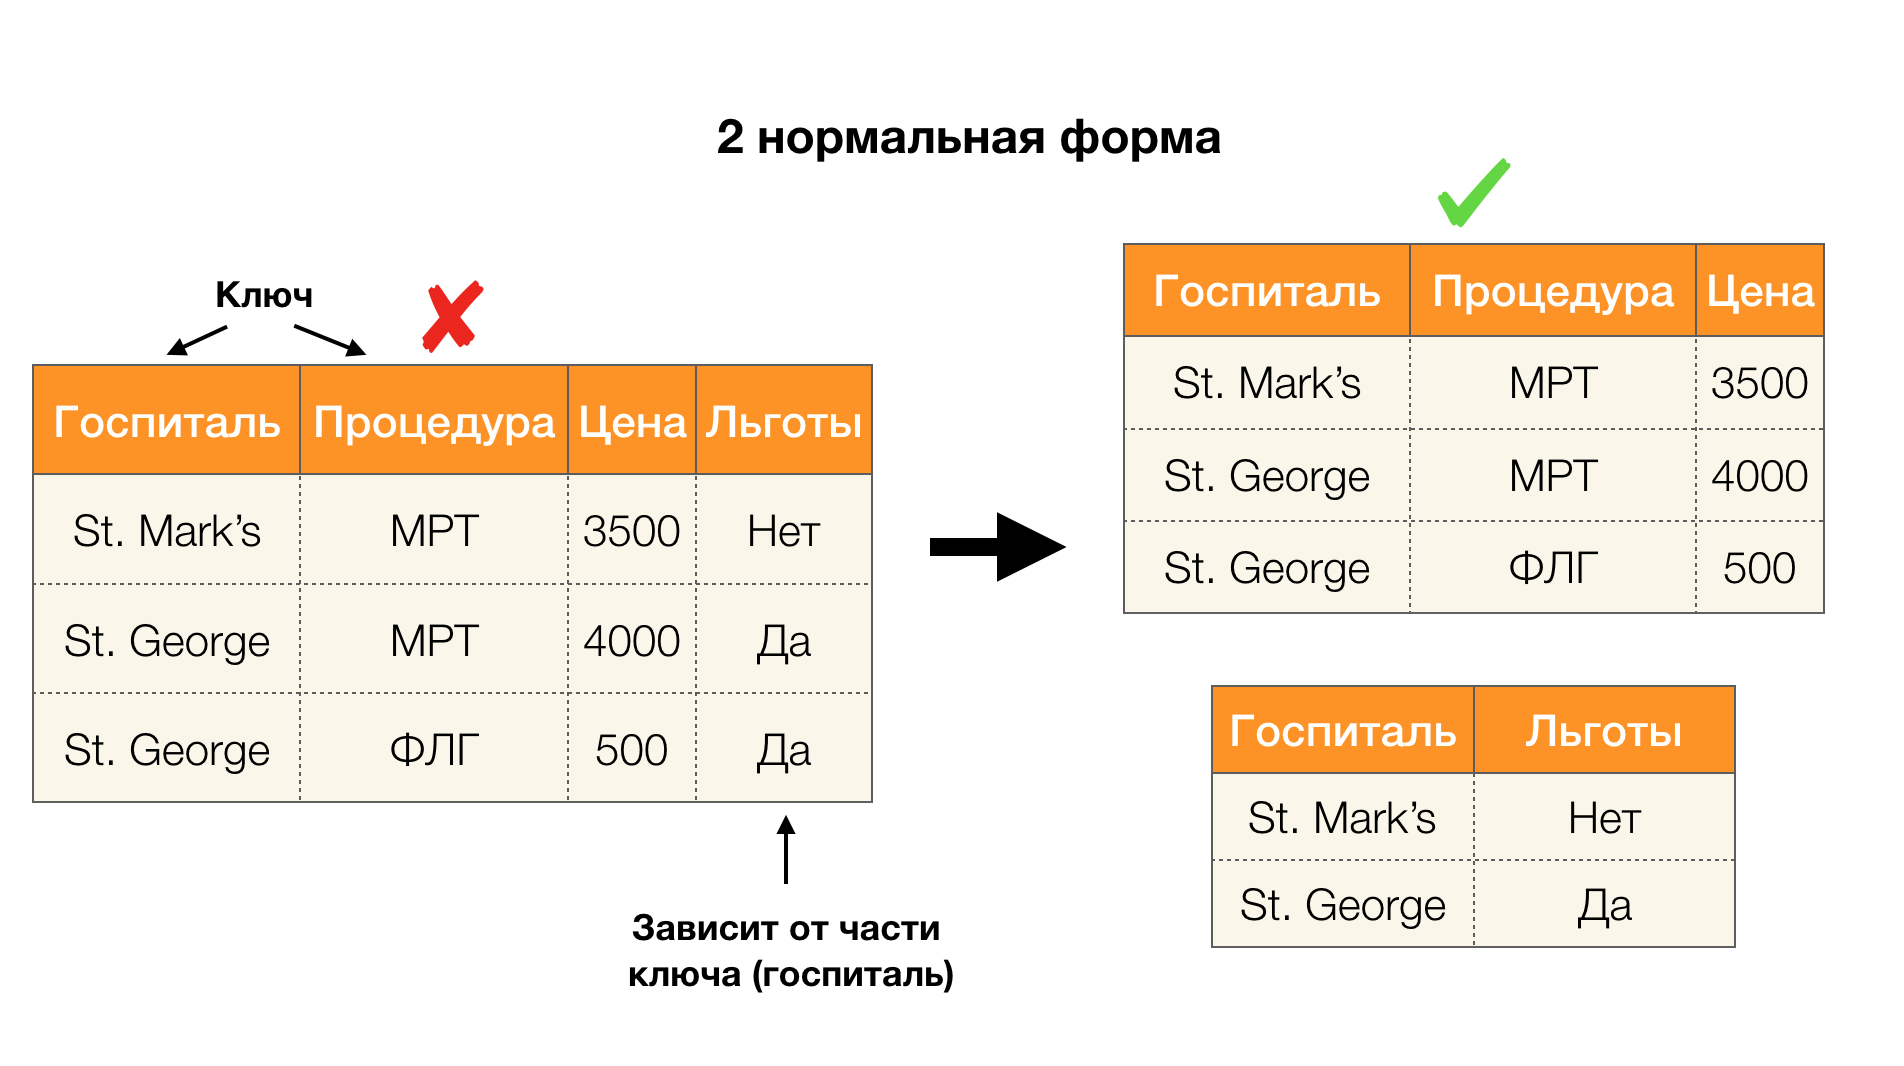
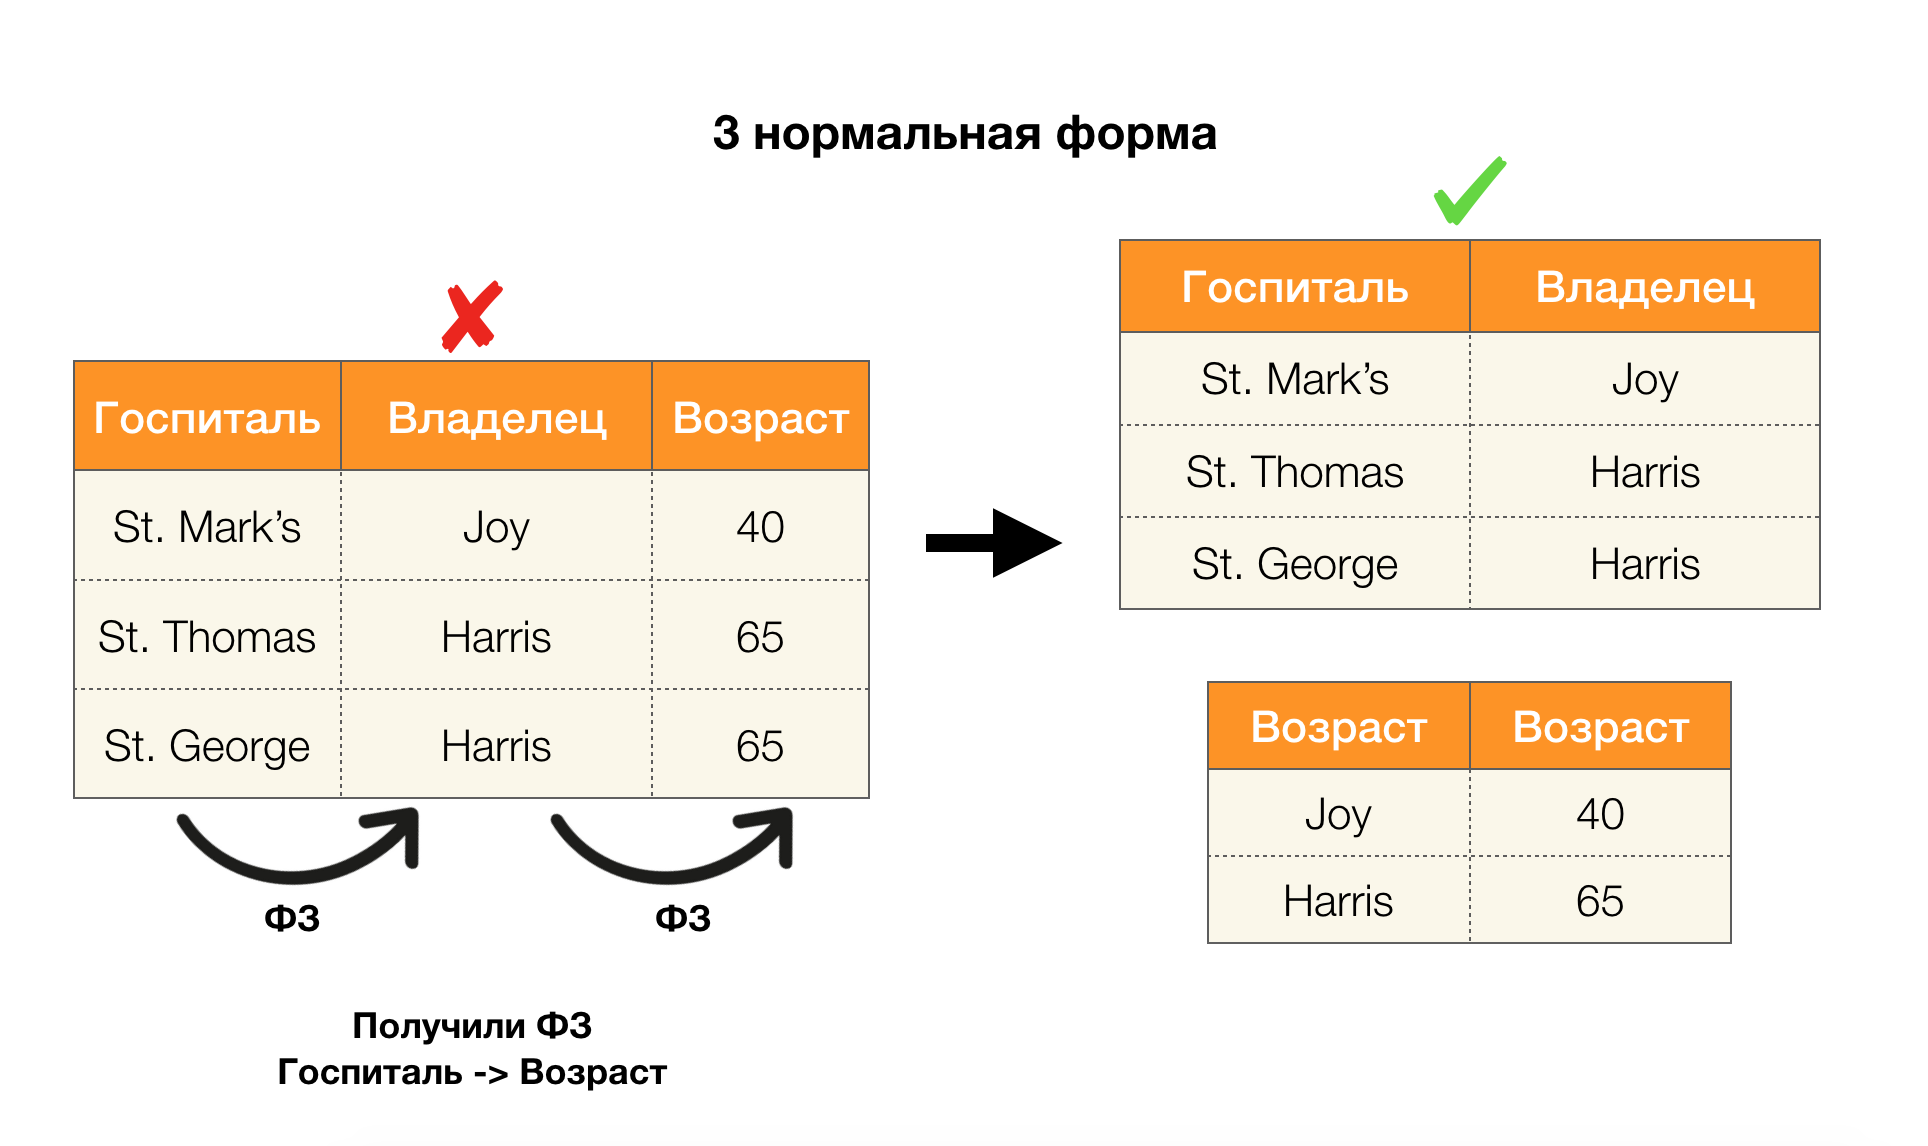
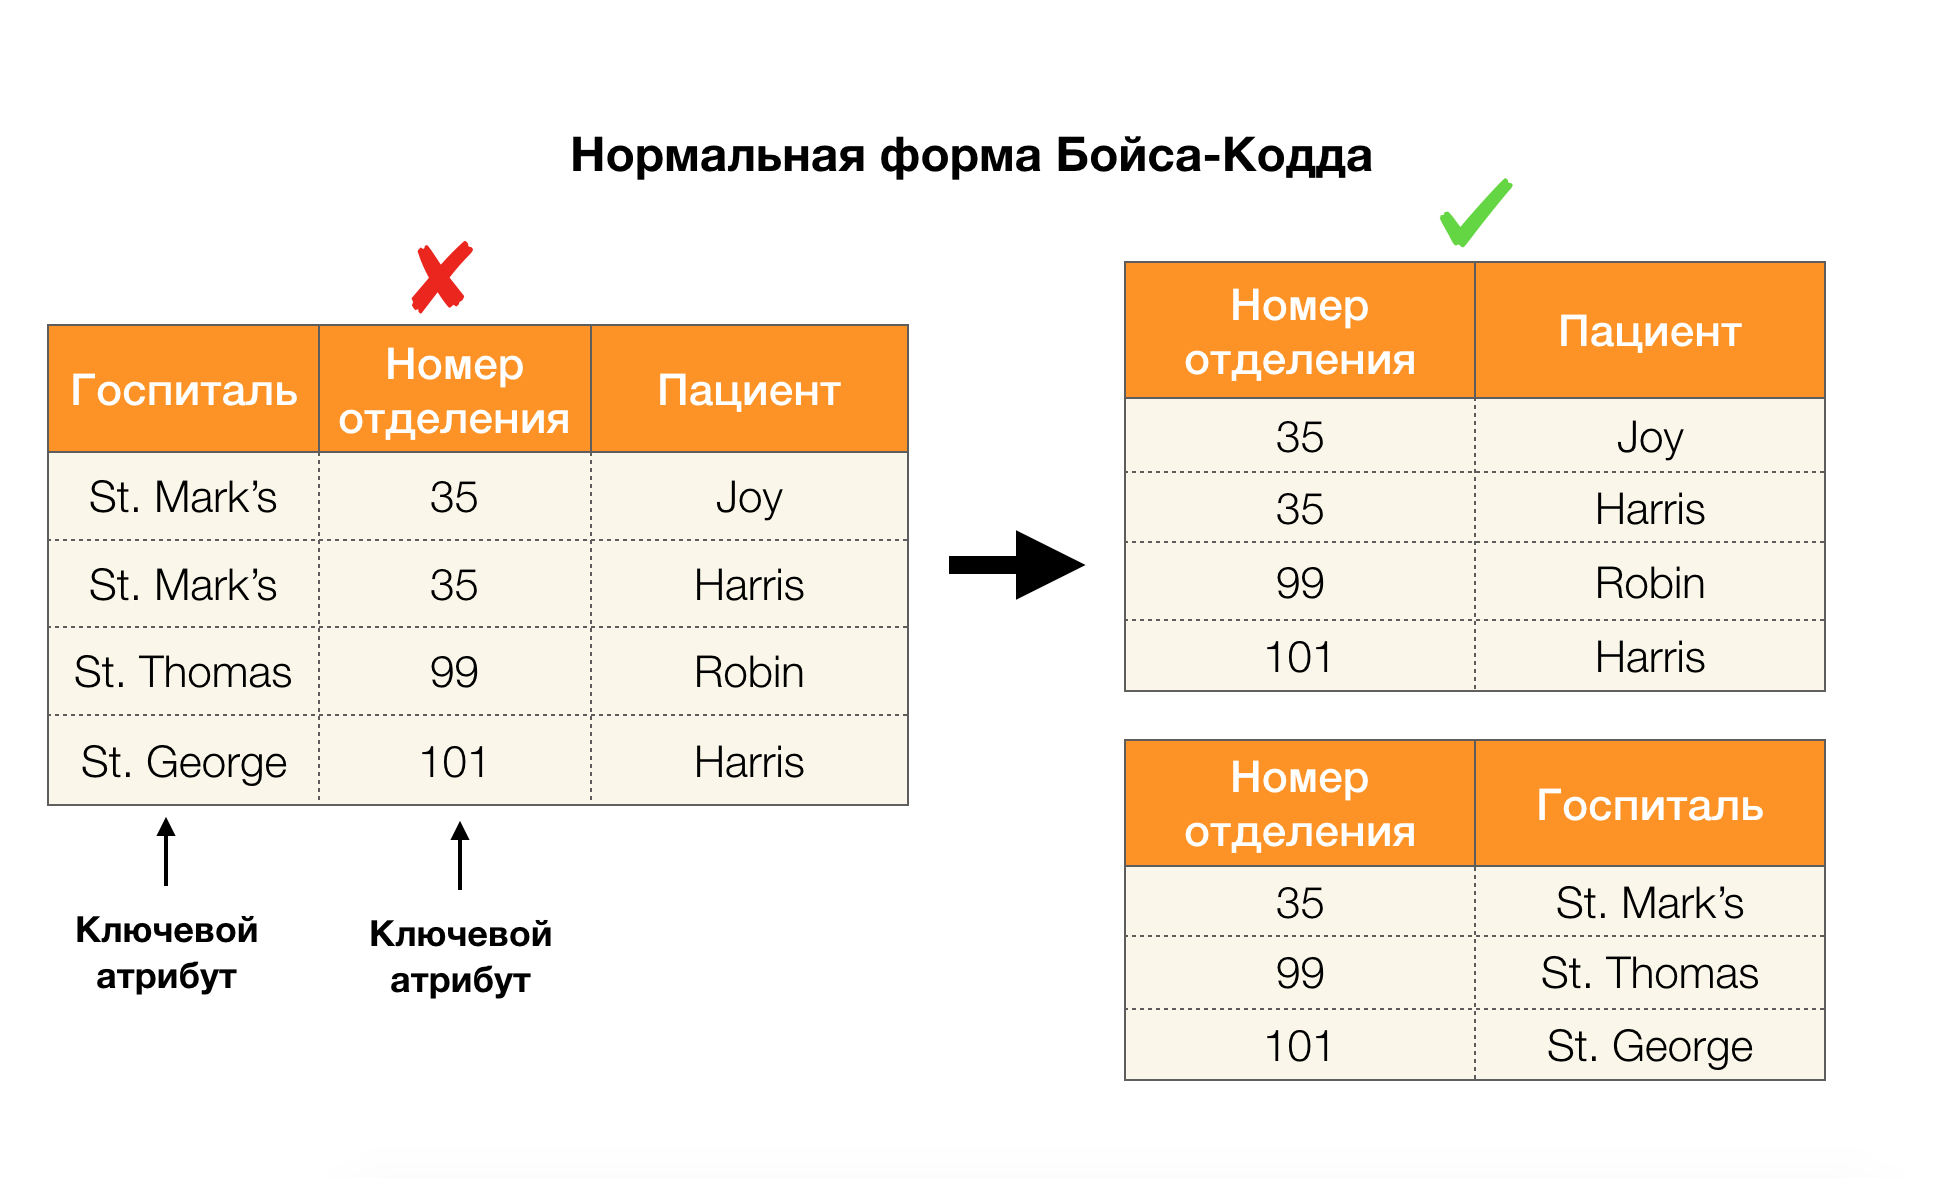
Другой популярной областью применения является дизайн базы данных. Здесь стоит напомнить про нормальные формы и нормализацию. Нормализация — это процесс приведения отношения в соответствие некоторому набору требований, каждый из которых определяется нормальной формой по-своему. Расписывать требования различных нормальных форм мы не станем (это делается в любой книге по курсу БД для начинающих), а лишь заметим, что каждая из них по-своему использует концепцию функциональных зависимостей. Ведь ФЗ по своей сути являются ограничениями целостности, которые учитываются при проектировании базы данных (в контексте этой задачи ФЗ иногда называют суперключами).
Рассмотрим их применение для четырех нормальных форм на картинке ниже. Напомним, что нормальная форма Бойса-Кодда является более строгой, чем третья форма, но при этом менее строгой, чем четвертая. Последнюю пока не рассматриваем, поскольку для ее постановки нужно понимание многозначных зависимостей, которые в данной статье нам не интересны.
Еще одной областью, в которой зависимости нашли свое применение, является понижение размерности пространства признаков в таких задачах как построение наивного байесовского классификатора, выделение значимых признаков и репараметризация регрессионной модели. В оригинальных статьях эта задача называется определением избыточных признаков (feature redundancy) и релевантных (feature relevancy) [5, 6], и решается она с активным использованием концепций баз данных. С появлением таких работ мы можем говорить, что сегодня наблюдается запрос на решения, позволяющие объединить базу данных, аналитику и реализацию вышеперечисленных проблем оптимизации в один инструмент [7, 8, 9].
Для поиска ФЗ в наборе данных существует множество алгоритмов (как современных, так и не очень).Такие алгоритмы можно разделить на три группы:
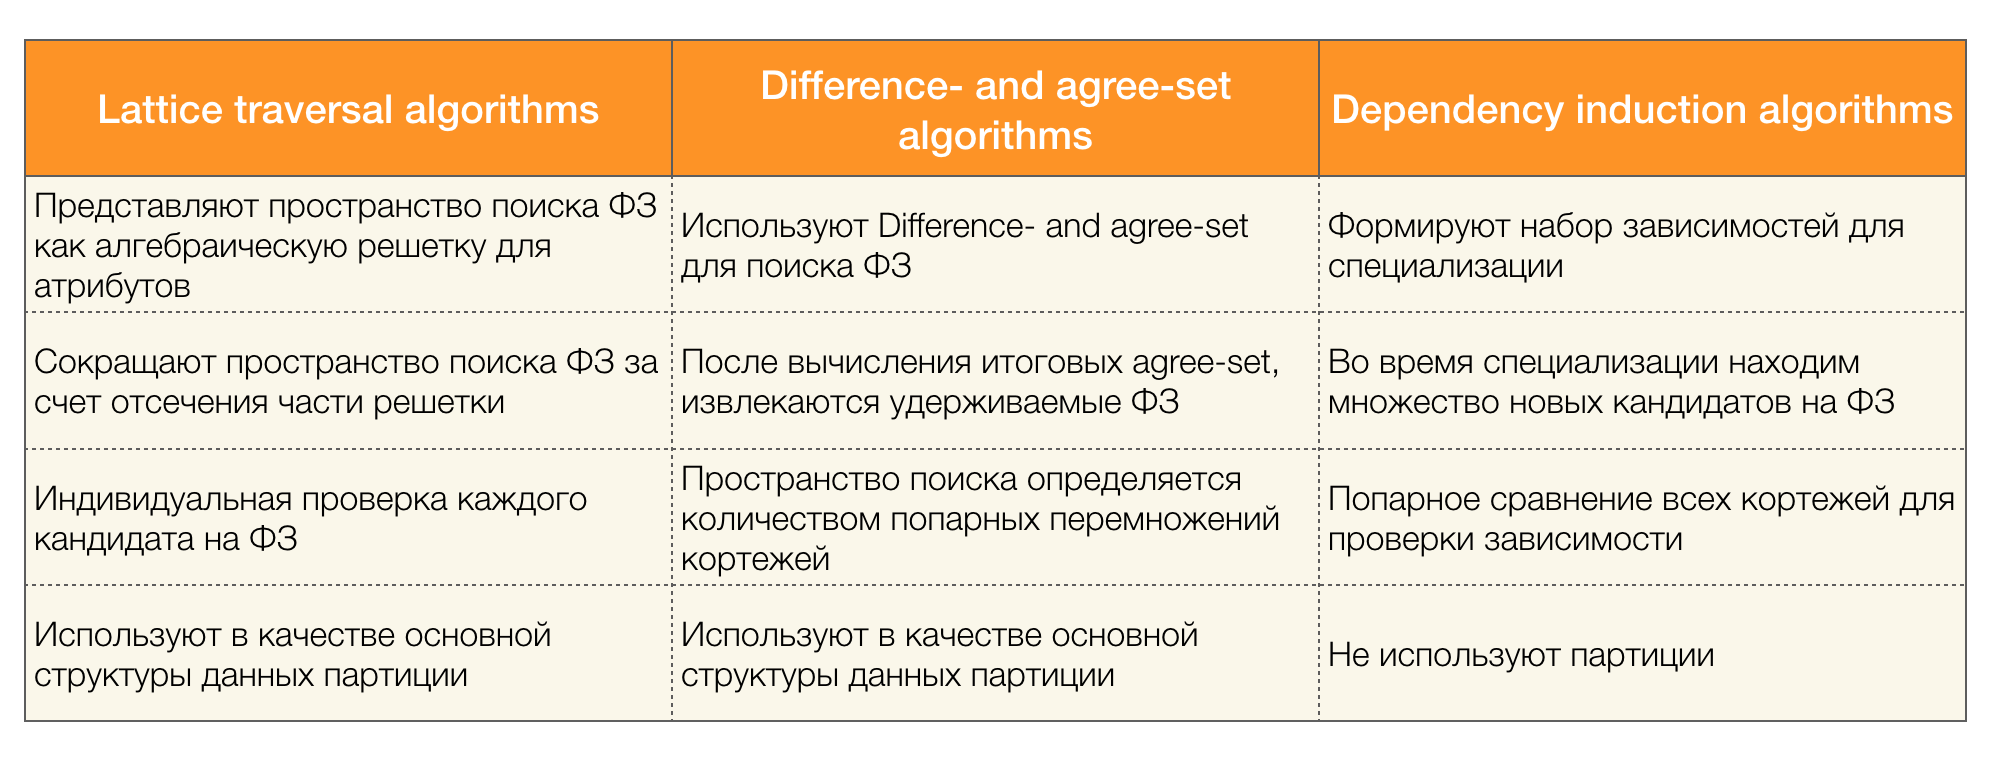
- Алгоритмы, использующие обход алгебраических решеток (Lattice traversal algorithms)
- Алгоритмы, основанные на поиске согласованных значений (Difference- and agree-set algorithms)
- Алгоритмы, основанные на попарных сравнениях (Dependency induction algorithms)
Краткое описание каждого типа алгоритмов представлено в таблице ниже:
Подробнее о данной классификации можно почитать [4]. Ниже представлены примеры алгоритмов на каждый из типов:

В настоящее время появляются новые алгоритмы, которые сочетают в себе сразу несколько подходов к поиску функциональных зависимостей. Примерами таких алгоритмов являются Pyro [2] и HyFD [3]. Разбор их работы предполагается в следующих статьях данного цикла. В этой статье мы лишь разберем основные понятия и лемму, которые необходимы для понимания техник выявления зависимостей.
Начнем с простого — difference- и agree-set, используемые во втором типе алгоритмов. Difference-set представляет собой множество кортежей, которые не совпадают по значениям, а agree-set наоборот — кортежи, совпадающие по значениям. Стоить отметить, что в данном случае мы рассматриваем только левую часть зависимости.
Также важным понятием, которое встречалось выше, является алгебраическая решетка. Так как многие современные алгоритмы оперируют данным понятием, нам нужно иметь представление о том, что это такое.
Для того чтобы ввести понятие решетки, необходимо определение частично упорядоченного множества (или partially ordered set, сокращенно — poset).
- Рефлексивность, то есть a ⩽ a
- Антисимметричность, то есть, если a ⩽ b и b ⩽ a, то a = b
- Транзитивность, то есть для a ⩽ b и b ⩽ c следует, что a ⩽ c
В качестве простейшего примера частично упорядоченного множества можно взять множество всех натуральных чисел N с обычным отношением порядка ⩽. Нетрудно проверить, что все необходимые аксиомы выполняются.
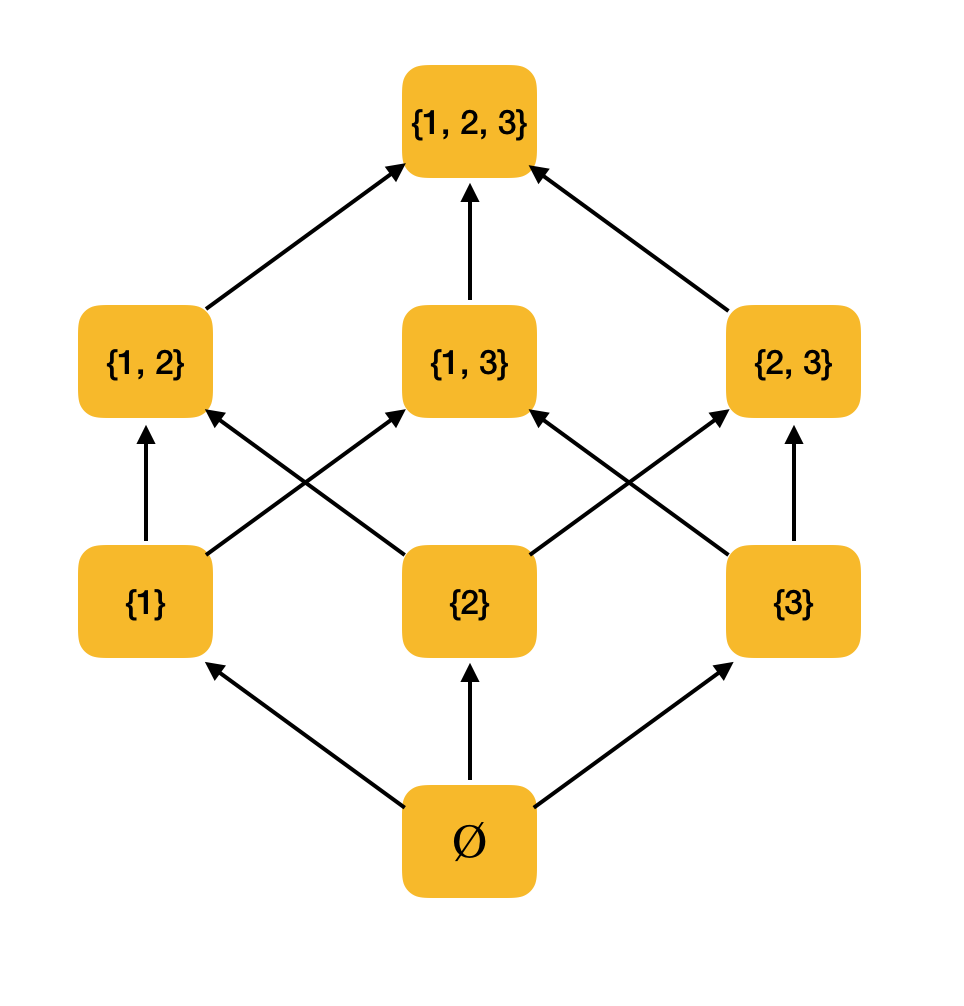
Более содержательный пример. Рассмотрим множество всех подмножеств , упорядоченное отношением включения ⊆. Действительно, это отношение удовлетворяет всем условиям частичного порядка, поэтому ⟨P (), ⊆⟩ — частично упорядоченное множество. На рисунке ниже изображена структура этого множества: если из одного элемента можно дойти по стрелочкам до другого элемента, то они находятся в отношении порядка.
Нам потребуются еще два простых определения из области математики — супремум (supremum) и инфимум (infimum).
Определение 3. Пусть ⟨S, ⩽⟩ — частично упорядоченное множество, A ⊆ S. Верхняя граница A — это такой элемент u ∈ S, что ∀x ∈ A: x ⩽ u. Пусть U — множество всех верхних границ A. Если в U существует наименьший элемент, тогда он называется супремумом и обозначается как sup A.
Аналогично вводится понятие точной нижней границы.
Определение 4. Пусть ⟨S, ⩽⟩ — частично упорядоченное множество, A ⊆ S. Нижняя граница A — это такой элемент l ∈ S, что ∀x ∈ A: l ⩽ x. Пусть L — множество всех нижних границ A. Если в L существует наибольший элемент, тогда он называется инфимумом и обозначается как inf A.
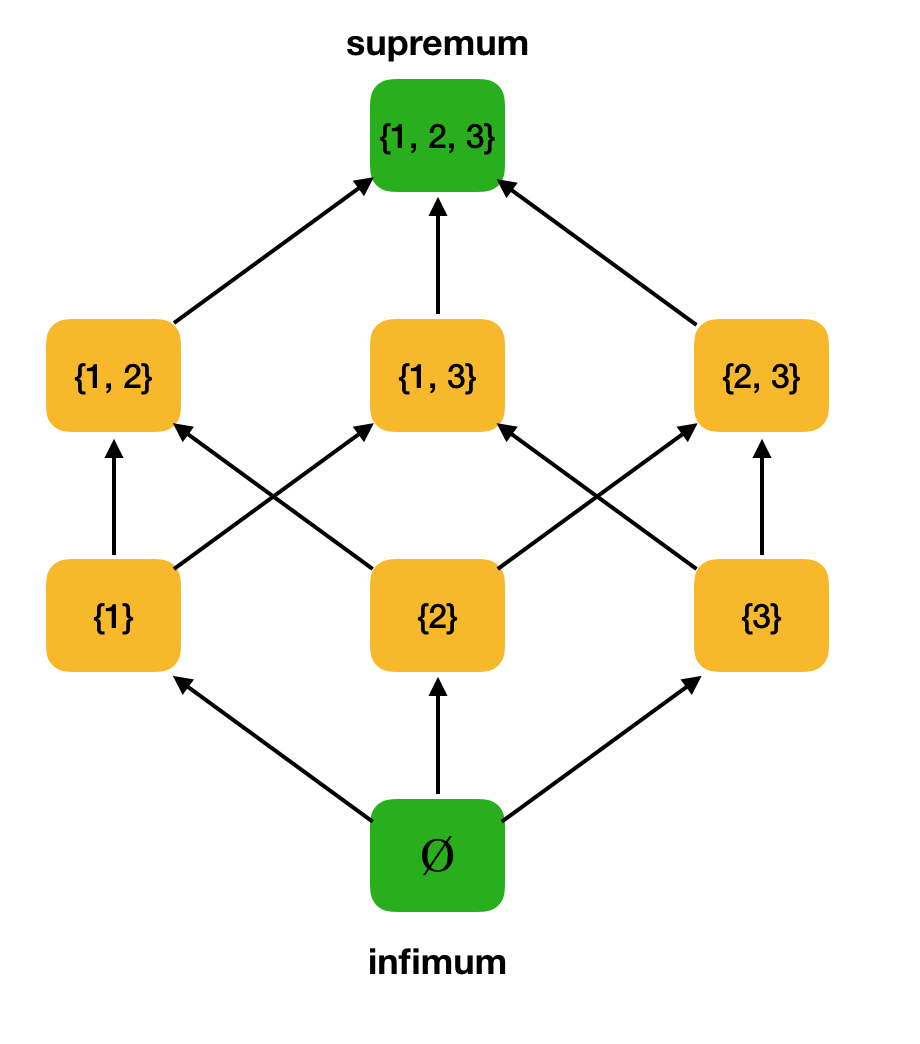
Рассмотрим в качестве примера приведенное выше частично упорядоченное множество ⟨P (), ⊆⟩ и найдем в нем супремум и инфимум:
Теперь можно сформулировать определение алгебраической решетки.
Определение 5. Пусть ⟨P, ⩽⟩ — частично упорядоченное множество, такое что всякое двухэлементное подмножество имеет точные верхнюю и нижнюю границы. Тогда P называется алгебраической решеткой. При этом sup записывают как x ∨ y, а inf — как x ∧ y.
Проверим, что наш рабочий пример ⟨P (), ⊆⟩ является решеткой. Действительно, для всяких a, b ∈ P (), a∨b = a∪b, а a∧b = a∩b. Например, рассмотрим множества и и найдем их инфимум и супремум. Если мы их пересечем, то получим множество , которое и будет являться инфимумом. Супремум же получим их объединением — .
В алгоритмах выявления ФЗ пространство поиска зачастую представляется в форме решетки, где множества из одного элемента (читай первый уровень решетки поиска, где левая часть зависимостей состоит из одного атрибута) являют собой каждый атрибут исходного отношения.
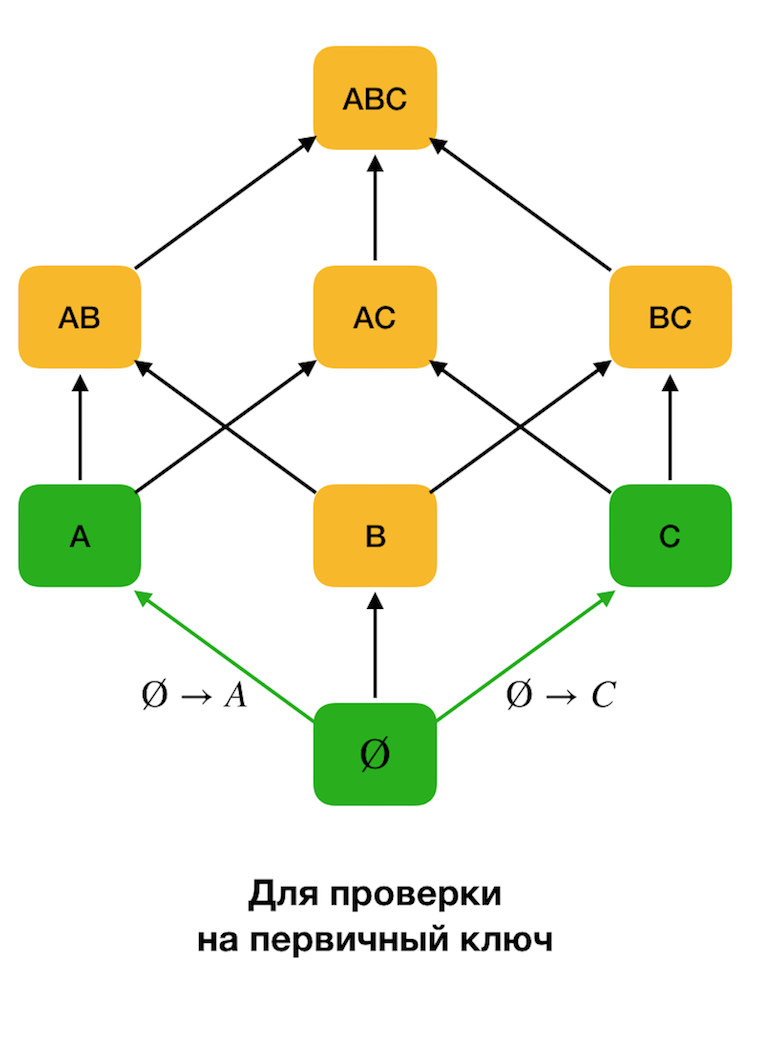
В начале рассматриваются зависимости вида ∅ → Одиночный атрибут. Данный шаг позволяет определить, какие атрибуты являются первичными ключами (для таких атрибутов не бывает детерминантов, а потому левая часть пуста). Далее такие алгоритмы двигаются по решетке вверх. При этом стоит отметить, что решетку можно обходить не всю, то есть если на вход передать желаемый максимальный размер левой части, то дальше уровня с таким размером алгоритм идти не будет.
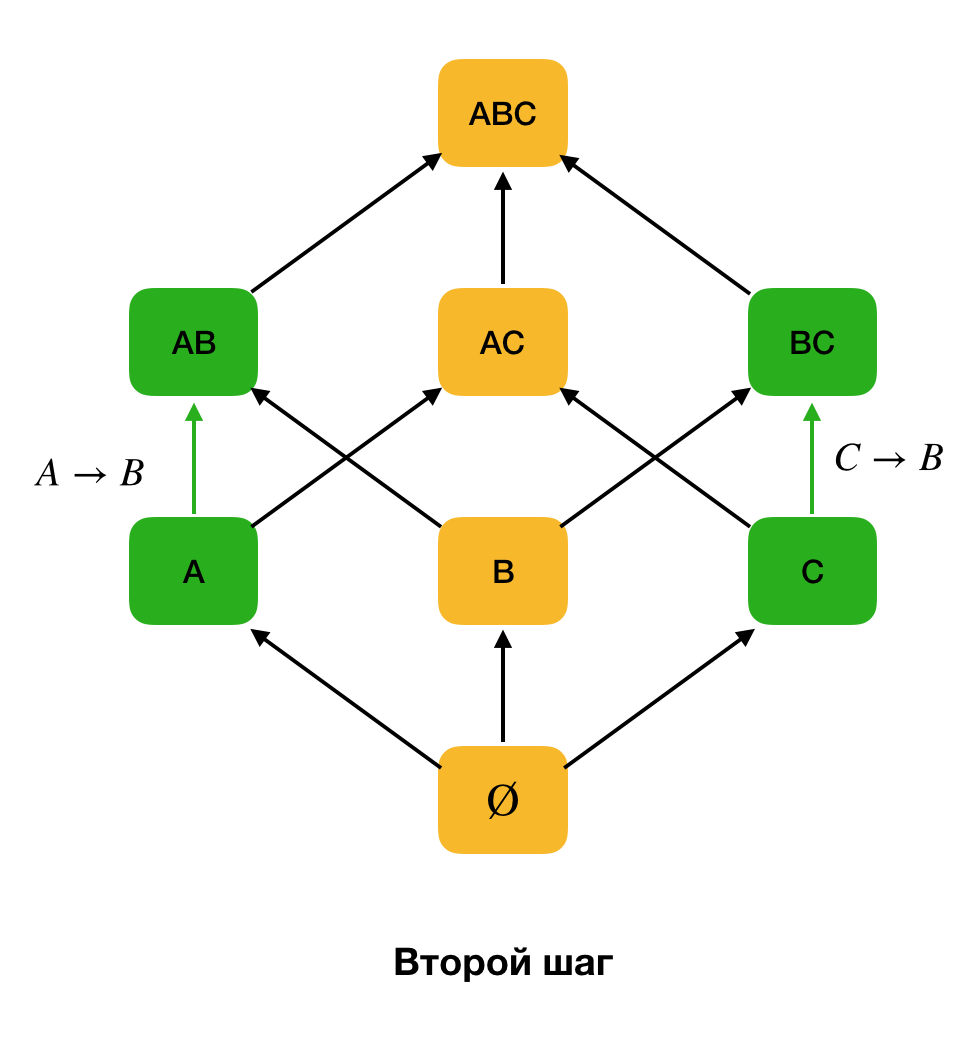
На рисунке ниже показано, как можно использовать алгебраическую решетку в задаче поиска ФЗ. Здесь каждое ребро (X, XY) представляет собой зависимость X → Y. Например, мы прошли первый уровень и знаем, что удерживается зависимость A → B (отобразим это зеленой связью между вершинами A и B). Значит далее, когда будем продвигаться по решетке вверх, мы можем не проверять зависимость A, C → B, потому что она будет уже не минимальной. Аналогично мы бы не стали ее проверять, если бы удерживалась зависимость C → B.
Кроме того, как правило, все современные алгоритмы по поиску ФЗ используют такую структуру данных, как партиция (в первоисточнике — stripped partition [1]). Формальное определение партиции выглядит следующим образом:
Определение 6. Пусть X ⊆ R — набор атрибутов для отношения r. Кластер представляет собой набор индексов кортежей из r, которые имеют одинаковое значение для X, то есть c(t) =
Простыми словами, партиция для атрибута X представляет собой набор списков, где каждый список содержит номера строк с одинаковыми значениями для X. В современной литературе структура, представляющая партиции, называется position list index (PLI). Кластеры единичной длины исключаются в целях сжатия PLI, потому что это кластеры, содержащие лишь номер записи с уникальным значением, которое всегда будет легко установить.
Рассмотрим пример. Вернемся все к той же таблице с пациентами и построим партиции для столбцов Пациент и Пол (слева появился новый столбец, в котором отмечены номера строк таблицы):
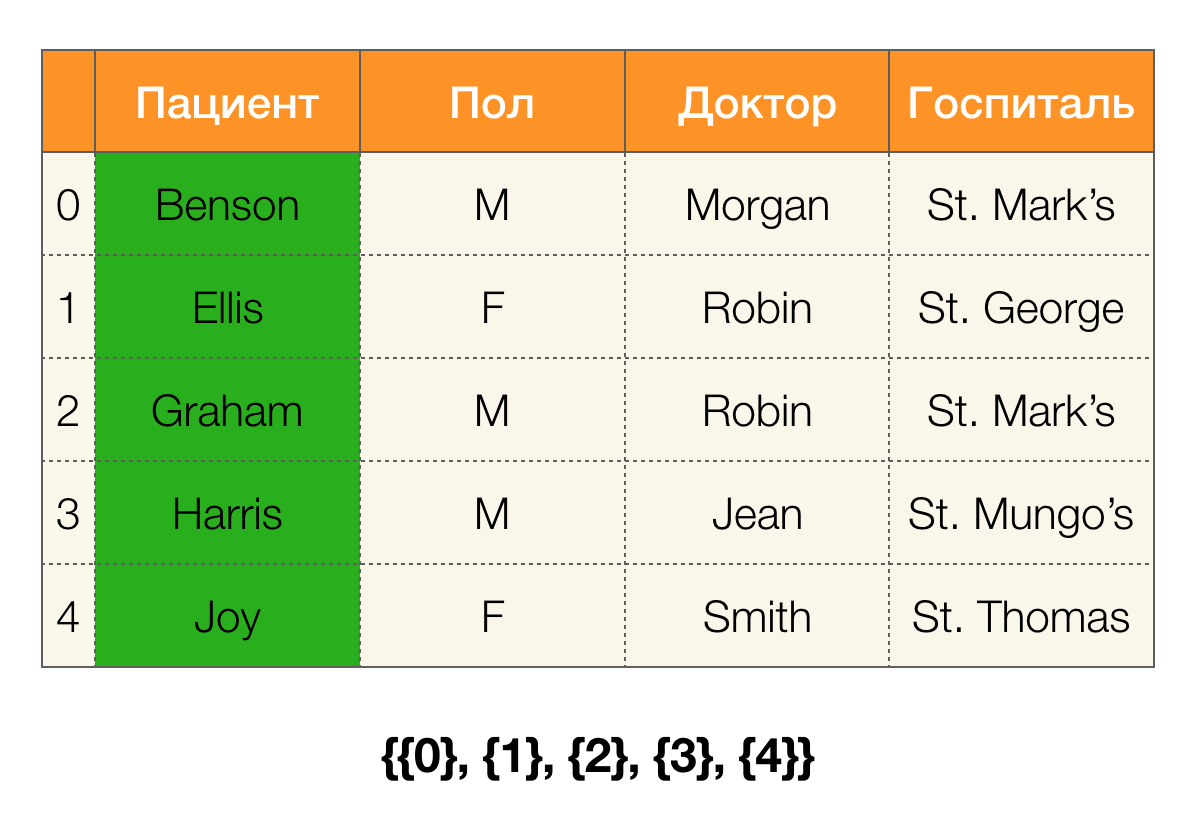
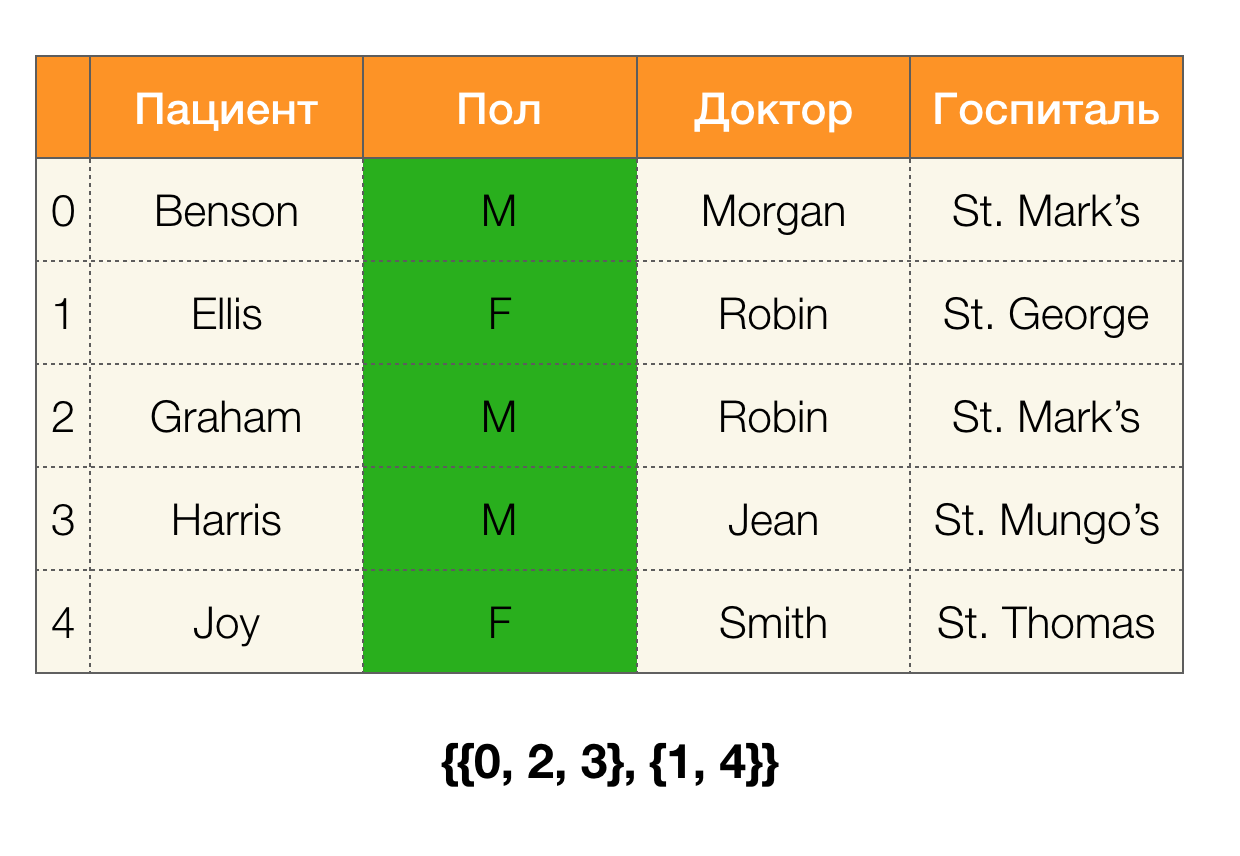
При этом, согласно определению, партиция для столбца Пациент на самом деле будет пустая, так как одиночные кластеры исключаются из партиции.
Партиции можно получать по нескольким атрибутам. И для этого существует два пути: пройдясь по таблице, построить партицию сразу по всем необходимым атрибутам, или же построить ее с помощью операции пересечения партиций по подмножеству атрибутов. Алгоритмы поиска ФЗ используют второй вариант.
Простыми словами, чтобы, например, получить партицию по столбцам ABC, можно взять партиции для AC и B (или любой другой набор непересекающихся подмножеств) и пересечь их между собой. Операция пересечения двух партиций выделяет кластеры наибольшей длины, общие для обеих партиций.
Давайте рассмотрим пример:
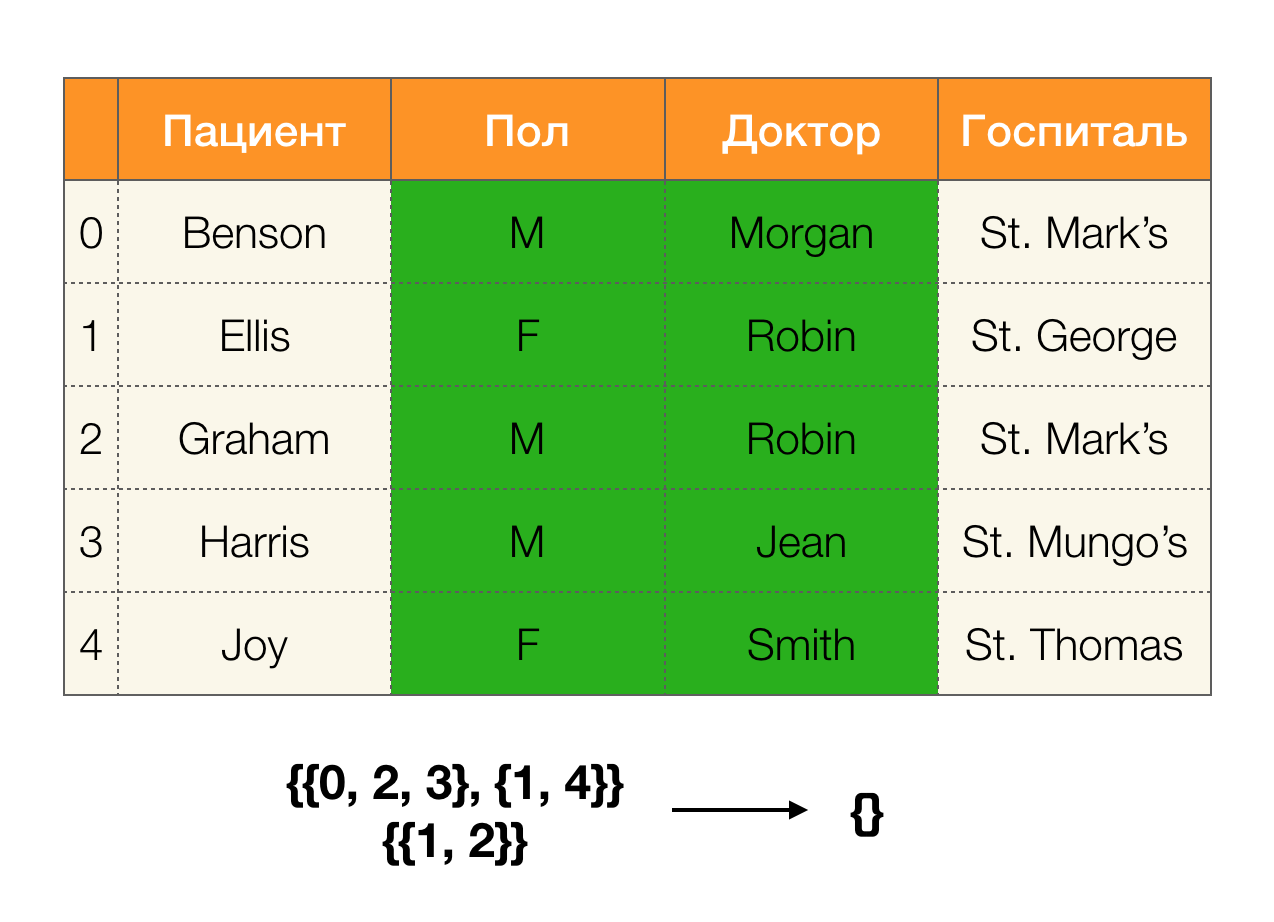
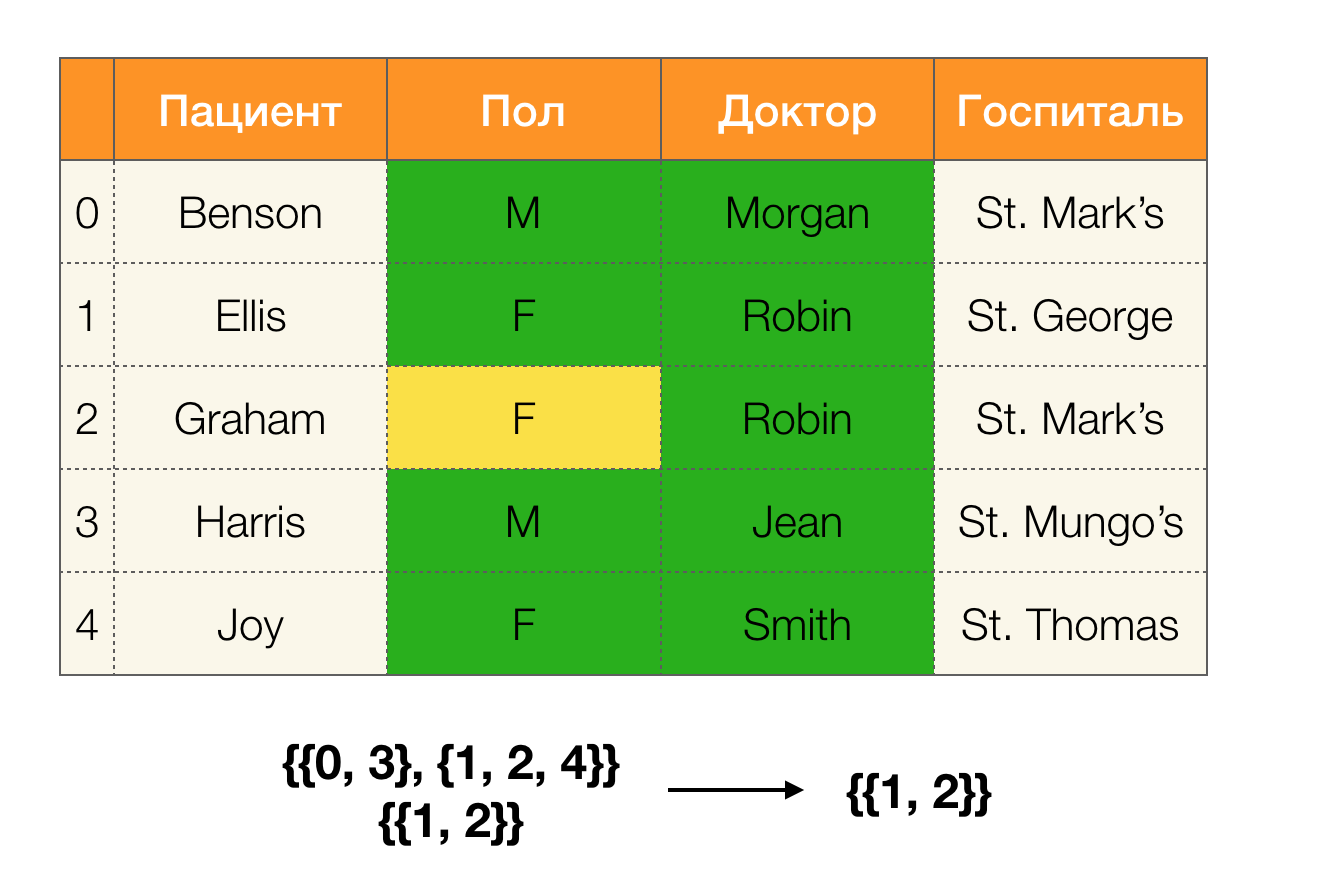
В первом случае мы получили пустую партицию. Если присмотреться к таблице, то действительно, одинаковых значений по двум атрибутам там нет. Если же мы немного модифицируем таблицу (случай справа), то уже получим непустое пересечение. При этом строки 1 и 2 и правда содержат одинаковые значения по атрибутам Пол и Доктор.
Далее нам понадобится такое понятие, как размер партиции. Формально:
Проще говоря, размер партиции представляет собой количество кластеров, входящих в партицию (помним, что единичные кластеры в партицию не входят!):
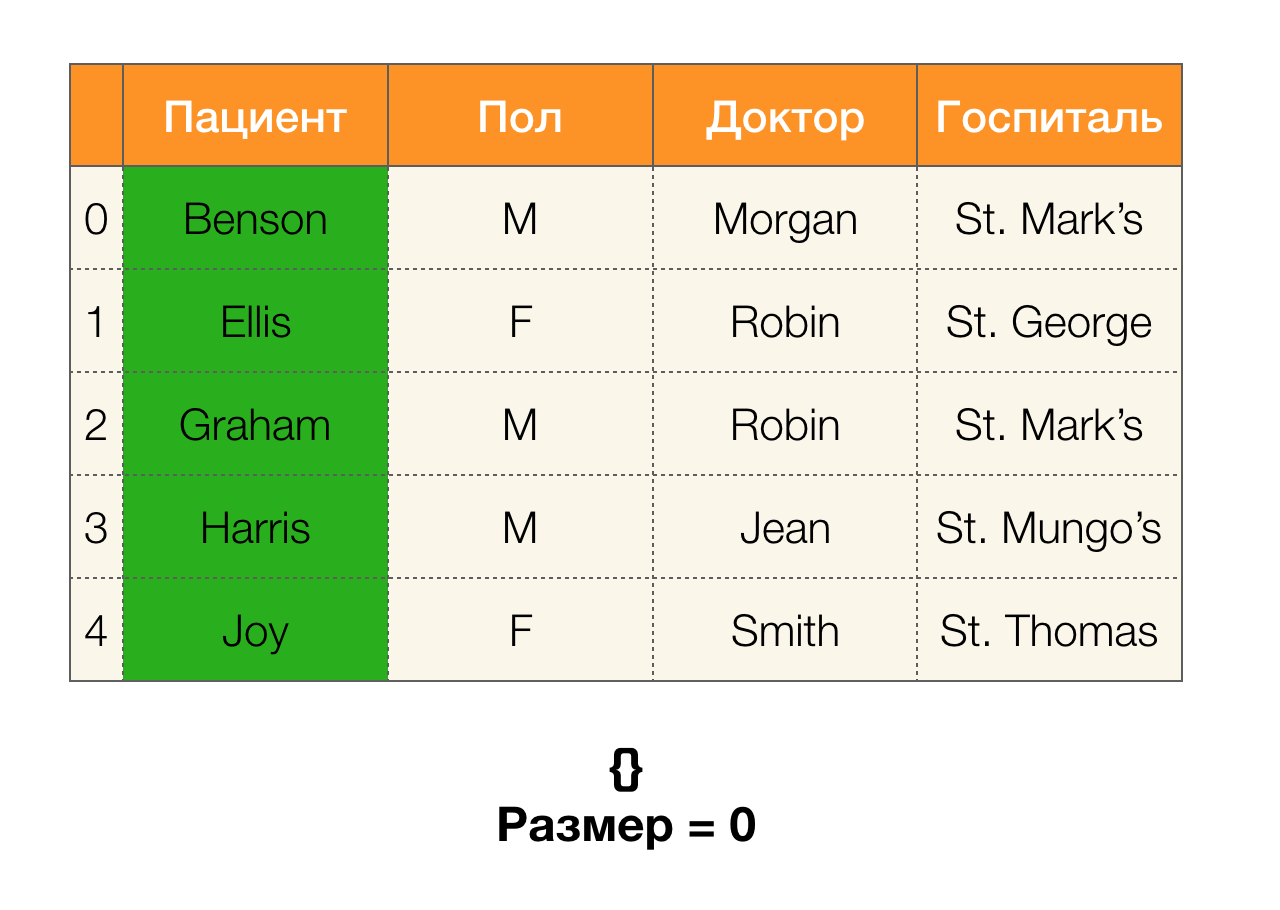
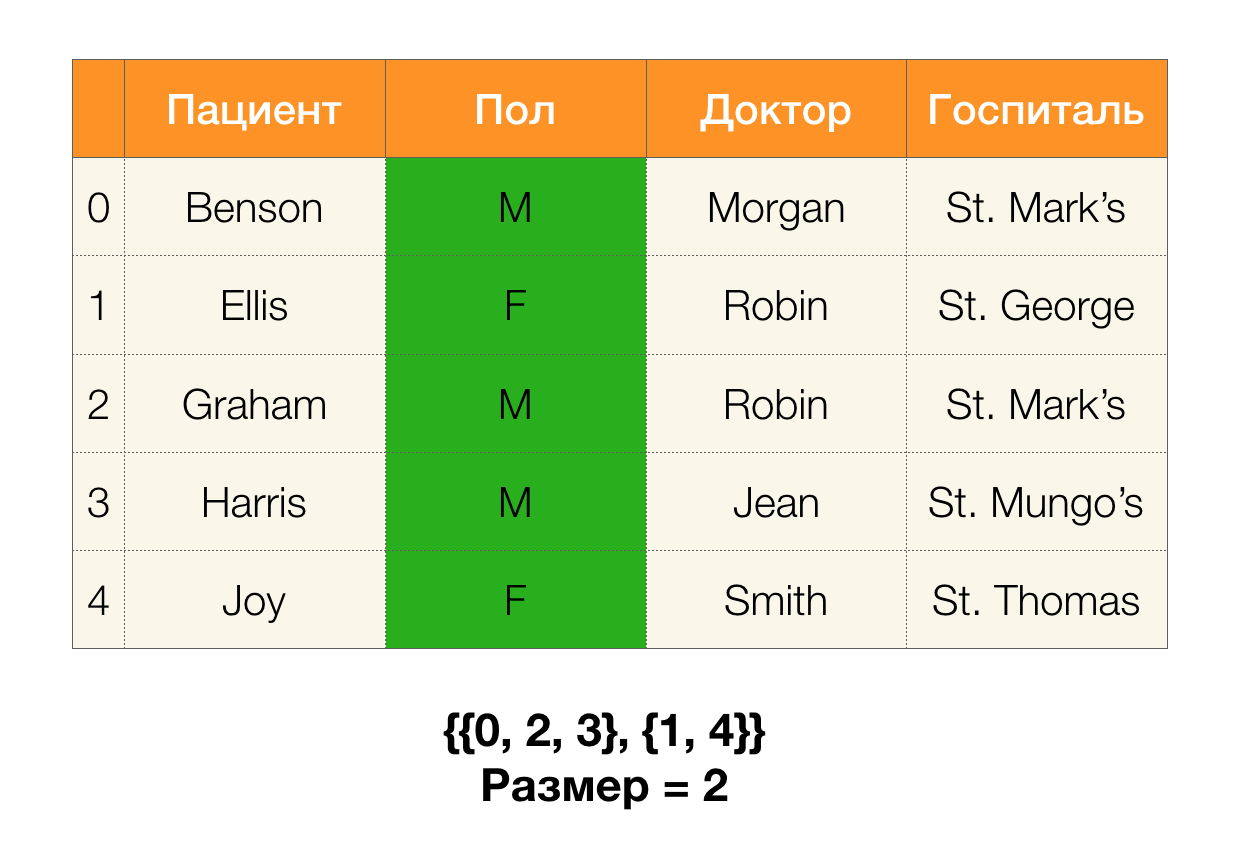
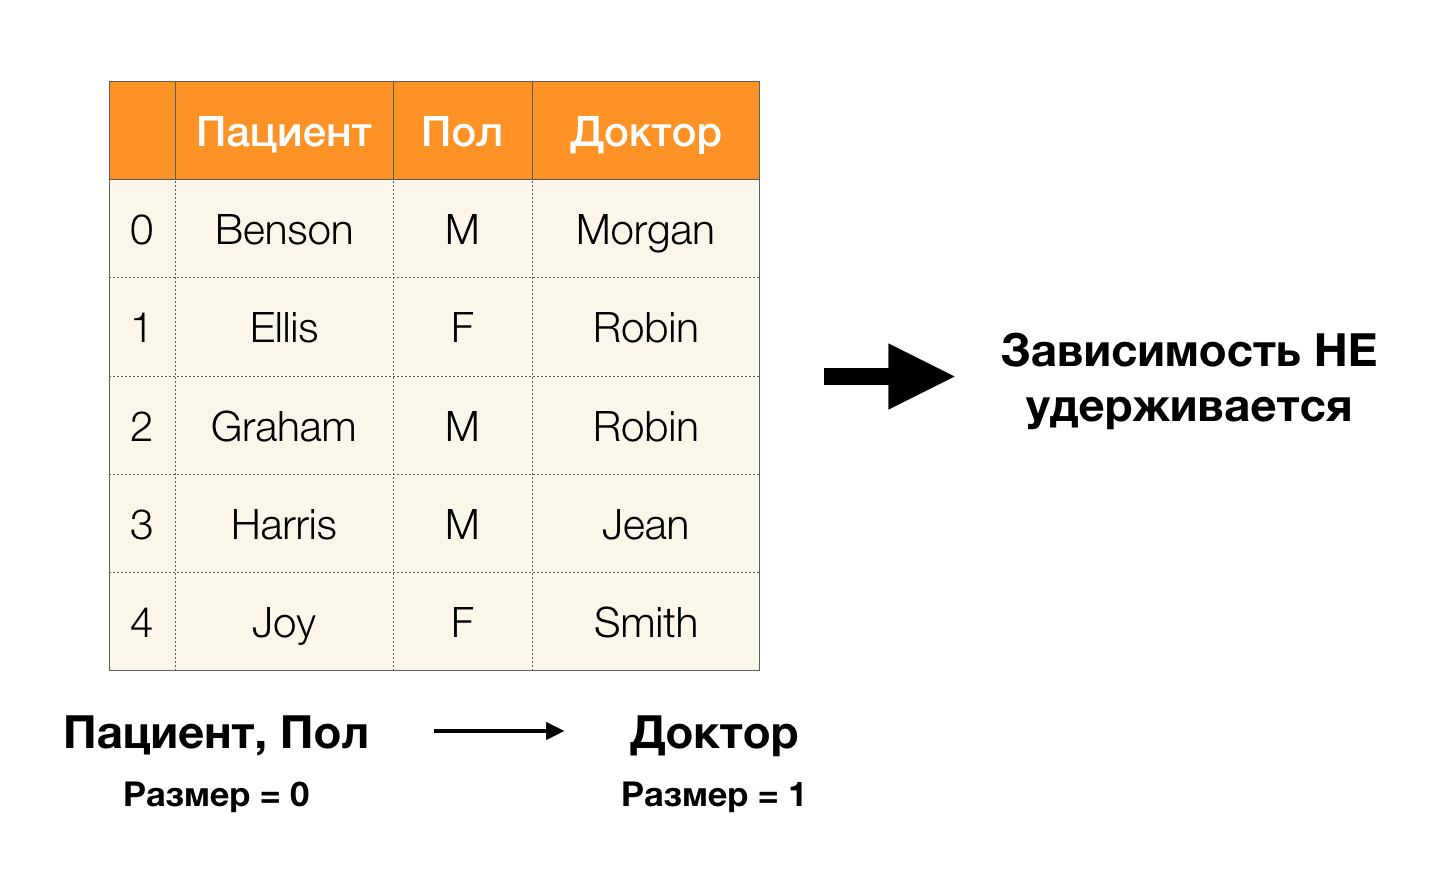
Теперь мы можем определить одну из ключевых лемм, которая для заданных партиций позволяет установить, удерживается зависимость или нет:
Лемма 1. Зависимость A, B → C удерживается, если и только если
Согласно лемме, для определения, удерживается ли зависимость, необходимо выполнить четыре шага:
- Вычислить партицию для левой части зависимости
- Вычислить партицию для правой части зависимости
- Вычислить произведение первого и второго шага
- Сравнить размеры партиций, полученных на первом и третьем шаге


В данной статье мы разобрали такие понятия, как функциональная зависимость, приближенная функциональная зависимость, рассмотрели, где они применяются, а также какие алгоритмы поиска ФЗ существуют. Также мы подробно разобрали базовые, но важные понятия, активно используемые в современных алгоритмах по поиску ФЗ.
Ссылки на литературу:
- Huhtala Y. et al. TANE: An efficient algorithm for discovering functional and approximate dependencies //The computer journal. – 1999. – Т. 42. – №. 2. – С. 100-111.
- Kruse S., Naumann F. Efficient discovery of approximate dependencies //Proceedings of the VLDB Endowment. – 2018. – Т. 11. – №. 7. – С. 759-772.
- Papenbrock T., Naumann F. A hybrid approach to functional dependency discovery //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – С. 821-833.
- Papenbrock T. et al. Functional dependency discovery: An experimental evaluation of seven algorithms //Proceedings of the VLDB Endowment. – 2015. – Т. 8. – №. 10. – С. 1082-1093.
- Kumar A. et al. To join or not to join?: Thinking twice about joins before feature selection //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – С. 19-34.
- Abo Khamis M. et al. In-database learning with sparse tensors //Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – С. 325-340.
- Hellerstein J. M. et al. The MADlib analytics library: or MAD skills, the SQL //Proceedings of the VLDB Endowment. – 2012. – Т. 5. – №. 12. – С. 1700-1711.
- Qin C., Rusu F. Speculative approximations for terascale distributed gradient descent optimization //Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – С. 1.
- Meng X. et al. Mllib: Machine learning in apache spark //The Journal of Machine Learning Research. – 2016. – Т. 17. – №. 1. – С. 1235-1241.
- jetbrains research
- data mining
- relational database
- functional dependency
- Блог компании Образовательные проекты JetBrains
- Исследования и прогнозы в IT
Функциональные зависимости
Реляционная БД содержит семантическую и структурную информацию. Структурой БД определяет число и вид включенных в нее отношений и связи типа «один-ко-многим», которые существуют между кортежами этих отношений. Семантической частью описывается множество функциональных зависимостей, которые существуют между атрибутами этих отношений.
Определение 1
Если имеются два атрибута А и В какого-либо отношения, то говорят, что В функционально зависит от А, если в каждый момент времени каждому значению А соответствует лишь одно значение В.
Функциональную зависимость (ФЗ) обозначают $А \to В$. Обратим внимание, что А и В могут быть не только единичными атрибутами, но и группами, которые составлены из нескольких атрибутов одного отношения.

Статья: Функциональные зависимости
Поможем написать реферат за 48 часов
Говорят, что функциональные зависимости являются связями типа «один-ко-многим», которые существуют внутри отношения.
С помощью функциональных зависимостей можно накладывать на реляционную схему дополнительные ограничения. Основной идеей является то, что значением одного атрибута в кортеже однозначно определяется значение другого атрибута.
К примеру, в каждом кортеже на рисунке 1 Фамилия однозначно определяется № работника; Специальность однозначно определяется № работника. Данные функциональные зависимости записывают в виде:
ФЗ: № работника $\to$ фамилия, ФЗ: № работника $\to$ специальность.
Определение 2
Функциональная зависимость значением одного атрибута в кортеже однозначно определяет значение другого атрибута в кортеже.