Изучение объектов Kubernetes
На этой странице объясняется, как объекты Kubernetes представлены в API Kubernetes, и как их можно определить в формате .yaml .
Изучение объектов Kubernetes
Объекты Kubernetes — сущности, которые хранятся в Kubernetes. Kubernetes использует их для представления состояния кластера. В частности, они описывают следующую информацию:
- Какие контейнеризированные приложения запущены (и на каких узлах).
- Доступные ресурсы для этих приложений.
- Стратегии управления приложения, которые относятся, например, к перезапуску, обновлению или отказоустойчивости.
После создания объекта Kubernetes будет следить за существованием объекта. Создавая объект, вы таким образом указываете системе Kubernetes, какой должна быть рабочая нагрузка кластера; это требуемое состояние кластера.
Для работы с объектами Kubernetes – будь то создание, изменение или удаление — нужно использовать API Kubernetes. Например, при использовании CLI-инструмента kubectl , он обращается к API Kubernetes. С помощью одной из клиентской библиотеки вы также можете использовать API Kubernetes в собственных программах.
Спецификация и статус объекта
Почти в каждом объекте Kubernetes есть два вложенных поля-объекта, которые управляют конфигурацией объекта: spec и status . При создании объекта в поле spec указывается требуемое состояние (описание характеристик, которые должны быть у объекта).
Поле status описывает текущее состояние объекта, которое создаётся и обновляется самим Kubernetes и его компонентами. Плоскость управления Kubernetes непрерывно управляет фактическим состоянием каждого объекта, чтобы оно соответствовало требуемому состоянию, которое было задано пользователем.
Например: Deployment — это объект Kubernetes, представляющий работающее приложение в кластере. При создании объекта Deployment вы можете указать в его поле spec , что хотите иметь три реплики приложения. Система Kubernetes получит спецификацию объекта Deployment и запустит три экземпляра приложения, таким образом обновит статус (состояние) объекта, чтобы он соответствовал заданной спецификации. В случае сбоя одного из экземпляров (это влечет за собой изменение состояние), Kubernetes обнаружит несоответствие между спецификацией и статусом и исправит его, т.е. активирует новый экземпляр вместо того, который вышел из строя.
Для получения дополнительной информации о спецификации объекта, статусе и метаданных смотрите документ с соглашениями API Kubernetes.
Описание объекта Kubernetes
При создании объекта в Kubernetes нужно передать спецификацию объекта, которая содержит требуемое состояние, а также основную информацию об объекте (например, его имя). Когда вы используете API Kubernetes для создания объекта (напрямую либо через kubectl ), соответствующий API-запрос должен включать в теле запроса всю указанную информацию в JSON-формате. В большинстве случаев вы будете передавать kubectl эти данные, записанные в файле .yaml. Тогда инструмент kubectl преобразует их в формат JSON при выполнении запроса к API.
Ниже представлен пример .yaml -файла, в котором заданы обязательные поля и спецификация объекта, необходимая для объекта Deployment в Kubernetes:
apiVersion: apps/v1 kind: Deployment metadata: name: nginx-deployment spec: selector: matchLabels: app: nginx replicas: 2 # tells deployment to run 2 pods matching the template template: metadata: labels: app: nginx spec: containers: - name: nginx image: nginx:1.14.2 ports: - containerPort: 80 Один из способов создания объекта Deployment с помощью файла .yaml , показанного выше — использовать команду kubectl apply , которая принимает в качестве аргумента файл в формате .yaml . Например:
kubectl apply -f https://k8s.io/examples/application/deployment.yaml --record Вывод будет примерно таким:
deployment.apps/nginx-deployment created Обязательные поля
В файле .yaml создаваемого объекта Kubernetes необходимо указать значения для следующих полей:
- apiVersion — используемая для создания объекта версия API Kubernetes
- kind — тип создаваемого объекта
- metadata — данные, позволяющие идентифицировать объект ( name , UID и необязательное поле namespace )
- spec — требуемое состояние объекта
Конкретный формат поля-объекта spec зависит от типа объекта Kubernetes и содержит вложенные поля, предназначенные только для используемого объекта. В справочнике API Kubernetes можно найти формат спецификации любого объекта Kubernetes. Например, формат spec для объекта Pod находится в ядре PodSpec v1, а формат spec для Deployment — в DeploymentSpec v1 apps.
Что дальше
- Обзор API Kubernetes более подробно объясняет некоторые из API-концепций
- Познакомиться с наиболее важными и основными объектами в Kubernetes, например, с подами.
- Узнать подробнее про контролеры в Kubernetes
Обратная связь
Эта страница была полезна?
Спасибо за обратную связь! Если у вас есть конкретный вопрос об использовании Kubernetes, спросите на Stack Overflow. Создайте issue в репозитории GitHub, если вы хотите сообщить о проблеме или предложить улучшение.
Отличия DeploymentConfig от Deployment и примеры использования
Объекты DeploymentConfig накапливаются до определённого количества (типа retention-history limit) или сразу удаляются по завершению работы его pod-а ? В любом случае если возможно указать экземпляр DeploymentConfig в OwnerReferences ReplicaSet-а его pod-a, этот pod будет удалён автоматически с удалением экземпляра DeploymentConfig
This comment wasn’t rated yet 0
Reply Add to bookmarks More
Show previous comment
Они обновляются кмк, но автор ответит лучше.
при удалении реплика сет просто поднимет новый — деплоймент конфиг те же яйца только в профиль от редхата.
контроллеры — постоянная величина, она просто есть 🙂 никто никуда ничего не удаляет после завершения работы пода
This comment wasn’t rated yet 0
Reply Add to bookmarks More
Show previous comment
самое забавное — что ReplicationController, это старая версия ReplicaSet, о котором умлочали в «статье»
Total votes 1: ↑1 and ↓0 +1
Reply Add to bookmarks More
Show previous comment
Здесь я перепутал — ReplicaSet создаётся Deployment-ом, а вот конфигурация деплоймента самого компонента DeploymentConfig запускает создание ReplicationController-а (и его pod-a).
This comment wasn’t rated yet 0
Reply Add to bookmarks More
Show previous comment
DPC-RS ок, конфигурация компонента ? вы имеете в виду количество реплик?
This comment wasn’t rated yet 0
Reply Add to bookmarks More
Show previous comment
Я имел ввиду конфигурацию развёртываемого компонента, описанного в DeploymentConfig. Впервые о деталях OpenShift деплоймента читаю, так что путаюсь.
This comment wasn’t rated yet 0
Reply Add to bookmarks More
Show previous comment
это автор запутал, DPC — объект OCP, тут нет никакого рокет-сайнс, Редхат просто создал такое вот в API своей системы, если посмотреть на прмеры, оно прям простое.
Total votes 1: ↑1 and ↓0 +1
Reply Add to bookmarks More
Show previous comment
коллеги, какой ReplicationController я не понимаю — это старая сущность, автор вещал о ОКД4+, в свежем кубере нет этого
This comment wasn’t rated yet 0
Reply Add to bookmarks More
А зачем вы отдали билд на OCP?
почему не отдать его на Jenkins/GCI/Bamboo/etc ?
почему отказались от helm?
imagestreams — imho плохо, зачем тегировать, и отдавать на контейнерную платформу, какой OCP и является, такую важную часть процесса, как сборка и обновление?
как вы смотрите и дебажите билды? что у вас с IAC — в плане сборки?
This comment wasn’t rated yet 0
Reply Add to bookmarks More
«— это та же штука, что и деплоймент,» — это не так — вы сами описываете различия в этих сущностях.
Далее — я бы для первой статьи о «особенностях» рассмотрел скорее темплейты OCP, чем сравнение «родной» сущности и кастомной.
«Я бы назвал это некой заменой инструмента CI/CD, упрощающей жизнь разработчику» — сложно с Вами согласиться. Разработчик должен получать доступ до пайпалайна, как понимать как он работает. Главная особенность OCP — доступ до терминала, логов, мониторинга, да и в принципе через GUI решение OCP.
Вносить изменения вместе с командой DevOps — а так же, иметь гибкие настройки пайплайна, втч и обращение к секретам, которые не лежат в b64 etcd — вы же банкинг. =).
А было бы здорово, например использовать Vault? Вы рассматривали интеграцию с волтом при такой сборке?
Как можно таким прямым инструментом заменить тот же jenkins/gitlab-ci? вопрос в теорию, конечно.
«реквестов/лимитов ресурсов для POD’ов» — если Вы пишете о лимитах, то добавьте еще квоты и для самих контейнеров, они так же присутствуют в OCP и чаще более важны, чем то, о чем вы пишите. Вы же наверняка используете пре-стартеры/сопутствующие и сайдкары?
Так же — для знакомства коллег с OCP — приложили бы пример с лимитами к NS, раз у нас тут ямлы.
oc delete pod —field-selector=status.phase==Succeeded -> вы используете это на продуктиве? Тут все же странно, есть прекрасный хелм, о котором я писал выше.
«из maxSurge;» — стоит добавить, что это необязательное значение. Многие компании работают на OKD3, не совсем актуально. Хотя сущности, которые Вы описали — есть в обоих версиях. Тут могу ошибаться.
«Поддержка prehook и posthook» — про HPA расскажите пожалуйста, и кастомные метрики, информация которую Вы взяли из базы знаний редхат не так интересна, ее, я думаю все читали.
Еще несколько вопросов, если у Вас будет время ответить:
- «Build клонирует git-репозиторий от ветки main» — мы работаем только по мастеру? Какой это юзкейс для команд? Вы автобилдите что-то? А кастомные ветки? Прошу пояснить.
- «репозиторий битбакета или гитхаба» — других систем хранения кода нет/не поддерживается?
- «пушит собранный образ в репозиторий кластера»
Как вы пушите в репозиторий кластера и за ним следите? GC? правила версионирования? Это реджестри внутри OCP? Какие правила для обновления для этого необходимы? По каким правилам вы пушите — latest? Или 7ver? Или что вы используете и как тегируете? Как происходит тегирование образа? по ветке/хеш комиту? — тут то и интересно, а не копипаст.
- «создаётся новый deployer POD с суффиксом -deploy, который контролирует процесс развёртывания»;
или вы имеете ввиду — что создается дефолтный под с суффиксом деплой при разворачивании компонента? тогда зачем об этом писать?
- «создаётся ещё один ReplicationController, который создаёт новый экземпляр POD с нашим приложением»»
т.е создается именно новый контроллер? зачем? объясните пожалуйста
- после успешного старта контейнера внутри нового POD’а deployer POD завершает работу и переходит в состояние Completed;
как это работает? Readiness проба отработала? Как вы аккумулируете логи? и анализируете ли их?
И самое главное — как вы интегрируете такую сборку с QG?
Отличия DeploymentConfig от Deployment и примеры использования
Разницу между объектами DeploymentConfig и Deployment в OpenShift для коллег я объяснял с помощью упрощения:
«Да, короче, деплойментконфиг — это та же штука, что и деплоймент, только поделка от Редхата».
Да-да, мне было лень вдаваться в подробности. Но теперь я хочу попробовать раскрыть более подробно, а заодно поделиться информацией с другими. Сухой оригинал можно найти тут (по версии 4.8, на которой и буду основывать текст статьи).
Дополнительные объекты ImageStream и BuildConfig
DeploymentConfig — это объект, чуть усовершенствованный по сравнению с Deployment. Он использует триггеры и дополнительные объекты, такие как ImageStream и BuildConfig.
ImageStream — это объект, который хранит в себе sha-хеш образов во внутреннем реджистри OpenShift и позволяет задать произвольный тег, независимо от того, что определено в реджистри. Стоит понимать, что это ещё один уровень абстракций Kubernetes, а самих образов в ImageStream нет. Теги ссылаются либо на другой ImageStream, либо на Dockerimage. Помимо этого, с его помощью можно закешировать образ во внутреннем реджистри и не тянуть каждый раз снаружи.
Создадим такой объект:
apiVersion: image.openshift.io/v1 kind: ImageStream metadata: name: deploymentconfig-demo namespace: test-projectBuildConfig — это объект, который, по сути, является сценарием сборки образа. У него может быть много источников исходного кода (git, dockerfile и другие), стратегия сборки (Docker, S2I и другие). И назначение сборки — Dockerimage или ImageStreamTag.
Пример ниже для стратегии Docker:
apiVersion: build.openshift.io/v1 kind: BuildConfig metadata: name: deploymentconfig-demo namespace: test-project spec: source: git: ref: main uri: 'https://github.com/kruchkov-alexandr/deploymentconfig-demo.git' type: Git strategy: type: Docker dockerStrategy: pullSecret: name: mysecret triggers: - type: ConfigChange output: to: kind: ImageStreamTag name: 'deploymentconfig-demo:latest'Как примерно это работает:
- триггером для запуска build является изменение конфигурации BuildConfig;
- после создания этого объекта BuildConfig мы увидим, что он запустил объект build, в котором и происходит сборка;
- build подключается к git-репозиторию, выполняется клонирование из ветки main;
- по стратегии Docker читается содержимое файла Dockerfile (дефолтный путь в корне репозитория, но можно указать и другой путь);
- для скачивания образа из директивы FROM используется логин и пароль из заранее созданного секрета с именем mysecret (в примере просто мой логин и пароль от гитхаба);
- полученный образ пушится во внутренний репозиторий кластера OpenShift;
- после сборки проставляется тег ImageStreamTag в контейнере ImageStream.
Есть масса триггеров и хуков, о них можно почитать тут. Можно хоть по коммиту в битбакете или гитхабе триггерить билд в OpenShift.
Далее для демонстрации триггера мы создадим новый объект DeploymentConfig:
apiVersion: apps.openshift.io/v1 kind: DeploymentConfig metadata: name: deploymentconfig-demo namespace: test-project spec: selector: app: deploymentconfig-demo replicas: 1 template: metadata: labels: app: deploymentconfig-demo spec: containers: - name: deploymentconfig-demo env: - name: APP_COLOR value : blue image: image-registry.openshift-image-registry.svc:5000/test-project/deploymentconfig-demo:latest ports: - containerPort: 8080 triggers: - type: ConfigChange - imageChangeParams: automatic: true containerNames: - deploymentconfig-demo from: kind: ImageStreamTag name: deploymentconfig-demo:latest type: ImageChange Тут мы видим новый блок с триггерами, в котором происходит проверка на ImageStreamTag.
Как это работает в связке, если не брать в расчёт service + route:
- в OpenShift создаём объекты ImageStream, BuildConfig и DeploymentConfig;
- после создания DeplymentConfig автоматически будет создан объект ReplicationController, который создаст нужное количество экземпляров POD, в нашем случае 1 экземпляр;
- разработчик получил готовый и работающий сервис в OpenShif;
- далее разработчик отправляет новый коммит в git-репозитории;
- репозиторий битбакета/гитхаба запускает вебхук (я его не рассматривал в статье), запуская Build от BuildConfig, или разработчик вручную запускает Build от BuildConfig в OpenShift (как в моём примере);
- Build клонирует git-репозиторий от ветки main, берёт Dockerfile и запускает сборку, подставляя логин и пароль от заранее созданного секрета mysecret для образа из FROM, пушит собранный образ в репозиторий кластера и добавляет/обновляет тег ImageStreamtag в ImageStream;
- при изменении тега в ImageStream происходит триггер запуска DeploymentConfig;
- создаётся новый deployer POD с суффиксом -deploy, который контролирует процесс развёртывания;
- создаётся ещё один ReplicationController, который создаёт новый экземпляр POD с нашим приложением;
- после успешного старта контейнера внутри нового POD’а deployer POD завершает работу и переходит в состояние Completed;
- предыдущий ReplicationController гасит предыдущий POD;
- разработчик снова получил готовый и работающий сервис в OpenShift с пересобранным образом.
Я бы назвал это некой заменой инструмента CI/CD, упрощающей жизнь разработчику в публикации приложения. То есть разработчику не обязательно настраивать CI/CD процессы и утилиты, привлекать отдельного инженера девопса. Он может быстро опубликовать приложение в OpenShift с минимальными ресурсами и затраченным временем. Настроил git, включил хуки, задеплоил DeploymentConfig, коммитнул в репозиторий, приложение развернулось в OpenShift.
Надо также понимать, что если в вашем неймспейсе кластера есть дефолтные значения реквестов/лимитов ресурсов для POD’ов (объект LimitRange) и это значение, например, 100m для CPU limits, то для deployer POD необходимо 100m CPU. То есть если вы одновременно запустили редеплой 10 DeploymentConfig, то будет поднято 10 deployer POD, которые суммарно возьмут из квоты (объект ResourceQuota) 1000m CPU и будут их держать ещё в течение до 5 секунд после перехода в состояние Completed. В условиях ограничения ресурсов могут возникнуть сложности в одновременном деплое из-за нехватки ресурсов.
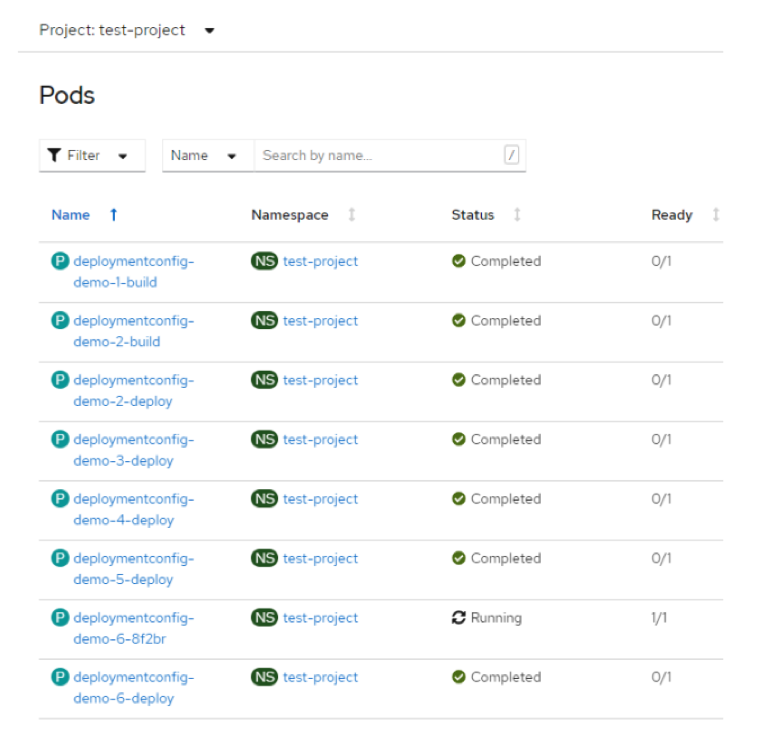
Стоит также упомянуть про небольшой баг особенность, которая идёт от версии к версии. Все деплойер POD’ы переходят в состояние Completed и не подчищаются за собой.
- Можно использовать revisionHistoryLimit:1, и тогда будет по 1 Completed деплойер POD’у на каждый из DeploymentConfig.
- Либо можно поставить «костыль» в скрипты/скедулер, нечто типа:
oc delete pod --field-selector=status.phase==SucceededИначе у вас картина в кластере будет выглядеть следующим образом:
Применение DeploymentConfig не обязывает вас использовать ImageStream и BuildConfig.
Контроллеры ReplicaSet и ReplicationController
Вторая разница — это использование различных контроллеров:
- у Deployment — ReplicaSet;
- у DeploymentConfig — ReplicationController.
Replication Controller и RepliicaSet — это объекты API Kubernetes, которые следят, чтобы указанное количество экземпляров подов было запущено в неймспейсе (проекте) в любое время. Если один или несколько POD’ов завершаются с ошибкой, то контроллер создаст и запустит новый экземпляр, чтобы количество подов всегда соответствовало желаемому.
ReplicaSet является усовершенствованной версией ReplicationController и поддерживает множественный селектор.
Пример различия контроллеров ниже. Обратите внимание на spec.selector.
apiVersion: v1 kind: ReplicationController metadata: name: example namespace: test-project spec: replicas: 2 selector: app: hello-openshift template: metadata: name: hello-openshift labels: app: hello-openshift spec: containers: - name: hello-openshift image: openshift/hello-openshift ports: - containerPort: 8080apiVersion: apps/v1 kind: ReplicaSet metadata: name: example namespace: test-project spec: replicas: 2 selector: matchExpressions: - template: metadata: name: hello-openshift labels: app: hello-openshift spec: containers: - name: hello-openshift image: openshift/hello-openshift ports: - containerPort: 8080Напрямую создавать объекты ReplicaSet или ReplicationController не нужно. Необходимо использовать создание высокоуровневого объекта Deployment или DeploymentConfig соответственно. Говоря простым языком, нужно создавать объект DeploymentConfig, который автоматически создаст объект ReplicationController, который, в свою очередь, создаст необходимое количество экземпляров POD’ов и будет следить за их количеством.
Автооткат в случае неудачи деплоя
У DeploymentConfig есть возможность автоматического отката в случае неудачного деплоя. Deployer POD сам контролирует процесс деплоя и в случае неудачи автоматически удалит новую версию, откатив на успешную последнюю.
Поддержка кастомных стратегий развёртывания
DeploymentConfig поддерживает кастомные стратегии развёртывания, кроме стандартных Recreate и дефолтной RollingUpdate.
Например, OpenShift позволяет определить отдельный контейнер, который отвечает за весь процесс сборки или деплоя.
strategy: type: Custom customParams: image: docker.io/imagestrategy:latest command: [ "command", "arg1" ]Дополнительные примеры можно посмотреть тут.
Поддержка prehook и posthook
DeploymentConfig поддерживает pre-hook и post-hook для стратегии развёртывания.
Пример, как это можно использовать для стратегии Rolling:
. spec: . strategy: type: Rolling rollingParams: updatePeriodSeconds: 1 intervalSeconds: 1 timeoutSeconds: 120 maxSurge: "20%" maxUnavailable: "10%" pre: <> post: <> . Как это работает:
- запускается pre-hook;
- количество экземпляров POD’а скалируется вверх для нового ReplicationController исходя из maxSurge;
- количество экземпляров POD’а скалируется вниз для предыдущего ReplicationController исходя из maxUnavailable;
- повторяется масштабирование во время деплоя до тех пор, пока новый ReplicationController не наберёт нужного количества экземпляров POD’а, а старый ReplicationController не станет равным 0;
- запускается post-hook.
Заключение
Надеюсь, ничего важного не упустил и информация была полезной. Я хоть немного раскрыл разницу между этими двумя объектами в кластере OpenShift. В зависимости от процесса разработки вы можете использовать то, что подходит больше всего.
- openshift
- deployment
- DeploymentConfig
- devops
- системное программирование
- pod
- Иннотех corporate blog
- System Programming
- Server Administration
- DevOps
- Openshift
Управление ресурсами
Итак, вы развернули приложение и настроили доступ к нему с помощью сервиса. Что дальше? Kubernetes предоставляет ряд инструментов, помогающих управлять развертыванием приложений, включая их масштабирование и обновление. Среди особенностей, которые мы обсудим более подробно, — конфигурационные файлы и лейблы.
Организация конфигураций ресурсов
Многие приложения требуют создания нескольких ресурсов типа Deployment и Service. Управление ими можно упростить, сгруппировав в один YAML-файл (со строкой «—» в качестве разделителя). Например:
apiVersion: v1 kind: Service metadata: name: my-nginx-svc labels: app: nginx spec: type: LoadBalancer ports: - port: 80 selector: app: nginx --- apiVersion: apps/v1 kind: Deployment metadata: name: my-nginx labels: app: nginx spec: replicas: 3 selector: matchLabels: app: nginx template: metadata: labels: app: nginx spec: containers: - name: nginx image: nginx:1.14.2 ports: - containerPort: 80 Можно создавать сразу несколько ресурсов:
kubectl apply -f https://k8s.io/examples/application/nginx-app.yaml service/my-nginx-svc created deployment.apps/my-nginx created Ресурсы будут создаваться в порядке, в котором они описаны в файле. Таким образом, первым лучше всего описать сервис — это позволит планировщику распределять Pod’ы этого сервиса по мере их создания контроллером (контроллерами), например, Deployment’ом.
kubectl apply также может принимать сразу несколько аргументов -f :
kubectl apply -f https://k8s.io/examples/application/nginx/nginx-svc.yaml -f https://k8s.io/examples/application/nginx/nginx-deployment.yaml Кроме того, можно указывать директории вместо отдельных файлов или в дополнение ним:
kubectl apply -f https://k8s.io/examples/application/nginx/ kubectl прочитает все файлы с расширениями .yaml , .yml или .json .
Рекомендуется размещать ресурсы, имеющие отношение к одному микросервису или уровню приложения, в одном файле, а также группировать все файлы, связанные с приложением, в одной директории. Если уровни вашего приложения связываются друг с другом через DNS, можно развернуть все компоненты стека совместно.
Также в качестве источника конфигурации можно указать URL — это удобно при создании/настройке с использованием конфигурационных файлов, размещенных на GitHub:
kubectl apply -f https://raw.githubusercontent.com/kubernetes/website/main/content/en/examples/application/nginx/nginx-deployment.yaml deployment.apps/my-nginx created Пакетные операции в kubectl
Создание ресурсов — не единственная операция, которую kubectl может выполнять в рамках одной команды. Этот инструмент также способен извлекать имена ресурсов из конфигурационных файлов для выполнения других операций, в частности, для удаления созданных ресурсов:
kubectl delete -f https://k8s.io/examples/application/nginx-app.yaml deployment.apps "my-nginx" deleted service "my-nginx-svc" deleted В случае двух ресурсов их можно перечислить в командной строке, используя синтаксис вида resource/name:
kubectl delete deployments/my-nginx services/my-nginx-svc При большем количестве ресурсов удобнее указать селектор (запрос по лейблу) с помощью -l или —selector , который отфильтрует ресурсы по их лейблам:
kubectl delete deployment,services -l app=nginx deployment.apps "my-nginx" deleted service "my-nginx-svc" deleted Поскольку kubectl выводит имена ресурсов в том же синтаксисе, что и получает, можно выстраивать цепочки операций с помощью $() или xargs :
kubectl get $(kubectl create -f docs/concepts/cluster-administration/nginx/ -o name | grep service) kubectl create -f docs/concepts/cluster-administration/nginx/ -o name | grep service | xargs -i kubectl get <> NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE my-nginx-svc LoadBalancer 10.0.0.208 80/TCP 0s Приведенные выше команды сначала создают ресурсы в разделе examples/application/nginx/ , выводят о них информацию в формате -o name (то есть в виде пары resource/name). Затем в результатах производится поиск по «service» ( grep ), и информация о найденных ресурсах выводится с помощью kubectl get .
Если ресурсы хранятся в нескольких поддиректориях в пределах одной директории, можно рекурсивно выполнять операции и в этих поддиректориях, указав —recursive или -R наряду с флагом —filename , -f .
Предположим, что существует директория project/k8s/development , в которой хранятся все манифесты, необходимые для dev-окружения, организованные по типу ресурсов:
project/k8s/development ├── configmap │ └── my-configmap.yaml ├── deployment │ └── my-deployment.yaml └── pvc └── my-pvc.yaml По умолчанию при выполнении массовых операций над project/k8s/development команда остановится на первом уровне, не обрабатывая поддиректории. К примеру, попытка создать ресурсы, описанные в этой директории, приведет к ошибке:
kubectl apply -f project/k8s/development error: you must provide one or more resources by argument or filename (.json|.yaml|.yml|stdin) Вместо этого следует указать флаг —recursive или -R с флагом —filename , -f :
kubectl apply -f project/k8s/development --recursive configmap/my-config created deployment.apps/my-deployment created persistentvolumeclaim/my-pvc created Флаг —recursive работает с любыми операциями, принимающими флаг —filename , -f , например: kubectl и т.д.
Флаг —recursive также работает для нескольких аргументов -f :
kubectl apply -f project/k8s/namespaces -f project/k8s/development --recursive namespace/development created namespace/staging created configmap/my-config created deployment.apps/my-deployment created persistentvolumeclaim/my-pvc created В разделе Инструмент командной строки kubectl доступна дополнительная информация о kubectl .
Эффективное использование лейблов
Во всех примерах, рассмотренных до этого момента, к ресурсам прикреплялся лишь один лейбл. Однако существуют сценарии, когда необходимо использовать несколько лейблов, чтобы отличить наборы ресурсов друг от друга.
Например, разные приложения могут использовать разные значения для лейбла app , а в случае многоуровневого приложения вроде гостевой книги лейблы могут указывать на соответствующий уровень. Например, у фронтенда могут быть следующие лейблы:
labels: app: guestbook tier: frontend в то время как у master’а и slave’а Redis будут лейблы tier и, возможно, даже дополнительный лейбл role :
labels: app: guestbook tier: backend role: master labels: app: guestbook tier: backend role: slave Лейблы позволяют группировать ресурсы по любому параметру с соответствующим лейблом:
kubectl apply -f examples/guestbook/all-in-one/guestbook-all-in-one.yaml kubectl get pods -Lapp -Ltier -Lrole NAME READY STATUS RESTARTS AGE APP TIER ROLE guestbook-fe-4nlpb 1/1 Running 0 1m guestbook frontend guestbook-fe-ght6d 1/1 Running 0 1m guestbook frontend guestbook-fe-jpy62 1/1 Running 0 1m guestbook frontend guestbook-redis-master-5pg3b 1/1 Running 0 1m guestbook backend master guestbook-redis-slave-2q2yf 1/1 Running 0 1m guestbook backend slave guestbook-redis-slave-qgazl 1/1 Running 0 1m guestbook backend slave my-nginx-divi2 1/1 Running 0 29m nginx my-nginx-o0ef1 1/1 Running 0 29m nginx kubectl get pods -lapp=guestbook,role=slave NAME READY STATUS RESTARTS AGE guestbook-redis-slave-2q2yf 1/1 Running 0 3m guestbook-redis-slave-qgazl 1/1 Running 0 3m Канареечные развертывания
Еще один сценарий, в котором применение нескольких лейблов как нельзя кстати, — дифференциация развертываний отдельных релизов или конфигураций одного и того же компонента. Как правило, новая версия приложения (указанная с помощью тега образа в шаблоне Pod’а) запускается в так называемом канареечном (canary) развертывании параллельно с предыдущей версией. Далее на нее направляется часть реального production-трафика.
В примере ниже лейбл track помогает различить релизы.
У основного, стабильного релиза он будет иметь значение stable :
name: frontend replicas: 3 . labels: app: guestbook tier: frontend track: stable . image: gb-frontend:v3 У нового релиза фронтенда гостевой книги значение этого лейбла будет другим ( canary ), чтобы два набора Pod’ов не пересекались:
name: frontend-canary replicas: 1 . labels: app: guestbook tier: frontend track: canary . image: gb-frontend:v4 Чтобы охватить оба набора реплик, сервис фронтенда следует настроить на выбор общего подмножества их лейблов (т.е. опустить лейбл track ). В результате трафик будет поступать на обе версии приложения:
selector: app: guestbook tier: frontend При этом число стабильных и канареечных реплик можно менять, регулируя долю production-трафика, которую будет получать каждая версия приложения (три к одному в нашем случае). Убедившись в стабильности новой версии, можно поменять значение ее лейбла track с canary на stable .
Обновление лейблов
Иногда возникает необходимость поменять лейблы у существующих Pod’ов и других ресурсов перед созданием новых. Сделать это можно с помощью команды kubectl label . Например, чтобы промаркировать все Pod’ы NGINX как имеющие отношение к фронтенду, выполните следующую команду:
kubectl label pods -l app=nginx tier=fe pod/my-nginx-2035384211-j5fhi labeled pod/my-nginx-2035384211-u2c7e labeled pod/my-nginx-2035384211-u3t6x labeled Сначала она выберет все Pod’ы с лейблом app=nginx , а затем пометит их лейблом tier=fe . Чтобы просмотреть список этих Pod’ов, выполните:
kubectl get pods -l app=nginx -L tier NAME READY STATUS RESTARTS AGE TIER my-nginx-2035384211-j5fhi 1/1 Running 0 23m fe my-nginx-2035384211-u2c7e 1/1 Running 0 23m fe my-nginx-2035384211-u3t6x 1/1 Running 0 23m fe Будут выведены все Pod’ы app=nginx с дополнительным столбцом tier (задается с помощью -L или —label-columns ).
Дополнительную информацию можно найти в разделах Лейблы и kubectl label.
Обновление аннотаций
Иногда возникает потребность навесить на ресурсы аннотации. Аннотации — это произвольные неидентифицирующие метаданные для извлечения клиентами API (инструментами, библиотеками и т.п.). Добавить аннотацию можно с помощью команды kubectl annotate . Например:
kubectl annotate pods my-nginx-v4-9gw19 description='my frontend running nginx' kubectl get pods my-nginx-v4-9gw19 -o yaml apiVersion: v1 kind: pod metadata: annotations: description: my frontend running nginx . Для получения дополнительной информации обратитесь к разделу Аннотации и описанию команды kubectl annotate.
Масштабирование приложения
Для масштабирования приложения можно воспользоваться инструментом kubectl . Например, следующая команда уменьшит число реплик с 3 до 1:
kubectl scale deployment/my-nginx --replicas=1 deployment.apps/my-nginx scaled После ее применения количество Pod’ов под управлением соответствующего объекта Deployment сократится до одного:
kubectl get pods -l app=nginx NAME READY STATUS RESTARTS AGE my-nginx-2035384211-j5fhi 1/1 Running 0 30m Чтобы система автоматически выбирала необходимое количество реплик NGINX в диапазоне от 1 до 3, выполните следующую команду:
kubectl autoscale deployment/my-nginx --min=1 --max=3 horizontalpodautoscaler.autoscaling/my-nginx autoscaled Теперь количество реплик NGINX будет автоматически увеличиваться и уменьшаться по мере необходимости.
Для получения дополнительной информации см. разделы kubectl scale, kubectl autoscale и horizontal pod autoscaler.
Обновление ресурсов «на месте»
Иногда возникает необходимость внести мелкие обновления в созданные ресурсы, не требующие их пересоздания.
kubectl apply
Хранить конфигурационные файлы рекомендуемтся в системе контроля версий (см. конфигурация как код). В этом случае их можно будет поддерживать и версионировать вместе с кодом ресурсов, которые те конфигурируют. Далее с помощью команды kubectl apply изменения, внесенные в конфигурацию, можно применить к кластеру.
Она сравнит новую версию конфигурации с предыдущей и применит внесенные изменения, не меняя параметры, установленные автоматически, не затронутые новой редакцией конфигурации.
kubectl apply -f https://k8s.io/examples/application/nginx/nginx-deployment.yaml deployment.apps/my-nginx configured Обратите внимание, что kubectl apply добавляет к ресурсу аннотацию, помогающую отслеживать изменения в конфигурации с момента предыдущего вызова. При вызове kubectl apply проводит трехстороннее сравнение (three-way diff) предыдущей конфигурации, ее текущей и новой версий, которое определяет, какие правки следует внести в ресурс.
На данный момент ресурсы в Kubernetes создаются без данной аннотации, поэтому при первом вызове kubectl apply проведет двустороннее сравнение входных данных и текущей конфигурации ресурса. Кроме того, она не cможет определить, какие свойства, заданные при создании ресурса, требуют удаления (соответственно, не будет их удалять).
При всех последующих вызовах kubectl apply и других команд, меняющих конфигурацию, таких как kubectl replace и kubectl edit , аннотация будет обновляться. В результате kubectl apply сможет проводить трехстороннее сравнение (three-way diff), определяя, какие свойства требуют удаления, и удалять их.
kubectl edit
Ресурсы также можно обновлять с помощью команды kubectl edit :
kubectl edit deployment/my-nginx По сути, kubectl edit объединяет в себе логику нескольких команд, упрощая жизнь пользователям: сначала она получает ( get ) ресурс, вызывает текстовый редактор, а затем применяет ( apply ) обновленную конфигурацию:
kubectl get deployment my-nginx -o yaml > /tmp/nginx.yaml vi /tmp/nginx.yaml # внесите правки и сохраните файл kubectl apply -f /tmp/nginx.yaml deployment.apps/my-nginx configured rm /tmp/nginx.yaml Обратите внимание, что задать предпочитаемый текстовый редактор можно с помощью переменных окружения EDITOR или KUBE_EDITOR .
За дополнительной информацией обратитесь к разделу kubectl edit.
kubectl patch
Команда kubectl patch обновляет объекты API «на месте». Она поддерживает форматы JSON patch, JSON merge patch и strategic merge patch. См. разделы Обновление объектов API «на месте» с помощью kubectl patch и kubectl patch.
Обновления, требующие перерыва в работе
Иногда может понадобиться обновить поля ресурса, которые нельзя изменить после инициализации, или возникнет необходимость немедленно внести рекурсивные изменения, например, «починить» сбойные Pod’ы, созданные Deployment’ом. Для этого можно воспользоваться командой replace —force , которая удалит и пересоздаст ресурс. Вот как можно внести правки в исходный файл конфигурации в нашем примере:
kubectl replace -f https://k8s.io/examples/application/nginx/nginx-deployment.yaml --force deployment.apps/my-nginx deleted deployment.apps/my-nginx replaced Обновление приложения без перерыва в работе
В какой-то момент возникнет необходимость обновить развернутое приложение. Обычно это делают, указывая новый образ или тег образа, как в приведенном выше сценарии канареечного развертывания. kubectl поддерживает несколько видов обновлений, каждый из которых подходит для разных сценариев.
Ниже будет рассказано, как создавать и обновлять приложения с помощью объектов Deployment.
Предположим, что в кластере используется версия NGINX 1.14.2:
kubectl create deployment my-nginx --image=nginx:1.14.2 deployment.apps/my-nginx created с тремя репликами (чтобы старые и новые ревизии могли сосуществовать):
kubectl scale deployment my-nginx --current-replicas=1 --replicas=3 deployment.apps/my-nginx scaled Чтобы перейти на версию 1.16.1, измените значение параметра .spec.template.spec.containers[0].image с nginx:1.14.2 на nginx:1.16.1 :
kubectl edit deployment/my-nginx Вот и все! Deployment декларативно обновит развернутое приложение NGINX «за кулисами». При этом Kubernetes проследит, чтобы число недоступных реплик в каждый момент времени не превышало определенного значения, а также за тем, чтобы количество новых реплик не превышало определенного предела, установленного для желаемого числа Pod’ов. Более подробную информацию об этом можно получить в разделе Deployment.
Что дальше
- Узнайте о том, как использовать kubectl для интроспекции и отладки приложений.
- Ознакомьтесь с Лучшими практиками и советами по конфигурированию.
Обратная связь
Эта страница была полезна?
Спасибо за обратную связь! Если у вас есть конкретный вопрос об использовании Kubernetes, спросите на Stack Overflow. Создайте issue в репозитории GitHub, если вы хотите сообщить о проблеме или предложить улучшение.