Что такое VictoriaMetrics

Опубликовано: 12.12.2022
VictoriaMetrics —
база данных временных рядов долгого хранения. Позиционируется как быстрое, экономичное и масштабируемое хранилище для метрик Prometheus, InfluxDB, OpenTSDB, Graphite.
Позволяет решить следующие проблемы (на примере Prometheus):
- Данные плохо сжимаются, занимая много дискового пространства.
- Prometheus не может быть настроен в режиме кластера, что делает решение не до конца надежным и масштабируемым.
- Глобальный поиск по всем серверам мониторинга. Если у нас много баз Prometheus, сбор данных в общую базу позволит искать информацию в одном инструменте.
- По умолчанию, Prometheus хранит данные 15 дней. Но это поведение может быть скорректировано опцией storage.tsdb.retention.time. Также лимит на хранение может быть определен в байтах с помощью опции storage.tsdb.retention.size.
VictoriaMetrics представляет из себя бинарный файл, поэтому для установки достаточно скопировать его и выполнить запуск с желаемыми опциями. Поддерживаются все популярные операционные системы от Linux до Windows. Скачать приложение и/или исходники можно на Github. Помимо бинарника, мы можем развернуть приложение в Docker или c помощью Helm, собрать свой deb или rpm пакет и другое.
Для визуализации данных можно использовать инструмент Grafana. На сайте последней или Github VictoriaMetrics можно найти готовые дашборды.
Встречается в статьях
Мини-инструкции:
VictoriaMetrics и мониторинг приватных облаков. Павел Колобаев

VictoriaMetrics — быстрая и масштабируемая СУБД для хранения и обработки данных в форме временного ряда (запись образует время и набор соответствующих этому времени значений, например, полученных через периодический опрос состояния датчиков или сбор метрик).

Меня зовут Колобаев Павел. DevOps, SRE, LeroyMerlin, все как код – это все про нас: про меня и про других сотрудников LeroyMerlin.

Есть облако на базе OpenStack. Там небольшая ссылка на техрадар.
Построено оно на базе железа и Kubernetes, а также на всех сопутствующих сервисах к OpenStack и логирования.

Схема вот такая у нас была на разработке. Когда мы все это разрабатывали у нас был оператор Prometheus, который хранил данные внутри самого кластера K8s. Он автоматически находит то, что нужно отскрейпить и складывает себе под ноги, грубо говоря.

Все данные нам нужно будет вынести за пределы кластера Kubernetes, потому что если что-то случится, то мы должны понимать, что и где.

Первое решение – мы используем federation, когда у нас есть сторонний Prometheus, когда мы ходим в кластер Kubernetes через механизм federation.

Но тут получаются небольшие проблемы. В нашем случае проблемы начались, когда у нас было 250 000 метрик, а когда стало 400 000 метрик, поняли, что так работать не можем. Мы увеличили scrape_timeout до 25 секунд.
Почему нам это пришлось сделать? Prometheus начинает отсчитывать время тайм-аута с начала момента забора. И не важно, что данные все еще льются. Если за этот указанный промежуток времени данные не слились и сессия не будет закрыта по http, то считается, что сессия провальная и данные не попадают в сам Prometheus.

Всем знакомые графики, которые мы получаем, когда часть данных отсутствуют. Графики рванные и нас это не устраивает.

Следующий вариант – это шардирование на основе двух разных Prometheus через тот же механизм federation.
Например, просто взять и по имени их отшардировать. Это можно тоже использовать, но мы решили двигаться дальше.

Нам придется теперь эти шарды как-то обрабатывать. Можно взять promxy, который сходит в область шарда, смультиплицирует данные. Он работает с двумя шардами как с единой точкой входа. Такое можно реализовать через promxy, но слишком пока сложно.
Первый вариант – мы хотим отказаться от механизма federation, потому что он очень медленный.

Разработчики Prometheus явно говорят: «Ребята, используйте другие TimescaleDB, потому что мы не будем поддерживать долгое хранение метрик». Это не их задача.
Мы себе на бумажку записываем, что нам все-таки требуется выгрузка наружу, дабы не хранить все в одном месте.

Второй недостаток – это потребление памяти. Да, я понимаю, что многие скажут, что в 2020-ом году пару гигабайт памяти – это стоит копейки, но тем не менее.
Сейчас у нас есть dev и prod-среда. В dev – это порядка 9 гигабайтов на 350 000 метрик. В prod – это 14 гигабайтов с небольшим на 780 000 метрик. При этом retention time у нас всего 30 минут. Это плохо. И сейчас объясню почему.

Мы делаем расчет, т. е. при полутора миллионах метрик, а мы уже близки к ним, на этапе еще проектирования мы получаем 35-37 гигабайт памяти. Но уже к 4 миллионам метрик требуется уже порядка 90 гигабайтов памяти. Т. е. это было рассчитано по той формуле, которую предоставляют разработчики Prometheus. Мы посмотрели корреляцию и поняли, что мы не хотим платить пару миллионов за сервер просто под мониторинг.
У нас не просто увеличится количество машин, мы еще мониторим и сами виртуальные машины. Поэтому чем больше виртуальных машин, тем больше метрик разного рода и т. д. У нас будет специальный рост нашего кластера в плане метрик.

С дисковым пространством здесь не все так печально, но хотелось бы улучшить. Мы получили за 15 дней суммарно 120 гигабайтов, из которых 100 – это сжатые данные, 20 – это не сжатые данные, но всегда хочется меньше.

Соответственно, мы записываем еще один пункт – это большое потребление ресурсов, которые хочется все-таки экономить, потому что мы не хотим, чтобы наш кластер мониторинга съел ресурсов больше, чем наш кластер, который занимается управлением OpenStack.

Есть еще один недостаток у Prometheus, который мы для себя выявили, это хоть какое-то ограничение по памяти. С Prometheus здесь все гораздо хуже, потому что у него вообще таких крутилок нет. Использовать ограничение в докере тоже не вариант. Если вдруг у вас RAF упал и там 20-30 гигабайтов, то подниматься он будет очень долго.

Это еще одна причина, почему нам не подходит Prometheus, т. е. нельзя ограничить потребление памяти.

Можно было бы выйти на такую схему. Эта схема нам нужна для того, чтобы организовать HA кластер. Мы хотим, чтобы наши метрики были доступны всегда и везде, даже при падении сервера, который хранит эти метрики. И тем самым нам придется вот такую схему построить.
Эта схема говорит, что у нас будет дублирование шардов, а, соответственно, и дублирование расходов потребляемых ресурсов. Ее можно почти горизонтально масштабировать, но тем не менее потребление ресурсов будет адское.

Недостатки по порядку в том виде, в котором мы для себя их выписали:
- Требуется выгрузка метрик наружу.
- Большое потребление ресурсов.
- Нельзя ограничить потребление памяти.
- Сложная и ресурсоемка реализация HA.

Для себя мы решили, что мы уходим от Prometheus как от хранилища.
Мы для себя определили еще дополнительные требования, которые нам нужны. Это:
- Это поддержка promql, потому что уже много всего написано под Prometheus: запросы, алерты.
- И дальше у нас есть Grafana, которая уже точно так же написана под Prometheus как бэкенд. Не хочется переписывать дашборды.
- Мы хотим построить нормальную HA архитектуру.
- Мы хотим уменьшить потребление любых ресурсов.
- Есть еще маленький нюанс. Мы не можем использовать различного рода cloud системы сбора метрик. Мы не знаем, что у нас улетит в эти метрики пока. И так как туда может улететь все, что угодно, нам приходится ограничиваться локальным размещением.

Выбор был небольшой. Мы собрали все, по чему у нас был опыт. Посмотрели на страницу Prometheus в разделе integration, прочитали кучу статей, посмотрели, что вообще есть. И для себя мы выбрали VictoriaMetrics в качестве замены Prometheus.
Почему? Потому что:
- Умеет promql.
- Есть модульная архитектура.
- Не требует изменений в Grafana.
- И самое главное – мы, возможно, будем предоставлять хранилище метрик внутри своей компании как сервис, поэтому мы заранее смотрим в сторону ограничения различного рода, чтобы пользователи могли в каком-то ограниченном виде использовать все ресурсы кластера, потому что есть шанс, что он будет multitenancy.
Делаем первые сравнение. Мы берем тот же самый Prometheus внутри кластера, к нему ходит внешний Prometheus. Добавляем через remoteWrite VictoriaMetrics.

Сразу оговорюсь, что вот здесь мы поймали небольшое увеличение по потреблению CPU со стороны VictoriaMetrics. На VictoriaMetrics wiki написано, какие параметры лучше подходят. Мы их проверили. Они очень хорошо уменьшили потребление именно по CPU.
В нашем случае потребление памяти Prometheus, который находится в кластере Kubernetes, возросло незначительно.

Сравниваем два data source одних и тех же данных. В Prometheus мы видим все те же недостающие данные. В VictoriaMetrics все хорошо.

Результаты тестов с дисковым пространством. Мы в Prometheus получили 120 гигабайтов суммарно. В VictoriaMetrics мы получаем уже 4 гигабайта в день. Там немножко другой механизм, чем нежели привыкли видеть в Prometheus. Т. е. данные уже достаточно хорошо жмутся за день, за полчаса. Они уже хорошо пожаты за день, за полчаса, несмотря на то, что еще потом будет мержить данные. В итоге мы сэкономили на дисковом пространстве.

Еще мы экономим на потреблении ресурсов памяти. У нас Prometheus был на момент тестов развернут на виртуальной машине – 8 ядер, 24 гигабайта. Prometheus отъедает практически все. Он упал по OOM Killer. При этом в него лилось всего 900 000 активных метрик. Это порядка 25 000-27 000 метрик в секунду.
VictoriaMetrics у нас была запущена на двухъядерной виртуальной машине с 8 гигабайтами RAM. Нам удалось заставить VictoriaMetrics хорошо работать, покрутив некоторые вещи на 8-гигабайтной машине. В итоге мы уложились в 7 гигабайт. При этом получили скорость отдачи контента, т. е. метрик, даже выше, чем у Prometheus.

В CPU стало гораздо лучше относительно Prometheus. Здесь Prometheus потребляет 2,5 ядра, а VictoriaMetrics всего – 0,25 ядра. На старте – 0,5 ядра. По мере мержа она доходит до одного ядра, но это крайне-крайне редко.

В нашем случае выбор пал на VictoriaMetrics по понятным причинам, мы хотели сэкономить и сэкономили.

Вычеркиваем с ходу два пункта – это выгрузка метрик и большое потребление ресурсов. И нам остается решить два пункта, которые мы для себя еще оставили.

Здесь я оговорюсь сразу, мы VictoriaMetrics рассматриваем как хранилище метрик. Но так как мы будем предоставлять, скорее всего, VictoriaMetrics как хранилище для всего Leroy, нам нужно тех, кто будет использовать этот кластер, ограничить, чтобы они нам его не положили.
Есть замечательный параметр, который позволяет ограничивать по времени, по объему данных и по времени выполнению.
А также есть отличная опция, позволяющая ограничивать потребление памяти, тем самым мы можем найти тот самый баланс, который позволит нам получить нормальную скорость работы и адекватное потребление ресурсов.

Минус еще один пункт, т. е. зачеркиваем пункт – нельзя ограничить потребление памяти.

В первых итерациях мы тестировали VictoriaMetrics Single Node. Дальше мы переходим к VictoriaMetrics Cluster Version.
Здесь у нас развязываются руки на предмет разнесения разных сервисов в VictoriaMetrics в зависимости оттого, на чем они будут крутиться и какие ресурсы потреблять. Это очень гибкое и удобное решение. Мы на себе это использовали.

Основные компоненты VictoriaMetrics Cluster Version – это vmstsorage. Их может быть N количество. В нашем случае пока их 2.
И есть vminsert. Это прокси-сервер, который позволяет нам: устроить шардирование между всеми storages, о которых мы ему рассказали, и он позволяет еще реплику, т. е. у вас будет и шардирование, и реплика.
Vminsert поддерживает протоколы OpenTSDB, Graphite, InfluxDB и remoteWrite от Prometheus.

Есть еще vmselect. Его основная задача – это сходить в vmstorage, получить от них данные, дедуплицировать эти данные и отдать клиенту.

Есть замечательная штука как vmagent. Нам очень нравится она. Она позволяет конфигурировать точно так же как Prometheus и при этом делать все точно так же как Prometheus. Т. е. он собирает с разных сущностей, сервисов метрики и отправляет их в vminsert. Дальше все уже зависит от вас.

Еще один замечательный сервис – это vmalert, который позволяет в качестве бэкенда использовать VictoriaMetrics, получать от vminsert и отправлять в vmselect обработанные данные. Обрабатывает он сами алерты, а также rules. В случае алертов мы получаем алерт через alertmanager.
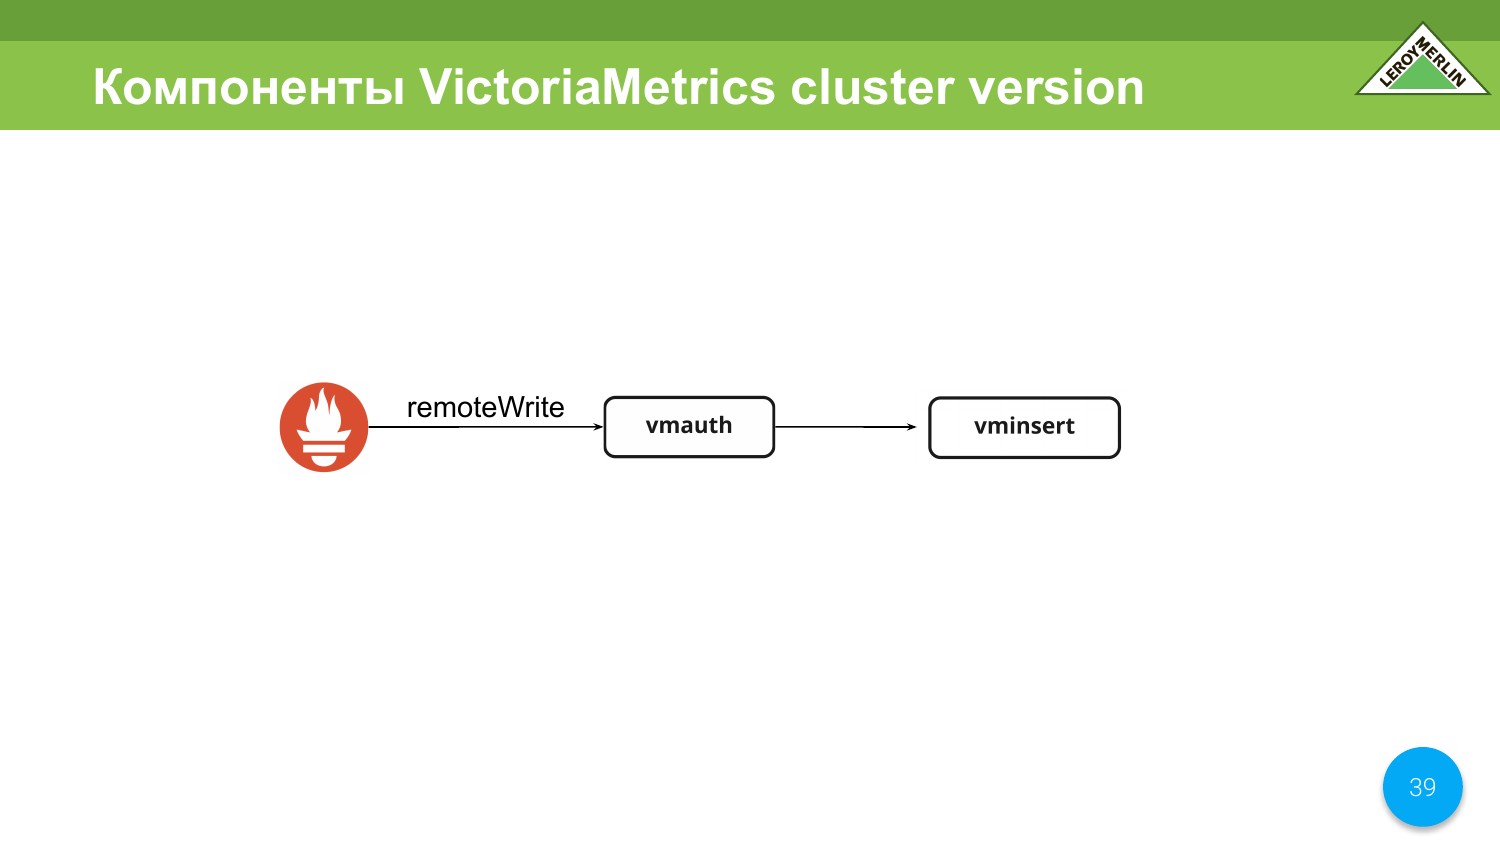
Есть компонент vmauth. Он у нас будет, возможно, использоваться, а, возможно, и нет (мы еще не определись с этим) в качестве системы авторизации при multitenancy версии кластеров. Он поддерживает remoteWrite для Prometheus и может авторизовать на основе url, а точнее второй его части, куда вам можно или нельзя писать.

Есть еще vmbackup, vmrestore. Это, по сути, восстановление и бэкап всех данных. Умеет S3, GCS, file.

Первая итерация нашего кластера была сделана во время карантина. На тот момент не было реплики, поэтому наша итерация представляла собой два разных и независимых кластера, в которые через remoteWrite мы получали данные.

Здесь оговорюсь, что, когда мы переходили с VictoriaMetrics Single Node на VictoriaMetrics Cluster Version, мы все так же остались в тех же потребляемых ресурсах, т. е. основная – это память. Примерно таким образом распределились наши данные, т. е. потребление ресурсов.

Здесь уже была добавлена реплика. Мы объединили все это в один относительно большой кластер. Все данные у нас как шардируются, так и реплицируются.
У всего кластера есть N точек входа, т. е. Prometheus может добавлять данные через HAPROXY. Вот у нас эта точка входа. И через эту точку входа можно заходить c Grafana.
В нашем случае HAPROXY – это единственный порт, который проксирует select, insert и остальные сервисы внутрь этого кластера. В нашем случае нельзя было сделать один адрес, нам пришлось сделать несколько точек входа, потому что сами виртуалки, на которых крутится VictoriaMetrics-кластер, находятся у нас в разных зонах одного облачного провайдера, т. е. не внутри нашего облака, а снаружи.

У нас есть алертинг. Мы его используем. Мы используем alertmanager от Prometheus. Мы в качестве канала доставки алертов используем Opsgenie и Telegram. В Telegram сыплются от dev, может быть, что-то от prod, но больше что-то такое статистическое, нужное инженерам. А Opsgenie – critical. Это звонки, управление инцидентами.

Извечный вопрос: «Кто же мониторит мониторинг?». В нашем случае мониторинг мониторит сам мониторинг, потому что мы используем vmagent на каждой ноде. А так как наши ноды разнесены по разным дата-центрам одного провайдера, у каждого дата-центра у нас свой канал, они независимые и даже если придет split brain, то мы все равно получит алерты. Да, их будет больше, но лучше получить больше алертов, чем ни одного.

Мы заканчиваем наш список с реализацией HA.

И дальше хотел бы отметить опыт общения с комьюнити VictoriaMetrics. Оно получилось очень позитивное. Ребята отзывчивые. Они пытаются вникнуть в каждый кейс, который предлагается.
Я заводил issues на GitHub. Они очень быстро были решены. Есть еще парочка issues, которые не до конца закрыты, но я уже по коду вижу, что работа в этом направлении идет.
Основная боль во время итераций для меня была в том, что если вырублю ноду, то первые 30 секунд у меня vminsert не мог понять, что бэкенда нет. Сейчас это уже решено. И буквально за секунду или две данные забираются уже со всех оставшихся нод, и запрос перестает ждать ту отсутствующую ноду.

Мы хотели в какой-то момент от VictoriaMetrics, чтобы это был VictoriaMetrics operator. Мы его дождались. Мы сейчас в активном построении обвязки над VictoriaMetrics operator, чтобы взять все pre-calculating rules и т. д. Prometheus, потому что мы достаточно активно используем rules, которые идут вместе с оператором Prometheus.
Есть предложения по улучшению кластерной реализации. Я их изложил выше.

И еще очень хочется downsampling. В нашем случае downsampling нужен исключительно для просмотров трендов. Грубо говоря, мне одной метрики в течение дня хватит. Эти тренды нужны на год, на три, на пять, на десять лет. И одного значения метрики вполне достаточно.
- Мы познали боль, как и некоторые наши коллеги, при использовании Prometheus.
- Мы выбрали для себя VictoriaMetrics.
- Она достаточно хорошо масштабируется как вертикально, так и горизонтально.
- Мы можем разносить разные компоненты на разное количество узлов в кластере, лимитировать их по объему памяти, накидывать память и т. д.
Мы будем у себя использовать VictoriaMetrics, потому что она нам очень понравилась. Вот что было и что стало.

Пара qr-кодов на чат VictoriaMetrics, мои контакты, техрадар LeroyMerlin.
“Victoria Metrics agent — комбайн для мониторинга” (Николай Храмчихин, Victoria Metrics)
Добрый день, меня зовут Николай Храмчихин. Сегодня я расскажу о vmagent ’е, нашем комбайне для мониторинга .
Вначале краткий экскурс в историю — с чего все началось и зачем был разработан vmagent . Сначала была VictoriaMetrics, это быстрая и простая в установке БД для временных рядов . Она принимала данные в себя из Prometheus по remote_write -протоколу. В ходе эксплуатации Prometheus ’а мы и наши клиенты столкнулись с определенными проблемами. Проблемы были актуальны на тот период — где-то полтора года назад. Сейчас, возможно, что-то изменилось, и они уже не актуальны.
В первую очередь, Prometheus потреблял много оперативной памяти (RAM), это приводило к ошибкам out-of-memory . Он глючил и тормозил после unclean shutdown , думаю, многие сталкивались с этой проблемой — его сложно запустить после этого. Нужно было либо удалять все данные, либо добавлять ему оперативной памяти.
Также он мог терять метрики, если удаленное хранилище было недоступно какой-то период. Это было очень неприятно — на графиках были пропуски, и работать с удаленным хранилищем было невозможно.
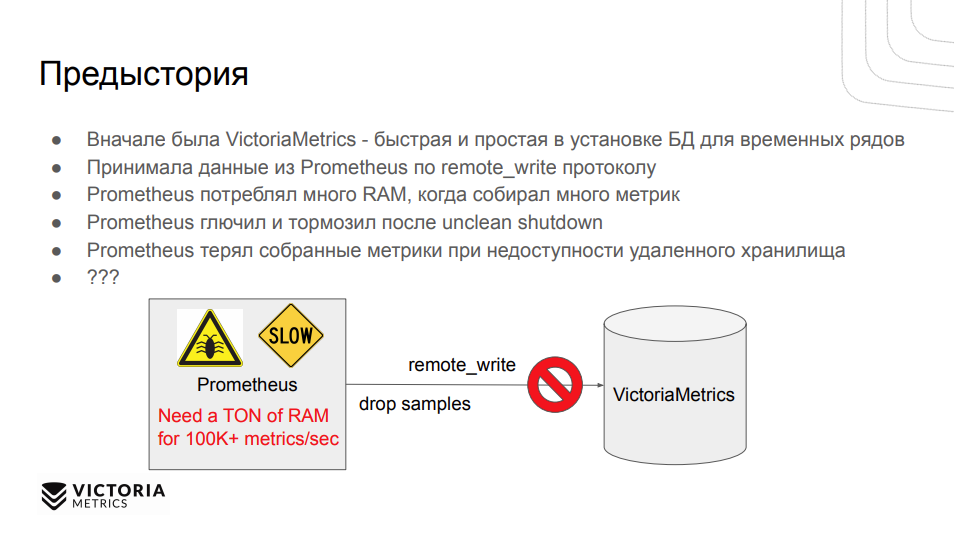
В ответ на все эти проблемы был разработан vmagent как легковесная замена Prometheus .
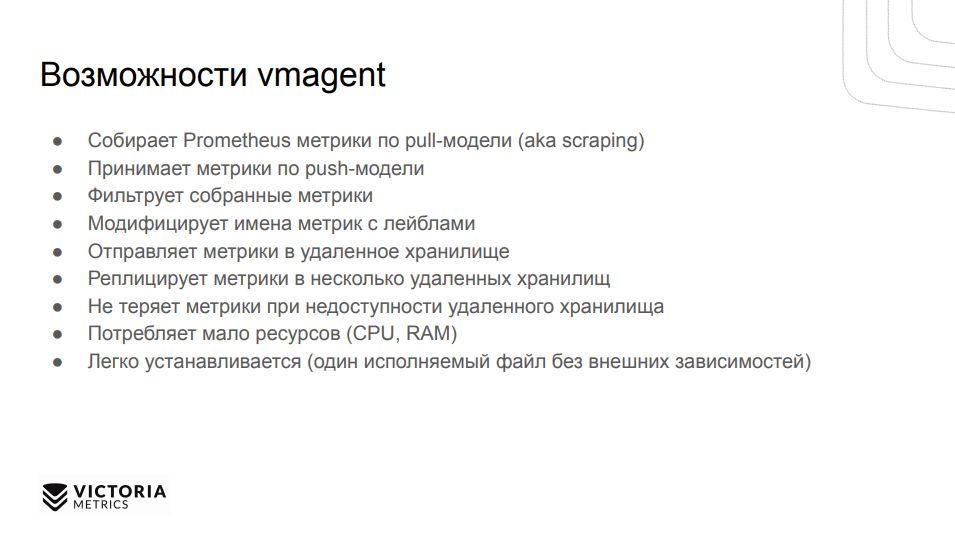
Давайте рассмотрим его основные возможности. В первую очередь это, конечно, сбор метрик по pull-модели , как это делает Prometheus . В этом случае vmagent отправляет http-запросы на цели и получает от них список метрик. Кроме этого, он умеет получать метрики по push-модели, когда разнообразные клиенты ( Telegraf , statsd и проч.) могут отправлять в него метрики.
Помимо этого он может фильтровать собранные метрики . Есть определенный набор правил, по которым это можно сделать, и модифицировать имена метрик с их лейблами.
Конечно же он может сохранять метрики в удаленное хранилище, как это делал Prometheus , по remote_write -протоколу. С его помощью можно настроить репликацию в несколько хранилищ, главное, чтобы они понимали протокол. Например, можно записывать в VictoriaMetrics , в vmagent , в Cortex и в некоторые другие удаленные хранилища. При недоступности хранилища vmagent не теряет метрики, у него есть дисковый буфер (на каждое удаленное хранилище отдельный).
Самое главное: он использует небольшое количество ресурсов CPU и оперативной памяти . Конечно же, он легко устанавливается: у него всего один исполняемый файл без внешних зависимостей.
Как осуществляется сбор Prometheus -метрик? Мы сделали возможность использования конфигурационного файла Prometheus . Vmagent поддерживает global и scrape_configs секции конфигурационного файла. Можно настроить как static config со статических таргетов, так и с помощью service discovery от провайдеров получить список таргетов и уже использовать их. В данный момент vmagent работает с основными, такими как Kubernetes , Amazon EC2 и остальные. Если какого-то service -провайдера нет в списке, всегда можно открыть issue на Github.com , и мы сразу все добавим. Также как и Prometheus , vmagent умеет в релейблинг .
Помимо этого, у vmagent есть дополнительные фичи. Это, в первую очередь, кластеризация . Можно разделить таргеты между разными vmagent ’ами при помощи простой конфигурации. Это бывает полезно, когда не хватает ресурсов одного vmagent ’a для сбора метрик, либо можно таким образом распределить точки отказа: если одна виртуальная машина с vmagent ’ом вышла из строя, можно продолжить собирать часть метрик со второй машины. Соответственно, достаточно указать количество агентов в кластере и каждому из них присвоить уникальный номер.
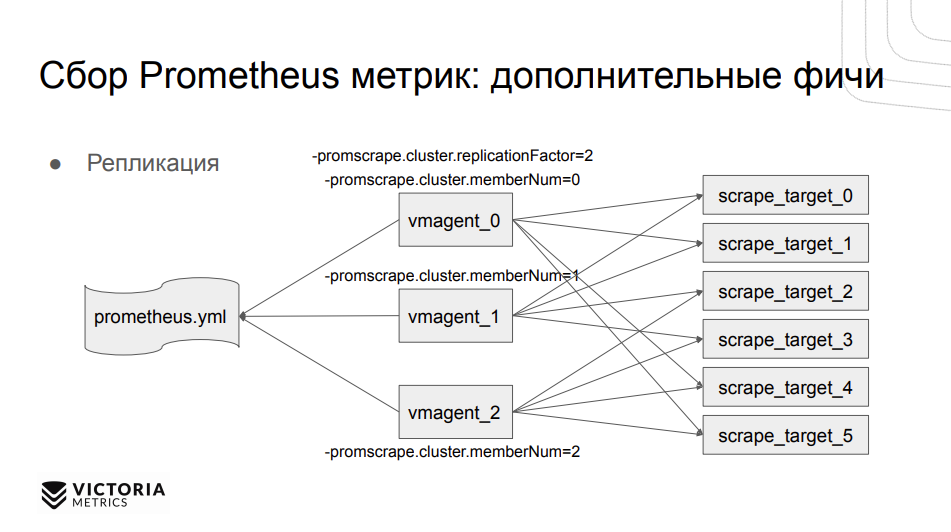
Где кластеризация, там уже может быть и репликация . И да, vmagent умеет в репликацию. Настроив replication factor , можно собирать несколько метрик с разных таргетов.
Одна из важных фичей, которые позволяют vmagent ’у использовать небольшое количество RAM — это потоковое чтение метрик . В данном случае, если таргет экспортирует более 10 млн метрик, то потребление памяти будет достаточно большое. Настраивается все достаточно просто: нужно указать stream_parse:true в конфигурационном файле для конкретной job, либо глобально для всего vmagent’ а. Prometheus -экспортеры отдают метрики в построчном формате (prometheus text exposition), поэтому vmagent читает первые n-строк, обрабатывает их и отправляет на запись в удаленное хранилище, потом продолжает обрабатывать следующий блок данных, пока не обработает все.
Список принимаемых форматов метрик:
- InfluxDB (http, tcp & udp)
- Graphite (tcp, udp)
- OpenTSDB (http, tcp)
- JSON line
- CSV
- Prometheus text exposition format
- Prometheus remote_write
Та самая фильтрация метрик, о которой я хотел рассказать. Она осуществляется с помощью Prometheus-compatible relabeling , то есть поддерживается весь тот синтаксис, который предоставляет Prometheus для релейблинга . Можно фильтровать по имени метрики, по значению тэгов (лейблов) и по регулярным выражениям. Модифицировать можно с тем же совместимым с Prometheus -форматом. Можно переименовать метрики, добавить новые лейблы, изменить или удалить их.
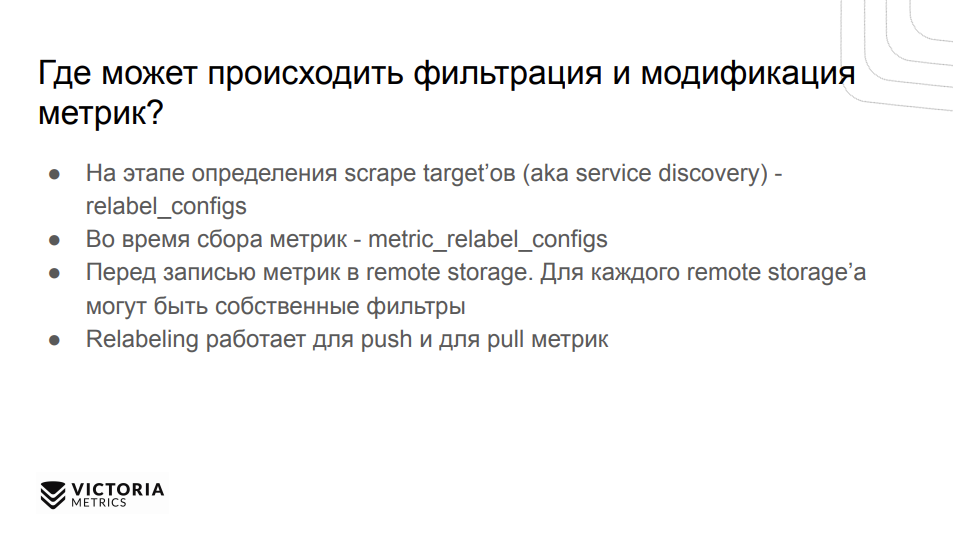
Где может происходить фильтрация и модификация метрик? В vmagent’е она может происходить практически везде . Можно настроить в конфигурационном файле на уровне relable_configs , в этом случае релейбелинг будет применяться, когда vmagent определяет таргеты, получая список таргетов от Kubernetes ’а.
Во время сбора метрик можно настроить metric_relabel_configs . На этом этапе уже не будут доступны металейблы от Kubernetes ’а. Это нужно делать немного заранее. Перед записью в remote storage тоже можно делать релейбелинг, как для каждого хранилища, так и глобально для всех. И да, релейбелинг работает как для push-метрик, так и для pull.
О других возможностях vmagent ’a. Он может ограничивать скорость записи метрик в удаленное хранилище . Настраивается это для каждого хранилища отдельно или глобально для всех. Это бывает полезно, когда удаленное хранилище недоступно, vmagent забуферизировал метрики, и ему нужно записать большое количество метрик в удаленное хранилище, что может его перегрузить. В данном случае можно ограничить количество записываемых метрик в секунду.
Совсем недавняя фича — можно ограничивать количество уникальных метрик (high cardinality) в час и в день. Соответственно, это может спасти от ошибок конфигурации экспортеров, когда они начинают неправильно работать и выдавать высоко кардинальные метрики. Это очень сильно нагружает БД, так как хранение уникальных метрик грузит RAM и CPU, а регистрация новых метрик ID достаточно дорогой процесс. Для улучшения сжатия данных можно ограничить количество знаков после запятой (настраивается для каждого хранилища).
Где и как можно внедрить vmagent? И какие конфигурации могут быть? Самая простая и логичная — легковесная замена Prometheus . Если у вас есть связка с Prometheus , которая пишет данные в VictoriaMetrics , можно его остановить и запустить с тем же конфигурационным файлом vmagent и указать запись в удаленное хранилище VictoriaMetrics .
Для настройки алертинга, если вы используете его вместе с Prometheus , можно запустить vmalert , он понимает алерты в Prometheus -совместимом формате и умеет отправлять их в Alertmanager .
Также vmagent можно использовать для репликации между несколькими ЦОДами для обеспечения отказоустойчивости. Можно сконфигурировать несколько -remoteWrite.url ’ов, и, соответственно, между ЦОДами будут реплицироваться данные.
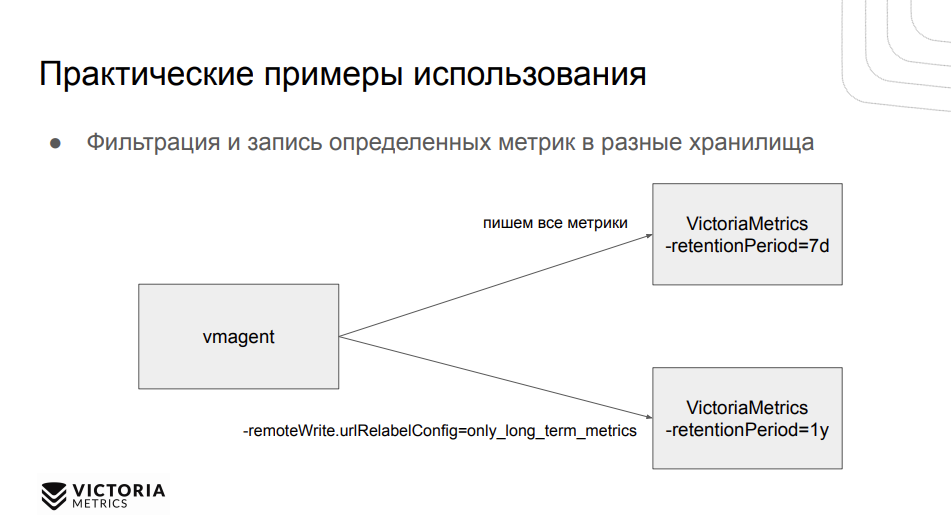
Фильтрация и запись определенных метрик в разные хранилища. Да, один из популярных вопросов, как сделать в VictoriaMetrics разное время хранения разных метрик (retention) в зависимости от лейбла. У нас есть открытый issue, как это сделать на уровне одной базы данных, но сейчас это можно реализовать, запустив две разных VictoriaMetrics с разным временем хранения и добавив для одной из них фильтр, который будет сохранять метрики только с определенным лейблом. А в другую БД писать все метрики. Сверху можно поставить какой-нибудь Promxy или что-то подобное, чтобы он опрашивал две VictoriaMetrics и уже показывал результат в Grafan ’е.
При помощи vmagent ’а также можно разделять метрики между разными тенантами . Это актуально для кластерной версии, где можно указать два remoteWright.url ’а. Первый будет писать в один тенант, другой — во второй, и уже на основе каких-то правил будет маршрутизировать между тенантами эти метрики. Это полезно, чтобы разделить метрики разных команд и окружений.
Также можно переводить метрики в “человекочитаемый” формат. Если странный экспортер отдает метрики вот в таком странном формате “ foo_temp ”, с помощью трансформации и релейблинга сделать более приемлемый формат с понятной температурой и названием компании.
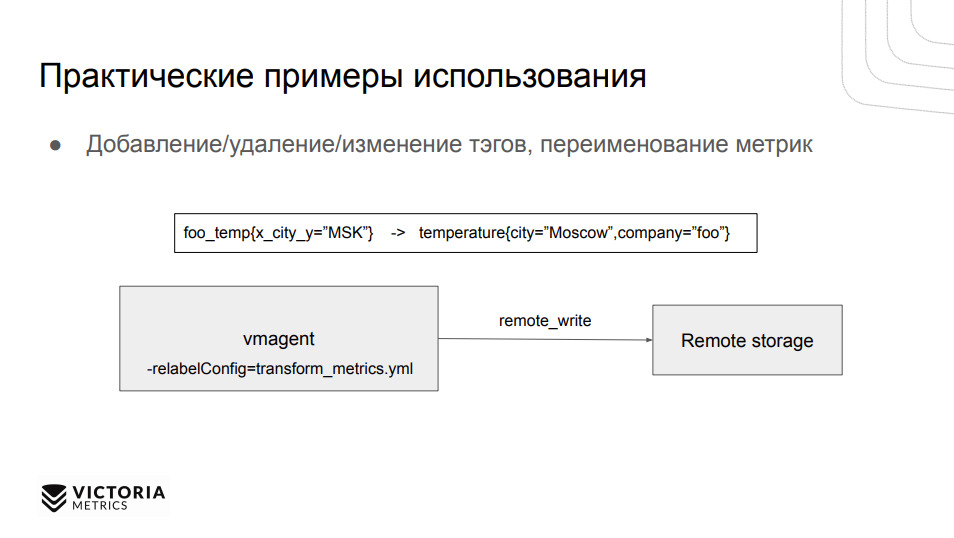
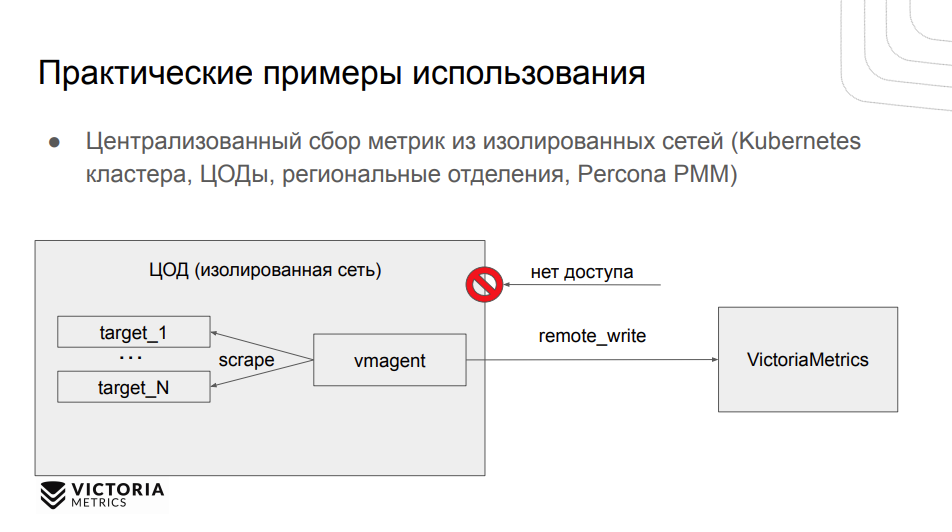
Один из популярных кейсов — централизованный сбор метрик из изолированных сетей. Если применение Prometheus недоступно или сложно настроить, то можно использовать vmagent для сбора этих метрик и отправки в централизованное хранилище.
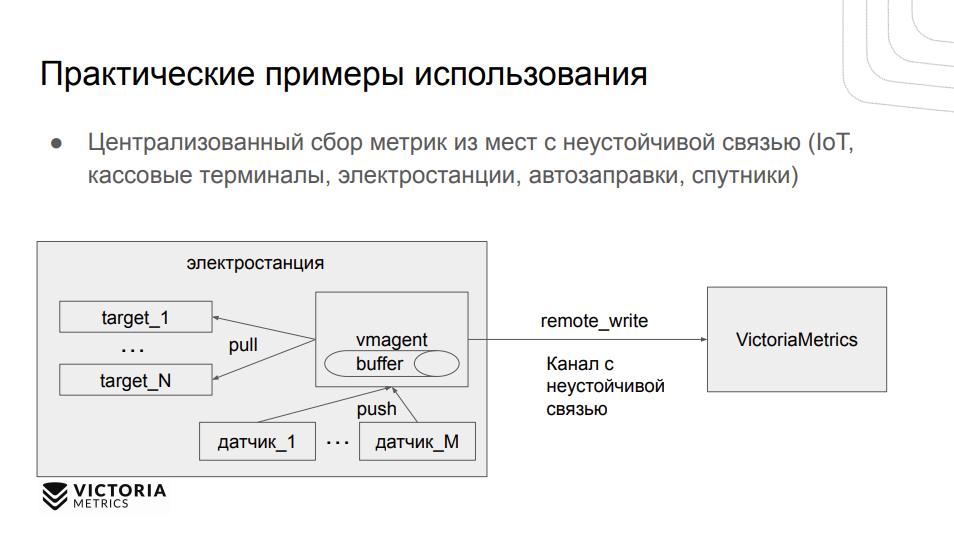
Также vmagent можно использовать в сетях с неустойчивой связью — кассовые терминалы, электростанции и даже спутники. Если связью с Землей нет, то vmagent будет буферизировать данные, как только связь появится, он их отправит VictoriaMetrics .
Какие у нас планы на будущее? Это поддержка statsd и DogStatsD -протоколов. И мы очень хотели бы разработать новый протокол передачи данных между vmagent и VictoriaMetrics , который потреблял бы гораздо меньше пропускную способность и ее было бы удобнее эксплуатировать в таких случаях, как кассы и спутники. И мы всегда готовы реализовать ваши фичи.
- pull и push модели для сбора метрик
- Фильтрация и редактирование метрик
- Репликация
- Буферизация на диск при отсутствии связи с удаленным хранилищем
- Простота использования
- Легковесность
- Open Source
ВОПРОСЫ К СПИКЕРУ:
— Можно ознакомиться с какими-то бенчмарками, чтобы сравнить Prometheus и vmagent ?
— Мы проводили честный бенчмарк VictoriaMetrics , базы данных, который может не только при помощи vmagent ’а, но и самостоятельно собирать данные. Результаты можно посмотреть в документации.
— У Alertmanager есть возможность создания дополнительной crd по поводу рутов и ресиверов, вот для vmalert вы отписывались, что не очень хорошо используется создание дополнительной crd , ну, какой-то другой механизм существует в vmalert, подписывать ConfigMap ’ы на основании лейблов или аннотаций, ну или что-то другое, чтобы можно было динамически создавать пары?
— Да, эта имплементация планируется, возможно, в следующем релизе.
— Когда падает remote storage , возрастает ли потребление ресурсов?
— Нет, по идее ничего не возрастает. Есть два буфера — в памяти и дисковый. Второй заполняется после. И потреблять vmagent будет меньше, чем “single-версия” VictoriaMetrics .
— По поводу кластерности для vmagent . Не является ли это дополнительной точкой отказа? Используется ли кворум? Не проще ли использовать просто пару vmagent с дупликацией?
— Кворума нет. Указывается уникальный идентификатор для каждого vmagent ’а, он собирает часть данных с определенных таргетов. Можно запустить пару агентов, но будет повышенная нагрузка на экспортеры.
— В планах нет ли замены Alertmanager на что-то свое?
— Нет. Пока есть issue на поддержку Webhook , чтобы можно было отправлять алерты в разные системы.
— Когда теряется связь, данные буферизуются в сжатом или сыром виде?
— На диске они хранятся в сжатом виде, отправляются в бинарном Prometheus -формате.
— Были ли какие-то тесты, когда и связь пропадает и ноды рестартуются, теряются ли метрики?
— Да, они могут теряться, если происходит неправильное включение vmagent ’а. Если корректно завершить работу, то ничего не теряется.
Полезные ссылки:
- https://victoriametrics.com/
- https://github.com/VictoriaMetrics/VictoriaMetrics/
- https://docs.victoriametrics.com/vmagent.html
- https://twitter.com/MetricsVictoria
Victoria metrics что это
Базы данных и системы хранения
Базы данных / другое
Логирование и мониторинг
Логи, метрики, ошибки
Целевая аудитория
Инженеры, DevOps’ы, менеджеры по разработке и все те, кому интересен современный мониторинг, observability и детали технических решений при проектировании баз данных для хранения временных рядов.
Тезисы
Рост популярности систем мониторинга приводит ко всё большим требованиям производительности и надежности от баз данных для хранения временных рядов. VictoriaMetrics — решение для мониторинга и база для хранения временных рядов — была спроектирована с целью соответствовать растущим требованиям и закрывать те ниши, где другие решения уже не справляются.
В докладе будет в деталях о том, какие инженерные и архитектурные решения были приняты разработчиками для обеспечения наилучшей производительности и эффективности. Будет объяснён весь цикл «жизни» метрики, рассказано об оптимизациях при вставке, индексах для быстрого поиска, секретах быстрого чтения с диска и улучшениях алгоритмов сжатия.
В ходе доклада будут произведены сравнения с альтернативными решениями, рассмотрены их плюсы и минусы, а также компромиссы, допущенные разработчиками. Если вы знакомы и используете такие системы, как Prometheus, Thanos, Cortex, InfluxDB, TimescaleDB или Graphite — доклад вам будет интересен.
Александр Валялкин — основатель и главный разработчик VictoriaMetrics. Также известен как автор оптимизированных по скорости проектов на Go — fasthttp, quicktemplate, fastjson и fastcache.