Сжатие изображений
Цифровое изображение при хранении занимает большие объемы памяти. Так растровое изображение размером 1024 на 1024 пикселов с глубиной цвета 24 бит занимает 3 Мб. Понятно, что хранение и передача изображений в таком виде является весьма трудоёмкой задачей. Поэтому задача представления изображений в компактной форме (сжатие данных) является весьма актуальной. При этом должны быть разработаны алгоритмы как для кодирования, так и для декодирования (восстановления) изображений.
Алгоритмы сжатия изображений делятся на два больших класса: без потерь и с потерями. В первом случае в ходе компрессии информация об изображении сохраняется в полном объеме, а во втором – частично утрачивается. Первая группа методов сжатия обеспечивает восстановление исходного изображения без потерь и искажений. Для хранения изображений, предназначенных для дальнейшей обработки, следует применять форматы, использующие именно такие методы сжатия. Однако, если изображение предназначено для визуального восприятия, это не всегда необходимо. В ряде случаев исходный сигнал уже содержит такие искажения и шумы, что небольшие потери информации при кодировании (в пользу высокой степени сжатия) не испортят качества изображения в целом.
Одна из серьезных проблем компьютерной графики заключается в том, что до сих пор не найден адекватный и однозначный критерий оценки потерь качества изображения. Для изображений, наблюдаемых визуально, основным является неотличимость глазом исходного и компрессированного изображения.
Рассмотрим некоторые из используемых методов сжатия изображений.
Груповое сжатие
Одним из простейших методов сжатия изображений является алгоритм RLE (Run Length Encoding – кодирование с переменной длиной строки). Основной идеей этого метода является поиск одинаковых пикселов в одной строке. Найденные цепочки одинаковых элементов заменяются на пары (счетчик повторений, значение), что в определенных случаях существенно уменьшает избыточность данных.
Алгоритм в первую очередь рассчитан на изображения с большими областями повторяющегося цвета (деловая графика, схемы, рисунки и т.п.). Недостатком такого подхода является то, что в определенных ситуациях он может вместо уменьшения приводить к увеличению размера файла (например, в некоторых случаях при сохранении цветных фотографий).
Существует много схем группового сжатия, одну из которых можно проиллюстрировать следующим образом:
Входной поток данных:
17 8 54 0 0 0 97 5 16 0 45 23 0 0 0 0 0 3 67 0 0 8
Поток данных после кодирования:
17 8 54 0 3 97 5 16 0 1 45 23 0 5 3 67 0 2 8
Чаще всего для кодирования используется схема, которая называется PackBits. По аналогии с хранением отрицательных чисел, каждые 7 бит исходных данных заменяются в результате на 8 бит. Дополнительный девятый бит интерпретируется как флаг сжатия. Например:
Входные данные: 1,2,3,4,2,2,2,2,4
Данные после кодирования: 1,2,3,4,2,&3,4.
Принцип: Последовательности повторяющихся значений цвета заменяются его значением и количеством повторений.
Форматы: BMP, TIFF, GIF
Коэффициент сжатия: 2
Метод Хафмана
Этот метод назван в честь его разработчика (1950). Алгоритм основан на том предположении, что некоторые значения сигнала встречаются чаще других. Если проанализировать гистограммы изображений, то можно в этом убедиться. Этот факт можно использовать для сжатия изображений. Использовать для хранения значений интенсивности, которые встречаются чаще, меньшее число бит чем на само значение. Главная проблема в том, чтобы отделять одно значение от другого. Ведь на разные значения отводится разное количество бит. Метод сжатия Хафмана можно проиллюстрировать следующим образом:
| Значение | Частота упоминания | Код Хафмана |
| A B C D E F G |
.154 .110 .072 .063 .059 .015 .011 |
1 01 0010 0011 0001 000010 000011 |
Входной поток данных: C E G A D F B E A
Поток данных после кодирования: 0010 0001 000011 1 0011 000010 01 0001 1)
Группировка по байтам: (0010 0001) (000011 1 0) (011 00001) (0 01 00 1 0 1)
Получившиеся коды уникальны, в то смысле, что могут быть записаны в поток данных без разделителей и маркеров. По количеству нулей до и после 1 программа восстановления может однозначно определить значение элемента.
Этот метод иногда используется в усложненной форме, когда кодируется не одно значение, а последовательности значений. Другая модификация метода – подвергнуть коды Хафмана групповому сжатию.
Форматы: TIFF, GIF
Коэффициент сжатия: 3
Метод LZW
Этот метод назван также в честь его разработчиков (Lempel, Ziv, Welch). Это универсальный метод, пригодный для кодирования любых сигналов. Похож на метод Хафмана, только для кодирования элементов используются коды равной длины, а также используются коды для часто встречающихся последовательностей элементов.
Составляется таблица всех цветов, имеющихся в сжимаемом изображении. Таким образом, вместо значения цвета пиксела можно использовать индекс из таблицы. Наиболее часто встречающиеся цвета на изображении имеют меньшие индексы, а редко встречающиеся цвета размещаются в конце таблицы. Таблица цветов (палитра) размешается между заголовком и собственно изображением. Например,
| Индекс | Значение |
| 0000 0001 0254 0255 0256 0257 4095 |
0 1 254 255 145 201 4 243 245 xxx xxx xxx |
Входной поток данных: 123 145 201 4 119 89 243 245 59 11 206 145 201 4 243 245
Поток данных после кодирования: 123 256 119 89 257 59 11 206 256 257
Разработчики предложили не только способ хранения данных, но и хорошо документированные алгоритмы сжатия и восстановления сигнала. Метод был запатентован, стандартизован и теперь используется для сжатия любой информации.
Форматы: TIFF, GIF
Коэффициент сжатия: 5
Метод LZW, как и RLE , лучше действует на изображениях, содержащих однородных, свободных от шума участки цветов. При этом он действует гораздо лучше, чем RLE, при сжатии произвольных графических данных, но процесс кодирования и распаковки происходит медленнее.
Метод JPEG
Среди методов сжатия с потерями следует выделить семейство JPEG, разработанное организацией Joint Photographers Experts Group. Метод основан на частотных представлениях изображения и следующих предположениях. Если к сигналу применить интегральное преобразование (Фурье например), то в результате в частотном представлении основную информации несут низкие частоты. Высокие частоты описывают шум и несущественные детали. Удаление 50% высокочастотной информации повлечет за собой удаление 5% полезной информации содержащейся в изображении.
JPEG-сжатие начинается с разбиения изображения на квадратные области размером 8 на 8 пикселов (64 пиксела — 64 байта). Эти области обрабатываются независимо. После преобразования в каждой группе остается от 2 до 20 байт. При восстановлении сигнала должна быть выполнена аппроксимация и восстановлена исходная область 8 на 8 пикселов.
Для сжатого представления сигнала могут использоваться различные преобразования. Наиболее адекватный (качественные) результат дает преобразование Karhunen-Loeve, но оно сложно и трудоемко в реализации. Преобразование Фурье просто, но не дает желаемого результата при восстановлении. Наиболее пригодным оказалось дискретное косинусное преобразование (Discrete Cosine Transform, DCT). При использовании DCT не нужно работать с комплексными числами (исходный сигнал и его спектр вещественные).
В результате преобразования выборки 8 на 8 получаем выборку спектра 8 на 8. При этом низкие частоты содержатся в верхнем левом углу спектра, а высокие в правом нижнем. Высокие частоты можно обнулить и не хранить.
Если представить спектр в виде следующей последовательности:
то можно её закодировать с использование группового сжатия. На последнем этапе сжатия используется кодирование методом Хафмана для более эффективного сжатия конечных данных.
Принцип: Используется методика сжатия с потерями. Хранится не информация о цвете пикселов, а коэффициенты разложения по некоторому базису.
Коэффициент сжатия: в зависимости от качества от 10 до 1000.
Положительными сторонами алгоритма JPEG является то, что пользователь может управлять соотношением размер/качество, задавая степень сжатия. Выходное цветное изображение может глубину цвета 24 бита на точку. С помощью алгоритма JPEG достигаются большие коэффициенты сжатия при визуально высоком качестве изображения. Отрицательными сторонами алгоритма является то, что при повышении степени сжатия изображение распадается на отдельные квадратные области (размером 8×8). Это связано с тем, что происходят большие потери в низких частотах при квантовании, и восстановить исходные данные становится невозможно. Кроме того может проявляться так называемый эффект Гиббса – ореолы по границам резких переходов цветов. Кроме того, так как это алгоритм сжатия с потерями, изображения обработанные с его применением практически неприменимы для анализа и дальнейшей обработки.
Как работает JPEG-сжатие? Разбор
Поговорим про JPEG-формат и сжатие фотографий. Как это было раньше, как это сейчас и что будет дальше?
aka_opex 15 декабря 2022 в 09:11
Сегодня для нас нет ничего необычного в том, чтобы отправить фотку другу и не волноваться по поводу того, какое устройство, браузер или операционную систему он использует. Все это благодаря формату JPEG, который может уменьшить размер исходного файла в 10, 50 и даже в 100 раз. Изображения формата JPEG встречаются повсюду в нашей жизни в интернете, но за простотой и удобством использования скрываются алгоритмы, устраняющие детали, не воспринимаемые человеческим глазом. В итоге получается высочайшее визуальное качество при наименьшем размере файла.
Вы когда-нибудь задумывались, сколько места фотки на наших устройствах?
Давате посмотрим на этот снимок:
Его разрешение 12.2 мегапикселя или 4032 × 3024 точек. Сколько он должна бы весить? Давайте посчитаем. Как известно, цвет каждого пикселя определяется тремя составляющими: красным, зелёным и синим. Каждая составляющая кодируется восьмибитным числом. Получим, что такое изображение будет весить 8х3х4032×3024 = 292 626 432 бит, то есть почти 300 мб.
В реальности же она весит 7.36 мб. То есть в 40 раз МЕНЬШЕ! А если пожать через Whatsapp, будут какие-то 200 килобайт. Все благодаря формату JPEG, с которым мы сталкиваемся постоянно.
Конечно, присутствует небольшая потеря качества, но по сравнению с тем, что размер файла был уменьшен в несколько десятков раз, это уже не играет большой роли. И новые форматы отвоевывают рынок — тот же hevc. JPEG все еще остается королем индустрии. Так что давайте разберемся, как конкретно всё это работает? Причем здесь психология зрения, и как хитрая математика экономит место.
К началу 80-х годов прошлого столетия компьютеры умели хранить и показывать цифровые изображения, однако для воплощения этого существовало множество различных решений. Например, нельзя было просто отправить изображение с одного компьютера на другой. Для решения этой проблемы в 1986 году был собран комитет экспертов со всего мира под названием «Объединённая группа экспертов по фотографии» (Joint Photographic Experts Group, JPEG). Эта группа людей и создала стандарт сжатия цифровых изображений JPEG в 1992 году, который спасает нас до сих пор.
Прежде всего давайте разберёмся, почему вообще возможно сжать изображение так, чтобы наши глаза при этом не замечали изменений, вносимых форматом в фотографию. JPEG удаляет информацию, которую человеческий глаз плохо воспринимает.
Теперь стоит поговорить о том, как устроено наше зрение. Как известно, в глазу есть два типа восприимчивых к свету клеток: палочки и колбочки (rods and cones). Палочки плохо восприимчивы к свету, но играют решающую роль для зрения в условиях низкой освещенности, в то время как колбочки имеют цветовые рецепторы. Именно они обеспечивают нашим глазам цветное зрение. В каждом глазу имеется около 100 миллионов палочек и всего лишь 6 миллионов колбочек.
Как следствие, глаз гораздо более восприимчив к изменениям в яркости изображения и менее восприимчив к изменению в цвете. Поэтому при сжатии картинки можно использовать такую хитрость: во первых, отделить цвет от яркости, во вторых, убрать немного цвета, и в таком случае никто ничего не заметит. Именно на данной хитрости и основывается первый и очень важный этап сжатия, называемый цветовой субдискредитацией.
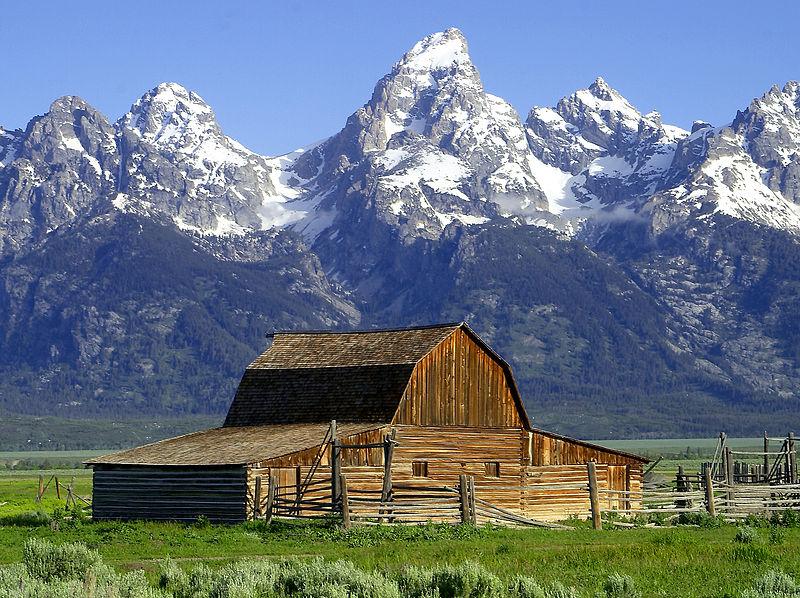
Но как именно нам отделить яркость от цвета? Как известно, каждый пиксель характеризуется тремя компонентами: R,G,B — по одной переменной для каждого цвета, которые могут принимать значения в диапазоне от 0 до 255.
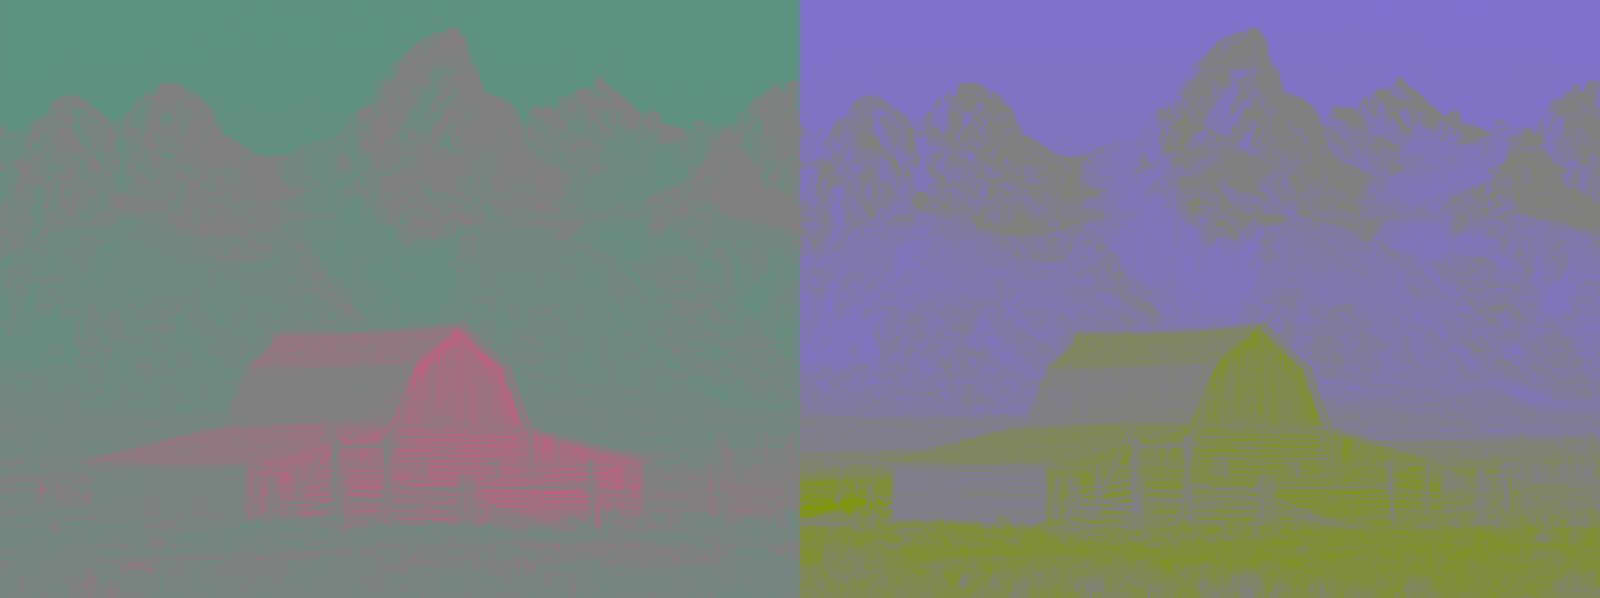
Хитрость в том, что эту же информацию мы можем сохранить, используя другие три переменные: Y, Cb, Cr. Тогда мы без проблем можем преобразовать изображение с пикселями формата RGB в новый формат с другими компонентами Y,Cb,Cr. Здесь Y отвечает за яркость, а Cb и Cr- цветовые каналы. Таким образом, вычислив эти переменные, мы получаем три новых изображения, составленных из этих трех компонент. Вычисление происходит по таким мудреным формулам, если интересно.
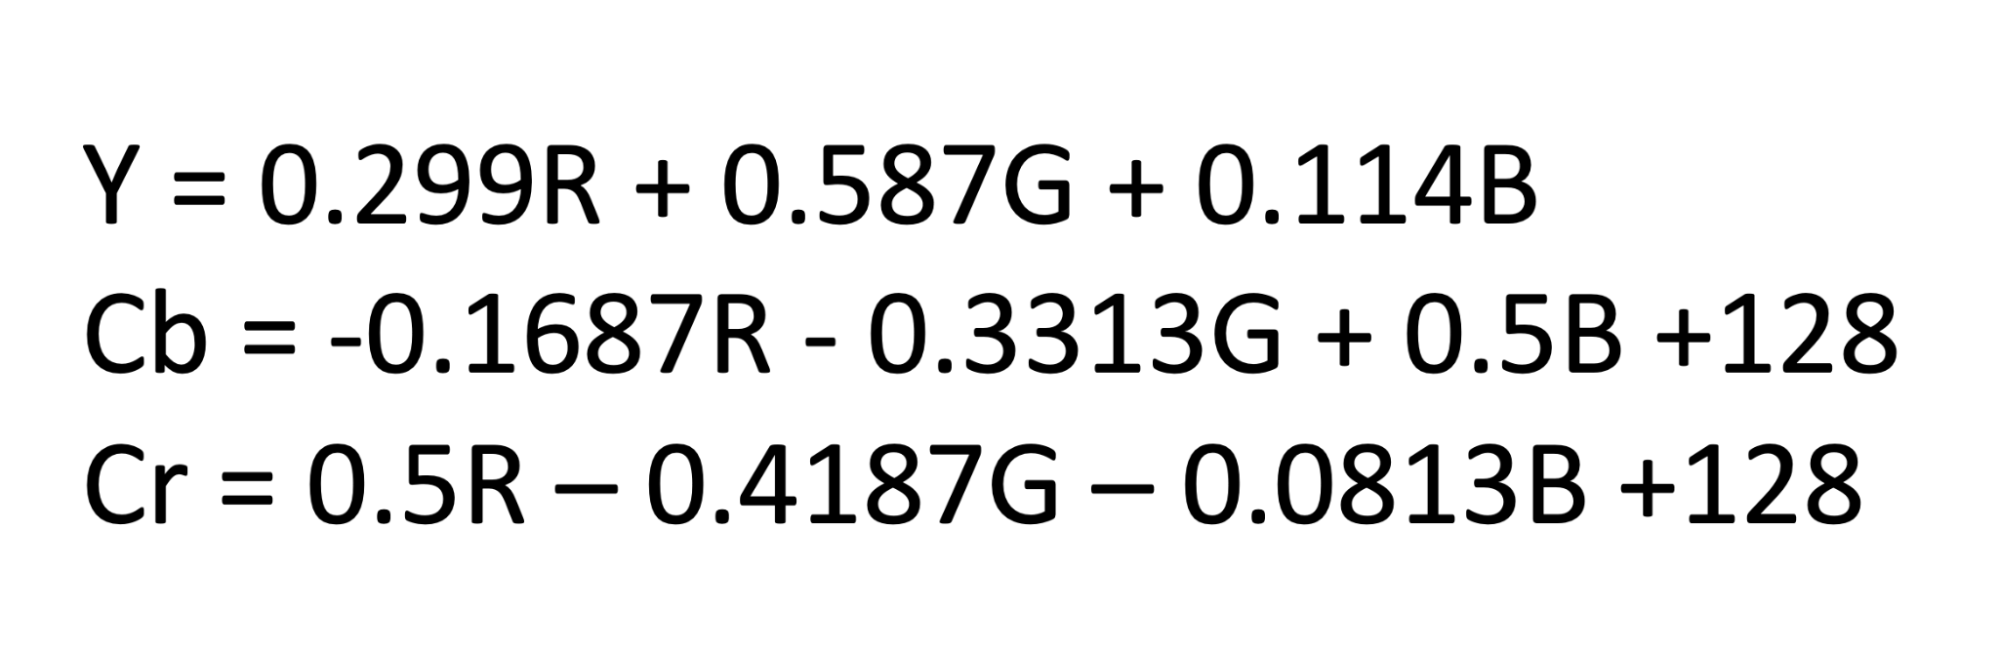
Такое разделение необходимо, чтобы дальше мы могли убрать часть деталей из цветовых каналов (составленных из Сb и Cr).Пока что никакие данные мы не удаляли, а математические преобразования из одного формата в другой являются обратимыми. Данные действия, конечно же, проделываются над всеми пикселями изображения.
Теперь мы и будем использовать особенность нашего зрения: воспринимать изменения в цвете хуже, чем изменения в яркости. Ранее мы получили из исходной картинки 2 цветовых переменных и одну яркостную.
Теперь делается еще один ход: каждые 4 пикселя в обоих цветовых изображениях объединяются в 1, тем самым удаляется повторяющаяся информация. В результате, детали, плохо воспринимаемые нашими глазами, т.е. обе цветовые составляющие (Cr и Сb), уменьшаются до ¼ своего исходного размера, а яркостная составляющая остаётся прежней. Таким образом, всего за два шага изображение становится в 2 раза меньше исходного размера
При этом если сейчас собрать эти 3 составляющие в одно исходное изображение, то невооруженным глазом разницу между оригиналом и сжатым изображением заметить будет невозможно.
Теперь выполняется подготовка к самому важному, сложному и умному этапу. Для этого каждая из 3 наших картинок, составленных из яркостного и двух цветовых каналов, разбивается на блоки пикселей 8×8. Теперь алгоритмы сжатия должны каким-то образом понять, насколько много деталей в каждом из таких блоков. Если деталей мало, то можно закодировать меньшим количеством бит, уменьшая размер файла, а если деталей много, то наоборот.
Иными словами, если бы картины в музеях хранились в джипеге, то любая картина Ван Гога занимала бы меньше места, чем черный квадрат Малевича.
Такой анализ и производится с помощью штуки со страшным названием — дискретное косинусное преобразование. Прежде, чем переходить к нему, рассмотрим такой простой пример. У нас есть разноцветные полупрозрачные стеклышки. Накладывая их друг на друга, мы можем получить тот цвет, который нам нужен, т.е., например,чтобы получить фиолетовый цвет, нужно наложить синее стеклышко на красное. Такая же ситуация и в случае с алгоритмом.
Рассмотрим один из блоков 8х8. Все последующие действия будут выполняться для каждого из таких блоков. Такой блок содержит 64 пикселя. Оказывается, что любое простое монохромное изображение можно представить в виде комбинации вот таких 64 базовых картинок.
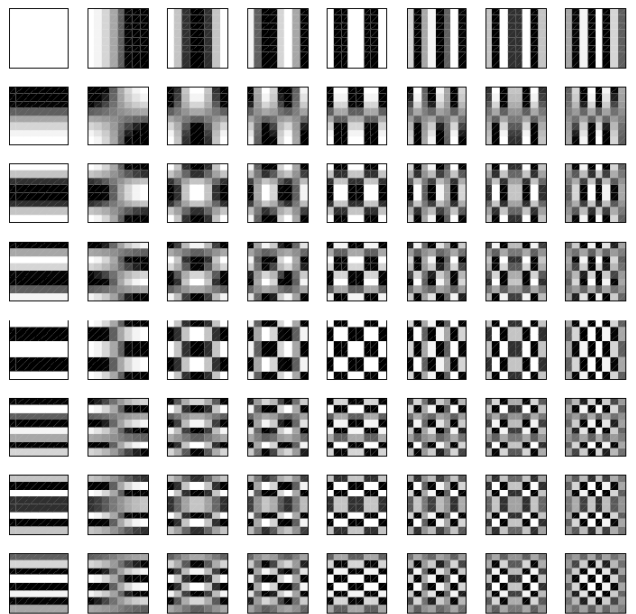
То есть, накладывая их друг на друга с разной степенью прозрачности, можно получить любую простую картинку 8х8 примерно так же, как и в примере со стеклышками.
Именно таким образом мы и можем перестроить любой наш блок 8х8 путём наложения этих базовых картинок друг на друга. При этом каждый из узоров умножается на число, являющееся показателем того, какая его часть используется при построении определенной картинки.
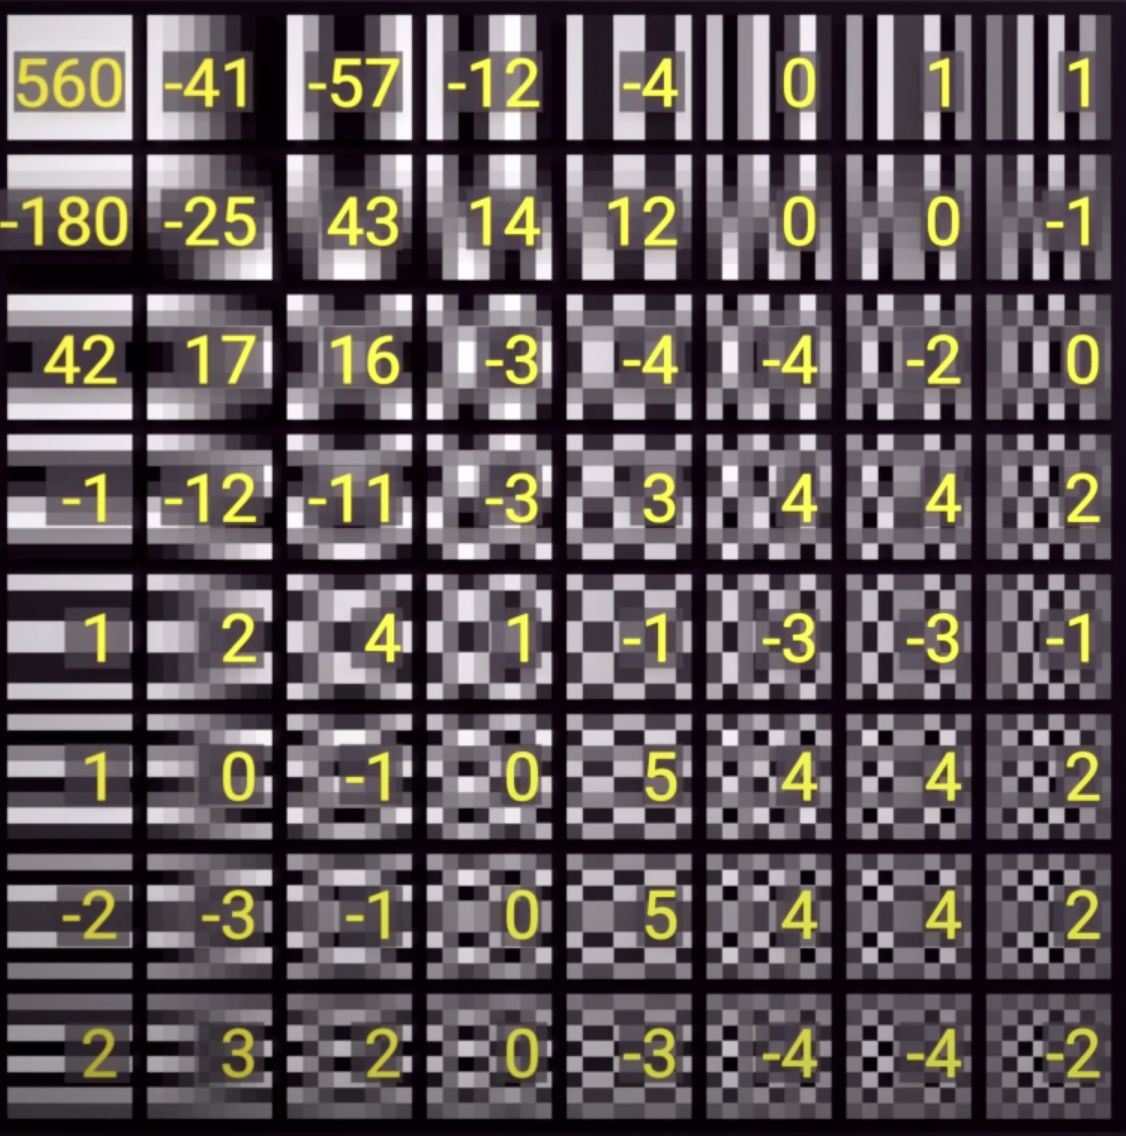
Суть алгоритма дискретного косинусного преобразования и заключается в вычислении данных чисел. На выходе получаем матрицу 8х8, состоящую из чисел, отображающих, насколько большой или не очень вклад каждого узора в данное изображение 8х8. Выглядит это примерно так. Прикольно, да?
Чем больше число, тем больший вклад базового изображения (узора), соответствующего данному числу. Коэффициенты, находящиеся в левой верхней части матрицы отвечают за плавные переходы и более общие черты, а коэффициенты, лежащие в правой нижней части- за частые переходы, т.е. за тонкие детали. Если деталей в данном блоке оказывается мало, то коэффициенты, отвечающие за них (находящиеся в правой нижней части матрицы) будут равны нулям или близким к нулю значениям. (Именно на данном этапе отбрасывается огромная часть информации, не видимой человеческим глазом.) Это важный момент запомним.
Это немного напоминает составление фоторобота: нос номер 9, рот номер 13, глаза среднее между нумером 6 и 42.
Прежде, чем идти дальше, подведем промежуточные итоги. Что мы имеем на данный момент?
У нас есть матрица из 64 чисел, содержащих информацию о том, как именно нужно использовать базовые изображения. Если не считать этап цветовой субдискредитации, то пока что мы не отбрасывали существенное количество информации, а только определяли, что нужно отбросить.
Как это делается?
Для этого этапа используется вот такая таблица. Называется таблица квантования. К квантовым компьютерам не имеет отношения. Не пугайтесь, какждется это послдений сложный термин на сегодня. Если по простому: она определяет какую часть из полученной прежде информации мы возьмем в итоговый файл. Смотрите: это матрица 8х8, содержащая коэффициенты, на которые мы делим числа из нашей исходной матрицы. Степень сжатия задаётся характеристиками таблицы квантования, т.е. чем больше коэффициенты в этой таблице, тем меньше будут числа в новой матрице. В зависимости от характеристик таблицы квантования мы можем уменьшить размер изображения до 95% от первоначального размера, но в таком случае, конечно, качество сжатого изображения будет далеко не самым высоким. Именно эта таблица и является основной настройкой jpeg, регулирующей степень сжатия.
Теперь переходим к квантованию, т.е. этапу, на котором будет производиться наибольшее сжатие. Здесь происходит сначала деление чисел из матрицы, которую мы получили на прошлом этапе, на определенные коэффициенты, соответствующие таблице квантования, а затем происходит округление полученных чисел до ближайшего целого (например: делим 560/4=140; -41/3=-13,7- округляем до целого, получаем -14 и т.д.). Но что ещё за таблица квантования и откуда она берется?
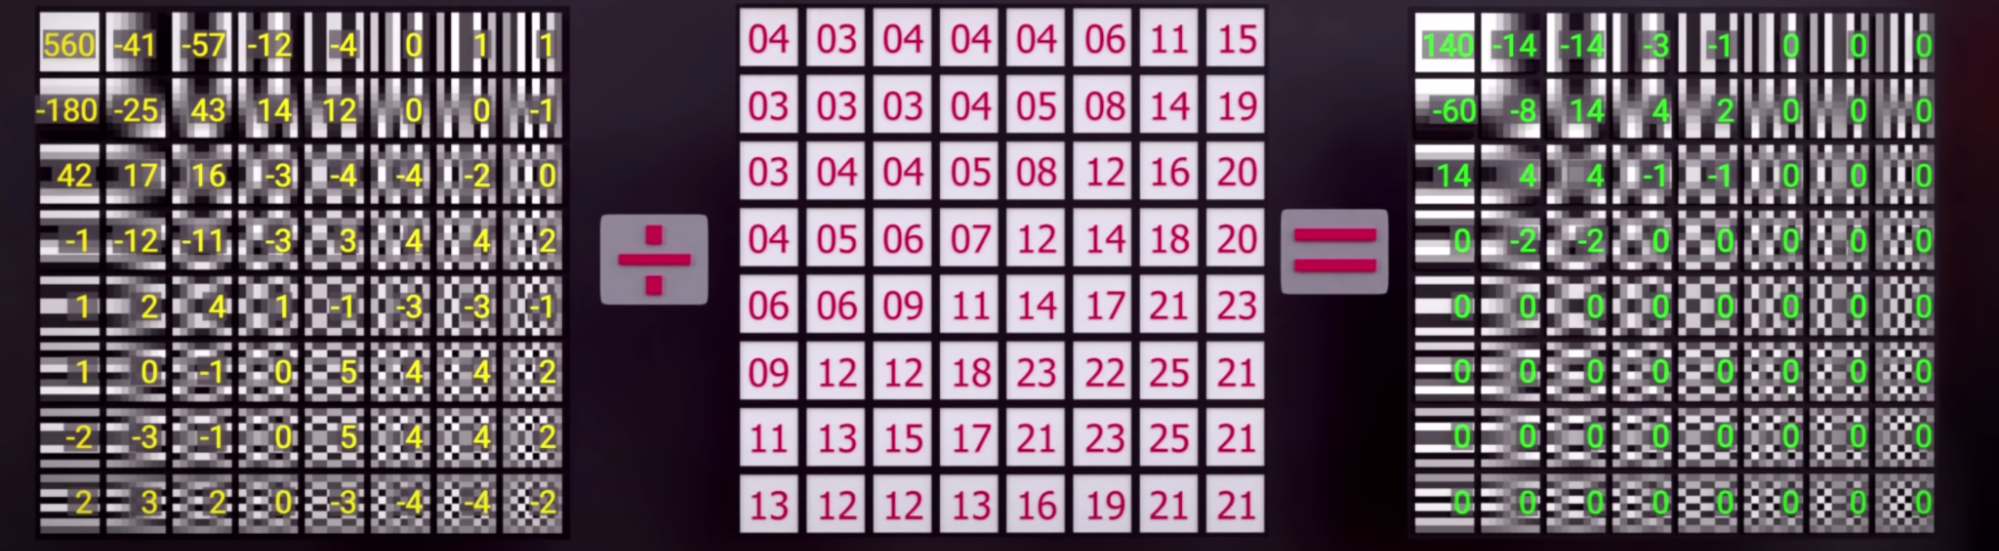
- Исходная матрица
- Таблица квантования
- Новая матрица
Если посмотреть на таблицу квантования, то можно увидеть, что самые большие числа расположены в правой нижней части таблицы. Это значит, что большего всего отбрасываются высокочастотные данные, т.е. отвечающие за те детали, которые наши глаза хуже всего воспринимают.
В результате этого процесса получается, что большая часть чисел нашей исходной матрицы стала равной нулю, так как числа, близкие к правому нижнему углу матрицы были слишком малы и после деления и округления обнулились. Остаются только числа, близкие к левому верхнему углу матрицы. На этом этапе и происходит самое существенное сжатие изображения, т.е. практически все данные, к которым наши глаза плохо восприимчивы, отбрасываются.
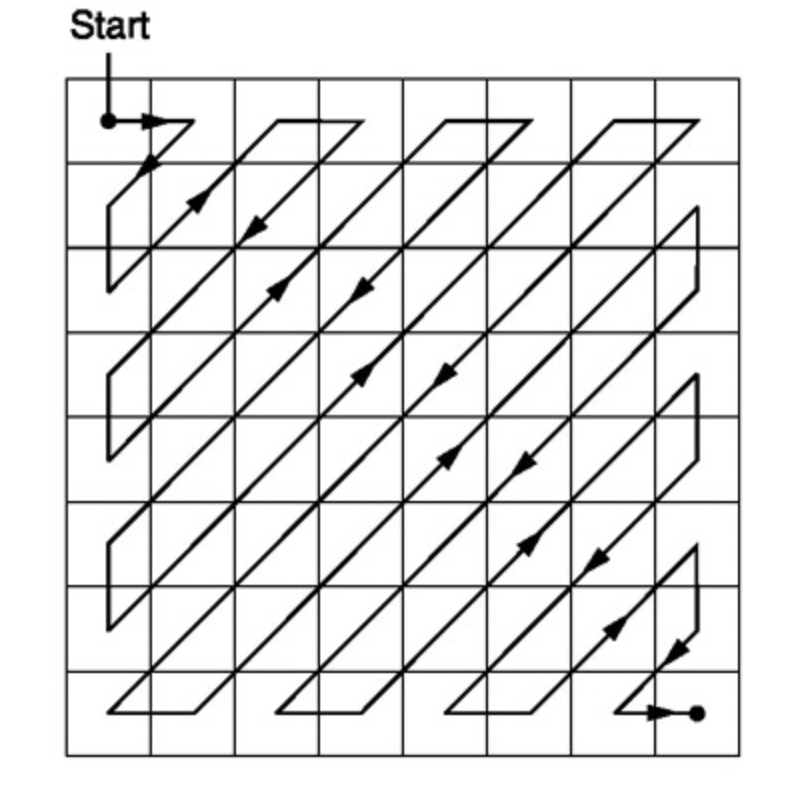
Далее используется зигзагообразное сканирование матрицы чисел, в результате чего получается числовая строка, в начале которой ненулевые значения, а в конце — нулевые.
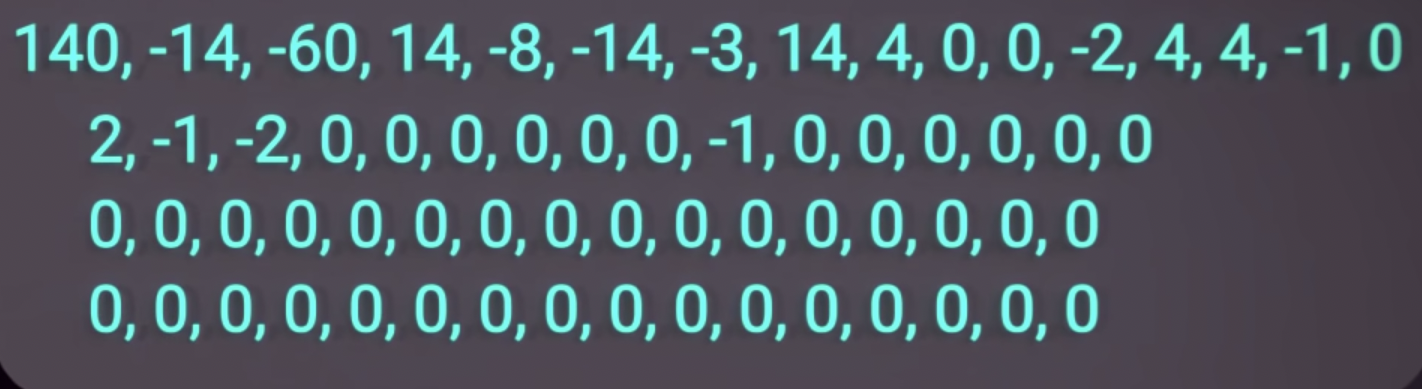
Затем вместо того, чтобы перечислять все числа строки по порядку, мы используем алгоритм кодирования длин серий, благодаря которому можно не перечислять все нули, а просто назвать их количество.
Далее уже сжатая последовательность кодируется с помощью алгоритма Хаффмана. Это достаточно сложный процесс, но если говорить кратко, то нули кодируются меньшим количеством бит, а ненулевые элементы последовательности кодируются большим количеством бит.
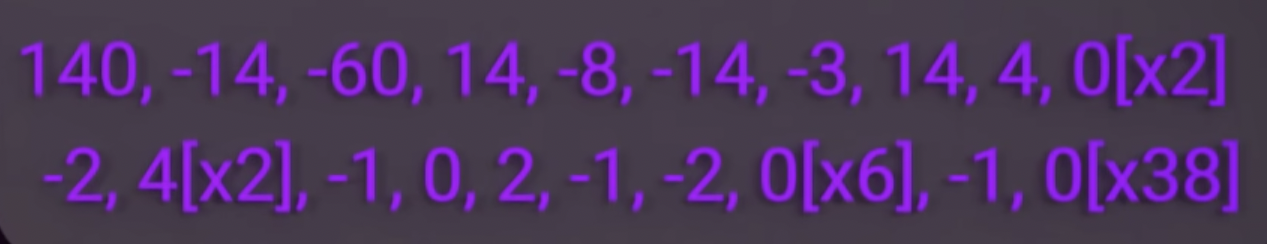
Процесс сжатия завершён. Мы получили сжатое изображение в виде последовательности чисел.
Как же теперь вывести его на экран? Для этого необходимы все те же самые действия, но уже проделанные в обратном порядке: 1. Декодирование с помощью алгоритма Хаффмана, 2. Декодирование по методу длин серий, 3. Заполнение матрицы 8х8 коэффициентами зигзагообразным методом для каждого из блоков 8х8, 4. Умножение каждого числа матрицы на соответствующий коэффициент согласно таблице квантования, 5. Масштабирование компоненты цветов, 6. Преобразование полученных значений Y, Cb и Cr для каждого пикселя в RGB и 7. Вывод изображения уже в формате JPEG на экран. Готово!
Подведём итоги. Как видите, при работе JPEG используется огромное количество нюансов: особенности строения глаза, математические методы сжатия, разложение в спектр.
Конечно, у JPEG есть достаточно большое количество недостатков: невозможность качественного сжатия текстовых изображений, ухудшение качества при повторном сохранении, но несмотря на все его многочисленные недостатки и почтенный возраст, он по сей день остаётся самым популярным форматом изображений в интернете, хотя сейчас ему на смену начали приходить другие, гораздо более продвинутые форматы, такие как HEIC, AV1, WebP и другие. Причины популярности JPEG в настоящее время, конечно, есть: он очень хорошо изучен за 30 лет существования, является бесплатным, а также всем понятен и привычен.
Какой метод сжатия использует алгоритм jpeg
Исследования алгоритмов сжатия данных, начавшись в 50 годы прошлого века, остаются сегодня одной из актуальных областей информатики. Цель фундаментальных исследований в этой области состоит в разработке стандартов сжатия информации для использования в различных устройствах и приложениях. Алгоритмы сжатия информации применяются для сокращения избыточности данных и применяются при хранении информации, передаче данных по сетям связи и обработке мультимедиа данных (графики и видео). В тестах на производительность компьютерных систем в качестве одного из критерия выступает время архивирования определенного объема данных или кодирования видео из одного формата в другой.
Первые алгоритмы сжатия информации (например, алгоритм Хаффмана), разрабатывались в 50-х годах XX века. Основой для практического применения является работа Клода Шеннона (одного из ученых, внесших вклад в развитие теории информации) по математическим основам теории связи (1948). В результате исследований в области сжатия информации сегодня известно большое количество алгоритмов сжатия данных; аппарат теории сжатия информации применяется кроме архивирования данных в других областях, например обработке изображений и разработке устройств безопасности и видеонаблюдения. Первыми стали разрабатываться алгоритмы сжатия текстовых данных (например, алгоритм Хаффмана в 1952 году и алгоритм LZ-77 в 1977 году). Примерно тогда же начали появляться и первые устройства для хранения данных. В процессе развития средств вычислительной техники, полученные результаты стали применяться и при разработке подходов к сжатию информации других типов, потому что поняли, что для каждого типа информации необходимо применять разные подходы к кодированию текста, звука изображений и видео.
Кратко рассмотрим эволюцию ключевых подходов к сжатию изображений: стандарта JPEG, фрактального сжатия и сжатия с использованием вейвлет-преобразований.
Комитет JPEG (объединенная группа экспертов по обработке изображений) был сформирован в 1986 году. Результатом работы комитета является стандарт сжатия графических изображений JPEG, разработанный, в том числе и при содействии международного консультативного комитета по телеграфии и телефонии. Благодаря этому стало возможным появление цифровых фотоаппаратов (алгоритм симметричен, то есть время кодирования равно времени декодированию), сохранять свои снимки с приемлемым качеством. Алгоритмы сжатия JPEG применяются в различных случаях (кроме сжатия информации), например фотографии на веб-страницах размещаются в формате JPEG. Но из-за того, что при задании высоких значений параметров сжатия (коэффициента квантования и качества кодирования) увеличиваются потери в кодировании.
Примерно в тоже время проводились разработки алгоритмов фрактального кодирования. Основателем теории фракталов считают французского и американского математика Бенуа Мандельброта. Математические основы разрабатывались Джоном Хатчинсоном (теория систем итерируемых функций и использование аффинных преобразований для построения геометрических фракталов). Метод сжатия, основанный на передаче в файл коэффициентов преобразований вместо кодирования изображения в явном виде, стал известен благодаря работам Майкла Барнсли (разработавшего основы фрактального метода), Ювала Фишера (предложившего способ кодирования с использованием метода квадродерева). Основополагающие теоремы (теорема коллажа и теорема о сжимающих отображениях) были сформулированы в 1987 году, метод сжатия разработан и запатентован в 1993 году. На практике фракталы (кроме сжатия изображения) применяются при создании фрактальных антенн, исследовании процессов, протекающих в атмосфере Земли и информационном пространстве.
Как в нашей стране, так и за рубежом (Waterloo Fractal Coding and Analysis Group) создаются научные сообщества и объединения, целью которых является исследование и разработка новых подходов к сжатию информации.
Еще один подход к сжатию изображений – сжатие на основе вейвлет-преобразований. Функции типа «маленькой волны» (другое название вейвлетов) возникли давно и применялись при исследовании функциональных пространств[2]. Практическое применение вейвлеты получили в последние десятилетия и используются в обработке сигналов и изображений[3]. Это направление исследований является сегодня одним из популярных (наряду с изучением алгоритмов фрактального кодирования). Теория вейвлет-преобразований использует достаточно сложный математический аппарат, в частности технику рядов Фурье и преобразование Фурье (алгоритм JPEG использует дискретное косинусное преобразование, являющееся модификацией преобразования Фурье). Известны вейвлеты Добеши, Хаара, Мейра, Котельникова-Шеннона и другие. При сжатии изображений с использованием теории вейвлетов используется дискретное преобразование Фурье (ДПФ), а для анализа сигналов – непрерывное преобразование Фурье (НПФ). ДПФ используется в стандарте сжатия графических изображений JPEG-2000.
Можно отметить работы Д.С.Ватолина, А.Ратушняка, М.Смирнова, В.Юкина, Д.Шкарина. Алгоритмы сжатия графики и аспектов компьютерной графики изучаются в технологических институтах и университетах, курсы Массачусетского технологического института, Вашингтонского университета и других. В некоторых странах изучение технологических дисциплин (в том числе и фундаментальных дисциплин, относящихся к области обработки информации) поддерживается программами, разработанными правительствами государств. Обратим внимание на национальную программу расширенного обучения, поддерживаемую министерством развития человеческих ресурсов Индии (The Ministry of Human Resource Development). В реализации программы участвуют технологические институты в разных городах Индии.
Анализ исторического пути развития подходов к сжатию графики, образовательных программ вузов подтверждает актуальность выбранной темы исследования — «Методическая система обучения алгоритмам сжатия мультимедиа данных в условиях непрерывного обучения» и необходимость обучения алгоритмам сжатия данных не только в технических, но и в педагогических вузах[1].
1. Мокрый В.Ю. Технология обучения магистров алгоритмам сжатия мультимедиа данных// в сб. материалов конференции «Новые образовательные стратегии в современном информационном пространстве». РГПУ имени А.И.Герцена, 2011.
2. Смоленцев И.К. Основы теории вейвлетов. Вейвлеты в MATLAB. – М.:ДМК Пресс, 2008.
3. Штарк Г.-Г. Применение вейвлетов для ЦОС. Москва: техносфера, 2007. – 192 с. ISBN 978-5-94836-108-6.
Эффективные методы оптимизации алгоритмы сжатия изображений Текст научной статьи по специальности «Компьютерные и информационные науки»
Аннотация научной статьи по компьютерным и информационным наукам, автор научной работы — Ташманов Е.Б.
В работе рассматриваются алгоритмы эффективного кодирования изображений . Приведены основные методы оптимизации алгоритмы сжатия изображения .
i Надоели баннеры? Вы всегда можете отключить рекламу.
Похожие темы научных работ по компьютерным и информационным наукам , автор научной работы — Ташманов Е.Б.
Контурная информация при сжатии полутоновых изображений
Об иерархическом кодировании в цифровой системе видеонаблюдения
Оценка эффективности стеганографического скрытия цифровых водяных знаков в видеопоследовательностях за счет дифференциальной разности энергий областей изображения
Использование wavelet2преобразования в алгоритме сжатия изображения JPEG
Методы сжатия спектра телевизионных сигналов изображения
i Не можете найти то, что вам нужно? Попробуйте сервис подбора литературы.
i Надоели баннеры? Вы всегда можете отключить рекламу.
Текст научной работы на тему «Эффективные методы оптимизации алгоритмы сжатия изображений»
Стажер-соискатель — исследователь, Ташкентский университет информационных технологий,
ЭФФЕКТИВНЫЕ МЕТОДЫ ОПТИМИЗАЦИИ АЛГОРИТМЫ СЖАТИЯ
В работе рассматриваются алгоритмы эффективного кодирования изображений. Приведены основные методы оптимизации алгоритмы сжатия изображения.
Ключевые слова: Изображение, сжатия, кодирования, декодирования, яркость.
Keywords: Image, compression, coding, decoding, brightness.
Под сжатием цифрового изображения понимают сопоставление ему такого набора данных, количество единиц информации, для представления которого будет меньше, чем для представления исходного изображения. Операция преобразования набора данных,
представляющих сжатое изображение, в новое изображение называется восстановлением. Если в результате последовательного выполнения сжатие и восстановления восстановленное изображения совпадают исходным, то метод, реализующий этот процесс, называется сжатием без потерь информации, в противном случае метод называется сжатием с потерями информации.
Задача сжатия в цифровой обработке изображений возникла вместе с развитием вычислительной техники и средств связи в 60-е года 20 века. В настоящее время сжатие изображений играет существенную роль во многих разнообразных и важных областях, таких, как дистанционный зондирование Земли использование изображений. Получаемых со спутников, для прогноза погоды и изучения земных ресурсов, обработка медицинских изображений, факсимильная передача, управления беспилотными летательными аппаратами, цифровая фотография и многих других [1].
2. Сжатие изображений
Изображения являются своеобразным типом данных и могут быть охарактеризованы следующими особенностями. 1) Изображения обычно требует для хранения и передачи гораздо большего объема памяти, чем текст. 2) Человеческое зрение при анализе изображения оперирует контурами, общим переходом цветов и сравнительно нечувствительно к малым изменениям в изображении. Данная особенность позволила создать алгоритмы сжатия, ориентированные только на изображения. 3) Изображение в отличие, например, от текста обладает избыточностью в двух измерениях. Таким образом, при создании алгоритма компрессии графики можно использовать особенности структуры изображения.
Сжатие изображений становится возможным в силу наличия избыточности данных, которую можно разделить на три типа: межэлементная избыточность, визуальная
избыточность, кодовая избыточность[2].
Межэлементная избыточность возникает вследствие того, что в естественных изображениях имеет место сильная межэлементная корреляция, которая является следствием структурных или геометрических взаимосвязей между объектами на изображении. В силу этого, значение любого элемента изображения может быть достаточно точно предсказано по значениям его соседей, следовательно, информация, содержащаяся в отдельном элементе, оказывается относительно малой. Для уменьшения данного вида избыточности выполняется такое преобразование исходного набора данных, что межэлементная корреляция становится меньше.
© Ташманов Е.Б., 2015 г.
Визуальная избыточность является следствием психофизических характеристик зрения человека, связанных с тем, что глаз воспринимает не количественное значение яркости элементов изображения, а фиксирует особенности изображений, такие как текстуры или контуры. Присутствие визуальной избыточности позволяет, например, затрачивать меньшее количество единиц информации на представления однородных областей изображения, увеличивая за счет этого количество единиц информации на представления деталей.
Основанием для сокращения кодовой избыточности является то, что распределение уровней яркости в естественном изображении неравнономерно. Максимальное количество единиц информации, необходимых для представления изображения, получается в том случае, если каждому значению яркости присваивать код равной длины. Однако если учитывать знания о вероятностях появления уровней яркости, можно сократить среднее количество бит на представление каждого значения, используя неравномерное кодировании , присваивающее менее вероятным событием коды большей длины.
Суммируя сказанное выше, можно утверждать, что в основе современных методов сжатия изображений лежат следующие идеи:
— выполнение дискретного преобразования элементов изображения для снижения межэлементной избыточности;
— квантование коэффициентов преобразования для снижения визуальной избыточности;
— статистическое кодирование проквантованных значений для снижения кодовой избыточности.
Самый распространенный в настоящее время метод сжатия изображений с потерями, называемый ШЕО, основан на квантовании и статистическом кодировании коэффициентов дискретного косинусного преобразования (ДКП). Популярность метода ДРЕС обусловлена сравнительной простотой реализации, разработкой стандарта, а также многочисленными исследованиями в области оптимизации его основных этапов. Несмотря на то, что, начиная с 1990-х годов, активно развиваются методы сжатия изображений на основе вейвлетпреобразований, разработанный на базе этой группы преобразований стандарт ДРЕС 2000 до сих пор не стал общепринятым. Одна из причин этого заключается в вычислительной сложности реализации ДРЕС 2000, в том числе и аппаратной.
Сокращения сложности вычислений можно достичь за счет уменьшения количества операций умножения при вычислении преобразования, лежащего в основе метода сжатия. Быстрые алгоритмы дискретного косинусного и вейвлет-преобразований предоставляют такую возможность, однако достигнутый результат оказывается недостаточным для некоторых задач, в частности, при необходимости обработки большого количества изображений за короткий промежуток времени, как, например, в задаче дистанционного зондирования Земли. Кроме того, в последнее время повсеместно используются мобильные телефоны, карманные компьютеры и коммуникаторы, то есть такие устройства, где аппаратные ресурсы ограничены, и, вместе с тем, требуется хранение и обработка фотографий.
В указанных приложениях для сжатия изображений можно использовать известные дискретные преобразования, позволяющие проводить вычисления без использования операций умножения (например, дискретное преобразование Уолша-Адамара), но методы на их основе могут не обеспечивать желаемой эффективности. Здесь и далее под эффективностью метода сжатия подразумевается соотношение среднеквадратичной ошибки восстановления и степени сжатия изображения.
При исследовании применения различных дискретных преобразований к сжатию изображений было рассмотрено дискретное псевдокосинусное преобразование (ДПКП), допускающее вычисление без использования операций умножения. Изучение свойств этого преобразования выявило его потенциал для построения метода сжатия, который при меньших вычислительных затратах позволял бы достигнуть эффективности сжатия, сравнимой с эффективностью сжатия по методу ДРЕС.
Группой экспертов в области фотографии в 1991 г. был утвержден стандарт сжатия JPEG, учитывающий все выше перечисленные особенности сжимаемых данных. На настоящий
момент, по некоторым оценкам, до 80 % изображений в мультимедийных базах данных представлены именно в формате JPEG или производных от него [3].
3. Основные этапы кодирования алгоритма JPEG
Рассмотрим основные этапы кодирования алгоритма JPEG применительно к полутоновому изображению формата b mp, где каждый пиксель яркостью[0:255] кодируется восьмью битами. 1) Исходное изображение разбивается на матрицы (блоки) 8х8. 2) К каждому из блоков применяется двумерное дискретное косинусное преобразование (ДКП). При этом получается матрица, в которой коэффициенты в левом верхнем углу соответствуют низкочастотной составляющей изображения, а в правом нижнем — высокочастотной. Понятие частоты следует из рассмотрения изображения как двумерного сигнала. Плавное изменение цвета соответствует низкочастотной составляющей, а резкие скачки — высокочастотной. 3) Квантование — производится путем поэлементного деления рабочей матрицы ( Y[u, v] ) на матрицу квантования ( q[u, v]).
Yq[u, v] = IntegerRound (Y [u v])
На этом шаге осуществляется управление степенью сжатия, и происходят большие потери. 4) Матрица 8х8 проквантованных спектральных коэффициентов переводится в 64-элементный вектор при помощи так называемого «зигзаг»-сканирования. В итоге в начале вектора мы получаем коэффициенты матрицы, соответствующие низким частотам, а в конце -высоким. 5) Полученный вектор сворачивается с помощью алгоритма кодирования серий (RLE). 6) Результаты п. 5 переводятся в цифровой поток кодированием Хаффмана с фиксированной таблицей.
В ряде источников считается, что алгоритм JPEG является оптимальным в случае сжатия изображения с заранее неизвестной сценой. Но если сцена предопределена, то алгоритм можно настроить и изменить, получив тем самым выигрыш в сжатии [4].
Оптимальные методы кодирования изображений формализованы в основном для стационарных сигналов, и их разработка была нацелена, в первую очередь, на повышение эффективности использования канала связи. Вместе с тем, для создания автономных малогабаритных систем формирования и передачи изображений например, беспилотных летательных аппаратов, актуальна другая цель — обеспечение эффективности использования кодера источника, сложность которого постоянно возрастает. Для корректной оценки работы кодера непрерывного нестационарного источника важно учесть не только ошибку передачи и скорость передачи полезной информации, но и затраты на сложность кодера, которая в конечном счёте влияет на массу аппаратуры.
Существующие кодеры источников непрерывных изображений на основе «быстрых» алгоритмов с использованием технологии систем на кристалле и видеосистем на кристалле оптимизируются на основе принципа декомпозиции. Однако имеется потребность в обосновании оптимальности сложной системы кодирования видеоинформации, а не оптимальности подсистем, её составляющих.
1. Гонсалес Р., Вудс Р. Цифровая обработка изображений. — М., Техносфера, 2005. — 1072 с.
2. Беляев Е.А., Тюрликов А.М. Управление скоростью и ошибкой кодирования в системе сжатия и передачи видеоинформации с ограничениями на память передающего и принимающего устройств// Компьютерная оптика. Москва.-2007.-№2.- С.69-76.
3. Ташманов Е.Б. Управление скоростью кодирования видеоинформации передачи данных в системах мобильной связи // Информационные технологии и проблемы телекоммуникаций. Сборник научных трудов научно-технической конференции. Ташкент.-2011.- С. 182-183.
4. Самарский А.А., Николаев Е.С. Методы решения сеточных уравнений. — М.: Наука, 1978. — 570 с.
5. Дорогов А.Ю., Курбанов Р.Г., Разин В.В.. Быстродействующий алгоритм семантической классификации JPEG-изображений // СПбГЭТУ, 2006.