Структуры данных
Связный список (Linked List) представляет набор связанных узлов, каждый из которых хранит собственно данные и ссылку на следующий узел. В реальной жизни связный список можно представить в виде поезда, каждый вагон которого может содержать некоторый груз или пассажиров и при этом может быть связан с другим вагоном.
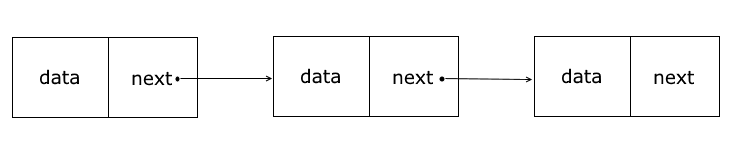
Таким образом, если в массиве положение элементов определяется индексами, то в связном списке — указателями на следующий и (или) на предыдущий элемент.
Связные списки могут различаться. Есть односвязные списки, в которых каждый узел хранит указатель только на следующий узел. Есть двусвязные списки: в них каждый элемент хранит ссылку как на следующий элемент, так и на предыдущий. Есть кольцевые замкнутые списки. В данном случае мы рассмотрим создание односвязного списка.
Перед созданием списка нам надо определить класс узла, который будет представлять одиночный объект в списке:
public class Node < public Node(T data) < Data = data; >public T Data < get; set; >public Node? Next < get; set; >>
Класс Node является обобщенным, поэтому может хранить данные любого типа. Для хранения данных предназначено свойство Data . Для ссылки на следующий узел определено свойство Next .
Далее определим сам класс списка:
using System.Collections; using System.Collections.Generic; public class LinkedList : IEnumerable // односвязный список < Node? head; // головной/первый элемент Node? tail; // последний/хвостовой элемент int count; // количество элементов в списке // добавление элемента public void Add(T data) < Nodenode = new Node(data); if (head == null) head = node; else tail!.Next = node; tail = node; count++; > // удаление элемента public bool Remove(T data) < Node? current = head; Node? previous = null; while (current != null && current.Data != null) < if (current.Data.Equals(data)) < // Если узел в середине или в конце if (previous != null) < // убираем узел current, теперь previous ссылается не на current, а на current.Next previous.Next = current.Next; // Если current.Next не установлен, значит узел последний, // изменяем переменную tail if (current.Next == null) tail = previous; >else < // если удаляется первый элемент // переустанавливаем значение head head = head?.Next; // если после удаления список пуст, сбрасываем tail if (head == null) tail = null; >count--; return true; > previous = current; current = current.Next; > return false; > public int Count < get < return count; >> public bool IsEmpty < get < return count == 0; >> // очистка списка public void Clear() < head = null; tail = null; count = 0; >// содержит ли список элемент public bool Contains(T data) < Node? current = head; while (current != null && current.Data !=null) < if (current.Data.Equals(data)) return true; current = current.Next; >return false; > // добвление в начало public void AppendFirst(T data) < Nodenode = new Node(data); node.Next = head; head = node; if (count == 0) tail = head; count++; > IEnumerator IEnumerable.GetEnumerator() < Node? current = head; while (current != null) < yield return current.Data; current = current.Next; >> // реализация интерфейса IEnumerable IEnumerator IEnumerable.GetEnumerator() < return ((IEnumerable)this).GetEnumerator(); > >
Разберем основные моменты. В зависимости от конкретных задач реализация списков может отличаться, но для всех реализаций характерны прежде всего два метода: добавление и удаление.
Но прежде чем выполнять различные операции с данными, в классе списка определяются три переменные:
Node? head; // головной/первый элемент Node? tail; // последний/хвостовой элемент int count; // количество элементов в списке
public void Add(T data) < Nodenode = new Node(data); if (head == null) head = node; else tail!.Next = node; tail = node; count++; >
Если у нас не установлена переменная head (то есть список пуст), то устанавливаем head и tail. После добавления первого элемента они будут указывать на один и тот же объект.
Если же в списке есть как минимум один элемент, то устанавливаем свойство tail.Next — теперь оно хранит ссылку на новый узел. И переустанавливаем tail — теперь она ссылается на новый узел.
Сложность данного метода составляет O(1) . Графически это выглядит так:
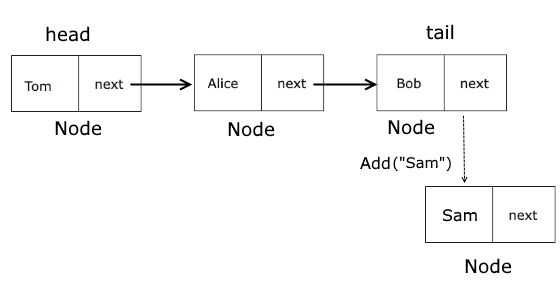
Важно отметить наличие переменной tail, которая указывает на последний элемент. Ряд реализаций не используют подобную переменную и добавляют иным образом:
public void AddWithoutTail(T data) < Nodenode = new Node(data); if (head == null) < head = node; >else < Nodecurrent = head; // ищем последний элемент while (current.Next!=null) < current = current.Next; >//устанавливаем последний элемент current.Next = node; > count++; >
Данный способ вполне рабочий и нередко встречается, однако необходимость перебора элементов для нахождения последнего увеличивает время на поиск и сложность алгоритма. Она равна O(n) .
Особняком стоит метод добавления в начало списка, где нам достаточно переустановить ссылку на головной элемент:
public void AppendFirst(T data) < Nodenode = new Node(data); node.Next = head; head = node; if (count == 0) tail = head; count++; >
public bool Remove(T data) < Node? current = head; Node? previous = null; while (current != null && current.Data != null) < if (current.Data.Equals(data)) < // Если узел в середине или в конце if (previous != null) < // убираем узел current, теперь previous ссылается не на current, а на current.Next previous.Next = current.Next; // Если current.Next не установлен, значит узел последний, // изменяем переменную tail if (current.Next == null) tail = previous; >else < // если удаляется первый элемент // переустанавливаем значение head head = head?.Next; // если после удаления список пуст, сбрасываем tail if (head == null) tail = null; >count--; return true; > previous = current; current = current.Next; > return false; >
Алгоритм удаления элемента представляет следующую последовательность шагов:
- Поиск элемента в списке путем перебора всех элементов
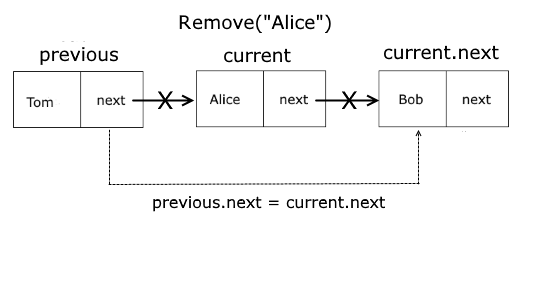
- Установка свойства Next у предыдущего узла (по отношению к удаляемому) на следующий узел по отношению к удаляемому.
Для отслеживания предыдущего узла применяется переменная previous . Если элемент найден, и переменная previous равна null, то удаление идет сначала, и в этом случае происходит переустановка переменной head, то есть головного элемента.
Если же previous не равна null, то реализуются шаги выше описанного алгоритма.
Сложность такого алгоритма составляет O(n) . Графически удаление можно представить так:
Чтобы проверить наличие элемента, исползуется метод Contains:
public bool Contains(T data) < Node? current = head; while (current != null && current.Data !=null) < if (current.Data.Equals(data)) return true; current = current.Next; >return false; >
Здесь опять же просто осуществляется перебор. Сложность алгоритма метода составляет O(n) .
И для того, чтобы список можно было бы перебрать во внешней прграмме с помощью цикла for-each, класс списка реализует интерфейс IEnumerable :
// реализация интерфейса IEnumerable IEnumerator IEnumerable.GetEnumerator() < return ((IEnumerable)this).GetEnumerator(); > IEnumerator IEnumerable.GetEnumerator() < Node? current = head; while (current != null) < yield return current.Data; current = current.Next; >>
Реализация данного интерфейса не является неотъемлимой частью односвязных списков, однако предоставляет эффективный метод для перебора коллекции в цикле foreach. Иначе нам бы пришлось реализовать какие-то собственные конструкции по перебору списка.
LinkedList linkedList = new LinkedList < // добавление элементов "Tom", "Alice", "Bob", "Sam" >; // выводим элементы foreach (var item in linkedList) < Console.WriteLine(item); >// удаляем элемент linkedList.Remove("Alice"); Console.WriteLine("\nПосле удаления Alice"); foreach (var item in linkedList) Console.WriteLine(item); // проверяем наличие элемента bool isPresent = linkedList.Contains("Sam"); Console.WriteLine(isPresent ? "Sam присутствует" : "Sam отсутствует"); // добавляем элемент в начало linkedList.AppendFirst("Bill"); Console.WriteLine("\nПосле добавления Billa"); foreach (var item in linkedList) Console.WriteLine(item);
Tom Alice Bob Sam После удаления Alice Tom Bob Sam Sam присутствует После добавления Billa Bill Tom Bob Sam
Node c что это
Что такое Node.js?
Node.js (или просто Node) — это серверная платформа для работы с JavaScript через движок V8. JavaScript выполняет действие на стороне клиента, а Node — на сервере. С помощью Node можно писать полноценные приложения. Node умеет работать с внешними библиотеками, вызывать команды из кода на JavaScript и выполнять роль веб-сервера.
В чём преимущество Node?
C Node проще масштабироваться. При одновременном подключении к серверу тысяч пользователей Node работает асинхронно, то есть ставит приоритеты и распределяет ресурсы грамотнее. Java же, например, выделяет на каждое подключение отдельный поток.
Откуда Node вообще взялся?
Node появился в 2009 году благодаря Райану Далу. До этого в серверах царил подход «один поток на каждое соединение», а Дал придумал использовать систему, которая ориентирована на события. То есть реагирует на действие или бездействие и выделяет под это ресурс. Главная цель Node — построение масштабируемых сетевых серверов.
Кто-то из крупных компаний использует Node?
Конечно, вот неполный список:
eBay постепенно переходит на Node, как и веб-версия PayPal. В LinkedIn ещё в 2012 году переехали с Ruby On Rails на Node и сразу ощутили преимущества этой платформы: 27 серверов показали 20-кратное увеличение скорости работы.
Что я могу написать на Node?
Полноценную программу для веба, Linux, OS X и Windows.
А если подробнее?
Не вопрос. Node удобен для создания API — уже существуют удобные библиотеки вроде Loopback.
На этом языке можно писать кроссплатформенные приложения — в связке мобильный + десктоп Node помогает достигать синхронности. Например, когда вы пишете сообщение с телефона, оно сразу же появляется и на ноутбуке, и в вебе.
А что-нибудь модное Node умеет?
Конечно. Node — это родной дом всего «интернета вещей» (Internet of Things, IoT). Термостаты, фитнес-трекеры — всё это можно запрограммировать через Node.
Node случайно не теряет популярность?
Совсем наоборот. Вот график интереса к Node с 2009 года в поиске Google:
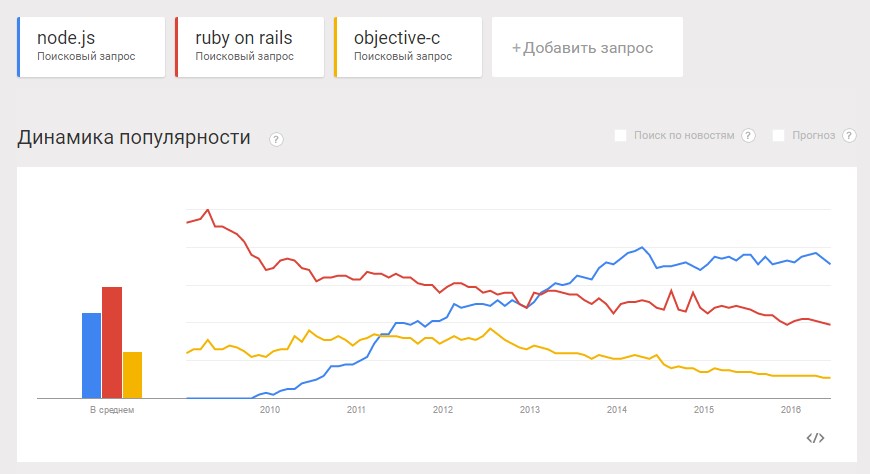
Интерес к Node стремительно растёт и уже обходит по этому показателю Ruby и Objective-C.
Убедили, хочу выучить Node. Что для этого нужно знать?
Перед тем, как осваивать Node, нужно знать JavaScript и в общих чертах понимать, как устроен клиент и сервер. Node — платформа для full-stack программистов, то есть для тех, кто может сделать приложение сам, а не специализируется на какой-то его части.
Односвязный список
О дносвязный список – структура данных, в которой каждый элемент (узел) хранит информацию, а также ссылку на следующий элемент. Последний элемент списка ссылается на NULL.
Для нас односвязный список полезен тем, что
- 1) Он очень просто устроен и все алгоритмы интуитивно понятны
- 2) Односвязный список – хорошее упражнение для работы с указателями
- 3) Его очень просто визаулизировать, это позволяет «в картинках» объяснить алгоритм
- 4) Несмотря на свою простоту, односвязные списки часто используются в программировании, так что это не пустое упражнение.
- 5) Эта структуру данных можно определить рекурсивно, и она часто используется в рекурсивных алгоритмах.
Для простоты рассмотрим односвязный список, который хранит целочисленное значение.
Односвязный список
Односвязный список состоит из узлов. Каждый узел содержит значение и указатель на следующий узел, поэтому представим его в качестве структуры
typedef struct Node < int value; struct Node *next; >Node;
Чтобы не писать каждый раз struct мы определили новый тип.
Теперь наша задача написать функцию, которая бы собирала список из значений, которые мы ей передаём. Стандартное имя функции – push, она должна получать в качестве аргумента значение, которое вставит в список. Новое значение будет вставляться в начало списка. Каждый новый элемент списка мы должны создавать на куче. Следовательно, нам будет удобно иметь один указатель на первый элемент списка.
Node *head = NULL;
Вначале списка нет и указатель ссылается на NULL.
Для добавления нового узла необходимо
- 1) Выделить под него память.
- 2) Задать ему значение
- 3) Сделать так, чтобы он ссылался на предыдущий элемент (или на NULL, если его не было)
- 4) Перекинуть указатель head на новый узел.
1) Создаём новый узел
Создали новый узел, на который ссылается локальная переменная tmp
2) Присваиваем ему значение
Присвоили ему значение
3) Присваиваем указателю tmp адрес предыдущего узла
Перекинули указатель tmp на предыдущий узел
4) Присваиваем указателю head адрес нового узла
Перекинули указатель head на вновь созданный узел tmp
5) После выхода из функции переменная tmp будет уничтожена. Получим список, в который будет вставлен новый элемент.
Новый узел добавлен
void push(Node **head, int data) < Node *tmp = (Node*) malloc(sizeof(Node)); tmp->value = data; tmp->next = (*head); (*head) = tmp; >
Так как указатель head изменяется, то необходимо передавать указатель на указатель.
Теперь напишем функцию pop: она удаляет элемент, на который указывает head и возвращает его значение.
Если мы перекинем указатель head на следующий элемент, то мы потеряем адрес первого и не сможем его удалить и тем более вернуть его значения. Для этого необходимо сначала создать локальную переменную, которая будет хранить адрес первого элемента
Локальная переменная хранит адрес первого узла
Уже после этого можно удалить первый элемент и вернуть его значение
Перекинули указатель head на следующий элемент и удалили узел
int pop(Node **head) < Node* prev = NULL; int val; if (head == NULL) < exit(-1); >prev = (*head); val = prev->value; (*head) = (*head)->next; free(prev); return val; >
Не забываем, что необходимо проверить на NULL голову.
Таким образом, мы реализовали две операции push и pop, которые позволяют теперь использовать односвязный список как стек. Теперь добавим ещё две операции — pushBack (её ещё принято называть shift или enqueue), которая добавляет новый элемент в конец списка, и функцию popBack (unshift, или dequeue), которая удаляет последний элемент списка и возвращает его значение.
Для дальнейшего разговора необходимо реализовать функции getLast, которая возвращает указатель на последний элемент списка, и nth, которая возвращает указатель на n-й элемент списка.
Так как мы знаем адрес только первого элемента, то единственным способом добраться до n-го будет последовательный перебор всех элементов списка. Для того, чтобы получить следующий элемент, нужно перейти к нему через указатель next текущего узла
Node* getNth(Node* head, int n) < int counter = 0; while (counter < n && head) < head = head->next; counter++; > return head; >
Переходя на следующий элемент не забываем проверять, существует ли он. Вполне возможно, что был указан номер, который больше размера списка. Функция вернёт в таком случае NULL. Сложность операции O(n), и это одна из проблем односвязного списка.
Для нахождение последнего элемента будем передирать друг за другом элементы до тех пор, пока указатель next одного из элементов не станет равным NULL
Node* getLast(Node *head) < if (head == NULL) < return NULL; >while (head->next) < head = head->next; > return head; >
Теперь добавим ещё две операции — pushBack (её ещё принято называть shift или enqueue), которая добавляет новый элемент в конец списка, и функцию popBack (unshift, или dequeue), которая удаляет последний элемент списка и возвращает его значение.
Для вставки нового элемента в конец сначала получаем указатель на последний элемент, затем создаём новый элемент, присваиваем ему значение и перекидываем указатель next старого элемента на новый
void pushBack(Node *head, int value) < Node *last = getLast(head); Node *tmp = (Node*) malloc(sizeof(Node)); tmp->value = value; tmp->next = NULL; last->next = tmp; >
Односвязный список хранит адрес только следующего элемента. Если мы хотим удалить последний элемент, то необходимо изменить указатель next предпоследнего элемента. Для этого нам понадобится функция getLastButOne, возвращающая указатель на предпоследний элемент.
Node* getLastButOne(Node* head) < if (head == NULL) < exit(-2); >if (head->next == NULL) < return NULL; >while (head->next->next) < head = head->next; > return head; >
Функция должна работать и тогда, когда список состоит всего из одного элемента. Вот теперь есть возможность удалить последний элемент.
void popBack(Node **head) < Node *lastbn = NULL; //Получили NULL if (!head) < exit(-1); >//Список пуст if (!(*head)) < exit(-1); >lastbn = getLastButOne(*head); //Если в списке один элемент if (lastbn == NULL) < free(*head); *head = NULL; >else < free(lastbn->next); lastbn->next = NULL; > >
Удаление последнего элемента и вставка в конец имеют сложность O(n).
Можно написать алгоритм проще. Будем использовать два указателя. Один – текущий узел, второй – предыдущий. Тогда можно обойтись без вызова функции getLastButOne:
int popBack(Node **head) < Node *pFwd = NULL; //текущий узел Node *pBwd = NULL; //предыдущий узел //Получили NULL if (!head) < exit(-1); >//Список пуст if (!(*head)) < exit(-1); >pFwd = *head; while (pFwd->next) < pBwd = pFwd; pFwd = pFwd->next; > if (pBwd == NULL) < free(*head); *head = NULL; >else < free(pFwd->next); pBwd->next = NULL; > >
Теперь напишем функцию insert, которая вставляет на n-е место новое значение. Для вставки, сначала нужно будет пройти до нужного узла, потом создать новый элемент и поменять указатели. Если мы вставляем в конец, то указатель next нового узла будет указывать на NULL, иначе на следующий элемент
void insert(Node *head, unsigned n, int val) < unsigned i = 0; Node *tmp = NULL; //Находим нужный элемент. Если вышли за пределы списка, то выходим из цикла, //ошибка выбрасываться не будет, произойдёт вставка в конец while (i < n && head->next) < head = head->next; i++; > tmp = (Node*) malloc(sizeof(Node)); tmp->value = val; //Если это не последний элемент, то next перекидываем на следующий узел if (head->next) < tmp->next = head->next; //иначе на NULL > else < tmp->next = NULL; > head->next = tmp; >
Покажем на рисунке последовательность действий
Создали новый узел и присвоили ему значение
После этого делаем так, чтобы новый элемент ссылался на следующий после n-го
Теперь значение next нового узла хранит адрес того же узла, что и элемент, на который ссылается head
Перекидываем указатель next n-го элемента на вновь созданный узел
Теперь узел, адрес которого хранит head, указывает на новый узел tmp
Функция удаления элемента списка похожа на вставку. Сначала получаем указатель на элемент, стоящий до удаляемого, потом перекидываем ссылку на следующий элемент за удаляемым, потом удаляем элемент.
int deleteNth(Node **head, int n) < if (n == 0) < return pop(head); >else < Node *prev = getNth(*head, n-1); Node *elm = prev->next; int val = elm->value; prev->next = elm->next; free(elm); return val; > >
Рассмотрим то же самое в картинках. Сначала находим адреса удаляемого элемента и того, который стоит перед ним
Для удаления узла, на который ссылается elm необходим предыдущий узел, адрес которого хранит prev
После чего прокидываем указатель next дальше, а сам элемент удаляем.
Прекидываем указатель на следующий за удалённым узел и освобождаем память
Кроме создания списка необходимо его удаление. Так как самая быстрая функция у нас этот pop, то для удаления будем последовательно выталкивать элементы из списка.
void deleteList(Node **head) < while ((*head)->next) < pop(head); *head = (*head)->next; > free(*head); >
Вызов pop можно заменить на тело функции и убрать ненужные проверки и возврат значения
void deleteList(Node **head) < Node* prev = NULL; while ((*head)->next) < prev = (*head); (*head) = (*head)->next; free(prev); > free(*head); >
Осталось написать несколько вспомогательных функций, которые упростят и ускорят работу. Первая — создать список из массива. Так как операция push имеет минимальную сложность, то вставлять будем именно с её помощью. Так как вставка произойдёт задом наперёд, то массив будем обходить с конца к началу:
void fromArray(Node **head, int *arr, size_t size) < size_t i = size - 1; if (arr == NULL || size == 0) < return; >do < push(head, arr[i]); >while(i--!=0); >
И обратная функция, которая возвратит массив элементов, хранящихся в списке. Так как мы будем создавать массив динамически, то сначала определим его размер, а только потом запихнём туда значения.
int* toArray(const Node *head) < int leng = length(head); int *values = (int*) malloc(leng*sizeof(int)); while (head) < values[--leng] = head->value; head = head->next; > return values; >
И ещё одна функция, которая будет печатать содержимое списка
void printLinkedList(const Node *head) < while (head) < printf("%d ", head->value); head = head->next; > printf("\n"); >
Теперь можно провести проверку и посмотреть, как работает односвязный список
void main() < Node* head = NULL; int arr[] = ; //Создаём список из массива fromArray(&head, arr, 10); printLinkedList(head); //Вставляем узел со значением 333 после 4-го элемента (станет пятым) insert(head, 4, 333); printLinkedList(head); pushBack(head, 11); pushBack(head, 12); pushBack(head, 13); pushBack(head, 14); printLinkedList(head); printf("%d\n", pop(&head)); printf("%d\n", popBack(&head)); printLinkedList(head); //Удаляем пятый элемент (индексация с нуля) deleteNth(&head, 4); printLinkedList(head); deleteList(&head); getch(); >
Сортировка односвязного списка
Сортировать список будем слиянием. Этот метод очень похож на сортировку слиянием для массива. Для его реализации нам понадобятся две функции: одна буде делить список пополам, а другая будет объединять два упорядоченных односвязных списка, не создавая при этом новых узлов. Наша реализация не будет оптимальной, однако, некоторые решения, которые мы применим, могут быть использованы и в других алгоритмах.
Вспомогательная функция – слияние двух отсортированных списков. Функция не должна создавать новых узлов, так что будем использовать только имеющиеся. Для начала проверим, если хоть один из списков пуст, то вернём другой.
Node tmp; *c = NULL; if (a == NULL) < *c = b; return; >if (b == NULL)
После этого нужно, чтобы наша локальная переменная стала хранить адрес большего из узлов двух списков, от него и будем танцевать дальше
if (a->value < b->value) < *c = a; a = a->next; > else < *c = b; b = b->next; >
Теперь сохраним указатель c, так как в дальнейшем он будет использоваться для прохода по списку
tmp.next = *c;
После этого проходим по спискам, сравниваем значения и перекидываем их
while (a && b) < if (a->value < b->value) < (*c)->next = a; a = a->next; > else < (*c)->next = b; b = b->next; > (*c) = (*c)->next; >
В конце, может остаться один список, который пройден не до конца. Добавим его узлы
if (a) < while (a) < (*c)->next = a; (*c) = (*c)->next; a = a->next; > > if (b) < while (b) < (*c)->next = b; (*c) = (*c)->next; b = b->next; > >
Теперь указатель c хранит адрес последнего узла, а нам нужна ссылка на голову. Она как раз хранится во второй переменной tmp
*c = tmp.next;
void merge(Node *a, Node *b, Node **c) < Node tmp; *c = NULL; if (a == NULL) < *c = b; return; >if (b == NULL) < *c = a; return; >if (a->value < b->value) < *c = a; a = a->next; > else < *c = b; b = b->next; > tmp.next = *c; while (a && b) < if (a->value < b->value) < (*c)->next = a; a = a->next; > else < (*c)->next = b; b = b->next; > (*c) = (*c)->next; > if (a) < while (a) < (*c)->next = a; (*c) = (*c)->next; a = a->next; > > if (b) < while (b) < (*c)->next = b; (*c) = (*c)->next; b = b->next; > > *c = tmp.next; >
Ещё одна важная функция – нахождение середины списка. Для этих целей будем использовать два указателя. Один из них — fast – за одну итерацию будет два раза изменять значение и продвигаться по списку вперёд. Второй – slow, всего один раз. Таким образом, если список чётный, то slow окажется ровно посредине списка, а если список нечётный, то второй подсписок будет на один элемент длиннее.
void split(Node *src, Node **low, Node **high) < Node *fast = NULL; Node *slow = NULL; if (src == NULL || src->next == NULL) < (*low) = src; (*high) = NULL; return; >slow = src; fast = src->next; while (fast != NULL) < fast = fast->next; if (fast != NULL) < fast = fast->next; slow = slow->next; > > (*low) = src; (*high) = slow->next; slow->next = NULL; >
Очевидно, что можно было один раз узнать длину списка, а потом передавать размер в каждую функцию. Это было бы проще и быстрее. Но мы не ищем лёгких путей)))
Теперь у нас есть функция, которая позволяет разделить список на две части и функция слияния отсортированных списков. С их помощью реализуем функцию сортировки слиянием.
Сортировка слиянием для односвязного списка
Функция рекурсивно вызывает сама себя, передавая части списка. Если в функцию пришёл список длинной менее двух элементов, то рекурсия прекращается. Идёт обратная сборка списка. Сначала из двух списков, каждый из которых хранит один элемент, создаётся отсортированный список, далее из таких списков собирается новый отсортированный список, пока все элементы не будут включены.
void mergeSort(Node **head) < Node *low = NULL; Node *high = NULL; if ((*head == NULL) || ((*head)->next == NULL)) < return; >split(*head, &low, &high); mergeSort(&low); mergeSort(&high); merge(low, high, head); >
Если Вы желаете изучать этот материал с преподавателем, советую обратиться к репетитору по информатике
ru-Cyrl 18- tutorial Sypachev S.S. 1989-04-14 sypachev_s_s@mail.ru Stepan Sypachev students

Всё ещё не понятно? – пиши вопросы на ящик
Как работает функция struct в C?
Объясните на пальцах — как она работает?
В частности я не могу понять как работает строка struct node* next;
Первую строку я понимаю, объявляется переменная int с именем n, также понимаю как ее использовать, например —
node number; number.n = 3;- Вопрос задан более трёх лет назад
- 1801 просмотр
Комментировать
Решения вопроса 1

Самый лучший программист
Вообщето это обьявление типа данных — структура. Описание работы со структурами есть — тут
Строка struct node* next; это обьявление члена структуры типа указатель, на данные такого же типа структуры.