TableSelect::having
Устанавливает условие для записей для рассмотрения в операциях агрегатной функции.
Список параметров
Условие для агрегатных функций, используемых в критериях группировки.
Возвращаемые значения
Примеры
Пример #1 Пример использования mysql_xdevapi\TableSelect::having()
$session = mysql_xdevapi\getSession ( «mysqlx://user:password@localhost» );
$session -> sql ( «DROP DATABASE IF EXISTS addressbook» )-> execute ();
$session -> sql ( «CREATE DATABASE addressbook» )-> execute ();
$session -> sql ( «CREATE TABLE addressbook.names(name text, age int)» )-> execute ();
$session -> sql ( «INSERT INTO addressbook.names values (‘John’, 42), (‘Sam’, 42)» )-> execute ();
$session -> sql ( «INSERT INTO addressbook.names values (‘Suki’, 31)» )-> execute ();
$schema = $session -> getSchema ( «addressbook» );
$table = $schema -> getTable ( «names» );
$result = $table -> select ( ‘count(*) as count’ , ‘age’ )
-> groupBy ( ‘age’ )-> orderBy ( ‘age asc’ )
-> having ( ‘count > 1’ )
-> execute ();
$row = $result -> fetchAll ();
print_r ( $row );
?>
Результатом выполнения данного примера будет что-то подобное:
Array ( [0] => Array ( [count] => 2 [age] => 42 ) )
Группировки и оконные функции в Oracle
Привет, Хабр! В компании, где я работаю, часто проходят (за мат извините) митапы. На одном из них выступал мой коллега с докладом об оконных функциях и группировках Oracle. Эта тема показалась мне стоящей того, чтобы сделать о ней пост.
С самого начала хотелось бы уточнить, что в данном случае Oracle представлен как собирательный язык SQL. Группировки и методы их применения подходят ко всему семейству SQL (который понимается здесь как структурированный язык запросов) и применимы ко всем запросам с поправками на синтаксис каждого языка.
Всю необходимую информацию я постараюсь кратко и доступно объяснить в двух частях. Пост скорее будет полезен начинающим разработчикам. Кому интересно — добро пожаловать под кат.
Часть 1: предложения Order by, Group by, Having
Здесь мы поговорим о сортировке — Order by, группировке — Group by, фильтрации — Having и о плане запроса. Но обо всем по-порядку.
Order by
Оператор Order by выполняет сортировку выходных значений, т.е. сортирует извлекаемое значение по определенному столбцу. Сортировку также можно применять по псевдониму столбца, который определяется с помощью оператора.
Преимущество Order by в том, что его можно применять и к числовым, и к строковым столбцам. Строковые столбцы обычно сортируются по алфавиту.
Сортировка по возрастанию применяется по умолчанию. Если хотите отсортировать столбцы по убыванию — используйте дополнительный оператор DESC.
SELECT column1, column2, … (указывает на название)
FROM table_name
ORDER BY column1, column2… ASC|DESC;
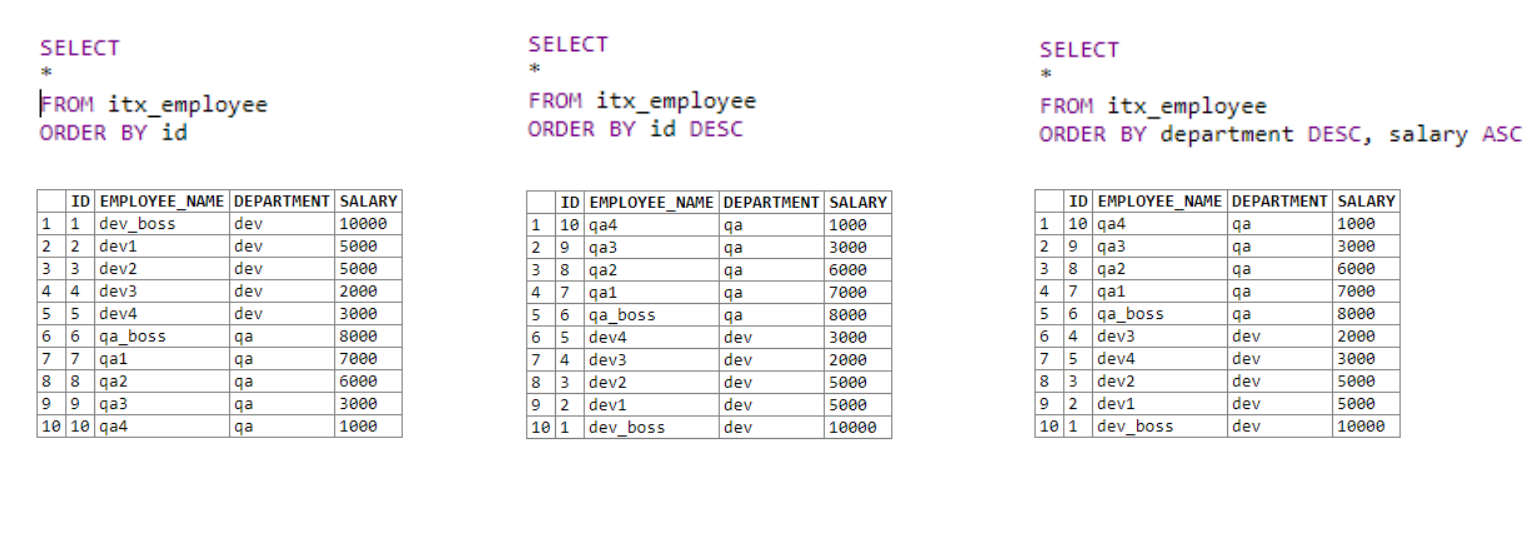
Давайте все рассмотрим на примерах:
В первой таблице мы получаем все данные и сортируем их по возрастанию по столбцу ID.
Во второй мы также получаем все данные. Сортируем по столбцу ID по убыванию, используя ключевое слово DESC.
В третьей таблице используется несколько полей для сортировки. Сначала идет сортировка по отделу. При равенстве первого оператора для полей с одинаковым отделом применяется второе условие сортировки; в нашем случае — это зарплата.
Все довольно просто. Мы можем задать более одного условия сортировки, что позволяет более грамотно сортировать выходные списки.
Group by
В SQL оператор Group by собирает данные, полученные из базы данных в определенных группах. Группировка разделяет все данные на логические наборы, что дает возможность выполнять статистические вычисления отдельно в каждой группе.
Этот оператор используется для объединения результатов выборки по одному или нескольким столбцам. После группировки будет только одна запись для каждого значения, использованного в столбце.
С использованием оператора SQL Group by тесно связано использование агрегатных функций и оператор SQL Having. Агрегатная функция в SQL — это функция, возвращающая какое-либо одно значение по набору значений столбца. Например: COUNT(), MIN(), MAX(), AVG(), SUM()
SELECT column_name(s)
FROM table_name
WHERE condition
GROUP BY column_name(s)
ORDER BY column_name(s);
Group by стоит после условного оператора WHERE в запросе SELECT. По желанию можно использовать ORDER BY, чтобы отсортировать выходные значения.
Итак, опираясь на таблицу из предыдущего примера, нам нужно найти максимальную зарплату сотрудников каждого отдела. В итоговой выборке должно получиться название отдела и максимальная зарплата.
Решение 1 (без использования группировки):
SELECT DISTINCT ie.department ie.slary FROM itx_employee ie WHERE ie.salary = ( SELECT max(ie1.salary) FROM itx_employee ie1 WHERE ie.department = ie1.department ) Решение 2 (с использованием группировки):
SELECT department, max(salary) FROM itx_employee GROUP BY department В первом примере решаем задачу без использования группировки, но с использованием подселекта, т.е. в один селект вкладываем второй. Во втором решении используем группировку.
Второй пример вышел короче и читабельнее, хотя выполняет такие же функции, что и первый.
Как у нас работает Group by: сначала разбивает два отдела на группы qa и dev. Потом для каждого из них ищет максимальную зарплату.
Having
Having это инструмент фильтрации. Он указывает на результат выполнения агрегатных функций. Предложение Having используется в SQL там, где нельзя применить WHERE.
Если предложение WHERE определяет предикат для фильтрации строк, то Having используется после группировки для определения логичного предиката, фильтрующего группу по значениям агрегатных функций. Предложение необходимо для проверки значений, полученных при помощи агрегатных функций из групп строк.
SELECT column_name(s)
FROM table_name
WHERE condition
GROUP BY column_name(s)
HAVING condition
Сначала мы выводим отделы со средней зарплатой больше 4000. Затем выводим максимальную зарплату с применением фильтрации.
Решение 1 (без использования GROUP BY и HAVING):
SELECT DISTINCT ie.department AS "DEPARTMENT", ( (SELECT AVG(ie1.salary) FROM itx_employee ie1 WHERE ie1.department = ie.department) ) AS "AVG SALARY" FROM itx_employee ie where (SELECT AVG(ie1.salary) FROM itx_employee ie1 WHERE ie1.department = ie.department) > 4000 Решение 2 (с использованием GROUP BY и HAVING):
SELECT department, AVG(salary) FROM itx_employee GROUP BY department HAVING AVG(salary) > 4000 В первом примере используется два подселекта: один для нахождения максимальной зарплаты, другой для фильтрации средней зарплаты. Второй пример, опять же, вышел намного проще и лаконичнее.
План запроса
Нередко бывают ситуации, когда запрос работает долго, потребляя значительные ресурсы памяти и дисков. Чтобы понять, почему запрос работает долго и неэффективно, мы можем посмотреть план запроса.
План запроса — это предполагаемый план выполнения запроса, т.е. как СУБД будет его выполнять. СУБД распишет все операции, которые будут выполняться в рамках подзапроса. Проанализировав все, мы сможем понять, где в запросе слабые места и с помощью плана запроса сможем оптимизировать их.
Исполнение любого SQL предложения в Oracle извлекает так называемый “план исполнения”. Этот план исполнения запроса является описанием того, как Oracle будет осуществлять выборку данных, согласно исполняемому SQL предложению. План представляет собой дерево, которое содержит порядок шагов и связь между ними.
К средствам, позволяющим получить предполагаемый план выполнения запроса, относятся Toad, SQL Navigator, PL/SQL Developer и др. Они выдают ряд показателей ресурсоемкости запроса, среди которых основными являются: cost — стоимость выполнения и cardinality (или rows) — кардинальность (или количество строк).
Чем больше значение этих показателей, тем менее эффективен запрос.
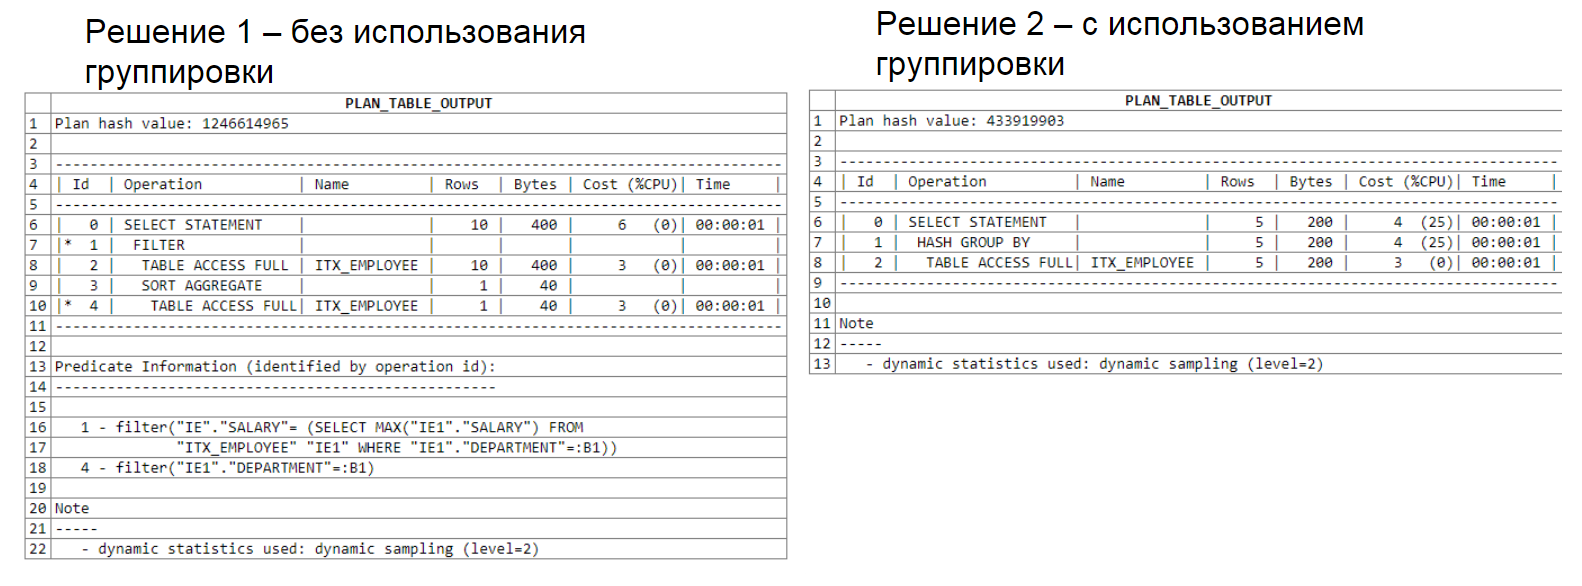
Ниже можно увидеть анализ плана запроса. В первом решении используется подселект, во втором — группировка. Обратите внимание, что в первом решении обработано 22 строки, во втором — 15.
Анализ плана запроса:
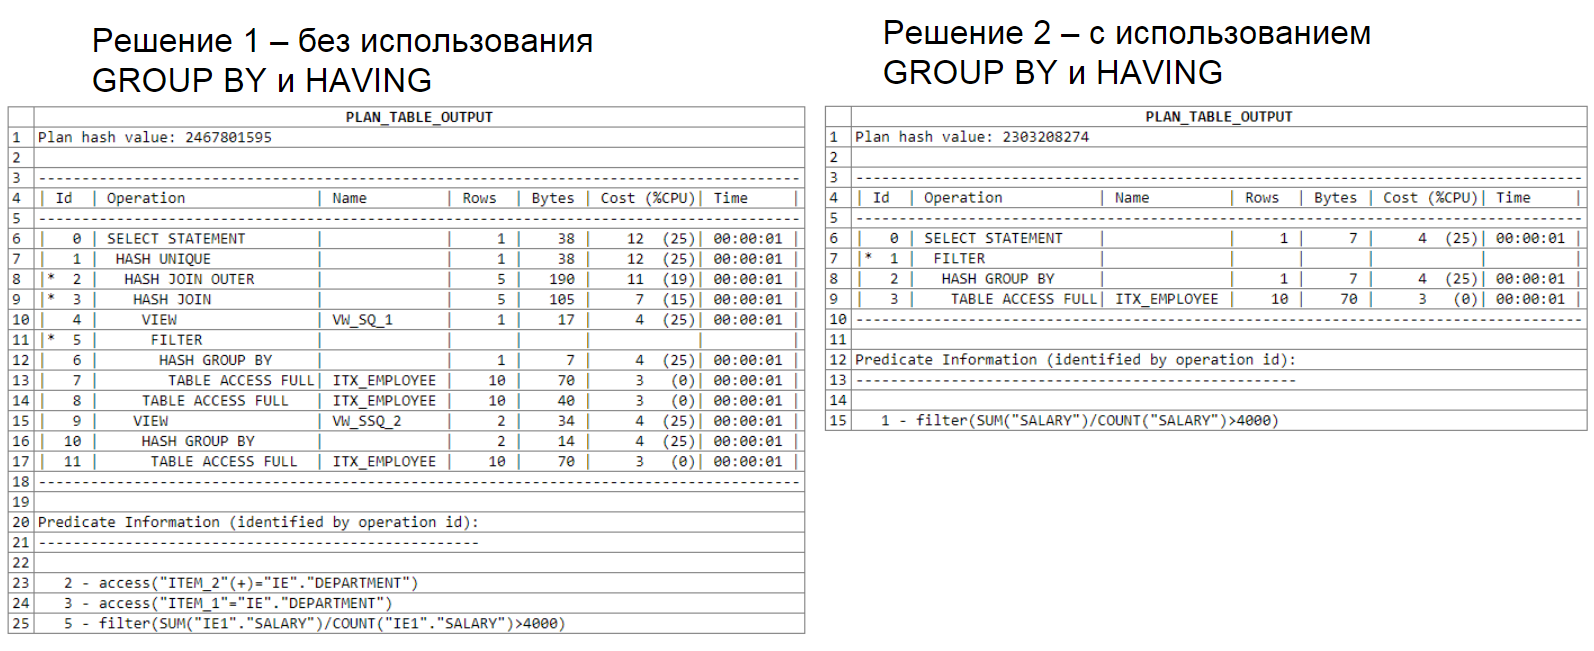
Ещё один анализ плана запроса, в котором применяется два подселекта:
Этот пример приведен как вариант нерационального использования средств SQL и я не рекомендую вам его использовать в своих запросах.
Все перечисленные выше функции упростят вам жизнь при написании запросов и повысят качество и читабельность вашего кода.
Часть 2: Оконные функции
Оконные функции появились ещё в Microsoft SQL Server 2005. Они осуществляют вычисления в заданном диапазоне строк внутри предложения Select. Если говорить кратко, то “окно” — это набор строк, в рамках которого происходит вычисление. “Окно” позволяет уменьшить данные и более качественно их обработать. Такая функция позволяет разбивать весь набор данных на окна.
Оконные функции обладают огромным преимуществом. Нет необходимости формировать набор данных для расчетов, что позволяет сохранить все строки набора с их уникальными ID. Результат работы оконных функций добавляется к результатирующей выборке в еще одно поле.
SELECT column_name(s)
Агрегирующая функция (столбец для вычислений)
OVER ([PARTITION BY столбец для группировки]
FROM table_name
[ORDER BY столбец для сортировки]
[ROWS или RANGE выражение для ограничения строк в пределах группы])
OVER PARTITION BY — это свойство для задания размеров окна. Здесь можно указывать дополнительную информацию, давать служебные команды, например добавить номер строки. Синтаксис оконной функции вписывается прямо в выборку столбцов.
Давайте рассмотрим все на примере: в нашу таблицу добавился еще один отдел, теперь в таблице 15 строк. Мы попытаемся вывести работников, их з/п, а также максимальную з/п организации.
В первом поле мы берем имя, во втором — зарплату. Дальше мы применяем оконную функцию over(). Используем её для получения максимальной зарплаты по всей организации, так как не указаны размеры “окна”. Over() с пустыми скобками применяется для всей выборки. Поэтому везде максимальная зарплата — 10 000. Результат действия оконной функции добавляется к каждой строчке.
Если убрать из четвертой строки запроса упоминание оконной функции, т.е. остается только max (salary), то запрос не сработает. Максимальную зарплату просто не удалось бы посчитать. Так как данные обрабатывались бы построчно, и на момент вызова max (salary) было бы только одно число текущей строки, т.е. текущего работника. Вот тут и можно заметить преимущество оконной функции. В момент вызова она работает со всем окном и со всеми доступными данными.
Давайте рассмотрим еще один пример, где нужно вывести максимальную з/п каждого отдела:
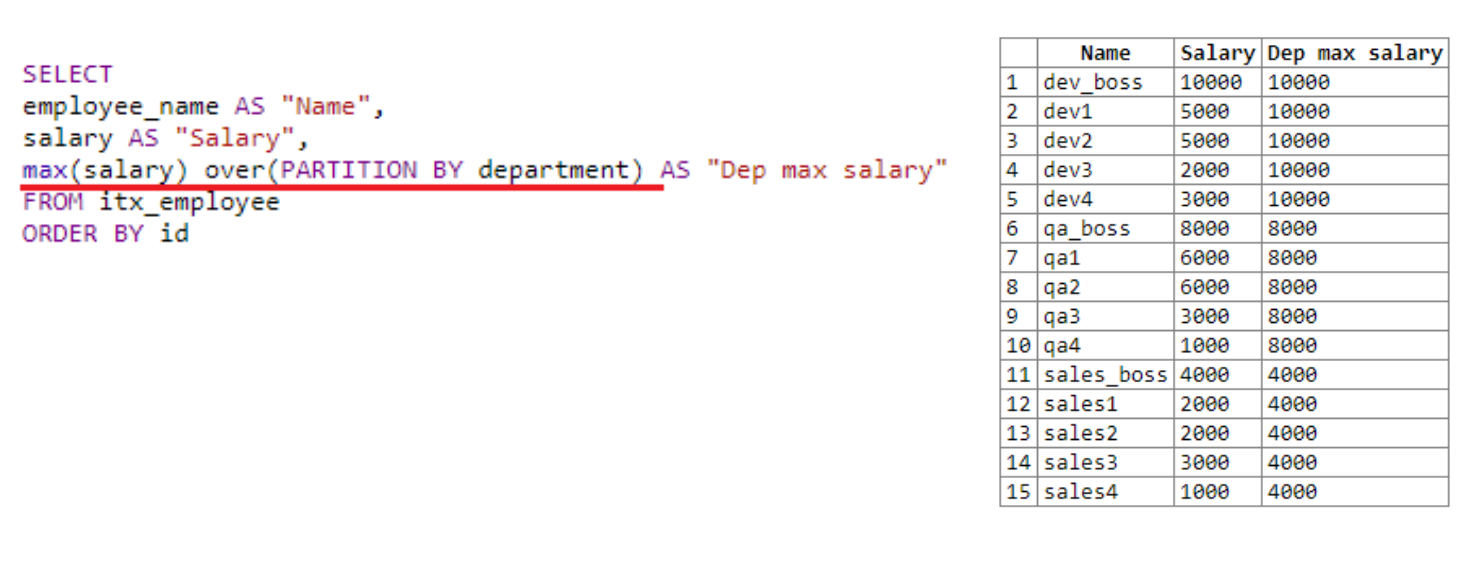
Фактически мы задаем рамки для “окна”, разбивая его на отделы. В качестве ранжирующего примера мы указываем department. У нас есть три отдела: dev, qa и sales.
“Окно” находит максимальную зарплату для каждого отдела. В результате выборки мы видим, что оно нашло максимальную зарплату сначала для dev, затем для qa, потом для sales. Как уже упоминалось выше, результат оконной функции записывается в результат выборки каждой строки.
В предыдущем примере в скобках после over не было указано. Здесь мы использовали PARTITION BY, которое позволило задать размеры нашего окна. Здесь можно указывать какую-то доп информацию, передавать служебные команды, например, номер строки.
Заключение
SQL не так прост, как кажется на первый взгляд. Все описанное выше — это базовые возможности оконных функций. С их помощью можно “упростить” наши запросы. Но в них скрыто намного больше потенциала: есть служебные операторы (например ROWS или RANGE), которые можно комбинировать, добавляя больше функциональности запросам.
Надеюсь, пост был полезен для всех интересующихся данной темой.
Оконные функции SQL простым языком с примерами
Сразу хочется отметить, что данная статья написана исключительно для людей, начинающих свой путь в изучении SQL и оконных функций. Здесь могут быть не разобраны сложные применения функций и могут не использоваться сложные формулировки определений — все написано максимально простым языком для базового понимания.
P.S. Если автор что-то не разобрал и не написал, значит он посчитал это не обязательным в рамках этой статьи)))
Для примеров будем использовать небольшую таблицу, которая показывает оценки учеников по разным предметам. В БД табличка выглядит следующим образом
--создание таблицы create table student_grades ( name varchar, subject varchar, grade int); -- наполнение таблицы данными insert into student_grades ( values ('Петя', 'русский', 4), ('Петя', 'физика', 5), ('Петя', 'история', 4), ('Маша', 'математика', 4), ('Маша', 'русский', 3), ('Маша', 'физика', 5), ('Маша', 'история', 3)); --запрос всех данных из таблицы select * from student_grades;
SQL часто используется для вычислений в данных различных метрик или агрегаций значений по измерениям. Помимо функций агрегации для этого широко используются оконные функции.
Оконная функция в SQL — функция, которая работает с выделенным набором строк (окном, партицией) и выполняет вычисление для этого набора строк в отдельном столбце.
Партиции (окна из набора строк) — это набор строк, указанный для оконной функции по одному из столбцов или группе столбцов таблицы. Партиции для каждой оконной функции в запросе могут быть разделены по различным колонкам таблицы.

В чем заключается главное отличие оконных функций от функций агрегации с группировкой?
При использовании агрегирующих функций предложение GROUP BY сокращает количество строк в запросе с помощью их группировки.

При использовании оконных функций количество строк в запросе не уменьшается по сравнении с исходной таблицей.

Порядок расчета оконных функций в SQL запросе

Сначала выполняется команда выборки таблиц, их объединения и возможные подзапросы под командой FROM.
Далее выполняются условия фильтрации WHERE, группировки GROUP BY и возможная фильтрация c HAVING
Только потом применяется команда выборки столбцов SELECT и расчет оконных функций под выборкой.
После этого идет условие сортировки ORDER BY, где тоже можно указать столбец расчета оконной функции для сортировки.
Здесь важно уточнить, что партиции или окна оконных функций создаются после разделения таблицы на группы с помощью команды GROUP BY, если эта команда используется в запросе.
Синтаксис оконных функций
Синтаксис оконных функций вне зависимости от их класса будет так или иначе состоять из идентичных команд.

Оконные функции можно прописывать как под командой SELECT, так и в отдельном ключевом слове WINDOW, где окну дается алиас (псевдоним), к которому можно обращаться в SELECT выборке.

Классы Оконных функций
Множество оконных функций можно разделять на 3 класса:

- Агрегирующие (Aggregate)
- Ранжирующие (Ranking)
- Функции смещения (Value)
Агрегирующие:
Можно применять любую из агрегирующих функций — SUM, AVG, COUNT, MIN, MAX
select name, subject, grade, sum(grade) over (partition by name) as sum_grade, avg(grade) over (partition by name) as avg_grade, count(grade) over (partition by name) as count_grade, min(grade) over (partition by name) as min_grade, max(grade) over (partition by name) as max_grade from student_grades;
Ранжирующие:
В ранжирующих функция под ключевым словом OVER обязательным идет указание условия ORDER BY, по которому будет происходить сортировка ранжирования.
ROW_NUMBER() — функция вычисляет последовательность ранг (порядковый номер) строк внутри партиции, НЕЗАВИСИМО от того, есть ли в строках повторяющиеся значения или нет.
RANK() — функция вычисляет ранг каждой строки внутри партиции. Если есть повторяющиеся значения, функция возвращает одинаковый ранг для таких строчек, пропуская при этом следующий числовой ранг.
DENSE_RANK() — то же самое что и RANK, только в случае одинаковых значений DENSE_RANK не пропускает следующий числовой ранг, а идет последовательно.
select name, subject, grade, row_number() over (partition by name order by grade desc), rank() over (partition by name order by grade desc), dense_rank() over (partition by name order by grade desc) from student_grades;
Про NULL в случае ранжирования:
Для SQL пустые NULL значения будут определяться одинаковым рангом
Функции смещения:
Это функции, которые позволяют перемещаясь по выделенной партиции таблицы обращаться к предыдущему значению строки или крайним значениям строк в партиции.
LAG() — функция, возвращающая предыдущее значение столбца по порядку сортировки.
LEAD() — функция, возвращающая следующее значение столбца по порядку сортировки.
На простом примере видно, как можно в одной строке получить текущую оценку, предыдущую и следующую оценки Пети в четвертях.
--создание таблицы create table grades_quartal ( name varchar, quartal varchar, subject varchar, grade int); --наполнение таблицы данными insert into grades_quartal ( values ('Петя', '1 четверть', 'физика', 4), ('Петя', '2 четверть', 'физика', 3), ('Петя', '3 четверть', 'физика', 4), ('Петя', '4 четверть', 'физика', 5) ); --запрос всех данных из таблицы select * from grades_quartal;
select name, quartal, subject, grade, lag(grade) over (order by quartal) as previous_grade, lead(grade) over (order by quartal) as next_grade from grades_quartal;
FIRST_VALUE()/LAST_VALUE() — функции возвращающие первое или последнее значение столбца в указанной партиции. В качестве аргумента указывает столбец, значение которого нужно вернуть. В оконной функции под словом OVER обязательное указание ORDER BY условия.
В следующей версии статьи разберем отдельно такое понятие как фрейм окна функции или window frame и рассмотрим на простых примерах как он используется.
2.7. Агрегатные функции
PostgreSQL , как и многие другие реляционные СУБД, поддерживает агрегатные функции. Агрегатная функция производит вычисление над единичным результатом от множества записей. Например, есть агрегаты для вычисления count (количества), sum (суммы), avg (среднего арифметического), max (максимального значения) и min (минимального значения) списка записей.
В качестве примера, мы можем найти наиболее высокую низкую температуру, создав запрос:
SELECT max(temp_lo) FROM weather;
Если мы хотим знать, в каком городе (или городах) это происходило, мы можем попытаться создать такой запрос:
SELECT city FROM weather WHERE temp_lo = max(temp_lo); НЕПРАВИЛЬНО
но он не будет работать, потому что агрегат max нельзя использовать в предложении WHERE . (Это ограничение существует, потому что предложение WHERE определяет записи, которые будут использованы на стадии обработки агрегатами; и таким образом оно должно уже отработать перед тем, как будут запущены агрегатные функции). Однако, эту ситуацию можно разрешить, если использовать позапрос :
SELECT city FROM weather WHERE temp_lo = (SELECT max(temp_lo) FROM weather);
city ————— San Francisco (1 row)
Теперь всё в порядке, потому что подзапрос является независимым вычислением, которое вычисляет свой собственный агрегат отдельно от того, который работает во внешнем запросе.
Агрегаты являются очень полезными в комбинациях с литералами GROUP BY . Например, мы можем получить максимально низкую температуру, отмеченную в каждом городе с помощью запроса:
SELECT city, max(temp_lo) FROM weather GROUP BY city;
city | max —————+—— Hayward | 37 San Francisco | 46 (2 rows)
который предоставит нам по одной записи на город. Каждый результат агрегата подсчитывается исходя из записей таблицы, которые соответствуют определенному городу. Мы можем фильтровать сгруппированные записи, используя литерал HAVING :
SELECT city, max(temp_lo) FROM weather GROUP BY city HAVING max(temp_lo) < 40;
city | max ———+—— Hayward | 37 (1 row)
Данный запрос возвращает такой же результат, но только для тех городов, в которых низкая температура temp_lo меньше. Наконец, если мы хотим получить только те города, имена которых начинаются на букву » S » , мы можем выполнить запрос:
SELECT city, max(temp_lo) FROM weather WHERE city LIKE ‘S%’ (1) GROUP BY city HAVING max(temp_lo) < 40;
(1) Оператор LIKE выполняет сравнение по шаблону и описывается подробно в PostgreSQL User’s Guide .
Очень важно понимать различия между агрегатами и такими конструкциями SQL как WHERE и HAVING . Фундаментальное отличие между WHERE и HAVING состоит в следующем: WHERE выбирает входящие записи перед группированием и вычислениями агрегатами (а значит управляет тем, какие записи попадут в агрегатные функции), в то время как HAVING выбирает группу записей после группирования и вычисления агрегатов. Таким образом, предложение WHERE не должно содержать агрегатных функций; оно не оказывает влияния на попытку использовать агрегаты для того, чтобы определить какие записи будут переданы агрегатам. С другой стороны предложение HAVING всегда содержит агрегатные функции. (Вкратце, вам разрешается писать предложение HAVING , которое не использует агрегаты, но это непроизводительно: такое же условие можно использовать в предложении WHERE с большей эффективностью).
Обратите внимание, что мы можем применять ограничения по имени города в предложении WHERE , так как оно не требует использования агрегата. Это будет более эффективно, чем добавлять это ограничение в предложение HAVING , потому что мы пропускаем операции группирования и вычисления агрегатов для всех записей, которые не соответствуют условию в предложении WHERE .
| Prev | Home | Next |
| Объединения таблиц (Join) | Up | Обновление данных в таблицах |