Как обучить нейросеть, если разметка данных стоит как самолет
Искусственный интеллект все чаще используется в медицинских целях, в частности для анализа медицинских изображений. Это прекрасный помощник для врачей-рентгенологов, который позволяет определять даже едва различимые человеческому глазу признаки патологий и вообще разгружает медицинских специалистов за счет автоматизации ряда рутинных задач.
Мы, в том числе, создаем нейросети для обработки КТ-исследований, например для оценки поражения легких при COVID-19 пневмонии (кстати, вы знали, что врачи оценивают процент поражения легких ковидного пациента “на глаз”?). Процесс создания качественной и эффективной нейросети долгий и дорогой. Более того, данных для обучения зачастую недостаточно.
Например, для классического обучения нейронных сетей необходимо много размеченных данных. Это ресурсозатратный процесс, как по стоимости, так и по времени, так как в качестве аннотаторов выступают врачи-рентгенологи. Кроме того, размеченным снимкам необходима повторная валидация. Например, пропуск диагнозов при анализе врачом КТ-снимков может составлять до 42% [1]. Также данные довольно разнообразны, это тоже проблема: разные дозы облучения при исследовании, положение пациента, особенности КТ-аппарата.
Именно по этим причинам мы решили исследовать различные подходы, которые могли бы помочь сократить число необходимых аннотированных данных для получения модели того же качества. Это может позволить не только сократить время и расходы на аннотацию, но и ускорить цикл поставки новых моделей.
В результате нашего исследования, мы нашли лучший подход, который помог сохранить точность работы алгоритма при использовании лишь 20% разметки.
Магия — нет, расскажем подробнее…
Целевая задача
Мы решили создать модель для анализа КТ органов грудной клетки “ковидных” пациентов, в качестве патологии выбрали матовое стекло. Почему именно этот симптом? Во-первых, он часто возникает на фоне COVID-19 (у 61.4%-91% пациентов [2, 3]). Патология представляет собой уплотнения легочной ткани, альвеолы заполняются жидкостью и, как следствие, затрудняется дыхание. Во-вторых, патология может иметь сложные паттерны, что затрудняет исследование (см. рисунок ниже). При обнаружении “матового стекла” необходимо тщательно обследовать пациента, так как он подвергается большой опасности при заболевании COVID-19.
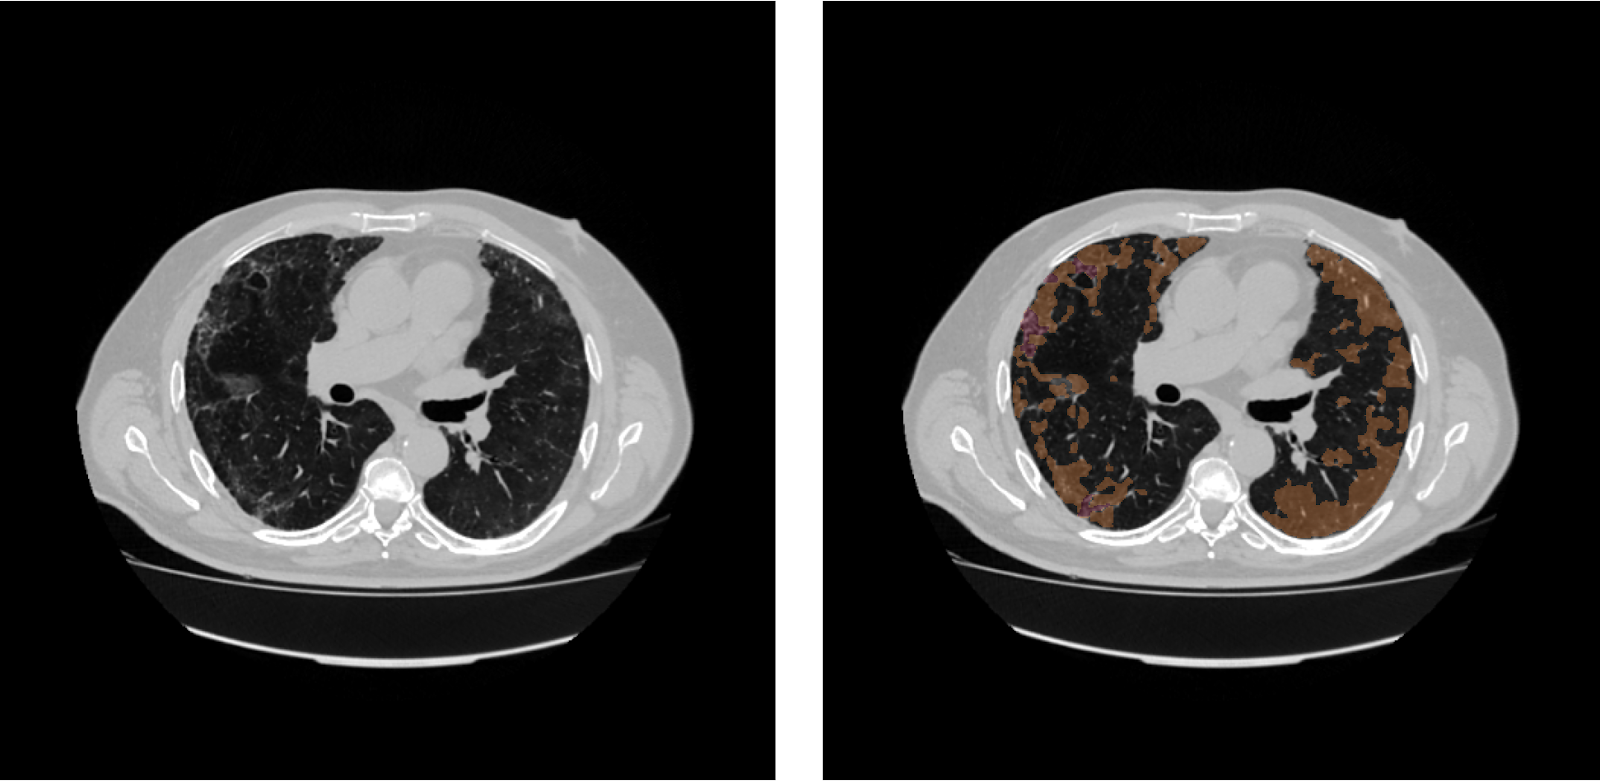
При анализе снимков необходимо учитывать, что КТ-снимок — это объемное изображение (3D), содержащее целевой орган. Эту особенность можно использовать в анализе объемных патологий – на вход алгоритму подается не один снимок, а набор последовательно идущих, что позволяет передать контекст и дает больше информации алгоритму об окружении.

План эксперимента
Для имеющихся данных (КТ-снимков легких) решается задача сегментации патологии “матовое стекло” с использованием классической нейронной сети U-net [6], лежащей в основе модели .
Для получения референсных значений мы обучили целевую модель классическим способом (supervised) на данных с полной аннотацией (размечен каждый срез на всех исследованиях).

Качество работы данной модели берется как эталонное, именно такие метрики мы и хотим сохранить или улучшить при дальнейших экспериментах. Вторым этапом мы проверяем, какое качество мы получим, если классическим образом supervised обучим ту же модель на данных с 20% аннотации. Для этого этапа и последующих экспериментов срезы с аннотацией выбираются не случайно, а по следующему правилу: в каждом исследовании берется разметка только для каждого пятого срезы. Далее мы начали пробовать более свежие методы, которые являются представителями подходов self-supervised и semi-supervised, используя также только часть аннотации.

Исследование подхода №1
Semi-supervised Contrastive Learning for Label-efficient Medical Image Segmentation
Основная идея контрастивного обучения заключается в подготовке пространства признаков за счет использования только исходных данных. Сейчас наша задача – обучить сеть давать схожие вектора признаков на схожих примерах. В данном случае на вход подается два примера – оригинальное изображение x и аугментированное x’ и расстояние между векторами должно быть минимальным. Таким образом можно быстрее и качественнее обучить сеть на целевую задачу благодаря утилизации всех неразмеченных данных. Зачастую при использовании такого подхода предобучается только Encoder на всех данных (a)[4], после чего Decoder обучается обычным supervised на размеченных данных (c)[4]. Метод отличается тем, что авторы статьи придумали, как обучать ещё и Decoder с помощью подхода локального контрастивного обучения (b)[4]. Это достигается за счет работы не с векторами признаков, полученными из энкодера, а уже с картами признаков, получаемыми из ветки декодера.

Таким образом на первом этапе обучается только Encoder; фичи, полученные после AVG слоя, сравниваются с помощью контрастивного лосса:

где z_i и z_j — значения выхода Encoder x и x’, а z_t – все остальные результаты обработки батча.
Как было сказано ранее, первый этап — лишь подготовка части модели, далее следующим мы дообучаем модель с аннотацией в supervised манере. На рисунке ниже показан полный пайплайн обучения.

Достаточно часто в качестве функции потерь используют Dice [7], он обозначает меру схожести классов между ground truth и prediction (также известный как F-1 мера):
D(P, G) = 2 |G∩P| / (|G| + |P|)
Однако он имеет несколько недостатков, так как оперирует целыми числами и не учитывает вероятностных значений prediction. Во-первых, необходимо подобрать threshold, который будет напрямую влиять на правильность результата. Во-вторых, для классического Dice без разницы, какая вероятность была у класса, например, если граничное значение равно 0, то значение 0.1 и 0.9 будут одинаково расценены как класс 1.

Continuous Dice – более подходящая функция ошибки в рамках данной задачи, так как он учитывает вероятности выхода и штрафует за ошибки аддитивно их вероятностям.

Исследование подхода №2
Transformation-consistent Self-ensembling Model for Semi-supervised Medical Image Segmentation
Не менее интересный подход – согласованная с преобразованием самоорганизующаяся модель для обучения с частичным привлечением учителя. Идею можно передать следующим примером – если мы подадим на вход нейронной сети повернутую на 90 градусов картинку, то получим тот же результат, если мы сначала повернем изображение на 90 градусов, а потом уже подадим в нейронную сеть. Таким образом, кроме поворота могут быть и другие преобразования (a)[5].

Однако важно понимать, что нейронные сети – нелинейные алгоритмы, поэтому одинаковые маски на выходе мы не получим (b)[5]. Эту идею сформулировать как функцию потерь.На основе этой идеи был создан алгоритм TCSM (transformation consistent self-ensembling model). Есть сеть “студент” и её копия ”учитель”, которая должна предсказывать маски. В сеть-ученик передается оригинальное изображение, в сеть-учитель – измененное, потом с помощью тех же самых преобразований меняем выход сети-ученик. Результат должен быть одинаковым. Так как сеть-учитель выступает в качестве среднего сглаживающего фильтра состояний модели-студента, то это позволяет использовать неразмеченные данные без потери консистентности предсказаний моделей (учитель, ученик) в процессе обучения. И так для всех исходных изображений обучаем таким пайплайном сети, используя соответственно Unlabeled loss. Для изображений с аннотациями – просто сравниваем выход сеть-учитель с целевой маской и используем для расчета ошибки labeled loss.

Результаты
Полученные модели мы оценили по метрикам Dice и объемный Dice (VolDice), который используется для оценки всего исследования как целого 3D объекта. Метрики были рассчитаны для каждого класса, где 0 — норма (отсутствие патологии), 1 — матовое стекло.
Как работают искусственный интеллект, машинное и глубокое обучение
Об авторе: Андрей Беляев, технический директор (CTO) исследовательской компании Neurodata Lab.
Умные дома, самоуправляемые автомобили, роботы-помощники… Нас окружают инновационные технологии, в основе которых лежат алгоритмы, по своей специфике напоминающие работу человеческого мозга. Их называют по-разному: алгоритмы с использованием машинного обучения, глубокого обучения, а иногда и вовсе искусственный интеллект (ИИ).
В чем разница между этими названиями?
Все задачи, которые может решать человек или компьютер, можно условно разделить на две категории: рутинные и нерутинные.
К рутинным задачам можно отнести те, где достаточно просто найти универсальный путь решения: например, сложение чисел или измерение температуры воздуха.
Искусственным интеллектом сейчас принято называть все, что способно решать нерутинные задачи на уровне, близком к человеческому, а иногда и лучше. Такие задачи окружают нас везде. Камеры над дорогой вычисляют скорость автомобиля, распознают его знак и высылают штраф, а системы безопасности в метро и аэропортах находят преступников в толпе. Все это сегодня принято считать искусственным интеллектом, хотя в действительности алгоритмы, лежащие в основе каждой такой технологии, уникальны. И только некоторые используют машинное обучение.
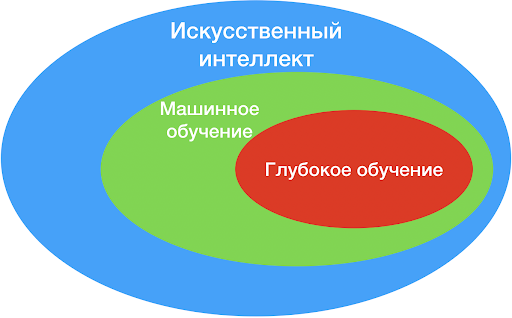
Получается, что машинное обучение — это обучение ИИ
Искусственный интеллект — это название не какого-то отдельного алгоритма, но скорее группы методов, которыми пользуются для решения различного рода задач. Алгоритмы, которые используют подходы с обучением, являются лишь одной из подгрупп всего того множества алгоритмов, что принято называть искусственным интеллектом.
Машинное обучение — это подход, при котором алгоритм «учится» решать задачу. Один из самых простых примеров алгоритма, использующего машинное обучение, это классификация фотографий на те, где изображены кошки и те, где есть собаки:
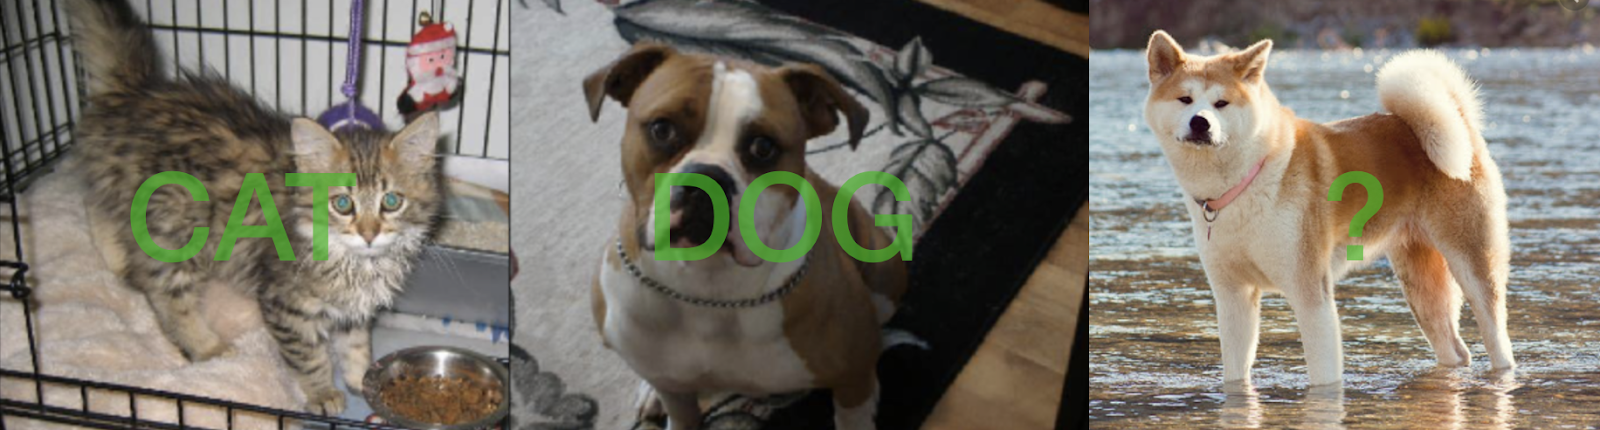
Допустим, есть несколько тысяч фотографий кошек и несколько тысяч — собак. Эти данные можно загрузить в алгоритм и заставить его «учиться» отличать кошек от собак, «ругая» за ошибки в классификации и «поощряя» за правильные ответы. В зависимости от количества и качества вводных данных, а также от сложности используемого алгоритма после некоторого количества итераций с «наказанием» и «поощрением», получается обученный алгоритм, которой с разным качеством умеет отличать кошек и собак.
Применяя методы машинного обучения, эти же алгоритмы можно «натренировать» и для выполнения более сложных задач — таких как поиск людей на кадре, определение пола и возраста человека и т.д.
Такие алгоритмы можно научить решать задачи любой сложности?
В теории — да. Но на практике мы сталкиваемся с большим количеством проблем, начиная от недостаточного количества данных для обучения, заканчивая невозможностью интерпретировать действия человека при решении такой же задачи. Получается, что невозможно построить алгоритм, который эти действия бы совершал. Хороший пример — автопилотируемый автомобиль. Научить машину держать полосу, входить в повороты и автоматически перестраивать маршрут, если на дороге ремонт, сравнительно несложно, потому что есть понимание, как вел бы себя человек (а значит, как должна вести себя машина) в таких ситуациях.
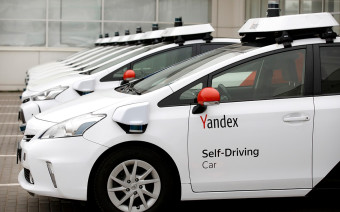
Однако научить автомобиль принимать решения в чрезвычайных ситуациях гораздо сложнее: проблема в том, что и самому человеку трудно понять, как именно надо поступать в том или ином экстренном случае. Поэтому человек не может показать алгоритмам примеры хорошего и плохого поведения для таких случаев.
А что насчет глубокого обучения? Чем оно отличается от машинного?
Как машинное обучение является подвидом искусственного интеллекта, так и глубокое обучение является подвидом машинного (см. картинку в начале статьи). В глубоком обучении используются те же подходы: алгоритму дают много данных и «ругают» его за ошибки. Разница здесь в том, что сами алгоритмы глубокого обучения устроены гораздо сложнее и часто используют более серьезные математические модели. Сейчас под алгоритмами глубокого обучения практически всегда подразумевают нейронные сети.
Нейронные сети? Как те, что в мозгу у человека?
Такое сравнение действительно часто используется. Нейронная сеть — это последовательность слоев, каждый из которых, в свою очередь, состоит из нейронов, и каждый выполняет свою роль. Есть нейроны (или структуры нейронов), которые учатся выделять важные элементы на изображениях, например шерсть у кошки или собаки; есть те, которые учатся делать выводы, исходя из выделенных элементов — например, если у животного длинные лапы, то, скорее всего, это собака. Эти нейроны объединяются в группы (слои), а они превращаются в единую искусственную нейронную сеть.
И все же можно как-то сравнить процессы внутри нейросети с деятельностью мозга?
Некоторое количество идей, используемых в нейросетях, разработчики почерпнули из знаний об устройстве человеческого мозга. Одни из самых частых задач для нейросетей — это задачи, связанные с работой с изображениями. Для таких задач используют специальный тип нейросетей, внутри которых есть так называемые сверточные слои.
Если говорить упрощенно, смысл этой сверточной нейронной сети в том, чтобы оценивать каждый элемент картинки (пиксель) не отдельно, а в группе с несколькими соседними, благодаря чему можно находить как базовые фигуры (линии, углы, и т.д.), так и объекты целиком. Примерно такой же процесс происходит и в человеческом мозге при обработке визуальной информации. После снятия всех возможных визуальных признаков в нейросети, как и в человеческом мозге, происходит анализ этих признаков, а затем принимается решение: видим мы, допустим, кошку или собаку.
А как происходит процесс обучения?
Процесс обучения алгоритма во многом напоминает процесс обучения человека. Как мы совершаем ошибки и учимся на них (например, что не стоит засовывать руку в кипящую воду), так и алгоритмы, использующие машинное обучение, совершают ошибки, за что получают штраф.
Как работает нейросеть? В качестве примера можно рассмотреть процесс обучения нейросети распознаванию лиц. Чтобы корректно обучить любую нейросеть, нужно сделать две вещи: собрать достаточное количество данных и определить, за что мы будем ее штрафовать. Применительно к этой задаче необходимо собрать несколько десятков фотографий лиц для каждого из людей, которых надо определить, и штрафовать нейросеть за то, что предсказанный ею человек не совпадает с человеком на фотографии.
Что значит «поощрять» и «штрафовать» нейросеть?
С математической точки зрения нейросеть — это функция с большим количеством параметров. Штрафование этой функции за неверное определения лица — это когда мы, упрощенно говоря, корректируем работу функции таким образом, чтобы в будущем она меньше ошибалась. Соответственно, поощрение нейросети — это когда мы ее просто не штрафуем.
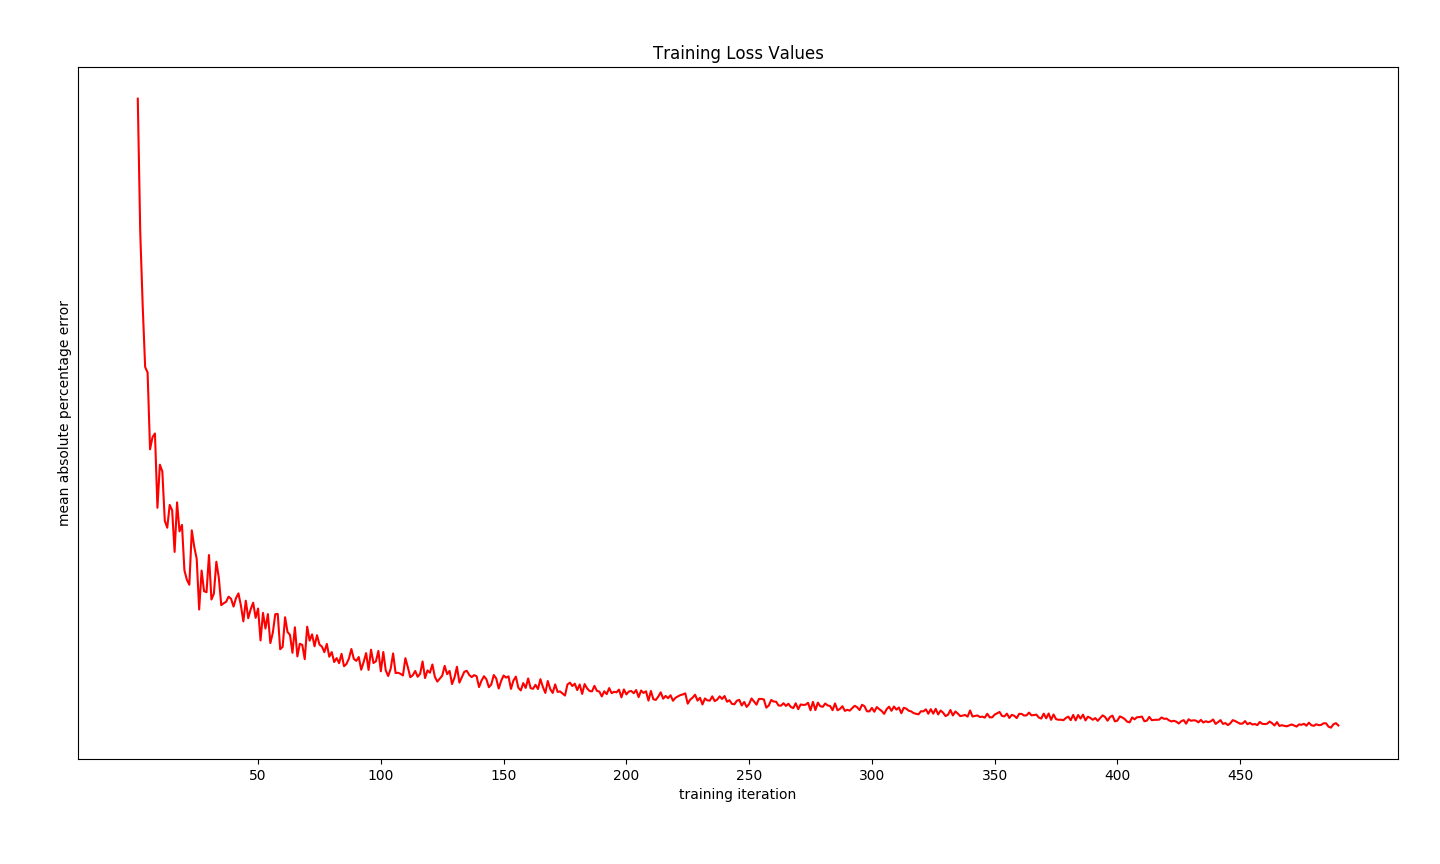
График зависимости между длительностью обучения (горизонтальная ось) и конечной ошибкой (вертикальная ось). Чем дольше мы учим нейросеть, тем меньше ошибка.
Во всех примерах вы рассказываете про конкретные задачи. А можно ли нейросеть научить думать, как человек?
Это уже скорее философский вопрос. Мыслительный процесс напрямую связан с наличием сознания. Нейронная сеть, как и любой другой алгоритм машинного обучения, по своей сути является лишь математической функцией, и умеет решать лишь одну конкретную задачу. Нейросеть, которую учили отличать кошек и собак, не сможет отличить медведя от слона, ведь она даже не знала, что такие существуют. Процессы же анализа данных, которые происходят в голове у человека, намного сложнее чем те, что происходят в нейросети, так что даже при наличии данных, сопоставимых по размеру с массивом информации, которую за жизнь получает человек, сегодня обучить нейросеть думать, как человек, невозможно.
Подписывайтесь и читайте нас в Яндекс.Дзене — технологии, инновации, эко-номика, образование и шеринг в одном канале.
Введение в искусственный интеллект
Курс «Введение в искусственный интеллект» поможет овладеть навыками Data Culture.
- О курсе
- Формат
- Информационные ресурсы
- Требования
- Программа курса
- Результаты обучения
- Формируемые компетенции
- Направления подготовки
- Отзывы о курсе
О курсе
Курс является вводным и знакомит слушателей с основами науки о данных и принципами работы искусственного интеллекта. Курс будет интересен и полезен не только тем, кто уже знаком с основами анализа данных и программированием, но и тем, кто не имеет бэкграунда в этой области.
За последние десятилетия во многих областях науки и индустрии стали накапливаться большие объемы данных, а также стали развиваться методы машинного обучения, позволяющие извлекать из этих данных знания и экономическую пользу. Сегодня методы анализа данных позволяют решать настолько сложные задачи, что в применении к ним всё чаще используют термин “искусственный интеллект”.
Задача онлайн курса от НИУ ВШЭ — дать слушателям базовое представление о методах искусственного интеллекта, познакомить с терминологией и научить применять некоторые из методов для решения несложных задач. В процессе обучения вы дистанционно узнаете больше о мире искусственного интеллекта, его методах и даже самостоятельно попробуете обучать несложные модели на готовых данных.
Формат
Курс состоит из 12 недель. Каждая неделя содержит видеолекции, тестовые задания и материалы для самостоятельного изучения. В открытом доступе вы можете ознакомиться с видеолекциями первых двух недель, остальные материалы станут доступны после оплаты курса.
Информационные ресурсы
- Смолин Д. В. Введение в искусственный интеллект: конспект лекций. Учебное пособие. М: ФИЗМАТЛИТ, 2007.
- Osondu O. A First Course in Artificial Intelligence. Bentham Science Publishers Ltd., 2021.
- Алексеева И.Ю. Интеллект и технологии: монография. М: Проспект, 2016.
Требования
Программа курса
- Введение в искусственный интеллект.
- Введение в машинное обучение.
- Машинное обучение в задачах классификации.
- Введение в машинное обучение: кластеризация и визуализация данных.
- Введение в теорию вероятностей.
- Введение в математическую статистику.
- A/B тестирование.
- Основы визуализации данных.
- Введение в нейронные сети.
- Нейронные сети в задачах распознавания изображений.
- Нейронные сети в задачах стилизации изображений.
- Другие задачи искусственного интеллекта: рекомендательные системы и ассоциативные правила.
Результаты обучения
В результате усвоения курса слушатели научатся:
- Обучать несложные модели на готовых данных в Orange;
- Интерпретировать статистические данные;
- Проводить разведывательный анализ данных;
- Понимать основные ошибки в рассуждениях на основе данных;
- “Отличать случайное от неслучайного” — проверять гипотезы;
- Грамотно визуализировать результаты исследований.
Формируемые компетенции
Курс позволяет освоить следующие компетенции в соответствии с Рекомендациями к дополнительным профессиональным программам ИТ-профиля, реализуемым в рамках проекта «Цифровые кафедры» университета–участника программы стратегического академического лидерства «Приоритет-2030»:
Сфера: Искусственный интеллект и машинное обучение
Компетенция: Применяет искусственный интеллект и машинное обучение
Уровень: Базовый
Сфера: Искусственный интеллект и машинное обучение
Компетенция: Решает задачи искусственного интеллекта (ИИ)
Уровень: Базовый
Как обучают искусственный интеллект?
Компьютер AlphaGo, разработанный компанией Google Deepmind, выиграл матч в го у многократного чемпиона по этой игре Ли Седоля. Из пяти партий AlphaGo выиграл четыре. Компьютер, способный обыграть шахматного чемпиона существует уже много лет, но го долгое время считалась слишком сложной игрой для нейросетей.
Каких еще нейросетей?
Нейросеть — это база, на которой строится искусственный интеллект, его «мозг». Если коротко, нейросеть — это сложная программа, состоящая из огромного множества простых программ, каждая из которых «реагирует» на какой-то свой сигнал. Система работает примерно как лампочка: при определенном условии «зажигается», а в остальных случаях — нет. Каждая из таких маленьких программ называется нейроном, а нейросеть — это, собственно, гигантская сеть нейронов, объединенных в последовательные слои.
Нейроны? Это как в мозге?
Нет, это только аналогия. Искусственные нейросети имеют отношение к математике и алгоритмам, а не к анатомии. И в нейросети, и в мозге человека нейроны по отдельности довольно примитивны, но когда их очень много — миллионы, сотни миллионов или миллиарды — они могут научиться вместе решать почти любую задачу.
Что значит «научиться»?
Для того чтобы нейросеть делала полезную работу, ее надо учить. Как учится ребенок: мы показываем ему много кошек разных цветов и много собак разных пород, но не объясняем отличий между кошками и собаками в целом (форму ушей, хвоста или носов, возможные позы). В какой-то момент у ребенка накапливается опыт, и он начинает отличать любую кошку от любой собаки на всякой картинке. То же самое и с нейросетью: мы даем ей «посмотреть» огромные коллекции фотографий кошек и собак, и в конце концов компьютер сам для себя вырабатывает признаки, по которым в будущем отличает одно от другого.
Ух ты! А как это происходит?
Как у детей. Сначала нейросеть почти ничего не умеет, а каждый нейрон в ней реагирует на поступающие в него сигналы случайным образом. То есть, она угадывает, кто на фотографии — кошка или собака — с вероятностью 50 процентов. Но если мы дадим много таких заданий и будем говорить правильный ответ, нейросеть научится отличать на фотографиях кошек от собак не хуже человека. После каждой попытки сеть «закрепляет знания» — изменения внутри нейронов, которые положительно повлияли на верное решение, фиксируются.
И многому так можно научить?
Очень. Распознаванию изображений и видео, пониманию речи и диалогу с человеком, рисованию картин и написанию музыки, постановке диагнозов и еще сотням задач, которые пока считаются прерогативой человека.
Можете привести примеры, которые уже существуют?
Пожалуйста. «Яндекс» использует нейросети для поиска изображений: пользователь загружает свою картинку а искусственный интеллект ищет похожие образы. Созданные в Google нейросети научились находить котов в Youtube-роликах и рисовать картины. Другие ученые научили нейросеть решать кроссворды. А в MIT создали нейросеть, которая «изучила» предвыборные речи и твиты кандидата в президенты США Дональда Трампа и теперь ведет его фейковый твиттер.
То есть скоро создадут Скайнет, как в «Терминаторе»?
Вряд ли. Нейросеть только выполняет задачи, но не ставит их перед собой. Пока за нее это делает человек, мы в безопасности. Кроме того, универсальной нейросети, которая одинаково хорошо решала бы несколько разных задач, не существует. Программа, победившая сильнейших игроков в го, не сможет отличить кубик от шарика на картинке.
Нейросети и искусственный интеллект — это что-то новое в мире технологий?
Не совсем. Основы нейросетей были заложены математиками еще в середине прошлого века. Но до недавнего времени их потенциал трудно было раскрыть полностью. Для обучения большой нейросети нужно очень много мощных компьютеров — слишком много нейронов и связей между ними нужно настроить.
Могу я сам обучить нейросеть новым задачам? Например, по видео в домофоне определять, что за человек пришел.
Сейчас это требует специальных знаний, большого количества данных для обучения и вычислительных ресурсов. Но со временем обучение нейросетей и их использование будет становиться проще и доступнее.
Где узнать больше о нейросетях?
Читайте на «Медузе» интервью о том, как нейросеть научили играть в го лучше человека, зачем это было нужно и как искусственный интеллект изменит нашу жизнь в ближайшее время.
Автор: Александр Крайнов, руководитель службы компьютерного зрения и технологий искусственного интеллекта компании «Яндекс»
- Телеграм
- Фейсбук
- Твиттер