Глава 1. Введение в драйвера устройств
Интерес к написанию драйверов для Linux устойчиво растет, по мере роста популярности этой операционной системы. Linux – межплатформенная ОС, большая часть кода которой, не зависит от аппаратной платформы, и большинство пользователей (к счастью) могут ничего не знать об ее аппаратных особенностях. Большей частью, особенности каждой аппаратной платформы сокрыты в реализации драйверов, которые и делают возможной работу ОС на данной платформе.
Драйвера устройств играют специальную роль в ядре Linux. Они представляют собой “черные ящики”, которые обрабатывают определенную часть запросов к аппаратной части Linux ядра через хорошо организованный внутренний программный интерфейс. Особенности работы каждого конкретного устройства полностью скрыты в коде драйвера. Запросы пользователей посылаются через стандартный набор системных вызовов, который не зависит от конкретного драйвера (но, несколько зависит от класса обслуживаемого устройства). Эти запросы отображаются на аппаратно-зависимые функции, которые управляют реальными устройствами. Именно набор этих функций и играют роль драйвера устройств. Программный интерфейс реализован таким образом, что драйвера могут быть построены отдельно от ядра, и прилинкованы (связаны с ядром) в запущенное ядро по мере надобности. Это свойство драйверов в Linux называется модульностью и сильно упрощает написание и управление драйверами.
Таким образом, драйвера в Linux могут быть реализованы как часть ядра, а могут быть реализованы как модули, линкуемые (устанавливаемые) в ядро по мере необходимости.
Эта книга научит вас тому, как можно написать свой собственный драйвер и как просматривать определенные части ядра. Мы будем рассматривать аппаратно-независимое приближение. При необходимости, будет представлена техника программирования и интерфейс, не применительно к какому-либо устройству. Каждый драйвер уникален, как и программист, который его пишет. Лично вам потребуется глубокое понимание специфики вашего устройства. Но несмотря на уникальность каждого конкретного драйвера, большинство принципов одинаковы для всех драйверов. Эта книга не научит вас работать с вашим устройством, но она расскажет вам об общих принципах, которые помогут вам заставить ваше устройство работать.
Пока вы будете учиться писать драйвера, вы многое узнаете о ядре Linux, и это поможет вам понять, как работает машина вообще, и почему некоторые вещи работают не так, как вы ожидаете. Мы будем знакомиться с новыми идеями постепенно, начиная с очень простых драйверов. Каждую новую концепцию мы будем сопровождать простым кодом, не относящемуся к какой-то конкретной аппаратной конструкции.
В этой главе мы не будем писать какого-либо кода. Однако, мы познакомимся с некоторыми базовыми концепциями, знание которых поможет нам в дальнейшем программировании.
Роль драйверов устройств
Как программисту, при написании драйвера, вам предстоит разрешить компромисс между временем, затраченным на программирование, и гибкостью результирующего кода. И хотя многим может показаться странным говорить о “гибкости” драйвера (англ. flexibility, имеется в виду гибкость, с точки зрения политики управления драйвером), но нам нравится это слово, потому что оно подчеркивает роль драйвера устройства, который обеспечивает механизм взаимодействия с устройством, но не политику управления им.
Различие между механизмом управления и политикой управления представляет собой одну из лучших идей в Unix архитектуре. Большинство проблем программирования можно разделить на две части: “какие характеристики необходимо обеспечить” (функциональность и связанный с ней механизм реализации), и “как эти характеристики можно будет использовать” (политика). Если эти два элемента реализуются разными частями программы, или даже разными программами, то такой программный пакет легче разрабатывать и адаптировать к конкретным целям.
Для примера, Unix управление графическим дисплеем разделено между X сервером, с одной стороны, и менеджерами окон и сессии с другой. X серверу, который предоставляет унифицированный интерфейс для пользовательских программ, известны особенности оборудования. Ни менеджер окон, ни менеджер сессии ничего не знают об аппаратных особенностях дисплея. Пользователи могут использовать один и тот же оконный менеджер на разных аппаратных платформах, или использовать различные оконные менеджеры на одной и той-же рабочей станции. Даже совершенно различные десктопы, такие как KDE и GNOME могут сосуществовать на одной системе, благодаря хорошо продуманной архитектуре графической подсистемы Unix.
Другой пример слойной структуры – это семейство протоколов TCP/IP. Операционная система предоставляет абстракцию, называемую сокет (socket), которая реализует передачу данных, но не управляет политикой такой передачи. С другой стороны, различные сетевые серверы, предоставляющие различные сервисы, опираясь на транспорт сокетов, реализуют политику передачи данных. Кроме того, серверы, наподобии ftpd реализуют сервис передачи файлов, в то время как пользователи могут использовать любую клиентскую программу, которую они предпочитают, для работы с этим сервером. Таким образом, политика, должна быть максимально свободна от реализации всех остальных функций системы.
Ко всем типам драйверов применимо одно и то-же разделение механизма управления и политики управления. Драйвер дисковода для гибких дисков не содержит в своем коде никакой политики, его роль – показать содержимое дискеты как последовательность блоков данных. Более высокие уровни операционной системы обеспечивают политику управления: какие пользователи могут получить доступ к дисководу, читается ли диск напрямую или через файловую систему, и какие пользователи могут монтировать файловую систему, расположенную на дискете. Т.к., в зависимости от разных причин, требуется различный способ работы с устройством, очень важно, чтобы код драйвера был свободен от политики настолько, насколько это возможно.
При написании драйвера, программист должен уделить особенное внимание следующей фундаментальной концепции: пишите код взаимодействия с аппаратурой, но не форсируйте проблемы политики использования драйвера, т.к. различные пользователи могут иметь различные требования к этой политике. Управлять такой политикой должны пользовательские приложения. Драйвер, который обеспечивает доступ к оборудованию без дополнительных ограничений называется гибким. Однако, для упрощения кода драйвера, в некоторых случаях, требуется присутствие в его коде и некоторых политических решений. Например, драйвер ввода/вывода может предоставлять только побайтовый доступ к аппаратным ресурсам, для того, чтобы не перегружать драйвер дополнительным кодом доступа к индивидуальным битам.
Вы можете смотреть на ваш драйвер с различных точек зрения. С одной стороны это программный слой, лежащий между приложением и реальным устройством. Эта особая роль драйвера позволяет программисту определить представление устройства в программе – различные драйвера могут иметь различные характеристики даже для одного и того же устройства. При разработке драйвера решаются различные компромиссы. Например, простое устройство может использоваться одновременно различными программами, и программист должен решить, каким образом будут обрабатываться такие параллельные запросы. Вы можете реализовать отображение памяти на устройство независимо от аппаратных особенностей платформы, или вы можете предоставить пользовательскую библиотеку, реализующую особенную политику управления, для приложений, использующих драйвер. Основной компромисс заключается между желанием предоставить наиболее полный набор функций управления устройством и между тем временем, которое вы желаете потратить на реализацию драйвера и устранение ошибок.
Драйверы не реализующие политику управления имеют некоторые общие особенности. В них реализована поддержка синхронных и асинхронных операций. Они обеспечивают параллельные запросы (например, одновременно от разных приложений). Они в состоянии предоставить наиболее полные характеристики оборудования. Также, в них максимально сокращено количество программных слоев, что несколько упрощает проектирование и ускоряет работу драйвера. Драйвера этого сорта не только работают лучше, с точки зрения конечных пользователей, но и более просты в использовании.
Многие драйвера устройств реализуются совместно с пользовательскими программами, упрощающими конфигурирование и доступ к устройству. Диапазон этих программ достаточно широк, от простых утилит до сложных графических приложений. Часто, также, предоставляются клиентские библиотеки, обеспечивающие более высокоуровневый доступ к функциям драйвера.
В рамках данной книги описывается ядро операционной системы Linux, поэтому мы попытаемся обойти стороной вопросы политики управления устройствами, построения клиентских программ и клиентских библиотек. Конечно, в особых случаях, мы будем касаться политики управления устройством, но не станем акцентировать на этом внимание. Вы должны понимать, что пользовательские программы являются неотъемлемой частью комплекса управления устройством, и что, как минимум, этот комплекс подчиняется общесистемной политике.
Структура ядра
В системе Unix, множество, конкурирующих за ресурсы, процессов заняты решением различных задач. Каждый процесс запрашивает системные ресурсы, такие как процессорное время, память, сетевые и файловые службы, и прочее. Ядро представляет собой программный код, в задачу которого входит разделение ресурсов вычислительной системы между различными процессами. И хотя различия между различными задачами ядра не всегда прозрачны для понимания, можно попытаться изобразить взаимодействие различных элементов ядра в виде структурной схемы, как показано на рисунке 1-1.
Рисунок 1-1. Структурная схема ядра.
Управление процессами Одной из функций ядра является управление созданием и уничтожением процессов, обеспечение взаимодействие процессов с внешним миром (ввод/вывод) и обеспечение взаимодействия процессов между собой (сигналы, трубы (pipes), и IPC-примитивы (interprocess communication). Также, в функции управления процессами, входит диспетчеризация процессов, которая управляет разделением времени процессора между процессами. Управление памятью Память компьютера представляет собой очень важный ресурс компьютера, и реализация политики его разделения существенно влияет на производительность операционной системы. Ядро предоставляет огромные виртуальные пространства памяти некоторым или всем процессам на фоне ограниченных физических ресурсов. Различные части ядра взаимодействуют с подсистемой управления памятью через определенный набор функций, начиная от простой пары malloc()/free() и заканчивая множеством более сложных экзотических функций. Файловые системы Unix жестко связан с концепцией файловых систем: почти все в Unix может быть представлено как файл. Ядро выстраивает структурированную файловую систему из неструктурированного аппаратного слоя, и результирующая файловая абстракция жестко вплетена во все компоненты системы. В дополнении к этому, Linux поддерживает множество типов файловых систем, которые различным способом организуют данные на физических носителях информации. Для примера, дискета может быть отформатирована либо в Linux стандарте, файловой системе ext2, либо, в распространенных на Windows платформе, форматах FATx. Управление устройствами Практически каждая системная операция, в конечном счете, отображается на физическое устройство. За исключением процессора, памяти и некоторых других элементов, все остальные операции управления устройствами выполняются кодом, специфичным для адресуемого устройства. Этот код называется драйвером устройства. Ядро должно включать в себя драйвер каждого устройства, управляемого системой, начиная от жесткого диска и заканчивая клавиатурой и мышью. Именно этот аспект функциональности ядра представляет главный интерес для данной книги. Сетевые службы Сетевой транспорт должен быть реализован в ядре операционной системы, т.к. большинство сетевых операций не специфичны для процессов – поступление пакетов является асинхронным событием. Пакеты должны быть собраны, идентифицированы и диспетчеризованы перед тем, как будут переданы на дальнейшую обработку в пользовательские процессы. Система должна управлять передачей пакетов данных между программами через сетевые интерфейсы. Маршрутизация и система распознавания различных классов сетевых адресов, также должны быть реализована в ядре операционной системы.
Продвигаясь к концу книги вы познакомитесь более подробно с функциями ядра в главе 16.
Одной из замечательных характеристик ядра Linux является способность расширять функциональность ядра во время его работы. Это означает, что вы можете добавить требуемые функции в ядро без перезагрузки операционной системы.
Драйвер, который может быть прилинкован (добавлен) к ядру во время его работы называется модулем. Ядро Linux поддерживает несколько типов (или классов) модулей. Модуль представляет собой объектный код (т.е. код не линкованный в исполняемую программу), который может быть динамически установлен в ядро с помощью программы insmod, и удален из ядра, с помощью команды rmmod.
На рисунке 1-1 изображены различные классы модулей, исполняющих специфические задачи. Говорят, что модули принадлежат определенному классу, в зависимости от функциональности, которую они предлагают. Положение модулей на рисунке 1-1 покрывает наиболее важные, но далеко не полные классы модулей, т.к. функциональность, реализуемая модулями в Linux, все более и более расширяется.
Классы устройств и модулей
В Unix, устройства подразделяются на три класса (типа). Каждый модуль реализует поддержку одного из этих классов устройств, и, таким образом, подразделяется на модули символьных, блочных и сетевых устройств. Такое разделение модулей на различные классы не является жестким. Программист может создать большой модуль, реализующий различные драйверы в одном куске кода. Однако, более верным стилем программирования является создание различных модулей для каждой новой функциональности, которую они добавляют, т.к. декомпозиция является ключевым элементом масштабируемости и расширяемости.
Рассмотрим более подробно все три класса устройств:
Символьные устройства (character devices)
Символьным называется устройство, которое может быть представлено потоком байт (как файл). Такие драйвера реализуют, по меньшей мере, системные вызовы open(), close(), read() и write(). Текстовая консоль (/dev/console) и последовательные порты (/dev/ttyS0 и аналогичные) представляют собой примеры символьных устройств, т.к. они отлично представляются через абстракцию потока. Доступ к символьным устройствам реализуется через специальные файлы, называемые интерфейсами устройств, которые обычно располагаются в каталоге /dev. Отличие между символьным устройством и файлом, заключается в том, что открыв обычный файл, вы можете перемещаться по нему как вперед, так и назад, в то время как символьное устройство представляет собой последовательный канал данных. Однако, существуют символьные устройства, которые представляются как область данных, и вы также можете перемещаться по ней как вперед, так и назад, используя функции lseek() и mmap().
Блочные устройства (block devices)
Доступ к блочным устройствам, так же как и к символьным, осуществляется через специальные файлы-интерфейсы устройств, расположенные, обычно, в каталоге /dev. На блочных устройствах, как правило, размещаются файловые системы. В большинстве Unix систем, блочные устройства могут быть представлены только как множество блоков. Размер блока кратен степени двух и часто равен одному килобайту данных. Linux позволяет приложениям читать и писать в блочные устройства, также как и в символьные. Разница заключается в том, что при обращении к блочному устройству передается блок данных, а не один байт (символ). Для пользователя, блочные и символьные устройства неразличимы. Драйвер блочного устройства взаимодействует с ядром через более широкий блочно-ориентированный интерфейс, но это скрыто от пользователя и приложений, которые взаимодействуют с устройством через файл интерфейса устройства, расположенного, как правило, в каталоге /dev. Интерфейсы блочных устройств наиболее удобны для монтирования файловых систем.
Сетевые интерфейсы (network interfaces)
Передача данных по сети характеризуется тем, что сетевое устройство, передающее трафик, взаимодействует с другим, таким же устройством. Обычно, сетевой интерфейс реализован на основе аппаратного устройства, но возможна и чисто программная реализация, например интерфейс loopback. На сетевой интерфейс, который управляется сетевой подсистемой ядра, наложены функции приема и передачи пакетов данных, без понимания того, как конкретные транзакции отображаются на реально передаваемые пакеты. Разные сетевые службы, например telnet или FTP, ведут передачу данных через одно и тоже сетевое устройство, которое не знает об индивидуальных потоках, и только передает пакеты данных. При этом, и telnet и FTP являются потокоориентированными системами, в то время как сетевой интерфейс не принадлежит к потокоориентированным устройствам, а работает с дискретными данными — пакетами. Под потокоориентированной системой следует понимать систему передающую данные непрерывным потоком байт, не дискретизируя поток на какие-нибудь блоки (пакеты, фреймы и пр.).
Не будучи потокоориетированным, сетевой интерфейс не может быть легко представлен через файловый интерфейс устройства, наподобии /dev/tty1. В ОС Unix, доступ к сетевому интерфейсу осуществляется через уникальное имя, такое как eth0, которое не является элементом файловой системы. Взаимодействие между ядром и драйвером сетевого устройства полностью отличается от взаимодействия с символьным и блочным устройством. Вместо чтения и записи, ядро вызывает функции, относящиеся к передаче пакетов.
В ОС Linux представлены и другие классы модулей. Модули каждого класса предоставляют интерфейс для предоставления определенного типа устройств. Поэтому, можно говорить о модулях шины USB, последовательного порта и т.д. К наиболее общему, нестандартному классу устройств относятся устройства SCSI. И хотя любое устройство подсоединенное к шине SCSI представляется файлом интерфейсом в каталоге /dev как символьное или блочное устройство, внутренняя организация таких драйверов отличается.
SCSI есть акроним от Small Computer System Interface, и представляет собой учрежденный стандарт на рынке рабочих станций и high-end серверов.
Также как сетевые карты обеспечивают аппаратно-зависимую функциональность сетевой подсистемы, также, контроллеры SCSI обеспечивают функциональность подсистемы SCSI для доступа к устройствам на соответствующей шине. SCSI представляет коммуникационный протокол между компьютером и периферийными устройствами, и каждое SCSI устройство работает в этом протоколе, независимо от того, какой контроллер установлен на вашем компьютере. Поэтому ядро Linux включает в себя реализацию SCSI (т.е. отображает файловые операции на коммуникационный протокол SCSI). Разработчик драйвера должен реализовать отображение между SCSI абстракцией и физической шиной. Это отображение зависит от SCSI контроллера и не зависит от устройств, подключенных к SCSI шине.
Другие классы устройств добавлены к ядру в последнее время, включая драйвера USB, FireWire и I2O. По подобию управления драйверами SCSI, разработчики ядра классифицируют характеристики классов устройств и передают их реализацию на уровень драйверов. Такая классификация необходима, прежде всего, для того, чтобы избежать дублирования работы и ошибок, упрощая, тем самым, процесс написания таких драйверов.
В добавление к драйверам устройств, в ядре модуляризируются и другие функции для поддержки программно-аппаратных технологий. Помимо драйверов устройств, файловые системы, возможно, представляют собой важнейший класс модулей системы Linux. Тип файловой системы определяет способ организации информации о дереве файлов и каталогов на блочном устройстве. По своей сути это не драйвер устройства, т.к. нет явного устройства, связанного со способом размещения информации на нем. Драйвер файловой системы представляет собой программный слой, отображающий низкоуровневые структуры данных (блоки) в высокоуровневые (деревья). Тип файловой системы определяет набор атрибутов и максимальную длину имени файла. Модуль файловой системы должен реализовать самый нижний уровень системных вызовов при обращении к файлам и каталогам. Реализация заключается в отображение имен файлов и путей на структуру данных, сохраняемых в блоках данных устройства. При этом учитывается дополнительная информации, такая как режимы доступа. Такой интерфейс совершенно не зависит от реальной передачи данных с диска и на диск (или другую среду), который реализуется драйвером блочного устройства.
Если вы понимаете как сильно система Unix зависит от используемой файловой системы, то вы легко представите себе жизненную важность такой программной концепции для системных операций. Способность декодировать информацию о файловой системе лежит на самом нижнем уровне иерархии ядра, и это очень важно. Даже если вы пишете блочный драйвер для вашего нового устройства CD-ROM, он будет бесполезным, если вы не сможете выполнить команды ls или cp для данных, которые содержаться на установленном в нем диске. Linux поддерживает концепцию модулей файловых систем, чей программный интерфейс описывает различные операции, которые могут быть выполнены над inode, каталогом, файлом и суперблоком файловой системы. Написание модулей для файловых систем достаточно редкая задача, т.к. официальное ядро уже содержит код для большинства типов существующих файловых систем.
Замечания о безопасности
Вопросы безопасности для современных систем представляют собой весьма актуальную задачу постоянно растущей важности. По мере продвижения по книге, мы будем затрагивать эти вопросы. Однако, имеются несколько важных понятий, которые стоит затронуть уже сейчас.
Нарушение безопасности системы может быть рассмотрено в двух аспектах – случайном и преднамеренном. Обычный пользователь может случайно нарушить безопасность системы в результате неправильного использования программ, или в результате использования программ, содержащих ошибки. Программист, имея, как правило, более высокую квалификацию, нежели обычный пользователь, потенциально представляет большую заботу для системы безопасности. Запуск чужой программы под логином суперпользователя означает, иногда, передачу создателю программы прав суперпользователя. И хотя свободный доступ к компилятору напрямую не означает дыру в безопасности, но эта дыра может стать явной после запуска откомпилированной программы или, тем более модуля. Помните, что модуль установленный в ядро может делать все что угодно, без каких либо серьезных ограничений.
Любая проверка безопасности в системе порождается кодом ядра. Если ядро имеет дыру в безопасности, значит эту дыру имеет операционная система. При использовании официальной версии ядра, загрузка модулей разрешена только авторизованным пользователям. Системный вызов create_module() проверяет авторизацию пользователя при загрузке модуля в ядро. Таким образом, при использовании официальной версии ядра, использование привилегированного кода допустимо только суперпользователем или злоумышленником получившем права привилегированного пользователя.
Версия ядра 2.0 позволяет запускать привилегированный код только суперпользователю, в то время как версия 2.2 имеет более изощренные способы проверки авторизации. Мы обсудим это в главе 5 «Capabilities and Restricted Operations» и «Enhanced Char Driver Operations».
По возможности, разработчики драйверов должны избегать политики безопасности в своем коде. Безопасность системы это проблема политики управления, которая часто решается на верхних уровнях ядра или системы лучшим способом, и управляется системным администратором. Однако, всегда имеются исключения из этого правила. Как разработчик драйвера, вы должны избегать ситуаций, в которых, через запросы к драйверу можно получить злоумышленный доступ к системным ресурсам. Т.е. вы должны обеспечить адекватный контроль таких запросов. Например, операции с устройством, которые управляют глобальными ресурсами (такими как установка линий прерываний) или операции, которые не должны производиться другими пользователями (такие как установка размера блока по умолчанию на магнитном накопителе) обычно доступны только привилегированным пользователям, и такая проверка должна быть реализована в самом драйвере.
Конечно же, разработчики драйверов должны быть особенно внимательны и избегать ошибок при реализации системы безопасности. Язык программирования C, позволяет легко допустить некоторые типы ошибок. Например, сегодня известно множество дыр в безопасности системы, которые открываются через переполнение буфера. Программисты забывают проверить количество данных передаваемых в буфер обмена между программами. Такие ошибки могут иметь непредсказуемые последствия для системы в целом, и для ее безопасности в частности. Поэтому таких ошибок надо избегать. К счастью, в контексте драйверов устройств, избежать таких ошибок относительно легко, так как интерфейс драйвера с пользователем жестко определен и хорошо контролируется.
Стоит ознакомиться с некоторыми основными идеями безопасности. К любым входным данным, полученным от пользовательского процесса, стоит относиться с большим подозрением. Никогда не доверяйте данным не проверив их. Будьте внимательны при инициализации памяти. Любая память полученная из ядра должна быть инициализирована (например, обнулена) сразу, или, хотя бы, перед тем, как она будет передана пользовательскому процессу или устройству. В противном случае, может произойти утечка информации. Если ваше устройство интерпретирует данные посланные в него, то будьте уверены, что пользователь не может послать ничего, что могло бы подвергнуть систему риску сбоя. Наконец, думайте о возможных последствиях дисковых операций. Если какие либо специфические операции (например, форматирование диска) могут повредить систему, то они должны быть ограничены привилегиями пользователей.
Будьте внимательны, когда получаете программный продукт со стороны, особенно если он связан с работой в ядре. Помните, что каждый, кто имеет источники кода, может его модифицировать и перекомпилировать. В результате, всем известная программа может превратиться в троянского коня. Как правило, вы можете доверять ядру полученному вами из дистрибутива, но вы не должны использовать ядра, компиляция которых произведена кем-то, кому вы не доверяете. Например, ядро, откомпилированное с преднамеренным злым умыслом, может позволить загружать в себя модули кому угодно, что полностью открывает двери к системе через создание модулей.
Заметьте, что ядро Linux может быть собрано без поддержки модулей вообще, что закроет одну из потенциальных дыр в безопасности системы. В этом случае, конечно, все необходимые драйвера должны быть встроены в ядро. Также, используя ядра версии 2.2 и выше, возможно запрещение загрузки модулей после загрузки системы через специальный механизм.
Нумерация версий
Перед началом программирования, мы бы хотели прокомментировать схему нумерации версий ядра, используемую в Linux. Также, следует сказать о версиях, для которых материал книги является актуальным.
Прежде всего, обратите внимание, что каждый программный пакет, используемый в ОС Linux имеет свой собственный номер релиза, и что часто, имеются зависимости между релизами различных пакетов. Создатели Linux дистрибутивов решают проблемы совместимости пакетов. Поэтому пользователи, которые инсталлируют пакеты из таких дистрибутивов, не интересуют вопросы совместимости версий зависимых пакетов. Взяв новый пакет со стороны, или решив апгрейдить существующий пакет, вы можете столкнуться с проблемой совместимости. К счастью, большинство современных дистрибутивов поддерживают автоматическую проверку зависимостей пакетов. И, обычно, менеджеры пакетов не позволят установить пакет до удовлетворения зависимостей.
Для того, чтобы запустить примеры приводимые в книге вам не будут нужны, какие-нибудь особые версии инструментов, за исключением ядра – можно использовать любой современный Linux дистрибутив. Те читатели, кому интересно, могут ознакомиться с особенностями, используемой ими версии ядра, в файле Documentation/Changes в каталоге источников ядра (как правило /usr/src/linux/).
Что касается версий ядра, то четно нумерованные версии (например 2.2.х или 2.4.х) отражают стабильность версии и предназначены для использования в готовых дистрибутивах. Нечетно нумерованные версии (например 2.3.х), наоборот, отражают нестабильность и предназначены для тестеров и разработчиков.
Эта книга охватывает версии ядра от 2.0 до 2.4. Акцент сделан на описании характеристик версии 2.4, последней, на момент написания книги. Версия 2.2 отражена в книге практически полностью. Сосредоточено внимание на различиях 2.2 и 2.4, а также на характеристиках недоступных в 2.0. В общем, примеры приведенные в книге должны соответствовать широкому диапазону версий ядра. Примеры тестировались на версии 2.4.4, и применимы, также для версий 2.2.18 и 2.0.38 (по оригинальному английскому тексту непонятно, тестировались ли примеры на чем-нибудь кроме 2.4.4).
В тексте книги специально не рассматриваются нечетно-нумерованные версии ядра. Т.к. разработчики, экспериментирующие с новыми характеристиками нестабильных ядер, обычно, достаточно искусно работают с кодом ядра и данная книга не представляет для них интереса. Обычные пользователи, которые могут стать читателями данной книги, не имеют причин для использования нестабильных ядер. Следует заметить, что на экспериментальные версии ядер не предоставляется никаких гарантий.
Заметьте, что даже если вы пользуетесь четно-нумерованными ядрами, какие-либо гарантии вам может обеспечить только коммерческий дистрибьютор, на основе договора о купле-продаже.
Как уже говорилось, Linux является аппаратно-независимой операционной системой. Это уже давно не “Unix клон для PC клонов”. Linux успешно работает на процессорах Alpha и SPARC, на платформах 68000 и PowerPC. Число платформ, поддерживаемых Linux растет, наверное, каждый месяц. Эта книга, насколько это возможно, платформенно-независима. Примеры были протестированны на нескольких платформах, таких как PC, Alpha, ARM, IA-64, M68k, PowerPC, SPARC, SPARC64, и VR41xx (MIPS). Т.к. код был протестирован как на 32-битных, так и на 64-битных процессорах, он, предположительно, должен откомпилироваться и запуститься на любых других платформах.
Условия лицензии
Операционная система Linux, лицензирована GNU General Publib License (GPL). GPL разработана в рамках проекта GNU организацией Free Software Foundation. GPL позволяет всем желающим заниматься распространением, и даже продажей, продуктов, выпущенных под данной лицензией. Пользователи таких продуктов могут собирать точные копии бинарных файлов из источников, предоставляемых согласно лицензии. Кроме того, все программные продукты, произведенные на основе продуктов, лицензированных GPL, также должны выпускаться под лицензией GPL.
Главной целью этой лицензии является разрешение свободного распространения знаний. Кому угодно, на основе определенных правил, разрешена модификация существующих программ. В тоже время, люди, занимающиеся продажей программного обеспечения, могут спокойно делать свою работу, продавая, в том числе, программы лицензированные GPL. Несмотря на простейшие цели, проставленные GPL, до сих пор не прекращаются бесконечные споры о GPL и ее использовании. Если вы хотите ознакомиться с лицензией, вы можете найти ее в различных местах вашей файловой системы, включая каталог размещения источников ядра: /usr/src/linux. Название файла с лицензией – COPYING.
Модули третьих фирм и ваши собственные модули не являются частью ядра Linux, и вы имеете право не лицензировать их под GPL. Модули линкуются в ядро при установке, но не являются частью ядра. Модули, в какой-то степени, похожи на пользовательские программы, работающие с ядром через системные вызовы. Заметьте, что освобождение от GPL применимо только к модулям, использующим открытый интерфейс модулей. Модули, которые взаимодействуют с ядром на более глубоком уровне должны твердо придерживаться условий GPL.
В общем, если ваш код входит в ядро, вы должны использовать GPL, как только вы отдаете свой код за пределы собственного пользования. Также, изменяя код, вы можете не использовать GPL, пока вы являетесь единоличным пользователем измененного кода. Если же вы распространяете код, то вы должны включать источник кода в дистрибутив, чтобы пользователи, которые его приобрели, могли бы сами скомпилировать бинарные формы для них. С другой стороны, если вы сами пишите модуль, вы можете распространять его в бинарной форме. Однако, это не всегда практично, т.к. модули должны быть скомпилированы с той версией ядра, в которое они должны быть слинкованы (установлены). Это подробно обсуждается в главе 2 «Building and Running Modules» (раздел «Version Dependency») и главе 11 «kmod and Advanced Modularization» (раздел «Version Control in Modules»). Новые версии ядра (даже младшие стабильные релизы) часто отказывают в линковке прекомпилированным модулям, требуя перекомпиляцию. Линус Торвальдс высказал мнение, что он не видит в этом проблемы, т.к. модуль должен быть скомпилирован для той версии ядра, в которую он, предположительно, будет установлен. Как разработчик модуля вы будете более полезны пользователям, если источники вашего модуля будут доступны для них.
Большая часть кода, размещенного в данной книге, свободно распространяемая. Ни мы ни O’Reilly & Associates не удерживают права на любое изменение приведенного кода. Все программы доступны на http://examples.oreilly.com/linuxdrive2 . Там-же, в файле LICENSE изложены условия лицензирования приведенного кода.
Примеры программ, содержащиеся в книге, включают код ядра, применяется соглашения GPL, т.е. вносятся необходимые комментарии.
Вступление в общество разработчиков ядра (Kernel Development Community)
Как только вы начнете писать модули для ядра Linux, вы станете частью большого сообщества разработчиков. Внутри этого сообщества, вы найдете не только людей, занимающихся подобной работой, но и группу высококвалифицированных инженеров, работающих над улучшением Linux системы. Эти люди могут помочь вам советами, идеями и критическими замечаниями. Среди них, вы легко найдете тестеров вашего нового драйвера.
Центральное место взаимодействия разработчиков Linux ядра – linux-kernel mailing list. На него подписаны все основные разработчики, начиная с Линуса Торвальдса. Трафик этого почтового листа достигает 200 сообщений в день и более. Несмотря на это, данная информация очень важна для тех, кто интересуется разработкой ядра.
Для того, чтобы подписаться на linux-kernel mailing list следуйте инструкциям, которые лежат в FAQ по адресу http://www.tux.org/lkml . Пожалуйста, прочитайте данный FAQ до конца, прежде чем подписаться на него. Там может оказаться масса полезной информации для вас. Разработчики Linux ядра очень занятые люди, и они более расположены помочь тем, кто может ясно излагать свои проблемы.
Обзор книги
Итак, мы вступаем в мир программирования ядра. Глава 2 “Построение и запуск модулей” ознакомит вас с построением модулей, объясняя секреты мастерства на основе приводимых примеров. В главе 3 “Символьные устройства” подробно рассматриваются драйвера символьных устройств и приводится полный код memory-based драйвера устройства, с которым можно производить операции чтения и записи. Использование памяти как аппаратной основы позволяет кому угодно запустить простой код без использования специального оборудования.
Техника отладки имеет жизненно важное значение для программиста и обсуждается в главе 4 “Техника отладки”. Получив навыки отладки, мы познакомимся с более сложными составляющими драйвера символьного устройства, такими как блоковые операции, использование выбора, и вызовами ioctl. Об этом подробно рассказано в главе 5 «Enhanced Char Driver Operations».
Перед началом работы по управлению аппаратными средствами, мы обсудим некоторые элементы программного интерфейса ядра. Глава 6 «Flow of Time» расскажет об управлении временем в ядре. Глава 7 «Getting Hold of Memory» объясняет основы динамического распределения памяти в ядре.
Далее, мы сфокусируем внимание на аппаратной части. Глава 8. «Hardware Management» описывает управление портами ввода вывода и буферами памяти, которые находятся в устройстве. После этого, в главе 9 “Управление прерываниями” мы познакомимся с управлением прерываниями, возникающими в аппаратуре. К несчастью, не у каждого будет возможность запустить примеры кода из этих глав, просто потому, что для работы этих программ потребуется специальное оборудование. Мы пытались свести к минимуму требования к тестовому оборудованию, но вам, все таки, понадобится засучить рукава и взять в руки паяльник для сборки собственного устройства. Устройство представляет собой простейшую контактную пару подсоединенную к параллельному порту. Мы надеемся, что у вас не будет проблем со сборкой такого устройства.
В главе 10 «Judicious Use of Data Types» обсуждаются дополнительные вопросы, связанные с написанием кода ядра. Например, вопросы связанные с переносимостью кода под разные платформы.
К следующей части книги, мы приходим уже с большим багажом базовых знаний. Глава 11 «kmod and Advanced Modularization» вводит нас в глубинные вопросы модуляризации.
Затем, в главе 12 «Loading Block Drivers» описывается реализация драйверов для блочных устройств. Там же затрагиваются отличия драйверов для блочных и символьных устройств. В главе 13 «mmap and DMA» объясняются вопросы управления памятью, которые, по разным причинам, не были рассмотрены в предыдущих главах. Будут рассмотрены такие механизмы, как kiobuf (kernel input-output buffer), mmap (memory mapping – отображение памяти) и DMA (Direct Memory Access — прямой доступ к памяти). После ознакомления с этими главами будут исчерпаны все вопросы, связанные с построением драйверов для символьных и блочных устройств.
Далее рассматривается третий по важности класс драйверов. В главе 14, “Network Drivers” в деталях рассматривается сетевой интерфейс и анализируется код простого сетевого драйвера.
Некоторые характеристики драйверов устройств напрямую зависят от интерфейса шины, на которую они установлены. Так, в главе 15 «Overview of Peripheral Buses» проведен обзор главных характеристик, наиболее широко применяемых сегодня, интерфейсных шин. Особое внимание уделяется, поддерживаемым в ядре, шинам PCI и USB.
Наконец, в главе 16 «Physical Layout of the Kernel Source» проводится ознакомительный тур по источникам ядра. Эту главу можно назвать стартовой точкой для всех тех, кто хочет понять общую картину, но напуган огромным количеством источников кода Linux ядра.
Как написать драйвер для linux
Что такое драйвер устройства. Создание драйвера устройства — дело достаточно трудоемкое. Запись на жесткий диск требует помещения определенных цифровых данных в определенное место, ожидания ответа на запрос о готовности жесткого диска, затем аккуратной пересылки информации. Запись на флопповод проходит еще сложнее — нужен постоянный контроль на текущим состоянием дискеты. Вместо помещения кода каждого отдельного приложения управляющего устройством, вы разделяете код между приложениями. Вам следует защитить этот код от других пользователей и использующих его программ. Если вы верно сделали это, то вы можете без смены приложений подключать или убирать устройства. Более того, вы должны иметь возможности ОС — загрузить вашу программу в память и запустить ее. Так что ОС, в сущности, — это набор привилегированных, общих и частных функций или функций аппаратного обеспечения низкого уровня,функций работы с памятью и функций контроля. Все версии UNIX имеет абстрактный способ считывания и записи на устройство. Действующие устройства представляются в виде файлов, так что одинаковые вызовы ( read(), write() и т.п.) могут быть использованы и как устройства и как файлы. Внутри ядра существует набор функций, отмеченных как файлы, вызываемые при запросе для ввода/вывода на файлы устройств, каждый из которых представляет свое устройство. Всем устройствам, контролируемым одним драйвером, дается один и тот же основной номер, и различные подномера. Эта глава описывает, как написать любой из допускаемых в Linux типов драйверов устройств : символьных, блочных, сетевых и драйверов SCSI. Она описывает, какие функции вы должны написать, как инициализировать драйверы и эффективно выделять под них память, какие функции встроены в Linux для упрощения деятельности такого рода. Создание драйвера устройств для Linux оказывается более простым чем мнится на первый взгляд, ибо оно включает в себя написание новой функции и определение ее в системе переключения файлов(VFS). Тем самым, когда доступно устройство, присущее вашему драйверу, VFS вызывает вашу функцию. Однако, вы должны помнить, что драйвер устройства является частью ядра. Это означает, что ваш драйвер запускается на уровне ядра и обладает большими возможностями : записать в любую область памяти, повредить ваш монитор или разбить вам унитаз в случае, если ваш компьютер управляет сливным баком. Также ваш драйвер будет запущен в режиме работы с ядром, а ядро Linux, как и большинство ядер UNIX, не имеет средств принудительного сброса. Это означает, что если ваш драйвер будет долго работать, не давая при этом работать другим программам, ваш компьютер может «зависнуть «. Нормальный пользовательский режим с последовательным запуском не обращается к вашему драйверу. Если вы решили написать драйвер устройства, вы должны внимательно прочитать всю эту главу, однако, нет гарантий, что эта глава не содержит ошибок, и вы не сломаете ваш компьютер, даже если будете следовать всем инструкциям. Единственный совет — сохраняйте информацию перед запуском драйвера. Драйверы пользовательского уровня. Не всегда нужно писать драйвер для устройства, особенно если за устройством следит всего одно приложение. Наиболее полезным примером этому является устройство карты памяти, однако вы можете сделать карту памяти с помощью устройств ввода/вывода (доступ к устройствам осуществляется с помощью функций inpb() и outpb()). Если вы работаете в режиме superuser, вы можете использовать функцию mmap для того, чтобы поместить вашу функцию в какую-то область памяти. С помощью этой процедуры вы сможете весьма просто работать с адресами памяти, как с обычными переменными. Если ваш драйвер использует прерывание, то вам придется работать внутри ядра, так как не существует других путей для прерываний обычных пользовательских процессов. В проекте DOSEMU однако, есть Простейший Генератор прерываний — SIG, но он работает недостаточно быстро, как это можно было ожидать от последней версии DOSEMU. Прерывание — это жестко определенная процедура. Также вы при установке своего аппаратного обеспечения вы определяете линию IRQ для физического сигнала прерываний, возникающего, когда устройство обращается к драйверу. Это происходит, когда устройство пересылает или запрашивает информацию, а также при обнаружении каких-либо исключительных ситуаций, о которых должен знать драйвер. Для обработки прерываний в ядре и для обработки сигналов на пользовательском уровне используется одна и та же структура данных — sigaction. Таким образом, где сигналы аппаратных прерываний доставляются ядру точно так же, как системные сигналы на уровне пользовательского обеспечения. Если ваш драйвер должен обращаться к нескольким процессам сразу или управлять общими ресурсами, тогда вы должны написать драйвер устройства, и драйвер пользовательского уровня вам не подходит.
2.2.1 Пример — vgalib.
Хорошим примером драйвера пользовательского уровня является библиотека vgalib. Стандартные функции read() и write() не подходят для написания действительно быстрого графического драйвера, и поэтому существует библиотека функций, которая концептуально работает как драйвер устройства, но на пользовательском уровне. Все функции, которые используют ее, должны запускать setuid, так как она использует системную функцию ioperm(). Функции, которые не запускают setuid, обладают возможностью записи в /DEV/MEM, если у вас есть группы mem или kmem, которые позволяют это, но только корневые процессы могут запускать ioperm(). Есть несколько портов ввода/вывода, относящихся к графике VGA. Vgalib дает им символические имена с помощью #define, и далее используют ioperm() для разрешения функции правильного прочтения и записи в эти порты.
if (ioperm(CRT_IC, 1, 1)) < printf("VGAlib: can't get I/O permission \n"); exit(-1); >ioperm(CRT_IM, 1, 1); ioperm(ATT_IW, 1, 1); [--]
Это требует лишь однократной проверки, так как единственной причиной нефункционирования ioperm() может быть обращение к ней не в статусе superuser или во время смены статуса. /\
\/ После вызова этой функции разрешается использование inb и outb инструкций, однако лишь с определенными портами. Эти инструкции могут быть доступны без использования прямого ассемблерного кода , но работают они лишь в случае компиляции с параметром optimization on и с ключом -0?. Для более подробных сведений читай .
После обращения в порты ввода вывода vgalib засылает информацию в область ядра следующим образом :
/* open /dev/mem */ if ((mem_fd = open(«/dev/mem», 0_RDWR) ) < 0) < prntf( "VGAlib: can' t open /dev/mem \n"); exit (-1); >/* mmap graphics memory */ if ((graph_mem = malloc(GRAPH*SIZE + (PAGE-SIZE-1))) == NULL) < printf( " VGAlib: allocation error \n "); exit (-1); >if ((unsigned long)graph_mem % PAGE_SIZE) graph_mem += PAGE_SIZE — ((unsigned long)graph_mem % PAGE_SIZE); graph_mem = (unsigned char *)mmap( (caddr_t)graph_mem, GRAPH_SIZE, PROT_READ|PROT_WRITE, MAP_SHARED|MAP_FIXED, mem_fd, GRAPH_BASE ); if ((long)graph_mem
В начале программа открывает /dev/mem, затем выделят достаточное количество памяти для распределения на страницу, затем меняет карту памяти.
GRAPHSIZE - размер памяти vga. GRAPHBASE - адрес начала памяти VGA в /dev/mem.
Затем, записывая в адрес возвращаемый mmap(), программа осуществляет запись в память экрана.
2.2.2 Пример : Преобразование мыши.
Если вы хотите написать драйвер, работающий так же, как и драйвер на уровне ядра, но не находящийся в его области, то вы можете создать fifo (буфер — first in, first out). Обычно он помещается в директорию /dev (во время нефункционирования) и ведет себя как подключенное устройство. В частности, это используется когда вы используете мышь типа PS/2 и хотите запустить XFree86. Вы должны создать fifo, называемый /dev/mouse, и запустить программу mconv, которая, читая сигналы мыши PS/2 из /dec/psaux, пишет эквивалентные сигналы microsoft mouse в /dev/mouse. В этом случае XFree86 будет читать сигналы из /dev/mouse и функционировать также как и при подключенной microsoft mouse.
2.3 Основы драйверов устройств.
Мы будем полагать, что вы не хотите писать драйвер на пользовательском уровне, а желаете работать непосредственно в области ядра. В таком случае вам придется иметь дело с файлами .с и .h. Мы будем условно обозначать ваши труды как foo.c и foo.h.
2.3.1 Область имени (именная область).
Первое что вы должны сделать при написании драйвера — назвать устройство. Имя должно выть кратким — строка из двух — трех символов. К примеру, параллельные устройства — «lp», дисководы «fd», диски SCSI — «sd». Создавая ваш драйвер, называйте функции в нем с первыми тремя буквами избранной строки в имени. Так как мы называем его foo — функции в нем соответственно — foo_read и foo_write.
2.3.2 Выделение памяти.
- Память выделяется кусками размером степени 2, за исключением кусков больше 128 байтов, размер коих равен степени 2 за вычетом части под метку о размере. Вы можете запросить произвольный размер, однако это будет неэффективно, так как 31 байтового об’екта, к примеру, выделяется 32 байтовый кусок. Общий предел выделяемой памяти 131056 байт.
- В качестве второго аргумента kmalloc() использует приоритет. Он используется в качестве аргумента функции get_free_page(), где он используется в качестве числа определяющего момент возврата. Обычно используемый приоритет — GFP_KERNEL. Если функция может быть вызвана с помощью прерывания используйте GFP_ATOMIC и приготовьтесь к тому, что функция может не работать. Это происходит из-за того, что при использовании GFP_KERNEL kmalloc() может не быть активным в любой момент времени, что не возможно при прерывании. Можно так же использовать опцию GFP_BUFFER, которая используется для выделения ядром области буфера. В драйверах устройств она не используется.
См 2.6 для получения более подробной информации о kmalloc(), kfree() и о других полезных функциях.
-
! Существует возможность выделения виртуальной памяти с помощью vmalloc(), однако это будет описано лишь в главе VMM во время ее написания. В данный момент вам придется изучать это самостоятельно.!
2.3.3 Символьные и блочные устройства.
Существует два типа устройств в системах UN*X — символьные и блочные устройства. Для символьных устройств не предусмотрено буфера, в то время как блочные устройства имеют доступ лишь через буферную память. Блочные устройства должны быть равнодоступными, а для символьных это не обязательно, хотя и возможно. Файловая система может работать лишь в случае, если она является блочным устройством.
Общение с символьными устройствами осуществляется с помощью функций foo_read() и foo_write(). Функции foo_read() и foo_write() не могут останавливаться в процессе деятельности, поэтому блочные устройства даже не требуют использования этих функций, а вместо этого используют специальный механизм, называемый «strategy routine» — стратегическая подпрограмма. Обмен информацией происходит при помощи функций bread(), breada(), bwrite(). Эти функции, просматривая буферную память, могут вызывать «strategy routine» в зависимости от того, готово устройство или нет к приему информации (в случае записи — буфер переполнен), или же присутствует ли информация в буфере (в случае чтения ).Запрос текущего блока из буфера может быть асинхронен чтению — breada() может вначале определить график передачи информации, а затем заняться непосредственно передачей. Далее мы представим полный обзор буферной памяти(кэш). Исходные тексты для символьных устройств содержатся в /kernel/chr_drv, исходники для блочных — /kernel/blk_drv. Для простоты чтения интерфейсы у них довольно просты, за исключением функций записи и чтения. Это происходит из за определения вышеописанной «strategy routine» в случае блочных устройств и соответствующего ему определения foo_read и foo_write() для символьных устройств. Более подробно об этом в 2.4.1 и 2.5.1.
2.3.4. Прерывание или поочередное опрашивание устройств ?
Аппаратное обеспечение работает достаточно медленно. Это определяется временем получения информации, в момент получения которой процессор не занят, и находится в состоянии ожидания. Для того чтобы вывести процессор из режима работа — ожидание, вводятся ! прерывания ! — процессы, предназначенные для прерывания конкретных операций и предоставления ОС задачи по выполнению которой последняя без потерь возвращается в исходное положение.
В идеале все устройства должны обрабатываться с использованием прерываний, однако на PC и совместимых прерывания используются лишь в некоторых случаях, так что некоторые драйверы вынуждены проверять аппаратное обеспечение на готовность к приему информации.
Так же существуют аппаратные средства ( дисплей с распределенной памятью ) работающие быстрее остальных частей компьютера. В таком случае драйвер, управляемый прерываниями будет выглядеть нелепо.
В Linux cуществуют как драйверы, управляемые прерываниями так и драйверы, не использующие прерываний, и оба типа драйверов могут отключаться или включаться во время работы подпрограммы. В частности, «lp» устройство ждет готовности принтера к принятию информации и, в случае отказа, отключается на какой-то промежуток времени, чтобы затем попытаться вновь.
Это улучшает показатели системы. Однако, если вы имеете параллельную карту, поддерживающую прерывания, драйвер, используя ее, увеличит скорость работы. Существуют несколько программных отличий между драйвером, управляемым прерываниями и ждущими драйверами. Для осознания этих отличий вы должны представлять себе устройство системных вызовов UN*X. Ядро — неразделяемая задача под UN*X. В таком случае в каждом процессе находится копия ядра.
Когда процесс запускает системный запрос, он не передает управление другому процессу, а скорее меняет режим исполнения на режим ядра. В этом режиме он запускает он запускает защищенный от ошибок код ядра.
В режиме ядра процесс все еще имеет доступ к пространству памяти пользователя, как и до смены режима, что достигается с помощью макросов: get_fs_*() и memcpy_fromfs(), осуществляющих чтение из памяти, и put_fs_*() и memcpy_tofs(), осуществляющих запись. Так как процесс переходит из одного режима в другой, вопроса о помещении информации в определенную область памяти не возникает.
-
! Об’ясните, как работает verify_area(), который используется лишь в случае необусловленной защиты от записи во время работы в режиме ядра для проверки области памяти, принимающей информацию.!
Вместо отслеживания прерываний драйвер может выделять временную область для информации.Когда часть драйвера, управляемая прерыванием, заполняет эту область, она замораживает процесс,списывает информацию в пространство памяти пользователя.В блочных устройствах драйвер, создающий эту временную область, снабжен механизмом кеширования, что не предусмотрено в символьных устройствах.
2.3.5. Механизмы замораживания и активизации.
Начнем с об»яснения механизма заморозки и его использования. Это включает в себя то, что процесс, будучи в замороженном состоянии (не функционирует), в какой — то момент времени можно активизировать, а затем опять заморозить (приостановить )!
Возможно, лучший способ понять механизм замораживания и активизации в Linux — изучение исходного текста функции __sleep_on(), использующейся для описания функций sleep_on() и interruptible_sleep_on().
static inline void __sleep_on(struct wait_queue **p, int state) < unsigned long flags; struct wait_queue wait = < current, NULL >; if (!p) return; if (current == task[0]) panic ( "task[0] trying to sleep"); current->state = state; add_wait_queue(p, &wait); save_flags(flags); sti(); schedule(); remove_wait_queue(p, &wait); restore_flags(flags); >
wait_queue — циклический список указателей на структуры задач, определенные в как
struct wait_queue < struct task_struct * task; struct wait_queue * next; >;
Меткой состояния процесса в данном случае является или TASK_INTERRAPTIBLE, или TASK_UNINTERRAPTIBLE, в зависимости от того, может ли заморозка процесса прерываться такими вещами, как системные вызовы.Вообще говоря, механизм заморозки необходимо прерывать лишь в случае медленных устройств, так как такое устройство может приостановить на достаточно длительный срок работу всей системы. add_wait_queue() отключает прерывание, создает новый элемент структуры wait_queue, определенной в начале функции как список p.Затем она восстанавливает в исходное положение метку о состоянии процесса.
save_flags() — макрос, сохраняющий флаги процессов, задаваемых в виде аргументов. Это делается для фиксации предыдущего положения метки состояния процесса. Таким образом, функция restore_flags() может восстанавливать положение метки.
Функция sti() затем разрешает прерывания, а schedule() выбирает для выполнения следующий процесс. Задача не может быть избранной для выполнения, пока метка не будет находиться в состоянии TASK_RUNNING.
Это достигается с помощью функции wake_up(),примененной к задаче, ждущей в структуре p своей очереди.
Затем процесс исключает себя из wait_queue,восстанавливает состояние положения прерывания с помощью restore_flags() и завершает работу.
Для определения очередности запросов на ресурсы в структуру wait_queue введены указатели на задачи, использующие этот ресурс. В таком случае, когда несколько задач запрашивают один и тот же ресурс одновременно, задачи, не получившие доступ к ресурсу, замораживаются в wait_queue.По окончании работы текущей задачи активизируется следующая задача из wait_queue,относящаяся к этому ресурсу с помощью функций wake_up() или wake_up_interruptible().
Если вы хотите понять последовательность разморозки задач или более детально изучить механизм заморозки, вам нужно купить одну из книг, предложенных в приложении А и просмотреть !mutual exclusion! и !deadlock!.
2.3.5.1.Усложненный механизм заморозки.
Если механизм sleep_on()/wake_up() в Linux не удовлетворяет вашим требованиям, вы можете усовершенствовать его. В качестве примера тому можете посмотреть серийный драйвер устройства (/kernel/chr_drv/serial.c), функцию
block_til_ready(), которая представляет собой несколько измененные add_wait_queue() и schedule()
2.3.6. VFS.
VFS — Virtual Filesystem Switch (Система виртуального переключения файловой системы ) — механизм, позволяющий Linux поддерживать сразу несколько файловых систем. В первой версии Linux доступ к файловой системе осуществляется через подпрограммы, работающие с файловой системой minix. Для обеспечения возможности работы с другой файловой системой ее вызовы переопределяются как функции знакомой Linux системы файлов. Это делается с помощью программы, содержащей структуру указателей на функции, представляющие все возможные действия с файловой системой. Вызывает интерес структура file_operations :
From /usr/include/linux/fs.h: struct file_operations < int (*lseek) (struct inode *, struct file *, off_t, int); int (*read) (struct inode *, struct file *, char *, int); int (*write) (struct inode *, struct file *, char *, int); int (*readdir) (struct inode *, struct file *, struct dirent *, int count); int (*select) (struct inode *, struct file *, int, select_table *); int (*ioctl) (struct inode *, struct file *, unsigned int, unsigned int); int (*mmap) (struct inode *, struct file *, unsigned long, size_t, int, unsigned long); int (*open) (struct inode *, struct file *); void (*release) (struct inode *, struct file *); >;
Эта структура содержит список функций, нужных для создания драйвера.
2.3.6.1. Функция lseek().
Функция вызывается, когда в специальном файле, представляющем устройство, появляется системный вызов lseek().Это функция перехода текущей позиции на заданное смещение.Ей задается четыре аргумента :
struct inode * inode - Указатель на структуру inode для этого устройства. struct file * file - Указатель на файловую структуру для данного устройства. off_t offset - Смещение от ! origin !. int origin 0 = смещение от начала. 1 = смещение от текущей позиции. 2 = смещение от конца.
lseek() возвращает -errno в случае ошибки или положительное смещение после выполнения.
Если lseek() отсутствует, ядро автоматически изменяет элемент file -> f_pos.При origin = 2 в случае file -> f_inode = NULL ему присваивается значение -EINVAL,иначе file -> fpos принимает значение file -> f_inode -> i_size + offset.Поэтому в случае возврата ошибки устройства системным вызовом lseek() вы должны использовать функцию lseek для определения этой ошибки.
2.3.6.2. Функции read() и write().
Функции read() и write() осуществляют обмен информацией с устройством, посылая на него строку символов.Если функции read() и write() отсутствуют в структуре file_operatios, определенной в ядре, то в случае символьного устройства одноименные вызовы будут возвращать -EINVAL.В случае блочных устройств функции не определяются, так как VFS будет общаться с устройством через механизм обработки буфера, вызывающий «strategy routine». См. 2.5.2 для более подробного изучения устройства механизма работы с буфером.
- struct inode * inode
— Указатель на структуру inode специального файла устройства, доступного для использования непосредственно пользователем. В частности, вы можете найти подномер файла при помощи конструкции unsigned int minor = MINOR(inode -> i_rdev); Определение макроса MINOR находится в , так же, как и масса других нужных определений. Для получения более подробной информации см. fs.h. Более подробное описание представлено в 2.6. Для определения типа файла может быть использована inode -> i_mode. - struct file * file
— Указатель на файловую структуру этого устройства. - char * buf
— Буфер символов для чтения и записи. Он расположен в пространстве памяти пользователя, и доступ к нему осуществляется с помощью макросов get_fs*(), put_fs*() и memcpu*fs(), описанных в 2.6. Пространство памяти пользователя не доступно во время прерывания, так что если ваш драйвер управляется прерываниями, вам придется списывать содержание буфера в очередь (queue). - int count
— Число символов, записанных или читаемых из buf. count — размер буфера, так что с помощью него легко определить последний символ buf, даже если буфер не заканчивается NULL.
2.3.6.3 Функция readdir().
Еще один элемент структуры file_operations, используемый для описания файловых систем так же, как драйверы устройств. Функция не нуждается в предопределении. Ядро возвращает -ENOTDIR в случае вызова readdir() из специального файла устройства.
2.3.6.4 Функция select().
- struct inode * inode
— Указатель на структуру inode устройства. - struct file * file
— Указатель на файловую структуру устройства. - int sel_type
— Тип совершаемого действия
SEL_IN — чтение
SEL_OUT — запись
SEL_EX — удаление - select_table * wait
— Если wait = NULL, функция select() проверяет, готово ли устройство, и возвращается в случае отсутствия готовности. Если wait не равен NULL, select() замораживает процесс и ждет, пока устройство не будет готово. Функция select_wait() делает то же, что и select() при wait = NULL.
2.3.6.5 Функция ioctl().
- struct inode * inode
— Указатель на inode структуру данного устройства; - struct file * file
— Указатель на файловую структуру устройства; - unsigned int cmd
— Команда, над которой осуществляется контроль; - unsigned int arg
— Это аргумент для команды, определяется пользователем. В случае, если он вида (void *), он может быть использован как указатель на область пользователя, обычно находящуюся в регистре fs. - Возвращаемое значение :
-errno в случае ошибки, все другие значения определяются пользователем.
- FIOCLEX 0x5451
Устанавливает бит «закрытие для запуска» - FIONCLEX 0x5450
Очищает бит «закрытие для запуска» - FIONBIO 0x5421
Если аргумент не равен 0, устанавливает O_NONBLOCK, иначе очищает O_NONBLOCK. - FIOASYNC 0x5421
Если аргумент не равен 0, устанавливает O_SYNC, иначе очищает O_SYNC. Пока еще не описано, но для полноты вставлено в ядро.
Помните, что вам надо учитывать эти четыре номера при написании своих ioctl(), так как они могут быть несовместимы между собой, откуда в программе может возникнуть тяжело обнаруживаемая ошибка.
2.3.6.6.Функция mmap().
- struct inode *inode
— Указатель на inode - struct file *file
— Указатель на файловую структуру - unsigned long addr
— Начальный адрес блока, используемого mmap() - size_t len — Общая длина блока.
- int prot — Принимает значения:
PROT_READ читаемый кусок
PROT_WRITE перезаписываемый кусок
PROT_EXEC кусок, доступный для запуска
PROT_NONE недоступный кусок - unsigned long off
— Внутрифайловое смещение, от которого производится перестановка. Этот адрес будет переставлен на адрес addr.
[В описании распределения памяти описано, как функции интерфейса Менеджера виртуальной памяти могут быть использованы mmap().]
2.3.6.7. Функции open() и release().
- struct inode *inode
— Указатель на inode - struct file *file
— Указатель на файловую структуру
Функция вызывается после открытия специальных файлов устройств. Она является механизмом слежения за последовательностью выполняемых действий. Если устройством пользуется лишь один процесс, функция open() закроет устройство любым доступным в данный момент способом, обычно устанавливая нужный бит в положение «занято». Если процесс уже использует устройство (бит уже установлен), open() возвращает -EBUSY.
Если же устройство необходимо нескольким процессам, эта функция обладает возможностью любой очередности.
Если устройство не существует, open() вернет -ENODEV.
Функция release() вызывается лишь тогда, когда процесс закрывает последний файловый дескриптор. release() может переустанавливать бит «занято». После вызова release(), вы можете очистить куски выделенной kmalloc() памятью под очереди процессов.
2.3.6.8 Функция init().
Эта функция не входит в file_operations но вам придется использовать ее, так как именно она регистрирует file_operations с содержащейся там VFS — — без нее запросы на драйвер будут находится в беспорядочном состоянии. Эта функция запускается во время загрузки и самоконфигурирования ядра. init() получает переменную с адресом конца используемой памяти. Затем она обнаруживает все устройства, выделяет память, исходя из их общего числа, сохраняет полезные адреса и возвращает новый адрес конца используемой памяти. Функцию init() вы должны вызывать из определенного места. Для символьных устройств это /kernel/cdr_dev/mem.c. В общем случае функции надо задавать лишь переменную memory_start.
- int major — основной номер устройства.
- srtring name — имя устройства.
- адрес #DEVICE#_fops структуры file_operations.
После окончания работы функции, файлы становятся доступными для VFS, и она по надобности переключает устройство с одного вызова на другой.
Функция init() обычно выводит сведения о найденном аппаратном обеспечении и информацию о драйвере.Это делается с использованием функции printk().
2.4 Cимвольные устройства.
2.4.1. Инициализация.
- int major — основной номер драйвера.
- char *name — имя драйвера оно может быть изменено, но не имеет практического применения.
- struct file_operations *fops — адрес определенной вами file_operations.
- Возвращаемые значения : 0 — в случае если указанным основным номером ни одно устройство более не обладает. не 0 в случае некорректного вызова.
2.4.2 Прерывания или последовательный вызов ?
В драйверах, не использующих прерывания, легко пишутся функции foo_read() и foo_write() :
static int foo_write(struct inode * inode, struct file * file, char * buf, int count) < unsigned int minor = MINOR(inode->i_rdev); char ret; while (count > 0) < ret = foo_write_byte(minor); if (ret < 0) < foo_handle_error(WRITE, ret, minor); continue; >buf++ = ret; count-- > return count; >
foo_write_byte() и foo_handle_error() — функции, также определенные в foo.c или псевдокоде.
WRITE — константа или определена #define.
Из примера также видно как пишется функция foo_read(). Драйверы, управ- ляемые прерываниями, более сложны :
Пример foo_write для драйвера, управляемого прерываниями :
static int foo_write(struct inode * inode, struct file * file, char * but, int count) < unsigned int minor = MINOR(inode->i_rdev); unsigned long copy_size; unsigned long total_bytes_written = 0; unsigned long bytes_written; struct foo_struct *foo = &foo_table[minor]; do < copy_size = (count foo_buffer, buf, copy_size); while (copy_size) < /* запуск прерывания */ if (some_error_has_occured) < /* обработка ошибочного состояния */ >current->timeout = jiffies +FOO_INTERRUPT_TIMEOUT; /* set timeout in case an interrupt has been missed */ interruptible_sleep_on(&foo->foo_wait_queue); bytes_written = foo->bytes_xfered; foo->bytes_written = 0; if (current->signal & ~current->blocked) < if (total_bytes_written + bytes_written) return total_bytes_written + bytes_written; else return -EINTR; /* nothing was written, system call was interrupted, try again */ >> total_bytes_written += bytes_written; buf += bytes_written; count -= bytes-written; > while (count > 0); return total_bytes_written; > static void foo_interrupt(int irq) < struct foo_struct *foo = &foo_table[foo_irq[irq]]; /* Here, do whatever actions ought to be taken on an interrupt. Look at a flag in foo_table to know whether you ought to be reading or writing. */ /* Increment foo->bytes_xfered by however many characters were read or written */ if (buffer too full/empty) wake_up_ interruptible(&foo->foo_wait_queue); >
Здесь функция foo_read также аналогична. foo_table[] — массив структур, каждая из которых имеет несколько элементов, в том числе foo_wait_queue и bytes_xfered, которые используются и для чтения, и для записи. foo_irq[] — — массив из 16 целых использующийся для контроля за приоритетами элементов foo_table[] засылаемыми в foo_interrupt().
- номеp irq, котоpым вы pасполагаете>
- указатель на пpоцедуpу упpавления пpеpываниями, имеющую аpгумент типа integer.>
request_irq() возвpащает -EINVAL, если irq > 15, или в случае указателя на пpогpамму pавного NULL, EBUSY если пpеpывание уже используется или 0 в случае успеха.
irqaction() pаботает также как функция sigaction() на пользовательском уpовне и фактически использует стpуктуpу sigaction. Поле sa_restorer() в стpуктуpе не используется, остальное — же осталось неизменным. См. pаздел «Функции поддеpжки» для более полной инфоpмации о irqaction().
2.5 Дpайвеpы для блочных устpойств.
Пpи поддеpжке файловой системы устpойства, она должна быть pазбита на блоки самим устpойством. Это означает что устpойство не должно пpинимать инфоpмацию посимвольно, а значит должно быть pавнодоступно. Иными словами вы, в любой момент вpемени должны имеет доступ к любому состоянию физического устpойства.
Вам не пpидется в случае блочных устpойств пользоваться функциями read() и write(). Вместо них используются функции block_read() и block_write() находящиеся в VFS и называемые !strategy routine! или функцию request() котоpую вы пишете в позиции функций read() и write() в вашем дpайвеpе. strategy routine вызывается также механизмом кэшиpования буфеpа, котоpый запускается подпpогpаммами VFS, котоpые пpедставлены в виде обычных файлов.
Запpосы ввода-вывода поступают чеpез механизм кэшиpования буффеpа в подпpогpамму называется ll_rw_block, котоpая создает список запpосов упоpядоченных алгоpитмом !elevator!, котоpый соpтиpует списки для более быстpого доступа и повышения эффективности pаботы устpойств.
Затем она вызывает фнкцию request() для осуществления ввода — вывода. Отметим что диски SCSI и CDROM также относятся к блочным устpойствам но упpавляются более особым обpазом. Часть 2.7 «Hаписание дpайвеpа SCSI» описывает это более подpобно.
2.5.1 Инициализация
Инициализация блочного устpойства имеет более общий вид, нежели инициализация символьного устpойства, т.к. часть «инициализации» пpоисходит во вpемя компиляции. Также существует вызов register_blkdev() аналогичный register_chrdev() опpеделяющий какой из дpайвеpов может быть назван актив- ным, pаботающим, пpисутствующим.
2.5.1.1 Файл blk.h
Вначале текста вашего дpайвеpа после описания.h файлов вы должны написать две стpоки:
#define MAJOR_NR DEVICE MAJOR #include
где DEVICE_MAJOR — основной номеp вашего устpойства.drivres/block/blk.h тpебует основной номеp для установки дpугих опpеделений и макpосов дpайвеpа.
Тепеpь вам нужно изменить файл blk.h.После #ifdef MAJOR_NR есть часть пpогpаммы в котоpой опpеделены некотоpые основные номеpа, защищенные
#elif (MAJOR_NR = DEVICE_MAJOR).
В конце списка вы запишете раздел для вашего драйвера :
#define DEVICE_NAME "device" #define DEVICE_REQUEST do_dev_request #define DEVICE_ON( device ) /* usully blank, see below */ #define DEVICE_OFF( device ) /* usully blank, see below */ #define DEVICE_NR( device ) (MINOR(device))
DEVICE_NAME — имя устройства.В качестве примера посмотрите предыдущие записи в blk.h.
DEVICE_REQUEST — ваша «strategy routine», которая будет осуществлять ввод/вывод в вашем устройстве.См 2.5.3 для более полного изучения.
DEVICE_ON и DEVICE_OFF — для устройств, которые включаются/выключаются во время работы.
DEVICE_NR(device) — используется для определения номера физического устройства с помощью подномера устройства. В частности, драйвер hd, в то время как второй жесткий диск работает с подномером 64, DEVICE_NR(device) определяется (MINOR(device) >> 6).
Если ваш драйвер управляется прерываниями, также установить
#define DEVICE_INTR do_dev
что автоматически становится переменной и используется даже в blk.h, в основном макросами SET_INTR и CLEAR_INTR.
Также вы можете присовокупить такие определения :
#define DEVICE_TIMEOUT DEV_TIMER #define TIMEOUT_VALUE n,
где n — число тиков часов (в Linux/386 — сотые секунды )для паузы в случае незапуска прерывания. Это делается для того,чтобы драйвер не ждал прерывания, которое может никогда не случиться. Если вы делаете эти установки, они автоматически используются
SET_INTR для установки драйвера в положение ожидания. Конечно, в таком случае ваш драйвер должен будет иметь возможность отмены ожидания.
Как разработать драйвер Linux с нуля
Недавно я занимался изучением IoT и, так как мне не хватало устройств, при попытках симулировать работу прошивки я часто сталкивался с неимением нужного /dev/xxx. Так что я стал задумываться, а могу ли написать драйвер самостоятельно, чтобы заставить прошивку работать. Независимо от того, насколько сложно это будет, и удастся ли воплотить такое намерение, в любом случае вы не пожалеете, если научитесь разрабатывать драйвер Linux с нуля.
❯ Введение
Я написал серию статей, ориентированных в основном на практику, о теории там мало что говорится. Разрабатывать драйверы я научился по книге Linux Device Drivers, а код к примерам, разобранным в этой книге, выложен на GitHub.
Если начать с азов – операционная система Linux делится на пространство ядра и пользовательское пространство. Доступ к аппаратному устройству возможен только через пространство ядра, а драйвер устройства при этом может трактоваться как API, предоставляемый в пространстве ядра и позволяющий коду из пользовательского пространства обращаться к устройству.
Опираясь на эти базовые концепции, я сформулировал для себя несколько проблем, которые и побудили меня изучить разработку драйвера.
- В программировании учёба всегда начинается с программы Hello World, так как же в данном случае написать программу Hello World?
- Как драйвер генерирует файлы устройств под /dev?
- Как именно происходит доступ драйвера к имеющемуся аппаратному обеспечению?
- Как написать код, управляемый системой? Или можно извлечь драйвер без кода? Где находятся двоичные файлы, в которых хранятся драйвера? В будущем все это можно было бы опробовать, чтобы изучить, насколько безопасно конкретное устройство.
❯ Всё начинается с Hello World
Вот какой получилась моя программа Hello World:
#include #include MODULE_LICENSE("Dual BSD/GPL"); MODULE_AUTHOR("Hcamal"); int hello_init(void) < printk(KERN_INFO "Hello World\n"); return 0; >void hello_exit(void) < printk(KERN_INFO "Goodbye World\n"); >module_init(hello_init); module_exit(hello_exit);Драйвер Linux разрабатывается на языке C, причём, на таком, который не слишком мне привычен. При работе я часто пользуюсь библиотекой Libc, которая отсутствует в ядре. Поскольку драйвер – это программа, работающая в ядре, именно в ядре мы используем и библиотечные функции.
Например, printk — это функция вывода, определяемая в ядре, она аналогична printf из Libc. Но мне она в большей степени напоминает логирующую функцию из Python, так как вывод printk идёт разу в лог ядра, а этот лог можно просмотреть командой dmesg .
В коде драйвера есть ровно одна точка входа и одна точка выхода. При загрузке драйвера в ядро выполнится функция, определяемая функцией module_init , которая в вышеприведённом коде называется hello_init . При выгрузке драйвера из ядра вызывается функция, определяемая в функции module_exit , которая в вышеприведённом коде называется hello_exit .
Из показанного выше кода понятно, что, загружаясь, драйвер выводит Hello World, а выгружаясь — Goodbye World .
Кстати: MODULE_LICENSE и MODULE_AUTHOR не так важны. Здесь я не буду подробно их разбирать.
И ещё: для вывода функции printk должен добавляться переход на новую строку, иначе опорожнение буфера происходить не будет.
❯ Компилируем драйвер
Драйвер необходимо скомпилировать командой make , и соответствующий Makefile показан ниже:
ifneq ($(KERNELRELEASE),) obj-m := hello.o else KERN_DIR ?= /usr/src/linux-headers-$(shell uname -r)/ PWD := $(shell pwd) default: $(MAKE) -C $(KERN_DIR) M=$(PWD) modules endif clean: rm -rf *.o *~ core .depend .*.cmd *.ko *.mod.c .tmp_versionsВообще исходный код ядра находится в каталоге /usr/src/linux-headers-$(shell uname -r)/, например:
$ uname -r 4.4.0-135-generic/usr/src/linux-headers-4.4.0-135/ --> каталог исходного кода ядра /usr/src/linux-headers-4.4.0-135-generic/ --> каталог скомпилированного исходного кода для данного ядраА нам нужен каталог для скомпилированных исходников, а именно /usr/src/linux-headers-4.4.0-135-generic/ .
Поиск заголовочных файлов для драйверного кода осуществляется именно из этого каталога.
Параметр M=$(PWD) указывает, что вывод от компиляции драйвера попадает именно в текущий каталог.
Наконец, вот команда obj-m := hello.o , предназначенная для загрузки hello.o в hello.ko , а ko – это файл из пространства ядра.
❯ Загружаем драйвер в ядро
Вот некоторые системные команды, которые нам при этом понадобятся:
- Lsmod : просмотр модуля ядра, загружаемого в настоящий момент.
- Insmod : загрузка модуля ядра с последующим требованием прав администратора.
- Rmmod : удаление модуля.
# insmod hello.ko // Load the hello.ko module into the kernel # rmmod hello // Remove the hello module from the kernelВ старых версиях ядра таким же методом загружалось и удалялось само ядро, но в новых версиях ядра Linux здесь добавляется верификация модуля. Вот в какой ситуации мы сейчас находимся:
# insmod hello.ko insmod: ERROR: could not insert module hello.ko: Required key not availableС точки зрения безопасности актуальное ядро предполагает, что данный модуль не вызывает доверия. Чтобы этот модуль мог быть загружен, его нужно подписать доверенным сертификатом.
Это можно сделать двумя способами:
- Войти в BIOS и отключить безопасную загрузку в UEFI.
- Добавить в ядро самоподписываемый сертификат, и именно с его помощью подписать модуль драйвера (подробнее об этом написано тут).
❯ View the Results

❯ Добавляем файлы устройств под /dev
Once again, we firstly provide the code, and then explain the example code.
#include #include #include /* printk() */ #include /* kmalloc() */ #include /* everything. */ #include /* error codes */ #include /* size_t */ #include /* O_ACCMODE */ #include #include /* copy_*_user */ MODULE_LICENSE("Dual BSD/GPL"); MODULE_AUTHOR("Hcamael"); int scull_major = 0; int scull_minor = 0; int scull_nr_devs = 4; int scull_quantum = 4000; int scull_qset = 1000; struct scull_qset < void **data; struct scull_qset *next; >; struct scull_dev < struct scull_qset *data; /* Pointer to first quantum set. */ int quantum; /* The current quantum size. */ int qset; /* The current array size. */ unsigned long size; /* Amount of data stored here. */ unsigned int access_key; /* Used by sculluid and scullpriv. */ struct mutex mutex; /* Mutual exclusion semaphore. */ struct cdev cdev; /* Char device structure. */ >; struct scull_dev *scull_devices; /* allocated in scull_init_module */ /* * Follow the list. */ struct scull_qset *scull_follow(struct scull_dev *dev, int n) < struct scull_qset *qs = dev->data; /* Allocate the first qset explicitly if need be. */ if (! qs) < qs = dev->data = kmalloc(sizeof(struct scull_qset), GFP_KERNEL); if (qs == NULL) return NULL; memset(qs, 0, sizeof(struct scull_qset)); > /* Then follow the list. */ while (n--) < if (!qs->next) < qs->next = kmalloc(sizeof(struct scull_qset), GFP_KERNEL); if (qs->next == NULL) return NULL; memset(qs->next, 0, sizeof(struct scull_qset)); > qs = qs->next; continue; > return qs; > /* * Data management: read and write. */ ssize_t scull_read(struct file *filp, char __user *buf, size_t count, loff_t *f_pos) < struct scull_dev *dev = filp->private_data; struct scull_qset *dptr; /* the first listitem */ int quantum = dev->quantum, qset = dev->qset; int itemsize = quantum * qset; /* how many bytes in the listitem */ int item, s_pos, q_pos, rest; ssize_t retval = 0; if (mutex_lock_interruptible(&dev->mutex)) return -ERESTARTSYS; if (*f_pos >= dev->size) goto out; if (*f_pos + count > dev->size) count = dev->size - *f_pos; /* Find listitem, qset index, and offset in the quantum */ item = (long)*f_pos / itemsize; rest = (long)*f_pos % itemsize; s_pos = rest / quantum; q_pos = rest % quantum; /* follow the list up to the right position (defined elsewhere) */ dptr = scull_follow(dev, item); if (dptr == NULL || !dptr->data || ! dptr->data[s_pos]) goto out; /* don't fill holes */ /* read only up to the end of this quantum */ if (count > quantum - q_pos) count = quantum - q_pos; if (raw_copy_to_user(buf, dptr->data[s_pos] + q_pos, count)) < retval = -EFAULT; goto out; >*f_pos += count; retval = count; out: mutex_unlock(&dev->mutex); return retval; > ssize_t scull_write(struct file *filp, const char __user *buf, size_t count, loff_t *f_pos) < struct scull_dev *dev = filp->private_data; struct scull_qset *dptr; int quantum = dev->quantum, qset = dev->qset; int itemsize = quantum * qset; int item, s_pos, q_pos, rest; ssize_t retval = -ENOMEM; /* Value used in "goto out" statements. */ if (mutex_lock_interruptible(&dev->mutex)) return -ERESTARTSYS; /* Find the list item, qset index, and offset in the quantum. */ item = (long)*f_pos / itemsize; rest = (long)*f_pos % itemsize; s_pos = rest / quantum; q_pos = rest % quantum; /* Follow the list up to the right position. */ dptr = scull_follow(dev, item); if (dptr == NULL) goto out; if (!dptr->data) < dptr->data = kmalloc(qset * sizeof(char *), GFP_KERNEL); if (!dptr->data) goto out; memset(dptr->data, 0, qset * sizeof(char *)); > if (!dptr->data[s_pos]) < dptr->data[s_pos] = kmalloc(quantum, GFP_KERNEL); if (!dptr->data[s_pos]) goto out; > /* Write only up to the end of this quantum. */ if (count > quantum - q_pos) count = quantum - q_pos; if (raw_copy_from_user(dptr->data[s_pos]+q_pos, buf, count)) < retval = -EFAULT; goto out; >*f_pos += count; retval = count; /* Update the size. */ if (dev->size < *f_pos) dev->size = *f_pos; out: mutex_unlock(&dev->mutex); return retval; > /* Beginning of the scull device implementation. */ /* * Empty out the scull device; must be called with the device * mutex held. */ int scull_trim(struct scull_dev *dev) < struct scull_qset *next, *dptr; int qset = dev->qset; /* "dev" is not-null */ int i; for (dptr = dev->data; dptr; dptr = next) < /* all the list items */ if (dptr->data) < for (i = 0; i < qset; i++) kfree(dptr->data[i]); kfree(dptr->data); dptr->data = NULL; > next = dptr->next; kfree(dptr); > dev->size = 0; dev->quantum = scull_quantum; dev->qset = scull_qset; dev->data = NULL; return 0; > int scull_release(struct inode *inode, struct file *filp) < printk(KERN_DEBUG "process %i (%s) success release minor(%u) file\n", current->pid, current->comm, iminor(inode)); return 0; > /* * Open and close */ int scull_open(struct inode *inode, struct file *filp) < struct scull_dev *dev; /* device information */ dev = container_of(inode->i_cdev, struct scull_dev, cdev); filp->private_data = dev; /* for other methods */ /* If the device was opened write-only, trim it to a length of 0. */ if ( (filp->f_flags & O_ACCMODE) == O_WRONLY) < if (mutex_lock_interruptible(&dev->mutex)) return -ERESTARTSYS; scull_trim(dev); /* Ignore errors. */ mutex_unlock(&dev->mutex); > printk(KERN_DEBUG "process %i (%s) success open minor(%u) file\n", current->pid, current->comm, iminor(inode)); return 0; > /* * The "extended" operations -- only seek. */ loff_t scull_llseek(struct file *filp, loff_t off, int whence) < struct scull_dev *dev = filp->private_data; loff_t newpos; switch(whence) < case 0: /* SEEK_SET */ newpos = off; break; case 1: /* SEEK_CUR */ newpos = filp->f_pos + off; break; case 2: /* SEEK_END */ newpos = dev->size + off; break; default: /* can't happen */ return -EINVAL; > if (newpos < 0) return -EINVAL; filp->f_pos = newpos; return newpos; > struct file_operations scull_fops = < .owner = THIS_MODULE, .llseek = scull_llseek, .read = scull_read, .write = scull_write, // .unlocked_ioctl = scull_ioctl, .open = scull_open, .release = scull_release, >; /* * Set up the char_dev structure for this device. */ static void scull_setup_cdev(struct scull_dev *dev, int index) < int err, devno = MKDEV(scull_major, scull_minor + index); cdev_init(&dev->cdev, &scull_fops); dev->cdev.owner = THIS_MODULE; dev->cdev.ops = &scull_fops; err = cdev_add (&dev->cdev, devno, 1); /* Fail gracefully if need be. */ if (err) printk(KERN_NOTICE "Error %d adding scull%d", err, index); else printk(KERN_INFO "scull: %d add success\n", index); > void scull_cleanup_module(void) < int i; dev_t devno = MKDEV(scull_major, scull_minor); /* Get rid of our char dev entries. */ if (scull_devices) < for (i = 0; i < scull_nr_devs; i++) < scull_trim(scull_devices + i); cdev_del(&scull_devices[i].cdev); >kfree(scull_devices); > /* cleanup_module is never called if registering failed. */ unregister_chrdev_region(devno, scull_nr_devs); printk(KERN_INFO "scull: cleanup success\n"); > int scull_init_module(void) < int result, i; dev_t dev = 0; /* * Get a range of minor numbers to work with, asking for a dynamic major * unless directed otherwise at load time. */ if (scull_major) < dev = MKDEV(scull_major, scull_minor); result = register_chrdev_region(dev, scull_nr_devs, "scull"); >else < result = alloc_chrdev_region(&dev, scull_minor, scull_nr_devs, "scull"); scull_major = MAJOR(dev); >if (result < 0) < printk(KERN_WARNING "scull: can't get major %d\n", scull_major); return result; >else < printk(KERN_INFO "scull: get major %d success\n", scull_major); >/* * Allocate the devices. This must be dynamic as the device number can * be specified at load time. */ scull_devices = kmalloc(scull_nr_devs * sizeof(struct scull_dev), GFP_KERNEL); if (!scull_devices) < result = -ENOMEM; goto fail; >memset(scull_devices, 0, scull_nr_devs * sizeof(struct scull_dev)); /* Initialize each device. */ for (i = 0; i < scull_nr_devs; i++) < scull_devices[i].quantum = scull_quantum; scull_devices[i].qset = scull_qset; mutex_init(&scull_devices[i].mutex); scull_setup_cdev(&scull_devices[i], i); >return 0; /* succeed */ fail: scull_cleanup_module(); return result; > module_init(scull_init_module); module_exit(scull_cleanup_module);❯ Классификация драйверов
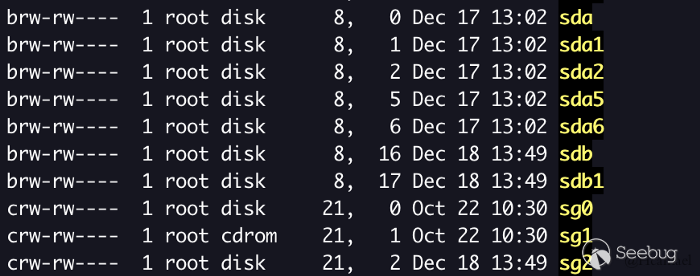
Драйверы делятся на три категории: символьные устройства, блочные устройства и сетевые интерфейсы. В вышеприведённом коде было разобрано символьное устройство, а обсуждение двух других категорий выходит за рамки этой статьи.
Как было показано выше, brw-rw— — строка о правах доступа для блочных устройств начинается с буквы «b», а для символьных устройств начинается с буквы «c».
❯ О старших и младших числах
Старшее число отличает один драйвер от всех остальных. В принципе, если старшее число у устройств совпадает, это означает, что они управляются одним и тем же драйвером.
В одном каталоге drive может быть создано множество устройств, и отличаться они будут младшими числами. Вместе старшее и младшее число характеризуют устройство, управляемое драйвером (как показано выше).
brw-rw---- 1 root disk 8, 0 Dec 17 13:02 sda brw-rw---- 1 root disk 8, 1 Dec 17 13:02 sda1Старшее число аппаратуры sda и sda1 это 8, а младших чисел здесь два: у одного устройства 0, а у другого 1.
❯ Как драйвер предоставляет API
Я привык считать, что /dev/xxx – это интерфейс, предоставляемый файлом, а в Linux «всё – файл». Поэтому, оперируя драйвером, мы, фактически, оперируем файлом, и именно в драйвере определяется define/open/read/write… что произойдёт с /dev/xxx . Любые мыслимые действия с API драйвера – это операции над файлами.
Какие операции над файлами здесь присутствуют? Все они определяются в структуре file_operations в заголовочном файле ядра .
В коде, приведённом выше в качестве примера:
struct file_operations scull_fops = < .owner = THIS_MODULE, .llseek = scull_llseek, .read = scull_read, .write = scull_write, .open = scull_open, .release = scull_release, >;Я определяю структуру и присваиваю её. Не считая owner, значения всех остальных членов – это указатели функций.
Затем я применяю cdev_add , чтобы зарегистрировать структуру для файловых операций под каждый драйвер, это делается в функции scull_setup_cdev .
Например, совершая операцию “open” (открыть) с устройством под управлением драйвера, я выполняю функцию scull_open, что эквивалентно «перехвату» функции open в системном вызове.
❯ Как сгенерировать нужное нам устройство под /dev
Скомпилировав вышеприведённый код, получим scull.ko , затем подпишем его и, наконец, загрузим в ядро при помощи insmod .
Проверим, удачно ли он загрузился:
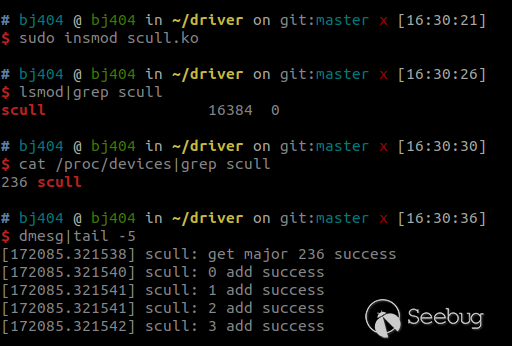
Да, драйвер устройства загрузился успешно, но он не создаёт файла устройства в каталоге /dev. Необходимо вручную воспользоваться mknod для связывания устройства:
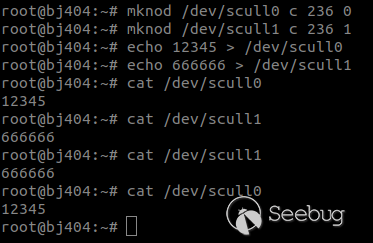
❯ Итоги
В данном примере мы не совершали никаких операций с конкретным устройством, а просто воспользовались kmalloc , и с его помощью применили блок памяти в пространстве ядра.
Далее не буду вдаваться в детали о коде, все их можно уточнить, погуглив информацию или изучив заголовочные файлы.
В этой статье я хотел поделиться с вами, как самостоятельно научиться разрабатывать драйвера: сначала читать книги, чтобы усвоить базовые концепции, а затем искать информацию по конкретным деталям, когда дойдёт дело до практического применения.
Например, я не знаю, какой API может предоставить драйвер. Всё, что мне нужно знать – что такой API ограничивается файловыми операциями. На данный момент мне понадобятся только операциями open , close , read и write . Как делаются другие операции с файлами – можно уточнить при необходимости.
Ссылки
- github.com/jesstess/ldd4
- raw.githubusercontent.com/Hcamael/Linux_Driver_Study/master/hello.c
- jin-yang.github.io/post/kernel-modules.html
- raw.githubusercontent.com/Hcamael/Linux_Driver_Study/master/scull.c
- raw.githubusercontent.com/torvalds/linux/master/include/linux/fs.h
Как написать свой первый Linux device driver
Цель данной статьи — показать принцип реализации драйверов устройств в системе Linux, на примере простого символьного драйвера.
Для меня же, главной целью является подвести итог и сформировать базовые знания для написания будущих модулей ядра, а также получить опыт изложения технической литературы для публики, т.к. через полгода я буду выступать со своим дипломным проектом (да я студент).
Это моя первая статья, пожалуйста не судите строго!
P.S
Получилось слишком много букв, поэтому я принял решение разделить статью на три части:
Часть 1 — Введение, инициализация и очистка модуля ядра.
Часть 2 — Функции open, read, write и trim.
Часть 3 — Пишем Makefile и тестируем устройство.
Перед вступлением, хочу сказать, что здесь будут изложены базовые вещи, более подробная информация будет изложена во второй и последней части данной статьи.
Подготовительные работы
UPD.
Спасибо Kolyuchkin за уточнения.
Символьный драйвер (Char driver) — это, драйвер, который работает с символьными устройствами.
Символьные устройства — это устройства, к которым можно обращаться как к потоку байтов.
Пример символьного устройства — /dev/ttyS0, /dev/tty1.
UPD.
К вопросу про проверсию ядра:
~$ uname -r 4.4.0-93-genericДрайвер представляет каждое символьное устройство структурой scull_dev, а также предостовляет интерфейс cdev к ядру.
struct scull_dev < struct scull_qset *data; /* Указатель на первый кусок памяти */ int quantum; /* Размер одного кванта памяти */ int qset; /* Количество таких квантов */ unsigned long size; /* Размер используемой памяти */ struct semaphore sem; /* Используется семафорами */ struct cdev cdev; /* Структура, представляющая символьные устройства */ >; struct scull_dev *scull_device; Устройство будет представлять связный список указателей, каждый из которых указывает на структуру scull_qset.
struct scull_qset < void **data; struct scull_qset *next; >; Для наглядности посмотрите на картинку.
Для регистрации устройства, нужно задать специальные номера, а именно:
MAJOR — старший номер (является уникальным в системе).
MINOR — младший номер (не является уникальным в системе).
В ядре есть механизм, который позволяет регистрировать специализированные номера вручную, но такой подход нежелателен и лучше вежливо попросить ядро динамически выделить их для нас. Пример кода будет ниже.
После того как мы определили номера для нашего устройства, мы должны установить связь между этими номерами и операциями драйвера. Это можно сделать используя структуру file_operations.
struct file_operations scull_fops = < .owner = THIS_MODULE, .read = scull_read, .write = scull_write, .open = scull_open, .release = scull_release, >; В ядре есть специальные макросы module_init/module_exit, которые указывают путь к функциям инициализации/удаления модуля. Без этих определений функции инициализации/удаления никогда не будут вызваны.
module_init(scull_init_module); module_exit(scull_cleanup_module); Здесь будем хранить базовую информацию об устройстве.
int scull_major = 0; /* MAJOR номер*/ int scull_minor = 0; /* MINOR номер*/ int scull_nr_devs = 1; /* Количество регистрируемых устройств */ int scull_quantum = 4000; /* Размер памяти в байтах */ int scull_qset = 1000; /* Количество квантов памяти */ Последним этапом подготовительной работы будет подключение заголовочных файлов.
Краткое описание приведено ниже, но если вы хотите копнуть поглубже, то добро пожаловать на прекрасный сайт: lxr
#include /* Содержит функции и определения для динамической загрузки модулей ядра */ #include /* Указывает на функции инициализации и очистки */ #include /* Содержит функции регистрации и удаления драйвера */ #include /* Содержит необходимые функции для символьного драйвера */ #include /* Содержит функцию ядра для управления памятью */ #include /* Предоставляет доступ к пространству пользователя */ Инициализация
Теперь давайте посмотрим на функцию инициализации устройства.
static int scull_init_module(void) < int rv, i; dev_t dev; rv = alloc_chrdev_region(&dev, scull_minor, scull_nr_devs, "scull"); if (rv) < printk(KERN_WARNING "scull: can't get major %d\n", scull_major); return rv; >scull_major = MAJOR(dev); scull_device = kmalloc(scull_nr_devs * sizeof(struct scull_dev), GFP_KERNEL); if (!scull_device) < rv = -ENOMEM; goto fail; >memset(scull_device, 0, scull_nr_devs * sizeof(struct scull_dev)); for (i = 0; i < scull_nr_devs; i++) < scull_device[i].quantum = scull_quantum; scull_device[i].qset = scull_qset; sema_init(&scull_device[i].sem, 1); scull_setup_cdev(&scull_device[i], i); >dev = MKDEV(scull_major, scull_minor + scull_nr_devs); return 0; fail: scull_cleanup_module(); return rv; > Первым делом, вызывая alloc_chrdev_region мы регистрируем диапазон символьных номеров устройств и указываем имя устройства. После вызовом MAJOR(dev) мы получаем старший номер.
Далее проверяется вернувшееся значение, если оно является кодом ошибки, то выходим из функции. Стоит отметить, что при разработке реального драйвера устройства следует всегда проверять возвращаемые значения, а также указатели на любые элементы (NULL?).
rv = alloc_chrdev_region(&dev, scull_minor, scull_nr_devs, "scull"); if (rv) < printk(KERN_WARNING "scull: can't get major %d\n", scull_major); return rv; >scull_major = MAJOR(dev); Если вернувшееся значение не является кодом ошибки, продолжаем выполнять инициализацию.
Выделяем память, делая вызов функции kmalloc и обязательно проверяем указатель на NULL.
UPD
Стоит упомянуть, что вместо вызова двух функций kmalloc и memset, можно использовать один вызов kzalloc, который выделят область памяти и инициализирует ее нулями.
scull_device = kmalloc(scull_nr_devs * sizeof(struct scull_dev), GFP_KERNEL); if (!scull_device) < rv = -ENOMEM; goto fail; >memset(scull_device, 0, scull_nr_devs * sizeof(struct scull_dev)); Продолжаем инициализацию. Главная здесь функция — это scull_setup_cdev, о ней мы поговорим чуть ниже. MKDEV служит для хранения старший и младших номеров устройств.
for (i = 0; i < scull_nr_devs; i++) < scull_device[i].quantum = scull_quantum; scull_device[i].qset = scull_qset; sema_init(&scull_device[i].sem, 1); scull_setup_cdev(&scull_device[i], i); >dev = MKDEV(scull_major, scull_minor + scull_nr_devs); Возвращаем значение или обрабатываем ошибку и удаляем устройство.
return 0; fail: scull_cleanup_module(); return rv; > Выше были представлены структуры scull_dev и cdev, которые реализуют интерфейс между нашим устройством и ядром. Функция scull_setup_cdev выполняет инициализацию и добавление структуры в систему.
static void scull_setup_cdev(struct scull_dev *dev, int index) < int err, devno = MKDEV(scull_major, scull_minor + index); cdev_init(&dev->cdev, &scull_fops); dev->cdev.owner = THIS_MODULE; dev->cdev.ops = &scull_fops; err = cdev_add(&dev->cdev, devno, 1); if (err) printk(KERN_NOTICE "Error %d adding scull %d", err, index); > Удаление
Функция scull_cleanup_module вызывается при удалении модуля устройства из ядра.
Обратный процесс инициализации, удаляем структуры устройств, освобождаем память и удаляем выделенные ядром младшие и старшие номера.
void scull_cleanup_module(void) < int i; dev_t devno = MKDEV(scull_major, scull_minor); if (scull_device) < for (i = 0; i < scull_nr_devs; i++) < scull_trim(scull_device + i); cdev_del(&scull_device[i].cdev); >kfree(scull_device); > unregister_chrdev_region(devno, scull_nr_devs); > Полный код
#include #include #include #include #include #include int scull_major = 0; int scull_minor = 0; int scull_nr_devs = 1; int scull_quantum = 4000; int scull_qset = 1000; struct scull_qset < void **data; struct scull_qset *next; >; struct scull_dev < struct scull_qset *data; int quantum; int qset; unsigned long size; unsigned int access_key; struct semaphore sem; struct cdev cdev; >; struct scull_dev *scull_device; int scull_trim(struct scull_dev *dev) < struct scull_qset *next, *dptr; int qset = dev->qset; int i; for (dptr = dev->data; dptr; dptr = next) < if (dptr->data) < for (i = 0; i < qset; i++) kfree(dptr->data[i]); kfree(dptr->data); dptr->data = NULL; > next = dptr->next; kfree(dptr); > dev->size = 0; dev->quantum = scull_quantum; dev->qset = scull_qset; dev->data = NULL; return 0; > struct file_operations scull_fops = < .owner = THIS_MODULE, //.read = scull_read, //.write = scull_write, //.open = scull_open, //.release = scull_release, >; static void scull_setup_cdev(struct scull_dev *dev, int index) < int err, devno = MKDEV(scull_major, scull_minor + index); cdev_init(&dev->cdev, &scull_fops); dev->cdev.owner = THIS_MODULE; dev->cdev.ops = &scull_fops; err = cdev_add(&dev->cdev, devno, 1); if (err) printk(KERN_NOTICE "Error %d adding scull %d", err, index); > void scull_cleanup_module(void) < int i; dev_t devno = MKDEV(scull_major, scull_minor); if (scull_device) < for (i = 0; i < scull_nr_devs; i++) < scull_trim(scull_device + i); cdev_del(&scull_device[i].cdev); >kfree(scull_device); > unregister_chrdev_region(devno, scull_nr_devs); > static int scull_init_module(void) < int rv, i; dev_t dev; rv = alloc_chrdev_region(&dev, scull_minor, scull_nr_devs, "scull"); if (rv) < printk(KERN_WARNING "scull: can't get major %d\n", scull_major); return rv; >scull_major = MAJOR(dev); scull_device = kmalloc(scull_nr_devs * sizeof(struct scull_dev), GFP_KERNEL); if (!scull_device) < rv = -ENOMEM; goto fail; >memset(scull_device, 0, scull_nr_devs * sizeof(struct scull_dev)); for (i = 0; i < scull_nr_devs; i++) < scull_device[i].quantum = scull_quantum; scull_device[i].qset = scull_qset; sema_init(&scull_device[i].sem, 1); scull_setup_cdev(&scull_device[i], i); >dev = MKDEV(scull_major, scull_minor + scull_nr_devs); printk(KERN_INFO "scull: major = %d minor = %d\n", scull_major, scull_minor); return 0; fail: scull_cleanup_module(); return rv; > MODULE_AUTHOR("Your name"); MODULE_LICENSE("GPL"); module_init(scull_init_module); module_exit(scull_cleanup_module); С удовольствием выслушаю конструктивную критику и буду ждать feedback’a.
Если вы нашли ошибки или я не правильно изложил материал, пожалуйста, укажите мне на это.
Для более быстрой реакции пишите в ЛС.
Литература
- Linux device drivers 3rd edition
- Essential linux device drivers