Основные принципы работы сетевой маршрутизации
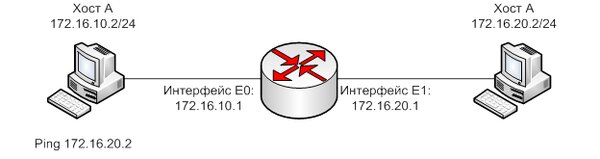
Маршрутизатор узнает об удаленных сетях от соседних маршрутизаторов или от сетевого администратора. Затем маршрутизатор строит таблицу маршрутизации, которая описывает, как найти удаленные сети.
Если сеть подключена непосредственно к маршрутизатору, он уже знает, как направить пакет в эту сеть. Если же сеть не подключена напрямую, маршрутизатор должен узнать (изучить) пути доступа к удаленной сети с помощью статической маршрутизации (ввод администратором вручную местоположения всех сетей в таблицу маршрутизации) или с помощью динамической маршрутизации.
Динамическая маршрутизация — это процесс протокола маршрутизации, определяющий взаимодействие устройства с соседними маршрутизаторами. Маршрутизатор будет обновлять сведения о каждой изученной им сети. Если в сети произойдет изменение, протокол динамической маршрутизации автоматически информирует об изменении все маршрутизаторы. Если же используется статическая маршрутизация, обновить таблицы маршрутизации на всех устройствах придется системному администратору.
Что такое маршрутизатор (шлюз, gateway)?
Маршрутизатором, или шлюзом, называется узел сети с несколькими IP-интерфейсами (содержащими свой MAC-адрес и IP-адрес), подключенными к разным IP-сетям, осуществляющий на основе решения задачи маршрутизации перенаправление дейтаграмм из одной сети в другую для доставки от отправителя к получателю.
Маршрутизаторы представляют собой либо специализированные вычислительные машины, либо компьютеры с несколькими IP-интерфейсами, работа которых управляется специальным программным обеспечением.
Процесс IP-маршрутизации
IP-маршрутизация — простой процесс, который одинаков в сетях любого размера. Например, на рисунке показан процесс пошагового взаимодействия хоста А с хостом В в другой сети. В примере пользователь хоста А запрашивает по ping IP-адрес хоста В. Дальнейшие операции не так просты, поэтому рассмотрим их подробнее:
- В командной строке пользователь вводит ping 172.16.20.2. На хосте А генерируется пакет с помощью протоколов сетевого уровня IP и ICMP.
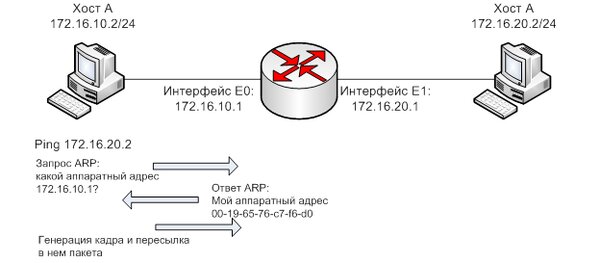
- IP обращается к протоколу ARP для выяснения сети назначения для пакета, просматривая IP-адрес и маску подсети хоста А. Это запрос к удаленному хосту, т.е. пакет не предназначен хосту локальной сети, поэтому пакет должен быть направлен маршрутизатору для перенаправления в нужную удаленную сеть.
- Чтобы хост А смог послать пакет маршрутизатору, хост должен знать аппаратный адрес интерфейса маршрутизатора, подключенный к локальной сети. Сетевой уровень передает пакет и аппаратный адрес назначения канальному уровню для деления на кадры и пересылки локальному хосту. Для получения аппаратного адреса хост ищет местоположение точки назначения в собственной памяти, называемой кэшем ARP.
- Если IP-адрес еще не был доступен и не присутствует в кэше ARP, хост посылает широковещательную рассылку ARP для поиска аппаратного адреса по IP-адресу 172.16.10.1. Именно поэтому первый запрос Ping обычно заканчивается тайм-аутом, но четыре остальные запроса будут успешны. После кэширования адреса тайм-аута обычно не возникает.
- Маршрутизатор отвечает и сообщает аппаратный адрес интерфейса Ethernet, подключенного к локальной сети. Теперь хост имеет всю информацию для пересылки пакета маршрутизатору по локальной сети. Сетевой уровень спускает пакет вниз для генерации эхо-запроса ICMP (Ping) на канальном уровне, дополняя пакет аппаратным адресом, по которому хост должен послать пакет. Пакет имеет IP-адреса источника и назначения вместе с указанием на тип пакета (ICMP) в поле протокола сетевого уровня.
- Канальный уровень формирует кадр, в котором инкапсулируется пакет вместе с управляющей информацией, необходимой для пересылки по локальной сети. К такой информации относятся аппаратные адреса источника и назначения, а также значение в поле типа, установленное протоколом сетевого уровня (это будет поле типа, поскольку IP по умолчанию пользуется кадрами Ethernet_II). Рисунок 3 показывает кадр, генерируемый на канальном уровне и пересылаемый по локальному носителю. На рисунке 3 показана вся информация, необходимая для взаимодействия с маршрутизатором: аппаратные адреса источника и назначения, IP-адреса источника и назначения, данные, а также контрольная сумма CRC кадра, находящаяся в поле FCS (Frame Check Sequence).
- Канальный уровень хоста А передает кадр физическому уровню. Там выполняется кодирование нулей и единиц в цифровой сигнал с последующей передачей этого сигнала по локальной физической сети.
- Сигнал достигает интерфейса Ethernet 0 маршрутизатора, который синхронизируется по преамбуле цифрового сигнала для извлечения кадра. Интерфейс маршрутизатора после построения кадра проверяет CRC, а в конце приема кадра сравнивает полученное значение с содержимым поля FCS. Кроме того, он проверяет процесс передачи на отсутствие фрагментации и конфликтов носителя.
- Проверяется аппаратный адрес назначения. Поскольку он совпадает с адресом маршрутизатора, анализируется поле типа кадра для определения дальнейших действий с этим пакетом данных. В поле типа указан протокол IP, поэтому маршрутизатор передает пакет процессу протокола IP, исполняемому маршрутизатором. Кадр удаляется. Исходный пакет (сгенерированный хостом А) помещается в буфер маршрутизатора.
- Протокол IP смотрит на IP-адрес назначения в пакете, чтобы определить, не направлен ли пакет самому маршрутизатору. Поскольку IP-адрес назначения равен 172.16.20.2, маршрутизатор определяет по своей таблице маршрутизации, что сеть 172.16.20.0 непосредственно подключена к интерфейсу Ethernet 1.
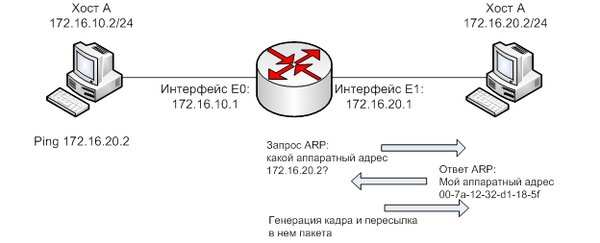
- Маршрутизатор передает пакет из буфера в интерфейс Ethernet 1. Маршрутизатору необходимо сформировать кадр для пересылки пакета хосту назначения. Сначала маршрутизатор проверяет свой кэш ARP, чтобы определить, был ли уже разрешен аппаратный адрес во время предыдущих взаимодействий с данной сетью. Если адреса нет в кэше ARP, маршрутизатор посылает широковещательный запрос ARP в интерфейс Ethernet 1 для поиска аппаратного адреса для IP-адреса 172.16.20.2.
- Хост В откликается аппаратным адресом своего сетевого адаптера на запрос ARP. Интерфейс Ethernet 1 маршрутизатора теперь имеет все необходимое для пересылки пакета в точку окончательного приема. На рисунке показывает кадр, сгенерированный маршрутизатором и переданный по локальной физической сети.
Кадр, сгенерированный интерфейсом Ethernet 1 маршрутизатора, имеет аппаратный адрес источника от интерфейса Ethernet 1 и аппаратный адрес назначения для сетевого адаптера хоста В. Важно отметить, что, несмотря на изменения аппаратных адресов источника и назначения, в каждом передавшем пакет интерфейсе маршрутизатора, IP-адреса источника и назначения никогда не изменяются. Пакет никоим образом не модифицируется, но меняются кадры.
- Хост В принимает кадр и проверяет CRC. Если проверка будет успешной, кадр удаляется, а пакет передается протоколу IP. Он анализирует IP-адрес назначения. Поскольку IP-адрес назначения совпадает с установленным в хосте В адресом, протокол IP исследует поле протокола для определения цели пакета.
- В нашем пакете содержится эхо-запрос ICMP, поэтому хост В генерирует новый эхо-ответ ICMP с IP-адресом источника, равным адресу хоста В, и IP-адресом назначения, равным адресу хоста А. Процесс запускается заново, но в противоположном направлении. Однако аппаратные адреса всех устройств по пути следования пакета уже известны, поэтому все устройства смогут получить аппаратные адреса интерфейсов из собственных кэшей ARP.
В крупных сетях процесс происходит аналогично, но пакету придется пройти больше участков по пути к хосту назначения.
Таблицы маршрутизации
В стеке TCP/IP маршрутизаторы и конечные узлы принимают решения о том, кому передавать пакет для его успешной доставки узлу назначения, на основании так называемых таблиц маршрутизации (routing tables).
Таблица представляет собой типичный пример таблицы маршрутов, использующей IP-адреса сетей, для сети, представленной на рисунке.
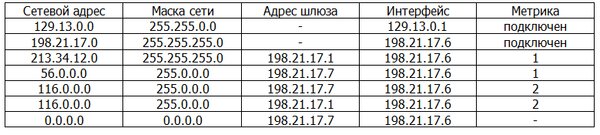
Таблица маршрутизации для Router 2
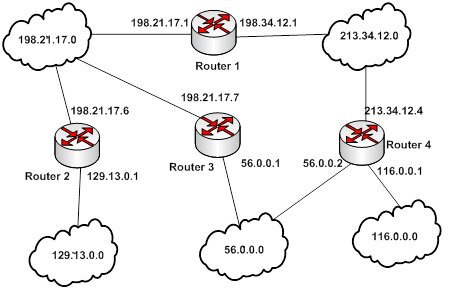
В таблице представлена таблица маршрутизации многомаршрутная, так как содержится два маршрута до сети 116.0.0.0. В случае построения одномаршрутной таблицы маршрутизации, необходимо указывать только один путь до сети 116.0.0.0 по наименьшему значению метрики.
Как нетрудно видеть, в таблице определено несколько маршрутов с разными параметрами. Читать каждую такую запись в таблице маршрутизации нужно следующим образом:
Чтобы доставить пакет в сеть с адресом из поля Сетевой адрес и маской из поля Маска сети, нужно с интерфейса с IP-адресом из поля Интерфейс послать пакет по IP-адресу из поля Адрес шлюза, а «стоимость» такой доставки будет равна числу из поля Метрика.
В этой таблице в столбце «Адрес сети назначения» указываются адреса всех сетей, которым данный маршрутизатор может передавать пакеты. В стеке TCP/IP принят так называемый одношаговый подход к оптимизации маршрута продвижения пакета (next-hop routing) – каждый маршрутизатор и конечный узел принимает участие в выборе только одного шага передачи пакета. Поэтому в каждой строке таблицы маршрутизации указывается не весь маршрут в виде последовательности IP-адресов маршрутизаторов, через которые должен пройти пакет, а только один IP-адрес — адрес следующего маршрутизатора, которому нужно передать пакет. Вместе с пакетом следующему маршрутизатору передается ответственность за выбор следующего шага маршрутизации. Одношаговый подход к маршрутизации означает распределенное решение задачи выбора маршрута. Это снимает ограничение на максимальное количество транзитных маршрутизаторов на пути пакета.
Для отправки пакета следующему маршрутизатору требуется знание его локального адреса, но в стеке TCP/IP в таблицах маршрутизации принято использование только IP-адресов для сохранения их универсального формата, не зависящего от типа сетей, входящих в интерсеть. Для нахождения локального адреса по известному IP-адресу необходимо воспользоваться протоколом ARP.
Одношаговая маршрутизация обладает еще одним преимуществом — она позволяет сократить объем таблиц маршрутизации в конечных узлах и маршрутизаторах за счет использования в качестве номера сети назначения так называемого маршрута по умолчанию – default (0.0.0.0), который обычно занимает в таблице маршрутизации последнюю строку. Если в таблице маршрутизации есть такая запись, то все пакеты с номерами сетей, которые отсутствуют в таблице маршрутизации, передаются маршрутизатору, указанному в строке default. Поэтому маршрутизаторы часто хранят в своих таблицах ограниченную информацию о сетях интерсети, пересылая пакеты для остальных сетей в порт и маршрутизатор, используемые по умолчанию. Подразумевается, что маршрутизатор, используемый по умолчанию, передаст пакет на магистральную сеть, а маршрутизаторы, подключенные к магистрали, имеют полную информацию о составе интерсети.
Кроме маршрута default, в таблице маршрутизации могут встретиться два типа специальных записей — запись о специфичном для узла маршруте и запись об адресах сетей, непосредственно подключенных к портам маршрутизатора.
Специфичный для узла маршрут содержит вместо номера сети полный IP-адрес, то есть адрес, имеющий ненулевую информацию не только в поле номера сети, но и в поле номера узла. Предполагается, что для такого конечного узла маршрут должен выбираться не так, как для всех остальных узлов сети, к которой он относится. В случае, когда в таблице есть разные записи о продвижении пакетов для всей сети N и ее отдельного узла, имеющего адрес N,D, при поступлении пакета, адресованного узлу N,D, маршрутизатор отдаст предпочтение записи для N,D.
Записи в таблице маршрутизации, относящиеся к сетям, непосредственно подключенным к маршрутизатору, в поле «Метрика» содержат нули («подключено»).
Алгоритмы маршрутизации
Основные требования к алгоритмам маршрутизации:
- точность;
- простота;
- надёжность;
- стабильность;
- справедливость;
- оптимальность.
Существуют различные алгоритмы построения таблиц для одношаговой маршрутизации. Их можно разделить на три класса:
- алгоритмы простой маршрутизации;
- алгоритмы фиксированной маршрутизации;
- алгоритмы адаптивной маршрутизации.
Независимо от алгоритма, используемого для построения таблицы маршрутизации, результат их работы имеет единый формат. За счет этого в одной и той же сети различные узлы могут строить таблицы маршрутизации по своим алгоритмам, а затем обмениваться между собой недостающими данными, так как форматы этих таблиц фиксированы. Поэтому маршрутизатор, работающий по алгоритму адаптивной маршрутизации, может снабдить конечный узел, применяющий алгоритм фиксированной маршрутизации, сведениями о пути к сети, о которой конечный узел ничего не знает.
Простая маршрутизация
Это способ маршрутизации не изменяющийся при изменении топологии и состоянии сети передачи данных (СПД).
Простая маршрутизация обеспечивается различными алгоритмами, типичными из которых являются следующие:
- Случайная маршрутизация – это передача сообщения из узла в любом случайно выбранном направлении, за исключением направлений по которым сообщение поступило узел.
- Лавинная маршрутизация – это передача сообщения из узла во всех направлениях, кроме направления по которому сообщение поступило в узел. Такая маршрутизация гарантирует малое время доставки пакета, засчет ухудшения пропускной способности.
- Маршрутизация по предыдущему опыту – каждый пакет имеет счетчик числа пройденных узлов, в каждом узле связи анализируется счетчик и запоминается тот маршрут, который соответствует минимальному значению счетчика. Такой алгоритм позволяет приспосабливаться к изменению топологии сети, но процесс адаптации протекает медленно и неэффективно.
В целом, простая маршрутизация не обеспечивает направленную передачу пакета и имеет низкую эффективности. Основным ее достоинством является обеспечение устойчивой работы сети при выходе из строя различных частей сети.
Фиксированная маршрутизация
Этот алгоритм применяется в сетях с простой топологией связей и основан на ручном составлении таблицы маршрутизации администратором сети. Алгоритм часто эффективно работает также для магистралей крупных сетей, так как сама магистраль может иметь простую структуру с очевидными наилучшими путями следования пакетов в подсети, присоединенные к магистрали, выделяют следующие алгоритмы:
- Однопутевая фиксированная маршрутизация – это когда между двумя абонентами устанавливается единственный путь. Сеть с такой маршрутизацией неустойчива к отказам и перегрузкам.
- Многопутевая фиксированная маршрутизация – может быть установлено несколько возможных путей и вводится правило выбора пути. Эффективность такой маршрутизации падает при увеличении нагрузки. При отказе какой-либо линии связи необходимо менять таблицу маршрутизации, для этого в каждом узле связи храниться несколько таблиц.
Адаптивная маршрутизация
Это основной вид алгоритмов маршрутизации, применяющихся маршрутизаторами в современных сетях со сложной топологией. Адаптивная маршрутизация основана на том, что маршрутизаторы периодически обмениваются специальной топологической информацией об имеющихся в интерсети сетях, а также о связях между маршрутизаторами. Обычно учитывается не только топология связей, но и их пропускная способность и состояние.
Адаптивные протоколы позволяют всем маршрутизаторам собирать информацию о топологии связей в сети, оперативно отрабатывая все изменения конфигурации связей. Эти протоколы имеют распределенный характер, который выражается в том, что в сети отсутствуют какие-либо выделенные маршрутизаторы, которые бы собирали и обобщали топологическую информацию: эта работа распределена между всеми маршрутизаторами, выделяют следующие алгоритмы:
- Локальная адаптивная маршрутизация – каждый узел содержит информацию о состоянии линии связи, длины очереди и таблицу маршрутизации.
- Глобальная адаптивная маршрутизация – основана на использовании информации получаемой от соседних узлов. Для этого каждый узел содержит таблицу маршрутизации, в которой указано время прохождения сообщений. На основе информации, получаемой из соседних узлов, значение таблицы пересчитывается с учетом длины очереди в самом узле.
- Централизованная адаптивная маршрутизация – существует некоторый центральный узел, который занимается сбором информации о состоянии сети. Этот центр формирует управляющие пакеты, содержащие таблицы маршрутизации и рассылает их в узлы связи.
- Гибридная адаптивная маршрутизация – основана на использовании таблицы периодически рассылаемой центром и на анализе длины очереди с самом узле.
Показатели алгоритмов (метрики)
Маршрутные таблицы содержат информацию, которую используют программы коммутации для выбора наилучшего маршрута. Чем характеризуется построение маршрутных таблиц? Какова особенность природы информации, которую они содержат? В данном разделе, посвященном показателям алгоритмов, сделана попытка ответить на вопрос о том, каким образом алгоритм определяет предпочтительность одного маршрута по сравнению с другими.
В алгоритмах маршрутизации используется множество различных показателей. Сложные алгоритмы маршрутизации при выборе маршрута могут базироваться на множестве показателей, комбинируя их таким образом, что в результате получается один гибридный показатель. Ниже перечислены показатели, которые используются в алгоритмах маршрутизации:
- Длина маршрута.
- Надежность.
- Задержка.
- Ширина полосы пропускания.
Длина маршрута
Длина маршрута является наиболее общим показателем маршрутизации. Некоторые протоколы маршрутизации позволяют администраторам сети назначать произвольные цены на каждый канал сети. В этом случае длиной тракта является сумма расходов, связанных с каждым каналом, который был траверсирован. Другие протоколы маршрутизации определяют «количество пересылок» (количество хопов), т. е. показатель, характеризующий число проходов, которые пакет должен совершить на пути от источника до пункта назначения через элементы объединения сетей (такие как маршрутизаторы).
Надежность
Надежность, в контексте алгоритмов маршрутизации, относится к надежности каждого канала сети (обычно описываемой в терминах соотношения бит/ошибка). Некоторые каналы сети могут отказывать чаще, чем другие. Отказы одних каналов сети могут быть устранены легче или быстрее, чем отказы других каналов. При назначении оценок надежности могут быть приняты в расчет любые факторы надежности. Оценки надежности обычно назначаются каналам сети администраторами. Как правило, это произвольные цифровые величины.
Задержка
Под задержкой маршрутизации обычно понимают отрезок времени, необходимый для передвижения пакета от источника до пункта назначения через объединенную сеть. Задержка зависит от многих факторов, включая полосу пропускания промежуточных каналов сети, очереди в порт каждого маршрутизатора на пути передвижения пакета, перегруженность сети на всех промежуточных каналах сети и физическое расстояние, на которое необходимо переместить пакет. Т. к. здесь имеет место конгломерация нескольких важных переменных, задержка является наиболее общим и полезным показателем.
Полоса пропускания
Полоса пропускания относится к имеющейся мощности трафика какого-либо канала. При прочих равных показателях, канал Ethernet 10 Mbps предпочтителен любой арендованной линии с полосой пропускания 64 Кбайт/с. Хотя полоса пропускания является оценкой максимально достижимой пропускной способности канала, маршруты, проходящие через каналы с большей полосой пропускания, не обязательно будут лучше маршрутов, проходящих через менее быстродействующие каналы.
Объясни мне: как устроен интернет
Недавно приняли закон о так называемом суверенном интернете. Есть много слухов о том, что интернет смогут блокировать, подавлять, отключать и многое другое. Мы не комментируем слухи, но воспользуемся случаем и расскажем немного об устройстве самого интернета.
В этой статье — основные знания о том, как устроен интернет, на примере одного запроса на сайт. Дальше — больше. Чтобы было понятно, мы намеренно упускаем некоторые технические детали.
Интернет — это много компьютеров
Интернет — это много вычислительных машин, которые объединены в сеть. Объединение в сеть означает, что одна вычислительная машина может отправить другой сообщение, а та может ответить. Пока непонятно, но подождите.
Например, есть ваш смартфон. И есть компьютер «Яндекса», который отвечает за отображение страницы по адресу yandex.ru. Смартфон делает запрос «Покажи мне главную yandex.ru», компьютер «Яндекса» этот запрос получает, обрабатывает, проверяет, кто вы, и отдаёт вам эту страницу в виде кода. Ваш гаджет получает код страницы и выводит на экран в виде главной страницы «Яндекса».
Может сложиться впечатление, что мы ходим по интернету, заходим на сайты, входим в личные кабинеты. На самом деле никто никуда не ходит. Просто наш компьютер делает запрос другому, тот даёт ответ, и наш компьютер выводит этот ответ на экран. Можно сказать, мы не ходим по интернету, а выборочно его скачиваем.
Клиенты и серверы
Обычно компьютеры в интернете грубо делят на клиенты и серверы. Клиенты — это все компьютеры, на которых информацию потребляют. Обычно у них есть клавиатуры, экраны, они мобильные и удобные для людей. Ваш телефон, планшет и ноутбук — клиенты.
Серверы — это тоже компьютеры, но предназначенные для раздачи информации клиентам. Внешне они обычно выглядят как металлические ящики, вкрученные в металлические шкафы: у них нет мониторов и клавиатур, зато внутри там огромные жёсткие диски, сотни гигабайт оперативной памяти и мощнейшие процессоры.
Внутри между клиентами и серверами нет принципиальных различий. И то, и другое — компьютеры. Вы можете установить программу-сервер на свой рабочий компьютер и после некоторой настройки раздавать с него сайты. Или можете под покровом ночи проникнуть в серверную, подключить к серверу монитор и клавиатуру и поиграть в пасьянс на 32-ядерном процессоре.
Ради интереса: что может быть сервером
Сервером может работать почти любой компьютер. Вот несколько идей:
Ваш старый системный блок, который пылится в гараже, можно переоборудовать под файловый сервер. На последний можно будет скидывать семейные фото и делать резервные копии важных документов. Поставили компьютер в кладовке, подвели к нему сетевой провод, включили и забыли.
На вашем рабочем компьютере может в фоновом режиме работать сервер для игры Counter-Strike. Другие люди смогут спасать виртуальных заложников и обезвреживать виртуальные бомбы, пользуясь мощностями вашего компьютера.
Можно купить одноплатный компьютер Raspberry Pi, подключить к нему Wi-Fi-антенну и батарею, и у вас будет карманный сервер, который по вашему желанию может раздавать файлы, показывать сайты или управлять ботом в Telegram.
Можно на базе того же Raspberry Pi сделать сервер для умного дома. Он собирает информацию со всех датчиков в квартире, а вы подключаетесь к нему через интернет и смотрите, какая где температура, нет ли протечек, что происходит на камерах.
Как они связаны
Все понимают, что в интернете компьютеры как-то связаны. Но как? Представьте разветвлённую корневую систему дерева или кровеносную систему человека: есть большие толстые артерии, от них отходят сосуды, от них — более тонкие сосуды, потом ещё и ещё, до тончайших капилляров. Похожим образом устроен интернет.
Основа интернета — огромные магистральные кабели, которые лежат под землёй и на дне океана: они соединяют города, страны и континенты. Это толстые пучки оптоволокна, по которым передаются колоссальные объёмы данных.
Одна из главных угроз международному интернету — акулы: они любят грызть магистральные подводные кабели. Это не шутка. Причину учёные пока не знают — то ли из-за излучения, то ли просто интересно.
Огромные магистральные кабели соединяют большие точки обмена данными: так называемые эксчейнджи. Это организации, которые отвечают за обмен трафиком между городами, странами и континентами. В России около 50 таких точек, в мире — порядка 1 500.
В самом упрощённом виде ваш интернет-провайдер получает доступ к ближайшему эксчейнджу, чтобы иметь возможность продавать вам интернет. Представьте, что от эксчейнджа прокладывается толстый кабель к провайдеру. Конкретно толстый кабель бывает не всегда, но для наших целей такая метафора подойдёт.
Дальше обычно так: провайдер прокладывает менее толстый кабель в ваш район, ставит в каком-нибудь доме распределительный маршрутизатор. Из него провода тянутся в соседние дома. Обратите внимание на провода между уголками двух соседних многоэтажек — чаще всего это интернет.
Провод попадает в ваш дом. На крыше или в подвале ставится маршрутизатор — это устройство, которое определяет, куда какой сигнал отправить. В маршрутизатор вставляется провод, который тянется непосредственно в вашу квартиру. Мастер подключает провод к маршрутизатору в вашей квартире — та серая или чёрная коробочка с огоньками. Коробочка начинает раздавать Wi-Fi, и ваш компьютер подключается к сети.
Есть и другие способы подключиться, но в общем виде это так: магистраль → городская точка → провайдер → район → дом → подъезд → вы. И везде кабели. Интернет — это не волшебное облако с контентом, это огромная куча серверов, маршрутизаторов и кабелей, которые оплетают планету. И в самом конце, как вишенка на торте, ваш беспроводной роутер с Wi-Fi.
На примере одного запроса
Допустим, вы захотели открыть главную страницу «Яндекса». Вот как всё будет происходить.
Вы набрали в браузере адрес yandex.ru. Опуская технические подробности, скажем, что ваш браузер узнал, что сайт yandex.ru живёт на компьютере с адресом 77.88.55.80.
77.88.55.80 — это IP-адрес. Такой адрес есть у всех компьютеров в интернете, в том числе у вашего. Ваш браузер говорит компьютеру: «Сделай запрос на 77.88.55.80».
Компьютер упаковывает этот запрос: ставит отметку «от кого», «кому», формулирует сам вопрос. Получается такой пакет данных. Он отправляет этот пакет той коробочке, которая стоит у вашей двери и мигает огоньками.
Роутер смотрит, что за адрес. Он видит, что никаких компьютеров с таким адресом к этому роутеру не подключено, поэтому передаёт запрос более старшему роутеру — на крыше подъезда.
Роутер на крыше видит, что никаких компьютеров с нужным адресом к нему тоже не подключено. Он отдаёт запрос выше, на районный роутер. Тот ещё выше, провайдеру.
У провайдера на роутере написана чёткая инструкция, что если придёт запрос на адрес 77.88.55.80, нужно передать его вон тому роутеру. Он это делает. Мы оказываемся на магистральном канале, который приведёт запрос в «Яндекс».
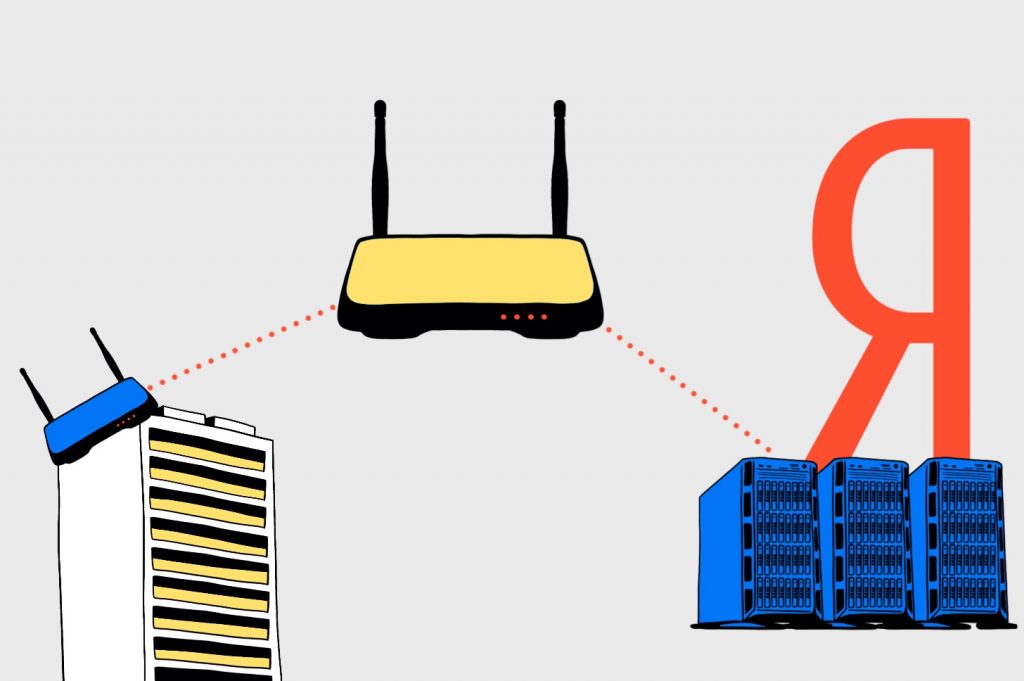
У «Яндекса» тысячи серверов, и один из них отвечает за главную страницу. Он получил запрос через цепочку роутеров и теперь обрабатывает.
Программа на сервере «Яндекса» готовит ответ на запрос. Она смотрит, из какого города к нему обращаются, и компонует новости для этого города. Определяет, знает ли она этого пользователя, и если знает — показывает ему число непрочитанных в почтовом ящике. Ещё она совершает множество невидимых действий, чтобы оптимизировать страницу.
Код итоговой страницы программа пакует по маленьким пакетам и отдаёт на ближайший роутер. На каждом пакете написан обратный адрес, с которого изначально пришёл запрос. Роутер начинает искать, как бы доставить эти пакеты обратно. Он отправляет их на магистраль, там роутеры передают эти пакеты провайдеру, он их направляет в нужный район, в районе их отправляют в дом, подъезд и, наконец, квартиру.
Пакеты приходят в вашу коробочку у двери. Она находит, какой компьютер запрашивал данные из «Яндекса», и отправляет ему по беспроводной связи только что пришедшие пакеты.
Ваш компьютер получает пакеты, распаковывает их, собирает цельный текст и рисует из этого текста страницу.
На весь путь из вашей квартиры до сервера «Яндекса» и обратно ушло меньше секунды, но в процессе было задействовано не менее пятидесяти машин — роутеров и серверов. Ваш запрос физически пропутешествовал до сервера «Яндекса» и вернулся. У вас ощущение, будто вы зашли в «Яндекс», но на самом деле «Яндекс» пришёл в ваш дом.
Это только самые основы. Дальше разберём, что можно с этими знаниями делать, как работают блокировки интернета и почему они на самом деле не работают, а главное — как сделать собственный сайт, который будет работать не хуже «Яндекса».
Получите ИТ-профессию
В «Яндекс Практикуме» можно стать разработчиком, тестировщиком, аналитиком и менеджером цифровых продуктов. Первая часть обучения всегда бесплатная, чтобы попробовать и найти то, что вам по душе. Дальше — программы трудоустройства.
Курс по основам компьютерных сетей на базе оборудования Cisco. Этот курс поможет вам подготовиться к экзаменам CCENT/CCNA, так как за его основу взят курс Cisco ICND1.
1.20 Разница между хабами, коммутаторами и роутерами (маршрутизаторами)
- 17.06.2018
- Cisco CCNA (ICND1 и ICND2), Компьютерные сети
- 15 комментариев
Привет, посетитель сайта ZametkiNaPolyah.ru! Продолжаем изучать основы работы компьютерных сетей, напомню, что эти записи основаны на программе Cisco ICND1 и помогут вам подготовиться к экзаменам CCENT/CCNA. Эта запись подводит итоги трем предыдущим, в которых мы знакомились с назначением, хабов (сетевых концентраторов), коммутаторов (свитчей) и роутеров (маршрутизаторов).
Как известно, повторение — мать учения, нам придется немного повториться, чтобы закрепить полученную ранее информацию о сетевых устройствах, которые занимаются передачей данных по сети.
Перед началом я хотел бы вам напомнить, что ознакомиться с опубликованными материалами первой части нашего курса можно по ссылке: «Основы взаимодействия в компьютерных сетях».
1.20.1 Введение
Эта тема подводит итог разговору о коммутаторах, сетевых концентраторах, маршрутизаторах, хабах и компьютерной сети, построенной по топологии с общей шиной. Все эти темы получились довольно объемными, поэтому здесь мы лишь подводим итоги этого большого разговора. Нам нужно просто выделить и посмотреть на основные отличия этих устройств.
Сейчас коротко напомню, что в данный момент вы вряд ли где-нибудь встретите компьютерные сети построенные по топологии с общей шиной или сети, в которых есть хабы и сетевые концентраторы, так как минусов в таких подходах гораздо больше, нежели плюсов, из плюсов можно выделить стоимость компьютерной сети, построенной на хабах, минусов много, на, пожалуй, на данный момент основной минус заключается в том, что в компьютерных сетях с хабами вы не сможете организовать такой вид сетевого взаимодействия, как H2H. Вместо хабов в данный момент используются коммутаторы, их предназначение заключается в том, чтобы объединить несколько компьютеров в сеть. Но коммутаторы совершенно не годятся для того, чтобы наладить взаимодействие между двумя сетями, так как коммутаторы не понимают и по сути не умеют работать с IP-пакетами.
Для задачи объединения двух сетей используется маршрутизатор или роутер – это устройство сетевого уровня модели TCP/IP, которое работает с IP-пакетами а дает нам возможность передать данные из одной подсети в другую.
1.20.2 Хабы и Ethernet с общей шиной
Начнем мы с физического уровня модели OSI, ведь именно к этому уровню относятся хабы, сетевые концентраторы и коаксиальный Ethernet кабель, который используется в компьютерных сетях с общей шиной. Хабы и сетевые концентраторы – это одно и то же, у этих устройств очень простая логика, они даже не умеют работать с Ethernet-кадрами, для них все данные представлены в виде последовательности бит. Работает хаб очень просто: данные приходящие ему на один из портов копируются и отправляются во все порты, кроме того, из которого эти самые данные пришли, давайте посмотрим на принцип его работы. Откроем Cisco Packet Tracer и соберем схему как показано на рисунке ниже, не забудьте переключиться в режим симуляции и настроить фильтр.

Рисунок 1.20.1 Схема для демонстрации работы сетевого концентратора
В фильтрах я оставил только ICMP пакеты, давайте запустим пинг от первого узла до третьего (см. последний октет IP-адреса).
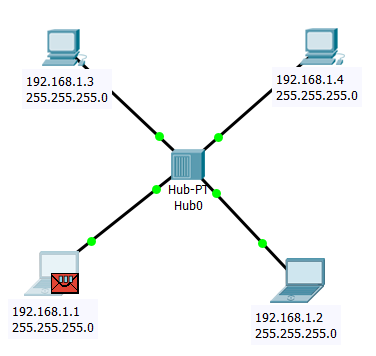
Рисунок 1.20.2 Компьютер сформировал ICMP пакет
Первый узел сформировал ICMP пакет, который в дальнейшем будет направлен в сторону сетевого концентратора.

Рисунок 1.20.3 ICMP запрос дошел до хаба
Узел направил ICMP запрос в сторону хаба, но дело в том, что сетевой концентратор ничего не знает про кадры и пакеты, для него это просто последовательность логических нулей и единиц, то есть электрических сигналов, не более.
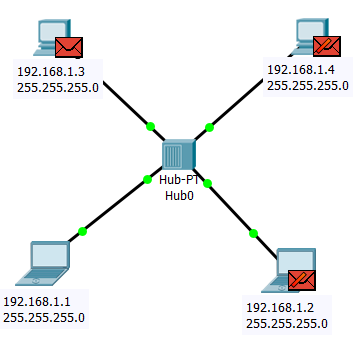
Рисунок 1.20.4 Хаб скопировал пришедшую последовательность бит и разослал ее во все порты
Затем хаб берет и просто побитно копирует данные, пришедшие в порт, который смотрит в сторону первого узла, во все остальные порты, эти данный приходят всем узлам, кроме первого, при этом эти данные не предназначены второму и четвертому узлу, поэтому, проанализировав полученный Ethernet кадр, эти узлы отбрасывают его. А вот третий узел понимает, что это ICMP-запрос, на который нужно ответить.
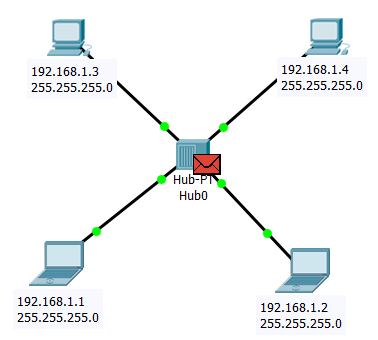
Рисунок 1.20.5 Третий узел послал ICMP ответ в сторону хаба
Поэтому, он формирует ICMP-ответ, запаковывает его в Ethernet-кадр и отправляет в сторону хаба. При этом хаб не запомнил, где находился узел, который посылал ICMP-запрос, просто потому, что хаб этого делать не умеет.
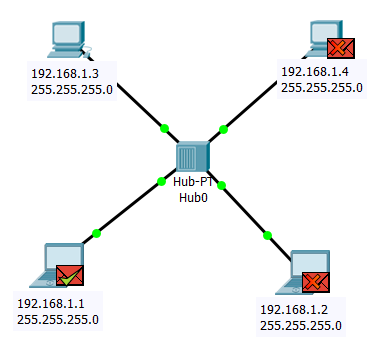
Рисунок 1.20.6 Хаб повторно разослал ICMP-ответ во все порты
И снова хаб поступает так, как и должен любой нормальный хаб: клонирует последовательность бит и рассылает ее во все порты, кроме того, на который эта последовательность пришла, при этом узлы два и четыре снова должны делать бесполезную работу по анализу и отбрасыванию не предназначенных им кадров. Из плюсов у хабов была только их небольшая цена и до какого-то времени схемы с хабами можно было терпеть, сейчас это уже не плюс и хаб вы навряд ли где-то найдете.
Минусов же у хабов очень много. Первый и очевидный минус – это безопасность, данные рассылаются во все порты хаба, а значит их очень просто перехватить сниффером. Второй минус заключается в неэффективном использование ресурса сети и его узлов: узлы вынуждены обрабатывать бесполезную информацию и при этом каналы заняты бесполезным трафиком. Третий минус заключается в отсутствие резерва: вы не сможете соединить хабы в кольцо (здесь вы найдете публикацию о физической и логической топологии компьютерной сети), тем самым создав дополнительные линии связи, таким образом в схемах с хабами нет защиты от обрывов и повреждений кабеля.
Компьютерную сеть с хабами очень быстро ложиться под воздействием широковещательного шторма и у вас не будет других механизмов его погасить, кроме как прийти физически к этому хабу и отключить его, а затем начнется еще более мучительный процесс по выявлению узла, который этот шторм начал. Также стоит отметить, что порты хаба работают в режиме half duplex и у них нет входящих и выходящих буферов, вся логика хаба описывается тремя глаголами: получил, скопировал, разослал.
Поэтому если ваша сеть целиком и полностью построена на хабах, то она вся представляет собой домен коллизий, то есть в любой точке вашей сети может произойти коллизия, но обнаруженная коллизия – это не самое страшное, самое страшное начинается, когда коллизия произошла, но ее не удалось обнаружить. Ну и последнее уже скорее следствие: в компьютерной сети с хабами в один момент времени может передавать только один узел, все остальные должны молчать и слушать.
Ну а теперь что касается топологии сети с общей шиной, построенной на коаксиальном Ethernet кабеле: такой компьютерной сети присущи все недостатки, которые есть в сетях с хабом, но добавляется еще один: при любом обрыве в любом месте сети с общей шиной, сеть мгновенно перестает работать. Как вы помните, концы коаксиального Ethernet кабеля оканчиваются специальными пассивными устройствами, которые называются терминаторами, они используются для поглощения сигнала, если бы терминаторов не было, то в сети с общей шиной постоянно были бы коллизии, так как сигнал бы просто отражался и частично возвращался назад в сеть, при этом происходило бы столкновение с полезными данными.
Поэтому, даже если в сети с общей шиной повредится отвод, идущий к узлу, мы получим ничем не оконченный кабель, от которого будет происходить отражение, а затем и коллизии.
1.20.3 Основные отличия хабов от коммутаторов
С хабами и общей шиной все понятно, а если непонятно, то просто запомните, что их не нужно использовать. Перейдем лучше к коммутаторам, эти, как и сетевые концентраторы, позволяют объединять узлы в единую сеть, но при этом коммутаторы лишены многих недостатков, которые есть у хабов. Классический L2 коммутатор – это устройство канального уровня модели OSI 7, которое умеет работать с Ethernet кадрами, а это означает, что у него уже есть логика, современный управляемый коммутатор можно представить как компьютер без видеокарты и монитора, у этого компьютера есть своя операционная система, которая заточена под решение определенных задач, как и модули этого компьютера: у коммутатора есть процессор, есть оперативная память, есть энергонезависимая память и многое другое, что присуще обычным настольным ПК, но все эти модули реализованы немного иначе, чем в настольных ПК, так как у коммутатора иные задачи.
Про внутренности коммутаторов Cisco и их устройство мы еще поговорим, сейчас давайте посмотрим на принципы работы L2 коммутаторов и чем же таким они отличаются от хабов, что смогли их вытеснить. Тут стоит упомянуть, что у нас есть еще неуправляемые коммутаторы, которые не стоит путать с хабами, такими коммутаторами нельзя управлять, они работают так, как их на строили на заводе, у них несколько меньший функционал, нежели у управляемых, но они все же коммутаторы, а не хабы.
Давайте теперь посмотрим, какие преимущества нам даст коммутатор перед хабом, для этого соберем аналогичную схему, но вместо хаба мы будем использовать коммутатор, схема показана на Рисунке 1.20.7. Я не рассказываю, как настроить узлы, поскольку есть отдельная публикация, в которой это все подробно описано можете к ней обратиться и сделать по аналогии (сетевое взаимодействие двух компьютеров)
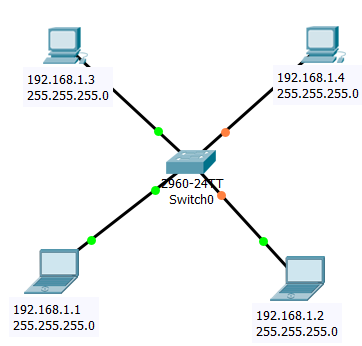
Рисунок 1.20.7 Схема для демонстрации работы управляемого коммутатора Cisco
Первое отличие заключается в том, что при подключении других устройств к коммутатору, линки загораются зеленым не сразу, а это означает, что передача данных сразу невозможна, дело все в том, что коммутатору прежде чем начать передавать данные, нужно понять, что за устройство к нему подключили и согласовать режим работы с этим устройством: определить какой режим дуплекса будет использован для передачи данных и на какой скорости передача данных будет вестись, помимо всего прочего, у коммутаторов Cisco по умолчанию включен протокол STP, который предназначен для защиты от петель, в Cisco Packet Tracer главным образом этот протокол (вот тут запись про протоколы, службы и примитивы) и дает небольшую задержку при подключении.
Давайте теперь попробуем пропинговать третий узел с первого узла и посмотрим, что получится, переключим в режим симуляции Cisco Packet Tracer, а в фильтре оставим ICMP и ARP, именно эти данные нам будут интересны. Но прежде, чем мы начнем симуляцию, давайте зайдем в интерфейс командной строки коммутатора и посмотрим на таблицу, в которой есть соответствие между портами коммутатора и мак-адресами устройств, которые за этими портами находятся.

Рисунок 1.20.8 Таблица мак-адресов коммутатора
Обратите внимание: сейчас эта таблица пуста, посмотреть мы ее смогли при помощи команды «show mac address-table», эта таблица пуста, поскольку ни одно устройство еще не передавало данные через наш коммутатор. Посмотрим, как эта таблица будет изменяться. На рисунке ниже показано, что первый узел сформировал два Ethernet кадра, в одном, который выделен зеленым, находится ARP-запрос, этот кадр будет направлен первым, так как первый узел не знает мак-адреса третьего узла, но знает его IP-адрес, а при помощи протокола ARP и известного IP-адреса можно выяснить мак-адрес удаленной стороны.

Рисунок 1.20.9 Ноутбук сформировал два Ethernet кадра
Итак, первым отправится в путь ARP-запрос, нам будет интересно посмотреть, что изменится на коммутаторе, после того, как он получит первый Ethernet кадр, тут стоит отметить, что коммутатор понимает, что кадр, который он получил, является широковещательным (коммутатор это увидит по мак-адресу назначения, про мак-адреса мы будем еще говорить), исходя из того, что кадр сам по себе широковещательный, коммутатор разошлет его всем устройствам, которые находятся в одной канальной среде вместе с тем устройством, которое сгенерировало этот кадр (тут стоит отметить, что не во все другие порты, как это делал хаб, все дело в том, что коммутаторы умеют работать с такой штукой как VLAN, которая позволяет изолировать канальные среды друг от друга). В нашем случае это все четыре устройства, подключенные к коммутатору. Но прежде чем это посмотреть, давайте посмотрим на таблицу мак-адресов коммутатора после того, как он обработает полученный кадр, она показана на Рисунке 1.20.10.

Рисунок 1.20.10 Таблица мак-адресов коммутатора после того, как он обработал первый Ethernet кадр
Теперь в таблице появилась первая запись, по которой коммутатор понимает, что за первым портом находится мак-адрес ноутбука. А теперь посмотрим, что будет дальше, Рисунок 1.20.11.

Рисунок 1.20.11 Коммутатор разослал всем устройствам канальной среды широковещательный Ethernet кадр
Пояснения к этому рисунку я давал ранее, но обратите внимание: третий узел понял, что этот ARP-запрос для него и только он будет на него отвечать. Процесс передачи ARP-ответа с третьего узла на коммутатор понятен, но давайте посмотрим, как изменилась таблица мак-адресов коммутатора, когда тот получил ARP-ответ от третьего узла, Рисунок 1.20.12.
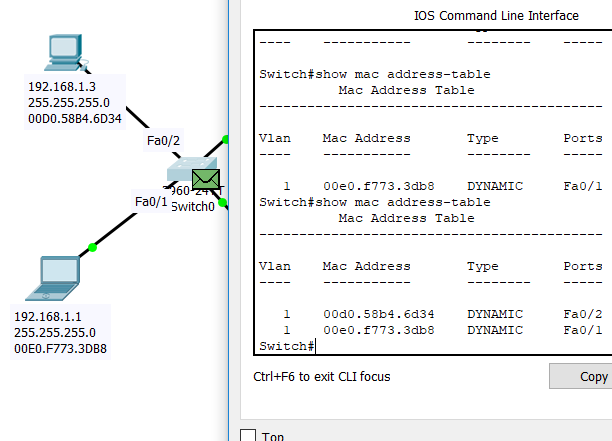
Рисунок 1.20.12 Теперь коммутатор знает, кто находится за первым портом, а кто за вторым
Теперь наш коммутатор знает, что за первым портом у него находится наш первый узел, а за вторым портом – третий, таким образом, по мере обмена данными между узлами, эта таблица будет заполняться, размер этой таблице ограничен, то есть она не бесконечна, ее размер зависит от модели коммутатора и от задач, для которых этот коммутатор создавался, на данном этапе нас это не очень сильно волнует.
Также стоит отметить, что записи в таблицы мак-адресов не вечны, их можно удалить вручную, но, если от узла не будет активности долгое время, коммутатор решит, что за портом все умерли и сотрет запись (время хранение записи на управляемых коммутаторах можно изменять). Давайте посмотрим, что сделает коммутатор с полученным ARP-ответом, Рисунок 1.20.13.
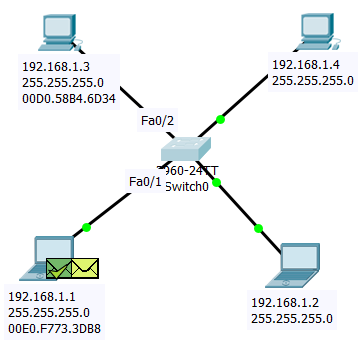
Рисунок 1.20.13 ARP-ответ будет направлен только первому узлу, так как у коммутатора уже есть запись в таблице
ARP-ответ будет направлен только первому узлу, так как у коммутатора уже есть запись в таблице мак-адресов, а в Ethernet кадре, который он получил, в качестве мак-адреса назначения был указан адрес первого узла, всё просто. Когда первый узел получил и обработал ARP-ответ, он вытащил из своего буфера ICMP-запрос, который будет направлен третьему узлу, мы не будем смотреть на прохождение ICMP, но отметим, что коммутатор будет действовать конкретно, то есть он будет передавать кадры с ICMP только между первым и третьим узлом, то есть каналы, идущие до второго и четвертого узла, будут свободны, а сами эти узлы не будут заняты ненужной работой. Вы самостоятельно можете это проверить.
Сейчас нам будет интересна другая ситуация: мы помним, что у компьютера есть таблица ARP, в которой хранится информации о соответствие IP и мак-адресов, при помощи этой таблицы узлы из одной подсети могут общаться друг с другом, не генерируя широковещательные арп-запросы и не засоряя среду передачи данных служебным трафиком, у третьего узла после общения с первым узлом, арп-таблица будет выглядеть примерно так, как показано в листинге ниже.
C : \ > arp — a
Internet Address Physical Address Type
192.168.1.1 00e0.f773.3db8 dynamic
У первого узла есть аналогичная запись, но в ней хранится информация о третьем узле, давайте смоделируем ситуацию небольшого сбоя на коммутаторе, при котором произошла очистка его таблицы мак-адресов, но при этом у конечных узлов останется информация в таблице ARP, то есть узлы не будут делать широковещательные ARP-запросы. Чтобы очистить таблицу маков на коммутаторе Cisco воспользуемся командой «clear mac address-table», а затем убедимся, что она пустая, Рисунок 1.20.14.
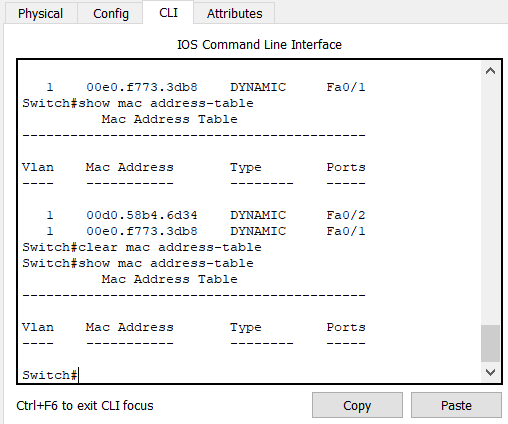
Рисунок 1.20.14 Очистим таблицу мак-адресов на коммутаторе
А теперь давайте повторно пропигуем третий узел с первого, ведь именно у них есть информация друг о друге в ARP, поэтому при общении они не будут формировать ARP-запросы.
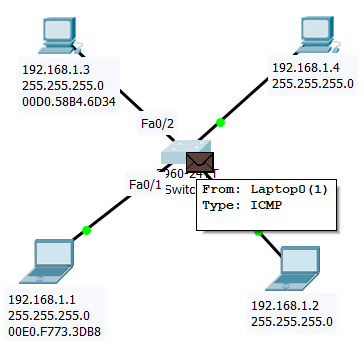
Рисунок 1.20.15 Ethernet кадр с ICMP вложением пришел на коммутатор
Кадр с ICMP пришел на коммутатор, Cisco Packet Tracer показывает тип кадра или пакета, если на него навести курсор мыши и немного подержать, мы видим, что никаких других кадров, кроме ICMP нет, мы пока этого не видим, но поверьте, содержимое этого кадра довольно таки конкретное и оно говорит коммутатору о том, что этот кадр идет из узла с мак-адресом 00E0.F773.3DB8 на узел с вот таким мак-адресом: 00D0.58B4.6D34. Но дело все в том, что в данный момент таблица маков у коммутатора пуста, он не знает куда посылать этот кадр, при этом нужно учесть, что коммутатор не умеет формировать широковещательные запросы, зато он прекрасно умеет флудить, имитируя поведения хаба с той лишь разницей, что кадр с неизвестным мак-адресом назначения будет отправлен не во все порты, а только в те порты, на которых прописан тот же VLAN, что и на порту, в который этот кадр пришел (я понимаю, что сейчас это непонятно, но в дальнейшем все встанет на свои места). В нашем случае это три других порта.
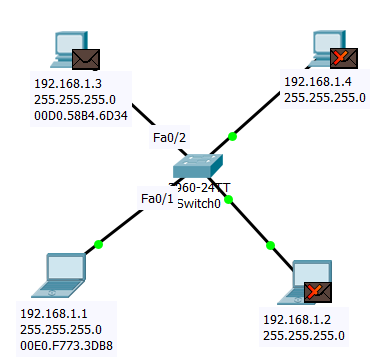
Рисунок 1.20.16 Коммутатор флудит и рассылает полученный ICMP запрос всем устройствам в канальной среде
Если сейчас посмотреть на таблицу маков коммутатора, то там можно уже увидеть запись о первом узле, так как коммутатор уже обработал от него кадр, поэтому, когда третий узел пошлет ICMP-ответ, коммутатор не станет его отправлять второму и четвертому узлам, он будет направлен только первому узлу, в этом вы сможете убедиться самостоятельно, если продолжите симуляцию. Дальнейшие ICMP-запросы и ответы будут ходить только между первым и третьим узлом, второй и четвертый не будут нагружены бесполезной работой.
Итак, основное отличие хабов от коммутаторов заключается в том, что это устройства разных уровней модели OSI 7. Первые относятся к физическому уровню, а вот коммутаторы – это уже устройства канального уровня, их основной единицей измерения информации является кадр, в нашем случае, это Ethernet кадр, коммутаторы гораздо сложение хабов и по сути являются компьютером с операционной системой, но без графики (хотя управлять коммутаторами можно и через веб-интерфейс, но в этом случае за графическую составляющую отвечает компьютер сетевого инженера, на коммутаторе лишь хранятся веб-страницы).
У коммутаторов есть таблица, по которой он понимает: за каким портом какое устройство находится, но у L2 коммутатора нет ARP-таблицы, да она ему и не нужна, хотя, опять же, есть коммутаторы L3, которые умеют работать с IP-адресами, и у них есть ARP.
Еще одним плюсом коммутаторов является то, что порт коммутатора может работать в нескольких режимах: full duplex или half duplex, а также на порту коммутатора можно регулировать скорость передачи данных, например, модель коммутатора Cisco 2960, реализованная в Packet Tracer, имеет два порта, способных передавать данные на скорости до 1 Гбит/c и 24 порта на скорости до 100 Мбит/c. При этом гигабитные порты можно перевести в режим на 100 Мбит/c или 10 Мбит/c, для портов 100 Мбит/c аналогично.
Стоит отметить, что режим half duplex в современных коммутаторах сохранен в основном для совместимости с древними устройствами, но и он может быть иногда полезен в тех случаях, когда вы используете двухпарную медную линию, в ситуациях, когда одна из пар повредилась передача данных в режиме 100 Мбит/c full duplex будет невозможна, тогда нужно будет попробовать переключить порт в режим 10 Мбит/c full duplex, а если и это не поможет, то стоит попробовать настроить устройства, связанные частично поврежденным кабелем в режим работы 10half, таким образом вы сможете сохранить связь до тех пор, пока обрыв не будет устранен.
Я не зря упоминал про режимы работы порта коммутатора, именно благодаря тому, что порт коммутатора может работать в режиме работы full duplex, узлы, подключенные к коммутатору, могут одновременно и передавать, и принимать данные, но не только благодаря этому, у портов коммутатора есть еще входные и выходные буферы, в которых находятся кадры, ждущие своей участи. Две этих особенности практически полностью устраняют домен коллизий в сетях, построенных на коммутаторах. Практически, потому, что по причинам различных сбоев может произойти ситуация, в которой случается рассинхронизация режимов работы порта коммутатора и порта устройства, подключенного к этому коммутатору, при этом домен коллизий ограничен портом коммутатора, то есть столкновение кадров может произойти только в канале между коммутатором и устройством, с которым произошла рассинхронизация.
Вообще, современные коммутаторы обладают богатым арсеналом технологий, делающих передачу данных в компьютерных сетях более безопасной, надежной и эффективной, но сейчас мы их не будем касаться, для этого у нас еще есть много других тем, но уже сейчас видно, почему на данный момент коммутаторы вытеснили хабы отовсюду.
1.20.4 Коммутаторы коммутируют, а маршрутизаторы маршрутизируют
При собеседовании на начальные позиции сетевых инженеров часто задают вопрос: чем отличается коммутатор от маршрутизатора. Можно, конечно, пошутить и сказать, что коммутаторы коммутируют, а маршрутизаторы маршрутизируют, но шутку могут не оценить. Поэтому, если нужен короткий и ясный ответ, то можно сказать так: коммутаторы используются для объединения компьютеров в одну сеть, а маршрутизаторы нужны для объединения сетей.
Действительно, коммутаторы L2, да и L2+ практически не умеют работать с IP-адресами, их задача заключается в том, чтобы организовать взаимодействие узлов, находящихся в одной канальной среде, то есть в одной подсети, для решения этой задачи коммутаторам хватает мак-адресов. Но что если вам нужно наладить связь между двумя подсетями, как тут быть? Здесь два выхода: переконфигурировать узлы так, чтобы они находились в одной подсети и получить неэффективную сеть, в которой будет очень много широковещательного трафика, который не только занимает канал связи, но еще и создает дополнительную нагрузку на коммутаторы или воспользоваться маршрутизатором/роутером, который способен перенаправлять пакеты из одной подсети в другую.
Схема, с которой мы будем работать показана на Рисунке 1.20.17, здесь показано две подсети, условно будем их называть левая и правая, а в центре этой схемы находится маршрутизатор. Стоит обратить внимание на то, что порты маршрутизатора по умолчанию выключены и их нужно включать, на рисунке все уже настроено, поэтому линки горят зеленым, при сборке схемы у вас изначально они будут красными.

Рисунок 1.20.17 Компьютерная сеть с маршрутизатором
Также обратите внимание, что все настройки, а также мак-адреса устройств подписаны под каждым из узлов и для каждого интерфейса маршрутизатора, особенность маршрутизаторов заключается в том, что каждый физический интерфейс имеет мак-адрес, это важно. Также стоит заметить, что каждый интерфейс маршрутизатора должен находиться в своей подсети, если вы попробуете задать на первый и второй порт маршрутизатора IP-адреса из одной подсети, то операционная система Cisco выдаст ошибку и на второй интерфейс IP-адрес задан не будет.
Также напомню список команд и их последовательность, чтобы вам проще было настроить интерфейсы маршрутизатора:
- enable – входим в привилегированный режим.
- configure terminal – переходим в режим конфигурации.
- interface gi0/0 – переходим в режим конфигурации порта gi0/0.
- no shutdown – включаем порт gi0/0.
- ip address 192.168.1.1 255.255.255.0 – задаем ip-адрес и маску на порт gi0/0.
- gi0/1 – переключаемся на конфигурации порта gi0/1.
- no shutdown – включаем порт gi0/1.
- ip address 45.10.10.1 255.255.255.0 – задаем ip-адрес и маску на порт gi0/1.
- end – выходим из режима конфигурации.
- write – сохраняем настройки.
Если в нашем случае настройки не сохранить, то после перезагрузки устройства произойдет откат до заводского состояния. Обратите внимание: у узлов теперь появился шлюз или gateway (default gateway или шлюз по умолчанию). Узлам мы задаем в качестве шлюза IP-адрес того интерфейса маршрутизатора, который находится в одной подсети с этими узлами, то есть для левой подсети это 192.168.1.1, а для правой подсети 45.10.10.1.
Основной шлюз, вернее IP-адрес шлюза, для узла является указанием: если узел, к которому ты хочешь обратиться, находится не в твоей подсети, посылай IP-пакет мне, я попробую разобраться. В теме, где мы знакомились с роутером, мы смотрели таблицу маршрутов на компьютере и видели, как это правило выглядит. А также мы видели, что у компьютеров есть ARP-таблица, такая же таблица есть и у маршрутизатора, посмотреть ее можно командой «show ip arp». Так выглядит таблица нашего маршрутизатора сразу после того, как мы его настроили:
Руководство по стеку протоколов TCP/IP для начинающих
Разбираемся в основных понятиях и принципах работы современного стека.
Эта инструкция — часть курса «Как работают сетевые протоколы».
Смотреть весь курс
Cтек протоколов TCP/IP широко распространен. Он используется в качестве основы для глобальной сети интернет. Разбираемся в основных понятиях и принципах работы стека.
Основы TCP/IP
Стек протоколов TCP/IP (Transmission Control Protocol/Internet Protocol, протокол управления передачей/протокол интернета) — сетевая модель, описывающая процесс передачи цифровых данных. Она названа по двум главным протоколам, по этой модели построена глобальная сеть интернет. Сейчас это кажется невероятным, но в 1970-х информация не могла быть передана из одной сети в другую. Чтобы обеспечить такую возможность, был разработан стек интернет-протоколов, известный как TCP/IP.
Разработка сетевой модели осуществлялась при содействии Министерства обороны США, поэтому иногда модель TCP/IP называют DoD (Department of Defence) модель. Если вы знакомы с моделью OSI, то вам будет проще понять построение модели TCP/IP, потому что обе модели имеют деление на уровни, внутри которых действуют определенные протоколы и выполняются собственные функции. Мы разделили статью на смысловые части, чтобы было проще понять, как устроена модель TCP/IP:
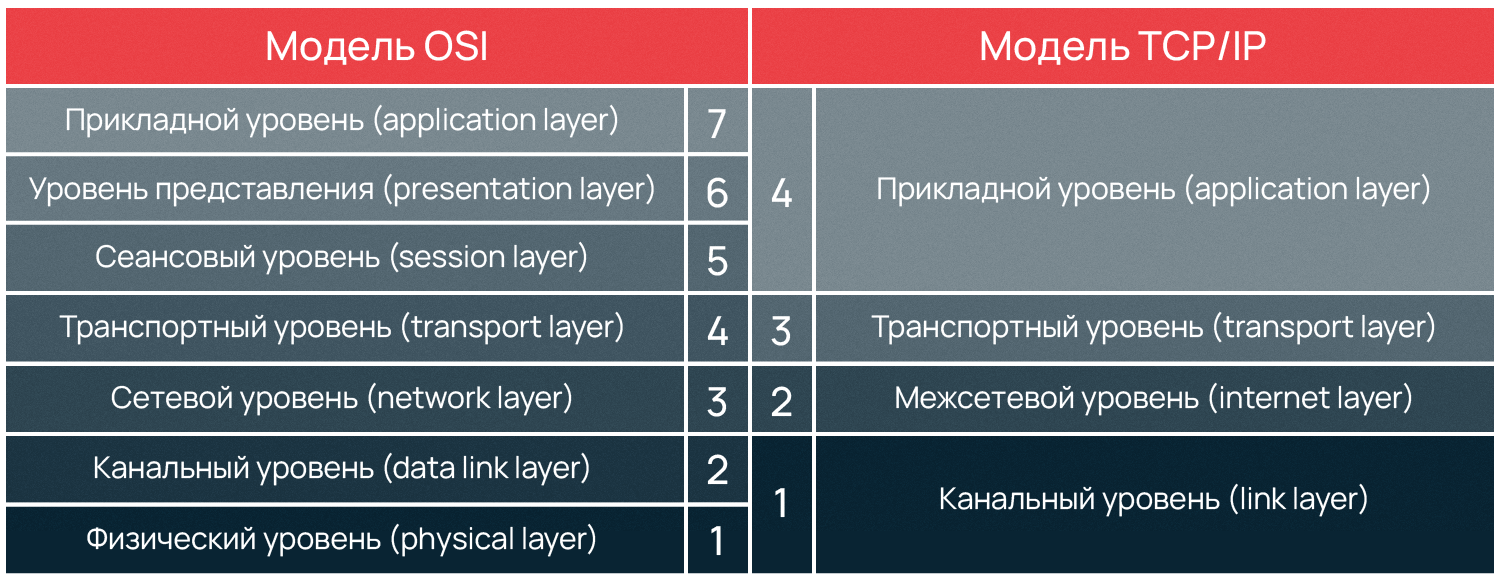
Уровневая модель TCP/IP
Выше мы уже упоминали, что модель TCP/IP разделена на уровни, как и OSI, но отличие двух моделей в количестве уровней. Документами, определяющими сертификацию модели, являются RFC 1122 и RFC1123. Эти стандарты описывают четыре уровня абстракции модели TCP/IP: прикладной, транспортный, межсетевой и канальный. Существуют и другие версии описания модели, в том числе включающие иное количество уровней и их наименований. Однако в этой статье мы придерживаемся оригинальной версии и далее рассмотрим четыре уровня модели.
Канальный уровень (link layer)
Предназначение канального уровня — дать описание тому, как происходит обмен информацией на уровне сетевых устройств, определить, как информация будет передаваться от одного устройства к другому. Информация здесь кодируется, делится на пакеты и отправляется по нужному каналу, т.е. среде передачи.
Этот уровень также вычисляет максимальное расстояние, на которое пакеты возможно передать, частоту сигнала, задержку ответа и т.д. Все это — физические свойства среды передачи информации. На канальном уровне самым распространенным протоколом является Ethernet, который мы рассмотрим в конце статьи.
Межсетевой уровень (internet layer)
Глобальная сеть интернет состоит из множества локальных сетей, взаимодействующих между собой. Межсетевой уровень используется, чтобы описать обеспечение такого взаимодействия.
Межсетевое взаимодействие — это основной принцип построения интернета. Локальные сети по всему миру объединены в глобальную, а передачу данных между этими сетями осуществляют магистральные и пограничные маршрутизаторы.
Именно на межсетевом уровне функционирует протокол IP, позволивший объединить разные сети в глобальную. Как и протокол TCP, он дал название модели, рассматриваемой в статье.
Маска подсети и IP-адреса
Маска подсети помогает маршрутизатору понять, как и куда передавать пакет. Подсетью может являться любая сеть со своими протоколами. Маршрутизатор передает пакет напрямую, если получатель находится в той же подсети, что и отправитель. Если же подсети получателя и отправителя различаются, пакет передается на второй маршрутизатор, со второго на третий и далее по цепочке, пока не достигнет получателя.
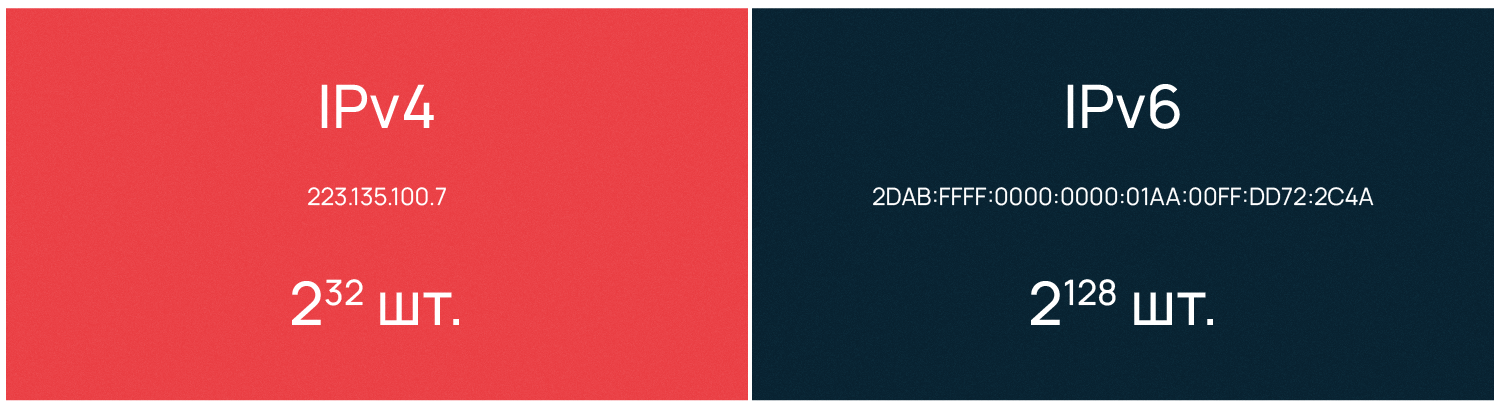
Протокол IP (Internet Protocol) используется маршрутизатором, чтобы определить, к какой подсети принадлежит получатель. Свой уникальный IP-адрес есть у каждого сетевого устройства, при этом в глобальной сети не может существовать два устройства с одинаковым IP. Протокол имеет две действующие версии, первая из которых — IPv4 (IP version 4, версии 4) — была описана в 1981 году.
IPv4 предусматривает назначение каждому устройству 32-битного IP-адреса, что ограничивало максимально возможное число уникальных адресов 4 миллиардами (2^32). В более привычном для человека десятичном виде IPv4 выглядит как четыре блока (октета) чисел от 0 до 255, разделенных тремя точками. Первый октет IP-адреса означает класс сети, классов всего 5: A, B, C, D, E. При этом адреса сети D являются мультикастовыми, а сети E вообще не используются.
Рассмотрим, например, IPv4 адрес класса С 223.135.100.7. Первые три октета определяют класс и номер сети, а последний означает номер конечного устройства. Например, если необходимо отправить информацию с компьютера номер 7 с IPv4 адресом 223.135.100.7 на компьютер номер 10 в той же подсети, то адрес компьютера получателя будет следующий: 223.135.100.10.
В связи с быстрым ростом сети интернет остро вставала необходимость увеличения числа возможных IP-адресов. В 1995 году впервые был описан протокол IPv6 (IP version 6, версии 6), который использует 128-битные адреса и позволяет назначить уникальные адреса для 2^128 устройств.
IPv6 имеет вид восьми блоков по четыре шестнадцатеричных значения, а каждый блок разделяется двоеточием. IPv6 выглядит следующим образом:
2dab:ffff:0000:0000:01aa:00ff:dd72:2c4a.
Так как IPv6 адреса длинные, их разрешается сокращать по определенным правилам, которые также описываются RFC:
- Для написания адреса используются строчные буквы латинского алфавита: a, b, c, d, e, f.
- Ведущие нули допускается не указывать — например, в адресе выше :00ff: можно записать как :ff:.
- Группы нулей, идущие подряд, тоже допустимо сокращать и заменять на двойное двоеточие. На примере выше это выглядит так: 2dab:аааа::01aa:00ff:dd72:2c4a. Допускается делать не больше одного подобного сокращения в адресе IPv6 на наибольшей последовательности нулей. Если одинаково длинных последовательностей несколько — на самой левой из них.
IP предназначен для определения адресата и доставки ему информации. Он предоставляет услугу для вышестоящих уровней, но не гарантирует целостность доставляемой информации.
IP способен инкапсулировать другие протоколы, предоставлять место, куда они могут быть встроены. К таким протоколам, например, относятся ICMP (межсетевой протокол управляющих сообщений) и IGMP (межсетевой протокол группового управления). Информация о том, какой протокол инкапсулируется, отражается в заголовке IP-пакета. Так, ICMP будет обозначен числом 1, а IGMP будет обозначен числом 2.
ICMP
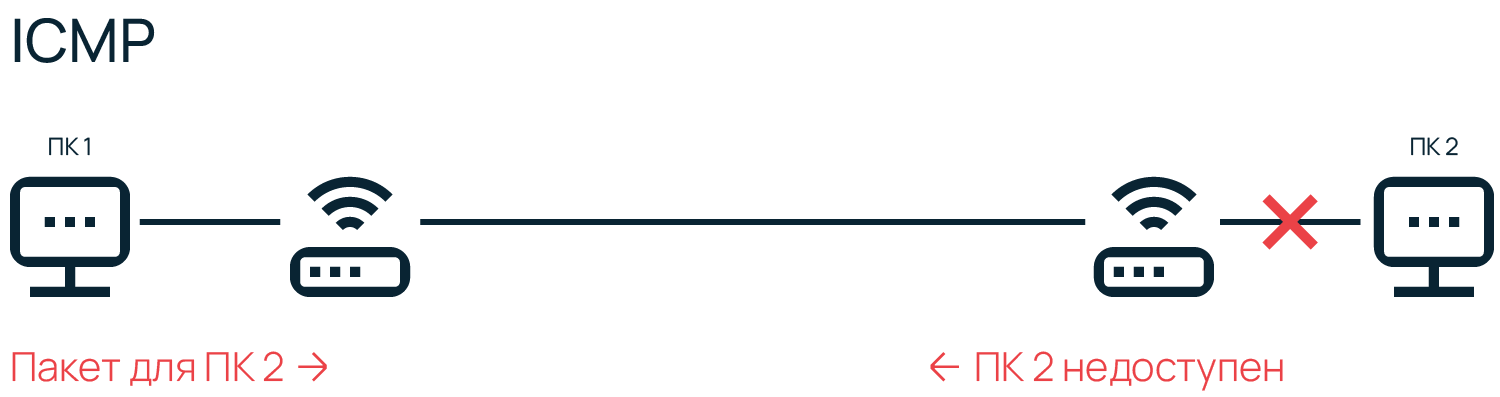
ICMP в основном используется устройствами в сети для доставки сообщений об ошибках и операционной информации, сообщающей об успехе или ошибке при связи с другим устройством. Например, именно с использованием ICMP осуществляется передача отчетов о недоступности устройств в сети. Кроме того, ICMP используется при диагностике сети — к примеру, в эксплуатации утилит ping или traceroute.
ICMP не передает какие-либо данные, что отличает его от протоколов, работающих на транспортном уровне — таких как TCP и UDP. ICMP, аналогично IP, работает на межсетевом уровне и фактически является неотъемлемой частью при реализации модели TCP/IP. Стоит отметить, что для разных версий IP используются и разные версии протокола ICMP.
Транспортный уровень (transport layer)
Постоянные резиденты транспортного уровня — протоколы TCP и UDP, они занимаются доставкой информации.
TCP (протокол управления передачей) — надежный, он обеспечивает передачу информации, проверяя дошла ли она, насколько полным является объем полученной информации и т.д. TCP дает возможность двум конечным устройствам производить обмен пакетами через предварительно установленное соединение. Он предоставляет услугу для приложений, повторно запрашивает потерянную информацию, устраняет дублирующие пакеты, регулируя загруженность сети. TCP гарантирует получение и сборку информации у адресата в правильном порядке.
UDP (протокол пользовательских датаграмм) — ненадежный, он занимается передачей автономных датаграмм. UDP не гарантирует, что всех датаграммы дойдут до получателя. Датаграммы уже содержат всю необходимую информацию, чтобы дойти до получателя, но они все равно могут быть потеряны или доставлены в порядке отличном от порядка при отправлении.
UDP обычно не используется, если требуется надежная передача информации. Использовать UDP имеет смысл там, где потеря части информации не будет критичной для приложения, например, в видеоиграх или потоковой передаче видео. UDP необходим, когда делать повторный запрос сложно или неоправданно по каким-то причинам.
Протоколы транспортного уровня не интерпретируют информацию, полученную с верхнего или нижних уровней, они служат только как канал передачи, но есть исключения. RSVP (Resource Reservation Protocol, протокол резервирования сетевых ресурсов) может использоваться, например, роутерами или сетевыми экранами в целях анализа трафика и принятия решений о его передаче или отклонении в зависимости от содержимого.
Прикладной уровень (application layer)
В модели TCP/IP отсутствуют дополнительные промежуточные уровни (представления и сеансовый) в отличие от OSI. Функции форматирования и представления данных делегированы библиотекам и программным интерфейсам приложений (API) — своего рода базам знаний, содержащим сведения о том, как приложения взаимодействуют между собой. Когда службы или приложения обращаются к библиотеке или API, те в ответ предоставляют набор действий, необходимых для выполнения задачи и полную инструкцию, каким образом эти действия нужно выполнять.
Протоколы прикладного уровня действуют для большинства приложений, они предоставляют услуги пользователю или обмениваются данными с «коллегами» с нижних уровней по уже установленным соединениям. Здесь для большинства приложений созданы свои протоколы. Например, браузеры используют HTTP для передачи гипертекста по сети, почтовые клиенты — SMTP для передачи почты, FTP-клиенты — протокол FTP для передачи файлов, службы DHCP — протокол назначения IP-адресов DHCP и так далее.
Сети в Selectel
Узнайте, как устроена сетевая архитектура крупного провайдера.
Зачем нужен порт и что означает термин «сокет»
Приложения прикладного уровня, общаются также с предыдущим, транспортным, но они видят его протоколы как «черные ящики». Для приема-передачи информации они могут работать, например, с TCP или UDP, но понимают только конечный адрес в виде IP и порта, а не принцип их работы.
Как говорилось ранее, IP-адрес присваивается каждому конечному устройству протоколом межсетевого уровня. Но обмен данными происходит не между конечными устройствами, а между приложениями, установленными на них. Чтобы получить доступ к тому или иному сетевому приложению недостаточно только IP-адреса, поэтому для идентификации приложений применяют также порты. Комбинация IP-адреса и порта называется сокетом, или гнездом (socket).
Кроме собственных протоколов, приложения на прикладном уровне зачастую имеют и фиксированный номер порта для обращения к сети. Администрация адресного пространства интернет (IANA), занимающаяся выделением диапазонов IP-адресов, отвечает еще за назначение сетевым приложениям портов.
Так почтовые приложения, которые общаются по SMTP-протоколу, используют порт 25, по протоколу POP3 — порт 110, браузеры при работе по HTTP — порт 80, FTP-клиенты — порт 21. Порт всегда записывается после IP и отделяется от него двоеточием, выглядит это, например, так: 192.168.1.1:80.
Что такое DNS и для чего используется эта служба
Чтобы не запоминать числовые адреса интернет-серверов была создана DNS — служба доменных имен. DNS всегда слушает на 53 порту и преобразует буквенные имена сетевых доменов в числовые IP-адреса и наоборот. Служба DNS позволяет не запоминать IP — компьютер самостоятельно посылает запрос «какой IP у selectel.ru?» на 53 порт DNS-сервера, полученного от поставщика услуг интернет.
DNS-сервер дает компьютеру ответ «IP для selectel.ru — XXX.XXX.XXX.XXX». Затем, компьютер устанавливает соединение с веб-сервером полученного IP, который слушает на порту 80 для HTTP-протокола и на порту 443 для HTTPS. В браузере порт не отображается в адресной строке, а используется по умолчанию, но, по сути, полный адрес сайта Selectel выглядит вот так: https://selectel.ru:443.
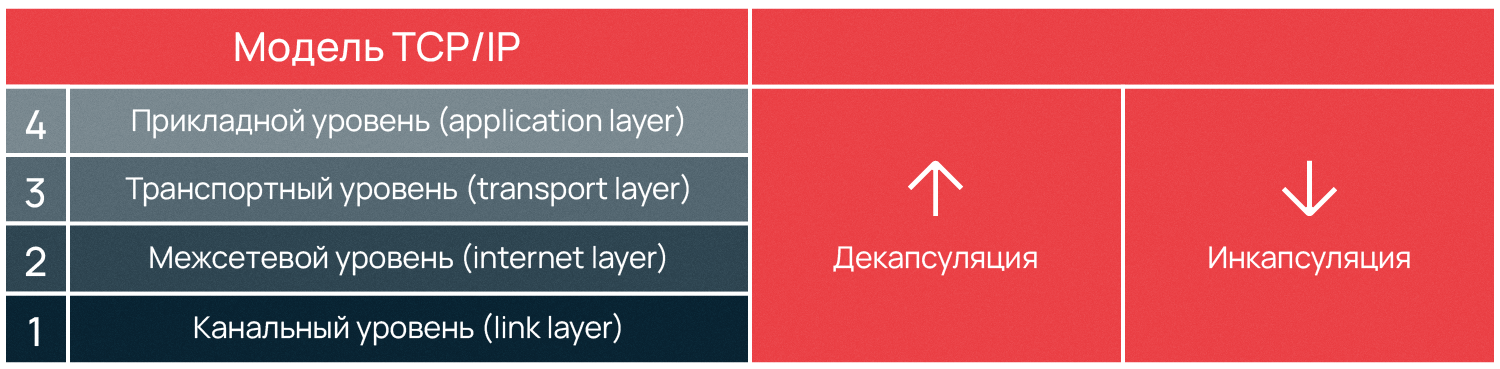
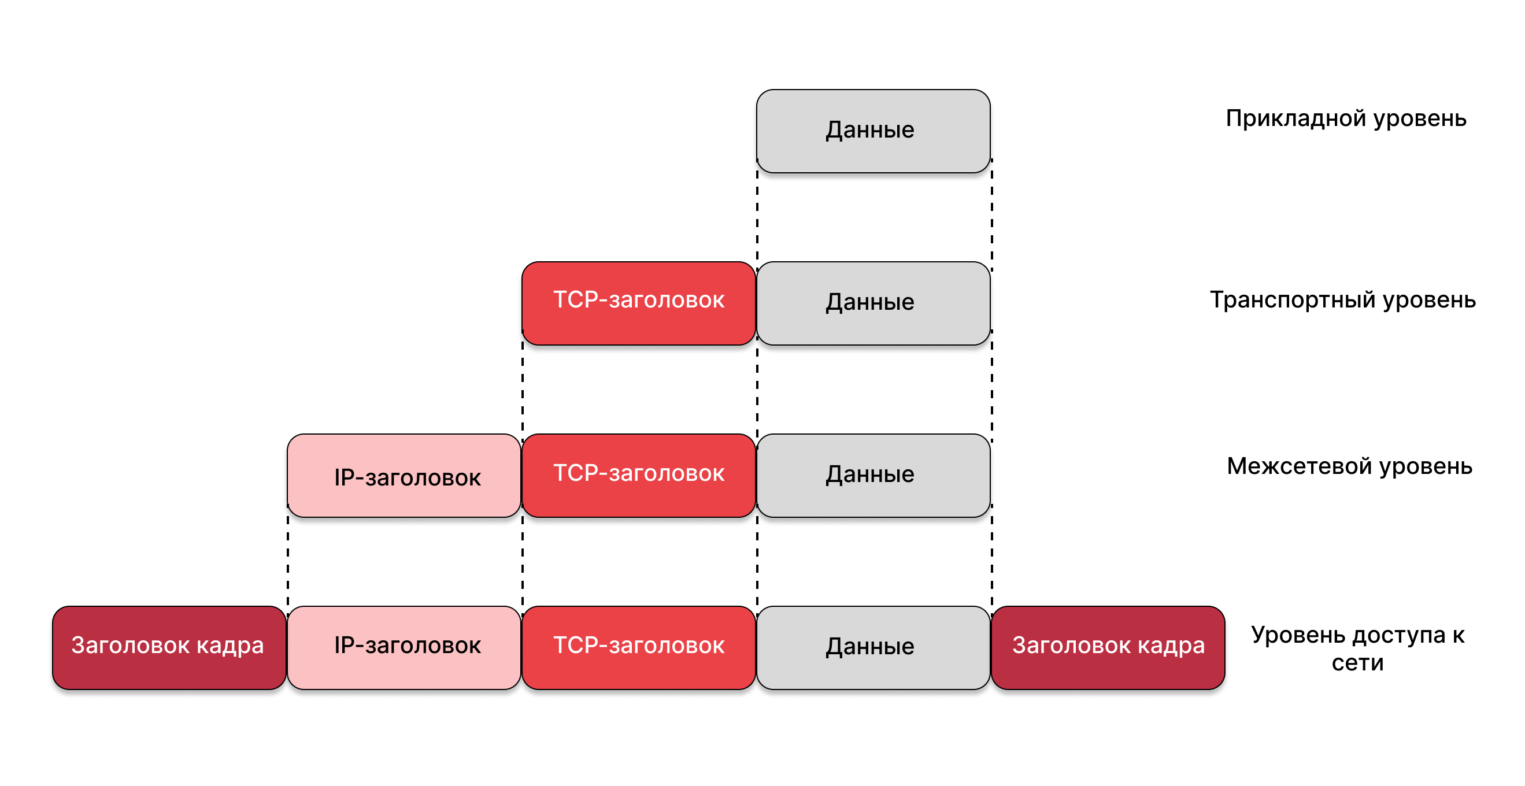
Для обеспечения корректной работы протоколов различных уровней в сетевых моделях используется специальный метод — инкапсуляция. Суть этого метода заключается в добавлении заголовка протокола текущего уровня к данным, полученным от протокола вышестоящего уровня. Процесс, обратный описанному, называется декапсуляцией. Оба процесса осуществляются на компьютерах получателя и отправителя данных попеременно, это позволяет долго не удерживать одну сторону канала занятой, оставляя время на передачу информации другому компьютеру.
Стек протоколов, снова канальный уровень
О канальном уровне модели TCP/IP мы рассказали меньше всего. Давайте вернемся еще раз к началу, чтобы рассмотреть инкапсуляцию протоколов и что значит «стек».
Большинству пользователей знаком протокол Ethernet. В сети, по стандарту Ethernet, устройства отправителя и адресата имеют определенный MAC-адрес — идентификатор «железа». MAC-адрес инкапсулируется в Ethernet вместе с типом передаваемых данных и самими данными. Фрагмент данных, составленных в соответствии с Ethernet, называется фреймом, или кадром (frame).
MAC-адрес каждого устройства уникален, и двух «железок» с одинаковым адресом не должно существовать. Совпадение может привести к сетевым проблемам. Таким образом, при получении кадра сетевой адаптер занимается извлечением полученной информации и ее дальнейшей обработкой.
После ознакомления с уровневой структурой модели становится понятно, что информация не может передаваться между двумя компьютерами напрямую. Сначала кадры передаются на межсетевой уровень, где компьютеру отправителя и компьютеру получателя назначается уникальный IP. После чего, на транспортном уровне, информация передается в виде TCP-фреймов либо UDP-датаграмм.
На каждом этапе, подобно снежному кому, к уже имеющейся информации добавляется служебная информация, например, порт на прикладном уровне, необходимый для идентификации сетевого приложения. Добавление служебной информации к основной обеспечивают разные протоколы — сначала Ethernet, поверх него IP, еще выше TCP, над ним порт, означающий приложение с делегированным ему протоколом. Такая вложенность называется стеком, названным TCP/IP по двум главным протоколам модели.
Point-to-Point протоколы
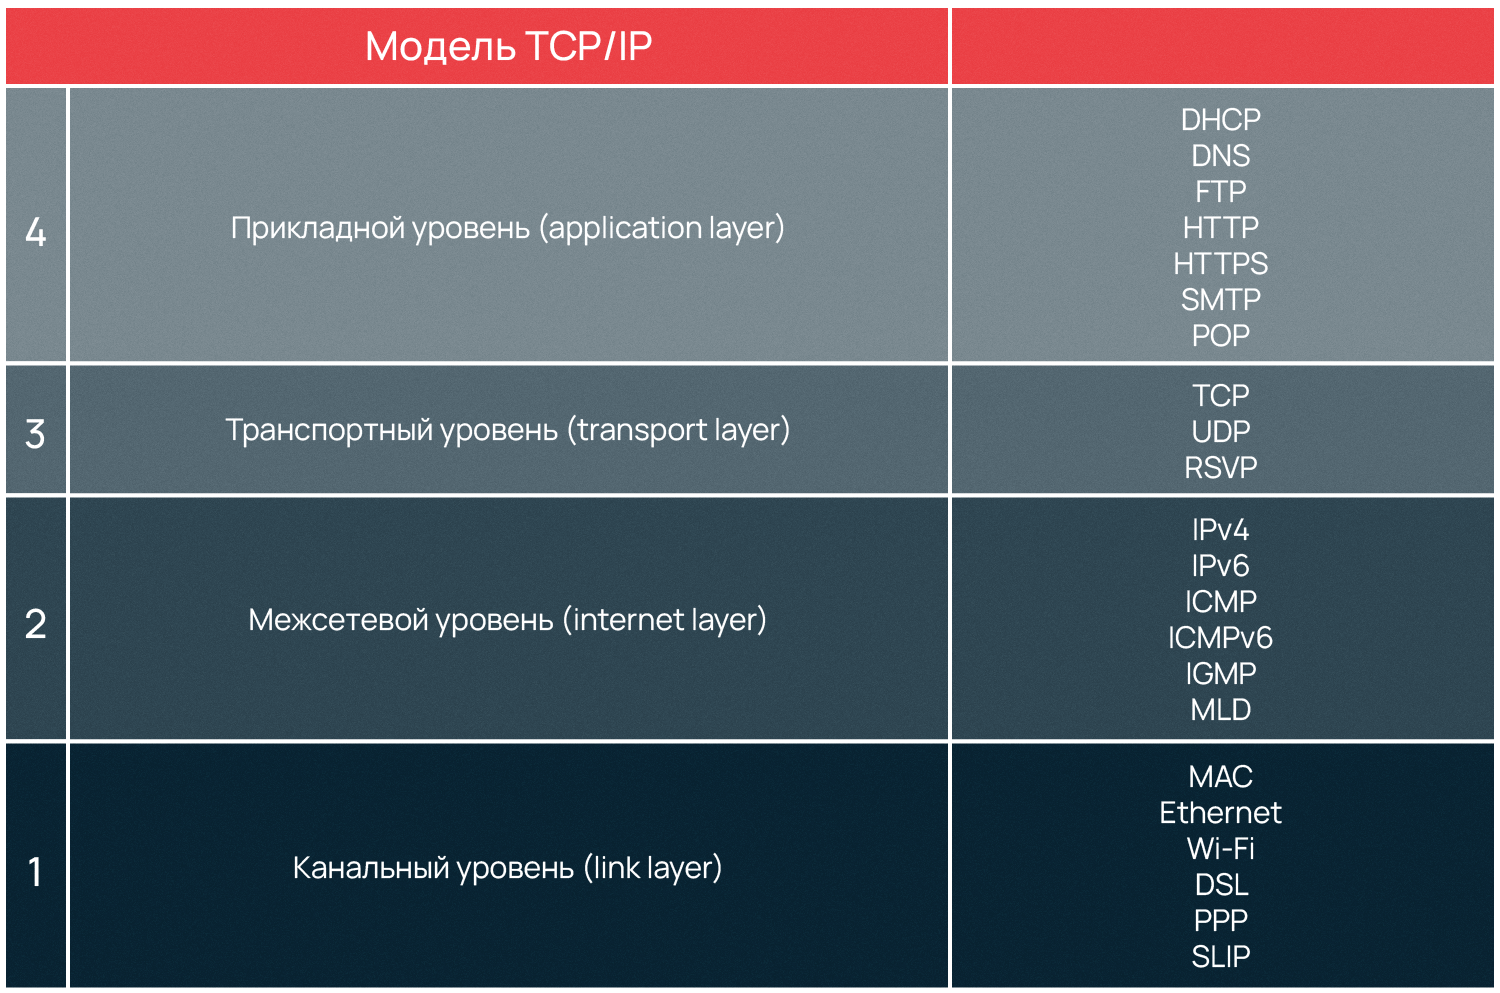
Отдельно расскажем о Point-to-Point (от точки к точке, двухточечный) протоколе, также известном как PPP. PPP уникален по своим функциям, он применяется для коммуникации между двумя маршрутизаторами без участия хоста или какой-либо сетевой структуры в промежутке. При необходимости PPP обеспечивает аутентификацию, шифрование, а также сжатие данных. Он широко используется при построении физических сетей, например, кабельных телефонных, сотовых телефонных, сетей по кабелю последовательной передачи и транк-линий (когда один маршрутизатор подключают к другому для увеличения размера сети).
У PPP есть два подвида — PPPoE (PPP по Ethernet) и PPPoA (PPP через асинхронный способ передачи данных — ATM), интернет-провайдеры часто их используют для DSL соединений.
PPP и его старший аналог SLIP (протокол последовательной межсетевой связи) формально относятся к межсетевому уровню TCP/IP, но в силу особого принципа работы, иногда выделяются в отдельную категорию. Преимущество PPP в том, что для установки соединения не требуется сетевая инфраструктура, а необходимость маршрутизаторов отпадает. Эти факторы обуславливают специфику использования PPP протоколов.
Заключение
Стек TCP/IP регламентирует взаимодействие разных уровней. Ключевым понятием здесь являются протоколы, формирующие стек, встраиваясь друг в друга с целью передать данные. Рассмотренная модель по сравнению с OSI имеет более простую архитектуру.
Сама модель остается неизменной, в то время как стандарты протоколов могут обновляться, что еще дальше упрощает работу с TCP/IP. Благодаря всем преимуществам стек TCP/IP получил широкое распространение и использовался сначала в качестве основы для создания глобальной сети, а после для описания работы интернета.
Простое пособие по сетевой модели OSI для начинающих