1.1.1. Компоненты поисковых машин
Информация в Сети не только пополняется, но и постоянно изменяется, но об этих изменениях никто никому не сообщает. Отсутствует единая система занесения информации, одновременно доступная для всех пользователей Интернета. Поэтому с целью структурирования информации, предоставления пользователям удобных средств поиска данных и были созданы поисковые машины.
Поисковые системы бывают разных видов. Одни из них выполняют поиск информации на основе того, что в них заложили люди. Это могут быть каталоги, куда сведения о сайтах, их краткое описание либо обзоры заносят редакторы. Поиск в них ведется среди этих описаний.
Вторые собирают информацию в Сети, используя специальные программы. Это поисковые машины, состоящие, как правило, из трех основных компонентов:
Агент, или более привычно — паук, робот (в англоязычной литературе — spider, crawler), в поисках информации обходит сеть или ее определенную часть. Этот робот хранит список адресов (URL), которые он может посетить и проиндексировать, с определенной для каждой поисковой машины периодичностью скачивает соответствующие ссылкам документы и анализирует их. Полученное содержимое страниц сохраняется роботом в более компактном виде и передается в Индекс. Если при анализе страницы (документа) будет обнаружена новая ссылка, робот добавит ее в свой список. Поэтому любой документ или сайт, на который есть ссылки, может быть найден роботом. И наоборот, если на сайт или любую его часть нет никаких внешних ссылок, робот может его не найти.
Робот — это не просто сборщик информации. Он обладает довольно развитым «интеллектом». Роботы могут искать сайты определенной тематики, формировать списки сайтов, отсортированных по посещаемости, извлекать и обрабатывать информацию из существующих баз данных, могут выполнять переходы по ссылкам различной глубины вложенности. Но в любом случае, всю найденную информацию они передают базе данных (Индексу) поисковой машины.
Поисковые роботы бывают различных типов:
? Spider (паук) — это программа, которая скачивает веб-страницы тем же способом, что и браузер пользователя. Отличие состоит в том, что браузер отображает информацию, содержащуюся на странице (текстовую, графическую и т. д.), паук же не имеет никаких визуальных компонентов и работает напрямую с HTML-текстом страницы (аналогично тому, что вы увидите, если включите просмотр HTML-кода в вашем браузере).
? Crawler (краулер, «путешествующий» паук) — выделяет все ссылки, присутствующие на странице. Его задача — определить, куда дальше должен идти паук, основываясь на ссылках или исходя из заранее заданного списка адресов. Краулер, следуя по найденным ссылкам, осуществляет поиск новых документов, еще неизвестных поисковой системе.
? Индексатор разбирает страницу на составные части и анализирует их. Выделяются и анализируются различные элементы страницы, такие как текст, заголовки, структурные и стилевые особенности, специальные служебные HTML-теги и т. д.
Индекс — это та часть поисковой машины, в которой осуществляется поиск информации. Индекс содержит все данные, которые были переданы ему роботами, поэтому размер индекса может достигать сотен гигабайт. Практически, в индексе находятся копии всех посещенных роботами страниц. В случае если робот обнаружил изменение на уже проиндексированной им странице, он передает в Индекс обновленную информацию. Она должна замещать имеющуюся, но в ряде случаев в Индексе появляется не только новая, но остается и старая страница.
Поисковый механизм — это тот самый интерфейс, с помощью которого посетитель взаимодействует с Индексом. Через интерфейс пользователи вводят свои запросы и получают ответы, а владельцы сайтов регистрируют их (и эта регистрация — еще один способ донести до робота адрес своего сайта). При обработке запроса поисковый механизм выполняет отбор соответствующих ему страниц и документов среди многих миллионов проиндексированных ресурсов и выстраивает их в порядке важности или соответствия запросу.
Названные выше компоненты не обязательно входят в состав поисковой машины так, как они здесь описаны. У разных поисковиков реализация может отличаться друг от друга. К примеру, связка Spider+Crawler+Индексатор может быть выполнена в виде единой программы, которая скачивает известные веб-страницы, анализирует их и ищет по ссылкам новые ресурсы.
Данный текст является ознакомительным фрагментом.
Продолжение на ЛитРес
Читайте также
Виды виртуальных машин
Виды виртуальных машин Система виртуальных машин может быть построена на базе различных платформ и при помощи разных технологий. Используемая схема виртуализации зависит как от аппаратной платформы, так и от особенностей «взаимоотношений» хостовой ОС и поддерживаемых
Консоль виртуальных машин
Консоль виртуальных машин Большую часть окна консоли занимает поле, в котором отображается перечень имеющихся ВМ. Если ни одной машины еще не создано, то это поле пустое (см. рис. 2.4), а в правой части окна доступна единственная кнопка — New (создать). Эта кнопка запускает
Окно виртуальных машин
Окно виртуальных машин Центральную часть окна виртуальных машин занимает поле, в котором отображаются значения основных параметров и текущая конфигурация запущенной ВМ (рис. 4.7). Рис. 4.7. Окно виртуальных машин Parallels WorkstationВ каждый момент времени могут быть представлены
Поиск по трекерам средствами поисковых машин
Поиск по трекерам средствами поисковых машин Если вы пользуетесь услугами пиринговой сети не часто, а от случая к случаю, то можете искать ссылки или так называемые торренты с помощью поисковой машины Google. Для этого достаточно ввести в поле ввода ключевых слов для поиска
Использование языка запросов поисковых машин
Использование языка запросов поисковых машин В строку запроса поисковой машины, помимо ключевых слов, можно вводить так называемые операторы – специальные служебные слова или символы, которые сообщают поисковой системе, каким образом нужно обращаться с теми или иными
Описание языков запросов различных поисковых машин
Описание языков запросов различных поисковых машин Умение искать информацию с помощью поисковых машин очень важно для создания и последующей раскрутки блога.Благодаря поисковым машинам можно своевременно собирать информацию, появляющуюся в Интернете по теме, которой
18.2. Инсталляция системы виртуальных машин
18.2. Инсталляция системы виртуальных машин Для установки необходимо сначала скачать ПО с сайта компании VMware, а также получить лицензию на его использование. Можно, конечно, купить лицензию (стоимость ее около 300 долларов), однако можно пользоваться и временной (30-дневной)
История развития поисковых машин
История развития поисковых машин История эволюции поисковых машин наиболее полно, на наш взгляд, представлена в книге признанных экспертов в области невидимого интернета Криса Шермана и Гарри Прайса «Невидимый Интернет».[2]До середины 1960-х годов компьютеров было
Ограничения возможностей поисковых машин
Ограничения возможностей поисковых машин 1. Физические ограничения скорости. Информационные системы имеют физические ограничения по скорости поиска новых страниц. Скажем так, скорость, с которой сегодня паук пытается найти новые страницы, оказывается ниже, чем
1.1.2. Характеристики поисковых машин
1.1.2. Характеристики поисковых машин В статье, посвященной поисковой машине Rambler (http://www.rambler.ru/ doc/architecture.shtml), называются основные характеристики, которые могут быть применены к любым поисковикам:? полнота;? точность;? актуальность;? скорость;? наглядность.Полнота поиска
5.4. Оптимизация сайта для поисковых машин
5.4. Оптимизация сайта для поисковых машин Какие задачи решает оптимизация для поисковых машин Поисковые машины сегодня являются важнейшим инструментом навигации в Интернете. С их помощью в Сети ищут информацию, сравнивают, анализируют, спрашивают совета, ищут
Какие задачи решает оптимизация для поисковых машин
Какие задачи решает оптимизация для поисковых машин Поисковые машины сегодня являются важнейшим инструментом навигации в Интернете. С их помощью в Сети ищут информацию, сравнивают, анализируют, спрашивают совета, ищут единомышленников, знакомых и даже смысл жизни. Если
13-я КОМНАТА: Этика машин и механизмов
13-я КОМНАТА: Этика машин и механизмов Автор: Леонид Левкович-МаслюкВ этом номере вы найдете статью о «биржевых роботах» — компьютерных программах, зарабатывающих для своих владельцев деньги на фондовом рынке. Соотношение квалификации электронных и живых трейдеров
История машин, мешавших обучению
История машин, мешавших обучению Несмотря на все факты, сведения и научные выводы, говорящие против этого, в настоящее время школы (и даже детские сады!) повсеместно оборудуются компьютерами — в целях обучения. Почему это не может дать положительных результатов, было
Что такое краулинг и как управлять роботами
Выдача ответов на поисковый запрос на странице поиска за долю секунды только верхушка айсберга. В «черном ящике» поисковых систем — просканированные и занесенные в специальную базу данных миллиарды страниц, которые отбираются для представления с учетом множества факторов.
Страница с результатами поиска формируется в результате трех процессов:
- сканирования;
- индексирования;
- предоставления результатов (состоит из поиска по индексу и ранжирования страниц).
В этом выпуске «Азбуки SEO» речь пойдет о сканировании или краулинге страниц сайта.
Как работает сканирование (краулинг) сайта?
Если кратко, краулинг (сканирование, crawling) — процесс обнаружения и сбора поисковым роботом (краулером) новых и обновленные страницы для добавления в индекс поисковых систем. Сканирование — начальный этап, данные собираются только для дальнейшей внутренней обработки (построения индекса) и не отображаются в результатах поиска. Просканированная страница не всегда оказывается проиндексированной.
Поисковый робот (он же crawler, краулер, паук, бот) — программа для сбора контента в интернете. Краулер состоит из множества компьютеров, запрашивающих и выбирающих страницы намного быстрее, чем пользователь с помощью своего веб-браузера. Фактически он может запрашивать тысячи разных страниц одновременно.
Что еще делает робот-краулер:
- Постоянно проверяет и сравнивает список URL-адресов для сканирования с URL-адресами, которые уже находятся в индексе Google.
- Убирает дубликаты в очереди, чтобы предотвратить повторное скачивание одной и той же страницы.
- Добавляет на переиндексацию измененные страницы для предоставления обновленных результатов.
При сканировании пауки просматривают страницы и выполняют переход по содержащимся на них ссылкам так же, как и обычные пользователи. При этом разный контент исследуется ботами в разной последовательности. Это позволяет одновременно обрабатывать огромные массивы данных.
Например, в Google существуют роботы для обработки разного типа контента:
- Googlebot — основной поисковый робот;
- Googlebot News — робот для сканирования новостей;
- Googlebot Images — робот для сканирования изображений;
- Googlebot Video — робот для сканирования видео.
В статье о robots.txt мы собрали полный перечень роботов-пауков. Знакомьтесь 🙂
Кстати, именно с robots.txt и начинается процесс сканирования сайта — краулер пытается обнаружить ограничения доступа к контенту и ссылку на карту сайта (Sitemap). В карте сайта должны находиться ссылки на важные страницы сайта. В некоторых случаях поисковый робот может проигнорировать этот документ и страницы попадут в индекс, поэтому конфиденциальную информацию нужно закрывать паролем непосредственно на сервере.
Просматривая сайты, бот находит на каждой странице ссылки и добавляет их в свою базу. Робот может обнаружить ваш сайт даже без размещения ссылок на него на сторонних ресурсах. Для этого нужно осуществить переход по ссылке с вашего сервера на другой. Заголовок HTTP-запроса клиента «referer» будет содержать URL источника запроса и, скорее всего, сохранится в журнале источников ссылок на целевом сервере. Следовательно, станет доступным для робота.
Как краулер видит сайт
Если хотите проверить, как робот-краулер видит страницу сайта, отключите обработку JavaScript при включенном отладчике в браузере. Рассмотрим на примере Google Chrome:
1. Нажимаем F12 — вызываем окно отладчика, переходим в настройки.
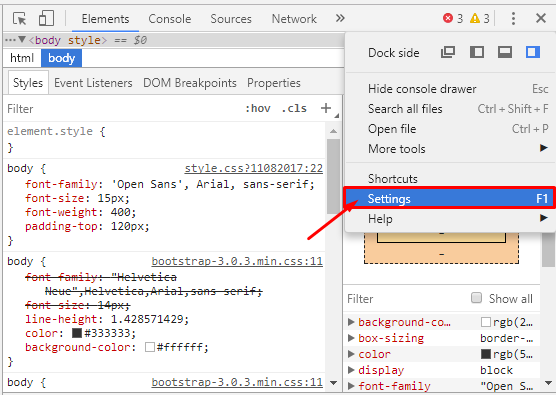
2. Отключаем JavaScript и перезагружаем страницу.
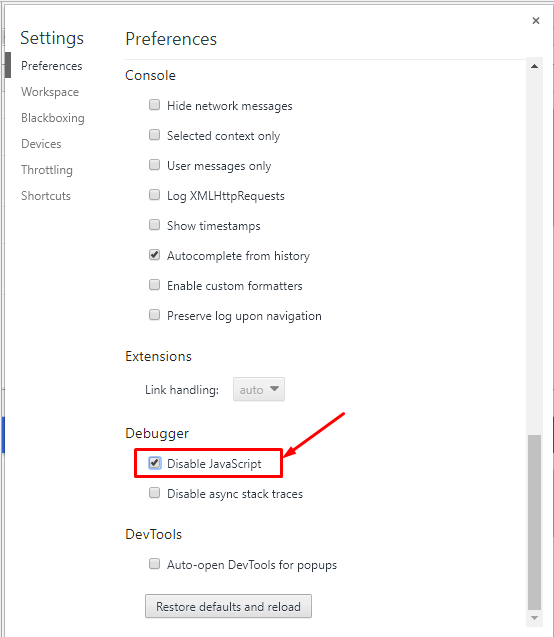
Если в целом на странице сохранилась основная информация, ссылки на другие страницы сайта и выглядит она примерно так же, как и с включенным JavaScript, проблем со сканированием не должно возникнуть.
Второй способ — использовать инструмент Google «Просмотреть как Googlebot» в Search Console.
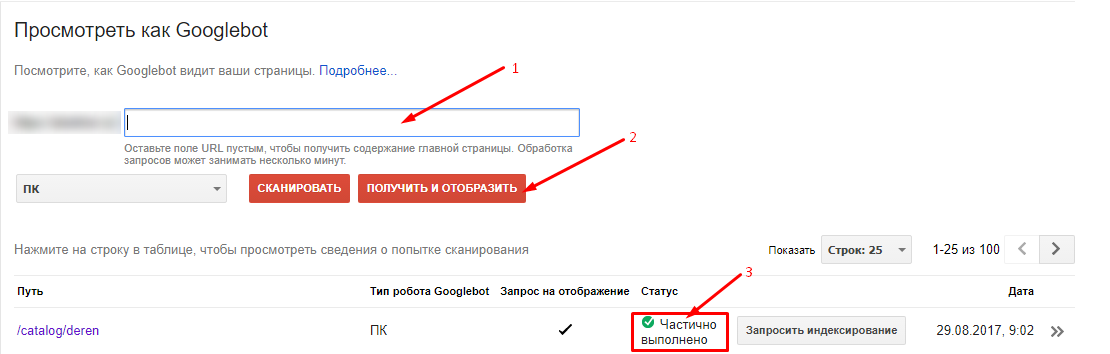
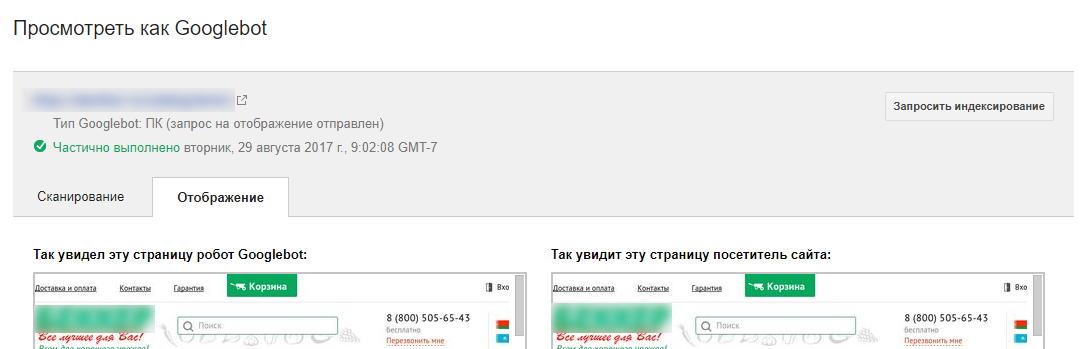
Если краулер видит вашу страницу так же, как и вы, проблем со сканированием не возникнет.
Третий метод — специальное программное обеспечение. Например, Netpeak Spider показывает более 50 разных видов ошибок, найденных при сканировании, и разделяет их по степени важности.
Если страница не отображается так, как вы ожидали, стоит проверить, доступна ли она для сканирования: не заблокирована ли она в robots.txt, в файле .htaccess.
Проблемы со сканированием могут возникать, если сайт создан с помощью технологий Javascript и Ajax , так как поисковые системы пока с трудом сканируют подобный контент.
Как управлять сканированием страниц
Запуск и оптимизация сканирования сайта
Существует несколько методов пригласить робота-паука к себе на сайт:
- Разрешить сканирование сайта, если он был запаролен на сервере, и передать информацию об URL c помощью HTTP-заголовка «referer» при переходе на другой ресурс.
- Разместить ссылку на ваш сайт на другом ресурсе, например, в соцсетях.
- Зарегистрироваться в панелях вебмастеров Google.
- Сообщить о сайте поисковой системе напрямую через кабинет вебмастеров Google.
- Использовать внутреннюю перелинковку страниц для улучшения навигации и сканирования ресурса, например, хлебные крошки.
- Создать карту сайта с нужным списком страниц и разместить ссылку на карту в robots.txt.
Запрет сканирования сайта
- Для ограничения сканирования контента следует защитить каталогов сервера паролем. Это простой и эффективный способ защиты конфиденциальной информации от ботов.
- Ставить ограничения в robots.txt.
- Использовать метатег . С помощью директивы “nofollow” стоит запретить переход по ссылкам на другие страницы.
- Использовать HTTP-заголовок X-Robots tag. Запрет на сканирование со стороны сервера осуществляется с помощью HTTP заголовка X-Robots-tag: nofollow. Директивы, которые применяются для robots.txt, подходят и для X-Robots tag.
Больше информации о использовании http-заголовка в справке для разработчиков.
Управление частотой сканирования сайта
Googlebot использует алгоритмический процесс для определения, какие сайты сканировать, как часто и сколько страниц извлекать. Вебмастер может предоставить вспомогательную информацию краулеру с помощью файла sitemap, то есть с помощью атрибутов:
- — дата последнего изменения файла;
- — вероятная частота изменений страницы;
- — приоритетность.
К сожалению, значения этих атрибутов рассматриваются роботами как подсказка, а не как команда, поэтому в Google Search Console и существует инструмент для ручной отправки запроса на сканирование.
Выводы
- Разный контент обрабатывается ботами в разной последовательности. Это позволяет одновременно обрабатывать огромные массивы данных.
- Для улучшения процесса сканирования нужно создавать карты сайтов и делать внутреннюю перелинковку — чтобы бот смог найти все важные страницы.
- Закрывать информацию от индексирования лучше с помощью метатега или http-заголовка X-Robot tag, так как файл robots.txt содержит лишь рекомендации по сканированию, а не прямые команды к действию.
Читайте больше об инструментах для парсинга сайта , необходимых SEO-специалисту в рутинной работе.
Поисковая система
В Unisender есть все для рассылок: можно создавать и отправлять клиентам письма и SMS, настроить чат-бота и делать рассылки в Telegram и даже собрать простой лендинг для пополнения базы контактов.
Поисковая система (поисковик) — это специальная программа, которая в ответ на запрос пользователя через веб-интерфейс (сайт) выдает список ресурсов, отсортированных по релевантности этому запросу.
Хорошая поисковая система предлагает материалы, которые наиболее корректно отвечают на запрос пользователя. При этом многие поисковики могут искать нужное не только по словам, но и по картинке или голосовому сообщению.
Прародителем всех поисковых систем считают программу Арчи — первый инструмент для поиска контента в интернете. Арчи предлагал пользователям архив со списком доступных файлов и возможностью поиска по ним.
Лишь в 1994 году появилась первая полноценная поисковая система — WebCrawler, которая стала индексировать не только названия файлов или заголовки страниц, но и их содержимое. А уже через три года, в 1997 году, на рынок вышли привычные нам Google и Яндекс — самые популярные поисковые системы в России, по данным Яндекс.радар .
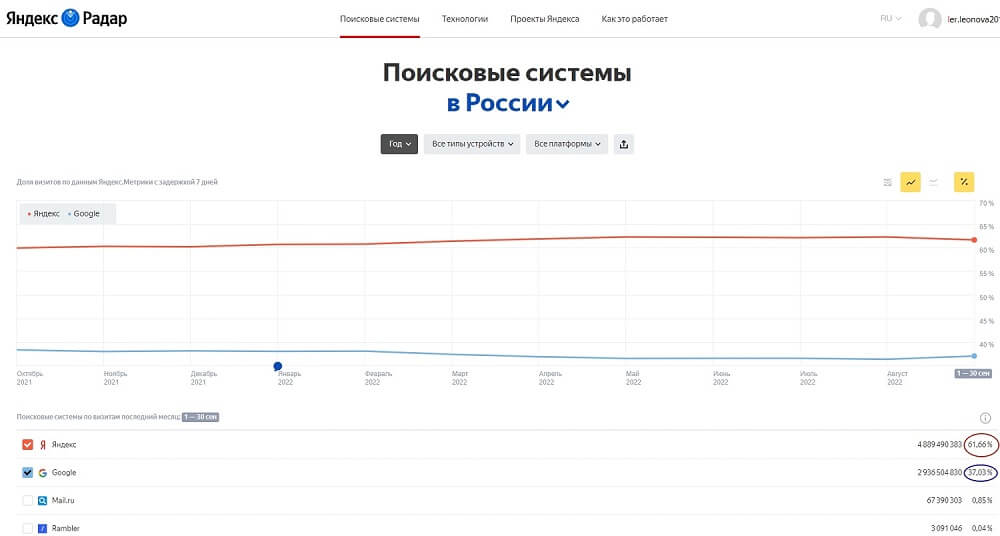
Если обратиться к мировой статистике, то здесь лидирует Google (84,8%), а «Яндекс» (1,06%) уходит на 6-е место.
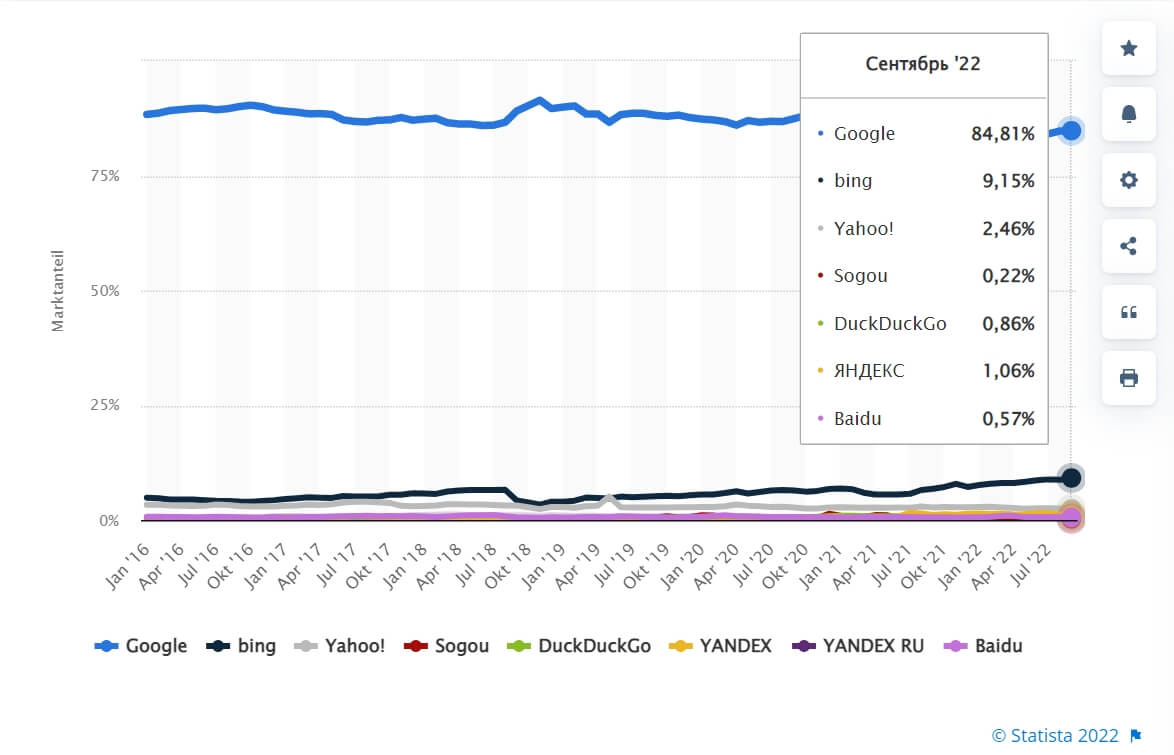
Доля рынка наиболее часто используемых поисковых систем по всему миру по состоянию на сентябрь 2022 г. Источник
Зачем нужна поисковая система
Без поисковых систем обычный пользователь вряд ли найдет в интернете нужную информацию, так как без них не будет привычного нам списка сайтов. Придется вручную вбивать адрес каждого ресурса, чтобы проверить, есть ли там то, что вы ищите. К счастью, алгоритмы поисковиков уже знают, какая информация есть на большинстве сайтов, и в ответ на запрос выдают список страниц, которые больше всего соответствуют этому запросу.
Кроме того, современные поисковые системы давно вышли за границы обычных поисковиков и превратились в целые экосистемы, которые помогают пользователям решать множество бытовых и бизнес-задач. В том же «Яндексе» есть электронная почта, маркетплейс, онлайн-кинотеатр, такси, доставка еды, карты, различные сервисы для бизнеса, а еще собственная платежная система и знакомый многим голосовой помощник Алиса.
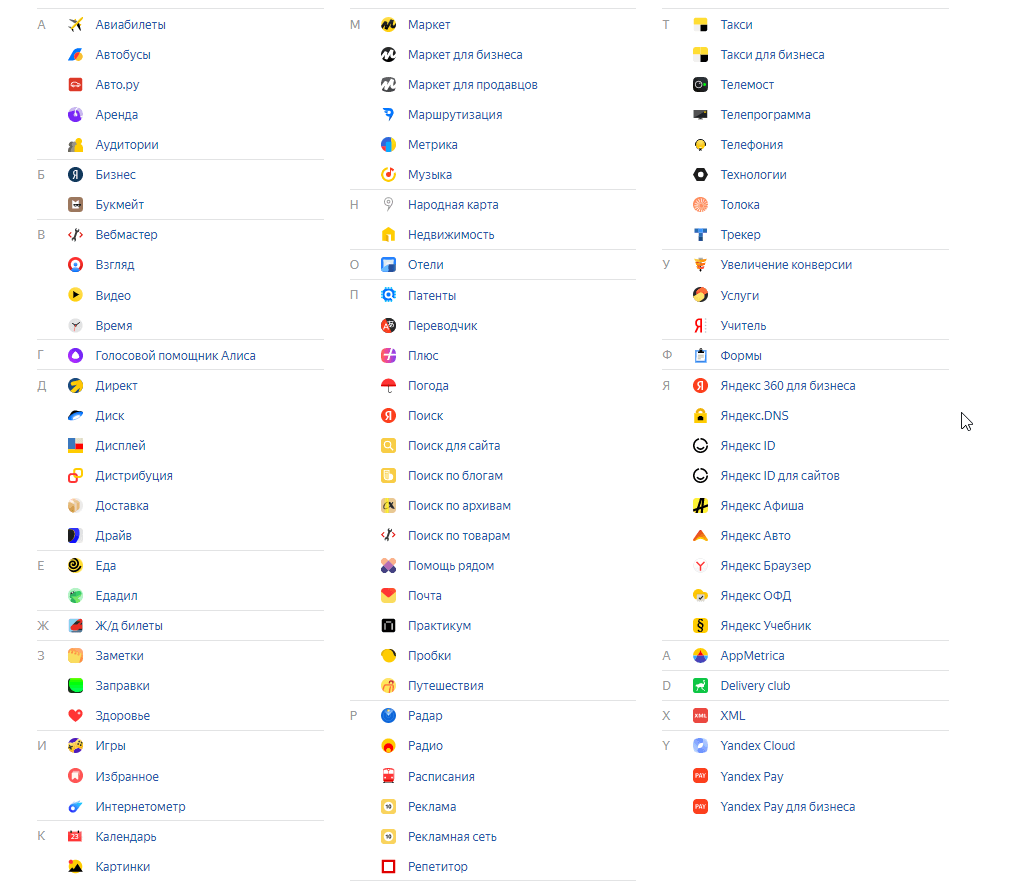
У Яндекса столько разных сервисов, что они не поместились на одном экране даже мелким шрифтом
Этапы работы поисковиков
У каждой поисковой системы — свой алгоритм работы, который держится в строгом секрете. Однако условно весь процесс подбора нужной информации поисковиком можно разделить на три этапа: сканирование (поиск и сохранение страниц), индексация и ранжирование.
Сканирование
Чтобы поисковая система смогла найти нужную информацию в большом количестве сайтов, эти сайты должны быть ей известны, то есть прочитаны и сохранены в памяти.
Можно сравнить с библиотекой: если вы не знаете, какие книги стоят на полках и никогда не заглядывали в них, то вероятность того, что вы быстро сориентируетесь и найдете нужную цитату, равна нулю.
Поисковая система узнает о содержимом сайтов с помощью специального робота — краулера, или паука . Название происходит от английского crawler (ползающее насекомое, ползунок). Робот обходит все страницы, переходит по ссылкам и постепенно охватывает миллиарды веб-страниц в сети, сохраняет их и отправляет на индексацию.
Индексация
Следующий этап — подробный анализ загруженных страниц и добавление информации о том, какие сведения в них содержатся, в базу поисковой системы (создание индекса).
Индексный робот разбивает каждую сохраненную страницу на части (заголовки, текст, ссылки, теги html и т.д), изучает их содержимое, переваривает и структурирует. В результате получается упорядоченный список адресов страниц и размещенной на них информации.
По аналогии с библиотекой недостаточно знать, какие книги есть на полках. Важно составить подробный и удобный каталог, который расскажет, в каких книгах и на каких страницах искать нужную информацию.
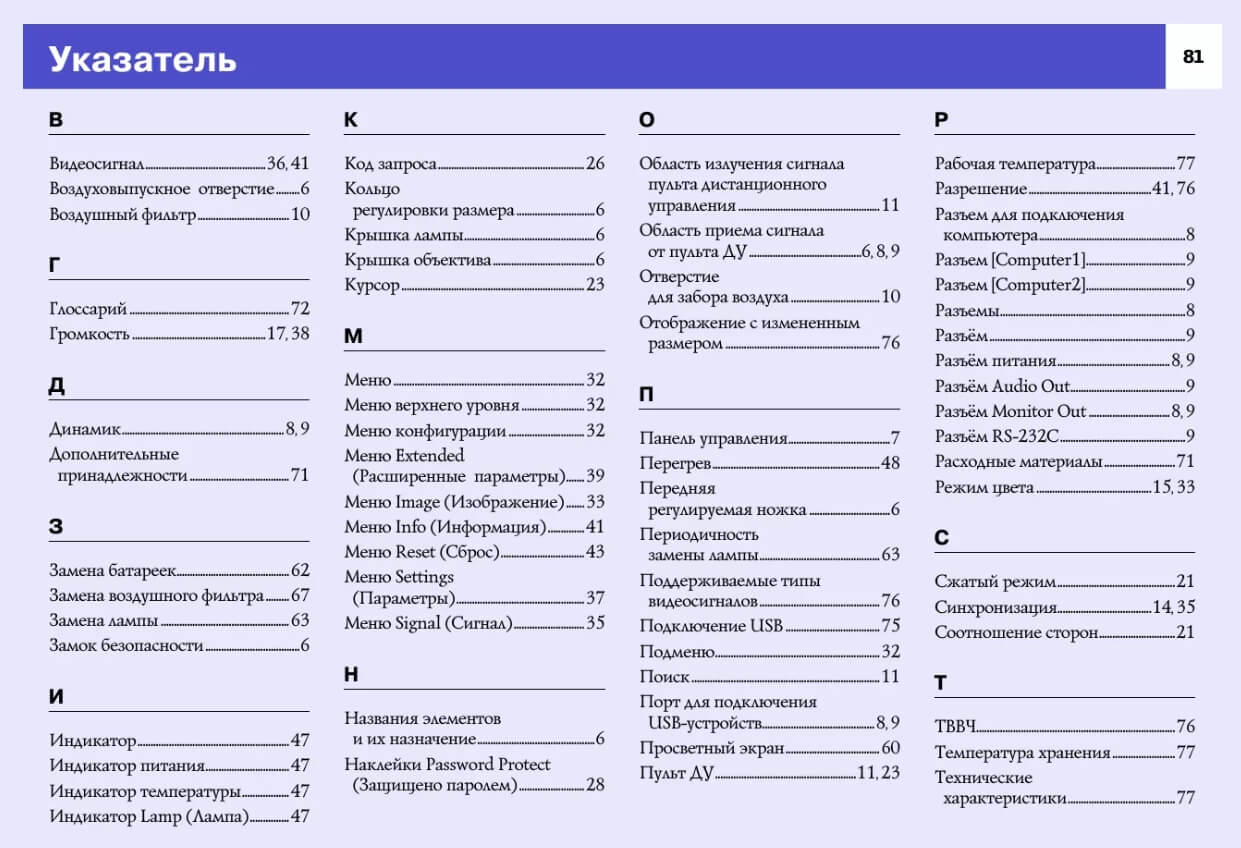
Другой пример — предметный указатель в справочниках, который помогает без труда найти ответ на нужный вопрос. Все термины здесь размещены по алфавиту с указанием страниц, на которых они встречаются
Пока страница не проиндексирована, для поисковика она не существует. Поэтому важно, чтобы сайт был открыт для индексации. При необходимости можно закрыть от поисковых роботов отдельные страницы, например личный кабинет и корзину, чтобы они не попали в выдачу.
Как ускорить индексацию страниц
Если страница открыта для индексации, то самая распространенная причина того, что она не появляется в выдаче — она новая, и поисковый робот просто не успел ее проиндексировать.
В зависимости от характеристик сайта и возможностей поисковых роботов обновление или апдейт страниц может занять от нескольких минут до нескольких недель.
Проверить индексирование страницы можно в « Яндекс.Вебмастере » раздел «Индексирование», а в Google Search Console «Проверка URL».
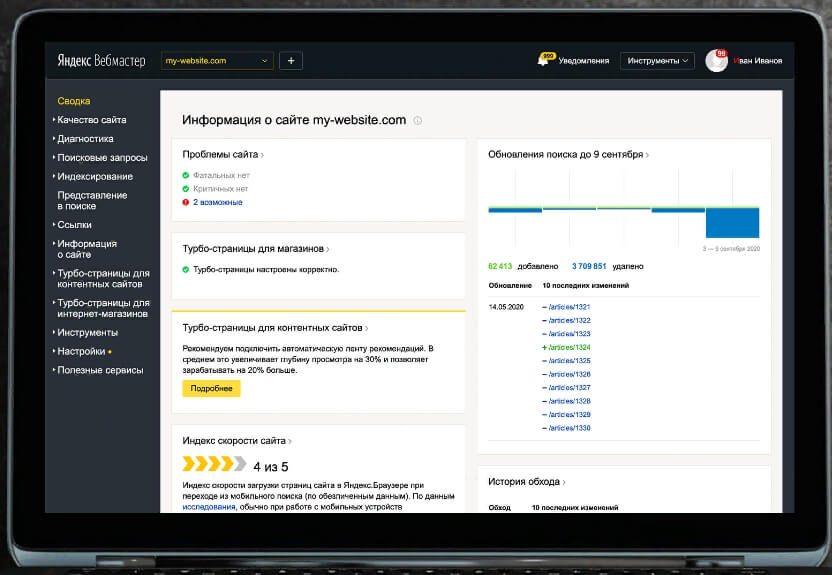
Яндекс.Вебмастер помогает понять, виден ли сайт в поисковой выдаче
Также в «Яндекс Вебмастере» можно направить страницы сайта на индексацию вручную с помощью функции «Переобход страниц», а в Google Search Console — сделать запрос индексирования.
Ранжирование и поисковая выдача
Когда человек вводит запрос в поисковую строку, поисковик выбирает все страницы, которые имеют отношение к запросу, прогоняет их через свои алгоритмы и выдает список сайтов в определенном порядке. При этом чем выше сайт оказался в выдаче, тем лучше он соответствует запросу пользователя и требованиям поисковика.
Процесс сортировки сайтов по определенному списку критериев называется ранжированием. На результаты ранжирования влияет релевантность контента запросу, качество и удобство сайта, его технические и пользовательские характеристики и многое другое. Точный список критериев поисковые системы держат в секрете и постоянно обновляют свои алгоритмы.
По итогам ранжирования можно получить разные результаты поисковой выдачи:
- в разных поисковиках, так как используются различные критерии фильтрации;
- в разных регионах, так как в запросах учитывается местонахождение пользователя;
- на разных устройствах — в десктопной и мобильной версии, так как имеет значение удобство использования сайта на разных устройствах;
- по одинаковым запросам у разных пользователей, так как учитывается индивидуальная история поиска.
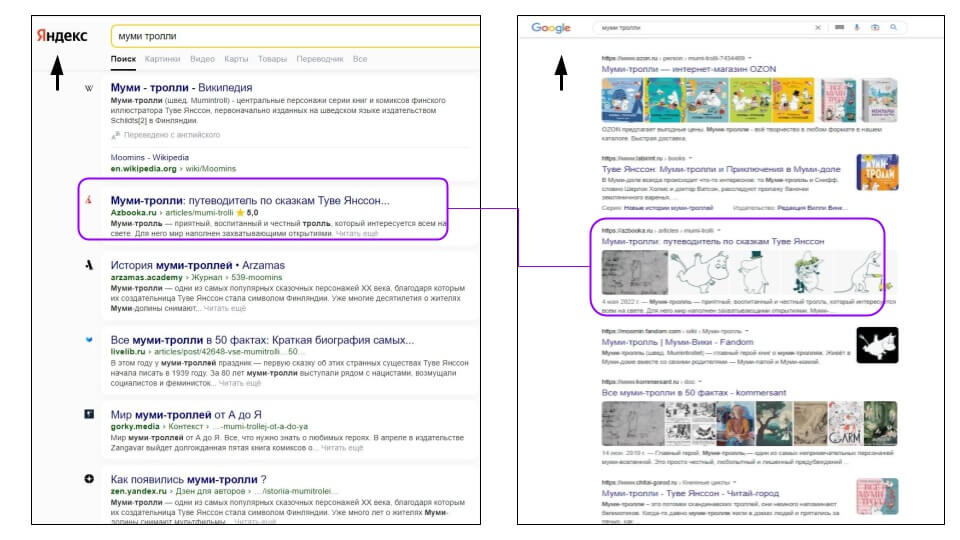
По запросу «Муми тролли» «Яндекс» и Google выдают разные результаты, на первой странице совпадает только один сайт из шести
Ранжирование позволяет пользователям быстрее получить нужную и достоверную информацию, а компаниям использовать поисковую выдачу для продвижения своего сайта.
Альтернативные поисковые системы
Большинству поисковых систем далеко до Яндекса и Гугла, и все же некоторые из них могут быть полезны в той или иной ситуации. Вот несколько примеров поисковиков, которые ориентируются на определенную нишу или предлагают больше конфиденциальности. Не только Яндекс и Google: 7 альтернативных поисковых систем
DuckDuckGo — поисковая система с открытым исходным кодом. Не собирает и не хранит данные о посетителях, а значит, обеспечивает максимальную конфиденциальность своим пользователям. Кроме того, Google и Яндекс стремятся персонализировать выдачу и учитывают предпочтения посетителя. В DuckDuckGo такого нет, поэтому поисковая выдача получается чуть более объективной. Например, через поисковик удобнее искать информацию на иностранном языке.
FindSounds — поисковик по звукам. Можно ввести текстовый запрос или загрузить образец. Запросы на русском не поддерживаются, но есть большой список русскоязычных тегов. Можно уточнить запрос, выбрав желаемый формат и качество звучания. Легко найти рев леопарда, жужжание осы, тикание часов и даже звук дыхания Дарта Вейдера. Все найденные звуки доступны для скачивания.
BoardReader — поиск по форумам, сервисам вопросов и ответов и другим сообществам. Специальные настройки помогут быстро найти посты и комментарии, которые соответствуют заданным критериям: языку, дате публикации и названию сайта.
JavaScript-ссылки и всё, что с ними связано
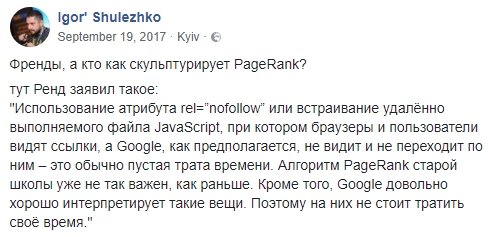
Передача ссылочного веса, индексация, краулинговый бюджет Автор: Максим Ковкрак, руководитель SEO-отдела ADINDEX — украинского агентства комплексного интернет-маркетинга Созданию статьи послужил пост Игоря Шулежко в своём фейсбуке. Он попросил своих “френдов” и “SEO-титанов” прокомментировать заявление Рэнда Фишкина о бесполезном скульптурировании PageRank (PR) старыми методами (rel=nofollow и JS). В комментариях много дискуссий и открытых вопросов, а значит, тема актуальна. В этой статье вы узнаете все нюансы при использовании JS для управления ссылочным весом и краулинговым бюджетом, риски и недостатки. Разберём вопросы распознавания JS гуглом, экономии краулингового бюджета, актуальности работ скульптурирования PR.
1. Сразу к сути: распознаёт ли Google JS-код?
- Редиректы JavaScript
Использовался метод — функция window.location. Было проведено два теста: тест А включал абсолютный URL, тест Б — относительный.
Результат:
- JavaScript-ссылки
Протестированы стандартные JavaScript-ссылки. Это наиболее распространенные типы ссылок, которые используются SEO-специалистами:
- Функции за пределами href AVP, но в рамках тега (“onClick”)
- Функции внутри href AVP (“javascript:window.location”)
- Функции за пределами тега a, но вызываемые в пределах href AVP (“javascript:openlink()”)
- и т. п.
Ссылки полностью краулились и отслеживались.
Проверялись две ситуации:
- Возможность поисковика сканировать динамический текст, если текст находится на HTML-странице. Что-то вроде кнопки “Читать полностью”, при нажатии на которую раскрывается остальная часть контента.
- Способность поисковика принимать во внимание динамический текст, если он расположен во внешнем JavaScript-файле.
Результат:
В обоих случаях текст краулился, индексировался и влиял на ранжирование страниц.
- Динамическая загрузка метаданных и элементов страницы
Динамически внедрили в DOM различные теги, важные для SEO:
- Элементы title
- Метаописания
- Метатеги robots
- Теги canonical
Результат:
Во всех случаях теги краулились — точно так же, как HTML-элементы в исходном коде.
Итого: Google давно научился распознавать JS-код как простой, так и сложный. Он не просто выполняет различные типы событий JavaScript, но и индексирует динамически генерируемый контент, читая DOM.
Другой вопрос, если запретить боту доступ к файлу *.js, в котором хранится исполняемый код и скрываемый контент, вдобавок закодированный стандартом Base64. Причём в html-коде вы также не увидите URL-адреса, будет что-то вроде этого:
В таком случае браузеры смогут исполнять код, а Google — нет.
Да, это рабочий метод, технология называется SEOhide, но вы же понимаете разницу между “распознаёт” и “закрытый доступ”?
2. Сокрытие ссылок
Зачем возникает необходимость скрытия ссылок от поисковых систем?
- Для управления PR (простыми словами ссылочным весом).
- Экономии краулингового бюджета.
2.1. Управление ссылочным весом
История начинается с создания поисковой системы Google, особенностью которой и являлся алгоритм PageRank. Идея заключалась в том, что страница считается тем “важнее”, чем больше на неё ссылается других страниц. При этом также учитывается “важность” ссылающихся страниц. Попросту говоря, ноу-хау заключалось в учёте внутренней и внешней ссылочной массы.
С тех пор алгоритм PageRank неоднократно подвергался изменениям, он улучшился и изменился во многих аспектах (например, учитывается тематичность ссылки, её расположение на странице), но основной принцип остаётся прежним.
Каждая страница сайта обладает определённым весом, который она с некой долей потери передаёт другим страницам через ссылки, расположенные на ней. Вес зависит от того, сколько страниц и с какой авторитетностью ссылаются на эту страницу (как внешние источники, так и внутренние страницы сайта).
Скульптурирование PR заключается в предотвращении передачи ссылочного веса бесполезным страницам сайта (или не приоритетным) и аккумулировании ссылочного веса на важных страницах.
Бесполезные — страницы не генерирующие трафик: корзина, контакты, «О нас», пользовательское соглашение и пр. Обычно ссылки на такие страницы расположены в шапке и подвале сайта, а значит собирают ссылочный вес с абсолютно всех страниц сайта.
Важные — это приоритетные страницы, находящиеся в продвижении.
1) Предотвращение передачи ссылочного веса
До 2009 г. скульптурирование ссылочного веса заключалось в использовании атрибута rel=»nofollow». Значение nofollow ставилось на уровне ссылки или страницы и запрещало поисковой системе сканировать и передавать PageRank.
Изначально Google ввёл этот атрибут для борьбы со спамом. Идея заключалась в предоставлении вебмастерам инструмента борьбы с ссылками, оставленными сеошниками с целью продвижения своих проектов. Nofollow делал бессмысленным такой откровенный вид линкбилдинга.
Когда Google понял, что все за счет nofollow просто перераспределяют PR внутри своего сайта, он обновил механизм работы тега. О новой логике работы атрибута рассказал Мэтт Каттс во время конференции SMX. Позднее на его блоге вышла статья “PageRank Sculpting”.
Теперь через ссылки nofollow ссылочный вес исчезает в никуда: он не остаётся на текущей странице и не передается странице акцептору.
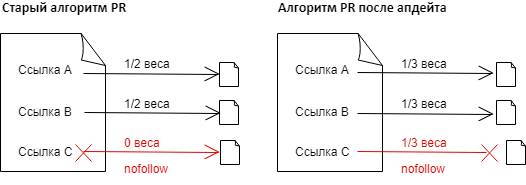
Итак, атрибут rel=»nofollow» не ограничивает передачу ссылочного веса, наоборот, нужно помнить, что через такие ссылки вы будете терять PR вашего сайта.
Как мы выяснили раньше, JS не скроет ссылки сайта от Google. Остаётся рабочий метод SEOHide. Но есть один минус, который ставит под сомнение использование данной технологии и о котором стоит упомянуть — возможные санкции со стороны Google.
В июле 2015 г. Google массово разослал вебмастерам сайтов в Search Console уведомление об ошибке: “Googlebot не может получить доступ к файлам CSS и JS на сайте” и предупреждение о возможной потере позиций в поисковой выдаче в случае, если проблема не будет устранена.
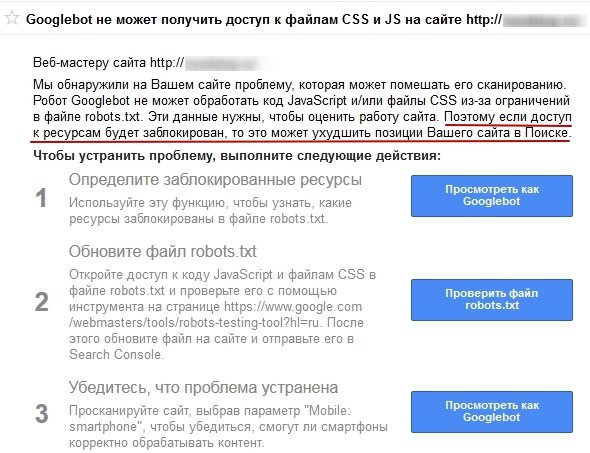
То есть, если для поисковой системы закрыт доступ к CSS и JS-файлам, есть вероятность понижения сайта в поисковой выдаче.
Принято считать, что это влияет на позиции в мобильной выдаче, проверить адаптивность сайта без анализа CSS и JS-файлов бот не сможет, а значит тест может быть не пройден. Если это так, то SEOhide не повлияет на прохождение теста Mobile Friendly и понижения не будет.
2) Передача ссылочного веса важным страницам сайта (перелинковка)
Для передачи ссылочного веса важным страницам используют различные варианты и методы перелинковки. Например, ссылки размещают в меню сайта, на фильтровой панели, на отдельных перелинковочных блоках. Логика заключается в том, чтобы накопленный ссылочный вес направить на приоритетные категории, находящиеся в продвижении.
В последнее время мы всё чаще встречаем упоминания о слабом влиянии внутренней перелинковки, всё чаще поднимается вопрос: “А стоит ли вообще заниматься скульптурированием ссылочного веса, стоит ли тратить на это время?”. В частности об этом говорит Рэнд Фишкин в статье “Как работать с внутренними ссылками сегодня: советы и практики”. Он утверждает, что классический формат скульптурирования, о котором мы говорили выше, редко эффективен, а если эффект и есть, то он небольшой:
“В настоящее время эффективность PR очень сильно уменьшилась. Тем не менее какой-то результат это приносит. В любом случае, наличие большого количества необоснованных ссылок на странице может оказать негативное влияние на ранжирование, в то время как небольшое число тщательно отобранных ссылок даёт положительный эффект. Однако в большинстве случаев оптимизация внутренних ссылок не добавляет большой ценности и не приносит значительных результатов.”
Здесь не говорится о влиянии внешних ссылок — они работают. Идёт речь об изменении эффективности алгоритма PR. В частности, об изменении влияния одной из составляющих алгоритма — внутреннего ссылочного веса. Внешние ссылки генерируют больше ценности для ранжирования и больше влияют на позиции, а вес внутренних практически не ощутим.
Высказывания Рэнда подтверждаются проведёнными тестами Дмитрия Шахова, с результатами которых он выступил на онлайн-конференции “WebPromoExperts SEO Day” 2018 года, представив доклад на тему: “Внутренняя перелинковка: мифы и реальность”. Были взяты коммерческие сайты, которые давно находятся в топе, со стабильной статистикой по позициям. Активных работ по проектам давно не проводилось.
- шершня (перелинковка уровнями)
- линковка с релевантных страниц
- линковка с рандомных страниц
- влияние кол-ва ссылок
В ходе экспериментов не удалось добиться значительного эффекта от точечной перелинковки. Результаты были настолько слабы, что передавить влияние внешних текстовых и ссылочных факторов не удаётся — эффект близок к нулю.
Единственный найденный вариант — подтолкнуть страницу очень большим количеством ссылок. Здесь важную роль оказывает уровень траста самого хоста. Влияние будет у сайтов, которые хорошо ранжируются в поиске.
Вывод: опять-таки, очень слабое влияние внутренней перелинковки. Эффекта можно добиться только большим количеством ссылок и только для трастового сайта.
Но так ли всё однозначно с вопросом перелинковки?
Было одно событие, из которого можно сделать вывод, что есть и другие факторы, влияющие на эффективность линковки.
На вопрос: “Если на странице размещено 3 ссылки: 2 dofollow и 1 nofollow, какой PR будет передаваться через каждую dofollow ссылку: 1/3 или 1/2?” Андрей Липатцев, старший специалист по качеству поиска Google, ответил, что ни 1/2, ни 1/3:
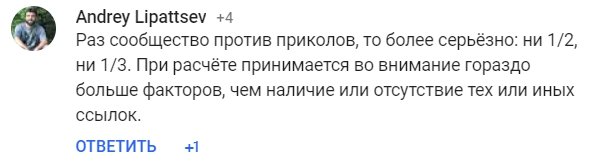
Какие это могут быть факторы? Точно неизвестно, но, скорее всего, речь идёт о “полезности и релевантности ссылки”. Все мы знаем, что на работу бэклинков влияет месторасположение ссылки на странице, переходят ли по ней пользователи, релевантна ли она содержанию — всё это работает и для внутренних ссылок сайта и их эффективности.
Вот и получается, как говорил Рэнд, что в одних случаях есть небольшой эффект от внутренней перелинковки, а в других нет. Скорее всего, всё зависит от вида реализации.
Управление ссылочным весом: общий итог
Здесь будьте очень осторожны, ниже описано заключение, к которому пришёл автор статьи, и оно может не совпадать с вашим. Это нормально, это же SEO и у нас всегда так. Если считаете по-другому, напишите свои рассуждения в комментариях к статье.
Со дня своего появления алгоритм PageRank значительно изменился и усложнился. Одна из его составляющих — внутренний ссылочный вес, утратила своё былое влияние.
Обновление алгоритма требует и изменения подхода в скульптурировании ссылочного веса.
Стоит ли скрывать ссылки?
Раз влияние внутреннего веса незначительно, зачем использовать сложную технологию SEOhide для закрытия дырок перетекания ссылочного веса, реализация которой стоит денег? Скорее всего, это будет нерентабельно, учитывая то, что алгоритм передачи ссылочного веса не работает по схеме “делим поровну между всеми ссылками на странице”.
Мы не рекомендуем использовать технологию SEOhide и подобные для экономии PR-веса. Атрибут nofollow вообще будет красть ссылочный вес вашего сайта.
Что делать с перелинковкой?
Перелинковочные блоки внизу страницы сайта неэффективны, старайтесь все элементы перелинковки сделать частью пользовательского функционала, чтобы они были полезны и приносили дополнительную ценность. Тогда использование этой ссылки пользователями, если хотите — её важность, будет дополнительным сигналом влияния для страницы акцептора.
Классическую перелинковку можно использовать для максимизации индексирования.
2.2. Экономия краулингового бюджета с помощью JS
Логика какая — нет ссылки на странице, значит бот не тратит время на её индексацию.
Желание использовать JS возникает у вебмастеров, например, для того, чтобы скрыть ссылки на панели фильтрации.
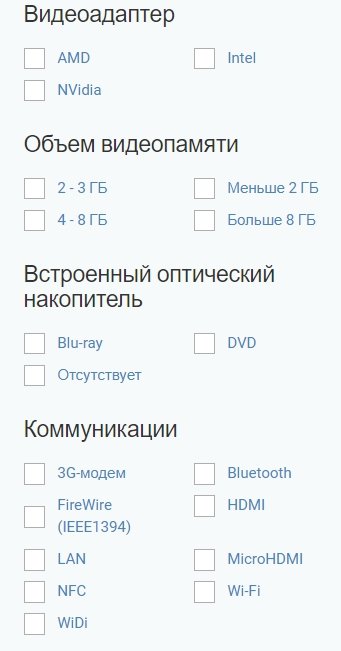
Зачастую их очень много и большая часть из них закрыта от индексации. “Убрав” лишние ссылки со страницы, бот должен пойти по страницам пагинации, товарам, ссылкам на подкатегории.
Если для скрытия использовать JS, который, как мы уже выяснили, с лёгкостью распознается гуглом, мы только усугубим ситуацию и увеличим расход краулингового бюджета.
Почему увеличим? Ответ на этот вопрос полностью раскрыт в статье Барри Адамса “JavaScript и SEO: разница между сканированием и индексированием”.
Вся суть заключается в тесной работе двух парней гугла: краулера — Googlebot и индексатора — Caffeine.
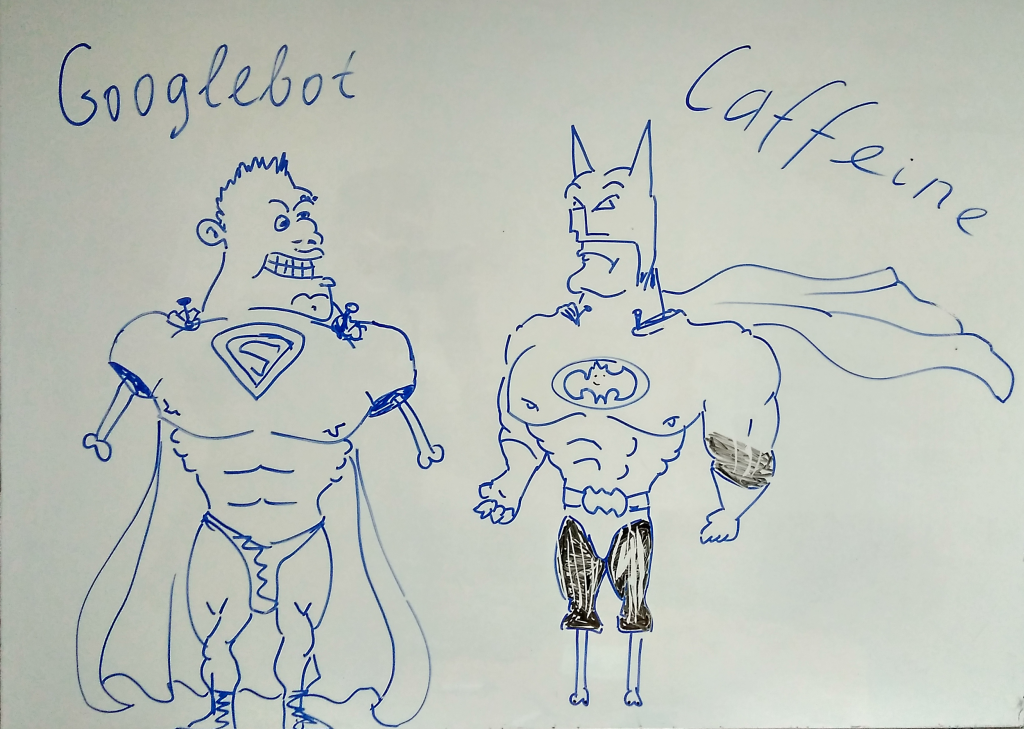
Googlebot. Его задача — ходить по страницам сайта, находить все URL-адреса и сканировать их. У него также есть модуль парсинга, который смотрит на исходный код HTML и извлекает любые найденные ссылки. Парсер не рендерит страницы, он просто анализирует исходный код и извлекает любые URL-адреса, найденные в фрагментах.
Когда googlebot видит новые или изменённые URL-адреса, он отправляет их второму парню.
Caffeine — парень, который сидит на месте и пытается понять полученные URL-адреса от краулера, анализируя их контент и релевантность. Он отвечает за рендеринг веб-страниц и выполнение JS кода.
В опубликованной документации Google для разработчиков объясняется, как работает их служба веб-рендеринга WRS.
Именно WRS в Caffeine выполняет JavaScript. Функция “Получить и отобразить” в Search Console позволяет посмотреть, как WRS Google видит вашу страницу.
Теперь мы выяснили, что за ширмой механизма “сканирования страниц сайта” спрятан сложный процесс взаимодействия двух систем: сканирования и индексирования.
На сайте, где большое количество ссылок не является частью исходного HTML-кода, при первом посещении краулер находит только ограниченный набор URL. Потом ему нужно подождать, пока индексатор обработает эти страницы и извлечёт новые URL, которые краулер затем просканирует и отправит индексатору. И так раз за разом.
Не исключена ситуация, когда Google будет тратить много времени на сканирование и рендеринг ненужных страниц и очень мало времени на обработку важных.
А что с SEOHide, о котором было сказано выше?
Да он будет работать, но есть куда более простой и рекомендованный способ от гугла.
В официальной справке указано:
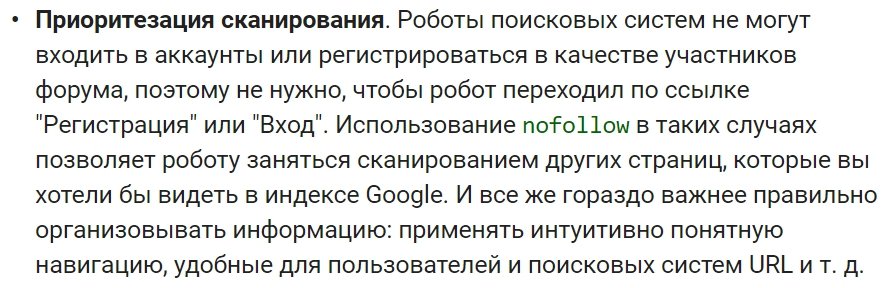
Проще говоря, если вы хотите сэкономить краулинговый бюджет для более важных страниц, для управления приоритетом сканирования, на все второстепенные ссылки нужно добавить атрибут nofollow.
Есть один минус у этого варианта, в таком исполнении у нас получается конфликт интересов между скульптурированием PR и экономией краулингового бюджета. Если вы всё же хотите управлять ссылочным весом, помните, что через такие ссылки будет “исчезать” PR.
Вам решать, что важнее — действуйте по ситуации. Если у вас проблемы с индексацией сайта — ставьте nofollow, не давайте роботу обращать внимание на эти “бесполезные страницы”. Если не хотите терять PR, лучше просто оставить ссылки открытыми.
Если рассматривать наш пример со ссылками на страницы фильтров, которые не нужны в поисковой выдаче, то можно использовать еще два способа:
1) Закрыть такие страницы в robots.txt
Если у вас страница закрыта только тегом meta name=»robots» content=»noindex, follow» вы не будете экономить краулинговый бюджет. Данным тегом пользуется индексатор, а не краулер, поэтому страница будет просканирована и обработана, но в индекс не добавлена.
Нужно использовать оба метода — robots.txt заблокирует доступ краулеру.
2) Настроить в Search Console запрет на сканирование по параметрам URL
Общие выводы
- JavaScript распознаётся гуглом. Но если исполняемый код закодировать и спрятать в файле, а файл закрыть от доступа в robots.txt — получим метод скрывающий любой контент (SEOhide).
- Использование JS для скрытия ссылок только усугубит ситуацию. Во-первых, ссылки видно; во-вторых, тратится больше краулингового бюджета.
- Использование nofollow с целью управления ссылочным весом даст противоположный результат желаемому — через такие ссылки ссылочный вес будет утекать в никуда.
- SEOhide — затратный по бюджету метод с сомнительным эффектом.
- Сколько передастся PR по ссылке зависит не только от количества линков на странице и параметра nofollow. Месторасположение, использование, “важность” ссылки также влияют на данный фактор.
- Перелинковку с целью передачи PR нужно делать частью пользовательского функционала сайта, тогда можно получить результат. Перелинковка внизу страницы сайта — только с целью максимизации индексирования.
- Если смотреть на SEOhide в качестве экономии краулингового бюджета — то вариант рабочий, но есть методы и попроще.
- Экономить краулинговый бюджет без скрытия ссылок можно. Максимально эффективный способ — использовать атрибут nofollow на уровне ссылок. Для страниц, ненужных в индексе, есть ещё два варианта: закрыть в robots.txt или в настройках вебмастера. Минус всех методов — теряем PR.
- Индексирование сайта — это взаимодействие двух систем краулера и индексатора, каждый из которых руководствуется своими правилами. Краулер — файлом robots.txt, параметром ссылок nofollow, настройками в Search Console и др. Индексатор — тегом meta name=»robots» content=»».
Кейс: как увеличить органический трафик на треть с помощью on-page SEO
В статье автор рассказал о о двух решениях, которые помогли увеличить трафик крупного онлайн-форума и возобновить его рост