Руководство по SQL. Индексы.
Индексы – это специальные таблицы, которые могут быть использованы поисковым двигателем базы данных (далее – БД), для ускорения получения данных. Необходимо просто добавить указатель индекса в таблицу. Индекс в БД крайне схож с индексом в конце книги.
Допустим, мы хотим иметь ссылку на все страницы книги, которые касаются определённой темы (например, Наследование в книге по программированию на языке Java). Для этого, мы в первую очередь ссылаемся на индекс, который указан в конце книге и переходим на любую из страниц, которая относится к необходимой теме.
Индекс помогает ускорить запросы на получение данных (SELECT [WHERE]), но замедляет процесс добавления и изменения записей (INSERT, UPDATE). Индексы могут быть добавлены или удалены без влияния на сами данные.
Для того, чтобы добавить индекс, нам необходимо использовать команду CREATE INDEX, что позволит нам указать имя индекса и определить таблицу и колонку или индекс колонки и определить используется ли индекс по возрастанию или по убыванию.
Индекса также могут быть уникальными, так же как и констрейнт UNIQUE. В этом случае индекс предотвращает добавление повторяющихся данных в колонку или комбинацию колонок, на которые указывает индекс.
Команда добавления индекса имеет следующий вид:
CREATE INDEX имя_индекса ON имя_таблицы;
Индекс может относиться, как к одной колонке:
CREATE INDEX имя_индекса ON имя_таблицы (имя_колонки);
Так и к нескольким:
CREATE INDEX имя_индекса ON имя_таблицы (колонка1, колонка2);
Выбор типа индекса (одноколоночный или многоколоночный) зависит от того, что именно мы чаще всего будем использовать в нашем условном операторе WHERE.
Для того, чтобы удалить индекс, мы должны использовать следующую команду:
DROP INDEX имя_индекса;
Дополнительно вы можете ознакомиться с индексом, прочитав статью, посвящённую констрейнту INDEX.
Индексы используются для увеличения производительности БД, но есть случаи, когда нам стоит избегать их использования:
- Не стоит использовать индексы для небольших таблиц.
- Не стоит использовать индексы для таблиц, в которых, как предполагается, будут часто добавляться новые данные, либо эти данные будут изменяться.
- Не стоит использовать индекс для колонок, с которыми будут производиться частые манипуляции.
- Не стоит использовать индексы для колонок, которые имеют много значений NULL.
На этом мы заканчиваем изучение индексов.
В следующей статье мы рассмотрим способ изменения структуры таблицы.
ИНДЕКС (функция ИНДЕКС)
Excel для Microsoft 365 Excel для Microsoft 365 для Mac Excel для Интернета Excel 2021 Excel 2021 для Mac Excel 2019 Excel 2019 для Mac Excel 2016 Excel 2016 для Mac Excel 2013 Excel 2010 Excel 2007 Excel для Mac 2011 Excel Starter 2010 Еще. Меньше
Функция ИНДЕКС возвращает значение или ссылку на значение из таблицы или диапазона.

Функцию ИНДЕКС можно использовать двумя способами:
- Если вы хотите возвращать значение указанной ячейки или массива ячеек, см. раздел Форма массива.
- Если требуется возвращать ссылку на указанные ячейки, см. раздел Ссылочная форма.
Форма массива
Описание
Возвращает значение элемента в таблице или массиве, выбранное по индексам номеров строк и столбцов.
Если первый аргумент функции ИНДЕКС является константной массива, используйте форму массива.
Синтаксис
ИНДЕКС(массив; номер_строки; [номер_столбца])
Форма массива функции INDEX имеет следующие аргументы:
- массив. Обязательный аргумент. Диапазон ячеек или константа массива.
- Если массив содержит только одну строку или столбец, соответствующий аргумент номер_строки или номер_столбца является необязательным.
- Если массив содержит более одной строки и более одного столбца и используется только номер_строки или номер_столбца, ИНДЕКС возвращает массив всей строки или столбца в массиве.
Замечания
- Если используются аргументы номер_строки и номер_столбца, функция ИНДЕКС возвращает значение в ячейке на пересечении номеров_строки и номера_столбца.
- row_num и column_num должны указывать на ячейку в массиве; в противном случае ИНДЕКС возвращает #ССЫЛКА! ошибку «#ЗНАЧ!».
- Если задать для row_num или column_num значение 0 (ноль), ИНДЕКС возвращает массив значений для всего столбца или строки соответственно. Чтобы использовать значения, возвращаемые в виде массива, введите функцию ИНДЕКС как формулу массива.
Примечание: Если у вас есть текущая версия Microsoft 365, вы можете ввести формулу в верхнюю левую ячейку выходного диапазона, а затем нажать клавишу ВВОД, чтобы подтвердить формулу как формулу динамического массива. В противном случае формулу необходимо ввести как устаревшую формулу массива, сначала выбрав выходной диапазон, введите формулу в верхнюю левую ячейку выходного диапазона, а затем нажмите CTRL+SHIFT+ENTER для подтверждения. Excel автоматически вставляет фигурные скобки в начале и конце формулы. Дополнительные сведения о формулах массива см. в статье Использование формул массива: рекомендации и примеры.
Примеры
Пример 1
В этих примерах функция ИНДЕКС используется для поиска значения ячейки, находящейся на пересечении заданных строки и столбца.
Скопируйте образец данных из следующей таблицы и вставьте их в ячейку A1 нового листа Excel. Чтобы отобразить результаты формул, выделите их и нажмите клавишу F2, а затем — ВВОД.
14 вопросов об индексах в SQL Server, которые вы стеснялись задать
Индексы — это первое, что необходимо хорошо понимать в работе SQL Server, но странным образом базовые вопросы не слишком часто задаются на форумах и получают не так уж много ответов.
Роб Шелдон отвечает на эти, вызывающие смущение в профессиональных кругах, вопросы об индексах в SQL Server: одни из них мы просто стесняемся задать, а прежде чем задать другие сначала подумаем дважды.От переводчика
- SQL Server Index Basics от 25 ноября 2008 года (заметка даёт понимание основных терминов)
- 14 SQL Server Indexing Questions You Were Too Shy To Ask от 25 марта 2014 года (собственно, ради неё всё и затевалось)
Используемая терминология в русском переводе
index индекс heap куча table таблица view представление B-tree сбалансированное дерево clustered index кластеризованный индекс nonclustered index некластеризованный индекс composite index составной индекс covering index покрывающий индекс primary key constraint ограничение на первичный ключ unique constraint ограничение на уникальность значений query запрос query engine подсистема запросов database база данных database engine подсистема хранения данных fill factor коэффициент заполнения индекса surrogate primary key суррогатный первичный ключ query optimizer оптимизатор запросов index selectivity избирательность индекса filtered index фильтруемый индекс execution plan план выполнения Основы индексов в SQL Server
Одним из важнейших путей достижения высокой производительности SQL Server является использование индексов. Индекс ускоряет процесс запроса, предоставляя быстрый доступ к строкам данных в таблице, аналогично тому, как указатель в книге помогает вам быстро найти необходимую информацию. В этой статье я приведу краткий обзор индексов в SQL Server и объясню как они организованы в базе данных и как они помогают ускорению выполнения запросов к базе данных.
Структура индекса
Индексы создаются для столбцов таблиц и представлений. Индексы предоставляют путь для быстрого поиска данных на основе значений в этих столбцах. Например, если вы создадите индекс по первичному ключу, а затем будете искать строку с данными, используя значения первичного ключа, то SQL Server сначала найдет значение индекса, а затем использует индекс для быстрого нахождения всей строки с данными. Без индекса будет выполнен полный просмотр (сканирование) всех строк таблицы, что может оказать значительное влияние на производительность.
Вы можете создать индекс на большинстве столбцов таблицы или представления. Исключением, преимущественно, являются столбцы с типами данных для хранения больших объектов (LOB), таких как image, text или varchar(max). Вы также можете создать индексы на столбцах, предназначенных для хранения данных в формате XML, но эти индексы устроены немного иначе, чем стандартные и их рассмотрение выходит за рамки данной статьи. Также в статье не рассматриваются columnstore индексы. Вместо этого я фокусируюсь на тех индексах, которые наиболее часто применяются в базах данных SQL Server.
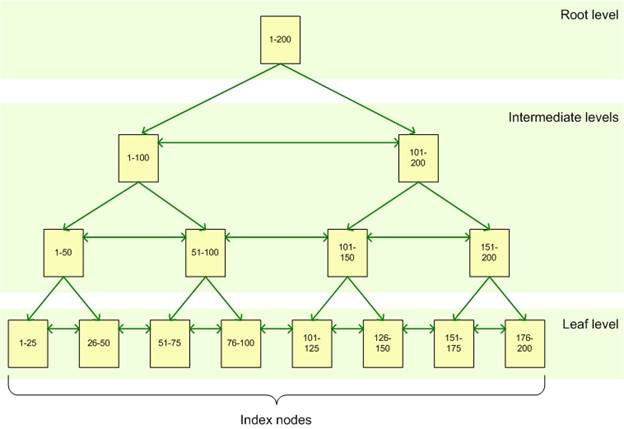
Индекс состоит из набора страниц, узлов индекса, которые организованы в виде древовидной структуры — сбалансированного дерева. Эта структура является иерархической по своей природе и начинается с корневого узла на вершине иерархии и конечных узлов, листьев, в нижней части, как показано на рисунке:Когда вы формируете запрос на индексированный столбец, подсистема запросов начинает идти сверху от корневого узла и постепенно двигается вниз через промежуточные узлы, при этом каждый слой промежуточного уровня содержит более детальную информацию о данных. Подсистема запросов продолжает двигаться по узлам индекса до тех пор, пока не достигнет нижнего уровня с листьями индекса. К примеру, если вы ищете значение 123 в индексированном столбе, то подсистема запросов сначала на корневом уровне определит страницу на первом промежуточном (intermediate) уровне. В данном случае первой страница указывает на значение от 1 до 100, а вторая от 101 до 200, таким образом подсистема запросов обратится ко второй странице этого промежуточного уровня. Далее будет выяснено, что следует обратиться к третьей странице следующего промежуточного уровня. Отсюда подсистема запросов прочитает на нижнем уровне значение самого индекса. Листья индекса могут содержать как сами данные таблицы, так и просто указатель на строки с данными в таблице, в зависимости от типа индекса: кластеризованный индекс или некластеризованный.
Кластеризованный индекс
Кластеризованный индекс хранит реальные строки данных в листьях индекса. Возвращаясь к предыдущему примеру, это означает что строка данных, связанная со значение ключа, равного 123 будет храниться в самом индексе. Важной характеристикой кластеризованного индекса является то, что все значения отсортированы в определенном порядке либо возрастания, либо убывания. Таким образом, таблица или представление может иметь только один кластеризованный индекс. В дополнение следует отметить, что данные в таблице хранятся в отсортированном виде только в случае если создан кластеризованный индекс у этой таблицы.
Таблица не имеющая кластеризованного индекса называется кучей.Некластеризованный индекс
В отличие от кластеризованного индекса, листья некластеризованного индекса содержат только те столбцы (ключевые), по которым определен данный индекс, а также содержит указатель на строки с реальными данными в таблице. Это означает, что системе подзапросов необходима дополнительная операция для обнаружения и получения требуемых данных. Содержание указателя на данные зависит от способа хранения данных: кластеризованная таблица или куча. Если указатель ссылается на кластеризованную таблицу, то он ведет к кластеризованному индексу, используя который можно найти реальные данные. Если указатель ссылается на кучу, то он ведет к конкретному идентификатору строки с данными. Некластеризованные индексы не могут быть отсортированы в отличие от кластеризованных, однако вы можете создать более одного некластеризованного индекса на таблице или представлении, вплоть до 999. Это не означает, что вы должны создавать как можно больше индексов. Индексы могут как улучшить, так и ухудшить производительность системы. В дополнение к возможности создать несколько некластеризованных индексов, вы можете также включить дополнительные столбцы (included column) в свой индекс: на листьях индекса будет храниться не только значение самих индексированных столбцов, но и значения этих не индексированных дополнительных столбцов. Этот подход позволит вам обойти некоторые ограничения, наложенные на индекс. К примеру, вы можете включить неидексируемый столбец или обойти ограничение на длину индекса (900 байт в большинстве случаев).
Типы индексов
В дополнение к тому, что индекс может быть либо кластеризованным, либо некластеризованным, возможно его дополнительно сконфигурировать как составной индекс, уникальный индекс или покрывающий индекс.
Составной индекс
Такой индекс может содержать более одного столбца. Вы можете включить до 16 столбцов в индекс, но их общая длина ограничена 900 байтами. Как кластеризованный, так и некластеризованный индексы могут быть составными.
Уникальный индекс
- Первичный ключ
Когда вы определяете ограничение первичного ключа на один или несколько столбцов, тогда SQL Server автоматически создаёт уникальный кластеризованный индекс, если кластеризованный индекс не был создан ранее (в этом случае создается уникальный некластеризованный индекс по первичному ключу) - Уникальность значений
Когда вы определяете ограничение на уникальность значений, тогда SQL Server автоматически создает уникальный некластеризованный индекс. Вы можете указать, чтобы был создан уникальный кластеризованный индекс, если кластеризованного индекса до сих пор не было создано на таблице
Покрывающий индекс
Такой индекс позволяет конкретному запросу сразу получить все необходимые данные с листьев индекса без дополнительных обращений к записям самой таблицы.
Проектирование индексов
Насколько полезны индексы могут быть, настолько аккуратно они должны быть спроектированы. Поскольку индексы могут занимать значительное дисковое пространство, вы не захотите создавать индексов больше, чем необходимо. В дополнение, индексы автоматически обновляются когда сама строка с данными обновляется, что может привести к дополнительным накладным расходам ресурсов и падению производительности. При проектирование индексов должно приниматься во внимание несколько соображений относительно базы данных и запросов к ней.
База данных
- Для таблиц которые часто обновляются используйте как можно меньше индексов.
- Если таблица содержит большое количество данных, но их изменения незначительны, тогда используйте столько индексов, сколько необходимо для улучшение производительности ваших запросов. Однако хорошо подумайте перед использованием индексов на небольших таблицах, т.к. возможно использование поиска по индексу может занять больше времени, нежели простое сканирование всех строк.
- Для кластеризованных индексов старайтесь использовать настолько короткие поля насколько это возможно. Наилучшим образом будет применение кластеризованного индекса на столбцах с уникальными значениями и не позволяющими использовать NULL. Вот почему первичный ключ часто используется как кластеризованный индекс.
- Уникальность значений в столбце влияет на производительность индекса. В общем случае, чем больше у вас дубликатов в столбце, тем хуже работает индекс. С другой стороны, чем больше уникальных значения, тем выше работоспособность индекса. Когда возможно используйте уникальный индекс.
- Для составного индекса возьмите во внимание порядок столбцов в индексе. Столбцы, которые используются в выражениях WHERE (к примеру, WHERE FirstName = ‘Charlie’) должны быть в индексе первыми. Последующие столбцы должны быть перечислены с учетом уникальности их значений (столбцы с самым высоким количеством уникальных значений идут первыми).
- Также можно указать индекс на вычисляемых столбцах, если они соответствуют некоторым требованиям. К примеру, выражение которые используются для получения значения столбца, должны быть детерминистическими (всегда возвращать один и тот же результат для заданного набора входных параметров).
Запросы к базе данных
- Старайтесь вставлять или модифицировать в одном запросе как можно больше строк, а не делать это в несколько одиночных запросов.
- Создайте некластеризованный индекс на столбцах которые часто используются в ваших запросах в качестве условий поиска в WHERE и соединения в JOIN.
- Рассмотрите возможность индексирования столбцов, использующихся в запросах поиска строк на точное соответствие значений.
А теперь, собственно:
14 вопросов об индексах в SQL Server, которые вы стеснялись задать
Почему таблица не может иметь два кластеризованных индекса?
Хотите короткий ответ? Кластеризованный индекс – это и есть таблица. Когда вы создаете кластеризованный индекс у таблицы, подсистема хранения данных сортирует все строки в таблице в порядке возрастания или убывания, согласно определению индекса. Кластеризованный индекс это не отдельная сущность как другие индексы, а механизм сортировки данных в таблице и облегчения быстрого доступа к строкам с данными.
Представим, что у вас есть таблица, содержащая историю операций по продажам. Таблица Sales включает в себя такую информация как идентификатор заказа, позицию товара в заказе, номер товара, количество товара, номер и дату заказа и т.д. Вы создаёте кластеризованный индекс по столбцам OrderID и LineID, с сортировкой в порядке возрастания, как показано в следующем T-SQL коде:CREATE UNIQUE CLUSTERED INDEX ix_oriderid_lineid ON dbo.Sales(OrderID, LineID);Когда вы запустите этот скрипт все строки в таблице будут физически отсортированы сначала по столбцу OrderID, а затем по LineID, но сами данные останутся в единственном логическом блоке, в таблице. По этой причине вы не можете создать два кластеризованных индекса. Может быть только одна таблица с одними данными и эта таблица может быть отсортирована только один раз в определенном порядке.
Если кластеризованная таблица даёт множество преимуществ, то зачем использовать кучу?
Вы правы. Кластеризованые таблицы отличны и большинство ваших запросов будут лучше выполнятся к таблицам, имеющим кластеризованный индекс. Но в некоторых случаях вы возможно захотите оставить таблицы в их естественном первозданном состоянии, т.е. в виде кучи, и создать лишь некластеризованные индексы для поддержания работоспособности ваших запросов.
Куча, как вы помните, хранит данные в случайном порядке. Обычно подсистема хранения данных добавляет в таблицу данные в той последовательности в которой они вставляются, однако подсистема также любит перемещать строки с целью более эффективного хранения. В результате у вас нет ни единого шанса предсказать в каком порядке будут храниться данные.
Если подсистема запросов должна найти данные без преимуществ некластеризованного индекса, то она сделает полное сканирование таблицы для нахождения нужных ей строк. На очень маленьких таблицах это обычно не проблема, но как только куча растет в своих размерах производительность быстро падает. Конечно, некластеризованный индекс может помочь, используя указатель на файл, страницу и строку где хранятся необходимые данные – обычно это намного лучшая альтернатива сканированию таблицы. Но даже в этом случае трудно сравнивать с преимуществами кластеризованного индекса при рассмотрении производительности запросов.
Однако куча может помочь улучшить производительность в определенных ситуациях. Рассмотрим таблицу с большим количеством вставок, но редкими обновлениями или удалением данных. К примеру, таблица, хранящая лог, преимущественно используется для вставки значений до тех пор пока не будет архивирована. В куче вы не увидите разбиением страниц и фрагментацию данных, как это случается с кластеризованным индексом, потому что строки просто добавляются в конец кучи. Слишком большое разделение страниц может иметь значительное влияние на производительность и в не самом хорошем смысле. В общем, куча позволяет производить вставку данных относительно безболезненно и вам не надо будет бороться с накладными расходами на хранение и обслуживание, как это бывает в случае кластеризованного индекса.
Но отсутствие обновления и удаления данных не должны рассматриваться как единственная причина. Способ выборки данных также является важным фактором. К примеру, вы не должны использовать кучу, если часто выполняете запросы диапазонов данных или запрашиваемые данные часто должны быть сортированы или сгруппированы.
Всё это означает, что вы должны рассматривать возможность использования кучи только когда работаете с особо-маленькими таблицами или всё ваше взаимодействие с таблицей ограничено вставкой данных и ваши запросы чрезвычайно просты (и вы все-равно используете некластеризованные индексы). В противном случае держитесь хорошо спроектированного кластеризованного индекса, к примеру определенного на простом возрастающем ключевом поле, как широко применяемый столбец с IDENTITY.Как изменить установленное по умолчанию значение коэффициента заполнения индекса?
Изменение установленного по умолчанию коэффициента заполнения индекса это одно дело. Понимание того как установленный по умолчанию коэффициент работает это другое. Но сначала пару шагов назад. Коэффициент заполнения индекса определяет количество пространства на странице для хранения индекса на нижнем уровне (уровень листьев) перед тем как начать заполнять новую страницу. К примеру, если коэффициент выставлен в значение 90, то при росте индекс займет на странице 90%, а затем перейдет на следующую страницу.
По умолчанию, значение коэффициента заполнения индекса в SQL Server равно 0, что равнозначно значению 100. В результате все новые индексы автоматически наследуют эту настройки, если вы специально в коде не укажете отличное от стандартного для системы значения или измените поведение по умолчанию. Вы можете воспользоваться SQL Server Management Studio для корректировки установленного по умолчанию значения или запустить системную сохраненную процедуру sp_configure. К примеру, следующий набор T-SQL команд устанавливает значение коэффициента равное 90 (предварительно необходимо переключится в режим продвинутых настроек):EXEC sp_configure 'show advanced options', 1; GO RECONFIGURE; GO EXEC sp_configure 'fill factor', 90; GO RECONFIGURE; GOПосле изменения значения коэффициента заполнения индекса необходимо перезагрузить сервис SQL Server. Теперь вы можете проверить установленное значение, запустив процедуру sp_configure без указанного второго аргумента:
EXEC sp_configure 'fill factor' GOДанная команда должна вернуть значение равное 90. В результате все вновь создаваемые индексы будут использовать это значение. Вы можете проверить это, создав индекс и запросить значение коэффициента заполнения:
USE AdventureWorks2012; -- ваша база данных GO CREATE NONCLUSTERED INDEX ix_people_lastname ON Person.Person(LastName); GO SELECT fill_factor FROM sys.indexes WHERE object_id = object_id('Person.Person') AND name='ix_people_lastname';В данном примере мы создали некластеризованный индекс в таблице Person в базе данных AdventureWorks2012. После создания индекса мы можем получить значение коэффициента заполнения из системной таблиц sys.indexes. Запрос должен вернуть 90.
Однако, представим, что мы удалили индекс и снова создали его, но теперь указали конкретное значение коэффициента заполнения:CREATE NONCLUSTERED INDEX ix_people_lastname ON Person.Person(LastName) WITH (fillfactor=80); GO SELECT fill_factor FROM sys.indexes WHERE object_id = object_id('Person.Person') AND name='ix_people_lastname';В этот раз мы добавили инструкцию WITH и опцию fillfactor для нашей операции создания индекса CREATE INDEX и указали значение 80. Оператор SELECT теперь возвращает соответствующее значение.
До сих пор всё было довольно-таки прямолинейно. Где вы реально можете погореть во всём этом процессе, так это когда вы создаёте индекс, использующий значение коэффициента по умолчанию, подразумевая, что вы знаете это значение. К примеру, кто-то неумело ковыряется в настройках сервера и он настолько упорот, что ставит значение коэффициента заполнения индекса равное 20. Тем временем вы продолжаете создавать индексы, предполагая значение по умолчанию равное 0. К сожалению, у вас нет способа узнать значение коэффициента до тех пор как вы не создадите индекс, а затем проверите значение, как мы делали в наших примерах. В противном случае, вам придётся ждать момента когда производительность запросов настолько упадёт, что вы начнёте что-то подозревать.
Другая проблема о которой вам стоит помнить это перестроение индексов. Как и при создании индекса вы можете конкретизировать значение коэффициента заполнения индекса, когда его перестраиваете. Однако, в отличие от команды создания индекса, перестройка не использует серверные настройки по умолчанию, несмотря на то что так может показаться. Даже больше, если вы конкретно не укажете значение коэффициента заполнения индекса, то SQL Server будет использовать то значение коэффициента, с которым этот индекс существовал до его перестройки. К примеру, следующая операция ALTER INDEX перестраивает только что созданный нами индекс:ALTER INDEX ix_people_lastname ON Person.Person REBUILD; GO SELECT fill_factor FROM sys.indexes WHERE object_id = object_id('Person.Person') AND name='ix_people_lastname';Когда мы проверим значение коэффициента заполнения мы получим значение равное 80, потому что именно его мы указали при последнем создании индекса. Значение по умолчанию не учитывается.
Как вы видите изменить значение коэффициента заполнения индекса не такое уж сложно дело. Намного сложнее знать текущее значение и понимать когда оно применяется. Если вы всегда конкретно указывается коэффициент при создании и перестройки индексов, то вы всегда знаете конкретный результат. Разве что вам приходится заботиться о том, чтобы кто-то другой снова не напортачил в настройках сервера, вызвав перестройку всех индексов со смехотворно низким значением коэффициента заполнения индекса.Можно ли создать кластеризованный индекс на столбце, содержащем дубликаты?
И да, и нет. Да вы можете создать кластеризованный индекс на ключевом столбце, содержащем дубликаты значений. Нет, значение ключевого столбца не смогут остаться в состоянии не уникальности. Позвольте объяснить. Если вы создаёте неуникальный кластерный индекс (non-unique clustered index) на столбце, то подсистема хранения данных добавляет к дублирующему значению целочисленное значение (uniquifier), чтобы удостовериться в уникальности и, соответственно, обеспечить возможность идентифицировать каждую строку в кластеризованной таблице.
К примеру, вы можете решить создать в таблице с данными о клиентах кластеризованный индекс по столбцу LastName, хранящим фамилию. Столбец содержит такие значения как Franklin, Hancock, Washington и Smith. Затем вы вставляете значения Adams, Hancock, Smith и снова Smith. Но значение ключевого столбца обязательно должны быть уникальны, поэтому подсистема хранения данных изменит значение дубликатов таким образом, что они будут выглядеть примерно так: Adams, Franklin, Hancock, Hancock1234, Washington, Smith, Smith4567 и Smith5678.
На первый взгляд такой подход кажется нормальным, но целочисленное значение увеличивает размер ключа, что может стать проблемой при большом количестве дубликатов, а эти значения станут основой некластеризованного индекса или ссылкой внешнего ключа. По этим причинам вы всегда должны стараться создавать уникальный кластеризованный (unique clustered indexes) при любой возможности. Если это невозможно, то по крайней мере постарайтесь использовать столбцы с очень высоким содержание уникальных значений.Как хранится таблица, если не был создан кластеризованный индекс?
SQL Server поддерживает два типа таблиц: кластеризованные таблицы, имеющие кластеризованный индекс и таблицы-кучи или просто кучи. В отличие от кластеризованных таблиц данные в куче не сортированы никоим образом. По сути это и есть нагромождение (куча) данных. Если вы добавите строку к такой таблице, то подсистема хранения данных просто добавит её к концу страницы. Когда страница заполнится данными, то они будут добавлены на новую страницу. В большинстве случаев, вы захотите создать кластеризованный индекс на таблице, чтобы получить преимущества от возможности сортировки и ускорения запросов (попробуйте представить себе найти телефонный номер в адресной книге, не отсортированной по какому-либо принципу). Однако, если вы решите не создавать кластеризованный индекс, то вы по-прежнему можете создать у кучи некластеризованный индекс. В этом случае каждая строка индекса будет иметь указатель на строку кучи. Указатель включает в себя идентификатор файла, номер страницы и номер строки с данными.
Какая взаимосвязь между ограничениями на уникальность значения и первичным ключом с индексами таблицы?
Первичный ключ и и ограничение уникальности обеспечивают, что значения в столбце будут уникальны. Вы можете создать только один первичный ключ у таблицы и он не может содержать значения NULL. Вы можете создать у таблицы несколько ограничений на уникальность значения и каждый из них может иметь единственную запись с NULL.
Когда вы создаете первичный ключ, подсистема хранения данных так же создает уникальный кластеризованный индекс, в случае если уже кластеризованный индекс не был создан. Однако, вы можете переопределить установленное по умолчанию поведение и тогда будет создан некластеризованный индекс. Если кластеризованный индекс существует когда вы создаёте первичный ключ, то будет создан уникальный некластеризованный индекс.
Когда вы создаете ограничение на уникальность, подсистема хранения данных создает уникальный некластеризованный индекс. Но вы можете указать создание уникального кластеризованного индекса, если он не был создан ранее.
В общем случае, ограничение на уникальность значение и уникальный индекс это одно и то же.Почему в SQL Server кластеризованные и некластеризованные индексы называются сбалансированным деревом?
Базовые индексы в SQL Server, кластеризованные или некластеризованные, распространяются по наборам страниц – узлам индекса. Эти страницы организованы в виде определенной иерархии с древовидной структурой, называемой сбалансированным деревом. На верхнем уровне находится корневой узел, на нижнем, конечные узлы листьев, с промежуточными узлами между верхним и нижним уровнями, как показано на рисунке:
Корневой узел предоставляет главную точку входа для запросов, пытающихся получить данные через индекс. Начиная с этого узла, подсистема запросов инициирует переход по иерархической структуре вниз к подходящему конечному узлу, содержащему данные.
К примеру, представим, что поступил запрос на выборку строк, содержащих значение ключа равное 82. Подсистема запросов начинает работу с корневого узла, который отсылает к подходящему промежуточному узлу, в нашем случае 1-100. От промежуточного узла 1-100 происходит переход к узлу 51-100, а оттуда к конечному узлу 76-100. Если это кластеризованный индекс, то на листе узла содержится данные строки, ассоциированной с ключом равным 82. Если же это некластеризованный индекс, то лист индекса содержит указатель на кластеризованную таблицу или конкретную строку в куче.Как вообще индекс может улучшить производительность запросов, если приходится переходить по всем этим индексным узлам?
Во-первых, индексы не всегда улучшают производительность. Слишком много неверно созданных индексов превращают систему в болото и понижают производительность запросов. Правильнее сказать, что если индексы были аккуратно применены, то они могут обеспечить значительный прирост в производительности.
Подумайте об огромной книге, посвященной настройке производительности SQL Server (бумажной, не об электронном варианте). Представьте, что вы хотите найти информацию о конфигурировании Регулятора ресурсов. Вы можете водить пальцем постранично через всю книгу или открыть содержание и узнать точный номер страницы с искомой информацией (при условии, что книга правильно проиндексирована и в содержании верные указатели). Безусловно, это сэкономит вам значительное время, не смотря на то, что вам надо сначала обратиться к совершенно другой структуре (индексу), чтобы получить необходимую вам информацию из первичной структуры (книги).
Как и книжный указатель, указатель в SQL Server позволяет вам выполнять точные запросы к нужным данным вместо полного сканирования всех данных, содержащихся в таблице. Для маленьких таблиц полное сканирование обычно не проблема, но большие таблицы занимают много страниц с данными, что в результате может привезти с значительному времени выполнения запроса, если не существует индекса, позволяющего подсистеме запросов сразу получить правильное месторасположение данных. Представьте, что вы заблудились на многоуровневой дорожной развязке перед крупным мегаполисом без карты и вы поймёте идею.Если индексы настолько замечательны, то почему бы просто не создать их на каждый столбец?
Ни одно доброе дело не должно оставаться безнаказанным. По крайней мере, именно так и обстоит дело с индексами. Разумеется, индексы отлично себя показывают, пока вы выполняете запросы на выборку данных оператором SELECT, но как только начинается частый вызов операторов INSERT, UPDATE и DELETE, так пейзаж очень быстро меняется.
Когда вы инициируется запрос данных оператором SELECT, подсистема запросов находит индекс, продвигается по его древовидной структуре и обнаруживает искомые данные. Что может быть проще? Но все меняется, если вы инициируете оператор изменения, такой как UPDATE. Да, для первой части оператора подсистема запросов может снова использовать индекс для обнаружения модифицируемой строки – это хорошие новости. И если происходит простое изменение данных в строке, не затрагивающее изменение ключевых столбцов, то процесс изменения пройдет вполне безболезненно. Но что, если изменение приведет к разделению страниц, содержащих данные, или будет изменено значение ключевого столбца, приводящее к переносу его в другой индексный узел – это приведёт к тому, что индексу может потребоваться реорганизация, затрагивающая все связанные индексы и операции, в результате будет повсеместное падение производительности.
Аналогичные процессы происходят при вызове оператора DELETE. Индекс может помочь найти месторасположение удаляемых данных, но само по себе удаление данных может привести к перестановке страниц. Касаемо оператора INSERT, главного врага всех индексов: вы начинаете добавлять большое количество данных, что приводит к изменению индексов и их реорганизации и все страдают.
Так что учитывайте виды запросов к вашей базе данных при размышлениях какой тип индексов и в каком количестве стоит создавать. Больше не значит лучше. Перед тем как добавить новый индекс на таблицу просчитайте стоимость не только базовых запросов, но и объем занимаемого дискового пространства, стоимость поддержания работоспособности и индексов, что может привести к эффекту домино для других операций. Ваша стратегия проектирования индексов один из важнейших аспектов внедрения и должна включать в рассмотрение множество соображений: от размера индекса, количества уникальных значений, до типа поддерживаемых индексом запросов.Обязательно ли создавать кластеризованный индекс на столбце с первичным ключом?
Вы можете создать кластеризованный индекс на любой столбце, соответствующем необходимым условиям. Это верно, что кластеризованный индекс и ограничение первичного ключа созданы друг для друга и их брак заключен на небесах, так что усвойте факт, что когда вы создаете первичный ключ, тогда же будет автоматически создан кластеризованный индекс, если он не был создан ранее. Тем не менее, вы можете решить, что кластеризованный индекс будет лучше работать в другом месте, и часто ваше решение будет вполне оправданным.
Главная цель кластеризованного индекса это сортировка всех строк к вашей таблице на основе ключевого столбца, указанного при определении индекса. Это обеспечивает быстрый поиск и легкий доступ к данным таблицы.
Первичный ключ таблицы может быть хорошим выбором, потому что он однозначно идентифицирует каждую строку в таблицы без необходимости добавлять дополнительные данные. В некоторых случаях лучшим выбором будет суррогатный первичный ключ, обладающий не только признаком уникальности, но и малым размером, а значения которого увеличиваются последовательно, что делает некластеризованные индексы, основанные на этом значении более эффективными. Оптимизатор запросов также любит такое сочетание кластеризованого индекса и первичного ключа, потому что соединение таблиц происходит быстрее, чем при соединении другим способом, не использующим первичный ключ и ассоциированный с ним кластеризованный индекс. Как я и говорил это брак, заключенный на небесах.
В конце стоит, однако, отметить, что при создании кластеризованного индекса необходимо принять во внимание несколько аспектов: как много некластеризованных индексов будет основываться на нём, как часто будут изменяться значение ключевого столбца индекса и на сколько ни большие. Когда значение в столбцах кластеризованого индекса изменятся или индекс не будет обеспечивать должной производительности, тогда все другие индексы таблицы могут быть задеты. Кластеризованный индекс должен быть основан на наиболее устойчивом столбце, значения которого увеличиваются в определенном порядке, но не изменяются в случайном. Индекс должен поддерживать запросы к наиболее часто используемым данным таблицы, таким образом запросы получают все преимущества того, что данные сортированы и доступны на корневых узлах, листьях индекса. Если первичный ключ соответствует этому сценарию, то используйте его. Если же нет, то выберите другой набор столбцов.А что если проиндексировать представление, то это по-прежнему будет представление?
Представление – это виртуальная таблица, формирующая данные из одной или нескольких таблиц. По сути, это именованный запрос, который получает данные из нижележащих таблиц, когда вы вызываете запрос к этому представлению. Вы можете улучшить производительность запросов, создав кластеризованных индекс и некластеризованные индексы у этого представления, аналогично как вы создаете индексы у таблицы, но основной нюанс состоит в том, что первоначально создается кластеризованный индекс, а затем вы можете создать некластеризованный.
Когда создается индексированное представление (материализованное представление), тогда само определение представления остается отдельной сущностью. Это, в конце концов, всего лишь жестко прописанный оператор SELECT, хранящийся в базе данных. А вот индекс совсем другая история. Когда вы создаете кластеризованный или некластеризованный индекс у предастваления, то данные физически сохраняются на диск, аналогично обычному индексу. В дополнение, когда в нижележащих таблицах изменяются данные, то индекс представления автоматически изменяется (это означает, что вы можете захотеть избежать индексирования представлений тех таблиц, в которых происходят частые изменения). В любом случае, представление остается представлением — взглядом на таблицы, но именно выполненном в данный момент, с индексами ему соответствующими.
Перед тем как вы сможете создать индекс у представления, оно должно соответствовать нескольким ограничениям. К примеру, представление может ссылаться только на базовые таблицы, но не другие представления и эти таблицы должны находиться в той же самой базе данных. На самом деле там множество других ограничений, так что не забудьте обратиться к документации по SQL Server за всеми грязными подробностями.Зачем использовать покрывающий индекс взамен составного индекса?
Во-первых, давайте убедимся, что мы понимаем различие между ними. Составной индекс это просто обычный индекс, в который включено больше одного столбца. Несколько ключевых столбцов может использоваться для обеспечения уникальности каждой строки таблицы, также возможен вариант, когда первичный ключ состоит из нескольких столбцов, обеспечивающих его уникальность, или вы пытаетесь оптимизировать выполнение часто вызываемых запросов к нескольким столбцам. В общем, однако, чем больше ключевых столбцов содержит индекс, тем менее эффективна работа этого индекса, а значит составные индексы стоит использовать разумно.
Как было сказано, запрос может извлечь огромную выгоду, если все необходимые данные сразу расположены на листьях индекса, как и сам индекс. Это не проблема для кластеризованного индекса, т.к. все данные уже там (вот почему так важно хорошенько подумать когда вы создаете кластеризованный индекс). Но некластеризованный индекс на листьях содержит только ключевые столбцы. Для доступа ко всем остальным данным оптимизатору запросов необходимы дополнительные шаги, что может вызвать значительные дополнительные накладные расходы для выполнения ваших запросов.
Вот где покрывающий индекс спешит на помощь. Когда вы определяете некластеризованный индекс, то можете указать дополнительные столбцы к вашим ключевым. К примеру, представим, что ваше приложение часто запрашивает данные столбцов OrderID и OrderDate в таблице Sales:SELECT OrderID, OrderDate FROM Sales WHERE OrderID = 12345;Вы можете создать составной некластеризованный индекс на обоих столбцах, но столбец OrderDate только добавит накладных расходов на обслуживание индекса, но так и не сможет служить особо полезным ключевым столбцом. Лучшее решение будет это создание покрывающего индекса с ключевым столбцом OrderID и дополнительно включенным столбцом OrderDate:
CREATE NONCLUSTERED INDEX ix_orderid ON dbo.Sales(OrderID) INCLUDE (OrderDate);При этом вы избегаете недостатков, возникающих при индексации излишних столбцов, в то же время сохраняете преимущества хранения данных на листьях при выполнении запросов. Включенный столбец не является частью ключа, но данные хранятся именно на конечном узле, листе индекса. Это может улучшить производительность выполнения запроса без каких либо дополнительных расходов. К тому же, на столбцы, включенные в покрывающий индекс, накладывается меньше ограничений, нежели на ключевые столбцы индекса.
Имеет ли значение количество дубликатов в ключевом столбце?
Когда вы создаете индекс, вы обязаны постараться уменьшить количество дубликатов в ваших ключевых столбцах. Или более точно: стараться держать коэффициент повторяющихся значений настолько низким, насколько это возможно.
Если вы работаете с составным индексом, то дублирование относится ко всем ключевым столбцам в целом. Отдельный столбец может содержать множество повторяющихся значений, но повторения среди всех столбцов индекса должно быть минимальным. К примеру, вы создаете составной некластеризованный индекс на столбцах FirstName и LastName, вы можете иметь множество значений равных John и множество Doe, но вы хотите иметь как можно меньше значений John Doe, или лучше только одно значение John Doe.
Коэффициент уникальности значений ключевого столбца называется избирательностью индекса. Чем больше уникальных значений, тем выше избирательность: уникальный индекс обладает наибольшей возможной избирательностью. Подсистема запросов очень любит столбцы с высоким значением избирательности, особенно если эти столбцы участвуют в условиях выборки WHERE ваших наиболее часто выполняемых запросов. Чем выше избирательность индекса, тем быстрее подсистема запросов может уменьшить размер результирующего набора данных. Обратной стороной, разумеется, является то, что столбцы с относительно небольшим количеством уникальных значений редко будут хорошими кандидатами на индексирование.Можно ли создать некластеризованный индекс только для определенного подмножества данных ключевого столбца?
По умолчанию, некластеризованный индекс содержит по одной строке для каждой строки таблицы. Конечно, вы можете сказать то же самое относительно кластеризованного индекса, принимая в расчет, что такой индекс это и есть таблица. Но что касается некластеризованного индекса, то отношение «один к одному» важный концепт, потому что, начиная с версии SQL Server 2008, у вас есть возможность создать фильтруемый индекс, который ограничивает включенные в него строки. Фильтруемый индекс может улучшить производительность выполнения запросов, т.к. он меньше по размеру и содержит отфильтрованную, более аккуратную, статистику, чем вся табличная — это приводит к созданию улучшенных планов выполнения. Фильтруемый индекс также требует меньше места для хранения и меньших затрат на обслуживание. Индекс обновляется только когда изменяются подходящие под фильтр данные.
В дополнение, фильтруемый индекс легко создать. В операторе CREATE INDEX просто необходимо указать в WHERE условие фильтрации. К примеру, вы можете отфильтровать из индекса все строки, содержащие NULL, как показано в коде:CREATE NONCLUSTERED INDEX ix_trackingnumber ON Sales.SalesOrderDetail(CarrierTrackingNumber) WHERE CarrierTrackingNumber IS NOT NULL;Мы можем, фактически, отфильтровать любые данные, которые не важны в критических запросах. Но будьте внимательны, т.к. SQL Server накладывает несколько ограничений на фильтруемые индексы, такие, как невозможность создать фильтруемый индекс у представления, так что внимательно читайте документацию.
Также, может случиться, что вы можно достичь подобных результатов созданием индексированного представления. Однако, фильтруемый индекс имеет несколько преимуществ, таких как возможность уменьшить стоимость обслуживания и улучшить качество ваших планов выполнения. Фильтруемые индексы также допускают перестройку в онлайн-режиме. Попробуйте это сделать с индексируемым представлением.И снова немного от переводчика
Целью появления данного перевода на страницах Хабрахабра было рассказать или напомнить вам о блоге SimpleTalk от RedGate.
В нём публикуется множество занимательных и интересных записей.
Я не связан ни с продуктами фирмы RedGate, ни с их продажей.Как и обещал, книги для тех кто хочет знать больше
Порекомендую от себя три очень хорошие книги (ссылки ведут на kindle версии в магазине Amazon):
Microsoft SQL Server 2012 T-SQL Fundamentals (Developer Reference)
Author Itzik Ben-Gan
Publication Date: July 15, 2012
Автор, мастер своего дела, даёт базовые знания о работе с базами данных.
Если вы всё забыли или никогда не знали, то определенно стоит её прочитать
SQL Server Execution Plans
Author Grant Fritchey
Publication Date: May 21, 2013
Автор буквально на пальцах объясняет как работают запросы к базе данных.
GraDea напомнил, что бесплатно можно скачать pdf на сайте RedGate
SQL Server Query Performance Tuning
Author Grant Fritchey
Publication Date: September 3, 2014
Этот же автор в более глобальной и всеобъемлющей книге объясняет как улучшить производительности базы данных и запросов к ней.Да, на самом деле очень много хороших и качественных книг.
В принципе, можно открыть просто список самых желаемых по SQL Server и покупать любую.
Многие из них на русский язык не переведены. И, наверное, никогда не будут!
Тема бесплатного поиска книг не раскрыта и оставлена на ваше личное усмотрение (upd: таки, теперь немного раскрыта).- Веб-разработка
- Программирование
- SQL
- Microsoft SQL Server
Оптимизация структуры базы данных: исправляем ошибки
В нашем предыдущем материале Как эффективно управлять ростом объема данных речь шла о том, как с самого начала не допустить ошибок при работе с базами данных. В этой же статье предлагаем рассмотреть ситуации, когда с самого начала вы совершили просчеты и столкнулись с тем, что уже поздно менять структуру данных, но все еще есть возможность их оптимизировать.
- Как работать с индексами бд?
- Индексы в бд: о чем еще стоит помнить
- Критические ошибки: запросы
- Оптимизация индексов: о чем еще стоит задуматься?
Даже если вы прислушались к нашим рекомендациям и сделали все как по учебнику, после того как ваша система заработала и накопила определенное количество данных, с ними могут случаться проблемы, например, медленное выполнение запросов. Это самое частое явление, с которым обычно сталкиваются, когда работают с данными. И это нормально, потому что на этапе разработки структуры вы не всегда сможете предугадать, как будет развиваться ваша база данных. Предположим, вы запускаете MVP-проект, но впоследствии тестовый продукт может обрасти не тем функционалом, который был запланирован. С самого начала сложно все предусмотреть, поэтому заниматься оптимизацией не всегда имеет смысл, нужно сперва посмотреть, во что выльется проект. Все оптимизации, которые на этом этапе надо выполнять, обычно связаны с двумя вещами: во-первых, вы начинаете индексировать все, что индексировали до этого, а во-вторых, вы смотрите, как вообще осуществляются запросы, возможно, они выполняются неэффективно.
Как работать с индексами
Учимся читать план выполнения запроса.
Разработчики зачастую плохо понимают, как устроены базы данных. Нужно уметь разбираться в том, как их структурировать и проектировать. Также большинство разработчиков не понимает, что такое план выполнения запроса в СУБД. Но это несложно: достаточно изучить документацию и понять, где в запросах теряется время. Чаще всего помогает «навешивание» каких-нибудь индексов.
Частичный индекс компактнее полного.
По умолчанию индекс, который вы навешиваете на таблицу, индексирует вообще все значения. Но в большинстве случаев вам не нужны NULL-значения, если они есть базе. Так выкиньте их и постройте такой индекс (любая СУБД это позволяет), который NULL-значения не учитывает. Размер индекса в этом случае у вас сильно уменьшится и будет содержать в себе только то, что нужно. То же самое касается ситуации, когда значения, которые вы индексируете, тоже вам не нужны. В поле могут быть значения от 1 до 100, но вы чаще всего делаете запрос по значениям 1, 2, 3, поэтому можете легко проиндексировать только эти значения. В этом случае индекс у вас будет небольшого размера, и работать он будет быстро. Разницу между полным индексом и частичным можно даже увидеть на глаз в вашей системе мониторинга: время отклика резко упадет.
Кластеризованные индексы идеальны для дат.
Кластеризованным называют индекс, который гарантирует, что данные в вашей таблице идут друг за другом и так, как надо. Это бывает очень полезно, когда вы в своих запросах используете интервалы, и, чаще всего, интервалы по датам. Например, вы делаете запрос о поиске всех строк с 18 по 19 июня, и если вы используете на дате кластеризованный индекс, то строки будут идти подряд, а это значит, что СУБД их очень быстро считает с диска, а не будет «бегать» по всему диску и искать. Это минимизирует количество операций чтения и может значительно уменьшить время отклика.
Функциональный индекс поддерживают все СУБД.
С помощью него вы можете индексировать данные по какой-либо функции. Бывают ситуации, когда вам нужно найти всех людей, у которых день рождения 19 июня (не важно какого года). И именно функциональный индекс эффективен в данном случае.
Индексы по числам эффективнее, чем по строкам.
Храните все, что является числом, как число (номера телефонов, ИНН и так далее), потому что индекс по номерам телефонов и ИНН (его часто приходится навешивать и на одно, и на другое) будет занимать меньше места, а если что-либо в СУБД занимает меньше места, то оно быстрее находится, считывается, оптимально кэшируется и быстрее выдается. Все это влияет на производительность. Пока у вас маленькая база данных, это незаметно, а когда она вырастает до гигабайтов и количество запросов в секунду переваливает за несколько десятков, вы сразу это ощущаете.
Индексы: о чем стоит помнить?
Не все можно эффективно индексировать.
Не все понимают, что индексы имеют свои пределы и ограничения. Встречаются разработчики, которые при создании таблицы навешивали индексы на каждое поле с надеждой, что база будет работать быстрее. Вообще не рекомендуется индексы навешивать сразу при создании таблицы, нужно сначала дождаться результата, а потом смотреть, какая у вас логика и план выполнения запроса. Не нужно торопиться.
Поиск по нескольким индексированным полям — лотерея. Надо помнить, что если в одной таблице есть несколько индексированных полей и вы не по всем из них ищите данные, то результат будет непредсказуемым, как в лотерее. Ситуация может отличаться от сервера к серверу и от машины к машине. Почему? Разные условия, нагрузка, количество памяти, скорость работы с диском. Поэтому индексировать данные надо, изучая план запроса на том самом «боевом» сервере, на котором у вас возникли проблемы.
За индексами нужно ухаживать. Индексы со временем «разбухают», становятся большими, и их нужно постоянно чистить, сжимать, дефрагментировать — только тогда они будут работать эффективно.
Много индексов на таблице — признак перегруженной структуры.
Критические ошибки: запросы
Нижеприведенные рекомендации — это классика жанра, об этом написано в любом руководстве по тому, как правильно работать с SQL-базами данных. Никогда нельзя запрашивать все разом (SELECT *), запрашивайте только то, что вы ищите, это, если хотите, закон. Скорость работы СУБД зависит в том числе и от того, сколько вы из нее запрашиваете. Если вы запрашиваете много ненужных вещей, которые потом выкинете, значит вы делаете работу вхолостую. Такой запрос — зло, особенно в ситуации, когда таблица большая.
За SELECT COUNT (*) и LIMIT/OFFSET надо винить разработчиков таких интерфейсов, где есть списки с постраничным выводом данных. Это, может, выглядит красиво, но даже по опыту использования поисковиков мы знаем, что пользователи дальше второй страницы заходят редко. А если список длинный, то они и первую страницу просматривают не до конца. Нужно давать в интерфейсах возможность делать такие фильтры, чтобы данные можно было получить быстро и именно столько, сколько нужно.
Арифметика в фильтрах, функции и полнотекстовый поиск убивают индексы. Если в условиях поиска вы используете арифметику, функции или полнотекстовый поиск, то чаще всего это убивает любые индексы. Запросы не будут быстрыми: вам нужно будет или упрощать их, или использовать какие-то специфические решения (например, для полнотекстового поиска есть плагин либо функциональный индекс, о котором шла речь ранее).
Оптимизация: о чем еще стоит задуматься?
Настройка ORM.
На это месте нам начинает сильно мешать ORM. Разработчики любят ее использовать, это сильно упрощает работу, но она часто делает много лишних действий. Это могут быть как неоптимальные запросы, так и просто лишние. На практике при разборе ошибок мы видели ситуации, когда ORM запрашивает из базы что попало, когда ее об этом не просили. Ее нужно уметь настраивать, чтобы она этого не делала.
Рефакторинг бизнес-логики.
Иногда проще сделать два маленьких запроса, чем один большой — он будет медленнее. Но здесь каждый случай индивидуален, нужно уметь экспериментировать. Поэтому чтобы ускорить работу с базами, стоит и настроить ORM, и отрефакторить запросы к ним.
Контроль ссылочной целостности.
Речь идет о ситуациях, когда настроены каскадные удаления и обновления. В то время, как вы пытаетесь что-то удалить, СУБД ищет все связанные сущности и пытается понять, стоит их удалять или нет. В этом случае можно не удалять, а помечать как удаленную. Либо пытаться ссылочную целостность как-то порвать, но это может привести к несогласованности, когда вы случайно забудете удалить вместе с основной записью и все связанные с ней. В этом случае в вашей базе будут накапливаться «потерянные» записи. Они, как минимум, будут зря занимать место. Но в перспективе это может привести к неправильной работе бизнес-логики, что гораздо хуже. Так что, если вы очень часто удаляете что-то из БД, то рвать ссылочную целостность надо очень аккуратно, семь раз проверив, что вы удалили действительно всё.
Оптимизация структуры БД — исправление ошибок, совершенных ранее. Если к тому времени, когда у вас начались первые проблемы со скоростью вы видите, что ошиблись на первой стадии, настало время их поправить, потому что далее проблемы будут усугубляться.
теги
рекомендуем
Как сократить время загрузки веб-сайта на 30% и увеличить лояльность пользователей

Обзор возможностей виртуальной и дополненной реальности для повышения эффективности и безопасности персонала

Avanpost DS: отечественная служба каталогов без использования open source

Открытие инновационной демозоны в офисе ГК Softline