HTML::LinkExtractor — Парсер внешних и внутренних ссылок с указанного сайта
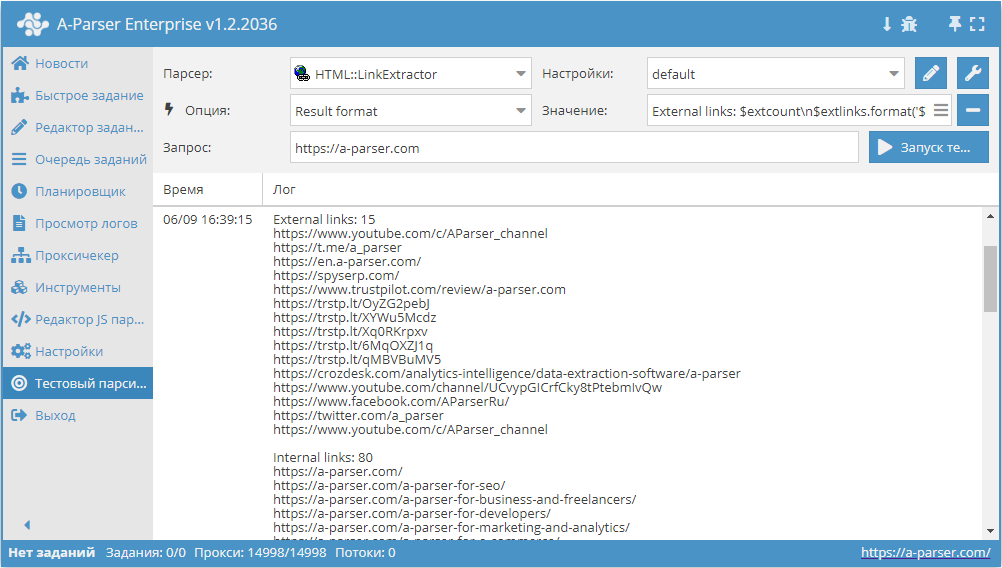
 HTML::LinkExtractor – парсер внешних и внутренних ссылок с указанного сайта. Поддерживает многостраничный парсинг и переход по внутренним страницам сайта до указанной глубины, что позволяет пройтись по всем страницам сайта, собирая внутренние и внешние ссылки. Имеет встроенные средства обхода защиты CloudFlare и также возможность выбора Chrome в качестве движка для парсинга почт со страниц, данные на которых подгружаются скриптами. Способен развивать скорость до 2000 запросов в минуту – это 120 000 ссылок за час.
Кейсы по применению парсера
Сбор всех внешних ссылок с сайта
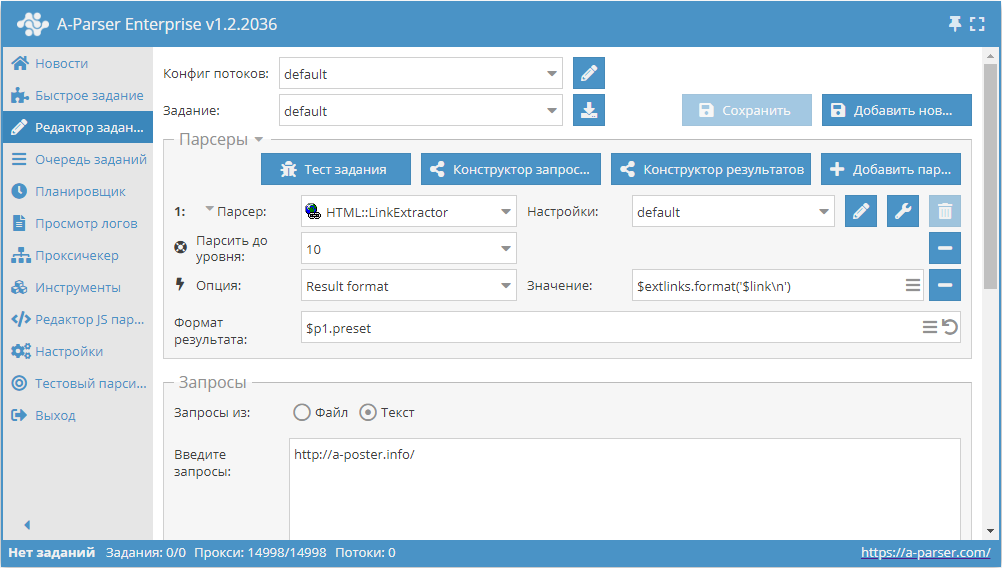
- Добавить опцию Парсить до уровня, в списке выбрать значение 10 (переход по соседним страницам до 10-ого уровня).
- Добавить опцию Result format, в качестве значения указать $extlinks.format(‘$link\n’) (вывод внешних ссылок).
- В разделе Запросы поставить галочку на опцию Уникальные запросы .
- В разделе Результаты поставить галочку на опцию Уник по строке .
- В качестве запроса указать ссылку на сайт, с которого требуется спарсить внешние ссылки.
Скачать пример
eJxtU01v2zAM/S9CgK5AlrSHXnxLgwZb4dZdm57SHISYztTIoirRWQrD/32U7NjJ 1ptIvsfHL9WCpN/5JwceyItkVQsb3yIRORSy0iTGwkrnwYXwSvxYPqRJkiqzuzuQ kxtCx4geWwv6tMBstKTQeI6pnM2YIoU9aPbspa4Yc33VnOD34JzK4Ugo0JWSuJa2 hI4iRnAgzeJ+0gK+XYyC+fZmLi5Fs16PRUvxixgODHs96Xrqgy9yD0sMKkrD4F6w 9SjLqJNLghA96lxO6BAyyDxXoTOpW4UwlUH11aiPWKcnp8yW8Ww6BX7hsGQ3QUwS nJ/HCldiFG3BaarI/9VyREKugrHwXO1Cci15Hyik9hxRBE7yBrJu2Ekt0My0joMe YDH9baV0zlucFUz62RG/hmT/5Wj6Dk+leGV/HNfQZ4nWbfYwsHJMccuNG+S2tSoV se3nWJmwmyt27gBsP7bHACvRQS/TZe7U+VAtmHAfw9ZmdnCdtXG2mXPnBk2htll3 c0dkZZb8GzIzx9JqCH2ZSmveiofn4UJmvltDMIYC/yXPo8TZPyJE7e9f2lKtU3yB N6HAkid5qtql3EitX5/T04gYLoqN30Q2mU7ld4ueFzpRpsCpCESCLfJFcVvNuv+/ /S+vv/zFSd3wwt79U4sO3QUs+3hMnrfBP7b5C6wbebo= Как спарсить со всех страниц сайта используя python
Я не особо опытна в python, поэтому если решите помочь, прошу, подробнее =) Проблема такая, хочу спарсить этот сайт https://www.mir-priaji.ru/ (у них каталог в открытом доступе есть, так что это не воровство) По видеоурокам разобралась, написала парсер для одной страницы, а как автоматизировать процесс для всех страниц в пределах данного url? то есть там каталог не поддаётся алгоритмированию, все ссылки уникальны, неужели всё ручками вбивать нужно? привожу код:
import requests from bs4 import BeautifulSoup import csv import time URL = 'https://www.mir-priaji.ru/catalog/aksessuary_dlya_vyshivaniya/pyaltsy_ramki/prochie_2/207569/' HEADERS = HOST = 'https://www.mir-priaji.ru' FILE = 'catalog.csv' def get_html(url, params=None): r = requests.get(url, headers=HEADERS, params=params) return r def get_pages_count(html): soup = BeautifulSoup(html, 'html.parser') pagination = soup.find_all('span', class_='page-item mhide') if pagination: return int(pagination[-1].get_text()) else: return 1 """ def get_img(html): p = requests.get(img) out = open("/upload/resize_cache/iblock/a2f/400_400_140cd750bba9870f18aada2478b24840a/a2fd17144bc3457aa0626e7b1a6dba79.jpeg", "wb") out.write(p.content) out.close() """ def get_content(html): soup = BeautifulSoup(html, 'html.parser') items = soup.find_all('div', class_='wraps hover_shine') catalog = [] for item in items: cost = item.find('span', class_='grey size13') if cost: cost = cost.get_text() else: cost = 'Цену уточняйте' catalog.append(< 'title': item.find('div', class_='preview_text dotdot').get_text(strip=True), 'kategory': item.find('a', class_='number').get_text(strip=True), 'kategory2': item.find('div', class_='bx-breadcrumb-item drop').get_text(strip=True), 'cost': cost, 'kol-vo': item.find('span', class_='value').get_text(strip=True), >) return catalog def save_file(items, path): with open(path, 'w', newline='') as file: writer = csv.writer(file, delimiter=';') writer.writerow(['Название', 'Категория', 'Подкатегория','Цена', 'Изображение', 'Наличие',]) for item in items: writer.writerow([item['title'], item['kategory'], item['kategory2'], item['cost'], item['kol-vo']]) def parse(): """ URL = input('Введите URL: ') URL = URL.strip() """ html = get_html(URL) if html.status_code == 200: catalog = [] pages_count = get_pages_count(html.text) for page in range (1, pages_count + 1): print(f'Парсинг страницы . ') html = get_html(URL, params=) catalog.extend(get_content(html.text)) time.sleep(1) save_file(catalog, FILE) print(f'Получено товаров') else: print('Error') parse() Как спарсить любой сайт?

Меня зовут Даниил Охлопков, и я расскажу про свой подход к написанию скриптов, извлекающих данные из интернета: с чего начать, куда смотреть и что использовать.
Написав тонну парсеров, я придумал алгоритм действий, который не только минимизирует затраченное время на разработку, но и увеличивает их живучесть, робастность, масштабируемость.
TL;DR
Чтобы спарсить данные с вебсайта, пробуйте подходы именно в таком порядке:
- Найдите официальное API,
- Найдите XHR запросы в консоли разработчика вашего браузера,
- Найдите сырые JSON в html странице,
- Отрендерите код страницы через автоматизацию браузера,
- Если ничего не подошло — пишите парсеры HTML кода.
Совет профессионалов: не начинайте с BS4/Scrapy
BeautifulSoup4 и Scrapy — популярные инструменты парсинга HTML страниц (и не только!) для Python.
Крутые вебсайты с крутыми продактами делают тонну A/B тестов, чтобы повышать конверсии, вовлеченности и другие бизнес-метрики. Для нас это значит одно: элементы на вебстранице будут меняться и переставляться. В идеальном мире, наш написанный парсер не должен требовать доработки каждую неделю из-за изменений на сайте.
Приходим к выводу, что не надо извлекать данные из HTML тегов раньше времени: разметка страницы может сильно поменяться, а CSS-селекторы и XPath могут не помочь. Используйте другие методы, о которых ниже. ⬇️
Используйте официальный API
�� Ого? Это не очевидно ��? Конечно, очевидно! Но сколько раз было: сидите пилите парсер сайта, а потом БАЦ — нашли поддержку древней RSS-ленты, обширный sitemap.xml или другие интерфейсы для разработчиков. Становится обидно, что поленились и потратили время не туда. Даже если API платный, иногда дешевле договориться с владельцами сайта, чем тратить время на разработку и поддержку.
Sitemap.xml — список страниц сайта, которые точно нужно проиндексировать гуглу. Полезно, если нужно найти все объекты на сайте. Пример: http://techcrunch.com/sitemap.xml
RSS-лента — API, который выдает вам последние посты или новости с сайта. Было раньше популярно, сейчас все реже, но где-то еще есть! Пример: https://habr.com/ru/rss/hubs/all/
Поищите XHR запросы в консоли разработчика

Все современные вебсайты (но не в дарк вебе, лол) используют Javascript, чтобы догружать данные с бекенда. Это позволяет сайтам открываться плавно и скачивать контент постепенно после получения структуры страницы (HTML, скелетон страницы).

Обычно, эти данные запрашиваются джаваскриптом через простые GET/POST запросы. А значит, можно подсмотреть эти запросы, их параметры и заголовки — а потом повторить их у себя в коде! Это делается через консоль разработчика вашего браузера (developer tools).
В итоге, даже не имея официального API, можно воспользоваться красивым и удобным закрытым API. ☺️
Даже если фронт поменяется полностью, этот API с большой вероятностью будет работать. Да, добавятся новые поля, да, возможно, некоторые данные уберут из выдачи. Но структура ответа останется, а значит, ваш парсер почти не изменится.
Алгорим действий такой:

- Открывайте вебстраницу, которую хотите спарсить
- Правой кнопкой -> Inspect (или открыть dev tools как на скрине выше)
- Открывайте вкладку Network и кликайте на фильтр XHR запросов
- Обновляйте страницу, чтобы в логах стали появляться запросы
- Найдите запрос, который запрашивает данные, которые вам нужны
- Копируйте запрос как cURL и переносите его в свой язык программирования для дальнейшей автоматизации.
Вы заметите, что иногда эти XHR запросы включают в себя огромные строки — токены, куки, сессии, которые генерируются фронтендом или бекендом. Не тратьте время на ревёрс фронта, чтобы научить свой парсер генерировать их тоже.
Вместо этого попробуйте просто скопипастить и захардкодить их в своем парсере: очень часто эти строчки валидны 7-30 дней, что может быть окей для ваших задач, а иногда и вообще несколько лет. Или поищите другие XHR запросы, в ответе которых бекенд присылает эти строчки на фронт (обычно это происходит в момент логина на сайт). Если не получилось и без куки/сессий никак, — советую переходить на автоматизацию браузера (Selenium, Puppeteer, Splash — Headless browsers) — об этом ниже.
Поищите JSON в HTML коде страницы
Как было удобно с XHR запросами, да? Ощущение, что ты используешь официальное API. �� Приходит много данных, ты все сохраняешь в базу. Ты счастлив. Ты бог парсинга.
Но тут надо парсить другой сайт, а там нет нужных GET/POST запросов! Ну вот нет и все. И ты думаешь: неужели расчехлять XPath/CSS-selectors? ��♀️ Нет! ��♂️
Чтобы страница хорошо проиндексировалась поисковиками, необходимо, чтобы в HTML коде уже содержалась вся полезная информация: поисковики не рендерят Javascript, довольствуясь только HTML. А значит, где-то в коде должны быть все данные.
Современные SSR-движки (server-side-rendering) оставляют внизу страницы JSON со всеми данные, добавленный бекендом при генерации страницы. Стоп, это же и есть ответ API, который нам нужен! ������
Вот несколько примеров, где такой клад может быть зарыт (не баньте, плиз):

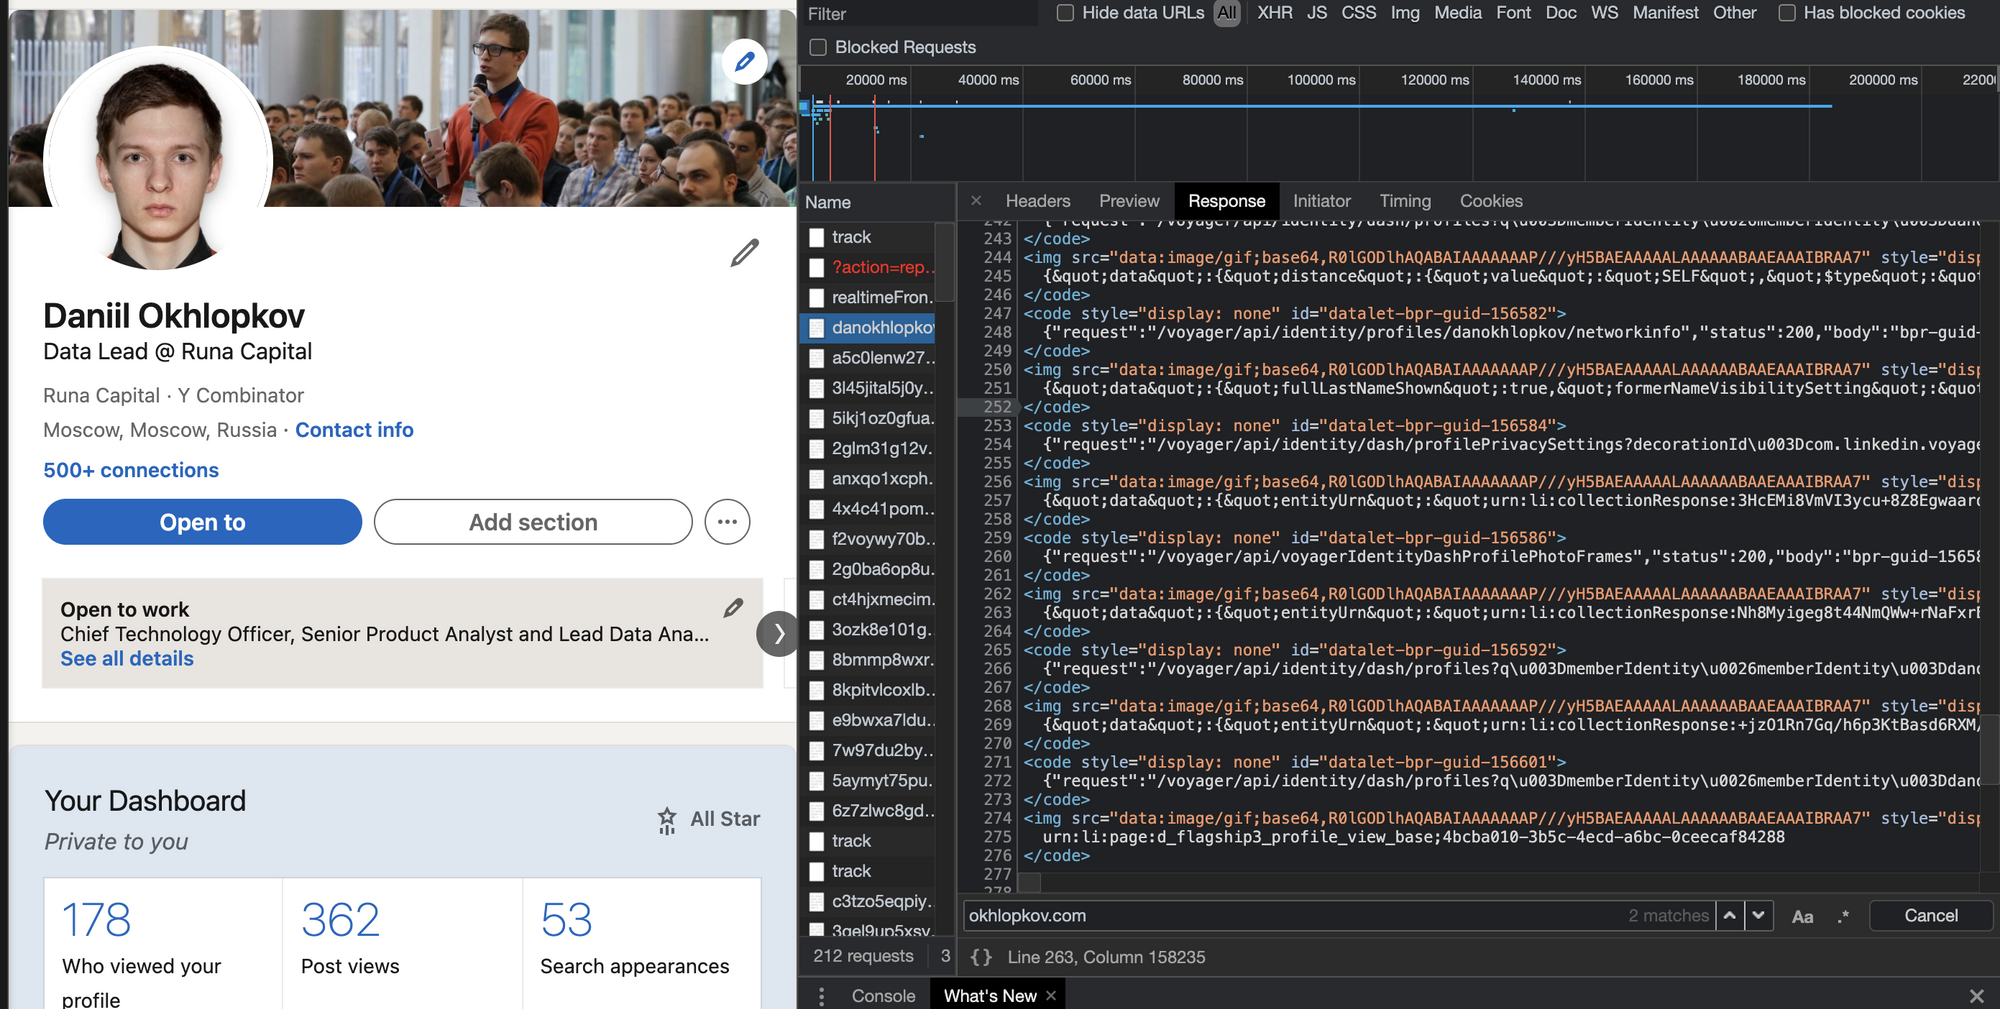
Алгоритм действий такой:
- В dev tools берете самый первый запрос, где браузер запрашивает HTML страницу (не код текущий уже отрендеренной страницы, а именно ответ GET запроса).
- Внизу ищите длинную длинную строчку с данными.
- Если нашли — повторяете у себя в парсере этот GET запрос страницы (без рендеринга headless браузерами). Просто requests.get .
- Вырезаете JSON из HTML любыми костылямии (я использую html.find(«= <") ).
Отрендерите JS через Headless Browsers
Если XHR запросы требуют актуальных tokens, sessions, cookies. Если вы нарываетесь на защиту Cloudflare. Если вам обязательно нужно логиниться на сайте. Если вы просто решили рендерить все, что движется загружается, чтобы минимизировать вероятность бана. Во всех случаях — добро пожаловать в мир автоматизации браузеров!
Если коротко, то есть инструменты, которые позволяют управлять браузером: открывать страницы, вводить текст, скроллить, кликать. Конечно же, это все было сделано для того, чтобы автоматизировать тесты веб интерфейса. I’m something of a web QA myself.
После того, как вы открыли страницу, чуть подождали (пока JS сделает все свои 100500 запросов), можно смотреть на HTML страницу опять и поискать там тот заветный JSON со всеми данными.
driver.get(url_to_open) html = driver.page_sourceSelenoid — open-source remote Selenium cluster
Для масштабируемости и простоты, я советую использовать удалённые браузерные кластеры (remote Selenium grid).
Недавно я нашел офигенный опенсорсный микросервис Selenoid, который по факту позволяет вам запускать браузеры не у себя на компе, а на удаленном сервере, подключаясь к нему по API. Несмотря на то, что Support team у них состоит из токсичных разработчиков, их микросервис довольно просто развернуть (советую это делать под VPN, так как по умолчанию никакой authentication в сервис не встроено). Я запускаю их сервис через DigitalOcean 1-Click apps: 1 клик — и у вас уже создался сервер, на котором настроен и запущен кластер Headless браузеров, готовых запускать джаваскрипт!
Вот так я подключаюсь к Selenoid из своего кода: по факту нужно просто указать адрес запущенного Selenoid, но я еще зачем-то передаю кучу параметров бразеру, вдруг вы тоже захотите. На выходе этой функции у меня обычный Selenium driver, который я использую также, как если бы я запускал браузер локально (через файлик chromedriver).
def get_selenoid_driver( enable_vnc=False, browser_name="firefox" ): capabilities = < "browserName": browser_name, "version": "", "enableVNC": enable_vnc, "enableVideo": False, "screenResolution": "1280x1024x24", "sessionTimeout": "3m", # Someone used these params too, let's have them as well "goog:chromeOptions": , "prefs": < "credentials_enable_service": False, "profile.password_manager_enabled": False >, > driver = webdriver.Remote( command_executor=SELENOID_URL, desired_capabilities=capabilities, ) driver.implicitly_wait(10) # wait for the page load no matter what if enable_vnc: print(f"You can view VNC here: ") return driverЗаметьте фложок enableVNC . Верно, вы сможете смотреть видосик с тем, что происходит на удалённом браузере. Всегда приятно наблюдать, как ваш скрипт самостоятельно логинится в Linkedin: он такой молодой, но уже хочет познакомиться с крутыми разработчиками.
Парсите HTML теги
Мой единственный совет: постараться минимизировать число фильтров и условий, чтобы меньше переобучаться на текущей структуре HTML страницы, которая может измениться в следующем A/B тесте.
Даниил Охлопков — Data Lead @ Runa Capital
Подписывайтесь на мой Телеграм канал, где я рассказываю свои истории из парсинга и сливаю датасеты.
Надеюсь, что-то из этого было полезно! Я считаю, что в парсинге важно, с чего ты начинаешь. С чего начать — я рассказал, а дальше ваш ход ��
Как получить все ссылки с сайта?
Есть сайт, мне нужно спарсить (сграббить) все ссылки. Но на странице показаны всего 10 первых, а остальные по ещё 10 штук подгружаются по клику на кнопку. Там чуть больше чем 600 000 ссылок.. =)
Вопрос: если какие скрипты\программы чтобы получить все ссылки?
- Вопрос задан более трёх лет назад
- 7135 просмотров
Комментировать
Решения вопроса 0
Ответы на вопрос 3

Пример его использования для парсинга всех ссылок с сайта google.com
$html = file_get_html(‘www.google.com’);
echo $html->find(‘a’);
Если нужна только ссылка(href), то можно указать атрибут
echo $html->find(‘a’)->href;
Ответ написан более трёх лет назад
Комментировать
Нравится 2 Комментировать