SQL-Ex blog
Когда использовать CHAR, VARCHAR или VARCHAR(MAX)
Добавил Sergey Moiseenko on Четверг, 21 июля. 2022
В каждой базе данных имеются различные виды данных, которые нужно хранить. Некоторые данные строго числовые, в то время как другие данные состоят только из букв или комбинации букв, чисел и даже специальных символов. Даже при простом хранении данных в памяти или на диске требуется, чтобы каждая часть данных имела тип. Выбор правильного типа зависит от характеристик сохраняемых данных. В этой статье объясняется разница между CHAR, VARCHAR и VARCHAR(MAX).
При выборе типа данных столбца необходимо подумать о характеристиках данных, чтобы назначить правильный тип данных. Будет ли каждое значение иметь одну и ту же длину, или размер будет сильно различаться от значения к значению? Как часто будут меняться данные? Будет ли длина столбца меняться со временем? Могут быть и другие факторы, подобные эффективному использованию пространства и производительности, которые могут привести вас к принятию того или иного типа данных.
Типы данных CHAR, VARCHAR и VARCHAR(MAX) могут хранить символьные данные. В этой статье будут обсуждаться и сравниваться эти три различных типа символьных данных. Приведенная информация призвана помочь вам выбрать подходящий среди этих трех типов данных.
Символьный тип данных фиксированной длины CHAR
Тип данных CHAR является типом данных фиксированной длины. Он может хранить буквы, числа и специальные символы в строках размером до 8000 байт. Тип данных CHAR наилучшим образом используется для хранения данных, которые имеют сопоставимую длину. Например, двухсимвольные коды штатов США, односимвольные коды половой принадлежности, номера телефонов, почтовые коды и т.п. Столбец CHAR является не лучшим выбором для хранения данных, у которых существенно варьируется длина. Столбцы, хранящие данные типа адресов или мемо-полей не подходят для столбцов с типом данных CHAR.
Это не означает, что столбец CHAR не может содержать значения, которые варьируются по размеру. Когда в столбец CHAR заносятся строки, которые короче, чем длина столбца, справа будут добавляться пробелы. Число этих пробелов определяется разностью между размером столбца и длиной сохраняемых символов. Поскольку столбцы CHAR при необходимости полностью добиваются пробелами, каждый столбец занимает одно и то же пространство на диске или в памяти. Концевые пробелы также играют роль при поиске в столбцах типа CHAR. Подробнее об этом несколько позже.
Символьный тип данных переменной длины VARCHAR
Столбцы VARCHAR, как подразумевает название, хранят данные переменной длины. Они могут хранить буквы, числа и специальные символы, как и столбец CHAR, и поддерживают строки размером до 8000 байт. Столбец переменной длины занимает только то место, которое требуется для хранения строки символов, и не дополняются никакими пробелами. По этой причине столбцы VARCHAR отлично подходят для хранения строк, которые сильно варьируются по размеру.
Для поддержки столбцов переменной длины необходимо, помимо самих данных, хранить их длину. Поскольку длина необходима для вычислений и используется ядром базы данных при чтении и сохранении столбцов переменной длины, считается, что они несколько менее производительны по сравнению со столбцами CHAR. Однако, если учесть, что они используют только то пространство, которое им необходимо, экономия места на диске сама по себе может компенсировать потери производительности при использовании типа VARCHAR.
Различия типов данных CHAR и VARCHAR
Фундаментально отличие CHAR от VARCHAR состоит в том, что тип данных CHAR имеет фиксированную длину, в то время как тип данных VARCHAR поддерживает столбцы данных переменной длины. Но он и похожи. Оба предназначены для хранения алфавитно-цифровых данных. Для лучшего понимания разницы между этими двумя типами, посмотрите таблицу 1, где сделан обзор их подобия и отличий.
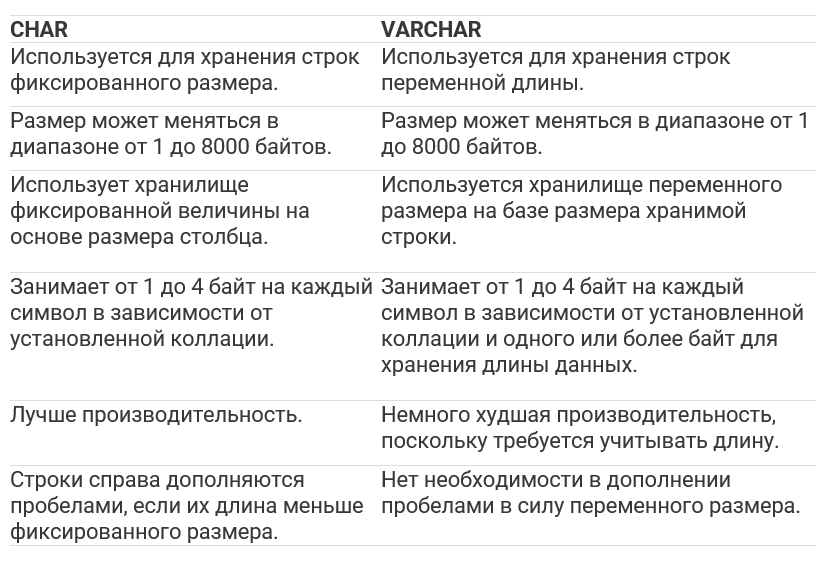
Таблица 1: сравнение типов CHAR и VARCHAR
Что означает «N» в CHAR(N) или VARCHAR(N)
«N» означает не максимальное число символов, которое может храниться в столбце CHAR или VARCHAR, а максимальное число байтов, которое займет тип данных. SQL Server имеет различные коллации для хранения символов. Некоторые наборы символов, подобные Latin, хранят каждый символ и одном байте пространства. В то время как другие наборы символов, например, японский, требуют нескольких байтов на символ.
Столбцы CHAR и VARCHAR могут хранить до 8000 байтов. Если используется односимвольный набор, то столбец CHAR или VARCHAR может хранить до 8000 символов. Если используется мультибайтовая коллация, максимальное число символов, которое может хранить CHAR или VARCHAR, будет меньше 8000. Обсуждение коллации выходит за рамки этой статьи, но если вы хотите больше узнать об однобайтовом и многобайтовыми наборами символов, обратитесь к документации.
Ошибка усечения
Если столбец определен как CHAR(N) или VARCHAR(N), «N» представляет число байтов, которое может храниться в столбце. При заполнении столбца CHAR(N) или VARCHAR(N) символьной строкой может возникнуть подобная ошибка усечения, показанная на рисунке 1.
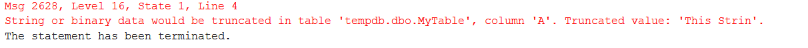
Рис.1 Ошибка усечения
Эта ошибка возникает при попытке сохранить строку, размер которой превышает максимальную длину столбца
CHAR или VARCHAR. Когда возникает подобная ошибка усечения, код TSQL прерывается, и последующий код не выполняется. Это можно продемонстрировать следующим кодом в листинге 1.
Листинг 1: код, приводящий к ошибке усечения
USE tempdb;
GO
CREATE TABLE MyTable (A VARCHAR(10));
INSERT INTO MyTable VALUES ('This String');
-- Продолжение
SELECT COUNT(*) FROM MyTable;
GO
Код в листинге 1 вызывает ошибку, показанную на рисунке 1, при выполнении оператора INSERT. Оператор SELECT, следующий за оператором INSERT, не был выполнен из-за ошибки усечения. Ошибка усечения и прерывание выполнения скрипта могут давать вам желаемую функциональность, но иногда вы не хотите получать ошибку усечения, прерывающую ваш код.
Предположим, что необходимо перенести данные из старой системы в новую. В старой системе есть таблица MyOldData, которая содержит данные, созданные с помощью скрипта в листинге 2.
Листинг 2: таблица в старой системе
USE tempdb;
GO
CREATE TABLE MyOldData (Name VARCHAR(20), ItemDesc VARCHAR(45));
INSERT INTO MyOldData
VALUES ('Widget', 'This item does everything you would ever want'),
('Thing A Ma Jig', 'A thing that dances the jig');
GO
Планируется перенести данные из таблицы MyOldData в таблицу MyNewTable, которая имеет меньший размер столбца ItemDesc. Код в листинге 3 используется для создания новой таблицы и переноса данных.
Листинг 3: перенос данных в новую таблицу
USE tempdb;
GO
CREATE TABLE MyNewData (Name VARCHAR(20), ItemDesc VARCHAR(40));
INSERT INTO MyNewData SELECT * FROM MyOldData;
SELECT * FROM MyNewData;
GO
При выполнении кода в листинге 3 вы получите ошибку усечения, подобную ошибке на рис.1, и никакие данные перенесены не будут.
Для успешного переноса данных необходимо определиться с тем, что делать с усечением, чтобы гарантировать перенос всех строк. Одним из методов является усечение описания элемента (ItemDesc) с помощью функции SUBSTRING при выполнении кода в листинге 4.
Листинг 4: Устранение ошибки усечения с помощью SUBSTRING
DROP Table MyNewData
GO
USE tempdb;
GO
CREATE TABLE MyNewData (Name VARCHAR(20), ItemDesc VARCHAR(40));
INSERT INTO MyNewData SELECT Name, substring(ItemDesc,1,40)
FROM MyOldData;
SELECT * FROM MyNewData;
GO
При выполнении кода в листинге 4 все записи переносятся. При этом ItemDesc превышающая 40 будет усекаться с помощью функции SUBSTRING, но есть и другой способ.
Если вы хотите избежать ошибки усечения без написания специального кода усечения столбцов, длина которых слишком велика, можно выключить параметр ANSI_WARNINGS, как показано в листнге 5.
Листинг 5: устранение ошибки усечения при выключении ANSI_WARNINGS.
DROP Table MyNewData
GO
USE tempdb;
GO
CREATE TABLE MyNewData (Name VARCHAR(20), ItemDesc VARCHAR(40));
SET ANSI_WARNINGS OFF;
INSERT INTO MyNewData SELECT * FROM MyOldData;
SET ANSI_WARNINGS ON;
SELECT * FROM MyNewData;
GO
При выключении параметра ANSI_WARNINGS ядро SQL Server не следует стандарту ISO для некоторых состояний ошибок, одним из которых является состояние ошибки усечения. При отключении этого параметра SQL Server автоматически усекает исходный столбец для соответствия его целевым столбцам без возвращения ошибки. Следует осторожно использовать выключение параметра ANSI_WARNINGS, поскольку при этом могут также остаться незамеченными другие ошибки. Поэтому изменение параметра ANSI_WARNINGS следует использовать ситуативно.
VARCHAR(MAX)
Тип данных VARCHAR(MAX) подобен типу данных VARCHAR в том, что он поддерживает символьные данные переменной длины. VARCHAR(MAX) отличается от VARCHAR тем, что он поддерживает строки символов длиной вплоть до 2 Гб (2,147,483,647 байтов). Вам следует рассмотреть использование VARCHAR(MAX) только тогда, когда каждая строка, сохраняемая в этом типе данных существенно варьируется по длине, и значение может превышать 8000 байтов.
Вы можете спросить себя, почему бы не использовать VARCHAR(MAX) везде вместо использования VARCHAR(N)? Вы можете, но имеется несколько причин, почему этого делать не стоит:
столбцы VARCHAR(MAX) не могут быть включены в ключевые столбцы индекса;
столбцы VARCHAR(MAX) не позволяют ограничить длину столбца;
для хранения больших строк столбцы VARCHAR(MAX) используют единицы распределения LOB_DATA. Хранилище LOB_DATA существенней медленней, чем использование единиц распределения хранилища IN_ROW_DATA;
хранилище LOB_DATA не поддерживает сжатие страниц и строк.
Можно подумать, что столбцы VARCHAR(MAX) будут устранять ошибку усечения, которую мы наблюдали ранее. Это частично верно при условии, что вы не пытаетесь сохранить строку со значением длинее, чем 2,147,483,647 байтов. Если вы попытаетесь записать строку, размер которой превышает 2,147,483,647 байтов, вы получите ошибку, показанную на рисунке 2.

Рис.2: ошибка, когда размер строки превышает 2 Гб
Столбцы VARCHAR(MAX) следует использовать только тогда, когда вы знаете, что некоторые сохраняемые данные будут ожидаемо превосходить 8000-байтовый предел для столбца VARCHAR(N), и все данные будут короче предела 2 Гб для типа данных VARCHAR(MAX).
Проблемы конкатенации со столбцами CHAR
Когда столбец CHAR не полностью заполнен строкой символов, неиспользованные символы замещаются пробелами. Когда столбец CHAR дополняется пробелами, это может вызвать некоторые проблемы при конкатенации столбцов CHAR. Для лучшего понимания рассматрим несколько примеров, которые используют таблицу, созданную в листинге 6.
Листинг 6: таблица для примеров Sample
USE tempdb;
GO
CREATE TABLE Sample (
ID int identity,
FirstNameChar CHAR(20),
LastNameChar CHAR(20),
FirstNameVarChar VARCHAR(20),
LastNameVarChar VARCHAR(20));
INSERT INTO Sample VALUES ('Greg', 'Larsen', 'Greg', 'Larsen');
Таблица Sample, созданная в листинге 6, содержит 4 столбца. Первые два определены как CHAR(20), а вторые два — VARCHAR(20). Эти столбцы будут использоваться для хранения моего имени и фамилии.
Для демонстрации проблем конкатенации, связанной с дополняемыми столбцами CHAR, выполните код в листинге 7.
Листинг 7: демонстрация проблемы конкатенации
SELECT FirstNameChar + LastNameChar AS FullNameChar,
FirstNameVarChar + LastNameVarChar AS FullNameVarChar FROM Sample;
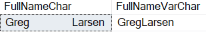
Результат выполнения кода в листнге 7
Здесь столбец FirstNameCHAR содержит несколько пробелов между именем и фамилией. Эти пробелы являются пробелами, дополненными в столбце FirstNameCHAR при сохранении имени в столбце типа CHAR. Столбец FullNameVARCHAR не содержит пробелов между именем и фамилией. Если длина записываемого значения меньше длины столбца VARCHAR, пробелы не добавляются.
При конкатенации столбцов CHAR вам может понадобиться удалить концевые пробелы, чтобы получить желаемый результат. Вы можете использовать функцию RTRIM для удаления пробелов, как показано в листинге 8.
Листинг 8: удаление концевых пробелов с помощью функции RTRIM
SELECT RTRIM(FirstNameChar) + RTRIM(LastNameChar) AS FullNameChar,
FirstNameVarChar + LastNameVarChar AS FullNameVarchar
FROM Sample;
Результат выполнения скрипта показан на рисунке ниже.
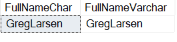
Пр использовани функции RTRIM все дополнительные пробелы, добавленные к столбцам FirstNameCHAR и LastNameCHAR удаляются перед выполнением конкатенации.
Проблемы с поиском пробелов в столбцах CHAR
Поскольку столбцы CHAR могут дополняться пробелами, поиск пробела может стать проблемой.
Предположим, что имеется таблица, содержащая фразы, подобные создаваемым в листинге 9.
Листинг 9: создание таблицы Phrase
USE tempdb;
GO
CREATE TABLE Phrase (PhraseChar CHAR(100));
INSERT INTO Phrase VALUES ('Worry Less'),
('Oops'),
('Think Twice'),
('Smile');
Некоторые фразы в таблице Phrase состоят из одного слова, а другие содержать два. Для поиска в таблице Phrase всех фраз, которые содержат два слова, воспользуемся кодом в листинге 10.
Листинг 10: попытка найти фразы из двух слов
SELECT PhraseChar FROM Phrase WHERE PhraseChar like '% %';
Результат выполнения скрипта показан ниже.

Почему были возвращены все фразы из таблицы Phrase, хотя имеется только две строки, состоящие из двух слов? Поисковая строка % % также находит пробелы, которые были добавлены в конце значения столбца. И опять, функция RTRIM может использоваться, чтобы гарантировать, что дополненные пробелы не будут включены в результаты поиска при выполнении кода в листинге 11.
Листинг 11: удаление концевых пробелов
SELECT PhraseChar FROM Phrase
WHERE RTRIM(PhraseChar) like '% %';
Вы можете сами проверить, что будут возвращены только фразы из двух слов.
Сравнение производительности VARCHAR и CHAR
Количество работы, которое выполняет движок базы данных при сохранении и извлечения столбцов VARCHAR, больше, чем для столбца CHAR. При каждом извлечении информации из столбца VARCHAR движок базы данных должен использовать информацию о длине, хранящуюся вместе с данными в столбце VARCHAR.
Использование информации о длине вызывает лишние циклы работы ЦП. В то же время фиксированная длина столбца CHAR позволяет SQL Server более легко выполнять навигацию по записям столбца CHAR, благодаря его фиксированной длине.
При работе со столбцами CHAR и VARCHAR проблемой может стать дисковое пространство. Поскольку столбец типа CHAR имеет фиксированную длину, он всегда будут занимать одинаковое пространство диска. Столбцы VARCHAR изменяются по размеру, поэтому необходимое пространство основывается на размере хранимых строк, а не на размере в определении столбца. Когда подавляющее большинство значений, хранимых в столбце CHAR, меньше заданного размера, то использование столбца VARCHAR может использовать меньше дискового пространства. Когда используется меньше дискового пространства, требуется меньше операций ввода/вывода при работе с данными столбца, что означает улучшение производительности. Эти два соображения определяют выбор между CHAR и VARCHAR.
CHAR, VARCHAR и VARCHAR(MAX)
Столбцы CHAR фиксированы по размеру, в то время как столбцы VARCHAR и VARCHAR(MAX) поддерживают данные переменной длины. Столбцы CHAR следует использовать для столбцов, длина которых меняется незначительно. Строковые значения, которые значительно варьируются по длине и не превышают 8000 байтов, следует хранить в столбце VARCHAR. Если у вас огромные строки (свыше 8000 байтов), то следует использовать VARCHAR(MAX). При использовании столбцов VARCHAR вместе с данными хранится информация о длине строки. Вычисление и хранение значения длины для столбца VARCHAR означает, что SQL Server должен выполнить немного больше работы для записи и извлечения столбцов VARCHAR по сравнению типом данных CHAR.
Когда вам предстоит решить, должен ли новый столбец иметь тип CHAR, VARCHAR или VARCHAR(MAX), задайте себе несколько вопросов, чтобы выбрать подходящий тип. Все ли сохраняемые строковые значения близки по размеру? Если да, то следует выбрать CHAR. Если сохраняемые строки значительно варьируются по размеру, и их размер не превышает 8000, используйте VARCHAR. В противном случае следует использовать VARCHAR(MAX).
Типы char, short, int и long
Целый тип char занимает в памяти 1 байт (8 бит) и позволяет выразить в двоичной системе счисления 2^8 значений=256. Тип char может содержать как положительные, так и отрицательные значения. Диапазон изменения значений составляет от -128 до 127.
uchar
Целый тип uchar также занимает в памяти 1 байт, как и тип char, но в отличие от него, uchar предназначен только для положительных значений. Минимальное значение равно нулю, максимальное значение равно 255. Первая буква u в названии типа uchar является сокращением слова unsigned (беззнаковый).
short
Целый тип short имеет размер 2 байта(16 бит) и, соответственно, позволяет выразить множество значений равное 2 в степени 16: 2^16=65 536. Так как тип short является знаковым и содержит как положительные, так и отрицательные значения, то диапазон значений находится между -32 768 и 32 767.
ushort
Беззнаковым типом short является тип ushort, который также имеет размер 2 байта. Минимальное значение равно 0, максимальное значение 65 535.
int
Целый тип int имеет размер 4 байта (32 бита). Минимальное значение -2 147 483 648, максимальное значение 2 147 483 647.
uint
Беззнаковый целый тип uint занимает в памяти 4 байта и позволяет выражать целочисленные значения от 0 до 4 294 967 295.
long
Целый тип long имеет размер 8 байт (64 бита). Минимальное значение -9 223 372 036 854 775 808, максимальное значение 9 223 372 036 854 775 807.
ulong
Целый тип ulong также занимает 8 байт и позволяет хранить значения от 0 до 18 446 744 073 709 551 615.
char ch= 12 ;
short sh=- 5000 ;
int in= 2445777 ;
Так как беззнаковые целые типы не предназначены для хранения отрицательных значений, то попытка установить отрицательное значение может привести к неожиданным последствиям. Вот такой невинный скрипт приведет к бесконечному циклу:
//— бесконечный цикл
void OnStart ()
<
uchar u_ch;
for ( char ch=-128;ch <128;ch++)
<
u_ch=ch;
Print ( «ch = » ,ch, » u_ch = » ,u_ch);
>
>
Правильно будет так:
//— правильный вариант
void OnStart ()
<
uchar u_ch;
for ( char ch=-128;ch <=127;ch++)
<
u_ch=ch;
Print ( «ch = » ,ch, » u_ch = » ,u_ch);
if (ch==127) break ;
>
>
ch= -128 u_ch= 128
ch= -127 u_ch= 129
ch= -126 u_ch= 130
ch= -125 u_ch= 131
ch= -124 u_ch= 132
ch= -123 u_ch= 133
ch= -122 u_ch= 134
ch= -121 u_ch= 135
ch= -120 u_ch= 136
ch= -119 u_ch= 137
ch= -118 u_ch= 138
ch= -117 u_ch= 139
ch= -116 u_ch= 140
ch= -115 u_ch= 141
ch= -114 u_ch= 142
ch= -113 u_ch= 143
ch= -112 u_ch= 144
ch= -111 u_ch= 145
.
//— отрицательные значения нельзя хранить в беззнаковых типах
uchar u_ch=-120;
ushort u_sh=-5000;
uint u_in=-401280;
Шестнадцатеричные: цифры 0-9, буквы а-f или А-F для значений 10-15; начинаются с 0х или 0Х.
0x0A , 0x12 , 0X12 , 0x2f , 0xA3 , 0Xa3 , 0X7C7
Типы данных в MySQL
В этой инструкции рассказываем про основные типы данных в MySQL и даем советы, где лучше использовать тот или иной тип.
Эта инструкция — часть курса «MySQL для новичков».
Смотреть весь курс
Введение
При создании таблиц в MySQL для каждого столбца нужно указывать тип данных. Он определяет, какие данные там могут храниться, как будут обрабатываться и сколько места будут занимать. В MySQL все типы данных делятся на несколько классов: числовые типы, символьные, дата/время и так далее. В каждом классе есть несколько типов данных, которые внешне могут быть похожи, но их поведение или принципы хранения отличаются. Важно выбрать правильный тип сразу при создании таблицы, потому что потом готовую структуру и приложения будет сложней переделать.
В этой статье мы расскажем об основных типах данных в MySQL и дадим советы, где лучше использовать тот или иной тип.
Возможности MySQL в «Облачных базах данных»
Числовые типы
Используются для хранения чисел. Бывают целочисленными, с плавающей точкой и с фиксированной точкой.
Целые числа
Хранят только целые числа, без дробной части. Делятся на signed (со знаком) и unsigned (без знака). Типы singed позволяют хранить как положительные, так и отрицательные значения. Типы unsigned хранят только положительные числа, но зато диапазон значений больше. Это может быть полезно в случаях, когда хранимые значения заведомо не могут быть отрицательным. Например, количество товара или идентификатор записи в таблице.
| Тип | Размер (байт) | Диапазон signed | Диапазон unsigned |
| TINYINT | 1 | -128 … 127 | 0 … 255 |
| SMALLINT | 2 | -3 2768 … 32 767 | 0 … 65 535 |
| MEDIUMINT | 3 | -8 388 608 … 8388607 | 0 … 16 777 215 |
| INT | 4 | 2 147 483 648 … 2 147 483 647 | 0 … 42 94 967 295 |
| BIGINT | 8 | -2 63 … 2 63 -1 | 0 … 2 64 -1 |
Числа с плавающей точкой
Хранят приблизительные значения. Не резервируют определенное количество бит для целочисленной или дробной частей. Поэтому у всех значений в таблице количество до и после запятой будет разным.
| Тип | Размер (байт) | Диапазон |
| FLOAT | 4 | -3.402823466E+38 … -1.175494351E-38 и 1.175494351E-38 … 3.402823466E+38 |
| DOUBLE | 8 | -1.7976931348623157E+308 … -2.2250738585072014E-308 и2.2250738585072014E-308 … 1.7976931348623157E+308 |
До версии MySQL 8.0.17 эти типы данных поддерживали диапазон unsigned, но он работал не так, как с целыми числами. Беззнаковый диапазон просто запрещал сохранять отрицательные значения, при этом максимальное значение не увеличивалось. Начиная с версии 8.0.17, использование unsigned не рекомендуется и считается устаревшим. В будущих версиях MySQL поддержку беззнакового диапазона для этого типа данных могут вовсе удалить.
Числа с фиксированной точкой
Эти типы данных используются для сохранения заданной точности. Такие числа резервируют определенное количество бит для целочисленной и дробной частей. Независимо от того, насколько большое или маленькое число, оно всегда будет использовать одно и то же количество бит для сохранения каждой части. Эти типы данных подходят для случаев, когда важна точность, например, деньги.
В MySQL для хранения чисел с фиксированной точкой используются типы DECIMAL(M,D) и NUMERIC(M,D), но по факту это синонимы. Можно использовать любой из этих типов, результат будет одинаковым. В таких столбцах максимально можно хранить до 65 чисел вместе с целочисленной и дробной частями.
Символьные (строковые)
Символьные типы используются для хранения текстов. Есть два основных типа: CHAR и VARCHAR. С точки зрения пользователя они выглядят похоже, но MySQL хранит и обрабатывает их по-разному.
- CHAR хранит строку фиксированной длины до 255 символов. Если длина вставляемой записи меньше, то MySQL автоматически дополняет значение пробелами. Например, если мы указали тип CHAR(10) и сохранили строку «Привет», то по факту в БД будет храниться строка «Привет » (обратите внимание на четыре пробела в конце строки).
Кажется, что это лишняя трата места. Но если во всех ваших записях хранятся строки примерно одной длины, то тип CHAR будет очень производительным. Например, его можно использовать для хранения хешей, у которых длина всегда одинакова.
- VARCHAR хранит строки переменной длины до 65 535 символов. Причем в памяти хранится именно та длина, которая была указана при создании. VARCHAR занимает меньше места, чем CHAR, но подвержен фрагментации и из-за этого может проигрывать в скорости обработки данных.
Текстовые и бинарные
Текстовые (TEXT) и бинарные (BLOB) типы данных используются для хранения больших объемов текста или двоичных данных. Эти типы похожи, но отличаются по способу хранения и обработки внутри MySQL.
- BLOB обрабатывается как двоичные данные. В нем не хранится набор символов, а операции сортировки и сравнения основаны на числовых значениях байтов.
- TEXT обрабатывается как символьные строки. В нем хранится именно набор символов, а значения сортируются и сравниваются на основе сопоставления набора символов..
Текстовые типы отлично подходят для хранения больших текстов: статей, докладов и так далее. А бинарные типы могут хранить любые файлы или мультимедиа-контент.
| Тип | Размер (байт) | Макс. размер символов |
| TINYTEXT / TINYBLOB | 255 | 255 |
| TEXT / BLOB | 65 535 | 65 535 |
| MEDIUMTEXT / MEDIUMBLOB | 16 777 215 | 2 24 -1 |
| LONGTEXT / LONGBLOB | 4 294 967 295 | 2 32 -1 |
Кажется, что типы TINYTEXT и TEXT похожи на CHAR и VARCHAR. Но разница в том, что MySQL не умеет индексировать текстовые и бинарные типы и не может использовать индексы для сортировки.
Дата/время
Типы данных, которые позволяют работать с датой и временем.
| Тип | Размер (байт) | Описание |
| DATE | 3 | Только дата в формате YYYY-MM-DD. Допустимые значения от 1000-01-01 до 9999-12-31 |
| DATETIME | 8 | Дата и время в формате YYYY-MM-DD HH:MM:SS. Допустимые значения от 1000-01-01 00:00:00 до 9999-12-31 23:59:59 |
| TIMESTAMP | 4 | Дата и время. Хранится в виде количества секунд, прошедших с 1 января 1970 года по гринвичу. Занимает в два раза меньше места, чем тип DATETIME. Но при этом диапазон ограничен значениями от 1970-01-01 00:00:01 до 2038-01-09 03:14:07 |
| TIME | 3 | Только время в формате HH:MM:SS. Допустимые значения от 00:00:00 до 23:59:59 |
| YEAR(N) | 1 | Только год в формате YYYY или YY. Допустимые значения от 1901 до 2155 или от 70 до 69 (1970 — 2069) |
JSON
Это относительно новый тип данных, который появился в MySQL версии 5.7.8. Он позволяет нативно хранить и обрабатывать данные в JSON-формате.
В отличие от хранения объектов в виде текста, в использовании специального типа данных есть несколько преимуществ:
- Валидация JSON-объектов. Если попытаться сохранить неправильный JSON, MySQL сгенерирует ошибку.
- Возможность нативно работать с JSON, выбирать и обновлять только отдельные части объектов, а не весь объект целиком.
- MySQL сохраняет тип JSON в специальном внутреннем формате. Такой способ более производительный, чем работа с JSON в виде строки.
Составные типы
Строковые типы данных, которые могут хранить значения только из заранее определенного списка. Несмотря на то, что список значений состоит из строк, в самих таблицах хранятся только числа, которые ассоциированы со справочником возможных значений. Поэтому они занимают мало места.
- ENUM может хранить только одно значение из списка, занимает 1-2 байта.
- SET может хранить одновременно до 64 значений из списка, занимает от 1 до 8 байт.
Заключение
Мы рассмотрели основные типы данных и полей в MySQL, объяснили разницу между схожими типами. Теперь вы можете создавать свои структуры БД, используя полученные знания.
Создание базы данных в MySQL
CHAR или VARCHAR? А может быть BLOB?
На диске запись всегда упаковывается. То есть, концевые пробелы не имеют никакого значения с точки зрения дискового пространства.
Количество концевых пробелов учитывается только для varchar. Значение char «добивается» пробелами до объявленной длины только тогда, когда с ним производятся операции присвоения или передача данных на сторону клиента.
Поэтому с точки зрения эффективности хранения различия между char и varchar практически нет. И для работы нужно выбирать то, что удобнее. Как правило это varchar.
Клиентские компоненты могут (или не могут) осуществлять обрезание концевых пробелов для столбцов CHAR. В зависимости от склонностей разработчика такого набора обрезание пробелов может быть по умолчанию, а может и потребовать установки в True какого-либо свойства или на уровне DataSet, или на уровне конкретного поля (TStringField). Поэтому, если вас замучили концевые пробелы в строках, посмотрите на свойства компонент.
Нужно отметить, что ни BDE ни dbExpress не могут выполнять обрезание концевых пробелов у строк.
Поля типа BLOB
Поля этого типа позволяют хранить безразмерную произвольную двоичную информацию (поэтому поля типа BLOB не имеют свойства «набор символов»). Запись на диск производится сегментами. Дисковый сегмент блоба это вовсе не то, что имеется в виду при объявлении столбца BLOB (SEGMENT SIZE xx). Сервер сам разбирается, как хранить конкретное значение blob на диске. Указание размера сегмента при объявлении столбца BLOB не даст никакого выигрыша или проигрыша в производительности. Оно нужно только для приложений, написанных на C (Embedded SQL) при помощи GPRE. Например, в IBX размер буфера для чтения-записи blob определен жестко в 16К, и именно такими «сегментами» оперирует IBX. Поэтому определять размер сегмента при объявлении blob не имеет смысла.
Существуют предопределенные подтипы (SUB_TYPE) BLOB: 0 – двоичные данные, 1 – текстовые данные. На самом деле разницы между ними нет, и подтип имеет значение только для вашего приложения (или при написании фильтров BLOB). Пользовательские подтипы можно определить, указав SUB_TYPE с отрицательным знаком – -1, -2, -10, -200 и т. д., и опять же это имеет значение только для приложения, работающего с данными или для фильтра.
Сегменты BLOB всегда записываются на свободное пространство, и занимают только действительный объем данных BLOB.
Если размер BLOB превышает размер страницы, то создается массив указателей на страницы BLOB. При очень больших размерах BLOB могут появиться указатели на страницы указателей BLOB.
При изменении записи, если содержимое blob не менялось, его blobID остается тем же самым. Собственно, в новой версии записи пишутся только те поля, которые были изменены. Следовательно, при модификации записи, если не затронуто поле BLOB, данные blob не «дублируются». Если же блоб меняется, то как и версия записи, он находится на диске в двух экземплярах – старом и новом. Учитывайте это для блобов, хранящих большой объем данных.
Примечание. Индексировать по полям BLOB невозможно.
CHAR или BLOB?
- Если длина поля < 255 символов, то
- лучше использовать VARCHAR – по хранению varchar на 2 байта больше char, зато в приложениях не надо писать отрезание концевых пробелов у строк.
- в старых версиях IB при использовании VARCHAR могут возникнуть проблемы с производительностью при использовании протокола TCP/IP.
- не имеет смысла использовать BLOB – выборка BLOB осуществляется по его идентификатору, поэтому происходит чуть дольше и требует немного больше затрат на программирование.
- Можно использовать как CHAR или VARCHAR, так и BLOB. Индексирование по полями такой длины невозможно, к тому же есть шанс что однажды записываемые данные превысят 10000 символов, и может быть BLOB подойдет больше. Ориентируйтесь только на удобство работы с такими данными в приложении.
- лучше использовать BLOB. Подтип может быть любой, информацию в таком поле можно хранить произвольную и не беспокоиться о размере данных. Стоимость доступа к данным такого размера полностью компенсирует разницу в способах хранения и извлечения полей типа CHAR и BLOB.
Конвертация данных
В Firebird и Yaffil, в 3-м диалекте появилась возможность при insert (update?) содержимое блоба задавать обычной строкой. В остальных серверах при подобных действиях будет выдано стандартное сообщение о невозможности конвертации данных.
Вместе с тем уже давно существуют UDF перевода блоба в строку и обратно (FreeUDFLib и другие).
Возможные проблемы
Индексирование
- Строковые независимо от типа поля имеют ограничение на длину индекса – 84 байта при указании COLLATE и 252 байта – без COLLATE.
- BLOB-поля не могут быть проиндексированы.
Поиск
- Для поиска по полям типа CHAR, VARCHAR и BLOB можно использовать операторы STARTING WITH (начинается с), LIKE (начинается, содержит, или заканчивается на) и CONTAINING (содержит). В BLOB этими операторами можно искать произвольную информацию (необязательно текстовую), однако необходимо учитывать что поиск в BLOB может осуществляться только перебором записей.
- Если поиск производится по окончанию, например, LIKE ‘%ов’, то такой запрос по полю CHAR выдаст 0 записей, если длина значения поля хотя бы на один символ меньше объявленной длины поля. Это происходит потому, что CHAR при сравнении добивается до длины поля пробелами, и получается, что ‘Иванов ‘ не подходит под условие поиска ‘%ов’. Для решения этой проблемы нужно пользоваться VARCHAR
- Поиск или упорядочивание (ORDER BY) с использованием функции UPPER возможен только для полей типа CHAR или VARCHAR, т. к. только они имеют свойство CHARACTER SET (BLOB содержит только произвольную двоичную информацию, т. е. необязательно текстовую). Кроме того, для UPPER поля CHAR и VARCHAR должны иметь соответствующий COLLATE либо в объявлении типа поля, либо в выражении поиска или сортировки.
Примечание. Вы можете написать собственную функцию, аналогичную UPPER, и избежать указанной проблемы.
Выборка данных
- При конкатенации строковых полей в запросе нужно учитывать, что CHAR-поля будут «расширены» до указанной длины пробелами, а VARCHAR – нет. Например, если в запросе производится «сборка» фамилии, имени и отчества
select last_name||first_name||middle_name from clients
то результат будет приблизительно такой: «Иванов Иван Иванович». А если это будут VARCHAR-поля, то такой же запрос выдаст результат в виде «ИвановИванИванович».
Для решения этой проблемы можно для CHAR использовать UDF (типа RTrim), а для VARCHAR – вставлять дополнительные пробелы (||» «||).
- Для многоязыковых баз данных BLOB не могут быть перекодированы из одной кодировки в другую. Например, если сервер поддерживает кодировки WIN1251 и KOI8R, и база создана в WIN1251, возможно подключиться (через компоненты прямого доступа) указывая lc_ctype=KIO8R в параметрах коннекта. При этом информация будет перекодироваться из win1251 в koi8r и наоборот для всех строковых типов данных, кроме BLOB. Для конвертации данных blob хотя бы при выборке придется написать собственную UDF.
Вставка и модификация данных
- Поля BLOB невозможно передавать как параметр запроса или хранимой процедуры в BDE 2.5x и 3.x (такая возможность появилась только в BDE 4.0 и у компонент Delphi 3.0). Это приводит к необходимости использования TQuery и передачи данных в BLOB-поля через TBlobStream. Сам сервер не имеет проблем с получением или передачей blob в виде параметров запроса или параметров процедур.
Создание переносимой базы данных
- Стандарт ANSI SQL в частности определяет типы полей, но безусловно реализация этих типов, способ хранения и обработки определяет изготовитель конкретного SQL-сервера. Для обеспечения хоть какой-то возможной переносимости следует пользоваться совместимыми типами, игнорируя преимущества использовани типов данных (например CHAR в InterBase). Вам необходимо обратиться к документации или справочным файлам BDE (BDE32.HLP), для того чтобы определить совместимость различных типов между выбранными вами SQL-серверами.
Copyright iBase.ru © 2002-2023