String Pool в Java
Java даёт выбор между примитивными типами данных и объектными. Одни передаются по значению, другие по ссылке. Одни занимают предсказуемое количество памяти, другие не очень (конечно только если Вы не знаете размеры метаинформации класса, для которого хотите произвести расчёт). Под одних память выделяется на стеке, под другие в heap’е. Они сильно отличаются друг от друга
Элементы в пределах своего типа (примитивный или объектный) ведут себя похоже, независимо от конкретного типа данных. Значения int ведут себя так же, как и значения типа short. В объектных типах данных схожая ситуация. Но есть исключения. Например — объектный тип String.
Что такое String?
String — это класс в Java, то есть объектный тип. Он описывает строки и хранит их данные в массиве char.
Оговорка:
Тип char используется в старых версиях Java, например 8-ой. В Java 11 используется уже массив byte’ов.
Сколько памяти занимает String? Примитивный тип char в Java имеет размер 2 byte’а. То есть один символ занимает в памяти 2 байта. Теперь представьте — каждый раз когда мы используем строку в Java, будь-то имя пользователя или ссылку на какой-либо сайт, мы создаём в системе большой массив char. Это занимает память. В объектных типах помимо всех ссылок на объекты и примитивов, память занимает ещё и заголовочная информация класса.
Зачем это знать? Строки — самый популярный тип данных в Java. Огромное количество данных описывается строками. Ещё более интересн тот факт, что строки в одних и тех же программах часто повторяются.
String — это immutable тип. То есть, после создания объекта этого типа поменять его значение нельзя. Отсюда делаем вывод — смысла в создании новых объектов типа String со значениями, для которых объекты уже были созданы — нет. Это не целесообразно, потому что каждый раз выделять память под одно и тоже, что ещё и не возможно изменить — чревато чрезмерным потреблением памяти.
Создатели Java заранее позаботились об этой проблеме и сделали тип String не совсем обычным объектным типом.
Что такое строковый пул?
Строковый пул или String pool — это особое место в heap’е, куда попадают объекты типа String после их создания. Он выполняет функцию кеша строк. Каждый раз, когда Вы создаёте строку, она попадает в строковый пул. Если же на момент создания новой строки пул уже содержит такое же значение, то вместо создания нового объекта возвращается тот, что уже лежит в пуле.
У Вас есть возможность влиять на это поведение и не класть объекты в пул, если требуется.
Как работать со строковым пулом?
Разберёмся с тем как работает String pool на практике.
Обычно строки в Java программах объявляются так:
String text = “Hello World”;
Что происходит в JVM за кадром? Остановитесь и подумайте. Если Вашим ответом будет что-то вроде — «В heap’е будет выделена память под строковый объект и ссылка на него будет возвращена и присвоена локальной переменной text» — Вы правы.
String text = “Hello World”;
String text2 = “Hello World”;
А что произойдёт тут? Если Вы думаете, что на обе локальные переменные будет выделена память в heap’е — Вы ошибаетесь. Именно в этом примере и видно результат работы пула строк.
В Java все строки, объявленные в виде литералов, то есть так:
“My String”
автоматически попадают в строковый пул. Любая попытка объявить новую переменную задав ей значение с помощью литерала приводит к тому, что JVM проверяет наличие такой строки в пуле строк и возвращает объект из него, если объект с таким значением обнаружен.
Как убедиться в том, действительно ли обе переменные указывают на один и тот же объект? Очень просто. Достаточно посмотреть что будет выведено в результате следующей операции:
System.out.println(text == text2);
Не спешите набирать код, я Вам подскажу — ответом будет `true`. Это означает — обе переменные указывают на один и тот же объект.
А как тогда сделать так, чтобы строки в пул не попадали? Это тоже сделать просто. Используйте конструктор явно при создании строк. Вот так:
String text = new String(“text”);
В этом случае, объект типа String будет создан, память под него будет выделена в heap’е, но в строковый пул он не попадёт. Это легко проверяется следующим примером:
String text = “Hello World”;
String text2 = new String(“Hello World”);
System.out.println(text == text2);
Результатом работы кода выше будет `false`, потому что теперь ссылки указывают на два разных объекта.
Ну и наконец, как добавить строку в строковый пул после её создания? Для этого класс String содержит метод под названием `intern()`. Именно он отвечает за сохранение текущего объекта String в пул строк. Пример использования:
String text = “Hello World”;
String text2 = new String(“Hello World”);
System.out.println(text == text2); // выведет falsetext2 = text2.intern(); // попытается положить текущую строку в пул строк, обнаружит что такое значение уже там есть и вернёт объект из строкового пула. То есть тот, на который указывает переменная text
System.out.println(text == text2); // выведет true
Зачем знать о строковом пуле?
Строковый пул несёт не только пользу. Если не знать о его существовании и принципах работы, можно легко получить дыру в безопасности приложения. Сделать это довольно просто — достаточно добавить в пул какой-нибудь пароль или логин. Содержимое строкового пула доступно в memory dump’ах, к которым Вы или кто-то другой может получить доступ.
Надеюсь эта статья поможет Вам писать код более осознанно, ведь, теперь Вы знаете, что за строками в Java стоит String pool.
Что такое пул строк в Java?

Пул строк (String Pool) — это множество строк в кучи (Java Heap Memory). Мы знаем, что String — особый класс в java, с помощью которого мы можем создавать строковые объекты.
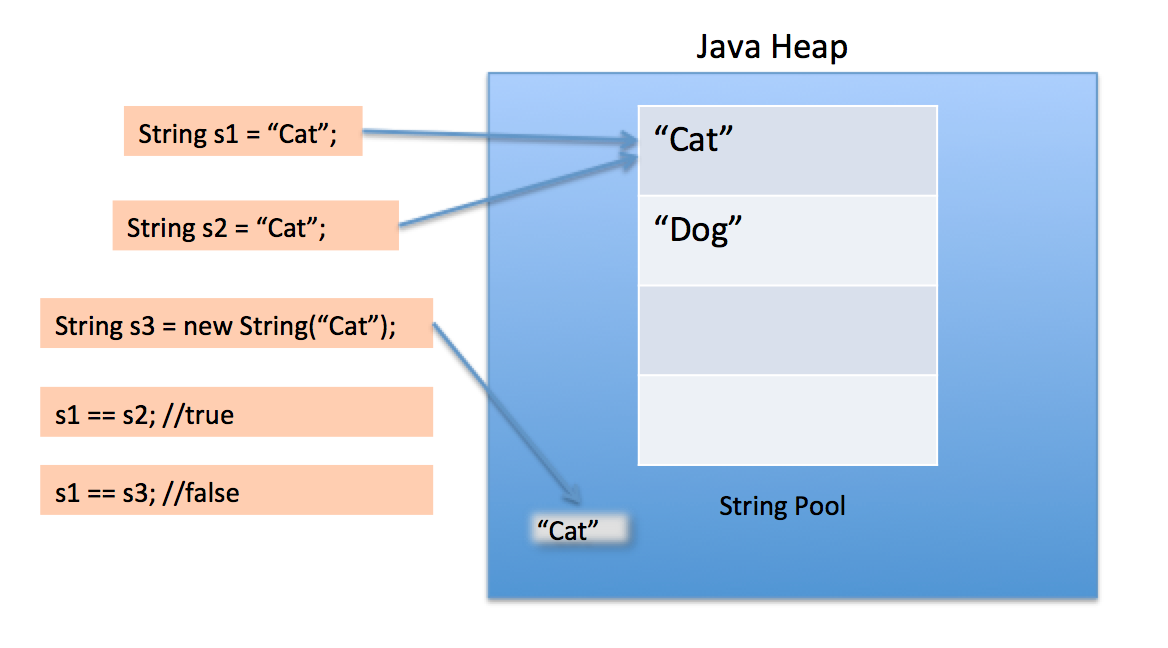
На диаграмме ниже мы видим как именно строковый пул расположен в памяти Java Heap. И как разные способы создания строк влияют на расположение их в памяти.

Сам строковый пул возможен только потому, что строки в Java неизменные. Также пул строк позволяет сохранить память в Java Runtime, хотя это и требует больше времени на создание самой строки.
Пример работы с пулом строк
Когда мы используем двойные кавычки, чтобы создать новую строку, то первым делом идет поиск строки с таким же значением в пуле строк. Если java такую строку нашла, то возвращает ссылку, в противном случае создается новая строка в пуле, а затем возвращается ссылка.
Однако использование оператора new заставляет класс String создать новый объект String. После этого можем использовать метод intern() , чтобы поместить этот объект в пул строк или обратиться к другому объекту из пула строк, который имеет такое же значение.
Ниже приведена программа, которая демонстрирует работу с пулом строк:
Руководство по пулу строк Java
Объект String является наиболее часто используемым классом в языке Java.
В этой быстрой статье мы рассмотрим пул строк Java — специальную область памяти, в которой JVM хранит строки .
2. Стажировка строк
Благодаря неизменности строк в Java, JVM может оптимизировать объем выделяемой для них памяти, сохраняя в пуле только одну копию каждой литеральной строки . Этот процесс называется интернированием .
Когда мы создаем переменную String и присваиваем ей значение, JVM ищет в пуле строку с равным значением.
Если он найден, компилятор Java просто вернет ссылку на свой адрес памяти, не выделяя дополнительной памяти.
Если он не найден, он будет добавлен в пул (интернирован), и его ссылка будет возвращена.
Давайте напишем небольшой тест, чтобы проверить это:
String constantString1 = "ForEach"; String constantString2 = "ForEach"; assertThat(constantString1) .isSameAs(constantString2); 3. Строки , выделенные с помощью конструктора
Когда мы создаем String с помощью оператора new , компилятор Java создаст новый объект и сохранит его в пространстве кучи, зарезервированном для JVM.
Каждая строка , созданная таким образом, будет указывать на другую область памяти со своим собственным адресом.
Давайте посмотрим, чем это отличается от предыдущего случая:
String constantString = "ForEach"; String newString = new String("ForEach"); assertThat(constantString).isNotSameAs(newString); 4. Строковый литерал против строкового объекта
Когда мы создаем объект String с помощью оператора new() , он всегда создает новый объект в куче памяти. С другой стороны, если мы создадим объект, используя синтаксис строкового литерала, например, « ForEach », он может вернуть существующий объект из пула строк, если он уже существует. В противном случае он создаст новый объект String и поместит его в пул строк для повторного использования в будущем.
На высоком уровне оба являются объектами String , но основное различие заключается в том, что оператор new() всегда создает новый объект String . Кроме того, когда мы создаем строку , используя литерал, она интернируется.
Это станет намного яснее, если мы сравним два объекта String , созданные с использованием литерала String и оператора new :
String first = "ForEach"; String second = "ForEach"; System.out.println(first == second); // True В этом примере объекты String будут иметь одну и ту же ссылку.
Далее создадим два разных объекта с помощью new и проверим, что у них разные ссылки:
String third = new String("ForEach"); String fourth = new String("ForEach"); System.out.println(third == fourth); // False Точно так же, когда мы сравниваем литерал String с объектом String, созданным с помощью оператора new() с помощью оператора ==, он вернет false:
String fifth = "ForEach"; String sixth = new String("ForEach"); System.out.println(fifth == sixth); // False В общем, мы должны использовать литеральную нотацию String , когда это возможно . Его легче читать, и он дает компилятору возможность оптимизировать наш код.
5. Стажировка вручную
Мы можем вручную интернировать строку в пуле строк Java, вызвав метод intern() для объекта, который мы хотим интернировать.
Интернирование строки вручную сохранит ее ссылку в пуле, и JVM вернет эту ссылку при необходимости.
Давайте создадим тестовый пример для этого:
String constantString = "interned ForEach"; String newString = new String("interned ForEach"); assertThat(constantString).isNotSameAs(newString); String internedString = newString.intern(); assertThat(constantString) .isSameAs(internedString); 6. Сбор мусора
До Java 7 JVM помещала Java String Pool в пространство PermGen , которое имеет фиксированный размер — его нельзя расширить во время выполнения и нельзя использовать для сборки мусора .
Риск интернирования Strings в PermGen (вместо Heap ) заключается в том, что мы можем получить ошибку OutOfMemory от JVM, если интернируем слишком много Strings .
Начиная с Java 7, пул строк Java хранится в пространстве кучи , которое является мусором , собираемым JVM . Преимущество этого подхода заключается в снижении риска ошибки OutOfMemory , поскольку строки , на которые нет ссылок , будут удалены из пула, тем самым освобождая память.
7. Производительность и оптимизация
В Java 6 единственная оптимизация, которую мы можем выполнить, — это увеличение пространства PermGen во время вызова программы с параметром JVM MaxPermSize :
-XX:MaxPermSize=1G В Java 7 у нас есть более подробные параметры для проверки и расширения/уменьшения размера пула. Рассмотрим два варианта просмотра размера пула:
-XX:+PrintFlagsFinal -XX:+PrintStringTableStatistics Если мы хотим увеличить размер пула с точки зрения сегментов, мы можем использовать параметр StringTableSize JVM:
-XX:StringTableSize=4901 До Java 7u40 размер пула по умолчанию составлял 1009 сегментов, но в более поздних версиях Java это значение претерпело некоторые изменения. Если быть точным, размер пула по умолчанию от Java 7u40 до Java 11 составлял 60013, а теперь он увеличился до 65536.
Обратите внимание, что увеличение размера пула потребует больше памяти, но имеет то преимущество, что сокращает время, необходимое для вставки строк в таблицу.
8. Примечание о Java 9
До Java 8 строки были внутренне представлены как массив символов — char[] , закодированный в UTF-16 , так что каждый символ использует два байта памяти.
В Java 9 предоставляется новое представление, называемое компактными строками. Этот новый формат выберет подходящую кодировку между char[] и byte[] в зависимости от сохраненного содержимого.
Поскольку новое представление String будет использовать кодировку UTF-16 только при необходимости, объем памяти кучи будет значительно меньше, что, в свою очередь, приведет к меньшим накладным расходам сборщика мусора на JVM.
9. Заключение
В этом руководстве мы показали, как JVM и компилятор Java оптимизируют выделение памяти для объектов String через Java String Pool.
Все примеры кода, использованные в статье, доступны на GitHub .
Бассейн со строками
Бывает так, что долго-долго собираюсь написать про какую-то тему и не нахожу на это время, а потом приходит человек и задает на эту тему вопрос (спасибо тебе, человек!), после которого находятся силы и время сделать разбор интересной темы.
Речь пойдет об организации памяти в JVM и таком явлении как String pool, а также почему нельзя так просто взять и удалить секретную информацию из памяти android приложения.
Внутри много картинок!
Очень поверхностный ликбез
Все строки в JVM являются неизменяемыми и создаются в области памяти, которая называется “куча” (heap). Внутри кучи есть еще одна область памяти, которая называется string pool. В эту область памяти, строки попадают автоматически, если создаются с помощью двойных кавычек. Строки могут быть также помещены в эту область памяти вручную при вызове метода intern() , а сам процесс помещения строк в пул называется интернированием.
- Содержимое строк нельзя менять. При перезаписи строкового значения, будет создан новый объект, а старый ждет пока его соберет сборщик мусора.
- Сборщик мусора не собирает строки из пула
Эти оба два нюанса приводят к очень неприятным последствиям с точки зрения безопасности — невозможности гарантированно удалить строки из памяти приложения. А значит все токены, пароли и прочая конфиденциальная информация будет находиться в памяти приложения непредсказуемое количество времени. Почитать про пул строк более подробно можно по ссылке в конце статьи, а сейчас разберем на практических примерах как работает вся эта кухня и рассмотрим возможные решения этой проблемы.
Погружение в проблему
Чтобы наше путешествие в глубины JVM было удачным, нужно подготовить инструменты для создания дампов и последующего анализа памяти. Для создания дампов я использую самописный скрипт на bash:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 #!/bin/bash if [ -z $1 ] then echo "Usage: ./dumper " exit fi if ! command -v adb &> /dev/null then echo "adb could not be found. Add your \$ANDROID_HOME/platform-tools to PATH" exit fi if ! command -v hprof-conv &> /dev/null then echo "hprof-conv could not be found. Add your \$ANDROID_HOME/platform-tools to PATH" exit fi DEFAULT_HPROF_FILE=dump_$(date +%s).hprof adb shell am dumpheap $(adb shell ps | grep $1 | awk '') /data/local/tmp/$DEFAULT_HPROF_FILE && adb pull /data/local/tmp/$DEFAULT_HPROF_FILE && hprof-conv -z $DEFAULT_HPROF_FILE $1.hprof && adb shell "rm /data/local/tmp/$DEFAULT_HPROF_FILE" if [[ -f $1.hprof ]] then echo "���� Dumped to: $1.hprof" else echo "�� Something went wrong!" fi А для разных этапов анализа нам понадобятся следующие инструменты:
- Утилита strings и ее ближайший друг grep
- Android Studio Memory Profiler
- Парсер hprof файлов
Как это все будет задейстовано я покажу далее, а пока начнем с очень простого и надуманного примера.
Тому, кто захочет это повторить — придется делать очень много дампов. Более ленивых людей призываю просто наслаждаться происходящим 😉
Простой, надуманный пример
var token = "super_secret_token1337" Log.d("Debug", token) token = "" System.gc() Log.d("Debug", token) Результат работы этого кода довольно предсказуем:

Был токен и не стало. Но, не все так однозначно. Давайте сделаем дамп памяти запущенного приложения и поищем в ней этот токен.
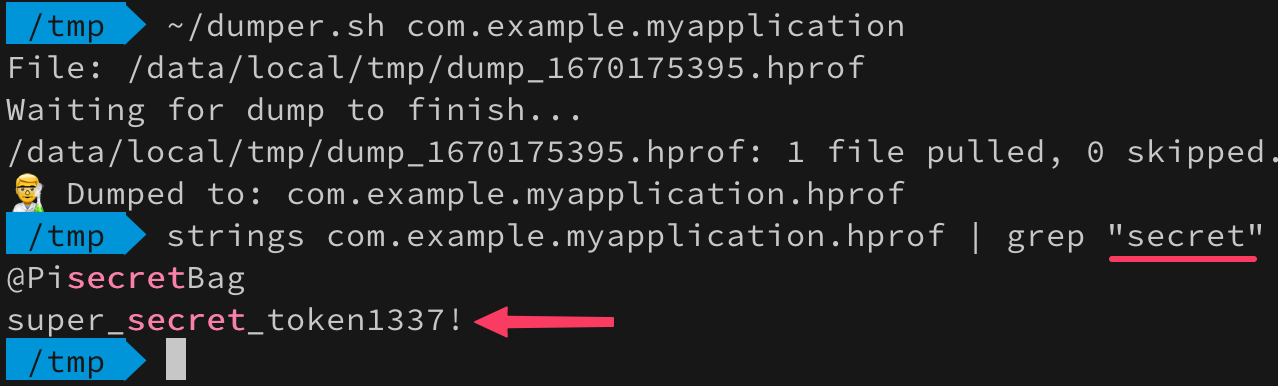
Строковый литерал предсказуемо оказался в пуле строк и даже принудительная сборка мусора не смогла его оттуда удалить. Используя знания полученные о том, что строки созданные с помощью конструктора в пул автоматически не попадают, попробуем сделать так чтобы наш секретный токен не оседал в памяти. Собирать строку будем через CharArray , чтобы вообще отказаться от строковых литералов.
var token = String( charArrayOf( 's', 'u', 'p', 'e', 'r', '_', 's', 'e', 'c', 'r', 'e', 't', '_', 't', 'o', 'k', 'e', 'n', '1', '3', '3', '7' ) ) Log.d("Debug", token) token = "" System.gc() Log.d("Debug", token) 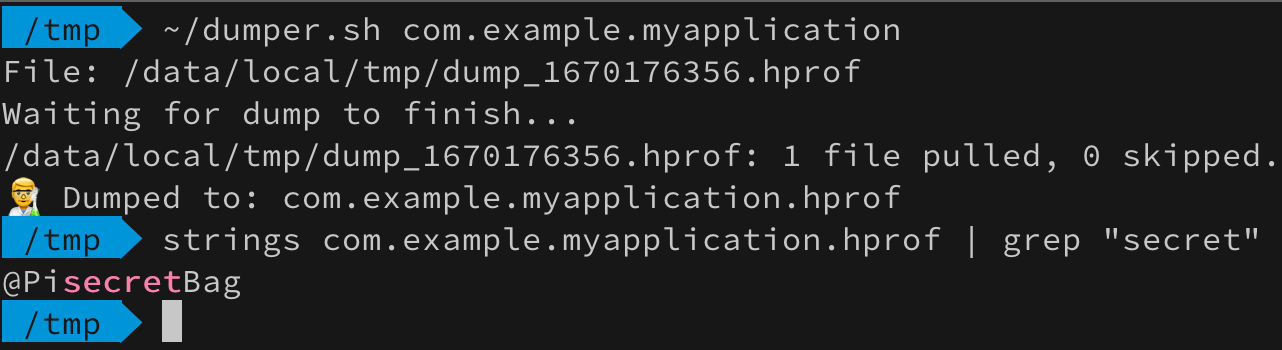
Гипотеза сработала! CharArray всех спас! На этом можно было бы закончить статью фразой “Используйте CharArray и да пребудет с вами безопасность”. Но давайте не будем торопиться с выводами. Немного модифицируем код и поменяем содержимое токена для наглядности:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 var token = String( charArrayOf( 'n', 'o', 't', '_', 's', 'o', '_', 's', 'e', 'c', 'r', 'e', 't', '_', 't', 'o', 'k', 'e', 'n', '1', '3', '3', '7' ) ) val hw = findViewByIdTextView>(R.id.hworld) hw.setOnClickListener Toast.makeText(this, "$token", Toast.LENGTH_SHORT).show() token = "" System.gc() > Запускаем приложением, нажимаем на TextView и…
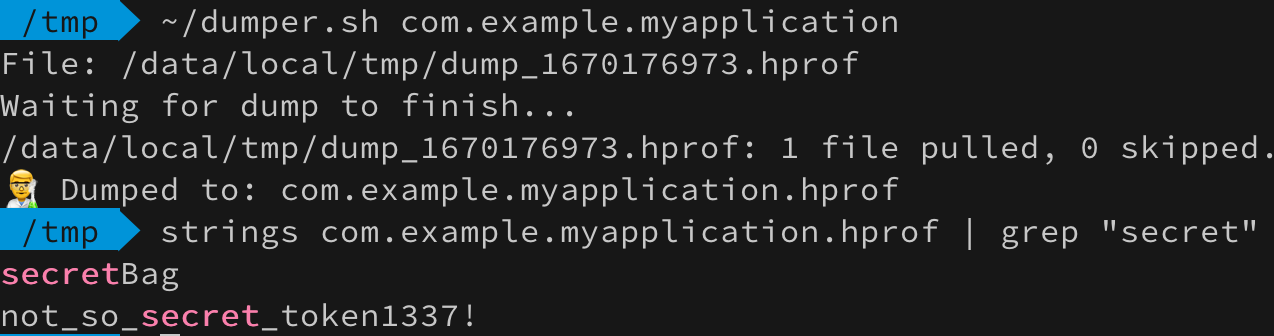
Упс… А вот и магия Хогвартса перестала работать =( Почему так произошло? Давайте разберемся. Для этого нужно загрузить дамп в профилировщик Android Studio и найти ту самую строку чтобы посмотреть ссылки на нее.
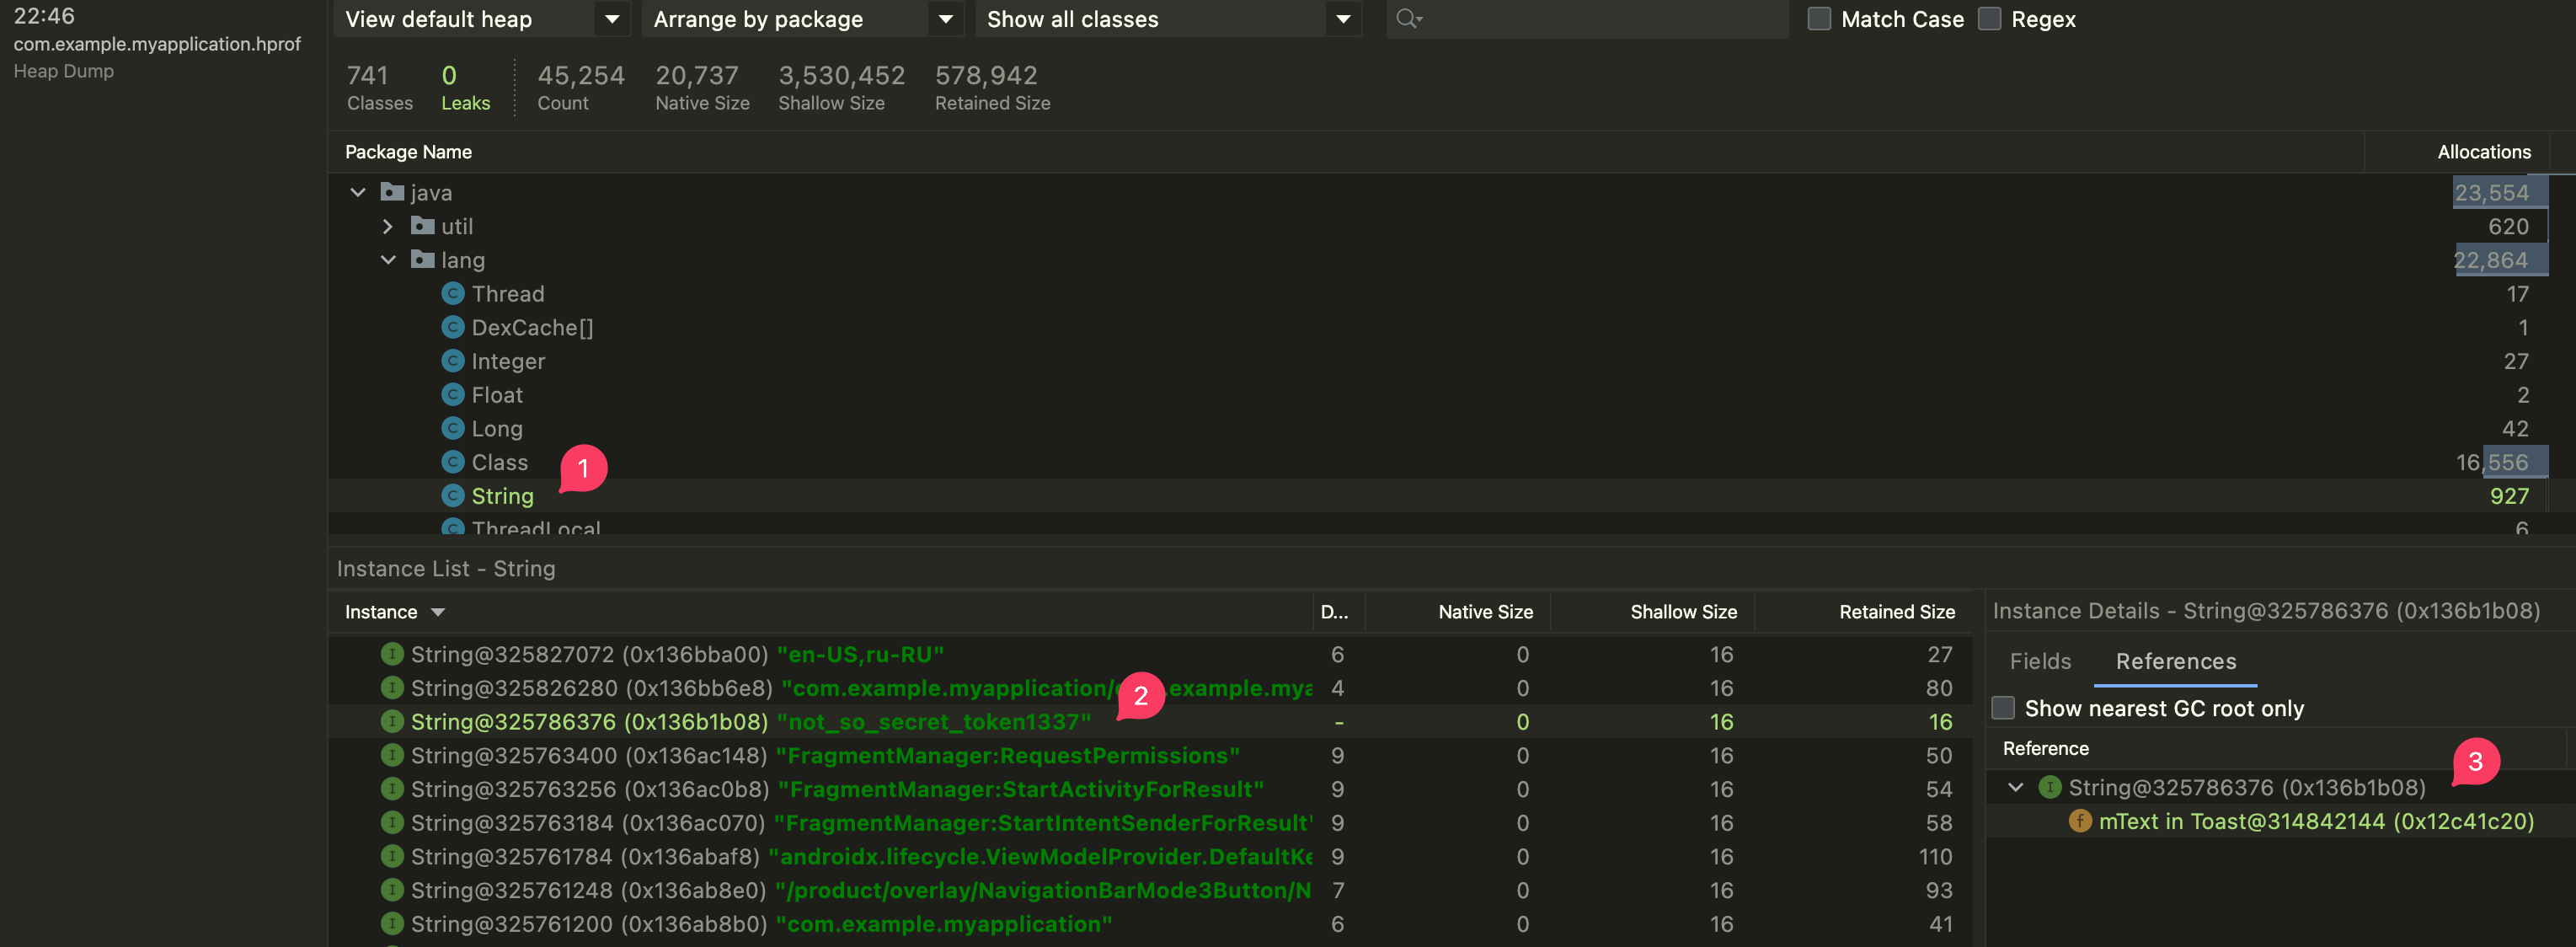
А вот и причина — строка утекла через поле mText класса Toast . Но как так вышло?! Опытные android разработчики и прочие java-джедаи уже знают ответ. Для всех остальных, я открою страшный секрет: параметры в Java всегда передаются по значению. Другими словами — методы работают с копией данных, а не с оригиналом.
Более жизненный пример
До этого строки создавались “руками”, и у вас могли появиться сомнения в адекватности проводимых исследований. Все верно. Всегда нужно сомневаться в том, что читаешь в интернете! Поэтому все дальнейшие исследования будем проводить на классическом, клиент-серверном приложении, которое получает токены от сервера по https и сохраняет их в зашифрованном виде. Приложение забирайте тут.
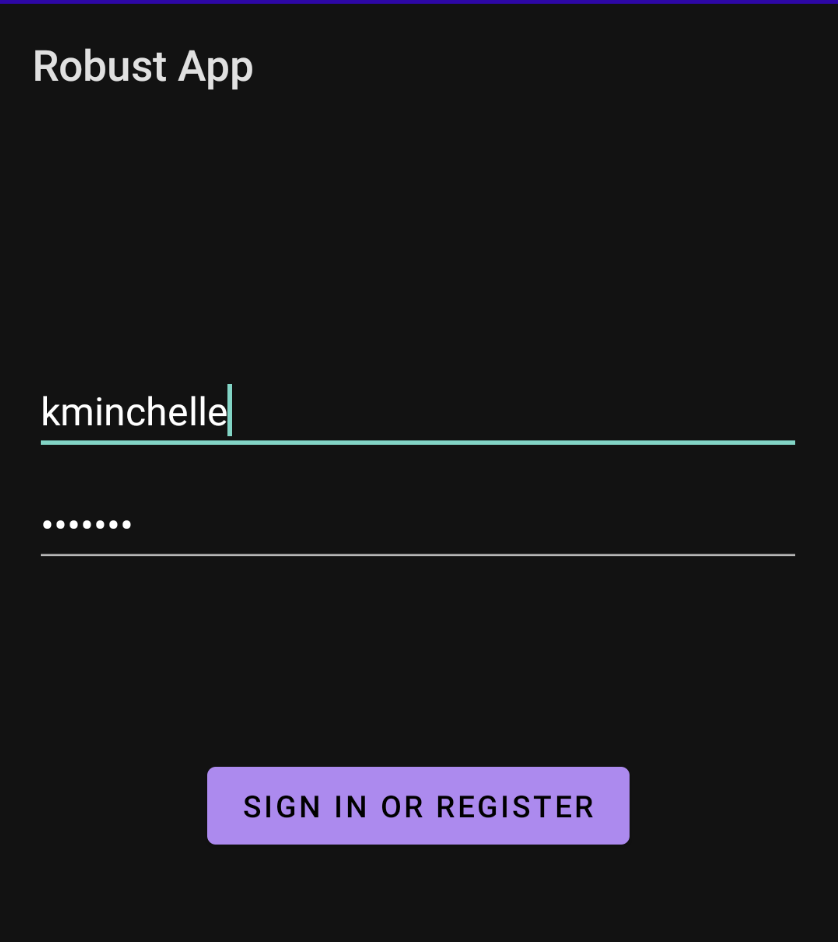
Основной флоу работы приложения выглядит следующим образом:
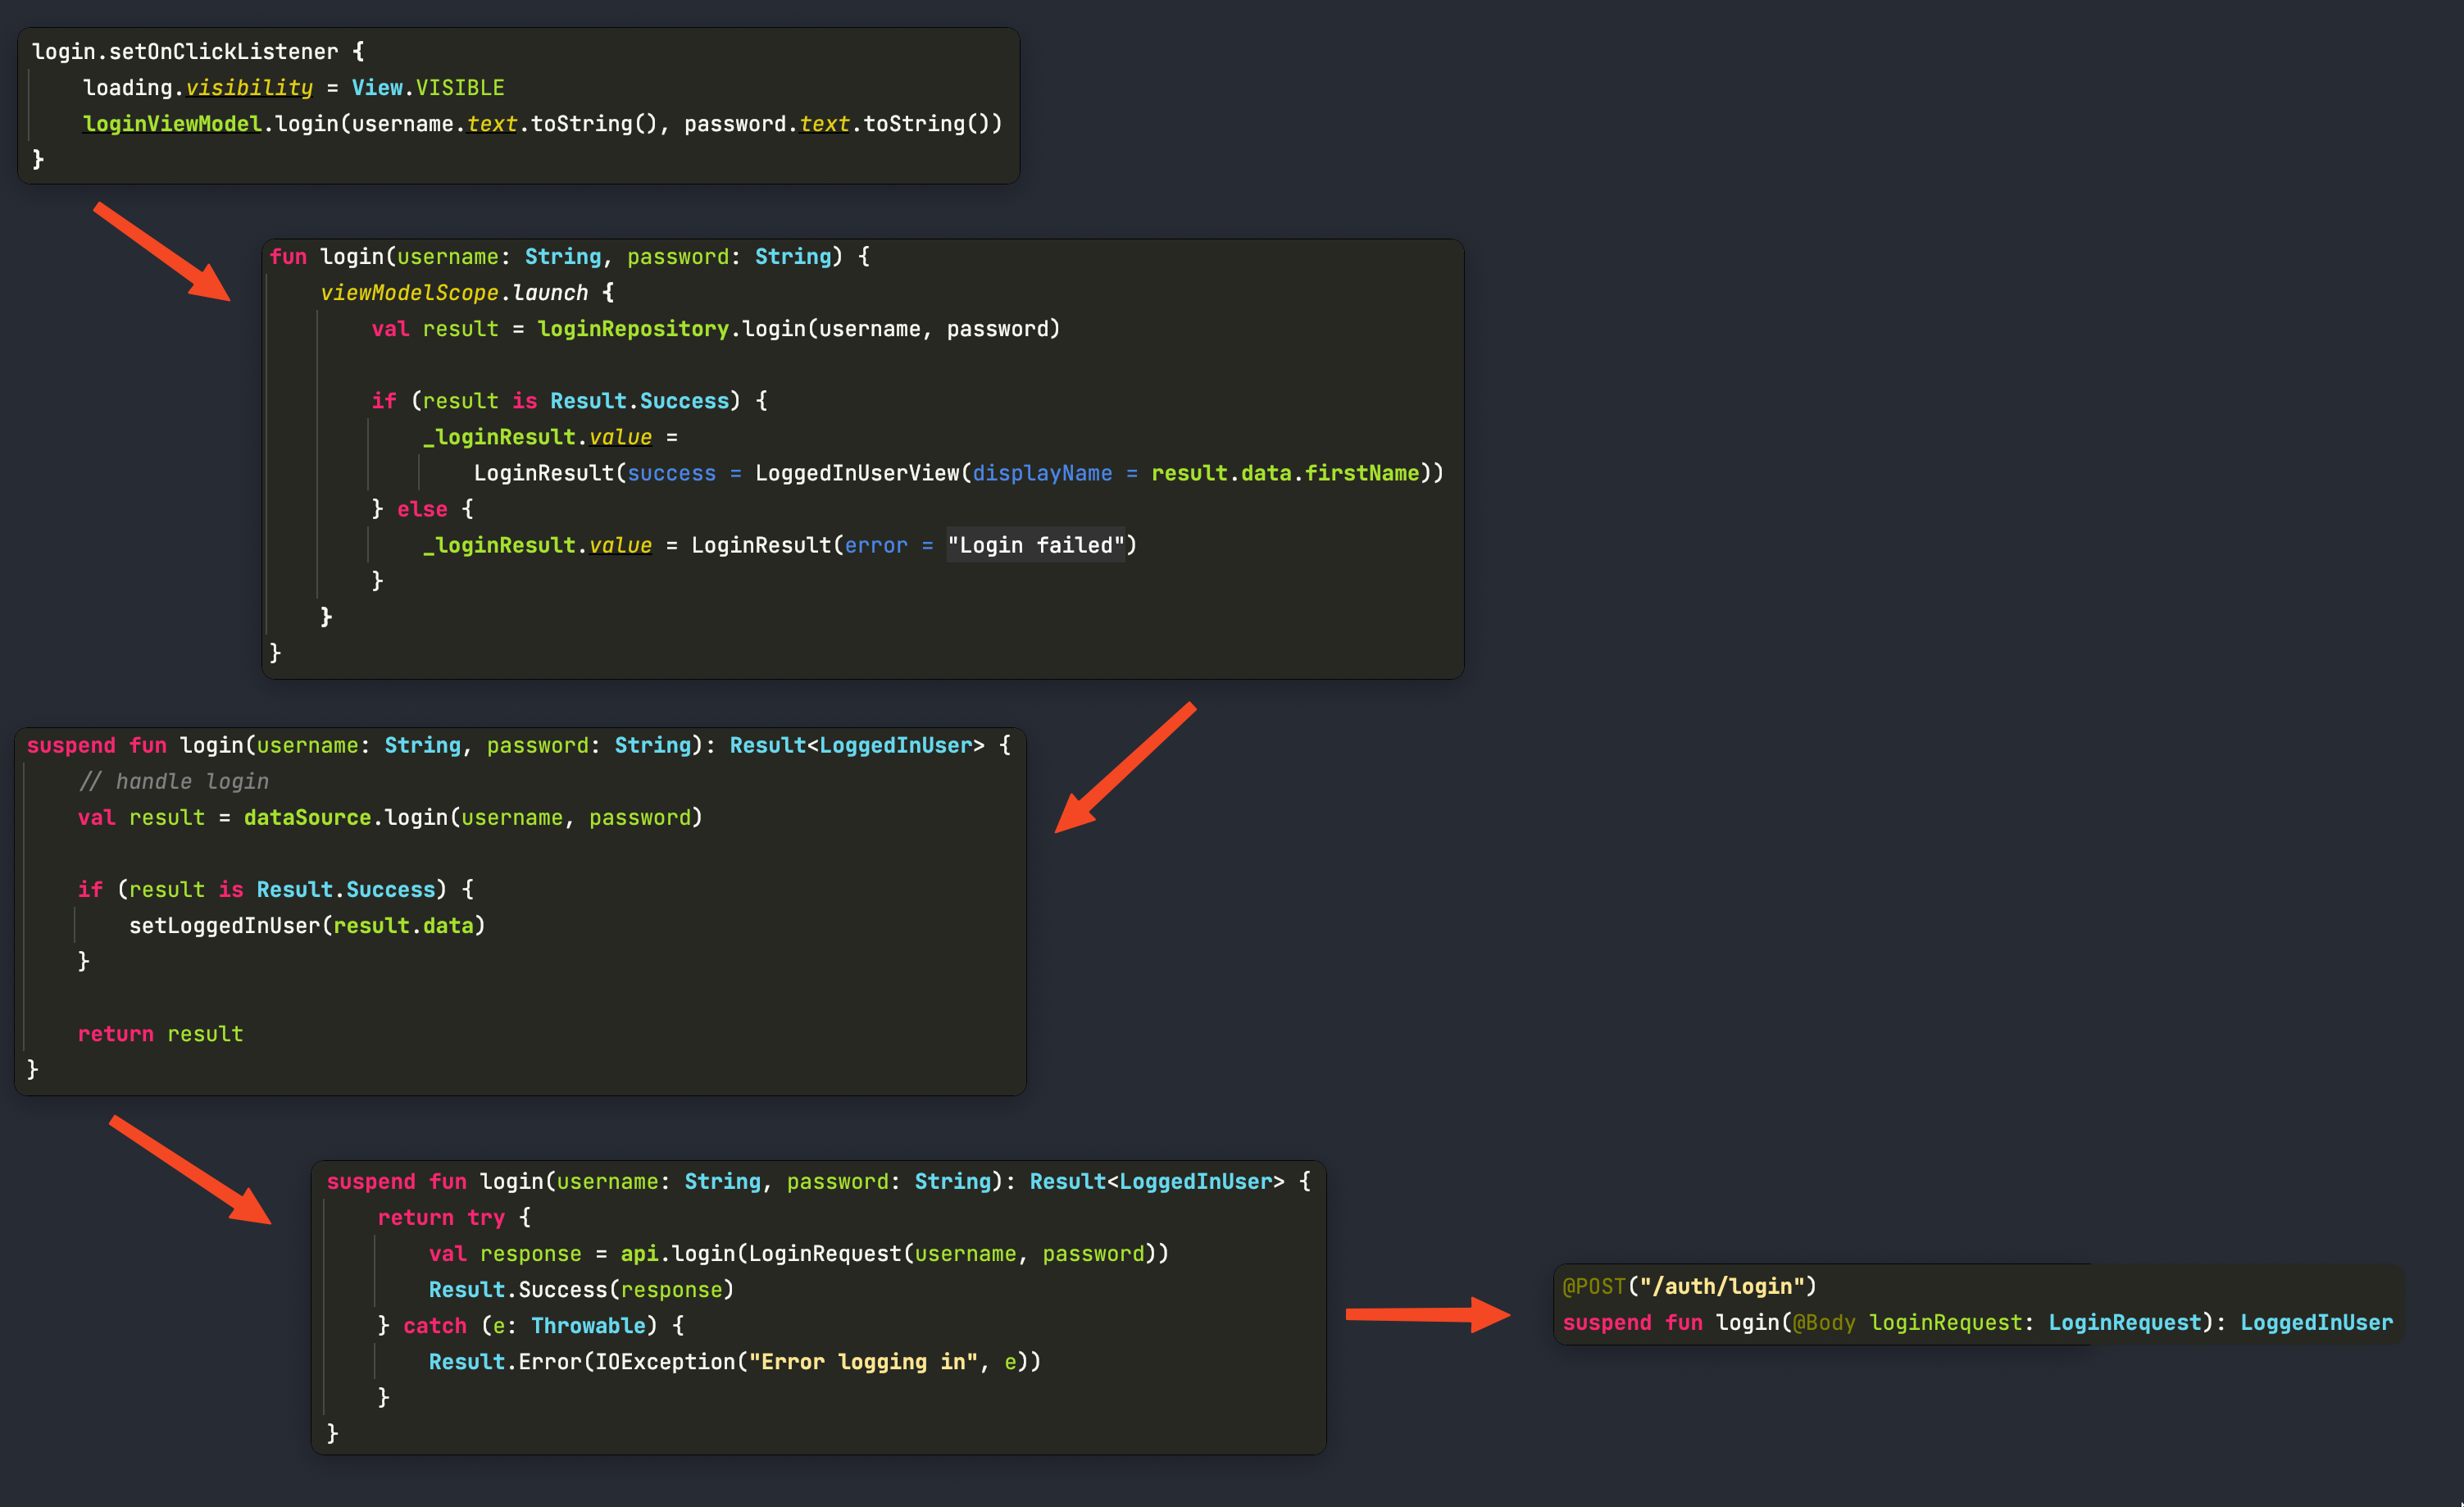
В ответ на запрос приходит модель описывающая залогиненного юзера и среди прочих данных возвращает токен для доступа к API:
1 2 3 4 5 6 7 8 9 10 "id": 15, "username": "kminchelle", "email": "kminchelle@qq.com", "firstName": "Jeanne", "lastName": "Halvorson", "gender": "female", "image": "https://robohash.org/autquiaut.png?size=50x50&set=set1", "token": "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpZCI6MTUsInVzZXJuYW1lIjoia21pbmNoZWxsZSIsImVtYWlsIjoia21pbmNoZWxsZUBxcS5jb20iLCJmaXJzdE5hbWUiOiJKZWFubmUiLCJsYXN0TmFtZSI6IkhhbHZvcnNvbiIsImdlbmRlciI6ImZlbWFsZSIsImltYWdlIjoiaHR0cHM6Ly9yb2JvaGFzaC5vcmcvYXV0cXVpYXV0LnBuZz9zaXplPTUweDUwJnNldD1zZXQxIiwiaWF0IjoxNjM1NzczOTYyLCJleHAiOjE2MzU3Nzc1NjJ9.n9PQX8w8ocKo0dMCw3g8bKhjB8Wo7f7IONFBDqfxKhs" > Пройдем этот сценарий как есть, потом сделаем дамп и посмотрим где в памяти оседает токен.
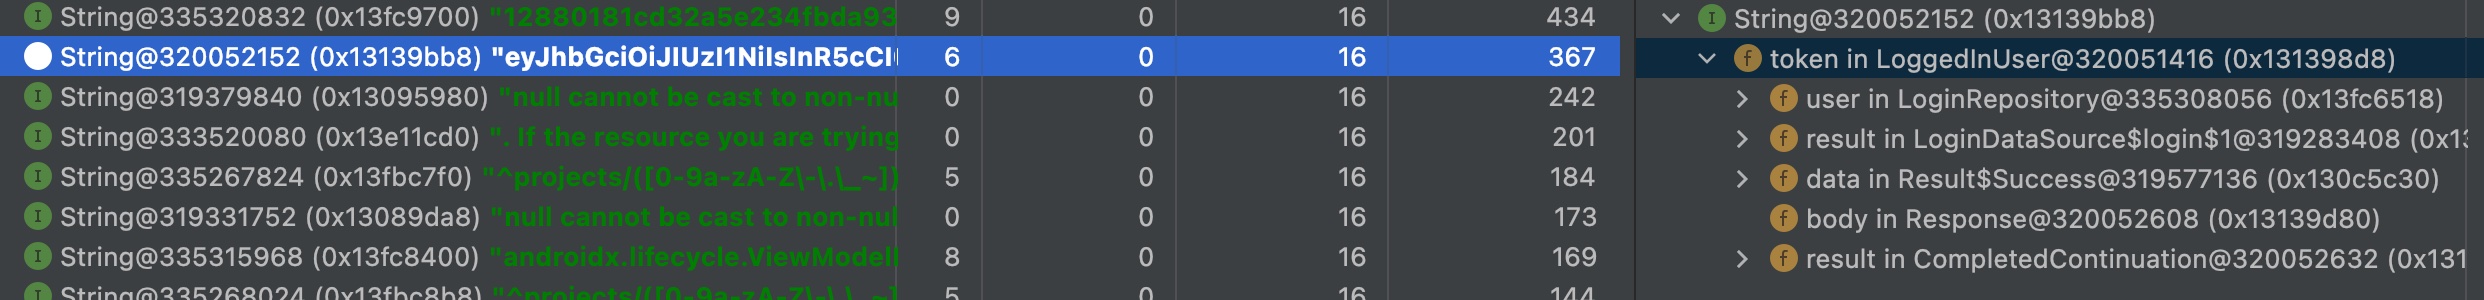
Из скрина видно, что токен ссылается несколько объектов из показанной выше цепочки вызовов. Попробуем теперь “очистить память” после сохранения токена в защищенное хранилище и посмотреть, что в итоге попадет в дамп. Сначала нужно доработать метод setLoggedInUser() убрав из памяти ненужный токен:
private fun setLoggedInUser(loggedInUser: LoggedInUser) this.user = loggedInUser preferences.edit putString("accessToken", user?.token) >.also // user?.token = "" System.gc() > > 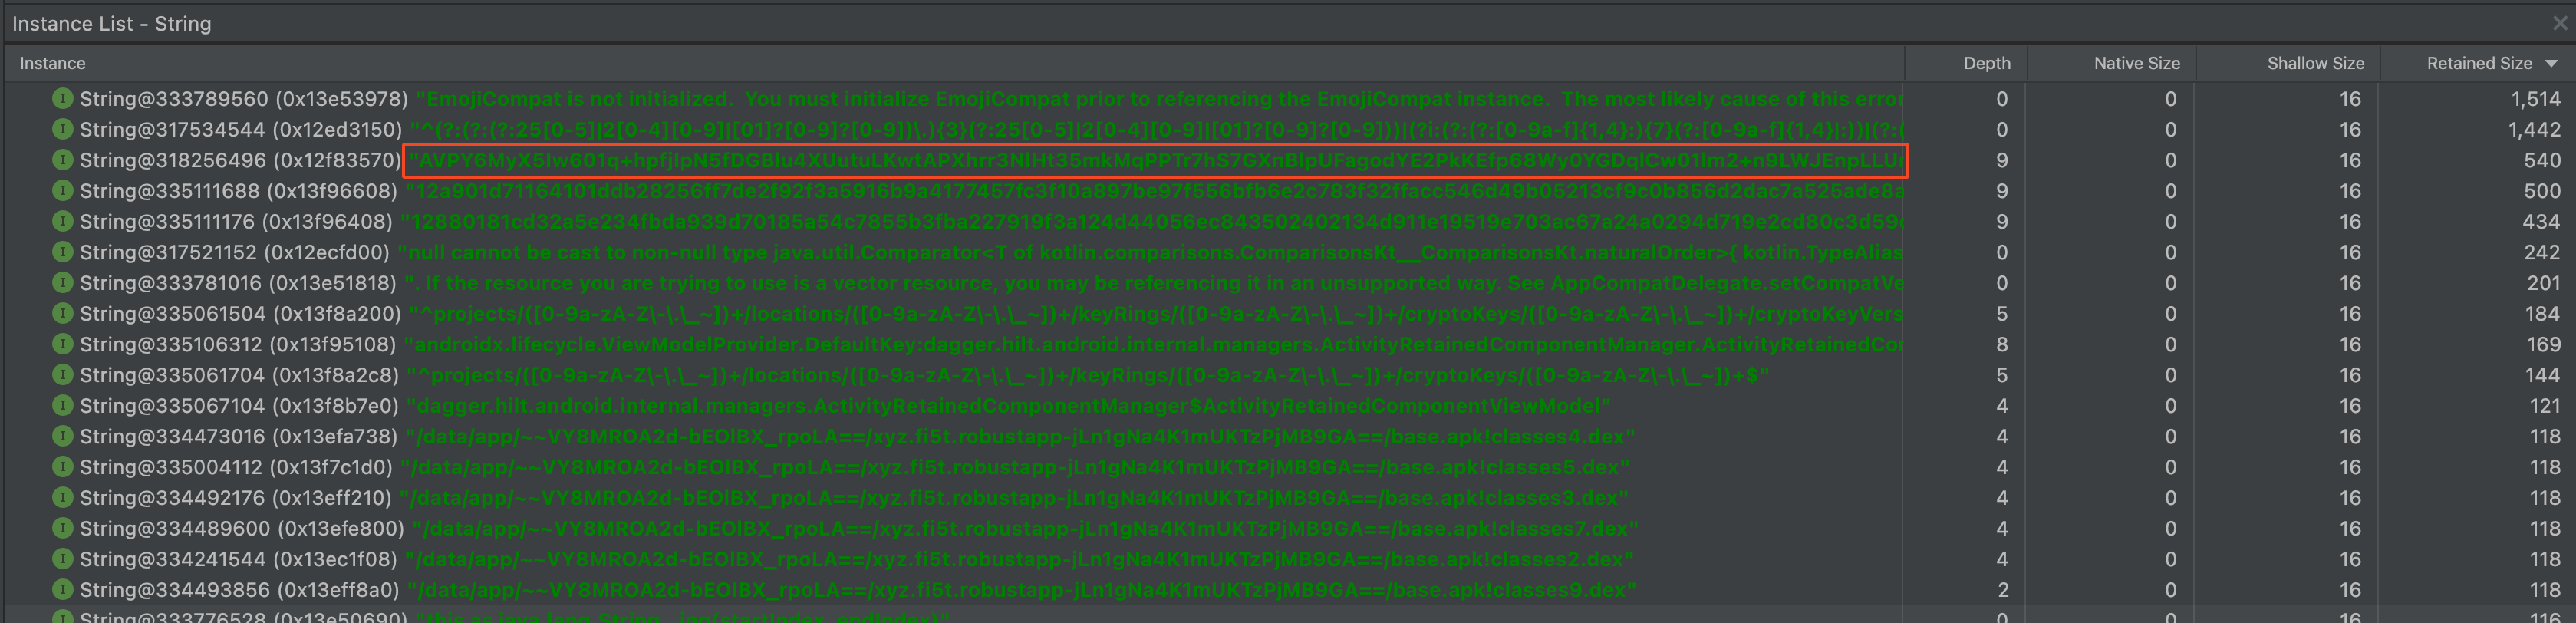
На привычном месте, среди длинных строк, токена больше нет. Только его зашифрованный вариант, который сохранился в преференсы. Неужели получилось? Спойлер: нет ��
В профилировщике студии нет поиска по строкам (или я не нашел), поэтому пройдемся по дампу утилитой strings и погрепаем jwt токены:
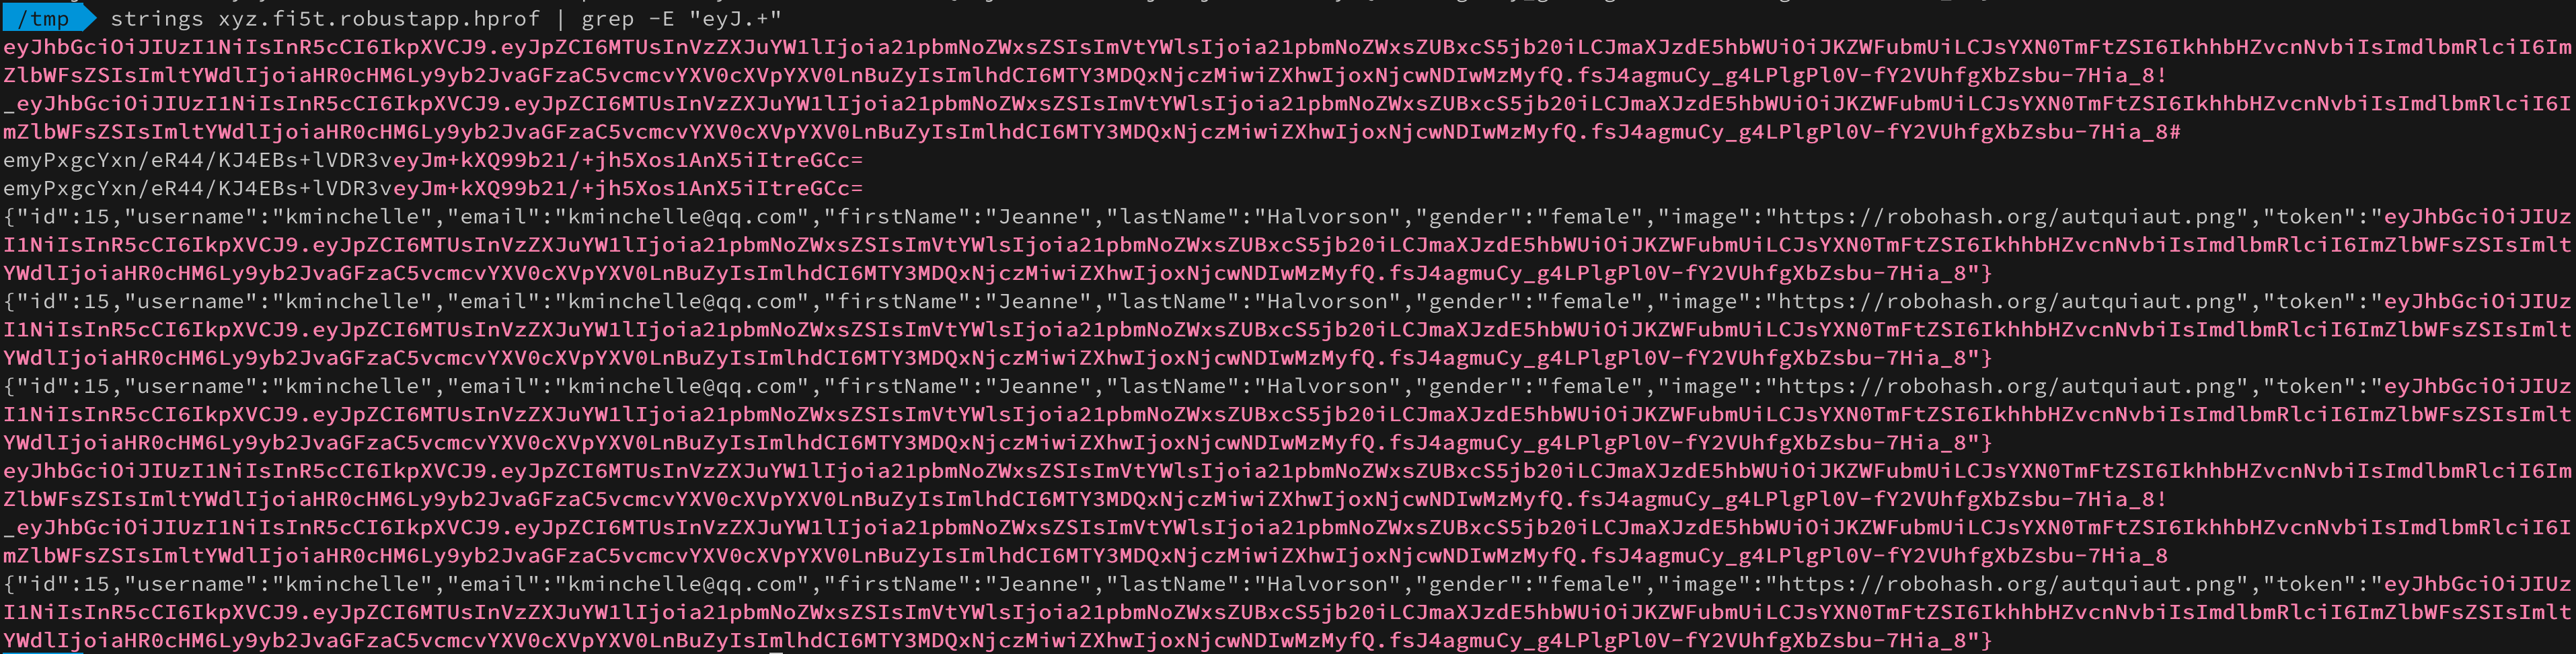
Все на месте. Пришло время погрузится в нюансы формата HPROF и выяснить в какой области памяти оказался вроде бы надежно удаленный токен.
Покопаемся в куче
К дальнейшему анализу дампов, помимо уже имеющихся инструментов, подключим парсер формата hprof. Я взял готовую реализацию отсюда и немного допилил ее напильником чтобы она вообще работала, а не валилась с ошибкой. Доработанный вариант лежит здесь(ветка research) Стоит сказать, что до того, как найти эту реализацию я начал писать свою и концепт получился даже неплохим, но в итоге я решил не изобретать велосипед и взять что-то более-менее готовое. Если кому-то захочется написать такой парсер самостоятельно, то начать нужно отсюда.
Строки в JVM представляют из себя массив символов — char[] в кодировке UTF-16. А значит искать мы будем записи с типом HPROF_GC_PRIM_ARRAY_DUMP :
HPROF_GC_PRIM_ARRAY_DUMP dump of a primitive array id array object ID u4 stack trace serial number u4 number of elements u1 element type 4: boolean array 5: char array 6: float array 7: double array 8: byte array 9: short array 10: int array 11: long array [u1]* elements Записи (records) это элементы из которых состоит hprof файл. Они делятся на records и sub-records, и имеют разную структуру в зависимости от типа, который определяется тегом (первый байт записи).
Начнем с извлечения всех записей содержащих массивы символов:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 func main() . hprofFile, err := os.Open(filename) if err != nil log.Fatalln(err) > defer hprofFile.Close() hprofParser := parser.NewParser(hprofFile) // Mandatory thing �� _, err = hprofParser.ParseHeader() . for record, err := hprofParser.ParseRecord() if err != nil if errors.Is(err, io.EOF) fmt.Println("\nComplete!") break > log.Fatalln(err) > if subRecord, ok := record.(*hprofdata.HProfPrimitiveArrayDump); ok if subRecord.ElementType == hprofdata.HProfValueType_CHAR content := decodeUTF16(subRecord.Values, binary.BigEndian) if strings.Contains(content, needle) fmt.Println(content) > > > > > Запуск парсера выдает интересные результаты. Совпадения нашлись, но их значительно меньше чем было при проходе утилитой strings . Всего два результата.

На этом месте нужно остановиться и немного подумать. Взглянув на возможные типы элементов, можно предположить, что строки также могут быть представлены как массивы байтов, а не символов. Модифицируем немного код парсера чтобы проверить эту гипотезу:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 for record, err := hprofParser.ParseRecord() if err != nil if errors.Is(err, io.EOF) fmt.Println("\nComplete!") break > log.Fatalln(err) > if subRecord, ok := record.(*hprofdata.HProfPrimitiveArrayDump); ok var elementsType string var content string switch subRecord.ElementType case hprofdata.HProfValueType_BYTE: elementsType = fmt.Sprintf("\033[35m%s\033[0m", subRecord.ElementType) content = string(subRecord.Values) case hprofdata.HProfValueType_CHAR: elementsType = fmt.Sprintf("\033[33m%s\033[0m", subRecord.ElementType) content = decodeUTF16(subRecord.Values, binary.BigEndian) > if strings.Contains(content, needle) fmt.Printf("\033[32m[*] Elements type:\033[0m %s; \033[32mContent:\033[0m %s\n", elementsType, content) > > 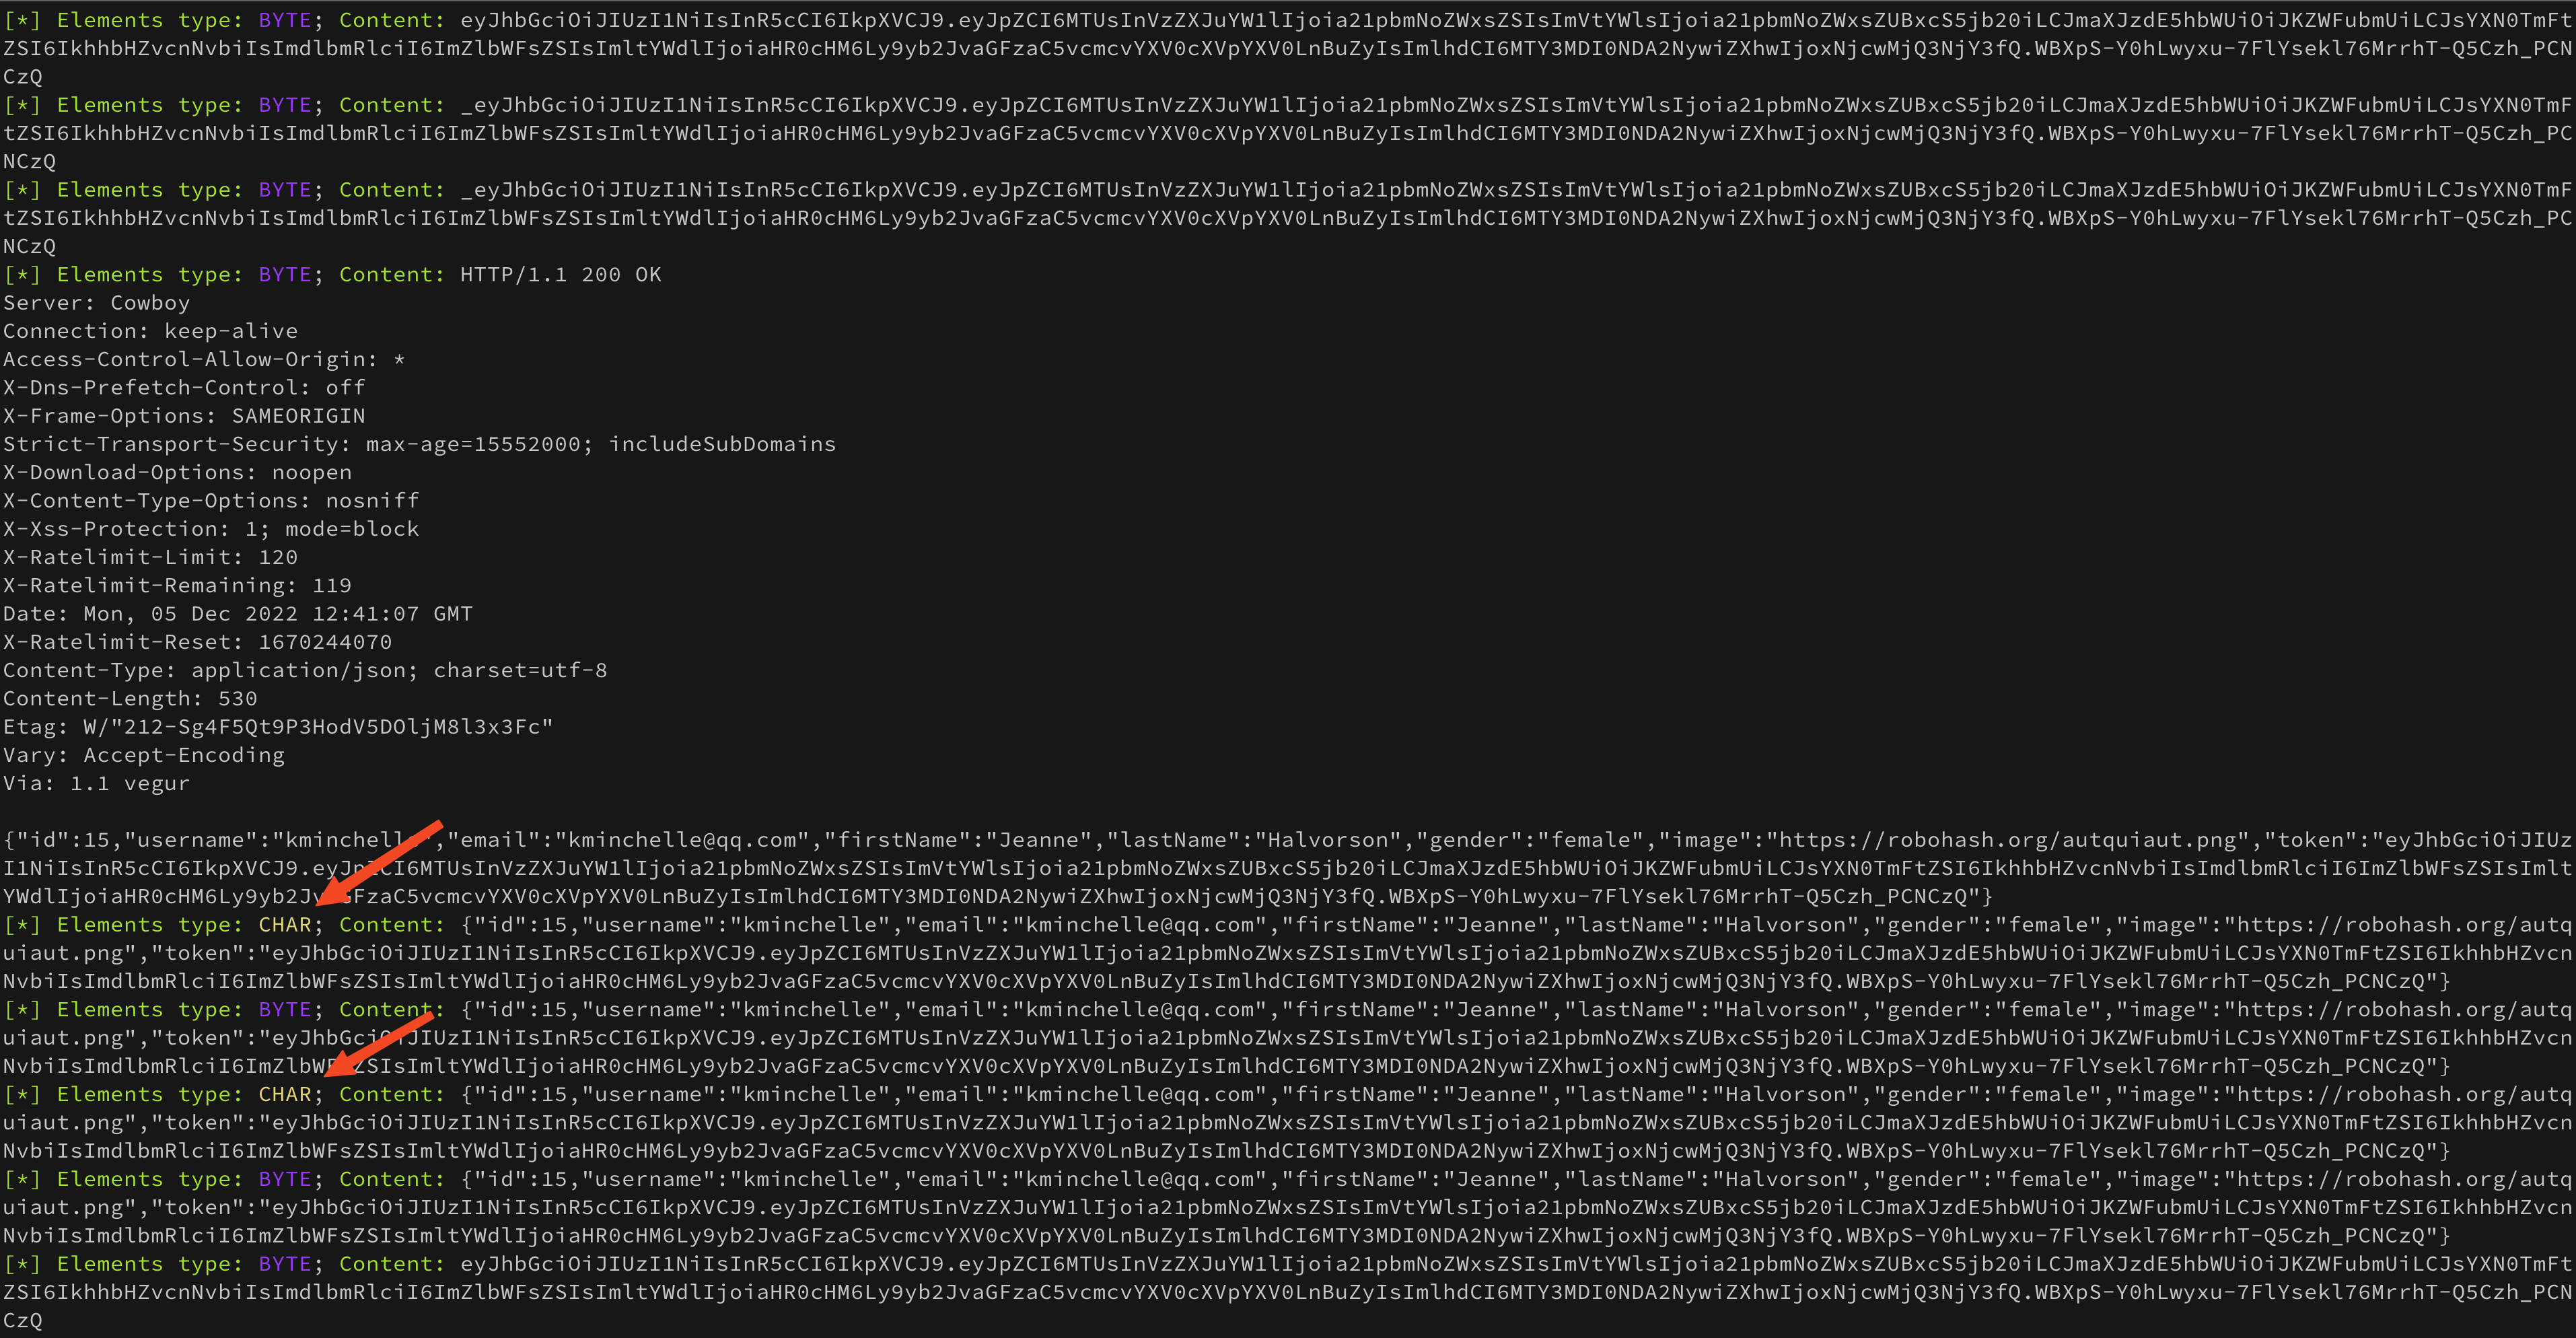
Отлично! Помимо уже имеющихся массивов символов появились байтовые массивы, которые содержат много интересных данных. Уже сейчас видно, что токен, несмотря на все наши усилия попал сразу в несколько кусков памяти, которые мы никак не контролируем.
И что теперь делать?
Порассуждаем. Токен, попал в несколько мест в куче в виде массивов двух типов, char[] и byte[] , но это прозошло неявно, т.к. никаких массивов мы в коде не создавали. Что если попробовать получить больше контроля над этими всеми процессами и вместо строк начать использовать массивы байтов? А еще, байтовые массивы не являются иммутабельными и их можно затирать. Звучит как план!
На самом деле, можно пойти еще дальше и вместо байтового массива использовать байтовый буфер ( ByteBuffer ) с прямой аллокацией памяти.
A direct buffer refers to a buffer’s underlying data allocated on a memory area where OS functions can directly access it.
Начать использовать такой буфер нужно как можно раньше (ниже?) в архитектурном смысле. Самая первая точка, где мы получаем контроль над происходящим, находится в процедуре десериализации. Все, что происходит до этого является для нас черным ящиком. Поэтому начнем с написания адаптера, который будет сериализовать токен в ByteBuffer .
1 2 3 4 5 6 7 8 9 10 11 class ByteBufferAdapter : TypeAdapterByteBuffer>() override fun write(out: JsonWriter?, value: ByteBuffer?) ... > override fun read(`in`: JsonReader): ByteBuffer return `in`.nextString().let ByteBuffer.allocateDirect(it.length).put(it.encodeToByteArray()) > > > Даже на этом уровне нам уже приходится иметь дело со строками, но будем надеятся, что они там как-нибудь сами пропадут 😉 Далее доработаем доменную модель пользователя:
1 2 3 4 5 6 7 data class LoggedInUser( ... @SerializedName("token") @JsonAdapter(ByteBufferAdapter::class) var token: ByteBuffer ) Тут уже все хорошо, никаких строк не создается и мы практически в шаге от абсолютной безопасности! Осталось только очистить буфер после его сохранения в shared preferences.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 fun ByteBuffer.wipeDirectBuffer(random: Random = Random()) if (!this.isDirect) throw IllegalStateException("Only direct-allocated byte buffers can be meaningfully wiped") val arr = ByteArray(this.capacity()) this.rewind() random.nextBytes(arr) this.put(arr) > ... private fun setLoggedInUser(loggedInUser: LoggedInUser) this.user = loggedInUser user?.let u -> preferences.edit putString("accessToken", String(u.token.array())) >.also u.token.wipeDirectBuffer() System.gc() > > > Тут мы тоже без строк не обойдемся, к сожалению. SharedPreferences.Editor просто не умеет сохранять данные в виде массива байт. Но может нам повезет и это использование строк тоже никто не заметит? Тем более строка создается через конструктор, в пул строк попасть не должна, а значит мы все еще в безопасности!
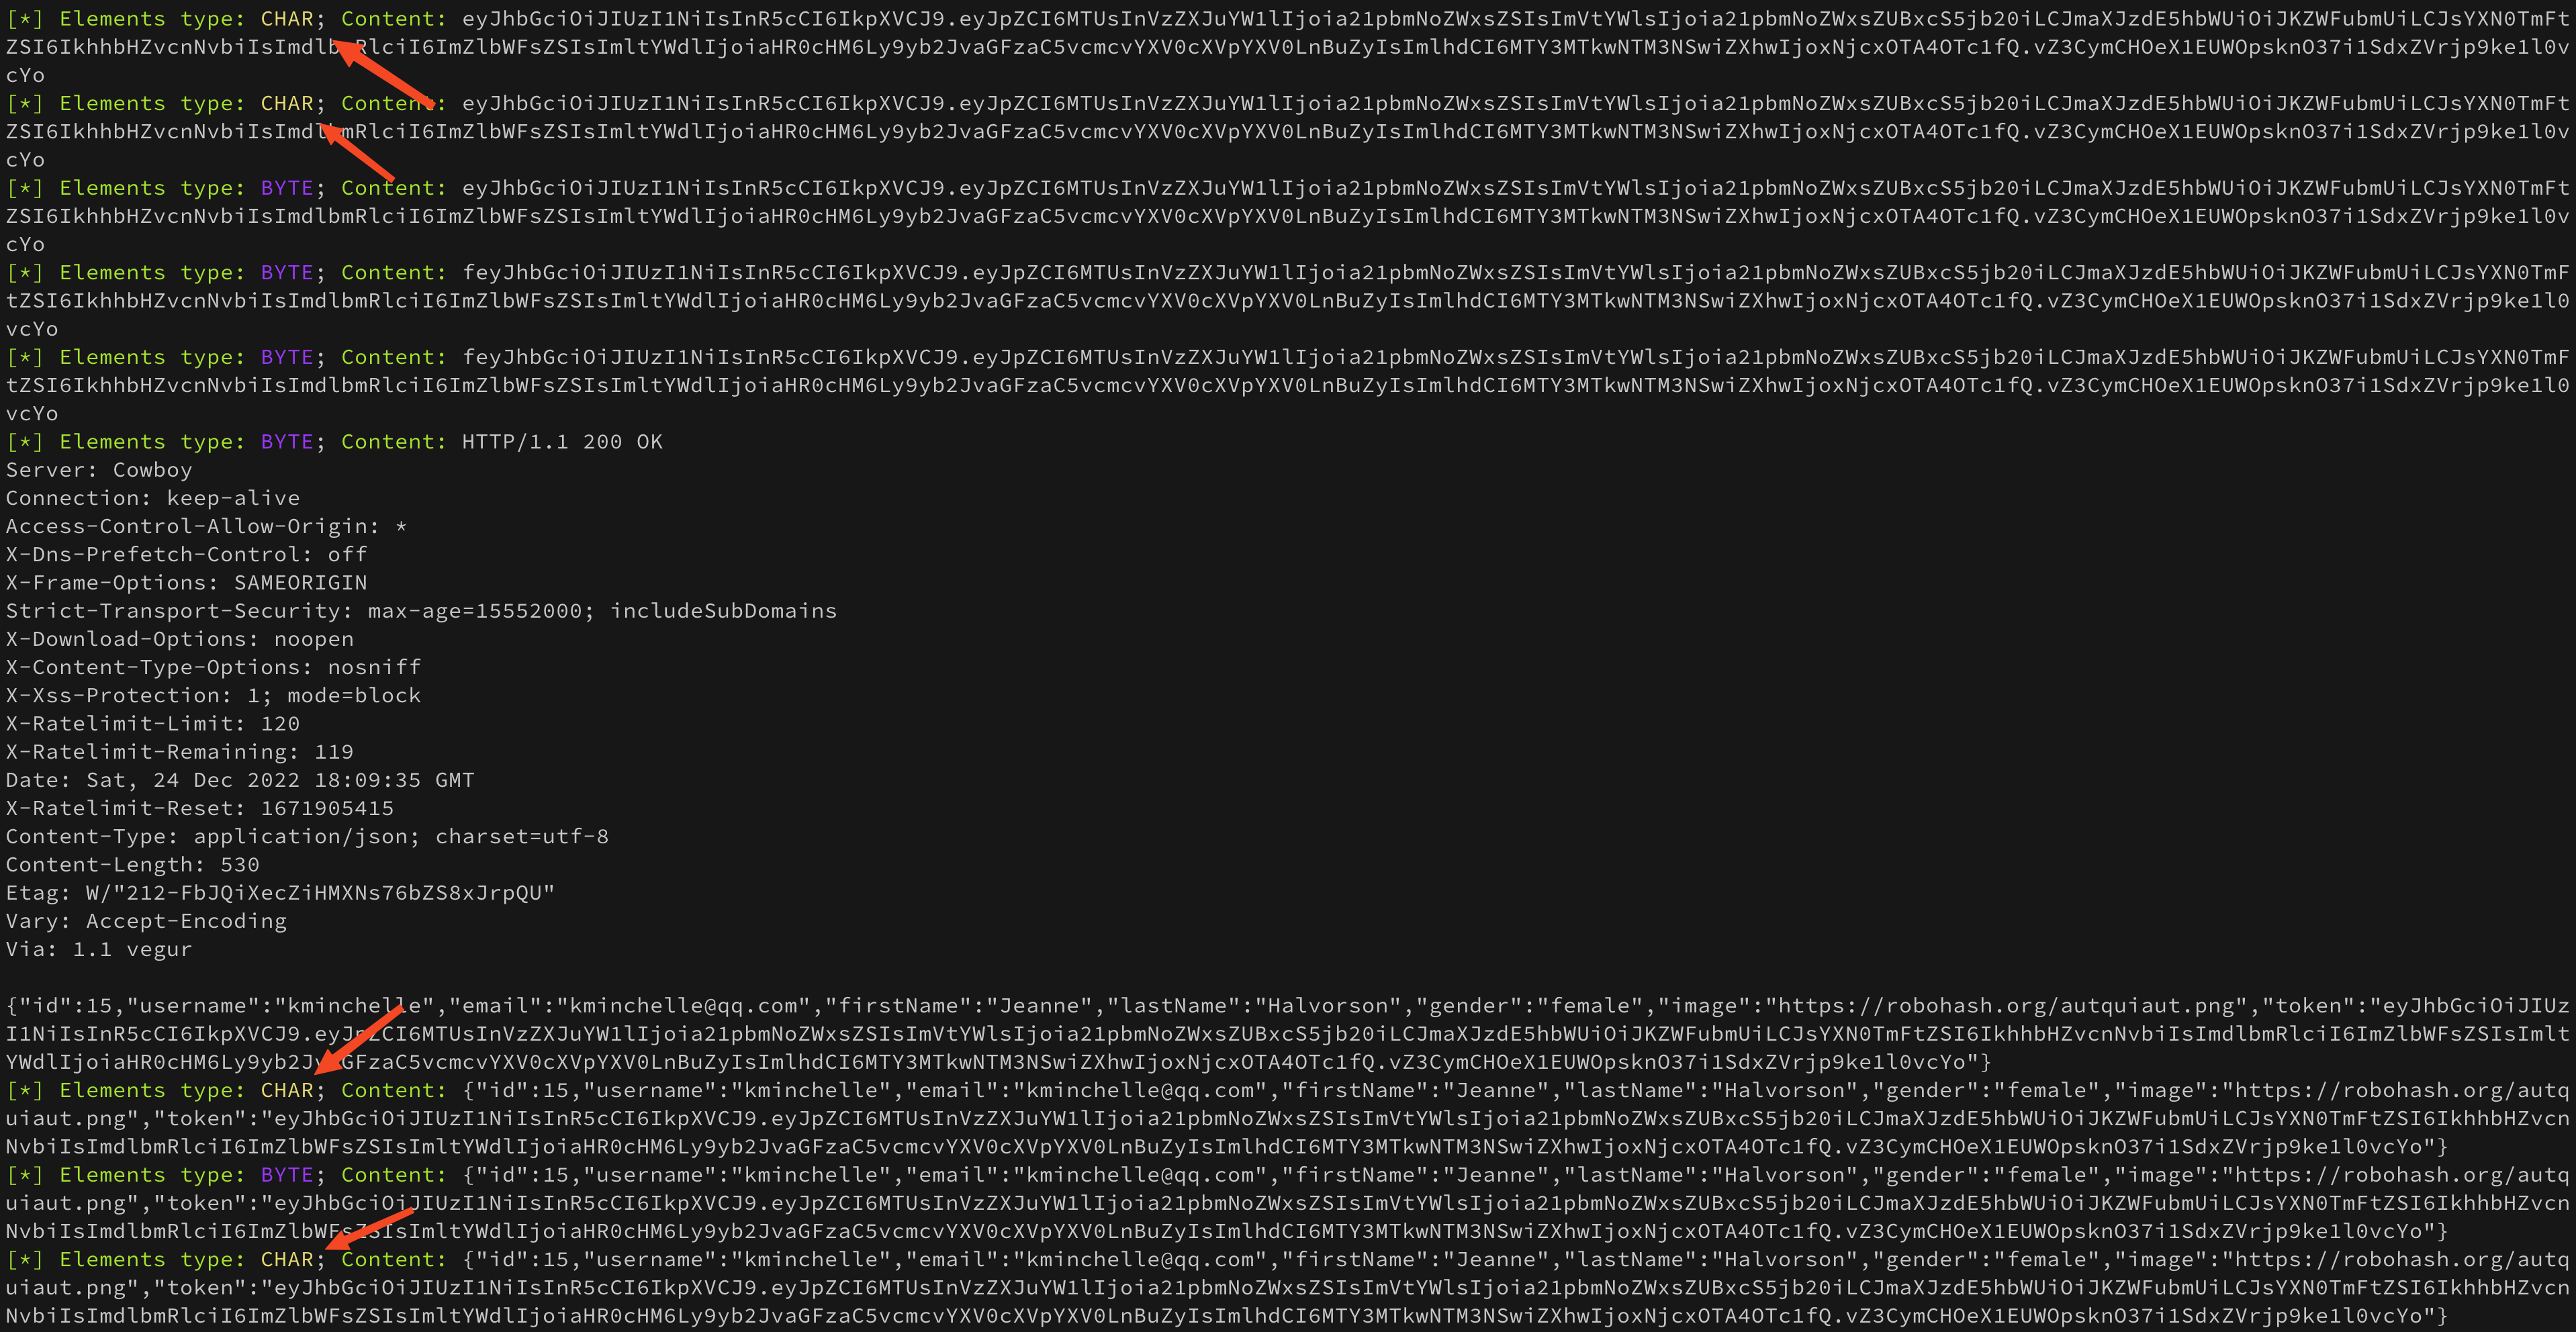
Запускаем приложение, получаем токен с сервера, делаем дамп и смотрим на результат
В голову сразу приходит вот эта картинка
Да, результат стал еще хуже чем был. И это еще не все данные, остальные не уместились на скриншоте. Что тут сказать… Не прокатило ��
Показанный выше способ с байтовыми буферами — вполне рабочий. Проблема не в нем. Она в том, что мы не контролируем большую часть того, что происходит с данными в приложении. Как с ними обращаются библиотеки, которые мы используем. Куда и как они их копируют и во что конвертируют. Чтобы избавиться от этой проблемы — нужно контролировать вообще все. В том числе сетевые библиотеки, сериализаторы, сохранять данные на диск в собственном формате. Все это должно быть самописным и не использовать JVM строки. Никто в здравом уме не будет этим заниматься.
Заключение
Стоило ли писать целую статью, если можно было в 3-5 предложений обрисовать ситуацию? Я считаю, что стоило. Хотябы для того чтобы прекратить поиск точки G возможностей затирать строки в памяти и сделать это осознанно. С доказательной базой, с инструментами для проверки гипотез и четким пониманием границ реализуемых механизмов. Я надеюсь, что прочитав ее вы узнали что-то новое и стали лучше понимать ту платформу с которой имеете дело в качестве разработчика или хакера.
Всех с наступающим Новым Годом! ��
Ссылки
- Руководство по String pool в Java
- Java is Pass by Value and Not Pass by Reference
- Guide to ByteBuffer