Методы программирования
Задание состоит из трех частей, первая и третья обязательны для выполнения, вторая выполняется по желанию студента. Срок сдачи задания — 17 октября.
Теория
Двоичное дерево задается следующей структурой:
typedef struct _t int data; /* данные в узле */
struct _t *left, *right; /* указатели на левого и правого сыновей */
> t;
t *root; /* корень дерева */
Таким образом, каждый элемент дерева содержит некоторые данные и два указателя на потомков (на левого сына и на правого). Сам узел будем называть отцом этих двух потомков. Определение дерева требует, чтобы у каждого узла, кроме корня, был ровно один отец. Указатель на корень дерева хранится в переменной root , она равна нулю, если дерево пусто.
Левым и правым поддеревьями узла t ( t != 0 ) будем называть деревья (возможно, пустые), корнями которых являются соответственно t->left и t->right .
Основные операции на деревьях: поиск элемента, добавление элемента, удаление элемента. Для поиска элемента в произвольном бинарном дереве необходимо обойти все элементы этого дерева. Существует два основных способа обхода дерева: в глубину и в ширину.
Обход дерева в глубину
Обход в глубину производится рекурсивно либо с использованием стека. В обоих случаях можно обходить узлы дерева в различной последовательности. Обход начинается от корня. Выделяют три наиболее важных порядка обхода в глубину:
- префиксный (прямой) обход — сначала обрабатывается текущий узел, затем левое и правое поддеревья;
- инфиксный (симметричный) обход — сначала обрабатывается левое поддерево текущего узла, затем корень, затем правое поддерево;
- постфиксный (обратный) обход — сначала обрабатываются левое и правое поддеревья текущего узла, затем сам узел.
В качестве примера рассмотрим следующее дерево:
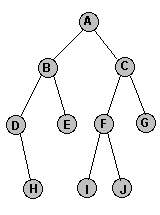
- префиксный обход: A, B, D, H, E, C, F, I, J, G
- инфиксный обход: D, H, B, E, A, I, F, J, C, G
- постфиксный обход: H, D, E, B, I, J, F, G, C, A
Запишем в качестве примера рекурсивную процедуру, выводящую на экран узлы дерева в порядке префиксного обхода.
void prefix(t *curr)
if (!curr)
return;
printf(«%d «, curr->data);
prefix(curr->left);
prefix(curr->right);
>
Обход дерева в ширину
Обход в ширину производится с помощью очереди. Первоначально в очередь помещается корень, затем, пока очередь не пуста, выполняются следующие действия:
- Из очереди выталкивается очередной узел;
- Этот узел обрабатывается;
- В очередь добавляются оба сына этого узла.
Узлы дерева на рисунке перечисляются в порядке обхода в ширину следующим образом: A, B, C, D, E, F, G, H, I, J. Заметим, что перечисление узлов происходит в порядке удаления от корня, что делает поиск в ширину удобным, например, для поиска узла дерева со значением k , наиболее близкого к корню, и т.д.
Приведем пример процедуры, которая выводит на экран узлы дерева в порядке обхода в ширину. Считаем, что определены три функции:
void add(t *elem); /* добавляет в конец очереди элемент elem */
t *del(); /* удаляет из очереди первый элемент и возвращает указатель на него */
int empty(); /* возвращает 1, если очередь пуста, и 0 в противном случае */
Тогда процедура обхода будет иметь следующий вид:
void width(t *root)
if (!root)
return;
add(root);
while (!empty()) t *curr = del();
printf(«%d «, curr->data);
if (curr->left)
add(curr->left);
if (curr->right)
add(curr->right);
>
>
Двоичные деревья поиска
Для поиска узла в таком дереве можно использовать как рекурсивную функцию, так и простой цикл. Ниже приведен пример функции, которая ищет узел со значением k в двоичном дереве поиска с корнем root . Этот код весьма напоминает обычный бинарный поиск:
t *search(t *root, int k)
t *curr = root;
while (curr) if (k == curr->data)
return (curr);
if (k < curr->data)
curr = curr->left;
else
curr = curr->right;
>
return (0);
>
Добавление узла в двоичное дерево поиска напоминает добавление элемента в середину связанного списка: выполняется проход по дереву с запоминанием указателя на узел, предшествующий текущему, и добавление узла к предыдущему, как только текущий указатель станет равным нулю. Необходимо отдельно обработать случай пустого дерева.
Удаление узла из двоичного дерева поиска является менее тривиальной операцией: необходимо поддерживать выполнение условия расположения элементов («слева меньше, справа больше»). Одним из возможных способов является следующий:
- если у удаляемого узла нет сыновей, его удаление не представляет проблемы (освобождаем память и зануляем указатель на нее у его отца);
- если у удаляемого узла есть ровно один сын, удаляем узел, а указатель на него у отца заменяем указателем на этого сына;
- если у удаляемого узла есть оба сына, ищем в правом поддереве узел с минимальным значением (у него по определению будет отсутствовать левый сын) и ставим этот узел на место удаляемого, аккуратно поменяв все необходимые указатели.
Сбалансированные деревья
При работе с двоичными деревьями поиска возможен случай, когда дерево по сути примет вид линейного связанного списка (например, если элементы подавались на вход в порядке возрастания). В таком случае поиск элемента в дереве будет занимать линейное время. Одним из способов предотвращения подобной ситуации является балансировка дерева по мере добавления элементов.
Сбалансированным деревом (AVL-деревом) называется двоичное дерево поиска, удовлетворяющее следующему условию: для любого узла глубина левого поддерева отличается от глубины правого поддерева не более чем на 1. В сбалансированном дереве поиск элемента выполняется за время O(log2N), где N — количество узлов (Адельсон-Вельский, Ландис, 1962). Алгоритм построения сбалансированных деревьев можно найти в сети и в литературе (Вирт, Кнут, . ), поэтому подробное описание его здесь не приводится.
Формулировка задания
а. Реализация простых двоичных деревьев поиска
Во входном файле input.txt в первой строке находится количество записей N , в следующих N строках находятся записи вида имя значение , причем имена могут повторяться. В файл output.txt выдать итоговые значения всех переменных в алфавитном порядке. Хранение записей организовать в виде двоичного дерева поиска.
Примеры
| Ввод: input.txt 5 a 10 b 20 a 15 c 25 b 11 |
Вывод: output.txt a 15 c 25 b 11 |
b. ** Реализация сбалансированных деревьев
Задание аналогично предыдущему, но требуется поддерживать дерево сбалансированным. Задание не является обязательным.
c. Реализация префиксного, инфиксного и постфиксного обходов двоичного дерева
Необходимо реализовать функции обхода дерева в порядке префиксного, инфиксного и постфиксного обходов. Дерево задается произвольным образом.
Как указать что узел дерева не имеет левого правого сына
Граф — это сложная нелинейная многосвязная динамическая структура, отображающая свойства и связи сложного объекта.
6.2.2. Логическое представление и изображение деревьев.
6.2.3. Бинарные деревья.
6.2.4. Представление любого дерева, леса бинарными деревьями.
- 1. В каждом узле оставить только ветвь к старшему сыну (вертикальное соединение);
- 2. Соединить горизонтальными ребрами всех братьев одного отца;
- 3. Таким образом перестроить дерево по правилу:
- левый сын — вершина, расположенная под данной;
- правый сын — вершина, расположенная справа от данной (т.е. на одном ярусе с ней).
6.2.5. Машинное представление деревьев в памяти ЭВМ.
LPTR DATA RPTR 6.2.6. Основные операции над деревьями.
- 1) Поиск узла с заданным ключом ( Find ).
- 2) Добавление нового узла ( Dob ).
- 3) Удаление узла ( поддерева ) ( Udal ).
- 4) Обход дерева в определенном порядке:
- Нисходящий обход ( процедура Preorder , рекурсивная процедура r_Preoder);
- Смешанный обход (процедура Inorder, рекурсивная процедура r_Inorder);
- Восходящий обход ( процедура Postorder, рекурсивная процедура r_Postorder).
- процедура включения в стек при нисходящем обходе (Push_st);
- функция извлечения из стека при нисходящем обходе (Pop_st);
- процедура включения в стек при восходящем и смешанном обходе (S_Push);
- функция извлечения из стека при восходящем и смешанном обходе (S_Pop).
- функция нахождения сына данного узла ( Inson );
- функция нахождения отца данного узла ( Inp );
-
- процедура включения в дерево узла слева от данного (leftIn);
Function Find(k:KeyType;d:TreePtr;var rez:TreePtr):bollean;
< где k - ключ, d - корень дерева, rez - результат >
Var
p,g: TreePtr;
b: boolean;
Begin
b:=false; p:=d; < ключ не найден >
if d <> NIL then
repeat q: =p; if p^.key = k then b:=true < ключ найден >
else begin q:=p; < указатель на отца >
if k < p^.key then p:=p^.left < поиск влево >
else p:=p^.right < поиск вправо>
end; until b or (p=NIL);
Find:=b; rez:=q;
End;
Procedure Dob (k:KeyType; var d:TreePtr; zap:data);
< k - ключ, d - узел дерева, zap - запись >
Var
r,s: TreePtr;
t: DataPtr;
Begin
if not Find(k,d,r) then
begin (* Занесение в новое звено текста записи *)
new(t); t^:=zap; new(s); s^.key:=k;
s^.ssil:=t; s^.left:=NIL; s^.right:=NIL;
if d = NIL then d:=s (* Вставка нового звена *)
else if k < r^.key
then r^.left:=s
else r^.right:=s;
end; End;
Дерево поиска, наивная реализация
Бинарное дерево поиска (англ. binary search tree, BST) — структура данных для работы с упорядоченными множествами.
Бинарное дерево поиска обладает следующим свойством: если [math]x[/math] — узел бинарного дерева с ключом [math]k[/math] , то все узлы в левом поддереве должны иметь ключи, меньшие [math]k[/math] , а в правом поддереве большие [math]k[/math] .
Операции в бинарном дереве поиска
Для представления бинарного дерева поиска в памяти будем использовать следующую структуру:
struct Node: T key // ключ узла Node left // указатель на левого потомка Node right // указатель на правого потомка Node parent // указатель на предка
Обход дерева поиска
Есть три операции обхода узлов дерева, отличающиеся порядком обхода узлов:
- [math]\mathrm[/math] — обход узлов в отсортированном порядке,
- [math]\mathrm[/math] — обход узлов в порядке: вершина, левое поддерево, правое поддерево,
- [math]\mathrm[/math] — обход узлов в порядке: левое поддерево, правое поддерево, вершина.
func inorderTraversal(x : Node): if x != null inorderTraversal(x.left) print x.key inorderTraversal(x.right)
При выполнении данного обхода вершины будут выведены в следующем порядке: 1 3 4 6 7 8 10 13 14.
func preorderTraversal(x : Node) if x != null print x.key preorderTraversal(x.left) preorderTraversal(x.right)
При выполнении данного обхода вершины будут выведены в следующем порядке: 8 3 1 6 4 7 10 14 13.
func postorderTraversal(x : Node) if x != null postorderTraversal(x.left) postorderTraversal(x.right) print x.key
При выполнении данного обхода вершины будут выведены в следующем порядке: 1 4 7 6 3 13 14 10 8.
Данные алгоритмы выполняют обход за время [math]O(n)[/math] , поскольку процедура вызывается ровно два раза для каждого узла дерева.
Поиск элемента
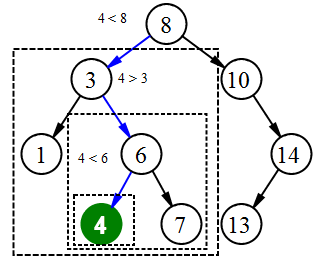
Поиск элемента 4
Для поиска элемента в бинарном дереве поиска можно воспользоваться следующей функцией, которая принимает в качестве параметров корень дерева и искомый ключ. Для каждого узла функция сравнивает значение его ключа с искомым ключом. Если ключи одинаковы, то функция возвращает текущий узел, в противном случае функция вызывается рекурсивно для левого или правого поддерева. Узлы, которые посещает функция образуют нисходящий путь от корня, так что время ее работы [math]O(h)[/math] , где [math]h[/math] — высота дерева.
Node search(x : Node, k : T): if x == null or k == x.key return x if k < x.key return search(x.left, k) else return search(x.right, k)
Поиск минимума и максимума
Чтобы найти минимальный элемент в бинарном дереве поиска, необходимо просто следовать указателям [math]left[/math] от корня дерева, пока не встретится значение [math]null[/math] . Если у вершины есть левое поддерево, то по свойству бинарного дерева поиска в нем хранятся все элементы с меньшим ключом. Если его нет, значит эта вершина и есть минимальная. Аналогично ищется и максимальный элемент. Для этого нужно следовать правым указателям.
Node minimum(x : Node): if x.left == null return x return minimum(x.left)
Node maximum(x : Node): if x.right == null return x return maximum(x.right)
Данные функции принимают корень поддерева, и возвращают минимальный (максимальный) элемент в поддереве. Обе процедуры выполняются за время [math]O(h)[/math] .
Поиск следующего и предыдущего элемента
Реализация с использованием информации о родителе
Если у узла есть правое поддерево, то следующий за ним элемент будет минимальным элементом в этом поддереве. Если у него нет правого поддерева, то нужно следовать вверх, пока не встретим узел, который является левым дочерним узлом своего родителя. Поиск предыдущего выполнятся аналогично. Если у узла есть левое поддерево, то предыдущий ему элемент будет максимальным элементом в этом поддереве. Если у него нет левого поддерева, то нужно следовать вверх, пока не встретим узел, который является правым дочерним узлом своего родителя.
Node next(x : Node): if x.right != null return minimum(x.right) y = x.parent while y != null and x == y.right x = y y = y.parent return y
Node prev(x : Node): if x.left != null return maximum(x.left) y = x.parent while y != null and x == y.left x = y y = y.parent return y
Обе операции выполняются за время [math]O(h)[/math] .
Реализация без использования информации о родителе
Рассмотрим поиск следующего элемента для некоторого ключа [math]x[/math] . Поиск будем начинать с корня дерева, храня текущий узел [math]current[/math] и узел [math]successor[/math] , последний посещенный узел, ключ которого больше [math]x[/math] .
Спускаемся вниз по дереву, как в алгоритме поиска узла. Рассмотрим ключ текущего узла [math]current[/math] . Если [math]current.key \leqslant x[/math] , значит следующий за [math]x[/math] узел находится в правом поддереве (в левом поддереве все ключи меньше [math]current.key[/math] ). Если же [math]x \lt current.key[/math] , то [math]x \lt next(x) \leqslant current.key[/math] , поэтому [math]current[/math] может быть следующим для ключа [math]x[/math] , либо следующий узел содержится в левом поддереве [math]current[/math] . Перейдем к нужному поддереву и повторим те же самые действия.
Аналогично реализуется операция поиска предыдущего элемента.Node next(x : T): Node current = root, successor = null // root — корень дерева while current != null if current.key > x successor = current current = current.left else current = current.right return successor
Вставка
Операция вставки работает аналогично поиску элемента, только при обнаружении у элемента отсутствия ребенка нужно подвесить на него вставляемый элемент.
Реализация с использованием информации о родителе
func insert(x : Node, z : Node): // x — корень поддерева, z — вставляемый элемент while x != null if z.key > x.key if x.right != null x = x.right else z.parent = x x.right = z break else if z.key < x.key if x.left != null x = x.left else z.parent = x x.left = z break
Реализация без использования информации о родителе
Node insert(x : Node, z : T): // x — корень поддерева, z — вставляемый ключ if x == null return Node(z) // подвесим Node с key = z else if z < x.key x.left = insert(x.left, z) else if z > x.key x.right = insert(x.right, z) return x
Время работы алгоритма для обеих реализаций — [math]O(h)[/math] .
Удаление
Нерекурсивная реализация
Для удаления узла из бинарного дерева поиска нужно рассмотреть три возможные ситуации. Если у узла нет дочерних узлов, то у его родителя нужно просто заменить указатель на [math]null[/math] . Если у узла есть только один дочерний узел, то нужно создать новую связь между родителем удаляемого узла и его дочерним узлом. Наконец, если у узла два дочерних узла, то нужно найти следующий за ним элемент (у этого элемента не будет левого потомка), его правого потомка подвесить на место найденного элемента, а удаляемый узел заменить найденным узлом. Таким образом, свойство бинарного дерева поиска не будет нарушено. Данная реализация удаления не увеличивает высоту дерева. Время работы алгоритма — [math]O(h)[/math] .
Случай Иллюстрация Удаление листа 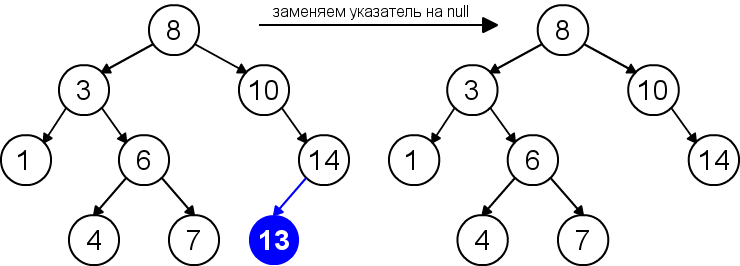
Удаление узла с одним дочерним узлом 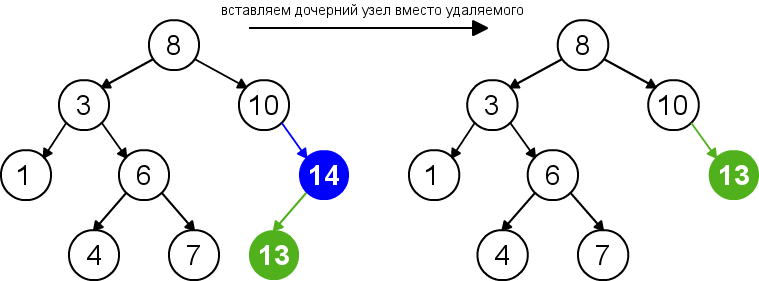
Удаление узла с двумя дочерними узлами 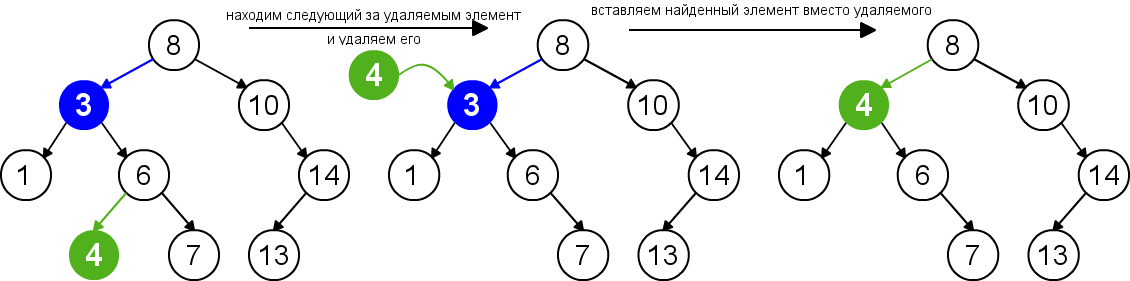
func delete(t : Node, v : Node): // — дерево, — удаляемый элемент p = v.parent // предок удаляемого элемента if v.left == null and v.right == null // первый случай: удаляемый элемент - лист if p.left == v p.left = null if p.right == v p.right = null else if v.left == null or v.right == null // второй случай: удаляемый элемент имеет одного потомка if v.left == null if p.left == v p.left = v.right else p.right = v.right v.right.parent = p else if p.left == v p.left = v.left else p.right = v.left v.left.parent = p else // третий случай: удаляемый элемент имеет двух потомков successor = next(v, t) v.key = successor.key if successor.parent.left == successor successor.parent.left = successor.right if successor.right != null successor.right.parent = successor.parent else successor.parent.right = successor.right if successor.right != null successor.right.parent = successor.parent
Рекурсивная реализация
При рекурсивном удалении узла из бинарного дерева нужно рассмотреть три случая: удаляемый элемент находится в левом поддереве текущего поддерева, удаляемый элемент находится в правом поддереве или удаляемый элемент находится в корне. В двух первых случаях нужно рекурсивно удалить элемент из нужного поддерева. Если удаляемый элемент находится в корне текущего поддерева и имеет два дочерних узла, то нужно заменить его минимальным элементом из правого поддерева и рекурсивно удалить этот минимальный элемент из правого поддерева. Иначе, если удаляемый элемент имеет один дочерний узел, нужно заменить его потомком. Время работы алгоритма — [math]O(h)[/math] . Рекурсивная функция, возвращающая дерево с удаленным элементом [math]z[/math] :
Node delete(root : Node, z : T): // корень поддерева, удаляемый ключ if root == null return root if z < root.key root.left = delete(root.left, z) else if z > root.key root.right = delete(root.right, z) else if root.left != null and root.right != null root.key = minimum(root.right).key root.right = delete(root.right, root.key) else if root.left != null root = root.left else if root.right != null root = root.right else root = null return root
Задачи о бинарном дереве поиска
Проверка того, что заданное дерево является деревом поиска
Задача: Определить, является ли заданное двоичное дерево деревом поиска. 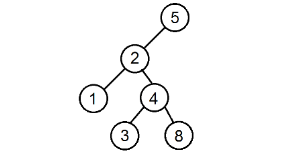
Пример дерева, для которого недостаточно проверки лишь его соседних вершин
Для того чтобы решить эту задачу, применим обход в глубину. Запустим от корня рекурсивную логическую функцию, которая выведет [math]\mathtt[/math] , если дерево является BST и [math]\mathtt[/math] в противном случае. Чтобы дерево не являлось BST, в нём должна быть хотя бы одна вершина, которая не попадает под определение дерева поиска. То есть достаточно найти всего одну такую вершину, чтобы выйти из рекурсии и вернуть значение [math]\mathtt[/math] . Если же, дойдя до листьев, функция не встретит на своём пути такие вершины, она вернёт значение [math]\mathtt[/math] .
Функция принимает на вход исследуемую вершину, а также два значения: [math]\mathtt[/math] и [math]\mathtt[/math] , которые до вызова функции равнялись [math] \infty [/math] и [math] -\infty [/math] соответственно, где [math] \infty [/math] — очень большое число, т.е. ни один ключ дерева не превосходит его по модулю. Казалось бы, два последних параметра не нужны. Но без них программа может выдать неверный ответ, так как сравнения только вершины и её детей недостаточно. Необходимо также помнить, в каком поддереве для более старших предков мы находимся. Например, в этом дереве вершина с номером [math]8[/math] находится левее вершины, в которой лежит [math]5[/math] , чего не должно быть в дереве поиска, однако после проверки функция бы вернула [math]\mathtt[/math] .
bool isBinarySearchTree(root: Node): // Здесь root — корень заданного двоичного дерева. bool check(v : Node, min: T, max: T): // min и max — минимально и максимально допустимые значения в вершинах поддерева. if v == null return true if v.key or max return false return check(v.left, min, v.key) and check(v.right, v.key, max) return check(root, , )
Время работы алгоритма — [math]O(n)[/math] , где [math]n[/math] — количество вершин в дереве.
Задачи на поиск максимального BST в заданном двоичном дереве
Задача: Найти в данном дереве такую вершину, что она будет корнем поддерева поиска с наибольшим количеством вершин. Если мы будем приведённым выше способом проверять каждую вершину, мы справимся с задачей за [math]O(n^2)[/math] . Но её можно решить за [math]O(n)[/math] , идя от корня и проверяя все вершины по одному разу, основываясь на следующих фактах:
- Значение в вершине больше максимума в её левом поддереве;
- Значение в вершине меньше минимума в её правом поддереве;
- Левое и правое поддерево являются деревьями поиска.
Введём [math]\mathtt[/math] и [math]\mathtt[/math] , которые будут хранить минимум в левом поддереве вершины и максимум в правом. Тогда мы должны будем проверить, являются ли эти поддеревья деревьями поиска и, если да, лежит ли ключ вершины [math]\mathtt[/math] между этими значениями [math]\mathtt[/math] и [math]\mathtt[/math] . Если вершина является листом, она автоматически становится деревом поиска, а её ключ — минимумом или максимумом для её родителя (в зависимости от расположения вершины). Функция [math]\mathtt[/math] записывает в [math]\mathtt[/math] количество вершин в дереве, если оно является деревом поиска или [math]\mathtt[/math] в противном случае. После выполнения функции ищем за линейное время вершину с наибольшим значением [math]\mathtt[/math] .
int count(root: Node): // root — корень заданного двоичного дерева. int cnt(v: Node): if v == null v.kol = 0 return = 0 if cnt(v.left) != -1 and cnt(v.right) != -1 if v.left == null and v.right == null v.min = v.key v.max = v.key v.kol = 1 return 1 if v.left == null if v.right.max > v.key v.min = v.key v.kol = cnt(v.right) + 1 return v.kol if v.right == null if v.left.min < v.key v.max = v.key v.kol = cnt(v.left) + 1 return v.kol if v.left.min < v.key and v.right.max > v.key v.min = v.left.min v.max = v.right.max v.kol = v.left.kol + v.right.kol + 1 v.kol = cnt(v.left) + cnt(v.right) + 1 return v.kol return -1 return cnt(root)
Алгоритм работает за [math]O(n)[/math] , так как мы прошлись по дереву два раза за время, равное количеству вершин.
Восстановление дерева по результату обхода preorderTraversal
Задача: Восстановить дерево по последовательности, выведенной после выполнения процедуры [math]\mathrm[/math] . Восстановление дерева поиска по последовательности ключей
Как мы помним, процедура [math]\mathrm[/math] выводит значения в узлах поддерева следующим образом: сначала идёт до упора влево, затем на каком-то моменте делает шаг вправо и снова движется влево. Это продолжается до тех пор, пока не будут выведены все вершины. Полученная последовательность позволит нам однозначно определить расположение всех узлов поддерева. Первая вершина всегда будет в корне. Затем, пока не будут использованы все значения, будем последовательно подвешивать левых сыновей к последней добавленной вершине, пока не найдём номер, нарушающий убывающую последовательность, а для каждого такого номера будем искать вершину без правого потомка, хранящую наибольшее значение, не превосходящее того, которое хотим поставить, и подвешиваем к ней элемент с таким номером в качестве правого сына. Когда мы, желая найти такую вершину, встречаем какую-нибудь другую, уже имеющую правого сына, проходим по ветке вправо. Мы имеем на это право, так как если такая вершина стоит, то процедура обхода в ней уже побывала и поворачивала вправо, поэтому спускаться в другую сторону смысла не имеет. Вершину с максимальным ключом, с которой будем начинать поиск, будем запоминать. Она будет обновляться каждый раз, когда появится новый максимум.
Процедура восстановления дерева работает за [math]O(n)[/math] .
Разберём алгоритм на примере последовательности [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] .
Будем выделять красным цветом вершины, рассматриваемые на каждом шаге, чёрным жирным — их родителей, курсивом — убывающие подпоследовательности (в случаях, когда мы их рассматриваем) или претендентов на добавление к ним правого ребёнка (когда рассматривается вершина, нарушающая убывающую последовательность).
См. также
- Поисковые структуры данных
- Рандомизированное бинарное дерево поиска
- Красно-черное дерево
- АВЛ-дерево
Источники информации
- Википедия — Двоичное дерево поиска
- Wikipedia — Binary search tree
- Кормен, Т., Лейзерсон, Ч., Ривест, Р., Штайн, К. Алгоритмы: построение и анализ = Introduction to Algorithms / Под ред. И. В. Красикова. — 2-е изд. — М.: Вильямс, 2005. — 1296 с. — ISBN 5-8459-0857-4
Бинарные деревья — Алгоритмы на деревьях
Организация хранения данных в виде дерева позволяет обойти ограничения линейной структуры данных. Например, в последней нельзя организовать быстрыми поиск и вставку элементов одновременно. При этом в иерархической структуре данных можно эффективно выбирать и обновлять большие объемы данных.
Один из наиболее часто используемых и простых в реализации подвидов деревьев — бинарные деревья. Помимо организации поиска, бинарные деревья используют, когда разбирают математические выражения и компьютерные программы. Еще их используют, чтобы хранить данные для алгоритмов сжатия, а также они лежат в основе других структур данных, например, очереди с приоритетом, кучи и словари.
В этом уроке мы познакомимся с устройством и особенностями бинарных деревьев и разберем основные операции с его узлами.
Что такое бинарные деревья
Бинарное дерево или двоичное дерево — это дерево, в котором у каждого из его узлов не более двух дочерних узлов. При этом каждый дочерний узел тоже представляет собой бинарное дерево.
Рассмотрим примеры деревьев на следующем рисунке:
Дерево (а) — бинарное. У каждого его узла не более двух дочерних узлов, у каждого из которых тоже не более двух дочерних. Например, узлы E, G, H, I и K — листовые, значит, у них ноль дочерних узлов. У узла C только один дочерний узел, а у узлов A, B, D и F по два дочерних.
Как только правило двух дочерних нарушается, то дерево перестает относиться к классу бинарных. Так, дерево (б) не является бинарным, так как у узла E три дочерних узла.
Благодаря тому, что дочерних узлов всегда не больше двух, их называют правый и левый дочерние узлы.
Напомним, что есть завершенное и полное деревья. Для бинарных деревьев они приобретают следующий вид:
- Завершенное бинарное дерево — это бинарное дерево, в котором каждый уровень, кроме последнего, полностью заполнен, а заполнение последнего уровня производится слева направо
- Полное бинарное дерево — это бинарное дерево, в котором у каждого узла ноль или два дочерних узла
На практике чаще применяются два подвида бинарных деревьев: бинарные деревья поиска и бинарные кучи. Последние разберем в следующих уроках, а в этом сосредоточимся на первых.
Что такое бинарные деревья поиска
Бинарные деревья поиска отличаются от обычных бинарных деревьев тем, что хранят данные в отсортированном виде. Хранение значений внутри бинарного дерева поиска организовано в следующем виде:
- Все значения в узлах левого дочернего поддерева меньше значения родительского узла
- Все значения в узлах правого дочернего поддерева больше значения родительского узла
- Каждый дочерний узел тоже является бинарным деревом поиска
Благодаря такой структуре хранения данных поиск узла в бинарном дереве поиска занимает
. Это значительно меньше, если хранить значения в списках —
Если использовать отсортированный массив для хранения данных, скорость поиска элементов сравняется. Но при оценке времени вставки хранение в массиве значительно проигрывает работе с деревьями —
Такая высокая эффективность поиска в бинарном дереве поиска наблюдается только при сохранении его в сбалансированном состоянии — когда все уровни, кроме последнего полностью заполнены. Это значит, что любое добавление или удаление вершины может потребовать полное перестроение дерева. Более подробно об этой особенности мы поговорим в следующем уроке.
Рассмотрим на примере поиска элемента (10) сравнение операций поиска в отсортированном массиве, списке и бинарном дереве поиска:
Для поиска в массиве применяется традиционный подход на основе половинного деления — метод дихотомии. На схеме можно видеть что аналогичная операция и на массиве, и на бинарном дереве поиска будет выполнена за три шага. В то же время поиск этого элемента на списке займет десять шагов.
Далее поговорим о структуре бинарных деревьев и начнем реализовывать бинарное дерево в коде.
Как бинарные деревья поиска реализуются в коде
Напомним свойства бинарных деревьев:
- Должно быть не более двух дочерних узлов
- Дочерние узлы тоже должны быть бинарными деревьями
- Дочерние узлы называют левыми и правыми
В этом случае структура узла принимает следующий вид:
class BinaryTreeNode constructor(value, parent) this.left = null; //ссылка на левый дочерний узел this.right = null; //ссылка на правый дочерний this.parent = parent; //ссылка на родителя this.value = value; //полезная нагрузка > >class BinaryTreeNode public BinaryTreeNode left = null; public BinaryTreeNode right = null; public BinaryTreeNode parent; public Object value; BinaryTreeNode(Object value, BinaryTreeNode parent) this.parent = parent; this.value = value; > >class BinaryTreeNode: def __init__(self, value, parent=None): self.left = None # ссылка на левый дочерний узел self.right = None # ссылка на правый дочерний узел self.parent = parent # ссылка на родителя self.value = value # полезная нагрузкаТеперь нам необходимо расширить наш класс и реализовать необходимые операции, чтобы взаимодействовать с проектируемым классом. Начнем с операции поиска узла.
С бинарными деревьями поиска можно выполнять следующие операции:
- Искать узел
- Вставлять узел
- Удалять узел
- Выполнять обход дерева
Разберем каждую операцию подробнее.
Поиск узла
Если искомое значение бинарного дерева поиска меньше значения узла, то оно может находиться только в левом поддереве. Искомое значение, которое больше значения узла, может быть только в правом поддереве. В таком случае мы можем применить рекурсивный подход и операция поиска будет выглядеть так:
function findNode(value) let node = this; while (node) if (value == node.value) return node; if (value node.value) node = node.left; if (value > node.value) node = node.right; > return null; >class BinaryTreeNode // . BinaryTreeNode findNode(int value) BinaryTreeNode node = this; while (node != null) if (value == node.value) return node; > if (value node.value) node = node.left; > if (value > node.value) node = node.right; > > return null; > >def find_node(self, value): node = self while node: if value == node.value: return node if value node.value: node = node.left if value > node.value: node = node.right return NoneВставка узла
Все значения меньше текущего значения узла надо размещать в левом поддереве, а большие — в правом. Чтобы вставить новый узел, нужно проверить, что текущий узел не пуст. Далее может быть два пути:
- Если это так, сравниваем значение со вставляемым. По результату сравнения проводим проверку для правого или левого поддеревьев
- Если узел пуст, создаем новый и заполняем ссылку на текущий узел в качестве родителя
Операция вставки использует рекурсивный подход аналогично операции поиска. Переведем данный алгоритм на язык JavaScript и получим следующий код метода вставки:
function insertNode(value) return #insertNode(value, this) > function #insertNode(value, parentNode) if (value parentNode.value) if (parentNode.left == null) parentNode.left = new BinaryTreeNode(value, parentNode); > else #insertNode(value, parentNode.left); > > if (value > parentNode.value) if (parentNode.right == null) parentNode.right = new BinaryTreeNode(value, parentNode); > else #insertNode(value, parentNode.right); > > >class BinaryTreeNode // . public void insertNode(int value) insertNode(value, this); > private void insertNode(int value, BinaryTreeNode parentNode) if (value parentNode.value) if (parentNode.left == null) parentNode.left = new BinaryTreeNode(value, parentNode); > else insertNode(value, parentNode.left); > > if (value > parentNode.value) if (parentNode.right == null) parentNode.right = new BinaryTreeNode(value, parentNode); > else insertNode(value, parentNode.right); > > > >def insert_node(self, value): return self._insert_node(value, self) def _insert_node(self, value, parent_node): if value parent_node.value: if parent_node.left is None: parent_node.left = BinaryTreeNode(value, parent_node) else: self._insert_node(value, parent_node.left) elif value > parent_node.value: if parent_node.right is None: parent_node.right = BinaryTreeNode(value, parent_node) else: self._insert_node(value, parent_node.right)Удаление узла
Чтобы удалить элемент в связном списке, нужно найти его и ссылку на следующий элемент перенести в поле ссылки на предыдущем элементе.
Если необходимо удалить корневой узел или промежуточные вершины и сохранить структуру бинарного дерева поиска, выбирают один из следующих двух способов:
- Находим и удаляем максимальный элемент левого поддерева и используем его значение в качестве корневого или промежуточного узла
- Находим и удаляем минимальный элемент правого поддерева и используем его значение в качестве корневого или промежуточного узла
Оба варианта приемлемы для нашего дерева. Реализуем в коде второй вариант:
function removeNode(value) return #removeNode(value, this) > function #removeNode(value, node) if (node == null) return null; if (value node.value) node.left = #removeNode(value, node.left); > else if (value > node.value) node.right = #removeNode(value, node.right); > else if (node.left == null) return node.right; if (node.right == null) return node.left; > let original = node; node = node.right; while (node.left) node = node.left; > node.right = #removeMin(original.right); node.left = original.left; >class BinaryTreeNode // . private BinaryTreeNode removeNode(int value, BinaryTreeNode node) if (node == null) return null; > if (value node.value) node.left = removeNode(value, node.left); > else if (value > node.value) node.right = removeNode(value, node.right); > else if (node.left == null) return node.right; > if (node.right == null) return node.left; > > BinaryTreeNode original = node; node = node.right; while (node.left != null) node = node.left; > node.right = removeNode(original.right); node.left = original.left; return node.right; > >def remove_node(self, value): return self._remove_node(value, self) def _remove_node(self, value, node): if node is None: return None if value node.value: node.left = self._remove_node(value, node.left) return node elif value > node.value: node.right = self._remove_node(value, node.right) return node else: if node.left is None: return node.right elif node.right is None: return node.left else: original = node node = node.right while node.left: node = node.left node.right = self._remove_min(original.right) node.left = original.left return nodeРеализация первого варианта будет выглядеть практически идентично. Только есть исключение: мы будем обходить правое поддерево и искать максимальное значение узла вместо минимального.
Для деревьев также существуют специфические операции, важнейшая из которых — обход дерева. Рассмотрим эту операцию подробнее.
Обход деревьев
Когда мы поработали с деревом и нам нужно его сохранить в файл или вывести в печать, нам больше не нужен древовидный формат. Здесь мы прибегаем к обходу дерева — последовательное единоразовое посещение всех вершин дерева.
Существуют такие три варианта обхода деревьев:
- Прямой обход (КЛП): корень → левое поддерево → правое поддерево
- Центрированный обход (ЛКП): левое поддерево → корень → правое поддерево
- Обратный обход (ЛПК): левое поддерево → правое поддерево → корень
Такие обходы называются поиском в глубину. На каждом шаге итератор пытается продвинуться вертикально вниз по дереву перед тем, как перейти к родственному узлу — узлу на том же уровне. Еще есть поиск в ширину — обход узлов дерева по уровням: от корня и далее:
Реализация поиска в глубину может осуществляться или с использованием рекурсии, или с использованием стека. А поиск в ширину реализуется за счет использования очереди:
function traverseRecursive(node) if (node != null) console.log(`node = $node.val>`); traverseRecursive(node.left); traverseRecursive(node.right); > > function traverseWithStack() let stack = []; stack.push(this); while (stack.length > 0) let currentNode = stack.pop(); console.log(`node = $currentNode.val>`); if (currentNode.right != null) stack.push(currentNode.right); > if (currentNode.left != null) stack.push(currentNode.left); > > > function traverseWithQueue() let queue = []; queue.push(this.root); while (queue.length > 0) let currentNode = queue.shift(); console.log(`node = $currentNode.val>`); if (currentNode.left) queue.push(currentNode.left); > if (currentNode.right) queue.push(currentNode.right); > > >class BinaryTreeNode // . public void traverseRecursive() traverseRecursive(this); > private void traverseRecursive(BinaryTreeNode node) if (node != null) System.out.println("node color: #000000;font-weight: bold">+ node.value); traverseRecursive(node.left); traverseRecursive(node.right); > > public void traverseWithStack() DequeBinaryTreeNode> stack = new ArrayDeque<>(); stack.push(this); while (stack.size() > 0) BinaryTreeNode currentNode = stack.pop(); System.out.println("node color: #000000;font-weight: bold">+ currentNode.value); if (currentNode.right != null) stack.push(currentNode.right); > if (currentNode.left != null) stack.push(currentNode.left); > > > public void traverseWithQueue() DequeBinaryTreeNode> queue = new ArrayDeque<>(); queue.push(this); while (queue.size() > 0) BinaryTreeNode currentNode = queue.removeFirst(); System.out.println("node" + currentNode.value); if (currentNode.left != null ) queue.push(currentNode.left); > if (currentNode.right != null) queue.push(currentNode.right); > > > >def traverse_recursive(node): if node is not None: print(f"node = node.value>") traverse_recursive(node.left) traverse_recursive(node.right) def traverse_with_stack(root): stack = [] stack.append(root) while len(stack) > 0: current_node = stack.pop() print(f"node = current_node.value>") if current_node.right is not None: stack.append(current_node.right) if current_node.left is not None: stack.append(current_node.left) def traverse_with_queue(root): queue = [] queue.append(root) while len(queue) > 0: current_node = queue.pop(0) print(f"node = current_node.value>") if current_node.left: queue.append(current_node.left) if current_node.right: queue.append(current_node.right)