Как ускорить Data Science с помощью GPU
Аналитикам данных нужны вычислительные мощности. Обрабатываете ли вы большой датасет в Pandas или перемножаете множество матриц с Numpy — вам понадобится производительная машина, чтобы выполнить работу в разумные сроки. В этой статье мы наглядно покажем, как с помощью GPU можно ускорить обработку данных в десятки раз.
За последние несколько лет библиотеки Python, предназначенные для Data Science, довольно хорошо научились использовать возможности CPU. Например, Pandas отлично справляется с обработкой наборов данных, размер которых превышает 100 ГБ. А если у вашей машины недостаточно ОЗУ, вы всегда можете использовать удобные функции, разбивающие данные на небольшие пакеты и обрабатывающие по одному фрагменту за раз.
GPU vs CPU: параллельная обработка
CPU лучше справляются с процессами, где большую роль играет тактовая частота. Также стоит использовать его в задачах, которые нельзя реализовать на GPU. В свою очередь, графический процессор гораздо эффективнее выполняет программы, выигрывающие от параллельной обработки.

Большое влияние GPU оказывают на Deep Learning. Повторяющиеся вычисления, например, свёртку, можно ускорить с их помощью до 100 раз.
В Data Science тоже присутствуют многократно выполняемые операции, которые обрабатывают большие наборы данных с помощью таких библиотек как Pandas, Numpy и Scikit-Learn. На GPU выполнять эти операции достаточно просто.
Ускорение GPU с Rapids
Rapids — набор программных библиотек, предназначенных для ускорения Data Science за счет использования графических процессоров. Он генерирует низкоуровневый код CUDA для быстрого выполнения алгоритмов, оптимизированных на GPU, и в то же время имеет простую реализацию на Python.
Преимущество Rapids в том, что он хорошо интегрируется в библиотеки Data Science. Например, Pandas dataframe можно легко передать в Rapids и ускорить обработку на GPU. На рисунке ниже показано, как Rapids делает доступным низкоуровневое ускорение, сохраняя при этом высокоуровневую реализацию.

Rapids использует несколько Python-библиотек:
— cuDF: dataframes для GPU. Поддерживает практически те же способы обработки данных, что и Pandas.
— CuML: библиотека для машинного обучения. Содержит множество алгоритмов ML, которые есть в Scikit-Learn.
— cuGraph: обработка графов на GPU. Поддерживает много основных алгоритмов анализа графов, включая PageRank.
Гайд по использованию Rapids
Установка
Теперь вы увидите Rapids в действии!
В качестве примера мы запустим простой код на сервере с GPU NVIDIA Tesla V100.
Для демонстрации мы решили запустить код на двух GPU NVIDIA Tesla V100 и сравнить время выполнения с Nvidia Data Science Work Station, которая работает на двух GPU NVIDIA Quadro RTX 8000.
Чтобы загрузить и запустить образ с Rapids и всем необходимым ПО, мы использовали следующие команды. В этом примере мы выбрали конфигурацию с Ubuntu 18.04, CUDA 10.0 и Python 3.7. Вы можете поменять версии и скопировать команды для установки на сайте Rapids.
How to use Jupyter notebooks on the GPU nodes
Users can run jupyter notebooks directly on the GPU nodes (or any other node) while accessing the notebeook from a browser within a ThinLinc session, or via an ssh tunnel.
Overview
- start an interactive session
- load an anaconda module
- start a jupyter notebook in the background
- access from a web browser in
- in a ThinLinc remote desktop session
- over an ssh tunnel
- terminate the juptyer notebook when done
Full Procedure
- Request an interactive session on a GPU node
srun --account=my-account-id --partition=gpu --gpus=1 --time=2:00:00 --x11 --pty bash
When the interactive session is allocated, this will provide you with a command prompt on the allocated node e.g.
[acs03XXX@gpu01]$ module load anaconda/python-3.8.8/2021.05 jupyter-notebook --no-browser --ip=gpu01 > notebook-output 2>&1 & jupyter notebook list This will return something like:
http://gpu01:8888/?token=4f1f3e780d70d75c09b4ce6c77289f52cdd79047bb461665 :: /users/acs03XXX http://gpu01:8888/?token=4f1f3e780d70d75c09b4ce6c77289f52cdd79047bb461665 jupyter notebook stop How to make Jupyter Notebook to run on GPU?
Jupyter Notebook is one of the most popular IDEs for data science in python. If you already have Python 3.x and Anaconda installed, you can launch Jupyter Notebook from Anaconda Navigator.
After launching Jupyter Notebook, if you click on New, you will see a dropdown menu to select a virtual environment to choose to launch the notebook. By default, you will only see Python3 environment. Once you select that new notebook page will be opened in separate tab, where you can start doing your coding. This Python3 virtual environment will use your computer’s CPU to compute your code.
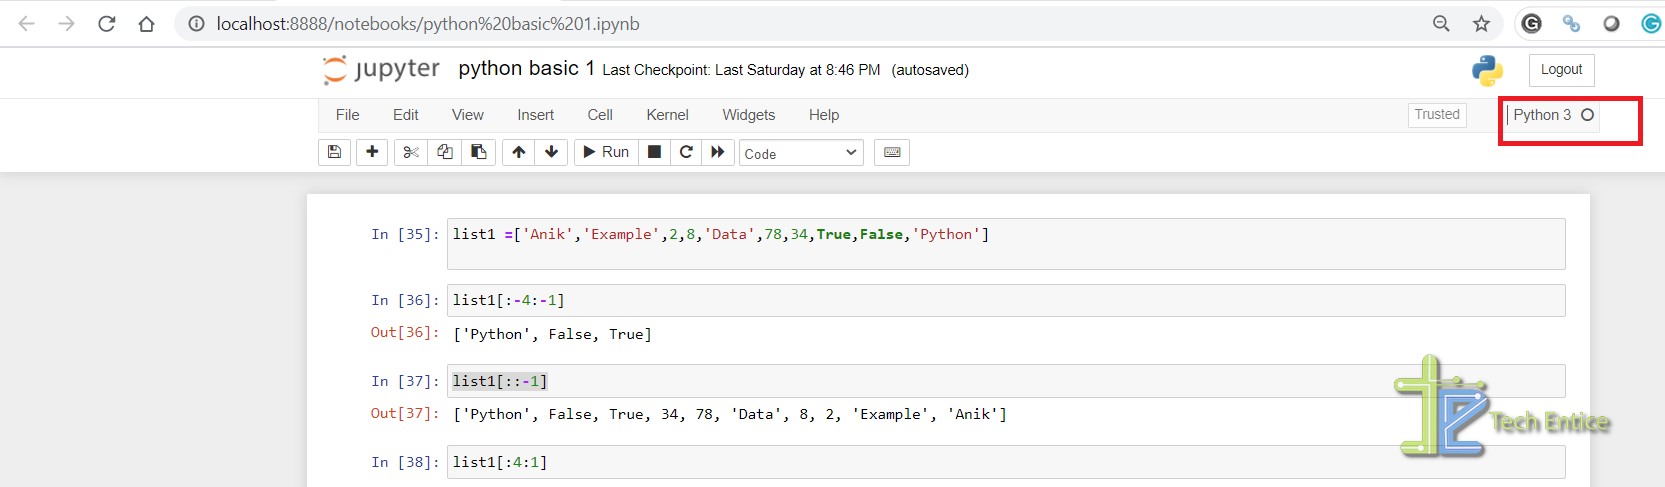
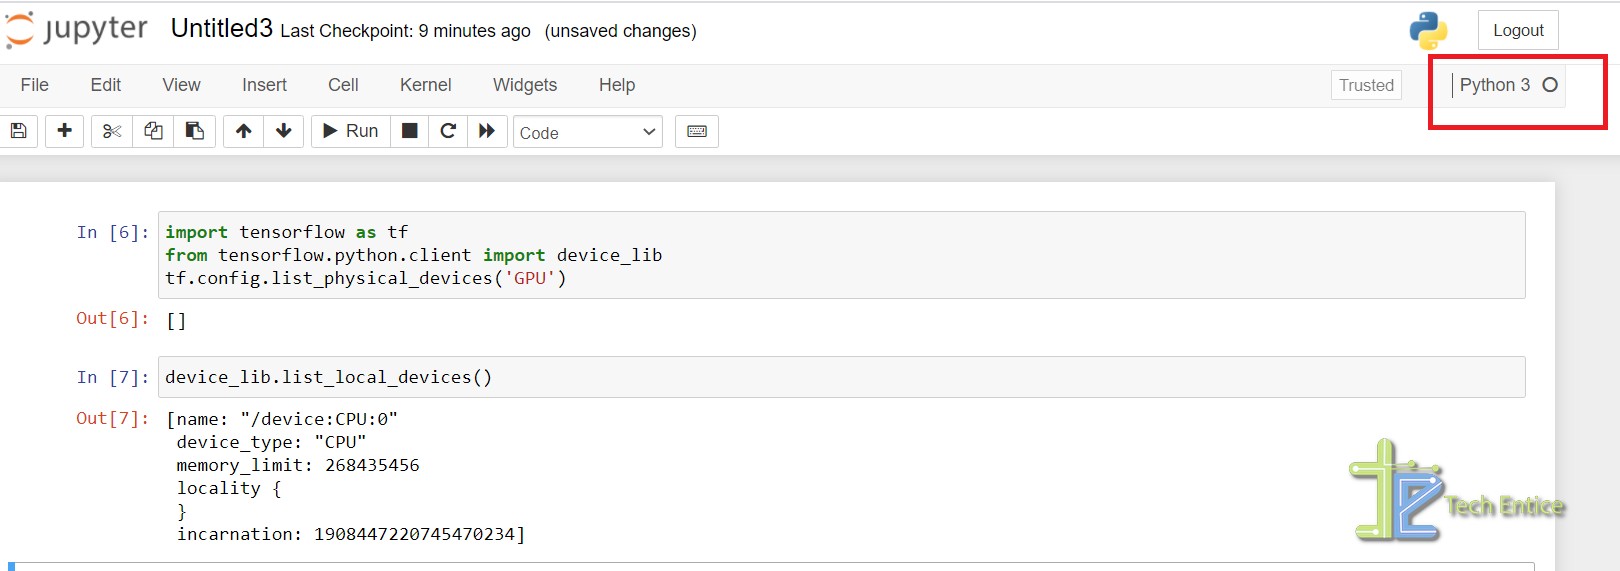
It should be enough if you are doing EDA tasks or running simple ML tasks on limited dataset. But if you want to run some heavy computing tasks like training AI and DL models, fine tuning a BERT model, Image processing etc. then you might need an environment with GPU or TPU.
If you have already worked in Kaggle or Google Colab, then you must have seen that there is option in both the platform to choose whether you want to run your model on CPU, GPU or TPU and you can select that runtime env. before launching your notebook. You can do the same thing in your local system if your local system already has a GPU (preferably Nvidia GPU).
Before following below steps make sure that below pre-requisites are in place:
- Python 3.x is installed.
- Anaconda is installed.
- CUDA toolkit is installed.
Steps to run Jupyter Notebook on GPU
- Create a new environment using conda:
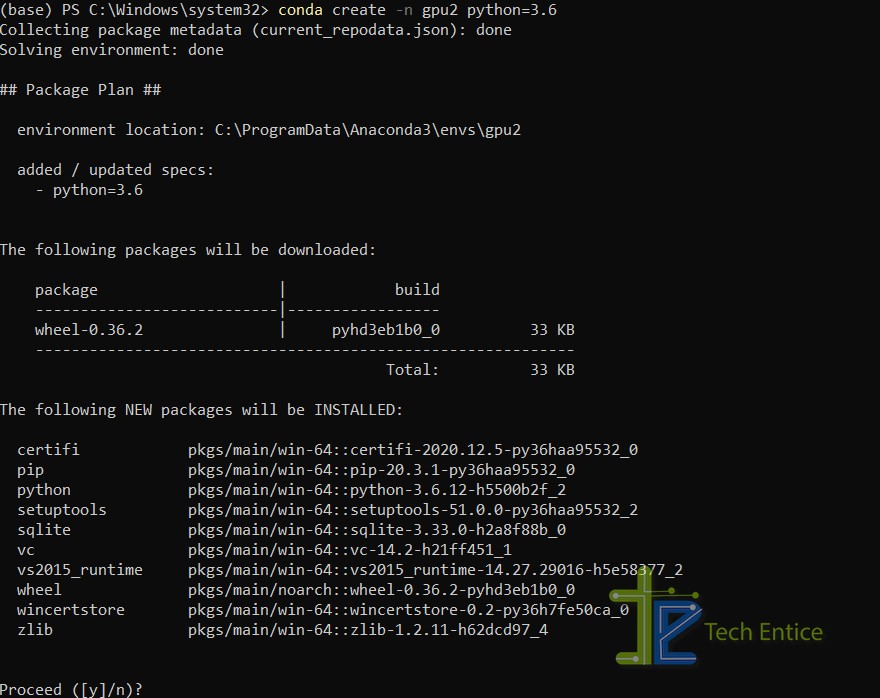
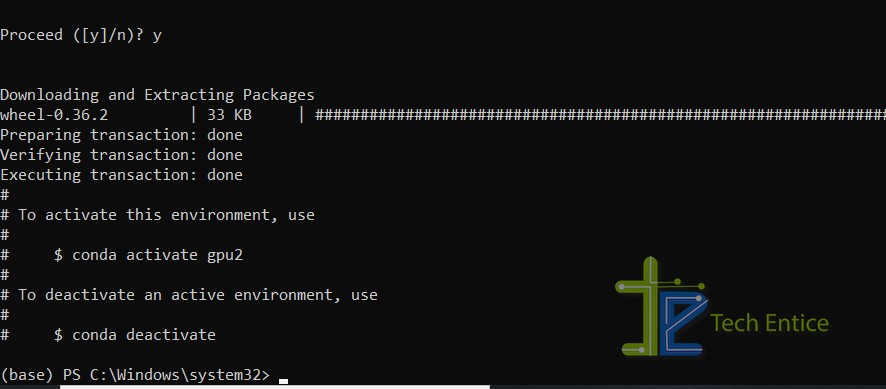
Open command prompt with Admin privilege and run below command to create a new environment with name gpu2.
conda create -n gpu2 python=3.6
Follow the on-screen instructions as shown below and gpu2 environment will be created.
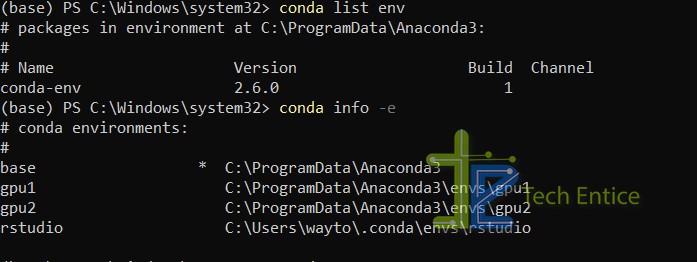
- Run below command to list all available environments.
conda info -e
- Now, run below command to activate / enable newly created gpu2 environment.
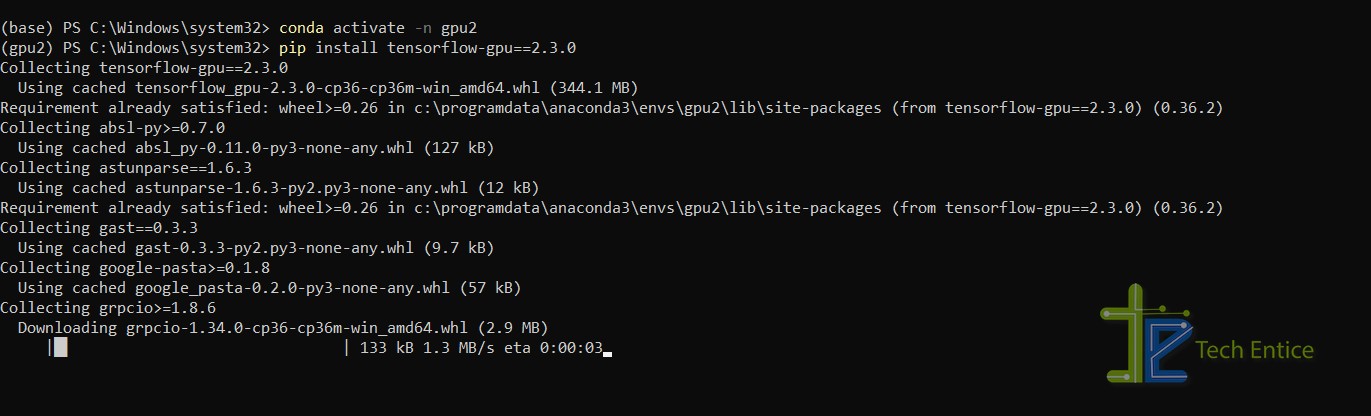
conda activate -n gpu2
- Install tensorflow-gpu. Here I have installed tensorflow-gpu v2.3.0.
You can check below link to find the compatibale tensorflow-gpu version with your install Python version.
pip install tensorflow-gpu==2.3.0
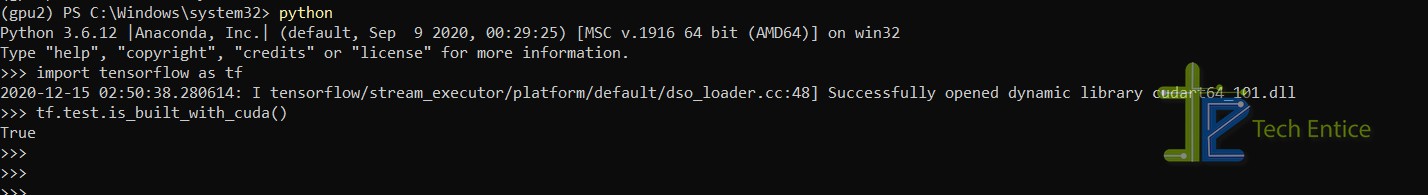
- Use tf.test.is_built_with_cuda() to validate if TensorFlow was built with CUDA support. You can see below it’s returning True.
- Install ipykernal by running below command. Before running this make sure that you already have activated gpu2 environment (step 3).
conda install -c anaconda ipykernel
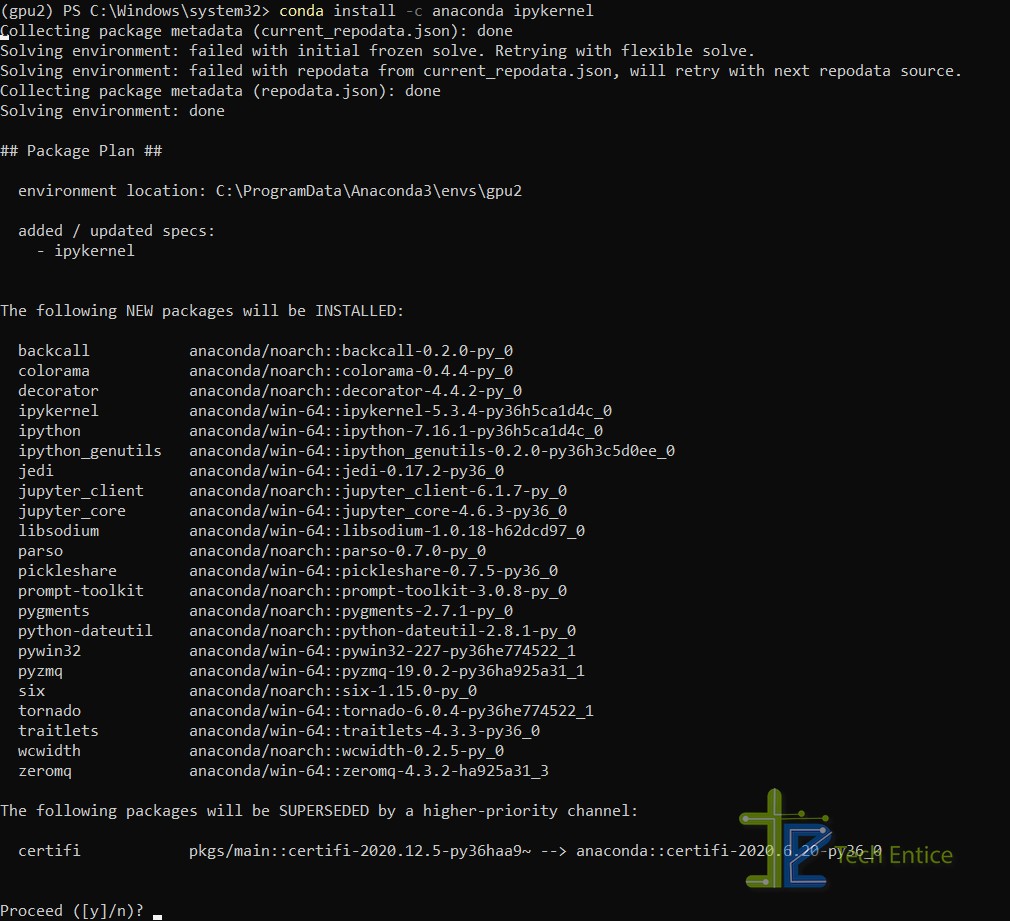
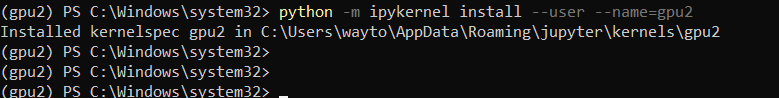
- Now install the new kernel by running below command:
python -m ipykernel install –user –name=gpu2
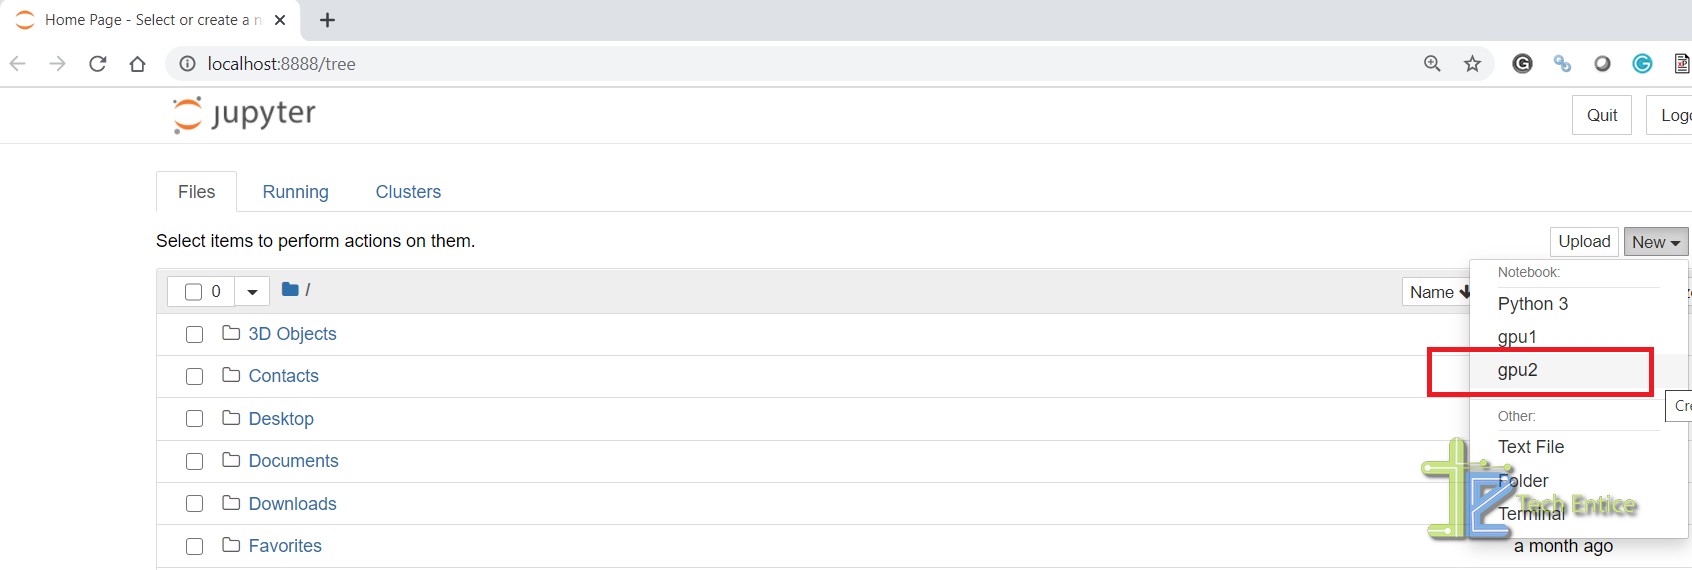
- Now, this new environment (gpu2) will be added into your Jupyter Notebook. Launch Jupyter Notebook and you will be able to select this new environment.
- Launch a new notebook using gpu2 environment and run below script. It will show you all details about the available GPU.
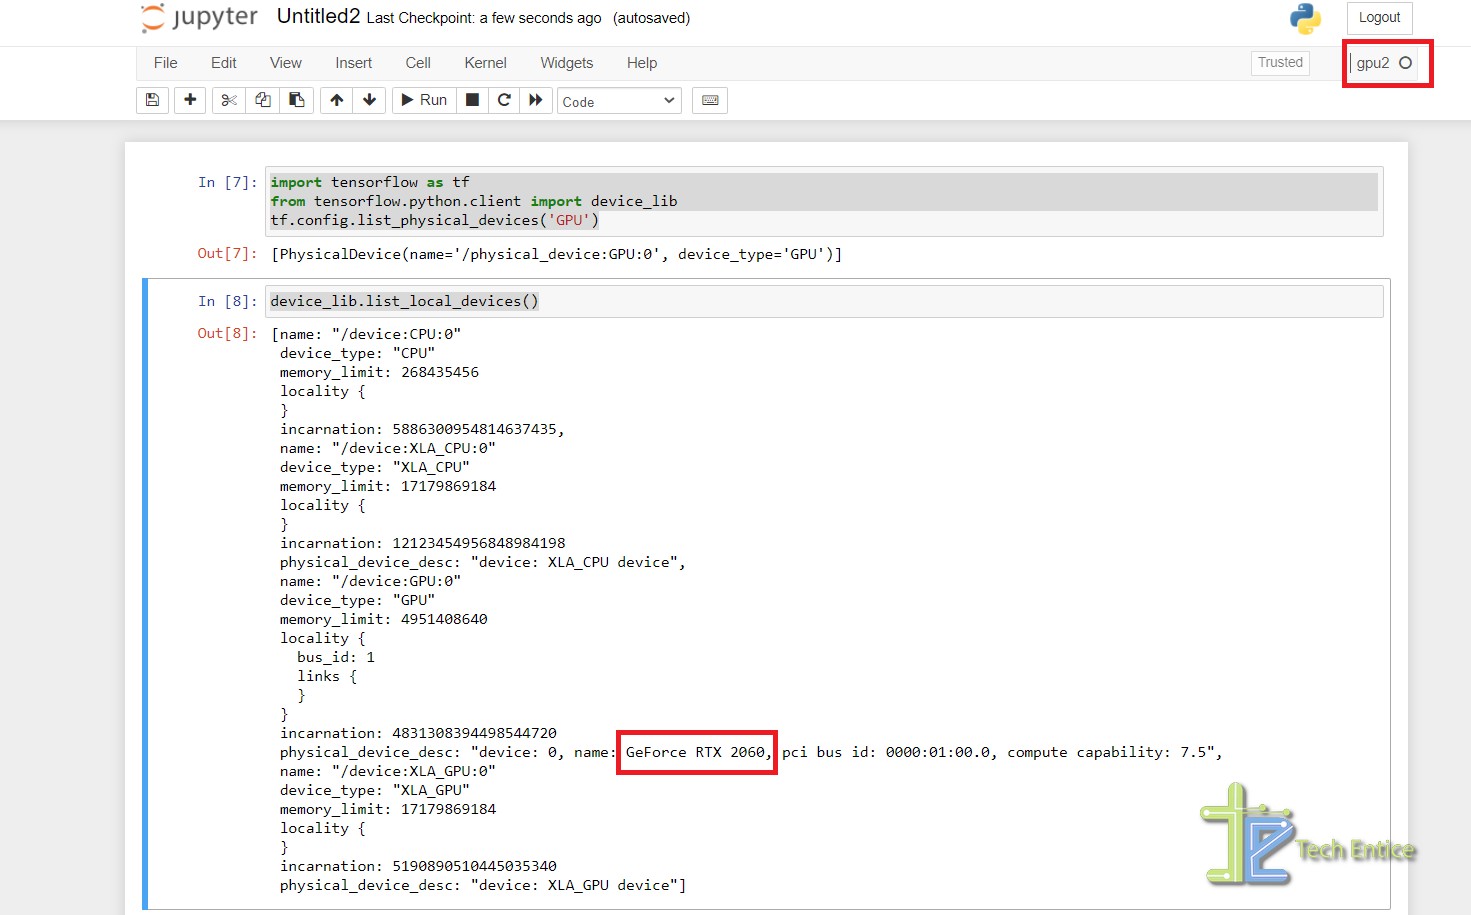
CUDA support is also available.
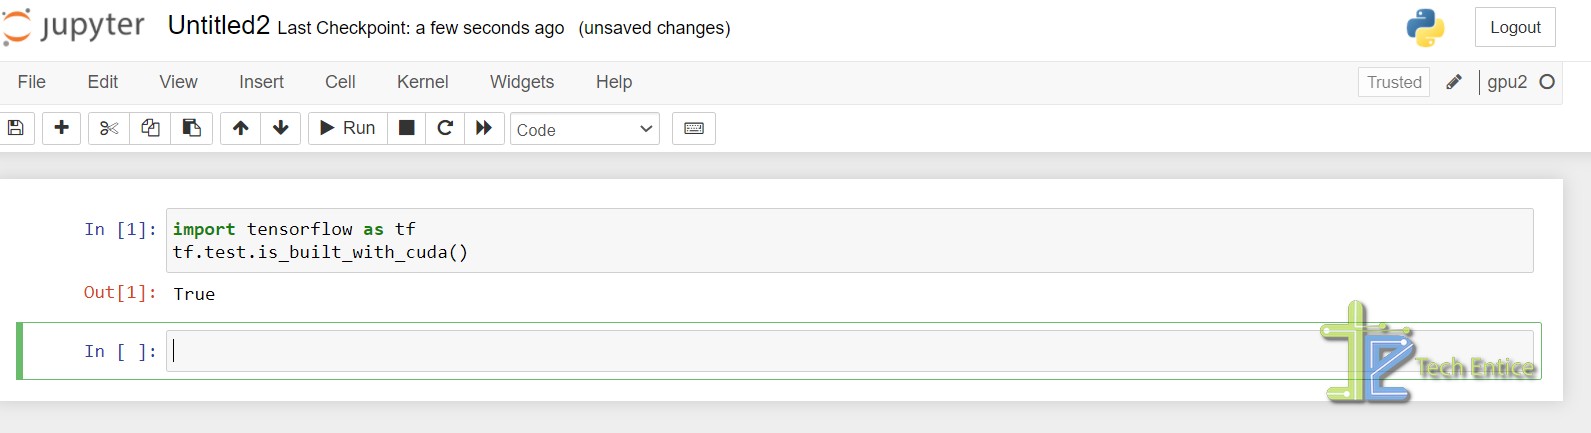
Any notebook created in gpu2 environment will use the GPU to compute and if you need only CPU to compute then you can launch the notebook in Python3 environment.
Бесплатная GPU Tesla K80 для ваших экспериментов с нейросетями
Около месяца назад Google сервис Colaboratory, предоставляющий доступ к Jupyter ноутбукам, включил возможность бесплатно использовать GPU Tesla K80 с 13 Гб видеопамяти на борту. Если до сих пор единственным препятствием для погружения в мир нейросетей могло быть отсутствие доступа к GPU, теперь Вы можете смело сказать, “Держись Deep Learning, я иду!”.
Я попробовал использовать Colaboratory для работы над kaggle задачами. Мне больше всего не хватало возможности удобно сохранять натренированные tensorflow модели и использовать tensorboard. В данном посте, я хочу поделиться опытом и рассказать, как эти возможности добавить в colab. А напоследок покажу, как можно получить доступ к контейнеру по ssh и пользоваться привычными удобными инструментами bash, screen, rsync.
Для начала, почему это интересно
Наличие GPU ускорителя является критическим фактором для скорости обучения deep learning моделей. Без GPU обучение нейросети займет многие часы/дни и не позволит полноценно экспериментировать со структурой сети. Объем видеопамяти так же важен. Больше памяти — можно установить больший размер батча и использовать более сложные модели. На сегодняшний день 13G это хороший объем, если захотите получить примерно столько же у себя на столе, придется покупать GPU уровня GTX 1080 Ti.
Что такое Colaboratory
Это форк популярной среды Jupyter notebook. Ваши ноутбуки доступны через google drive в .ipynb формате и вы можете их запускать у себя локально. Поддерживается Python 2.7 и 3.6. Код исполняется на сервере в docker контейнере. Можно закрыть браузер, все процессы на сервере продолжат работать, позже можно подключиться к серверу снова. Docker контейнер выдается вам во временное пользование на 12 часов. Вы имеете root привилегии, и можете устанавливать и запускать любые программы внутри контейнера. Colaboratory (далее colab) также поддерживает совместную работу над ноутбуком, по типу google docs. Это отличная платформа для начала изучения deep learning, machine learning. Многие бесплатные курсы, например Открытый курс машинного обучения используют Jupyter notebook формат для своих учебных материалов.
Запускаем обучение
Для создания нового ноутбука перейдите по ссылке. После успешного логина и создания ноутбука в меню выберете Runtime -> Change Runtime Type, в открывшемся диалоге в опции Hardware acceleration установите GPU, далее save.
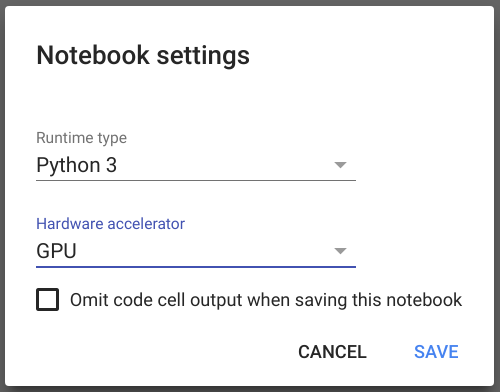
После этого можно удостовериться, что tensorflow использует GPU. Просто скопируйте этот код в первую ячейку ноутбука и выполните, нажав shift+Enter:
import tensorflow as tf tf.test.gpu_device_name()Теперь попробуем запустить простую модель tensorflow из примеров, для этого клонируем github репозиторий и запустим скрипт.
! git clone https://github.com/tensorflow/models.git %run models/samples/core/get_started/premade_estimator.py После выполнения это команды мы увидим как сеть обучиться и сделает первые предсказания. Существует достаточно много материалов описывающих возможности Jupyter, поэтому я не буду подробно на этом останавливаться.
Монтируем google drive
Всё работает отлично, но через 12 часов виртуальную машину у вас заберут и все данные внутри контейнера будут потеряны. Хорошо бы позаботиться о постоянном хранилище. В colab есть примеры как использовать импортировать данные из cloud storage, google sheets. Это предполагает явный вызов операции копирования, а мне бы хотелось иметь возможность примонтировать внешний диск к файловой системе внутри контейнера, тут на помощь приходит google drive и FUSE драйвер для него. Подключить google drive можно выполнив код, по рецепту из статьи
Код для монтирования google drive
!apt-get install -y -qq software-properties-common python-software-properties module-init-tools !add-apt-repository -y ppa:alessandro-strada/ppa 2>&1 > /dev/null !apt-get update -qq 2>&1 > /dev/null !apt-get -y install -qq google-drive-ocamlfuse fuse from google.colab import auth auth.authenticate_user() from oauth2client.client import GoogleCredentials creds = GoogleCredentials.get_application_default() import getpass !google-drive-ocamlfuse -headless -id= -secret= < /dev/null 2>&1 | grep URL vcode = getpass.getpass() !echo | google-drive-ocamlfuse -headless -id= -secret=
После этого вам будет доступна директория куда вы можете записывать данные, без опаски их потерять после остановки контейнера. Вы можете определить параметр model_dir в конфигурации модели, tensorflow будет автоматически восстанавливать состояние модели из последнего checkpoint. Таким образом, вы можете продолжить обучение модели или запустить inference в любой момент.
Tensorboard
Я люблю использовать tensorboard в процессе экспериментов со структурой и параметрами нейросети. Если вы хотите узнать больше об этом инструменте рекомендую посмотреть презентацию. Поэтому, я искал возможность, как можно запустить tensorboard в colab. Ответ нашелся на SO. Через переменную LOG_DIR вам необходимо задать путь к model_dir из конфигурации tensorflow модели, либо к корневой директории внутри которой содержиться множество сохраненных моделей.
Код для запуска tensorboard.
LOG_DIR = '/tmp' get_ipython().system_raw( 'tensorboard --logdir <> --host 0.0.0.0 --port 6006 &' .format(LOG_DIR) ) ! wget -c -nc https://bin.equinox.io/c/4VmDzA7iaHb/ngrok-stable-linux-amd64.zip ! unzip -o ngrok-stable-linux-amd64.zip get_ipython().system_raw('./ngrok http 6006 &') ! curl -s http://localhost:4040/api/tunnels | python3 -c \ "import sys, json; print(json.load(sys.stdin)['tunnels'][0]['public_url'])"После выполнения в последней строчке будет выведен URL, открыв который в браузере, мы увидим привычный нам tensorboard.
Доступ по ssh
Если у вас есть опыт использования Jupyter. То вы вероятно знаете, что выйдя за рамки игрушечных моделей, некоторые преимущества формата jupyter ноутбука становятся его недостатками. Ноутбук превращается в сложно читаемую кашу, результаты вычислений становится трудно воспроизвести. Jupyter ноутбуки остаются отличным инструментом для обучения, визуализации и небольших экспериментов. Однако, в средних по величине проектах, я предпочитаю структурировать python код классическим способом, используя разбиение на модули и классы. Работать на серьезным проектом удобнее в PyCharm / Vim и т.д… Постоянно синхронизировать код через репозиторий, запускать .py файлы не очень удобно через jupyter, использовать для этого привычные инструменты намного комфортнее.
Основываясь на примере запуска tensorboard, я написал код, который открывает ssh туннель в контейнер.
#Generate root password import secrets, string password = ''.join(secrets.choice(string.ascii_letters + string.digits) for i in range(20)) #Download ngrok ! wget -q -c -nc https://bin.equinox.io/c/4VmDzA7iaHb/ngrok-stable-linux-amd64.zip ! unzip -qq -n ngrok-stable-linux-amd64.zip #Setup sshd ! apt-get install -qq -o=Dpkg::Use-Pty=0 openssh-server pwgen > /dev/null #Set root password ! echo root:$password | chpasswd ! mkdir -p /var/run/sshd ! echo "PermitRootLogin yes" >> /etc/ssh/sshd_config ! echo "PasswordAuthentication yes" >> /etc/ssh/sshd_config ! echo "LD_LIBRARY_PATH=/usr/lib64-nvidia" >> /root/.bashrc ! echo "export LD_LIBRARY_PATH" >> /root/.bashrc #Run sshd get_ipython().system_raw('/usr/sbin/sshd -D &') #Ask token print("Copy authtoken from https://dashboard.ngrok.com/auth") import getpass authtoken = getpass.getpass() #Create tunnel get_ipython().system_raw('./ngrok authtoken $authtoken && ./ngrok tcp 22 &') #Print root password print("Root password: <>".format(password)) #Get public address ! curl -s http://localhost:4040/api/tunnels | python3 -c \ "import sys, json; print(json.load(sys.stdin)['tunnels'][0]['public_url'])"Для создания TCP туннеля вам потребуется создать аккаунт на сайте ngrok.com и скопировать authtoken оттуда. В бесплатной версии ngrok два тунеля не поддерживаются, поэтому если http тунель на tensorboard всё еще работает, вам надо его отключить, можно это сделать например перезапустив контейнер, нажав Ctrl+M затем «.».
После запуска тунеля вы увидите в ноутбуке, примерно следующее
Root password: 3KTyBVjtD6zPZX4Helkj tcp://0.tcp.ngrok.io:15223Теперь с рабочего компьютера вы сможете залогиниться в colab контейнер используя любой ssh клиент и в данном примере хост 0.tcp.ngrok.io, порт 15223. Пример для linux
ssh root@0.tcp.ngrok.io -p15223Бонус для каглеров, для импортирования данных из kaggle и отсылки submit прямо из colaboratory вы можете использовать официальный API клиент, устанавливается командой pip install kaggle.