Правильное обнаружение проблем с помощью Zabbix
Меня зовут Алексей Владышев, я являюсь создателем Zabbix, и в данный момент я отвечаю за его архитектуру и roadmap.

Это вводная лекция, сначала я расскажу, что такое Zabbix, потом – как работает Zabbix с точки зрения высокоуровневой архитектуры и с точки зрения обнаружения проблем. Мы будем говорить о том, как обнаруживать проблемы применительно к Zabbix, как можно использовать Zabbix, чтобы обнаруживать проблемы.
Что такое Zabbix? Если вы зайдете на нашу страницу, вы увидите, что Zabbix – это Enterprise level Open Source monitoring solution, т.е. это открытое решение уровня enterprise для мониторинга. Я понимаю слово «enterprise» таким образом, что решение должно легко интегрироваться в существующую инфраструктуру. Т.е. если у вас есть большое предприятие, вы уже используете какие-то продукты – Helpdesk, Configuration Management, еще что-то – система должна легко интегрироваться.
Что отличает Zabbix от других продуктов? Я думаю, что большое отличие и достаточно большое преимущество заключается в том, что Zabbix – открытый продукт, это реально open source, т.е. у нас нет никаких закрытых версий, мы 24/7 строим продукт и отдаем его бесплатно. Пожалуйста, заходите на нашу страницу и используйте наш продукт. Есть и другие преимущества. Я не в целях рекламы, а просто в образовательном смысле – чем мы отличаемся? Zabbix является решением «все в одном», т.е. визуализация, обнаружение проблем, сбор информации различными способами – все это есть в Zabbix, вам не нужно строить вашу систему мониторинга из разных отдельных блоков.

Как работает Zabbix? Для тех, кто еще не очень представляет, мы собираем данные. Zabbix-сервер – это ядро Zabbix, в котором вся логика. Мы собираем данные различными способами. Эти данные, информация складывается в базе данных, история, потом используется информация для визуализации, и ядро занимается в том числе и анализом потока информации. Мы обнаруживаем проблемы и каким-то образом реагируем на проблемы. Есть различные виды реакции на проблемы.
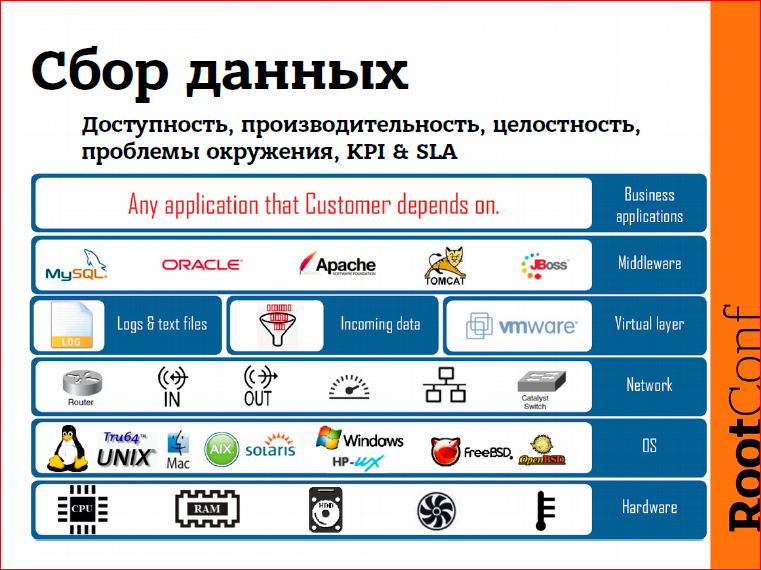
Что касается сбора данных, какие проблемы можем отлавливать? Это проблемы связанные с производительностью, с доступностью – доступен сервис или нет. Мы сразу же можем определить, насколько быстро работает система. Это проблемы с производительностью, с целостностью данных. Если у нас изменился какой-то конфигурационный файл или, может быть, image нашей системы, которую мы деплоим в cloude. Изменилась чек-сумма – Zabbix вам тут же скажет, что изменился наш файл.
Zabbix также немножко покрывает область бизнес-level мониторинга, т.е. фактически мы можем обнаруживать проблемы на различных уровнях нашей IT-инфраструктуры:
- это уровень железа – что-то произошло с какой-то железякой, мы тут же об этом узнаем,
- уровень операционной системы,
- сеть, в основном это мониторинг через SNMP,
- виртуальный уровень, т.е. «из коробки» мы предлагаем, например, мониторинг WMware инфраструктуры, vCenter и vSphere,
- дальше идет middleware,
- бизнес-приложения.
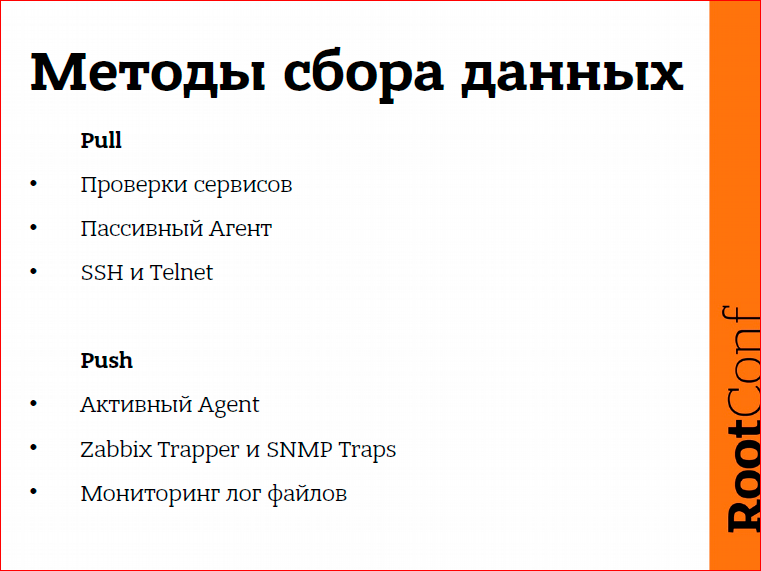
Каким образом можно собирать данные? Есть два способа: Pull – когда мы вытягиваем данные из устройства; и Push-метод – это когда само устройство сообщает нам, выдает нам информацию. Pull – это обычные проверки, допустим, SNMP, либо сервисные проверки, когда мы подключаемся к сервису, скажем, SSH, и если веб-страница корректно отвечает, значит все в порядке. Push – это в основном активный агент, различного вида Traps и SNMP Traps. Сбор данных работает через Push-метод.
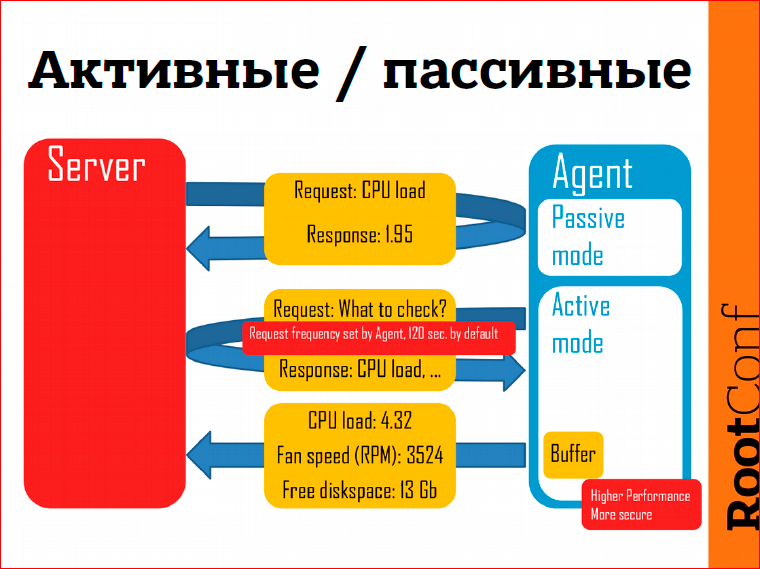
Что касается Zabbix агента. Агент – это такая программа, которую можно установить на Linux, Windows или другие операционные системы. Я хотел поговорить об активном режиме. Какие у него преимущества в плане обнаружения проблем? Если пассивный режим – это мы подключаемся к агенту, запрашиваем информацию, агент возвращает нам, скажем, загрузку процессора, то в активном режиме сам агент отправляет данные на сервер мониторинга. Здесь такие преимущества:

- это работает быстро, по крайней мере, быстрее, т.к. сервер не должен заниматься постоянным опрашиванием устройств, сами устройства отправляют информацию,
- более безопасно с точки зрения агента, потому что агент не должен слушать никакие TCP-соединения или сетевые соединения.
- небольшое преимущество, то, что нам сегодня важно – в активном режиме есть буферизация. Если Zabbix-сервер недоступен по каким-то причинам, допустим, мы делаем апгрейд Zabbix-сервера, у нас downtime несколько минут, то данные будут накапливаться на стороне агента. Как только мы сервер запускаем, данные тут же отправятся на сторону сервера, и мы их сможем обрабатывать.
Вообще, стоит вопрос: как часто опрашивать устройство, как часто собирать данные?
Конечно, хотелось бы опрашивать данные раз в секунду, любые устройства опрашивать раз в секунду, собирать какие-то Гбайты информации. Как только проблема возникает, тут же, через секунду, мы понимаем, что у нас есть проблема. Но тут есть такой принцип: мы не должны навредить системе. Как в квантовой физике – наблюдатель влияет на процесс. Если мы зачем-то наблюдаем, мы уже влияем на процесс. То же самое с системой мониторинга. Если мы начинаем собирать слишком много информации слишком часто, мы системой мониторинга влияем на ту систему, которую мы мониторим. Поэтому здесь нужно выбирать золотую середину – с одной стороны не навредить, с другой стороны мы должны обнаружить проблему как можно быстрее.
В Zabbix есть несколько вариантов. Во-первых, мы можем мониторить какое-то устройство или метрику раз в n секунд или раз в минуту мы запускаем какую-то проверку. Есть возможность использовать различную частоту в зависимости от интервала времени. Предположим, нам не важно, что система не работает в нерабочее время, нам важно, чтобы система работала в рабочее время. Тогда мы говорим Zabbix: «Проверяй, пожалуйста, рабочие станции с 9:00 до 18:00» и все. Есть такая возможность.
В Zabbix 3.0 появится новая возможность проверки типа «готово к работе», «ready for business». Это означает, что мы сможем сказать Zabbix: «Сделай эти проверки в конкретное время». Допустим, открывается филиал банка в 9 часов утра, а в 8:55 у нас есть некий чек-лист, и мы проверяем, что филиал действительно готов к работе, что с workstation’ами все в порядке, что сервисы, от которых мы зависим, в порядке, что удачно закрылся предыдущий и открылся новый финансовый день и т.д. Т.е. начиная с Zabbix 3.0 можно запускать проверки в определенное время. Если мы скажем Zabbix: «Проверь, пожалуйста, этот сервис в 8:55», Zabbix проверит сервис в 8:55. Также будет возможность совершать эти проверки с периодичностью, например, в 9:00, в 10:00, в 11:00 – ровно в это время, как мы указали.
Как в потоке информации отлавливать проблемы? Идет огромный поток информации, Zabbix совершает в секунду тысячи, десятки тысяч различных проверок производительности, доступности, и мы предлагаем решение – триггеры. Если вы используете Zabbix, вы знаете, что такое триггеры. Это, по сути, описание проблемы, т.е. мы формулируем проблему. Сначала, может быть на своем языке, а потом мы это пытаемся перевести в формат триггерных выражений.
Простое триггерное выражение, например, загрузка процессора на сервере больше 5:

Это простейший триггер. Триггеры могут быть намного более сложные, мы можем использовать арифметически-логические операции. Здесь очень важно то, что мы не ограничены одной метрикой: мы анализируем не только одну метрику, мы можем анализировать практически все, т.е. брать данные с различных устройств, использовать их в описании проблемы. Также Zabbix’у для анализа доступна как real-time информация, которую мы только-только получили, так и информация, которая у нас есть в базе данных, т.н. историческая информация.
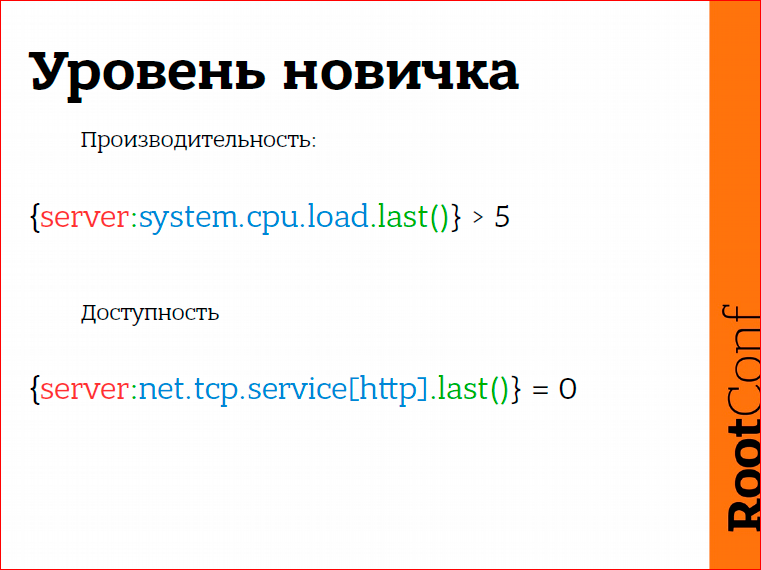
С чего обычно начинают новички, неофиты от мониторинга? Попадает им в руки Zabbix, такой мощный инструмент для того, чтобы обнаруживать проблемы, и сразу хочется узнать все обо всем. Хочется, как только что-то где-то произошло, сразу получить e-mail либо SMS. К чему это приводит? Приводит к тому, что, казалось бы, вроде бы все в порядке, вот система перегружена, создается триггер «текущая загрузка процессора больше 5», для доступности создаются триггеры, типа «сервис http недоступен», т.е. последняя проверка сказала, что веб-сервер недоступен, и мы считаем, что у нас есть проблема. Почему так делать не очень хорошо?

Такие триггеры, такие описания проблем слишком чувствительны. Загрузка процессора превысила 5, и мы считаем, что система перегружена, подключаемся через SSH, запускаем TOP, а загрузка процессора уже 4.5. Или Zabbix нам сказал, что веб-сервер не работает, на самом деле мы подключились, а он работает. Так что же происходит?
Такие вещи, эта чувствительность приводит к привыканию. Система мониторинга генерирует слишком много сообщений, и мы перестаем на них реагировать, потому что это не совсем реальные проблемы.
Просто приведу пример. В Латвии какое-то время назад был такой случай – в супермаркете сработала сигнализация, и люди, как обычно, на это не среагировали. Персонал, который должен вывести всех людей из супермаркета, подумал,: «А, сигнализация сработала, ничего страшного». Те люди, которые находились в супермаркете, подумали: «Ну, ладно, я завершу покупки и выйду». На самом деле это был предвестник того, что обрушилось все перекрытие, и погибло очень много людей.
Почему это произошло? Потому что люди привыкли, что вот сработала сигнализация, посмотрели вокруг, пожара нет. Ну, продолжаем работу или продолжаем веселиться… Но вот это привыкание – это очень-очень страшная вещь. Все-таки, если система мониторинга говорит о том, что у нас есть проблема, должна быть эта проблема, не должна система мониторинга быть уж слишком чувствительной.
Что же делать? Здесь важно правильно формулировать проблему и понимать суть. Нужно задаться вопросом: какую действительно проблему мы пытаемся описать. Что значит «система перегружена» или что означает «сервис недоступен»?
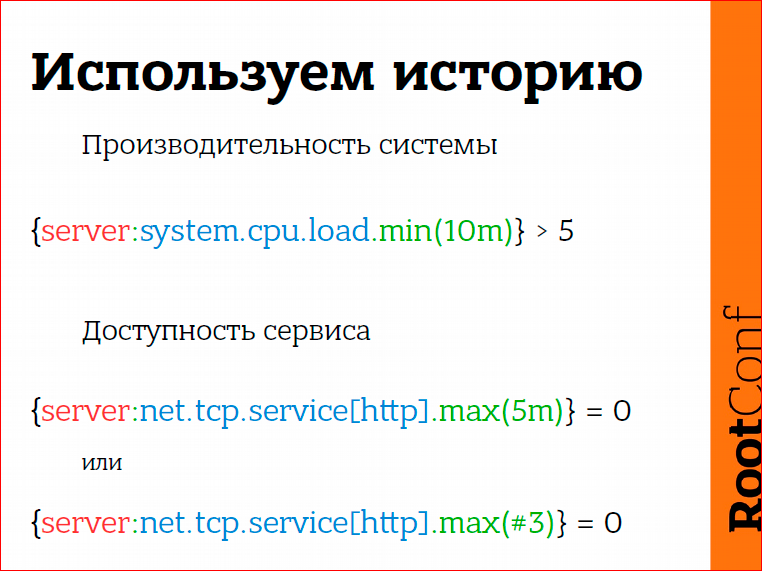
Система перегружена, скажем, загрузка процессора больше 5 (я сегодня сознательно применяю очень простые примеры, т.е. примеры могут быть более сложными, но это такой простой пример). Система перегружена – это не то, что вот сейчас у нас загрузка процессора = 5, а все-таки система должна быть нагружена в течение какого-то периода времени. И здесь мы можем анализировать историю. Т.е. скажем, последние 10 минут загрузка процессора была больше 5, тогда да, действительно система перегружена, может быть, какой-нибудь процесс завис, или еще что-то произошло.
В случае доступности сервиса что мы можем сделать? То же самое – посмотреть в историю: «А как было до этого?». Если последние 5 минут система нам отвечала, что http недоступен, то, наверное, http недоступен.
Тут еще важно понимать суть проверки. Как мы проверяем, что веб-сервер доступен? Проверяем мы следующим образом: мы делаем TCP-соединение, get-запрос, потом отсчитываем результат, и здесь что-то может пойти не так. Например, произошел timeout. Да, timeout произошел, но означает ли это, что веб-сервер не работает? Нет, не обязательно. Но если три раза у нас произошел timeout, как здесь, (#3) – это означает, что три последние проверки ответили, что сервер недоступен, тогда уже очень высока вероятность, что наш веб-сервер действительно недоступен, либо проблемы с сетью, например.
Поэтому мы все-таки должны смотреть на историю, т.е. основывать свое решение на последнем значении – это не совсем правильно в большинстве случаев.

О чем мне еще бы хотелось поговорить? Решение проблемы – не эквивалентно ее отсутствию. Что это означает?
Например, не хватает нам свободного места на диске (опять же, беру очень простые примеры). Как можно это сформулировать? Скажем, свободного места на диске осталось менее 10%. Вопрос в том: как только у нас появится 11% свободного места на диске, эта проблема решилась или не решилась? Мне кажется, что проблема все-таки не совсем решилась. Или у нас там 10% плюс 1 байт.
Так вот, в Zabbix есть механизм, который позволяет описывать различные условия для проблемной ситуации и для выхода из проблемной ситуации.
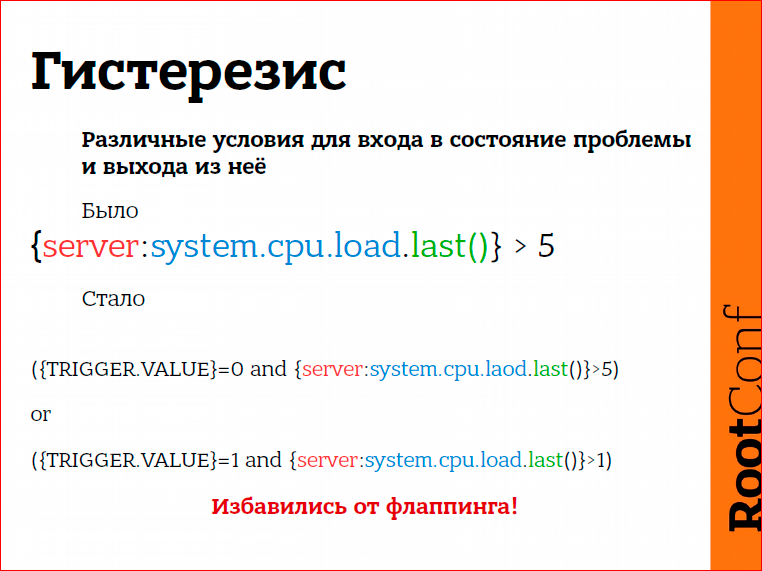
Свободного места на диске, скажем, меньше 10%, но я хочу выйти из этой проблемной ситуации только в том случае, когда у меня будет свободного места на диске 30%, не 10%, а 30%. Только в этом случае я на 100% уверен, что кто-то что-то сделал, что кто-то удалил какие-то файлы, системный администратор подключился, расширил нашу файловую систему, увеличил ее размер, в этом случае проблемы больше нет.
Для этого мы используем гистерезис. Гистерезис, по сути, означает следующее. Предположим, что мы смотрим на фотографию машины. Машина будто бы стоит, но мы не знаем ее состояния – она может стоять, может двигаться вперед, назад… Не зная историю, что до этого происходило, мы не можем сказать, в каком состоянии находится машина сейчас. Т.е. мы должны все-таки посмотреть немножечко на историю, что до этого произошло. И используя различные условия для входа в состояние проблемы и выхода из состояния проблемы, мы избавляемся от т.н. флаппинга.
Что такое флаппинг? Флаппинг – это когда используются очень простые описания проблем. Напрмер, загрузка процессора больше 5, или свободного места на диске меньше 10. Что произойдет, если у нас то 10%, то 8%, то 11%, то 7%? Это флаппинг. Проблема возникает, пропадает, возникает, пропадает. Мы приходим утром, открываем свой inbox и видим массу сообщений от Zabbix о том, что проблема была, проблема исчезла, была, исчезла, была, исчезла… К чему это приводит? К тому, что мы уже системе мониторинга не доверяем. Вот это флаппинг. И если мы используем различные условия для входа в проблему и выхода из проблемы, то мы избавляемся полностью от флаппинга.
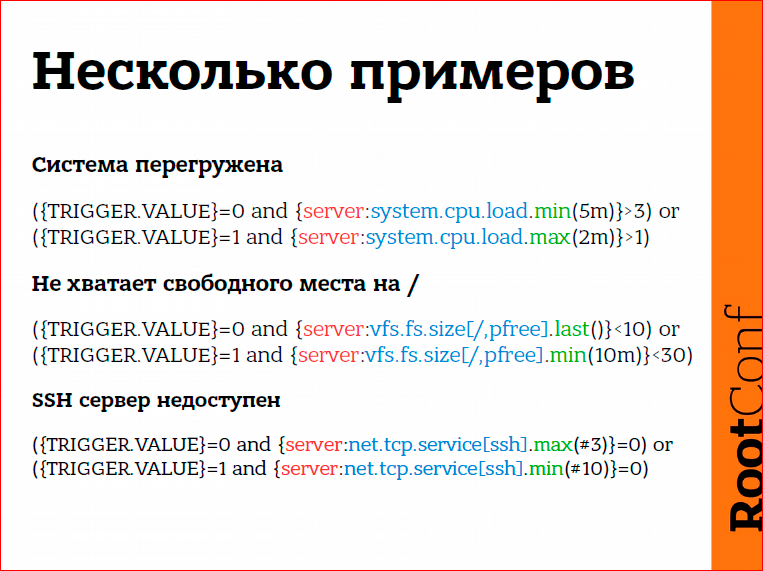
Система перегружена, загрузка процессора за последние 5 минут превышала тройку, но мы выходим из проблемы только тогда, когда последние 2 минуты загрузка процессора была меньше единицы. Здесь используется немножко другая логика, здесь первое условие – это вход в проблему, второе условие – мы остаемся в состоянии проблемы, пока есть хотя бы одно значение больше единицы.
Нет свободного места на диске. Мой пример – меньше 10%. Проблема, потому что это действительно проблема, мы тут на 100% уверены. И выходим из состояния проблемы, когда в течение последних 10-ти минут у нас было более 30% свободного места на диске. Потому что системный администратор может начать, скажем, двигать какие-то большие файлы с одной файловой системы в другую, копировать что-то. Если в течение 10-ти минут у нас есть стабильная ситуация, что свободного места на диске более 30%, мы считаем, что проблема пропала.
То же самое, SSH сервер не доступен. Три последние проверки сказали нам, что сервер недоступен, мы считаем, что сервер недоступен. Но восстановиться мы хотим только тогда, когда 10 последних проверок сказали нам, что сервер наконец-то доступен. Что происходит в реальности? У нас проблемы с сервисом, начинают его чинить, перезапускать, может быть, откатываться на какие-то старые версии, то система работает, то не работает. И вот здесь мы, как раз, описываем этот период доступности. 10 последних проверок все в порядке, вот сейчас мы точно можем пойти спать, потому что мы знаем, что сервисом все хорошо.
Аномалии. Вообще, что такое аномалии? Аномалия – это греческое слово, означающее отклонение от нормы, т.е. есть некая норма, и как только мы отклоняемся от нормы, это считается аномалией.

Как можно обнаружить аномалию? В Zabbix есть такая функциональность, когда мы за норму берем состояние системы в прошлом и сравниваем с тем, что есть в данный момент. Допустим, если средняя загрузка процессора за последний час превышает вдвое загрузку процессора за тот же период ровно неделю назад… Ни вчера, потому что если мы сравниваем со вчерашним днем, это можем быть сравнение воскресения с понедельником, пятницы с субботой – не совсем корректно. Скажем, если сегодня четверг, то мы сравниваем с тем, что было в прошлый четверг. Считаем, что это норма – то, что было в прошлый четверг. Если сегодня мы видим, что нагрузка процессора увеличилась, то Zabbix может отправить сообщение администраторам и сказать: «Эй, ребята, посмотрите, пожалуйста, какие-то у нас есть тут проблемы». Возможно, проблемы, не обязательно, конечно. Потому что это информативное сообщение. Может быть, сделали апгрейд какой-либо системы, появились регрессии в плане производительности, может быть еще что-то… Это важно.
Хорошая функциональность, я предлагаю каким-то образом начать ее использовать. Трудно сказать, принесет ли она какую-то реальную практическую пользу, но, по крайней мере, это та вещь, которая очень часто отображает предвестники более важных проблем, более серьезных проблем. Обратите на это внимание.

И зависимости. Казалось бы, вроде бы, избавились от флаппинга, от всех таких вещей, но мы все равно знаем, что у нас есть проблемы, которые зависят друг от друга.
Простейший пример на уровне сети – это когда у нас есть устройство за коммутатором. С коммутатором проблемы, система мониторинга думает, что все наши устройства отвалились, мы получаем массу SMS сообщений. Определить, что действительно произошло, что является первопричиной всех этих проблем, мы не можем.
В Zabbix мы просто определяем зависимости одной проблемы от другой. Скажем, CRM система зависит от базы данных, зависит от сети, зависит от какого-то middleware, еще чего-то. Сама база данных зависит от места на диске. В случае, если у нас нет места на диске, мы получим единственное сообщение о том, что у нас нет места на диске.
Как реагировать на проблемы?

Реакция может быть разной. Наверное, то, что надо использовать, может быть, не всегда, но часто это хорошая идея, все-таки автоматическое решение проблемы. Иногда это возможно.
Иногда мы знаем, что у нас есть приложение, которое поедает память. Поедает память и все, решения у нас нет, и это приложение просто надо время от времени перезапускать. Иногда возникает ситуация с тем, что мы получили какой-то kernel panic. Вот, время от времени получаем kernel panic, нам нужно перезапускать этот сервер. Это все можно поручить системе мониторинга. Т.е. в случае kernel panic по IPMI мы можем автоматически на уровне железа делать reset. В случае с сервисами мы можем перезапускать наши сервисы также в автоматическом режиме.
Реакция может быть просто сообщение пользователю или группе пользователей. Также реакцией может быть открытие каких-то тикетов в Helpdesk системе. Т.е. реагировать можно абсолютно по-разному, и конечно, способ реакции зависит от того, насколько серьезная проблема. Если проблема не очень серьезная, не стоит тут же отправлять SMS сообщение в 4 часа ночи, если эту проблему все равно будут решать в 10 часов утра на следующий день.
Еще есть возможность эскалировать проблемы. Т.е. возникла проблема, и дальше мы задаемся вопросом: что с этим делать, кого оповещать? Конечно, мы отправляем сообщение администраторам, администраторы что-то делают, но, я думаю, что очень эффективный вариант, это когда проблема эскалируется на уровень бюрократического дерева, на более высокий уровень, менеджеру, может быть, еще менеджеру, может быть, дальше – CEO. И CEO не будет получать сообщения вида «отвалился какой-то там диск volume, что-то там еще», CEO получит от Zabbix просто сообщение вида «последние полчаса мы теряем деньги». И все, и тогда все понятно.
Можно реагировать сразу – возникла проблема, мы тут же что-то делаем. Можно реагировать с задержкой, т.е. возникла проблема, ну, давайте подождем еще, может быть, 5 минут, и через 5 минут мы отправим сообщение. И тут еще важно следующее. Оповещение, если автоматика не сработала. Предположим, у нас есть сервис, он не работает, мы сконфигурировали Zabbix, чтобы этот сервер автоматически перезапускался. Как мы настраиваем эскалацию в этом случае? Настраиваем следующим образом: сначала мы перезапускаем сервис, и через 10 минут, если проблема все еще существует, отправляем оповещение пользователям. Либо идет дальше эскалация на более высокие уровни.
И повторные оповещения – это тоже очень важно, особенно для серьезных проблем. Какие-то вещи можно легко пропустить, можно пропустить SMS, можно пропустить e-mail сообщение, но для важных проблем надо все-таки использовать повторные сообщения. Это тоже очень хороший стимул, мы видим, что да, проблема существует, и нам надо работать, чтобы решить ее как можно раньше.

И, может быть, такой итог. Что тут важно?
-
История. Мы основываем свое решение не только на real-time мониторинге, на оперативной информации, которую мы только-только получили, но и смотрим в историю. В историю нужно обязательно смотреть. Это важно.
Контакты
Этот доклад — расшифровка одного из лучших выступлений на профессиональной конференции по эксплуатации и devops RootConf.
На сайте RootConf вы можете подписаться на рассылку про эксплуатацию и devops, где мы публикуем расшифрованные статьи, а также новости подготовки.
Ну и главная новость — мы начали подготовку весеннего фестиваля «Российские интернет-технологии», в который входит восемь конференций, включая RootConf.
Такие доклады, как этот, мы не очень любим — фактически, это ликбез про конкретную технологию. Такой доклад имеет шанс пройти только, если технологию/инструмент представляет сам разработчик инструмента — тогда это может получиться глубокое интересное выступление. И желающие могут задать свои вопросы создателю технологии напрямую.
- Блог компании Конференции Олега Бунина (Онтико)
- Системное администрирование
- IT-инфраструктура
- Серверная оптимизация
- Серверное администрирование
Zabbix: что такое и как использовать
Как крупные, так и небольшие компании постоянно анализируют работу и продуктивность устройств, которые используются при создании продукта. Поэтому существует множество мониторинговых программ. Одной из самых популярных систем такого рода является Zabbix. В этой статье мы расскажем, что такое система мониторинга Zabbix, что можно мониторить с её помощью и как эта система работает.

Итак, Zabbix ― что это за программа и какие возможности она даёт? Это система с веб-интерфейсом, которая позволяет собирать различные данные с устройств. С её помощью можно производить мониторинг сети, серверов, виртуальных машин, баз данных, приложений и устройств. Zabbix может получать данные о состоянии устройства: объёме памяти, скорости работы процессора, температуре машины, логах и др. Помимо этого, система способна наблюдать за бизнес-метриками ― к примеру скоростью продажи продукта. 14 мая 2021 года вышла последняя версия Zabbix-сервера ― Zabbix 5.4.
Мощный VPS со встроенной системой мониторинга
Рег.ру предлагает VPS с установленной программой для мониторинга Zabbix.

Как работает Zabbix
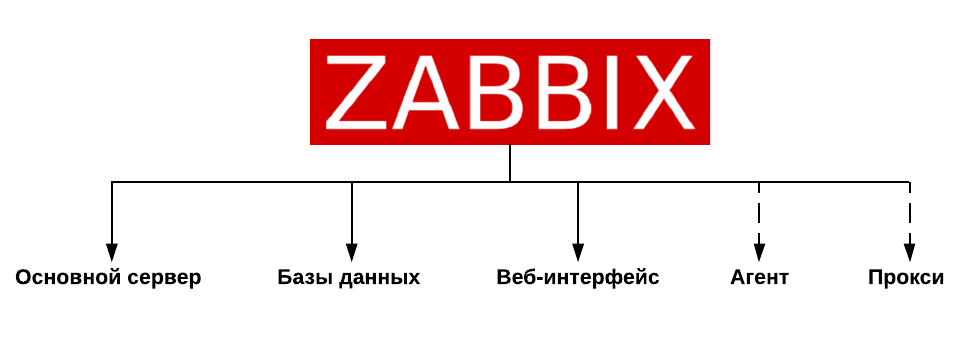
Чтобы система могла одновременно наблюдать за сотнями устройств без перегрузок, разработчики разделили всю систему на несколько компонентов:
Мониторинг серверов Zabbix
- Основной сервер. Это мозг программы. Он получает, обрабатывает и анализирует данные.
- Базы данных. В них вся информация, полученная с сервера, собирается и хранится в течение установленного пользователем времени.
- Веб-интерфейс. Позволяет легко получать доступ к настройкам Zabbix.
- Агент. Zabbix agent ― что это? Он работает на сервере в режиме демона. Агент может быть как в активном режиме (сам запрашивает список нужных параметров), так и в пассивном (ждёт запросов от сервера). Это необязательный элемент системы Zabbix, так как сервер может получать информацию с устройства при помощи других инструментов, с которыми можно познакомиться на официальном сайте Zabbix.
- Прокси. Отвечает за управление агентами. Это тоже необязательный компонент, но он снижает нагрузку на Zabbix-сервер. Прокси берёт на себя функцию предобработки данных, полученных агентами. Этот компонент актуален для тех компаний, которые мониторят сотни устройств с Zabbix-агентами.
Как пользоваться системой Zabbix
Информация с устройств попадает на Zabbix-сервер и обрабатывается им. Далее результаты обработки попадают в базу данных, где пользователь видит информацию в структурированном виде. Можно выбрать любую базу данных: MySQL, PostgreSQL, SQLite или Oracle. Для каждой метрики устанавливается пользовательский интервал. Пользовательские интервалы ― это промежутки времени, в которых собирается информация с устройства или системы. Например, программа может измерять температуру устройства каждые два часа.
Заббикс-мониторинг состояния любой системы чаще всего устанавливается, чтобы предупредить возможные технические проблемы. Благодаря Zabbix можно не только быстро узнавать об ошибках, но и предвидеть проблемы. Для этого в системе устанавливаются триггеры. Триггеры ― это условия, которые указывают, что в работе устройства или системы возникли проблемы. При срабатывании триггера Zabbix уведомляет пользователя о проблемах и может сам исправить ошибку, выполняя заранее прописанные действия для определённого триггера. Допустим мы установили, что процессор запускается в течение 7 секунд. Если запуск происходил хотя бы 8 секунд, то в программе сработает триггер и она уведомит пользователя о проблеме.
Для того, чтобы активировать мониторинг, нужно определить web-сценарии. В Zabbix web-сценарии позволяют собирать данные с узлов сети. Они настраиваются в виде шаблонов, которые можно применить к разным узлам или группам.
Приостановить отправку уведомлений о проблемах можно в настройках периода обслуживания. При этом оповещения, созданные в этот период, будут доступны для просмотра. Также их можно будет отправить после завершения обслуживания. В Zabbix период обслуживания можно настроить для отдельного узла или для группы.
Так как Zabbix собирает большие объёмы данных, он может предвидеть проблемы с устройством. Вернёмся к примеру с запускающимся процессором. Представим, что обычно запуск происходит в течение 4 секунд. Через неделю время запуска ― 5 секунд, ещё через неделю ― 6 секунд. Есть тенденция к увеличению времени запуска, и скоро сработает триггер. Заметив эту тенденцию, можно предотвратить проблему.
Чтобы пользователям было проще настраивать мониторинг, разработчики предлагают шаблоны со стандартным набором метрик и триггеров. Например, для Linux-сервера предлагают мониторинг памяти, состояния процессора и сети. Есть также специальный шаблон, который осуществляет мониторинг интернет-канала Zabbix.
Подробная установка Zabbix на Linux-системы описаны в статьях:
- Установка и настройка Zabbix в CentOS,
- Как установить Zabbix на Ubuntu и Debian.
В них описана пошаговая установка Zabbix, а также есть Zabbix agent настройка.
Zabbix: требования к серверу
Основные системные требования Zabbix ― это память и поддерживаемая платформа. Zabbix хорошо работает на большинстве платформ: Linux и другие операционные системы Unix, IBM AIX, FreeBSD, NetBSD, OpenBSD, HP-UX, Mac OS X, Solaris и Windows. С памятью тоже все просто. Чем больше данных вы хотите мониторить и хранить, тем больше оперативной памяти и места на жёстком диске понадобится. Подробнее о системных требованиях можно узнать на официальном сайте Zabbix.
Активные и пассивные агенты
Как мы писали выше в структуре системы мониторинга есть агент, с помощью которого можно получать данные. Он может работать в пассивном или активном режиме.
При пассивном режиме Zabbix-сервер в соответствии с настройками отправляет запросы агенту. Затем данные собираются и отправляются снова на Zabbix-сервер. Недостатки пассивного режима:
- не работает, если узел находится за NAT,
- большая нагрузка на сервер.
При активном режиме сам агент сначала запрашивает у Zabbix-сервера список данных, которые нужно собрать. Частота запросов устанавливается пользователем в соответствии с количеством узлов и объёмом данных, которые нужно получить. Чем чаще происходят запросы, тем больше нагружается сервер. Как только агент получает данные, он отправляет их на Zabbix-сервер для обработки.
Недостаток активного режима ― нужно самостоятельно создавать шаблоны для запросов, в то время как для пассивного режима есть готовые решения и нужно только выбрать подходящие параметры.
Какой агент лучше выбрать? Если сеть небольшая, подойдет пассивный агент. Если же сеть большая и на сервере много постоянно меняющихся данных, лучше использовать активный режим. Zabbix agent Linux установка подробно описана в документации. Для установки агента Zabbix инструкция на русском доступна по ссылке.
В этой статье мы разобрали, что такое мониторинговая система Zabbix и как она работает. Теперь администрировать бизнес будет проще.
Помогла ли вам статья?
Спасибо за оценку. Рады помочь ��
2 Проблемы
В разделе Мониторинг → Проблемы вы можете увидеть какие проблемы сейчас у вас имеются. Проблемами называются те триггеры, которые в состоянии «Проблема».
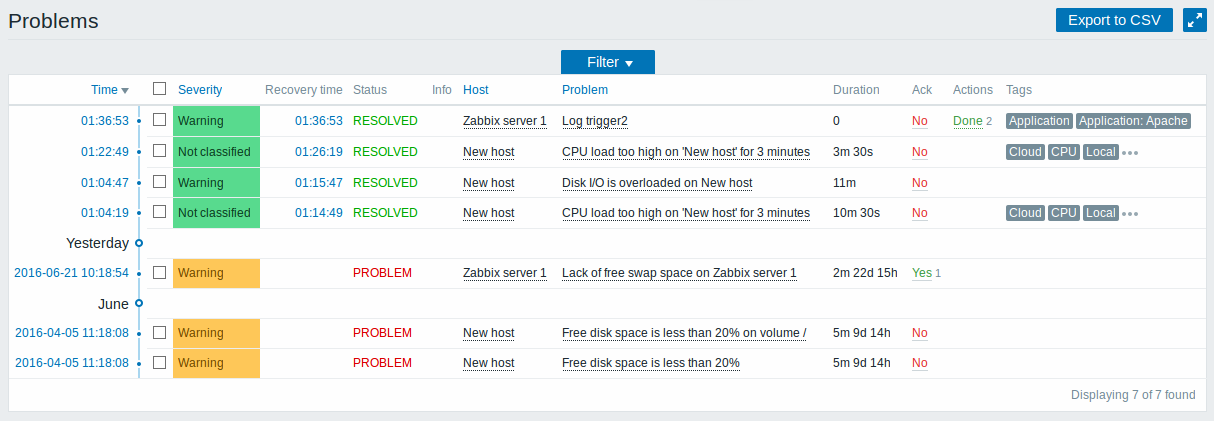
| Колонка | Описание |
|---|---|
| Время | Время начала проблемы. |
| Важность | Важность проблемы. Важность проблемы основывается на важности основного триггера проблемы. Цвет важности триггера используется фоном ячейки. У решенных проблем используется зеленый цвет фона. |
| Время восстановления | Время решения проблемы. |
| Состояние | Состояние проблемы: Проблема — нерешенная проблема Решено — недавно решенная проблема. Вы можете скрыть недавно решенные проблемы при помощи фильтра. Новые и недавно решенные проблемы мигают в течении 30 минут. Решенные проблемы в целом отображаются в течении 30 минут. Оба этих значения настраиваются в Администрировании → Общие → Опции отображения триггеров. |
| Инфо | Отображается зеленая информационная иконка, если проблема закрыта глобальной корреляцией или вручную при помощи подтверждения. При наведении курсора мыши на иконку отобразятся более детальные сведения: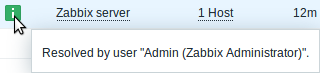 |
| Узел сети | Узел сети с проблемой. |
| Проблема | Имя проблемы. Имя проблемы основывается от имени основного триггера проблемы. |
| Длительность | Длительность проблемы. |
| Подтверждение | Состояние подтверждения проблемы: Да — зеленый текст сигнализирует о том, что проблема подтверждена. Проблема считается подтверждённой, если все её события подтверждены. Нет — красная ссылка сигнулизирует о неподтвержденных событиях. Если вы нажмёте на эту ссылку, вы попадёте на экран массового подтверждения, где можно за раз подтвердить все события этого триггера. Эта колонка отображается, если подтверждение проблем активировано в Администрирование → Общие. |
| Действия | Состояние действия: В работе — действие выполняется в данный момент Готово — действие завершено Ошибки — действие завершилось с ошибками Также отображается количество действий предпринятых над этой проблемой (таких как отправленные оповещения или выполненные удаленные команды). |
| Теги | Теги события (если имеются). |
Использование фильтра
Вы можете воспользоваться фильтром, чтобы отображать только те проблемы в которых вы заинтересованы. Фильтр располагается над таблицой.
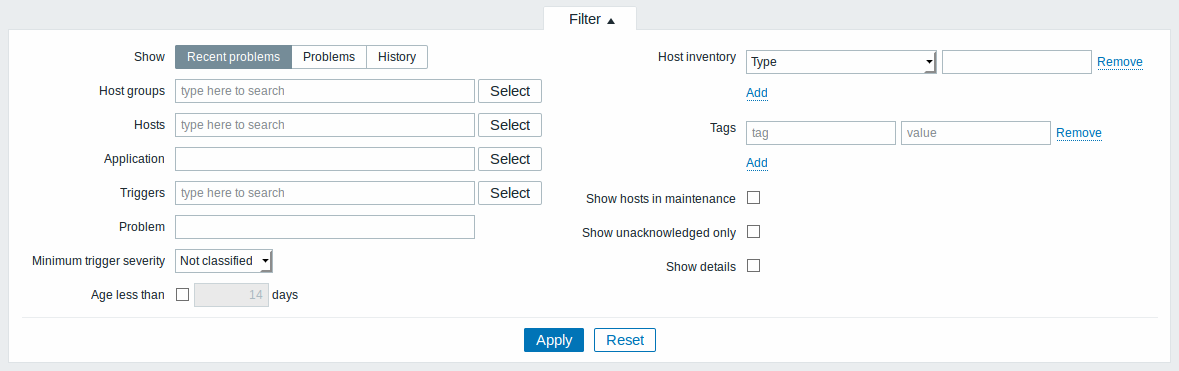
| Параметр | Описание |
|---|---|
| Показать | Фильтр по состоянию проблем: Недавние проблемы — нерешенные и недавно решенные проблемы (по умолчанию) Проблемы — нерешенные проблемы История — история всех событий |
| Группы узлов сети | Фильтр по одному или нескольким группам узлов сети. Указывая родительскую группу узлов сети косвенным образом будут выбраны все вложенные группы узлов сети начиная с Zabbix 3.2.2. В Zabbix 3.2.0, 3.2.1, вложенные группы узлов сети выбираются, если родительская группа указана при помощи родительская группа/* синтаксиса. |
| Узел сети | Фильтр по одному или нескольким узлам сети. |
| Группа элементов данных | Фильтр по имени группы элементов данных. |
| Триггер | Фильтр по одному или нескольким триггерам. |
| Проблема | Фильтр по имени проблемы. |
| Минимальная важность триггеров | Фильтр по минимальной важности триггеров. |
| Возраст менее чем | Фильтр по тому насколько старая может быть проблема. |
| Инвентарные данные узла сети | Фильтр по типу инвентарных данных и значению. |
| Теги | Фильтр по имени тега событий и значению тега событий. |
| Показывать узлы сети в обслуживании | Отметьте, чтобы также отображались проблемы узлов сети в обслуживании. |
| Отображать только неподтвержденные | Отметьте, чтобы отображались только неподтвержденные проблемы. |
| Показывать детали | Отметьте, чтобы отображались выражения основных триггеров проблем. |
Просмотр деталей
В Мониторинг → Проблемы поля времени начала проблемы и восстановления являются ссылками. При нажатии на них, откроется более детальная информация по событию.
Установка и первоначальная настройка ZABBIX
Перед установкой Zabbix, у Вас должен быть настроен и запущен сервер PostgreSQL или MySQL, с созданным пользователем zabbix и созданной базой zabbix.
Для управления системой мониторинга и чтения данных используется веб-интерфейс, написанный на PHP, соответственно должен быть настроен и запущен веб-сервер (Apache, Nginx).
- 1 Установка Zabbix сервера
- 1.1 Создание базы данных
- 1.1.1 PostgreSQL
- 1.1.2 MySQL/MariaDB
- 3.1 Настройка ноды
- 3.2 Настройка Zabbix сервера
- 4.1 Не работает обнаружение при помощи ICMP Ping
Установка Zabbix сервера
Создание базы данных
В процессе установки Zabbix сервера должна быть создана база данных Zabbix.
PostgreSQL
В репозитории p10 на данный момент поддерживается несколько версий PostgreSQL. В данной статье мы будем использовать версию postgresql 13.
Установить PostgreSQL, Zabbix сервер и дополнительную утилиту fping :
# apt-get install postgresql13-server zabbix-server-pgsql fpingПримечание: В p9 можно использовать postgresql 12:
# apt-get install postgresql12-server zabbix-server-pgsql fpingПодготовить к запуску и настроить службы PostgreSQL:
-
создать системные базы данных:
# /etc/init.d/postgresql initdb# systemctl enable --now postgresqlСоздать базу данных Zabbix:
-
создать пользователя zabbix (пароль необходимо запомнить) и базу данных zabbix (под правами root):
# su - postgres -s /bin/sh -c 'createuser --no-superuser --no-createdb --no-createrole --encrypted --pwprompt zabbix' Введите пароль для новой роли: Повторите его: # su - postgres -s /bin/sh -c 'createdb -O zabbix zabbix'
# su - postgres -s /bin/sh -c 'psql -U zabbix -f /usr/share/doc/zabbix-common-database-pgsql-*/schema.sql zabbix'если вы создаете базу данных для Zabbix прокси, следующие команды выполнять не нужно
# su - postgres -s /bin/sh -c 'psql -U zabbix -f /usr/share/doc/zabbix-common-database-pgsql-*/images.sql zabbix' # su - postgres -s /bin/sh -c 'psql -U zabbix -f /usr/share/doc/zabbix-common-database-pgsql-*/data.sql zabbix'
MySQL/MariaDB
Установить сервер MySQL или MariaDB (в данном случае MariaDB), Zabbix сервер и дополнительную утилиту fping :
# apt-get install mariadb-server zabbix-server-mysql fpingВключить по умолчанию и запустить службу mysqld:
# systemctl enable --now mysqldСоздать базу данных Zabbix:
-
создать пользователя zabbix и базу данных zabbix (пароль необходимо запомнить):
$ mysql -uroot -p Enter password: MariaDB [(none)]> create database zabbix character set utf8 collate utf8_bin; MariaDB [(none)]> grant all privileges on zabbix.* to zabbix@localhost identified by ''; MariaDB [(none)]> quit;
$ mysql -uzabbix -p zabbix < /usr/share/doc/zabbix-common-database-mysql-*/schema.sqlесли вы создаете базу данных для Zabbix прокси, следующие команды выполнять не нужно
$ mysql -uzabbix -p zabbix < /usr/share/doc/zabbix-common-database-mysql-*/images.sql $ mysql -uzabbix -p zabbix < /usr/share/doc/zabbix-common-database-mysql-*/data.sql
Установка Apache2
Установить необходимые пакеты:
# apt-get install apache2 apache2-mod_php8.1Примечание: Для p9:
# apt-get install apache2 apache2-mod_php7Добавить в автозапуск и запустить apache2:
# systemctl enable --now httpd2Установка PHP
Примечание: Начиная с Zabbix 5.0 для веб-интерфейса требуется PHP версии 7.2 или выше.
Примечание: Начиная с версии php 8.0, пакеты модулей именуются следующим образом:Все пакеты php можно устанавливать и эксплуатировать в одной системе одновременно, за исключением пакетов apache2-mod_php — они не умеют работать в одном адресном пространстве.
В данной статье для p10 используется версия php8.1.
Установить необходимые пакеты:
-
если Zabbix устанавливается с PostgreSQL:
# apt-get install php8.1 php8.1-mbstring php8.1-sockets php8.1-gd php8.1-xmlreader php8.1-pgsql php8.1-ldap php8.1-openssl# apt-get install php8.1 php8.1-mbstring php8.1-sockets php8.1-gd php8.1-xmlreader php8.1-mysqlnd-mysqli php8.1-ldap php8.1-openssl-
если Zabbix устанавливается с PostgreSQL:
# apt-get install php7 php7-mbstring php7-sockets php7-gd2 php7-xmlreader php7-pgsql php7-ldap# apt-get install php7 php7-mbstring php7-sockets php7-gd2 php7-xmlreader php7-mysqlnd-mysqli php7-ldapИзменить некоторые опции php в файле /etc/php/8.1/apache2-mod_php/php.ini (версия PHP может быть другой):
memory_limit = 256M post_max_size = 32M max_execution_time = 600 max_input_time = 600 date.timezone = Europe/Moscow (регион вписать свой) always_populate_raw_post_data = -1
# systemctl restart httpd2Настройка и запуск Zabbix сервера
Внести изменения в конфигурационный файл /etc/zabbix/zabbix_server.conf :
DBHost=localhost DBName=zabbix DBUser=zabbix DBPassword=Пароль
В параметре DBPassword используйте пароль от MySQL базы данных Zabbix; пароль пользователя PosgreSQL для PosgreSQL.
Добавить Zabbix server в автозапуск и запустить его:
-
если Zabbix устанавливается с PostgreSQL:
# systemctl enable --now zabbix_pgsql# systemctl enable --now zabbix_mysqlУстановка веб-интерфейса Zabbix
# apt-get install zabbix-phpfrontend-apache2 zabbix-phpfrontend-php8.1Примечание: Для p9:
# apt-get install zabbix-phpfrontend-apache2-mod_php7 zabbix-phpfrontend-php7Включить аддоны в apache2:
# ln -s /etc/httpd2/conf/addon.d/A.zabbix.conf /etc/httpd2/conf/extra-enabled/# service httpd2 restartИзменить права доступа к конфигурационному каталогу веб-интерфейса, чтобы веб-установщик мог записать конфигурационный файл:
# chown apache2:apache2 /var/www/webapps/zabbix/ui/confПримечание: Если устанавливается Zabbix4, команда будет такой:
# chown apache2:apache2 /var/www/webapps/zabbix/frontends/php/confВ браузере перейти на страницу установки Zabbix сервера:
Примечание: Если при входе на страницу у Вас будет 403 ошибка (доступ запрещен), обратитесь к Zabbix_заметки#Настройка_Apache2
При первом заходе на страницу запустится мастер, который шаг за шагом проверит возможности веб-сервера, интерпретатора PHP и сконфигурирует подключение к базе данных.
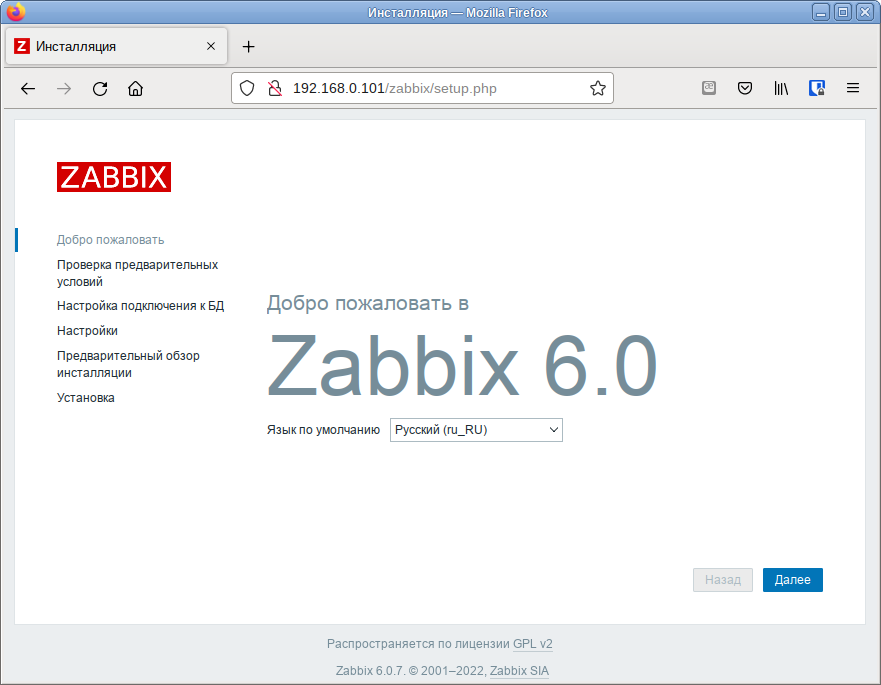
Для начала установки необходимо нажать кнопку «Далее» («Next Step»), что осуществит переход на страницу проверки предварительных условий:
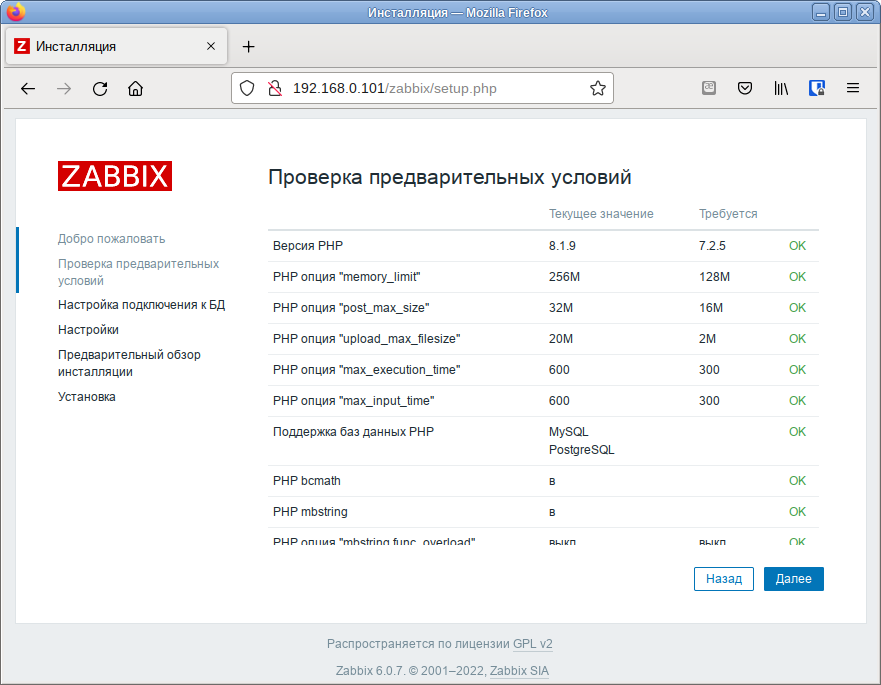
Необходимо доустановить то, что требуется и перейти на следующую страницу.
Здесь необходимо ввести параметры подключения к базе данных (параметры подключения нужно указывать такие же, как у сервера Zabbix).
Если база в PostgreSQL, по умолчанию в качестве Database schema необходимо указать «public»:
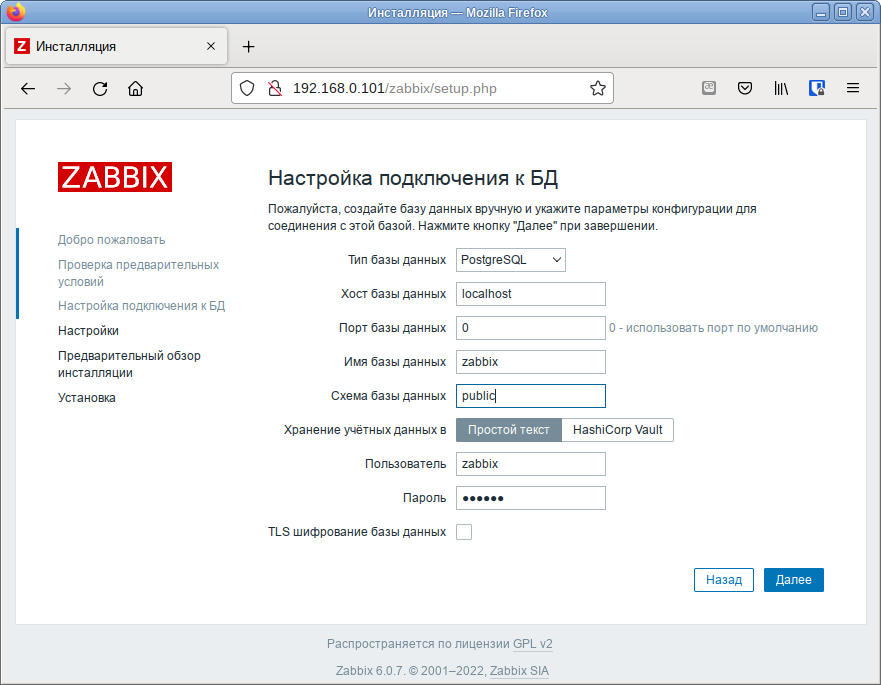
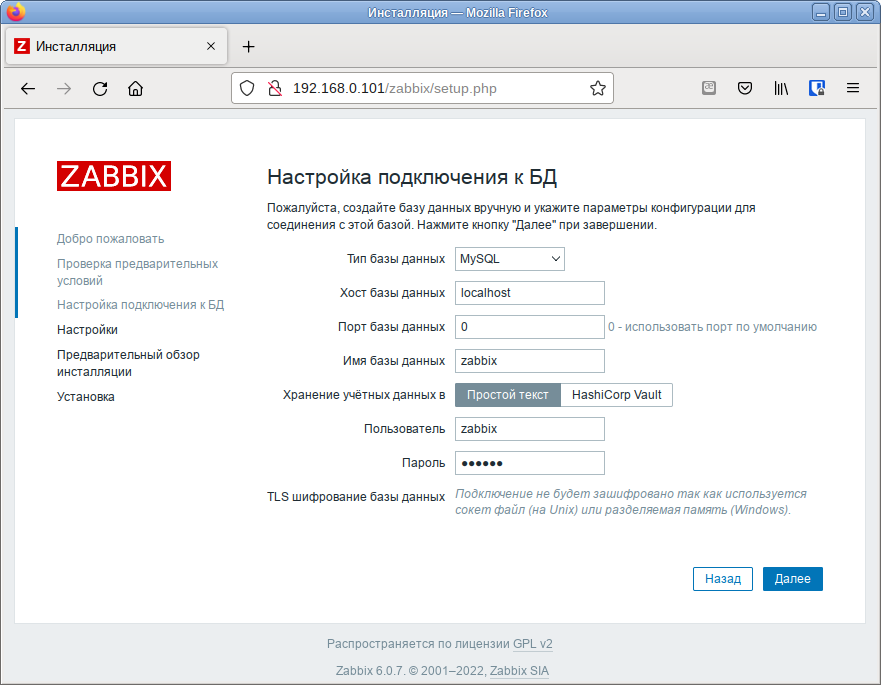
Примечание: Параметры подключения к базе данных MySQL:
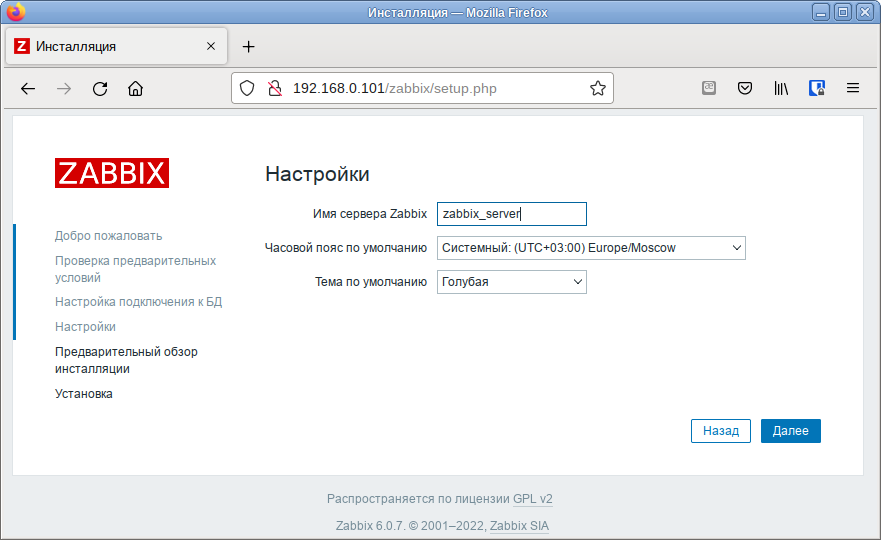
На следующей странице можно задать имя сервера:
После окончания установки на экране будет отображаться форма входа в интерфейс управления системой мониторинга. Параметры доступа по умолчанию:
Логин: Admin Пароль: zabbix
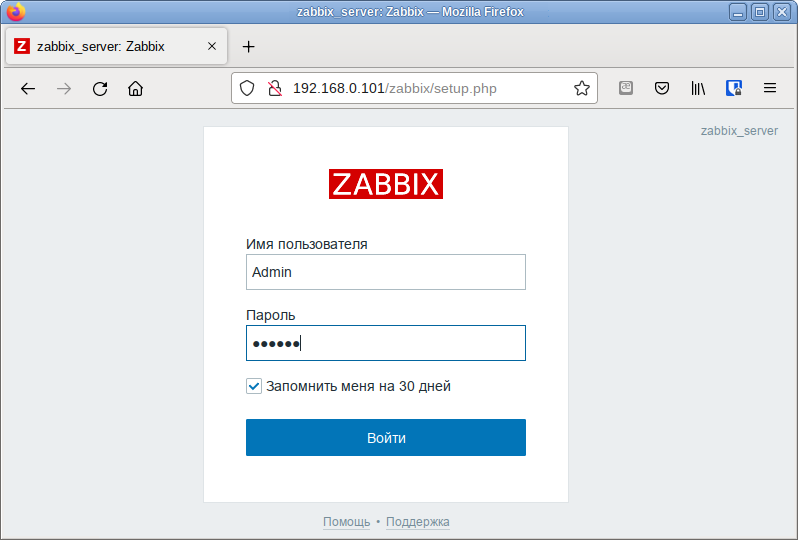
Войдя в систему, нужно сменить пароль пользователя ( Administration ▷ Users ), завести других пользователей и можно начать настраивать Zabbix.

Примечание: В профиле пользователя можно настроить некоторые функции веб-интерфейса Zabbix, такие, как язык интерфейса, цветовая тема, количество отображаемых строк в списках и т.п. Сделанные в профиле изменения будут применены только к пользователю, в профиле которого были сделаны эти изменения.
Обновление с Zabbix4 до Zabbix5
После обновления необходимо изменить права доступа к новой директории с zabbix и изменить путь в конфигурационном файле:
# chown -R apache2:apache2 /var/www/webapps/zabbix/ui/conf # sed -i 's|/var/www/webapps/zabbix/frontends/php|/var/www/webapps/zabbix/ui|' /etc/httpd2/conf/extra-enabled/A.zabbix.conf # systemctl restart httpd2
Для того, чтобы из System information убрать предупреждение Database history tables upgraded: No необходимо остановить zabbix и обновить базу данных:
# systemctl stop zabbix_pgsql # su - postgres -s /bin/sh -c 'psql -U zabbix -f /usr/share/doc/zabbix-common-database-pgsql-*/double.sql zabbix'
В файл /var/www/webapps/zabbix/ui/conf/zabbix.conf.php добавить параметр $DB[‘DOUBLE_IEEE754’] = ‘true’; и запустить zabbix:
# echo "\$DB['DOUBLE_IEEE754'] = 'true';" >>/var/www/webapps/zabbix/ui/conf/zabbix.conf.php # systemctl start zabbix_pgsql
Установка и первоначальная настройка клиента Zabbix
Установить необходимый пакет:
# apt-get install zabbix-agentЕсли Zabbix-агент устанавливается не на сам сервер мониторинга, то в файле конфигурации агента /etc/zabbix/zabbix_agentd.conf нужно задать следующие параметры:
Server= ServerActive= Hostname=freeipa.example.test
где freeipa.example.test — имя узла мониторинга, которое будет указано на сервере Zabbix;
— адрес сервера, которому разрешено обращаться к агенту.
Примечание: Если параметр Hostname будет пустой или закомментирован, то узел добавится под системным именем.
Добавить Zabbix-агент в автозапуск и запустить его:
# systemctl enable --now zabbix_agentd.serviceПримечание: Для настройки Zabbix-агента можно также воспользоваться модулем ЦУС Агент наблюдения.
Мониторинг CEPH
Настройка ноды
Установить на ноду CEPH необходимые пакеты:
# apt-get install zabbix-agent-sudo gitЗагрузить необходимые файлы:
# git clone https://github.com/thelan/ceph-zabbix.gitСоздать директорию и скопировать файлы:
# mkdir /etc/zabbix/zabbix_ceph # cp ceph-status.sh /etc/zabbix/zabbix_ceph/ # cp zabbix_agent_ceph_plugin.conf /etc/zabbix/zabbix_agentd.conf.d/
Изменить путь расположения скрипта в файле zabbix_agent_ceph_plugin.conf :
# sed -i 's/\/opt/sudo \/etc\/zabbix\/zabbix_ceph/' /etc/zabbix/zabbix_agentd.conf.d/zabbix_agent_ceph_plugin.confДобавить скрипту права на запуск:
# chmod +x /etc/zabbix/zabbix_ceph/ceph-status.shНастройка Zabbix сервера
В веб-интерфейсе сервера необходимо перейти на вкладку Configuration ▷ Templates , нажать кнопку Import.
Импортировать файлы zbx_ceph_mon_template.xml zbx_ceph_osd_template.xml zbx_ceph_cluster_template.xml zbx_ceph_mds_template.xml из директории zabbix_templates , которая находится в склонированной раннее директории.
После импорта шаблонов необходимо их прикрепить к нужному хосту.
Возможные проблемы
Не работает обнаружение при помощи ICMP Ping
В журнале /var/log/zabbix/zabbix_server.log присутствуют различные ошибки касающиеся команд fping , fping6 :
-
failed: /usr/sbin/fping6: can’t create raw socket (must run as root?) : Permission denied Для разрешения проблемы необходимо обеспечить запуск программ fping и fping6 с повышением привилегий. Так как сервер запускается от пользователя zabbix входящего в группу zabbix, то
chown root:zabbix /usr/sbin/fping chown root:zabbix /usr/sbin/fping6 chmod 710 /usr/sbin/fping chmod 710 /usr/sbin/fping6 chmod ug+s /usr/sbin/fping chmod ug+s /usr/sbin/fping6
Fping6Location=
Также бывает полезно указать точное нахождение fping , в этом же файле директива:
FpingLocation=/usr/sbin/fping
Вы всегда можете проверить корректность работы команд fping и fping6 из терминала авторизовавшись пользователем zabbix:
# su zabbix -s /bin/sh $ fping 192.168.0.1 192.168.0.1 is alive
Разрешения выполнения команды fping , управляемой control:
# control fping help public: Any user can execute /usr/sbin/fping netadmin: Only "netadmin" group members can execute /usr/sbin/fping restricted: Only root can execute /usr/sbin/fpingПереключить control для fping :
# control fping publicКаталоги для архива
mysqldump -uroot -pzabbix -A>zabb_bk.sql /etc/zabbix /var/www/webapps/zabbix /etc/httpd2/conf/addon.d /etc/httpd2/conf/sites-available /etc/php/x.x/apache2-mod_php/php.ini
- 1.1 Создание базы данных