Как работает разметка данных
Поговорим о том, что мы все уже давно работаем на искусственный интеллект. А именно занимаемся разметкой данных. Что это такое рассказывает Светлана Вронская, менеджер по маркетингу департамента аналитических решений ГК «КОРУС Консалтинг» в подкасте Телеграм-канала Analytics Now на портале Tadviser.
Импортозамещение BI-систем
Внедрение или кастомизация российский BI-систем, соответствующих требованиям импортозамещения, позволяет с минимальными рисками для деятельности компании обеспечивать прозрачность, оптимизировать бизнес и создавать инновационные продукты для своих заказчиков. Подробнее об услуге
Сегодня хочу вас обрадовать: вы все уже давно работает на искусственный интеллект. Cейчас объясню почему. Набившее оскомину выражение «данные – это новая нефть» особенно верно, если вспомнить, что сама по себе нефть, сырая, — вы особенно не сможете нигде применить. Ее надо очистить и переработать. Точно также дело обстоит и с нашей новой нефтью, информацией. Даже собрав большое количество неструктурированных данных, вы не сможете никак их применить в работе. И здесь появляется новый сегмент работы в области машинного обучения – разметка данных, data labelling. 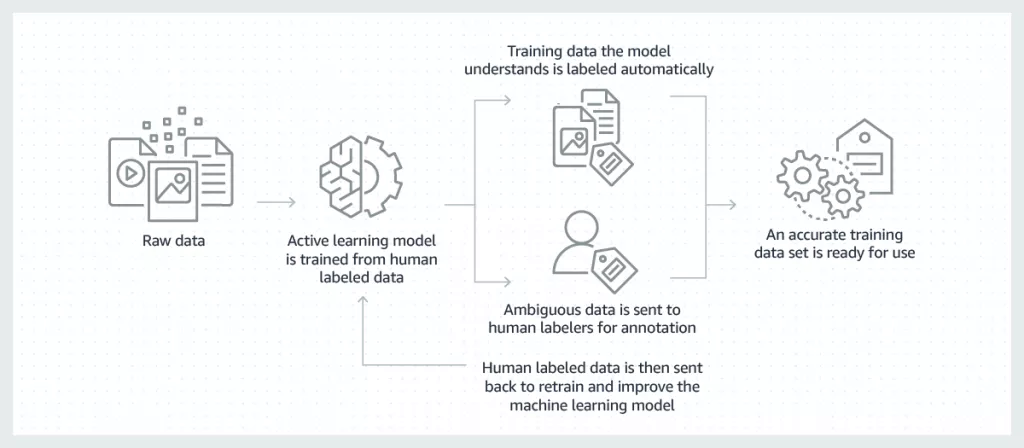
Пусть объем этого рынка пока сравнительно небольшой — по оценке аналитиков из Cognica Research в 2023 году он достигнет 1,2 млрд. долларов США, работа по разметке данных занимает до четверти всего времени на реализацию ML-проектов. Плюс, как вы увидите дальше, не факт, что мы когда-либо сможем достоверно узнать, сколько реально тратиться денег на data labelling. 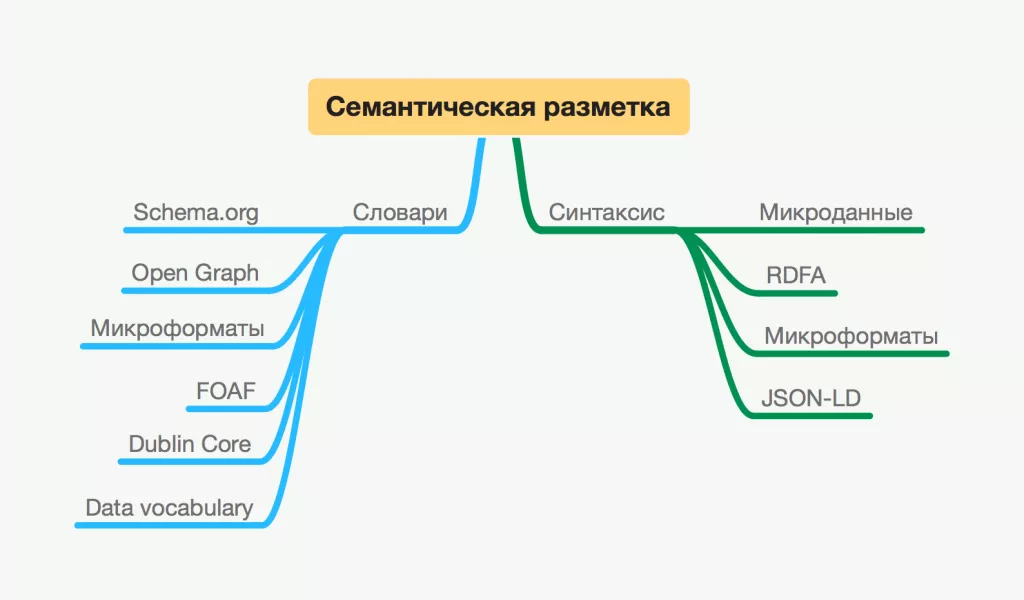
Итак, что же это такое – разметка данных? Основной задачей машинного обучения является обучение алгоритма – будь то традиционные статистические модели или новые нейронные сети, — искать и использовать закономерности из обучающего набора вопросов и ответов. При этом эти вопросы и ответы могут быть в виде текста, в виде изображения, в виде аудио или видео файла. К примеру, мы хотим научить модель определять тональность голоса человека, который звонит в колл-центр. Тогда вопрос будет звучать: какая интонация у звонящего? А ответами – положительная или негативная. Такие же примеры можно привести про видеозаписи, которые фиксируют нарушение автомобилем линии STOP перед светофором или нарушение привычной формы органа на рентгеновском снимке пациента. Чтобы искусственный интеллект научился давать правильные ответы на эти вопросы, за него это задачу сначала должен решить человек. То есть человек должен подготовить данные для машинного обучения. Это и разметка данных. 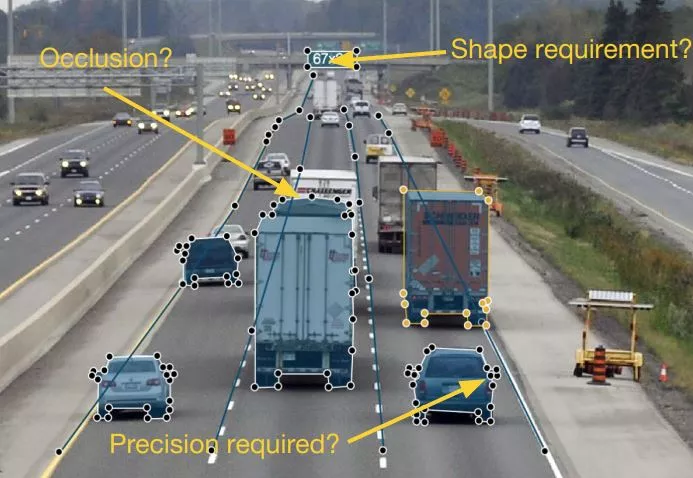
Теперь вы понимаете, почему data labelling— самая трудозатратная задача при создании решений на базе искусственного интеллекта: надо без ошибок разметить тысячи единиц информации и сделать это нужно быстро. Как и в случае, когда нужно было генерить большой объем программного кода и Индия оказалась самым подходящим ресурсом для этого и стала (и остается) лидером в области оффшорного программирования, так и в случае с разметкой данных основной ресурс находится в Азии. Прежде всего это Китай, в котором миллионы сотрудников, без квалификации или с низкой квалификацией и маленькой заработной платой, ежедневно отсматривают десятки и сотни тысяч данных и размечают ее. Так что старая картинка с шуткой о сервисе распознавания музыкальных треков Shazam, где в огромном зале в наушниках сидят сотрудники и один из них кричит: «Кто-нибудь знает, чья эта песня?» не так уж далека от истины. Каким бы умным ни был искусственный интеллект, он ничто без человека. Смею надеяться, что так будет еще очень долго. Несмотря на то, что количество данных растет, пока нет полноценных средств автоматизации для процесса разметки данных. Да, появляются решения, которые частично облегчают процесс – такие, например, как MarkLab, Handl, Annotate.online, Clarifai, — но все равно пока главная роль отдана человеку. Именно поэтому на рынке – и за рубежом, и в России, — появилось большое количество компаний, которые предоставляют услуги по разметке данных, нанимая фрилансеров, работающих из дому из всех точек земного шара. Крупные поставщики инфраструктуры данных также создали хабы для разметки данных. В Штатах лидирует решение от Amazon, Amazon Mechanical Turk, названное в честь уловки 18 века, когда было модно играть в автоматизированные шахматы, хотя в ящике под шахматным столом сидел человек и физически передвигал фигуры. В России более популярна площадка Яндекс.Толока, которая, как и механический турок позволяет свести заказчиков наборов данных, датасетов, и специалистов по разметке данных. Пару слов о том, как этот процесс работает. Все очень просто: клиент загружает «грязные» данные, выбирает шаблон задачи – классификацию, сегментацию, ввод текста, — и запускает процесс. Площадка сама находит исполнителей и выдает потом заказчику размеченные данные. Для справки, примерная стоимость такой работы у Яндекса – 15 долларов США за 1000 заданий, длительностью около 3 часов. Площадка берет себе около 20% комиссионных. Наверно, не так много, но за время самоизоляции многим очень пригодилась такая работа на дому. Напоследок, как обещала, расскажу, почему мы с вами все работаем на искусственный интеллект. Вспомните, как при доступе на некоторые сайты, Google просит вас отметить все светофоры или автомобили (по крайней мере, мне он подсовывает именно их)? Так вот, каждый раз, когда вы кликаете по частям автомашин и горящих светофоров, вы работаете специалистом по разметке данных. Где же только наши 15 долларов? Источник: Tadviser
Зарплата за байты: профессия разметчик данных для машинного обучения
Специалисты BGStaff рассказывают, как стать разметчиком данных и сколько можно зарабатывать на этой должности в Москве и регионах России. Читайте подробно в статье!
время на прочтение: 3 мин.

Профессия разметчик данных для машинного обучения занимает важное место в мире информационных технологий. В эпоху цифрового прогресса объемы информации, собранные и обрабатываемые организациями, растут с каждым днем. Извлечение ценных сведений из этого огромного объема становится важной задачей. Разметчики данных внутри организации играют ведущую роль в этом процессе, определяя и классифицируя их, делая понятными, упорядоченными для анализа.
Разметчик данных для машинного обучения – что это за профессия
Разметчик – это специалист, который отвечает за классификацию, организацию, аннотацию данных, собранных или сгенерированных компаниями, организациями. Это осуществляется для обеспечения их структурированности, удобства использования. ИТ-специалист выполняет работу по определению требуемых метаданных, тегированию, маркировке или подготовке данных для обучения алгоритмов машинного обучения, тестирования моделей.
Задачи сотрудника зависят от конкретной сферы и проектов, над которыми он работает. Например:
- в области обработки естественного языка он может аннотировать тексты, выделяя ключевые слова, определяя сущности или создавая синтаксические обозначения;
- в компьютерном зрении – помечает объекты, определяет границы, классифицирует изображения;
- в области аудио – анонсирует звуковые фрагменты, отмечая язык, эмоциональную окраску или другие характеристики.
Обратите внимание! Человек, занимающийся разметкой, должен не только уметь осуществлять сбор, классифицировать и описывать данные, но и удалять ненужные сведения для упрощения анализа.
Для успешного выполнения своей работы разметчику данных требуется владеть инструментами и методами разметки. Понимать основные принципы исследовательской работы и искусственного интеллекта, быть внимательным к деталям, иметь хорошую организационную способность.
Зарплата разметчика данных в Москве и регионах
Заработная плата IT-специалиста зависит от:
- опыта работы, квалификации;
- размера, типа компании работодателя;
- региона;
- текущих рыночных условий.
Сколько зарабатывает Data-разметчик в столице и регионах России:
- В Москве средняя заработная плата – от 60 000 до 100 000 рублей в месяц. Однако в крупных технологических компаниях или фирмах с высоким спросом на разметку данных зарплата может быть значительно выше, достичь уровня от 120 000 и более рублей в месяц.
- В регионах зарплата разметчиков данных обычно ниже. Средний уровень заработной платы – от 40 000 до 70 000 рублей в месяц (с возможностью значительных колебаний в зависимости от конкретной локации, компании).
Обратите внимание! Также размер з/п может зависеть от дополнительных факторов: бонусов, премий, социальных льгот, возможностей профессионального роста.
Как стать разметчиком данных, где пройти обучение
Есть несколько способов это сделать:
- Самостоятельное обучение. Необходимо изучить основные методы разметки данных. Ознакомиться с такими понятиями, как классификация, аннотирование, семантическая разметка и другие. Это самый сложный и долгий способ, который требует усидчивости, внимательности, усердия.
- Онлайн-курсы, посвященные разметке данных. Множество платформ предлагает бесплатные или платные курсы, которые помогут вам освоить необходимые навыки.
После освоения основной базы, необходимо наработать опыт. Для этого можно принять участие в открытых соревнованиях по машинному обучению или предложите помощь в аннотации данных для компаний или исследовательских проектов. Это поможет вам набраться опыта и узнать больше о процессе разметки.
Технологии и методы разметки постоянно меняются и развиваются, поэтому важно оставаться в курсе последних тенденций. Необходимо читать свежие тематические статьи, участвовать в вебинарах и посещать конференции.
Где найти сотрудника в компанию
Если вам нужно быстро закрыть вакансию разметчика данных, обратитесь в наше кадровое агентство BGStaff. Мы имеем обширную базу данных и опытных специалистов по подбору персонала. Сможем подобрать для вас сотрудника, который идеально впишется в вашу команду, справится с поставленными перед ним задачами на 100%. Обращение в наше ИТ-агентство поможет закрыть вакансию значительно быстрее, чем при размещении объявлений на платформах, на которых они могут висеть месяцами.
Найдем ИТ-специалистов любого уровня и направлений
- Работаем без предоплаты
- Первый кандидат через 3 дня
- Финансовая гарантия в течение 3 месяцев
Разметка данных: что это такое, ее роль в машинном обучении


Разметка данных — это своеобразная проверка данных в машинном обучении. То есть мы имеем некие входные данные, которые мы даем на обработку искусственному интеллекту. Потом проверяем исходные данные, полученные после их анализа ИИ , и сопоставляем их с эталонными данными. Если очень простым языком, то берем картинку коровы, даем искусственному интеллекту опознать объект на картине. Если он определил, что это корова, то значит , что все хорошо, а если он определил, что это слон, значит , все плохо. Разметка данных в этом случае — это проверка, что определил на изображении искусственный интеллект : корову или другое животное?
Разметка данных — это своего рода процесс обучения искусственного интеллекта.
Что это такое — разметка данных?
Задачей любого машинного обучения является качественное обучение алгоритма ИИ, а точнее , помо щь быстрее находить закономерности во входных данных, чтобы в дальнейшем искусственный интеллект качественне е выполнял свою задачу. Все это не было бы возможным, если бы не существовала разметка данных, то есть если бы не было проверки изначальной работы искусственного интеллекта.
Что самое интересное — разметка данных спровоцировала возникновение новой профессии — «разметчики данных». По сути, это люди, которые проверяют работу искусственного интеллекта.
Вообще , сам процесс разметки данных и машинного обучения можно сопоставить с парой «учитель/ученик». Учитель обладает определенными знаниями, которые хочет передать ученику, чтобы тот занял свое место в жизни. Изначально ученик, идя в школу, практически ничего не знает, а задача учителя — научить его . Как происходит процесс обучения людей? Учитель дает «порцию» информации ученику, а потом проверяет , как он ее понял. Когда ученик начинает «отвечать» по изученному материалу, то , естественно , он может ошибаться. Учитель на ошибки реагирует дополнительными наводящими вопросами, чтобы ученик исправил озвученную ошибку и в конце выдал эталонный ответ по материалу. Чем старше и опытнее становится ученик, тем сложнее обучающий материал.
С искусственным интеллектом происходит такая же ситуация. «Подачей» материала ИИ занимаются разработчики, а в роли «учителей» выступают «разметчики данных». Проверка того , как понял материал «ученик» , — это и есть разметка данных. Только у людей проверку материала делает один учитель, а у искусственного интеллекта их очень много по одному предмету.
К примеру, если вернемся к изображению коровы, котор ое мы дали проверить нашему искусственному интеллекту. ИИ определил, что на нем изображена корова. Чтобы для него это стало истиной, нужно будет, чтобы несколько разных разметчиков данных подтвердили этот факт. Как только это подтвердят «учителя», ИИ поймет, что его алгоритм определения коровы на изображении верен. И далее по нему он будет определять коров на изображении. Виток машинного обучения сделали — чему-то уже научили наш ИИ.
Но как и у людей, дальше задачи усложняются. Мы берем наше изображение и просим ИИ определить , какого цвета корова. Корова у нас черно-белая, а он определил как коричнево-белая. Разметчики это определили, значит , ИИ понял, что с алгоритмом определения цвета что-то не так. Провер ил еще раз , после чего определил цвет правильно. Разметчики это подтвердили, значит , алгоритм определения цвета верен.
Далее опять берем наше изображение и просим и нтеллект определить , а чем занимается корова на изображении: ест, пьет, спит, лежит, бежит и т. д? И так с каждым разом процесс усложняется. И каждый подобный этап обучени я проверяет разметка данных. А весь такой комплекс мероприятий и есть процесс машинного обучения.
Заметьте, что мы описали пример одной фотографии, чтобы ИИ определил , что изображено на картинке , и дал нам небольшое описание из разряда: « Ч ерно-белая корова пасется на лугу». При этом сколько манипуляций было задействовано? А представьте то же самое в более крупных масштабах, сколько манипуляций нужно провести? Допустим , у нас есть 1 млн разнообразных фото, по которым нужно обучить искусственный интеллект, тогда различных манипуляций буд у т десятки миллионов. Список девушек индивидуалок проститутики Екатеринбург Досуг для мужчин
Разметка данных по факту
По факту разметка данных — это очень энерго — и трудозатратный процесс, который силами разработчиков чисто физически не может быть решен, потому что нужно обрабатывать сотни тысяч единиц информации.
Для отладки взаимодействия между заказчиками, которым нужно обучить свой ИИ, и разметчиками, которые могут это сделать , есть несколько площадок:
- MarkLab;
- Handl;
- Annotate online;
- Clarifai;
- Яндекс.Толока;
- и др.
Разметка данных на подобных площадках происходит просто:
- заказчики загружают необработанную информацию, которую необходимо проверить на ресурс;
- фрилансеры и другие удаленные работники проверяют эту информацию за небольшое вознаграждение;
- площадка возвращает заказчику уже размеченные данные.
Именно так налажена современная разметка данных.
Заключение
Разметка данных в машинном обучении — это важная часть, без которой такое обучение было бы невозможным. По сути , любой пользователь интернета может прикоснуться к машинному обучению и стать «учителем» искусственного интеллекта, потому что пока этот процесс невозможно автоматизировать. А может , это и хорошо, потому что «человеческая» разметка данных предполагает, что на вершине всего обучения стоит человек и именно он определяет эталон знаний любого искусственного интеллекта.
Мы будем очень благодарны
если под понравившемся материалом Вы нажмёте одну из кнопок социальных сетей и поделитесь с друзьями.
Разметка данных
Data labeling

Мировой рынок машинного обучения растет со скоростью примерно 50% в год. В 2018 году его объем составил 1,8 млрд долл., а на 2023 год он оценивается суммой почти в 20 млрд [1] . Сюда включаются не только очевидные составляющие — аппаратное и программное обеспечение, сервис, но и качественно новый тип производства, получивший название data labeling или разметка данных. Подробнее о появлении этого термина и применении подобных операций – в материале, подготовленном специально для TAdviser журналистом Леонидом Черняком.
Послушайте 6-и минутный рассказ о разметке данных в нашем подкасте:
Появление data labeling связано с необходимостью подачи на вход систем обучения больших объемов специально подготовленных данных. Говоря об этом чаще всего ограничиваются простой констатацией того факта, что Big Data служит основой машинного обучения. При этом, объем сегмента data labeling, по данным Cognica Research, в 2023 году достигнет 1,2 млрд. долл [2] .
Потребность в индустрии разметки связана с тем, что практическое значение имеет не некий абстрактный AI (Artificial Intelligence или Искусственный интеллект), а его вполне практически ориентированное подмножество, называемое той же аббревиатурой AI, но от Augmented Intelligence, то есть ИИ, усиливающий возможности человека. К Augmented Intelligence относят задачи распознавания изображений, работу с текстами на естественных языках, управление транспортными средствами и т.д. Всем этим приложениям AI для работы требуется информация о внешнем мире.
Суета вокруг разметки данных позволяет заново переоценить мудрость выражения математика Клива Хамби, сказавшего в 2006 году «Data is the new oil» («Данные новая нефть»). Эту мудрость подтвердил журнал Economist в опубликованном в 2017 году отчете «The world’s most valuable resource is no longer oil, but data» («Теперь самый ценный ресурс в мире не нефть, а данные»). Но сырые данные, как и сырая нефть, сами по себе не имеют потребительской стоимости, в этом их главное сходство. Для превращения нефти в горючее, масла и другие полезные продукты создана гигантская нефтеперерабатывающая промышленность. Самую большую прибыль поучают не нефтедобывающие страны, а мировые концерны, специализирующиеся на переработке нефти. Аналогичную процедуру необходимо проделывать и над данными, чтобы превратить их в товар. Но, в отличие от нефти, пока средств для автоматизации предварительной обработки данных нет и в обозримом будущем не будет, поэтому эту нудную работу вручную будут выполнять низкоквалифицированные работники (handmaid data labeling). Их можно назвать «синими воротничками» индустрии машинного обучения, которая до сих пор была представлена исключительно «белыми воротничками». Рабочие индустрии должны выполнять вручную огромный объем работы. Например, аннотация одного человеческого образа требует указания от 15 до 40 точек и делается это все обычными средствами человеко-машинного интерфейса.
У Китая есть очевидный шанс стать супер монополистом в области data labeling. Страна располагает необходимым количеством высококвалифицированных специалистов, здесь выработаны государственные программы по развитию ИИ, и в то же время наличествует неограниченное количество желающих на роль исполнителей низкого уровня. Они работают надомно или в стесненных условиях на так называемых «фабриках разметки» (tagging factories), получая чрезвычайно низкую заработную плату — менее полутора долларов в час.

У Китая есть очевидный шанс стать супер монополистом в области data labeling
Типичным примером фабрики разметки служит компания Mada Code [3] , насчитывающая более 10 000 надомников, выполняющих разметку данных для задач оптического распознавания (Optical Character Recognition, OCR) и обработки текстов на естественных языках (Natural Language Processing, NLP). Среди ее клиентов крупные компании, в т.ч. Microsoft, и университеты. Ее руководитель сказал:

Несмотря на то, что разметка, казалось бы, тривиальная операция – внесение в изображение или текст тэгов, в этих словах содержится глубокий смысл. В процессе разметки производится качественное преобразование — сырые данные дополняются метаданными и превращаются в информацию. Самое утилитарное определение информации звучит следующим образом «Информация – это данные плюс метаданные» [4] . Российский рынок мобильных приложений для бизнеса и госсектора: крупнейшие игроки, тенденции и перспективы. Обзор TAdviser
Технологии и языки разметки изображений явление новое, первые публикации на эту тему относятся к 2016 году. Идея же разметки текстов намного старее — она родом из полиграфии. Первыми языками разметки были корректурные знаки, вносимые в рукописи. Настоящий переворот в разметке совершил Чарльз Гольдфарб, исследователь из IBM, которого называют «отцом современных языков разметки». Он создал язык Generalized Markup Language (GML), который понимала машина, а не наборщик. Создатель WWW Тим Бернерс-Ли использовал этот язык в качестве прототипа для создания языка разметки гипертекстов HTML, используемого в первом проекте WWW. В середине 90-х другой британец, Йон Борсак, предложил свою версию языка «SGML для Web». Разработка рабочей версии нового языка осуществлялась в 1996 году силами рабочей группы, насчитывавшей 11 человек, а возглавлял ее известный эксперт в области программирования в открытых кодах Джеймс Кларк. Именно он и переложил принятое сейчас название — XML. Для разметки изображений сейчас есть и свободно распространяемые технологии (Sloth, Visual Object Tagging), и коммерческие (Diffgram Supervisely), и другие. Список средств для разметки тестовых тестов, используемых при обработке текстов на естественных языках NLP, существенно длиннее.
Все эти технологии разметки объединяет то, что они позволяют превратить данные в информацию. Потом эта информация станет источником знаний в приложениях, попадающих под определение ИИ, выполняя следующую функцию intelligencе, суть которой заключается в превращении информации в знания.
Наличие этой естественной технологической цепочки отличает машинное обучение от символического подхода к ИИ с его искусственными попытками перенесения человеческих знаний в машину. Возможно когда-то разметка будет автоматизирована, но для этого нужны качественно новые сенсоры и средства для работы с текстами. С их появлением нынешние технологии работы с данными, повсеместно и ошибочно называемые информационными, станут информационными в полном смысле этого слова.
Разметка данных в России
2022: Российский рынок разметки данных вырос на 70%
Российский рынок разметки данных вырос в 2022 году на 70% и составил 1,6 млрд рублей. Об этом компания АБК сообщила 17 августа 2022 года.
При этом количество пользователей, зарегистрированных на специализированных площадках по разметке данных, в первой половине 2022 года выросло на 60%. Годом ранее темпы роста были ниже – 20%.
В частности, существенный прирост пользователей на площадке Elementary произошел за счет самозанятых. На август 2022 года на их долю приходится 85% всех пользователей платформы. Это стало возможно благодаря подключению бесплатной услуги от Сбербанка для корпоративных клиентов — «Реестровые выплаты самозанятым в рамках зарплатного проекта». За счет нее реестровые зачисления денежных средств на счета самозанятых совершаются быстро, а чеки самозанятых формируются автоматически. Пользователю площадки — физическому лицу – нужно только получить статус самозанятого (плательщика налога на профессиональный доход) через сервис «Своё дело» в мобильном приложении СберБанк Онлайн или просто подключить данный сервис, если пользователь уже зарегистрирован как самозанятый в ФНС или другом банке. Регистрация в сервисе занимает всего нескольку минут.
В конце 2021 года в Elementary провели пилот по привлечению к работе по разметке данных сотрудниц ряда территориальных отделений Сбера, находящихся в декретном отпуске. За первые 3 дня пилота на площадке зарегистрировалось более 1 тыс. человек. На август 2022 года декретницы составляют 10% разметчиков, занятых на площадке. Еще 5% приходится на маломобильных граждан и матерей детей с инвалидностью.
В 2022 году пилот по привлечению к работе по разметке данных сотрудниц в декрете масштабируется на весь Сбер.
2020: Сбербанк заплатит 400 безработным Кавказа за просмотр и разметку картинок с едой
11 сентября 2020 года Сбербанк сообщил TAdviser о предоставлении безработным жителям семи регионов Северо-Кавказского федерального округа (СКФО) возможность зарабатывать на платформе разметки данных TagMe.
В частности, безработным жителям регионов Северного Кавказа и тем, кто нуждается в подработке, будет предложено заняться разметкой аудиозаписей и изображений еды для ряда проектов SberAI в области распознавания речи и компьютерного зрения. На первом этапе в проекте примет участие до 400 жителей СКФО. Если «пилот» окажется успешным, он может быть масштабирован, в том числе и в других федеральных округах. Подробнее здесь.
Робототехника
- Роботы (робототехника)
- Робототехника (мировой рынок)
- Обзор: Российский рынок промышленной робототехники 2019
- Карта российского рынка промышленной робототехники
- Промышленные роботы в России
- Каталог систем и проектовРоботы Промышленные
- Топ-30 интеграторов промышленных роботов в России
- Карта российского рынка промышленной робототехники: 4 ключевых сегмента, 170 компаний
- Технологические тенденции развития промышленных роботов
- В промышленности, медицине, боевые (Кибервойны)
- Сервисные роботы
- Каталог систем и проектовРоботы Сервисные
- Collaborative robot, cobot (Коллаборативный робот, кобот)
- IoT — IIoT — Цифровой двойник (Digital Twin)
- Компьютерное зрение (машинное зрение)
- Компьютерное зрение: технологии, рынок, перспективы
- Как роботы заменяют людей
- Секс-роботы
- Роботы-пылесосы
- Искусственный интеллект (ИИ, Artificial intelligence, AI)
- Обзор: Искусственный интеллект 2018
- Искусственный интеллект (рынок России)
- Искусственный интеллект (мировой рынок)
- Искусственный интеллект (рынок Украины)
- В банках, медицине, радиологии, ритейле, ВПК, производственной сфере, образовании, Автопилот, транспорте, логистике, спорте, СМИ и литература, видео (DeepFake, FakeApp), музыке
- Национальная стратегия развития искусственного интеллекта
- Национальная Ассоциация участников рынка робототехники (НАУРР)
- Российская ассоциация искусственного интеллекта
- Национальный центр развития технологий и базовых элементов робототехники
- Международный Центр по робототехнике (IRC) на базе НИТУ МИСиС
- Машинное обучение, Вредоносное машинное обучение, Разметка данных (data labeling)
- RPA — Роботизированная автоматизация процессов
- Видеоаналитика (машинное зрение)
- Машинный интеллект
- Когнитивный компьютинг
- Наука о данных (Data Science)
- DataLake (Озеро данных)
- BigData
- Нейросети
- Чатботы
- Умные колонки Голосовые помощники
- Безэкипажное судовождение (БЭС)
- Автопилот (беспилотный автомобиль)
- Беспилотные грузовики
- Беспилотные грузовики в России
- В мире и России
- Летающие автомобили
- Электромобили
- Подводные роботы
- Беспилотный летательный аппарат (дрон, БПЛА)