Изменение формы и объединение таблиц — Python: Pandas
В работе с данными приходится собирать их из разных источников и объединять в единую структуру. В библиотеке Pandas реализован функционал для таких операций над табличными данными в виде методов:
На данном уроке рассмотрим практические случаи, в которых они применяются.
Метод concat()
За основу возьмем данные о кликах на сайтах 4 магазинов за 28 дней.
df_clicks = pd.read_csv('./data/Cite_clicks.csv', index_col=0) print(df_clicks.head()) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 319.0 328.0 # 2 292.0 274.0 292.0 301.0 # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 Разобьем исходные данные на два датафрейма за первую и вторую недели месяца. Это операция делается с использованием срезов.
df_clicks_first_week = df_clicks[:7] df_clicks_second_week = df_clicks[7:14] print(df_clicks_first_week) print(df_clicks_second_week) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 319.0 328.0 # 2 292.0 274.0 292.0 301.0 # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # 6 445.0 418.0 409.0 445.0 # 7 481.0 400.0 481.0 409.0 # # SHOP1 SHOP2 SHOP3 SHOP4 # day # 8 NaN 267.0 333.0 344.0 # 9 300.0 278.0 300.0 311.0 # 10 289.0 311.0 -278.0 289.0 # 11 344.0 388.0 344.0 333.0 # 12 421.0 377.0 399.0 355.0 # 13 487.0 454.0 -443.0 487.0 # 14 531.0 432.0 531.0 443.0 Операция, обратная разбиению — конкатенация, применяется, чтобы собрать куски данных в единый фрагмент. Если предположить, что отчетные материалы за разные недели лежат в разных таблицах, а для аналитика необходимо поработать над всеми значениями сразу, то можно использовать метод concat() . В качестве параметров ему передается список тех датасетов, которые необходимо объединить:
df_weeks_concat = pd.concat([ df_clicks_first_week, df_clicks_second_week ]) print(df_weeks_concat) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 319.0 328.0 # 2 292.0 274.0 292.0 301.0 # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # 6 445.0 418.0 409.0 445.0 # 7 481.0 400.0 481.0 409.0 # 8 NaN 267.0 333.0 344.0 # 9 300.0 278.0 300.0 311.0 # 10 289.0 311.0 -278.0 289.0 # 11 344.0 388.0 344.0 333.0 # 12 421.0 377.0 399.0 355.0 # 13 487.0 454.0 -443.0 487.0 # 14 531.0 432.0 531.0 443.0 Рассмотрим ситуацию, в которой данные разбиты по парам магазинов. Возможно, это данные из разных городов, и лежат они в разных таблицах баз данных:
df_clicks_two_first = df_clicks[['SHOP1', 'SHOP2']] df_clicks_two_last = df_clicks[['SHOP3', 'SHOP4']] print(df_clicks_two_first.head()) print(df_clicks_two_last.head()) # => SHOP1 SHOP2 # day # 1 319.0 -265.0 # 2 292.0 274.0 # 3 283.0 301.0 # 4 328.0 364.0 # 5 391.0 355.0 # # SHOP3 SHOP4 # day # 1 319.0 328.0 # 2 292.0 301.0 # 3 274.0 283.0 # 4 328.0 NaN # 5 373.0 337.0 Чтобы собрать их в единое целое, применяется метод concat() , но указывается направление объединения с помощью параметра axis :
- 0 — объединение происходит по строкам
- 1 — по столбцам
df_shop_concat = pd.concat([ df_clicks_two_first, df_clicks_two_last ], axis=1) print(df_shop_concat.head()) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 319.0 328.0 # 2 292.0 274.0 292.0 301.0 # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 Стоит быть внимательными с направлением объединения. Если его не указать в данном примере, то результат будет не тот, который ожидается:
print(pd.concat([ df_clicks_two_first, df_clicks_two_last ])) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 NaN NaN # 2 292.0 274.0 NaN NaN # 3 283.0 301.0 NaN NaN # 4 328.0 364.0 NaN NaN # 5 391.0 355.0 NaN NaN Фрагменты данных на подобии срезов по неделям и парам магазинов довольно типичная ситуация. Однако бывают случаи, когда срезы делаются по разным пересекающимся промежуткам времени. Рассмотрим данные кликов для пар магазинов за пять рабочих дней:
df_clicks_two_first = df_clicks[['SHOP1', 'SHOP2']][:5] df_clicks_two_last = df_clicks[['SHOP3', 'SHOP4']][2:7] print(df_clicks_two_first) print(df_clicks_two_last) # => SHOP1 SHOP2 # day # 1 319.0 -265.0 # 2 292.0 274.0 # 3 283.0 301.0 # 4 328.0 364.0 # 5 391.0 355.0 # # SHOP3 SHOP4 # day # 3 274.0 283.0 # 4 328.0 NaN # 5 373.0 337.0 # 6 409.0 445.0 # 7 481.0 409.0 Здесь дни месяца не совпадают, но пересекаются. Для объединения также используется метод concat() , который объединит по соответствующим индексам и оставит пропуски в тех днях, для которых значений нет.
df_concat = pd.concat([ df_clicks_two_first, df_clicks_two_last ],axis=1) print(df_concat) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 NaN NaN # 2 292.0 274.0 NaN NaN # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # 6 NaN NaN 409.0 445.0 # 7 NaN NaN 481.0 409.0 Метод join()
Метод concat() позволяет производить операции конкатенации по направлениям. Однако при работе с данными требуются более сложные объединения данных. Одним из методов, который поддерживает различные сценарии объединения данных по индексам, является метод join() :
df_join_to_first = df_clicks_two_first.join( df_clicks_two_last ) print(df_join_to_first) # => SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 NaN NaN # 2 292.0 274.0 NaN NaN # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 Важно отметить, что join() не является методом Pandas, а применяется к датафрейму. Также важно, к какому датафрейму при объединении он применяется. Если поменять местами датафреймы в примере выше, то результат будет отличаться:
df_join_to_last = df_clicks_two_last.join( df_clicks_two_first ) print(df_join_to_last) # => SHOP3 SHOP4 SHOP1 SHOP2 # day # 3 274.0 283.0 283.0 301.0 # 4 328.0 NaN 328.0 364.0 # 5 373.0 337.0 391.0 355.0 # 6 409.0 445.0 NaN NaN # 7 481.0 409.0 NaN NaN В примерах выше в результирующем датафрейме присутствуют только индексы датафрейма, к которому применялся данный метод. Такой способ объединения называется left join и применяется по умолчанию. Метод join() поддерживает различные сценарии объединения и включает такие случаи:
- inner join — объединение по пересечению индексов
- right join — внешнее объединение по всем индексам объединяемых датафреймов
Для их использования в примерах ниже указываются соответствующие значения параметра how :
print('left join:') print(df_clicks_two_first.join( df_clicks_two_last, how='left' )) print('right join:') print(df_clicks_two_first.join( df_clicks_two_last, how='right' )) print('inner join:') print(df_clicks_two_first.join( df_clicks_two_last, how='inner' )) print('outer join:') print(df_clicks_two_first.join( df_clicks_two_last, how='outer' )) # => left join: # SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 NaN NaN # 2 292.0 274.0 NaN NaN # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # # right join: # SHOP1 SHOP2 SHOP3 SHOP4 # day # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # 6 NaN NaN 409.0 445.0 # 7 NaN NaN 481.0 409.0 # # inner join: # SHOP1 SHOP2 SHOP3 SHOP4 # day # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # # outer join: # SHOP1 SHOP2 SHOP3 SHOP4 # day # 1 319.0 -265.0 NaN NaN # 2 292.0 274.0 NaN NaN # 3 283.0 301.0 274.0 283.0 # 4 328.0 364.0 328.0 NaN # 5 391.0 355.0 373.0 337.0 # 6 NaN NaN 409.0 445.0 # 7 NaN NaN 481.0 409.0 Метод merge()
Объединение данных можно производить не только по индексам, но и по столбцам значений двух датафреймов. Для этого не достаточно функционала метода join() , который может производить объединения по индексам датафреймов. Для таких случаев в Pandas используется метод merge() .
Рассмотрим датасет с кликами, в котором дни месяца указаны в столбце day , а не в индексе строк:
df_clicks = df_clicks.reset_index() print(df_clicks.head()) # => day SHOP1 SHOP2 SHOP3 SHOP4 # 0 1 319.0 -265.0 319.0 328.0 # 1 2 292.0 274.0 292.0 301.0 # 2 3 283.0 301.0 274.0 283.0 # 3 4 328.0 364.0 328.0 NaN # 4 5 391.0 355.0 373.0 337.0 Будем решать задачу по объединению двух датасетов, содержащих пятидневные срезы по парам магазинов:
df_clicks_two_first = df_clicks[['day', 'SHOP1', 'SHOP2']][:5] df_clicks_two_last = df_clicks[['day', 'SHOP3', 'SHOP4']][2:7] print(df_clicks_two_first) print(df_clicks_two_last) # => day SHOP1 SHOP2 # 0 1 319.0 -265.0 # 1 2 292.0 274.0 # 2 3 283.0 301.0 # 3 4 328.0 364.0 # 4 5 391.0 355.0 # # day SHOP3 SHOP4 # 2 3 274.0 283.0 # 3 4 328.0 NaN # 4 5 373.0 337.0 # 5 6 409.0 445.0 # 6 7 481.0 409.0 Для их объединения необходимо указать сперва левый, а затем правый датафреймы. Также нужно определить по каким столбцам в каждом из датафреймов будет происходить объединение.
df_merged = pd.merge( df_clicks_two_first, df_clicks_two_last, left_on='day', right_on='day' ) print(df_merged) # => day SHOP1 SHOP2 SHOP3 SHOP4 # 0 3 283.0 301.0 274.0 283.0 # 1 4 328.0 364.0 328.0 NaN # 2 5 391.0 355.0 373.0 337.0 Также как и в методе join() в методе merge() поддерживаются различные сценарии объединения данных:
print('inner merge:') print(pd.merge( df_clicks_two_first, df_clicks_two_last, left_on='day', right_on='day', how='inner' )) print('left merge:') print(pd.merge( df_clicks_two_first, df_clicks_two_last, left_on='day', right_on='day', how='left' )) print('right merge:') print(pd.merge( df_clicks_two_first, df_clicks_two_last, left_on='day', right_on='day', how='right' )) print('outer merge:') print(pd.merge( df_clicks_two_first, df_clicks_two_last, left_on='day', right_on='day', how='outer' )) # => inner merge: # day SHOP1 SHOP2 SHOP3 SHOP4 # 0 3 283.0 301.0 274.0 283.0 # 1 4 328.0 364.0 328.0 NaN # 2 5 391.0 355.0 373.0 337.0 # # left merge: # day SHOP1 SHOP2 SHOP3 SHOP4 # 0 1 319.0 -265.0 NaN NaN # 1 2 292.0 274.0 NaN NaN # 2 3 283.0 301.0 274.0 283.0 # 3 4 328.0 364.0 328.0 NaN # 4 5 391.0 355.0 373.0 337.0 # # right merge: # day SHOP1 SHOP2 SHOP3 SHOP4 # 0 3 283.0 301.0 274.0 283.0 # 1 4 328.0 364.0 328.0 NaN # 2 5 391.0 355.0 373.0 337.0 # 3 6 NaN NaN 409.0 445.0 # 4 7 NaN NaN 481.0 409.0 # # outer merge: # day SHOP1 SHOP2 SHOP3 SHOP4 # 0 1 319.0 -265.0 NaN NaN # 1 2 292.0 274.0 NaN NaN # 2 3 283.0 301.0 274.0 283.0 # 3 4 328.0 364.0 328.0 NaN # 4 5 391.0 355.0 373.0 337.0 # 5 6 NaN NaN 409.0 445.0 # 6 7 NaN NaN 481.0 409.0 Выводы
На данном уроке мы познакомились с различными методами Pandas для объединения табличных данных. Рассмотренные методы применяются по мере усложнения производимой операции:
- concat() — данные объединяются по строкам или по столбцам с сохранением всех значений
- join() — объединяюся датафреймы по индексам
Открыть доступ
Курсы программирования для новичков и опытных разработчиков. Начните обучение бесплатно
- 130 курсов, 2000+ часов теории
- 1000 практических заданий в браузере
- 360 000 студентов
Объединение таблиц в Pandas: merge, join и concatenate
Люди, которые работают с sql, знают, что для объединения таблиц используется операция join. В библиотеке Pandas также предусмотрен join, но помимо него, есть еще такие табличные функции объединения, как merge и concatenate. Когда только-только знакомишься с этими функциями разница между ними неочевидна, поэтому я предлагаю вам краткий обзор отличительных особенностей этих операций.
Join
DataFrame.join(self, other, on=None, how='left', lsuffix='', rsuffix='', sort=False) Из трех операций объединения датафреймов join является наиболее простым и предлагает минимум «средств управления» объединения ваших таблиц.
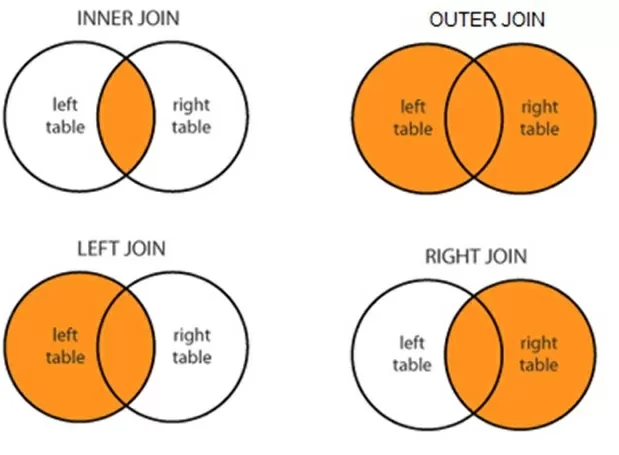
Он объединит все столбцы из двух таблиц с общими столбцами, переименованными в определенные lsuffix и rsuffix. Способ объединения строк из двух таблиц определяется с помощью how – inner, outer, right, left (по умолчанию) аналогично sql. Визуализировать понимание соединения таблиц всеми этими способами могут схемы, изображенные с помощью кругов Эйлера:
Рассмотрим как работает объединение с помощью Join на примере:
df1 = pd.DataFrame() df2 = pd.DataFrame() 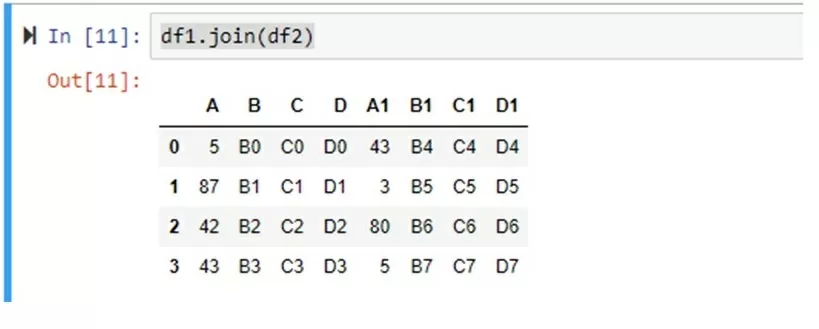
Merge
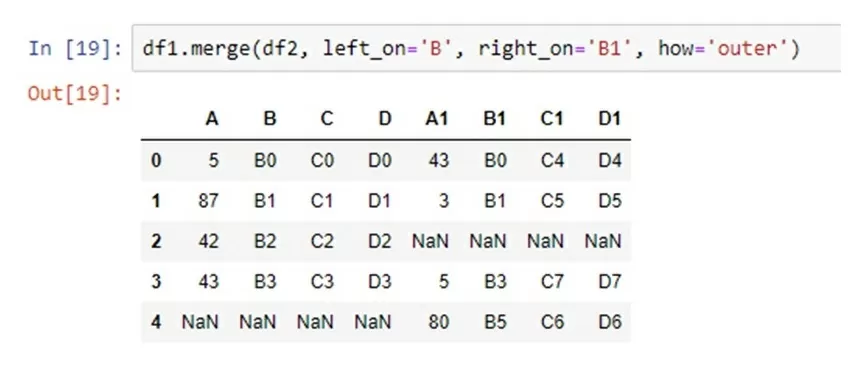
DataFrame.merge(self, right, how='inner', on=None, left_on=None, right_on=None, left_index=False, right_index=False, sort=False, suffixes=('_x', '_y'), copy=True, indicator=False, validate=None) Аналогично предыдущей функции merge также объединяет все столбцы из двух таблиц с общими столбцами, переименованными в определенные suffixes. Но в отличие от join, merge уже предлагает три способа организации построчного выравнивания. Первый способ заключается в использовании on = «НАЗВАНИЕ СТОЛБЦА», в этом случае столбец должен быть общим столбцом в обеих таблицах. Второй способ — использовать left_on = «НАЗВАНИЕ СТОЛБЦА» и right_on = «НАЗВАНИЕ СТОЛБЦА». Такой способ позволяет объединить две таблицы, используя два разных столбца. Третий способ — использовать left_index = True и right_index = True, в данном случае таблицы будут объединены по индексам.
Рассмотрим на примере:
df2 = pd.DataFrame() df1 = pd.DataFrame() 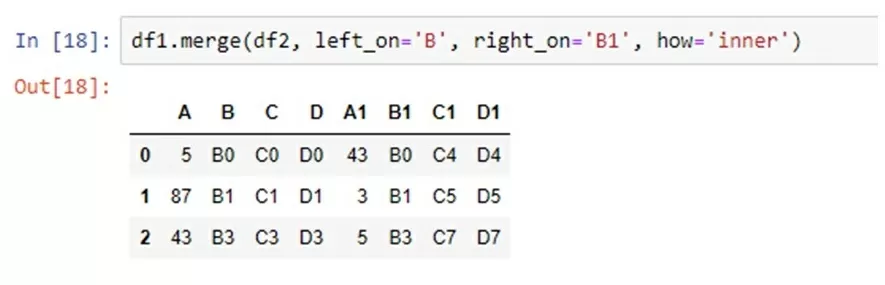
Concatenate
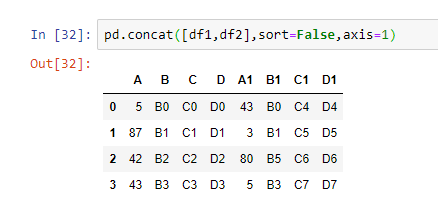
pandas.concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False, keys=None, levels=None, names=None, verify_integrity=False, sort=None, copy=True)В отличии от join и merge, которые по умолчанию работают со столбцами, concat позволяет выбрать, хотим ли мы выполнять объединение по столбцам или по строкам. Для этого в аргументе функции необходимо прописать axis=0 или axis=1, в первом случае вторая таблица будет присоединена к первой снизу, во втором – справа.
Рассмотрим на примере:
df2 = pd.DataFrame() df1 = pd.DataFrame() 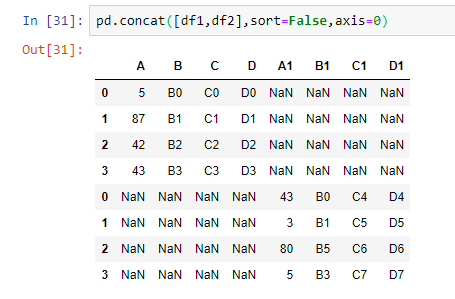
Append
DataFrame.append(self, other, ignore_index=False, verify_integrity=False, sort=False)Напоследок будет уместно упомянуть такую функцию как append(). Она несколько выбивается из перечня ранее упомянутых функций, но тем не менее ее также можно считать инструментом объединения таблиц. Append() используется для добавления строк одного датафрейма в конец другого, возвращая новый датафрейм. Столбцы, не входящие в исходный датафрейм, добавляются как новые столбцы, а новые ячейки заполняются значениями NaN.
Рассмотрим на примере:
df2 = pd.DataFrame() df1 = pd.DataFrame() 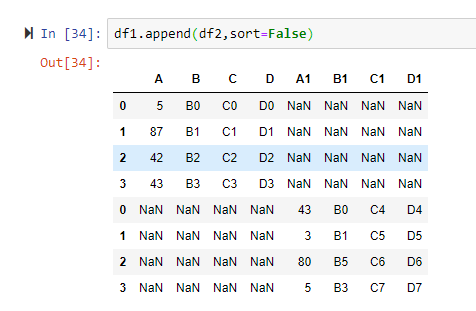
Мы рассмотрели основные различия функций объединения датафреймов в Pandas. Join и merge работают со столбцами, и переименовывает общие столбцы, используя заданный суффикс. Но merge позволяет более гибко настроить построчное выравнивание. В отличии от join и merge, concat позволяет работать как со столбцами, так и со строками, но не дает переименовывать строки/столбцы.
Как объединить Pandas DataFrames в несколько столбцов
Часто вы можете захотеть объединить два кадра данных pandas в нескольких столбцах. К счастью, это легко сделать с помощью функции pandas merge() , которая использует следующий синтаксис:
pd.merge(df1, df2, left_on=['col1','col2'], right_on = ['col1','col2']) В этом руководстве объясняется, как использовать эту функцию на практике.
Пример 1: объединение нескольких столбцов с разными именами
Предположим, у нас есть следующие два Pandas DataFrames:
import pandas as pd #create and view first DataFrame df1 = pd.DataFrame() print(df1) a1 b c 0 0 0 11 1 0 0 8 2 1 1 10 3 1 1 6 4 2 1 6 #create and view second DataFrame df2 = pd.DataFrame() print(df2) a2 b d 0 0 0 22 1 1 0 24 2 1 0 25 3 1 1 33 4 3 1 37 В следующем коде показано, как выполнить левое соединение с использованием нескольких столбцов из обоих фреймов данных:
pd.merge(df1, df2, how='left', left_on=['a1', 'b'], right_on = ['a2',' b']) a1 b c a2 d 0 0 0 11 0.0 22.0 1 0 0 8 0.0 22.0 2 1 1 10 1.0 33.0 3 1 1 6 1.0 33.0 4 2 1 6 NaN NaN Пример 2: объединение нескольких столбцов с одинаковыми именами
Предположим, у нас есть следующие два кадра данных pandas с одинаковыми именами столбцов:
import pandas as pd #create DataFrames df1 = pd.DataFrame() df2 = pd.DataFrame() В этом случае мы можем упростить использование on = [‘a’, ‘b’], поскольку имена столбцов одинаковы в обоих DataFrames:
pd.merge(df1, df2, how='left', on=['a', 'b']) a b c d 0 0 0 11 22.0 1 0 0 8 22.0 2 1 1 10 33.0 3 1 1 6 33.0 4 2 1 6 NaN Как объединить 4 DataFrame в один?
Необходимо соединить df3 c остальными df . При этом необходимо соединить df4 с помощью left join , а с оставшимися df — через inner (реальные данные содержат более 100 000 рядов).
pd.concat([df3, df4], axis=0, join = 'left').concat([df3, df1, df2], axis=0, join = 'inner') выдаёт ValueError. Подскажите, пожалуйста, эффективный способ решения данной задачи?
Отслеживать
12.5k 7 7 золотых знаков 18 18 серебряных знаков 48 48 бронзовых знаков
задан 26 мая 2021 в 14:12
21 3 3 бронзовых знака
а зачем вы конкатенируете все цепочкой, особенно, если не до конца понимаете, как этом метод работает? вы же сами себе алгоритм расписали. так и делайте, сначала одно, а потом другое.
26 мая 2021 в 14:32
А по какой колонке то вы join делаете, по индексу? То есть фактически не join , а именно concat просто нужен в данном случае (индекс у них у всех одинаковый)?