NumPy, часть 3: random

Здравствуйте! Я продолжаю работу над пособием по python-библиотеке NumPy.
В прошлой части мы научились работать с массивами.
Сегодня мы узнаем, как создавать массивы из случайных элементов и как работать со случайными элементами в NumPy.
Путь первый
Создавать списки, используя встроенный модуль random, а затем преобразовывать их в numpy.array:
Но есть способ лучше.
numpy.random
Для создания массивов со случайными элементами служит модуль numpy.random.
Создание массивов
Самый простой способ задать массив со случайными элементами — использовать функцию sample (или random, или random_sample, или ranf — это всё одна и та же функция).
Без аргументов возвращает просто число в промежутке [0, 1), с одним целым числом — одномерный массив, с кортежем — массив с размерами, указанными в кортеже (все числа — из промежутка [0, 1)).
С помощью функции randint или random_integers можно создать массив из целых чисел. Аргументы: low, high, size: от какого, до какого числа (randint не включает в себя это число, а random_integers включает), и size — размеры массива.
Также можно генерировать числа согласно различным распределениям (Гаусса, Парето и другие). Чаще всего нужно равномерное распределение, которое можно получить с помощь функции uniform.
Выбор и перемешивание
Перемешать NumPy массив можно с помощью функции shuffle:
Также можно перемешать массив с помощью функции permutation (она, в отличие от shuffle, возвращает перемешанный массив). Также она, вызванная с одним аргументом (целым числом), возвращает перемешанную последовательность от 0 до N.
Сделать случайную выборку из массива можно с помощью функции choice. Про неё стоит рассказать подробнее.
numpy.random.choice(a, size=None, replace=True, p=None)
- a : одномерный массив или число. Если массив, будет производиться выборка из него. Если число, то выборка будет производиться из np.arange(a).
- size : размерности массива. Если None, возвращается одно значение.
- replace : если True, то одно значение может выбираться более одного раза.
- p : вероятности. Это означает, что элементы можно выбирать с неравными вероятностями. Если не заданы, используется равномерное распределение.
Инициализация генератора случайных чисел
seed(число) — инициализация генератора.
get_state и set_state — возвращают и устанавливают состояние генератора.
Для вставки кода на Python в комментарий заключайте его в теги
- Модуль csv - чтение и запись CSV файлов
- Создаём сайт на Django, используя хорошие практики. Часть 1: создаём проект
- Онлайн-обучение Python: сравнение популярных программ
- Книги о Python
- GUI (графический интерфейс пользователя)
- Курсы Python
- Модули
- Новости мира Python
- NumPy
- Обработка данных
- Основы программирования
- Примеры программ
- Типы данных в Python
- Видео
- Python для Web
- Работа для Python-программистов
- Сделай свой вклад в развитие сайта!
- Самоучитель Python
- Карта сайта
- Отзывы на книги по Python
- Реклама на сайте
Помогите решить задачу: C# Создать рандомную матрицу nxn (выполнено) после чего сложить данные выделенные элементы:
Буду премного благодарен за ответ, уже бьюсь около месяца над задачей, никак решить всей группой не можем.
Дополнен 9 лет назад
К комментарию ниже: А если придется посчитать внутри этой фигуры? Просто это 2 задание этой задачи 🙂
Дополнен 9 лет назад
Всем спасибо, немного начинаю понимать, но вот 2 комментарий очень хорошо показывает суть задачи) Спасибо)
Лучший ответ
Как всё сложно. Решение должно быть красивым!
Вот http://ideone.com/cZMbPY заполнение матрицы произвольного размера.
Вместо заполнения можно переделать на подсчет сумм.
Остальные ответы
Если в условии точно заданно что n - нечетное число, тогда все просто.
for(int i = 0; i < n / 2; i++)
for(int j = 0; j < n / 2; j++)
sum += a[n / 2 + i + 1, j];
sum += a[n / 2 + i + 1, n - j];
sum += a[i, n / 2 + j + 1];
sum += a[n - i, n / 2 + j + 1];
>
using System;
namespace Example public class Program static void Main() Random rnd = new Random();
int range = 5;
int[][] matrix = new int[range][];
for (int r = 0; r < range; ++r) matrix[r] = new int[range];
for (int c = 0; c < range; ++c) matrix[r][c] = rnd.Next(1, 10);
>
Print(matrix);
if (range % 2 != 0) Console.WriteLine("Вариант со звёздочками: ", SimIn(matrix));
Console.WriteLine("Вариант без звёздочек: ", SimOut(matrix));
>
Console.ReadKey();
>
static void Print(int[][] matrix) int range = matrix.GetLength(0);
for (int r = 0; r < range; ++r) for (int c = 0; c < range; ++c) Console.Write("", matrix[r][c]);
Console.WriteLine();
>
>
static int SimIn(int[][] matrix) int range = matrix.GetLength(0);
int sum = Sum(matrix);
int tmp = 0;
int midRow = range >> 1;
int left = midRow;
int right = midRow;
for (int r = 0; r < range; ++r) for (int c = 0; c < range; ++c) if (c == left || c == right) continue;
tmp += matrix[r][c];
>
if (r < midRow) ++right;
--left;
> else --right;
++left;
>
>
return sum - tmp;
>
static int SimOut(int[][] matrix) < return Sum(matrix) - SimIn(matrix); >
static int Sum(int[][] matrix) int sum = 0;
int range = matrix.GetLength(0);
for (int r = 0; r < range; ++r) for (int c = 0; c < range; ++c) sum += matrix[r][c];
return sum;
>
>
>
NumPy: матрицы и операции над ними
В этом ноутбуке из сторонних библиотек нам понадобится только NumPy. Для удобства импортируем ее под более коротким именем:
import numpy as np
1. Создание матриц
Приведем несколько способов создания матриц в NumPy.
Самый простой способ — с помощью функции numpy.array(list, dtype=None, . ).
В качестве первого аргумента ей надо передать итерируемый объект, элементами которого являются другие итерируемые объекты одинаковой длины и содержащие данные одинакового типа.
Второй аргумент является опциональным и определяет тип данных матрицы. Его можно не задавать, тогда тип данных будет определен из типа элементов первого аргумента. При задании этого параметра будет произведена попытка приведения типов.
Например, матрицу из списка списков целых чисел можно создать следующим образом:
a = np.array([1, 2, 3]) # Создаем одномерный массив print(type(a)) # Prints "" print(a.shape) # Prints "(3,)" - кортеж с размерностями print(a[0], a[1], a[2]) # Prints "1 2 3" a[0] = 5 # Изменяем значение элемента массива print(a) # Prints "[5, 2, 3]" b = np.array([[1,2,3],[4,5,6]]) # Создаем двухмерный массив print(b.shape) # Prints "(2, 3)" print(b[0, 0], b[0, 1], b[1, 0]) # Prints "1 2 4" print(np.arange(1, 5)) #Cоздает вектор с эелементами от 1 до 4
(3,) 1 2 3 [5 2 3] (2, 3) 1 2 4 [1 2 3 4]
matrix = np.array([[1, 2, 3], [2, 5, 6], [6, 7, 4]]) print ("Матрица:\n", matrix)
Матрица: [[1 2 3] [2 5 6] [6 7 4]]
Второй способ создания — с помощью встроенных функций numpy.eye(N, M=None, . ), numpy.zeros(shape, . ), numpy.ones(shape, . ).
Первая функция создает единичную матрицу размера N×M ; если M не задан, то M = N .
Вторая и третья функции создают матрицы, состоящие целиком из нулей или единиц соответственно. В качестве первого аргумента необходимо задать размерность массива — кортеж целых чисел. В двумерном случае это набор из двух чисел: количество строк и столбцов матрицы.
Примеры:
b = np.eye(5) print ("Единичная матрица:\n", b)
Единичная матрица: [[1. 0. 0. 0. 0.] [0. 1. 0. 0. 0.] [0. 0. 1. 0. 0.] [0. 0. 0. 1. 0.] [0. 0. 0. 0. 1.]]
c = np.ones((7, 5)) print ("Матрица, состоящая из одних единиц:\n", c)
Матрица, состоящая из одних единиц: [[1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.]]
d = np.full((2,2), 7) # Создает матрицу (1, 2) заполненую заданным значением print(d) # Prints "[[ 7. 7.] # [ 7. 7.]]" e = np.random.random((2,2)) # Создает еденичную матрицу (2, 2) заполненую случаными числами (0, 1) print(e) # Might print "[[ 0.91940167 0.08143941] # [ 0.68744134 0.87236687]]"
[[7 7] [7 7]] [[0.25744383 0.48056466] [0.13767881 0.40578168]]
Обратите внимание: размерность массива задается не двумя аргументами функции, а одним — кортежем!
Вот так — np.ones(7, 5) — создать массив не получится, так как функции в качестве параметра shape передается 7, а не кортеж (7, 5).
И, наконец, третий способ — с помощью функции numpy.arange([start, ]stop, [step, ], . ), которая создает одномерный массив последовательных чисел из промежутка [start, stop) с заданным шагом step, и метода array.reshape(shape).
Параметр shape, как и в предыдущем примере, задает размерность матрицы (кортеж чисел). Логика работы метода ясна из следующего примера:
v = np.arange(0, 24, 2) print ("Вектор-столбец:\n", v)
Вектор-столбец: [ 0 2 4 6 8 10 12 14 16 18 20 22]
d = v.reshape((3, 4)) print ("Матрица:\n", d)
Матрица: [[ 0 2 4 6] [ 8 10 12 14] [16 18 20 22]]
Более подробно о том, как создавать массивы в NumPy, см. документацию.
2. Индексирование
Для получения элементов матрицы можно использовать несколько способов. Рассмотрим самые простые из них.
Для удобства напомним, как выглядит матрица d:
print ("Матрица:\n", d)
Матрица: [[ 0 2 4 6] [ 8 10 12 14] [16 18 20 22]]
Элемент на пересечении строки i и столбца j можно получить с помощью выражения array[i, j].
Обратите внимание: строки и столбцы нумеруются с нуля!
print ("Второй элемент третьей строки матрицы:", d[2, 1])
Второй элемент третьей строки матрицы: 18
Из матрицы можно получать целые строки или столбцы с помощью выражений array[i, :] или array[:, j] соответственно:
print ("Вторая строка матрицы d:\n", d[1, :]) print ("Четвертый столбец матрицы d:\n", d[:, 3])
Вторая строка матрицы d: [ 8 10 12 14] Четвертый столбец матрицы d: [ 6 14 22]
Еще один способ получения элементов — с помощью выражения array[list1, list2], где list1, list2 — некоторые списки целых чисел. При такой адресации одновременно просматриваются оба списка и возвращаются элементы матрицы с соответствующими координатами. Следующий пример более понятно объясняет механизм работы такого индексирования:
print ("Элементы матрицы d с координатами (1, 2) и (0, 3):\n", d[[1, 0], [2, 3]])
Элементы матрицы d с координатами (1, 2) и (0, 3): [12 6]
# Slicing # Создадим матрицу (3, 4) # [[ 1 2 3 4] # [ 5 6 7 8] # [ 9 10 11 12]] a = np.array([[1,2,3,4], [5,6,7,8], [9,10,11,12]]) # Используя слайсинг, созадим матрицу b из элементов матрицы а # будем использовать 0 и 1 строку, а так же 1 и 2 столебц # [[2 3] # [6 7]] b = a[:2, 1:3] print(b) # ОБРАТИТЕ ВНИМАНИЕ НА ИЗМЕНЕНИЕ ИСХОДОЙ МАТРИЦЫ print(a[0, 1]) # Prints "2" b[0, 0] = 77 # b[0, 0] is the same piece of data as a[0, 1] print(a[0, 1]) # Prints "77"
[[2 3] [6 7]] 2 77
# Integer array indexing a = np.array([[1,2], [3, 4], [5, 6]]) print(a) print() # Пример Integer array indexing # В результате получится массив размерности (3,) # Обратите внимание, что до запятой идут индексы строк, после - столбцов print(a[[0, 1, 2], [0, 1, 0]]) # Prints "[1 4 5]" print() # По-другому пример можно записать так print(np.array([a[0, 0], a[1, 1], a[2, 0]])) # Prints "[1 4 5]"
[[1 2] [3 4] [5 6]] [1 4 5] [1 4 5]
Примеры использования слайсинга:
# Создадим новый маассив, из которого будем выбирать эллементы a = np.array([[1,2,3], [4,5,6], [7,8,9], [10, 11, 12]]) print(a) # prints "array([[ 1, 2, 3], # [ 4, 5, 6], # [ 7, 8, 9], # [10, 11, 12]])" # Создадим массив индексов b = np.array([0, 2, 0, 1]) # Выберем из каждой строки элемент с индексом из b (индекс столбца берется из b) print(a[np.arange(4), b]) # Prints "[ 1 6 7 11]" print() # Добавим к этим элементам 10 a[np.arange(4), b] += 10 print(a) # prints "array([[11, 2, 3], # [ 4, 5, 16], # [17, 8, 9], # [10, 21, 12]])
[[ 1 2 3] [ 4 5 6] [ 7 8 9] [10 11 12]] [ 1 6 7 11] [[11 2 3] [ 4 5 16] [17 8 9] [10 21 12]]
a = np.array([[1,2], [3, 4], [5, 6]]) bool_idx = (a > 2) # Найдем эллементы матрицы a, которые больше 2 # В результате получим матрицу b, такой же размерности, как и a print(bool_idx) # Prints "[[False False] print() # [ True True] # [ True True]]" # Воспользуемся полученным массивом для создания нового массива, ранга 1 print(a[bool_idx]) # Prints "[3 4 5 6]" # Аналогично print(a[a > 2]) # Prints "[3 4 5 6]"
[[False False] [ True True] [ True True]] [3 4 5 6] [3 4 5 6]
#Помните, что вы можете пользоваться сразу несколькими типами индексирования a = np.array([[1,2,3,4], [5,6,7,8], [9,10,11,12]]) row_r1 = a[1, :] row_r2 = a[1:2, :] print(row_r1, row_r1.shape) # Prints "[5 6 7 8] (4,)" print(row_r2, row_r2.shape) # Prints "[[5 6 7 8]] (1, 4)"
[5 6 7 8] (4,) [[5 6 7 8]] (1, 4)
Более подробно о различных способах индексирования в массивах см. документацию.
3. Векторы, вектор-строки и вектор-столбцы
Следующие два способа задания массива кажутся одинаковыми:
a = np.array([1, 2, 3]) b = np.array([[1], [2], [3]])
Однако, на самом деле, это задание одномерного массива (то есть вектора) и двумерного массива:
print ("Вектор:\n", a) print ("Его размерность:\n", a.shape) print ("Двумерный массив:\n", b) print ("Его размерность:\n", b.shape)
Вектор: [1 2 3] Его размерность: (3,) Двумерный массив: [[1] [2] [3]] Его размерность: (3, 1)
Обратите внимание: вектор (одномерный массив) и вектор-столбец или вектор-строка (двумерные массивы) являются различными объектами в NumPy, хотя математически задают один и тот же объект. В случае одномерного массива кортеж shape состоит из одного числа и имеет вид (n,), где n — длина вектора. В случае двумерных векторов в shape присутствует еще одна размерность, равная единице.
В большинстве случаев неважно, какое представление использовать, потому что часто срабатывает приведение типов. Но некоторые операции не работают для одномерных массивов. Например, транспонирование (о нем пойдет речь ниже):
a = a.T b = b.T
print ("Вектор не изменился:\n", a) print ("Его размерность также не изменилась:\n", a.shape) print ("Транспонированный двумерный массив:\n", b) print ("Его размерность изменилась:\n", b.shape)
Вектор не изменился: [1 2 3] Его размерность также не изменилась: (3,) Транспонированный двумерный массив: [[1 2 3]] Его размерность изменилась: (1, 3)
4. Datatypes
Все элементы в массиве numpy принадлежат одному типу. В этом плане массивы ближе к C, чем к привычным вам листам питона. Numpy имеет множество встренных типов, подходящих для решения большинства задач.
x = np.array([1, 2]) # Автоматический выбор типа print(x.dtype) # Prints "int64" x = np.array([1.0, 2.0]) # Автоматический выбор типа print(x.dtype) # Prints "float64" x = np.array([1, 2], dtype=np.int64) # Принудительное выставление типа print(x.dtype) # Prints "int64"
int32 float64 int64
5. Математические операции
К массивам (матрицам) можно применять известные вам математические операции. Следут понимать, что при этом у элементов должны быть схожие размерности. Поведение в случае не совпадения размерностей хорошо описанно в документации numpy.
x = np.array([[1,2],[3,4]], dtype=np.float64) y = np.array([[5,6],[7,8]], dtype=np.float64) arr = np.array([1, 2])
# Сложение происходит поэлеметно # [[ 6.0 8.0] # [10.0 12.0]] print(x + y) print() print(np.add(x, y)) print('С числом') print(x + 1) print('C массивом другой размерности') print(x + arr)
[[ 6. 8.] [10. 12.]] [[ 6. 8.] [10. 12.]] С числом [[2. 3.] [4. 5.]] C массивом другой размерности [[2. 4.] [4. 6.]]
# Вычитание print(x - y) print(np.subtract(x, y))
[[-4. -4.] [-4. -4.]] [[-4. -4.] [-4. -4.]]
# Деление # [[ 0.2 0.33333333] # [ 0.42857143 0.5 ]] print(x / y) print(np.divide(x, y))
[[0.2 0.33333333] [0.42857143 0.5 ]] [[0.2 0.33333333] [0.42857143 0.5 ]]
# Другие функции # [[ 1. 1.41421356] # [ 1.73205081 2. ]] print(np.sqrt(x))
[[1. 1.41421356] [1.73205081 2. ]]
6. Умножение матриц и столбцов
Напоминание теории. Операция умножения определена для двух матриц, таких что число столбцов первой равно числу строк второй.
Пусть матрицы A и B таковы, что A ∈ ℝ n×k и B ∈ ℝ k×m . Произведением матриц A и B называется матрица C , такая что cij = ∑ k r = 1 airbrj , где cij — элемент матрицы C , стоящий на пересечении строки с номером i и столбца с номером j .
В NumPy произведение матриц вычисляется с помощью функции numpy.dot(a, b, . ) или с помощью метода array1.dot(array2), где array1 и array2 — перемножаемые матрицы.
a = np.array([[1, 0], [0, 1]]) b = np.array([[4, 1], [2, 2]]) r1 = np.dot(a, b) r2 = a.dot(b)
print ("Матрица A:\n", a) print ("Матрица B:\n", b) print ("Результат умножения функцией:\n", r1) print ("Результат умножения методом:\n", r2)
Матрица A: [[1 0] [0 1]] Матрица B: [[4 1] [2 2]] Результат умножения функцией: [[4 1] [2 2]] Результат умножения методом: [[4 1] [2 2]]
Матрицы в NumPy можно умножать и на векторы:
c = np.array([1, 2]) r3 = b.dot(c)
print ("Матрица:\n", b) print ("Вектор:\n", c) print ("Результат умножения:\n", r3)
Матрица: [[4 1] [2 2]] Вектор: [1 2] Результат умножения: [6 6]
Обратите внимание: операция * производит над матрицами покоординатное умножение, а не матричное!
r = a * b
print ("Матрица A:\n", a) print ("Матрица B:\n", b) print ("Результат покоординатного умножения через операцию умножения:\n", r)
Матрица A: [[1 0] [0 1]] Матрица B: [[4 1] [2 2]] Результат покоординатного умножения через операцию умножения: [[4 0] [0 2]]
Более подробно о матричном умножении в NumPy см. документацию.
7. Объединение массивов
Массивы можно Объединенять. Есть горизонтальное и вертикальное объединение.
a = np.floor(10*np.random.random((2,2))) b = np.floor(10*np.random.random((2,2))) print(a) print(b) print() print(np.vstack((a,b))) print() print(np.hstack((a,b)))
[[4. 0.] [1. 4.]] [[9. 7.] [2. 6.]] [[4. 0.] [1. 4.] [9. 7.] [2. 6.]] [[4. 0. 9. 7.] [1. 4. 2. 6.]]
Массивы можно переформировать при помощи метода, который задает новый многомерный массив. Следуя следующему примеру, мы переформатируем одномерный массив из десяти элементов во двумерный массив, состоящий из пяти строк и двух столбцов:
a = np.array(range(10), float) print(a) print() # Превратим в матрицу a = a.reshape((5, 2)) print(a) print() # Вернем обратно print(a.flatten()) # Другой вариант print(a.reshape((-1))) # Превратим в марицу (9, 1) print(a.reshape((-1, 1))) # Превратим в марицу (1, 9) print(a.reshape((1, -1)))
[0. 1. 2. 3. 4. 5. 6. 7. 8. 9.] [[0. 1.] [2. 3.] [4. 5.] [6. 7.] [8. 9.]] [0. 1. 2. 3. 4. 5. 6. 7. 8. 9.] [0. 1. 2. 3. 4. 5. 6. 7. 8. 9.] [[0.] [1.] [2.] [3.] [4.] [5.] [6.] [7.] [8.] [9.]] [[0. 1. 2. 3. 4. 5. 6. 7. 8. 9.]]
Задания: (Блок 1)
Задание 1:
Решите без использования циклов средставми NumPy (каждый пункт решается в 1-2 строчки)
- Создайте вектор с элементами от 12 до 42
- Создайте вектор из нулей длины 12, но его пятый елемент должен быть равен 1
- Создайте матрицу (3, 3), заполненую от 0 до 8
- Найдите все положительные числа в np.array([1,2,0,0,4,0])
- Умножьте матрицу размерности (5, 3) на (3, 2)
- Создайте матрицу (10, 10) так, чтобы на границе были 0, а внтури 1
- Создайте рандомный вектор и отсортируйте его
- Каков эквивалент функции enumerate для numpy массивов?
- *Создайте рандомный вектор и выполните нормализацию столбцов (из каждого столбца вычесть среднее этого столбца, из каждого столбца вычесть sd этого столбца)
- *Для заданного числа найдите ближайший к нему элемент в векторе
- *Найдите N наибольших значений в векторе
# ваш код здесь
Задание 2:
Напишите полностью векторизованный вариант
Дан трёхмерный массив, содержащий изображение, размера (height, width, numChannels), а также вектор длины numChannels. Сложить каналы изображения с указанными весами, и вернуть результат в виде матрицы размера (height, width). Считать реальное изображение можно при помощи функции scipy.misc.imread (если изображение не в формате png, установите пакет pillow: conda install pillow). Преобразуйте цветное изображение в оттенки серого, использовав коэффициенты np.array([0.299, 0.587, 0.114]).
# ваш код здесь
8. Транспонирование матриц
Напоминание теории. Транспонированной матрицей A T называется матрица, полученная из исходной матрицы A заменой строк на столбцы. Формально: элементы матрицы A T определяются как a T ij = aji , где a T ij — элемент матрицы A T , стоящий на пересечении строки с номером i и столбца с номером j .
В NumPy транспонированная матрица вычисляется с помощью функции numpy.transpose() или с помощью метода array.T, где array — нужный двумерный массив.
a = np.array([[1, 2], [3, 4]]) b = np.transpose(a) c = a.T
print ("Матрица:\n", a) print ("Транспонирование функцией:\n", b) print ("Транспонирование методом:\n", c)
Матрица: [[1 2] [3 4]] Транспонирование функцией: [[1 3] [2 4]] Транспонирование методом: [[1 3] [2 4]]
В следующих разделах активно используется модуль numpy.linalg, реализующий некоторые приложения линейной алгебры. Более подробно о функциях, описанных ниже, и различных других функциях этого модуля можно посмотреть в его документации.
9. Определитель матрицы
Напоминание теории. Для квадратных матриц существует понятие определителя.
Пусть A — квадратная матрица. Определителем (или детерминантом) матрицы A ∈ ℝ n×n назовем число
detA = ∑ α1, α2, …, αn ( − 1) N(α1, α2, …, αn) ⋅aα11⋅⋅⋅aαnn,
где α1, α2, …, αn — перестановка чисел от 1 до n , N(α1, α2, …, αn) — число инверсий в перестановке, суммирование ведется по всем возможным перестановкам длины n .
Не стоит расстраиваться, если это определение понятно не до конца — в дальнейшем в таком виде оно не понадобится.
Например, для матрицы размера 2×2 получается:
det ⎛ ⎜ ⎝ a11 a12 a21 a22 ⎞ ⎟ ⎠ = a11a22 − a12a21
Вычисление определителя матрицы по определению требует порядка n! операций, поэтому разработаны методы, которые позволяют вычислять его быстро и эффективно.
В NumPy определитель матрицы вычисляется с помощью функции numpy.linalg.det(a), где a — исходная матрица.
a = np.array([[1, 2, 1], [1, 1, 4], [2, 3, 6]], dtype=np.float32) det = np.linalg.det(a)
print ("Матрица:\n", a) print ("Определитель:\n", det)
Матрица: [[1. 2. 1.] [1. 1. 4.] [2. 3. 6.]] Определитель: -1.0
Рассмотрим одно интересное свойство определителя. Пусть у нас есть параллелограмм с углами в точках (0, 0), (c, d), (a + c, b + d), (a, b) (углы даны в порядке обхода по часовой стрелке). Тогда площадь этого параллелограмма можно вычислить как модуль определителя матрицы ⎛ ⎜ ⎝ a c b d ⎞ ⎟ ⎠ . Похожим образом можно выразить и объем параллелепипеда через определитель матрицы размера 3×3 .
10. Ранг матрицы
Напоминание теории. Рангом матрицы A называется максимальное число линейно независимых строк (столбцов) этой матрицы.
В NumPy ранг матрицы вычисляется с помощью функции numpy.linalg.matrix_rank(M, tol=None), где M — матрица, tol — параметр, отвечающий за некоторую точность вычисления. В простом случае можно его не задавать, и функция сама определит подходящее значение этого параметра.
a = np.array([[1, 2, 3], [1, 1, 1], [2, 2, 2]]) r = np.linalg.matrix_rank(a)
print ("Матрица:\n", a) print ("Ранг матрицы:", r)
Матрица: [[1 2 3] [1 1 1] [2 2 2]] Ранг матрицы: 2
С помощью вычисления ранга матрицы можно проверять линейную независимость системы векторов.
Допустим, у нас есть несколько векторов. Составим из них матрицу, где наши векторы будут являться строками. Понятно, что векторы линейно независимы тогда и только тогда, когда ранг полученной матрицы совпадает с числом векторов. Приведем пример:
a = np.array([1, 2, 3]) b = np.array([1, 1, 1]) c = np.array([2, 3, 5]) m = np.array([a, b, c])
print (np.linalg.matrix_rank(m) == m.shape[0])
True
11. Системы линейных уравнений
Напоминание теории. Системой линейных алгебраических уравнений называется система вида Ax = b , где A ∈ ℝ n×m , x ∈ ℝ m×1 , b ∈ ℝ n×1 . В случае квадратной невырожденной матрицы A решение системы единственно.
В NumPy решение такой системы можно найти с помощью функции numpy.linalg.solve(a, b), где первый аргумент — матрица A , второй — столбец b .
a = np.array([[3, 1], [1, 2]]) b = np.array([9, 8]) x = np.linalg.solve(a, b)
print ("Матрица A:\n", a) print ("Вектор b:\n", b) print ("Решение системы:\n", x)
Матрица A: [[3 1] [1 2]] Вектор b: [9 8] Решение системы: [2. 3.]
Убедимся, что вектор x действительно является решением системы:
print (a.dot(x))
Бывают случаи, когда решение системы не существует. Но хотелось бы все равно “решить” такую систему. Логичным кажется искать такой вектор x , который минимизирует выражение ‖ Ax − b ‖ 2 — так мы приблизим выражение Ax к b .
В NumPy такое псевдорешение можно искать с помощью функции numpy.linalg.lstsq(a, b, . ), где первые два аргумента такие же, как и для функции numpy.linalg.solve(). Помимо решения функция возвращает еще три значения, которые нам сейчас не понадобятся.
a = np.array([[0, 1], [1, 1], [2, 1], [3, 1]]) b = np.array([-1, 0.2, 0.9, 2.1]) x, res, r, s = np.linalg.lstsq(a, b, rcond=None)
print ("Матрица A:\n", a) print ("Вектор b:\n", b) print ("Псевдорешение системы:\n", x)
Матрица A: [[0 1] [1 1] [2 1] [3 1]] Вектор b: [-1. 0.2 0.9 2.1] Псевдорешение системы: [ 1. -0.95]
12. Обращение матриц
Напоминание теории. Для квадратных невырожденных матриц определено понятие обратной матрицы.
Пусть A — квадратная невырожденная матрица. Матрица A − 1 называется обратной матрицей к A , если
AA − 1 = A − 1 A = I,
где I — единичная матрица.
В NumPy обратные матрицы вычисляются с помощью функции numpy.linalg.inv(a), где a — исходная матрица.
a = np.array([[1, 2, 1], [1, 1, 4], [2, 3, 6]], dtype=np.float32) b = np.linalg.inv(a)
print ("Матрица A:\n", a) print ("Обратная матрица к A:\n", b) print ("Произведение A на обратную должна быть единичной:\n", a.dot(b))
Матрица A: [[1. 2. 1.] [1. 1. 4.] [2. 3. 6.]] Обратная матрица к A: [[ 6. 9. -7.] [-2. -4. 3.] [-1. -1. 1.]] Произведение A на обратную должна быть единичной: [[1. 0. 0.] [0. 1. 0.] [0. 0. 1.]]
13. Собственные числа и собственные вектора матрицы
Напоминание теории. Для квадратных матриц определены понятия собственного вектора и собственного числа.
Пусть A — квадратная матрица и A ∈ ℝ n×n . Собственным вектором матрицы A называется такой ненулевой вектор x ∈ ℝ n , что для некоторого λ ∈ ℝ выполняется равенство Ax = λx . При этом λ называется собственным числом матрицы A . Собственные числа и собственные векторы матрицы играют важную роль в теории линейной алгебры и ее практических приложениях.
В NumPy собственные числа и собственные векторы матрицы вычисляются с помощью функции numpy.linalg.eig(a), где a — исходная матрица. В качестве результата эта функция выдает одномерный массив w собственных чисел и двумерный массив v, в котором по столбцам записаны собственные вектора, так что вектор v[:, i] соотвествует собственному числу w[i].
a = np.array([[-1, -6], [2, 6]]) w, v = np.linalg.eig(a)
print ("Матрица A:\n", a) print ("Собственные числа:\n", w) print ("Собственные векторы:\n", v)
Матрица A: [[-1 -6] [ 2 6]] Собственные числа: [2. 3.] Собственные векторы: [[-0.89442719 0.83205029] [ 0.4472136 -0.5547002 ]]
Обратите внимание: у вещественной матрицы собственные значения или собственные векторы могут быть комплексными.
14. Расстояния между векторами
Вспомним некоторые нормы, которые можно ввести в пространстве ℝ n , и рассмотрим, с помощью каких библиотек и функций их можно вычислять в NumPy.
p-норма
p-норма (норма Гёльдера) для вектора x = (x1, …, xn) ∈ ℝ n вычисляется по формуле:
‖ x ‖ p = ( n ∑ i = 1 | xi | p ) 1 ⁄ p , p ≥ 1.
В частных случаях при: * p = 1 получаем ℓ1 норму * p = 2 получаем ℓ2 норму
Далее нам понабится модуль numpy.linalg, реализующий некоторые приложения линейной алгебры. Для вычисления различных норм мы используем функцию numpy.linalg.norm(x, ord=None, . ), где x — исходный вектор, ord — параметр, определяющий норму (мы рассмотрим два варианта его значений — 1 и 2). Импортируем эту функцию:
from numpy.linalg import norm
ℓ1 норма
ℓ1 норма (также известная как манхэттенское расстояние) для вектора x = (x1, …, xn) ∈ ℝ n вычисляется по формуле:
‖ x ‖ 1 = n ∑ i = 1 | xi | .
Ей в функции numpy.linalg.norm(x, ord=None, . ) соответствует параметр ord=1.
a = np.array([1, 2, -3]) print('Вектор a:', a)
Вектор a: [ 1 2 -3]
print('L1 норма вектора a:\n', norm(a, ord=1))
L1 норма вектора a: 6.0
ℓ2 норма
ℓ2 норма (также известная как евклидова норма) для вектора x = (x1, …, xn) ∈ ℝ n вычисляется по формуле:
‖ x ‖ 2 = √ ( n ∑ i = 1 ( xi ) 2 ) .
Ей в функции numpy.linalg.norm(x, ord=None, . ) соответствует параметр ord=2.
print ('L2 норма вектора a:\n', norm(a, ord=2))
L2 норма вектора a: 3.7416573867739413
Более подробно о том, какие еще нормы (в том числе матричные) можно вычислить, см. документацию.
15. Расстояния между векторами
Для двух векторов x = (x1, …, xn) ∈ ℝ n и y = (y1, …, yn) ∈ ℝ n ℓ1 и ℓ2 раccтояния вычисляются по следующим формулам соответственно:
ρ1 ( x, y ) = ‖ x − y ‖ 1 = n ∑ i = 1 | xi − yi |
ρ2 ( x, y ) = ‖ x − y ‖ 2 = √ ( n ∑ i = 1 ( xi − yi ) 2 ) .
a = np.array([1, 2, -3]) b = np.array([-4, 3, 8]) print ('Вектор a:', a) print ('Вектор b:', b)
Вектор a: [ 1 2 -3] Вектор b: [-4 3 8]
print ('L1 расстояние между векторами a и b:\n', norm(a - b, ord=1)) print ('L2 расстояние между векторами a и b:\n', norm(a - b, ord=2))
L1 расстояние между векторами a и b: 17.0 L2 расстояние между векторами a и b: 12.12435565298214
16. Скалярное произведение и угол между векторами
a = np.array([0, 5, -1]) b = np.array([-4, 9, 3]) print ('Вектор a:', a) print ('Вектор b:', b)
Вектор a: [ 0 5 -1] Вектор b: [-4 9 3]
Скалярное произведение в пространстве ℝ n для двух векторов x = (x1, …, xn) и y = (y1, …, yn) определяется как:
⟨x, y⟩ = n ∑ i = 1 xiyi.
Длиной вектора x = (x1, …, xn) ∈ ℝ n называется квадратный корень из скалярного произведения, то есть длина равна евклидовой норме вектора:
| x | = √ ( ⟨x, x⟩ ) = √ ( n ∑ i = 1 x 2 i ) = ‖ x ‖ 2.
Теперь, когда мы знаем расстояние между двумя ненулевыми векторами и их длины, мы можем вычислить угол между ними через скалярное произведение:
⟨x, y⟩ = | x | |y|cos(α) ⟹ cos(α) = ( ⟨x, y⟩ )/( | x | |y| ) ,
где α ∈ [0, π] — угол между векторами x и y .
cos_angle = np.dot(a, b) / norm(a) / norm(b) print ('Косинус угла между a и b:', cos_angle) print ('Сам угол:', np.arccos(cos_angle))
Косинус угла между a и b: 0.8000362836474323 Сам угол: 0.6434406336093618
17. Комплексные числа в питоне
Напоминание теории. Комплексными числами называются числа вида x + iy , где x и y — вещественные числа, а i — мнимая единица (величина, для которой выполняется равенство i 2 = − 1 ). Множество всех комплексных чисел обозначается буквой ℂ (подробнее про комплексные числа см. википедию).
В питоне комплескные числа можно задать следующим образом (j обозначает мнимую единицу):
a = 3 + 2j b = 1j
print ("Комплексное число a:\n", a) print ("Комплексное число b:\n", b)
Комплексное число a: (3+2j) Комплексное число b: 1j
С комплексными числами в питоне можно производить базовые арифметические операции так же, как и с вещественными числами:
c = a * a d = a / (4 - 5j)
print ("Комплексное число c:\n", c) print ("Комплексное число d:\n", d)
Комплексное число c: (5+12j) Комплексное число d: (0.0487804878048781+0.5609756097560976j)
Задания: (Блок 2)
Задание 3:
Рассмотрим сложную математическую функцию на отрезке [1, 15]:
f(x) = sin(x / 5) * exp(x / 10) + 5 * exp(-x / 2)
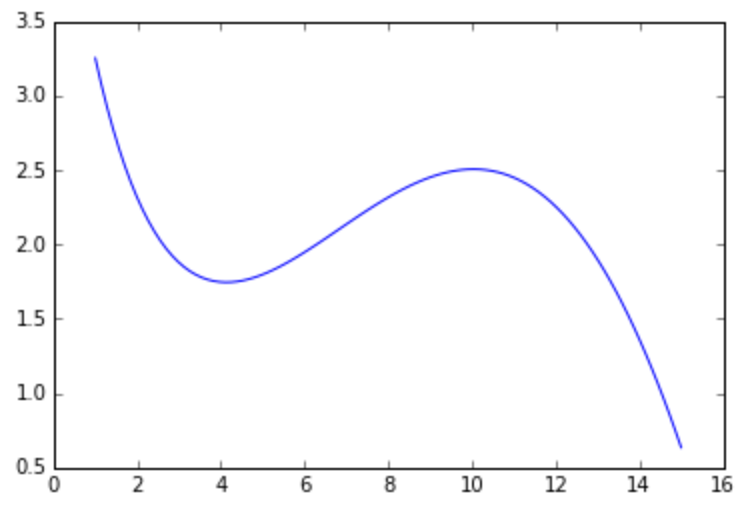
Она может описывать, например, зависимость оценок, которые выставляют определенному сорту вина эксперты, в зависимости от возраста этого вина. Мы хотим приблизить сложную зависимость с помощью функции из определенного семейства. В этом задании мы будем приближать указанную функцию с помощью многочленов.
Как известно, многочлен степени n (то есть w0 + w1x + w2x 2 + … + wnx n ) однозначно определяется любыми n + 1 различными точками, через которые он проходит. Это значит, что его коэффициенты w0 , … wn можно определить из следующей системы линейных уравнений:
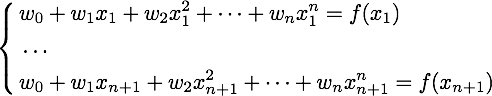
где через x1, . xn, xn + 1 обозначены точки, через которые проходит многочлен, а через f(x1), . f(xn), f(xn + 1) — значения, которые он должен принимать в этих точках.
Воспользуемся описанным свойством, и будем находить приближение функции многочленом, решая систему линейных уравнений.
- Сформируйте систему линейных уравнений (то есть задайте матрицу коэффициентов A и свободный вектор b) для многочлена первой степени, который должен совпадать с функцией f в точках 1 и 15. Решите данную систему с помощью функции scipy.linalg.solve. Нарисуйте функцию f и полученный многочлен. Хорошо ли он приближает исходную функцию?
- Повторите те же шаги для многочлена второй степени, который совпадает с функцией f в точках 1, 8 и 15. Улучшилось ли качество аппроксимации?
- Повторите те же шаги для многочлена третьей степени, который совпадает с функцией f в точках 1, 4, 10 и 15. Хорошо ли он аппроксимирует функцию? Коэффициенты данного многочлена (четыре числа в следующем порядке: w_0, w_1, w_2, w_3) являются ответом на задачу. Округлять коэффициенты не обязательно, но при желании можете произвести округление до второго знака (т.е. до числа вида 0.42)
Сайт построен с использованием Pelican. За основу оформления взята тема от Smashing Magazine. Исходные тексты программ, приведённые на этом сайте, распространяются под лицензией GPLv3, все остальные материалы сайта распространяются под лицензией CC-BY.
Генерация случайных данных в Python (Руководство)
Насколько случайны случайности? Это странный вопрос, но желательно его задать, если речь идет об информационной безопасности. Когда вы генерируете случайные данные, числа или строки в Python, неплохо иметь хотя бы приблизительное представление о том, как именно генерируются эти данные.
Здесь мы рассмотрим несколько различных способов генерации данных в Python и перейдем к их сравнению в таких категориях, как безопасность, универсальность, предназначение и скорость.
Мы обещаем, что данное руководство не будет похоже на урок математики, или криптографии: математики здесь будет ровно столько, сколько необходимо!
Насколько случайны случайности?
Во первых, нужно сделать небольшое заявление. Большая часть случайных данных, сгенерированных в Python — не совсем “случайная” в научном понимании слова. Скорее, это псевдослучайность, сгенерированная генератором псевдослучайных чисел (PRNG), который по сути, является любым алгоритмом для генерации на первый взгляд случайных, но все еще воспроизводимых данных.
Есть вопросы по Python?
На нашем форуме вы можете задать любой вопрос и получить ответ от всего нашего сообщества!
Telegram Чат & Канал
Вступите в наш дружный чат по Python и начните общение с единомышленниками! Станьте частью большого сообщества!
Паблик VK
Одно из самых больших сообществ по Python в социальной сети ВК. Видео уроки и книги для вас!
“Настоящие” случайные числа могут быть сгенерированы при помощи (как вы, скорее всего, можете догадаться), настоящим генератором случайных чисел (true random number generator, TRNG). Пример: регулярно поднимать игральный кубик с пола, подбрасывать его в воздух и дать ему приземлиться.
Представим, что вы совершаете бросок произвольно и понятия не имеете, какое число выпадет на кубике. Бросок кубика — это грубая форма использования аппаратного обеспечения для генерации числа, которое не является детерминированным. TRNG выходит за рамки этой статьи, однако это стоит упомянуть в любом случае, хотя бы для сравнения.
PRNG, выполняемые обычно программным, а не аппаратным обеспечением, немного отличаются. Вот краткое описание:
Они начинают со случайного числа, также известного как зерно и затем используют алгоритм для генерации псевдослучайной последовательности битов, основанных на нём.
В какой-то момент вам могут посоветовать почитать документацию. И эти люди не то, что ошибутся. Вот интересный сниппет из документации модуля random, который вам не стоит упускать:
Внимание: псевдослучайные генераторы этого модуля не должны быть использованы в целях безопасности (источник).
Возможно, вы уже сталкивались с random.seed(999), random.seed(1234), или им подобным. Этот вызов функции проходит через генератор случайных чисел, который используется модулем random Python. Это то, что делает последующие вызовы генератора случайных чисел детерминированными: вход А производит выход Б. Это чудо может стать проклятием, если используется неправильно.
Возможно термины “случайный” и “детерминированный” выглядят так, будто не могут упоминаться в одном контексте. Чтобы прояснить этот момент, вот супер упрощенная версия random(), которая итеративно создает “случайное” число, используя x = (x * 3) % 19.
“Х” изначально определен как значение сид (cлучайное начальное значение), после чего превращается в детерминированную последовательность чисел, основанных на этом семени:
class NotSoRandom ( object ) :
def seed ( self , a = 3 ) :
"""Самый загадочный генератор случайных чисел в мире."""
self . seedval = a
def random ( self ) :
"""Смотрите, случайные числа!"""
self . seedval = ( self . seedval * 3 ) % 19
return self . seedval
_inst = NotSoRandom ( )
seed = _inst . seed
random = _inst . random
Не стоит воспринимать этот пример слишком буквально, так как он служит чисто для отображения концепции. Если вы используете значение сид 1234, дальнейшая последовательность вызовов random() всегда должна быть идентичной:
>>> seed ( 1234 )
>>> [ random ( ) for _ in range ( 10 ) ]
[ 16 , 10 , 11 , 14 , 4 , 12 , 17 , 13 , 1 , 3 ]
>>> seed ( 1234 )
>>> [ random ( ) for _ in range ( 10 ) ]
[ 16 , 10 , 11 , 14 , 4 , 12 , 17 , 13 , 1 , 3 ]
Мы рассмотрим более серьезную иллюстрацию данного примера в дальнейшем.
Что значит “криптографически безопасно”?
Если вам казалось, что в статье мало акронимов типа “RNG” — то добавим сюда еще один: CSPRNG — криптографически безопасный PRNG. CSPRNG подходят для генерации конфиденциальных данных, таких как пароли, аутентификаторы и токены. Благодаря заданной случайно строке, условный злодей не сможет определить, какая строка шла за или перед этой строкой в последовательности случайных строк.
Еще один термин, с которым вы можете столкнуться — энтропия. В двух словах, она ссылается на количество случайностей, желаемых или введенных. Например, один модуль Python, который мы рассмотрим в данной статье, определяет DEFAULT_ENTROPY = 32, количество возвращаемых байтов по умолчанию. Разработчики считают это количество байтов “достаточным”.
Обратите внимание: В данной статье я предполагаю, что байт ссылается на 8 битов, как в далеких 60-х, а не к какой-либо другой единице хранения. Можете называть его октетом, если хотите.
Главная суть CSPRNG — это то, что они все еще псевдослучайные. Они сконструированы таким образом, что являются внутренне детерминированными, но добавляют некие другие переменные, или имеют определенную собственность, которая делает их “достаточно случайными”, чтобы запретить поддержку любой функции, которая выполняет детерменизм.
Что вы из этого почерпнете?
Практически, это значит, что вам нужно использовать PRNG для статистического моделирования, симуляции и сделать случайные данные воспроизводимыми. PRNG также значительно быстрее, чем CSPRNG, что вы и увидите в дальнейшем. Используйте CSPRNG для безопасности и в криптографических приложениях, где конфиденциальные данные являются обязательным условием.
В дополнение к расширению использования вышеупомянутых примеров в этой статье, вы познакомитесь с инструментами Python для работы как с PRNG, так и с CSPRNG:
- Опции PRNG включают в себя модуль random из стандартной библиотеки Python, а также основанную на массивах копию NumPy, под названием numpy.random
- Модули Python, такие как os, secrets, и uuid содержат функции для генерации криптографически безопасных объектов.
Мы рассмотрим все вышеперечисленное и подытожим детальным сравнением.
PRNG в Python
Модуль random
Возможно самый известный инструмент для генерации случайных данных в Python — это модуль random, который использует алгоритм PRNG под названием Mersenne Twister в качестве корневого генератора.
Ранее, мы затронули random.seed(), и теперь настало подходящее время, чтобы узнать, как он работает. Сначала, давайте создадим случайные данные без сидинга. Функция random.random() возвращает случайное десятичное число с интервалом [0.0, 1.0). В результате всегда будет меньше, чем правая конечная точка (1.0). Это также известно, как полуоткрытый диапазон:
>>> # Пока не вызываем random.seed()
>>> import random
>>> random . random ( )
0.35553263284394376
>>> random . random ( )
0.6101992345575074
Если вы запустите этот код лично, весьма вероятно, что полученные числа на вашем компьютере будут другими. По умолчанию, когда вы не используете сид генератор, вы используете текущее системное время, или “источник случайности” вашей операционной системы, если это доступно.
С random.seed() вы можете сделать результаты воспроизводимыми, и цепочка вызова, после random.seed(), будет генерировать один и тот же след данных:
>>> random . seed ( 444 )
>>> random . random ( )
0.3088946587429545
>>> random . random ( )
0.01323751590501987
>>> random . seed ( 444 ) # Re-seed
>>> random . random ( )
0.3088946587429545
>>> random . random ( )
0.01323751590501987
Обратите внимание на повторение “случайных” чисел. Последовательность случайных чисел становится детерменированной, или полностью определенной значением сида, 444.
Давайте рассмотрим основы того, как функционирует модуль random. Ранее мы создали случайное десятичное число. Вы можете сгенерировать случайное целое число между двумя отметками в Python при помощи функции random.randint(). Таким образом охватывается целый интервал [x, y] и обе конечные точки могут быть включены:
>>> random . randint ( 0 , 10 )
>>> random . randint ( 500 , 50000 )
С random.randrange(), вы можете исключить правую часть интервала, то есть сгенерированное число всегда остается внутри [x, y) и всегда будет меньше правой части:
>>> random . randrange ( 1 , 10 )
Если вы хотите сгенерировать случайные десятичные числа, которые находятся в определенном интервале [x, y], вы можете использовать random.uniform(), который вырывается из непрерывного равномерного распределения:
>>> random . uniform ( 20 , 30 )
27.42639687016509
>>> random . uniform ( 30 , 40 )
36.33865802745107
Чтобы взять случайный элемент из последовательности, не являющейся пустой (такой как список или кортеж), вы можете использовать random.choice(). Также есть random.choices() для выборки нескольких элементов из последовательности с заменой (дубликаты возможны):
>>> items = [ 'one' , 'two' , 'three' , 'four' , 'five' ]
>>> random . choice ( items )
>>> random . choices ( items , k = 2 )
[ 'three' , 'three' ]
>>> random . choices ( items , k = 3 )
[ 'three' , 'five' , 'four' ]
Вы можете сделать последовательность случайной прямо на месте, при помощи random.shuffle(). Таким образом удастся обновить объект последовательности и сделать порядок элементов случайным:
>>> random . sample ( items , 4 )
[ 'one' , 'five' , 'four' , 'three' ]
Если вы не хотите делать это с изначальным списком, сначала вам может понадобиться сделать копию, а потом уже перемешать её. Вы можете создавать копии списков Python при помощи модуля copy, или просто x[:], или x.copy(), где x является списком.
Перед тем, как перейти к генерированию случайных данных в NumPy, давайте рассмотрим еще одно приложение, которое частично включено в процесс: генерация последовательности уникальных случайных строк с одинаковой длиной.
В первую очередь, это может разобраться с устройством функции. Вам нужно выбрать из “пула” символов, таких как буквы, числа, и\или знаки препинания, совмести их в одну строку, и затем проверить, является ли эта строка сгенерированной. Python работает отлично для такого типа тестирования:
import string
def unique_strings ( k : int , ntokens : int ,
pool : str = string . ascii_letters ) -> set :
"""Generate a set of unique string tokens.
k: Length of each token
ntokens: Number of tokens
pool: Iterable of characters to choose from
For a highly optimized version:
https://stackoverflow.com/a/48421303/7954504
while len ( seen ) < ntokens :
token = '' . join ( random . choices ( pool , k = k ) )
seen . add ( token )
return seen
«».join() присоединяет буквы из random.choices() в простую строку, где «k» это длинна строки. Это токен добавлен в набор, который не может иметь дубликатов, и цикл while будет проходить, пока набор не будет содержать количество элементов, которое вы определили.
На заметку: Модуль string содержит ряд полезных констант: cii_lowercase, ascii_uppercase, string.punctuation, ascii_whitespace и еще много других.
Давайте проверим эту функцию:
>>> unique_strings ( k = 4 , ntokens = 5 )
>>> unique_strings ( 5 , 4 , string . printable )
Для хорошо настроенной версии этой функции, этот ответ Stack Overflow использует функции генератора, привязку имени и еще несколько продвинутых хитростей, чтобы создать более быструю, криптографически безопасную версию упомянутой ранее unique_strings().
PRNG для массивов: numpy.random
Одна вещь, которую вы могли заметить, заключается в том, что большинство функций из случайного числа возвращают скалярное значение (один int, float, или другой объект). Если вы хотели сгенерировать последовательность случайных чисел, один из способов достичь этого — охватить список Python:
>>> [ random . random ( ) for _ in range ( 5 ) ]
[ 0.021655420657909374 ,
0.4031628347066195 ,
0.6609991871223335 ,
0.5854998250783767 ,
0.42886606317322706 ]
Есть еще один вариант, который был разработан как раз для этого. Вы можете рассматривать пакет numpy.random от NumPy как стандартный модуль random библиотеки Python, но только для массивов NumPy. (Он также имеет возможность рисовать из гораздо большего количество статистических распределений).
Обратите внимание на то, что numpy.random использует собственные PRNG, которые отделены от обычных случайных чисел. Вы не будете создавать детерминестически случайные массивы NumPy с вызовом random.seed():
>>> import numpy as np
>>> np . random . seed ( 444 )
>>> np . set_printoptions ( precision = 2 ) # Выводим десятичное число
Без дальнейших церемоний, вот несколько примеров, удовлетворяющих ваш аппетит:
>>> # Возвращение примеров из стандартного нормального распределения
>>> np . random . randn ( 5 )
array ( [ 0.36 , 0.38 , 1.38 , 1.18 , - 0.94 ] )
>>> np . random . randn ( 3 , 4 )
array ( [ [ - 1.14 , - 0.54 , - 0.55 , 0.21 ] ,
[ 0.21 , 1.27 , - 0.81 , - 3.3 ] ,
[ - 0.81 , - 0.36 , - 0.88 , 0.15 ] ] )
>>> # `p` это возможность выбора каждого элемента
>>> np . random . choice ( [ 0 , 1 ] , p = [ 0.6 , 0.4 ] , size = ( 5 , 4 ) )
array ( [ [ 0 , 0 , 1 , 0 ] ,
[ 0 , 1 , 1 , 1 ] ,
[ 1 , 1 , 1 , 0 ] ,
[ 0 , 0 , 0 , 1 ] ,
[ 0 , 1 , 0 , 1 ] ] )
В синтаксе для randn(d0, d1, …, dn), параметры d0, d1, …, dn являются опциональными и указывают форму итогового объекта. Здесь, np.random.randn(3, 4) создает 2d массив с 3 строками и 4 столбцами. В качестве данных будут i.i.d., что означает, что каждая точка данных создается независимо от других.
Еще одна простая операция — это создание последовательности случайных логических значений: True или False. Один из способов сделать это — использовать np.random.choice([True, False]). Однако, будет практически в 4 раза быстрее выбрать (0, 1), а затем отобразить эти целые числа в соответствующие булевские значения:
КОД # randint является [inclusive, exclusive), в отличие от random.randint()
КОД
>>> # NumPy's `randint` is [inclusive, exclusive), unlike `random.randint()`
>>> np . random . randint ( 0 , 2 , size = 25 , dtype = np . uint8 ) . view ( bool )
array ( [ True , False , True , True , False , True , False , False , False ,
False , False , True , True , False , False , False , True , False ,
True , False , True , True , True , False , True ] )
Что на счет генерации коррелированных данных? Скажем, вы хотите симулировать два корелированных временных ряда. Один из способов сделать — это использовать функцию multivariate_normal() нашего NumPy, которая учитывает матрицу ковариации. Другими словами, чтобы списать из одной нормальной распределенной случайной переменной, вам нужно определить ее среднее значение и дисперсию (или стандартное отклонение).
Для выборки из многомерного нормального распределения, вы определяете матрицу ковариации и средние значения, в итоге вы получите несколько взаимосвязанных рядов данных, которые разделены приблизительно нормально.
Однако, в отличие от ковариации, корреляция — это более знакомая для большинства мера, к тому же более интуитивная. Это ковариация, нормализованная продуктом стандартных отклонений, так что вы можете определить ковариацию с точки зрения корреляции и стандартного отклонения:
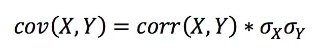
Итак, можете ли вы списать случайные выборки из многомерного нормального распределения, определив матрицу корреляции и стандартные отклонения? Да, но вам нужно будет получить приведенную выше формулу матрицы. Здесь, S — это вектор стандартных отклонений, P — это их корреляционная матрица, и С — это результирующая (квадратная) ковариационная матрица:
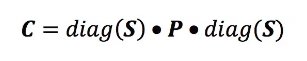
Это может быть выражено в NumPy следующим образом:
def corr2cov ( p : np . ndarray , s : np . ndarray ) -> np . ndarray :
"""Ковариационная матрица от корреляции и стандартных отклонений"""
d = np . diag ( s )
return d @ p @ d
Теперь, вы можете сгенерировать два временных ряда, которые коррелируют, но все еще являются случайными:
>>> # Начало с корреляционной матрицы и стандартных отклонений
>>> # -0.40 это корреляция между А и B, а корреляция
>>> # самой переменной равна 1.0
>>> corr = np . array ( [ [ 1. , - 0.40 ] ,
>>> # Стандартные отклонения\средние арифметические А и B, соответственно
>>> stdev = np . array ( [ 6. , 1. ] )
>>> mean = np . array ( [ 2. , 0.5 ] )
>>> cov = corr2cov ( corr , stdev )
>>> # `size` это длина временных рядов для 2д данных
>>> # (500 месяцев, дней, и так далее).
>>> data = np . random . multivariate_normal ( mean = mean , cov = cov , size = 500 )
array ( [ [ 0.58 , 1.87 ] ,
>>> data . shape
Вы можете рассматривать данные как 500 пар обратно-коррелированных точек данных. Вот проверка правильности, так что вы можете вернуться к изначальному вводу, который приблизительно соответствует corr, stdev, и mean из примера выше:
>>> np . corrcoef ( data , rowvar = False )
array ( [ [ 1. , - 0.39 ] ,
>>> data . std ( axis = 0 )
array ( [ 5.96 , 1.01 ] )
>>> data . mean ( axis = 0 )
array ( [ 2.13 , 0.49 ] )
Перед тем как мы перейдем к CSPRNG, может быть полезно обобщить некоторые случайные функции и копии numpy.random:
| Модуль random | Аналог NumPy | Использование |
| random() | rand() | Случайное десятичное [0.0, 1.0) |
| randint(a, b) | random_integers() | Случайное целое число [a, b] |
| randrange(a, b[, step]) | randint() | Случайное целое число [a, b) |
| uniform(a, b) | uniform() | Случайное десятичное [a, b] |
| choice(seq) | choice() | Случайный элемент из seq |
| choices(seq, k=1) | choice() | Случайные k элементы из seq с заменой |
| sample(population, k) | choice() с параметром replace=False | Случайные k элементы из seq без замены |
| shuffle(x[, random]) | shuffle() | Перемешка порядка |
| normalvariate(mu, sigma) или gauss(mu, sigma) | normal() | Пример из нормального распределения со средним значением mu и стандартным отклонением sigma |
Обратите внимание: NumPy специализируется на построении и обработке больших, многомерных массивов. Если вам нужно только одно значение, то random будет достаточно, к тому же, еще и быстрее. Для небольших последовательностей, random может быть еще быстрее, так как NumPy имеет ряд дополнительных расходов.
Мы рассмотрели две фундаментальные опции PRNG, так что теперь мы можем перейти к еще более безопасным адаптациям.
CSPRNG в Python
os.urandom(): настолько случайно, на сколько возможно
Функция Python под названием os.urandom() используется как в secrets, так и в uuid (мы к ним скоро придем). Чтобы не вдаваться в лишние подробности, os.urandom() генерирует зависимые от операционной системы случайные байты, которые спокойно можно назвать криптографически надежными:
- На операционных системах Unix, она считывает случайные байты из специального файла /dev/urandom, который за раз “открывает доступ к окружающим шумам, собранным из драйверов устройств и прочих ресурсов” (спасибо, Википедия). Это искаженная информация: частично о состоянии вашего оборудования и системы в определенный момент времени, и в тоже время, значительно случайные данные;
- Для Windows, используется функция C++ под названием CryptGenRandom(). Эта функция все еще технически псевдослучайная, но работает путем генерации значения сида из переменных, таких как ID процесса, состояние памяти, и так далее;
С os.urandom() нет такого понятия, как ручной сидинг. Хотя эта функция технически является псевдослучайной, она лучше подходит под наше понимание случайности. Единственный аргумент — это количество байтов в выдаче:
>>> os . urandom ( 3 )
b '\xa2\xe8\x02'
>>> x = os . urandom ( 6 )
b '\xce\x11\xe7"!\x84'
>>> type ( x ) , len ( x )
Перед тем как мы пойдем дальше, сейчас подходящее время для мини-урока о кодировке символов. Многие люди, как и я, имеют своего рода аллергическую реакцию, когда они видят объекты байтов и длинный ряд символов \x. Однако, будет полезным знать, как последовательности, такие как упомянутый x в итоге становятся строками и числами.
os.urandom() возвращает последовательность одиночных байтов:
b '\xce\x11\xe7"!\x84'
Но как это в итоге превращается в строку или последовательность чисел?
Сначала нужно обратиться к фундаментальным основам вычисления, которые заключаются в том, что байт состоит из 8 битов. Вы можете воспринимать бит как одинарную цифру, которая равна либо 1, либо 0.
Байт эффективно выбирает между 0 и 1 восемь раз, так что и 01101100, и 1111000 могут представлять байты. Попробуйте следующее, чтобы увидеть, как F-строки Python представлены в вашем интерпретаторе Python 3.6:
>>> binary = [ f '
>>> binary [ : 16 ]
Это эквивалент [bin(i) for i in range(256)] с определенным форматированием. bin() конвертирует целое число в его бинарное представление в качестве строки.
Что это нам дает? Использование диапазона (256) выше — это не случайный выбор. Учитывая, что мы можем использовать только 8 битов, каждый из которых имеет 2 варианта, значит мы имеем 2*8=256 возможных “комбинаций”.
Это значит, что каждый байт отображает целое число от 0 до 255. Другими словами, нам понадобится больше, чем 8 битов, чтобы выразить целое число 256. Вы можете подтвердить это, проверив, что len(f'8b>’) теперь 9, а не 8.
Хорошо, теперь вернемся к типу данных байтов, которые мы видели выше, построив последовательность битов, соответствующую числам от 0 до 255:
bites = bytes ( range ( 256 ) )
Если вы вызовите list(bites), вы вернетесь к списку Python, который работает от 0 до 255. Но если вы введете байты, вы получите страшно выглядящую последовательность, заваленную лишним мусором:
b '\x00\x01\x02\x03\x04\x05\x06\x07\x08\t\n\x0b\x0c\r\x0e\x0f\x10\x11\x12\x13\x14\x15'
'\x16\x17\x18\x19\x1a\x1b\x1c\x1d\x1e\x1f !"#$%&\'()*+,-./0123456789:;<=>?@ABCDEFGHIJK'
'LMNOPQRSTUVWXYZ[\\]^_`abcdefghijklmnopqrstuvwxyz<|>~\x7f\x80\x81\x82\x83\x84\x85\x86'
'\x87\x88\x89\x8a\x8b\x8c\x8d\x8e\x8f\x90\x91\x92\x93\x94\x95\x96\x97\x98\x99\x9a\x9b'
Эти бекслешы являются выходными последовательностями, а \xhh отображает символ с шестнадцатеричным значением hh. Некоторые элементы битов отображены буквально (печатные символы, такие как буквы, числа и знаки препинания). Большая части выражена проблеами. \x08 представляет клавишу backspace на клавиатуре, в то время как \x13 — возврат каретки (часть новой строки в системах Windows).
Если вы хотите переосмыслить шестнадцатеричный код, вот полезный комментарий Чарльза Петцольда: “Скрытый язык” — отличное место для этого. Hex — это основанная на нумерации из 16 чисел система, которая, вместо того, чтобы использовать от 0 до 9, использует от 0 до 9 и от «а» до «f» в качестве основных цифр.
Наконец, давайте вернемся к тому, где мы начинали, с последовательностью случайных байтов x. Надеюсь, так теперь будет понятнее. Вызов .hex() в байтовом объекте дает строку шестнадцатеричных чисел, каждое из которых соответствует десятичному числу от 0 до 255:
b '\xce\x11\xe7"!\x84'
[ 206 , 17 , 231 , 34 , 33 , 132 ]
'ce11e7222184'
>>> len ( x . hex ( ) )
Последний вопрос: каким образом b.hex() длиной 12 символов, если «х» длиной всего 6 байтов? Это связано с тем, что два шестнадцатеричных числа соответствуют одному байту. Str версия байтов всегда будет в два раза длиннее ожидаемого.
Даже если байт (такой, как \x01) не нуждается в полном наборе из 8 битов для отображения, b.hex() всегда будет использовать два числа на байт, так что номер 1 будет отображен как 01, а не просто 1. При этом математически, оба варианта получаются одинакового размера.
Техническая информация: то, что мы в основном рассмотрели здесь — это то, как объекты байтов становятся строками. Еще одна особенность заключается в том, как байты, создаваемые os.urandom(), конвертируются в десятичное число с интервалом [0.0, 1.0), как и в криптографически безопасной версии random.random(). Если вам интересно углубиться в данный вопрос, этот сниппет кода показывает, как int.from_bytes() делает начальное преобразование в целое число, используя систему с нумерацией 256.
Имея это ввиду, давайте рассмотрим предоставленный недавно модуль secrets, который делает генерацию токенов безопасности намного более удобным для пользователя.
Python умеет хранить секреты
Предоставленный одним из самых ярких PEP в Python 3.6, модуль secrets де-факто выполняет роль модуля для генерации криптографически безопасных случайных байтов и строк.
Вы можете проверить исходный код модуля, который является аккуратным и лаконичным примером 25 строк. Модуль secrets — это, по сути, обертка вокруг os.urandom(). Он экспортирует множество функций для генерации случайных чисел, байтов и строк. Большая часть этих примеров прекрасно рассказывают о себе сами:
>>> # Создание безопасных токенов
>>> secrets . token_bytes ( n )
b 'A\x8cz\xe1o\xf9!;\x8b\xf2\x80pJ\x8b\xd4\xd3'
>>> secrets . token_hex ( n )
'9cb190491e01230ec4239cae643f286f'
>>> secrets . token_urlsafe ( n )
'MJoi7CknFu3YN41m88SEgQ'
>>> # Безопасная версия для `random.choice()`
>>> secrets . choice ( 'rain' )
Что на счет конкретного примера? Вы (скорее всего) пользовались сервисами сокращения URL, такими как tinyurl или bit.ly, которые превращают длинный URL в что-нибудь вроде этого: https://bit.ly/2LwO8SH. Большинство сервисов сокращения не делают никакого сложного хеширования от ввода до вывода. Они просто генерируют случайную строку, и проверяют, чтобы она не была сгенерирована ранее, и связывают её с входящим URL-ом.
Предположим, что взглянув на Root Zone Database, вы зарегистрировали сайт short.ly. Вот функция, которая поможет начать работу с вашим сервисом:
from secrets import token_urlsafe
def shorten ( url : str , nbytes : int = 5 ) -> str :
ext = token_urlsafe ( nbytes = nbytes )
if ext in DATABASE :
return shorten ( url , nbytes = nbytes )
DATABASE . update ( < ext : url >)
return f ' short . ly / < ext >
Является ли это развернутым изображением? Нет. Ставлю на то, что bit.ly выполняет более сложную работу, чем просто хранить свою золотую шахту в глобальном словаре Python, который не является постоянным между сеансами. Однако, это достаточно точно:
. . . 'https://realpython.com/' ,
. . . 'https://docs.python.org/3/howto/regex.html'
>>> for u in urls :
. . . print ( shorten ( u ) )
short . ly / p_Z4fLI
short . ly / fuxSyNY
< 'p_Z4fLI' : 'https://realpython.com/' ,
'fuxSyNY' : 'https://docs.python.org/3/howto/regex.html' >
Погодите: Вы могли заметить одну вещь. Длина обеих результатов — 7, при том что мы запрашивали 5 байтов. Стоп, разве результат не должен быть в два раза длиннее, как и говорилось раньше? Не совсем, по крайней мере, для данного случая. Здесь происходит вот что: token_urlsafe() использует кодировку base64 , где каждый символ — это шесть битов данных. (Это от 0 до 63, плюс соответствующие символы: A-Z, a-z, 0-9, и +/.)
Если вы изначально определяете точное число байтов как nbytes, итоговая длина из secrets.token_urlsafe(nbytes) будет th.ceil(nbytes * 8 / 6), что можно доказать и исследовать, если вам любопытно.
В итоге мы имеем то, что хотя secrets — это, по сути своей, просто обертка вокруг существующих функций Python, это может пригодиться в случае, если безопасность для вас является ключевым параметром.
Последний кандидат: uuid
Последний вариант для генерации случайных токенов — это функция uuid4() из модуля uuid Python. UUID значит Universally Unique IDentifier (универсальный уникальный идентификатор), 128-битная последовательность (строка длина которой 32), разработанная для “гарантирования уникальности в пространстве и времени”. uuid4() — это одна из самых полезных функций модуля, и эта функция также использует os.urandom():
>>> import uuid
>>> uuid . uuid4 ( )
UUID ( '3e3ef28d-3ff0-4933-9bba-e5ee91ce0e7b' )
>>> uuid . uuid4 ( )
UUID ( '2e115fcb-5761-4fa1-8287-19f4ee2877ac' )
Приятно то, что все функции uuid предоставляют экземпляр класса UUID, который инкапсулирует ID и имеет такие свойства, как .int, .bytes, и .hex:
>>> tok = uuid . uuid4 ( )
>>> tok . bytes
b '.\xb7\x80\xfd\xbfIG\xb3\xae\x1d\xe3\x97\xee\xc5\xd5\x81'
>>> len ( tok . bytes )
>>> len ( tok . bytes ) * 8 # In bits
'2eb780fdbf4947b3ae1de397eec5d581'
62097294383572614195530565389543396737
Вы можете также столкнуться с другими вариациями: uuid1(), uuid3(), и uuid5(). Ключевая разница между ними и uuid4() в том, что эти три функции принимают ту или иную форму ввода и поэтому не соответствуют определению “случайные” в той мере, в которой делает четвертая версия UUID:
- uuid1() использует ID хост вашего компьютера в настоящее время по умолчанию. Ссылающаяся на настоящее время в наносекундном разрешении, это та версия, которая соответствует утверждению UUID “гарантированная уникальность во времени”.
- uuid3() и uuid5() принимают идентификатор пространства имен и название. Первый использует хеш MD5, второй использует SHA-1.
uuid4(), наоборот, является абсолютно псевдослучайным (или случайным). Функция являет собой использование 16 байтов для os.urandom(), конвертируя их в целое число и выполняет ряд поразрядных операций согласно формальной спецификации.
Надеюсь, теперь у вас есть более точное понимание различия между “типами” случайных данных и как они создаются. Однако, есть другая проблема, которая может возникнуть — это столкновения.
В нашем случае, столкновение может просто ссылаться к генерации двух соответствующих UUID. Каковы шансы того, что это произойдет? Технически, выше нуля, но достаточно близко к нему: существует 2*128 или 340 ундециллионов (10^36) возможных значений uuid4. Достаточно ли это низкие шансы чтобы спать крепко — решать вам.
Одно из главных применений uuid — это Django, имеющий поле UUIDField, которая часто используется как главный ключ в основной реляционной базе данных модуля.
Почему бы просто не использовать SystemRandom по умолчанию?
В дополнению к модулям конфиденциальности, упомянутым в данной статье (таким, как secrets), модуль Python под названием random имеет неприметный класс под названием SystemRandom, который использует os.urandom(). (SystemRandom, в свою очередь, также используется модулем secrets. Все это часть веб, которая возвращается обратно к urandom().)
На этом моменте, вы можете спросить себя, почему просто не использовать эту версию по умолчанию? Почему бы не “всегда быть в безопасности”, вместо того, чтобы пользоваться детерминистическими функциями, которые не являются до конца криптографически безопасными?
Я уже упоминал одну причину: иногда вам нужно, чтобы данные были детерминистическими и воспроизводимыми для других для возможности взаимодействия.
Вторая причина — это то, что CSPRNG (как минимум в Python) ведут себя критично медленнее, чем PRNG. Давайте проверим это со скриптом timed.py, который сравнивает версии randint() у PRNG и CSPRNG, используя timeit.repeat():