NULL-значения в PostgreSQL: правила и исключения
Навскидку многим кажется, что они знакомы с поведением NULL-значений в PostgreSQL, однако иногда неопределённые значения преподносят сюрпризы. Мы с коллегами написали статью на основе моего доклада с PGConf.Russia 2022 — он был полностью посвящён особенностям обработки NULL-значений в Postgres.
NULL простыми словами
Что такое SQL база данных? Согласно одному из определений, это просто набор взаимосвязанных таблиц. А что такое NULL? Обратимся к простому бытовому примеру: все мы задаём друг другу дежурный вопрос: «Как дела?». Часто мы получаем в ответ: «Да ничего. » Вот это «ничего» нам и нужно положить в базу данных — NULL: неопределённое, некорректное или неизвестное значение.

Допустим, вы суммируете две колонки, и в сотой по счёту записи наткнулись на NULL. Что тогда делать? Или возвращать ошибку, потому что так нельзя, или всё-таки как-то выполнить сложение и идти дальше. Сообщество решило в пользу второго варианта и закрепило это в стандартах языка SQL. Также договорились, что данные любого типа могут оказаться NULL, написали специальные функции и операции для обработки NULL-значений.
NULL может оказаться в столбце с любым типом данных и попасть на вход к любому оператору или функции. Соответственно, все операторы и функции как-то обрабатывают NULL, но результат обработки иногда оказывается неожиданным.
Какие значения не являются NULL?
Давайте теперь посмотрим, что не есть NULL. Ноль — это просто ноль, не NULL. Пустая строка — это пустая строка в Postgres, в отличие от Oracle. Пустой массив, пустой JSON, массив NULL-значений, пустой диапазон — это не NULL. Сложные типы, включающие NULL, уже не являются NULL.

Есть, правда, одно исключение: запись, собранная из NULL-значений, является NULL. Это сделано для совместимости со стандартом языка SQL. Однако, «под капотом» Postgres функции и операторы считают запись, состоящую из NULL-значений, NOT NULL. Ниже приведены результаты обработки такой записи для некоторых из них:
сount(row(NULL)) посчитает такую запись;
num_nulls(row(NULL)) выдаст ноль;
row(NULL) IS DISTINCT FROM NULL выдаст TRUE.
Ещё удивительнее пример с записями, содержащими NULL:
row(NULL::int, ‘Bob’::TEXT) IS NULL ожидаемо выдаст FALSE, но
row(NULL::int, ‘Bob’::TEXT) IS NOT NULL тоже выдаст FALSE!
Тем не менее, это поведение не является багом и описано в документации.
Операции с NULL
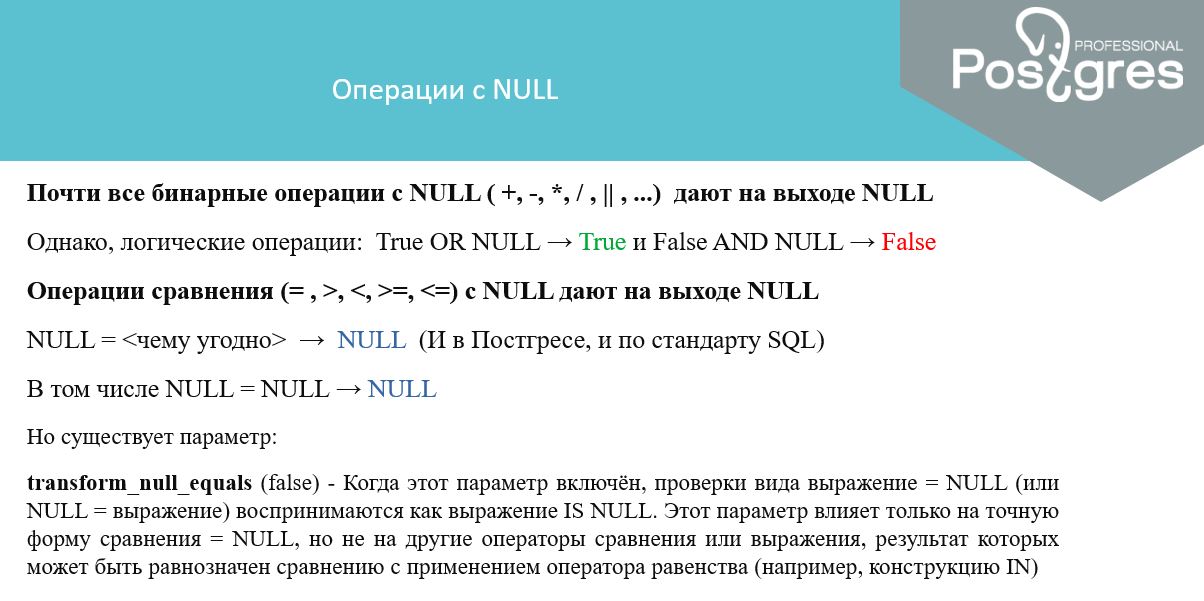
Почти все бинарные операции с NULL — сложить, вычесть, умножить, конкатенировать — дают на выходе NULL. С этим стоит быть осторожнее. Если вы к строке или к JSON конкатенируете что-то, оказавшееся NULL, то получаете на выходе NULL. А если вы ещё и сделали UPDATE в базу данных, выйдет совсем нехорошо.
Тем не менее, логическая операция TRUE OR NULL на выходе даёт TRUE. FALSE AND NULL даёт в результате FALSE. То есть существуют некоторые исключения из общего правила.
Операции сравнения
Операции сравнения — больше, меньше, больше или равно — c NULL на выходе дают NULL. При этом и сам NULL не равен самому себе. Впрочем, в PostgreSQL есть параметр transform_null_equals, который по умолчанию выключен. Если его включить, то NULL будет равен NULL.
Для проверки любого значения на NULL в Postgres предусмотрен специальный оператор — … IS NULL, . IS NOT NULL. Также может быть непривычно, что при сравнении булевых переменных с NULL или при применении оператора равенства помимо значений TRUE и FALSE возможно ещё и неизвестное значение. При этом оператор IS (NOT) UNKNOWN — это аналог IS (NOT) NULL для булевых переменных.
Операторы IS TRUE или IS FALSE для булевых переменных дают или TRUE, или FALSE. NULL в результате их применения получиться не может. Использование оператора IS TRUE позволяет писать более надёжный код, чем обычное сравнение = TRUE, которое может выдать не учтённое программистом NULL-значение и пойти «не туда».
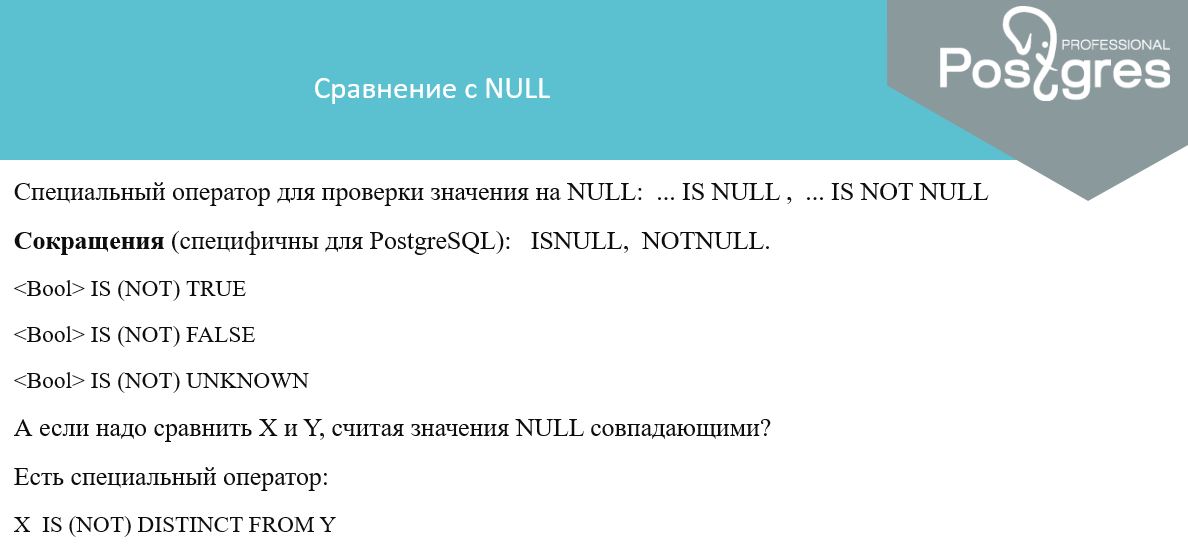
Что если нам нужно сравнить два значения X и Y, считая, что NULL-значения равны друг другу? Можно самому написать конструкцию из логических операторов, но существует уже готовый оператор X IS (NOT) DISTINCT FROM Y. Правда, планировщик PostgreSQL плохо понимает этот оператор и может выдавать долгие планы выполнения для запросов с ним.
Cпециальные функции для работы с NULL
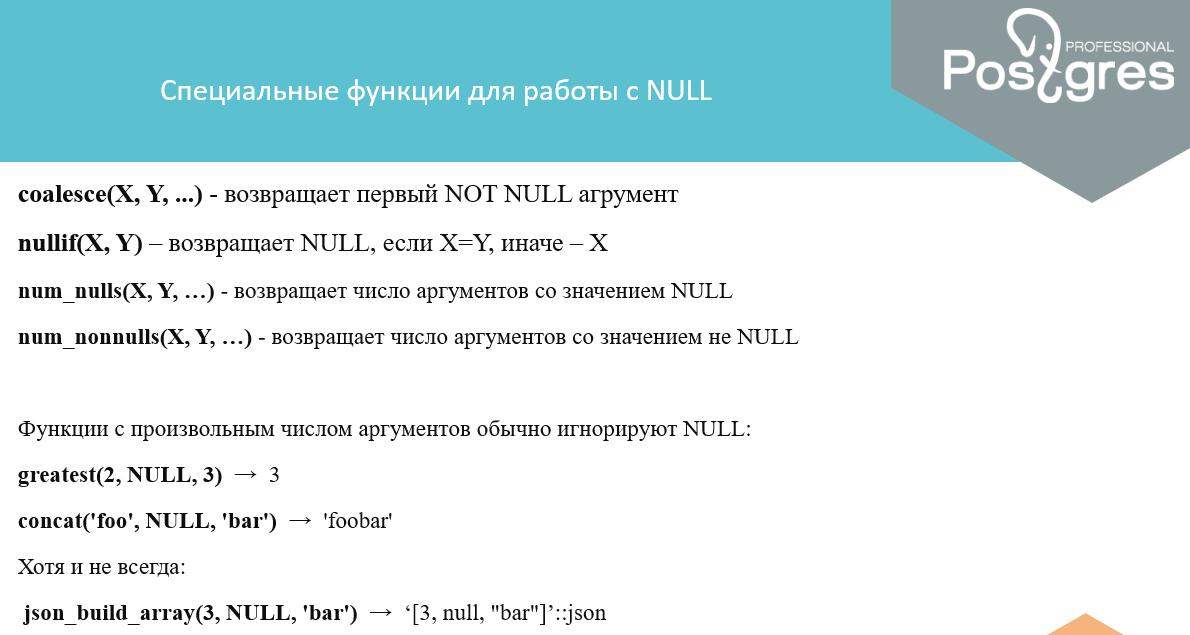
Обратимся к специальным функциям для работы с NULL. Всем известная coalesce возвращает первый NOT NULL аргумент. Есть nullif, есть num_nulls — этой функции можно дать сколько угодно аргументов, она посчитает количество NULL-значений. С помощью функции num_nonnulls можно посчитать NOT NULL значения.
Как правило, функции с произвольным числом аргументов игнорируют NULL. Такие функции, как greatest, concat его просто проигнорируют. При этом функция создания массивов включит NULL-значение во вновь образованный массив, за этим надо следить.
NULL и агрегатные функции
Что касается агрегатных функций, то array_agg, json_agg включают NULL в агрегат, а конкатенация строки не может вставить NULL-значение в середину строки, и поэтому она NULL игнорирует.
Статистические функции min, max, sum игнорируют NULL, а вот с выражением Count всё хитро. Count по конкретному полю посчитает только строки, где выражение NOT NULL, а вот Count со звёздочкой посчитает всё, включая NULL-значения.
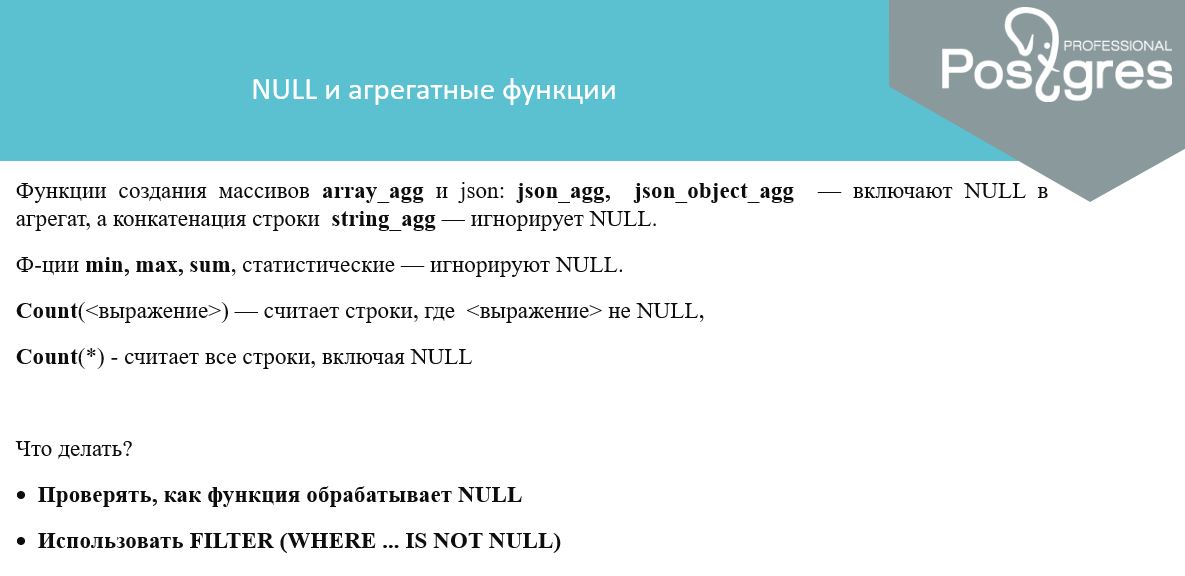
Что со всем этим делать? Можно почитать в справке или потестировать, как функция обрабатывает NULL-значения. А лучше использовать выражение FILTER и в явном виде исключить все NULL-значения.
NULL и пользовательские функции
Теперь о пользовательских функциях. При создании пользовательской функции по умолчанию включен режим CALLED ON NULL INPUT, то есть при наличии NULL среди аргументов функция вызовется и будет обрабатывать это значение. Если вам это не нужно, можно использовать RETURNS NULL ON NULL INPUT либо STRICT — в этом случае функция, обнаружив NULL хотя бы в одном аргументе, сразу возвращает NULL и дальше вообще не думает — для экономии времени.
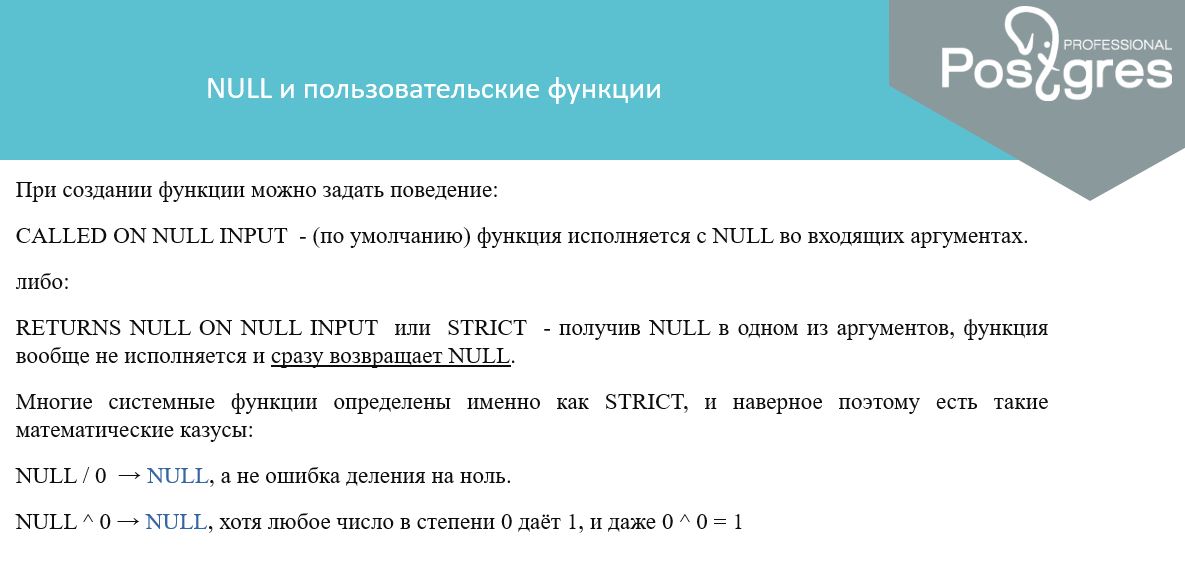
Многие системные функции в PostgreSQL определены именно как STRICT, поэтому стали возможны некоторые математические казусы. Например, NULL можно разделить на ноль, и в результате вы получите NULL — вместо ошибки деления на ноль. NULL в степени ноль тоже является NULL, хотя в математике любое число в нулевой степени, даже если это сам ноль, даёт единицу. Непонятно, правильно ли такое поведение с философской точки зрения, но вроде пока никто не жаловался.
Группировка и сортировка
Если говорить о группировке, то она считает все NULL-значения одинаковыми, так как это делает оператор IS NOT DISTINCT FROM. При сортировке есть специальные подвыражения, в которых можно указать NULLS FIRST или NULLS LAST. По умолчанию выбирается NULLS LAST, то есть считается, что неопределённые значения больше всех остальных чисел.
Сортировка работает так при создании выборки, индекса, в агрегатных функциях и оконных функциях.
NULL и записи
Когда мы формируем запись из нескольких значений, то сравниваются все NOT NULL значения. Если найдётся различие, то результат будет FALSE. Если все NOT NULL значения совпадают, и нашёлся NULL, то будет NULL.
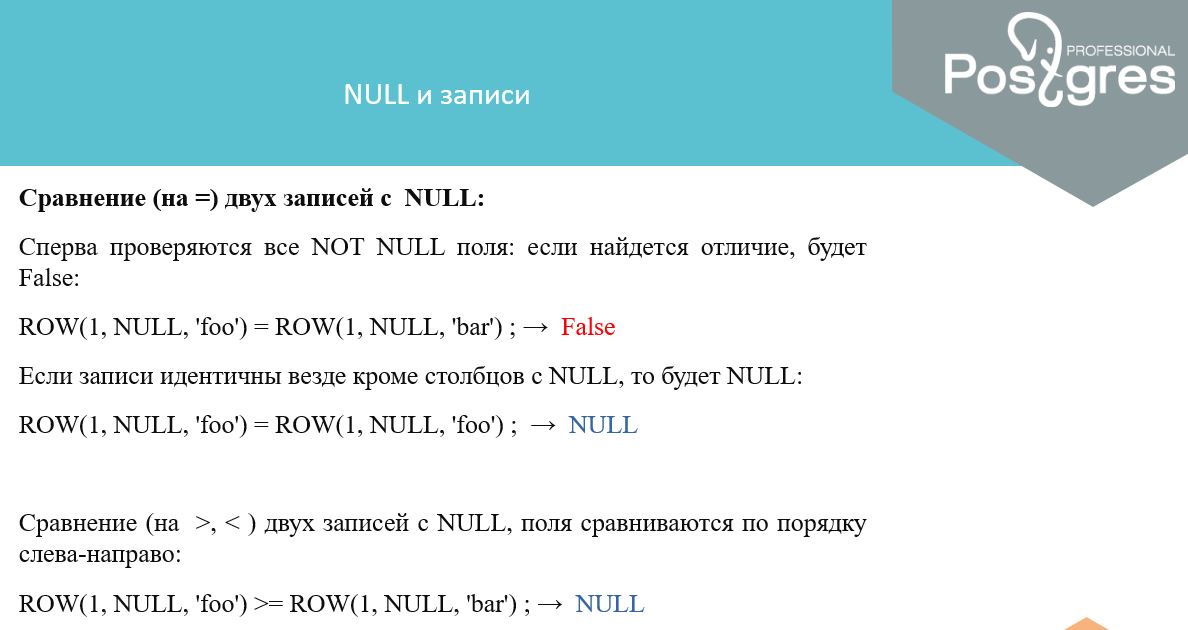
Сравнение на больше/меньше выполняется по другим правилам. Как только попадётся не совпадающее значение, тогда оно будет больше или меньше, а если обнаружится NULL, то будет NULL.
NULL и диапазоны
С бинарными операциями разобрались, но что если у нас тернарная операция? Например, SELECT NOW BETWEEN NULL AND NULL. Получится, ожидаемо, NULL.
Однако, точно такое же выражение, сформулированное через диапазоны, неожиданно даёт TRUE. Да, с точки зрения Postgres здесь и сейчас мы находимся в неопределённом промежутке времени!

Согласно стандарту SQL, все диапазонные типы — не только временные, а все вообще —воспринимают границу NULL как бесконечность.
Я полюбопытствовал и выяснил, что промежуток от минус бесконечности до плюс бесконечности входит в промежуток от NULL до NULL, а обратное — неверно.
Выходит, что NULL здесь даже несколько больше, чем бесконечность.
Также я попытался проверить, входит ли NULL в промежуток от минус бесконечности до плюс бесконечности. Оказалось, что это неизвестно. Это контринтуитивный для меня момент: мне казалось, что полный диапазон значений от минус до плюс бесконечности должен включать в себя любое значение, в том числе и неопределённое. Но нет, в PostgreSQL это не так.
Откуда в запросах появляются NULL-значения?
Во-первых, они попадают в базу данных при вставке или обновлении и продолжают храниться в столбцах таблиц.
Во-вторых, они записываются в базу как результат подзапроса не нашедшего ни одной строки — в этом случае подзапрос вернёт вам NULL.
В-третьих, NULL-значения могут появляться в результате операции объединения LEFT JOIN.
В-четвёртых, NULL-значения появлются как результат некоторых функций при некоторых условиях.
В-пятых, их можно создать вручную, например, при использовании конструкции CASE. В каком-то хитром запросе вы можете указать, что при определённых условиях получится неизвестное значение.

Структура базы данных и NULL
Во-первых, можно запретить хранение NULL-значений в столбце. Есть специальное ограничение (constraint) NOT NULL. Крайне рекомендую так и поступать — всегда запрещать хранение NULL-значений, если только вы не планируете хранить и обрабатывать NULL именно в этом столбце.
При определении ограничения (constraint) тоже есть одна особенность: если условие возвращает NULL, это считается допустимым, и такая запись может быть вставлена.
Например, ограничение Foreign key позволяет в дочерней таблице вставить запись со ссылкой, которая является NULL. Это будет допустимо.
Ограничение CHECK (price > 0) даст вам вставить в таблицу поле для Price со значением, равным NULL.
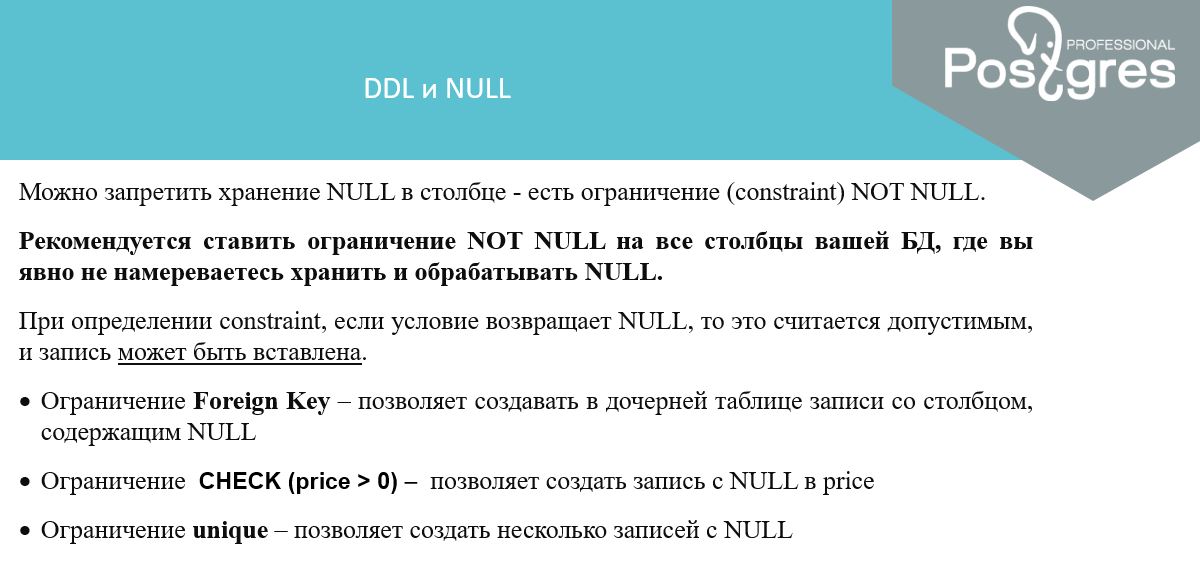
Ограничение unique позволяет создать несколько записей со значением NULL. Правда, в PostgreSQL 14 уже появилось специальное «заклинание», которое может запретить несколько записей с NULL.
Как NULL хранится внутри записи БД?
NULL вообще не хранится среди полей записи, но если там есть хотя бы одно NULL-значение, то создаётся битовая карта неопределённых значений, которая называется t_bits. Стоит запомнить, что самое первое NULL-значение влечёт за собой создание такой карты и расход некоторого количества места.

Правда, все дополнительные NULL-значения в этой записи вы уже храните бесплатно и достаточно компактно. Если вы действительно экономите каждый байт в своей базе данных, хранение NULL — правильное занятие.
NULL и индексы
Postgres хранит NULL-значения в btree-индексах. Этим он отличается от Oracle. Также Postgres может использовать такой индекс при поиске записей по NULL-значению.
Тем не менее, хранение NULL-значений в индексе для вас бесполезно, если у вас нет такого типа запросов (они довольно редки, и их можно проверить в представлении pg_stats_statements).
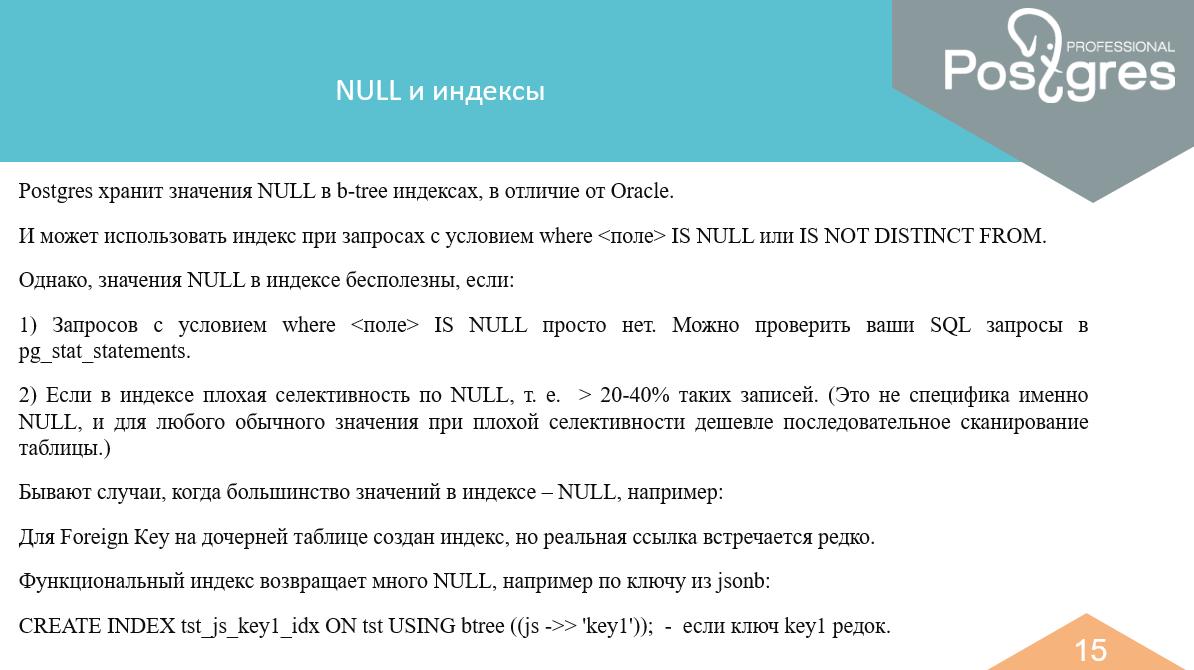
Также пользы не будет при большом количестве NULL-значений в индексе, и следовательно, плохой селективности. В этом случае будет дешевле сделать последовательное сканирование таблицы, а не возиться с индексом.
Вот пример случая с большим числом NULL-значений в таблице. У вас есть внешний ключ (foreign key) на какую-то родительскую таблицу, но реальная ссылка используется редко, и в основном в дочерней таблице NULL-значения.
Или же у вас может быть какой-то хитрый функциональный индекс, который часто возвращает NULL. Здесь у нас пример по JSONB-ключу key1, а если у вас в JSON этот ключ встречается нечасто, то и большинство значений будет NULL.
Если у вас NULL-значений много, то вам поможет перестроение индекса на частичный с условием WHERE IS NOT NULL. То есть мы просто выкидываем такие значения из нашего индекса. Это принесёт ряд улучшений:
- во-первых, сокращается размер индекса на дисках, в том числе на репликах и бэкапах;
- во-вторых, уменьшится количество записей в журнал предзаписи (WAL);
- в-третьих, освободится место в оперативной памяти и улучшится кэширование.
В моей практике были случаи, когда реально удавалось сократить размер индекса на порядок.
В поиске таких индексов поможет представление pg_stats. В нём есть поле null_frac, которое показывает долю NULL-значений в столбцах таблиц. То есть с помощью этого представления можно определить, есть ли у вас кандидаты на оптимизацию.
Сценарий аккуратного переезда вполне очевиден:
- создаёте новый частичный индекс;
- по представлению pg_stat_user_indexes убеждаетесь, что запросы переехали на новый индекс;
- удаляете старый индекс.
Выводы
- Значение NULL может преподнести некоторые сюрпризы, если вы к нему не готовы.
- Стоит проверить, как работают с NULL вызываемые вами функции и ваш код.
- Запрещайте NULL там, где вы не планируете его использовать явным образом.
- Проверяйте ваши индексы на наличие NULL-значений — возможно, за счёт оптимизаций удастся сэкономить некоторое количество памяти и ресурсов процессора.
Полезные ссылки
В статье Хаки Бенита рассматриваются как раз такие переполненные NULL-значениями индексы, есть SQL запрос для их поиска в вашей базе данных и практический результат перестроения.
Классическая статья Брюса Момжиана (Bruce Momjian) под названием «NULLs Make Things Easier?» доступна здесь.
Сравнение с NULL
Любое сравнение произвольного значения с NULL возвращает NULL (неопределенное значение):
denis=# select coalesce((1 <> null)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((1 = null)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((1 null)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((1 > null)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((null = null)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((null <> null)::varchar, ''); coalesce ---------- (1 row)
Поэтому выражения/переменные, которые могут принимать неопределенные значения, надо осторожно использовать в сравнениях. Если в выражении попадётся неопределенное значение, то результат всего выражения может быть очень неожиданным.
Использование неопределенного значения в сложном сравнении с использование булевых операторов AND, OR, NOT тоже не несет в себе какого-нибудь позитива — хотя и результаты логических операция не противоречат болевой логики, но их сложно анализировать разработчикам.
denis=# select coalesce((null or true)::varchar, ''); coalesce ---------- true (1 row) denis=# select coalesce((null and true)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((null and false)::varchar, ''); coalesce ---------- false (1 row) denis=# select coalesce((null or false)::varchar, ''); coalesce ---------- (1 row) denis=# select coalesce((not null)::varchar, ''); coalesce ---------- (1 row)
Для сравнения на равенство двух значение, которые могут принимать неопределенные значения, можно использовать конструкцию IS DISTINCT FROM, которая возвращает True, если значения отличаются друг от друга:
denis=# select coalesce((null is distinct from null)::varchar, ''); coalesce ---------- false (1 row) denis=# select coalesce((null is distinct from 1)::varchar, ''); coalesce ---------- true (1 row) denis=# select coalesce((1 is distinct from 1)::varchar, ''); coalesce ---------- false (1 row)
При использовании операторов is distinct from и is not distinct from в запросе индексы задействованы не будут.
denis=# explain select * from customers where id is not distinct from 222; QUERY PLAN ------------------------------------------------------------ Seq Scan on customers (cost=0.00..803.00 rows=1 width=17) Filter: (NOT (id IS DISTINCT FROM 222)) (2 rows)
denis=# explain select * from customers where id = 222; QUERY PLAN -------------------------------------------------------------------------------- Index Scan using customers_pkey on customers (cost=0.00..8.28 rows=1 width=17) Index Cond: (id = 222) (2 rows)
Это частично решает проблему сравнения неопределенных значений. Однако осталась проблема сравнений на больше-меньше. Это можно решить через функцию COALESCE:
denis=# select coalesce(1 null, false); coalesce ---------- f (1 row) denis=# select coalesce(2 > null, true); coalesce ---------- t (1 row)
При разработке разработке хранимых процедур на pl/pgsql вышеописанная проблема так же сохраняется, но не так остро. Хотя остаётся не менее коварной:
DECLARE _str text; _int int4; BEGIN _str := NULL; _int := NULL; IF _str <> '' THEN RAISE NOTICE 'str: True'; ELSE RAISE NOTICE 'str: False'; END IF; IF _int > 0 THEN RAISE NOTICE 'int: True'; ELSE RAISE NOTICE 'int: False'; END IF; IF NULL THEN RAISE NOTICE 'NULL: True'; ELSE RAISE NOTICE 'NULL: False'; END IF; RAISE NOTICE 'end'; END
NOTICE: str: False NOTICE: int: False NOTICE: NULL: False NOTICE: end
Неопределенное значение результата операции сравнения с NULL интерпретируется конструкцией IF NULL THEN ELSE END как False. Поэтому при простом сравнении переменной (которая может принимать NULL) с какой-либо константой можно проверки на NULL не делать:
IF _var IS NOT NULL AND _var > 0 THEN -- можно заменить на IF _var > 0 THEN IF _var IS NOT NULL AND _var = 'token' THEN -- можно за менить на IF _var = 'token' THEN .
В общем, будьте внимательны.
С помощью какой команды можно произвести автозамену null результата оконной функции в postgresql
Как посчитать всё на свете одним SQL-запросом. Оконные функции PostgreSQL

Я с удивлением обнаружил, что многие разработчики, даже давно использующие postgresql, не понимают оконные функции, считая их какой-то особой магией для избранных. Ну или в лучшем случае «копипастят» со StackOverflow выражения типа «row_number() OVER ()», не вдаваясь в детали. А ведь оконные функции — полезнейший функционал PostgreSQL.
Попробую по-простому объяснить, как можно их использовать.
Для начала хочу сразу пояснить, что оконные функции не изменяют выборку, а только добавляют некоторую дополнительную информацию о ней. Т.е. для простоты понимания можно считать, что postgres сначала выполняет весь запрос (кроме сортировки и limit), а потом только просчитывает оконные выражения.
Синтаксис примерно такой:
Окно — это некоторое выражение, описывающее набор строк, которые будет обрабатывать функция и порядок этой обработки.
Причем окно может быть просто задано пустыми скобками (), т.е. окном являются все строки результата запроса.
Например, в этом селекте к обычным полям id, header и score просто добавится нумерация строк.
В оконное выражение можно добавить ORDER BY, тогда можно изменить порядок обработки.
Обратите внимание, что я добавил еще и в конце всего запоса ORDER BY id, при этом рейтинг посчитан все равно верно. Т.е. посгрес просто отсортировал результат вместе с результатом работы оконной функции, один order ничуть не мешает другому.
Дальше — больше. В оконное выражение можно добавить слово PARTITION BY [expression],
например row_number() OVER (PARTITION BY section), тогда подсчет будет идти в каждой группе отдельно:
Если не указывать партицию, то партицией является весь запрос.
Тут сразу надо немного сказать о функциях, которые можно использовать, так как есть очень важный нюанс.
В качестве функции можно использовать, так сказать, истинные оконные функции из мануала — это row_number(), rank(), lead() и т.д., а можно использовать функции-агрегаты, такие как: sum(), count() и т.д. Так вот, это важно, агрегатные функции работают слегка по-другому: если не задан ORDER BY в окне, идет подсчет по всей партиции один раз, и результат пишется во все строки (одинаков для всех строк партиции). Если же ORDER BY задан, то подсчет в каждой строке идет от начала партиции до этой строки.
Давайте посмотрим это на примере. Например, у нас есть некая (сферическая в вакууме) таблица пополнений балансов.
и мы хотим узнать заодно, как менялся остаток на балансе при этом:
Т.е. для каждой строки идет подсчет в отдельном фрейме. В данном случае фрейм — это набор строк от начала до текущей строки (если было бы PARTITION BY, то от начала партиции).
Если же мы для агрегатной фунции sum не будем использовать ORDER BY в окне, тогда мы просто посчитаем общую сумму и покажем её во всех строках. Т.е. фреймом для каждой из строк будет весь набор строк
от начала до конца партиции.
Вот такая особенность агрегатных функций, если их использовать как оконные. На мой взгляд, это довольно-таки странный, интуитивно неочевидный момент SQL-стандарта.
Оконные функции можно использовать сразу по несколько штук, они друг другу ничуть не мешают, чтобы вы там в них не написали.
Если у вас много одинаковых выражений после OVER, то можно дать им имя и вынести отдельно с ключевым словом WINDOW, чтобы избежать дублирования кода. Вот пример из мануала:
Здесь w после слова OVER идет без уже скобок.
Результат работы оконной функции невозможно отфильтровать в запросе с помощью WHERE, потому что оконные фунции выполняются после всей фильтрации и группировки, т.е. с тем, что получилось. Поэтому чтобы выбрать, например, топ 5 новостей в каждой группе, надо использовать подзапрос:
Еще пример для закрепления. Помимо row_number() есть несколько других функций. Например lag, которая ищет строку перед последней строкой фрейма. К примеру мы можем найти насколько очков новость отстает от предыдущей в рейтинге:
Прошу в коментариях накидать примеров, где особенно удобно применять оконные фунции. А также, какие с ними могут возникнуть проблемы, если таковые имеются.
Подписывайтесь на подкаст о разработке «Цинковый прод», где мы обсуждаем базы данных, языки программирования и всё на свете!
PostgreSQL IGNORE NULLS в оконных функциях

Необходимо эмулировать Oracle IGNORE NULLS в оконных функциях (LEAD и LAG) в PostgreSQL.
Если есть NULL, он должен вернуть последнее ненулевое значение.
Я пробовал это через определенные пользователем агрегатные функции PostgreSQL, но довольно сложно понять методологию этого https://www.postgresql.org/docs/9.6/static/sql-createaggregate.html
Решение не может быть реализовано с помощью предложения WITH или подзапроса, поскольку оно используется в сложном запросе.
PostgreSQL: заполнить значения NULL в запросе временного ряда предыдущим значением
У меня есть база данных с информацией о времени. Я хочу список со значениями для каждой минуты. Вот так:
Но когда в течение нескольких минут не было данных, я получил такой результат:
Я хочу заполнить значение NULL предыдущим значением NOT NULL.
Этот запрос создает временную серию для каждой минуты. Затем он соединяет это с данными в моей базе данных.
Я прочитал кое-что о оконных функциях, чтобы заполнить значение NULL предыдущим значением NOT NULL, но я не могу понять, как реализовать это в этом запросе. Может ли кто-то подтолкнуть меня в правильном направлении?
Похожие публикации:
- Почему не грузится дискорд черный экран
- Почему не публикуются отзывы на яндекс картах
- Почему не работает формула сцепить в эксель
- Почему невозможно подписаться на яндекс музыку
Учимся применять оконные функции

Оконные функции — это мощнейший инструмент аналитика, который с легкостью помогает решать множество задач.
Если вам нужно произвести вычисление над заданным набором строк, объединенных каким-то одним признаком, например идентификатором клиента, вам на помощь придут именно они.
Можно сравнить их с агрегатными функциями, но, в отличие от обычной агрегатной функции, при использовании оконной функции несколько строк не группируются в одну, а продолжают существовать отдельно. При этом результаты работы оконных функций просто добавляются к результирующей выборке как еще одно поле. Этот функционал очень полезен для построения аналитических отчетов, расчета скользящего среднего и нарастающих итогов, а также для расчетов различных моделей атрибуции.
Принцип работы
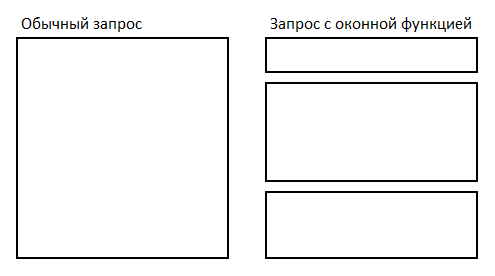
У вас может возникнуть вопрос – «Что значит оконные?»
При обычном запросе, все множество строк обрабатывается как бы единым «цельным куском», для которого считаются агрегаты. А при использовании оконных функций, запрос делится на части (окна) и уже для каждой из отдельных частей считаются свои агрегаты.
Синтаксис
Окно определяется с помощью обязательной инструкции OVER(). Давайте рассмотрим синтаксис этой инструкции:
SELECT Название функции (столбец для вычислений) OVER ( PARTITION BY столбец для группировки ORDER BY столбец для сортировки ROWS или RANGE выражение для ограничения строк в пределах группы )
Теперь разберем как поведет себя множество строк при использовании того или иного ключевого слова функции. А тренироваться будем на простой табличке содержащей дату, канал с которого пришел пользователь и количество конверсий:

OVER()
Откроем окно при помощи OVER() и просуммируем столбец «Conversions»:
SELECT Date , Medium , Conversions , SUM(Conversions) OVER() AS 'Sum' FROM Orders

Мы использовали инструкцию OVER() без предложений. В таком варианте окном будет весь набор данных и никакая сортировка не применяется. Появился новый столбец «Sum» и для каждой строки выводится одно и то же значение 14. Это сквозная сумма всех значений колонки «Conversions».
PARTITION BY
Теперь применим инструкцию PARTITION BY, которая определяет столбец, по которому будет производиться группировка и является ключевой в разделении набора строк на окна:
SELECT Date , Medium , Conversions , SUM(Conversions) OVER(PARTITION BY Date) AS 'Sum' FROM Orders

Инструкция PARTITION BY сгруппировала строки по полю «Date». Теперь для каждой группы рассчитывается своя сумма значений столбца «Conversions».
ORDER BY
Попробуем отсортировать значения внутри окна при помощи ORDER BY:
SELECT Date , Medium , Conversions , SUM(Conversions) OVER(PARTITION BY Date ORDER BY Medium) AS 'Sum' FROM Orders
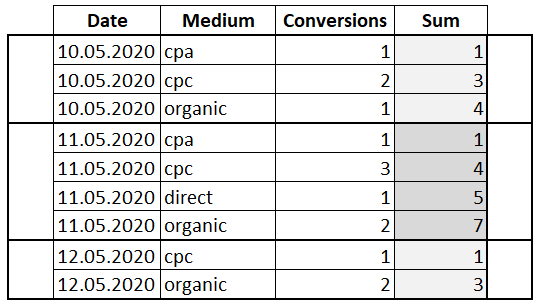
К предложению PARTITION BY добавилось ORDER BY по полю «Medium». Таким образом мы указали, что хотим видеть сумму не всех значений в окне, а для каждого значения «Conversions» сумму со всеми предыдущими. То есть мы посчитали нарастающий итог.
ROWS или RANGE
Инструкция ROWS позволяет ограничить строки в окне, указывая фиксированное количество строк, предшествующих или следующих за текущей.
Инструкция RANGE, в отличие от ROWS, работает не со строками, а с диапазоном строк в инструкции ORDER BY. То есть под одной строкой для RANGE могут пониматься несколько физических строк одинаковых по рангу.
Обе инструкции ROWS и RANGE всегда используются вместе с ORDER BY.
В выражении для ограничения строк ROWS или RANGE также можно использовать следующие ключевые слова:
- UNBOUNDED PRECEDING — указывает, что окно начинается с первой строки группы;
- UNBOUNDED FOLLOWING – с помощью данной инструкции можно указать, что окно заканчивается на последней строке группы;
- CURRENT ROW – инструкция указывает, что окно начинается или заканчивается на текущей строке;
- BETWEEN«граница окна» AND «граница окна» — указывает нижнюю и верхнюю границу окна;
- «Значение»PRECEDING – определяет число строк перед текущей строкой (не допускается в предложении RANGE).;
- «Значение»FOLLOWING — определяет число строк после текущей строки (не допускается в предложении RANGE).
Разберем на примере:
SELECT Date , Medium , Conversions , SUM(Conversions) OVER(PARTITION BY Date ORDER BY Conversions ROWS BETWEEN CURRENT ROW AND 1 FOLLOWING) AS 'Sum' FROM Orders
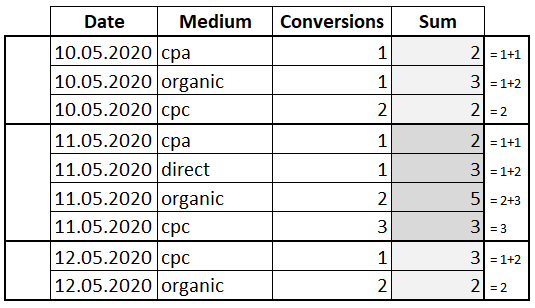
В данном случае сумма рассчитывается по текущей и следующей ячейке в окне. А последняя строка в окне имеет то же значение, что и столбец «Conversions», потому что больше не с чем складывать.
Комбинируя ключевые слова, вы можете подогнать диапазон работы оконной функции под вашу специфическую задачу.
Виды функций
Оконные функции можно подразделить на следующие группы:
- Агрегатные функции;
- Ранжирующие функции;
- Функции смещения;
- Аналитические функции.
В одной инструкции SELECT с одним предложением FROM можно использовать сразу несколько оконных функций. Давайте подробно разберем каждую группу и пройдемся по основным функциям.
Агрегатные функции
Агрегатные функции – это функции, которые выполняют на наборе данных арифметические вычисления и возвращают итоговое значение.
- SUM – возвращает сумму значений в столбце;
- COUNT — вычисляет количество значений в столбце (значения NULL не учитываются);
- AVG — определяет среднее значение в столбце;
- MAX — определяет максимальное значение в столбце;
- MIN — определяет минимальное значение в столбце.
Пример использования агрегатных функций с оконной инструкцией OVER:
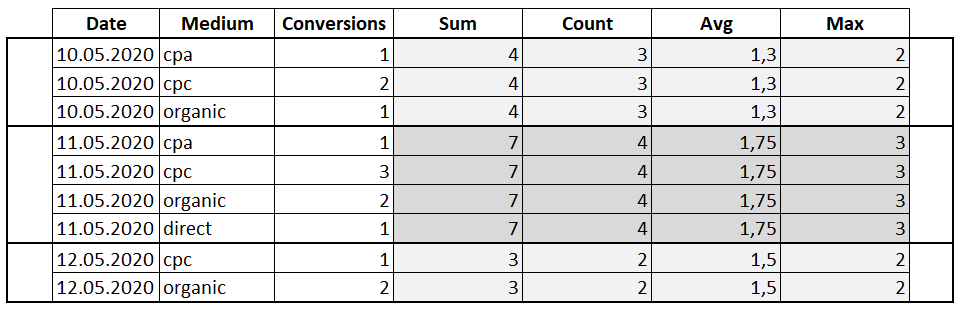
SELECT Date , Medium , Conversions , SUM(Conversions) OVER(PARTITION BY Date) AS 'Sum' , COUNT(Conversions) OVER(PARTITION BY Date) AS 'Count' , AVG(Conversions) OVER(PARTITION BY Date) AS 'Avg' , MAX(Conversions) OVER(PARTITION BY Date) AS 'Max' , MIN(Conversions) OVER(PARTITION BY Date) AS 'Min' FROM Orders
Ранжирующие функции
Ранжирующие функции – это функции, которые ранжируют значение для каждой строки в окне. Например, их можно использовать для того, чтобы присвоить порядковый номер строке или составить рейтинг.
- ROW_NUMBER – функция возвращает номер строки и используется для нумерации;
- RANK — функция возвращает ранг каждой строки. В данном случае значения уже анализируются и, в случае нахождения одинаковых, возвращает одинаковый ранг с пропуском следующего значения;
- DENSE_RANK — функция возвращает ранг каждой строки. Но в отличие от функции RANK, она для одинаковых значений возвращает ранг, не пропуская следующий;
- NTILE – это функция, которая позволяет определить к какой группе относится текущая строка. Количество групп задается в скобках.
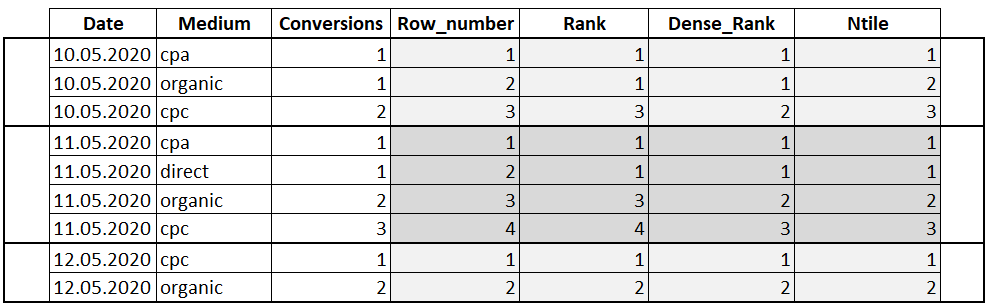
SELECT Date , Medium , Conversions , ROW_NUMBER() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Row_number' , RANK() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Rank' , DENSE_RANK() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Dense_Rank' , NTILE(3) OVER(PARTITION BY Date ORDER BY Conversions) AS 'Ntile' FROM Orders
Функции смещения
Функции смещения – это функции, которые позволяют перемещаться и обращаться к разным строкам в окне, относительно текущей строки, а также обращаться к значениям в начале или в конце окна.
- LAG илиLEAD – функция LAG обращается к данным из предыдущей строки окна, а LEAD к данным из следующей строки. Функцию можно использовать для того, чтобы сравнивать текущее значение строки с предыдущим или следующим. Имеет три параметра: столбец, значение которого необходимо вернуть, количество строк для смещения (по умолчанию 1), значение, которое необходимо вернуть если после смещения возвращается значение NULL;
- FIRST_VALUE или LAST_VALUE — с помощью функции можно получить первое и последнее значение в окне. В качестве параметра принимает столбец, значение которого необходимо вернуть.
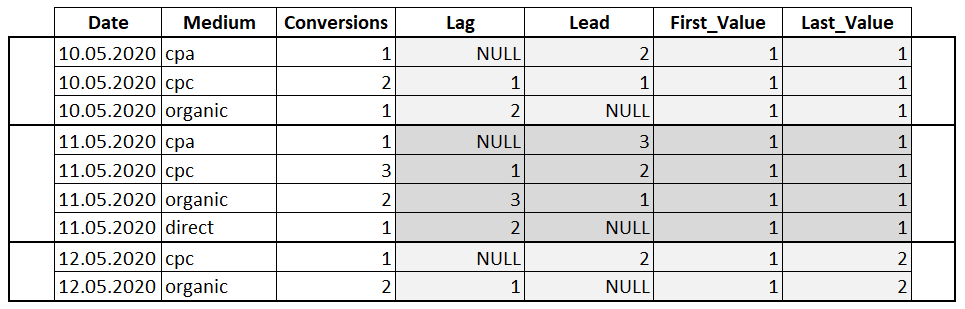
SELECT Date , Medium , Conversions , LAG(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'Lag' , LEAD(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'Lead' , FIRST_VALUE(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'First_Value' , LAST_VALUE(Conversions) OVER(PARTITION BY Date ORDER BY Date) AS 'Last_Value' FROM Orders
Аналитические функции
Аналитические функции — это функции которые возвращают информацию о распределении данных и используются для статистического анализа.
- CUME_DIST — вычисляет интегральное распределение (относительное положение) значений в окне;
- PERCENT_RANK — вычисляет относительный ранг строки в окне;
- PERCENTILE_CONT — вычисляет процентиль на основе постоянного распределения значения столбца. В качестве параметра принимает процентиль, который необходимо вычислить (в этой статье я рассказываю как посчитать медиану, благодаря этой функции);
- PERCENTILE_DISC — вычисляет определенный процентиль для отсортированных значений в наборе данных. В качестве параметра принимает процентиль, который необходимо вычислить.
Важно! У функций PERCENTILE_CONT и PERCENTILE_DISC, столбец, по которому будет происходить сортировка, указывается с помощью ключевого слова WITHIN GROUP.
SELECT Date , Medium , Conversions , CUME_DIST() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Cume_Dist' , PERCENT_RANK() OVER(PARTITION BY Date ORDER BY Conversions) AS 'Percent_Rank' , PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY Conversions) OVER(PARTITION BY Date) AS 'Percentile_Cont' , PERCENTILE_DISC(0.5) WITHIN GROUP (ORDER BY Conversions) OVER(PARTITION BY Date) AS 'Percentile_Disc' FROM Orders

Кейс. Модели атрибуции
Благодаря модели атрибуции можно обоснованно оценить вклад каждого канала в достижение конверсии. Давайте попробуем посчитать две разных модели атрибуции с помощью оконных функций.
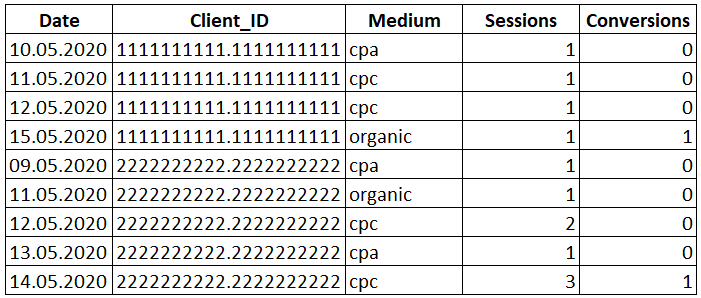
У нас есть таблица с id посетителя (им может быть Client ID, номер телефона и тп.), датами и количеством посещений сайта, а также с информацией о достигнутых конверсиях.
Первый клик
В Google Analytics стандартной моделью атрибуции является последний непрямой клик. И в данном случае 100% ценности конверсии присваивается последнему каналу в цепочке взаимодействий.
Попробуем посчитать модель по первому взаимодействию, когда 100% ценности конверсии присваивается первому каналу в цепочке при помощи функции FIRST_VALUE.
SELECT Date , Client_ID , Medium , FIRST_VALUE(Medium) OVER(PARTITION BY Client_ID ORDER BY Date) AS 'First_Click' , Sessions , Conversions FROM Orders
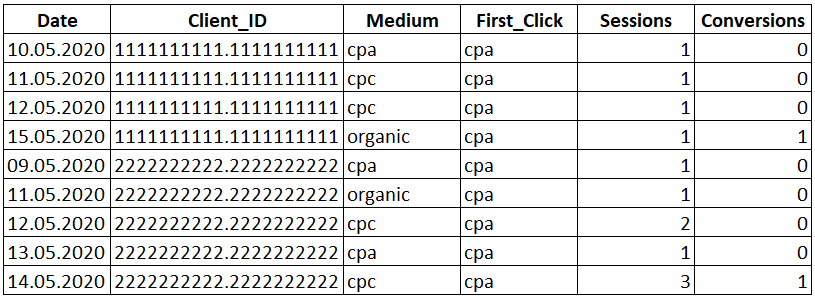
Рядом со столбцом «Medium» появился новый столбец «First_Click», в котором указан канал в первый раз приведший посетителя к нам на сайт и вся ценность зачтена данному каналу.
Произведем агрегацию и получим отчет.
WITH First AS ( SELECT Date , Client_ID , Medium , FIRST_VALUE(Medium) OVER(PARTITION BY Client_ID ORDER BY Date) AS 'First_Click' , Sessions , Conversions FROM Orders ) SELECT First_Click , SUM(Conversions) AS 'Conversions' FROM First GROUP BY First_Click

С учетом давности взаимодействий
В этом случае работает правило: чем ближе к конверсии находится точка взаимодействия, тем более ценной она считается. Попробуем рассчитать эту модель при помощи функции DENSE_RANK.
SELECT Date , Client_ID , Medium -- Присваиваем ранг в зависимости от близости к дате конверсии , DENSE_RANK() OVER(PARTITION BY Client_ID ORDER BY Date) AS 'Ranks' , Sessions , Conversions FROM Orders
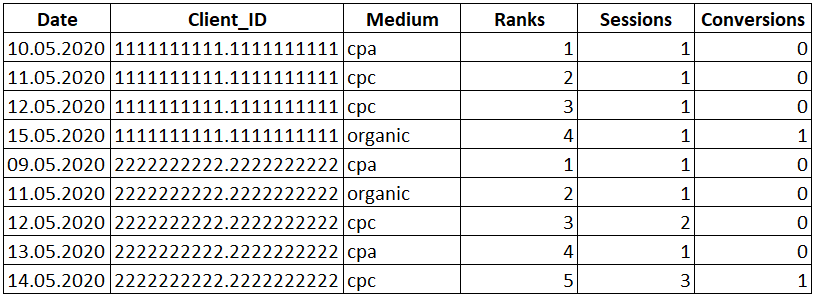
Рядом со столбцом «Medium» появился новый столбец «Ranks», в котором указан ранг каждой строки в зависимости от близости к дате конверсии.
Теперь используем этот запрос для того, чтобы распределить ценность равную 1 (100%) по всем точкам на пути к конверсии.
SELECT Date , Client_ID , Medium -- Делим ранг определенной строки на сумму рангов по пользователю , ROUND(CAST(DENSE_RANK() OVER(PARTITION BY Client_ID ORDER BY Date) AS FLOAT) / CAST(SUM(ranks) OVER(PARTITION BY Client_ID) AS FLOAT), 2) AS 'Time_Decay' , Sessions , Conversions FROM ( SELECT Date , Client_ID , Medium -- Присваиваем ранг в зависимости от близости к дате конверсии , DENSE_RANK() OVER(PARTITION BY Client_ID ORDER BY Date) AS 'Ranks' , Sessions , Conversions FROM Orders ) rank_table

Рядом со столбцом «Medium» появился новый столбец «Time_Decay» с распределенной ценностью.
И теперь, если сделать агрегацию, можно увидеть как распределилась ценность по каналам.
WITH Ranks AS ( SELECT Date , Client_ID , Medium -- Делим ранг определенной строки на сумму рангов по пользователю , ROUND(CAST(DENSE_RANK() OVER(PARTITION BY Client_ID ORDER BY Date) AS FLOAT) / CAST(SUM(ranks) OVER(PARTITION BY Client_ID) AS FLOAT), 2) AS 'Time_Decay' , Sessions , Conversions FROM ( SELECT Date , Client_ID , Medium -- Присваиваем ранг в зависимости от близости к дате конверсии , DENSE_RANK() OVER(PARTITION BY Client_ID ORDER BY Date) AS 'Ranks' , Sessions , Conversions FROM Orders ) rank_table ) SELECT Medium , SUM(Time_Decay) AS 'Value' , SUM(Conversions) AS 'Conversions' FROM Ranks GROUP BY Medium ORDER BY Value DESC
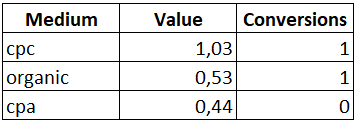
Из получившегося отчета видно, что самым весомым каналом является канал «cpc», а канал «cpa», который был бы исключен при применении стандартной модели атрибуции, тоже получил свою долю при распределении ценности.
Полезные ссылки:
- SELECT — предложение OVER (Transact-SQL)
- Как работать с оконными функциями в Google BigQuery — подробное руководство
- Модель атрибуции на основе онлайн/офлайн данных в Google BigQuery