Методы распознавания текстов
Несмотря на то, что в настоящее время большинство документов составляется на компьютерах, задача создания полностью электронного документооборота ещё далека до полной реализации. Как правило, существующие системы охватывают деятельность отдельных организаций, а обмен данными между организациями осуществляется с помощью традиционных бумажных документов.
Задача перевода информации с бумажных на электронные носители актуальна не только в рамках потребностей, возникающих в системах документооборота. Современные информационные технологии позволяют нам существенно упростить доступ к информационным ресурсам, накопленным человечеством, при условии, что они будут переведены в электронный вид.
Наиболее простым и быстрым является сканирование документов с помощью сканеров. Результат работы является цифровое изображение документа – графический файл. Более предпочтительным, по сравнению с графическим, является текстовое представление информации. Этот вариант позволяет существенно сократить затраты на хранение и передачу информации, а также позволяет реализовать все возможные сценарии использования и анализа электронных документов. Поэтому наибольший интерес с практической точки зрения представляет именно перевод бумажных носителей в текстовый электронный документ.
На вход системы распознавания поступает растровое изображение страницы документа. Для работы алгоритмов распознавания желательно, чтобы поступающее на вход изображение было как можно более высокого качества. Если изображение зашумлено, нерезко, имеет низкую контрастность, то это усложнит задачу алгоритмов распознавания.
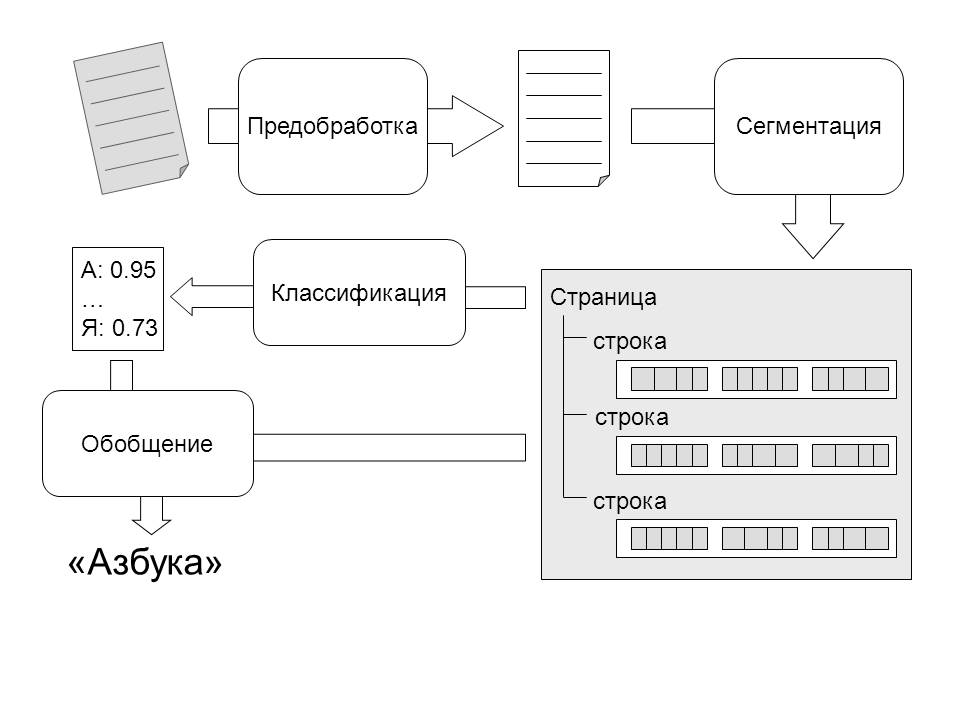
Поэтому перед обработкой изображения алгоритмами распознавания проводится его предварительная обработка, направленная на улучшение качества изображения. Она включает фильтрацию изображения от шумов, повышение резкости и контрастности изображения, выравнивание и преобразование в используемый системой формат (в нашем случае 8-битное изображение в градациях серого).
Подготовленное изображение попадает на вход модуля сегментации. Задачей этого модуля является выявление структурных единиц текста – строк, слов и символов. Выделение фрагментов высоких уровней, таких как строки и слова, может быть осуществлено на основе анализа промежутков между тёмными областями.
К сожалению, такой подход не может быть применён для выделения отдельных букв, поскольку, в силу особенностей начертания или искажений, изображения соседних букв могут объединяться в одну компоненту связанности (рис. 1) или наоборот — изображение одной буквы может распадаться на отдельные компоненты связанности (рис. 2). Во многих случаях для решения задачи сегментации на уровне букв используются сложные эвристические алгоритмы.

Рисунок 1. Объединение нескольких букв в одну компоненту связанности.

Рисунок 2. Распадение изображений букв на несвязанные компоненты вследствие низкого качества сканирования.
Полагаем, что для принятия окончательного решения о прохождении границы букв на таком раннем этапе обработки, системе распознавания недостаточно информации. Поэтому задачей модуля сегментации на уровне букв в разработанном алгоритме является нахождение возможных границ символов внутри буквы, а окончательное решение о разбиении слова принимается на последнем этапе обработки, с учётом идентификации отдельных фрагментов изображения как букв. Дополнительным преимуществом такого подхода является возможность работы с начертаниями букв, состоящих из нескольких компонент связанности без специальной обработки таких случаев.
Результатом работы модуля сегментации является дерево сегментации – структура данных, организация которой отражает структуру текста на странице. Самому верхнему уровню соответствует объект страница. Он содержит массив объектов, описывающих строки. Каждая строка в свою очередь включает набор объектов слов. Слова являются листьями этого дерева. Информация о возможных местах разделения слова на буквы храниться в слове, однако отдельные объекты для букв не выделяются. В каждом объекте дерева хранится информация об области, занимаемой соответствующим объектом на изображении. Данная структура легко может быть расширена для поддержки других уровней разбиения, например колонок, таблиц.
Выявленные фрагменты изображения подаются на вход классификатора, выходом которого является вектор возможности принадлежности изображения к классу той или иной буквы. В разработанном алгоритме используется классификатор составной архитектуры, организованный в виде дерева, листьями которого являются простые классификаторы, а внутренние узлы соответствуют операциям комбинирования результатов низлежащих уровней (рис. 3).

Рисунок 3. Архитектура классификатора.
Работа простого классификатора осуществляется в два шага (рис. 4). Сначала по исходному изображению вычисляются признаки. Значение каждого признака является функцией от яркостей некоторого подмножества пикселей изображения. В результате получается вектор значений признаков, который поступает на вход нейронной сети. Каждый выход сети соответствует одной из букв алфавита, а получаемое на выходе значение рассматривается как уровень принадлежности буквы нечёткому множеству.

Рисунок 4. Простой классификатор.
Задачей алгоритма комбинирования является обобщение информации, поступающей в виде входных нечётких множеств и вычисление на их основе выходного нечёткого подмножества множества распознаваемых символов. В качестве алгоритмов комбинирования используются операции теории нечётких множеств (такие как t-нормы и s-нормы), выбор наиболее уверенного эксперта.
Результатом работы классификатора является нечёткое множество, полученное в результате комбинирования на самом верхнем уровне.
На последнем этапе принимается решение о наиболее правдоподобном варианте прочтения слова. Для этого используются уровни возможности прочтения отдельных букв, межбуквенной сегментации и частоты сочетаний букв в русском языке.
Для оценки эффективности разработанного алгоритма было проведено сравнение с двумя существующими системами OCR. Это бесплатная open-source система CuneiForm v12 и коммерческая система ABBYY FineReader 10 Professional Edition.
К сожалению, для оценки эффективности работы систем распознавания, обычно используются наборы символов, подготовленных иностранными специалистами, либо наборы, собранные авторами и не опубликованные в открытом доступе. Так, например, оценивая эффективность работы алгоритмов ABBYY FineReader автор использовал базы данных CEDAR, NIST, CENPARMI а также сканированные анкеты ЕГЭ. Поскольку данные базы содержат английские и/или рукописные символы, они не могут быть использованы для оценки эффективности выполнения НИР по теме «разработка алгоритма распознавания печатных кириллических символов».
Сравнение производилось на образцах с разрешением 96 dpi и 180 dpi. В сравнении участвовал текст, состоящий из 300 слов, набранных шрифтами Arial 14pt и Times New Roman 14pt. Текст разрешением 96 dpi был создан на компьютере непосредственно в виде графического файла. Для теста с разрешением 180 dpi текст был распечатан на лазерном принтере, а затем сканирован с указанным разрешением. Фрагмент использованного текста приведен на рис. 5.

Рисунок 5. Фрагмент текста, использованного для тестирования систем распознавания.
Результаты сравнения для 96 dpi представлены в таблице 1.

Таблица 1. Результаты распознавания текста разрешением 96 dpi.
Результаты сравнения для текста с разрешением 180 dpi представлены в таблице 2.

Таблица 2. Результаты распознавания текста разрешением 180 dpi.
Лучшие результаты распознавания для 96 dpi можно объяснить тем, что текущая конфигурация системы была обучена на шрифтах Times New Roman 14pt и Arial 14pt при разрешающей способности 96 dpi. Можно ожидать улучшения результатов для этого текста при добавлении в систему простых классификаторов, обученных распознавать шрифты такого размера.
Суммарно, из 1200 слов было распознано:
• разработанным алгоритмом: 1180 слов (98,33%);
• системой с открытыми кодами CuneiForm: 597 слов (49,75%);
• коммерческой системой ABBYY FineReader: 1200 слов (100%).
Стоит отметить, что при низком разрешении, наличии большого числа шума Cuneiform не справляется с распознаванием текста, в то время как предложенный алгоритм распознает текст в таком качестве.
В целом, можно заключить, что хотя предложенный алгоритм уступает лучшему в данном классе коммерческому продукту фирмы Abbyy, он способен распознавать текст худшего качества, чем способна распознать система c открытыми исходными кодами CuneiForm.
Список использованной литературы.
Квасников В.П., Дзюбаненко А.В. Улучшение визуального качества цифрового изображения путем поэлементного преобразования // Авиационно-космическая техника и технология 2009 г., 8, стр. 200-204
Арлазаров В.Л., Куратов П.А., Славин О.А. Распознавание строк печатных текстов // Сб. трудов ИСА РАН «Методы и средства работы с документами». — М.: Эдиториал УРСС, 2000. — С. 31-51.
Проект СПбГУ Открытый код: распознавание текстовых изображений [Электронный ресурс] — Режим доступа: ocr.apmath.spbu.ru
Багрова И. А., Грицай А. А., Сорокин С. В., Пономарев С. А., Сытник Д. А. Выбор признаков для распознавания печатных кириллических символов // Вестник Тверского Государственного Университета 2010 г., 28, стр. 59-73
The concept of a linguistic variable and its application to approximate reasoning, Information Sciences, 8, 199-249; 9, 43-80.
Melin P., Urias J., Solano D., Soto M., Lopez M., Castillo O., Voice Recognition with Neural Networks, Type-2 Fuzzy Logic and Genetic Algorithms. Engineering Letters, 13:2, 2006.
Панфилов С. А. Методы и программный комплекс моделирования алгоритмов управления нелинейными динамическими системами на основе мягких вычислений. Диссертация на соискание ученой степени кандидата технических наук. Тверь, 2005.
- нейронные сети
- OCR
- распознавание текстов
Распознавание текстов очень важная задача которая возникает
Государственная публичная научно-техническая библиотека СО РАН
Г.Б. Паршукова
Научная работа библиотекарей на персональном компьютере
Глава 18 Система распознавания текста FineReader
Система распознавания � одна из наиболее перспективных областей применения искусственного интеллекта. Существует решение, максимально приближенное к человеческой способности читать: оно построено на принципах, сформулированных в результате наблюдений за поведением животных и человека. Это технология целостного, целенаправленного и адаптивного восприятия.
Процесс обработки FineReader осуществляется в несколько этапов:
2. Выделение блоков на изображении.
Затем нужно проверить ошибки и сохранить результат распознавания (передать его в другое приложение, например в текстовый редактор WORD , в Буфер и т.п.).
FineReader � это система оптического распознавания текстов. Она преобразует полученное с помощью сканера графическое изображение (картинку) в текст (то есть в коды букв, «понятные» компьютеру). Основные модификации � Standard, Professional, Рукопись.
Функции, обеспечиваемые модификациями FineReader
Печатные, рукописные
В библиотеках следует, конечно, применять профессиональные версии программ (это замечание касается любых программ). Если есть возможность, а главное уровень решаемых задач, то необходимо приобретать модификацию Рукопись.
Выбор сканера
Библиотекарям приходится сканировать именно тексты, которые должны быть потом распознаны и превращены в текстовый файл. Если же сканер используется для выполнения платных услуг по сканированию и распознавание не требуется, то можно использовать программы, предназначенные только для сканирования и сохранения картинки.
Для большего комфорта работы необходимо, чтобы программа была связана с подключенным к ней сканером: меню Сервис � Выбор сканера.
О планшетных сканерах
Наиболее универсальный и наиболее распространенный тип сканера. Как правило, обеспечивает высокое разрешение при средней и высокой скорости сканирования.
Планшетные сканеры делятся на две группы:
1. Для работы в офисе и дома.
Как правило, эти сканеры обладают максимальным оптическим разрешением 300 dpi, обычно достаточным для систем распознавания текстов и проведения простых работ по вводу фотографий для любительских фотоальбомов или дизайна страниц в Интернете. Они могут подключаться через параллельный порт, собственную ISA или PSI карту, или SCSI. Обычно имеют максимальную область сканирования A4.
2. Профессиональные сканеры.
Цветные. Оптическое разрешение 600 dpi и выше. Имеют SCSI интерфейс. Зачастую комплектуются модулем для сканирования слайдов. Область сканирования � от Legal до A3.
Некоторые модели сканеров могут дополнительно комплектоваться устройством автоматической подачи бумаги (Automat Document Feeder � ADF). Как правило, они производятся только для моделей, имеющих либо SCSI, либо другой достаточно быстрый интерфейс с компьютером.
При выборе модели сканера необходимо обращать внимание на следующие моменты:
1. Если предполагается сканировать толстые книги, желательно, чтобы крышка сканера это позволяла � не была жестко закреплена, а могла выдвигаться.
2. Если сканер снабжен автоподатчиком, необходимо проследить, как сканер и его драйвер обрабатывают ситуацию перекоса бумаги в лотке автоподатчика. Сканер должен позволять легко разрешать эту проблему.
3. Следует обращать внимание на шум, производимый при сканировании. Некоторые дешевые сканеры довольно шумные, что может доставить массу неудобств при работе в офисе или дома.
О листовых сканерах
Применяются обычно в офисе или дома для сканирования отдельных листов. Однако существуют модели, у которых снимается нижняя часть, что позволяет сканировать книги и журналы, но при этом качество изображения, как правило, резко снижается. Из-за невысокой скорости и среднего качества изображения применяются при эпизодической работе.
До недавнего времени листовые сканеры служили дешевой альтернативой планшетным. Дополнительным стимулом при покупке может служить экономное использование рабочего пространства. Существуют модели для сканирования как черно-белых, так и цветных изображений. Обычно максимальная область сканирования � A 4.
При выборе данной модели сканера необходимо обращать внимание на следующие моменты:
1. Сканер должен легко «захватывать» бумагу из лотка.
2. Как сканер и его драйвер обрабатывают ситуацию перекоса бумаги в лотке. Сканер должен позволять легко разрешать эту проблему.
3. Часто бывает полезной способность TWAIN-драйвера сканера сканировать в автоматическом режиме всю стопку документов, вставленную в лоток, а не ждать команды после сканирования каждого листа. Как правило, эта способность связана с другой не менее важной � автоматическое определение того, кончилась ли бумага в лотке.
О ручных сканерах
Из-за невысокого качества получаемого изображения ручные сканеры применяются обычно дома. В отличие от других типов сканеров, позволяют получать хорошее изображение области около корешка книг в жестком переплете.
До недавнего времени они служили дешевой альтернативой планшетным сканерам.
Модели с мотором иногда позволяют достигать лучшего качества сканирования за счет более равномерного перемещения сканера.
Дополнительным стимулом при покупке может служить экономное использование рабочего пространства. Существуют модели, предназначенные для сканирования черно-белых и модели для сканирования цветных изображений. Обычно максимальная ширина сканируемой области � 10 см.
При выборе модели сканера необходимо обращать внимание на следующие моменты:
1. Качество отсканированного изображения (лучше всего � текста). Качество изображения не должно страдать при более или менее равномерном перемещении сканера. Обычно запоминается скорость сканирования на разных этапах и происходит программная компенсация неизбежных вертикальных искажений. Если драйвер сканера не умеет компенсировать вертикальные искажения, то получить качественное изображение текста практически невозможно.
2. Проверьте, позволяет ли сканер указывать направление сканирования: слева направо, сверху вниз, справа налево.
3. Часто бывает полезной способность TWAIN-драйвера склеивать куски изображений. К сожалению, ею не всегда можно реально воспользоваться.
Некоторые общие советы на применение сканеров при вводе документов:
1. Документация сканера и сопровождающего программного обеспечения должна быть на русском языке.
2. В документации должны быть указаны адреса центров технического обслуживания.
3. Сканер должен иметь в комплекте TWAIN-драйвер совместимый с той операционной системой, в которой вы будете его использовать. Обычно на коробке сканера при этом присутствует логотип Twain-compliant или Twain-compatible. Как правило, все современные сканеры имеют TWAIN-драйвер, совместимый с MS Windows’95, 98. Кроме того, все сканеры подключаемые через SCSI, одинаково успешно работают в MS Windows’95, 98 и Windows NT 4.0. Проблему могут составить только сканеры, подключаемые через параллельный порт или специальные карты, при работе в MS Windows NT 4.0.
4. Обратите внимание на диалог с опциями сканера, который возникает перед сканированием. Желательно, чтобы в этом окне была легко доступна опция выбора типа сканируемого изображения (черно-белый, серый, цветной). В идеале еще и серый с 16 градациями (обычно только с 256 градациями) � это позволит включать встроенный в систему FineReader автоматический подбор яркости при сканировании в сером (обычно серое изображение с 16 градациями сканируется быстрее за счет меньшего объема информации, чем с 256 градациями). Возможность работать с серым изображением особенно важна для библиотек, так как очень часто возникает необходимость сканирования печатных текстов разного качества (бумага, шрифт и т.д.).
Окно программы
Окно программы FineReader имеет сложную структуру (оно разбито на несколько кадров, в которых отражаются результаты сканирования, страницы, которые необходимо распознать, результаты распознавания).
Сканировани е
Нажмите кнопку с изображением сканера на панели инструментов (сканировать).
Вы можете добавлять отсканированные страницы в пакет, по умолчанию создаваемый при запуске программы, или открыть другой пакет (нажмите кнопку) и записывать отсканированные страницы в него.
Нажмите стрелку справа от кнопки и из локального меню выберите пункт Сканировать и распознать.
Система отсканирует изображение, выделит на нем блоки, а затем распознает его.
Если у Вас отмечен пункт Открывать последний пакет (меню Сервис, пункт Опции. закладка Установки), то при загрузке программа будет открывать последний пакет, с которым вы работали в предыдущей сессии.
Параметры сканирования:
Яркость: для светлых документов необходимо уменьшить яркость (сделать их темнее), для темных � увеличить (сделать их светлее).
Разрешение: 300 dpi � для большинства документов; 400�600 dpi � для документов, набранных мелким шрифтом.
Выбор разрешения � это регулировка яркости у всех типов изображения. Часто у черно-белых изображений регулировка яркости осуществляется не выбором яркости (brigthness), а выбором порога (threshold). Это ничем не хуже, однако, если вы потом отключите опцию Показ диалога TWAIN-драйвера , то скорее всего не сможете регулировать яркость.
| Особенности входного изображения | Что сделать |
| Светлые или тонкие буквы | Уменьшить яркость (сделать темнее) |
| Темные или толстые буквы | Увеличить яркость (сделать светлее) |
| Глянцевая бумага | Уменьшить яркость |
| Слипшиеся символы | Увеличить яркость |
| Разрывы | Уменьшить яркость |
| Смазанные или заполненные контуры букв | Увеличить яркость |
Обратите внимание на скорость сканирования в режиме черно-белого изображения (300 dpi). Желательно, чтобы это время не превышало 1�2 минуты.
Обратите внимание на скорость сканирования в режиме цветного изображения (300 dpi). Желательно, чтобы это время не превышало 5�6 минут. В некоторых дешевых моделях, подключаемых через параллельный порт, это время может достигать огромных значений.
Некоторые TWAIN-драйверы при запуске сканирования показывают окно с сообщением о том, что идет разогрев (Warming �) или калибровка (Calibrating �). Как правило, это занимает около минуты. Иногда эта операция происходит при каждом запуске сканирования, даже если оно идет практически непрерывно или сканируется предварительное изображение (Preview�). Как утверждают разработчики сканеров, это необходимо для более корректной цветопередачи. Желательно, чтобы этого режима не было вообще или чтобы он был отключаемым.
Повернуть изображение
Распознаваемое изображение должно иметь стандартную ориентацию: текст должен читаться сверху вниз и строки должны быть параллельны нижнему краю экрана.
Вы можете указать программе, чтобы она автоматически подбирала ориентацию страницы.
Если ориентация не подбирается автоматически, повернуть изображение можно вручную:
1. Выделите нужные изображения.
Выделить одну страницу � Нажмите на нее мышью.
Выделить несколько страниц подряд � Удерживая клавишу SHIFT, нажмите мышью на первую страницу выборки, а затем � на последнюю.
2. Выделить несколько страниц не подряд
Удерживая клавишу CTRL, последовательно нажимайте на интересующие страницы.
Нажмите кнопку, с изображением направления, чтобы повернуть изображение на 90�.
Из меню Изображение выберите пункт Повернуть на 180�, чтобы перевернуть изображение вверх ногами.
Таким же образом можно повернуть активное открытое изображение.
Распознавание
Язык распознавания и тип текста являются главными параметрами распознавания.
Языки, которые имеют словарную поддержку: английский, голландский, датский, испанский, итальянский, немецкий, норвежский, польский, португальский, русский, украинский, финский французский, шведский.
При распознавании текста на том или ином языке выберите нужный язык из списка на панели Распознавание.
Если нужного языка нет в списке, то выберите значение Другой. и в открывшемся списке найдите нужный язык или выберите несколько языков, слова которых встречаются в распознаваемом тексте.
Тип текста определяется в системе автоматически. Однако для распознавания текстов, напечатанных на пишущей машинке или матричном принтере в черновом режиме, чтобы повысить надежность и скорость распознавания, выберите соответствующее значение в списке на панели инструментов.
Если вы распознавали тексты, напечатанные на пишущей машинке или матричном принтере, то при возвращении к типографскому тексту не забудьте снова выбрать значение Авто .
Открытие изображения:
- Меню Файл � Открыть.
- Выберите диск и папку, где находятся нужные файлы.
- Выберите нужные файлы и нажмите OK.
- Выбранные файлы копируются в текущий пакет.
- Вы можете указать, чтобы выбранные изображения не копировались, а перемещались в пакет (отметьте пункт Перемещать файлы в пакет).
Тогда при загрузке в текущий пакет выбранные файлы будут копироваться туда, где находится ваш пакет и удаляться оттуда.
Также можно добавлять изображения из буфера или через drag-&-drop.
Запуск распознавания:
- Выделите нужные страницы в окне пакета. Подведите курсор и щелкните 1 раз левой кнопкой мыши.
- Нажмите кнопку Распознать открытую страницу. Активизируйте открытое изображение и нажмите кнопку � Распознать.
Распознать все нераспознанные страницы:
- Нажмите стрелку справа от кнопки � Распознать и из открывшегося меню выберите пункт Распознать все нераспознанные страницы.
- Программа выделяет блоки (если они еще не выделены) и распознает изображения.
Установить расположение текста на странице :
Программа FineReader автоматически определяет раскладку текста на странице. Для книг, газет, факсов, отчетов и т.п. подходит положение Автоматическое определение. И только в редких случаях, например при распознавании оглавлений и листингов программ, нужно специально указывать программе, что текст напечатан в одну колонку.
1. Меню Сервис � Опции�
2. В диалоге Опции выберите закладку Сегментация.
3. В группе Число колонок выберите пункт Одна колонка (для текста, напечатанного в одну колонку с большими промежутками между словами) или Автоматическое определение.
С охранить результаты распознавания в файл:
1. Если Вы хотите сохранить не все страницы пакета, то выделите нужные в окне Пакет.
2. Нажмите стрелку справа от кнопки Сохранить и в открывшемся меню выберите пункт Сохранить в файл.
3. В открывшемся диалоговом окне выберите диск, каталог и укажите имя и расширение файла, в который хотите экспортировать распознанный текст.
4. Установите переключатель Какие страницы сохранять в положение Все распознанные или Только выделенные.
5. Чтобы записывать каждую страницу в отдельный файл, отметьте пункт Записывать каждую страницу в отдельный файл. Тогда имена, которые эти файлы получат, будут состоять из заданного имени и порядкового номера (1, 2, и т.д.).
Вы можете передать результаты распознавания в одно из следующих приложений: MS Word, MS Excel, Corel WordPerfect, Lotus Word Pro или PROMT:
1. Активизируйте окно пакета (нажмите в нем мышью) и нажмите стрелку справа от кнопки Сохранить.
2. В открывшемся меню выберите пункт Передать в Word, Передать в Excel и т.п.
Для выделенных страниц:
1. Если вы хотите передать в другое приложение не все страницы, а только некоторые, то выделите нужные страницы в окне Пакет.
2. Нажмите на стрелку справа от кнопки � Сохранить и выберите пункт Мастер сохранения результатов.
3. В открывшемся списке выберите нужное приложение и отметьте пункт Сохранять только выделенные страницы. По нажатию Готово в этом диалоге результаты распознавания передаются в выбранное приложение.
Позовите преподавателя для проверки работы
Цель работы: изучить и освоить возможности MS Word при работе с колонками и списками.
Задание 1. Установка параметров страницы
Установим поля страницы. Для этого выберите вкладку Разметка страницы ® Параметры страницы.

Откроется окно Параметры страницы:

Установите поля страницы: Верхнее – 2 см, Нижнее – 2 см, Левое – 2 см, Правое – 2 см.
Обратите внимание, что в этом же окне можно поменять ориентацию страницы с книжной (по умолчанию) на альбомную.
Задание 2. Создание колонок (3 колонки)
Наберите текст по образцу (тип шрифта Times New Roman, размер – 12):
Распознавание текстов — очень важная задача, которая возникает во многих областях деятельности человека. Заполняя бюллетень на выборах, бланк во время переписи населения, карточку в поликлинике, бланк теста на экзамене, мы знаем, что обработку информации с этих носителей будет выполнять компьютер, а вернее специальная программа распознавания текста. Но прежде специальное устройство сканер поможет ввести данные с бланков в память компьютера. Сканер предназначен для преобразования информации с бумажного носителя в графический файл, с которым и будет работать программа.
Внимание: после напечатанного абзаца обязательно нажмите несколько раз , иначе не получатся три колонки.
Выделите напечатанный текст и выберите вкладку Разметка страницы ® Колонки ® Другие колонки.

Откроется окно Колонки:

Заполните поля диалогового окна: Тип (количество колонок) – 3, промежуток – 0,5 см. Нажмите ОК. Получится так:
Распознавание текстов — очень важная задача, которая возникает во многих областях деятельности человека. Заполняя бюллетень на выборах, бланк во время переписи населения, карточку в поликлинике, бланк теста на экзамене, мы знаем, что обработку информации с этих носителей будет выполнять компьютер, а вернее специальная программа распознавания текста. Но прежде специальное устройство сканер поможет ввести данные с бланков в память компьютера. Сканер предназначен для преобразования информации с бумажного носителя в графический файл, с которым и будет работать программа.
Задание 3. Создание колонок (2 колонки с разделителем)
Скопируйте и вставьте образец текста еще раз. Расположите его в две колонки с интервалом между колонками 1 см, поставьте галочку в окошке Разделитель. Получится так:
Распознавание текстов — очень важная задача, которая возникает во многих областях деятельности человека. Заполняя бюллетень на выборах, бланк во время переписи населения, карточку в поликлинике, бланк теста на экзамене, мы знаем, что обработку информации с этих носителей будет выполнять компьютер, а вернее специальная программа распознавания текста. Но прежде специальное устройство сканер поможет ввести данные с бланков в память компьютера. Сканер предназначен для преобразования информации с бумажного носителя в графический файл, с которым и будет работать программа.
Задание 4. Списки
Списки используют для автоматической нумерации абзацев. Элементом списка может быть только абзац. Списки могут быть нумерованные, маркированные и многоуровневые.

Списки можно создавать двумя способами:
1. Набрать текст из последовательности абзацев, выделить его и выбрать вид списка.
2. Выбрать вид списка и только после этого набрать текст из последовательности абзацев.
Результат будет одинаковым.
Нумерованные списки
Для создания нумерованного списка выберите вкладку Главная ® Абзац ® Нумерация.
Если щелкнуть по стрелке, появится окно, в котором можно выбрать форматы нумерации. Выберите указанный вид нумерованного списка и создайте список:
1. Сайгутина Светлана
2. Асадова Светлана
3. Козырева Юлия
4. Сакаева Ирина
5. Кузнецова Кристина
6. Балахонова Дарья
7. Пономарева Лидия

Расположите фамилии студенток по алфавиту. Для этого: выделите список и щелкните по пиктограмме Сортировка:
Появится окно Сортировка текста. Нажмите ОК. Получится так:
1. Асадова Светлана
2. Балахонова Дарья
3. Козырева Юлия
4. Кузнецова Кристина
5. Пономарева Лидия
6. Сайгутина Светлана
7. Сакаева Ирина
Скопируйте и вставьте полученный список, выберите другой вид нумерованного списка. Например:
1) Асадова Светлана
2) Балахонова Дарья
3) Козырева Юлия
4) Кузнецова Кристина
5) Пономарева Лидия
6) Сайгутина Светлана
7) Сакаева Ирина
Если список начинается не с 1, а продолжается, выделите первую фамилию, нажмите правую кнопку мыши (контекстное меню) и выберите Начать заново с 1. Создайте другие виды нумерованных списков.
Маркированные списки
Для создания маркированного списка выберите вкладку Главная ® Абзац ® Маркеры:

Создайте маркированный список:
Функции процессора:
ü обработка данных по заданной программе путем выполнения арифметических и логических операций;
ü программное управление работой устройств компьютера.
Функции памяти:
ü прием информации из других устройств;
ü запоминание информации;
ü выдача информации по запросу в другие устройства машины.

Многоуровневые списки
Первоначально список не имеет уровней. Для понижения уровня списка следует увеличить отступ:
Для повышения уровня списка – уменьшите отступ:
Создайте многоуровневые списки:
Список 1
1. Компьютерное оборудование
1.1. Системный блок:
1.1.1. материнская плата;
1.1.2. жесткий диск;
1.1.4. блок питания;
Список 2
1. В современном документообороте чаще всего используется:
1) Microsoft Word
2) StarOffice Writer
3) Windows Блокнот
2. Преобразование документа, обеспечивающее вставку, удаление, перемещение его фрагментов (объектов) – это:
3. Часть текста, представляющая собой законченный по смыслу фрагмент произведения, окончание которого служит естественной паузой для перехода к новой мысли:
Сохраните работу в своей папке под именем Практическая работа 3.
Позовите преподавателя для проверки работы
Практическое занятие № 4
Создание и форматирование таблиц
Цель работы: изучить и освоить возможности MS Word при работе с таблицами.
Таблицы в документах используют для представления структурированной информации.
Задание 1. Создание таблицы
Образец: Таблица истинности для основных логических функций
| A | B | A Ù B конъюнкция | A Ú B дизъюнкция | ØA инверсия |
| 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 |
Для создания таблицы используется вкладка Вставка ® Таблица

Посчитайте количество столбцов в таблице – 5. Количество строк считать необязательно, т.к. они легко добавляются и удаляются. Щелкните по пиктограмме Таблица и, удерживая левую кнопку мыши нажатой, выделите 5 клеточек по горизонтали и 5 клеточек по вертикали. Щелкните левой кнопкой мыши.

Заполните таблицу. Для ввода символов конъюнкции, дизъюнкции, инверсии используйте вкладку Вставка ® Символ.

| A | B | A Ù B конъюнкция | A Ú B дизъюнкция | ØA инверсия |
| 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 |
Выделите всю таблицу и щелкните правой кнопкой мыши. Появится контекстное меню:

Выберите Автоподбор ® Автоподбор по содержимому. Получится так:
| A | B | A Ù B конъюнкция | A Ú B дизъюнкция | ØA инверсия |
| 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 |
Расположите таблицу по центру. Расположите надписи в ячейках по центру. Напечатайте название таблицы. Должно получиться, как на образце.
Задание 2. Конструктор. Создайте таблицу:
| Вид рекламы | Эффективность рекламы (%) |
| Телевидение | 40 |
| Радио | 20 |
| Средства печати | 26 |
| Транспорт | 7 |
| Уличные щиты | 2 |
| Прочие | 5 |
Установите курсор в любой ячейке таблицы и найдите вкладку РАБОТА С ТАБЛИЦАМИ Конструктор:

Откройте окно, где Вы можете выбрать стиль оформления таблицы или создать свой стиль. Выберите один из стилей.
Задание 3. Объединение ячеек Образец:
Единицы измерения информации
Для того, чтобы записать название таблицы Единицы измерения информации, необходимо выделить ячейки первой строки, щелкнуть правой кнопкой мыши (появится контекстное меню), выбрать: Объединить ячейки:

Расположите текст внутри ячеек По центру, введите название таблицы Единицы измерения информации. Объедините 4-ую и 5-ую ячейки второй строки (где будет напечатано Приставка), затем разбейте ее на 2 столбца, 2 строки.


Единицы измерения информации
Две верхние ячейки объедините. Заполните таблицу. Используйте надстрочные и подстрочные знаки.
Задание 4. Создайте таблицу самостоятельно. Образец:
Дата добавления: 2020-04-08 ; просмотров: 2276 ; Мы поможем в написании вашей работы!
Поделиться с друзьями:
© 2014-2023 — Студопедия.Нет — Информационный студенческий ресурс. Все материалы представленные на сайте исключительно с целью ознакомления читателями и не преследуют коммерческих целей или нарушение авторских прав (0.036)
Распознавание изогнутого текста
Распознавание текста — важная задача машинного обучения, решение которой позволит получать огромное количество информации из окружающего мира без участия человека. Распознавание изогнутого текста, в частности, одна из проблем, лежащих на пути решения данной задачи.
Введение
В решении задачи распознавания текста двумя основными составляющими являются определение области текста и распознавание содержимого области. В сообществе исследователей выделяют три разных вида ориентации текста: горизонтальная (англ. horizontal), множественная (англ. multi-oriented), изогнутая (англ. curved). Очевидно, что правильность определения области текста напрямую влияет на качество работы распознающих моделей. Долгое время распознавание изогнутого текста казалось крайне сложной задачей — до тех пор, пока не появились способы весьма точно определять контуры объектов на изображениях (например, Mask R-CNN [1] ). Использование методов сегментации изображения позволяет добиться хороших результатов на существующих наборах данных.
В этой статье будут описаны наборы данных, поспособствовавшие исследованиям, а также новейшие и наиболее удачные модели, которые показывают хорошие результаты вне зависимости от ориентации текста. Модели разделены на три категории:
- модели, занимающиеся только детекцией (они находят группы букв на изображении, а распознавание непосредственно слов разработчики делегируют другим инструментам).
- модели, которые занимаются только распознаванием.
- модели, которые занимаются и детекцией, и распознаванием — сквозные модели (англ. end-to-end).
При дальнейшем чтении статьи могут возникнуть вопросы относительно методов измерения точности моделей. В качестве меры точности используется F-мера (совместно с precision и recall). В задаче распознавания текста precision — это количество правильно распознанных слов из общего числа слов, которые модель сумела найти на изображениях; recall — это количество правильно распознанных слов из всех слов, представленных в наборе данных. В задаче детекции текста для различных наборов данных используются различные протоколы оценки, с помощью которых определяется recall и precision, потом высчитывается F-мера.
Наборы данных
TotalText (2017)
Предшествующие TotalText’у наборы данных ICDAR’03 [2] , ’11 [3] , ’13 [4] и MSRA-TD500 [5] сыграли значимую роль в начале исследований в области распознавания текста. У наборов данных ICDAR [2] [3] [4] [6] тексты встречались в единственной ориентации — горизонтальной, и на этом предположении были основаны многие ранние модели. Границы текста они определяли как прямоугольник. Это ограничивало возможности распознавания, и для привлечения внимания исследователей к этой проблеме в 2012 году был представлен набор данных MSRA-TD500 [5] , включавший в себя большое количество изображений с множественной ориентацией текста (от горизонтальной отличается тем, что область с текстом находится под наклоном или/и в перспективе). Модели были усовершенствованы, и теперь определяли границы как произвольных форм четырёхугольники. Текст же изогнутой формы, несмотря на частоту появления в реальном окружении, практически не появлялся в наборах данных (искл. COCO-text [7] и CUTE80 [8] , но они не привлекли особого внимания к проблеме). Поэтому справиться с произвольной формой текста многие модели попросту не могли.
Для привлечения внимания к этой проблеме в 2017 году был представлен набор данных TotalText, состоящий из 1555 изображений с текстом различной ориентации и содержащий в целом 9330 слов. Отличительной особенностью TotalText является эталон области (или же границ) текста. Так, в COCO-text [7] эталоном области текста являлся горизонтально ориентированный прямоугольник, а вот в TotalText это был многоугольник, состоящий из множества полигонов.
В качестве протокола оценки используется DetEval [9] .
SCUT-CTW1500 (2017)
SCUT-CTW1500 должен был привлечь внимание к той же проблеме, что и TotalText. Они были опубликованы практически одновременно (TotalText 27 октября 2017, а SCUT-CTW1500 6 декабря 2017). Вероятно, они разрабатывались независимо друг от друга — авторы SCUT-CTW1500 утверждали, что они являются первооткрывателями полигонального подхода, хотя TotalText был опубликован немного раньше. Позднее авторы TotalText добавили ссылку на SCUT-CTW1500 в качестве дополнения к своему набору данных. SCUT-CTW1500 включает в себя 1500 изображений (1000 для обучения, 500 для проверки), на которых содержится более 10 тысяч областей с текстом, и на каждом изображении как минимум один раз встречается изогнутый текст. Здесь, как и в TotalText, эталоном области является фигура, состоящая из нескольких полигонов. Оба этих набора данных (и модели, обученные на них) стали прорывом — они первые начали использовать полигональную форму.
Сейчас TotalText и SCUT-CTW1500 все реже используются как два независимых набора данных. Набор данных ArT [10] объединил их в себе и стал самым большим набором данных изогнутого текста.
Протоколом оценки является PASCAL VOC [11] протокол, где используется метрика IoU (граничное значение для определения true или false positive — 0.5).
Модели для детекции
TextSnake (2018)

Рисунок 1. Как TextSnake представляет текст [12]
TextSnake отличается уникальным способом представления области с текстом (см. Рисунок 1). Математически, экземпляр текста [math]t[/math] , состоящий из нескольких элементов, может быть представлен как упорядоченный список [math]S(t)[/math] . [math]S(t) = \[/math] , где [math]D_i[/math] — это [math]i[/math] -й диск, а [math]n[/math] — количество дисков. Каждый диск [math]D[/math] обладает набором геометрических свойств [math](c, r, θ)[/math] , где [math]c, r, θ[/math] — это центр, радиус и ориентация диска [math]D[/math] соответственно. Радиус [math]r[/math] определён как половина от локальной высоты [math]t[/math] , а ориентация [math]θ[/math] — это тангенциальное направление центральной линии относительно центра [math]c[/math] . Таким образом, текстовая область [math]t[/math] может быть легко представлена с помощью вычисления объединения дисков в [math]S(t)[/math] . Важно, что сами диски никак не связаны с символами, принадлежащими [math]t[/math] . Такое представление [math]t[/math] даёт возможность «выпрямить» текстовую область, что облегчит распознавание её содержимого.
Статья о модели доступна по ссылке. Реализацию этой модели можно найти в открытом доступе.
Архитектура

Рисунок 2. Схема работы TextSnake [12]
Схема работы TextSnake представлена справа (см. Рисунок 2). TextSnake использует свёрточную нейронную сеть. Чтобы определять текст произвольной формы, используется FCN (Fully Convolutional Network) [13] модель для предсказывания геометрических атрибутов текстовых областей. С помощью FCN [13] и FPN (Feature Pyramid Network) [14] предсказываются вероятностные карты центральной линии (text center line, TCL) и текстовых областей (text regions, TR), вместе с геометрическими атрибутами [math]r, cosθ, sinθ[/math] . Карта TCL в дальнейшем маскируется картой TR (TCL, по сути, является частью TR). Для сегментации используется непересекающийся набор, так как центральные линии не перекрывают друг друга. Далее извлекаются списки точек центральной оси и восстанавливаются экземпляры текста. Детальная архитектура представлена ниже (см. Рисунок 3):

Рисунок 3. Архитектура TextSnake [12]
Точность
- TotalText: 78.4%
- CTW1500: 75.6%
TextFuseNet (2020)
Основной особенностью TextFuseNet является выделение бóльшего количества признаков и их слияние для более точного определения текстовых областей. TextFuseNet опирается на Mask R-CNN [1] и Mask TextSpotter, рассматривая детекцию текста как задачу сегментации. Выделение признаков происходит на трёх уровнях: символьном, словесном и глобальном.
Статья о модели доступна по ссылке. Реализацию этой модели можно найти в открытом доступе.
Архитектура

Рисунок 4. Архитектура TextFuseNet [15]
Общая архитектура TextFuseNet представлена выше (см. Рисунок 4). В качестве основы для FPN [14] используется ResNet50 [16] , на этом этапе извлекаются общие признаки. Выходные данные используются RPN (Region Proposal Network) [17] и ветвью Semantic Segmentation. RPN [17] используется для генерации предполагаемых текстовых областей, что используется в последующих ветках Detection и Mask.
- Сначала в ветви Semantic Segmentation с помощью сегментации определяются признаки на глобальном уровне.
- Далее в ветви Detection, извлекаются признаки на словесном уровне и объединяются с признаками глобального уровня. Полученное представление используется для регрессии окружающей рамки и классификации объектов (текста/букв).
- Потом в ветви Mask извлекаются признаки на символьном уровне. Все три уровня признаков (символьный, словесный и глобальный) объединяются, и полученное представление используется при сегментации экземпляров (instance segmentation) для объектов, полученных в ветви Detection.
При объединении признаков используется модуль Multi-Path Fusion, общая схема работы которого представлена ниже (Рис. 5):