2. Видоизменения корней
Под влиянием условий окружающей среды корни, кроме своих основных функций, могут выполнять и некоторые другие. Это приводит к изменению их внешнего и внутреннего строения и возникновению видоизменений.
1. Накопительные корни .
Они, кроме основных функций, выполняют и функцию запасания веществ.
Существует \(2\) вида накопительных корней.

Рис. \(1\). Корнеплоды свеклы

Рис. \(2\). Корневые клубни
Корнеплоды образуются, когда питательные вещества запасаются в главном корне и нижней части стебля. Корнеплоды характерны для моркови, свеклы, редьки.
Корневые клубни формируются, если запасные вещества накапливаются в боковых и придаточных корнях. Такие видоизменения имеются у георгина, батата.
2. Корни-прицепки развиваются из придаточных корней и помогают растениям прикрепляться к различным поверхностям — стволам деревьев, фасадам зданий. Плющ балтийский ловко взбирается по сосновым стволам при помощи корней-прицепок.

Рис. \(3\). Плющ
Корни-прицепки имеются также у тропического растения ванили, которую мы знаем как ароматную пряность.
3. Дыхательные корни .

Рис. \(4\). Дыхательные корни
В местах со стоячей водой или в местах, которые часто затапливаются, проблематично обеспечение корневой системы кислородом, так как кислород растворяется в воде в ограниченном количестве.
У мангровых растений тропических болот на растущих в субстрате основных корнях развиваются дыхательные корни, которые растут вертикально вверх и поднимаются выше субстрата вопреки силе притяжения Земли.
Дыхательные корни образуются у некоторых деревьев, растущих на заболоченной почве.
4. Воздушные корни .

Рис. \(5\). Воздушные корни орхидеи
У растений, обитающих на стволах деревьев в тропических лесах (орхидей, бромелий), высоко над землёй образуются воздушные корни, предназначенные для поглощения влаги непосредственно из воздуха. Эти корни могут расти и в почве, выполняя обычные для корней функции.
5. Корни-подпорки .

Рис. \(6\). Корни-подпорки
Это придаточные корни, которые иногда встречаются у деревьев тропических лесов. Они образуются на стволах и крупных ветвях и выполняют функцию опоры для тяжёлых частей дерева.
Досковидные корни-подпорки встречаются как у растущих в тропических лесах деревьев (у хлопкового дерева), так и у деревьев, растущих в умеренных широтах (у вяза обыкновенного).
Справочник API хуков
Хуки — нововведение в React 16.8, которое позволяет использовать состояние и другие возможности React без написания классов.
На этой странице описан API, относящийся к встроенным хукам React.
Если вы новичок в хуках, вы можете сначала ознакомиться с общим обзором. Вы также можете найти полезную информацию в главе «Хуки: ответы на вопросы».
This content is out of date.
Read the new React documentation for useState .
const [state, setState] = useState(initialState);Возвращает значение с состоянием и функцию для его обновления.
Во время первоначального рендеринга возвращаемое состояние ( state ) совпадает со значением, переданным в качестве первого аргумента ( initialState ).
Функция setState используется для обновления состояния. Она принимает новое значение состояния и ставит в очередь повторный рендер компонента.
setState(newState);Во время последующих повторных рендеров первое значение, возвращаемое useState , всегда будет самым последним состоянием после применения обновлений.
Примечание
React гарантирует, что идентичность функции setState стабильна и не изменяется при повторных рендерах. Поэтому её можно безопасно не включать в списки зависимостей хуков useEffect и useCallback .
Если новое состояние вычисляется с использованием предыдущего состояния, вы можете передать функцию в setState . Функция получит предыдущее значение и вернёт обновлённое значение. Вот пример компонента счётчик, который использует обе формы setState :
function Counter(initialCount>) const [count, setCount] = useState(initialCount); return ( > Счёт: count> button onClick=() => setCount(initialCount)>>Сброситьbutton> button onClick=() => setCount(prevCount => prevCount - 1)>>-button> button onClick=() => setCount(prevCount => prevCount + 1)>>+button> > ); >Кнопки «+» и «-» используют функциональную форму, потому что обновлённое значение основано на предыдущем значении. Но кнопка «Сбросить» использует обычную форму, потому что она всегда устанавливает счётчик обратно в 0.
Если функция обновления возвращает абсолютно такой же результат как и текущее состояние, то последующие повторные рендеры будут полностью пропущены.
Примечание
В отличие от метода setState , который вы можете найти в классовых компонентах, useState не объединяет объекты обновления автоматически. Вы можете повторить это поведение, комбинируя форму функции обновления с синтаксисом расширения объекта:
const [state, setState] = useState(>); setState(prevState => // Object.assign также будет работать return . prevState, . updatedValues>; >);Другой вариант — useReducer , который больше подходит для управления объектами состояния, содержащими несколько значений.
Ленивая инициализация состояния
Аргумент initialState — это состояние, используемое во время начального рендеринга. В последующих рендерах это не учитывается. Если начальное состояние является результатом дорогостоящих вычислений, вы можете вместо этого предоставить функцию, которая будет выполняться только при начальном рендеринге:
const [state, setState] = useState(() => const initialState = someExpensiveComputation(props); return initialState; >);Досрочное прекращение обновления состояния
Если вы обновите состояние хука тем же значением, что и текущее состояние, React досрочно выйдет из хука без повторного рендера дочерних элементов и запуска эффектов. (React использует алгоритм сравнения Object.is .)
Обратите внимание, что для React всё ещё может быть необходим повторный рендер этого компонента. Это не должно быть проблемой, потому что React не будет сильно «углубляться» в дерево. Если вы делаете дорогостоящие вычисления во время рендеринга, вы можете оптимизировать их с помощью useMemo .
Группировка обновлений состояния
React может группировать несколько обновлений состояния в один повторный рендер для улучшения производительности. Обычно это улучшает производительность и не должно влиять на поведение вашего приложения.
До 18 версии React группировал только обновления внутри обработчиков событий. Начиная с 18 версии, группировка включена по умолчанию для всех обновлений. Обратите внимание, что если обновления вызваны несколькими различными действиями пользователя — например, пользователь дважды кликнул на кнопку — то они обрабатываются раздельно и не будут сгруппированы. Это позволяет избежать логических ошибок.
В редких случаях, когда вам нужно вызвать принудительное синхронное обновление DOM, вы можете обернуть его в flushSync . Однако это может вызвать ухудшение производительности, используйте это только в тех случаях, где это действительно нужно.
This content is out of date.
Read the new React documentation for useEffect .
useEffect(didUpdate);Принимает функцию, которая содержит императивный код, возможно, с эффектами.
Мутации, подписки, таймеры, логирование и другие побочные эффекты не допускаются внутри основного тела функционального компонента (называемого этапом рендеринга React). Это приведёт к запутанным ошибкам и несоответствиям в пользовательском интерфейсе.
Вместо этого используйте useEffect . Функция, переданная в useEffect , будет запущена после того, как рендер будет зафиксирован на экране. Думайте об эффектах как о лазейке из чисто функционального мира React в мир императивов.
По умолчанию эффекты запускаются после каждого завершённого рендеринга, но вы можете решить запускать их только при изменении определённых значений.
Часто эффекты создают ресурсы, которые необходимо очистить (или сбросить) перед тем, как компонент покидает экран, например подписку или идентификатор таймера. Чтобы сделать это, функция переданная в useEffect , может вернуть функцию очистки. Например, чтобы создать подписку:
useEffect(() => const subscription = props.source.subscribe(); return () => // Очистить подписку subscription.unsubscribe(); >; >);Функция очистки запускается до удаления компонента из пользовательского интерфейса, чтобы предотвратить утечки памяти. Кроме того, если компонент рендерится несколько раз (как обычно происходит), предыдущий эффект очищается перед выполнением следующего эффекта. В нашем примере это означает, что новая подписка создаётся при каждом обновлении. Чтобы избежать воздействия на каждое обновление, обратитесь к следующему разделу.
Порядок срабатывания эффектов
В отличие от componentDidMount и componentDidUpdate , функция, переданная в useEffect , запускается во время отложенного события после разметки и отрисовки. Это делает хук подходящим для многих распространённых побочных эффектов, таких как настройка подписок и обработчиков событий, потому что большинство типов работы не должны блокировать обновление экрана браузером.
Однако не все эффекты могут быть отложены. Например, изменение DOM, которое видно пользователю, должно запускаться синхронно до следующей отрисовки, чтобы пользователь не замечал визуального несоответствия. (Различие концептуально схоже с пассивным и активным слушателями событий.) Для этих типов эффектов React предоставляет один дополнительный хук, называемый useLayoutEffect . Он имеет ту же сигнатуру, что и useEffect , и отличается только в его запуске.
Также с 18 версии React, функция, переданная в useEffect , будет вызвана синхронно перед разметкой и отрисовкой, если эффект был вызван действием пользователя или результат обновления был обернут в flushSync . Такое поведение позволяет системе событий или функции, вызвавшей flushSync следить за результатом эффекта.
Примечание
Это влияет только на время, когда функция, переданная в useEffect , будет вызвана — обновления, которые запланированы внутри эффектов останутся отложенными. Это поведение отлично от useLayoutEffect , который вызывает функцию и обрабатывает обновления внутри него мнгновенно.
Хотя useEffect откладывается до тех пор, пока браузер не выполнит отрисовку, он гарантированно срабатывает перед любыми новыми рендерами. React всегда полностью применяет эффекты предыдущего рендера перед началом нового обновления.
Условное срабатывание эффекта
По умолчанию эффекты запускаются после каждого завершённого рендера. Таким образом, эффект всегда пересоздаётся, если значение какой-то из зависимости изменилось.
Однако в некоторых случаях это может быть излишним, например, в примере подписки из предыдущего раздела. Нам не нужно создавать новую подписку на каждое обновление, а только если изменился проп source .
Чтобы реализовать это, передайте второй аргумент в useEffect , который является массивом значений, от которых зависит эффект. Наш обновлённый пример теперь выглядит так:
useEffect( () => const subscription = props.source.subscribe(); return () => subscription.unsubscribe(); >; >, [props.source], );Теперь подписка будет создана повторно только при изменении props.source .
Примечание
Если вы хотите использовать эту оптимизацию, обратите внимание на то, чтобы массив включал в себя все значения из области видимости компонента (такие как пропсы и состояние), которые могут изменяться с течением времени, и которые будут использоваться эффектом. В противном случае, ваш код будет ссылаться на устаревшее значение из предыдущих рендеров. Отдельные страницы документации рассказывают о том, как поступить с функциями и что делать с часто изменяющимися массивами.
Если вы хотите запустить эффект и сбросить его только один раз (при монтировании и размонтировании), вы можете передать пустой массив ( [] ) вторым аргументом. React посчитает, что ваш эффект не зависит от каких-либо значений из пропсов или состояния и поэтому не будет выполнять повторных запусков эффекта. Это не обрабатывается как особый случай — он напрямую следует из логики работы входных массивов.
Если вы передадите пустой массив ( [] ), пропсы и состояние внутри эффекта всегда будут иметь значения, присвоенные им изначально. Хотя передача [] ближе по модели мышления к знакомым componentDidMount и componentWillUnmount , обычно есть более хорошие способы избежать частых повторных рендеров. Не забывайте, что React откладывает выполнение useEffect , пока браузер не отрисует все изменения, поэтому выполнение дополнительной работы не является существенной проблемой.
Мы рекомендуем использовать правило exhaustive-deps , входящее в наш пакет правил линтера eslint-plugin-react-hooks . Оно предупреждает, когда зависимости указаны неправильно и предлагает исправление.
Массив зависимостей не передаётся в качестве аргументов функции эффекта. Тем не менее, в теории вот что происходит: каждое значение, на которое ссылается функция эффекта, должно также появиться в массиве зависимостей. В будущем достаточно продвинутый компилятор сможет создать этот массив автоматически.
This content is out of date.
Read the new React documentation for useContext .
const value = useContext(MyContext);Принимает объект контекста (значение, возвращённое из React.createContext ) и возвращает текущее значение контекста для этого контекста. Текущее значение контекста определяется пропом value ближайшего над вызывающим компонентом в дереве.
Когда ближайший над компонентом обновляется, этот хук вызовет повторный рендер с последним значением контекста, переданным этому провайдеру MyContext . Даже если родительский компонент использует React.memo или реализует shouldComponentUpdate , то повторный рендер будет выполняться, начиная c компонента, использующего useContext .
Запомните, аргументом для useContext должен быть непосредственно сам объект контекста:
- Правильно: useContext(MyContext)
- Неправильно: useContext(MyContext.Consumer)
- Неправильно: useContext(MyContext.Provider)
Компонент, вызывающий useContext , всегда будет перерендериваться при изменении значения контекста. Если повторный рендер компонента затратен, вы можете оптимизировать его с помощью мемоизации.
Совет
Если вы были знакомы с API контекстов до появления хуков, то вызов useContext(MyContext) аналогичен выражению static contextType = MyContext в классе, либо компоненту .
useContext(MyContext) позволяет только читать контекст и подписываться на его изменения. Вам всё ещё нужен выше в дереве, чтобы предоставить значение для этого контекста.
Соединим все вместе с Context.Provider
const themes = light: foreground: "#000000", background: "#eeeeee" >, dark: foreground: "#ffffff", background: "#222222" > >; const ThemeContext = React.createContext(themes.light); function App() return ( ThemeContext.Provider value=themes.dark>> Toolbar /> ThemeContext.Provider> ); > function Toolbar(props) return ( div> ThemedButton /> div> ); > function ThemedButton() const theme = useContext(ThemeContext); return ( button style= background: theme.background, color: theme.foreground >>> Я стилизован темой из контекста! button> ); >Это пример из раздела Продвинутые темы: Контекст, только переписанный с использованием хуков. В этом же разделе можно найти больше информации о том, как и когда использовать объект Context.
Следующие хуки являются вариантами базовых из предыдущего раздела или необходимы только для конкретных крайних случаев. Их не требуется основательно изучать заранее.
This content is out of date.
Read the new React documentation for useReducer .
const [state, dispatch] = useReducer(reducer, initialArg, init);Альтернатива для useState . Принимает редюсер типа (state, action) => newState и возвращает текущее состояние в паре с методом dispatch . (Если вы знакомы с Redux, вы уже знаете, как это работает.)
Хук useReducer обычно предпочтительнее useState , когда у вас сложная логика состояния, которая включает в себя несколько значений, или когда следующее состояние зависит от предыдущего. useReducer также позволяет оптимизировать производительность компонентов, которые запускают глубокие обновления, поскольку вы можете передавать dispatch вместо колбэков.
Вот пример счётчика из раздела useState , переписанный для использования редюсера:
const initialState = count: 0>; function reducer(state, action) switch (action.type) case 'increment': return count: state.count + 1>; case 'decrement': return count: state.count - 1>; default: throw new Error(); > > function Counter() const [state, dispatch] = useReducer(reducer, initialState); return ( > Count: state.count> button onClick=() => dispatch(type: 'decrement'>)>>-button> button onClick=() => dispatch(type: 'increment'>)>>+button> > ); >Примечание
React гарантирует, что идентичность функции dispatch стабильна и не изменяется при повторных рендерах. Поэтому её можно безопасно не включать в списки зависимостей хуков useEffect и useCallback .
Указание начального состояния
Существует два разных способа инициализации состояния useReducer . Вы можете выбрать любой из них в зависимости от ситуации. Самый простой способ — передать начальное состояние в качестве второго аргумента:
const [state, dispatch] = useReducer( reducer, count: initialCount> );
Примечание
React не использует соглашение об аргументах state = initialState , популярное в Redux. Начальное значение иногда должно зависеть от пропсов и поэтому указывается вместо вызова хука. Если вы сильно в этом уверены, вы можете вызвать useReducer(reducer, undefined, reducer) , чтобы эмулировать поведение Redux, но это не рекомендуется.
Вы также можете создать начальное состояние лениво. Для этого вы можете передать функцию init в качестве третьего аргумента. Начальное состояние будет установлено равным результату вызова init(initialArg) .
Это позволяет извлечь логику для расчёта начального состояния за пределы редюсера. Это также удобно для сброса состояния позже в ответ на действие:
function init(initialCount) return count: initialCount>;> function reducer(state, action) switch (action.type) case 'increment': return count: state.count + 1>; case 'decrement': return count: state.count - 1>; case 'reset': return init(action.payload); default: throw new Error(); > > function Counter(initialCount>) const [state, dispatch] = useReducer(reducer, initialCount, init); return ( > Count: state.count> button onClick=() => dispatch(type: 'reset', payload: initialCount>)>> Reset button> button onClick=() => dispatch(type: 'decrement'>)>>-button> button onClick=() => dispatch(type: 'increment'>)>>+button> > ); >Досрочное прекращение dispatch
Если вы вернёте то же значение из редюсера хука, что и текущее состояние, React выйдет без перерисовки дочерних элементов или запуска эффектов. (React использует алгоритм сравнения Object.is.)
Обратите внимание, что для React всё ещё может быть необходим повторный рендер этого компонента. Это не должно быть проблемой, потому что React не будет сильно «углубляться» в дерево. Если вы делаете дорогостоящие вычисления во время рендеринга, вы можете оптимизировать их с помощью useMemo .
This content is out of date.
Read the new React documentation for useCallback .
const memoizedCallback = useCallback( () => doSomething(a, b); >, [a, b], );Передайте встроенный колбэк и массив зависимостей. Хук useCallback вернёт мемоизированную версию колбэка, который изменяется только, если изменяются значения одной из зависимостей. Это полезно при передаче колбэков оптимизированным дочерним компонентам, которые полагаются на равенство ссылок для предотвращения ненужных рендеров (например, shouldComponentUpdate ).
useCallback(fn, deps) — это эквивалент useMemo(() => fn, deps) .
Примечание
Массив зависимостей не передаётся в качестве аргументов для колбэка. Концептуально, однако, это то, что они представляют: каждое значение, использованное в колбэке, должно также появиться в массиве зависимостей. В будущем достаточно продвинутый компилятор может создать этот массив автоматически.
Мы рекомендуем использовать правило exhaustive-deps , входящее в наш пакет правил линтера eslint-plugin-react-hooks . Оно предупреждает, когда зависимости указаны неправильно и предлагает исправление.
This content is out of date.
Read the new React documentation for useMemo .
const memoizedValue = useMemo(() => computeExpensiveValue(a, b), [a, b]);Передайте «создающую» функцию и массив зависимостей. useMemo будет повторно вычислять мемоизированное значение только тогда, когда значение какой-либо из зависимостей изменилось. Эта оптимизация помогает избежать дорогостоящих вычислений при каждом рендере.
Помните, что функция, переданная useMemo , запускается во время рендеринга. Не делайте там ничего, что вы обычно не делаете во время рендеринга. Например, побочные эффекты принадлежат useEffect , а не useMemo .
Если массив не был передан, новое значение будет вычисляться при каждом рендере.
Вы можете использовать useMemo как оптимизацию производительности, а не как семантическую гарантию. В будущем React может решить «забыть» некоторые ранее мемоизированные значения и пересчитать их при следующем рендере, например, чтобы освободить память для компонентов вне области видимости экрана. Напишите свой код, чтобы он по-прежнему работал без useMemo , а затем добавьте его для оптимизации производительности.
Примечание
Массив зависимостей не передаётся в качестве аргументов функции. Концептуально, однако, это то, что они представляют: каждое значение, на которое ссылается функция, должно также появиться в массиве зависимостей. В будущем достаточно продвинутый компилятор может создать этот массив автоматически.
Мы рекомендуем использовать правило exhaustive-deps , входящее в наш пакет правил линтера eslint-plugin-react-hooks . Оно предупреждает, когда зависимости указаны неправильно и предлагает исправление.
This content is out of date.
Read the new React documentation for useRef .
const refContainer = useRef(initialValue);useRef возвращает изменяемый ref-объект, свойство .current которого инициализируется переданным аргументом ( initialValue ). Возвращённый объект будет сохраняться в течение всего времени жизни компонента.
Обычный случай использования — это доступ к потомку в императивном стиле:
function TextInputWithFocusButton() const inputEl = useRef(null); const onButtonClick = () => // `current` указывает на смонтированный элемент `input` inputEl.current.focus(); >; return ( > input ref=inputEl> type="text" /> button onClick=onButtonClick>>Установить фокус на поле вводаbutton> > ); >По сути, useRef похож на «коробку», которая может содержать изменяемое значение в своём свойстве .current .
Возможно, вы знакомы с рефами в основном как со способом получить доступ к DOM. Если вы передадите React объект рефа с помощью подобного выражения /> , React установит собственное свойство .current на соответствующий DOM-узел при каждом его изменении.
Но хук useRef() полезен не только установкой атрибута с рефом. Он удобен для сохранения любого мутируемого значения, по аналогии с тем, как вы используете поля экземпляра в классах.
Это возможно, поскольку useRef() создаёт обычный JavaScript-объект. Единственная разница между useRef() и просто созданием самого объекта — это то, что хук useRef даст один и тот же объект с рефом при каждом рендере.
Имейте в виду, что useRef не уведомляет вас, когда изменяется его содержимое. Мутирование свойства .current не вызывает повторный рендер. Если вы хотите запустить некоторый код, когда React присоединяет или отсоединяет реф к узлу DOM, вы можете использовать колбэк-реф вместо этого.
This content is out of date.
Read the new React documentation for useImperativeHandle .
useImperativeHandle(ref, createHandle, [deps])useImperativeHandle настраивает значение экземпляра, которое предоставляется родительским компонентам при использовании ref . Как всегда, в большинстве случаев следует избегать императивного кода, использующего ссылки. useImperativeHandle должен использоваться с forwardRef :
function FancyInput(props, ref) const inputRef = useRef(); useImperativeHandle(ref, () => ( focus: () => inputRef.current.focus(); > >)); return input ref=inputRef> . />; > FancyInput = forwardRef(FancyInput);В этом примере родительский компонент, который отображает /> , сможет вызывать inputRef.current.focus() .
This content is out of date.
Read the new React documentation for useLayoutEffect .
Сигнатура идентична useEffect , но этот хук запускается синхронно после всех изменений DOM. Используйте его для чтения макета из DOM и синхронного повторного рендеринга. Обновления, запланированные внутри useLayoutEffect , будут полностью применены синхронно перед тем, как браузер получит шанс осуществить отрисовку.
Предпочитайте стандартный useEffect , когда это возможно, чтобы избежать блокировки визуальных обновлений.
Совет
Если вы переносите код из классового компонента, useLayoutEffect запускается в той же фазе, что и componentDidMount и componentDidUpdate . Тем не менее, мы рекомендуем начать с useEffect , и попробовать использовать useLayoutEffect , если тот приводит к возникновению проблем.
Если вы используете серверный рендеринг, имейте в виду, что ни useLayoutEffect , ни useEffect не могут работать до загрузки JavaScript. Вот почему React предупреждает, когда серверный компонент содержит useLayoutEffect . Чтобы справиться с данной проблемой, либо переместите эту логику в useEffect (если она не нужна для первого рендера), либо задержите отображение этого компонента до тех пор, пока не выполнится рендеринг на стороне клиента (если HTML некорректный до запуска useLayoutEffect ).
Чтобы исключить компонент, который нуждается в эффектах макета из HTML-кода, полученного в результате серверного рендеринга, выполните его рендер по условию showChild && и отложите отображение с помощью useEffect(() => < setShowChild(true); >, []) . Таким образом, пользовательский интерфейс не будет выглядеть некорректно перед гидратацией.
This content is out of date.
Read the new React documentation for useDebugValue .
useDebugValue(value)useDebugValue может использоваться для отображения метки для пользовательских хуков в React DevTools.
Например, рассмотрим пользовательский хук useFriendStatus , описанный в разделе «Создание собственных хуков»:
function useFriendStatus(friendID) const [isOnline, setIsOnline] = useState(null); // . // Показывать ярлык в DevTools рядом с этим хуком // например, «Статус друга: В сети» useDebugValue(isOnline ? 'В сети' : 'Не в сети'); return isOnline; >Совет
Мы не рекомендуем добавлять значения отладки в каждый пользовательский хук. Это наиболее ценно для пользовательских хуков, которые являются частью общих библиотек.
Отложите форматирование значений отладки
В некоторых случаях форматирование значения для отображения может быть дорогой операцией. Это также не нужно, если хук не проверен.
По этой причине useDebugValue принимает функцию форматирования в качестве необязательного второго параметра. Эта функция вызывается только при проверке хуков. Она получает значение отладки в качестве параметра и должна возвращать форматированное отображаемое значение.
Например, пользовательский хук, который возвратил значение Date , может избежать ненужного вызова функции toDateString , передав следующую функцию форматирования:
useDebugValue(date, date => date.toDateString());This content is out of date.
Read the new React documentation for useDeferredValue .
const deferredValue = useDeferredValue(value);useDeferredValue accepts a value and returns a new copy of the value that will defer to more urgent updates. If the current render is the result of an urgent update, like user input, React will return the previous value and then render the new value after the urgent render has completed.
This hook is similar to user-space hooks which use debouncing or throttling to defer updates. The benefits to using useDeferredValue is that React will work on the update as soon as other work finishes (instead of waiting for an arbitrary amount of time), and like startTransition , deferred values can suspend without triggering an unexpected fallback for existing content.
Memoizing deferred children
useDeferredValue only defers the value that you pass to it. If you want to prevent a child component from re-rendering during an urgent update, you must also memoize that component with React.memo or React.useMemo :
function Typeahead() const query = useSearchQuery(''); const deferredQuery = useDeferredValue(query); // Memoizing tells React to only re-render when deferredQuery changes, // not when query changes. const suggestions = useMemo(() => SearchSuggestions query=deferredQuery> />, [deferredQuery] ); return ( > SearchInput query=query> /> Suspense fallback="Loading results. "> suggestions> Suspense> > ); >Memoizing the children tells React that it only needs to re-render them when deferredQuery changes and not when query changes. This caveat is not unique to useDeferredValue , and it’s the same pattern you would use with similar hooks that use debouncing or throttling.
This content is out of date.
Read the new React documentation for useTransition .
const [isPending, startTransition] = useTransition();Returns a stateful value for the pending state of the transition, and a function to start it.
startTransition lets you mark updates in the provided callback as transitions:
startTransition(() => setCount(count + 1); >);isPending indicates when a transition is active to show a pending state:
function App() const [isPending, startTransition] = useTransition(); const [count, setCount] = useState(0); function handleClick() startTransition(() => setCount(c => c + 1); >); > return ( div> isPending && Spinner />> button onClick=handleClick>>count>button> div> ); >Note:
Updates in a transition yield to more urgent updates such as clicks.
Updates in a transition will not show a fallback for re-suspended content. This allows the user to continue interacting with the current content while rendering the update.
This content is out of date.
Read the new React documentation for useId .
const id = useId();useId is a hook for generating unique IDs that are stable across the server and client, while avoiding hydration mismatches.
Note
useId is not for generating keys in a list. Keys should be generated from your data.
For a basic example, pass the id directly to the elements that need it:
function Checkbox() const id = useId(); return ( > label htmlFor=id>>Do you like React?label> input id=id> type="checkbox" name="react"/> > ); >;For multiple IDs in the same component, append a suffix using the same id :
function NameFields() const id = useId(); return ( div> label htmlFor=id + '-firstName'>>First Namelabel> div> input id=id + '-firstName'> type="text" /> div> label htmlFor=id + '-lastName'>>Last Namelabel> div> input id=id + '-lastName'> type="text" /> div> div> ); >Note:
useId generates a string that includes the : token. This helps ensure that the token is unique, but is not supported in CSS selectors or APIs like querySelectorAll .
useId supports an identifierPrefix to prevent collisions in multi-root apps. To configure, see the options for hydrateRoot and ReactDOMServer .
The following Hooks are provided for library authors to integrate libraries deeply into the React model, and are not typically used in application code.
This content is out of date.
Read the new React documentation for useSyncExternalStore .
const state = useSyncExternalStore(subscribe, getSnapshot[, getServerSnapshot]);useSyncExternalStore is a hook recommended for reading and subscribing from external data sources in a way that’s compatible with concurrent rendering features like selective hydration and time slicing.
This method returns the value of the store and accepts three arguments:
- subscribe : function to register a callback that is called whenever the store changes.
- getSnapshot : function that returns the current value of the store.
- getServerSnapshot : function that returns the snapshot used during server rendering.
The most basic example simply subscribes to the entire store:
const state = useSyncExternalStore(store.subscribe, store.getSnapshot);However, you can also subscribe to a specific field:
const selectedField = useSyncExternalStore( store.subscribe, () => store.getSnapshot().selectedField, );When server rendering, you must serialize the store value used on the server, and provide it to useSyncExternalStore . React will use this snapshot during hydration to prevent server mismatches:
const selectedField = useSyncExternalStore( store.subscribe, () => store.getSnapshot().selectedField, () => INITIAL_SERVER_SNAPSHOT.selectedField, );Note:
getSnapshot must return a cached value. If getSnapshot is called multiple times in a row, it must return the same exact value unless there was a store update in between.
A shim is provided for supporting multiple React versions published as use-sync-external-store/shim . This shim will prefer useSyncExternalStore when available, and fallback to a user-space implementation when it’s not.
As a convenience, we also provide a version of the API with automatic support for memoizing the result of getSnapshot published as use-sync-external-store/with-selector .
This content is out of date.
Read the new React documentation for useInsertionEffect .
useInsertionEffect(didUpdate);The signature is identical to useEffect , but it fires synchronously before all DOM mutations. Use this to inject styles into the DOM before reading layout in useLayoutEffect . Since this hook is limited in scope, this hook does not have access to refs and cannot schedule updates.
Note:
useInsertionEffect should be limited to css-in-js library authors. Prefer useEffect or useLayoutEffect instead.
Дерево
Дерево – структура данных, представляющая собой древовидную структуру в виде набора связанных узлов.
Бинарное дерево — это конечное множество элементов, которое либо пусто, либо содержит элемент ( корень ), связанный с двумя различными бинарными деревьями, называемыми левым и правым поддеревьями . Каждый элемент бинарного дерева называется узлом . Связи между узлами дерева называются его ветвями .

Способ представления бинарного дерева:
- A — корень дерева
- В — корень левого поддерева
- С — корень правого поддерева
Корень дерева расположен на уровне с минимальным значением.
Узел D , который находится непосредственно под узлом B , называется потомком B . Если D находится на уровне i , то B – на уровне i-1 . Узел B называется предком D .
Максимальный уровень какого-либо элемента дерева называется его глубиной или высотой .
Если элемент не имеет потомков, он называется листом или терминальным узлом дерева.
Остальные элементы – внутренние узлы (узлы ветвления).
Число потомков внутреннего узла называется его степенью . Максимальная степень всех узлов есть степень дерева.
Число ветвей, которое нужно пройти от корня к узлу x , называется длиной пути к x . Корень имеет длину пути равную 0 ; узел на уровне i имеет длину пути равную i .
Бинарное дерево применяется в тех случаях, когда в каждой точке вычислительного процесса должно быть принято одно из двух возможных решений.
Имеется много задач, которые можно выполнять на дереве.
Распространенная задача — выполнение заданной операции p с каждым элементом дерева. Здесь p рассматривается как параметр более общей задачи посещения всех узлов или задачи обхода дерева.
Если рассматривать задачу как единый последовательный процесс, то отдельные узлы посещаются в определенном порядке и могут считаться расположенными линейно.
Способы обхода дерева
Пусть имеем дерево, где A — корень, B и C — левое и правое поддеревья.

Существует три способа обхода дерева:
- Обход дерева сверху вниз (в прямом порядке): A, B, C — префиксная форма.
- Обход дерева в симметричном порядке (слева направо): B, A, C — инфиксная форма.
- Обход дерева в обратном порядке (снизу вверх): B, C, A — постфиксная форма.
Реализация дерева
Узел дерева можно описать как структуру:
struct tnode <
int field; // поле данных
struct tnode *left; // левый потомок
struct tnode *right; // правый потомок
>;
При этом обход дерева в префиксной форме будет иметь вид
void treeprint(tnode *tree) <
if (tree!= NULL ) < //Пока не встретится пустой узел
cout field; //Отображаем корень дерева
treeprint(tree->left); //Рекурсивная функция для левого поддерева
treeprint(tree->right); //Рекурсивная функция для правого поддерева
>
>
Обход дерева в инфиксной форме будет иметь вид
void treeprint(tnode *tree) <
if (tree!= NULL ) < //Пока не встретится пустой узел
treeprint(tree->left); //Рекурсивная функция для левого поддерева
cout field; //Отображаем корень дерева
treeprint(tree->right); //Рекурсивная функция для правого поддерева
>
>
Обход дерева в постфиксной форме будет иметь вид
void treeprint(tnode *tree) <
if (tree!= NULL ) < //Пока не встретится пустой узел
treeprint(tree->left); //Рекурсивная функция для левого поддерева
treeprint(tree->right); //Рекурсивная функция для правого поддерева
cout field; //Отображаем корень дерева
>
>
Бинарное (двоичное) дерево поиска – это бинарное дерево, для которого выполняются следующие дополнительные условия (свойства дерева поиска):
- оба поддерева – левое и правое, являются двоичными деревьями поиска;
- у всех узлов левого поддерева произвольного узла X значения ключей данных меньше, чем значение ключа данных самого узла X ;
- у всех узлов правого поддерева произвольного узла X значения ключей данных не меньше, чем значение ключа данных узла X .
Данные в каждом узле должны обладать ключами, на которых определена операция сравнения меньше.
Как правило, информация, представляющая каждый узел, является записью, а не единственным полем данных.
Для составления бинарного дерева поиска рассмотрим функцию добавления узла в дерево.
Добавление узлов в дерево
1
2
3
4
5
6
7
8
9
10
11
12
struct tnode * addnode( int x, tnode *tree) <
if (tree == NULL ) < // Если дерева нет, то формируем корень
tree = new tnode; // память под узел
tree->field = x; // поле данных
tree->left = NULL ;
tree->right = NULL ; // ветви инициализируем пустотой
> else if (x < tree->field) // условие добавление левого потомка
tree->left = addnode(x,tree->left);
else // условие добавление правого потомка
tree->right = addnode(x,tree->right);
return (tree);
>
Удаление поддерева
void freemem(tnode *tree) <
if (tree!= NULL ) <
freemem(tree->left);
freemem(tree->right);
delete tree;
>
>
Пример Написать программу, подсчитывающую частоту встречаемости слов входного потока.
Поскольку список слов заранее не известен, мы не можем предварительно упорядочить его. Неразумно пользоваться линейным поиском каждого полученного слова, чтобы определять, встречалось оно ранее или нет, т.к. в этом случае программа работает слишком медленно.
Один из способов — постоянно поддерживать упорядоченность уже полученных слов, помещая каждое новое слово в такое место, чтобы не нарушалась имеющаяся упорядоченность. Воспользуемся бинарным деревом.
В дереве каждый узел содержит:
- указатель на текст слова;
- счетчик числа встречаемости;
- указатель на левого потомка;
- указатель на правого потомка.
Рассмотрим выполнение программы на примере фразы
now is the time for all good men to come to the aid of their party

При этом дерево будет иметь следующий вид
#include
#include
#include
#include
//#include
#define MAX WORD 100
struct tnode < // узел дерева
char * word; // указатель на строку (слово)
int count; // число вхождений
struct tnode* left; // левый потомок
struct tnode* right; // правый потомок
>;
// Функция добавления узла к дереву
struct tnode* addtree( struct tnode* p, char * w) int cond;
if (p == NULL ) p = ( struct tnode*)malloc( sizeof ( struct tnode));
p->word = _strdup(w);
p->count = 1;
p->left = p->right = NULL ;
>
else if ((cond = strcmp(w, p->word)) == 0)
p->count++;
else if (cond < 0)
p->left = addtree(p->left, w);
else
p->right = addtree(p->right, w);
return p;
>
// Функция удаления поддерева
void freemem(tnode* tree) if (tree != NULL ) freemem(tree->left);
freemem(tree->right);
free(tree->word);
free(tree);
>
>
// Функция вывода дерева
void treeprint( struct tnode* p) if (p != NULL ) treeprint(p->left);
printf( «%d %s\n» , p->count, p->word);
treeprint(p->right);
>
>
int main() struct tnode* root;
char word[MAX WORD ];
root = NULL ;
do scanf_s( «%s» , word, MAX WORD );
if (isalpha(word[0]))
root = addtree(root, word);
> while (word[0] != ‘0’ ); // условие выхода – ввод символа ‘0’
treeprint(root);
freemem(root);
getchar();
getchar();
return 0;
>

Результат выполнения
Комментариев к записи: 19
Дерево поиска, наивная реализация
Бинарное дерево поиска (англ. binary search tree, BST) — структура данных для работы с упорядоченными множествами.
Бинарное дерево поиска обладает следующим свойством: если [math]x[/math] — узел бинарного дерева с ключом [math]k[/math] , то все узлы в левом поддереве должны иметь ключи, меньшие [math]k[/math] , а в правом поддереве большие [math]k[/math] .
Операции в бинарном дереве поиска
Для представления бинарного дерева поиска в памяти будем использовать следующую структуру:
struct Node: T key // ключ узла Node left // указатель на левого потомка Node right // указатель на правого потомка Node parent // указатель на предка
Обход дерева поиска
Есть три операции обхода узлов дерева, отличающиеся порядком обхода узлов:
- [math]\mathrm[/math] — обход узлов в отсортированном порядке,
- [math]\mathrm[/math] — обход узлов в порядке: вершина, левое поддерево, правое поддерево,
- [math]\mathrm[/math] — обход узлов в порядке: левое поддерево, правое поддерево, вершина.
func inorderTraversal(x : Node): if x != null inorderTraversal(x.left) print x.key inorderTraversal(x.right)
При выполнении данного обхода вершины будут выведены в следующем порядке: 1 3 4 6 7 8 10 13 14.
func preorderTraversal(x : Node) if x != null print x.key preorderTraversal(x.left) preorderTraversal(x.right)
При выполнении данного обхода вершины будут выведены в следующем порядке: 8 3 1 6 4 7 10 14 13.
func postorderTraversal(x : Node) if x != null postorderTraversal(x.left) postorderTraversal(x.right) print x.key
При выполнении данного обхода вершины будут выведены в следующем порядке: 1 4 7 6 3 13 14 10 8.
Данные алгоритмы выполняют обход за время [math]O(n)[/math] , поскольку процедура вызывается ровно два раза для каждого узла дерева.
Поиск элемента
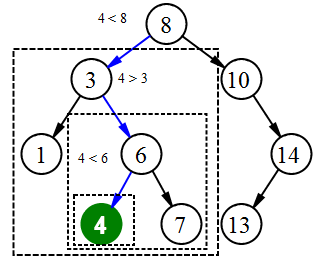
Поиск элемента 4
Для поиска элемента в бинарном дереве поиска можно воспользоваться следующей функцией, которая принимает в качестве параметров корень дерева и искомый ключ. Для каждого узла функция сравнивает значение его ключа с искомым ключом. Если ключи одинаковы, то функция возвращает текущий узел, в противном случае функция вызывается рекурсивно для левого или правого поддерева. Узлы, которые посещает функция образуют нисходящий путь от корня, так что время ее работы [math]O(h)[/math] , где [math]h[/math] — высота дерева.
Node search(x : Node, k : T): if x == null or k == x.key return x if k < x.key return search(x.left, k) else return search(x.right, k)
Поиск минимума и максимума
Чтобы найти минимальный элемент в бинарном дереве поиска, необходимо просто следовать указателям [math]left[/math] от корня дерева, пока не встретится значение [math]null[/math] . Если у вершины есть левое поддерево, то по свойству бинарного дерева поиска в нем хранятся все элементы с меньшим ключом. Если его нет, значит эта вершина и есть минимальная. Аналогично ищется и максимальный элемент. Для этого нужно следовать правым указателям.
Node minimum(x : Node): if x.left == null return x return minimum(x.left)
Node maximum(x : Node): if x.right == null return x return maximum(x.right)
Данные функции принимают корень поддерева, и возвращают минимальный (максимальный) элемент в поддереве. Обе процедуры выполняются за время [math]O(h)[/math] .
Поиск следующего и предыдущего элемента
Реализация с использованием информации о родителе
Если у узла есть правое поддерево, то следующий за ним элемент будет минимальным элементом в этом поддереве. Если у него нет правого поддерева, то нужно следовать вверх, пока не встретим узел, который является левым дочерним узлом своего родителя. Поиск предыдущего выполнятся аналогично. Если у узла есть левое поддерево, то предыдущий ему элемент будет максимальным элементом в этом поддереве. Если у него нет левого поддерева, то нужно следовать вверх, пока не встретим узел, который является правым дочерним узлом своего родителя.
Node next(x : Node): if x.right != null return minimum(x.right) y = x.parent while y != null and x == y.right x = y y = y.parent return y
Node prev(x : Node): if x.left != null return maximum(x.left) y = x.parent while y != null and x == y.left x = y y = y.parent return y
Обе операции выполняются за время [math]O(h)[/math] .
Реализация без использования информации о родителе
Рассмотрим поиск следующего элемента для некоторого ключа [math]x[/math] . Поиск будем начинать с корня дерева, храня текущий узел [math]current[/math] и узел [math]successor[/math] , последний посещенный узел, ключ которого больше [math]x[/math] .
Спускаемся вниз по дереву, как в алгоритме поиска узла. Рассмотрим ключ текущего узла [math]current[/math] . Если [math]current.key \leqslant x[/math] , значит следующий за [math]x[/math] узел находится в правом поддереве (в левом поддереве все ключи меньше [math]current.key[/math] ). Если же [math]x \lt current.key[/math] , то [math]x \lt next(x) \leqslant current.key[/math] , поэтому [math]current[/math] может быть следующим для ключа [math]x[/math] , либо следующий узел содержится в левом поддереве [math]current[/math] . Перейдем к нужному поддереву и повторим те же самые действия.
Аналогично реализуется операция поиска предыдущего элемента.
Node next(x : T): Node current = root, successor = null // root — корень дерева while current != null if current.key > x successor = current current = current.left else current = current.right return successor
Вставка
Операция вставки работает аналогично поиску элемента, только при обнаружении у элемента отсутствия ребенка нужно подвесить на него вставляемый элемент.
Реализация с использованием информации о родителе
func insert(x : Node, z : Node): // x — корень поддерева, z — вставляемый элемент while x != null if z.key > x.key if x.right != null x = x.right else z.parent = x x.right = z break else if z.key < x.key if x.left != null x = x.left else z.parent = x x.left = z break
Реализация без использования информации о родителе
Node insert(x : Node, z : T): // x — корень поддерева, z — вставляемый ключ if x == null return Node(z) // подвесим Node с key = z else if z < x.key x.left = insert(x.left, z) else if z > x.key x.right = insert(x.right, z) return x
Время работы алгоритма для обеих реализаций — [math]O(h)[/math] .
Удаление
Нерекурсивная реализация
Для удаления узла из бинарного дерева поиска нужно рассмотреть три возможные ситуации. Если у узла нет дочерних узлов, то у его родителя нужно просто заменить указатель на [math]null[/math] . Если у узла есть только один дочерний узел, то нужно создать новую связь между родителем удаляемого узла и его дочерним узлом. Наконец, если у узла два дочерних узла, то нужно найти следующий за ним элемент (у этого элемента не будет левого потомка), его правого потомка подвесить на место найденного элемента, а удаляемый узел заменить найденным узлом. Таким образом, свойство бинарного дерева поиска не будет нарушено. Данная реализация удаления не увеличивает высоту дерева. Время работы алгоритма — [math]O(h)[/math] .
| Случай | Иллюстрация |
|---|---|
| Удаление листа | 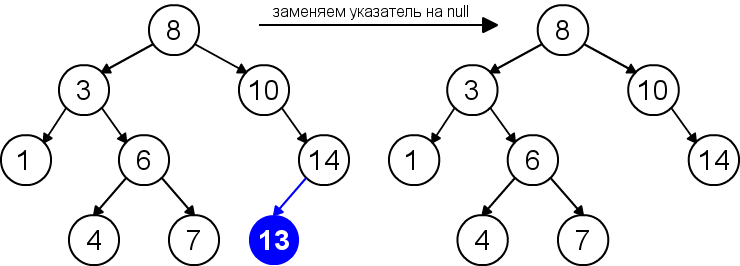 |
| Удаление узла с одним дочерним узлом | 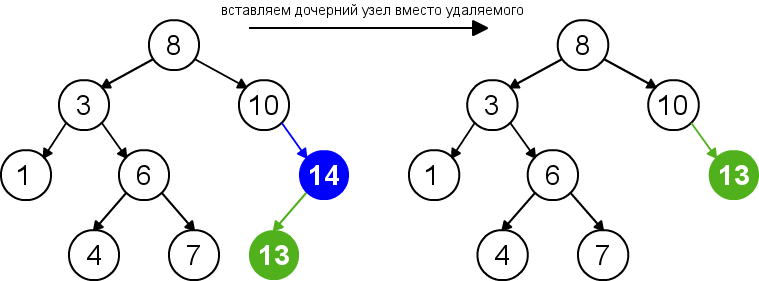 |
| Удаление узла с двумя дочерними узлами | 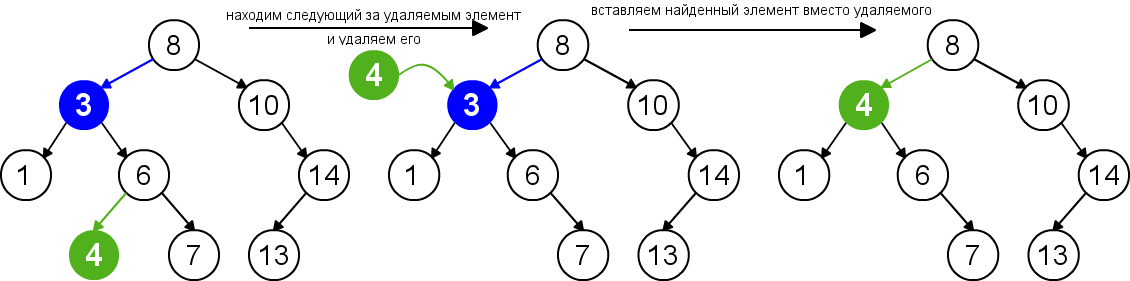 |
func delete(t : Node, v : Node): // — дерево, — удаляемый элемент p = v.parent // предок удаляемого элемента if v.left == null and v.right == null // первый случай: удаляемый элемент - лист if p.left == v p.left = null if p.right == v p.right = null else if v.left == null or v.right == null // второй случай: удаляемый элемент имеет одного потомка if v.left == null if p.left == v p.left = v.right else p.right = v.right v.right.parent = p else if p.left == v p.left = v.left else p.right = v.left v.left.parent = p else // третий случай: удаляемый элемент имеет двух потомков successor = next(v, t) v.key = successor.key if successor.parent.left == successor successor.parent.left = successor.right if successor.right != null successor.right.parent = successor.parent else successor.parent.right = successor.right if successor.right != null successor.right.parent = successor.parent
Рекурсивная реализация
При рекурсивном удалении узла из бинарного дерева нужно рассмотреть три случая: удаляемый элемент находится в левом поддереве текущего поддерева, удаляемый элемент находится в правом поддереве или удаляемый элемент находится в корне. В двух первых случаях нужно рекурсивно удалить элемент из нужного поддерева. Если удаляемый элемент находится в корне текущего поддерева и имеет два дочерних узла, то нужно заменить его минимальным элементом из правого поддерева и рекурсивно удалить этот минимальный элемент из правого поддерева. Иначе, если удаляемый элемент имеет один дочерний узел, нужно заменить его потомком. Время работы алгоритма — [math]O(h)[/math] . Рекурсивная функция, возвращающая дерево с удаленным элементом [math]z[/math] :
Node delete(root : Node, z : T): // корень поддерева, удаляемый ключ if root == null return root if z < root.key root.left = delete(root.left, z) else if z > root.key root.right = delete(root.right, z) else if root.left != null and root.right != null root.key = minimum(root.right).key root.right = delete(root.right, root.key) else if root.left != null root = root.left else if root.right != null root = root.right else root = null return root
Задачи о бинарном дереве поиска
Проверка того, что заданное дерево является деревом поиска
| Задача: |
| Определить, является ли заданное двоичное дерево деревом поиска. |
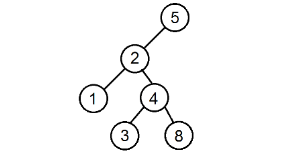
Пример дерева, для которого недостаточно проверки лишь его соседних вершин
Для того чтобы решить эту задачу, применим обход в глубину. Запустим от корня рекурсивную логическую функцию, которая выведет [math]\mathtt[/math] , если дерево является BST и [math]\mathtt[/math] в противном случае. Чтобы дерево не являлось BST, в нём должна быть хотя бы одна вершина, которая не попадает под определение дерева поиска. То есть достаточно найти всего одну такую вершину, чтобы выйти из рекурсии и вернуть значение [math]\mathtt[/math] . Если же, дойдя до листьев, функция не встретит на своём пути такие вершины, она вернёт значение [math]\mathtt[/math] .
Функция принимает на вход исследуемую вершину, а также два значения: [math]\mathtt[/math] и [math]\mathtt[/math] , которые до вызова функции равнялись [math] \infty [/math] и [math] -\infty [/math] соответственно, где [math] \infty [/math] — очень большое число, т.е. ни один ключ дерева не превосходит его по модулю. Казалось бы, два последних параметра не нужны. Но без них программа может выдать неверный ответ, так как сравнения только вершины и её детей недостаточно. Необходимо также помнить, в каком поддереве для более старших предков мы находимся. Например, в этом дереве вершина с номером [math]8[/math] находится левее вершины, в которой лежит [math]5[/math] , чего не должно быть в дереве поиска, однако после проверки функция бы вернула [math]\mathtt[/math] .
bool isBinarySearchTree(root: Node): // Здесь root — корень заданного двоичного дерева. bool check(v : Node, min: T, max: T): // min и max — минимально и максимально допустимые значения в вершинах поддерева. if v == null return true if v.key or max return false return check(v.left, min, v.key) and check(v.right, v.key, max) return check(root, , )
Время работы алгоритма — [math]O(n)[/math] , где [math]n[/math] — количество вершин в дереве.
Задачи на поиск максимального BST в заданном двоичном дереве
| Задача: |
| Найти в данном дереве такую вершину, что она будет корнем поддерева поиска с наибольшим количеством вершин. |
Если мы будем приведённым выше способом проверять каждую вершину, мы справимся с задачей за [math]O(n^2)[/math] . Но её можно решить за [math]O(n)[/math] , идя от корня и проверяя все вершины по одному разу, основываясь на следующих фактах:
- Значение в вершине больше максимума в её левом поддереве;
- Значение в вершине меньше минимума в её правом поддереве;
- Левое и правое поддерево являются деревьями поиска.
Введём [math]\mathtt[/math] и [math]\mathtt[/math] , которые будут хранить минимум в левом поддереве вершины и максимум в правом. Тогда мы должны будем проверить, являются ли эти поддеревья деревьями поиска и, если да, лежит ли ключ вершины [math]\mathtt[/math] между этими значениями [math]\mathtt[/math] и [math]\mathtt[/math] . Если вершина является листом, она автоматически становится деревом поиска, а её ключ — минимумом или максимумом для её родителя (в зависимости от расположения вершины). Функция [math]\mathtt[/math] записывает в [math]\mathtt[/math] количество вершин в дереве, если оно является деревом поиска или [math]\mathtt[/math] в противном случае. После выполнения функции ищем за линейное время вершину с наибольшим значением [math]\mathtt[/math] .
int count(root: Node): // root — корень заданного двоичного дерева. int cnt(v: Node): if v == null v.kol = 0 return = 0 if cnt(v.left) != -1 and cnt(v.right) != -1 if v.left == null and v.right == null v.min = v.key v.max = v.key v.kol = 1 return 1 if v.left == null if v.right.max > v.key v.min = v.key v.kol = cnt(v.right) + 1 return v.kol if v.right == null if v.left.min < v.key v.max = v.key v.kol = cnt(v.left) + 1 return v.kol if v.left.min < v.key and v.right.max > v.key v.min = v.left.min v.max = v.right.max v.kol = v.left.kol + v.right.kol + 1 v.kol = cnt(v.left) + cnt(v.right) + 1 return v.kol return -1 return cnt(root)
Алгоритм работает за [math]O(n)[/math] , так как мы прошлись по дереву два раза за время, равное количеству вершин.
Восстановление дерева по результату обхода preorderTraversal
| Задача: |
| Восстановить дерево по последовательности, выведенной после выполнения процедуры [math]\mathrm[/math] . |
Восстановление дерева поиска по последовательности ключей
Как мы помним, процедура [math]\mathrm[/math] выводит значения в узлах поддерева следующим образом: сначала идёт до упора влево, затем на каком-то моменте делает шаг вправо и снова движется влево. Это продолжается до тех пор, пока не будут выведены все вершины. Полученная последовательность позволит нам однозначно определить расположение всех узлов поддерева. Первая вершина всегда будет в корне. Затем, пока не будут использованы все значения, будем последовательно подвешивать левых сыновей к последней добавленной вершине, пока не найдём номер, нарушающий убывающую последовательность, а для каждого такого номера будем искать вершину без правого потомка, хранящую наибольшее значение, не превосходящее того, которое хотим поставить, и подвешиваем к ней элемент с таким номером в качестве правого сына. Когда мы, желая найти такую вершину, встречаем какую-нибудь другую, уже имеющую правого сына, проходим по ветке вправо. Мы имеем на это право, так как если такая вершина стоит, то процедура обхода в ней уже побывала и поворачивала вправо, поэтому спускаться в другую сторону смысла не имеет. Вершину с максимальным ключом, с которой будем начинать поиск, будем запоминать. Она будет обновляться каждый раз, когда появится новый максимум.
Процедура восстановления дерева работает за [math]O(n)[/math] .
Разберём алгоритм на примере последовательности [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] [math]\mathtt[/math] .
Будем выделять красным цветом вершины, рассматриваемые на каждом шаге, чёрным жирным — их родителей, курсивом — убывающие подпоследовательности (в случаях, когда мы их рассматриваем) или претендентов на добавление к ним правого ребёнка (когда рассматривается вершина, нарушающая убывающую последовательность).
См. также
- Поисковые структуры данных
- Рандомизированное бинарное дерево поиска
- Красно-черное дерево
- АВЛ-дерево
Источники информации
- Википедия — Двоичное дерево поиска
- Wikipedia — Binary search tree
- Кормен, Т., Лейзерсон, Ч., Ривест, Р., Штайн, К. Алгоритмы: построение и анализ = Introduction to Algorithms / Под ред. И. В. Красикова. — 2-е изд. — М.: Вильямс, 2005. — 1296 с. — ISBN 5-8459-0857-4