11.3. Словари (map).
Словари предназначены для хранения произвольного количества элементов, в виде пар «ключ-значение». Причем к «ключам» предъявляется требование уникальности. Словари обладают широкими возможностями доступа к произвольным элементам и незначительными накладными расходами на операцию добавления нового элемента. Если в словарь вставляется новое значение по существующему ключу, то оно затирает старое значение в паре «ключ-значение».
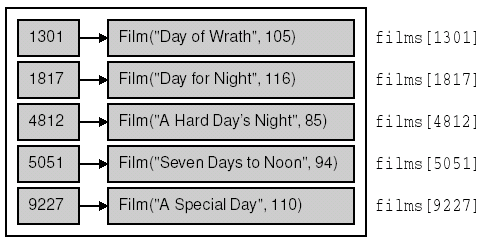
Рисунок 11.3. Словарь экземпляров класса Film.
Поскольку словари хранят элементы в виде «ключ-значение», то принципы работы со словарями несколько отличаются от тех, что используются при работе со списками и векторами. Ниже приводится версия класса Film, которая будет использоваться для иллюстрации работы со словарем:
class Film < public: Film(const QString &title = "", int duration = 0); QString title() const < return myTitle; >void setTitle(const QString &title) < myTitle = title; >int duration() const < return myDuration; >void setDuration(int minutes) < myDuration = minutes; >private: QString myTitle; int myDuration; >; Film::Film(const QString &title, int duration)
В этой версии отсутствует числовой идентификатор фильма, поскольку теперь он будет использоваться в качестве «ключа» в словаре. Кроме того, здесь отсутствуют операторы сравнения — словари изначально упорядочивают элементы по ключу, но не по значению.
Класс словаря в STL определен под именем std::map , в файле заголовка . Ниже приводится пример объявления словаря, с целыми значениями в качестве ключей и Film -- в качестве значения:
map films;
Эквивалент в Qt -- QMap :
QMap films;
Наиболее естесственный способ заполнения словарей -- присваивать значение по заданному ключу:
films[4812] = Film("A Hard Day's Night", 85); films[5051] = Film("Seven Days to Noon", 94); films[1301] = Film("Day of Wrath", 105); films[9227] = Film("A Special Day", 110); films[1817] = Film("Day for Night", 116);
Итератор словаря предоставляет возможность доступа к паре "ключ-значение". Ключ извлекается с помощью (*it).first, а значение -- (*it).second:
map::const_iterator it = films.begin(); while (it != films.end())
Большинство компиляторов допускают запись в виде it->first и it->second, но более переносимый вариант, все таки: (*it).first и (*it).second.
Итераторы словарей в Qt несколько отличаются от итераторов словарей в STL. В Qt ключ можно получить с помощью it.key(), а значение -- it.data():
QMap::const_iterator it = films.begin(); while (it != films.end())
При обходе словаря в цикле, элементы словаря всегда упорядочены по значению ключа.
Для доступа к значениям словаря и их изменения может использоваться оператор "[ ]", однако, при попытке получить значение по несуществующему в словаре ключу, будет создан новый элемент словаря с заданным ключом и пустым значением. Чтобы избежать случайного создания пустых элементов, используйте функцию find(), чтобы получить искомый элемент:
map::const_iterator it = films.find(1817); if (it != films.end()) cerrЭта функция вернет итератор end(), если ключ отсутствует в словаре.
В примере выше, в качестве ключа использовались целые числа, однако, для этих целей могут использоваться и другие типы. Наиболее популярный -- QString, например:
map actorToNationality; actorToNationality["Doris Day"] = "American"; actorToNationality["Greta Garbo"] = "Swedish";Если необходимо хранить несколько значений с одинаковыми ключами, используйте multimap . Если необходимо хранить одни только ключи, используйте set или multiset . Qt не имеет классов, эквивалентных приведенным.
Класс QMap имеет несколько дополнительных функций, особенно удобных при работе с небольшими наборами данных. Функции QMap::keys() и QMap::values() возвращают списки QValueList ключей и значений словаря.
| Пред. | В начало | След. |
| Списки. | На уровень выше | Контейнеры указателей. |
Что такое словарь map
Карта или std::map представляет контейнер, где каждое значение ассоциировано с определенным ключом. И по этому ключу можно получить элемент. Причем ключи могут иметь только уникальные значения. Примером такого контейнера может служить словарь, где каждому слову сопоставляется его перевод или объяснение. Поэтому такие структуры еще называют словарями.
Стандартная библиотека C++ предоставляет два типа словарей: std::map и std::unordered_map . Эти типы представляют шаблоны, которые типизируются двумя типами. Первый тип - Key задает тип для ключей, а второй тип - Value устанавливает тип для значений.
Тип std::map определен в заголовочном файле . Определение пустого словаря:
#include #include int main() < std::mapproducts; >
Здесь определен словарь products, который будет условно хранить цену товаров. Для ключей будет применяться тип std::string , а для значений - числа типа unsigned (условно в качестве ключа будет выступать название товара, а в качестве значения - его цена).
Обращение к элементам
Для обращения к элементам словаря - получения или изменения их значений, так же, как в массиве или векторе, применяется оператора индексирования [] . Только вместо целочисленных индексов можно использовать ключи любого типа в следующем виде:
map[ключ]=значение
#include #include int main() < std::mapproducts; // установка значений products["bread"] = 30; products["milk"] = 80; products["apple"] = 60; // получение значений std::cout
Здесь определен словарь products, в котором ключами служат строки, а значениями - числа типа unsigned. Поэтому для установки элемента в квадратные скобки передается ключ-строка, а присваивается значение-число:
products["bread"] = 30;
Будем считать, что ключ - название товара, а значение - цена товара. То есть в данном случае элементу с ключом "bread" присваивается значение 30. При этом не важно, что ранее создан пустой словарь, и в нем нет никакого элемента с ключом "bread" - если его нет, то он создается. Если же элемент с данным ключом уже есть, то меняется его значение.
Чтобы получить элемент по определенному ключу, используем тот же синтаксис. Например, поскольку значение элемента - число, то мы можем, обратившись по ключу, получить это число:
unsigned breadPrice = products["bread"];
В выше приведенной программе просто выводим значения элементов на консоль:
bread 30 milk 80 apple 60
Перебор элементов:
Для перебора элементов можно применять цикл for в стиле "for-each":
#include #include int main() < std::mapproducts; // установка значений products["bread"] = 30; products["milk"] = 80; products["apple"] = 60; for (const auto& [product, price] : products) std::cout
Рассмотрим определение цикла. Каждый элемент словаря фактически представляет объект типа std::pair , который хранит, как ключ, так и значение. В нашем случае это объект std::pair . И с помощью полей first и second данного объекта мы могли бы получить соответственно ключ и значение элемента:
for (const auto& element : products) std::coutНо начиная со стандарта С++17 также можно использовать другой синтаксис, который позволяет сразу разложить объект на отдельные части - ключ и значение:
for (const auto& [product, price] : products) std::coutВ данном случае в product будет помещаться ключ, а в price - значение элемента словаря. В итоге при выполнении программы мы получим следующий консольный вывод:
apple 60 bread 30 milk 80Обратите внимание, что элементы располагаются в словаре и соответственно выводятся на консоль по возрастанию ключей. Поскольку ключи представляют строки, то они сортируются в алфавитном порядке.
Инициализация элементов
Тот факт, что в словаре элементы представляют тип std::pair, позволяет инициализировать словарь объектами std::pair:
#include #include int main() < std::mapproducts < std::pair, std::pair, std::pair >; >И даже можно сократить определение:
#include #include int main() < std::mapproducts < , , >; >Удаление элементов
Как было показано выше, для добавления элемента в словарь достаточно просто установить для некоторого ключа какой-нибудь значение. Для удаления же элементов применяется функция erase() , в которую передается ключ удаляемого элемента:
#include #include int main() < std::mapproducts < , , >; products.erase("milk"); // удаляем элемент с ключом "milk" for (const auto& [product, price] : products) std::coutРазмер словаря
Для получения количества элементов в словаре применяется функция size() . Также класс map имеет функцию empty() , которая возвращает true , если словарь пуст.
#include #include int main() < std::mapproducts < , , >; std::coutПроверка наличия элемента
Чтобы проверить, есть ли в словаре элемент с определенным ключом, применяются функции count() (возвращает 1, если элемент есть, и 0 - если отсутствует) и contains() (возвращает true, если элемент есть, и false - если отсутствует). В обе функции передается ключ элемента:
#include #include int main() < std::mapproducts < std::pair, std::pair, std::pair >; std::coutНеупорядоченные словари
Тип std::map определяет словарь, который упорядочиваниет все свои элементы - по умолчанию в порядке возрастания ключей. Если упорядоченность не нужна, можно применять ти std::unordered_map , который в целом предоставляет тот же самый функционал, только не упорядочивает элементы и определен в заголовочном файле
#include #include int main() < std::unordered_mapproducts < std::pair, std::pair, std::pair >; for (const auto& [product, price] : products) std::cout
apple 60 milk 80 bread 30Итераторы
Стоит отметить, что итераторы типа std::map являеются константными, что не позволяет изменять значения элементов при переборе:
#include #include int main() < std::mapphoneBook < , , >; for(auto iter; iter != phoneBook.end(); iter++) < std::cout first << "\t" second // для получения итераторов также можно использовать функции cbegin и cend for(auto iter; iter != phoneBook.cend(); iter++) < std::cout first << "\t" second >Коллекции
Этот раздел содержит обзор коллекций Set и словарей Map (en-US) - встроенных структур данных с доступом по ключу.
Словари
Тип Map
Map (en-US) - реализация простого ассоциативного массива (словаря). Он содержит данные в виде набора пар ключ/значение(ключи уникальны) и предоставляет методы для доступа и манипулирования этими данными.
Также как и объект, словарь позволяет
- получать значение по ключу, а также проверять наличие ключа
- добавлять/удалять пары ключ/значение
- перезаписывать значение по ключу (ключи уникальны).
- итерироваться по ключам
Словари, как специализированная структура данных, имеют существенные преимущества по сравнению с объектами:
- Ключи словаря могут быть любого типа (а не только строки).
- Словарь хранит свой размер (не надо вычислять).
- Натуральный порядок обхода элементов ( в порядке добавления) с помощью for. of .
- Словарь не подмешивает ключи из прототипа (в отличие от объекта).
В следующем примере приведены основные операции со словарём:
var sayings = new Map(); sayings.set("dog", "woof"); sayings.set("cat", "meow").set("elephant", "toot"); //вызов функции .set возвращает Map, поэтому set можно объединять в цепочки sayings.set("dog", "гав-гав"); // заменить значение по ключу sayings.size; // 3 sayings.get("fox"); // undefined sayings.has("bird"); // false sayings.delete("dog"); for (var [key, value] of sayings) console.log(key + " goes " + value); > // "cat goes meow" // "elephant goes toot"
Больше примеров и полное описание на странице справочника Map (en-US) .
Тип WeakMap
WeakMap это специальный вид словаря, ключами которого могут быть только объекты, причём ссылки на них в WeakMap являются слабыми (не учитываются сборщиком мусора (garbage collector GC)).
Примечание: Интерфейс WeakMap совпадает с Map , единственное отличие - ключи WeakMap нельзя итерировать (т.e. нельзя получить список ключей). Это понятно, поскольку в таком случае возникла бы неопределённость с достоверностью этого списка в зависимости от состояния garbage collection.
Больше примеров, полное описание, а также обсуждение "Зачем WeakMap?" на странице справочника WeakMap .
Отметим, что WeakMap, в частности, может элегантно использоваться для упаковки приватных данных или деталей реализации. Следующий пример из статьи Nick Fitzgerald "Hiding Implementation Details with ECMAScript 6 WeakMaps". Приватная часть сохраняется как значение в privates и имеет время жизни такое же как и сущность класса. Сам класс и его методы публичны; прочее недоступно извне модуля:
const privates = new WeakMap(); export class Public() constructor() const me = // Приватные данные идут здесь >; // 'me' будет освобождён вместе с 'this' . privates.set(this, me); > method () const me = privates.get(this); // Сделайте что-нибудь с приватными данными в 'me'. > >
Коллекции
Тип Set
Set реализация коллекции - структура данных, которая содержит список уникальных элементов в порядке их добавления.
В следующем примере приведены основные операции по работе с коллекцией Set:
var mySet = new Set(); mySet.add(1); mySet.add("some text"); mySet.add("foo"); mySet.has(1); // true mySet.delete("foo"); mySet.size; // 2 for (let item of mySet) console.log(item); // 1 // "some text"
Больше примеров и полное описание на странице справочника Set
Преобразования между Array и Set
Можно создать Array из Set с помощью Array.from или используя spread operator.
В свою очередь, конструктор Set может принимать Array в качестве аргумента.
Примечание: Поскольку Set структура работает с уникальными значениями, любые повторяющиеся элементы из Array будут проигнорированы.
.from(mySet); [. mySet2]; mySet2 = new Set([1, 2, 3, 4]);
Сравнение Array и Set
Словари, как специализированная структура данных, имеют существенные отличия по сравнению с массивами:
- Set.has работает быстрее чем Array.indexOf .
- можно удалять элементы по значению (а не по индексу как массивах).
- NaN обрабатывается корректно.
- поддерживается уникальность значений.
Тип WeakSet
WeakSet это специальный вид коллекции, элементами которой могут быть только объекты. Ссылки на эти объекты в WeakSet являются слабыми (не учитываются сборщиком мусора (garbage collector GC)).
Примечание: Элементы WeakSet уникальны и могут быть добавлены только один раз, также как и в Set .
Основные отличия от Set :
- WeakSet это коллекция объектов ( примитивные значения не могут быть добавлены).
- WeakSet нельзя итерировать. А также нельзя получить список (итератор) элементов.
Использование WeakSet достаточно специфическое. Пользуясь тем, что они не могут создавать утечек памяти, в них можно, например, безопасно помещать ссылки на DOM-элементы.
Больше примеров и полное описание на странице справочника WeakSet
Проверка на равенство в Map и Set
Сравнение на равенство ключей в Map objects или объектов в Set основано на "same-value-zero algorithm":
- алгоритм сравнения в целом совпадает с оператором === .
- -0 и +0 считаются равными (в отличие от === ).
- NaN считается равным самому себе (в отличие от === ).
- « Предыдущая статья
- Следующая статья »
Found a content problem with this page?
- Edit the page on GitHub.
- Report the content issue.
- View the source on GitHub.
This page was last modified on 7 авг. 2023 г. by MDN contributors.
Your blueprint for a better internet.
Словарь (map) на языке C#
Словарь (map) — это структура данных, представляющая собой специальным образом организованный набор элементов хранимых данные. Все данные хранятся в виде пар ключ-значение. Доступ к элементам данных осуществляется по ключу. Ключ всегда должен быть уникальным в пределах одного словаря, данные могут дублироваться при необходимости. У данной структуры есть и другие часто встречающиеся названия: ассоциативный массив или Dictionary. Принцип работы словаря схож с камерой хранения: есть ячейка, в которой может храниться что угодно, но доступ к этой ячейке осуществляется по уникальному номеру, благодаря чему ее всегда легко найти. Давайте рассмотрим пример реализации словаря на языке C#.
На рисунке ниже представлена схематичная структура словаря.
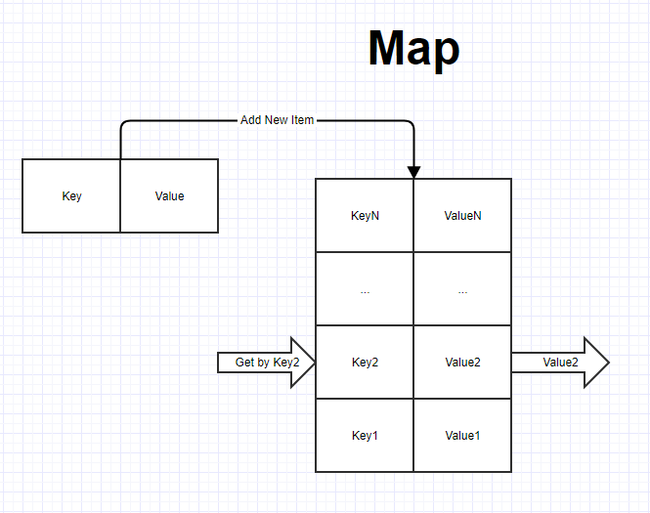
У словаря доступ осуществляется к любому из элементов хранимых данные по его ключу. Основные операции, которые могут выполняться со словарем:
1. Add — добавление нового элемента с уникальным ключом.
2. Remove — удаление элемента по ключу.
3. Update — изменить хранимое значение по ключу.
4. Get — получить хранимое значение по ключу.
Теперь приступим к реализации данной структуры данных. Будем использовать обобщенный класс с двумя принимаемыми типами для ключа и значения. Для хранения данных воспользуемся списком. Данная реализация является весьма примитивной, но позволяет разобраться в структуре и алгоритме работы данного типа данных.
Теперь рассмотрим программный код.
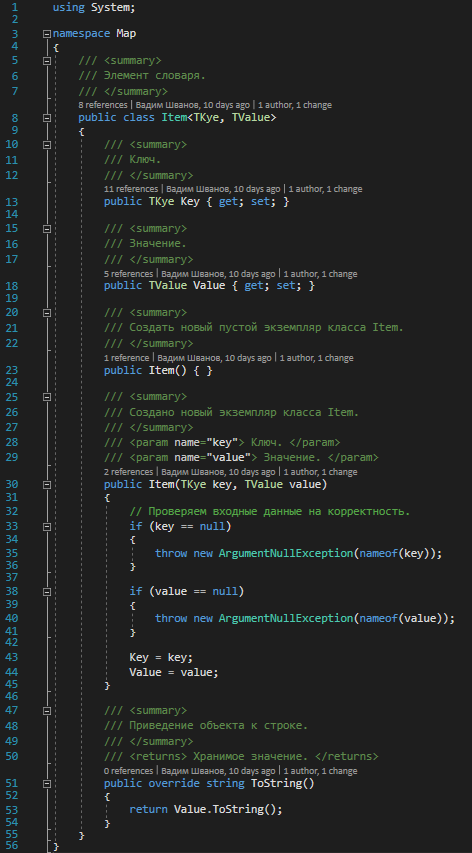
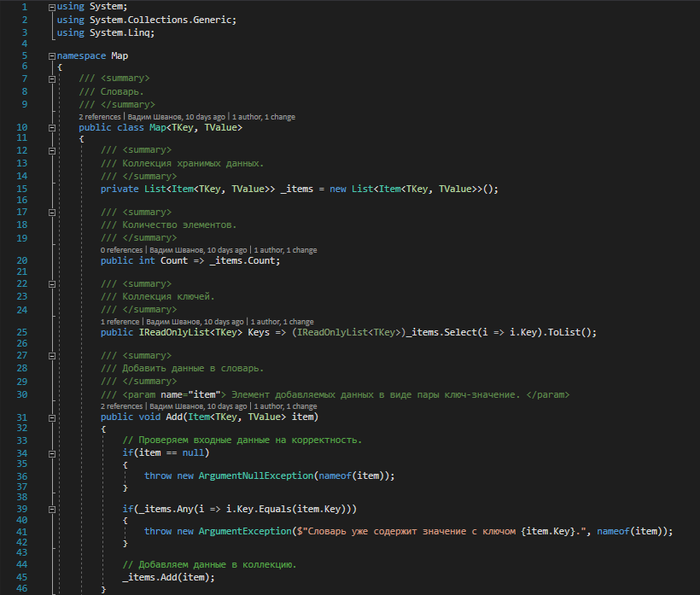
Объявим класс словаря, его свойства и реализуем основные операции


Теперь проверим работу словаря обратившись к нему
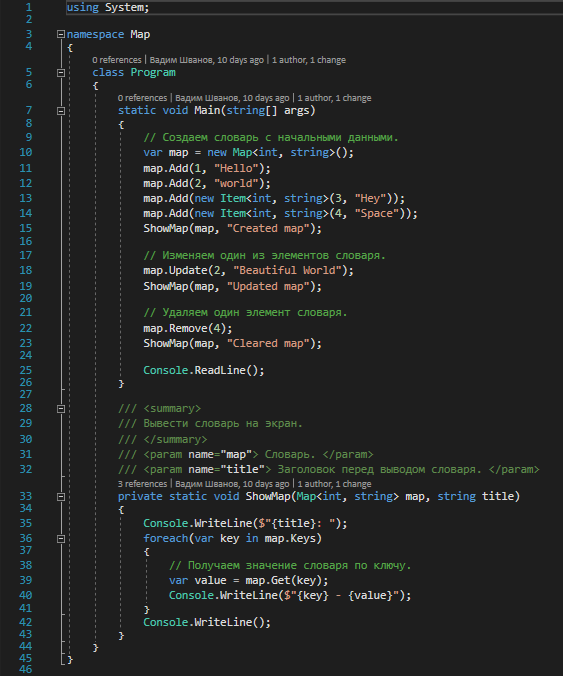
Ну и наконец запустим приложение и посмотрим результат работы на консоли
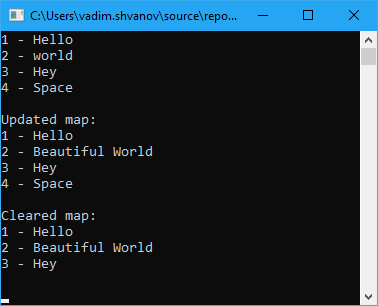
На платформе .NET уже есть готовая реализация данной структуры данных. Она содержится в пространстве имен System.Collections и называется Dictionary. Я не претендую на правильность, оптимальность и красоту реализации. Единственная цель, которую я преследую, поделиться полезной информацией о программировании, которая может кому-то пригодиться.
5 лет назад
Автор, у тебя мап на списке чтоль?
Их обычно на красно-черных деревьях делают (или на AVL деревьях, если вставок мало, выборок много).
Словари делают на хеш-таблицах.
Соответственно, у деревьев локап за O(log N), у хеш-таблиц за O(1) до O(N) (если bad case и автор упоролся и не контролирует load factor).
раскрыть ветку
5 лет назад
Я не понял, в С# map'a не было.
А vector там хоть есть, или что-то подобное? А queue??
раскрыть ветку
5 лет назад
И ТС, в .Net обобщенный словарь (то, что ты сделал) лежит в System.Collections.Generic. В System.Collections (необобщеные коллекции) класса Dictionary нет вообще (есть Hashtable)
Похожие посты
5 месяцев назад
Процедурная генерация простого подземелья в 150 строк (C#)
Всем привет. Решил поделиться кодом для создания подземелья, который я использую в своём рогалике. Код опубликовал год назад, но добавить пояснения и комментарии для начинающих руки дошли только сейчас.

Примеры генерации, как настроить канвас и прикрепить скрипт (первая минута): https://www.youtube.com/watch?v=_Vz9FDigioU
В игре есть тропический остров, на котором расположены руины, после обнаружения которых игрок спускается в подземелье состоящее из нескольких этажей (есть опция начать сразу с подземелья). Собственно с помощью кода создаётся основа для каждого этажа (но можно использовать и для создания интерьеров в наземных прямоугольных строениях). Работа алгоритма построения проста - сначала строится горизонтальная или вертикальная стена и в ней отмечается дверь (или несколько), таким образом пространство делится на две части, в каждом из которых происходит последующее разделение на две части и т.д. За основу взят метод построения правильных лабиринтов “Recursive Division”, посмотреть интерактивные примеры (в том числе и для десятка других алгоритмов) и код для ruby можно здесь: http://www.jamisbuck.org/mazes/
Чтобы в подземелье были «комнаты» и возможность нарезать круги добавлено ограничение на минимальный размер комнаты (int roomMinHorizontal, roomMinVertical) и шанс построения дополнительной двери (int extraDoorChance, minLengthForExtraDoor - минимальная длинна стены для дополнительной двери). В коде всего три метода, давайте посмотрим что они выполняют.
CreateDungeon() - главный метод, вызывается по нажатию пробела, строит подземелье и отрисовывает его на спрайте. В начале метода происходит проверка размера карты - по горизонтали и вертикали должны быть только нечётные числа. Затем идёт инициализация двумерного массива int[,] maze в котором и будет храниться карта. Далее - вызов метода разделения начальной пустой области Division(). Отрисовка полученной карты идёт с 39 по 56 строку - создается текстура и спрайт, текстуре присваивается цветовая информация (стены, пол, двери). Этот фрагмент можно использовать для отображения в игре мини-карты.
Division(int startX, int endX, int startY, int endY) - определение как надо разделить переданную область от стартовых координат (int startX, int startY) до конечных (int endX, int endY) на две части. В методе производится проверка габаритов области и если она слишком мала то выходим из метода через return - в этом случае дальнейшие действия в этом прямоугольнике не производятся. Если нет - создаём новую область через CreateRoom().
CreateRoom(bool isHorizontal, int startX, int endX, int startY, int endY) - непосредственно построение стены и дверей в определенной «комнате». isHorizontal - область по горизонтали шире чем по вертикали, т.е. будет ли построена вертикальная или горизонтальная стена. Сделано для того, чтобы комнаты не были слишком растянуты в одном из направлений. Это определяется в предыдущем методе через if (endX - startX > endY - startY), для квадратных комнат используется рандомное расположение стены. После этого проводится стена в массиве maze[verticalWall, i] = 1 (0 - пол, 1 - стена, 2 - дверь), через int doorNumbers определяем количество дверей в ней - как минимум должна быть одна дверь (но вы можете усложнить не добавляя на этом этапе дверей и создав телепорты для несвязанных частей подземелья). Затем вызывается Division() для каждой из двух областей разделённых стеной и происходит дальнейшее деление, пока не останется неразмеченных областей, после чего продолжится выполнение метода CreateDungeon() и будет визуально отрисована карта получившегося подземелья.
Итак, какие есть плюсы и минусы данного алгоритма. Построение комнат элементарно, при этом они все связаны и при дополнительных дверях появляется нелинейность прохождения. Также игровое пространство используется по максимуму, а с получившимися прямоугольниками в дальнейшем легко работать, расставляя в них мобов и дополнительный интерьер. В то же время, простота алгоритма определяет и его недостатки - некоторая однообразность и предсказуемость - в подземелье будет как минимум одна стена идущая от края до края. Более интересных и «пещеристых» подземелий можно добиться с помощью модификации этого алгоритма под названием "Blobby" Recursive Subdivision Algorithm (в ссылке выше примеры идут сразу после Recursive Devision). Однако, для своего проекта решил остановиться на первом варианте, поскольку мне удобнее работать с прямоугольниками, а вот внутри уже них я применял другие алгоритмы для создания самых разнообразных помещений, пещерок и коридоров. Вот примеры того как таким образом можно усложнить подземелье (игрок на карте отмечен зелёным кружочком):
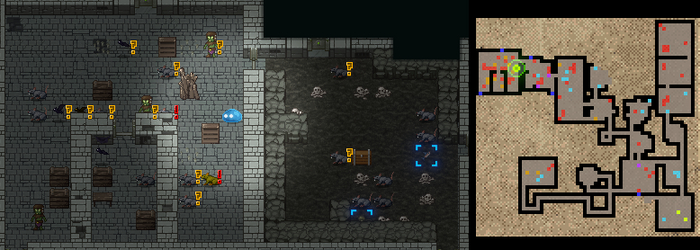
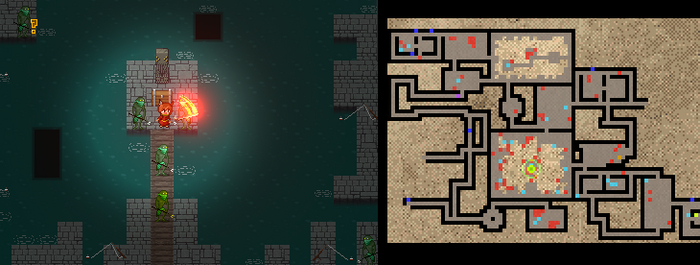
Здесь коридоры на самом деле тоже находятся внутри прямоугольных комнат - они просто соединяют клетки дверей граничащих комнат, а остальное пространство заливается стенами.
Пару слов о рогалике Tzakol in Exile. Разработку веду с 2021 года, планировал опубликовать в прошлом году, но притормозил и отодвинул дату до лучших времён. Сейчас периодически добавляю новый контент и то, что раньше было демоверсией постепенно повышаю до уровня lite - бесплатной версии. В ней есть два режима - с мета-прогрессией и в стиле традиционных рогаликов (доступны за исключением нескольких последний этажей и сражения с финальным боссом). Планирую добавить ещё блиц-режим, который будет представлен в lite-версии полностью. Скачать демо можно в стиме: https://store.steampowered.com/app/1764840/Tzakol_in_Exile/
Если есть вопросы по коду или по игре - пишите в комментариях, постараюсь ответить.