Host CPU usage и host memory usage

Добрый день уважаемые читатели и подписчики, продолжаем изучать виртуализацию и гипервизор компании VMware. В прошлый раз я вам рассказывал, как установить wmware tools в linux, сегодняшняя тема будет, так же про ошибки и предупреждения и разберем мы с вами вот такие «host CPU usage и host memory usage», что это такое и чем это чревато для вашей инфраструктуры.
Предупреждения о ОЗУ и CPU
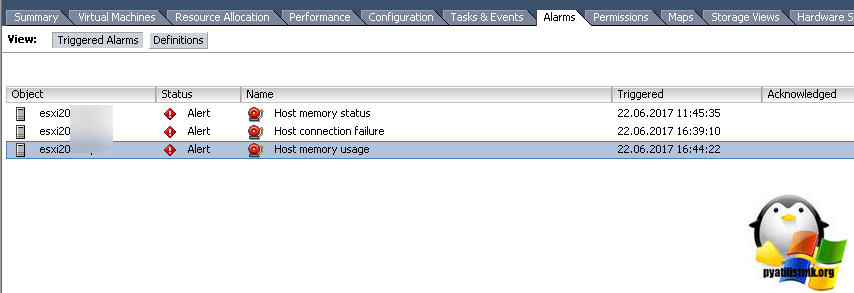
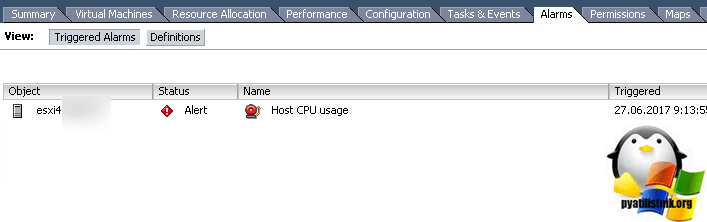
Данные предупреждения и алерты, вы можете обнаружить как в vCenter server, так и на отдельном хосте ESXI. Выглядят эти алерты вот так:
- Host memory usage на вкладке Alarms
- Host CPU usage на вкладке Alarms
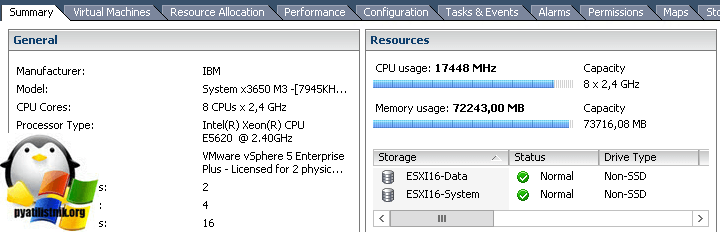
Если вы перейдет на вкладку «Summary», то в пункте «Resources» увидите шкалу загрузки по процессору
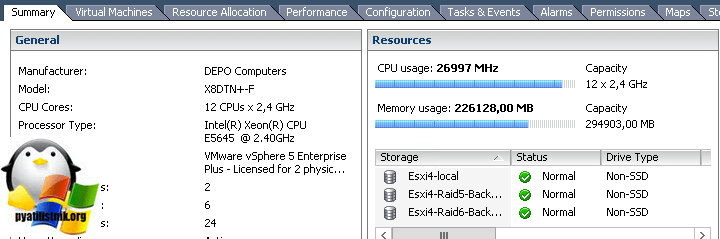
и оперативной памяти.
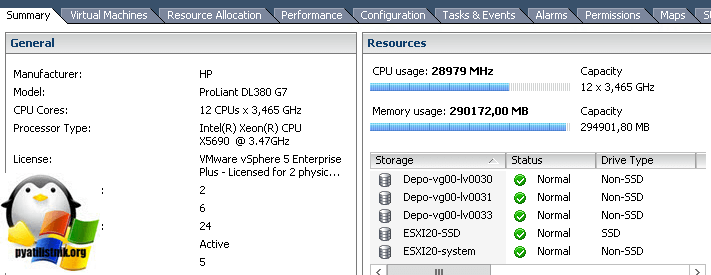
Пути решения данной ситуации такие:
- Вы ограничиваете потребление ресурсов для прожорливой виртуальной машины
- Либо более правильно перераспределяете их и дорабатываете план планирования, это дольше, но лучше, так как будет возможность предусмотреть будущий рост
Что плохого несут в себе эти предупреждения
Если у вас появились сообщения «Host CPU usage и host memory usage», это чревато тем что:
- Ваш сервер быстрее изнашивается, так как при правильно планировании, он не должен использовать более 90 процентов ресурсов.
- Идет борьба за ресурсы между виртуальными машинами, в следствии чего уменьшается их производительность.
- Может привести к зависанию хоста или виртуальной машины
Популярные Похожие записи:
- Ошибка Unable to apply DRS resource settings on host
 Ошибка миграции между кластерами ESXI и VDS
- Ошибка Cannot initialize SFTP protocol. Is the host running an SFTP server
 Ошибка 0x00002740: only one usage of each socket address
 Ошибка System Chassis 1 Chassis intro на ESXI хосте
 Как включить буфер обмена в vSphere Client (HTML5)
Анализ производительности ВМ в VMware vSphere. Часть 1: CPU
Рассказываем, что и почему «тормозит» и как сделать так, чтобы не «тормозило».
23 мая 2019 • Алексей Дарченков
Если вы администрируете виртуальную инфраструктуру на базе VMware vSphere (или любого другого стека технологий), то наверняка часто слышите от пользователей жалобы: «Виртуальная машина работает медленно!». В этом цикле статей разберу метрики производительности и расскажу, что и почему «тормозит» и как сделать так, чтобы не «тормозило».
Буду рассматривать следующие аспекты производительности виртуальных машин:
Для анализа производительности нам понадобятся:
- vCenter Performance Counters – счетчики производительности, графики которых можно посмотреть через vSphere Client. Информация по данным счетчикам доступна в любой версии клиента (“толстый” клиент на C#, web-клиент на Flex и web-клиент на HTML5). В данных статьях мы будем использовать скриншоты из С#-клиента, только потому, что они лучше смотрятся в миниатюре:)
- ESXTOP – утилита, которая запускается из командной строки ESXi. С ее помощью можно получить значения счетчиков производительности в реальном времени или выгрузить эти значения за определенный период в .csv файл для дальнейшего анализа.
Ниже в статье расскажу немного про ESXTOP и приведу несколько полезных ссылок на документацию и статьи по теме.
Немного теории
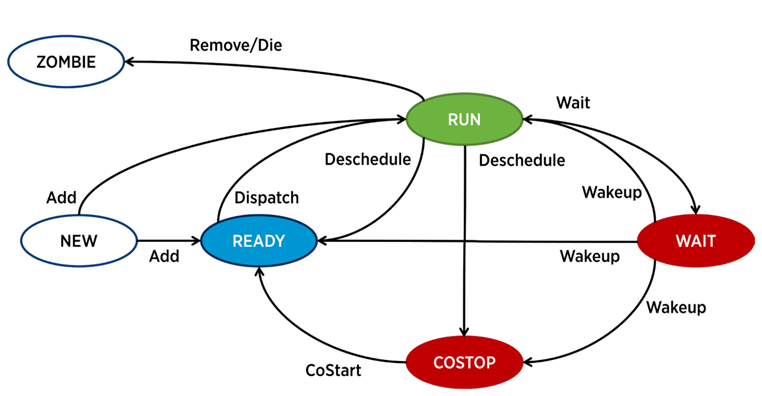
Диаграмма состояний процесса в ESXi. Источник
В ESXi за работу каждого vCPU (ядра виртуальной машины) отвечает отдельный процесс – world в терминологии VMware. Также есть служебные процессы, но с точки зрения анализа производительности ВМ они менее интересны.
Процесс в ESXi может находиться в одном из четырех состояний:
- Run – процесс выполняет какую-то полезную работу.
- Wait – процесс не выполняет никакой работы (idle) либо ждет ввода/вывода.
- Co-stop – состояние, которое возникает в многоядерных виртуальных машинах. Оно возникает, когда планировщик CPU гипервизора (ESXi CPU Scheduler) не может запланировать одновременное исполнение на физических ядрах сервера всех активных ядер виртуальной машины. В физическом мире все ядра процессора работают параллельно, гостевая ОС внутри ВМ рассчитывает на аналогичное поведение, поэтому гипервизору приходится замедлять ядра ВМ, у которых есть возможность закончить такт быстрее. В современных версиях ESXi планировщик CPU использует механизм, который называется relaxed co-scheduling: гипервизор считает разрыв между самым «быстрым» и самым “медленным» ядром виртуальной машины (skew). Если разрыв превышает определенный порог, «быстрое» ядро переходит в состояние co-stop. Если ядра ВМ проводят много времени в этом состоянии, это может вызвать проблемы с производительностью.
- Ready – процесс переходит в данное состояние, когда у гипервизора нет возможности выделить ресурсы для его исполнения. Высокие значения ready могут вызвать проблемы с производительностью ВМ.
Основные счетчики производительности CPU виртуальной машины
CPU Usage, %. Показывает процент использования CPU за заданный период.
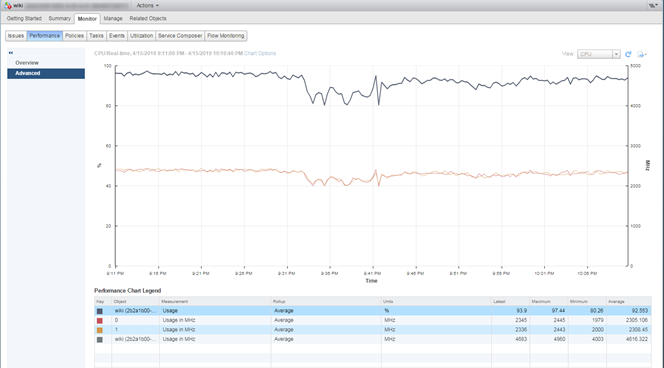
Как анализировать? Если ВМ стабильно использует CPU на 90% или есть пики до 100%, то у нас проблемы. Проблемы могут выражаться не только в «медленной» работе приложения внутри ВМ, но и в недоступности ВМ по сети. Если система мониторинга показывает, что ВМ периодически отваливается, обратите внимание на пики на графике CPU Usage.
Есть стандартный Аlarm, который показывает загрузку CPU виртуальной машины:
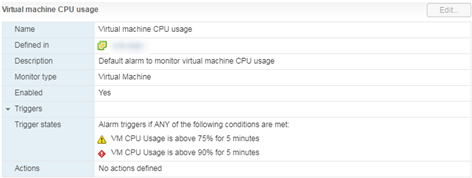
Что делать? Если у ВМ постоянно зашкаливает CPU Usage, то можно задуматься об увеличении количества vCPU (к сожалению, это не всегда помогает) или переносе ВМ на сервер с более производительными процессорами.
CPU Usage in Mhz
В графиках на vCenter Usage в % можно посмотреть только по всей виртуальной машине, графиков по отдельным ядрам нет (в Esxtop значения в % по ядрам есть).
По каждому ядру можно посмотреть Usage in MHz.
Как анализировать? Бывает, что приложение не оптимизировано под многоядерную архитектуру: использует на 100% только одно ядро, а остальные простаивают без нагрузки. Например, при дефолтных настройках бэкапа MS SQL запускает процесс только на одном ядре. В итоге резервное копирование тормозит не из-за медленной скорости дисков (именно на это изначально пожаловался пользователь), а из-за того, что не справляется процессор. Проблема была решена изменением параметров: резервное копирование стало запускаться параллельно в несколько файлов (соответственно, в несколько процессов).
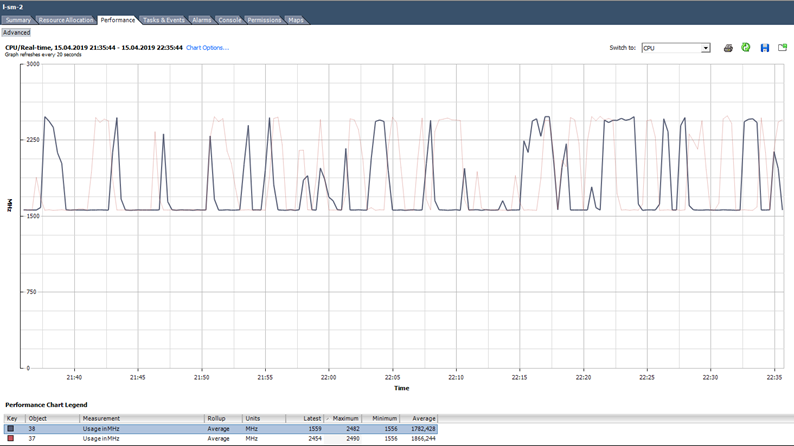
Пример неравномерной нагрузки ядер
Также бывает ситуация (как на графике выше), когда ядра нагружены неравномерно и на некоторых из них есть пики в 100%. Как и при загрузке только одного ядра, alarm по CPU Usage не сработает (он по всей ВМ), но проблемы с производительностью будут.
Что делать? Если ПО в виртуальной машине нагружает ядра неравномерно (использует только одно ядро или часть ядер), нет смысла увеличивать их количество. В таком случае лучше переместить ВМ на сервер с более производительными процессорами.
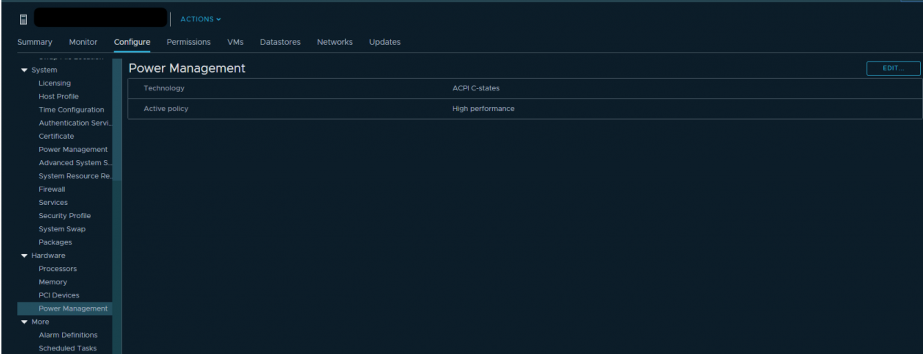
Также можно попробовать проверить настройки энергопотребления в BIOS сервера. Многие администраторы включают в BIOS режим High Performance и тем самым отключают технологии энергосбережения C-states и P-states. В современных процессорах Intel используется технология Turbo Boost, которая увеличивает частоту отдельных ядер процессора за счет других ядер. Но она работает только при включенных технологиях энергосбережения. Если мы их отключаем, то процессор не может уменьшить энергопотребление ядер, которые не нагружены.
VMware рекомендует не отключать технологии энергосбережения на серверах, а выбирать режимы, которые максимально отдают управление энергопотреблением гипервизору. При этом в настройках энергопотребления гипервизора нужно выбрать High Performance.
Если у вас в инфраструктуре отдельные ВМ (или ядра ВМ) требуют повышенную частоту CPU, корректная настройка энергопотребления может значительно улучшить их производительность.
CPU Ready (Readiness)
Если ядро ВМ (vCPU) находится в состоянии Ready, оно не выполняет полезную работу. Такое состояние возникает, когда гипервизор не находит свободное физическое ядро, на которое можно назначить процесс vCPU виртуальной машины.
Как анализировать? Обычно если ядра виртуальной машины находятся в состоянии Ready больше 10% времени, то вы заметите проблемы с производительностью. Проще говоря, больше 10% времени ВМ ждет доступности физических ресурсов.
В vCenter можно посмотреть 2 счетчика, связанных с CPU Ready:
Значения обоих счетчиков можно посмотреть как по всей ВМ, так и по отдельным ядрам.
Readiness показывает значение сразу в процентах, но только в Real-time (данные за последний час, интервал измерений 20 секунд). Этот счетчик лучше использовать только для поиска проблем «по горячим следам».
Значения счетчика Ready можно посмотреть также в исторической перспективе. Это полезно, если нужно установить закономерности и для более глубокого анализа проблемы. Например, если у виртуальной машины начинаются проблемы с производительностью в какое-то определенное время, можно сопоставить интервалы повешенного значения CPU Ready с общей нагрузкой на сервер, где данная ВМ работает, и принять меры по снижению нагрузки (если DRS не справился).
Ready в отличие от Readiness показывается не в процентах, а миллисекундах. Это счетчик типа Summation, то есть он показывает, сколько времени за период измерения ядро ВМ находилось в состоянии Ready. Перевести данное значение в проценты можно по несложной формуле:
(CPU ready summation value / (chart default update interval in seconds * 1000)) * 100 = CPU ready %
Например, для ВМ на графике ниже пиковое значение Ready на всю виртуальную машину получится следующим:
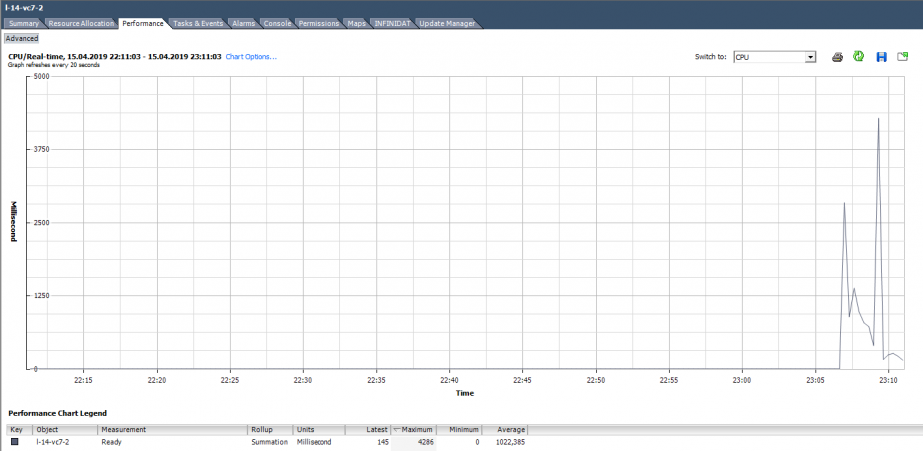
При подсчете значения Ready в процентах стоит обращать внимание на два момента:
- Значение Ready по всей ВМ – это сумма Ready по ядрам.
- Интервал измерения. Для Real-time – это 20 секунд, а, например, на дневных графиках – это 300 секунд.
При активном траблшутинге эти простые моменты можно легко упустить и потратить ценное время на решение несуществующих проблем.
Рассчитаем Ready на основе данных из графика ниже. (324474/(20*1000))*100 = 1622% на всю ВМ. Если смотреть по ядрам получится уже не так страшно: 1622/64 = 25% на ядро. В данном случае обнаружить подвох довольно просто: значение Ready нереалистичное. Но если речь идет о 10–20% на всю ВМ с несколькими ядрами, то по каждому ядру значение может быть в пределах нормы.
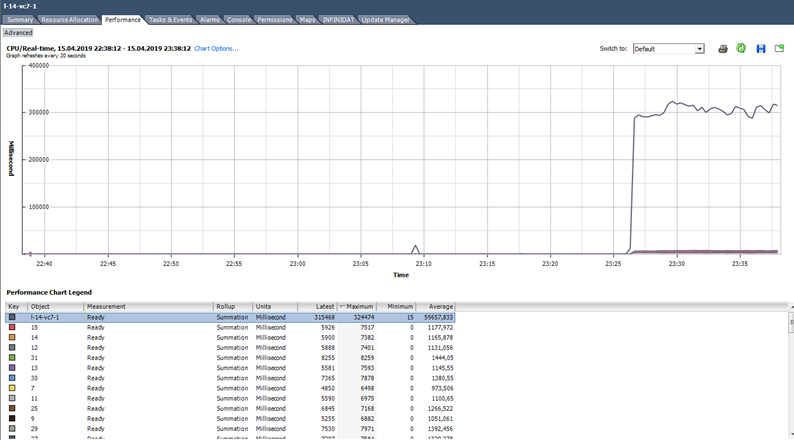
Что делать? Высокое значение Ready говорит о том, что серверу не хватает ресурсов процессора для нормальной работы виртуальных машин. В такой ситуации остается только уменьшить переподписку по процессору (vCPU:pCPU). Очевидно, этого можно добиться, уменьшив параметры существующих ВМ или путем миграции части ВМ на другие серверы.
Co-stop
Как анализировать? Данный счетчик также имеет тип Summation и переводится в проценты аналогично Ready:
(CPU co-stop summation value / ( * 1000)) * 100 = CPU co-stop %
Здесь также нужно обращать внимание на количество ядер на ВМ и на интервал измерения.
В состоянии Costop ядро таже не выполняет полезную работу. При правильном подборе размера ВМ и нормальной нагрузке на сервер счетчик со-stop должен быть близок к нулю.
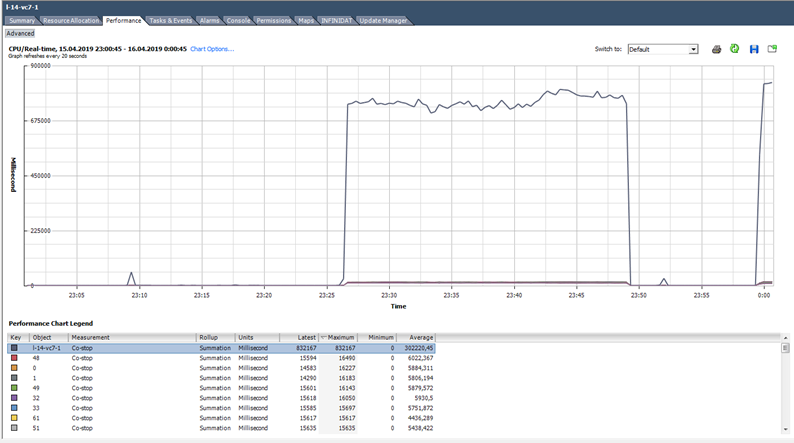
В данном случае нагрузка явно ненормальная 🙂
Что делать? Если на одном гипервизоре работают несколько ВМ с большим количеством ядер и есть переподписка по CPU, то счетчик co-stop может вырасти, что приведет к проблемам с производительностью данных ВМ.
Также co-stop вырастет, если для активных ядер одной ВМ используются треды на одном физическом ядре сервера со включенным hyper-treading. Такая ситуация может возникнуть, например, если у ВМ больше ядер, чем физически есть на сервере, где она работает, или если для ВМ включена настройка «preferHT». Про эту настройку можно прочитать здесь.
Чтобы избежать проблем с производительностью ВМ из-за высокого Co-stop, выбирайте размер ВМ в соответствии с рекомендациями производителя ПО, которое работает на этой ВМ, и с возможностями физического сервера, где работает ВМ.
Не добавляйте ядра про запас, это может вызвать проблемы с производительностью не только самой ВМ, но и ее соседей по серверу.
Другие полезные метрики CPU
Run – сколько времени (мс) за период измерения vCPU находился в состоянии RUN, то есть собственно выполнял полезную работу.
Idle – сколько времени (мс) за период измерения vCPU находился в состоянии бездействия. Высокие значения Idle – это не проблема, просто vCPU было «нечего делать».
Wait – сколько времени (мс) за период измерения vCPU находился в состоянии Wait. Так как в данный счетчик включается IDLE, высокие значения Wait также не говорят о наличии проблемы. А вот если при высоком Wait IDLE низкий, значит ВМ ждала завершения операций ввода/вывода, а это, в свою очередь, может говорить о наличии проблемы с производительностью жесткого диска или каких-либо виртуальных устройств ВМ.
Max limited – сколько времени (мс) за период измерения vCPU находился в состоянии Ready из-за установленного лимита по ресурсам. Если производительность необъяснимо низкая, то полезно проверить значение данного счетчика и лимит по CPU в настройках ВМ. У ВМ действительно могут оказаться выставлены лимиты, о которых вы не знаете. Например, так происходит, когда ВМ была склонирована из шаблона, на котором был установлен лимит по CPU.
Swap wait – сколько времени за период измерения vCPU ждал операции с VMkernel Swap. Если значения данного счетчика выше нуля, то у ВМ точно есть проблемы с производительностью. Подробнее про SWAP поговорим в статье про счетчики оперативной памяти.
ESXTOP
Если счетчики производительности в vCenter хороши для анализа исторических данных, то оперативный анализ проблемы лучше производить в ESXTOP. Здесь все значения представлены в готовом виде (не нужно ничего переводить), а минимальный период измерения 2 секунды.
Экран ESXTOP по CPU вызывается клавишей «c» и выглядит следующим образом:

Для удобства можно оставить только процессы виртуальных машин, нажав Shift-V.
Чтобы посмотреть метрики по отдельным ядрам ВМ, нажмите «e» и вбейте GID интересующей ВМ (30919 на скриншоте ниже):
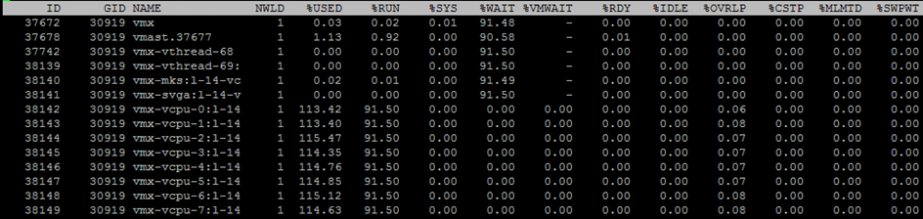
Кратко пройдусь по столбцам, которые представлены по умолчанию. Дополнительные столбцы можно добавить, нажав «f».
NWLD (Number of Worlds) – количество процессов в группе. Чтобы раскрыть группу и увидеть метрики для каждого процесса (например, для каждого ядра многоядерной ВМ), нажмите “e”. Если в группе больше одного процесса, то значения метрик для группы равны сумме метрик для отдельных процессов.
%USED – сколько циклов CPU сервера использует процесс или группа процессов.
%RUN – сколько времени за период измерения процесс находился в состоянии RUN, т.е. выполнял полезную работу. Отличается от %USED тем, что не учитывает hyper-threading, frequency scaling и время, затраченное на системные задачи (%SYS).
%SYS – время, затраченное на системные задачи, например: обработку прерываний, ввода/вывода, работу сети и пр. Значение может быть высоким, если на ВМ большой ввод/вывод.
%OVRLP – сколько времени физическое ядро, на котором выполняется процесс ВМ, потратило на задачи других процессов.
Данные метрики соотносятся между собой следующим образом:
%USED = %RUN + %SYS — %OVRLP.
Обычно метрика %USED является более информативной.
%WAIT – сколько времени за период измерения процесс находился в состоянии Wait. Включает IDLE.
%IDLE – cколько времени за период измерения процесс находился в состоянии IDLE.
%SWPWT – сколько времени за период измерения vCPU ждал операции с VMkernel Swap.
%VMWAIT – сколько времени за период измерения vCPU находилось в состояния ожидания события (обычно ввода/вывода). Аналогичного счетчика нет в vCenter. Высокие значения говорят о проблемах с вводом/выводом на ВМ.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Если ВМ не использует VMkernel Swap, то при анализе проблем с производительностью целесообразно смотреть на %VMWAIT, так как данная метрика не учитывает время, когда ВМ ничего не делала (%IDLE).
%RDY – cколько времени за период измерения процесс находился в состоянии Ready.
%CSTP – cколько времени за период измерения процесс находился в состоянии Co-stop.
%MLMTD – сколько времени за период измерения vCPU находился в состоянии Ready из-за установленного лимита по ресурсам.
%WAIT + %RDY + %CSTP + %RUN = 100% – ядро ВМ все время находится в каком-то из этих четырех состояний.
CPU на гипервизоре
В vCenter есть также счетчики производительности CPU для гипервизора, но они не представляют из себя ничего интересного – это просто сумма счетчиков по всем ВМ на сервере.
Удобнее всего смотреть состояние CPU на сервере на вкладке Summary:
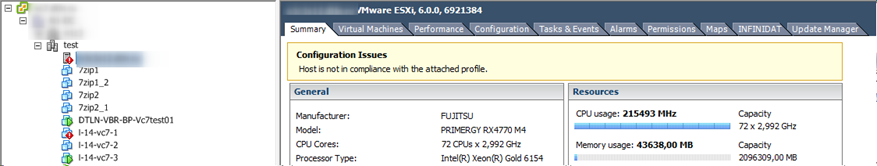
Для сервера, как и для виртуальной машины, есть стандартный Alarm:
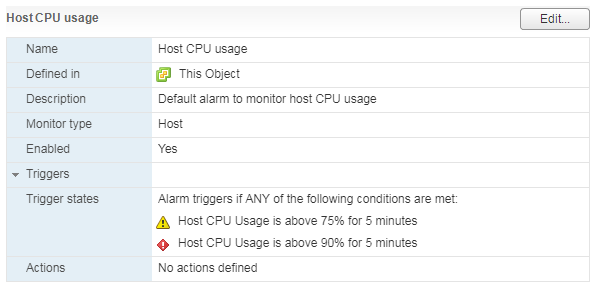
При высокой нагрузке на CPU сервера у ВМ, работающих на нем, начинаются проблемы с производительностью.
В ESXTOP данные о загрузке CPU сервера представлены в верхней части экрана. Помимо стандартного CPU load, который малоинформативен для гипервизоров, есть еще три метрики:
CORE UTIL(%) – загрузка ядра физического сервера. Данный счетчик показывает, сколько времени за период измерения ядро выполняло работу.
PCPU UTIL(%) – если включен hyper-threading, то на каждое физическое ядро приходится два потока (PCPU). Данная метрика показывает, сколько времени каждый поток выполнял работу.
PCPU USED(%) – то же, что PCPU UTIL(%), но учитывает frequency scaling (либо снижение частоты ядра в целях энергосбережения, либо повышение частоты ядра за счет технологии Turbo Boost) и hyper-threading.
PCPU_USED% = PCPU_UTIL% * эффективную частоту ядра / номинальную частоту ядра.
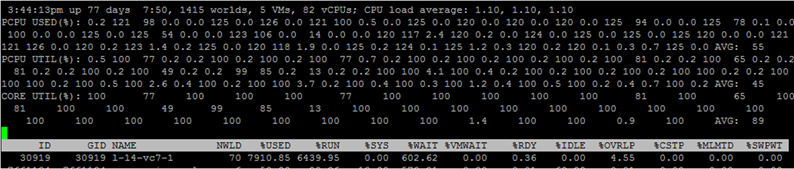
На этом скриншоте для некоторых ядер из-за работы Turbo Boost’а значение USED больше 100%, так как частота ядра выше номинальной
Пара слов о том, как учитывается hyper-threading. Если процессы исполняются 100% времени на обоих потоках физического ядра сервера, при этом ядро работает на номинальной частоте, то:
- CORE UTIL для ядра будет 100%,
- PCPU UTIL для обоих потоков будет 100%,
- PCPU USED для обоих потоков будет 50%.
Если оба потока не работали 100% времени за период измерения, то в те периоды, когда потоки работали параллельно, PCPU USED для ядер делится пополам.
В ESXTOP также есть экран с параметрами энергопотребления CPU сервера. Здесь можно посмотреть, используются ли сервером технологии энергосбережения: C-states и P-states. Вызывается клавишей «p»:
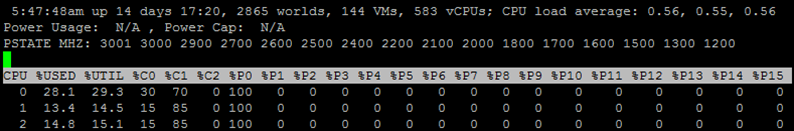
Стандартные проблемы производительности CPU
Напоследок пробегусь по типичным причинам возникновения проблем с производительностью CPU ВМ и дам короткие советы их решению:
- Не хватает тактовой частоты ядра. Если нет возможности перевести ВМ на более производительные ядра, можно попробовать изменить настройки энергопотребления, чтобы Turbo Boost работал эффективнее.
- Неправильный сайзинг ВМ (слишком много/мало ядер). Если поставить мало ядер, будет высокая загрузка CPU ВМ. Если много, словите высокий co-stop.
- Большая переподписка по CPU на сервере. Если на ВМ высокий Ready, снизьте переподписку по CPU.
- Неправильная NUMA-топология на больших ВМ. NUMA-топология, которую видит ВМ (vNUMA), должна соответствовать NUMA-топологии сервера (pNUMA). Про диагностику и возможные варианты решения данной проблемы написано, например, в книге «VMware vSphere 6.5 Host Resources Deep Dive». Если не хотите углубляться и у вас нет лицензионных ограничений по ОС, установленной на ВМ, делайте на ВМ много виртуальных сокетов по одному ядру. Много не потеряете:)
На этом про CPU у меня все. Задавайте вопросы. В следующей части расскажу про оперативную память.
Полезные статьи по теме:
Оптимизация производительности в vSphere: решение основных проблем с CPU
Как быстро идентифицировать проблему, связанную с производительностью процессора, какие метрики в этом случае будут наиболее информативными? На эти и многие другие вопросы, имеющие отношение к производительности CPU в виртуальном окружении vSphere, ответим в этой статье.
Интенсивность потребления процессорных ресурсов зависит от множества факторов и различных условий. Именно поэтому вопрос контроля ресурсоемкости и загруженности CPU должен быть максимально проработанным. Допустим, в окружении vSphere используется слишком большое количество виртуальных машин с запущенными на них высоконагруженными приложениями, все это может привести к недостаточности процессорных ресурсов. Иногда причиной подобной нехватки становится и другой момент, связанный, к примеру, с неэффективным использованием или неоптимальной конфигурацией виртуальных машин. В любом случае нехватка ресурсов CPU может привести к серьёзным проблемам с производительностью и сказаться на работе жизненно важных для бизнеса сервисов.
Самые распространенные проблемы производительности CPU
# High Ready Time – процессор находится в состоянии готовности, когда виртуальная машина готова к старту, однако не может быть запущена в силу недостаточности ресурсов физического хоста. Показатель Ready Time считается нормальным, когда его значение не превышает 10 %. Если же наблюдается рост текущего показателя, велика вероятность сбоев и зависания гостевой операционной системы. Однако некоторые менее чувствительные к показателям CPU приложения и виртуальные машины могут продолжать корректно функционировать и при значении Ready Time выше 10 %. # High Co—stoptime – показатель Co-stoptime указывает на наличие большего количества vCPU, чем в действительности необходимо. А это зачастую вызывает дополнительное расходование ресурсов, уменьшая производительность виртуальной машины. В подобной ситуации при снижении количества vCPU виртуалка сможет работать значительно лучше. # CPU Limits – указывает на установленные процессорные лимиты, запрещающие виртуальной машине использовать больше пороговых значений. Такое ограничение, в случае если виртуальной машине потребуется большее количество ресурсов, может стать причиной проблем с производительностью. # Host CPU Saturation – используется для проверки загрузки процессора хоста, и если средняя загрузка составляет более 75 % или пиковая – более 90 %, значит, наблюдается нехватка ресурсов CPU узла vSphere, что чревато проблемами запуска имеющихся виртуальных машин. # Guest CPU Saturation – указывает на загрузку процессора виртуальной машины. Если приложение виртуальной машины использует 90 % и более ресурсов CPU, наблюдается проблема с производительностью. В этом случае приложение становится «узким горлышком». Добавление дополнительного vCPU значительно улучшит производительность виртуальной машины. # Low Guest Usage – может указывать на некорректную конфигурацию приложения или недостаточность других ресурсов (будь то оперативная память или жесткий диск) и, следовательно, выделенные ресурсы vCPU не смогут использоваться в полной мере.
Скрипт как средство имитации загрузки CPU: изучаем особенности
Для имитации загрузки CPU в тестовой среде воспользуемся скриптом и понаблюдаем за поведением виртуальной машины. Для начала необходимо запустить VMware vSphere Power CLI, после чего станет доступным окно командной строки, в котором и запускается скрипт Start CPU Test. 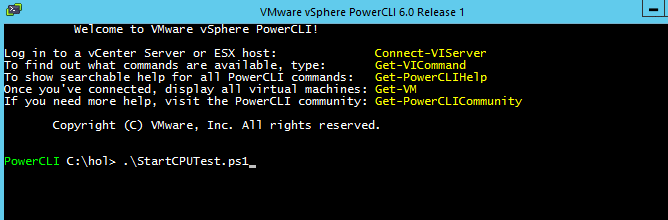 Рисунок 1. Окно командной строки После полной отработки скрипта запускаются удаленные рабочие столы двух виртуальных машин.
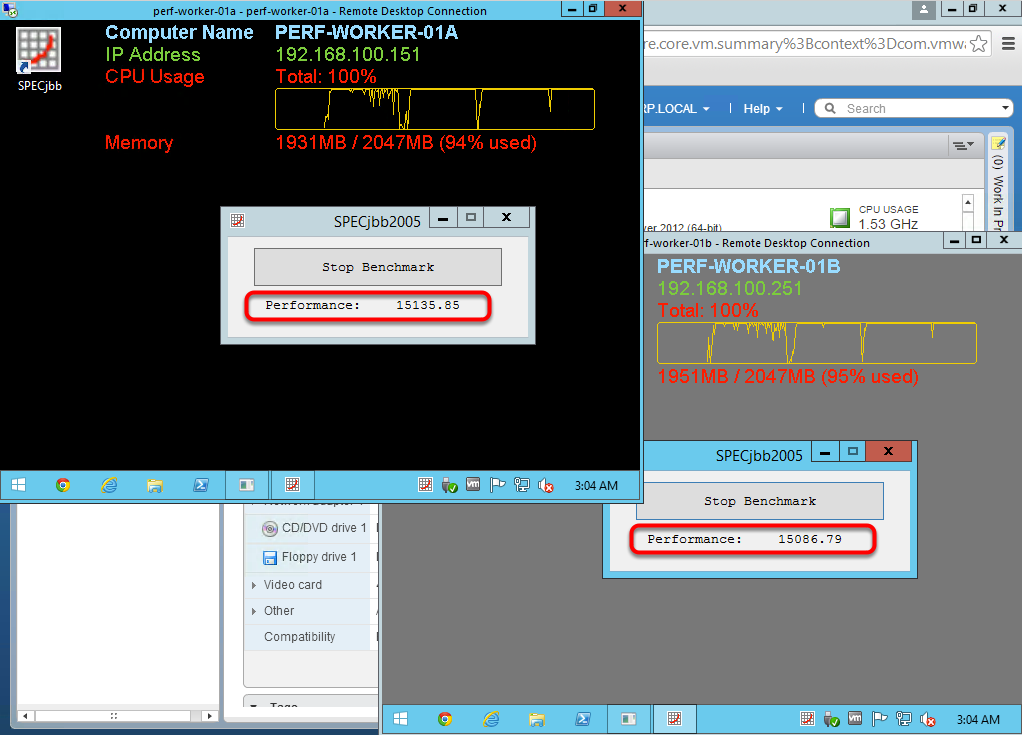 Рисунок 2. Запуск удаленных рабочих столов виртуальных машин Скрипт имитирует ресурсоемкий процесс загрузки CPU виртуальных машин: PERF—WORKER-01Aи PERF—WORKER-01B, а графический интерфейс отображает значения производительности в режиме реального времени. Как видите, отметка производительности близка к значению 15 000. Переключаемся в окно vSphere, переходим в закладку мониторинга производительности машины PERF-WORKER-01A. Поскольку интересны расширенные параметры, необходимо выбрать опцию Advanced –> Chart Options.
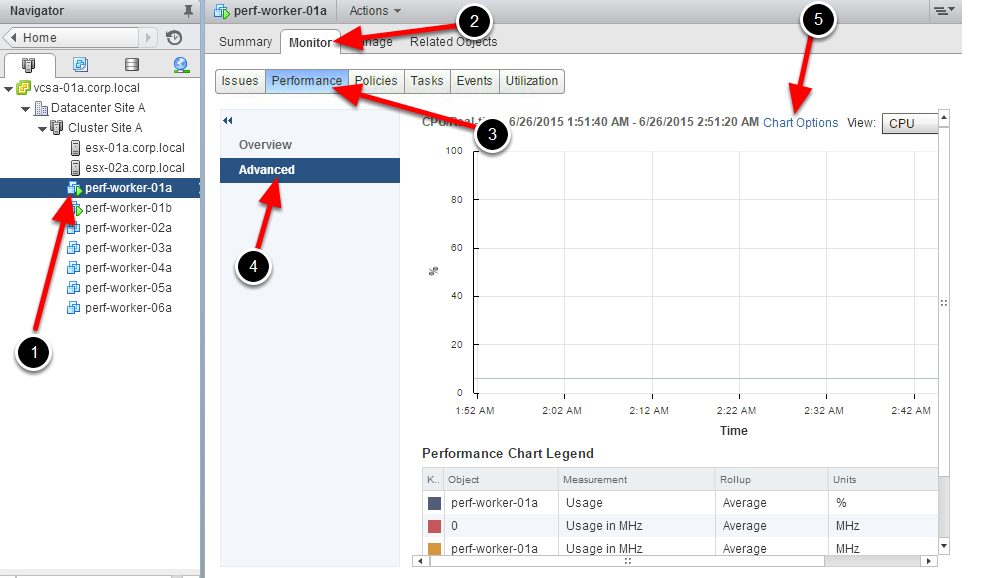 Рисунок 3. Обзор расширенных параметров в vSphere Здесь выбираются необходимые счетчики, полезные для отслеживания производительности процессора.
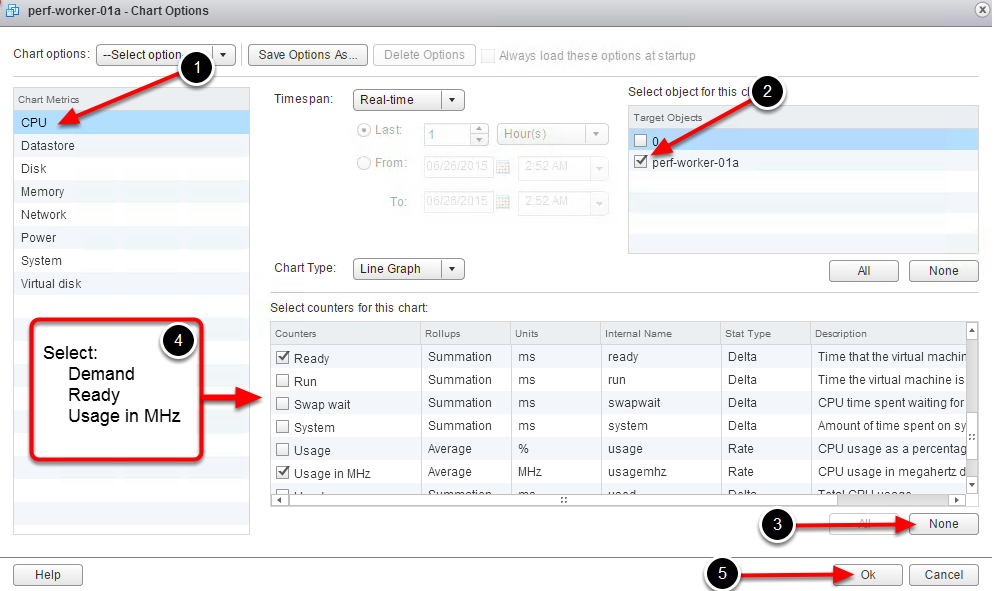 Рисунок 4. Выбор соответствующих счетчиков производительности При расследовании проблем производительности CPU стоит обратить внимание на следующие счетчики:
- Demand – количество CPU виртуальной машины, необходимых (требуемых) для использования.
- Ready – показатель времени, в течение которого виртуальная машина готова запуститься, но не может в силу недостаточности физически ресурсов.
- Usage – количество CPU виртуальной машины, фактически разрешенных для использования в текущий момент.
Для выбора Demand, Ready, Usage и других счетчиков необходимо перейти в раздел метрик CPU и указать необходимые элементы, после чего нажать кнопку ОК.
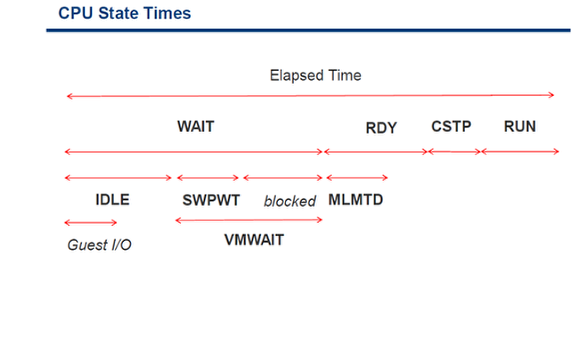
Рисунок 5. Показатели CPU State
Виртуальные машины могут находиться в одном из представленных ниже состояний, которые отслеживаем с помощью соответствующих счетчиков:
- Wait(VMWAIT) – такое состояние фиксируется, когда гостевая ОС виртуальной машины находится в состоянии простоя или ожидается выполнение задач на уровне vSphere. К примеру, vCPU может перейти в режим Wait в случае, если ожидается завершение операций ввода-вывода или выполнение «свопирования» на уровне ESX. Иными словами, такой счетчик отображает процент времени, который виртуальная машина потратила на ожидание, пока ядро ESX выполняло какие-либо операции.
- Ready(RDY) – главная составляющая производительности процессора. Процессор может находиться в состоянии RDY, когда виртуальная машина готова к запуску, но в силу недостаточности физических ресурсов хоста запуститься не может. Одной из причин может быть установленный на CPU лимит (выше мы говорили об этом), или лимит ресурсного пула.
- Co—Stop(CSTP): этот статус соотносится со временем, когда виртуальная машина готова исполнять команды, но вынуждена ждать высвобождения других vCPU для возможности их одновременного использования.
- Run(исполнение): показывает, что виртуальная машина «исполняется» в системе.
Исходя из рассмотренных статусов и счетчиков, нелишним будет ознакомиться с одной важной формулой. Она верна для отдельно взятой VM, которая либо простаивает и находится в ожидании (%WAIT), либо готова исполнять команды, но CPU занят (%RDY), либо ожидает высвобождения нескольких процессоров (%CSTP), либо исполняется в системе (%RUN).
%WAIT + %RDY + %CSTP + %RUN = 100%
Сравнение показателей Demand и Usage
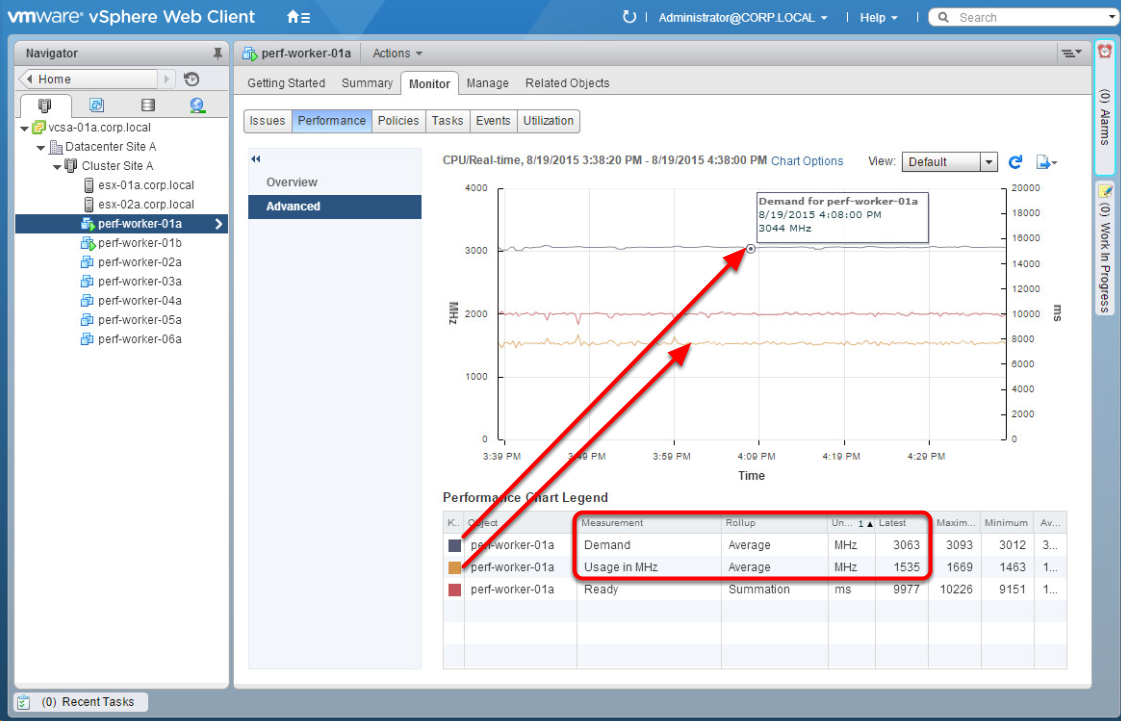
Рисунок 6. Сравнение показателей счетчиков производительности
Обратите внимание на то, сколько ресурсов CPU требуется для работы виртуальной машины и сколько в действительности используется. Как видно на рисунке, требуется (demand) значительно больше, чем используется (use). Также обратите внимание на показатель Ready Time, равный 9977 ms. Как вы помните, если это значение будет больше 10 %, вероятна проблема с производительностью. Для перевода значения из миллисекунд в проценты можно воспользоваться следующей формулой:
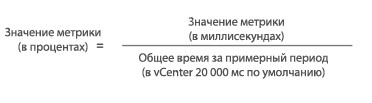
Заметка: поскольку некоторые показатели в отчетах vCenter отображаются в миллисекундах, приведенную формулу можно использовать для перевода значений в проценты.
Статистика CPU на уровне хоста
Для просмотра статистики на уровне хоста выбирается необходимый узел и используется закладка Monitor-Performance, как показано на рисунке. После выбора опции Advanced станет доступной возможность просмотра счетчиков производительности.
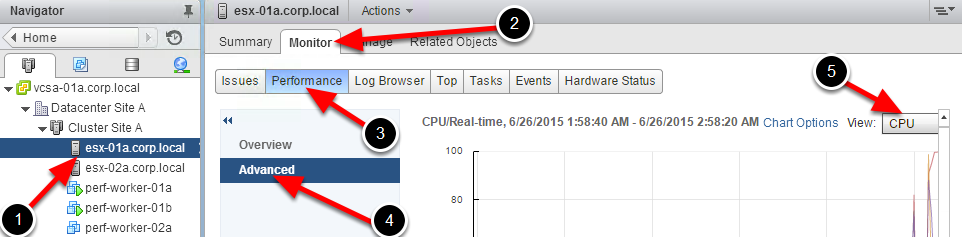
Рисунок 7. Обзор статистики на уровне хоста
Здесь можно отслеживать статистику по CPU на уровне хоста ESX.
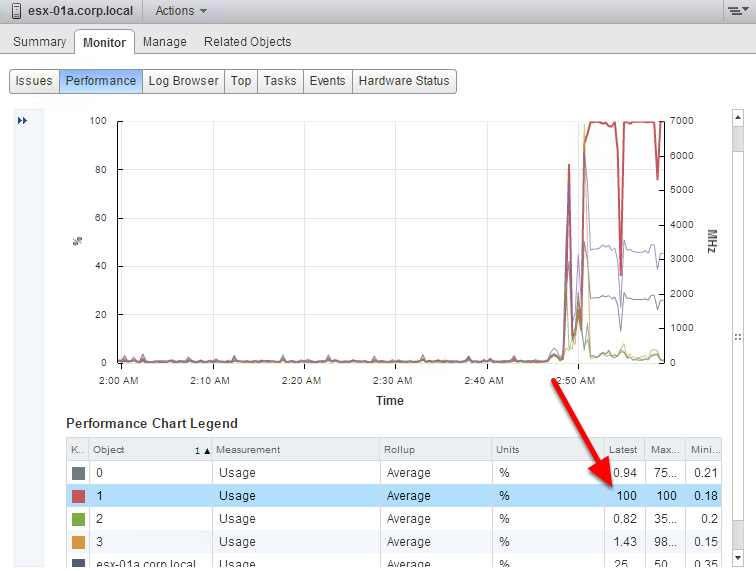
Рисунок 8. Обзор счетчиков производительности
Согласно рисунку, только один из процессоров хоста претерпевает значительную нагрузку, тогда как остальные практически не задействованы.
Редактирование параметров виртуальной машины
Зачастую возникает необходимость редактировать параметры виртуальной машины. Давайте рассмотрим, как это делается. Для начала обратимся к VMPERF-WORKER-01A, выберем Actions, а затем Edit Settings, как указано на рисунке.
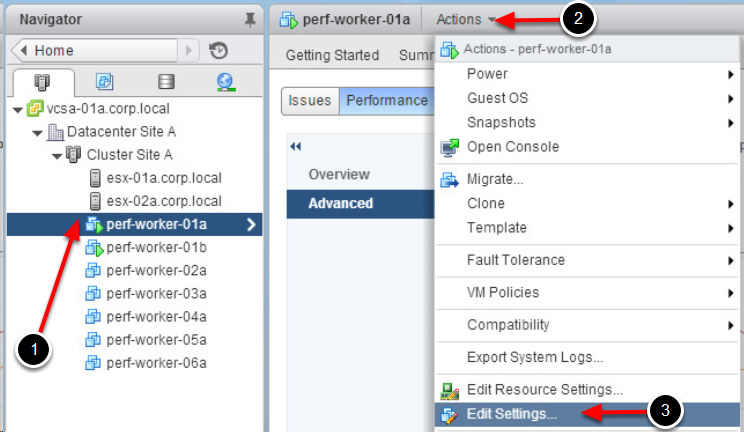
Рисунок 9. Редактирование параметров виртуальной машины
Выполним проверку параметров CPU affinity на машине PERF-WORKER-01A.
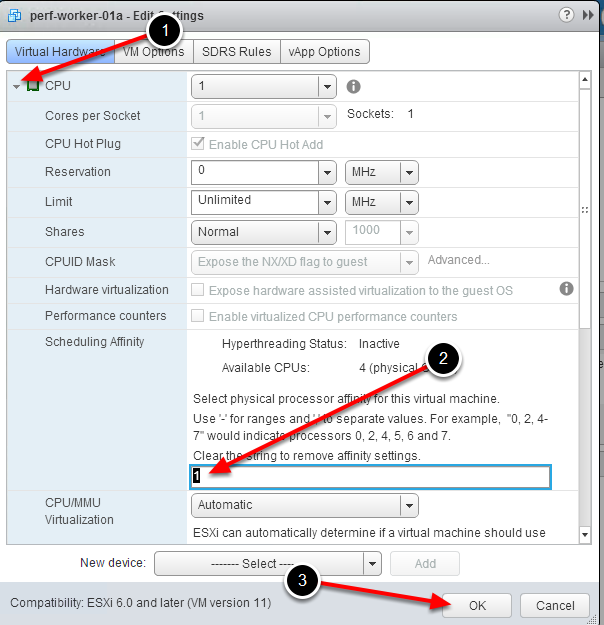
Рисунок 10. Редактирование параметров CPU
Как видно на рисунке, значение affinity равно единице. Чтобы правильно сбалансировать виртуальные машины на использование физических процессоров в системе, необходимо очистить установленное значение «1» и нажать ОК. Аналогичное действие выполняем и на второй виртуальной машине (PERF-WORKER-01B).
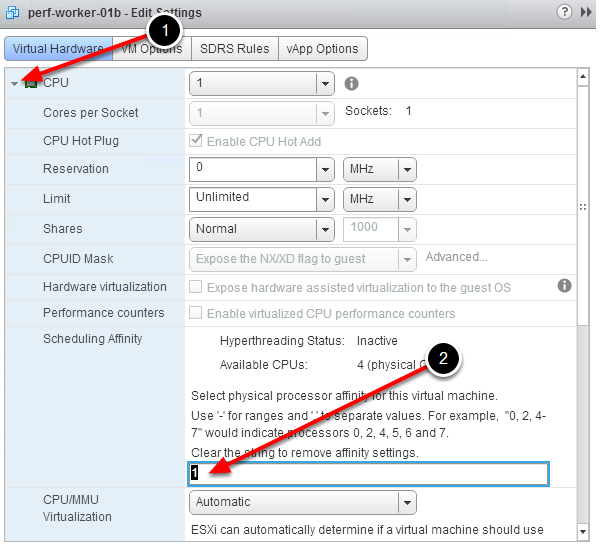
Рисунок 11. Редактирование параметров CPU
Заметка: в большинстве случаев VMware не рекомендует использовать установленные вручную значения affinity. vSphere способна выполнять оптимальную балансировку VM в контексте физических процессорных ресурсов. Кроме того, использование значений «affinity», выставленных вручную, не даст использовать vMotion, а также может вызвать сложности в управлении и проблемы с производительностью.
Подводим итоги
Мы рассмотрели самые распространенные проблемы с производительностью CPU в vSphere, изучили особенности загрузки процессора, используя скрипты, выполнили сравнение важнейших показателей процессора, ознакомились со сбором статистики на уровне хоста и другое.
Следите за новыми материалами нашего блога. В следующей статье мы продолжим рассказывать про оптимизацию производительности CPU в vSphere.
sidadm
В прошлый раз я писал о том, как настроить виртуальные машины, работающие в среде VMware Workstation, для обеспечения их максимальной производительности. Сегодня же хотел поговорить про решения Enterprise уровня от компании VMware. А в частности про мониторинг использования ресурсов виртуальных машин в VMware vSphere.
Если кто-то не сильно разбирается в маркетинговых названиях, поясню. У компании VMware есть гипервизор, который устанавливается на физическую машину, называется он — VMware ESXi. Для управления и мониторинга у ESXi имеется встроенная графическая web-консоль. Но, если виртуализированных хостов в дата-центре много, то управлять этим хозяйством становится сложнее. Так как для мониторинга или изменения конфигурации гипервизоров необходимо входить на web-консоль каждого ESXi. Для упрощения данной задачи (конечно, за отдельные деньги) компания предлагает решение VMware vCenter. В этом случае выделенный виртуальный сервер предоставляет единую точку входа для мониторинга, управления и конфигурации ESXi хостов вашей организации. Помимо общей точки входа вы получаете дополнительные функции, например, vMotion (перенос работающих виртуальных машин между ESXi хостами) или HA кластер. Комплексное решение «ESXi + vCenter» и называется VMware vSphere. Достаточно подробно про эти решения я рассказывал в этом посте.
Раз с названиями разобрались, двигаемся дальше, ближе к теме сегодняшнего поста.
На хосте под управлением гипервизора ESXi работают виртуальные машины. Мониторинг ресурсов сервера (процессор, память, сеть и т.д.) в случае виртуализации рекомендуется выполнять не на уровне операционной системы виртуальной машины, а (если вам это доступно) на уровне гипервизора VMware.
Web-консоль VMware ESXi позволяет выполнять мониторинг виртуальных машин лишь в реальном времени: статистика по загрузке процессоров, памяти, дисков и сети собирается и хранится только за последний час (рис. 1).
 |
| Рис. 1. Пример панели мониторинга процессора виртуальной машины в ESXi. |
Согласитесь, что для промышленных систем это несерьёзно. Мониторинга фактически нет. Можно отметить, что на уровне операционной системы ESXi сервера (помните, что в основе это Linux) есть утилита esxtop (я упоминал про неё тут), но она тоже показывает только текущую нагрузку в системе.
В свою очередь VMware vCenter имеет гораздо больше возможностей по мониторингу. В его консоли отображается не только текущая картина потребления ресурсов, но и собирается база статистики за прошедшие периоды. Можно выбрать различные метрики: процессорные ресурсы (загрузка в % или в MHz), оперативная память, swap-область, дисковая подсистема (несколько метрик), сеть и так далее. Данные для каждой метрики можно выбрать из стандартного набора интервалов:
- real-time,
- last day,
- last week,
- last month,
- last year,
- или задать свой интервал через custom interval.
Режим отображения real-time похож на то, что можно найти в консоли ESXi и обладает самой высокой точностью данных. Достигается это за счёт частоты сбора. Мне кажется, данные собираются раз в секунд 15-30. А вот дальше есть интересный нюанс, ради которого я и начал писать этот пост. Все остальные интервалы отображают менее детализированные данные, так как vCenter автоматически выполняет агрегацию данных. Если войти в раздел «Configure -> Settings -> General» вашего виртуального Datacenter, то можно увидеть параметры для сбора статистики. Значения по умолчанию выглядят так (рис. 2).
 |
| Рис. 2. Настройки сбора и агрегации статистики производительности. |
Обратите внимание, что для статистики сохранённой за последний день (last day) данные собираются раз в 5 минут, для последней недели (last week) раз в 30 минут, для месяца (last month) раз в 2 часа, а для года (last year) раз в день. Вы можете попробовать поменять настройки, но обнаружите, что самые глубокие доступные значения параметров для хранения статистики выглядят так (рис. 3).
 |
| Рис. 3. Максимально глубокие значения для хранимой статистики. |
Подкрутить можно только первый уровень: для последних 5 дней хранить данные с частотой 1 минута. Глубину данных за более длительные периоды изменить нельзя.
Кстати, хочу обратить внимание, что при изменении этих настроек VMware дополнительно рассчитывает требования к дисковому пространству для хранения статистики (рис. 3). Причём, вы можете подкорректировать количество хостов и виртуальных машин в вашем Datacenter для отображения более реальных значений для текущей инфраструктуры.
Снижение глубины статистики для прошедших периодов было бы не такой большой бедой, если бы не логика работы vCenter в этой части. Снижая частоту хранимых исторических данных, он не просто отбрасывает лишние значения, а автоматически агрегирует данные, усредняя значения. То есть для статистики, хранимой за последнюю неделю, берётся среднее значение с параметров за каждый 30 минутный интервал. А для интервалов старше недели, вообще за каждые 2 часа. Такая логика работы, как я понял, жёстко зашита в vCenter и приводит к сглаживанию показателей нагрузки в зависимости от запрашиваемого интервала.
Давайте я продемонстрирую это наглядно на одной из систем. Рассмотрим статистику по загрузке процессора виртуальной машины последовательно за разные периоды (рис. 4 — 8).
 |
| Рис. 4. Просмотр статистики загрузки CPU в реальном времени. |
 |
| Рис. 5. Просмотр статистики загрузки CPU за последние сутки. |
 |
| Рис. 6. Просмотр статистики загрузки CPU за последнюю неделю. |
 |
| Рис. 7. Просмотр статистики загрузки CPU за последний месяц. |
 |
| Рис. 8. Просмотр статистики загрузки CPU за год. |
Замечаете как показатели утилизации процессора из 50-75% постепенно превращаются в 40-60%, потом опускаются ниже 50%, а в годовом разрезе вообще не поднимаются выше 15%? 🙂
Рассмотрим ещё один пример. График загрузки процессора виртуальной машины за неделю показывает пиковые значения не выше 60%, и то только один раз. В остальные дни не выше 50%. Можно сделать преждевременные выводы, что процессорных ресурсов данной системе хватает.
 |
| Рис. 9. Пример статистики загрузки процессора виртуальной машины за неделю. |
А при этом на интервалах real-time для данной виртуальной машины фиксировались пики до 100% (рис. 10-12).
 |
| Рис. 10. Мониторинг загрузки процессора виртуальной машины в реальном времени. |
 |
| Рис. 11. Мониторинг загрузки процессора виртуальной машины в реальном времени. |
 |
| Рис. 12. Мониторинг загрузки процессора виртуальной машины в реальном времени. |
Если же обратиться к статистике за месяц, то опять видим ту же картину: пики едва превышают 40%. Сравните последние дни на разных графиках, где мы точно знаем, что были значения и по 100%. На графике с большим периодом отображения таких значений просто нет: они сглажены агрегацией (рис. 13).
 |
| Рис. 13. Пример статистики загрузки процессора виртуальной машины за месяц. |
Какие выводы из всего этого можно сделать?
Во-первых, нужно учитывать эту особенность сбора и отображения статистики по загрузке ресурсов виртуальной машины в VMware. Годовой график смотреть смысла нет, статистика гораздо ниже реальной. И даже в помесячном разрезе сглаженный график ниже реального где-то на 50%.
Во-вторых, периодически смотрите график в реальном времени, сравнивая его значения с недельной или месячной статистикой. Только в этом разрезе можно увидеть реальные значения нагрузки на систему.
Для некоторых приложений могут быть критичны, например, процессорные ресурсы сервера. И при их нехватке (достижении утилизации в 100%), даже на короткий период, происходят события в виде отказа в обслуживании или резкого снижения производительности приложений.
Виртуализация позволяет оптимизировать утилизацию ваших ресурсов за счёт размещения на одном физическом сервере нескольких виртуальных серверов. Но при проектировании виртуальных машин мы должны обеспечить достаточность процессорных ресурсов. Мы же используем виртуализацию для оптимизации, полагая что процессорные ресурсы в полном объёме физического сервера приложениям в этой виртуальной машине не нужны. А, если приложения утилизируют все ресурсы виртуальной машины, упираясь в ограничения, наложенные гипервизором, то значит ресурсы были распределены некорректно. Или за время в пути собачка могла подрасти.
В любом случае, эти ситуации надо отслеживать и, если есть возможность, вносить корректировки в настройки виртуальных машин. С другой стороны, сразу давать виртуальным машинам очень много процессорных ресурсов тоже не рекомендуется. Это приводит к снижению производительности виртуальной машины. Наша цель: найти баланс по ресурсам. Чтобы их было не много, но и недостатка тоже не наблюдалось.
В отслеживании пиков в потреблении процессорных ресурсов может помочь настройка Alarms в vCenter. По умолчанию существует Alarm с именем » Virtual machine CPU usage «, который срабатывает при потреблении больше 75% процессорных ресурсов в течении 5 минут (рис. 14).
 |
| Рис. 14. Настройки Alarm «Virtual machine CPU usage«. |
Возникновение этих событий для виртуальной машины в прошлом можно найти в разделе Events (рис. 15).
 |
| Рис. 15. История возникновения событий превышения утилизации процессора виртуальной машиной. |
Так вы по крайней мере сможете оценить в какие моменты и как часто не хватает процессорных ресурсов вашей виртуальной машине. Можно создать свой Alarm по аналогии с существующим, подкорректировав пороги срабатывания.
Все эти рассуждения справедливы так же для распределения и мониторинга других ресурсов виртуальных машин: оперативной памяти, сети, дисков.