Сколько указателей используется в односвязных списках
Понятие «списки» включает в себя самые разные структуры данных. Это могут быть и массивы, в том числе массивы записей, и специальные динамические структуры данных, и даже деревья. Общим для них является то, что они содержат набор записей одного вида, ограниченный по размеру или неограниченный, упорядоченный или неупорядоченный. Данные, хранящиеся в этих записях, обычно логически связаны между собой, например, фамилии студентов одной группы и т.п. В тексте программы такая связь может выражаться в том, что все такие элементы хранятся в одном и том же массиве как непрерывном блоке памяти. Но кроме общего имени массива (и адреса его начала) между этими элементами никакой другой физической связи нет, и на физическом уровне подобные списки могут быть названы «несвЯзными» (или, что (почти) то же самое, «несвязанными«). Т.е. внутри них нет связей (их элементы не связаны друг с другом физически).
Типичным примером незвязного (физически) списка является массив. В этой главе мы рассмотрим те самые «специальные динамические структуры данных», которые и получили название свЯзных списков.
3. Связные списки
- Строгие правила доступа к данным;
- Операции извлечения (считывания) данных являются разрушающими.
Связные списки свободны от этих ограничений. Они допускают гибкие методы доступа; извлечение (чтение) элемента из списка не приводит к удалению его из списка и потере данных. Для фактического удаления элемента из связного списка требуется специальная процедура.
Связные списки представляют собой (как ужЕ было сказано) динамические (фактически, линейные!) структуры данных (динамические цепочки звеньев), в которых однотипные элементы (звенья) каким-либо образом связаны между собой, обычно на физическом уровне. Связь между элементами можно осуществить за счёт хранения в одном элементе адреса другого такого же элемента (того же типа). Т.е. каждый информационный элемент содержит внутри себя указатель на собственный тип. Учитывая, что кроме этого указателя должны присутствовать полезные данные, тип информационного элемента оказывается записью. Например, для простейшего вида списка этот тип может быть следующим (на языках Си/Си++):
struct Link1
int data;
Link1* next;
>;
Классификация связных списков. По числу связей (и одновременно, направлению) списки бывают односвязными (однонаправленными), двусвязными (двунаправленными) и многосвязными.
По способу организации связей (или по архитектуре) списки могут быть линейными и кольцевыми (циклическими). (Если список не является ни линейным, ни кольцевым, то остаётся единственный вариант – ветвящийся список, фактически являющийся одной из древовидных структур данных.)
По степени упорядоченности хранимых данных списки могут быть упорядоченными и неупорядоченными. Такое разделение иногда бывает удобно на практике, но для поддержания упорядоченности списков приходится прибегать к специальным мерам.
- добавление нового звена списка (вставка звена);
- удаление звена;
- просмотр (или прохождение) списка;
- поиск данных в списке;
- создание ведущего (заглавного) звена (при необходимости);
- сортировка списка;
- обращение (реверсирование) списка, т.е. перестановка всех его звеньев в обратном порядке.
Рассмотрим основные из этих операций для каждого вида списка отдельно, вместе с особенностями этих видов списков.
Линейный односвязный список
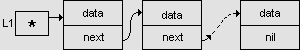
Линейный односвязный список является самым простым видом связных списков. Такой список можно определить с помощью описаний типов (см. пример 1).
Процедуры работы с линейным односвязным списком на языке Паскаль
Type
rel1 = ^elem; (* Указатель на запись *)
elem = record
next: rel1;
data: (* Любой допустимый тип данных *)
end;
var
L1: rel1;
Ддя того, чтобы такие операции, как добавление или удаление звена, выполнялись одинаково, независимо от места их выполнения в списке, удобно использовать ведущее или заглавное звено — самое первое звено списка, в котором не обязаны храниться полезные данные. Его создание для односвязного списка можно осуществить следующим образом:
Указатель на начало списка L1, значением которого является адрес ведущего звена, представляет список как единый программный объект.
Указатель на следующий элемент в последнем звене списка имеет значение nil (NULL или просто 0 в Си/Си++), что является признаком линейного списка.
procedure insert1(link: rel1; info: );
var q: rel1;
begin
new(q);
q^.data := info;
q^.next := link^.next;
link^.next := q
end;
procedure delete1(link:rel1);
var q: rel1;
begin
if link^.next <> nil then
begin
q := link^.next;
link^.next := link^.next^.next;
dispose(q);
end
end;
function search1(l: rel1; info: ; var r: rel1):boolean;
var q: rel1;
begin
search1 := false;
r := nil;
q := l^.next;
while (q <> nil) and (r <> nil) do
begin
if q^.data = info then
begin
search := true;
r := q
end;
q := q^.next
end
end;
Процедуры добавления и удаления звеньев являются критическими с точки зрения сохранения целостности списка. При неправильном выполнении этих процедур (т.е. при неправильной очерёдности выполнения операций присваивания) возможны 2 ошибочные ситуации:
1. Список «рвётся» по месту вставки или удаления звена, и звено, оказавшее последним, замыкается либо само на себя (чаще всего) (т.е. указатель next или аналогичный ему в этом звене получает значение адреса этого же звена), либо на одно из предшествующих звеньев (в зависимости от неправильной реализации операций вставки или удаления звена). При попытке просмотра списка процедура просмотра зацикливается и бесконечно выводит содержимое одного и того же звена (или нескольких звеньев).
2. Список так же «рвётся» по месту вставки или удаления звена, но указатель в звене, ставшем последним, получает какое-то произвольное значение, которое трактуется как адрес следующего звена (реально не существующего), у которого также есть указатель next, содержащий какой-то адрес, и так далее, до тех пор, пока случайно не попадётся блок данных, для которого указатель next не будер равен нулю. При попытке просмотра списка на дисплей сначала выводятся правильные данные, а затем случайный набор символов.
В обоих случаях к звеньям в «оторвавшейся» части («хвосте») списка больше нет доступа, и хранящиеся в них данные можно считать потерянными.
Для предовращения возникновения таких ошибок следует соблюдать правильный порядок проведения связей (т.е. присваивания указателей) при вставке нового звена и удалении существующего (очерёдность операций указана):
Добавление звена в произвольную позицию за ведущим звеном:
struct Link1
int data;
Link1* next;
>;
void Insert1(Link1* link, int data) // link — звено, за которым вставляется новое
Link1* q = new Link1; // 1 Выделение памяти под новое звено
q->data = data; // 2 Ввод данных
q->next = link->next; // 3 Проведение связи от нового звена к следующему
link->next = q; // 4 Проведение связи от «старого» звена у новому
>
Возможность перемещаться по 1-связному списку только в одном направлении приводит к тому, что при удалении звена приходится задавать не реально удаляемое звено, а предшествующее ему. Это делается для того, чтобы можно было скорректировать связь для предшествующего звена, добраться до которого от удаляемого иначе невозможно.
Удаление звена из любого места списка за ведущим звеном:
void Delete1(Link1* link) // link — звено, предшествующее удаляемому
Link1* q;
if (link->next) // Проверка на наличие звена, следующего за link
q = link->next // 1 Запоминание удаляемого звена для операции delete
link->next = q->next; // 2 Проведение новой связи в обход удаляемого звена
delete q; // 3 Очистка памяти
>
>
Одной из наиболее простых операций со всеми типами списков является их прохождение, т.е. поочерёдное получение доступа ко всем элементам. Приведём процедуру, реализующую эту операцию для просмотра списка (другие варианты использования прохождения – поиск данных и сохранение списка в файл). В случае перемещения по 2-связному списку в «прямом» направлении эта процедура является одинаковой для 1- и 2-связного линейных списков.
Просмотр 1-связного линейного списка
void Show(Link1* link)
Link1 *q = link->next; // Учитывается наличие «пустого» ведущего звена
while (q) // или while(q!=NULL)
coutdata q = q->next; // Переход по списку
>
cout >
Поиск в списке является вариантом операции просмотра и отличается тем, что:
1. вместо операции вывода на экран (coutdata) используется операция сравнения искомых данных с хранящимися в звеньях списка;
2. если искомые данные найдены, нет необходимости перемещаться по списку дальше.
Поиск в односвязных списках имеет следующую особенность. Если он выполняется в сочетании с удалением, то результатом поиска может (или должно) быть не то звено, в котором содержатся искомые данные, а предшествующее ему. В итоге для поиска в списке могут потребоваться либо две различные процедуры – «обычная» и находящая предыдущее звено, либо одна универсальная, позволяющая найти оба звена – с искомыми данными и предшествующее ему. Рассмотрим в качестве примера именно этот вариант
Универсальная процедура поиска (находит звено с ключом поиска и предшествующее ему)
int Search(Link1* Start, // Точка начала поиска
Link1*& Find, // Указатель для звена с искомыми данными
Link1*& Pred, // Указатель для предыдущего звена
int Key) // Ключ поиска
Link1* Cur = Start->next; // Текущее звено
Pred = Start; // Предыдущее звено («отстаёт» на 1 шаг от текущего)
int Success = 0; // Признак успеха поиска (установлен в 0)
while (Cur && !Success) // Операция логическое «И»
if (Cur->data == Key) // нашли
Find = Cur; // Запоминание найденного звена
Success = 1; // Установка в 1 признака успеха
break; // Выход из цикла при удачном поиске
>
Pred = Cur; // Перемещение предыдущего звена
Cur = Cur->next; // Переход по списку вперёд
>
return Success;
>
Следует отметить, что возможны разные (в том числе более короткие) варианты реализации такого алгоритма, например, без переменной Success (вместо неё используется указатель Find, который до начала поиска должен получить значение NULL и сохранить его при неудачном поиске).
Процедура, которая находит только искомое звено, является более простой, – в ней не нужен указатель Pred и все операторы, в которых он используется.
Похожая процедура применяется для 1-связного кольцевого списка. Отличие её от рассмотренного примера заключается в условии продолжения цикла в операторе while:
while(Cur != Start && !Success) // Для кольцевого списка
Ведущее (или заглавное) звено. Все приведённые выше примеры на языке Си++ подразумевают наличие в списке ведущего звена. Создаваться это звено может либо отдельной процедурой, либо следующим набором операторов (эти же операторы и будут находиться в процедуре):
Link1 *L1 = new Link1; // Выделение памяти под звено
L1->next = NULL; // Ведущее звено одновременно является последним
Возможна работа со связным списком и без выделенного ведущего звена, т.е. первое звено является обычным, в нём содержатся полезные данные. Именно такой вид списка использовался для организации стека. Ещё один пример использования подобных списков — очередь.
Занесение в очередь и извлечение из очереди, построенной на основе 2-связного списка
void queue_in(Link2*& q, // «Голова» очереди
Link2*& e, // «Хвост» очереди
int k) // Вводимые данные
Link2* n = new node; // Новый узел
n->data = k;
n->next = q;
if (q)
q->prev = n;
else
e = n;
n->prev = 0;
q = n;
>
Для упрощения обработки «головы» и «хвоста» очереди использован 2-связный список.
В остальных случаях (т.е. для обычных списков) использование ведущего звена является предпочтительным, т.к. позволяет избежать проверок при добавлении и удалении звеньев.
Недостатки односвязного списка заключаются в следующем:
1. По такому списку можно перемещаться только от начального звена к конечному. Начинать можно с любого звена в списке, но если вдруг возникнет необходимость обратиться к предшествующим элементам, придется начинать с начального звена, что неудобно, нерационально и усложняет алгоритмы обработки данных.
2. Наличие только одной связи снижает надёжность хранения данных в 1-связном списке.
3. Следствием первого недостатка является усложнение взаимодействия операций поиска и удаления.
Достоинствами этого списка являются меньший расход памяти по сравнению с другими свЯзными динамическими структурами данных (всего 1 указатель) и простота операций.
Линейный двусвязный список
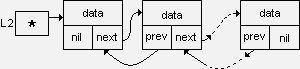
Этот список свободен от недостатков, присущих односвязному списку. Для этого в каждое звено добавлен еще один указатель на тип звена, значением которого является адрес предыдущего звена списка. Тип звена на языках Си/Си++:
struct Link2
int data;
Link2 *next, *prev;
>;
Структура списка будет выглядеть следующим образом (значения нулевых указателей показаны для языка Паскаль):
Ведущее звено этого списка создаётся следующим набором операторов:
Link2 *L2 = new Link2;
L2->next = NULL;
L2->prev = NULL;
По операторам создания ведущего звена можно судить о том, является список, 1- или 2-связным, линейным или кольцевым. Нулевые значения указателей next и prev являются признаком линейного списка.
Графически состояние списка после создания ведущего звена может быть отображено следующим образом:
- есть возможность перестроить поврежденный список;
- проще выполняются некоторые операции (например, удаление).
Операции с 2-связным списком.Всё, что касалось операций добавления звена и его удаления для 1-связного списка, справедливо и для 2-связного. Так же должен соблюдаться правильный порядок проведения (или удаления) связей между звеньями, но таких операций стало больше, т.к. должны обрабатываться 2 указателя. Кроме того, каждая из операций обладает дополнительыми особенностями:
1. При добавлении нового звена в пустой список, т.е. содержащий только ведущее звено (см. предыдущий рисунок), или при добавлении звена в конец списка (для пустого списка обе эти ситуации совпадают) необходимо проверять наличие звена, которое будет следующим за добавляемым (для пустого списка или конца списка такого звена нет, а значит нет и указателя, обозначающего связь). Такая же проверка должна выполняться при удалении звена.
2. Возможность перемещаться по списку в обоих направлениях позволяет напрямую задавать удаляемое звено (а не ему предшествующее, как в 1-связном списке). Следствием этого является упрощение как операции удаления, так и операции поиска.
Добавление звена в произвольную позицию за ведущим звеном
void Insert2(Link2* St, int data)
Link2* q = new Link2; // 1 Выделение памяти под звено
q->data = data; // 2 Ввод данных
q->next = St->next; // 3 Проведение связи от нового звена вперёд
q->prev = St; // 4 Проведение связи от нового звена назад
St->next = q; // 5 Проведение связи от предыдущего звена к новому
if (q->next) // Проверка наличия следующего звена
q->next->prev = q; // 6 Проведение связи от следующего звена к новому
>
Удаление звена из любого места списка за ведущим звеном
void Delete2(Link2* del)
del->prev->next = del->next; // 1 Обработка связи вперёд
if (del->next)
del->next->prev = del->prev; // 2 Обработка связи назад
delete del; // 3 Освобождение памяти
>
Эта процедура поиска фактически является (за исключением типа данных Link2 вместо Link1) процедурой «обычного» поиска (т.е. не для удаления) в 1-связном списке.
Операция просмотра списка в прямом направлении ничем не отличается от просмотра 1-связного списка.
Кольцевые списки
Если значение указателя последнего звена линейного односвязного списка заменить с nil (или NULL) на адрес ведущего звена, то линейный список превратится в односвязный кольцевой список.
Для двусвязного списка, кроме того, нужно заменить с nil на адрес последнего звена значение второго указателя в ведущем звене. Получится двусвязный кольцевой (циклический) список.
В односвязном кольцевом списке можно переходить от последнего звена к заглавному, а в двусвязном – еще и от заглавного к последнему.
Двусвязный кольцевой список выглядит так:
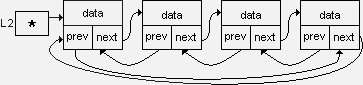
Кольцевой список, как и линейный, идентифицируется как единый программный объект указателем, например L2, значением которого является адрес заглавного звена.
Возможен другой вариант организации кольцевого списка:
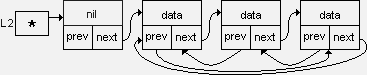
Оба варианта сопоставимы по сложности. Для первого варианта проще выполняется вставка нового элемента как в начало списка (после заглавного звена), так и в конец – так как вставка звена в конец кольцевого списка эквивалентна вставке перед заглавным звеном, но каждый раз при циклической обработке списка нужно проверять, не является ли текущее звено заглавным (или не совпадает ли текущее звено с точкой начала обработки).
Рассмотрим операции с кольцевыми списками.
Отсутствие «последнего» звена приводит к ещё большему упрощению операций добавления и удаления, по сравнению с 1- и 2-связным линейным списком. Например, для 1-связного кольцевого списка в процедуре удаления отсутствует оператор if – проверка на существование звена, следующего за заданным (в кольцевом списке такое звено всегда есть). Такие же операторы отсутствуют в процедурах добавления и удаления звеньев для 2-связного кольцевого списка.
При циклической обработке кольцевого списка нужно учесть, что формально последнего звена нет.
Программа работы с двусвязным кольцевым списком на языке Паскаль
Type
rel2 = ^elem2;
elem2 = record
next: rel1;
prev: rel2;
data:
end;
list2 = rel2;
procedure insert2(pred: rel2; info: );
var
q: rel2;
begin
new(q); (* Создание нового звена *)
q^.data := info;
q^.next := pred^.next;
q^.prev := pred^.next^.prev;
pred^.next.prev := q;
pred^.next := q
end;
При вставке в начало списка (после заглавного звена) нужно указать в качестве аргумента pred адрес заглавного звена, то есть указатель на список L2.
procedure delete2(del: rel2);
begin
del^.next^.prev := del^.prev;
del^.prev^.next := del^.next;
dispose(del);
end;
function search2(list: rel2; info: ; var point: rel2):boolean;
var
p,q: rel2;
b:boolean;
begin
b := false;
point := nil;
p := list;
q := p^.next;
while (p <> q) and (not b) do
begin
if q^.data = info then
begin
b := true;
point := q
end;
q := q^.next
end;
search2 := b
end;
var
l2: list2;
r: rel2;
begin (* Создание заглавного звена *)
new(r);
r^.next := r;
r^.pred := r;
l2 := r;
Процедуры работы с двусвязным кольцевым списком на языке Си++
Тип данных для кольцевого 2-связного списка такой же, как и для 2-связного линейного. То же самое справедливо для 1-связных списков. По типу звена списка нельзя судить о его архитектуре, можно — только о числе связей.
Добавление звена в произвольную позицию за ведущим звеном
void Insert(Link2* Pred, int data)
Link2* Loc = new Link2; // 1
Loc->Value = data; // 2
Loc->next = Pred->next; // 3
Loc->prev = Pred; // 4
Pred->next = Loc; // 5
Loc->next->prev = Loc; // 6
>
Удаление звена из любого места списка за ведущим звеном
void Delete2(Link2* Del)
Del->prev->next = Del->next; // 1
Del->next->prev = Del->prev; // 2
delete Del; // 3
>
Поиск
Прекращение поиска в случае неудачи происходит при достижении «текущим» указателем Cur точки начала поиска Start, т.е. при невыполнении условия в операторе while:
while(Cur != Start . )
Ведущее звено кольцевого 2-связного списка создаётся набором операторов:
Link2 *L2 = new Link2;
L2->next = L2;
L2->prev = L2;
Графически состояние списка после создания этого звена может быть представлено таким образом:
Многосвязные списки
Многосвязные списки представляют собой динамические структуры данных, в основу которых положены 1- или 2-связные списки, в которых имеются дополнительные связи между звеньями. Чаще всего, такие связи проводятся между далеко отстоящими звеньями, например, обозначающими категории данных. Пример многосвязного списка показан на следующем рисунке.
Переход между звеньями АА и БА может выполнен по дополнительной связи, в обход звеньев АБ и АВ. Из-за такого характера перемещения эти списки иногда называют скип-списками (skip – перепрыгивать). А при характере размещения данных, подобном показанному на этом рисунке, такие списки называют словарными (иногда просто словарями, но термин «словарь» может использоваться в теории структур данных в разных значениях).
Контрольные вопросы
1. Что представляют собой связные списки?
2. К каким классификационным группам структур данных относятся списки?
3. Какие существуют разновидности связных списков?
4. В чем состоит отличие несвязного списка от массива?
5. В чем состоит отличие связного списка от массива?
6. В чем состоит отличие линейного списка от кольцевого?
7. В чем заключаются недостатки односвязного списка?
8. В чем состоит отличие односвязного списка от двусвязного?
9. Какие операции применяются для связных списков?
10. В чем отличие считывания информации из списка от считывания из очереди или стека?
11. Особенности операций вставки и удаления для связных списков.
12. В чем отличие операции вставки в двусвязный список от вставки в односвязный список?
13. В чем отличие операции удаления из двусвязного списка от удаления из односвязного списка?
14. В чем заключаются особенности работы с кольцевыми списками?
15. Какой тип должно иметь звено связного списка? Почему?
16. Что обязательно должно содержать звено связного списка?
17. В чем состоит отличие звена двусвязного списка от звена односвязного списка?
18. В чем состоит отличие связного списка от стека, организованного в виде связного списка?
19. Перечислите сходства и отличия списков и очередей.
20. Перечислите достоинства и недостатки линейных односвязных списков.
21. В чем заключается поиск в списке?
22. Изобразите структуру линейного односвязного списка.
23. Изобразите структуру линейного двусвязного списка.
24. Перечислите достоинства и недостатки линейных двусвязных списков.
25. Изобразите возможные структуры двусвязных кольцевых списков.
26. Объясните назначение заглавного звена в списках.
27. На каких структурах данных могут строится списки?
Односвязный список
О дносвязный список – структура данных, в которой каждый элемент (узел) хранит информацию, а также ссылку на следующий элемент. Последний элемент списка ссылается на NULL.
Для нас односвязный список полезен тем, что
- 1) Он очень просто устроен и все алгоритмы интуитивно понятны
- 2) Односвязный список – хорошее упражнение для работы с указателями
- 3) Его очень просто визаулизировать, это позволяет «в картинках» объяснить алгоритм
- 4) Несмотря на свою простоту, односвязные списки часто используются в программировании, так что это не пустое упражнение.
- 5) Эта структуру данных можно определить рекурсивно, и она часто используется в рекурсивных алгоритмах.
Для простоты рассмотрим односвязный список, который хранит целочисленное значение.
Односвязный список
Односвязный список состоит из узлов. Каждый узел содержит значение и указатель на следующий узел, поэтому представим его в качестве структуры
typedef struct Node < int value; struct Node *next; >Node;
Чтобы не писать каждый раз struct мы определили новый тип.
Теперь наша задача написать функцию, которая бы собирала список из значений, которые мы ей передаём. Стандартное имя функции – push, она должна получать в качестве аргумента значение, которое вставит в список. Новое значение будет вставляться в начало списка. Каждый новый элемент списка мы должны создавать на куче. Следовательно, нам будет удобно иметь один указатель на первый элемент списка.
Node *head = NULL;
Вначале списка нет и указатель ссылается на NULL.
Для добавления нового узла необходимо
- 1) Выделить под него память.
- 2) Задать ему значение
- 3) Сделать так, чтобы он ссылался на предыдущий элемент (или на NULL, если его не было)
- 4) Перекинуть указатель head на новый узел.
1) Создаём новый узел
Создали новый узел, на который ссылается локальная переменная tmp
2) Присваиваем ему значение
Присвоили ему значение
3) Присваиваем указателю tmp адрес предыдущего узла
Перекинули указатель tmp на предыдущий узел
4) Присваиваем указателю head адрес нового узла
Перекинули указатель head на вновь созданный узел tmp
5) После выхода из функции переменная tmp будет уничтожена. Получим список, в который будет вставлен новый элемент.
Новый узел добавлен
void push(Node **head, int data) < Node *tmp = (Node*) malloc(sizeof(Node)); tmp->value = data; tmp->next = (*head); (*head) = tmp; >
Так как указатель head изменяется, то необходимо передавать указатель на указатель.
Теперь напишем функцию pop: она удаляет элемент, на который указывает head и возвращает его значение.
Если мы перекинем указатель head на следующий элемент, то мы потеряем адрес первого и не сможем его удалить и тем более вернуть его значения. Для этого необходимо сначала создать локальную переменную, которая будет хранить адрес первого элемента
Локальная переменная хранит адрес первого узла
Уже после этого можно удалить первый элемент и вернуть его значение
Перекинули указатель head на следующий элемент и удалили узел
int pop(Node **head) < Node* prev = NULL; int val; if (head == NULL) < exit(-1); >prev = (*head); val = prev->value; (*head) = (*head)->next; free(prev); return val; >
Не забываем, что необходимо проверить на NULL голову.
Таким образом, мы реализовали две операции push и pop, которые позволяют теперь использовать односвязный список как стек. Теперь добавим ещё две операции — pushBack (её ещё принято называть shift или enqueue), которая добавляет новый элемент в конец списка, и функцию popBack (unshift, или dequeue), которая удаляет последний элемент списка и возвращает его значение.
Для дальнейшего разговора необходимо реализовать функции getLast, которая возвращает указатель на последний элемент списка, и nth, которая возвращает указатель на n-й элемент списка.
Так как мы знаем адрес только первого элемента, то единственным способом добраться до n-го будет последовательный перебор всех элементов списка. Для того, чтобы получить следующий элемент, нужно перейти к нему через указатель next текущего узла
Node* getNth(Node* head, int n) < int counter = 0; while (counter < n && head) < head = head->next; counter++; > return head; >
Переходя на следующий элемент не забываем проверять, существует ли он. Вполне возможно, что был указан номер, который больше размера списка. Функция вернёт в таком случае NULL. Сложность операции O(n), и это одна из проблем односвязного списка.
Для нахождение последнего элемента будем передирать друг за другом элементы до тех пор, пока указатель next одного из элементов не станет равным NULL
Node* getLast(Node *head) < if (head == NULL) < return NULL; >while (head->next) < head = head->next; > return head; >
Теперь добавим ещё две операции — pushBack (её ещё принято называть shift или enqueue), которая добавляет новый элемент в конец списка, и функцию popBack (unshift, или dequeue), которая удаляет последний элемент списка и возвращает его значение.
Для вставки нового элемента в конец сначала получаем указатель на последний элемент, затем создаём новый элемент, присваиваем ему значение и перекидываем указатель next старого элемента на новый
void pushBack(Node *head, int value) < Node *last = getLast(head); Node *tmp = (Node*) malloc(sizeof(Node)); tmp->value = value; tmp->next = NULL; last->next = tmp; >
Односвязный список хранит адрес только следующего элемента. Если мы хотим удалить последний элемент, то необходимо изменить указатель next предпоследнего элемента. Для этого нам понадобится функция getLastButOne, возвращающая указатель на предпоследний элемент.
Node* getLastButOne(Node* head) < if (head == NULL) < exit(-2); >if (head->next == NULL) < return NULL; >while (head->next->next) < head = head->next; > return head; >
Функция должна работать и тогда, когда список состоит всего из одного элемента. Вот теперь есть возможность удалить последний элемент.
void popBack(Node **head) < Node *lastbn = NULL; //Получили NULL if (!head) < exit(-1); >//Список пуст if (!(*head)) < exit(-1); >lastbn = getLastButOne(*head); //Если в списке один элемент if (lastbn == NULL) < free(*head); *head = NULL; >else < free(lastbn->next); lastbn->next = NULL; > >
Удаление последнего элемента и вставка в конец имеют сложность O(n).
Можно написать алгоритм проще. Будем использовать два указателя. Один – текущий узел, второй – предыдущий. Тогда можно обойтись без вызова функции getLastButOne:
int popBack(Node **head) < Node *pFwd = NULL; //текущий узел Node *pBwd = NULL; //предыдущий узел //Получили NULL if (!head) < exit(-1); >//Список пуст if (!(*head)) < exit(-1); >pFwd = *head; while (pFwd->next) < pBwd = pFwd; pFwd = pFwd->next; > if (pBwd == NULL) < free(*head); *head = NULL; >else < free(pFwd->next); pBwd->next = NULL; > >
Теперь напишем функцию insert, которая вставляет на n-е место новое значение. Для вставки, сначала нужно будет пройти до нужного узла, потом создать новый элемент и поменять указатели. Если мы вставляем в конец, то указатель next нового узла будет указывать на NULL, иначе на следующий элемент
void insert(Node *head, unsigned n, int val) < unsigned i = 0; Node *tmp = NULL; //Находим нужный элемент. Если вышли за пределы списка, то выходим из цикла, //ошибка выбрасываться не будет, произойдёт вставка в конец while (i < n && head->next) < head = head->next; i++; > tmp = (Node*) malloc(sizeof(Node)); tmp->value = val; //Если это не последний элемент, то next перекидываем на следующий узел if (head->next) < tmp->next = head->next; //иначе на NULL > else < tmp->next = NULL; > head->next = tmp; >
Покажем на рисунке последовательность действий
Создали новый узел и присвоили ему значение
После этого делаем так, чтобы новый элемент ссылался на следующий после n-го
Теперь значение next нового узла хранит адрес того же узла, что и элемент, на который ссылается head
Перекидываем указатель next n-го элемента на вновь созданный узел
Теперь узел, адрес которого хранит head, указывает на новый узел tmp
Функция удаления элемента списка похожа на вставку. Сначала получаем указатель на элемент, стоящий до удаляемого, потом перекидываем ссылку на следующий элемент за удаляемым, потом удаляем элемент.
int deleteNth(Node **head, int n) < if (n == 0) < return pop(head); >else < Node *prev = getNth(*head, n-1); Node *elm = prev->next; int val = elm->value; prev->next = elm->next; free(elm); return val; > >
Рассмотрим то же самое в картинках. Сначала находим адреса удаляемого элемента и того, который стоит перед ним
Для удаления узла, на который ссылается elm необходим предыдущий узел, адрес которого хранит prev
После чего прокидываем указатель next дальше, а сам элемент удаляем.
Прекидываем указатель на следующий за удалённым узел и освобождаем память
Кроме создания списка необходимо его удаление. Так как самая быстрая функция у нас этот pop, то для удаления будем последовательно выталкивать элементы из списка.
void deleteList(Node **head) < while ((*head)->next) < pop(head); *head = (*head)->next; > free(*head); >
Вызов pop можно заменить на тело функции и убрать ненужные проверки и возврат значения
void deleteList(Node **head) < Node* prev = NULL; while ((*head)->next) < prev = (*head); (*head) = (*head)->next; free(prev); > free(*head); >
Осталось написать несколько вспомогательных функций, которые упростят и ускорят работу. Первая — создать список из массива. Так как операция push имеет минимальную сложность, то вставлять будем именно с её помощью. Так как вставка произойдёт задом наперёд, то массив будем обходить с конца к началу:
void fromArray(Node **head, int *arr, size_t size) < size_t i = size - 1; if (arr == NULL || size == 0) < return; >do < push(head, arr[i]); >while(i--!=0); >
И обратная функция, которая возвратит массив элементов, хранящихся в списке. Так как мы будем создавать массив динамически, то сначала определим его размер, а только потом запихнём туда значения.
int* toArray(const Node *head) < int leng = length(head); int *values = (int*) malloc(leng*sizeof(int)); while (head) < values[--leng] = head->value; head = head->next; > return values; >
И ещё одна функция, которая будет печатать содержимое списка
void printLinkedList(const Node *head) < while (head) < printf("%d ", head->value); head = head->next; > printf("\n"); >
Теперь можно провести проверку и посмотреть, как работает односвязный список
void main() < Node* head = NULL; int arr[] = ; //Создаём список из массива fromArray(&head, arr, 10); printLinkedList(head); //Вставляем узел со значением 333 после 4-го элемента (станет пятым) insert(head, 4, 333); printLinkedList(head); pushBack(head, 11); pushBack(head, 12); pushBack(head, 13); pushBack(head, 14); printLinkedList(head); printf("%d\n", pop(&head)); printf("%d\n", popBack(&head)); printLinkedList(head); //Удаляем пятый элемент (индексация с нуля) deleteNth(&head, 4); printLinkedList(head); deleteList(&head); getch(); >
Сортировка односвязного списка
Сортировать список будем слиянием. Этот метод очень похож на сортировку слиянием для массива. Для его реализации нам понадобятся две функции: одна буде делить список пополам, а другая будет объединять два упорядоченных односвязных списка, не создавая при этом новых узлов. Наша реализация не будет оптимальной, однако, некоторые решения, которые мы применим, могут быть использованы и в других алгоритмах.
Вспомогательная функция – слияние двух отсортированных списков. Функция не должна создавать новых узлов, так что будем использовать только имеющиеся. Для начала проверим, если хоть один из списков пуст, то вернём другой.
Node tmp; *c = NULL; if (a == NULL) < *c = b; return; >if (b == NULL)
После этого нужно, чтобы наша локальная переменная стала хранить адрес большего из узлов двух списков, от него и будем танцевать дальше
if (a->value < b->value) < *c = a; a = a->next; > else < *c = b; b = b->next; >
Теперь сохраним указатель c, так как в дальнейшем он будет использоваться для прохода по списку
tmp.next = *c;
После этого проходим по спискам, сравниваем значения и перекидываем их
while (a && b) < if (a->value < b->value) < (*c)->next = a; a = a->next; > else < (*c)->next = b; b = b->next; > (*c) = (*c)->next; >
В конце, может остаться один список, который пройден не до конца. Добавим его узлы
if (a) < while (a) < (*c)->next = a; (*c) = (*c)->next; a = a->next; > > if (b) < while (b) < (*c)->next = b; (*c) = (*c)->next; b = b->next; > >
Теперь указатель c хранит адрес последнего узла, а нам нужна ссылка на голову. Она как раз хранится во второй переменной tmp
*c = tmp.next;
void merge(Node *a, Node *b, Node **c) < Node tmp; *c = NULL; if (a == NULL) < *c = b; return; >if (b == NULL) < *c = a; return; >if (a->value < b->value) < *c = a; a = a->next; > else < *c = b; b = b->next; > tmp.next = *c; while (a && b) < if (a->value < b->value) < (*c)->next = a; a = a->next; > else < (*c)->next = b; b = b->next; > (*c) = (*c)->next; > if (a) < while (a) < (*c)->next = a; (*c) = (*c)->next; a = a->next; > > if (b) < while (b) < (*c)->next = b; (*c) = (*c)->next; b = b->next; > > *c = tmp.next; >
Ещё одна важная функция – нахождение середины списка. Для этих целей будем использовать два указателя. Один из них — fast – за одну итерацию будет два раза изменять значение и продвигаться по списку вперёд. Второй – slow, всего один раз. Таким образом, если список чётный, то slow окажется ровно посредине списка, а если список нечётный, то второй подсписок будет на один элемент длиннее.
void split(Node *src, Node **low, Node **high) < Node *fast = NULL; Node *slow = NULL; if (src == NULL || src->next == NULL) < (*low) = src; (*high) = NULL; return; >slow = src; fast = src->next; while (fast != NULL) < fast = fast->next; if (fast != NULL) < fast = fast->next; slow = slow->next; > > (*low) = src; (*high) = slow->next; slow->next = NULL; >
Очевидно, что можно было один раз узнать длину списка, а потом передавать размер в каждую функцию. Это было бы проще и быстрее. Но мы не ищем лёгких путей)))
Теперь у нас есть функция, которая позволяет разделить список на две части и функция слияния отсортированных списков. С их помощью реализуем функцию сортировки слиянием.
Сортировка слиянием для односвязного списка
Функция рекурсивно вызывает сама себя, передавая части списка. Если в функцию пришёл список длинной менее двух элементов, то рекурсия прекращается. Идёт обратная сборка списка. Сначала из двух списков, каждый из которых хранит один элемент, создаётся отсортированный список, далее из таких списков собирается новый отсортированный список, пока все элементы не будут включены.
void mergeSort(Node **head) < Node *low = NULL; Node *high = NULL; if ((*head == NULL) || ((*head)->next == NULL)) < return; >split(*head, &low, &high); mergeSort(&low); mergeSort(&high); merge(low, high, head); >
Если Вы желаете изучать этот материал с преподавателем, советую обратиться к репетитору по информатике
ru-Cyrl 18- tutorial Sypachev S.S. 1989-04-14 sypachev_s_s@mail.ru Stepan Sypachev students

Всё ещё не понятно? – пиши вопросы на ящик
Структуры и алгоритмы обработки данных
Лабораторная работа 2.Списковые структуры данных (односвязные очереди).
6.Как освободить память от удаленного из списка элемента ?
p=getnode;
ptr(p)=nil;
freenode(p) (верный);
p=lst.
7.Как создать новый элемент списка с информационным полем D ?
p=getnode;
p=getnode; info(p)=D (верный);
p=getnode; ptr(D)=lst.
8.Как создать пустой элемент с указателем p ?
p=getnode (верный);
info(p);
freenode(p);
ptr(p)=lst.
9.Сколько указателей используется в односвязных списках ?
1 (верный);
2;
сколько угодно.
10.В чём отличительная особенность динамических объектов ?
порождаются непосредственно перед выполнением программы;
возникают уже в процессе выполнения программы (верный);
задаются в процессе выполнения программы.
Лабораторная работа 3.Списковые структуры данных.
6.При удалении элемента из кольцевого списка…
список разрывается;
в списке образуется дыра;
список становится короче на один элемент (верный).
7.Для чего используется указатель в кольцевых списках ?
для ссылки на следующий элемент;
для запоминания номера сегмента расположения элемента;
для ссылки на предыдущий элемент (верный);
для расположения элемента в списке памяти.
8.Чем отличается кольцевой список от линейного ?
в кольцевом списке последний элемент является одновременно и первым;
в кольцевом списке указатель последнего элемента пустой;
в кольцевых списках последнего элемента нет (верный);
в кольцевом списке указатель последнего элемента не пустой.
9.Сколько указателей используется в односвязном кольцевом списке ?
1(верный);
2;
сколько угодно.
10.В каких направлениях можно перемещаться в кольцевом двунаправленном списке ?
в обоих (верный);
влево;
вправо.
Лабораторная работа 4. Модель массового обслуживания.
6.Чем отличается заявка первого приоритета от заявки второго приоритета ?
тем, что заявка второго приоритета обслуживается с вероятностью P=1, а заявка первого приоритета обслуживается с вероятностью P(B);
тем, что заявка второго приоритета становится в начало очереди, а первого приоритета становится в конец очереди (верный);
ничем, если есть очередь.
7.Может ли заявка первого приоритета вытеснить из очереди заявку второго приоритета ?
да, если P(B)=1;
да;
нет (верный).
8.Может ли на обслуживании находится заявка первого приоритета, если в очереди находится заявка второго приоритета ?
да, если P(B)=1;
да (верный);
нет.
9.С помощью какой структуры данных наиболее рационально реализовать очередь ?
стек;
список (верный);
дек.
10.Когда заявка покидает систему. Найдите ошибку.
если заявка обслужилась подложенное ей число тактов;
если заявка находится в очереди больше Т тактов;
если заявок второго приоритета стало больше, чем заявок первого приоритета (верный).
Лабораторная работа 5. Бинарные деревья (основные процедуры).
Страницы: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84
Алгоритмы и структуры данных для начинающих: связный список
Первая структура данных, которую мы рассмотрим — связный список. На то есть две причины: первое — связный список используется практически везде — от ОС до игр, и второе — на его основе строится множество других структур данных.
Связный список
Основное назначение связного списка — предоставление механизма для хранения и доступа к произвольному количеству данных. Как следует из названия, это достигается связыванием данных вместе в список.
Прежде чем мы перейдем к рассмотрению связного списка, давайте вспомним, как хранятся данные в массиве.
Как показано на рисунке, данные в массиве хранятся в непрерывном участке памяти, разделенном на ячейки определенного размера. Доступ к данным в ячейках осуществляется по ссылке на их расположение — индексу.
Это отличный способ хранить данные. Большинство языков программирования позволяют так или иначе выделить память в виде массива и оперировать его содержимым. Последовательное хранение данных увеличивает производительность (data locality), позволяет легко итерироваться по содержимому и получать доступ к произвольному элементу по индексу.
Тем не менее, иногда массив — не самая подходящая структура.
Предположим, что у нашей программы следующие требования:
- Прочесть некоторое количество целых чисел из источника (метод NextValue ), пока не встретится число 0xFFFF .
- Передать считанные числа в метод ProcessItems
Поскольку в требованиях указано, что считанные числа передаются в метод ProcessItems за один раз, очевидным решение будет массив целых чисел:
void LoadData() < // Предположим, что элементов будет не более 20 int[] values = new int[20]; for (int i = 0; i < values.Length; i++) < if (values[i] == 0xFFFF) < break; >values[i] = NextValue(); > ProcessItems(values); > void ProcessItems(int[] values) < // . обработать данные. > У этого решения есть ряд проблем, но самая очевидная из них — что случится, если будет необходимо прочесть больше 20 значений? В данной реализации значения с 21 и далее просто проигнорируются. Можно выделить больше памяти — 200 или 2000 элементов. Можно дать пользователю возможность выбрать размер массива. Или выделить память под новый массив большего размера при заполнении старого и скопировать элементы. Но все эти решения усложняют код и бесполезно тратят память.
Нам нужна коллекция, которая позволяет добавить произвольное число элементов и перебрать их в порядке добавления. Размер коллекции должен быть неограничен, а произвольный доступ нам не нужен. Нам нужен связный список.
Прежде чем перейти к его реализации, давайте посмотрим на то, как могло бы выглядеть решение нашей задачи.
static void LoadItems() < LinkedList list = new LinkedList(); while (true) < int value = NextValue(); if (value != 0xFFFF) < list.Add(value); >else < break; >> ProcessItems(list); > static void ProcessItems(LinkedList list) < // . обработать данные. > Обратите внимание: проблем, присущих первому варианту решения больше нет — мы не можем выделить недостаточно или, наоборот, слишком много памяти под массив.
Кроме того, из этого кода можно увидеть, что наш список будет принимать параметр типа и реализовывать интерфейс IEnumerable
Реализация класса LinkedList
Класс Node
В основе связного списка лежит понятие узла, или элемента (Node). Узел — это контейнер, который позволяет хранить данные и получать следующий узел.
В самом простом случае класс Node можно реализовать так:
public class Node < public int Value < get; set; >public Node Next < get; set; >> Теперь мы можем создать примитивный связный список. Выделим память под три узла ( first , middle , last ) и соединим их последовательно:
// +-----+------+ // | 3 | null + // +-----+------+ Node first = new Node < Value = 3 >; // +-----+------+ +-----+------+ // | 3 | null + | 5 | null + // +-----+------+ +-----+------+ Node middle = new Node < Value = 5 >; // +-----+------+ +-----+------+ // | 3 | *---+--->| 5 | null + // +-----+------+ +-----+------+ first.Next = middle; // +-----+------+ +-----+------+ +-----+------+ // | 3 | *---+--->| 5 | null + | 7 | null + // +-----+------+ +-----+------+ +-----+------+ Node last = new Node < Value = 7 >; // +-----+------+ +-----+------+ +-----+------+ // | 3 | *---+--->| 5 | *---+-->| 7 | null + // +-----+------+ +-----+------+ +-----+------+ middle.Next = last; Теперь у нас есть список из трех элементов, начиная с first и заканчивая last . Поле Next последнего узла имеет значение null , что показывает, что это последний элемент. С этим списком уже можно производить различные операции. Например, напечатать данные из каждого элемента:
private static void PrintList(Node node) < while (node != null) < Console.WriteLine(node.Value); node = node.Next; >> Метод PrintList итерируется по элементам списка: печатает значение поля Value и переходит к следующему узлу по ссылке в поле Next .
Теперь, когда мы знаем, как должен выглядеть узел связанного списка, давайте посмотрим на пример реализации класса LinkedListNode .
public class LinkedListNode < /// /// Конструктор нового узла со значением Value. /// public LinkedListNode(T value) < Value = value; >/// /// Поле Value. /// public T Value < get; internal set; >/// /// Ссылка на следующий узел списка (если узел последний, то null). /// public LinkedListNode Next < get; internal set; >> Класс LinkedList
Прежде чем реализовывать наш связный список, нужно понять, как мы будем с ним работать.
Ранее мы увидели, что коллекция должна поддерживать любой тип данных, а значит, нам нужно реализовать обобщенный интерфейс.
Поскольку мы используем платформу .NET, имеет смысл реализовать наш класс таким образом, чтобы его поведение было похоже на поведение встроенных коллекций. Самый простой способ сделать это — реализовать интерфейс ICollection . Заметьте, что мы реализуем ICollection , а не Ilist , поскольку интерфейс Ilist позволяет получать доступ к элементам по индексу. Несмотря на то, что произвольный доступ к элементам в целом полезен, его невозможно эффективно реализовать в связном списке.
Учитывая все вышесказанное, давайте набросаем примерный план класса, а затем заполним недостающие методы.
public class LinkedList : System.Collections.Generic.ICollection < public void Add(T item) < throw new System.NotImplementedException(); >public void Clear() < throw new System.NotImplementedException(); >public bool Contains(T item) < throw new System.NotImplementedException(); >public void CopyTo(T[] array, int arrayIndex) < throw new System.NotImplementedException(); >public int Count < get; private set; >public bool IsReadOnly < get < throw new System.NotImplementedException(); >> public bool Remove(T item) < throw new System.NotImplementedException(); >public System.Collections.Generic.IEnumerator GetEnumerator() < throw new System.NotImplementedException(); >System.Collections.IEnumerator System.Collections.IEnumerable.GetEnumerator() < throw new System.NotImplementedException(); >> Метод Add
- Поведение: Добавляет элемент в конец списка.
- Сложность: O(1)
Добавление элемента в связный список производится в три этапа:
- Создать экземпляр класса LinkedListNode .
- Найти последний узел списка.
- Установить значение поля Next последнего узла списка так, чтобы оно указывало на созданный узел.
Основная сложность заключается в том, чтобы найти последний узел списка. Можно сделать это двумя способами. Первый — сохранять указатель на первый узел списка и перебирать узлы, пока не дойдем до последнего. В этом случае нам не требуется сохранять указатель на последний узел, что позволяет использовать меньше памяти (в зависимости от размера указателя на вашей платформе), но требует прохода по всему списку при каждом добавлении узла. Это значит, что метод Add займет O(n) времени.
Второй метод заключается в сохранении указателя на последний узел списка, и тогда при добавлении нового узла мы поменяем указатель так, чтобы он указывал на новый узел. Этот способ предпочтительней, поскольку выполняется за O(1) времени.
Первое, что нам необходимо сделать — добавить два приватных поля в класс LinkedList : ссылки на первый (head) и последний (tail) узлы.
private LinkedListNode _head; private LinkedListNode _tail; Теперь мы можем добавить метод, который выполняет три необходимых шага.
public void Add(T value) < LinkedListNode node = new LinkedListNode(value); if (_head == null) < _head = node; _tail = node; >else < _tail.Next = node; _tail = node; >Count++; > Сначала мы создаем экземпляр класса LinkedListNode . Затем проверяем, является ли список пустым. Если список пуст, мы просто устанавливаем значения полей _head и _tail так, чтобы они указывали на новый узел. Этот узел в данном случае будет являться одновременно и первым, и последним в списке. Если список не пуст, узел добавляется в конец списка, а поле _tail теперь указывает на новый конец списка.
Поле Count инкрементируется при добавлении узла для того, чтобы сохранялся контракт интерфейса ICollection . Поле Count возвращает точное количество элементов списка.
Метод Remove
- Поведение: Удаляет первый элемент списка со значением, равным переданному. Возвращает true , если элемент был удален и false в противном случае.
- Сложность: O(n)
Прежде чем разбирать метод Remove , давайте посмотрим, чего мы хотим добиться. На следующем рисунке список с четырьмя элементами. Мы удаляем элемент со значением «3».
После удаления узла поле Next узла со значением «2» будет указывать на узел со значением «4».
Основной алгоритм удаления элемента такой:
- Найти узел, который необходимо удалить.
- Изменить значение поля Next предыдущего узла так, чтобы оно указывало на узел, следующий за удаляемым.
Как всегда, основная проблема кроется в мелочах. Вот некоторые из случаев, которые необходимо предусмотреть:
- Список может быть пустым, или значение, которое мы передаем в метод может не присутствовать в списке. В этом случает список останется без изменений.
- Удаляемый узел может быть единственным в списке. В этом случае мы установим значения полей _head и _tail равными null .
- Удаляемый узел будет в начале списка. В этом случае мы записываем в _head ссылку на следующий узел.
- Удаляемый узел будет в середине списка.
- Удаляемый узел будет в конце списка. В этом случае мы записываем в _tail ссылку на предпоследний узел, а в его поле Next записываем null .
public bool Remove(T item) < LinkedListNode previous = null; LinkedListNode current = _head; // 1: Пустой список: ничего не делать. // 2: Один элемент: установить Previous = null. // 3: Несколько элементов: // a: Удаляемый элемент первый. // b: Удаляемый элемент в середине или конце. while (current != null) < if (current.Value.Equals(item)) < // Узел в середине или в конце. if (previous != null) < // Случай 3b. // До: Head ->3 -> 5 -> null // После: Head -> 3 ------> null previous.Next = current.Next; // Если в конце, то меняем _tail. if (current.Next == null) < _tail = previous; >> else < // Случай 2 или 3a. // До: Head ->3 -> 5 // После: Head ------> 5 // Head -> 3 -> null // Head ------> null _head = _head.Next; // Список теперь пустой? if (_head == null) < _tail = null; >> Count--; return true; > previous = current; current = current.Next; > return false; > Поле Count декрементируется при удалении узла.
Метод Contains
- Поведение: Возвращает true или false в зависимости от того, присутствует ли искомый элемент в списке.
- Сложность: O(n)
Метод Contains достаточно простой. Он просматривает каждый элемент списка, от первого до последнего, и возвращает true как только найдет узел, чье значение равно переданному параметру. Если такой узел не найден, и метод дошел до конца списка, то возвращается false .
public bool Contains(T item) < LinkedListNode current = _head; while (current != null) < if (current.Value.Equals(item)) < return true; >current = current.Next; > return false; > Метод GetEnumerator
- Поведение: Возвращает экземпляр IEnumerator , который позволяет итерироваться по элементам списка.
- Сложность: Получение итератора — O(1). Проход по всем элементам — O(n).
Возвращаемый итератор проходит по всему списку от первого до последнего узла и возвращает значение каждого элемента с помощью ключевого слова yield .
IEnumerator IEnumerable.GetEnumerator() < LinkedListNode current = _head; while (current != null) < yield return current.Value; current = current.Next; >> IEnumerator IEnumerable.GetEnumerator()
Метод Clear
- Поведение: Удаляет все элементы из списка.
- Сложность: O(1)
Метод Clear просто устанавливает значения полей _head и _tail равными null . Поскольку C# — язык с автоматическим управлением памятью, нет необходимости явно удалять неиспользуемые узлы. Клиент, вызывающий метод, должен убедиться в корректном удалении значений узлов, если это необходимо.
public void Clear()
Метод CopyTo
- Поведение: Копирует содержимое списка в указанный массив, начиная с указанного индекса.
- Сложность: O(n)
Метод CopyTo проходит по списку и копирует элементы в массив с помощью присваивания. Клиент, вызывающий метод должен убедиться, что массив имеет достаточный размер для того, чтобы вместить все элементы списка.
public void CopyTo(T[] array, int arrayIndex) < LinkedListNode current = _head; while (current != null) < array[arrayIndex++] = current.Value; current = current.Next; >> Метод Count
- Поведение: Возвращает количество элементов списка. Возвращает 0, если список пустой.
- Сложность: O(1)
Count — поле с публичным геттером и приватным сеттером. Изменение его значения осуществляется в методах Add , Remove и Clear .
public int Count
Метод IsReadOnly
- Поведение: Возвращает true , если список только для чтения.
- Сложность: O(1)
public bool IsReadOnly < get < return false; >> Двусвязный список
Связный список, который мы только что создали, называется также «односвязным». Это значит, что между узлами только одна связь в единственном направлении от первого узла к последнему. Есть также достаточно распространенный вариант списка, который предоставляет доступ к обоим концам — двусвязный список.
Для того, чтобы создать двусвязный список, мы должны добавить в класс LinkedListNode поле Previous , которое будет содержать ссылку на предыдущий элемент списка.
Далее мы рассмотрим только отличия в реализации односвязного и двусвязного списка.
Класс Node
Единственное изменение, которое надо внести в класс LinkedListNode — добавить поле со ссылкой на предыдущий узел.
public class LinkedListNode < /// /// Конструктор нового узла со значением Value. /// /// public LinkedListNode(T value) < Value = value; >/// /// Поле Value. /// public T Value < get; internal set; >/// /// Ссылка на следующий узел списка (если узел последний, то null). /// public LinkedListNode Next < get; internal set; >/// /// Ссылка на предыдущий узел списка (если узел первый, то null). /// public LinkedListNode Previous < get; internal set; >> Метод AddFirst
В то время, как односвязный список позволяет добавлять элементы только в конец, используя двусвязный список мы можем добавлять элементы как в начало, так и в конец, с помощью методов AddFirst и AddLast соответственно. Метод ICollection.Add будет вызывать AddLast для совместимости с односвязным списком.
- Поведение: Добавляет переданный элемент в начало списка.
- Сложность: O(1)
При добавлении элемента в начало списка последовательность действий примерно такая же, как и при добавлении элемента в односвязный список.
- Установить значение поля Next в новом узле так, чтобы оно указывало на бывший первый узел.
- Установить значение поля Previous в бывшем первом узле так, чтобы оно указывало на новый узел.
- Обновить поле _tail при необходимости и инкрементировать поле Count
public void AddFirst(T value) < LinkedListNode node = new LinkedListNode(value); // Сохраняем ссылку на первый элемент. LinkedListNode temp = _head; // _head указывает на новый узел. _head = node; // Вставляем список позади первого элемента. _head.Next = temp; if (Count == 0) < // Если список был пуст, то head and tail должны // указывать на новой узел. _tail = _head; >else < // До: head ------->5 7 -> null // После: head -> 3 5 7 -> null temp.Previous = _head; > Count++; > Метод AddLast
- Поведение: Добавляет переданный элемент в конец списка.
- Сложность: O(1)
Добавление узла в конец списка легче, чем в начало. Мы просто создаем новый узел и обновляем поля _head и _tail , а затем инкрементируем поле Count .
public void AddLast(T value) < LinkedListNode node = new LinkedListNode(value); if (Count == 0) < _head = node; >else < _tail.Next = node; // До: Head ->3 5 -> null // После:Head -> 3 5 7 -> null // 7.Previous = 5 node.Previous = _tail; > _tail = node; Count++; > Как было сказано ранее, ICollection.Add просто зовет AddLast .
public void Add(T value)
Метод RemoveFirst
Как и метод Add , Remove будет разделен на два метода, позволяющих удалять элементы из начала и из конца списка. Метод ICollection.Remove будет также удалять элементы из начала, но теперь будет еще обновлять поля Previous в тех узлах, где это необходимо.
- Поведение: Удаляет первый элемент списка. Если список пуст, не делает ничего. Возвращает true , если элемент был удален и false в противном случае.
- Сложность: O(1)
RemoveFirst устанавливает ссылку head на второй узел списка и обнуляет поле Previous этого узла, удаляя таким образом все ссылки на предыдущий первый узел. Если список был пуст или содержал только один элемент, то поля _head и _tail становятся равны null .
public void RemoveFirst() < if (Count != 0) < // До: Head ->3 5 // После: Head -------> 5 // Head -> 3 -> null // Head ------> null _head = _head.Next; Count--; if (Count == 0) < _tail = null; >else < // 5.Previous было 3; теперь null. _head.Previous = null; >> > Метод RemoveLast
- Поведение: Удаляет последний элемент списка. Если список пуст, не делает ничего. Возвращает true , если элемент был удален и false в противном случае.
- Сложность: O(1)
RemoveLast устанавливает значение поля _tail так, чтобы оно указывало на предпоследний элемент списка и, таким образом, удаляет последний элемент. Если список был пустым, или содержал только один элемент, то поля _head и _tail становятся равны null .
public void RemoveLast() < if (Count != 0) < if (Count == 1) < _head = null; _tail = null; >else < // До: Head -->3 --> 5 --> 7 // Tail = 7 // После: Head --> 3 --> 5 --> null // Tail = 5 // Обнуляем 5.Next _tail.Previous.Next = null; _tail = _tail.Previous; > Count--; > > Метод Remove
- Поведение: Удаляет первый элемент списка со значением, равным переданному. Возвращает true , если элемент был удален и false в противном случае.
- Сложность: O(n)
Метод ICollection.Remove() почти такой же, как и в односвязном списке. Единственное отличие — теперь нам необходимо поменять значение поля Previous при удалении узла. Для того, чтобы не повторять код, этот метод зовет RemoveFirst при удалении первого узла.
public bool Remove(T item) < LinkedListNode previous = null; LinkedListNode current = _head; // 1: Пустой список: ничего не делать. // 2: Один элемент: установить Previous = null. // 3: Несколько элементов: // a: Удаляемый элемент первый. // b: Удаляемый элемент в середине или конце. while (current != null) < // Head ->3 -> 5 -> 7 -> null // Head -> 3 ------> 7 -> null if (current.Value.Equals(item)) < // Узел в середине или в конце. if (previous != null) < // Случай 3b. previous.Next = current.Next; // Если в конце, то меняем _tail. if (current.Next == null) < _tail = previous; >else < // До: Head ->3 5 7 -> null // После: Head -> 3 7 -> null // previous = 3 // current = 5 // current.Next = 7 // Значит. 7.Previous = 3 current.Next.Previous = previous; > Count--; > else < // Случай 2 или 3a. RemoveFirst(); >return true; > previous = current; current = current.Next; > return false; > Зачем нужен двусвязный список?
Итак, мы можем добавлять элементы в начало списка и в его конец. Что нам это дает? В том виде, в котором он реализован сейчас, нет особых преимуществ перед обычным односвязным списком. Но если добавить геттеры для полей head и tail , пользователь нашего списка сможет реализовать множество различных алгоритмов.
public LinkedListNode Head < get < return _head; >> public LinkedListNode Tail < get < return _tail; >> Так мы сможем итерироваться по списку вручную, в том числе от последнего элемента к первому.
В этом примере мы используем поля Tail и Previous для того, чтобы обойти список задом наперед.
public void ProcessListBackwards() < LinkedList list = new LinkedList(); PopulateList(list); LinkedListNode current = list.Tail; while (current != null) < ProcessNode(current); current = current.Previous; >> Кроме того, двусвязный список позволяет легко реализовать двусвязную очередь, которая, в свою очередь, является строительным блоком для других структур данных. Мы вернемся к ней позже, в соответствующей части.
Продолжение следует
На этом мы заканчиваем разбор связных списков. В следующий раз мы подробно разберем массивы.

Следите за новыми постами по любимым темам
Подпишитесь на интересующие вас теги, чтобы следить за новыми постами и быть в курсе событий.