Как узнать кодировку строки python
Этот документ (PEP 263 [1]) представляет синтаксис для декларации кодировки текста в файле исходного кода на языке Python. Информация о кодировке затем используется парсером Python для интерпретации файла на указанной кодировке. Прежде всего это улучшает интерпретацию литералов Unicode в исходном коде, и делает возможным писать в литералах Unicode с использованием например UTF-8 напрямую в редакторе, поддерживающем Unicode.
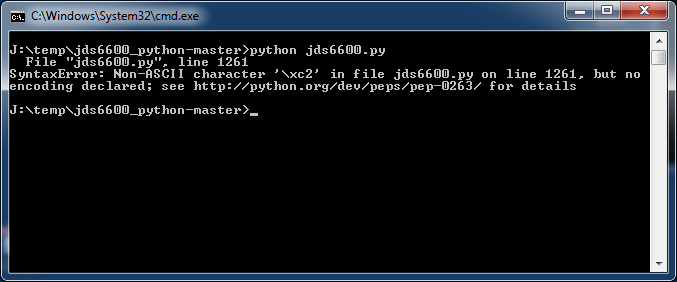
Описываемый ниже метод позволяет избежать ошибок наподобие:
SyntaxError: Non-ASCII character '\xc2' in file имя_модуля.py on line 1261, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details
Источник проблемы. В Python 2.1 литералы Unicode могут быть написаны только с использованием кодировки на основе Latin-1 («unicode-escape»). Это делает рабочее окружение программиста не дружественным для пользователей Python, кто живет и работает в странах, где используется не-Latin-1 локаль, как например многие из стран Азии. Программисты могут писать свои тексты своими 8-битными строками в любимой кодировке, но ограничены кодировкой «unicode-escape» для литералов Unicode.
Чаще всего ошибка «SyntaxError: Non-ASCII character» возникает из-за попытки использовать русскоязычные комментарии в файле, кодировка которого не UTF-8. Чтобы быстро исправить проблему, нужно сохранить текст проблемного модуля *.py в кодировке UTF-8, и сообщить об этом интерпретатору Python.
Процесс по шагам:
1. Проверьте, что текст модуля Python сохранен в кодировке UTF-8. В редакторе Notepad2 это делается через меню File -> Encoding. Этот же пункт меню позволяет перекодировать файл в кодировку UTF-8.
2. Добавьте в начало модуля строку:
# -*- coding: utf-8 -*-
После этого ошибка исчезнет.
Рекомендуемое решение. Рекомендуется сделать кодирование исходного кода Python как видимым, так и изменяемым на уровне исходного файла, применяя в каждом модуле файла исходного кода специальный комментарий в начале файла, чтобы декларировать в нем кодировку.
Чтобы настроить Python для распознавания этой декларации кодировки, необходимо ознакомиться о принципах обработки данных исходного кода Python.
[Определение кодировки]
По умолчанию Python подразумевает, что в файле принят стандарт кодирования ASCII, если не дано никаких других подсказывающих указаний. Чтобы определить кодировку исходного кода, во все исходные файлы нужно добавить «магический» комментарий в первой или второй строке исходного файла:
# coding=
или (используя форматы, распознаваемые популярными редакторами):
#!/usr/bin/python
# -*- coding: < имя_кодировки>-*-
#!/usr/bin/python
# vim: set fileencoding= < имя_кодировки>:
Если быть более точным, то первая или вторая строка должна попадать под фильтр следующего регулярного выражения:
^[ \t\v]*#.*?coding[:=][ \t]*([-_.a-zA-Z0-9]+)
Первая группа этого выражения интерпретируется как имя кодировки. Если эта кодировка не известна для Python, то во время попытки компиляции произойдет ошибка. Не должно быть никакого любого оператора Python в строке, в этой строке, где содержится декларация о кодировке. Если на первую строку регулярное выражение сработает, то вторая строка на предмет поиска кодировки игнорируется.
Чтобы обработать такие платформы, как Windows, которые добавляют маркеры Unicode BOM в начало файла Unicode, UTF-8 сигнатура \xef\xbb\xbf будет также интерпретироваться как кодировка ‘utf-8’ (даже если в файл не добавлен описанный магический комментарий).
Если исходный файл использует одновременно сигнатуру маркера UTF-8 BOM, и магический комментарий, то разрешенной кодировкой для комментария будет только ‘utf-8’. Любая другая кодировка в этом случае приведет к ошибке.
[Примеры]
Ниже приведено несколько примеров, показывающих разные стили определения кодировки исходного кода в начале файла Python.
1. Двоичный интерпретатор и использование файла стиля Emacs:
#!/usr/bin/python
# -*- coding: latin-1 -*-
import os, sys
#!/usr/bin/python
# -*- coding: iso-8859-15 -*-
import os, sys
#!/usr/bin/python
# -*- coding: ascii -*-
import os, sys
2. Без строки интерпретатора, используя чистый текст:
# This Python file uses the following encoding: utf-8
import os, sys
3. Текстовые редакторы могут иметь разные способы определения кодировки файла, например:
#!/usr/local/bin/python
# coding: latin-1
import os, sys
4. Без комментария кодировки парсер Python подразумевает, что это текст ASCII:
#!/usr/local/bin/python
import os, sys
[Плохие примеры]
Ниже для полноты приведены ошибочные комментарии для указания кодировки, которые не будут работать.
A. Пропущенный префикс «coding:»:
#!/usr/local/bin/python
# latin-1
import os, sys
B. Комментарий кодировки не находится на строке 1 или 2:
#!/usr/local/bin/python
# -*- coding: latin-1 -*-
import os, sys
C. Не поддерживаемая кодировка:
#!/usr/local/bin/python
# -*- coding: utf-42 -*-
import os, sys
PEP [1] основывается на следующих концепциях, которые должны быть реализованы, чтобы включить использование такого «магического» комментария:
1. Во всем исходном файле Python должна использоваться одинаковая кодировка. Встраивание по-другому закодированных данных приведет к ошибке декодирования на этапе компиляции исходного файла кода Python.
Можно использовать в исходном коде любое кодирование, которое позволяет обработать две первые строки способом, показанным выше, включая ASCII-совместимое кодирование, а также определенные многобайтовые кодировки, такие как Shift_JIS. Это не включает кодировки наподобие UTF-16, которые используют два или большее количество байтов для всех символов. Причина в том, что требуется сохранять простым алгоритм декодирования кодировки в парсере ключевых слов (токенизатор).
2. Обработка escape-последовательностей должна продолжать работать, как она это уже делает, но со всеми возможными кодировками исходного кода, являющимися стандартными строковыми литералами (как 8-битными, так и Unicode). Расширение escape-последовательностей поддерживает только очень малое подмножество возможных вариантов.
3. Комбинация токенизатор/компилятор Python должна быть обновлена, чтобы работать следующим образом:
A. Чтение файла.
B. Декодирование текста файла в Unicode, подразумевая фиксацию кодировки на весь файл. Т. е. файле должна использоваться единая, не изменяемая в пределах файла кодировка (разные файлы могут иметь разные кодировки).
C. Преобразование текста в байтовую строку UTF-8.
D. Разбитие на ключевые слова (токенизация) содержимого UTF-8.
E. Компиляция кода, создание Unicode-объектов из данных Unicode и создание строковых объектов из литеральных данных Unicode. При этом сначала перекодируются данных UTF-8 в 8-битные строковые данные с использованием имеющейся кодировки файла.
Обратите внимание, что идентификаторы Python ограничены подмножеством кодирования ASCII, так что других преобразований не потребуется.
Для обратной совместимости с существующим кодом, который в нестоящее время использует не-ASCII кодировку в строковых литералах без декларации кодирования, реализация будет представлена двумя фразами:
1. Разрешается использование не-ASCII кодировки в строковых литералах и комментариях, при этом внутренне будет рассматриваться отсутствие объявление кодировки как декларация «iso-8859-1». В результате произвольная строка байт будет корректно обработана с предоставлением совместимости с Python 2.2 для литералов Unicode, которые содержат байты, не попадающие в кодировку ASCII.
Будут выдаваться предупреждения по мере появления non-ASCII байтов на входе, один раз на неправильно закодированный входной файл.
2. Удаление предупреждения, и изменение кодировки по умолчанию на «ascii».
Встроенное compile() API будет расширено, чтобы принимать на входе Unicode. 8-битные входные строки являются субъектами стандартной процедуры детектирования кодировки, как это описано выше.
Если строка Unicode с декларацией кодирования будет передана в compile(), будет сгенерировано событие SyntaxError.
[Ссылки]
1. PEP 263 — Defining Python Source Code Encodings site:python.org.
Как определить кодировку строки (в string, а не bytes) в Python?
Т.е. нужна либо другая функция для string, либо string нужно превратить в bytes. Подскажите пожалуйста, как это сделать?
Отслеживать
задан 23 окт 2017 в 12:20
Ruslan Sagitov Ruslan Sagitov
11 1 1 золотой знак 1 1 серебряный знак 5 5 бронзовых знаков
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
Ошибка указывает, что у вас Питон 3, где str тип, используется для текста — каждая строка (str) это последовательность символов (Unicode codepoints).
Сами символы никакой кодировки не имеют (как внутри интерпретатора строки представлены не имеет значения, до тех пор пока абстракция не нарушена).
Любая кодировка, которая может представить все символы в строке, может быть использована:
>>> "мир".encode('utf-8') b'\xd0\xbc\xd0\xb8\xd1\x80' >>> "мир".encode('cp1251') b'\xec\xe8\xf0' >>> "мир".encode('cp866') b'\xac\xa8\xe0' >>> "мир".encode('koi8-r') b'\xcd\xc9\xd2' Сама строка никакой кодировки не имеет. Ещё примеры: Как работать с путями c русскими символами?
Вопрос, который можно для строки задать: на каком языке вероятно текст написан? Или более узкий (определённый) вопрос: принадлежат ли все букву заданному диапазону в Unicode.
- Python: How to determine the language?
- How to match Cyrillic characters with a regular expression
Кодирование строк
Чтобы компьютер смог отобразить передаваемые ему символы, они должны быть представлены в конкретной кодировке. Навряд ли найдется человек, который никогда не сталкивался с кракозябрами: открываешь интернет-страницу, а там – набор непонятных знаков; хочешь прочесть книгу в текстовом редакторе, а вместо слов получаешь сплошные знаки вопроса. Причина заключается в неверной процедуре декодирования текста (если сильно упростить, то программа пытается представить американцу, например, букву «Щ», осуществляя поиск в английском алфавите).
Возникают вопросы: что происходит, кто виноват? Ответ не будет коротким.
1. Компьютер – человек
Так сложилось, что компьютерная техника оперирует единицами и нулями. На вашей же клавиатуре представлено не менее 100 клавиш. Все, что вы вводите при печати, в итоге преобразуется в те самые бинарные величины.
В этом суть кодировки. ПК запоминает любые буквы, числа и знаки в виде определенного значения из единиц и нулей. Для примера: английская буква «Y» в двоичном коде выглядит как «0b1011001» , а в шестнадцатеричном как «0x59» .
Для осмысленного диалога пользователя и компьютера требуется двусторонний переводчик:
– «человеческие» строки необходимо перекодировать в байты;
– «компьютерную» речь требуется преобразовать в воспринимаемые пользователем осмысленные структуры.
В языке Python за это отвечают функции encode / decode . Важно кодировать и декодировать сообщение в одинаковой кодировке, чтобы не столкнуться с проблемой бессмысленных наборов символов.
2. ASCII
Так как первые вычислительные машины были малоемкими, для представления в их памяти всего набора требуемых знаков хватало 7 бит (или 128 символов). Сюда входил весь английский алфавит в верхнем и нижнем регистрах, цифры, знаки, вспомогательные символы.
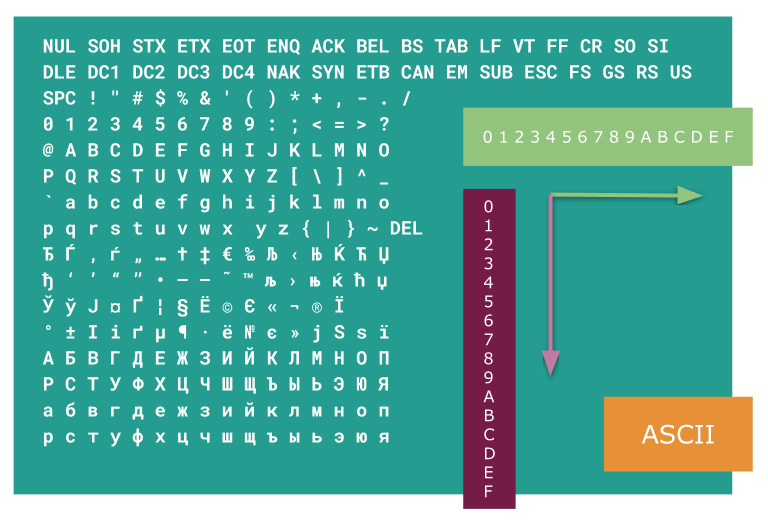
Пример ASCII символов
Поначалу этого вполне хватало. Кодировка получила имя ASCII (читается как «аски» или «эски»). В Пайтоне вы и сегодня можете посмотреть на символы ASCII. Для этого имеется встроенный модуль string .
Пример – IDE
import string print(string.ascii_letters) print(string.digits) print(string.punctuation) Результат выполнения кода abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ 0123456789 !"#$%&'()*+,-./:;?@[\]^_`<|>~
С другими свойствами модуля можете ознакомиться самостоятельно.
Время шло, компьютеризация общества ширилась, 128 символов стало не хватать. Оставшийся последний 8-ой бит также выделили для кодирования (а это еще 128 знаков). В итоге появилось большое количество кодировок (кириллическая, немецкая и т.п.). Такая ситуация привела к проблемам. Уже в то время англичанин, получающий электронное письмо из России, мог увидеть не русские буквы, а набор непонятных закорючек.
Потребовалось указание кодировок в заголовках документов.
3. Юникод-стандарт
Как вы считаете, сколько нужно символов, чтобы хватило всем и навсегда? 10_000? Конечно, нет. Уже сегодня более 100_000 знаков имеет свое числовое представление. И это не предел. Люди постоянно придумывают новые «буквы».
Откройте свой телефон и создайте пустое сообщение. Зайдите в раздел «смайликов». Да их тут больше сотни! И это не картинки в большинстве своем. Они являются символами определенной кодировки. Если вы застали времена, когда SMS-технологии только начинали развиваться, то этих самых «смайлов» было не более десятка. Лет через 10 их количество станет «неприличным».
Упомянутая выше кодировка ASCII в своем расширенном варианте породила большое количество новых. Основная беда: имея 128 вариантов обозначить символ, мы никак не сумеем внедрить туда буквы других языков. В частности, какой-нибудь символ под номером 201 в кириллице даст совсем не русскую букву, если отослать его в Румынию. Следовательно, говоря кому-то «посмотри на 201-ый символ» мы не даем никакой гарантии, что собеседник увидит то же.
Для решения задачи был разработан стандарт Unicode. Отметим, что это не определенная кодировка, а именно набор правил. Суть юникода – связь символа и определенного числа без возможного повторения. Если мы кого-то попросим показать символ, скрытый под номером «1000», то в любой точке планеты он будет одним и тем же графическим элементом.
Модуль chardet в Python, определение кодировки
Когда мы думаем о тексте, то представляем слова и буквы, которые видим на экране компьютера. Но компьютеры не работают с буквами и символами. Они имеют дело с битами и байтами. Каждый фрагмент текста, который выводится на экране, на самом деле хранится в определенной кодировке символов. Существует множество различных кодировок, некоторые из которых оптимизированы для определенных языков, таких как русский, китайский или английский, а другие могут использоваться для нескольких языков. Грубо говоря, кодировка символов обеспечивает соответствие между тем, что мы видим на экране, и тем, что компьютер фактически хранит в памяти и на диске.
Модуль chardet , это автоматический детектор кодировки текста и является портом кода автоопределения в Mozilla. Этот модуль поможет определить кодировку символов, если вдруг на экране появятся «кракозябры«.
Модуль chardet отлично поддерживает и определяет русские кодировки: KOI8-R, MacCyrillic, IBM855, IBM866, ISO-8859-5, windows-1251(Cyrillic)
Установка модуля chardet в виртуальное окружение.
# создаем виртуальное окружение, если нет $ python3 -m venv .venv --prompt VirtualEnv # активируем виртуальное окружение $ source .venv/bin/activate # ставим модуль chardet (VirtualEnv):~$ python -m pip install -U chardet
Примеры автоматического определения кодировки символов:
Самый простой способ автоматически определить кодировку — это использовать функцию обнаружения detect() модуля chardet .
>>> import urllib.request, chardet >>> rawdata = urllib.request.urlopen('http://yandex.ru/').read() >>> chardet.detect(rawdata) # >>> rawdata = urllib.request.urlopen('https://www.zeit.de/index').read() >>> chardet.detect(rawdata) #
Расширенное использование модуля chardet .
Если имеется большой объем текста/данных, то можно вызывать обнаружение кодировки постепенно. Как только модуль будет достаточно уверен в своих результатах, он остановится.
Для такого поведения необходимо создать объект UniversalDetector(), затем повторно вызывать его метод подачи .feed() с каждым блоком текста. Если созданный детектор достигнет минимального порога достоверности, он установит для Detector.done значение True.
В конце работы детектора необходимо вызвать Detector.close() , который выполнит некоторые окончательные вычисления в случае, если детектор не достиг минимального порога достоверности.
import urllib.request from chardet.universaldetector import UniversalDetector usock = urllib.request.urlopen('https://www.zeit.de/index') # создаем детектор detector = UniversalDetector() for line in usock.readlines(): # скармливаем детектору строки detector.feed(line) if detector.done: # если детектор определил # кодировку, то прерываем цикл break # закрываем детектор detector.close() # закрываем соединение с сайтом usock.close() print(detector.result) #
Пример определения кодировки нескольких файлов.
Для определения кодировки текстовых файлов, их необходимо открывать в режиме чтения байтов: more=’rb’
import glob from chardet.universaldetector import UniversalDetector # создаем детектор detector = UniversalDetector() for filename in glob.glob('*.xml'): print(filename.ljust(60), end='') # сбрасываем детектор # в исходное состояние detector.reset() # проходимся по строкам очередного # файла в режиме 'rb' for line in open(filename, 'rb'): detector.feed(line) if detector.done: break detector.close() print(detector.result)