How to Download Kaggle Datasets using Jupyter Notebook
Kaggle is a vast online community of professionals and practitioners in the domain of Machine Learning where they meet and share their knowledge. Whether you are a beginner or an expert, Kaggle may have come or might come in handy during your journey in the domain. Kaggle was established in 2010, where it used to host Machine Learning competitions, later acquired by Google.
Using Kaggle gives a variety of features for the user’s help. One can come and show off their skills by participating in competitions which would help them fill their pocket. Kaggle also hosts several fora based on different topics of highly qualified and kind people from the globe. Apart from this, you can learn to code and solve numerous problems available on the platform. One of the leading reasons you may or you might have heard about Kaggle is the number and variety of open-source datasets it hosts. The best part of Kaggle is, even you can host your dataset if it holds a little value to be analyzed or to train one’s model.
Downloading Kaggle Datasets (Conventional Way):
The conventional way of downloading datasets from Kaggle is:
1. First, go to Kaggle and you will land on the Kaggle homepage.
2. Sign up or Sign in with required credentials.
3. Then select the Data option from the left pane and you will land on the Datasets page.
4. Now from the variety of domains, select the datasets that match best of your needs and press the Download button.

If you are unaware or confused about which dataset you should select, Kaggle has got you covered. Kaggle has several updated lists of Datasets based on the interest of the viewer. For example, when you land upon the Kaggle Datasets page, you will find multiple lists of Datasets, such as Trending Datasets, Popular Datasets, Datasets related to Businesses, Datasets related to COVID, and so on.
Apart from this, if you are specific with the dataset you want, you can always use the Filters and select the file type and the desired dataset’s file size.
Downloading Kaggle Dataset in Jupyter Notebook
Now, let’s look at the new method to download Kaggle Dataset.
Before starting, you need to have the opendatasets library installed in your system. If it’s not present in your system, use Python’s package manager pip and run:
!pip install opendatasets
in a Jupyter Notebook cell. Python’s opendatasets library is used for downloading open datasets from platforms such as Kaggle.
The process to Download is as follows:
1. Import the opendatasets library
import opendatasets as od
2. Now use the download function of the opendatasets library, which as the name suggests, is used to download the dataset. It takes the link to the dataset as an argument.
For example, If I have selected the Heart Attack Analysis & Prediction Dataset to download. I will select its hyperlink. Now, this hyperlink is used as an argument in the .download() function.
od.download("https://www.kaggle.com/rashikrahmanpritom/heart-attack-analysis-prediction-dataset")
3. On executing the above line, it will prompt for Kaggle username. Kaggle username can be fetched from the Account tab of the My Profile section.
4. On entering the username, it will prompt for Kaggle Key. Again, go to the account tab of the My Profile section and click on Create New API Token. This will download a kaggle.json file.
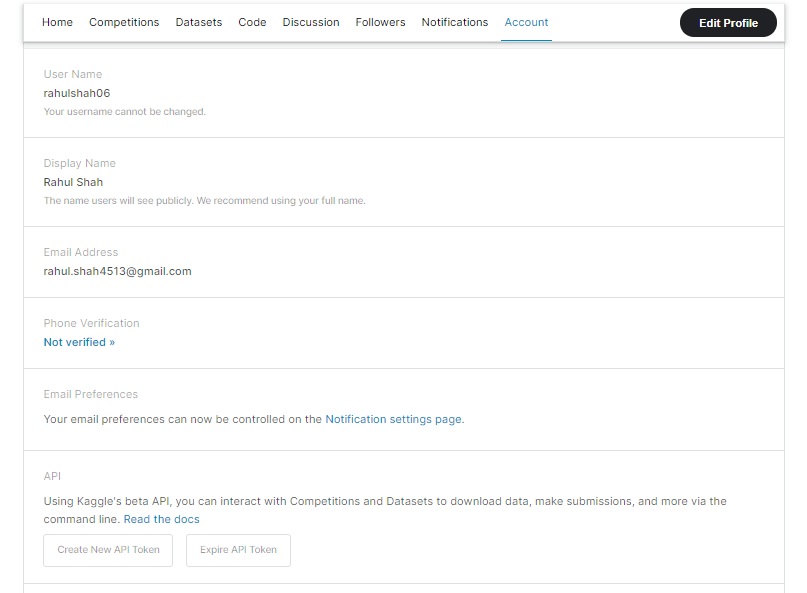
5. On opening this file, you will find the username and key in it. Copy the key and paste it into the prompted Jupyter Notebook cell. The content of the downloaded file would look like this:
username":,"key":"">6. A progress bar will show if the dataset is downloaded completely or not.
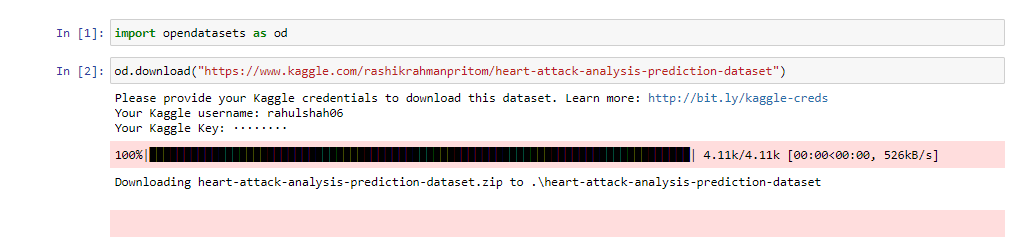
7. After successful completion of the download, a folder will be created in the current working directory of your Jupyter Notebook. This folder contains our dataset.
Your Jupyter Notebook should look like this:
NOTE: Remember, that you don’t have to create a new API Token from Kaggle every time you want to download a dataset. You can use the same key for every single download.
The Kaggle Dataset Page
Datasets play a vital role in one’s journey in achieving higher highs in the domain of Machine Learning. Thus, one must know every possible way to fetch the datasets. Kaggle is the most widely used platform for downloading dataset. Thus, you can get large varieties of datasets uploaded by the field experts.
Apart from the title, each dataset in Kaggle has more attributes such as Usability Score, the publisher, the size, and the dataset format. When you open a dataset, you will find these details. The Usability Score is given by certain parameters. For this score, it is not mentioned what range of score is a good Usability Score, but it is always good to start with high Usability Score dataset. Each dataset also shows the size of the dataset to be downloaded. A larger file size would take more time to load in the data frame. For example, the popular dataset US Accidents has about 4.2 Million Rows and has a file size of about 300 MBs. Thus, it would take varied times to load into a dataframe. It also shows the file format in which data is present. Knowing these details of your dataset can also be beneficial.

One can practice and share their findings in the Code section of Dataset’s page for each dataset. You will find several submissions by Kaggle members on every dataset page. Also, the Publisher of the dataset can post any Task which one can aim and work towards it. Since there is no single solution to any problem in Machine Learning, it is always good to see and learn from others. This may help you in your next projects. For example, the COVID-19 Open Research Dataset Challenge dataset has a file size of 9 GBs and over 1500 Code Submissions.
Selecting perfect data for your need needs time. It may happen several times that you might download a dataset that is not prepared as per your need. Thus it is always propitious to read the Dataset descriptions of what it is offering. For example, if you want to analyse the dataset based on COVID 19 Vaccination Programs worldwide, you will find an enormous number of such datasets fulfilling your interest. In such a situation, it is always helpful to read and select the perfect dataset for you.
Apart from this, Kaggle also provides Free Courses to improve Data Science skills such as Python, Data Cleaning, Data Visualization et cetera. You will get a completion certificate as well on the successful completion of a course.
Conclusion
Thus, opendatasets is a boon for the practitioners who are aiming to excel in the domain. Dataset is an essential part of every Data Science project. Your every bit of analysis starts with the data. Execution of a task in Python can be done most efficiently. And when it comes to downloading datasets, your ultimate task is to get the datasets with the least efforts possible.
Conclusively, the conventional method of downloading the dataset from Kaggle isn’t too difficult to procure, the above-stated Jupyter Notebook method is advantageous relatively in ways such as:
1. You don’t have to necessarily sign in to Kaggle if you are downloading directly from Jupyter Notebook. You can use your username and key when prompted.
2. You save yourself from the hassle of transferring the downloaded file from the browser to copying it to your Notebook’s directory. The file will get downloaded at the current working directory only.
3. It’s always good to know alternate solutions to an existing solution.
Don’t forget to check out my previous article here.
Прикладное машинное обучение на языке Python
Нажмите на ссылку https://www.kaggle.com/datasets?topic=trendingDataset, чтобы открыть ресурс.
Специальные возможности
Настройки
Навигация
- В начало
- Электронный университет ВГУ
- Поиск
- Календарь
- Высшее образование
- Внутренняя оценка качества образования (ФОС для пр.
- Геологический факультет
- Исторический факультет
- Математический факультет
- Медико-биологический факультет
- Общеуниверситетские кафедры
- Факультет военного образования
- Факультет географии, геоэкологии и туризма
- Факультет журналистики
- Факультет компьютерных наук
- Факультет международных отношений
- Факультет прикладной математики, информатики и мех.
- кафедра вычислительной математики и прикладных инф.
- Кафедра математических методов исследования операций
- Психология личности ПММ_1
- Инфографика в политической коммуникации
- Управление интеллектуальным капиталом компании
- Дипломники (Ухлова В.В.)
- ТВиМС (БИ)_1
- СУЭБ
- ИЗ и проектирование БЗ
- АОиАТД
- Учебная практика (СУЭБ)
- НЛ и НС
- ФОС ММИО
- ИМ ПМИ_1
- Основы проектного менеджмента
- Машинное обучение (ПИСиМС)
- УР_3
- ИМвЭБ
- ИКТ в политике и управлении
- Принятие решений
- САиМод_1
- УСЭС
- Актуализация ООП
- УИТСиК
- Автоматизация бухг. деят-ти
- ОбщТС_1
- ММетПР
- ОТСиСА
- АБД_бакалавры
- Производственная практика З/О
- Архитектура предприятий (магистры)
- Математика и ИКТ_бак.
- ИКТ в востоковедении_бак.
- НИТ_бакалавриат
- Проектный менеджмент_маг_ЗО
- МБП
- BD_маг_ЗО
- ИСУПК, БИ маг.
- ЭБ_КР
- Интернет-предпринимательство_бак.
- ИМвЗМО
- Учебная практика (магистры 1 курс)
- НИР ММИО
- Программирование в 1с
- ДМ (практ) КБ 2020/2021
- Рынки ИКТ и ОП_бакалавриат
- ИТУ
- БП_бакалавры
- ВССТ_бакалавриат
- ТС и СА_3
- ДМ (ПИ)
- ЛА (БИ)
- ОТС
- Машинное обучение
- Участники
- Общее
- Объявления
- Рабочая программа курса
- Воронина, Михеев Теория и практика машинного обучения
- Мюллер, Гвидо Введение в машинное обучение
- Вандер Плас «Python и машинное обучение»
- Книга на русском по анализу текстов
- Машинное обучение- карманный справочник
- Наборы данных для выполнения лабораторных и самостоятельных работ (на разные темы)
- Репозиторий с данными UCI
- Датасеты Kaggle
- примеры данных
- Открытый курс по машинному обучению
- Занятия по курсу Data mining (бакалавры) 2023 год
- Занятия по курсу Машинное обучение (магистры) 2023.
- Сдача лаб.
- сданные лаб. 4 к.7 гр.
- Лаб_магистры
Как начать работу в Kaggle: руководство для новичков в Data Science
Доброго времени суток, уважаемые хабровчане! Сегодня я хотел бы поговорить о том, как не имея особого опыта в машинном обучении, можно попробовать свои силы в соревнованиях, проводимых Kaggle.
Как вам уже, наверное, известно, Kaggle – это платформа для исследователей разных уровней, где они могут опробовать свои модели анализа данных на серьезных и актуальных задачах. Суть такого ресурса – не только в возможности получить неплохой денежный приз в случае, если именно ваша модель окажется лучшей, но и в том (а, это, пожалуй, гораздо важнее), чтобы набраться опыта и стать специалистом в области анализа данных и машинного обучения. Ведь самый важный вопрос, зачастую стоящий перед такого рода специалистами – где найти реальные задачи? Здесь их достаточно.
Мы попробуем поучаствовать в обучающем соревновании, не предусматривающем каких-либо поощрений, кроме опыта.
Для этого мною была выбрана задача распознавания рукописных цифр из выборки MNIST. Немного сведений из вики. MNIST (Mixed National Institute of Standards and Technology database) является основной базой при тестировании систем распознавания образов, а также широко используемой для обучения и тестирования алгоритмов машинного обучения. Она была создана перегруппировкой образов из оригинальной базы NIST, которая являлась достаточно сложной для распознавания. Кроме этого, были выполнены определенные преобразования (образы были нормализованы и сглажены для получения градаций серого цвета).
База MNIST состоит из 60000 образов для обучения и 10000 образов для тестирования. Написано большое количество статей, посвященных задаче распознавания MNIST, например (в данном случае авторы использовали иерархическую систему из сверточных нейронных сетей).
Оригинальная выборка представлена на сайте.
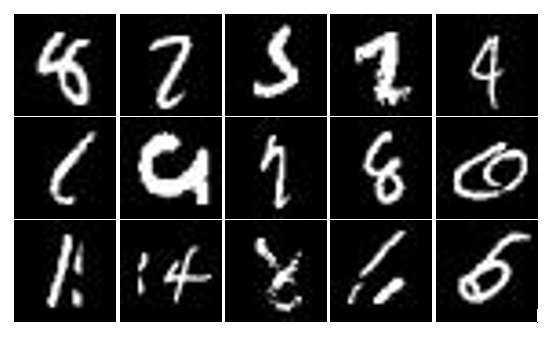
На Kaggle представлена полная выборка MNIST, организованная немного по-другому. Здесь обучающая выборка включает в себя 42000 образов, а выборка тестирования – 28000. Тем не менее, по содержанию они эквивалентны. Каждый образ MNIST представлен картинкой 28Х28 пикселей с 256 градациями серого цвета. Пример нескольких неоднозначных в идентификации цифр представлен на картинке ниже.
Для создания своей модели нейронной сети для распознавания цифр воспользуемся интерпретатором Рython c установленным пакетом nolearn 0.4, а также numpy и scipy (для удовлетворения всех зависимостей).
Здесь мне очень помогла вводная статья, написанная Adrian Rosebrock в своем блоге. В ней даются вводные сведения о нейронных сетях глубокого доверия и их обучении, хотя сам автор при тестировании использует обычный многослойный персептрон архитектуры 784-300-10 без какого-либо предобучения. Так поступим и мы. Кстати, весьма подробно и на примере разных классических выборок рассматривается процесс использования пакета на страничке nolearn.
Итак, следуя указаниям, которые даются в названных выше статьях, создадим свой многослойный персептрон, обучим его на загруженных и обработанных данных, а затем проведем тестирование.
Для начала создадим свой двухслойный персептрон архитектуры 784-300-10:
from nolearn.dbn import DBN net = DBN( [784, 300, 10], learn_rates=0.3, learn_rate_decays=0.9, epochs=10, verbose=1, )Здесь требуются некоторые пояснения. Первый параметр конструктора нейронной сети – список, содержащий количество входов и нейронов в каждом слое, learn_rates – скорость обучения, learn_rate_decays – множитель, задающий изменение скорости обучения после каждой эпохи, epochs – количество эпох обучения, verbose – флаг вывода подробного отчета процесса обучения.
После выполнения этой инструкции, необходимая модель будет создана и нам останется только загрузить данные. Kaggle предоставляет нам два файла: train.csv и test.csv, содержащие соответственно выборки для обучения и тестирования. Структура файлов простая – в первой строке содержится заголовок, далее следуют данные. Для train.csv каждая строка с данными предваряется соответствующей меткой – цифрой от 0 до 9, определяющей образ. В test.csv метка отсутствует.
Следующим этапом загрузим данные в массивы, воспользовавшись пакетом для работы с csv-файлами. Не забываем произвести нормировку:
import csv import numpy as np with open('D:\\train.csv', 'rb') as f: data = list(csv.reader(f)) train_data = np.array(data[1:]) labels = train_data[:, 0].astype('float') train_data = train_data[:, 1:].astype('float') / 255.0После этого обучаем нашу нейронную сеть на подготовленных данных:
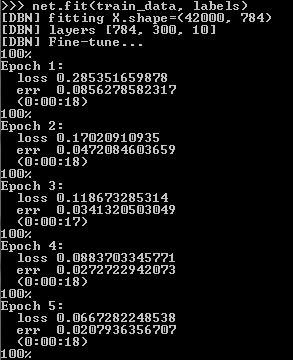
net.fit(train_data, labels)Сам процесс занимает некоторое время, определяемое количеством эпох обучения, заданным при конструировании нейронной сети. На каждой эпохе обучения на экран будут выводиться (при заданном параметре verbose) значения loss и err (значение функции потерь и ошибка).
После обучения все, что нам остается сделать – загрузить данные тестирования и сохранить предсказания для каждого образа из выборки тестирования в файл с расширением csv:
with open('D:\\test.csv', 'rb') as f: data = list(csv.reader(f)) test_data = np.array(data[1:]).astype('float') / 255.0 preds = net.predict(test_data) with open('D:\\submission.csv', 'wb') as f: fieldnames = ['ImageId', 'Label'] writer = csv.DictWriter(f, fieldnames=fieldnames) writer.writeheader() i = 1 for elem in preds: writer.writerow() i += 1Дальше загружаем полученный файл в систему тестирования (см. рисунок) и ждем.
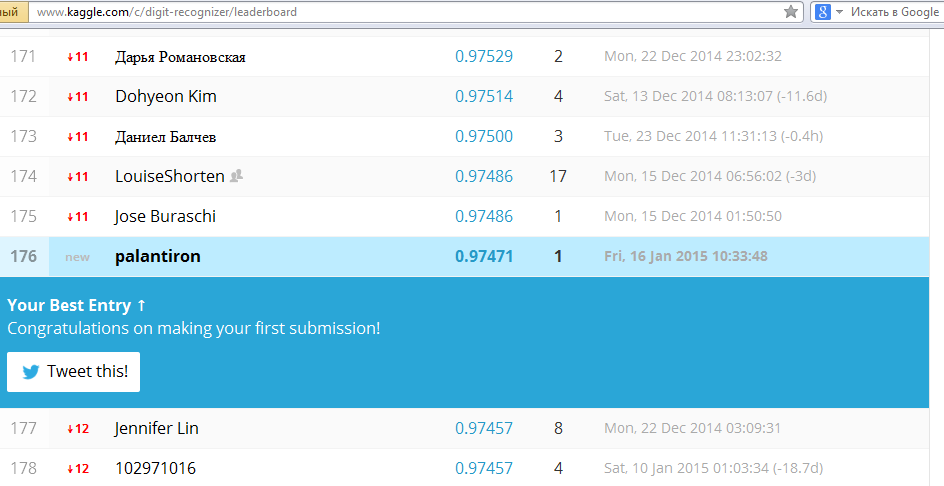
Готово! 176 место из более чем 500 участников. Для начала вполне неплохо. Теперь полученный результат можно попытаться улучшить, например, применив собственные разработки или модифицируя и подбирая параметры в nolearn. Благо времени достаточно: соревнование по MNIST’у неоднократно продлевали и теперь оно будет проходить до 31.12.2015. Удачи и спасибо, что прочитали эту статью.
- искусственные нейронные сети
- персептрон
- модель
- рython
- питон
- kaggle
- nolearn
- обучение
- глубокое обучение
- machine learning
- новичкам
- анализ данных
- актуальная проблематика
- искусственный интеллект
Как скачать датасет с kaggle
Для более простого и комфортного прохождения курса вы можете воспользоваться платформой Google Colab.
Так как мы используем используем данные с Kaggle, вам необходимо настроить Google Colab для работы с Kaggle:
- Создайте API ключ Kaggle. Для этого перейдите на kaggle.com/ и откройте пользовательские настройки.

- Затем прокрутите вниз до раздела доступа к API и нажмите «Создать», чтобы загрузить ключ API.

- На ваш компьютер будет загружен файл с именем kaggle.json. Вы будете использовать этот файл в Colab для доступа к датасетам и соревнованиям Kaggle.
- Загрузить файл kaggle.json нужно после запуска следующего коды:
from google.colab import files uploaded = files.upload() for fn in uploaded.keys(): print('User uploaded file "" with length bytes'.format( name=fn, length=len(uploaded[fn])))Воспользуйтесь ноутбуком для установки библиотек и закачки данных с kaggle. Всё что вам останется это написать код.
ВАЖНО!
Перед тем как скачать датасет с компетишена, нужно на каггле согласиться с правилами. Т.е. в случае, если команда !kaggle competitions download -c siim-acr-pneumothorax-segmentation выдает 403 Forbidden, то нужно перейти по ссылке и принять правила.
- Электронный университет ВГУ