Пишем парсер на Python за 5 минут
В данной статье мы рассмотрим, как парсить сайты быстро и эффективно при помощи нового инструмента LxmlSoup. Библиотека является аналогом популярной BeautifuulSoup, повторяющий её синтаксис. Что касается скорости, LxmlSoup превосходит BeautifulSoup в 2 раза, за счёт библиотеки lxml под капотом. Мы будем парсить сайт который являлся моей первой задачей — Sunlight. Тогда я ещё мало что понимал в программировании и парсинге, зато было море желания научиться этому полезному навыку. Итак, поехали!
Пример скорости библиотек 0.7749056816101074 - LxmlSoup 1.4368107318878174 - BeautifulSoupНачало парсинга
Для начала импортируем библиотеки requests и LxmlSoup. Requests используется для получения html кода сайта, в котором находится вся нужная информация для извлечения.
from LxmlSoup import LxmlSoup import requestsПосле сделаем GET запрос к сайту с целью получения html кода.
html = requests.get('https://sunlight.net/catalog').textДалее создаём экземпляр объекта LxmlSoup в который передаём переменную html. Это нужно, так как LxmlSoup является классом хранящим в себе нужные нам методы для извлечения информации из html кода.
soup = LxmlSoup(html)Теперь обратим внимание на структуру html. Для того чтобы извлечь ссылку на товар нужно за что-то зацепиться в коде сайта. В данном случае мы можем сделать это за тэг элемента и его класс.

Также нужно применить метод .get в котором мы передаем строку «href», для извлечения содержимого переменной href.
links = soup.find_all('a', class_='cl-item-link js-cl-item-link js-cl-item-root-link')Теперь пройдемся циклом по полученным элементам и извлечем их url.
for link in links: url = link.get("href")Наконец получим html блок с ценой и наименованием товара, которые извлечём с помощью метода .text() и красиво выведем все имеющееся в терминал.
for i, link in enumerate(links): url = link.get("href") # получаем ссылку товара name = link.text() # извлекаем наименование из блока со ссылкой price = soup.find_all("div", class_="cl-item-info-price-discount")[i].text() # извлекаем цену print(i) print(f"Url - ") print(f"Name - ") print(f"Price - \n")Вот полный код получившегося парсера:
from LxmlSoup import LxmlSoup import requests html = requests.get('https://sunlight.net/catalog').text # получаем html код сайта soup = LxmlSoup(html) # создаём экземпляр класса LxmlSoup links = soup.find_all('a', class_='cl-item-link js-cl-item-link js-cl-item-root-link') # получаем список ссылок и наименований for i, link in enumerate(links): url = link.get("href") # получаем ссылку товара name = link.text() # извлекаем наименование из блока со ссылкой price = soup.find_all("div", class_="cl-item-info-price-discount")[i].text() # извлекаем цену print(i) print(f"Url - ") print(f"Name - ") print(f"Price - \n") На этом всё. Вы можете записать данные в файлы и использовать их для своих целей. Это была моя первая статья на Хабре, и если вы ждете продолжения будущей серии статей или у Вас есть какие-то замечания, то пишите, постараюсь ответить и прислушаюсь. До новых встреч!
Почему стоит научиться «парсить» сайты, или как написать свой первый парсер на Python
Для начала давайте разберемся, что же действительно означает на первый взгляд непонятное слово — парсинг. Прежде всего это процесс сбора данных с последующей их обработкой и анализом. К этому способу прибегают, когда предстоит обработать большой массив информации, с которым сложно справиться вручную. Понятно, что программу, которая занимается парсингом, называют — парсер. С этим вроде бы разобрались.
Перейдем к этапам парсинга.
- Поиск данных
- Извлечение информации
- Сохранение данных
И так, рассмотрим первый этап парсинга — Поиск данных.
Так как нужно парсить что-то полезное и интересное давайте попробуем спарсить информацию с сайта work.ua.
Для начала работы, установим 3 библиотеки Python.
pip install beautifulsoup4
Без цифры 4 вы ставите старый BS3, который работает только под Python(2.х).
pip install requests
pip install pandas
Теперь с помощью этих трех библиотек Python, можно проанализировать нашу веб-страницу.
Второй этап парсинга — Извлечение информации.
Попробуем получить структуру html-кода нашего сайта.
Давайте подключим наши новые библиотеки.
import requests from bs4 import BeautifulSoup as bs import pandas as pd И сделаем наш первый get-запрос.
URL_TEMPLATE = "https://www.work.ua/ru/jobs-odesa/?page=2" r = requests.get(URL_TEMPLATE) print(r.status_code) Статус 200 состояния HTTP — означает, что мы получили положительный ответ от сервера. Прекрасно, теперь получим код странички.
print(r.text) Получилось очень много, правда? Давайте попробуем получить названия вакансий на этой страничке. Для этого посмотрим в каком элементе html-кода хранится эта информация.
Комірник
У нас есть тег h2 с классом «add-bottom-sm», внутри которого содержится тег a. Отлично, теперь получим title элемента a.
soup = bs(r.text, "html.parser") vacancies_names = soup.find_all('h2', class_='add-bottom-sm') for name in vacancies_names: print(name.a['title']) Хорошо, мы получили названия вакансий. Давайте спарсим теперь каждую ссылку на вакансию и ее описание. Описание находится в теге p с классом overflow. Ссылка находится все в том же элементе a.
Some information about vacancy.
Получаем такой код.
vacancies_info = soup.find_all('p', class_='overflow') for name in vacancies_names: print('https://www.work.ua'+name.a['href']) for info in vacancies_info: print(info.text) И последний этап парсинга — Сохранение данных.
Давайте соберем всю полученную информацию по страничке и запишем в удобный формат — csv.
import requests from bs4 import BeautifulSoup as bs import pandas as pd URL_TEMPLATE = "https://www.work.ua/ru/jobs-odesa/?page=2" FILE_NAME = "test.csv" def parse(url = URL_TEMPLATE): result_list = r = requests.get(url) soup = bs(r.text, "html.parser") vacancies_names = soup.find_all('h2', class_='add-bottom-sm') vacancies_info = soup.find_all('p', class_='overflow') for name in vacancies_names: result_list['href'].append('https://www.work.ua'+name.a['href']) result_list['title'].append(name.a['title']) for info in vacancies_info: result_list['about'].append(info.text) return result_list df = pd.DataFrame(data=parse()) df.to_csv(FILE_NAME) После запуска появится файл test.csv — с результатами поиска.
Как написать парсер телеграм‑каналов на Python

В предыдущей статье об асинхронном программировании на Python мы разобрали основные моменты, связанные с построением асинхронного приложения и функций. Теперь рассмотрим полезный пример, который вовсю использует принципы асинхронности, — простой парсер данных из Telegram
Содержание статьи
- async for
- Как написать парсер телеграм-каналов на Python
- Шаг 1. Создаем приложение API для Telegram
- Шаг 2. Устанавливаем библиотеку telethon
- Шаг 3. Получаем первые данные из Telegram
- Шаг 4. Получаем диалоги
- Шаг 5. Получаем сообщения из выбранного канала
async for
Чтобы пример с парсером был понятнее, сначала поговорим о циклах внутри асинхронных функций. Вспомним финальный пример из первой части статьи, посвященной асинхронному программированию на Python, с получением данных о погоде.
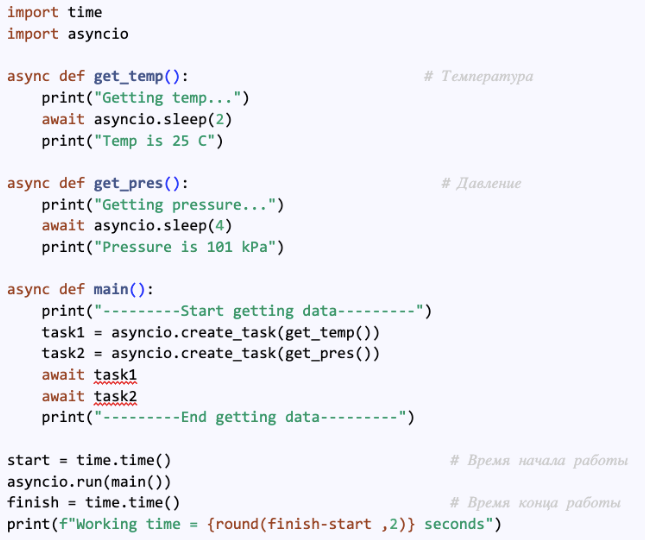
Добавим еще одну функцию, которая будет отображать прогресс измерения давления.

Теперь, если мы запустим приложение, будем видеть прогресс измерения давления.
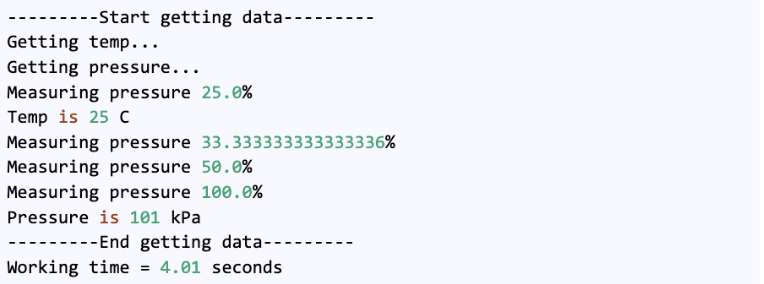
Все хорошо отрабатывает, и проблем нет. Но пойдем дальше в сторону реальных условий работы. Бывает, что функции отдают не готовую последовательность, а асинхронный генератор или асинхронный итератор. Это специальные контейнеры, которые содержат данные и при каждом обращении асинхронно выдают по одному объекту.
Перепишем функцию процесса измерения.
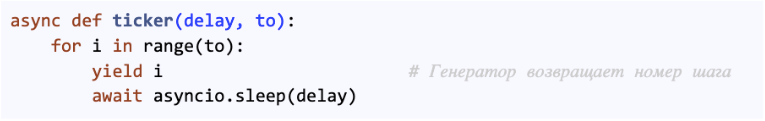
Раз функция def ticker ( ) теперь генератор, то мы должны каждый раз его вызывать, когда она нам понадобится. Классический способ перебора всех значений, возвращаемых генератором, — это подстановка его вызова в цикл for. Перепишем функцию измерения давления.
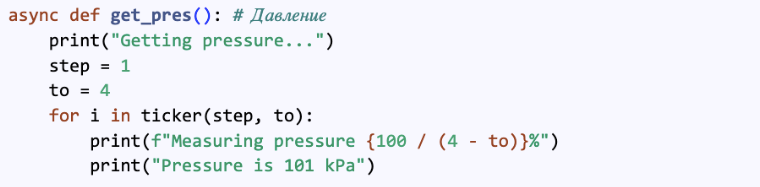
Теперь, если запустим код, столкнемся с интересной ошибкой.
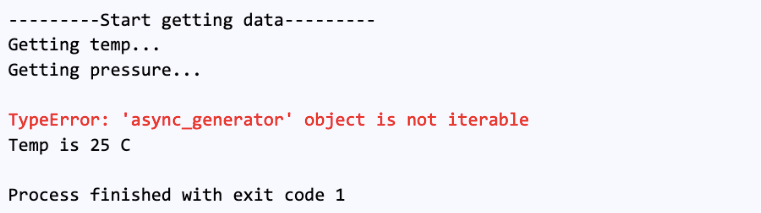
Из текста может показаться, что генератор не является итерируемым объектом. Но на самом деле проблема здесь в другом. Мы работаем с асинхронным генератором, а значит, и цикл, который его перебирает, тоже должен быть асинхронным.

Все снова отлично работает! Зачем это нужно, спросите вы? Прямо сейчас и узнаем.
Как написать парсер телеграм-каналов на Python
Основы языка Python
Курс для всех, а не только для IT-специалистовTelegram — один из самых популярных источников контента. Каналов в мессенджере столько, что следить за всеми самостоятельно просто нереально, не говоря уж об использовании и анализе получаемой информации.
Но зачем все делать вручную, когда за нас это может сделать приложение? Совместим приятное с полезным: напишем приложение для парсинга данных из любого телеграм-канала и параллельно закрепим тему асинхронных компонентов.
- Все о парсинге данных на бесплатном вебинаре Контур.Школы.
Шаг 1. Создаем приложение API для Telegram
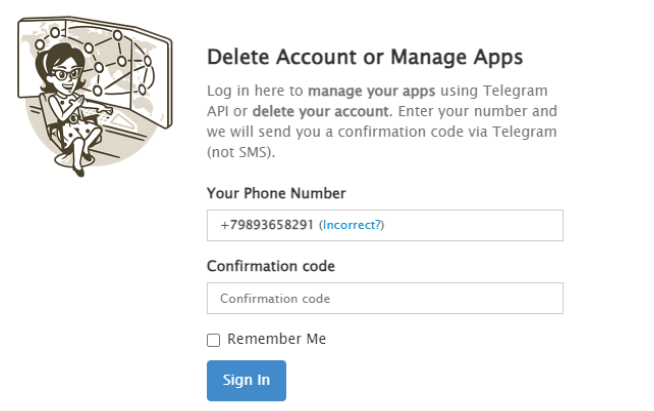
Для начала необходимо завести аккаунт в Telegram, если его еще нет. Затем переходим по ссылке https://my.telegram.org/auth и авторизуемся с помощью номера телефона.
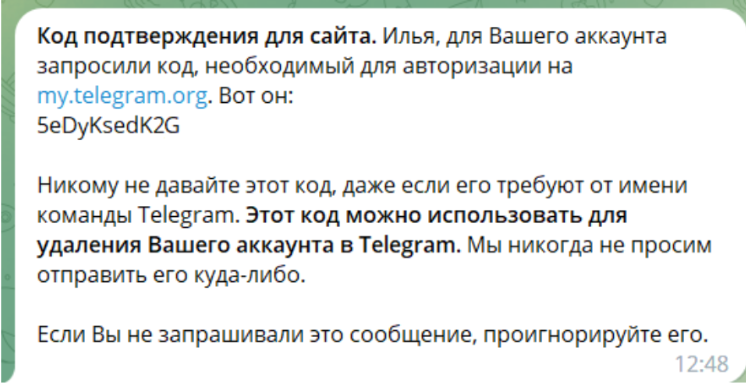
Код подтверждения придет прямо в мессенджере Telegram. Необходимо его ввести в поле Confirmation code.
 В открывшемся окне переходим по ссылке API Development Tools. Вас перебросит в окно создания приложения. Необходимо заполнить основные поля.
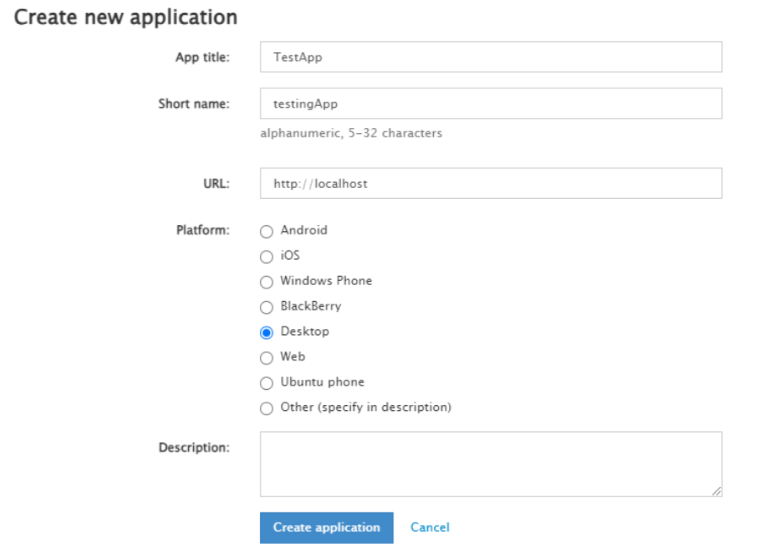
Значения полей можно указывать любые. Для нас они не играют особой роли. Ставим точку напротив Desktop и подтверждаем заполнение кнопкой Create application.

Следующее окно отобразит важные параметры вашего приложения, которые нам и будут нужны для создания приложения на Python, — это App api_id и App api_hash.
Шаг 2. Устанавливаем библиотеку telethon
Теперь у нас есть все необходимое, чтобы приступить к созданию приложения в Python. Первым делом нам понадобится библиотека telethon, чтобы авторизоваться и получить доступ к данным аккаунта. Устанавливаем ее обычным способом.

Далее импортируем необходимые модули и сразу создадим переменные с данными для авторизации.
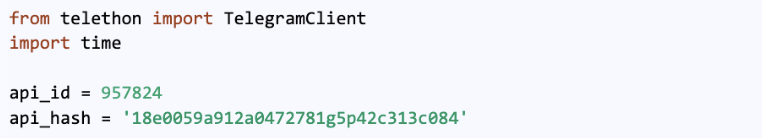
Естественно, в серьезных приложениях авторизационные данные не хранятся в таком открытом виде. Обычно используются переменные окружения, содержимое которых не раскрывается.
Следующий шаг — авторизация приложения и создание сессионного файла. Допишем следующую строку:

Здесь ‘test_tg’ — это название файла, который будет создан для хранения авторизационных данных приложения. Далее необходимо создать тот самый цикл обработки событий (event loop). Это будет асинхронная функция main ( ) , в которой мы пока напишем команду-заглушку pass. И сразу запустим этот цикл, используя один из методов запуска библиотеки telethon.
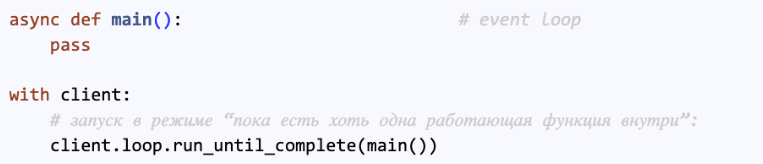
Теперь наше приложение необходимо запустить, чтобы пройти одноразовую авторизацию. Примерно так же вы устанавливаете приложение на компьютер и авторизуете его с помощью QR-кода. Запустите приложение — и в окне терминала увидите приглашение ввести проверочный код.
Можно ввести номер телефона — тогда следующее сообщение попросит одноразовый код, который придет в Telegram.

Если все выполнили верно, то ниже в терминале получите сообщение:

А также в списке файлов появится файл с авторизационными данными, имеющий расширение *.session.
Готово! Все последующие запуски вашего приложения уже будут выполняться без запроса одноразовых паролей. И код, написанный в обработчике событий main ( ) , будет сразу исполняться.
Шаг 3. Получаем первые данные из Telegram
Настало время сбора данных. Начнем с того, что у telethon есть неплохая документация, основные методы из которой мы и рассмотрим. Первая информация, которая нам доступна, — о нашем аккаунте.

Если проверим тип полученного объекта, то увидим знакомое сообщение.
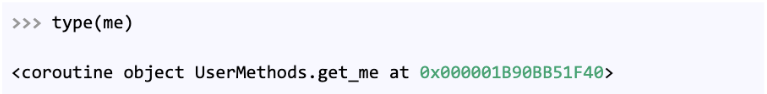
Мы получаем корутину. То есть все методы клиента Telegram асинхронны. Еще бы — без асинхронности мы не смогли бы получать информацию одновременно из нескольких чатов, а отправка фотографии другу вообще застопорила бы все процессы на глобальном уровне.
Поэтому все методы вызываем только через await.
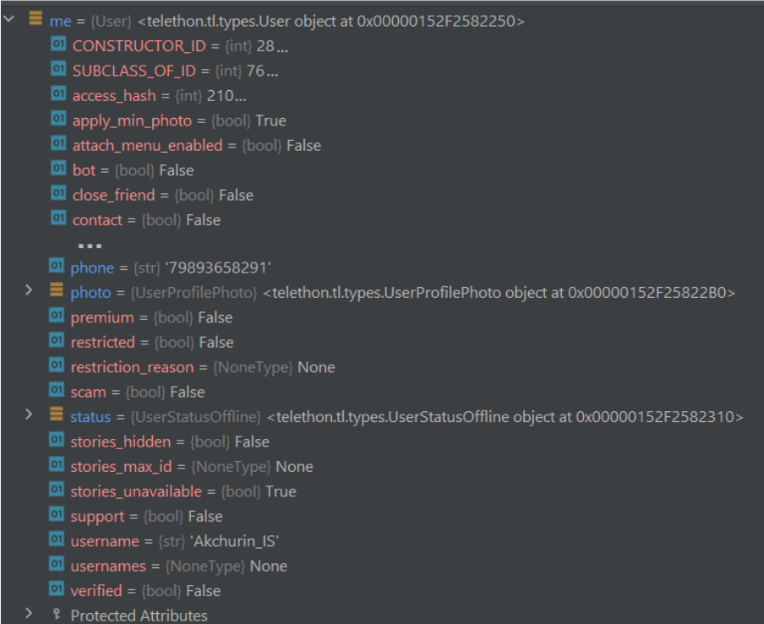
Полученный объект me содержит огромное количество свойств, включая ваше имя, фамилию, номер телефона, фотографию и много еще чего персонального, что афишировать не нужно. Просмотреть содержимое объекта удобно в режиме отладки.
 Шаг 4. Получаем диалоги
Чтобы получить список диалогов, воспользуемся еще одним методом клиента .get_dialogs( ).
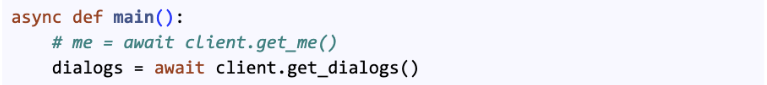
В dialogs получим общее количество диалогов. Оно включает не только каналы, на которые мы подписаны, но и личные переписки. Можете посмотреть их количество в отладчике или воспользоваться функцией len(dialogs) и испытать шок от итогового количества. У меня 1540 диалогов.

Зачем специалисту Python
Бесплатный вебинар в Контур.ШколеТак как в dialogs нам, по сути, возвращается итерируемый объект, мы можем легко его перебрать с помощью обычного цикла for, чтобы найти именно тот канал или переписку, которые нам нужны.
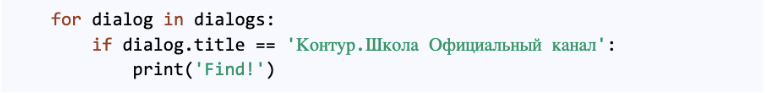
Каждый элемент полученного dialogs — это объект класса Dialog библиотеки telethon. Посмотреть методы и свойства этого объекта можно в документации. Переберем диалоги по названиям и найдем нужный.
 Шаг 5. Получаем сообщения из выбранного канала
Убедитесь, что нужный канал находится и вы получаете об этом сообщение. Когда канал у вас на руках, можно получить из него все сообщения, которые когда-либо были написаны.
Воспользуемся методом client.iter_messages(dialog), чтобы получить сообщения.

- Важно посмотреть на тип полученного значения у messages.
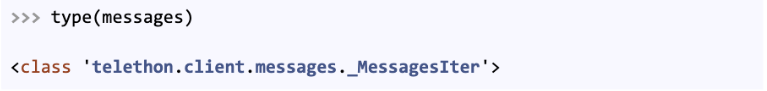
Получаем не готовый список, как в случае с диалогами, а итератор. Это не должно быть проблемой, потому что элементы итератора мы можем получить так же, как и элементы списка, — закинуть в цикл for.
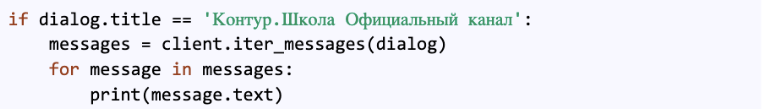
Если теперь запустим приложение, то текстов сообщений мы не увидим, а получим ошибку.

Это именно то, о чем мы говорили в начале: нужен асинхронный for, чтобы перебирать элементы асинхронного итератора. Исправим эту ошибку и получим желаемый результат.
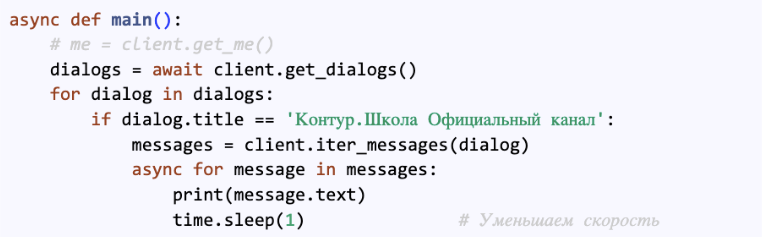
Единственное, что рекомендуется добавить, — обычную задержку между чтением каждого сообщения во избежание блокировок вашего аккаунта со стороны сервисов Telegram. Пусть будет медленно, зато спокойно и уверенно.
Напоследок рекомендуем также ознакомиться со всеми свойствами и методами объекта message. Основные из них, которые могут пригодиться при сборе полных данных, вынесены в таблицу.
date Свойство Содержит дату сообщения edit_date Свойство Содержит дату редактирования сообщения file Свойство Содержит файл, который приложен к сообщению download_media( ) Метод Позволяет загрузить файл, приложенный к сообщению is_reply Свойство Показывает, является ли сообщение ответом на другое сообщение forward Свойство Содержит информацию о первоисточнике, если текущее сообщение было переслано Конечно, в разных ситуациях могут потребоваться разные данные, но у этой статьи нет цели перепечатать всю документацию библиотеки telethon. На этой полезной ноте мы и завершим наше знакомство с асинхронным миром программирования.
Скрапинг веб-сайтов на Python — пошаговое руководство
Научитесь парсить веб-страницы с помощью Python, чтобы быстро собирать данные с нескольких сайтов с экономией времени и усилий.
3 min read
Antonello Zanini
Узнайте, как выполнять веб-скрапинг с помощью Python, чтобы быстро собирать данные с различных сайтов, экономя время и силы.
Веб-скрапинг — извлечение данных с сайтов в интернете. В частности, парсер —инструмент, позволяющий осуществлять веб-скрапинг. Python является одним из самых простых языков программирования и содержит большое количество библиотек для веб-скрапинга. Это делает его идеальным вариантом для парсинга сайтов. Скрипт для веб-скрапинга на Python требует относительно небольшого количества кода!
В этом пошаговом руководстве вы узнаете, как создать простой парсер на языке Python. Это приложение будет обходить весь сайт, извлекать данные с каждой его страницы и экспортировать их в CSV-файл. Данное руководство поможет вам понять, какие библиотеки для сбора данных на языке Python являются лучшими, какие из них следует взять на вооружение и как именно их использовать. Следуйте этому пошаговому руководству и узнайте, как создать Python-скрипт для веб-скрапинга.
Требования
Чтобы создать парсер Python, вам необходимы:
Обратите внимание, что pip по умолчанию включен в состав Python версии 3.4 и выше. Поэтому устанавливать его вручную не требуется. Если на вашем компьютере нет Python, следуйте приведенному ниже руководству для вашей операционной системы
macOS
Раньше компьютеры Mac поставлялись с предустановленным Python 2.7, но теперь это уже не так, поскольку эта версия устарела.
Если вам нужна последняя версия Python, ее необходимо установить вручную. Для этого загрузите программу установки, дважды щелкните по ней, чтобы запустить, и следуйте указаниям мастера установки.
Windows
Загрузите программу установки Python и запустите ее. Во время работы мастера установки убедитесь, что отмечен флажок «Добавить python.exe в PATH», как показано ниже:
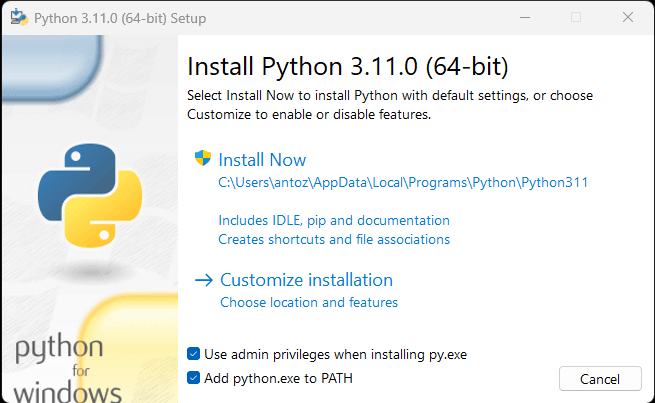
Таким образом, Windows будет автоматически распознавать команды python и pip в терминале. Напомним, что pip — менеджер пакетов для Python.
Linux
В большинстве дистрибутивов Linux Python уже предустановлен, однако речь может идти не о самой последней версии. Команда для установки или обновления Python в Linux зависит от менеджера пакетов. В дистрибутивах Linux на базе Debian выполните команду:
sudo apt-get install python3Независимо от используемой ОС, откройте терминал и убедитесь, что Python успешно установлен:
python --versionВ результате должно получиться что-то вроде этого:
Python 3.11.0Теперь все готово для создания вашего первого парсера Python. Но сначала вам нужна библиотека веб-скрапинга Python!
Лучшие библиотеки веб-скрапинга Python
Можно создать скрипт веб-парсера с нуля с помощью ванильного Python, но это не идеальное решение. В конце концов, Python известен своим обширным выбором пакетов и, в частности, есть масса библиотек для веб-скрапинга. Пришло время рассмотреть наиболее важные из них!
Requests
Библиотека Requests позволяет выполнять HTTP-запросы на языке Python. Она упрощает отправку HTTP-запросов, особенно по сравнению со стандартной библиотекой Python HTTP. Requests играет ключевую роль в проекте для веб-скрапинга на Python. Это связано с тем, что для сбора данных, содержащихся на странице, необходимо сначала получить их с помощью HTTP-запроса GET. Кроме того, возможно, придется выполнить и другие HTTP-запросы к серверу целевого сайта.
Установить Requests можно с помощью следующей команды pip:
pip install requestsBeautiful Soup
Python-библиотека Beautiful Soup упрощает сбор информации со страниц. В частности, Beautiful Soup работает с любым HTML- или XML-парсером и предоставляет все необходимое для итерации, поиска и модификации абстрактного синтаксического дерева. Обратите внимание, что Beautiful Soup можно использовать вместе с html.parser — парсером, входящим в стандартную библиотеку Python и позволяющим парсить текстовые HTM-файлы. В частности, Beautiful Soup помогает обходить DOM и извлекать из него нужные данные.
Установить Beautiful Soup с помощью программы pip можно следующим образом:
pip install beautifulsoup4Selenium
Selenium — современная система автоматизированного тестирования с открытым исходным кодом, позволяющая выполнять операции на странице в браузере. Другими словами, с его помощью можно поручить браузеру выполнение определенных задач. Обратите внимание, что Selenium также можно использовать в качестве библиотеки для веб-скрапинга благодаря его возможностям «безголового» браузера. Если вы не знакомы с этим понятием, то речь идет о веб-браузере, работающем без графического интерфейса пользователя (GUI). Если Selenium настроен в безголовом режиме, он будет запускать управляемый браузер, образно говоря «закулисно».
Интернет-страницы, посещаемые в Selenium, отображаются в реальном браузере. Таким образом, Selenium поддерживает веб-парсинг страниц, которые используют JavaScript для рендеринга или получения данных. Selenium предоставляет все необходимое для создания парсера, не требуя использования других библиотек. Установить его можно с помощью следующей команды pip:
pip install seleniumСоздание парсера на Python
Теперь давайте узнаем, как создать веб-парсер на языке Python. Вот как выглядит целевой сайт:
Это сайт Quotes to Scrape — «песочница» для веб-скрапинга, содержащая постраничный список цитат.
Цель этого урока — научиться извлекать из него данные: текст, автора и список тегов для каждой цитаты. Затем полученная информация будет преобразована в CSV-формат.
Как видите, Quotes to Scrape — это не что иное, как песочница для парсинга веб-страниц. Сайт содержит разбитый на страницы список цитат. Парсер Python, который вы собираетесь создать, извлечет все цитаты на каждой странице, и предоставит их в виде данных CSV.
Шаг 1: Выбор правильных библиотек для веб-скрапинга на языке Python
Прежде всего, необходимо понять, какие библиотеки для веб-скрапинга на языке Python лучше всего подходят для достижения поставленной цели. Для этого посетите целевой сайт в браузере. Щелкните правой кнопкой мыши по странице и выберите «Просмотреть код». Откроется окно браузера DevTools. Перейдите на вкладку «Сеть» и перезагрузите страницу.
Как вы заметили, целевой сайт не выполняет никаких Fetch/XHR-запросов.
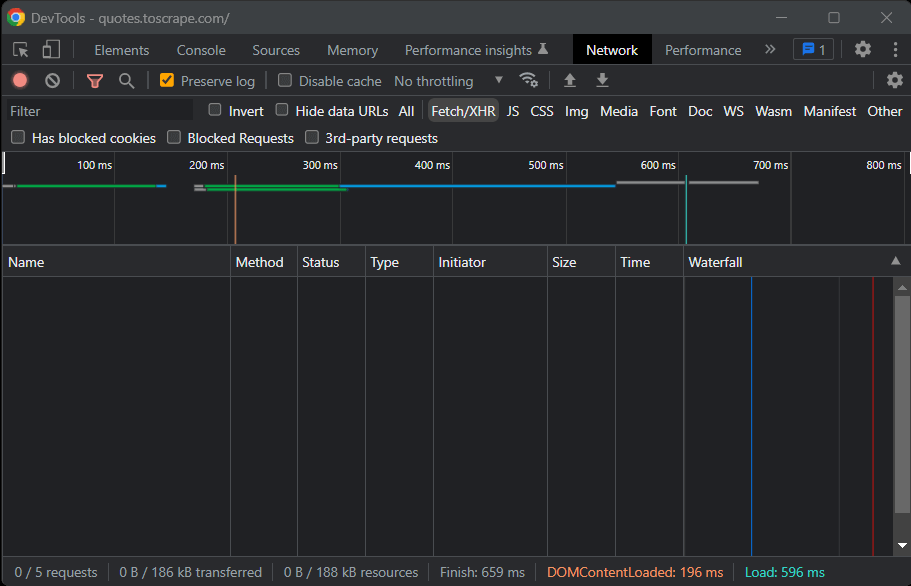
Это означает, что Quotes to Scrape не использует JavaScript для динамического извлечения данных. Другими словами, страницы, возвращаемые сервером, уже содержат интересующие данные. Именно так происходит на сайтах со статическим контентом.
Поскольку целевой сайт не использует JavaScript для вывода страницы или получения данных, Selenium для его сканирования не нужен. Вы можете использовать его, но это не обязательно. Причина в том, что Selenium открывает страницы в браузере. Поскольку это требует времени и ресурсов, Selenium снижает производительность. Этого можно избежать, используя Beautiful Soup вместе с Requests.
Теперь, когда вы поняли, какие библиотеки для веб-скрапинга на Python следует использовать, узнайте, как создать простой парсер с помощью Beautiful Soup!
Шаг 2: Инициализация проекта Python
Прежде чем написать первую строку кода, необходимо настроить проект для веб-скрапинга на языке Python. Технически для этого достаточно одного файла .py. Однако использование продвинутой IDE (Integrated Development Environment) облегчит вам работу c кодом. Здесь мы рассмотрим настройку Python-проекта в PyCharm, но подойдет и любая другая IDE для Python.
Откройте PyCharm и выберите «File > New Project… ». Во всплывающем окне «Новый проект» выберите «Чистый Python» и создайте новый проект.
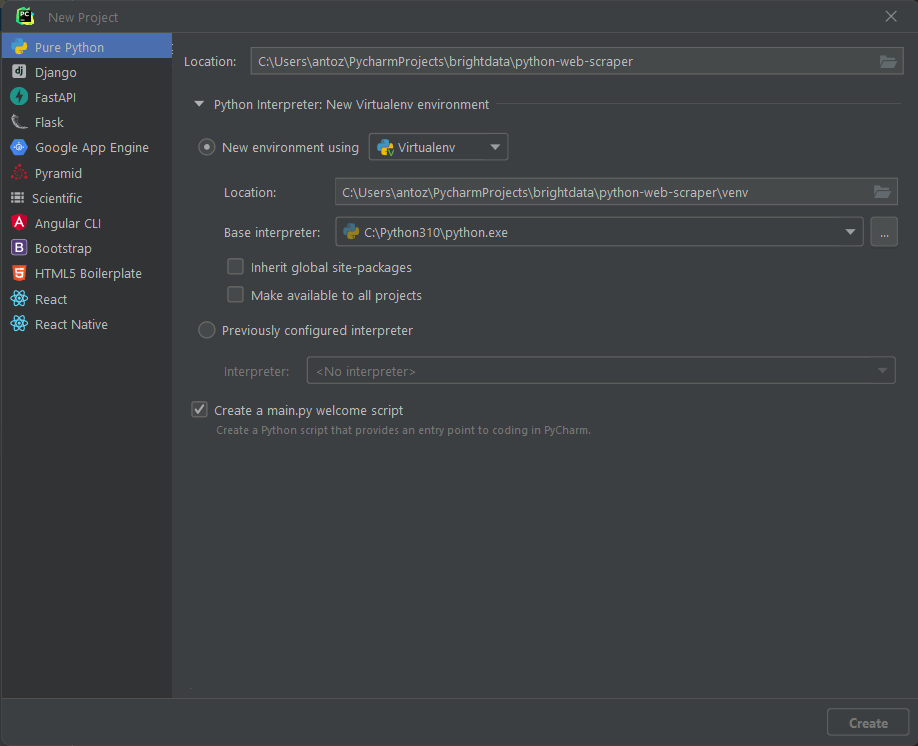
Например, вы можете назвать свой проект python-web-scraper. Нажмите кнопку «Создать», и вы получите доступ к своему пустому Python-проекту. По умолчанию PyCharm инициализирует файл main.py. Для наглядности переименуйте его в scraper.py. Вот как теперь будет выглядеть ваш проект:
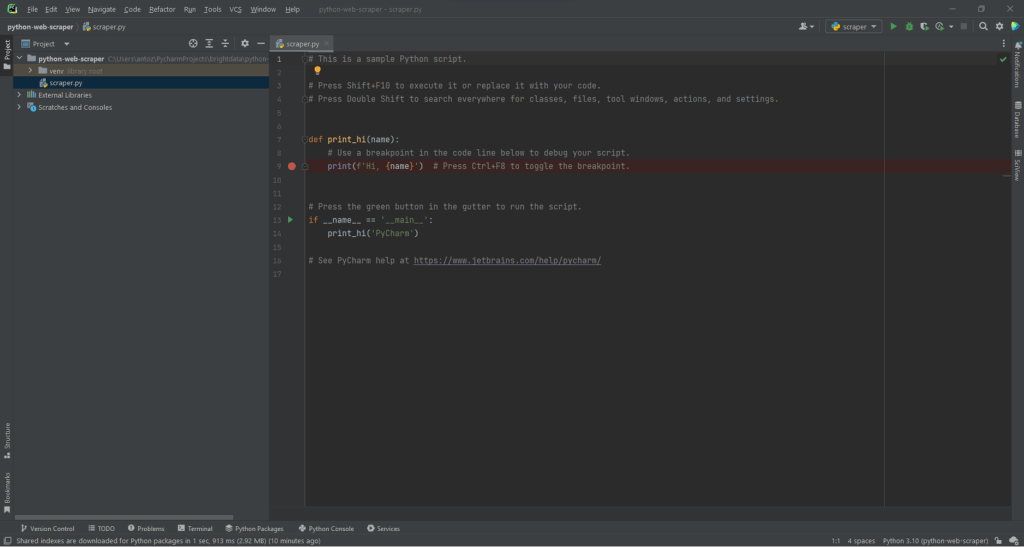
PyCharm автоматически инициализирует Python-файл со стандартным кодом. Удалите его, чтобы начать писать код с нуля.
Далее необходимо установить зависимости проекта. Установить Requests и Beautiful Soup можно, выполнив в терминале следующую команду:
pip install requests beautifulsoup4Это приведет к одновременной установке двух библиотек. Дождитесь завершения процесса установки. Теперь вы готовы использовать Beautiful Soup и Requests для создания веб-краулера и парсера на Python. Убедитесь в импорте двух библиотек, добавив следующие строки в верхнюю часть файла сценария scraper.py:
import requests from bs4 import BeautifulSoupPyCharm подсветит эти две строки серым цветом, потому что библиотеки не используются в коде. Если он подчеркнет их красным цветом, значит, что-то пошло не так в процессе установки. В этом случае попробуйте установить их снова.
Теперь вы готовы приступить к написанию логики веб-скрапинга на языке Python.
Шаг 2: Подключение к целевому URL
Первое, что необходимо сделать в веб-парсере — подключиться к целевому сайту. Для этого необходимо получить полный URL-адрес страницы из браузера. Обязательно скопируйте также секцию http:// или https:// HTTP-протокола. В данном случае это полный URL целевого сайта:
https://quotes.toscrape.comТеперь вы можете использовать запросы для загрузки страницы с помощью следующей строки кода:
page = requests.get('https://quotes.toscrape.com')Эта строка просто присваивает результат работы метода request.get() переменной page. Закулисно request.get() выполняет GET-запрос с использованием URL, переданного в качестве параметра. Затем он возвращает объект Response, содержащий ответ сервера на HTTP-запрос.
Если HTTP-запрос выполнен успешно, page.status_code будет содержать статус 200. Код ответа HTTP 200 OK означает, что HTTP-запрос был выполнен успешно. Статус HTTP 4xx или 5xx означает ошибку. Она может произойти по целому ряду причин, но следует помнить, что большинство сайтов блокируют запросы, не содержащие корректного User-Agent. Этот специальный заголовок представляет собой строку, характеризующую версию приложения и операционной системы, с которой поступил запрос. Подробнее о User-Agent для веб-скрапинга.
Задать допустимый заголовок User-Agent в запросах можно следующим образом:
headers = < 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/107.0.0.0 Safari/537.36' >page = requests.get('https://quotes.toscrape.com', headers=headersRequests теперь будет выполнять HTTP-запрос с заголовками, переданными в качестве параметра.
На что следует обратить внимание, так это на свойство page.text . В нем будет содержаться HTML-документ, возвращенный сервером в строковом формате. Передайте свойство text в программу Beautiful Soup, чтобы извлечь данные со страницы. Давайте узнаем, как это сделать.
На что следует обратить внимание, так это на свойство page.text. В нем будет содержаться HTML-документ, возвращенный сервером в строковом формате. Передайте свойство text в программу Beautiful Soup для парсинга страницы. Как это сделать, узнаем на следующем шаге!
Шаг 3: Парсинг содержимого HTML-документа
Чтобы выполнить парсинг HTML-документа, возвращенного сервером после GET-запроса, передайте конструктору BeautifulSoup() файл page.text:
soup = BeautifulSoup(page.text, 'html.parser')Второй параметр задает парсер, который будет использовать Beautiful Soup.
Теперь переменная soup содержит объект BeautifulSoup. Это древовидная структура, созданная в результате разбора HTML-документа, содержащегося в page.text, с помощью встроенного в Python парсера html.parser.
Теперь вы можете использовать его для выбора нужного HTML-элемента на странице. Смотрите, как!
Шаг 4: Выделение HTML-элементов с помощью Beautiful Soup
Beautiful Soup предлагает несколько подходов к выбору элементов в DOM. Отправными точками являются:
- find(): Возвращает первый HTML-элемент, соответствующий введенному селектору, если таковой вообще имеется.
- find_all(): Возвращает список HTML-элементов, удовлетворяющих условию селектора, переданному в качестве параметра.
В зависимости от параметров, передаваемых этим двум методам, они будут искать элементы на странице по-разному. В частности, можно выбрать элементы HTML:
# get all elements # on the page h1_elements = soup.find_all('h1')# get the element with main_title_element = soup.find(id='main-title')# find the footer element # based on the text it contains footer_element = soup.find(text=)# find the email input element # through its "name" attribute email_element = soup.find(attrs=)# find all the centered elements # on the page centered_element = soup.find_all(class_='text-center')Объединение этих методов позволяет извлекать данные из любого HTML-элемента на странице. Обратите внимание на приведенный ниже пример:
# get all "li" elements # in the ".navbar" element soup.find(class_='navbar').find_all('li')Чтобы упростить работу, в Beautiful Soup можно также использовать метод select(). Он позволяет применять CSS-селектор напрямую:
# get all "li" elements # in the ".navbar" element soup.select('.navbar > li')Обратите внимание, что на момент написания статьи селекторы XPath не поддерживаются.
Важно усвоить, что для извлечения данных с интернет-страницы необходимо сначала определить интересующие вас HTML-элементы. В частности, важно определить стратегию выбора тех, которые содержат требующие извлечения данные.
Для этого можно воспользоваться предлагаемыми браузером инструментами для разработчиков. В браузере Chrome щелкните правой кнопкой мыши на интересующем вас HTML-элементе и выберите опцию «Просмотреть код». В данном случае это нужно сделать на элементе цитаты.
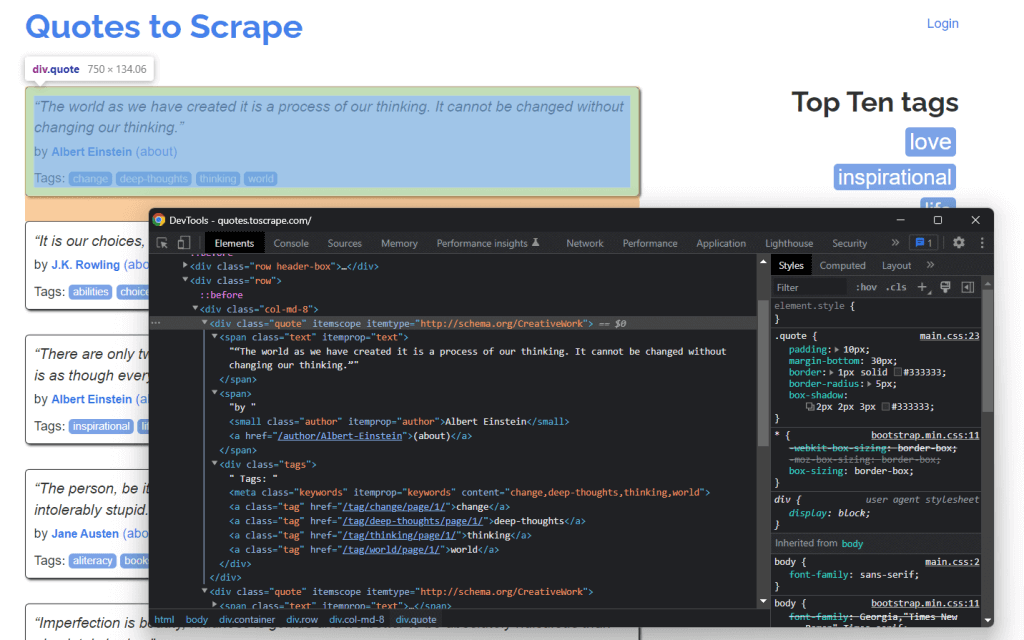
- Текст цитаты в HTML-элементе
- Автор цитаты в HTML-элементе
- Список тегов в элементе , каждый из которых содержится в HTML-элементе .
В частности, вы можете извлечь эти данные, используя следующие селекторы CSS в .quote:
Шаг 5: Извлечение данных из элементов
Во-первых, необходима структура данных, в которой будет храниться полученная благодаря парсингу информация. Для этого инициализируем переменную массива.
quotes = []Затем с помощью Soup извлекаем из DOM элементы цитаты, применив определенный ранее CSS-селектор .quote:
quote_elements = soup.find_all('div', class_='quote')Метод find_all() вернет список всех HTML-элементов
, идентифицированных классом quote. Итерация по списку цитат для получения данных о них приведена ниже:
for quote_element in quote_elements: # extract the text of the quote text = quote_element.find('span', class_='text').text # extract the author of the quote author = quote_element.find('small', class_='author').text # extract the tag HTML elements related to the quote tag_elements = quote_element.select('.tags .tag') # store the list of tag strings in a list tags = [] for tag_element in tag_elements: tags.append(tag_element.text)Метод Beautiful Soup find() получит единственный интересующий элемент HTML. Поскольку строк тегов, которые связанны с цитатой, несколько, их следует хранить в списке.
Затем можно преобразовать полученные данные в словарь и добавить его в список цитат следующим образом:
quotes.append( < 'text': text, 'author': author, 'tags': ', '.join(tags) # merge the tags into a "A, B, . Z" string >)Хранение данных в структурированном словаре облегчает доступ к ним и их понимание.
Отлично! Вы только что увидели, как извлечь все данные с одной страницы! Однако не забывайте, что у целевого сайта их гораздо больше. Пришло время научиться обходить весь сайт!
Шаг 6: Реализация логики поиска данных
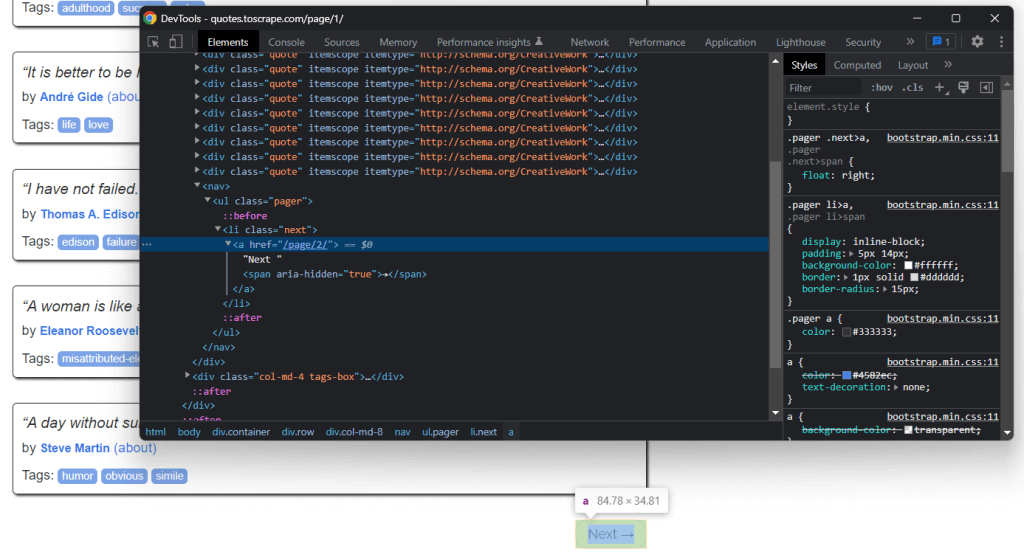
Переходя по ссылке, содержащейся в этом HTML-элементе, можно легко перемещаться по всему сайту. Итак, начните с главной страницы и посмотрите, как перейти на каждую страницу, из которых состоит целевой сайт. Для этого достаточно найти HTML-элемент .next и извлечь из него относительную ссылку на следующую страницу.
Реализовать логику по обходу всего сайта можно следующим образом:
# the URL of the home page of the target website base_url = 'https://quotes.toscrape.com' # retrieve the page and initializing soup. # get the "Next →" HTML element next_li_element = soup.find('li', class_='next') # if there is a next page to scrape while next_li_element is not None: next_page_relative_url = next_li_element.find('a', href=True)['href'] # get the new page page = requests.get(base_url + next_page_relative_url, headers=headers) # parse the new page soup = BeautifulSoup(page.text, 'html.parser') # scraping logic. # look for the "Next →" HTML element in the new page next_li_element = soup.find('li', class_='next')Цикл where выполняет итерацию по каждой странице до тех пор, пока не окажется на последней странице. Он извлекает относительный URL следующей страницы и использует его для создания полноценного URL-адреса для дальнейшего парсинга. Новая страница загружается, выполняется ее веб-скрапинг и та же логика повторяется снова.
Теперь вы знаете, как парсить многостраничный сайт. Осталось научиться преобразовывать извлеченные данные в более удобный формат, например CSV.
Шаг 7: Извлечение полученных данных в CSV-файл
Рассмотрим, как экспортировать список словарей, содержащих извлеченные данные, в CSV-файл. Для этого понадобится следующий код:
import csv # scraping logic. # reading the "quotes.csv" file and creating it # if not present csv_file = open('quotes.csv', 'w', encoding='utf-8', newline='') # initializing the writer object to insert data # in the CSV file writer = csv.writer(csv_file) # writing the header of the CSV file writer.writerow(['Text', 'Author', 'Tags']) # writing each row of the CSV for quote in quotes: writer.writerow(quote.values()) # terminating the operation and releasing the resources csv_file.close()Этот фрагмент записывает данные о цитатах, содержащиеся в списке словарей, в файл quotes.csv . Обратите внимание, что csv является частью стандартной библиотеки Python. Поэтому его можно импортировать и использовать без установки каких-либо дополнительных зависимостей.
По сути, необходимо просто создать CSV-файл с помощью функции open(). Затем заполнить его функцией writerow() из объекта Writer библиотеки csv. В результате каждый словарь цитат будет записан в виде строки в CSV-формате.
Вы перешли от необработанных данных, содержащихся на сайте, к полуструктурированным данным, хранящимся в CSV-файле. Процесс извлечения данных завершен, и теперь вы можете взглянуть на свой полноценный Python-парсер.
Шаг 8: Собираем все вместе
Вот как выглядит готовый скрипт на Python для сбора данных:
import requests from bs4 import BeautifulSoup import csv def scrape_page(soup, quotes): # retrieving all the quote HTML element on the page quote_elements = soup.find_all('div', class_='quote') # iterating over the list of quote elements # to extract the data of interest and store it # in quotes for quote_element in quote_elements: # extracting the text of the quote text = quote_element.find('span', class_='text').text # extracting the author of the quote author = quote_element.find('small', class_='author').text # extracting the tag HTML elements related to the quote tag_elements = quote_element.find('div', class_='tags').find_all('a', class_='tag') # storing the list of tag strings in a list tags = [] for tag_element in tag_elements: tags.append(tag_element.text) # appending a dictionary containing the quote data # in a new format in the quote list quotes.append( < 'text': text, 'author': author, 'tags': ', '.join(tags) # merging the tags into a "A, B, . Z" string >) # the url of the home page of the target website base_url = 'https://quotes.toscrape.com' # defining the User-Agent header to use in the GET request below headers = < 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/107.0.0.0 Safari/537.36' ># retrieving the target web page page = requests.get(base_url, headers=headers) # parsing the target web page with Beautiful Soup soup = BeautifulSoup(page.text, 'html.parser') # initializing the variable that will contain # the list of all quote data quotes = [] # scraping the home page scrape_page(soup, quotes) # getting the "Next →" HTML element next_li_element = soup.find('li', class_='next') # if there is a next page to scrape while next_li_element is not None: next_page_relative_url = next_li_element.find('a', href=True)['href'] # getting the new page page = requests.get(base_url + next_page_relative_url, headers=headers) # parsing the new page soup = BeautifulSoup(page.text, 'html.parser') # scraping the new page scrape_page(soup, quotes) # looking for the "Next →" HTML element in the new page next_li_element = soup.find('li', class_='next') # reading the "quotes.csv" file and creating it # if not present csv_file = open('quotes.csv', 'w', encoding='utf-8', newline='') # initializing the writer object to insert data # in the CSV file writer = csv.writer(csv_file) # writing the header of the CSV file writer.writerow(['Text', 'Author', 'Tags']) # writing each row of the CSV for quote in quotes: writer.writerow(quote.values()) # terminating the operation and releasing the resources csv_file.close()Как здесь показано, веб-парсер можно создать менее чем за 100 строк кода. Этот скрипт Python способен обойти весь сайт, автоматически извлечь его данные и экспортировать их в CSV-файл.
Поздравляем! Вы только что узнали, как создать веб-парсер на Python с помощью Requests и Beautiful Soup!
Шаг 9: Запуск скрипта для веб-скрапинга на языке Python
Если вы являетесь пользователем PyCharm, запустите скрипт, нажав кнопку ниже:
Или запустите следующую команду Python в терминале внутри каталога проекта:
python scraper.pyДождитесь окончания процесса, и вы получите доступ к файлу quotes.csv. Откройте его. Он должен содержать следующие данные:
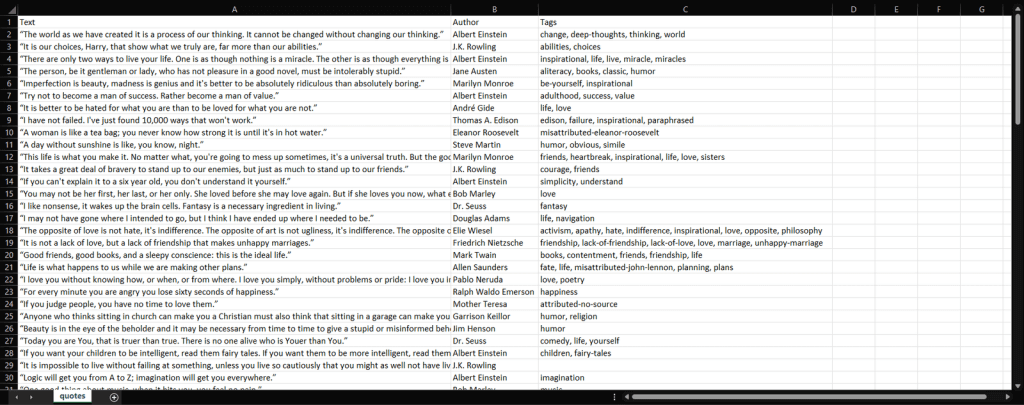
Теперь у вас есть все 100 цитат, содержащихся на целевом сайте, в одном файле и в удобном для чтения формате!
Вывод
Из этого руководства вы узнали, как выполнять веб-скрапинг с помощью Python, что в этом случае необходимо для начала работы и какие библиотеки Python для парсинга являются лучшими. Затем на реальном примере мы показали, как использовать Beautiful Soup и Requests для создания приложения для веб-скрапинга. Как вы могли убедиться, для создания скрипта для парсинга на языке Python нужно не так уж и много кода.
Однако веб-скрапинг сопряжен с целым рядом проблем. В частности, все большую популярность приобретают технологии защиты от ботов и парсинга. Именно поэтому вам необходим современный инструмент для веб-скрапинга, который предлагает компания Bright Data.
Чтобы избежать проблем с блокировками, мы также рекомендуем выбрать прокси с учетом ваших потребностей из большого ассортимента прокси-сервисов Bright Data.
FAQ
Является ли Python подходящим языком для веб-скрапинга? Python не только отлично подходит для веб-скрапинга, но и считается одним из лучших для этого языков. Это объясняется его удобочитаемостью и относительной простотой. Кроме того, он имеет одно из самых больших сообществ в мире IT и предлагает широкий выбор библиотек и инструментов, предназначенных для парсинга. Является ли веб-скрапинг и краулинг частью науки о данных? Да, веб-скрапинг и краулинг являются частью большой области науки о данных. Скрапинг/кроулинг служит основой для всех других побочных продуктов, которые могут быть получены из структурированных и неструктурированных данных. К ним относятся аналитика, алгоритмические модели/результаты, инсайты и «применимые знания». Как с помощью Python получить с сайта конкретные данные? Веб-скрапинг данных с сайта с помощью Python подразумевает изучение страницы целевого URL, определение данных, которые необходимо извлечь, написание и выполнение кода извлечения данных, а также сохранение полученной информации в нужном формате. Как создать веб-парсер на Python? Первым шагом в создании веб-парсера с помощью Python является использование строковых методов для анализа сайта, затем сбор данных с него с использованием HTML-парсера и, наконец, взаимодействие с необходимыми формами и компонентами интернет-ресурса.