Наводим порядок в разработке ПО вместе с maven. Часть 1

Разработка программного обеспечения — не самая простая наука. В общем объеме времени, отданного на создание продукта, написание непосредственно программного кода занимает далеко не самую большую долю. По мере увеличения сложности создаваемого продукта, финансовых и временных затрат, опережающими темпами растут затраты на анализ требований, планирование и организацию коллективной работы, на повышение качества. Почти год назад я написал несколько серий статей, посвященных не, собственно, программированию, а различным технологиям и инструментам, поддерживающим процесс разработки ПО. Это были статьи, рассказывающие об управлении версиями документов (SVN и perforce), ведении списка задачи и багов в JIRA, хоть и поверхностно, но я прошелся и по вопросам тестирования веб-проектов с помощью badboy и jmeter. Сегодня пришло время раскрыть еще один инструмент (maven), с помощью которого ход разработки ПО должен стать более управляемым.
Я не хотел бы начинать рассказ о maven и о том, что это такое, с какой-то цитаты или описания maven, взятого с wikipedia или сайта maven.apache.org. За сухой официальной формулировкой легко потерять главное – те конкретные плюсы, которые вы получите в реальных житейских ситуациях, если будете использовать maven. Поэтому я расскажу об истории своих взаимоотношений с maven и о том, как он шаг за шагом завоевывал мое уважение.
Хотя основная сфера моей деятельности связана с java и веб-технологиями, и maven считается java-инструментом, но надеюсь, что идеи, которые я расскажу, пригодятся и тем, кто работает с .net, php и другими языками и платформами (разработчики на flash/flex, внимание: maven уже идет к вам). В далеком 2006-м я частенько посещал один из российских форумов, посвященных программированию и java в частности. Читая чужие вопросы и ответы, можно узнать много нового, а если уж попробовать отвечать на них, то рост знаний и навыков просто обеспечен. Единственная проблема была в том, что часто люди, у которых возникали затруднения с каким-то кодом, помимо словесного описания, что у них есть, что нужно получить, и что не работает, прикладывали к сообщениям форума и файлы с архивами своих проектов (точнее, каких-то выжимок из них). В этих архивах были файлы с исходными кодами на java и файлы проекта. Файлы проекта — это особые файлы, нужные для правильной работы IDE (intellij idea, eclipse, netbeans). В файлах проекта помимо всякой малополезной ерунды вроде настроек шрифтов, списка открытых окон, были еще и сведения о библиотеках, используемых для компиляции и запуска проекта. Я не открою большой тайны, если скажу, что для java (да и для любого другого языка) характерно огромное количество библиотек, framework-ов для web, для работы с базами данных, веб-сервисами. Библиотек этих много, много и их версий (ведь библиотеки развиваются). Теперь представим себе последовательность шагов, которые должен был бы выполнить я, чтобы просмотреть чей-то проект и быстро (ведь это все на голом энтузиазме) найти ошибку. Я загружаю архив, распаковываю его, смотрю содержимое и должен угадать на основании расширения файлов, в какой ide его нужно открыть. Предположим, что это intellij idea, даже предположим, что у меня такая же версия intellij idea, как и та, которой пользуется тот, кто отправил мне архив проекта. Если же проект сделан не в intellij idea, а, например, в eclipse, то я трачу время на то, чтобы создать проект и импортировать в него файлы.
Импорт файлов не так прост, как кажется: давайте рассмотрим его на примере веб-приложения. Хотя есть sun-стандарт, описывающий, какая должна быть структура каталогов и файлов в конечном приложении (размещаемом на сервере), но вот стандарта того, как должны быть организованы (опять таки в каких каталогах и подкаталогах) исходные файлы проекта, такого стандарта нет. Если каталог с java-файлами худо-бедно, но во всех ide называется src, то каталог с выходными файлами может называться out, output, classes. По-разному могут называться и размещаться в каталоге проекта и папки, хранящие файлы графических ресурсов, css-файлов и файлов с javascript-ом и шаблоны html-страниц. Но сложности, связанные с необходимостью создания нового проекта и «раскладки» файлов из старого проекта по новым правилам, кажутся совсем незначительными, если мы подумаем о зависимостях проекта, то есть о том, какие библиотеки нужны для его работы. Итак, я загрузил файл проекта, запустил его на компиляцию и получаю множество ошибок вида: «не найдена библиотека X, не известен класс Y». Когда создавался проект в IDE, то программист определил в составе проекта некоторую логическую абстракцию – библиотеку, то, как ее понимает IDE. В состав этой библиотеки входит множество файлов с расширениями jar (реальные архивы библиотек java). Эти файлы загружены программистом на свой компьютер, например, в папку «c:\java_libs». Таким образом, библиотека в понятии IDE – это множество путей вида: «c:\java_libs\hibernate.jar «. А у меня на компьютере нет этих библиотек. Даже если я открыл настройки чужого проекта и увидел там файл с именем hibernate.jar, то это мне ничем не поможет, так как библиотека hibernate имеет множество версий, и я просто не знаю, какой файл добавить к проекту, чтобы он скомпилировался и запустился. Напоминаю, что я решил потратить не больше 10 минут на то, чтобы помочь кому-то разобраться с его ошибкой, я не будут тратить свое время на совершение рутинных подготовительных операций. Даже если забыть об истории с форумом и моим желанием разобраться в чужом коде, то представьте ту же ситуацию, когда на работе в коллективе вы создаете некоторый java-продукт. Так как над проектом работает несколько человек и у каждого из них своя предпочитаемая среда разработки (одному нравится eclipse, другому idea) с разными настройками, с разными путями к файлам библиотек и проектов. Следовательно, мы не можем хранить в CVS файлы проекта – они слишком «личные».
Но ведь этот проект должен регулярно извлекаться из репозитория, компилироваться, развертываться на тестовом сервере, чтобы затем команда тестеров могла регулярно проверять сделанную вами за день работу и завести в jira десяток-другой багов. Следовательно, в репозитории должна храниться информация о проекте, о том, какие модули входят в его состав, какой модуль зависит от какого – и все это в максимально абстрактном виде. То есть нам нужен такой стандарт представления проекта, который бы не зависел от среды разработки (читай, поддерживался бы ими всеми). Та же беда и с библиотеками, нужными для компиляции проекта: где их хранить? Единственное приемлемое решение – поместить их также внутрь cvs-репозитория. Таким образом, java-проект представляет в репозитории максимально самодостаточную единицу: он содержит и файлы с исходным кодом, и библиотеки, нужные для их компиляции, и некий супер-скрипт, который выполняет компиляцию проекта и подготовку его к развертыванию на «боевом» веб-сервере. Возникает естественный вопрос: неужели до сих пор не появился какой- то инструмент, решающий эту задачу. Задачу представления проекта и составляющих его модулей в форме, не зависимой от конкретной среды разработки, инструмента, содержащего средства записать сценарий, как нужно компилировать и собирать проект. Инструмент, позволяющий вынести все используемые для разработки библиотеки в отдельное хранилище (например, отдельный сервер) и позволяющий условно сказать: «для сборки проекта нужна библиотека hibernate версии 3.2.1». Инструмент, известный, популярный, такой, чтобы если у вас возникнет какая-то проблема, связанная с его применением, то можно было бы положиться на развитое community. Желательно, чтобы проект был opensource, чтобы включал в себя api, позволяющее создавать собственные расширения, плагины. Итак, первое лицо maven – это инструмент для декларативного описания структуры проекта и нужных для его работы зависимостей (библиотек). Таким образом, после миграции проекта на maven набор шагов по компиляции проекта будет следующим: извлечь из cvs исходные коды проекта и файл проекта maven, запустить проект на сборку, в ходе которой maven найдет правильный порядок сборки модулей, образующих проект (по ходу их зависимостей друг от друга), загрузит со специального сервера нужные для компиляции библиотеки (если их еще нет на вашем компьютере) и завершит компиляцию проекта. Важно, что один и тот же файл будет использоваться всеми участниками команды, как программистами, так и тестерами. Тестеры вообще ничего не знают о структуре проекта и его зависимостях, они знают только то, что если запустить вот этот maven-файл на выполнение, то получится исполняемый файл, который можно проверять на предмет ошибок.
Теперь перейдем к «немножко попрограммировать», и я опишу процесс создания проекта с помощью maven. Предполагается, что вы загрузили с сайта сайт архив с maven-ом. Так как maven появился уже достаточно давно, то в настоящий момент есть две ветви его разработки: 1x (больше не развивается) и 2x. Прогресс при переходе от версий 1x к 2x был очень большой, так что я не вижу никакой причины, почему вам следует использовать maven 1. Сам я уже довольно давно «сижу» на maven 2.0.9, и единственная причина, почему я не перешел на недавно вышедшую 2.0.10, так это моя лень и то, что в девятке меня все устраивает. Распаковав архив с maven, нужно создать пару переменных среды окружения для удобства последующей работы с maven из командной строки. Сначала создадим переменную M2_HOME, указывающую на каталог с maven. Еще в самый конец переменной PATH я добавил путь к каталогу %M2_HOME%/bin. Проверьте работоспособность maven, набрав в командной строке «m2 -v», и в ответ вы должны получить строку «Maven version: 2.0.9.». Значит, maven установлен и работает, а мы идем дальше.
Проект в терминологии maven – это каталог со стандартизированной структурой. Пусть и де-факто, но maven предлагает стандарт именования каталогов с исходными кодами, каталога, где находятся ресурсы, и каталога, куда будут помещены результаты компиляции проекта. В корне каталога проекта находится файл pom.xml. За счет того, что maven создан в соответствии с идеологией «соглашения превыше конфигурирования», то размер файла pom.xml может быть совсем маленьким. Например, если вы решили изменить имена и структуру каталогов проекта, то это придется указать в pom-файле, а если решили следовать правилам maven, то ничего делать не нужно. Более того, в maven есть понятие archetypes (шаблонов проектов). Количество различных программ, которые можно написать на java, бесконечно, однако количество типов этих приложений довольно ограничено: обычные java, web- приложения, ejb-модули, ear-приложения – это первое, что приходит на память. Более того, maven настолько популярен, что разработчики различных известных и не очень framework-ов, например, spring, jsf, tapestry, seam создали для maven новые виды archetypes. Следовательно, вы получаете возможность «быстрого старта» с maven и archetype. Более подробно об archetypes, какие они бывают и откуда их брать, я расскажу попозже, сейчас давайте создадим «ручками» maven-style структуру каталогов. Полагая, что мой проект называется testartifact1 (почему в названии присутствует слово artifact, опять требует уточнений, но позже), я создал каталог testartifact1, а в нем подкаталоги src и target.
В первом из них будут храниться исходные коды проекта, а во второй будет помещаться результат компиляции. Так как современная разработка ПО немыслима без тестов, то в каталоге src были созданы еще два подкаталога: main и test. В первом из них хранится код приложения, а во втором тесты для него. Это еще не все: кроме исходного кода в виде файлов java, проект часто включает ресурсы: это могут быть файлы properties с различными настройками и конфигурационными переменными, нужными для запуска создаваемой программы, или это могут быть файлы картинок для интерфейса. В любом случае каталог main состоит из двух подкаталогов: java и resources. Такое же деление характерно и для каталога test. В конечном счете я получил дерево каталогов, показанное на рис. 1.
Теперь нужно наполнить эти каталоги содержимым. Я создал простенький класс HelloBean, единственным назначением которого будет «приветствовать пользователя» (имя пользователя передается как параметр конструктора класса). Файл размещен в каталоге «src/main/java/blackzorro»:
package blackzorro;
public class HelloBean private String name;
public HelloBean(String name) this.name = name;
>
public String sayHello() return «Hello, » + name;
> >
Затем я создал еще два класса, использующих HelloBean. Первый из них, HelloMaven, разместился в одном каталоге с HelloBean:
public class HelloMaven public static void main(String [] args) System.out.println(new HelloBean(«Maven»).sayHello());
> >
А второй находится в каталоге «src/test/java/blckzorro» и представляет собой тест junit:
public class TestHelloBean extends TestCase public void testSimpleMessage() String message = new HelloBean(«Maven 2»).sayHello();
Assert.assertEquals(«Test Hello Machine», «Hello, Maven 2», message);
> >
Подписаться на ленту

Для подписки на ленту скопируйте и вставьте эту ссылку в вашу программу для чтения RSS.
Дизайн сайта / логотип © 2023 Stack Exchange Inc; пользовательские материалы лицензированы в соответствии с CC BY-SA . rev 2023.10.27.43697
Нажимая «Принять все файлы cookie» вы соглашаетесь, что Stack Exchange может хранить файлы cookie на вашем устройстве и раскрывать информацию в соответствии с нашей Политикой в отношении файлов cookie.
Apache Maven
Сегодня речь пойдёт о Maven. Это в первую очередь утилита для сборки Java проектов, но по факту является системой управления проекта в целом, определяет его структуру и, во многом, жизненный цикл. (Apache Maven is a software project management and comprehension tool. Project object model (POM)) Работая с базовыми сценариями в хорошо настроенном окружении, программисту не требуется глубоко вникать в тонкости этой технологии. Но стоит проекту Maven перестать собираться, как легко можно попасть в тупик, для выхода из которого требуется опыт и понимание определённых нюансов. Почему не находится плагин? Зачем он лезет в интернет? Почему падает деплой артефакта? Откуда взялась библиотека log4j первой версии? Почему сборка работает локально, а на Jenkins падает? У меня в IDE всё компилируется, а Maven что-то тупит. Вспоминать и фантазировать можно долго.
Многие скажут, что я утрирую, но Вы можете поверить, что люди переходили с Eclipse на IDEA после трёх и более лет разработки потому, что сложный maven проект отказывался нормально импортироваться в Eclipse, но коллеги пользовались IDEA и никто не мог помочь настроить его в Eclipse?
Но даже учитывая всё это, использование Maven — это необходимость и меньшее из зол. Maven заставляет всех разработчиков делать одинаково и более менее правильно. Это касается структуры проектов, расположения и имён определённых файлов, управлениями модулями, зависимостями и в определённой степени процессом релизов.
Как развивались некоторые проекты, пока их не мигрировали на maven? Все известные мне проекты собирались с помощью утилиты Ant. Не знаю, смог ли кто-то настроить компиляцию и сборку с использованием непосредственно утилиты javac, поставляемой вместе JDK а также shell или bat скриптов, но это было бы уж слишком безумно. Большинство вполне успешно обходилось утилитой Ant.
Давайте пофантазируем, как это было. Куда положить исходный код? Ну, допустим ./src/Main.java или ./src/com/example/Main.java, если с пакетами. Куда проперти файлы? Давайте туда же ./src/log4j.xml. Но не все, что-то положим в ./conf. Куда будем складывать скомпилированные файлы? Мне нравится ./dist. А тесты? В ./test/src, а данные для теста в ./test/*, то есть рядом с исходниками. Честно говоря, я подсматриваю в реальном проекте. Если вы уже имеете опыт разработки, то уже чувствуете отсутствие стандарта — вроде всё логично, но в то же время наобум. И на каждом новом проекте будет похоже, но по-другому. Кстати, а библиотеки мы куда положим? В ./lib, конечно же. Стоп! Что значит положим библиотеки, разве они не должны храниться централизованно и выкачиваться автоматически при необходимости? Нет, библиотеки скачивают, потом обычно из переименовывают из log4j-1.2.12.jar в log4j.jar, чтобы версию уже никак нельзя было определить, разве что её заботливо указали в MANIFEST файле внутри библиотеки. Естественно, библиотеки сохраняются и в системе контроля версий, и таким образом любой проект весит уже никак не меньше 20-50 мегабайт.
С библиотеками вообще очень неудобно — начинаешь новый проект и каждую библиотеку скачивать из интернета и сохранять в проекте неудобно, ещё и может понадобиться в IDE явно её добавлять. Но был найден удобный и эффективный подход, решающий все проблемы — мы будем копировать lib из проекта в проект. Со временем там окажутся все нужные нам библиотеки: логгеры, драйверы всех баз данных, spring, apache commons, junit, сервлеты.
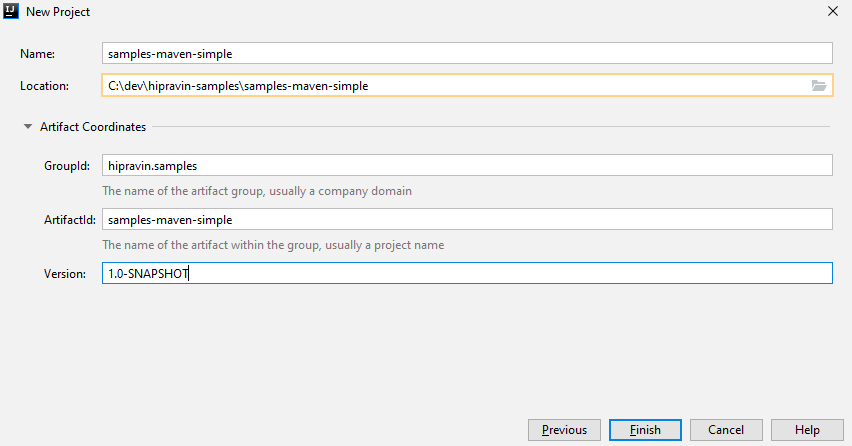
Ну вот у нас есть исходные файлы, мы настроили IDE, указав пути к ним, добавили библиотеки. Пришло время показать наше приложение кому-то, а на местном наречии — «выложить». Выложить в тестовую среду или продакшен. В случае web приложения это означает, что нужно создать ZIP архив фиксированной структуры, состоящий из скомпиливанных классов, файлов настроек, библиотек и ещё пары специальных файлов. Этот архив называется WAR-архивом (или варником). Для всего этого и создаётся Ant сборка. Чаще всего это файл с названием build.xml, в довесок к которому идёт build.properties. Пример содержимого такого фэйла:
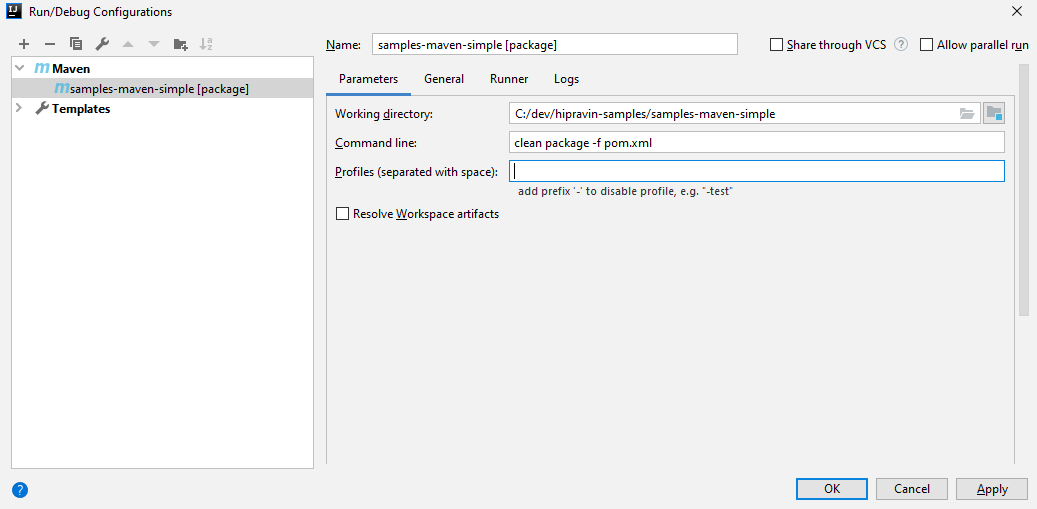
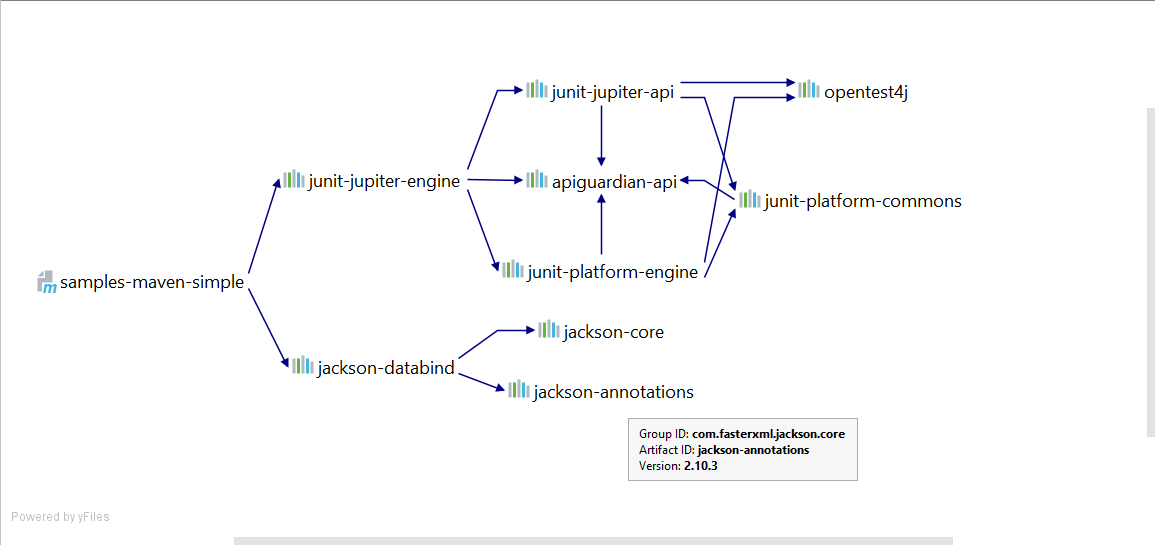
Команда завершается успешно, в папке ./target появился файл samples-maven-simple-1.0-SNAPSHOT.jar. В нём только сам pom.xml и MANIFEST.MF следующего содержания: Чаще всего это применяется к библиотекам логирования. Например, исключаем отовсюду log4j, а потом добавляем log4j-over-slf4j. Подробнее тут.
Добавлю один интересный сценарий связанный с тестированием, о котором не все знают. Все тесты располагаются в папке src/test, в все юнит тесты имеют постфикс «Test». По практикам разработки существуют ещё интеграционные тесты, которые могут использовать внешние сервисы и запускаются отдельно от юнит тестов. Для них иногда заводят отдельные модули и настройки surefire плагина. Можно поступить иначе — добавить к имени теста постфикс «IT» (полный список: **/IT*.java, **/*IT.java, **/*ITCase.java). Такие тесты запускаются командой «mvn verify», а отвечает за них специальный maven-failsafe-plugin. Он требует явного указания в pom.xml: То есть при настройках по умолчанию придётся ждать целый день, чтобы воспользоваться исправленной версией библиотеки! А если установить опцию ‘always’, то сборки начнут заметно тормозить при большом количестве snapshot зависимостей. Удобно при необходимости добавлять к аргументам команды сборки параметр «-U» (mvn clean package -U), тогда все снэпшоты будут принудительно обновлены. Процесс разработки можно выстроить следующим образом:
- Устанавливаем версию библиотеки 1.0-SNAPSHOT
- Устанавливаем версию зависимости в основном приложении в 1.0-SNAPSHOT
- Вносим изменения в библиотеку, выполняем deploy
- Пересобираем основное приложение, при необходимости с аргументом -U, тестируем
- Повторяем шаги 3-4 до тех пор, пока код не стабилизируется и все ошибки не будут исправлены
- Устанавливаем версию библиотеки 1.0
- Устанавливаем версию зависимости в основном приложении в 1.0
- Осуществляем финальные проверки и выходим в релиз. Если находим ошибки, возвращаемся на шаг 6, меняя версию на 1.0.1
- Начинаем работу над следующим релизом
- Устанавливаем версию библиотеки 1.1-SNAPSHOT
- Устанавливаем версию зависимости в основном приложении в 1.1-SNAPSHOT
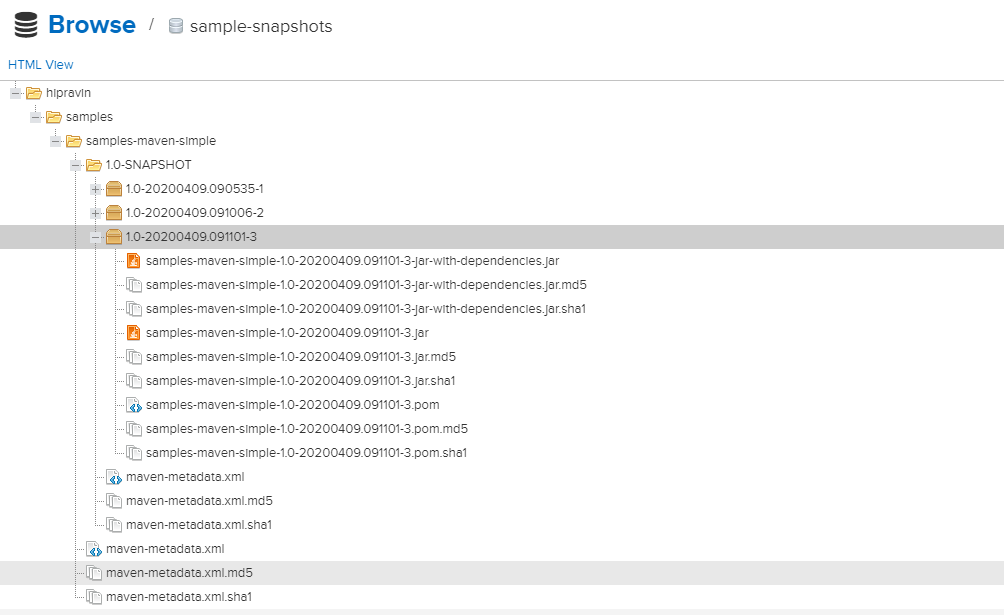
Чтобы снэпшоты не накапливались в репозитории в неограниченном количестве, в Nexus и Artifactory существуют политика удаления старых версий. Поэтому иногда старые снэпшоты теряют свою актуальность или вообще пропадают из репозитория, хотя по хорошему последняя-то версия не должна удаляться. Следует руководствоваться следующим правилом: версия release не должна иметь snapshot зависимостей. Только в этом случае релизная версия представляет собой что-то финальное и не подверженное случайным факторам. Если же мы оперируем версиями snapshot, значит наш код часто меняется и при случае мы легко можем восстановить артефакт в репозитории, запустив команду deploy.
На этом пока оставим релизы и снэпшоты. Заметили, что вместе с обычным артефактом сборки в репозиторий попала ещё версия «jar-with-dependencies»? При этом группа, артефакт и версия у них совпадают. Это возможно благодаря дополнительному атрибуту зависимостей — classifier. При использовании assembly плагина в файле конфигурации assembly.xml нужно указать id. В нашей сборке id неявно устанавливается в «jar-with-dependencies». Результаты сборки плагином assembly ведут себя так же, как и основной артефакт. Зависимость будет выглядеть так, если понадобится:
hipravin.samples samples-maven-simple 1.0-SNAPSHOT jar-with-dependencies
Атрибут classifier также используется при загрузке исходного кода и документации javadoc. По умолчанию загружается только скомпилированный код, а пользователи нашей библиотеки не увидят никакой документации, а если попытаются посмотреть исходный код, то получат в лучшем случае декомпилированную версию. Это не очень удобно, поэтому лучше публиковать sources и javadoc. Для этого добавляем в pom.xml два плагина:
org.apache.maven.plugins maven-source-plugin 3.2.1 attach-sources jar org.apache.maven.plugins maven-javadoc-plugin 3.2.0 attach-javadocs jar
Теперь при выполнении команды deploy в репозиторий будут загружены дополнительные артефакты с классификаторами «-sources» и «-javadoc», и соответствующая информация будет автоматически доступна в IDE разработчика, использующего нашу библиотеку.
Модули
До сих пор мы работали с приложением, состоящим из одного модуля. Однако модули — едва ли не главная функциональность Maven, сильнее всего влияющая на процесс проектирования и разработки приложений. Сегодня в эпоху микросервисов становится всё более популярно использовать один репозиторий (GIT) для одного сервиса. В этом случае объём кода и логики одного приложения часто не требует разделения на модули. Сейчас я не буду никак сравнивать монолит с микросервисной архитектурой. Многие работают с монолитом или как минимум c приложениями с большим объёмом кода в одном репозитории. В этом случае разделение кода на модули имеет тот же смысл, что разделение на пакеты, классы, методы.
Разделение на пакеты — по большей части логическое, визуальное, если не считать модификаторов доступа protected и default. При разделение на модули код одного модуля ни во время компиляции, ни во время исполнения ничего не знает о других модулях, если не установлена зависимость. Одна из ситуаций, когда модули жизненно необходимы — если в одном проекте уживаются вместе несколько приложений. Например, несколько web приложений, которые мы собираем в отдельные WAR архивы и может даже развертываем на разных серверах Apache Tomcat. Каждое приложение мы помещаем в отдельный модуль. Приложения не полностью различны, они как-то перекликаются, относятся к единому бизнес домену, поэтому возникают повторяющиеся классы и методы, то есть дублирование кода. Тогда мы выделяем отдельный модуль common, куда перемещаем все общие части. Потом нам хочется больше модулей, чтобы каждый отвечал за свою задачу, а не содержал сборную солянку разных утилит. Тогда в дополнение к common мы вводим модули security, model, dao и так далее. Просто чтобы в коде было чисто и аккуратно. Бонусом получаем скорость сборки, ведь нет смысла пересобирать модули, в которых не было изменений.
Код примера. Рассмотрим небольшое приложение, состоящее из нескольких модулей. Программа подсчитывает частоту появления различных слов во входном файле. В модуле common реализован сам алгоритм, модуль consoleapp содержит главный класс для запуска из консоли, а модуль webapp — Web приложение с REST сервисом. Между webapp и сonsoleapp нет зависимостей, но оба зависят от common. Можно представить, что приложение существует давно, а для работы с ним всегда использовалась консоль, но теперь решили добавить ещё и веб сервис. В коде приложения ничего показательного, его я приводить не буду, лучше сконцентрируюсь на Maven.
При создании проекта в корне я сразу удалил папку src, а в pom.xml установил свойство packaging в значение «pom». Также artifactId имеет окончание «-parent», но это необязательно, больше для удобства и потому что так принято.
hipravin.samples.maven samples-maven-multiple-parent 1.0-SNAPSHOT pom
Такой модуль называют родительским (parent) или иногда основным, главным. Он обычно не содержит исходного кода и артефактов сборки. Его предназначение — управлять остальными модулями. Все они должны быть перечислены в теге modules:
common consoleapp webapp
Все дочерние (child) модули наследуют свойства, зависимости, плагины от родительского модуля. Например, уровень языка для compiler плагина достаточно указать только в главном модуле. А вот зависимости в главном модуле указывать не стоит, потому что исключить их в дочерних модулях будет крайне затруднительно. Вместо этого в родительском модуле фиксируют список библиотек их версий, а в дочерних — лишь ссылаются на них. Выглядит это так: в главном модуле в pom.xml используется тег dependencyManagement, а в дочерних — dependency без версии:
. org.junit.jupiter junit-jupiter-engine 5.4.0 test org.junit.jupiter junit-jupiter-engine
Помимо перечисления версий библиотек в dependencyManagement по одной, существует дополнительный механизм указания версий для целой группы зависимостей — BOM (Bill Of Materials). Это очень полезно для проектов с большим количеством модулей (например, для spring: core, context, beans, web, jdbc, . ). Модуль webapp использует Spring Boot, BOM можно указать в главном модуле следующим образом:
org.springframework.boot spring-boot-dependencies 2.2.6.RELEASE pom import . org.springframework.boot spring-boot-starter-web
Ключевым здесь является значение параметра scope равное import.
Для проектов, использующих Spring Boot альтернативный вариант — указать в качестве родительского проекта spring-boot-starter-parent. То есть родительский модуль не обязательно должен располагаться рядом в том же проекте, он может загружаться и из удалённого Maven репозитория. В этом случае нужно установить свойство relativePath в пустое значение. Например, так:
org.springframework.boot spring-boot-starter-parent 2.2.2.RELEASE
При этом родительский модуль может быть только один.
Чтобы классы из модуля common были доступны в модуле consoleapp, нужно добавить зависимость так же, как ранее мы добавляли зависимость на библиотеку jackson.
hipravin.samples.maven common $
Вместо версии 1.0-SNAPSHOT мы ссылаемся на версию родительского модуля, потому что неразумно иметь разные версии в рамках одного проекта, а дублировать эту версию многократно неудобно. На этом этапе может возникнуть определённая путаница, как в понимании происходящего, так и в работе самого Maven. Как мы знаем, зависимости загружаются из репозитория, либо берутся напрямую из папки .m2. Но мы ещё ни разу не собирали наш проект и тем более не выполняли install или deploy. В рамках одного проекта Maven в этом не нуждается — он выстроит дерево зависимостей наших модулей, причём именно дерево, а не граф, потому что циклы запрещены. Потом он осуществит сборку модулей в правильном порядке и при работе с каждым модулем все его зависимости уже будут обработаны. Если какой-то из модулей Maven упорно пытается искать в репозитории, то вероятно допущена ошибка в координатах зависимости.
Чтобы собрать весь проект целиком достаточно запустить команду «mvn package» в корне проекта. Так же с install и deploy. Так выглядит лог успешной сборки:
. [INFO] Reactor Summary for samples-maven-multiple-parent 1.0-SNAPSHOT: [INFO] [INFO] samples-maven-multiple-parent . SUCCESS [ 1.012 s] [INFO] common . SUCCESS [ 10.054 s] [INFO] consoleapp . SUCCESS [ 1.032 s] [INFO] webapp . SUCCESS [ 4.769 s] [INFO] ------------------------------------------------------------------------ [INFO] BUILD SUCCESS
Довольно редко возникает необходимость собирать только один модуль, однако если проект громоздкий и полный билд занимает минуты, то это может быть полезно. Для этого нужно указать список модулей для сборки, например один модуль webapp, а также параметр —also-make, чтобы были обработаны необходимые модули, от которых явно или неявно зависит webapp.
clean package --projects webapp --also-make . [INFO] Reactor Summary for samples-maven-multiple-parent 1.0-SNAPSHOT: [INFO] [INFO] samples-maven-multiple-parent . SUCCESS [ 0.382 s] [INFO] common . SUCCESS [ 6.051 s] [INFO] webapp . SUCCESS [ 2.755 s] [INFO] ------------------------------------------------------------------------ [INFO] BUILD SUCCESS
Заметим, что сейчас в проекте несколько раз дублируется версия родительского модуля. Это вполне допустимо, но при обновлении версии на, скажем, 1.0 или 1.1-SNAPSHOT, нам придётся обновлять код в нескольких местах, что создаёт вероятность ошибки, вызванной человеческим фактором. Хуже всего обновлять по памяти: тут, тут и тут, потому что легко можно случайно забыть или пропустить один из модулей. Если артефакты попадают в локальный репозиторий, то проект продолжит собираться без ошибок, но код одного из модулей будет использовать старую версию родительского модуля. Второй вариант — использовать автозамену по проекту (Ctrl+Shift+R в IDEA). Этот вариант плох тем, что можно случайно заменить лишнего — но чаще всего в этом случае проект просто не скопмилируется. Правильный способ обновлять версию — использовать плагин versions:
mvn versions:set -DnewVersion=1.1-SNAPSHOT mvn versions:commit
Команда «commit» здесь не имеет ничего общего с коммитом в системе контроля версий, это специфический этап работы плагина, удаляющий сохранённую копию pom.xml файла, которая создаётся на первом этапе.
Разное
О нескольких моментах стоит упомянуть для полноты картины, хоть им не нашлось места в демонстрационных проектах, описанных ранее.
Параметр optional. Модули webapp и consoleapp транзитивно зависят от всех библиотек, от которых зависит common. Эти библиотеки можно исключить в pom.xml каждого из этих модулей, используя exclusions, как мы уже видели. Альтернативно можно указать на этих зависимостях в модуле common параметр optional в значение true, тогда в webapp и consoleapp изменения не потребуются. Используется редко, не буду заострять внимание на этом.
Беспорядок с версиями зависимостей. Версия одной и той же библиотеки может быть указана явно единожды, транзитивно единожды, явно многократно, транзитивно многократно. Теоретически у Maven есть детерминированный алгоритм по определению версии. Практически лучше избегать неопределённости и изучать граф зависимостей, а также список библиотек, попадающий в артефакт сборки JAR with dependencies, WAR или EAR. Версия, указанная явно в pom.xml самого модуля имеет приоритет над транзитивными версиями. Однако если версии отличаются ещё и в group id / artifact id как, например, log4j и log4j2, то проблему можно решить только аккуратным исключением всех лишних зависимостей. А найти проблему можно, опять же, только анализом графа зависимостей и артефактов сборки.
Dependency scope. Для каждой зависимости можно указать scope. Часть значений влияет на то, в какие classpath попадает данная зависимость, другие просто определяют некое особое поведение. Мы уже встречали compile (значение по умолчанию), test и import. Я просто приведу список всех значений с небольшими комментариями. Я буду писать «сохраняется в lib» имея в виду, что библиотека попадает в classpath во время исполнения, а также копируется в директорию lib внутри артефактов сборки таких как WAR и EAR.
compile Значение по умолчанию. Зависимость доступна во время компиляции основного кода и тестов, сохраняется в lib. provided Зависимость доступна во время компиляции основного кода и тестов, но не сохраняется в lib. Применяется, когда библиотека предоставляется контейнером. Например, Weblogic предоставляет драйвер для соединения с базой данных. runtime Зависимость не доступна во время компиляции основного кода, доступна для компиляции тестов (не знаю зачем), но сохраняется в lib. Пример — драйвер базы данных, библиотеки логирования. test Зависимость не доступна во время компиляции основного кода, доступна для компиляции тестов, не сохраняется в lib. system Позволяет подключить библиотеку, jar файл которой располагается по определённому пути на файловой системе. Не рекомендую к использованию, в этом случае следует просто установить библиотеку в локальный репозиторий с помощью install-file. import Используется в dependencyManagement вместе c так называемым BOM (bill of materials)
Я не разбираю scope подробно, потому что в большинстве случаев достаточно compile и test, которые тривиальны, а остальные применяются по ситуации и редко приводят к скрытым ошибкам. А вот понять и запомнить чем отличается provided от runtime при первом знакомстве мало кому удаётся.
Жизненный цикл, фазы. Жизненный цикл состоит из фаз, которые мы можем указывать в строке запуска mvn. Каждый плагин запускается в ту фазу, которая указана в его конфигурации. Список всех фаз: validate, compile, test, package, verify, install, deploy. Опять же углубляться не буду, полагаю станет только непонятней. С практической точки зрения мы уже рассмотрели все основные фазы жизненного цикла.
Архетипы. Без использования IDE чтобы создать пустой maven проект нужно будет где-то взять заголовок xml файла и добавить в него как минимум координаты проекта. А если наш проект использует какой-то фреймворк, то потребуются ещё какие-нибудь обязательные настройки и файлы. В Maven существует понятие архетипа — способа создавать готовые проекты по шаблону с указанием набора параметров. Spring initializer, вероятно, внутри работает на основе архетипов. Однако это отдельный сайт, да и ещё со встроенной поддержкой в IDEA, поэтому пользоваться шаблонами Spring Boot через интерфейс командной строки было бы странно. В своей практике я не применял архетипы кроме как в ознакомительных целях.
Gradle. Gradle — аналог Maven, который появился чуть позже и считается более продвинутым, современным, стильным — модным — молодежным. Основное различие между ними — Gradle использует язык Groovy или Kotlin для конфигурации, а не XML, а также по-другому определяет жизненный цикл. Одно и то же приложение может одновременно иметь эквивалентные конфигурации сборок на Maven и Gradle. На сайте spring.io примеры одновременно содержат инструкции и для Maven, и для Gradle. При этом сам springframework начиная как минимум с версии 4 собирается с помощью Gradle. В работе же я встречал только Maven, если не считать одного приложения, которое потом перенесли на Maven для порядка и потому что Gradle билд сломался, а починить никто не сумел. По своему опыту могу только сказать, что Gradle очень плохо настраивается в окружении, где отсутствует или ограничен доступ в интернет. Не исключено, что при должной сноровке это возможно, но у кого она есть, эта сноровка. Я уверен, что в коммерческой разработке Maven ещё долго будет популярен благодаря старым проектам и наработанному специалистами опыту.
Заключение
В Mаven очень много нюансов и тонкостей, но в целом это очень стройная и эффективная технология и экосистема. Так или иначе, в мире Java разработки встречи с Maven не избежать. Надеюсь, что наиболее частые, полезные и хитрые сценарии я как-нибудь, да затронул.
Study & Dev О программировании и не только
Наводим порядок в разработке ПО вместе с maven. Часть 4
Одна из самых широко разрекламированных и приятных возможностей maven – это управление зависимостями. Описав в файле pom.xml список артефактов нужных для работы проекта, мы перекладываем на maven все заботы связанные с загрузкой библиотек из internet, разрешение транзитивных зависимостей. И можем сосредоточиться на, собственно, разработке проекта, написании кода. Увы, но задачу разрешения зависимостей не всегда можно выполнить автоматически, т.к. существует вероятность конфликтов различных версий библиотек. Как находить и устранять такие конфликты – это как раз тема сегодняшнего материала.
В прошлой статье я остановился на том, что начал рассказывать об репозиториях артефактов, о том как регистрировать в файле проекта дополнительные сайты-репозитории артефактов, как настроить proxy-сервер для работы maven в сети, в которой нет прямого доступа в internet. Давайте продолжим рассмотрение характеристик артефакта-зависимости:
>mygroup >
>myartifact >
>linux >
>import >
>path-to-lib >
>true >
Первые пять характеристик артефакта (groupId, artifacId, version, classifier и type) вместе называются maven coordinates и служат для однозначного (с небольшой оговоркой) определения какой именно файл-библиотека нужен проекту, какое имя этого файла. Формально, координата артефакта — это четыре слова, разделенные знаком двоеточия, в следующем порядке groupId:artifactId:packaging:version, например, jboss: javassist:jar: 3.0. Путь, по которому находится файл артефакта, использует указанные выше четыре характеристики, например, «c:\Documents and Settings\blackzorro\.m2\repository\jboss\javassist\3.0\javassist-3.0.jar». Т.е. группе артефакта соответствует имя подкаталога (jboss) внутри каталога репозитория (./m2/repository). Затем идет подкаталог с именем артефакта, его версией. И, наконец, идет файл в названии которого присутствует имя артефакта, его версия, а расширение файла соотносится с packaging. Правило: “расширение файла с артефактом равно его packaging” не всегда верно. К примеру, те, кто знаком с разработкой enterprise приложений, состоящих из бизнес-логики в виде ejb-модулей и интерфейса в виде war-модулей, знают, что модули ejb-внешне представляют собой файлы обычных архивов с расширением jar. Хотя, записывая зависимость от такого модуля в веб-проекте, мы внутри элемента type пишем, именно, слово ejb. Если проект или библиотека имеют только одно представление, например, тот же файл архива jar, то packaging опускается и координаты выглядят так groupId:artifactId:version. Что касается пятого параметра – classifier, то его значение также участвует в формировании имени файла артефакта и записывается сразу после основного имени файла, перед расширением, например, так: javassist-3.7.ga-classifier.jar. Зачем я полез в такие дебри координат maven? Все дело в том, что часто на сайтах библиотек, или в статьях, блогах, когда идет рассказ о создании проекта. И дело доходит до перечисления того, какие библиотеки нужны проекту, то они задаются не длинными пространными описаниями, вроде “скачайте с сайта A файл B.zip распакуйте его найдите в нем …”, а короткими тройками (четверками) maven-координат. В любом случае знание о координатах maven будет для вас полезным т.к. те же координаты вы будете использовать не только для декларирования “что нужно для проекта”, но и для задания координат вашего проекта. Помните, я многократно акцентировал ваше внимание на том, что в maven-мире “все является артефактами”. К примеру, когда мы создаем проект и выполняем его компиляцию, то формируем имя файла, в названии которого присутствует основные черты “maven coordinates”. Эти артефакты уже готовы к установке как в локальный репозиторий на вашем компьютере, чтобы их могли использовать другие проекты, так и для распространения в public-репозитории в internet. Напомню, что в самом начале файла pom.xml вы указываете такие элементы-координаты как:
xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd">
>testgroup >
>obmach >
Как видите, есть четкое отображение элементов присутствующих в названии проекта и того, как можно на этот проект сослаться в другом проекте. groupId, artifactId, version имеют названия идентичные с названиями элементов внутри объявления зависимости dependency. Поменялось название элемента только для формата (расширения, стратегии упаковки) артефакта: так packaging в объявлении проекта соответствует type. Куда-то только пропал элемент classifier, но о нем позже т.к. classifier вещь сложная и требует рассказа о большом количестве редко используемых функций maven.
Вернемся немного назад и продолжим рассмотрение элементов формирующих зависимости и на очереди стоит элемент scope. Что же это такое, и какими могут быть его значения? Мы уже сталкивались с областями действия зависимостей (именно так переводится scope), когда в самом первом примере проекта хотели использовать библиотеку junit для написания теста, проверяющего логику работы основного приложения. Scope означает область действия, или этап жизненного цикла проекта, в котором эта зависимость будет доступна. К примеру, когда я пометил библиотеку junit как: test . То это значит, что зависимость будет “подсунута” maven-ом в проект, когда выполняется компиляция той части проекта, которая содержит тесты (напомню, что по правилам maven, тесты должны размещаться в каталоге src/test). Также библиотека junit будет “подсунута” в проект перед запуском тестов на выполнение и построением отчета с результатами тестирования кода. Если мы попробуем сослаться на какой-то класс или функцию из библиотеки junit в основной части приложения (каталог src/main), то получим ошибку. Наиболее часто используемая зависимость – это compile. Т.е. библиотека помеченная как compile (или для которой мы не указали значение элемента scope вообще) будет доступна для компиляции и основного приложения, и его тестов, и на стадии запуска тестов, и на стадии запуска основного приложения. Напомню, что инициировать запуск тестов из управляемого maven-проекта можно выполнив команду ”m2 test”, а для запуска приложения используется плагин exec (подробнее о нем во второй статье серии). Третий вариант значения scope – provided, его назначение можно разъяснить на примере разработки веб-приложения. Т.к. веб-приложение выполняется в среде веб-сервера, то в самом сервере уже могут быть установлены наиболее популярные библиотеки, например, hibernate или jsf. Таким образом, нет необходимости упаковывать в файл проекта (war-файл) эти библиотеки, а нужно только те, которые являются редкими и которых наверняка не будет в стандартном джентльменском наборе хостинг-провайдера. Либо, есть ситуация когда версии библиотек, которые были установлены хостером, вам категорически не подходят. Тогда вам придется включать правильные версии в файл war. В любом случае нет смысла включать в файл веб-проекта те библиотеки, которые должны гарантированно быть на веб-сервере по стандарту (например, servlet-api). Написав эти строки, я с усмешкой вспомнил встретившийся мне пару месяцев назад на одном из сайтов учебный материал, рассказывающий о создании на java собственного то ли сайта, то ли блога. Материал был очень хорош, но несколько портила впечатление ссылка в конце статьи, где предлагалось скачать к себе на компьютер архив размером в пару десяток мегабайт, из которых 99% занимали библиотеки, и только 1 %, непосредственно, код учебного материала. Итак, возвращаясь к maven, если вы разрабатываете приложение использующую некоторую большую библиотеку X, и при этом уверены, что эта библиотека будет на той машине или веб-сервере где приложение будет запускаться. В этом случае имеет смысл пометить зависимость как provided и хоть она будет доступна на стадии компиляции и тестирования приложения, но из финального архива поставляемого заказчику зависимость будет исключена. Не могу удержаться от небольшого лирического отступления адресованного тем, кто говорит про себя: подумаешь, размер больше на десяток другой мегабайт, за то не будет такого, что потом приложение не запустится у клиента из-за “потерянной” библиотеки. С одной стороны, действительно наличие в архиве “лишних” библиотек позволит избежать проблемы “на веб-сервере хостера не оказалось чего-то”. Но от другой проблемы, проблемы “на сервере хостера оказалась библиотека не той версии”, увы, легкого решения нет. К сожалению, в мире java разработчики стандартов не слишком долго думали над задачами размещения и одновременной работы на сервере множества веб-приложений. Т.к. разным приложениям могут потребоваться разные версии библиотек (и часто несовместимые между собой), то инсталлировать эти библиотеки внутрь сервера, так чтобы они были доступными, общими для всех веб-сайтов на одном физическом сервере опасно. С другой стороны, если общих библиотек нет, и каждое веб-приложение будет содержать десятки мегабайт библиотеки дублирующихся с библиотеками “вот того, соседнего приложения”, то очень скоро станет вопрос об исчерпании памяти, а, следовательно, медленной и неустойчивой работы. Именно это я считаю одной из причин того, что java будучи очень востребованной на рынке разработки сложных, больших, высокопроизводительных и прочая и прочая веб-приложений, имеет совершенно противоположную сторону для небольших веб-сайтиков, размещаемых пачками на одном физическом сервере. К сожалению, пока нет ни стандарта, ни конкретных продуктов (веб-серверов), которые бы позволяли создавать веб-приложения построенные на идеологии декларативного описания списка зависимостей нужных для работы приложения и их эффективного “коллективного использования” между несколькими веб-приложениями. В любом случае, проблема конфликта версий известна и многие веб-сервера имеют специальные, конечно же, проприетарные технологии разрешения конфликтов. Снова вернемся к maven и возможным значениями для характеристики scope. Четвертым видом области действия scope является runtime, такая библиотека не нужна для компиляции проекта, но нужна на стадии выполнения приложения. В редких случаях вам может пригодиться такое значение scope как system. К примеру, проект нуждается для работы в некоторой особой, недоступной в public-репозитории зависимости. По какой-то причине вы не хотите выполнять принудительную maven-изацию зависимости и инсталлировать ее в локальный репозиторий (про команду install более подробно смотрите в прошлой статье). В таком случае вы можете указать путь к файлу зависимости внутри элемента systemPath:
>sun.jdk >
>tools >
>system >
>$/../lib/tools.jar >
Есть требование, что значение systemPath должно быть абсолютным путем к файлу с артефактом. Соблюсти это требование практически не реально в случае, если один файл проекта pom.xml используется одновременно коллективом разработчиков (у всех ведь есть свои настройки компьютера). В любом случае, я не рекомендую использовать system scope, вместо этого выполнять установку артефактов в локальный или корпоративный репозиторий, да и разработчики maven говорят, что эту scope они могут в любой момент выкинуть вон как устаревшую. Есть еще один недавно появившийся вариант scope – import, но он слишком специфичен и пока нас не интересует. Давайте лучше пойдем далее и рассмотрим понятие распространения “propogation” для области действия артефакта. Scope propogation тесно связано с автоматическим обнаружением транзитивных зависимостей. К примеру, мы создаем проект A, который зависит от проекта B. Но этот проект, в свою очередь, нуждается проекте C. Подобная цепочка зависимостей может быть сколь угодно длинной, но нам нужно четкое понимание того, что делает maven и как связаны между собой проект A и проект C. В следующей табличке (любезно позаимствованной с сайта maven) приводится набор правил переноса режима scope. К примеру, если мы подключаем библиотеку “B” как compile, а она в свою очередь подключает библиотеку “C” как provided, то наш проект “A” будет зависеть от “C” так как указано в ячейке находящейся на пересечении строки “compile” и столбца “provided”.
| Compile | Provided | Runtime | Test | |
| Compile | Compile | — | Runtime | — |
| Provided | Provided | Provided | Provided | — |
| Runtime | Runtime | — | Runtime | — |
| Test | Test | — | Test | — |
Имея приведенную выше таблицу правил переноса scope и набор файлов pom соответствующих артефактам (в pom-файлах хранятся сведения о том какие зависимости нужны для артефакта) мы можем сами построить дерево зависимостей для каждой из фаз жизненного цикла проекта. Другое дело, что строить дерево зависимостей вручную долго и сложно. Поэтому я познакомлю вас с одним из самых полезных maven-плагинов – dependency. Так выполнив команду “m2 dependency:list” мы получим итоговый список артефактов и их вычисленных scope:
[INFO] [dependency:list] [INFO] [INFO] The following files have been resolved: [INFO] ant:ant:jar:1.5.2:compile [INFO] antlr:antlr:jar:2.7.6:compile [INFO] aopalliance:aopalliance:jar:1.0:compile [INFO] asm:asm:jar:1.5.3:compile [INFO] asm:asm-attrs:jar:1.5.3:compile [INFO] bouncycastle:bcprov-jdk15:jar:135:test [INFO] c3p0:c3p0:jar:0.9.1:compile [INFO] cglib:cglib:jar:2.1_3:compile
Такой “итоговый” список не слишком удобен для расследования вопроса: откуда взялся тот или иной артефакт (точнее какой другой артефакт потянул эту зависимость). Гораздо удобнее, если информация будет представлена в виде дерева. Например, команда dependency:tree сформирует дерево зависимостей как показано здесь:
[INFO] [dependency:tree] [INFO] mygroup:shared:jar:0.1-SNAPSHOT [INFO] +- javax.ejb:ejb-api:jar:3.0:provided [INFO] \- com.flexive:flexive-shared:jar:3.1-SNAPSHOT:provided [INFO] +- com.flexive:fxStream:jar:3.1-SNAPSHOT:provided [INFO] +- com.flexive:jboss-common-core-42-compat:jar:3.1-SNAPSHOT:provided [INFO] +- commons-codec:commons-codec:jar:1.3:provided [INFO] +- com.google.collections:google-collections:jar:0.8:provided [INFO] +- javax.activation:activation:jar:1.1:provided [INFO] +- commons-io:commons-io:jar:1.4:provided [INFO] +- commons-lang:commons-lang:jar:2.4:provided [INFO] +- commons-validator:commons-validator:jar:1.3.1:provided [INFO] | +- commons-beanutils:commons-beanutils:jar:1.7.0:provided [INFO] | +- commons-digester:commons-digester:jar:1.6:provided [INFO] | | \- commons-collections:commons-collections:jar:2.1:provided [INFO] | \- commons-logging:commons-logging:jar:1.0.4:provided [INFO] +- org.codehaus.groovy:groovy-all-minimal:jar:1.5.6:provided [INFO] +- com.thoughtworks.xstream:xstream:jar:1.3:provided [INFO] | \- xpp3:xpp3_min:jar:1.1.4c:provided [INFO] +- org.jboss.cache:jbosscache-core:jar:2.1.1.GA:provided [INFO] | \- jgroups:jgroups:jar:2.6.2:provided [INFO] \- com.flexive:sanselan:jar:0.87-incubator:provided [INFO] ------------------------------------------------------------------------ [INFO] Building ejb [INFO] task-segment: [dependency:tree] [INFO] ------------------------------------------------------------------------ [INFO] snapshot mygroup:shared:0.1-SNAPSHOT: checking for updates from maven.flexive.org [INFO] [dependency:tree] [INFO] mygroup:ejb-jar:ejb:0.1-SNAPSHOT [INFO] +- mygroup:shared:jar:0.1-SNAPSHOT:compile [INFO] +- javax.ejb:ejb-api:jar:3.0:provided [INFO] +- javax.persistence:persistence-api:jar:1.0:provided [INFO] \- com.flexive:flexive-shared:jar:3.1-SNAPSHOT:provided [INFO] +- com.flexive:fxStream:jar:3.1-SNAPSHOT:provided [INFO] +- com.flexive:jboss-common-core-42-compat:jar:3.1-SNAPSHOT:provided [INFO] +- commons-codec:commons-codec:jar:1.3:provided [INFO] +- com.google.collections:google-collections:jar:0.8:provided [INFO] +- javax.activation:activation:jar:1.1:provided [INFO] +- commons-io:commons-io:jar:1.4:provided [INFO] +- commons-lang:commons-lang:jar:2.4:provided [INFO] +- commons-validator:commons-validator:jar:1.3.1:provided [INFO] | +- commons-beanutils:commons-beanutils:jar:1.7.0:provided [INFO] | +- commons-digester:commons-digester:jar:1.6:provided [INFO] | | \- commons-collections:commons-collections:jar:2.1:provided [INFO] | \- commons-logging:commons-logging:jar:1.0.4:provided [INFO] +- org.codehaus.groovy:groovy-all-minimal:jar:1.5.6:provided [INFO] +- com.thoughtworks.xstream:xstream:jar:1.3:provided [INFO] | \- xpp3:xpp3_min:jar:1.1.4c:provided [INFO] +- org.jboss.cache:jbosscache-core:jar:2.1.1.GA:provided [INFO] | \- jgroups:jgroups:jar:2.6.2:provided [INFO] \- com.flexive:sanselan:jar:0.87-incubator:provided [INFO] ------------------------------------------------------------------------ [INFO] Building war [INFO] task-segment: [dependency:tree] [INFO] ------------------------------------------------------------------------ .
Плагин dependency содержит большое количество целей, одни из самых полезных это: dependency:purge-local-repository – служит для удаления из локального репозитория всех артефактов, от которых прямо или косвенно зависит наш проект. Затем удаленные артефакты заново загружаются из internet, это может быть нужно, когда какой-то из файлов артефактов был загружен из internet со сбоями, а у вас нет времени искать его, и проще очистить репозиторий (но ведь не весь) и попробовать загрузить библиотеки заново. Цель (goal) плагина dependency:sources служит для загрузки из internet исходников для всех артефактов используемых в проекте. Это одна из самых полезных функций, которые есть в maven. Ведь разрабатывая и тем более отлаживая какой-то код, часто возникает необходимость подсмотреть исходный код какой-либо библиотеки. В internet, в public репозиториях часто (хотя и не всегда) хранятся не только скомпилированные и готовые к использованию файлы артефактов в виде jar-библиотек, но и их исходники и документация. Например, для артефакта google-collections-0.8.jar исходники будут в расположенном рядом архиве google-collections-0.8-sources.jar, а документация в файле google-collections-0.8-javadoc.jar (как видите, слово sources или javadoc занимают места зарезервированные для classifier). В практике использовать вызов dependency:sources только для получения списка файлов с исходниками проекта мало: мы хотим ведь хотим разрабатывать проект в своей любимой среде разработке (IDE), такой как eclipse или idea. Генерацию проекта выполняет команда: “m2 idea:idea” или “m2 eclipse:eclipse”, но об них в следующий раз, а сегодня я продолжу рассказ об плагине dependency. Еще одна полезная функция maven – это создание каталога, внутрь которого будут скопированы абсолютно все, как прямые, так и косвенные зависимости для проекта. Это первый шаг для того, чтобы сделать разрабатываемое вами приложение переносимым между различными компьютерами. Разработанное вами приложение после выполнения фазы install будет представлено в виде архива jar содержащего написанный вами код. Естественно, что если нужные для проекта библиотеки-зависимости не будут найдены при запуске проекта в classpath, то ваше приложение не запустится. Общепринятой методикой является создание структуры установочного каталога в виде двух подкаталогов: bin и lib. Внутри lib находится и ваш код и абсолютно все библиотеки нужные для его запуска. В каталоге bin находится исполняемый файл в виде cmd-скрипта (для windows) или sh-скрипта (для linux). Действия, которые выполняет запускной скрипт (назовем его run.cmd) тривиальны. Необходимо динамически сконструировать строку classpath на основании списка всех библиотек внутри подкаталога lib и передать эту строку на выполнение, например, так:
java –cp ../lib/bar.jar;app.jar myapp.Starter
Как может выглядеть подобный скрипт запуска я расскажу в следующий раз, а пока сформируем каталог lib с помощью maven (единственная настройка плагина – это путь к каталогу, куда будут скопированы зависимости проекта):
m2 dependency:copy-dependencies -DoutputDirectory=target/lib