Библиотека для машинного обучения Tensorflow. Как установить Tensorflow
Умные машины становятся частью нашей повседневной жизни, появляются инструменты, которые позволяют создавать несложные проекты в сфере искусственного интеллекта без особых навыков. Познакомимся поближе с темой машинного обучения и инструментом для его использования.
Что такое машинное обучение
Машинное обучение – это раздел искусственного интеллекта, который занимается разработкой компьютерных алгоритмов, способных самостоятельно обучаться и делать прогнозы на основе данных. Этот процесс основан на идее, что компьютеры могут обучаться и прогнозировать результаты без явного программирования. Вместо этого, они анализируют большие объемы данных и находят в них закономерности и шаблоны, чтобы сделать предсказания или принять решения.
Основная идея машинного обучения заключается в использовании статистических методов для автоматического выявления закономерностей и паттернов в данных. Задачей алгоритмов машинного обучения является построение модели, которая способна обобщать и делать предсказания на новых данных, основываясь на полученном знании из обучающей выборки.

Для чего используется библиотека TensorFlow
Библиотека TensorFlow — это открытое программное обеспечение для машинного обучения, разработанное командой Google Brain. Она предоставляет инструменты для создания и обучения нейронных сетей под различные задачи по обработки данных.
TensorFlow имеет широкий набор инструментов для визуализации результатов. Он легко интегрируется с другими библиотеками и инструментами, например, Keras, Scikit-learn и Pandas.
Одним из главных преимуществ TensorFlow является его возможность обучать глубокие нейронные сети. Он позволяет создавать сложные модели с использованием различных архитектур. Библиотека также предлагает множество предварительно обученных моделей, которые могут быть использованы для таких более простых задач, как классификация изображений, распознавание речи, обработка естественного языка.
Библиотека TensorFlow поддерживает известные языки программирования ( Python , C++ и JavaScript), поэтому легко интегрируется с другими инструментами и фреймворками.
История появления TensorFlow
Объявление о разработке TensorFlow было сделано в ноябре 2015 года. TensorFlow был создан как более гибкий, расширяемый и пользовательский фреймворк для разработки и обучения нейронных сетей, по сравнению с его предшественником DistBelief.
TensorFlow популярен благодаря своей открытости и широкому сообществу разработчиков. Библиотека была выпущена под лицензией Apache 2.0, что позволяет разработчикам использовать, модифицировать и распространять ее в своих проектах. Также TensorFlow быстро стал одной из самых популярных программ для работы с глубоким обучением.

Для масштабных проектов предлагаем услугу Аренда выделенного сервера. Она подойдет для надежного хранения ваших данных и поможет реализовать задачи любой степени сложности.
Как работает TensorFlow
TensorFlow позволяет создавать и обучать модели машинного обучения на основе графовых вычислений. Когда создается модель в TensorFlow, то строится граф вычислений, где каждая операция представлена узлом, а данные передаются через ребра. Разработчик определяет входные данные (тензоры) и операции (например, умножение или сложение тензоров), а затем запускает вычисления, передавая данные через граф.
TensorFlow автоматически оптимизирует и распределяет работу между доступными процессорами, GPU или TPU (специализированные чипы для обработки тензоров). Это позволяет ускорить обучение моделей и обработку данных.
Применение TensorFlow
TensorFlow упрощает создание и обучение моделей машинного обучения, обеспечивает эффективное использование вычислительных ресурсов и позволяет решать разнообразные задачи с использованием искусственного интеллекта.
Области применения TensorFlow – широкий спектр сценариев и задач машинного обучения. Рассмотрим некоторые из них:
- Классификация и распознавание изображений. Эта возможность может использоваться для разработки систем автоматического распознавания лиц, автоматизации процесса классификации изображений или создания моделей компьютерного зрения.
- Распознавание речи. Этот навык подойдет для разработки голосовых помощников, систем автоматического распознавания речи и приложений, связанных с обработкой аудиоданных.
- Обработка письменного текста. Полезна для создания моделей машинного перевода, анализа тональности текста, создания чат-ботов и различных приложений по обработки текста.
- Рекомендательные системы. С их помощью можно предсказывать предпочтения пользователей и рекомендовать им товары, услуги или контент. Что актуально для интернет-магазинов, стриминговых платформ или социальных сетей.
- Анализ данных. TensorFlow позволяет проводить анализ данных и создавать модели для выявления паттернов, трендов и зависимостей в больших объемах данных. Это может использоваться для решения задач прогнозирования, кластеризации, расследования аномалий и других задач анализа данных.

Как установить TensorFlow
Рассмотрим два способа установки библиотеки TensorFlow:
- Через Google Colab.
- Через Python.
Установка TensorFlow через Google Colab.
- Перейдите на сайт Google Colab и войдите (или зарегистрируйтесь) в свою учетную запись Google.
- Создайте новый блокнот Colab, выбрав Файл >Новый блокнот в верхнем меню.
- Установите TensorFlow. Для этого в первой ячейке блокнота Colab введите код:
!pip install tensorflow
- Запустите ячейку, нажав на кнопку с треугольником в круге, или, используя сочетание клавиш Shift+Enter. В этом случае Colab установит последнюю версию TensorFlow.

- Если установка прошла успешно, вы увидите сообщение «Tensorflow успешно установлен», а также список установленных пакетов.
- Чтобы проверить установку TensorFlow в следующей ячейке введите код:
import tensorflow as tf
- Запустите ячейку и вы увидите версию установленного TensorFlow. Если все работает правильно, он будет отображен без каких-либо ошибок.
Теперь у вас установлена последняя версия TensorFlow в Google Colab. Вы можете использовать его для создания и обучения моделей машинного обучения.
Установка TensorFlow через Python
Чтобы установить TensorFlow через Python, вы можете использовать инструмент управления пакетами PIP.
- Перед установкой TensorFlow убедитесь, что у вас установлен Python версии 3.6 или выше. Если у вас нет Python, вы можете скачать его с официального сайта Python.
- Установите TensorFlow. Используя командную строку, введите:
pip install tensorflow
- После ввода команды нажмите Enter и дождитесь завершения процесса установки. Во время установки PIP загрузит и установит последнюю версию TensorFlow и все зависимости.
- После окончания установки вы увидите сообщение «Successfully installed tensorflow», а также список установленных пакетов.
- Для проверки установки TensorFlow откройте Python интерпретатор или создайте новый скрипт Python.
- Введите следующий код, чтобы импортировать TensorFlow и вывести версию:
import tensorflow as tf
- Вы должны увидеть версию установленного TensorFlow.
Последняя версия TensorFlow установлена, вы можете использовать его для разработки и обучения моделей машинного обучения с помощью Python.
Заключение
TensorFlow позволяет исследователям и разработчикам создавать и обучать модели на разных уровнях абстракции, а также включает в себя множество встроенных функций и алгоритмов для обработки данных.
Это мощный инструмент для работы с глубоким обучением, который можно легко установить и использовать для различных задач. Он предоставляет широкий набор функций и возможностей, которые позволяют создавать и обучать сложные модели нейронных сетей.
Быстрая загрузка большого количества данных в Google Colab
Доброго времени суток, Хабр. Решил поделиться своим знанием, как можно быстро загрузить большое количество файлов в Google Colab с Google Drive.
Всем известно, что Google Colab отличная бесплатная платформа для обучения и экспериментов над Нейронными Сетями.
На платформе Google Colab Вам бесплатно предоставят мощную видеокарту на которой вы сможете поэкспериментировать с обучением своей нейросети на протяжении примерно 12 часов.
Затем сеанс прервется, но на следующий день от Google можно опять будет получить видеокарту и продолжить свои эксперименты.
Нейронным сетям требуется очень много данных для обучения, особенно если речь идет о нейросетях работающих с изображениями.
Для обучения таких нейросетей необходимо загрузить в обучающую и валидационную выборки тысячи и сотни изображений. К сожалению, если эти изображения загружать непосредственно из вашего Google Drive, это занимает неприлично долгое время — десятки минут или даже часы. Ведь каждое обращение за файлом в Google Drive и получение от него ответа с содержимым файла происходит последовательно и не быстро.
Обидно тратить время доступа к бесплатной видеокарте на загрузку данных, да и не разумно это.
А мы люди разумные, поэтому мы один раз обратимся к Google Drive считаем наши данные запакованные заранее в zip архив, распакуем полученный zip архив в память Google Colab и считаем свои данные со скоростью в сотни раз большей чем с Google Drive последовательно по одному файлу.
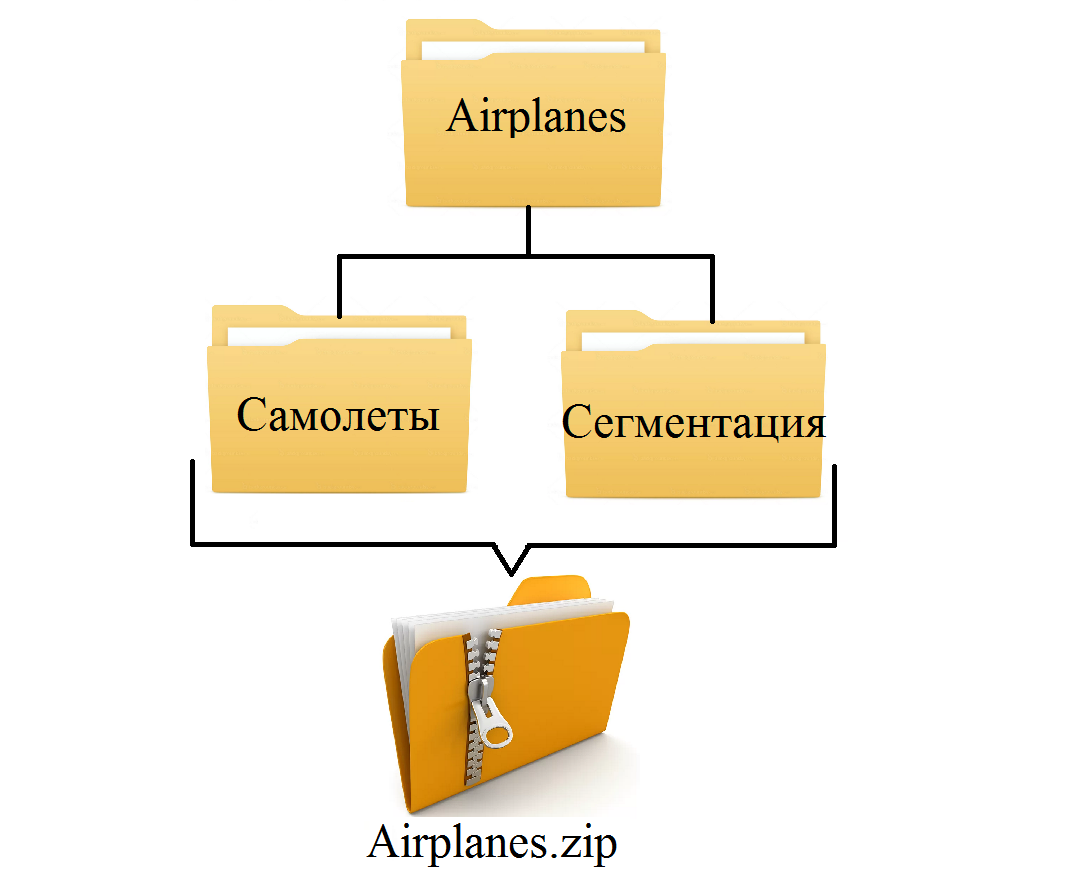
Для эксперимента со скорость загрузки данных в Colab я взял имеющуюся у меня базу «Airplanes» для сегментационной нейросети.
В этой базе есть папка с изображениями «самолеты» и папка «сегментация», где хранятся маски изображений самолетов из вышеназванной папки.
В каждой папке по 1005 изображений 1920*1080.
В общей сложности нам предстоит загрузить 2010 файлов.
Я заранее загрузил к себе на Google Drive как саму базу с изображениями, так и ее zip архив.
Структура Обучающей Базы:
Итак, приступим к скоростной загрузке данных с Google Drive:
-
Запускаем Google Colab и импортируем необходимые нам для этого библиотеки и модули
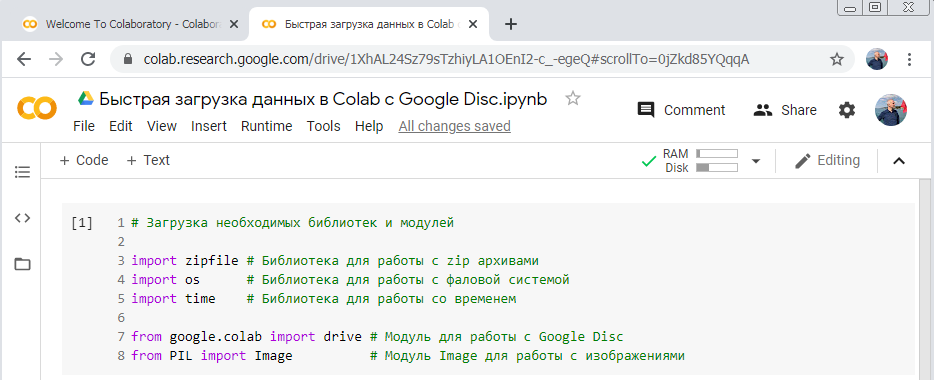
Выполняем команду на подключение к Google Drive

Переходим по ссылке для выбора свое аккаунта Google

Выбираем свой аккаунт в Google
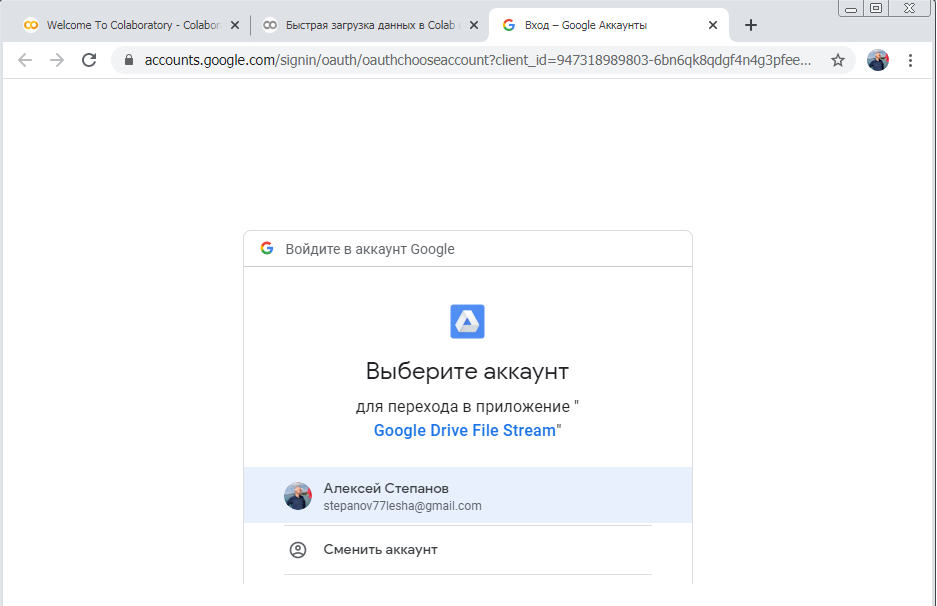
Подтверждаем доступ Colab к Google Drive
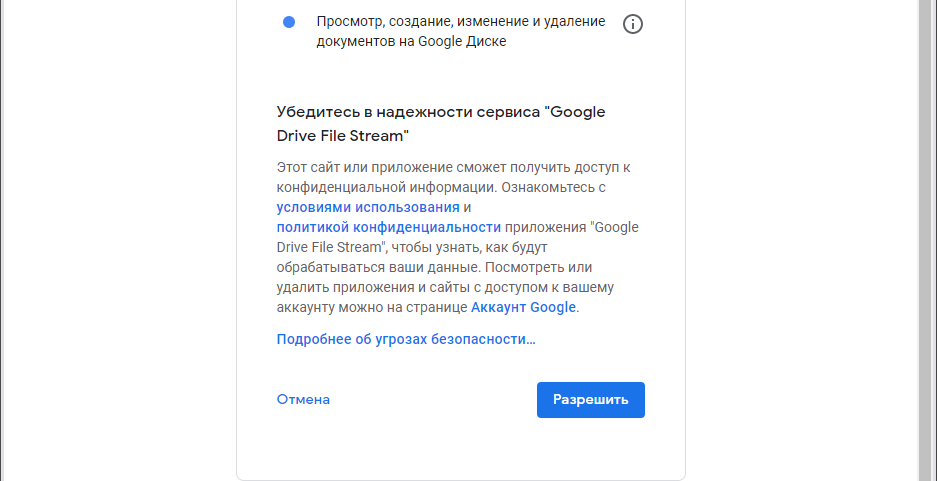
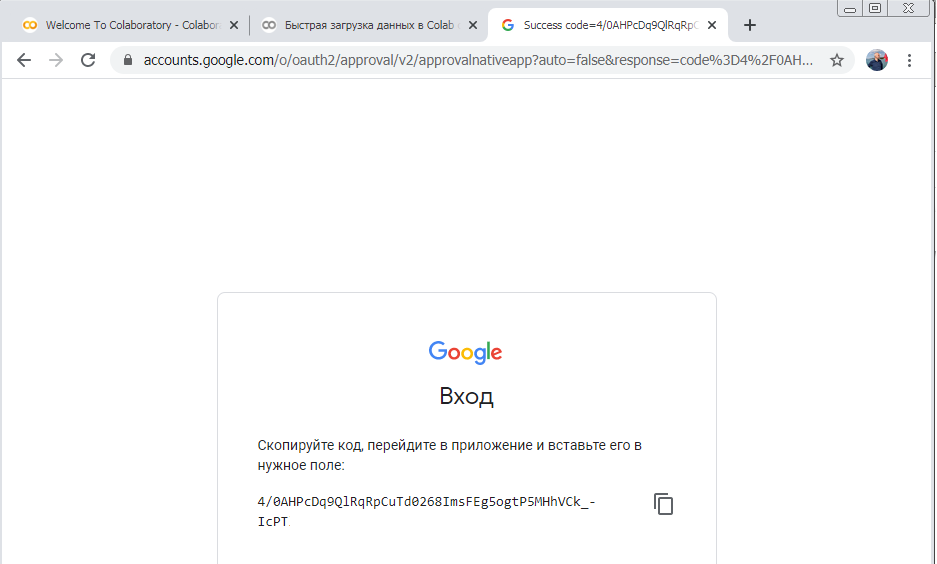
Копируем авторизационный код для доступа к Google Drive
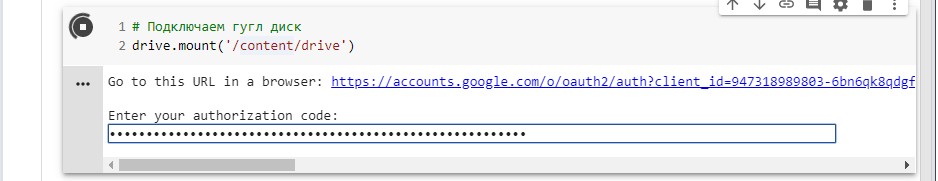
Вставляем авторизационный код в строку и получаем доступ к своему Google Drive
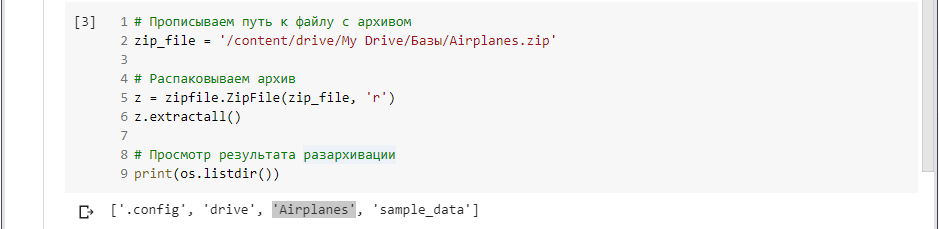
Прописываем путь к архиву с обучающей базой данных и разархивируем ее память Colab
Для тестирования скорости чтения файлов я написал функцию, которая пройдется по всем подкаталогам обучающей базы и в каждом подкаталоге прочитает все файлы которые в нем хранятся.
Тестируем скорость чтения всех файлов
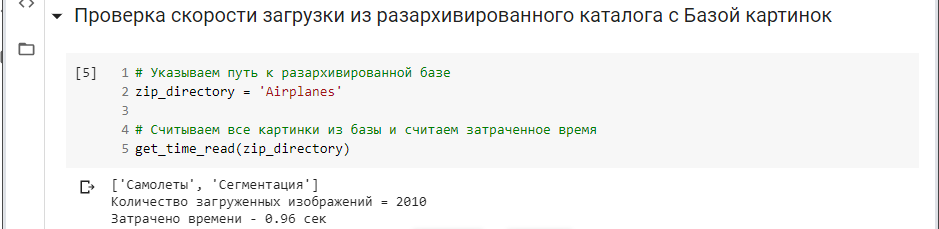
Как видно, время за которое мы загрузили 2010 файлов c размером изображения 1920*1080 составило всего 0,96 сек.
То есть, менее чем за секунду, мы загрузили весь наш объем информации.

Как мы видим для загрузки из каталога 2010 файлов хранящихся на Google Drive нам потребовалось уже 1500 секунд, а ведь это 25 минут.
Это 25 минут простоя вашего экспериментов с нейросетью.
Надеюсь, статья была для вас полезной и теперь загрузка большого количества файлов с Google Drive в Colab больше уже не проблема.
Загружайте свои обучающие данные в сотни раз быстрее чем делали до этого ранее.
Всего четыре простых шага.
- Запаковать Обучающую Базу в zip архив.
- Загрузить zip файл с Обучающей Базой к себе на Google Drive
- Распаковать zip файл с Обучающей базой в память Colab
- Прочитать все файлы памяти Colab в вашу программу
Для тех, кому нужен код, описанный в статье, добро пожаловать ко мне на GitHub.
Основы работы c SQLite
Google Colab позволяет выполнять программы, написанные на языке Python прямо в браузере без необходимости установки на компьютер дополнительного программного обеспечения.
Для использования Google Colab необходимо иметь учетную запись Google. Если вы используете смартфон на платформе Android, то такая учетная запись у вас уже есть, однако для безопасности вашей основной учетной записи рекомендуется создать новую учетную запись на время выполнения лабораторных работ.
Доступ к Google Drive для хранения базы данных
База данных может храниться локально, на том же компьютере, на котором запускается прикладное программное обеспечение для работы с базой данных или на удаленном компьютере.
Google Colab (точнее Python, запускаемый в среде Google Colab) позволяет работать и с условно «локальной» базой данных и с базой данных на удаленном сервере. В первом случае может использоваться СУБД SQLite, которая будет хранится на облачном диске Google Drive. Для среды Google Colab это будет локальная БД.
Для доступа к диску Google Drive сервису Google Colab необходимо дать разрешение на подключение к диску. К сожалению Google Colab через каждые 12 часов «забывает» полученные ранее разрешения, поэтому через каждые 12 часов необходимо заново разрешать доступ Google Colab к вашему облачному диску. Данные (файл базы данных SQLite) в Google Colab конечно сохраняются.
Для подключения и разрешения доступа Google Colab к диску Google Drive можно использовать следующий код:
from google.colab import drive drive.mount('/content/drive') Google Colab предложит перейти по предложенной ссылке для разрешения доступа к диску

После того, как вы разрешите доступ к диску Google Drive, появится окно с кодом, который нужно вставить в показанное выше поле “Enter your authorization code”:

После ввода кода и нажатия Enter появится сообщение о том, что диск подключен “Mounted at /content/drive/”.

Подключение к базе данных
Подключаем модуль для работы с базой SQLite
import sqlite3 Создаем на диске Google каталог databases. Указываем путь к будущей (или уже существующей) базе данных.

path = "./drive/My Drive/databases/mydatabase.db" Подключаемся к базе mydatabase.db. Если этого файла нет в каталоге, то он будет создан.
conn = sqlite3.connect(path) Создание таблицы
# Создаем объект типа cursor для доступа к данным cursor = conn.cursor() # Создание простейшей таблицы, все поля (столбцы) которой имеют тип text cursor.execute("CREATE TABLE albums (title text, artist text, release_date text, publisher text, media_type text)") # Подтверждаем изменения (обязательно) conn.commit() # Закрываем курсор cursor.close() # Закрываем соединение (рекомендуется) conn.close() Добавление записей в таблицу
Добавление в таблицу двух строк:
conn = sqlite3.connect(path) cursor = conn.cursor() sql = "INSERT INTO albums VALUES (?, ?, ?, ?, ?)" val1 = ("The Serpen't Egg", "Dead Can Dance", "1988", "4AD", "CD") val2 = ("Everyday Is Christmas", "SIA", "2017", "Atlantic", "CD") cursor.execute(sql, val1) cursor.execute(sql, val2) conn.commit() cursor.close() conn.close() Запрос данных из таблицы
conn = sqlite3.connect(path) cursor = conn.cursor() sql = "SELECT artist, title, release_date from albums" cursor.execute(sql) for i in cursor: print(i) cursor.close() conn.close() Для наглядного представления табличных данных можно использовать библиотеку pandas:
import pandas as pd conn = sqlite3.connect(path) cursor = conn.cursor() sql = "SELECT artist, title, release_date from albums" cursor.execute(sql) # Загружаем все результаты в список списков rows rows = cursor.fetchall() cursor.close() conn.close() Создаем объект DataFrame на основе списка rows, указывая наименования столбцов (columns=…):
pd.DataFrame( rows, columns=('Исполнитель', 'Альбом', 'Год') ) Результат будет выглядеть так:

Особенности хранения в SQLite значений дат
При работе с базой данных SQLite необходимо учитывать, что даты в таблицах SQLite хранятся в виде целого числа, которое представляет собой количество секунд прошедших с начала (по Гринвичу) первого января 1970 года – Unix-время (этот момент называют Unix-эпохой). Эту особенность представления даты и времени в SQLite следует учитывать при выводе (форматировании) и сравнении дат.
Например, следующий сценарий выводит таблицу имен покупателей с датами совершенных ими покупок до 20 января 2019 года.
select customers.customer_name, strftime("%d.%m.%Y", purchase_date, 'unixepoch') as purchase_date_string from purchases left join customers on customers.customer_id = purchases.customer_id where purchase_date < CAST(strftime('%s', '2019-01-20') AS INTEGER) order by purchase_date; customer_name |purchase_date_string| -----------------------------|--------------------| Гусев Пров Дмитриевич |06.01.2019 | Борисова Евдокcия Григорьевна|06.01.2019 | Дорофеев Митофан Демидович |10.01.2019 | В этом сценарии для преобразования из внутреннего Unix-времени в “читаемый” текстовый формат даты ГГГГ.ММ.ДД используется функция strftime, которая преобразует числовое значение даны в строку в соответствии с заданным форматом, который передается первым аргументом функции. Второй аргумент функции strftime – столбец таблицы, который содержит дату, “закодированную” целым числом. Третий аргумент – формат хранения даты ‘unixepoch’.
Для того, чтобы сравнить заданную текстовым представлением дату (в примере это ‘2019-01-20’) со значением в таблице, например, в условии WHERE, необходимо преобразовать строку в ГГГГ-ММ-ДД в строку, представляющую целое число секунд с Unix-эпохи, а затем преобразовать эту строку в целое число, которое и будет сравниваться со значениями в столбце purchase_date таблицы. Для преобразования из строки в целое число используется функция CAST(СТРОКА AS INTEGER), например результатом работы функции CAST(‘123’ AS INTEGER) будет целое число 123.
При работа с базой данных из среды Python, преобразование даты в формат Unix-времени и обратно можно выполнять в коде, используя метод объекта datetime – datetime.timestamp(), например:
import sqlite3 import datetime from tabulate import tabulate path = "./drive/My Drive/databases/goods.db" conn = sqlite3.connect(path) cursor = conn.cursor() sql = """ SELECT customers.customer_name, purchases.purchase_id, COUNT(purchase_items.product_id) FROM purchase_items LEFT JOIN purchases on purchase_items.purchase_id = purchases.purchase_id LEFT JOIN customers on customers.customer_id = purchases.customer_id WHERE purchases.purchase_date BETWEEN ? AND ? GROUP BY purchases.purchase_id ORDER BY customer_name """ cursor.execute(sql,(datetime.datetime(2019,8,1).timestamp(), datetime.datetime(2020,1,1).timestamp() )) rows = cursor.fetchall() print(tabulate(rows)) cursor.close() conn.close() © 2023. All rights reserved.
Colaboratory. Работаем с локальной файловой системой Вашего компьютера и Google диском
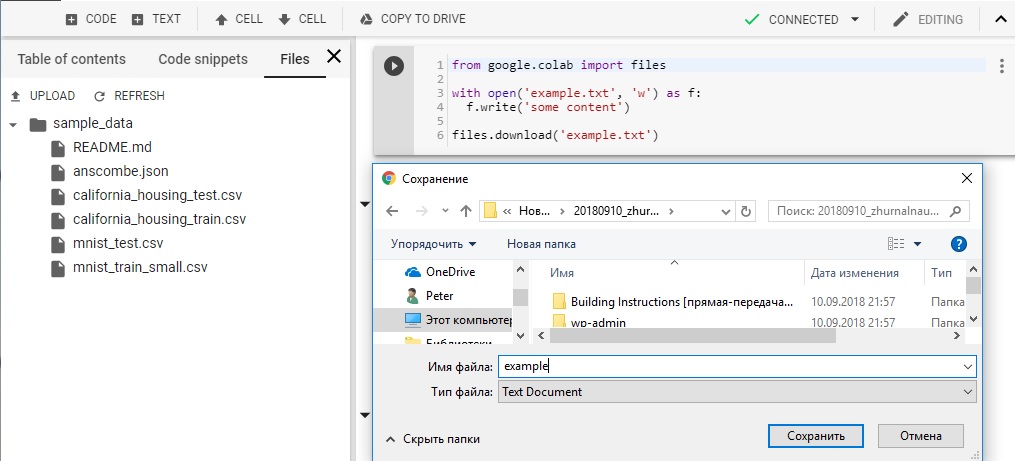
# wget — закачка с сети Internet на Google диск в папку /content/gdrive/My\ Drive ( My\ Drive — пробел в имени файла в системе Linux экранируется обратным слэшем ) файла с входными данными нейронной сети (в нашем случае: dogscats.zip — множество портретов кошек и собак для обучения и тестирования нейронной сети):
! wget -P /content/gdrive/My\ Drive http://files.fast.ai/data/dogscats.zip
!unzip /content/gdrive/My\ Drive/dogscats.zip -d /content/gdrive/My\ Drive/
!git clone https://github.com/fastai/fastai.git /content/gdrive/My\ Drive/fastai
PATH = «/content/gdrive/My Drive/dogscats/»
os.listdir(PATH)