Простой браузер на Python без всякого мусора?
Нужен простой браузер на питоне. Можете ли поскидывать примеры или хотя бы сказать на чем его можно сделать?
- Вопрос задан более трёх лет назад
- 8177 просмотров
Комментировать
Решения вопроса 1

Легче всего будет использовать фреймворк PySide2, компоненты QWebEnginePage, QWebEngineView.
Вот небольшой пример браузера.
Ответ написан более трёх лет назад
Комментировать
Нравится 1 Комментировать
Как на питоне сделать веб браузер
«Блог студента Бизнес-информатики»
Современная Веб-Автоматизация с Помощью Python и Selenium
В данной статье вы изучите продвинутую технику веб-автоматизации в Python. Мы используем Selenium с браузером без графического интерфейса, экспортируем отобранные данные в CSV файлы и перенесем ваш отобранный код в класс Python.
Original
Оглавление
- Мотивация: отслеживаем музыкальные привычки
- Установка и Настройка Selenium
- Пробный запуск браузера в режиме Headless
- Получаем удовольствие от мелодии
- Исследуем каталог
- Создание класса
- Собираем структурированные данные
- Что дальше и чему мы научились?
1. Мотивация: отслеживаем музыкальные привычки
Предположим, что вы время от времени слушаете музыку на bandcamp.com или soundcloud и вам хочется вспомнить название песни, которую вы услышали несколько месяцев назад.
Конечно, вы можете покопаться в истории вашего браузера и проверить каждую песню, но это весьма болезненная затея… Все, что вы помните, это то, что вы услышали песню несколько месяцев назад и она в жанре электроника.
«Было бы классно», думаете вы «Если бы у меня запись моей истории прослушиваний. Я мог бы просто взглянуть на электронную музыку, которую я слушал пару месяцев назад и найти эту песню!»
Сегодня мы создадим простой класс Python под названием BandLeader, который подключается к bandcamp.com, стримит музыку из раздела «Найденное» на главной странице, и отслеживает вашу историю прослушиваний.
История прослушиваний будет сохранена на диске в CSV файле. Далее, вы можете в любой момент просматривать CSV файл в вашей любимой программе для работы с таблицами, или даже в Python.
Если у вас есть опыт в веб-парсинга в Python, то вы знакомы с созданием HTTP запросами и использованием API Python для навигации в DOM. Сегодня мы затронем все эти пункты, за одним исключением.
Сегодня вы используете браузер в режиме без графического интерфейса (режим «командной строки») для выполнения запросов HTTP.
Консольный браузер – это обычный веб браузер, который работает без видимого пользовательского интерфейса. Как вы могли догадаться, он может делать больше, чем выполнять запросы: проводить рендер HTML (правда, вы этого не будете видеть), хранить информацию о сессии, даже проводить асинхронные сетевые связи на коде JavaScript.
Если вы хотите автоматизировать современную сеть, консольные браузеры – неотъемлемая часть.
Бесплатный бонус: Скачайте основу проекта Python+Selenium с полным исходным кодом, который вы можете использовать как основу для вашего веб-парсинга в Python и автоматических приложениях.
2. Установка и Настройка Selenium
Первый шаг, перед тем как написать первую строчку кода – это установка Selenium с поддержкой WebDriver для вашего любимого браузера. Далее в статье мы будем работать с Firefox Selenium, но Chrome также будет отлично.
- Установка драйвера geckodriver для Firefox Selenium
- Установка драйвера chromedriver для Chrome Selenium
По выше указанным ссылкам имеется полное описание процесса установки драйверов для Selenium.
Возможно, что путь ~/.local/bin находится в вашем исполнении PATH , вот как вы должны установить Firefox WebDriver, называемый geckodriver , на ОС Linux:
$ wget https://github.com/mozilla/geckodriver/releases/download/v0.19.1/geckodriver-v0.19.1-linux64.tar.gz $ tar xvfz geckodriver-v0.19.1-linux64.tar.gz $ mv geckodriver ~/.local/bin
Далее, нужно установить Selenium при помощи pip, или как вам удобнее. Если вы создали виртуальное пространство для этого проекта, просто введите:
$sudo pip install selenium
Время для пробного запуска.
3. Пробный запуск браузера
Чтобы убедиться, что все работает, попробуйте выполнить простой поиск в интернете через DuckDuckGo. Используйте свой предпочитаемый интерпретатор Python и введите:
>>>from selenium.webdriver import Firefox >>>from selenium.webdriver.firefox.options import Options >>>opts = Options() >>>opts.set_headless() >>>assert opts.headless # без графического интерфейса. >>>browser = Firefox(options=opts) >>>browser.get('https://duckduckgo.com')
Итак, вы только что создали Firefox без графического интерфейса, направленный на https://duckduckgo.com. Вы создали экземпляр «Options» и применили его для активации мода headless в конструкторе Firefox. Это похоже на введение команды firefox – headless в командной строке.
Теперь, когда страница загружена, вы можете запросить DOM при помощи методов, определенных в вашем созданном объекте браузера.
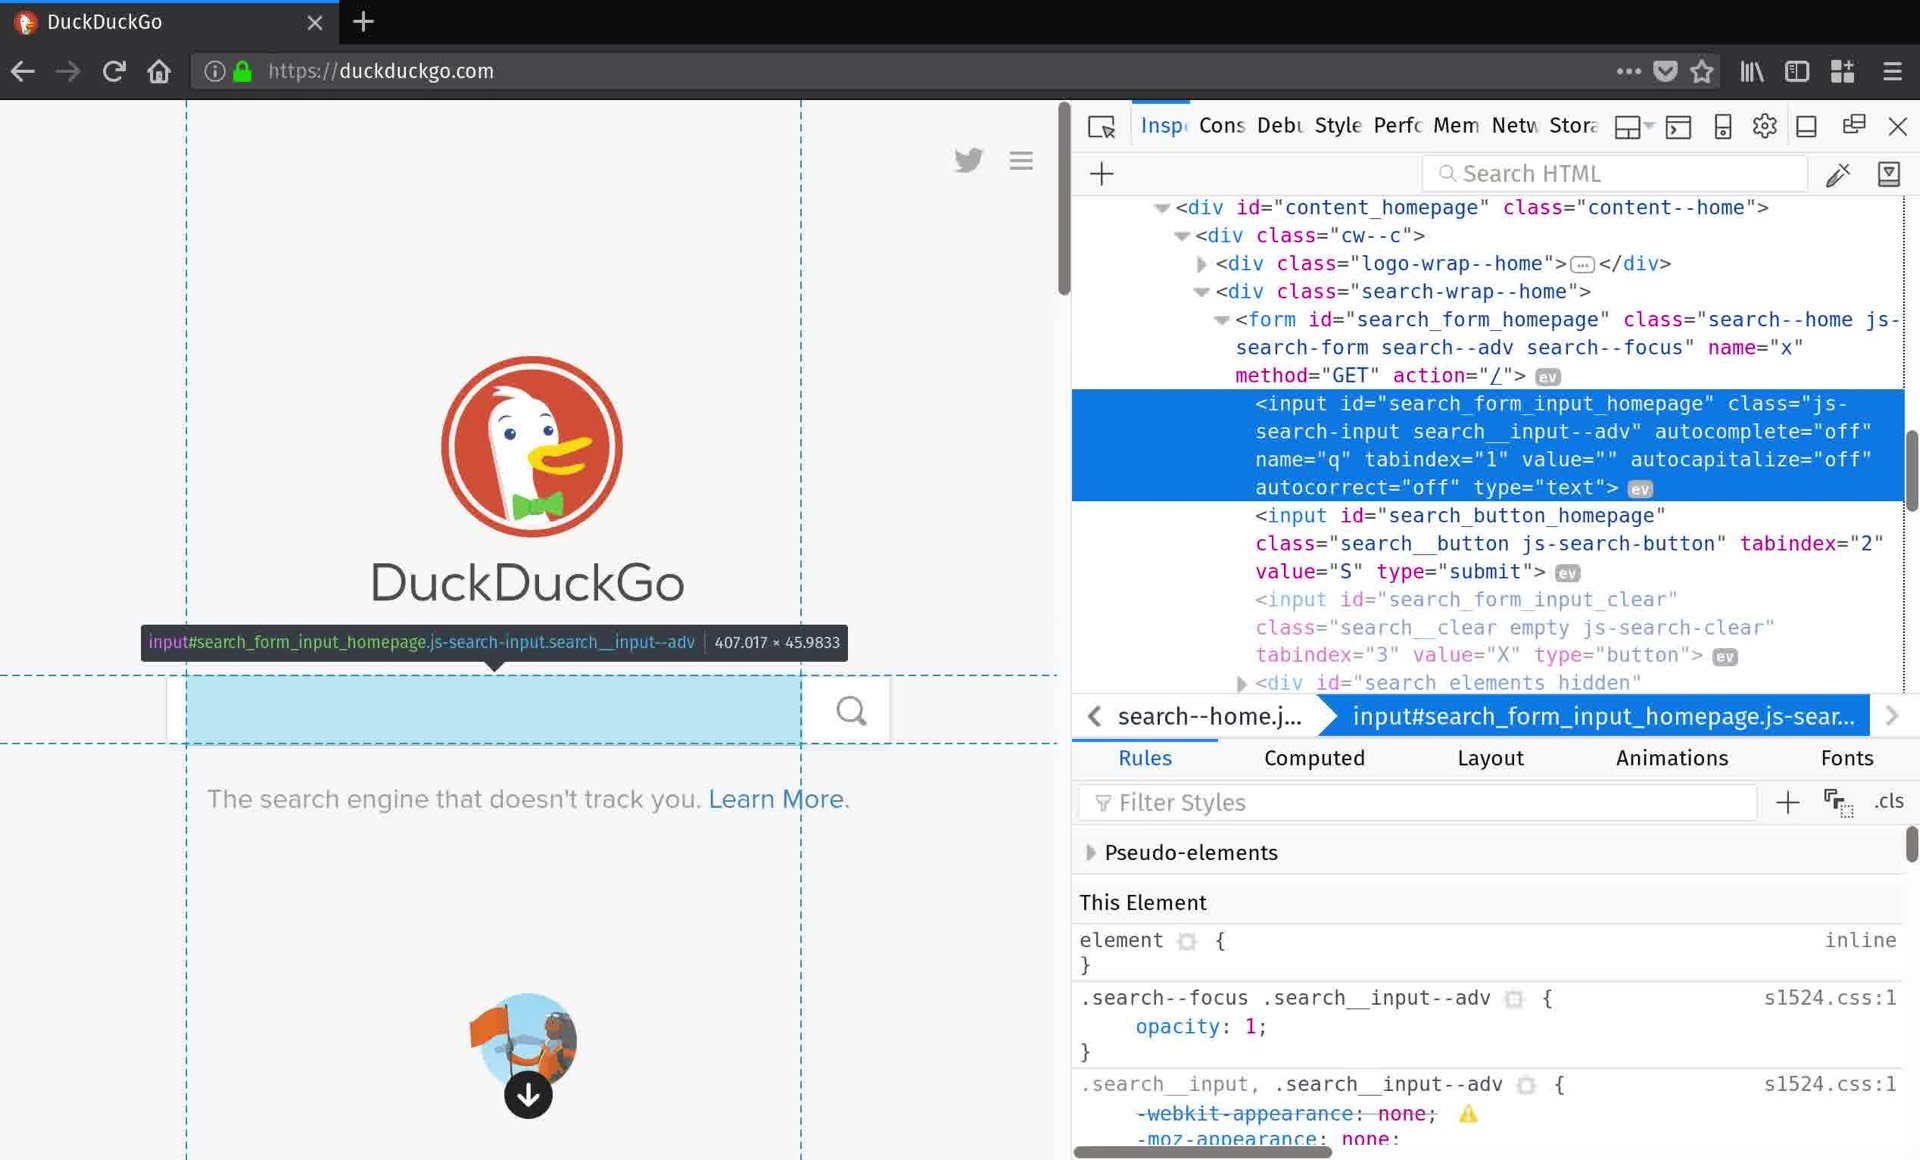
Но откуда мы знаем, что запрашивать? Лучший способ – это открыть ваш веб браузер и использовать его инструменты разработки для исследования содержимого страницы. Сейчас вы можете получить форму поиска для отправки запроса, чтобы выполнить запрос. Проверив главную страницу DuckDuckGo, вы увидите, что элемент поисковой формы имеет атрибут ID «search_form_input_homepage«. Вот, что вам нужно:
>>>search_form = browser.find_element_by_id('search_form_input_homepage') >>>search_form.send_keys('real python') >>>search_form.submit()
Вы нашли поисковую форму, используя метод send_keys для заполнения, затем метод submit для выполнения поиска для «Real Python». Вы можете проверить результат:
>>> results = browser.find_elements_by_class_name('result') >>> print(results[0].text) Real Python - Real Python Get Real Python and get your hands dirty quickly so you spend more time making real applications. Real Python teaches Python and web development from the ground up . https://realpython.com
Похоже, все работает. Чтобы избежать появления невидимых экземпляров браузера, нужно закрыть объект браузера перед окончанием сессии в Python:
>>> browser.close() >>> quit()
4. Получаем удовольствие на мелодию
Вы удостоверились в том, что можете управлять браузером в режиме headless (без головы т.е. без графического интерфейса), используя Python, теперь перейдем к практике.
- Вам нужно включать музыку;
- Вам нужно искать и просматривать музыку;
- Вам нужна информация о проигрываемой музыке.
Для начала, отправимся на https://bandcamp.com и покопаемся в инструментах разработки вашего браузера. Вы увидите большую и яркую кнопку воспроизведения внизу экрана с HTML атрибутом class, который содержит значение «playbutton«. Проверим, как это работает:
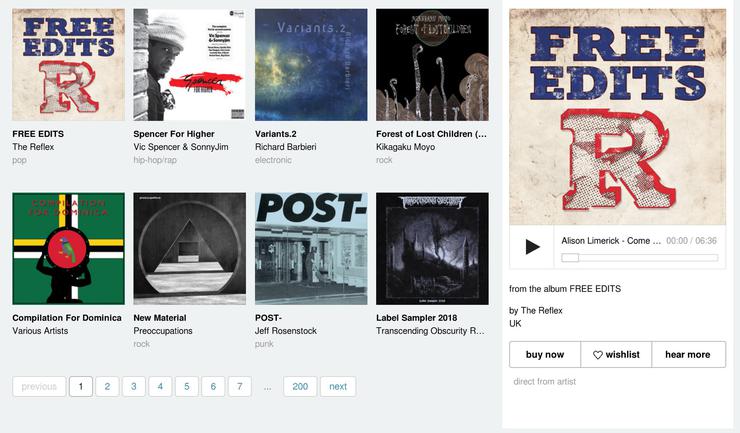
>>> opts = Option() >>> opts.set_headless() >>> browser = Firefox(options=opts) >>> browser.get('https://bandcamp.com') >>> browser.find_element_by_class('playbutton').click()Вы должны слышать музыку! Запустите трек и оставьте его, вернитесь обратно в веб браузер. Рядом с кнопкой воспроизведения находится окно поиска. Еще раз, нужно проверить эту секцию. Вы найдете, что каждый видимый и доступный трек имеет значение класса «discover-item«, а каждый объект кликабельный. В Python, проверка выполняется следующим образом:
>>> tracks = browser.find_elements_by_class_name('discover-item') >>> len(tracks) # 8 >>> tracks[3].click()Следующий трек должен воспроизвестись. Это первый шаг в исследовании bandcamp при помощи Python! Вы тратите несколько минут, переключая разные треки в пространстве Python, но скудная библиотека из восьми песен может быстро надоесть.
5. Изучаем каталог
Вернувшись в свой браузер, вы увидите кнопку для изучения всех треков, связанных с окном поиска bandcamp. Сейчас все должно выглядеть знакомым: каждая кнопка имеет значение класса»item-page«. Последняя кнопка — “далее” показывает следующие восемь композиций в каталоге. Нужно выполнить следующее:
>>> next_button = [e for e in browser.find_elements_by_class_name('item-page') if e.text.lower().find('next') > -1] >>> next_button.click()
Отлично! Теперь, может вам захочется просмотреть новые треки, и вы подумаете «Я просто перепишу переменные моих треков, так же, как я делал это минуту назад». Но здесь мы с вами столкнемся с хитростями.
Во первых, bandcamp разработали свой сайт так, чтобы пользователям было удобно им пользоваться, а не для скриптов Python для доступа к программному обеспечению. Вызывая next_button.click(), реальный веб браузер отвечает, выполняя какой-нибудь код JavaScript. Если вы попробуете сделать это в своем браузере, то увидите, что некоторое время уходит на эффект анимации каталога песен при прокрутке. Если вы попробуете переписать переменные композиций перед окончанием анимации, то можете получить не все треки, или получить те, которые вам не нужны.
Решение? Вы можете просто заснуть на секунду, или, если вы проделываете работу в оболочке Python, вы, вероятно, даже не заметите этого – в конце концов, на набор данных также уходит время.
Еще один небольшой момент, который можно обнаружить только путем проб и ошибок. Попробуйте запустить такой же код еще раз:
>>> tracks = browser.find_elements_by_class_name('discover-item') >>> assert(len(tracks) == 8)
Вы обнаружите кое-что странное. len(tracks)не равен 8, даже если пачка состоит из восьми треков. Углубившись, вы обнаружите, что ваш список состоит из треков, которые были показаны ранее. Чтобы получить треки, которые будут видны в браузере, нужно сделать небольшую фильтрацию результатов.
Попробовав несколько вариантов, вы решите оставить трек, только если его координата х на странице попадают в определенные рамки содержимого элемента. Контейнер каталога имеет значение класса «discover-results«. Выполним следующее:
>>> discover_section = self.browser.find_element_by_class_name('discover-results') >>> left_x = discover_section.location['x'] >>> right_x = left_x + discover_section.size['width'] >>> discover_items = browser.find_element_by_class_name('discover_items') >>> tracks = [t for t in discover_items if t.location['x'] >= left_x and t.location['x'] < right_x] >>> assert len(tracks) == 8
6. Создание класса
Если вас утомляет переписывать одни и те же команды снова и снова в пространстве Python, вам нужно выгрузить часть из них в модуль. Простейший класс для вашей работы с bandcamp должен выполнять следующие задачи:
- Инициализация headless браузера и выполнить направление на bandcamp;
- Хранение списка доступных треков;
- Поддержка поиска треков;
- Воспроизведение, пауза, переключение треков;
Четыре в одном. Вот простой код:
from selenium.webdriver import Firefox from selenium.webdriver.firefox.options import Options from time import sleep, ctime from collections import namedtuple from threading import Thread from os.path import isfile import csv BANDCAMP_FRONTPAGE='https://bandcamp.com/' class BandLeader(): def __init__(self): # Инициализация браузера. opts = Options() opts.set_headless() self.browser = Firefox(options=opts) self.browser.get(BANDCAMP_FRONTPAGE) # Список треков. self._current_track_number = 1 self.track_list = [] self.tracks() def tracks(self): ''' Запрос страницы для получения списка доступных треков ''' # Режим сна, пока браузер обрабатывает и выполняет все анимации sleep(1) # Получаем хранилище для списка видимых треков. discover_section = self.browser.find_element_by_class_name('discover-results') left_x = discover_section.location['x'] right_x = left_x + discover_section.size['width'] # Фильтруем объекты в списке, чтобы получить только те, которые мы можем включать. discover_items = self.browser.find_elements_by_class_name('discover-item') self.track_list = [t for t in discover_items if t.location['x'] >= left_x and t.location['x'] < right_x] # Вывод доступных треков на экран. for (i,track) in enumerate(self.track_list): print('[<>]'.format(i+1)) lines = track.text.split('\n') print('Album : <>'.format(lines[0])) print('Artist : <>'.format(lines[1])) if len(lines) > 2: print('Genre : <>'.format(lines[2])) def catalogue_pages(self): ''' Вывод доступных в настоящее время страниц в каталоге. ''' print('PAGES') for e in self.browser.find_elements_by_class_name('item-page'): print(e.text) print('') def more_tracks(self,page='next'): ''' Продвижение каталога, обновление списка композиций, мы можем передать число для продвижения любых доступных страниц. ''' next_btn = [e for e in self.browser.find_elements_by_class_name('item-page') if e.text.lower().strip() == str(page)] if next_btn: next_btn[0].click() self.tracks() def play(self,track=None): ''' Запускаем трек. Если не указан номер трека, запустится выбранная только что композиция ''' if track is None: self.browser.find_element_by_class_name('playbutton').click() elif type(track) is int and track = 1: self._current_track_number = track self.track_list[self._current_track_number - 1].click() def play_next(self): ''' Воспроизводится следующий доступный трек ''' if self._current_track_number < len(self.track_list): self.play(self._current_track_number+1) else: self.more_tracks() self.play(1) def pause(self): ''' Пауза воспроизведения. ''' self.play()
Довольно аккуратно. Вы можете импортировать этот код в ваше пространство Python и запустить bandcamp! Но постойте, разве мы не затеяли это все потому, что нам нужно собирать информацию о вашей истории прослушиваний?
7. Собираем структурированные данные
Наша последняя с вами задача, это отслеживать прослушанные вами треки. Как нам это сделать? Что буквально означает слушать что-либо? Если вы пролистываете каталог, переключая треки спустя пару секунд, это считается за прослушивание песни? Скорее всего, нет. Нам нужно включить фактор длительности прослушивания в сбор данных.
Сейчас нам нужно:
- Собрать структурированную информацию о воспроизводимых композициях;
- Хранить базу данных треков;
- Сохранить и восстановить эту базу данных на диск и из диска.
Используем namedtuple для сортировки отслеживаемой вами информации. Кортежи с названиями хороши для показа связки атрибутов без привязки к ним. Это немного похоже на запись базы данных.
TrackRec = namedtuple('TrackRec', [ 'title', 'artist', 'artist_url', 'album', 'album_url', 'timestamp' # When you played it ])
Чтобы собрать эту информацию, добавьте метод в класс BandLeader. Проверка при помощи инструментов разработки браузера откроет необходимые элементы HTML и атрибуты для выбора всей необходимой информации. Кстати, вам понадобится только информация о недавно прослушанных треках, если в это время музыка воспроизводилась. К счастью, страница плеера добавляет класс «playing» к кнопке воспроизведения, когда музыка играет, и убирает его, когда воспроизведение прекращается. Держа в голове данные нюансы, нужно прописать несколько методов:
def is_playing(self): ''' Выдает True, если трек воспроизводится в данный момент. ''' playbtn = self.browser.find_element_by_class_name('playbutton') return playbtn.get_attribute('class').find('playing') > -1 def currently_playing(self): ''' Возвращает запись воспроизводимого в данный момент трека или None, если ничего не воспроизводится. ''' try: if self.is_playing(): title = self.browser.find_element_by_class_name('title').text album_detail = self.browser.find_element_by_css_selector('.detail-album > a') album_title = album_detail.text album_url = album_detail.get_attribute('href').split('?')[0] artist_detail = self.browser.find_element_by_css_selector('.detail-artist > a') artist = artist_detail.text artist_url = artist_detail.get_attribute('href').split('?')[0] return TrackRec(title, artist, artist_url, album_title, album_url, ctime()) except Exception as e: print('there was an error: <>'.format(e)) return None
Для точного измерения, можно также модифицировать метод play для продолжения отслеживания играющего в данный момент трека:
def play(self, track=None): ''' Запуск трека. Если номер композиции не поддерживается, воспроизведется предыдущий трек. ''' if track is None: self.browser.find_element_by_class_name('playbutton').click() elif type(track) is int and track = 1: self._current_track_number = track self.track_list[self._current_track_number - 1].click() sleep(0.5) if self.is_playing(): self._current_track_record = self.currently_playing()
Далее, нам нужно создать какую-либо базу данных. Хотя она может плохо масштабироваться при больших объемах, в простом списке все должно пройти хорошо.
self.database = []
В методе инициализации класса BandCamp __init__ . Так как нам нужно дать возможность тому, чтобы прошло определенное время перед входом в объект TrackRec в базе данных, мы используем инструменты threading нашего Python, для запуска отдельных процессов, которые поддерживают базу данных в фоновом режиме.
Мы привяжем метод _maintain() к экземплярам BandLeader, которые запустят раздельный поток. Новый метод будет периодически проверять значение self._current_track_record и добавлять его в базу данных, если это новый трек.
Мы запустим поток, когда класс станет подтвержденным, путем добавления кода в __init__.
# Новый init. def __init__(self): # Инициализация браузера. opts = Options() opts.set_headless() self.browser = Firefox(options=opts) self.browser.get(BANDCAMP_FRONTPAGE) # Состояние списка треков. self._current_track_number = 1 self.track_list = [] self.tracks() # Состояние базы данных. self.database = [] self._current_track_record = None # Поток поддержки базы данных. self.thread = Thread(target=self._maintain) self.thread.daemon = True # Закрывает поток вместе с основным процессом. self.thread.start() self.tracks() def _maintain(self): while True: self._update_db() sleep(20) # Проверка каждые 20 секунд. def _update_db(self): try: check = (self._current_track_record is not None and (len(self.database) == 0 or self.database[-1] != self._current_track_record) and self.is_playing()) if check: self.database.append(self._current_track_record) except Exception as e: print('error while updating the db: <>'.format(e)
Если вы никогда не работали с мультипоточным программированием в Python, вы должны с этим ознакомиться! Для нашей нынешней цели, вы можете представить потоки как цикл, который возвращает фоновый режим основного процесса Python (тот, с которым вы напрямую взаимодействуете). Каждые двадцать секунд цикл выполняет небольшую проверку, чтобы увидеть, нужно ли обновить базу данных. Если нужно, он добавляет новую запись. Вполне себе круто.
Самым последним будет сохранение базы данных и восстановление из сохраненных состояний. Используя модуль csv, вы гарантированно будете хранить свою базу данных в очень портативном формате, кроме этого, базу данных можно будет использовать, даже если вы покинете ваш чудесный класс BandLeader
Метод __init__ снова нужно изменить, на этот раз, для принятия пути файла, в котором вы хотите сохранить базу данных. Вам может понадобиться загрузить эту базу данных, если она доступна, и периодически её сохранять, когда она будет обновлена. Обновления выглядят следующим образом:
def __init__(self,csvpath=None): self.database_path=csvpath self.database = [] # Загрузка базы данных из диска, если возможно. if isfile(self.database_path): with open(self.database_path, newline='') as dbfile: dbreader = csv.reader(dbfile) next(dbreader) self.database = [TrackRec._make(rec) for rec in dbreader] # . остальная часть метода __init__ остается неизменной . # Новый метод save_db. def save_db(self): with open(self.database_path,'w',newline='') as dbfile: dbwriter = csv.writer(dbfile) dbwriter.writerow(list(TrackRec._fields)) for entry in self.database: dbwriter.writerow(list(entry)) # Наконец, добавляем вызов save_db в метод поддержи вашей базы данных. def _update_db(self): try: check = (self._current_track_record is not None and self._current_track_record is not None and (len(self.database) == 0 or self.database[-1] != self._current_track_record) and self.is_playing()) if check: self.database.append(self._current_track_record) self.save_db() except Exception as e: print('error while updating the db: <>'.format(e)
Вуаля! Вы можете слушать музыку и хранить запись прослушанных треков. Великолепно.
Кое-что интересное показанном выше коде: использование namedtuple действительно начинает окупаться. При конвертации из формата CSV , вы получаете возможность упорядочивать строки в файле CSV для заполнения строк в объектах TrackRec. Также вы можете создать заглавную строку файла CSV, ссылаясь на атрибут TrackRec._fields. Это одна из причин, по которой использование кортежа имеет смысл во время работы со столбчатыми данными.
8. Что дальше и чему мы научились?
С этого момента вы умеете делать намного больше! Вот несколько идей, навскидку, которые можно реализовать при помощи суперсилы связки Python + Selenium:
- Вы можете расширить класс BandLeader для навигации по страницам альбомов и воспроизводить найденные в них треки;
- Вы можете создать плейлист на основании своих любимых и наиболее часто прослушиваемых композиций;
- Возможно, вы захотите добавить функцию автоматического воспроизведения;
- Может быть, вам захочется запросить песни по дате, названию или артисту и составить таким образом плейлист.
Здесь вы можете скачать основу проекта «Python + Selenium» со всеми исходными кодами, которые вы можете использовать как фундамент для веб-парсинга и автоматизации приложений.
Вы узнали, что Python может делать то же самое, что и веб-браузер, и даже больше. Вы можете легко прописывать скрипты для контроля экземпляров виртуального браузера, работающего в облаке, создавать ботов, которые могут взаимодействовать с реальными пользователями, или просто заполняют формы! Развивайтесь и автоматизируйте!
Записи
- Конспект лекции "Разработка ТЗ на сайт компании"
- Конспект лекции "Укрепление доверия россиян к искусственному интеллекту и развитие отечественной отрасли ИИ"
- Вкладки
- Аккардион
- 78-101
Пишем свой веб-сервер на Python: сокеты
Подпишись на обновления блогa, чтобы не пропустить следующий пост!
Оглавление
- Что определяет хорошего разработчика ПО?
- Что же такое веб-сервер?
- Как общаться с клиентами по сети
- Простейший TCP сервер
- Простейший TCP клиент
- Заключение
- Cсылки по теме
Лирическое отступление: что определяет хорошего разработчика?
Разработка ПО - это инженерная дисциплина. Если вы хотите стать действительно профессиональным разработчиком, то необходимо в себе развивать качества инженера, а именно: системный подход к решению задач и аналитический склад ума. Для вас должно перестать существовать слово магия. Вы должны точно знать как и почему работают системы, с которыми вы взаимодействуете (между прочим, полезное качество, которое находит применение и за пределами IT).
К сожалениею (или к счастью, ибо благоприятно складывается на уровне доходов тех, кто осознал), существует огромное множество людей, которые пишут код без должного понимания важности этих принципов. Да, такие горе-программисты могут создавать работающие до поры до времени системы, собирая их из найденных в Интернете кусочков кода, даже не удосужившись прочитать, как они реализованы. Но как только возникает первая нестандартная проблема, решение которой не удается найти на StackOverflow, вышеупомянутые персонажи превращаются в беспомощных жертв кажущейся простоты современной разработки ПО.
Для того, чтобы не оказаться одним из таких бедолаг, необходимо постоянно инвестировать свое время в получение фундаментальных знаний из области Computer Science. В частности, для прикладных разработчиков в большинстве случаев таким фундаментом является операционная система, в которой выполняются созданные ими программы.
Веб-фреймворки и контейнеры приложений рождаются и умирают, а инструменты, которыми они пользуются, и принципы, на которых они основаны, остаются неизменными уже десятки лет. Это означает, что вложение времени в изучение базовых понятий и принципов намного выгоднее в долгосрочной перспективе. Сегодня мы рассмотрим одну из основных для веб-разработчика концепций - сокеты. А в качестве прикладного аспекта, мы разберемся, что же такое на самом деле веб-сервер и начнем писать свой.
Что такое веб-сервер?
Начнем с того, что четко ответим на вопрос, что же такое веб-сервер?
В первую очередь - это сервер. А сервер - это процесс (да, это не железка), обслуживающий клиентов. Сервер - фактически обычная программа, запущенная в операционной системе. Веб-сервер, как и большинство программ, получает данные на вход, преобразовывает их в соответствии с бизнес-требованиями и осуществляет вывод данных. Данные на вход и выход передаются по сети с использованием протокола HTTP. Входные данные - это запросы клиентов (в основном веб-браузеров и мобильных приложений). Выходные данные - это зачастую HTML-код подготовленных веб-страниц.
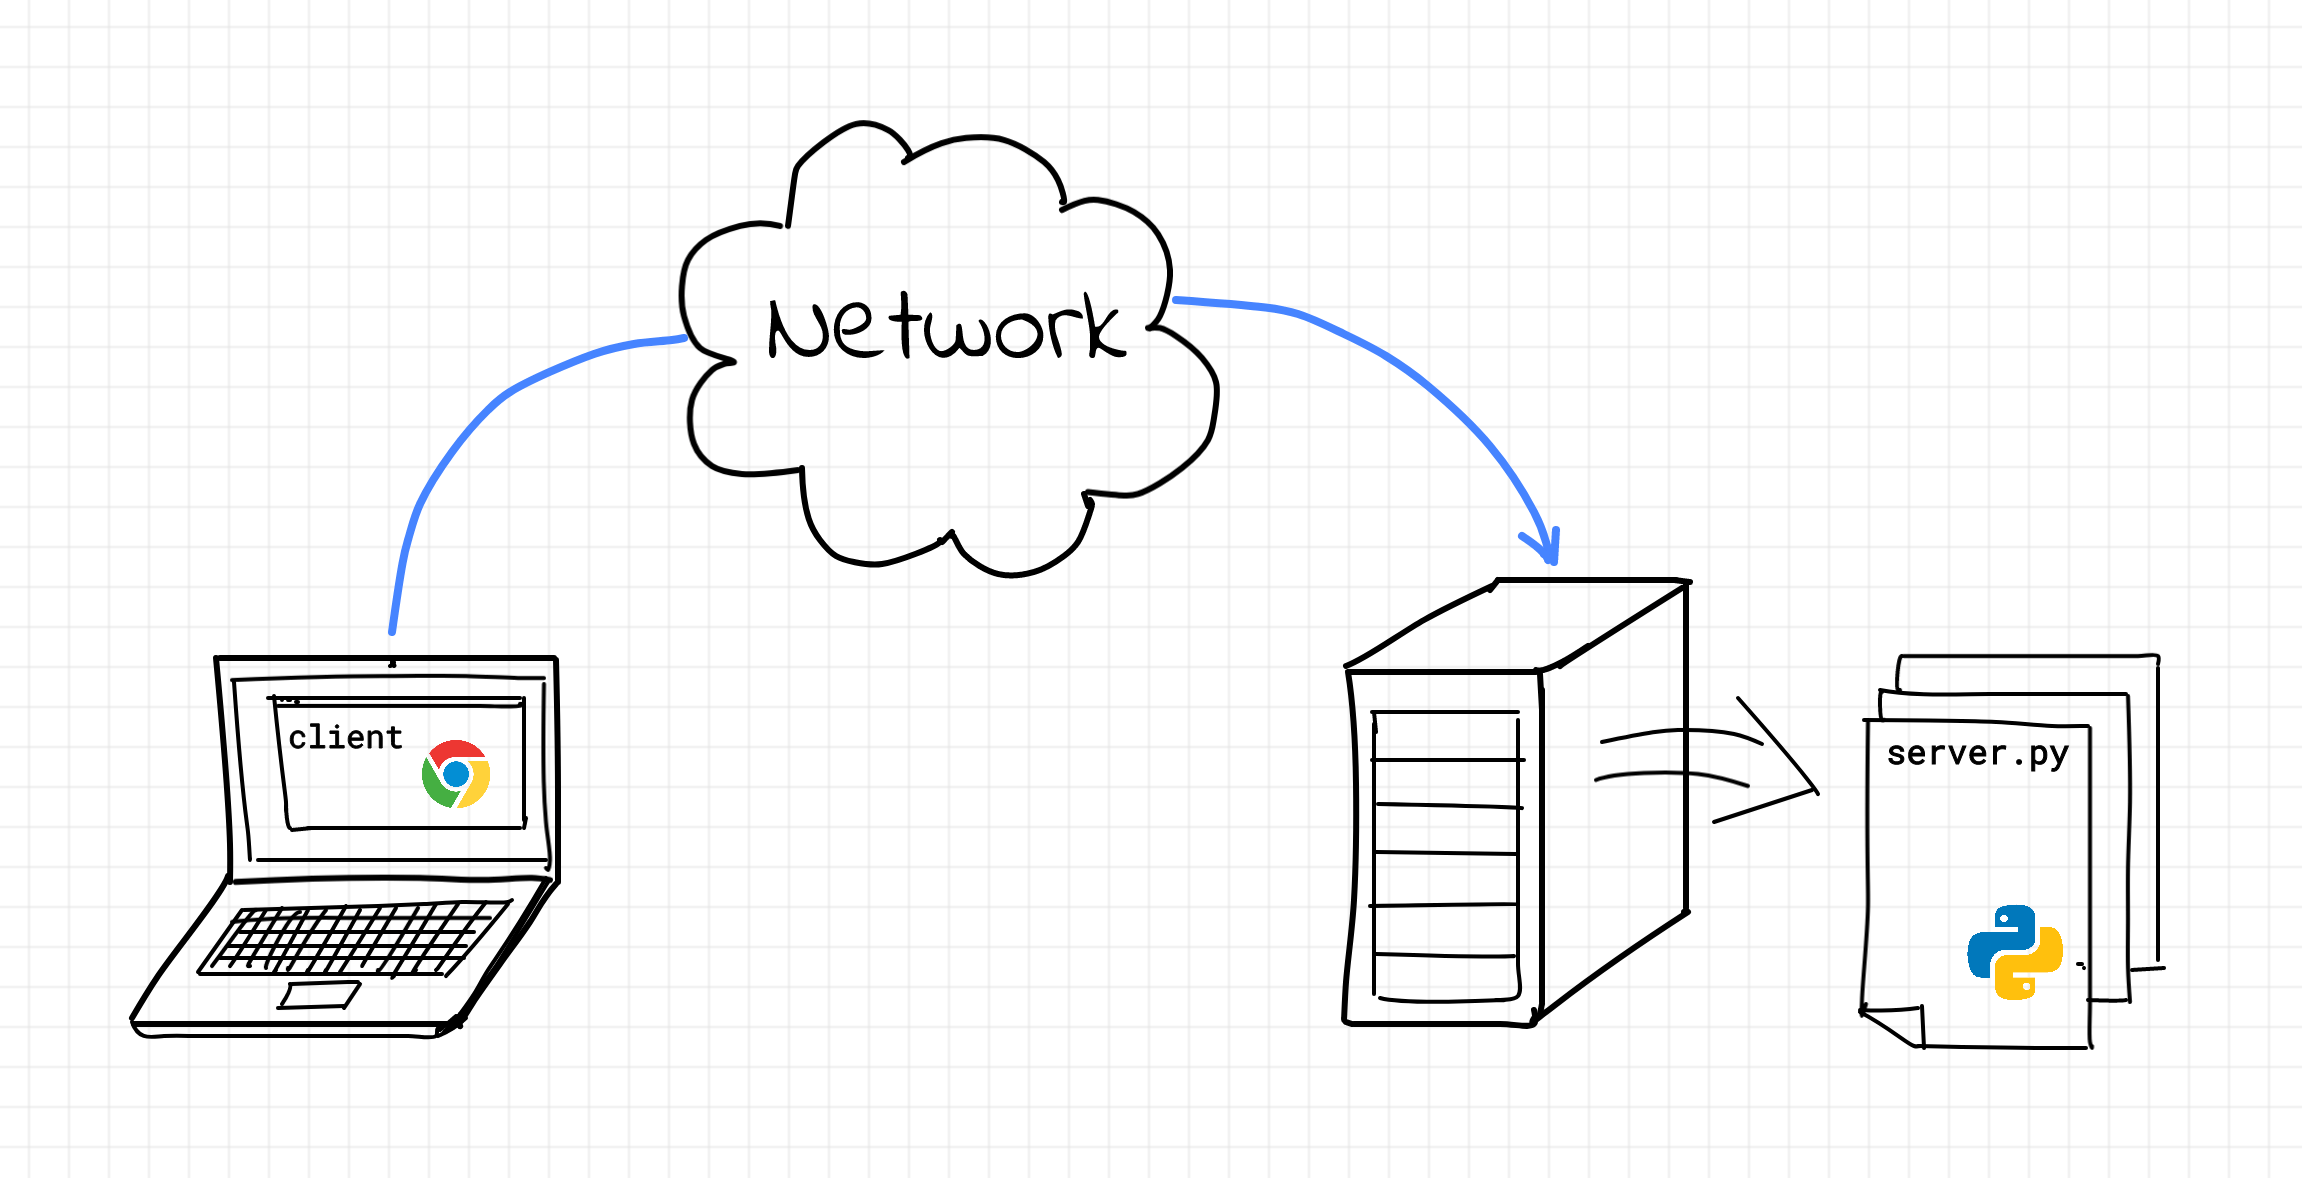
На данном этапе логичными будут следующие вопросы: что такое HTTP и как передавать данные по сети? HTTP - это простой текстовый (т.е. данные могут быть прочитаны человеком) протокол передачи информации в сети Интернет. Протокол - это не страшное слово, а всего лишь набор соглашений между двумя и более сторонами о правилах и формате передачи данных. Его рассмотрение мы вынесем в отдельную тему, а далее попробуем понять, как можно осуществлять передачу данных по сети.
Как компьютеры взаимодействуют по сети
В Unix-подобных системах принят очень удобный подход для работы с различными устройствами ввода/вывода - рассматривать их как файлы. Реальные файлы на диске, мышки, принтеры, модемы и т.п. являются файлами. Т.е. их можно открыть, прочитать данные, записать данные и закрыть.
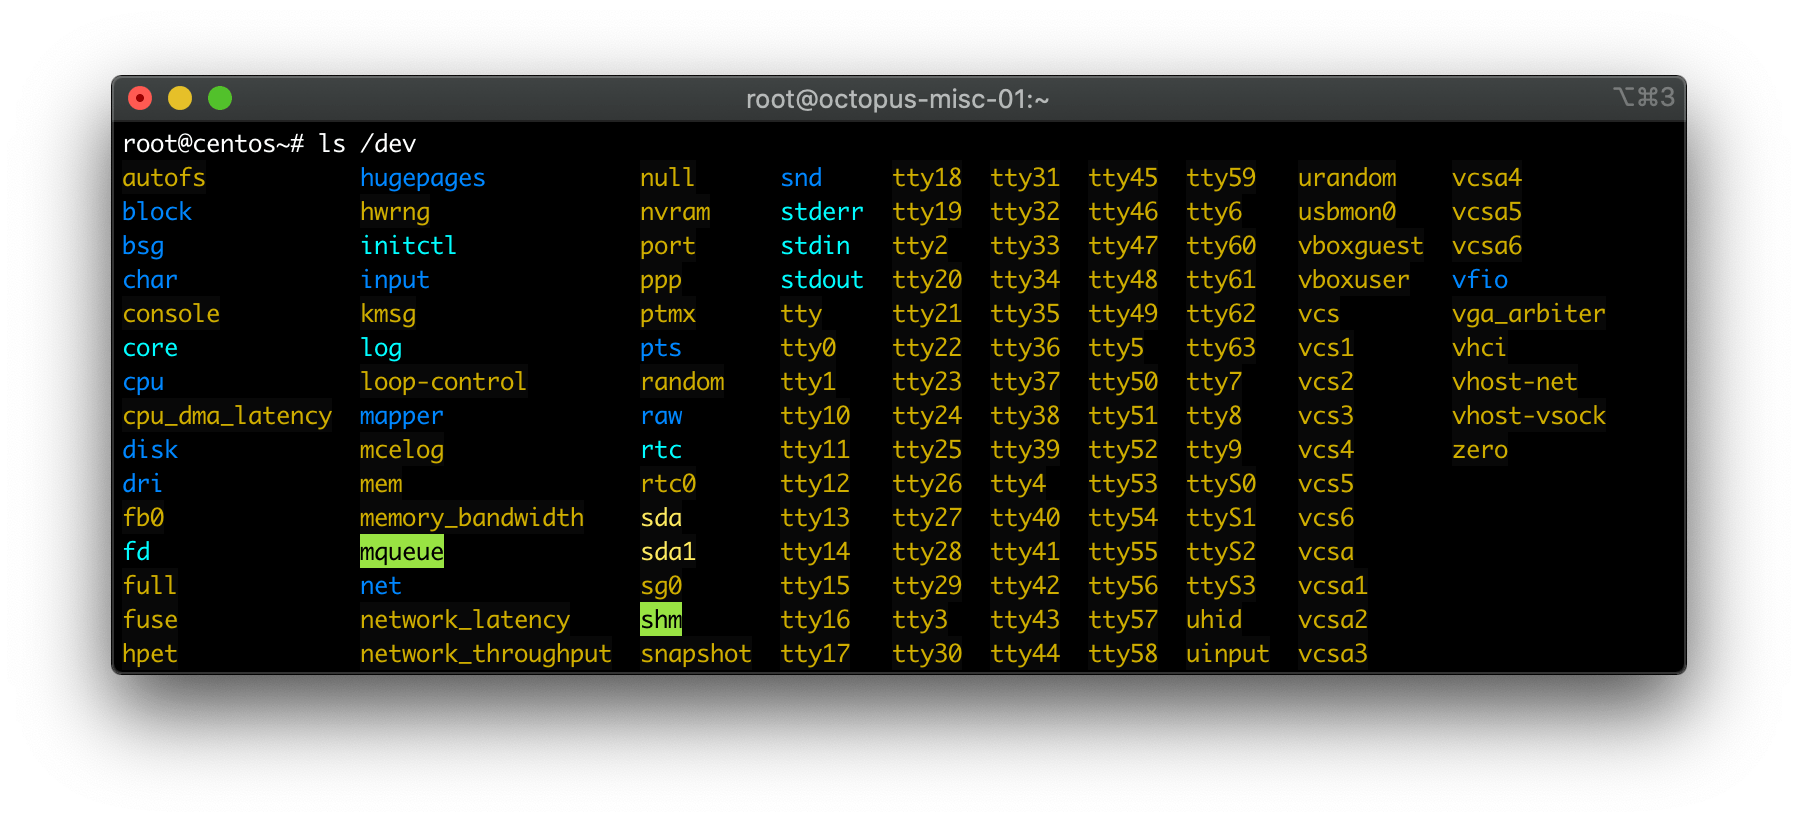
При открытии файла операционной системой создается т.н. файловый дескриптор. Это некоторый целочисленный идентификатор, однозначно определяющий файл в текущем процессе. Для того, чтобы прочитать или записать данные в файл, необходимо в соответсвующую функцию (например, read() или write() ) передать этот дескриптор, чтобы четко указать, с каким файлом мы собираемся взаимодействовать.
int fd = open("/path/to/my/file", . ); char buffer[1024]; read(fd, buffer, 1024); write(fd, "some data", 10); close(fd); Очевидно, что т.к. общение компьютеров по сети - это также про ввод/вывод, то и оно должно быть организовано как работа с файлами. Для этого используется специальный тип файлов, т.н. сокеты.
Сокет - это некоторая абстракция операционной системы, представляющая собой интерфейс обмена данными между процессами. В частности и по сети. Сокет можно открыть, можно записать в него данные и прочитать данные из него.
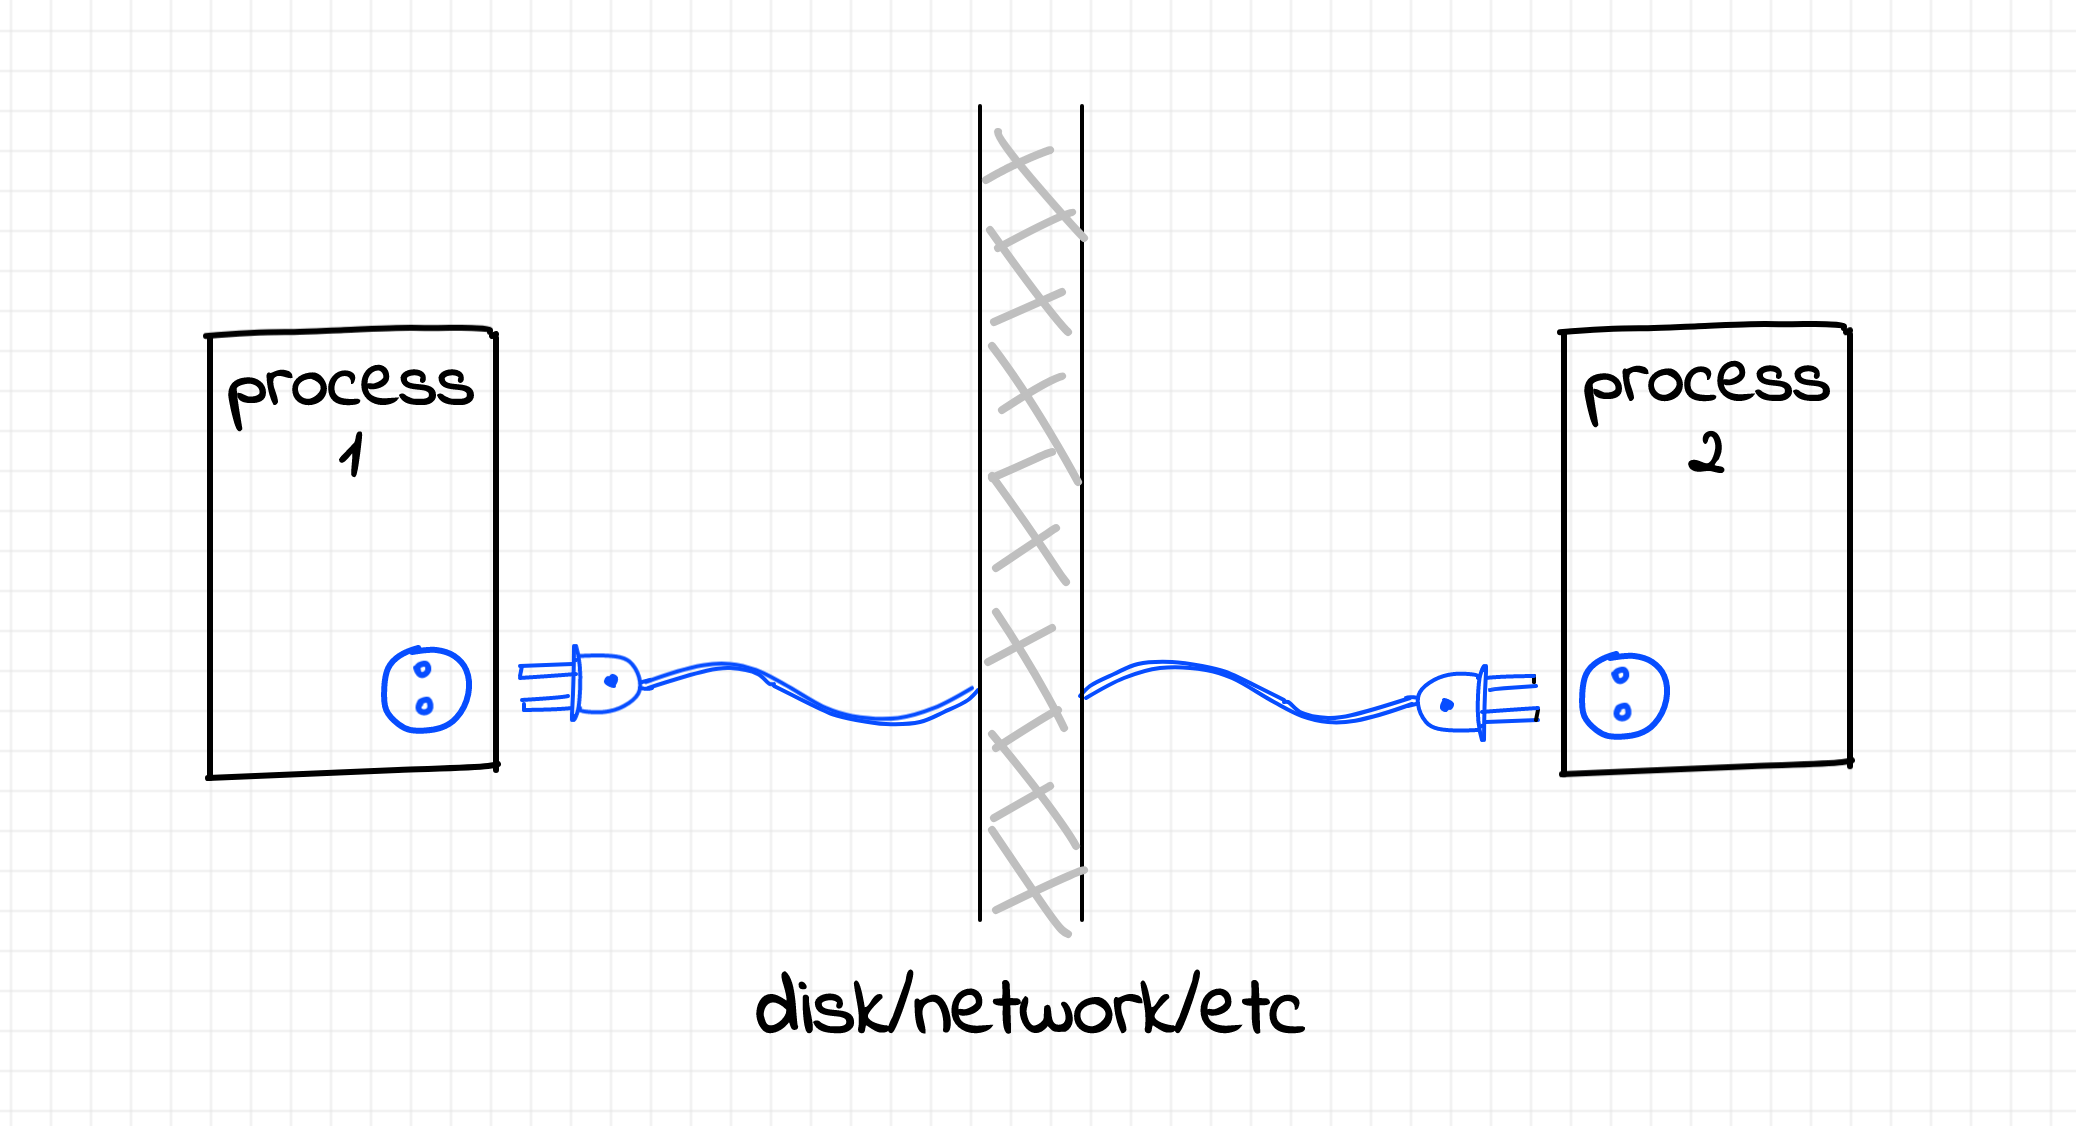
Т.к. видов межпроцессных взаимодействий с помощью сокетов множество, то и сокеты могут иметь различные конфигурации: сокет характеризуется семейством протоколов (IPv4 или IPv6 для сетевого и UNIX для локального взаимодействия), типом передачи данных (потоковая или датаграммная) и протоколом (TCP, UDP и т.п.).
Далее будет рассматриваться исключительно клиент-серверное взаимодействие по сети с использованием сокетов и стека протоколов TCP/IP.
Предположим, что наша прикладная программа хочет передать строку "Hello World" по сети, и соответствующий сокет уже открыт. Программа осуществляет запись этой строки в сокет с использованием функции write() или send() . Как эти данные будут переданы по сети?
Т.к. в общем случае размер передаваемых программой данных не ограничен, а за один раз сетевой адаптер (NIC) может передать фиксировнный объем информации, данные необходимо разбить на фрагменты, не превышающие этот объем. Такие фрагменты называются пакетами. Каждому пакету добавляется некоторая служебная информация, в частности содержащая адреса получателя и отправителя, и они начинают свой путь по сети.
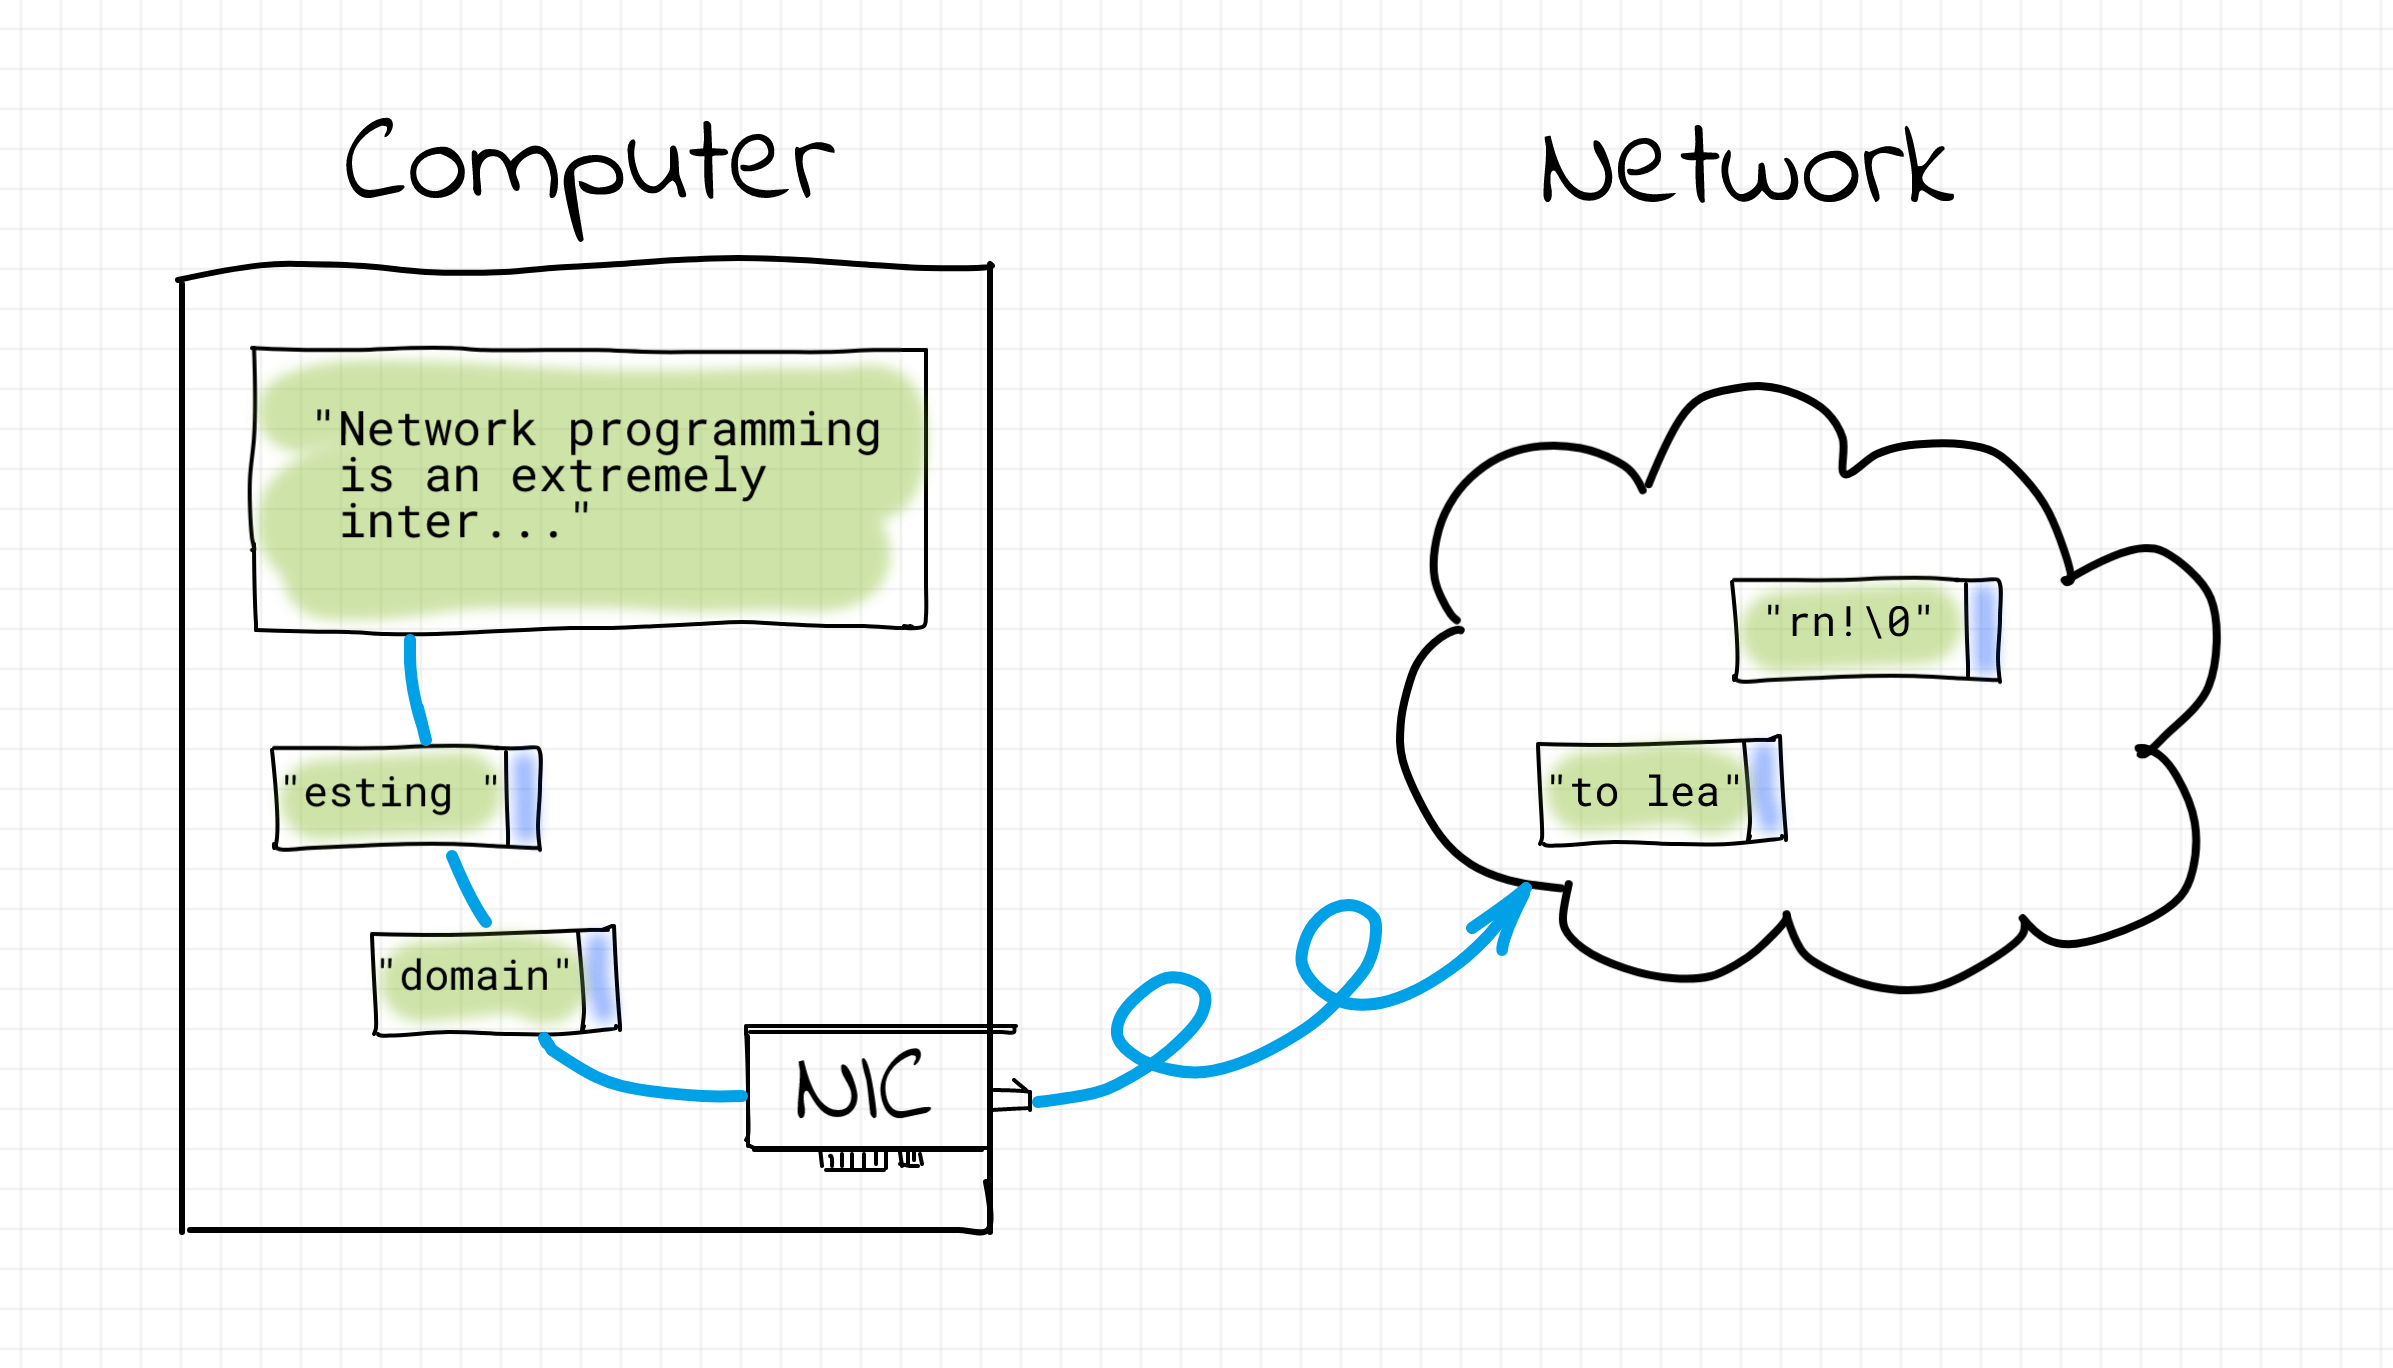
Адрес компьютера в сети - это т.н. IP-адрес. IP (Internet Protocol) - протокол, который позволил объединить множество разнородных сетей по всеми миру в одну общую сеть, которая называется Интернет. И произошло это благодаря тому, что каждому компьютеру в сети был назначен собственный адрес.
В силу особенности маршрутизации пакетов в сети, различные пакеты одной и той же логической порции данных могут следовать от отправителя к получателю разными маршрутами. Разные маршруты могут иметь различную сетевую задержку, следовательно, пакеты могут быть доставлены получателю не в том порядке, в котором они были отправлены. Более того, содержимое пакетов может быть повреждено в процессе передачи.
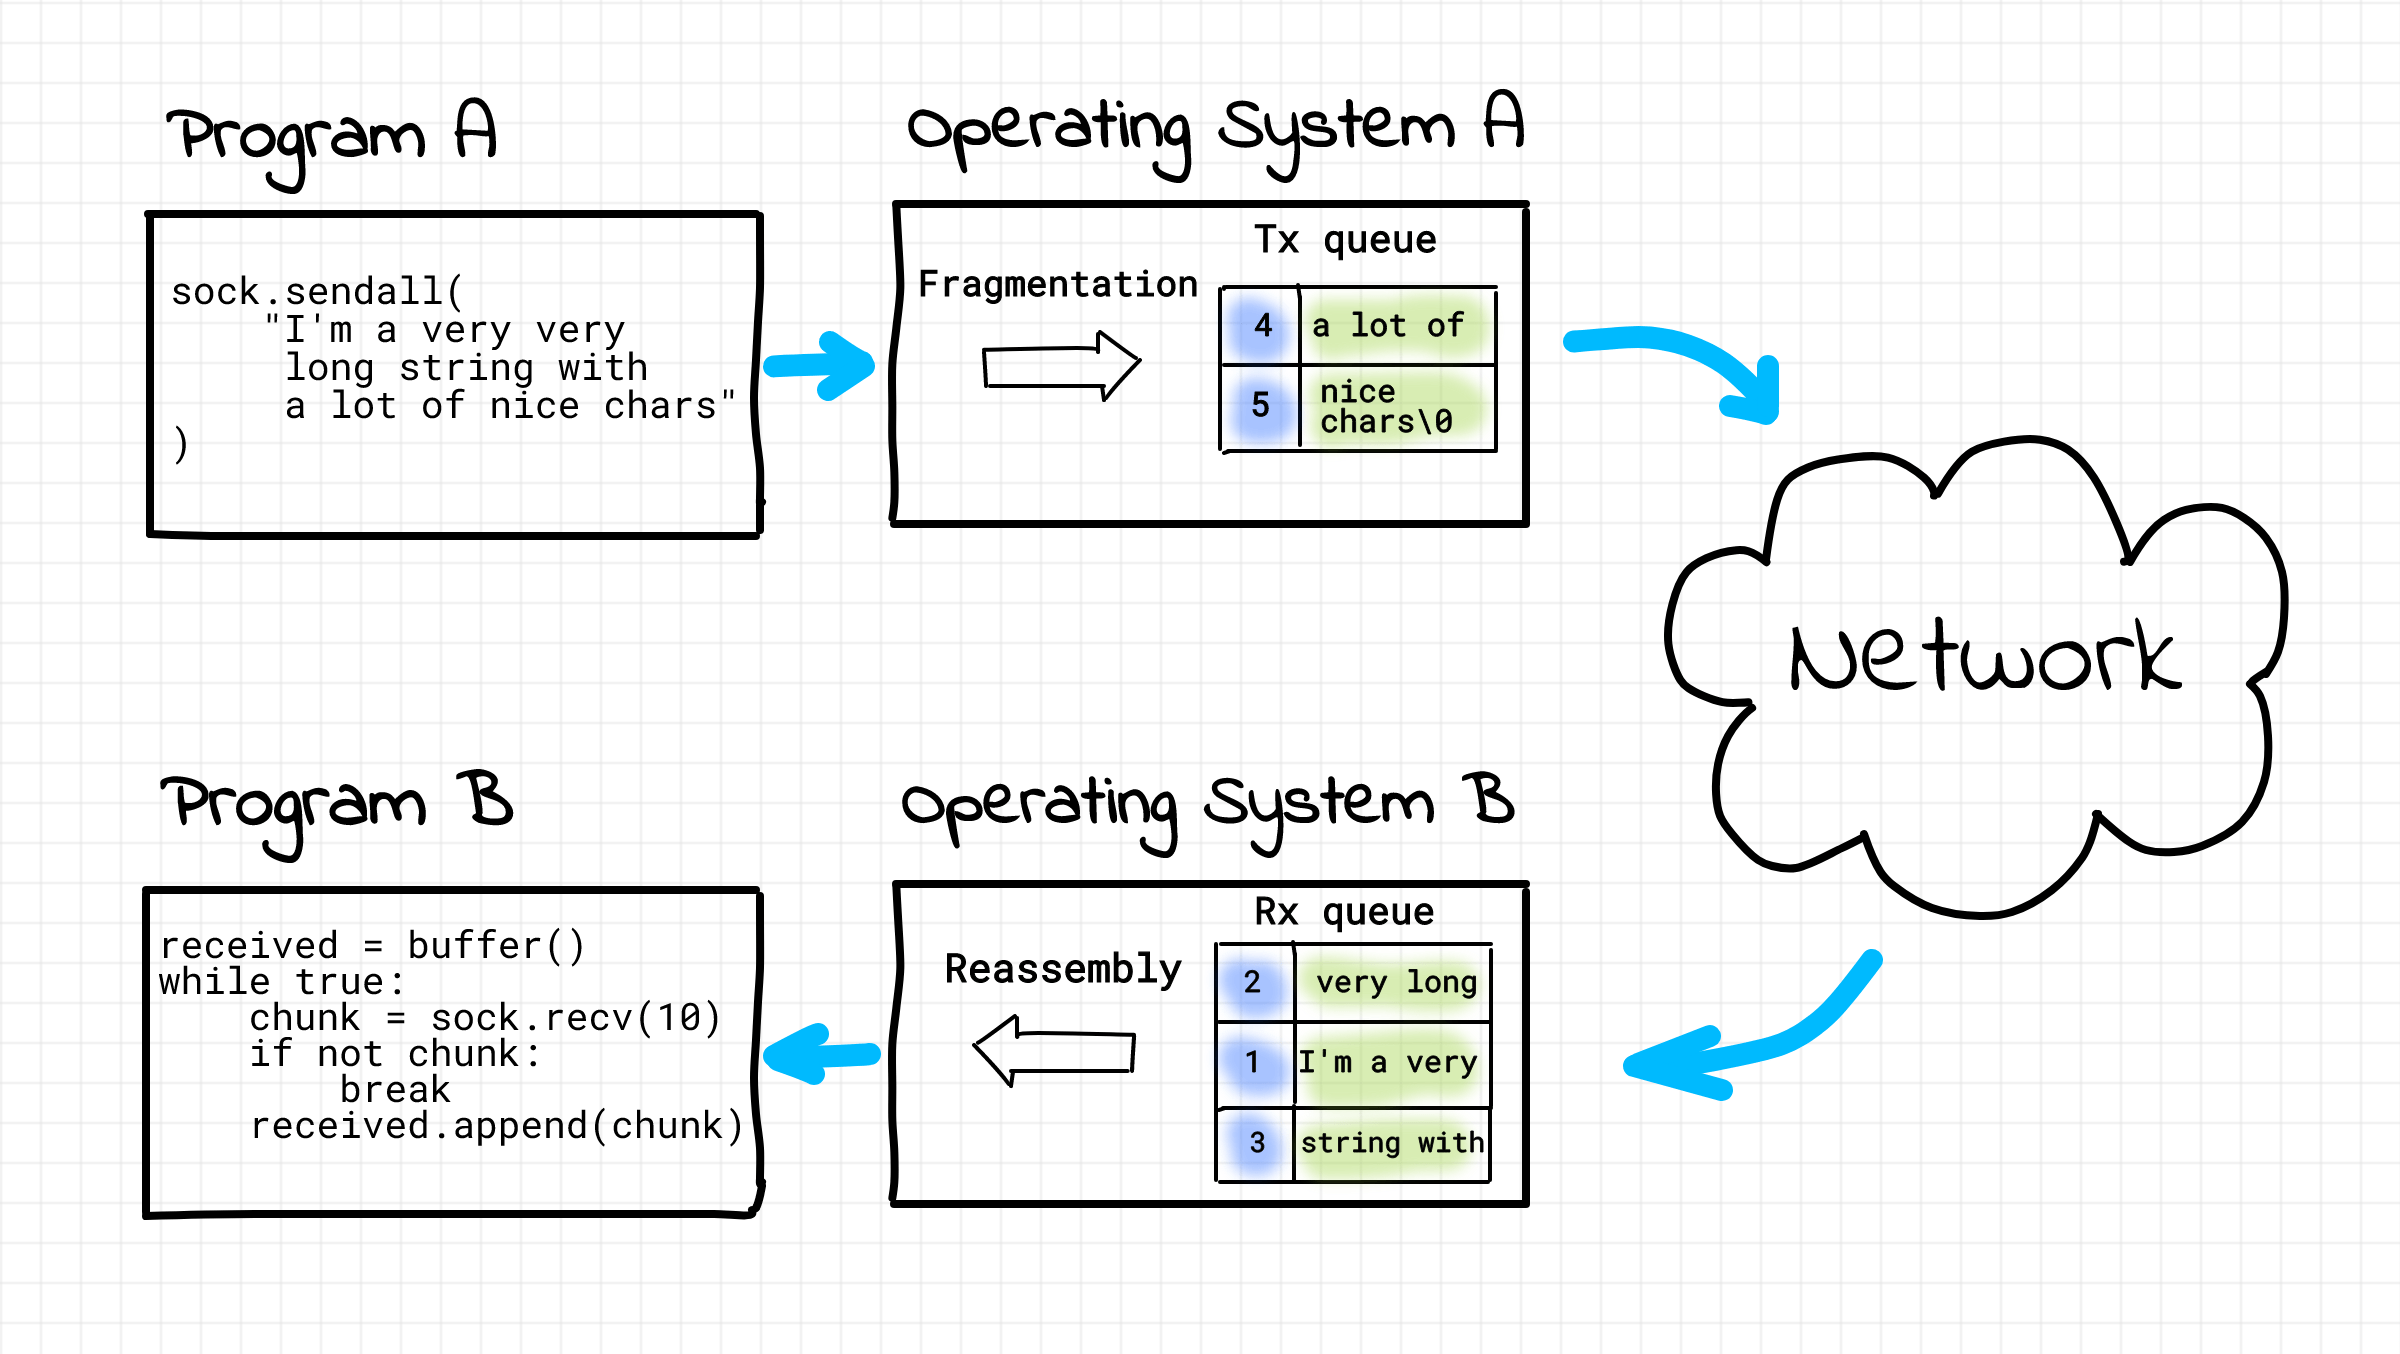
Вообще говоря, требование получать пакеты в том же порядке, в котором они были отправлены, не всегда является обязательным (например, при передаче потокового видео). Но, когда мы загружаем веб-страницу в браузере, мы ожидаем, что буквы на ней будут расположены ровно в том же порядке, в котором их нам отправил веб-сервер. Именно поэтому HTTP протокол работает поверх надеждного протокола передачи данных TCP, который будет рассмотрен ниже.
Чтобы организовать доставку пакетов в порядке их передачи, необходимо добавить в служебную информацию каждого пакета его номер в цепочке пакетов и на принимающей стороне делать сборку пакетов не в порядке их поступления, а в порядке, определенном этими номерами. Чтобы избежать доставки поврежденных пакетов, необходимо в каждый пакет добавить контрольную сумму и пакеты с неправильной контрольной суммой отбрасывать, ожидая, что они будут отправлены повторно.
Этим занимается специальный протокол потоковой передачи данных - TCP.
TCP - (Transmission Control Protocol — протокол управления передачей) - один из основных протоколов передачи данных в Интернете. Используется для надежной передачи данных с подтверждением доставки и сохранением порядка пакетов.
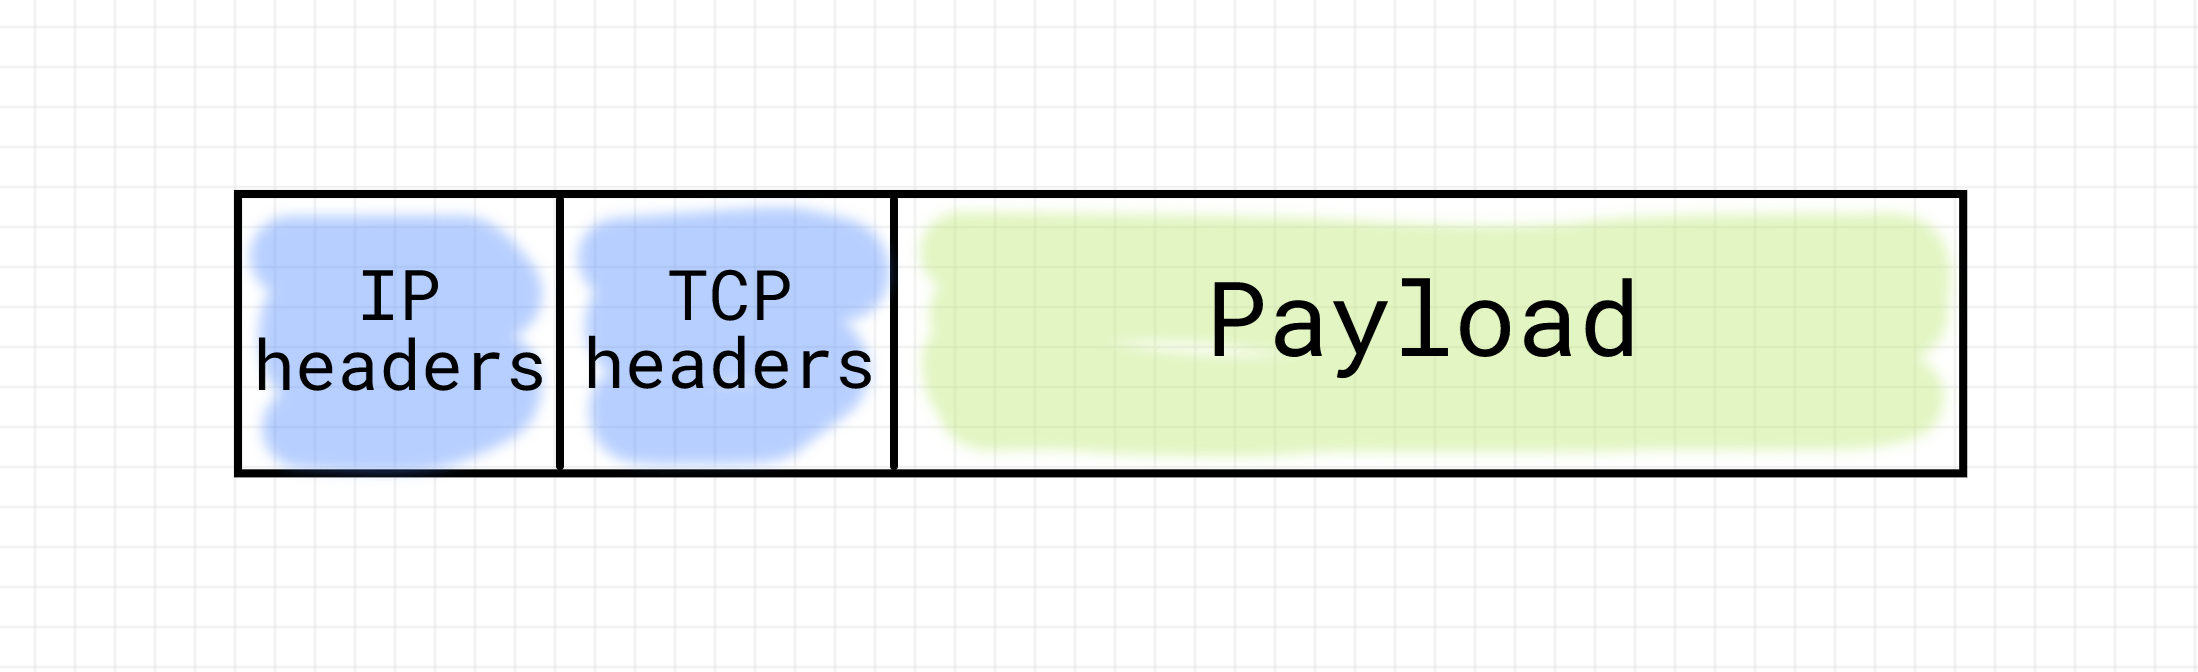
В силу того, что передачей данных по сети по протоколу TCP на одном и том же компьютере может заниматься одновременно несколько программ, для каждого из таких сеансов передачи данных необходимо поддерживать свою последовательность пакетов. Для этого TCP вводит понятие соединения. Соединение - это просто логическое соглашение между принимающей и передающей сторонами о начальных и текущих значениях номеров пакетов и состоянии передачи. Соединение необходимо установить (обменявшись несколькими служебными пакетами), поддерживать (периодически передавать данные, чтобы не наступил таймаут), а затем закрыть (снова обменявшись несколькими служебными пакетами).
Итак, IP определяет адрес компьютера в сети. Но, в силу наличия TCP соединений, пакеты могут принадлежать различным соединениям на одной и той же машине. Для того, чтобы различать соединения, вводится понятие TCP-порт. Это всего лишь пара чисел (одно для отправителя, а другое для получателя) в служебной информации пакета, определяющая, в рамках какого соединения должен рассматриваться пакет. Т.е. адрес соединения на этой машине.
Простейший TCP сервер
Теперь перейдем к практике. Попробуем создать свой собственный TCP-сервер. Для этого нам понадобится модуль socket из стандартной библиотеки Python.
Основная проблема при работе с сокетами у новичков связана с наличием обязательного магического ритуала подготовки сокетов к работе. Но имея за плечами теоретические знания, изложенные выше, кажущаяся магия превращается в осмысленные действия. Также необходимо отметить, что в случае с TCP работа с сокетами на сервере и на клиенте различается. Сервер занимается ожиданием подключений клиентов. Т.е. его IP адрес и TCP порт известны потенциальным клиентам заранее. Клиент может подключиться к серверу, т.е. выступает активной стороной. Сервер же ничего не знает об адресе клиента до момента подключения и не может выступать инициатором соединения. После того, как сервер принимает входящее соединения клиента, на стороне сервера создается еще один сокет, который является симметричным сокету клиента.
Итак, создаем серверный сокет:
# python3 import socket serv_sock = socket.socket(socket.AF_INET, # задамем семейство протоколов 'Интернет' (INET) socket.SOCK_STREAM, # задаем тип передачи данных 'потоковый' (TCP) proto=0) # выбираем протокол 'по умолчанию' для TCP, т.е. IP print(type(serv_sock)) #
А где же обещанные int fd = open("/path/to/my/socket") ? Дело в том, что системный вызов open() не позволяет передать все необходимые для инициализации сокета параметры, поэтому для сокетов был введен специальный одноименный системный вызов socket() . Python же является объектно-ориентированным языком, в нем вместо функций принято использовать классы и их методы. Код модуля socket является ОО-оберткой вокрут набора системных вызовов для работе с сокетами. Его можно представить себе, как:
class socket: # Да, да, имя класса с маленькой буквы :( def __init__(self, sock_familty, sock_type, proto): self._fd = system_socket(sock_family, sock_type, proto) def write(self, data): # на самом деле вместо write используется send, но об этом ниже system_write(self._fd, data) def fileno(self): return self._fd Т.е. доступ к целочисленному файловому дескриптору можно получить с помощью:
print(serv_sock.fileno()) # 3 или другой int Так мы работаем с серверным сокетом, а в общем случае на серверной машине может быть несколько сетевых адаптеров, нам необходимо привязать созданный сокет к одному из них:
serv_sock.bind(('127.0.0.1', 53210)) # чтобы привязать сразу ко всем, можно использовать '' Вызов bind() заставляет нас указать не только IP адрес, но и порт, на котором сервер будет ожидать (слушать) подключения клиентов.
Далее необходимо явно перевести сокет в состояние ожидания подключения, сообщив об этом операционной системе:
backlog = 10 # Размер очереди входящих подключений, т.н. backlog serv_sock.listen(backlog) После этого вызова операционная система готова принимать подключения от клиентов на этом сокете, хотя наш сервер (т.е. программа) - еще нет. Что же это означает и что такое backlog?
Как мы уже выяснили, взаимодействие по сети происходит с помощью отправки пакетов, а TCP требует установления соединения, т.е. обмена между клиентом и сервером несколькими служебными пакетами, не содержащими реальных бизнес-данных. Каждое TCP соединение обладает состоянием. Упростив, их можно представить себе так:
СОЕДИНЕНИЕ УСТАНАВЛИВАЕТСЯ -> УСТАНОВЛЕНО -> СОЕДИНЕНИЕ ЗАКРЫВАЕТСЯ Таким образом, параметр backlog определяет размер очереди для установленных, но еще не обработанных программой соединений. Пока количество подключенных клиентов меньше, чем этот параметр, операционная система будет автоматически принимать входящие соединения на серверный сокет и помещать их в очередь. Как только количество установленных соединений в очереди достигнет значения backlog, новые соединения приниматься не будут. В зависимости от реализации (GNU Linux/BSD), OC может явно отклонять новые подключения или просто их игнорировать, давая возможность им дождаться освобождения места в очереди.
Теперь необходимо получить соединение из этой очереди:
client_sock, client_addr = serv_sock.accept() В отличие от неблокирующего вызова listen() , который сразу после перевода сокета в слушающее состояние, возвращает управление нашему коду, вызов accept() является блокирующим. Это означает, что он не возвращает управление нашему коду до тех пор, пока в очереди установленных соединений не появится хотя бы одно подключение.
На этом этапе на стороне сервера мы имеем два сокета. Первый, serv_sock , находится в состоянии LISTEN , т.е. принимает входящие соединения. Второй, client_sock , находится в состоянии ESTABLISHED , т.е. готов к приему и передаче данных. Более того, client_sock на стороне сервера и клиенсткий сокет в программе клиента являются одинаковыми и равноправными участниками сетевого взаимодействия, т.н. peer'ы. Они оба могут как принимать и отправлять данные, так и закрыть соединение с помощью вызова close() . При этом они никак не влияют на состояние слушающего сокета.
Пример чтения и записи данных в клиентский сокет:
while True: data = client_sock.recv(1024) if not data: break client_sock.sendall(data) И опять же справедливый вопрос - где обещанные read() и write() ? На самом деле с сокетом можно работать и с помощью этих двух функций, но в общем случае сигнатуры read() и write() не позволяют передать все возможные параметры чтения/записи. Так, например, вызов send() с нулевыми флагами равносилен вызову write() .
Немного коснемся вопроса адресации. Каждый TCP сокет определяется двумя парами чисел: (локальный IP адрес, локальный порт) и (удаленный IP адрес, удаленный порт) . Рассмотрим, какие адреса на данный момент у наших сокетов:
serv_sock: laddr (ip=, port=53210) raddr (ip=0.0.0.0, port=*) # т.е. любой client_sock: laddr (ip=, port=51573) # случайный порт, назначенный системой raddr (ip=, port=53210) # адрес слушающего сокета на сервере Полный код сервера выглядит так:
# python3 import socket serv_sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM, proto=0) serv_sock.bind(('', 53210)) serv_sock.listen(10) while True: # Бесконечно обрабатываем входящие подключения client_sock, client_addr = serv_sock.accept() print('Connected by', client_addr) while True: # Пока клиент не отключился, читаем передаваемые # им данные и отправляем их обратно data = client_sock.recv(1024) if not data: # Клиент отключился break client_sock.sendall(data) client_sock.close() Подключиться к этому серверу можно с использованием консольной утилиты telnet , предназначенной для текстового обмена информацией поверх протокола TCP:
telnet 127.0.0.1 53210 > Trying 192.168.0.1. > Connected to 192.168.0.1. > Escape character is '^]'. > Hello > Hello Простейший TCP клиент
На клиентской стороне работа с сокетами выглядит намного проще. Здесь сокет будет только один и его задача только лишь подключиться к заранее известному IP-адресу и порту сервера, сделав вызов connect() .
# python3 import socket client_sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client_sock.connect(('127.0.0.1', 53210)) client_sock.sendall(b'Hello, world') data = client_sock.recv(1024) client_sock.close() print('Received', repr(data)) Заключение
Запоминать что-то без понимания, как это работает - злое зло не самый разумный подход для разработчика. Работа с сокетами тому отличный пример. На первый взгляд может показаться, что уложить в голове последовательность приготовления клиентских и серверных сокетов к работе практически не возможно. Это происходит из-за того, что не сразу понятен смысл производимых манипуляций. Однако, понимая, как осуществляется сетевое взаимодействие, API сокетов сразу становится прозрачным и легко оседает в подкорке. А с точки зрения полезности полученных знаний, я считаю. что понимание принципов сетевого взаимодействия жизненно важно для разработки и отладки действительно сложных веб-проектов.
Другие статьи из серии:
- Пишем свой веб-сервер на Python: процессы, потоки и асинхронный I/O
- Пишем свой веб-сервер на Python: протокол HTTP
- Пишем свой веб-сервер на Python: стандарт WSGI
- Пишем свой веб-сервер на Python: фреймворк Flask
Ссылки по теме
Справочная информация:
Литература
- Beej's Guide to Network Programming - отличные основы
- UNIX Network Programming - продвинутый уровень
Создание веб-приложения с помощью Flask в Python 3
Flask — это небольшой и легкий веб-фреймворк, написанный на языке Python, предлагающий полезные инструменты и функции для облегчения процесса создания веб-приложений с использованием Python. Он обеспечивает гибкость и является более доступным фреймворком для новых разработчиков, так как позволяет создать веб-приложение быстро, используя только один файл Python. Flask — это расширяемая система, которая не обязывает использовать конкретную структуру директорий и не требует сложного шаблонного кода перед началом использования.
В рамках этого обучающего руководства вы будете использовать инструментарий Bootstrap, чтобы сделать ваше приложение визуально привлекательным. Bootstrap поможет вам включить в ваше веб-приложение быстрые веб-страницы, чтобы приложение можно было использовать на мобильных браузерах без написания для этого собственных кодов HTML, CSS и JavaScript. Инструментарий дает возможность изучить работу Flask.
Flask использует механизм шаблонов Jinja для динамического создания HTML-страниц с использованием знакомых понятий в Python, таких как переменные, циклы, списки и т. д. Вы будете использовать эти шаблоны в рамках этого проекта.
С помощью этого обучающего руководства вы создадите небольшой веб-блог с использованием Flask и SQLite в Python 3. Пользователи приложения могут видеть все посты в вашей базе данных и нажимать на заголовки постов для просмотра их содержания. Кроме того, присутствует возможность добавлять новый пост в базу данных и редактировать или удалять существующий пост.
Предварительные требования
Перед началом выполнения этого руководства вам потребуется:
- Локальная среда программирования Python 3. Следуйте инструкциям из обучающего руководства Установка и настройка локальной среды программирования для Python 3 для вашего локального компьютера. В этом обучающем руководстве мы назовем директорию проекта flask_blog .
- Понимание концепций Python 3, таких как типы данных, условные выражения, циклы for, функции и другие. Если вы не знакомы с Python, воспользуйтесь нашей серией Программирование на Python 3.
Шаг 1 — Установка Flask
На этом этапе вы активируете вашу среду Python и установите Flask с помощью установщика пакетов pip .
Если вы еще не активировали среду программирования, убедитесь, что находитесь в директории проекта ( flask_blog ), и с помощью следующей команды активируйте среду:
После активации среды программирования в вашей командной строке появится префикс env , и она будет выглядеть следующим образом:
Данный префикс служит индикатором того, что среда env активна (имя среды может быть другим, в зависимости от того, как вы назвали ее при создании).
Примечание. Вы можете использовать Git, систему контроля версий, для эффективного управления и отслеживания процесса разработки вашего проекта. О том, как использовать Git, вы можете узнать из нашей статьи Введение в Git: установка, использование и ответвления.
Если вы используете Git, рекомендуем игнорировать вновь созданную директорию env в файле .gitignore , чтобы избежать отслеживания файлов, не связанных с проектом.
Теперь вы можете установить пакеты Python и изолировать ваш код проекта от основной системы Python. Это делается с помощью pip и python .
Чтобы установить Flask, запустите следующую команду:
После завершения установки запустите следующую команду, чтобы подтвердить установку:
Используйте интерфейс командной строки python с опцией -c для выполнения кода Python. Далее вы импортируете пакет flask с помощью import flask; и затем распечатываете версию Flask через переменную flask.__version__ .
В результате вы увидите номер версии, который будет выглядеть примерно так:
Output1.1.2 Вы создали папку проекта, виртуальную среду и установили Flask. Теперь вы готовы переходить к настройке базового приложения.
Шаг 2 — Создание базового приложения
Теперь, когда вы настроили среду программирования, можно начинать использовать Flask. На этом этапе вы создадите небольшое веб-приложение внутри файла Python и запустите его для начала работы сервера, который отобразит определенную информацию в браузере.
В директории flask_blog откройте файл с именем hello.py для редактирования. Используйте nano или любой другой текстовый редактор:
Этот файл hello.py будет служить минимальным примером того, как обрабатывать запросы HTTP. Внутри него импортируйте объект Flask и создайте функцию, которая возвращает ответ HTTP. Напишите следующий код внутри файла hello.py :
flask_blog/hello.py
from flask import Flask app = Flask(__name__) @app.route('/') def hello(): return 'Hello, World!' В предыдущем блоке кода необходимо предварительно импортировать объект Flask из пакета flask . Затем вы создаете ваш экземпляр приложения Flask с именем app . Вы передаете специальную переменную __name__ , которая содержит имя текущего модуля Python. Она указывает экземпляру его расположение. Это необходимо, так как Flask устанавливает ряд путей за кадром.
Создав экземпляр app , вы начинаете используете его для обработки поступающих веб-запросов и отправки ответов пользователю. @app.route — это декоратор, который превращает стандартную функцию Python в функцию просмотра Flask, конвертирующую возвращаемое значение функции в ответ HTTP, который отображается клиентом HTTP, например веб-браузером. Вы передаете значение '/' в @app.route() для обозначения того, что эта функция будет отвечать на веб-запросы для URL / , который является основным URL-адресом.
Функция просмотра hello() возвращает строку 'Hello, World!' в качестве ответа.
Сохраните и закройте файл.
Для запуска вашего веб-приложения сначала укажите Flask, где искать приложение (в вашем случае файл hello.py ) с помощью переменной среды FLASK_APP :
Затем запустите его в режиме разработки с помощью переменной среды FLASK_ENV :
И наконец, запустите приложение, используя команду flask run :
После запуска приложения вы увидите примерно следующее:
Output * Serving Flask app "hello" (lazy loading) * Environment: development * Debug mode: on * Running on http://127.0.0.1:5000/ (Press CTRL+C to quit) * Restarting with stat * Debugger is active! * Debugger PIN: 813-894-335 В предыдущем выводе представлена следующая информация:
- Название работающего приложения.
- Среда, в которой работает приложение.
- Debug mode: on означает, что отладчик Flask работает. Эта функция полезна при разработке, так как при возникновении проблем она выдает детализированные сообщения об ошибке, что упрощает работу по их устранению.
- Приложение работает локально на URL http://127.0.0.1:5000/ , где 127.0.0.1 — это IP-адрес localhost вашего компьютера, а :5000 — номер порта.
Откройте браузер и введите URL http://127.0.0.1:5000/ . Вы получите строку Hello, World! в качестве ответа. Это подтверждает то, что ваше приложение успешно работает.
Внимание. Flask использует простой веб-сервер для обслуживания нашего приложения в среде разработки, что также означает, что отладчик Flask работает для облегчения работы по обнаружению ошибок. Этот сервер для разработки не должен использоваться при развертывании в производственной среде. Дополнительную информацию можно найти в документации Flask на странице Опции развертывания или в обучающем руководстве по развертыванию Flask.
Теперь вы можете оставить сервер разработки работать в терминале и открыть другое окно терминала. Перейдите в папку проекта, где находится файл hello.py , активируйте виртуальную среду, установите переменные среды FLASK_ENV и FLASK_APP , а затем выполните следующие шаги (эти команды перечислены ранее на этом шаге).
Примечание. При открытии нового терминала важно помнить об активации виртуальной среды и настройке переменных среды FLASK_ENV и FLASK_APP .
Если сервер разработки приложения Flask работает, невозможно запустить еще одно приложение Flask с помощью такой же команды flask run . Это связано с тем, что flask run по умолчанию использует номер порта 5000 , следовательно, когда он занят, невозможно запустить другое приложение, поэтому вы увидите ошибку аналогичную этой:
OutputOSError: [Errno 98] Address already in use Для решения этой проблемы нужно либо остановить работающий в настоящий момент сервер с помощью команды CTRL+C , а затем снова задать команду flask run , или, если вам нужно,чтобы оба сервера работали одновременно, передать другой номер порта в аргумент -p , например запустить другое приложение через порт 5001 , используя следующую команду:
Теперь у вас есть небольшое веб-приложение Flask. Вы запустили ваше приложение и вывели информацию в браузере. Далее вы будете использовать файлы HTML в вашем приложении.
Шаг 3 — Использование шаблонов HTML
Сейчас ваше приложение отображает только простое сообщение без какого-либо HTML. Веб-приложения в основном используют HTML для отображения информации для посетителя, поэтому теперь вы можете заняться включением в ваше приложение файлов HTML, которые можно отобразить в браузере.
Flask предлагает вспомогательную функцию render_template() , которая позволяет использовать механизм шаблонов Jinja. Это упрощает работу с HTML благодаря написанию вашего кода HTML в файлах .html , а также использованию логики в вашем коде HTML. Вы будете использовать файлы HTML (шаблоны) для создания всех страниц вашего приложения, например главной страницы, где будут отображаться текущие посты блога, страницы поста блога, страницы, на которой пользователь сможет добавить новый пост и т. д.
На этом этапе вы создадите свое основное приложение Flask в новом файле.
Сначала в директории flask_blog с помощью nano или другого редактора создайте и отредактируйте файл app.py . Здесь будет хранить весь код, который вы будете использовать для создания приложения с блогом:
В этом новом файле вы сможете импортировать объект Flask для создания экземпляра приложения Flask так же, как вы делали ранее. Кроме того, вы сможете импортировать вспомогательную функцию render_template() , позволяющую поставлять файлы шаблонов HTML, существующих в папке templates , которую вы создадите. Файл будет иметь единичную функцию просмотра, отвечающую за обработку запросов по основному маршруту / . Добавьте следующее содержимое:
flask_blog/app.py
from flask import Flask, render_template app = Flask(__name__) @app.route('/') def index(): return render_template('index.html') Функция просмотра index() возвращает результат вызова render_template() с index.html в качестве аргумента. Это дает указание render_template() искать файл с именем index.html в папке шаблонов. И папка, и файл еще отсутствуют. Вы получите сообщение об ошибке, если запустите приложение на этом этапе. Тем не менее при запуске вы уже будете знать об этой часто встречающейся ошибке. Затем вы сможете исправить ошибку, создав необходимые папку и файл.
Сохраните и закройте файл.
Остановите сервер разработки на другом терминале, на котором работает приложение hello с помощью CTRL+C .
Перед запуском приложения убедитесь, что вы корректно указали значение для переменной среды FLASK_APP , так как вы больше не используете приложение hello :
После открытия URL http://127.0.0.1:5000/ в вашем браузере страница отладчика сообщит вам, что шаблон index.html не был найден. Основная строка кода, которая привела к этой ошибке, будет выделена. В данном случае это строка return render_template('index.html') .
Если вы нажмете на эту строку, отладчик откроет код, и у вас будет дополнительный контекст для понимания и решения проблемы.

Для устранения данной ошибки создайте директорию с именем templates внутри директории flask_blog . Затем внутри нее откройте файл с именем index.html для редактирования:
После этого добавьте следующий код HTML внутри index.html :
flask_blog/templates/index.html
DOCTYPE html> html lang="en"> head> meta charset="UTF-8"> title>FlaskBlogtitle> head> body> h1>Welcome to FlaskBlogh1> body> html> Сохраните файл и используйте свой браузер для перехода на http://127.0.0.1:5000/ или обновите страницу. Теперь браузер должен отобразить текст Welcome to FlaskBlog в теге .
Помимо папки templates веб-приложения Flask также обычно имеют папку static для хостинга статичных файлов, таких как файлы CSS, файлы JavaScript и изображения, которые использует приложение.
Вы можете создать файл стилей style.css , чтобы добавить CSS в ваше приложение. Сначала создайте директорию с именем static внутри основной директории flask_blog :
Затем создайте другую директорию с именем css внутри директории static для хостинга файлов .css . Обычно это делается для упорядочивания статичных файлов в специальных папках. Например, файлы JavaScript обычно находятся в директории с именем js , изображения хранятся в директории images (или img ) и т. д. Следующая команда создает директорию css внутри директории static :
После этого откройте файл style.css в директории css для редактирования:
Добавьте следующее правило CSS в файл style.css :
flask_blog/static/css/style.css
h1 border: 2px #eee solid; color: brown; text-align: center; padding: 10px; > Код CSS добавит границу, изменит цвет на коричневый, выравняет текст по центру и добавит небольшое дополнение к меткам .
Сохраните и закройте файл.
Далее откройте файл шаблона index.html для редактирования:
Добавьте ссылку в файл style.css внутри раздела файла шаблона index.html :
flask_blog/templates/index.html
. . . head> meta charset="UTF-8"> link rel="stylesheet" href=">"> title>FlaskBlogtitle> head> . . . Для этого вы используете вспомогательную функцию url_for() для генерирования подходящего расположения файла. Первый аргумент указывает, что вы связаны со статичным файлом, а второй — это путь файла внутри статичной директории.
Сохраните и закройте файл.
После обновления страницы индекса вашего приложения вы увидите, что цвет текста Welcome to FlaskBlog теперь коричневый, расположен по центру и добавлен внутри границы.
Используйте язык CSS для оформления стиля приложения и придавайте ему более привлекательный вид с помощью своего собственного дизайна. Однако, если вы не веб-дизайнер или не знакомы с CSS, воспользуйтесь инструментарием Bootstrap, который предлагает простые в использовании компоненты для оформления приложения. В данном проекте мы будем использовать Bootstrap.
Вероятно, вы уже догадались, что создание другого шаблона HTML будет означать повторение основной части кода HTML, который уже написан вами в шаблоне index.html . Избежать ненужного повторения кода возможно благодаря файлу базового шаблона, из которого наследуются все ваши файлы HTML. Дополнительную информацию можно найти в статье Наследование шаблонов в Jinja.
Для создания базового шаблона сначала необходимо создать файл с именем base.html внутри директории templates :
Введите следующий код в шаблоне base.html :
flask_blog/templates/base.html
doctype html> html lang="en"> head> meta charset="utf-8"> meta name="viewport" content="width=device-width, initial-scale=1, shrink-to-fit=no"> link rel="stylesheet" href="https://stackpath.bootstrapcdn.com/bootstrap/4.3.1/css/bootstrap.min.css" integrity="sha384-ggOyR0iXCbMQv3Xipma34MD+dH/1fQ784/j6cY/iJTQUOhcWr7x9JvoRxT2MZw1T" crossorigin="anonymous"> title> title> head> body> nav class="navbar navbar-expand-md navbar-light bg-light"> a class="navbar-brand" href=">">FlaskBloga> button class="navbar-toggler" type="button" data-toggle="collapse" data-target="#navbarNav" aria-controls="navbarNav" aria-expanded="false" aria-label="Toggle navigation"> span class="navbar-toggler-icon">span> button> div class="collapse navbar-collapse" id="navbarNav"> ul class="navbar-nav"> li class="nav-item active"> a class="nav-link" href="#">Abouta> li> ul> div> nav> div class="container"> div> script src="https://code.jquery.com/jquery-3.3.1.slim.min.js" integrity="sha384-q8i/X+965DzO0rT7abK41JStQIAqVgRVzpbzo5smXKp4YfRvH+8abtTE1Pi6jizo" crossorigin="anonymous">script> script src="https://cdnjs.cloudflare.com/ajax/libs/popper.js/1.14.7/umd/popper.min.js" integrity="sha384-UO2eT0CpHqdSJQ6hJty5KVphtPhzWj9WO1clHTMGa3JDZwrnQq4sF86dIHNDz0W1" crossorigin="anonymous">script> script src="https://stackpath.bootstrapcdn.com/bootstrap/4.3.1/js/bootstrap.min.js" integrity="sha384-JjSmVgyd0p3pXB1rRibZUAYoIIy6OrQ6VrjIEaFf/nJGzIxFDsf4x0xIM+B07jRM" crossorigin="anonymous">script> body> html> Сохраните и закройте файл после редактирования.
Основная часть кода в предыдущем блоке состоит из стандартного HTML и кода, необходимого для Bootstrap. Теги содержат информацию для веб-браузера, тег привязывает файлы CSS Bootstrap, а теги являются ссылками на код JavaScript, который позволяет выполнить ряд дополнительных функций Bootstrap. Дополнительную информацию по этому вопросу можно найти в документации Bootstrap.
Однако следующие выделенные части относятся к механизму шаблонов Jinja:
- : блок, замещающий заголовок. Позже вы будете использовать его в других шаблонах для написания пользовательского заголовка для каждой страницы в приложении без перезаписи всего раздела каждый раз.
- > : вызов функции, который возвращает URL для функции просмотра index() . Этот вариант отличается от прошлого вызова url_for() , который использовался для привязки статичного файла CSS. Он использует только один аргумент, а именно имя функции просмотра, и привязывается к маршруту, связанному с функцией вместо статичного файла.
- : еще один блок, который будет замещен контентом в зависимости от дочернего шаблона (шаблоны, которые наследуются из base.html ), который заменит его.
Теперь, когда у вас есть базовый шаблон, вы можете воспользоваться преимуществом, используя наследование. Откройте файл index.html :
Замените его содержание на следующее:
flask_blog/templates/index.html
h1> Welcome to FlaskBlog h1>
В этой новой версии шаблона index.html вы используете тег для наследования из шаблона base.html . Затем вы расширите его, заменив блок content в базовом шаблоне на содержимое блока content из предыдущего блока кода.
Этот блок content содержит тег с текстом Welcome to FlaskBlog внутри блока title , который в свою очередь заменяет оригинальный блок title в шаблоне base.html текстом Welcome to FlaskBlog . Так вы можете избежать повторения одного и того же текста дважды, так как он используется и в качестве названия страницы, и в качестве заголовка, который появляется под панелью навигации, унаследованной от базового шаблона.
Наследование шаблона также дает возможность использовать код HTML из других шаблонов (в данном случае base.html ) без повторения его при каждой необходимости.
Сохраните и закройте файл, а затем обновите страницу индекса в браузере. Вы увидите страницу с панелью навигации и оформленным заголовком.

Вы использовали шаблоны HTML и статичные файлы в Flask. Вы также использовали Bootstrap для начала оформления страницы и базовый шаблон для избежания повторения кода. В следующем шаге вы настроите базу данных, которая будет хранить данные вашего приложения.
Шаг 4 — Настройка базы данных
На этом этапе вы настроите базу данных для хранения данных, в случае с вашим приложением — это посты блога. Вы также наполните базу несколькими примерами.
Вы будете использовать файл базы данных SQLite для хранения ваших данных, так как модуль sqlite3 , который мы будем использовать для взаимодействия с базой, уже присутствует в стандартной библиотеке Python. Дополнительную информацию о SQLite можно найти в этом обучающем руководстве.
Поскольку данные в SQLite хранятся в таблицах и столбцах, а ваши данные в основном состоят из постов блога, в первую очередь вам понадобится создать таблицу с именем posts и необходимыми столбцами. Вы создадите файл .sql , содержащий команды SQL для создания таблицы posts с несколькими столбцами. Затем вы будете использовать этот файл для создания базы данных.
Откройте файл с именем schema.sql внутри директории flask_blog :
Введите следующие команды SQL в этом файле:
flask_blog/schema.sql
DROP TABLE IF EXISTS posts; CREATE TABLE posts ( id INTEGER PRIMARY KEY AUTOINCREMENT, created TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, title TEXT NOT NULL, content TEXT NOT NULL ); Сохраните и закройте файл.
Первая команда SQL — это DROP TABLE IF EXISTS posts; .Она удаляет все уже существующие таблицы с именем posts , чтобы не создавать путаницу. Обратите внимание, что при использовании этих команд SQL будет удалено все содержимое базы данных, поэтому не записывайте ничего важного в веб-приложении до окончания изучения этого руководства и экспериментируйте с финальным результатом. Далее, команда CREATE TABLE posts используется для создания таблицы posts со следующими столбцами:
- id : целое число, которое представляет собой первичный ключ. В базе данных будет присвоено уникальное значение каждой записи (посту блога).
- created : время создания поста блога. NOT NULL означает, что столбец не может быть пустым, а значение DEFAULT — это CURRENT_TIMESTAMP , т. е. время добавления поста в базу. Точно так же как и в случае с id , вам не нужно указывать значение для этого столбца, так как он будет заполнен автоматически.
- title : заголовок поста.
- content : содержание поста.
Теперь, когда у вас есть схема SQL в файле schema.sql , вы сможете использовать ее для создания базы данных с помощью файла Python, который сформирует файл базы данных SQLite .db . Откройте файл с именем init_db.py внутри директории flask_blog с помощью любого предпочитаемого редактора:
А затем добавьте следующий код.
flask_blog/init_db.py
import sqlite3 connection = sqlite3.connect('database.db') with open('schema.sql') as f: connection.executescript(f.read()) cur = connection.cursor() cur.execute("INSERT INTO posts (title, content) VALUES (?, ?)", ('First Post', 'Content for the first post') ) cur.execute("INSERT INTO posts (title, content) VALUES (?, ?)", ('Second Post', 'Content for the second post') ) connection.commit() connection.close() Сначала вы импортируете модуль sqlite3 , а затем открываете соединение с файлом базы данных database.db , который будет создан сразу после запуска файла Python. После этого используйте функцию open() для открытия файла schema.sql . Далее вы оформляете его содержание с помощью метода executescript() , при котором выполняется несколько операторов SQL одновременно, что формирует таблицу posts . Вы создаете объект курсор, который позволяет вам использовать метод execute() для выполнения двух операторов SQL INSERT , чтобы добавить два поста блога в таблицу posts . И наконец, вы вносите изменения и закрываете соединение.
Сохраните и закройте файл, а затем запустите его в терминале с помощью команды python :
После завершения выполнения файла новый файл с именем database.db появится в директории flask_blog . Это означает, что вы успешно настроили свою базу данных.
В следующем шаге вы будете извлекать посты, внесенные в базу данных, и отображать их на домашней странице своего приложения.
Шаг 5 — Отображение всех постов
Теперь, когда вы настроили базу данных, можно изменить функцию просмотра index() , чтобы отображать все посты, внесенные в базу данных.
Откройте файл app.py , чтобы произвести следующие изменения:
Для первого изменения необходимо импортировать модуль sqlite3 в верхней части файла:
flask_blog/app.py
import sqlite3 from flask import Flask, render_template . . . Далее вы создадите функцию, которая обеспечивает подключение к базе данных, и вернете ее. Добавьте ее непосредственно после импорта:
flask_blog/app.py
. . . from flask import Flask, render_template def get_db_connection(): conn = sqlite3.connect('database.db') conn.row_factory = sqlite3.Row return conn . . . Эта функция get_db_connection() открывает соединение с файлом базы данных database.db , а затем устанавливает атрибут row_factory в sqlite3. Row , чтобы получить доступ к столбцам на основе имен. Это означает, что подключение к базе данных будет возвращать строки, которые ведут себя как обычные словари Python. И наконец, функция возвращает объект подключения conn , который вы будете использовать для доступа к базе данных.
После определения функции get_db_connection() необходимо изменить функцию index() следующим образом:
flask_blog/app.py
. . . @app.route('/') def index(): conn = get_db_connection() posts = conn.execute('SELECT * FROM posts').fetchall() conn.close() return render_template('index.html', posts=posts) В этой новой версии функции index() сначала откройте подключение к базе данных, используя функцию get_db_connection() , которую вы определили ранее. После этого выполните запрос SQL, чтобы выбрать все записи из таблицы posts . Вы применяете метод fetchall() , чтобы доставить все строки результата запроса. Это вернет список постов, внесенных в базу данных на предыдущем шаге.
Вы закрываете подключение к базе данных, используя метод close() , и возвращаете результат отображения шаблона index.html . Вы также передаете объект posts в качестве аргумента, который содержит результаты, полученные из базы данных. Это откроет вам доступ к постам блога в шаблоне index.html .
После внесения этих изменений сохраните и закройте файл app.py .
Теперь, после передачи постов, доставленных из базы данных в шаблон index.html , вы можете использовать цикл for для отображения каждого поста на странице индекса.
Откройте файл index.html :
Затем измените его следующим образом:
flask_blog/templates/index.html
h1> Welcome to FlaskBlog h1> a href="#"> h2>>h2> a> span class="badge badge-primary">>span> hr>
В данном случае синтаксис — это цикл for Jinja , который аналогичен циклу for Python, за исключением того, что позже он закрывается с помощью синтаксиса . Вы используете этот синтаксис для создания цикла для каждого элемента в списке posts , который был передан функцией index() в строке return render_template('index.html', posts=posts) . Внутри этого цикла for вы отображаете название поста в заголовке в теге (позже вы будете использовать этот тег для привязки каждого поста в отдельности).
Вы отображаете заголовок с помощью буквального разделителя переменной ( > ). Не забывайте, что post представляет собой объект словарного типа, поэтому вы сможете получить доступ к заголовку поста с помощью post['title'] . Также вы отображаете дату создания поста помощью такого же метода.
После редактирования файла сохраните и закройте его. Затем перейдите на страницу индекса в браузере. Вы увидите на своей странице два поста, которые вы добавили в базу данных.

Теперь, когда вы изменили функцию просмотра index() , чтобы отобразить все посты, находящиеся в базе данных на домашней странице приложения, вы можете переходить к отображению каждого поста на отдельной странице и разрешить пользователям переходить по ссылке к каждому отдельному посту.
Шаг 6 — Отображение отдельного поста
На этом шаге вы создадите новый маршрут Flask с функцией просмотра и новым шаблоном HTML для отображения отдельного поста блога по его ID.
К концу этого шага на URL http://127.0.0.1:5000/1 будет находиться страница, на которой отображается первый пост (так как его ID 1 ). На URL http://127.0.0.1:5000/ ID будет отображаться пост с соответствующим номером ID , если такой существует.
Откройте app.py для редактирования:
Поскольку позже в рамках данного проекта вам потребуется получить пост блога по его ID из базы данных в нескольких расположениях, вы создадите отдельную функцию с именем get_post() . Вы можете вызвать его, передав ID, и получить обратно пост блога, связанный с предоставленным ID, или создать ответ Flask с сообщением 404 Not Found , если пост блога не существует.
Для ответа в виде страницы 404 вам необходимо импортировать функцию abort() из библиотеки Werkzeug , установленной вместе с Flask в верхней части файла:
flask_blog/app.py
import sqlite3 from flask import Flask, render_template from werkzeug.exceptions import abort . . . Затем добавьте функцию get_post() сразу после функции get_db_connection() , созданной вами на предыдущем шаге:
flask_blog/app.py
. . . def get_db_connection(): conn = sqlite3.connect('database.db') conn.row_factory = sqlite3.Row return conn def get_post(post_id): conn = get_db_connection() post = conn.execute('SELECT * FROM posts WHERE >, (post_id,)).fetchone() conn.close() if post is None: abort(404) return post . . . Эта новая функция имеет аргумент post_id , который определяет, какой пост блога предназначен для возврата.
Внутри функции вы используете функцию get_db_connection() для открытия подключения к базе данных и выполнения запроса SQL, чтобы получить пост блога, связанный с указанным значением post_id . Вы добавляете метод fetchone() для получения результата и хранения его в переменной post , а затем закрываете подключение. Если переменная post имеет значение None , т. е. результат не найден в базе данных, вы используете функцию abort() , импортированную вами ранее, для ответа с помощью кода ошибки 404 , и функция завершит выполнение. Если же пост был найден, вы возвращаете значение переменной post .
Далее добавьте следующую функцию просмотра в конце файла app.py :
flask_blog/app.py
. . . @app.route('/') def post(post_id): post = get_post(post_id) return render_template('post.html', post=post) В этой новой функции просмотра вы добавляете правило переменной , чтобы указать, что часть после слеша ( / ) представляет собой положительное целое число (отмеченное конвертером int ), которое вам необходимо в функции просмотра. Flask распознает это и передает его значение аргументу ключевого слова post_id вашей функции просмотра post() . Затем вы используете функцию get_post() для получения поста блога, связанного с заданным ID, и хранения результата в переменной post , которую вы передаете шаблону post.html . Этот шаблон вы создадите вскоре.
Сохраните файл app.py и новый файл шаблона post.html для редактирования:
Введите следующий код в этом новом файле post.html . Это будет аналогично файлу index.html , за исключением того, что он будет отображать единичный пост, так же как и содержание поста:
flask_blog/templates/post.html
h2> > h2> span class="badge badge-primary">>span> p>>p>
Вы добавляете блок title , который вы определили в шаблоне base.html , чтобы заголовок страницы отражал заголовок поста, в то же время отображаемый в заголовке .
Сохраните и закройте файл.
Теперь вы можете переходить к следующим URL-адресам для просмотра двух постов из вашей базы данных вместе со страницей, которая указывает пользователю, что запрашиваемый пост блога не обнаружен (так как пост с номером ID 3 пока отсутствует):
http://127.0.0.1:5000/1 http://127.0.0.1:5000/2 http://127.0.0.1:5000/3 Вернувшись на страницу индекса, вы осуществите привязку заголовка каждого поста к соответствующей странице. Сделать это можно с помощью функции url_for() . Сначала откройте шаблон index.html для редактирования:
Затем измените значение атрибута href с # на > , чтобы цикл for выглядел следующим образом:
flask_blog/templates/index.html
a href=">"> h2>>h2> a> span class="badge badge-primary">>span> hr>
Здесь вы передаете 'post' в функцию url_for() в качестве первого аргумента. Это имя функции просмотра post() , и поскольку она принимает аргумент post_id , вы присваиваете значение post['id'] . Функция url_for() возвращает правильный URL для каждого поста на основании его ID.
Сохраните и закройте файл.
Теперь ссылки на страницу индекса будут функционировать, как и ожидалось. Таким образом вы завершили построение той части приложения, которая отвечает за отображение постов блога в базе данных. Далее вы будете добавлять возможность создавать, редактировать и удалять посты в вашем приложении.
Шаг 7 — Изменение постов
Теперь, когда вы закончили работу по отображению постов блога, присутствующих в базе данных вашего веб-приложения, вам необходимо дать возможность пользователям вашего приложения писать новые посты в блог и добавлять их в базу данных, редактировать существующие посты, а также удалять ненужные.
Создание нового поста
До этого у вас было приложение, которое отображало посты из вашей базы данных, но не предоставляло возможности добавлять новые посты, кроме случая, когда вы напрямую подключены к базе данных SQLite и можете добавить один пост вручную. В этом разделе вы создадите страницу, на которой сможете создать пост, указав его заголовок и содержание.
Откройте файл app.py для редактирования:
Сначала импортируйте следующее из фреймворка Flask:
- Глобальный объект request для доступа к входящим данным запроса, которые будут подаваться через форму HTML.
- Функция url_for() для генерирования URL-адресов.
- Функция flash() для появления сообщения при обработке запроса.
- Функция redirect() для перенаправления клиента в другое расположение.
Добавьте импортированные функции в ваш файл следующим образом:
flask_blog/app.py
import sqlite3 from flask import Flask, render_template, request, url_for, flash, redirect from werkzeug.exceptions import abort . . . Функция flash() хранит всплывающие сообщения в сеансе браузера клиента, что требует настройки секретного ключа. Этот секретный ключ используется для защищенных сеансов, что позволяет Flask запоминать информацию от одного запроса к другому, например, переходить от страницы нового поста к странице индекса. Пользователь может получить доступ к информации, хранящейся в сеансе, но не может изменить ее без секретного ключа. Поэтому никогда никому не передавайте доступ к вашему секретному ключу. Дополнительную информацию можно найти в документации Flask о сеансах.
Для настройки секретного ключа вам нужно добавить конфигурацию SECRET_KEY в ваше приложение через объект app.config . Добавьте ее непосредственно после определения app перед определением функции просмотра index() :
flask_blog/app.py
. . . app = Flask(__name__) app.config['SECRET_KEY'] = 'your secret key' @app.route('/') def index(): conn = get_db_connection() posts = conn.execute('SELECT * FROM posts').fetchall() conn.close() return render_template('index.html', posts=posts) . . . Не забывайте, что секретный ключ должен представлять собой длинную случайную строку.
После настройки секретного ключа вы создадите функцию просмотра, которая будет отображать шаблон, показывающий форму, которую вы можете заполнить для создания нового поста в блоге. Добавьте эту новую функцию внизу файла:
flask_blog/app.py
. . . @app.route('/create', methods=('GET', 'POST')) def create(): return render_template('create.html') Это создает маршрут /create , который принимает запросы GET и POST. Запросы GET принимаются по умолчанию. Для того чтобы также принимать запросы POST, которые посылаются браузером при подаче форм, вы передаете кортеж с приемлемыми типами запросов в аргумент methods декоратора @app.route() .
Сохраните и закройте файл.
Для создания шаблона откройте файл с именем create.html внутри папки templates :
Добавьте в новый файл следующий код:
flask_blog/templates/create.html
h1> Create a New Post h1> form method="post"> div class="form-group"> label for="title">Titlelabel> input type="text" name="title" placeholder="Post title" class="form-control" value=">">input> div> div class="form-group"> label for="content">Contentlabel> textarea name="content" placeholder="Post content" class="form-control">>textarea> div> div class="form-group"> button type="submit" class="btn btn-primary">Submitbutton> div> form>
Большая часть этого кода — стандартный HTML. Он будет отображать поле ввода для заголовка поста, текстовое пространство для содержания поста и кнопку для отправки формы.
Значением ввода заголовка поста является > , а текстовое пространство имеет значение > . Это сделано для того, чтобы вводимые вами данные не потерялись, если что-то пойдет не по плану. Например, если вы напишете длинный пост и забудете дать ему заголовок, отобразится сообщение, информирующее вас о том, что указание заголовка является обязательным. Это произойдет без потери уже написанного поста, так как он будет сохранен в глобальном объекте request , к которому у вас есть доступ в шаблонах.
Теперь, когда сервер разработки работает, используйте браузер для перехода к маршруту /create :
http://127.0.0.1:5000/create Вы увидите страницу Create a New Post (Создать новый пост) с полями для заголовка и содержания.

Эта форма подает запрос POST в функцию просмотра create() . Но в функции пока отсутствует код обработки запроса POST, поэтому после заполнения формы и ее отправки ничего не происходит.
Вы будете обрабатывать входящий запрос POST после отправки формы. Это можно сделать в функции просмотра create() . Вы можете отдельно обрабатывать запрос POST, проверяя значение request.method . Когда задано значение 'POST' , это означает, что полученный запрос — это запрос POST. Тогда вы можете переходить к извлечению отправленных данных, их проверке и внесению в базу.
Откройте файл app.py для редактирования:
Измените функцию просмотра create() следующим образом:
flask_blog/app.py
. . . @app.route('/create', methods=('GET', 'POST')) def create(): if request.method == 'POST': title = request.form['title'] content = request.form['content'] if not title: flash('Title is required!') else: conn = get_db_connection() conn.execute('INSERT INTO posts (title, content) VALUES (?, ?)', (title, content)) conn.commit() conn.close() return redirect(url_for('index')) return render_template('create.html') Выражением if вы обеспечиваете, что следующий за ним код выполняется только в случае, если запрос является запросом POST через сравнение request.method == 'POST' .
Затем вы извлекаете отправленные заголовок и содержание из объекта request.form , который дает вам доступ к данным формы в запросе. Если заголовок не указан, будет выполнено условие if not title , и отобразится сообщение для пользователя с информацией о необходимости заголовка. С другой стороны, если заголовок указан, вы открываете подключение с помощью функции get_db_connection() и вставляете полученные заголовок и содержание в таблицу posts .
Затем вы вносите изменения в базу данных и закрываете подключение. После добавления поста блога в базу данных вы перенаправляете клиента на страницу индекса с помощью функции redirect() , передавая URL, сгенерированный функцией url_for() со значением 'index' в качестве аргумента.
Сохраните и закройте файл.
Теперь перейдите к маршруту /create , используя ваш веб-браузер:
http://127.0.0.1:5000/create Внесите в форму любой заголовок и какой-либо контент. После отправки формы вы увидите новый пост, указанный на странице индекса.
И в заключение вам нужно отобразить всплывающие сообщения и добавить ссылку на панель навигации в шаблоне base.html для обеспечения простого доступа к этой новой странице. Откройте файл шаблона:
flask_blog/templates/base.html
nav class="navbar navbar-expand-md navbar-light bg-light"> a class="navbar-brand" href=">">FlaskBloga> button class="navbar-toggler" type="button" data-toggle="collapse" data-target="#navbarNav" aria-controls="navbarNav" aria-expanded="false" aria-label="Toggle navigation"> span class="navbar-toggler-icon">span> button> div class="collapse navbar-collapse" id="navbarNav"> ul class="navbar-nav"> li class="nav-item"> a class="nav-link" href="#">Abouta> li> li class="nav-item"> a class="nav-link" href=">">New Posta> li> ul> div> nav> div class="container"> div class="alert alert-danger">>div> div> Сохраните и закройте файл. Теперь на панели навигации будет присутствовать элемент New Post , который связан с маршрутом /create .
Редактирование поста
Для того чтобы ваш блог был всегда актуальным, нужно иметь возможность редактировать существующие посты. В этом разделе будет рассказано, как создать новую страницу в вашем приложении для упрощения процесса редактирования поста.
Сначала вам нужно добавить новый маршрут в файл app.py . Его функция просмотра получит ID поста, который необходимо отредактировать. А URL будет представлен в формате / post_id /edit , где переменная post_id — это ID поста. Откройте файл app.py для редактирования:
Далее добавьте следующую функцию просмотра edit() в конце файла. Редактирование существующего поста аналогично созданию нового поста, поэтому эта функция просмотра будет такой же, как и функция просмотра create() :
flask_blog/app.py
. . . @app.route('//edit', methods=('GET', 'POST')) def edit(id): post = get_post(id) if request.method == 'POST': title = request.form['title'] content = request.form['content'] if not title: flash('Title is required!') else: conn = get_db_connection() conn.execute('UPDATE posts SET title = ?, content = ?' ' WHERE >, (title, content, id)) conn.commit() conn.close() return redirect(url_for('index')) return render_template('edit.html', post=post) Пост, который вы редактируете, определяется с помощью URL, а Flask будет передавать номер ID функции edit() через аргумент id . Вы добавляете это значение к функции get_post() , чтобы доставить пост, связанный с указанным ID, из базы данных. Новые данные будут поступать в запросе POST, который обрабатывается внутри условия if request.method == 'POST' .
Как и при создании нового поста, сначала вы извлекаете данные из объекта request.form , затем показываете всплывающее сообщение, если заголовок имеет пустое значение, в противном случае открываете подключение к базе данных. После этого вы обновляете таблицу posts , указывая новый заголовок и новое содержание, где ID поста в базе данных соответствует ID, который был указан в URL.
В случае запроса GET вы используете шаблон edit.html , передавая переменную post , которая содержит возвращенное значение функции get_post() . Вы будете это использовать для отображения существующих заголовка и содержания на странице редактирования.
Сохраните и закройте файл, а затем создайте новый шаблон edit.html :
Добавьте в новый файл следующий код:
flask_blog/templates/edit.html
h1> Edit ">" h1> form method="post"> div class="form-group"> label for="title">Titlelabel> input type="text" name="title" placeholder="Post title" class="form-control" value=">"> input> div> div class="form-group"> label for="content">Contentlabel> textarea name="content" placeholder="Post content" class="form-control">>textarea> div> div class="form-group"> button type="submit" class="btn btn-primary">Submitbutton> div> form> hr>
Сохраните и закройте файл.
Этот код пишется по той же схеме, за исключением синтаксиса > и > . Здесь отображаются данные, сохраненные в запросе, если он существует. В противном случае отображаются данные из переменной post , которая была передана в шаблон, содержащий данные текущей базы данных.
Теперь вы можете перейти к следующему URL для редактирования первого поста:
http://127.0.0.1:5000/1/edit Вы увидите страницу Edit “First Post”(Редактировать «Первый пост»).

Отредактируйте пост и отправьте форму, затем убедитесь, что пост был обновлен.
Теперь вам нужно добавить ссылку, которая указывает на страницу редактирования для каждого поста на странице индекса. Откройте файл шаблона index.html :
Отредактируйте файл, чтобы он выглядел в точности, как показано ниже:
flask_blog/templates/index.html
h1> Welcome to FlaskBlog h1> a href=">"> h2>>h2> a> span class="badge badge-primary">>span> a href=">"> span class="badge badge-warning">Editspan> a> hr>
Сохраните и закройте файл.
Удаление поста
Бывают случаи, когда вам больше не нужно, чтобы пост был общедоступен, поэтому важно наличие функции удаления поста. На этом шаге вы добавите функцию удаления в ваше приложение.
Сначала вам нужно добавить новый маршрут / ID /delete , который принимает запросы POST, аналогично функции просмотра edit() . Ваша новая функция просмотра delete() будет получать ID поста для удаления из URL. Откройте файл app.py :
Добавьте следующую функцию просмотра внизу файла:
flask_blog/app.py
# . @app.route('//delete', methods=('POST',)) def delete(id): post = get_post(id) conn = get_db_connection() conn.execute('DELETE FROM posts WHERE >, (id,)) conn.commit() conn.close() flash('"<>" was successfully deleted!'.format(post['title'])) return redirect(url_for('index')) Эта функция просмотра принимает только запросы POST. Это означает, что навигация по маршруту / ID /delete в вашем браузере вернет ошибку, так как веб-браузеры по умолчанию настроены на запросы GET.
Но вы можете получить доступ к этому маршруту через форму, которая отправляет запрос POST, передающий ID поста, который вы хотите удалить. Функция получит значение ID и будет использовать его для получения поста из базы данных с помощью функции get_post() .
Затем вы открываете подключение к базе данных и выполняете команду SQL DELETE FROM для удаления поста. Вы вносите изменения в базу данных и закрываете подключение, одновременно отображая сообщение для пользователя, о том, что пост был успешно удален, и перенаправляете на страницу индекса.
Обратите внимание, что вы не отображаете шаблон. Это связано с тем, что вы просто добавите кнопку Delete на страницу редактирования.
Откройте файл шаблона edit.html :
Затем добавьте следующий тег после тега
и непосредственно перед строкой :
flask_blog/templates/edit.html
hr> form action=">" method="POST"> input type="submit" value="Delete Post" class="btn btn-danger btn-sm" onclick="return confirm('Are you sure you want to delete this post?')"> form>
Вы используете метод confirm() для отображения сообщения подтверждения перед отправкой запроса.
Теперь снова перейдите на страницу редактирования поста блога и попробуйте удалить ее:
http://127.0.0.1:5000/1/edit В конце этого шага исходный код вашего проекта будет выглядеть, как код на этой странице.
Теперь пользователи вашего приложения могут писать новые посты и добавлять их в базу данных, редактировать и удалять существующие посты.
Заключение
В этом обучающем руководстве были представлены важные концепции фреймворка Flask Python. Вы научились создавать небольшое веб-приложение, запускать его на сервере разработки и предоставлять пользователю возможность вносить свои данные через параметры URL и веб-формы. Вы также использовали механизм шаблонов Jinja для повторного использования файлов HTML и использования логики в них. В конце этого обучающего руководства вы получили полностью функционирующий веб-блог, взаимодействующий с базой данных SQLite для создания, отображения, редактирования и удаления постов блога с использованием языка Python и запросов SQL.
Вы можете продолжить разработку этого приложения, добавив аутентификацию, позволяющую только зарегистрированным пользователям создавать и менять посты в блоге. В также можете добавить комментарии и теги для каждого поста блога или добавить загрузку файла, чтобы пользователи могли включать в пост изображения. Дополнительную информацию можно найти в документации Flask.
У Flask есть множество расширений, созданных сообществом. Ниже представлен список расширений, который вы можете использовать для упрощения процесса разработки:
- Flask-Login: управляет сеансом пользователя и обрабатывает вход и выход, а также запоминает вошедших в систему пользователей.
- Flask-SQLAlchemy: упрощает использование Flask благодаря SQLAlchemy, инструментарию Python SQL и Object Relational Mapper для взаимодействия с базами данных.
- Flask-Mail: помогает в решении задачи отправки сообщений электронной почты в приложении Flask.
Thanks for learning with the DigitalOcean Community. Check out our offerings for compute, storage, networking, and managed databases.