Отличия реляционных и нереляционных баз данных
С обработкой и хранением данных сегодня связаны любые компьютерные работы. Одна информация может быть представлена в форме таблиц, иметь четкие, структурированные сведения, поданные в определенном формате. Другие же, описывают самые разные объекты, с произвольными характеристиками. Они не имеют структуры, четкого распределения, формата. Исходя из этого в IT-среде выделяют два варианта баз данных (БД): реляционные (SQL) и нереляционные (NoSQL). Говоря простым языком, первые – структурированные, а вторые – неструктурированные. Оба варианта жизнеспособны, но имеют кардинальные расхождения, которые надо учитывать в процессе выбора БД. Так в чем отличие реляционной базы от нереляционной и для решения каких задач лучше всего подходит каждая из них.
Чтобы ответить на этот вопрос, необходимо познакомиться более подробно с каждой из них.
Особенности реляционной базы данных
Система управления базами данных (СУБД) – передовое программное обеспечение высокого уровня, работающее с API низкого уровня. Под данным термином понимают всевозможные инструменты, начиная от компьютерных приложений и до встроенных библиотек. Если говорить о реляционной системе, то она помогает управлять большими объемами четко структурированных данных. Преимущественно представлена в табличной форме. В строках указываются записи, а в столбцах – типы данных. При этом информация вносится в таблицу согласно установленному шаблону.
Впервые реляционная модель вошла в использование в 70-е годы 20 века. Предполагала математический способ для структуризации, хранения и применения сведений. В таблицы записывалась основная информация (например, ФИО человека) и соответствующие ей значения (год рождения, возраст, пол, семейное положение, наличие/отсутствие детей и пр.). За годы существования на рынке она успела доказать свою эффективность, надежность, гарантируя высокую защиту информации от утраты. Наряду с жесткими требованиями к формированию данных и их обработки, SQL может быть наделена и гибкостью. Но обеспечить это свойство сможет только профессиональный подход и дополнительные усилия.
Среди особенностей реляционных БД стоит выделить два основных момента:
- Целостность сведений. Информация, которая помещается в данную систему отличается повышенной точностью, однообразностью и максимальной полнотой. Целостность SQL поддерживается специальными инструментами: внешние и первичные ключи, ограничители и пр. В частности, ограничитель «Default» позволяет применять рабочие правила ко всей информации, хранящейся в таблицах БД, гарантируя ее точность.
- Транзакции. В базе данных под этим термином подразумевают упорядоченную последовательность действий операторов, обрабатывающих информацию, направленную на переведение БД из одного состояния в другое. Реляционные базы данных – это цепочка последовательных операций, работающих над решением одной задачи. Все эти операторы должны выполняться одновременно и работать как единая система.
Соблюдать целостность в процессе каждой транзакции, реляционные базы данных должны быть:
- Атомарными. Это обязательное условие, обеспечивающее или полное выполнение операции или ее полную отмену в тому случае, если хотя бы одна из составных частей по ряду причин не может быть реализована.
- Изолированными. Только в этом случае появится возможность контролировать то, насколько согласованными будут реализуемые транзакции.
- Однообразными. Следуя такому требованию, вся информация, которая записывается в ходе одной операции, должна соответствовать одинаковым, стандартизированным требованиям и нормам.
- Надежными. Если потребуется внести изменения в базу данных, то они должны быть совершенными, а не гипотетическими.
Краткий итог: реляционные БД в работе используют язык структурированных запросов, при помощи которого обрабатывают данные и управляют ими. Он подходит для любых запросов в том числе и сложных, но есть и ограничения. В SQL применяются только схемы, заданные наперед, чем достигается высокая согласованность. Также требуется заранее определять структуру данных, подстраивая их к некому «стандарту». Реляционную базу можно масштабировать по вертикали, увеличивая нагрузку на каждый отдельный server. В результате повысится мощность центрального процессора, оперативной памяти, твердотельного диска.
В чем разница между реляционными и нереляционными базами данных?

В чем разница между реляционными и нереляционными базами данных?
Реляционные и нереляционные базы данных – два способа хранения данных для приложений. Реляционная база данных (или база данных SQL) хранит данные в табличном формате со строками и столбцами. Столбцы содержат атрибуты данных, а строки – значения данных. Можно связать таблицы в реляционной базе данных, чтобы глубже понять взаимосвязь между различными точками данных. С другой стороны, нереляционные базы данных (или базы данных NoSQL) используют различные модели данных для доступа к данным и управления ими. Они оптимизированы для приложений, которые работают с большим объемом данных, нуждаются в низкой задержке и гибких моделях данных. Все это достигается путем смягчения жестких требований к согласованности данных, характерных для других типов БД.
Как хранятся данные в реляционных базах данных?
Реляционные базы данных хранят данные в таблицах со столбцами и строками. Каждый столбец представляет определенный атрибут данных, а каждая строка – инстанс этих данных.
Каждой таблице присваивается первичный ключ – столбец идентификаторов, который уникально идентифицирует таблицу. Первичный ключ используется для установления связей между таблицами. Вы используете его для связывания строк между таблицами в качестве внешнего ключа в другой таблице.
После соединения двух таблиц вы получаете данные из обеих таблиц одним запросом. Вы пишете SQL-запросы для взаимодействия с реляционной базой данных.
Пример сохраненных данных
Например, представьте, что розничный продавец создает таблицу всех своих продуктов. В ней могут быть столбцы с названиями продуктов, описаниями и ценой. Другая таблица содержит данные о клиентах, их именах и приобретенных товарах.
Этот подход показан в следующих таблицах.
Product_id (первичный ключ)
Item_purchased (внешний ключ)
Как хранятся данные в нереляционных базах данных?
Существует несколько различных нереляционных систем баз данных в связи с различиями в способах работы и хранения данных без схем. Данные без схемы – это данные, которые хранятся без ограничений, необходимых для реляционных баз данных.
Далее мы расскажем о некоторых распространенных типах нереляционных баз данных.
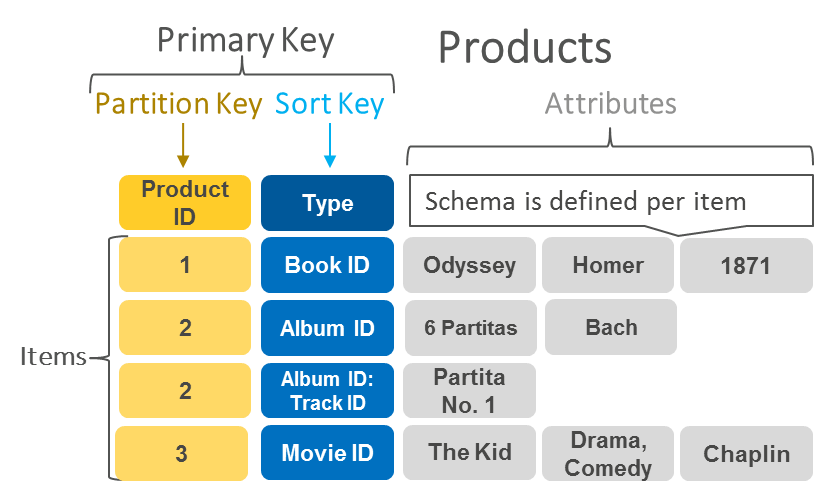
Базы данных на основе пар «ключ‑значение»
В базе данных «ключ-значение» данные хранятся в виде набора пар «ключ-значение». В паре ключ служит уникальным идентификатором. Как ключи, так и значения могут представлять собой что угодно: от простых до сложных составных объектов.
Базы данных документов
У баз данных документов тот же формат модели документа, который разработчики используют в коде своих приложений. Такие БД хранят данные в виде объектов JSON, которые являются гибкими, полуструктурированными и иерархическими по своей природе.
В следующем примере показано, как могут выглядеть сохраненные данные в базе данных документов.
industry: [«food processing», «appliances»]
Графовые базы данных
Графовые базы данных предназначены для хранения взаимосвязей и навигации в них. В таких базах данных используются узлы для хранения сущностей данных и ребра для хранения взаимосвязей между сущностями.
Ребро всегда имеет начальный узел, конечный узел, тип и направление. Ребра могут описывать, например, взаимосвязи типа «предок‑потомок», действия и права владения.

Ключевые отличия: реляционные и нереляционные базы данных
Реляционные и нереляционные базы данных хранят данные и управляют ими совершенно по-разному. В следующих разделах обсуждаются конкретные различия.
Структура
Реляционные базы данных хранят данные в табличной форме и следуют строгим правилам, касающимся вариаций данных и связей между таблицами. Они позволяют обрабатывать сложные запросы к структурированным данным, сохраняя целостность и согласованность данных.
Нереляционные базы данных более гибкие и удобные для данных с меняющимися требованиями. Их можно использовать для хранения изображений, видео, документов и другого полуструктурированного и неструктурированного контента.
Механизм целостности данных
Атомарность, непротиворечивость, изолированность, долговечность (ACID) – это возможности базы данных поддерживать целостность данных, несмотря на ошибки или перерывы в обработке данных.
Модель реляционной базы данных соответствует строгим свойствам ACID. Это означает, что набор последующих операций всегда будет выполняться вместе. Если одна операция не удалась, произойдет сбой всего набора операций. Таким образом гарантируется точность данных в любое время.
Напротив, нереляционные базы данных предлагают более гибкую модель базовой доступности, мягкого состояния и, в конечном итоге, согласованности (BASE).
Нереляционные базы данных гарантируют доступность, но не мгновенную согласованность. Состояние базы данных со временем может меняться и в конечном итоге становится неизменным. Некоторые нереляционные базы данных могут предлагать соответствие ACID за счет производительности или других условий.
Производительность
Производительность реляционных баз данных зависит от их дисковой подсистемы. Чтобы повысить производительность базы данных, можно использовать твердотельные накопители и оптимизировать диск, настроив его с помощью избыточного массива независимых дисков (RAID). Для достижения максимальной производительности необходимо также оптимизировать индексы, структуры таблиц и запросы.
Напротив, производительность баз данных NoSQL зависит от сетевой задержки, размера аппаратного кластера и вызывающего приложения. Существует несколько способов повысить производительность нереляционной базы данных:
- Увеличение размера кластера
- Минимизация сетевой задержки
- Индекс и кэш
Базы данных NoSQL обеспечивают более высокую производительность и масштабируемость для конкретных случаев использования по сравнению с реляционными базами данных.
Масштабирование
Жесткая схема реляционной системы баз данных может создавать проблемы при масштабировании. Обычно масштабирование выполняется по вертикали, добавляя к серверу больше ресурсов процессора или оперативной памяти. Можно также масштабировать по горизонтали путем дублирования данных между серверами для рабочих нагрузок, доступных только для чтения. Однако горизонтальное масштабирование рабочих нагрузок чтения и записи требует специальных стратегий, таких как поддержка разделов и сегментирование.
Напротив, базы данных NoSQL обладают высокой масштабируемостью. Их рабочую нагрузку можно легче распределить между несколькими узлами. Эти базы данных могут обрабатывать большие объемы данных, разбивая их на небольшие наборы и распределяя наборы по нескольким узлам.

Когда использовать реляционные, а когда – нереляционные базы данных
Реляционные базы данных – наилучший выбор, если ваши данные предсказуемы с точки зрения размера, структуры и частоты доступа. Вы также можете предпочесть систему управления реляционными базами данных, если взаимосвязи между сущностями важны. Например, если у вас есть большой набор данных со сложной структурой и взаимосвязями, вы хотите, чтобы связи были четко определены для аналитики и простоты использования.
Напротив, нереляционная модель лучше подходит для хранения гибких по форме и размеру данных, которые могут измениться в будущем.
Кроме того, в некоторых случаях взаимосвязи данных просто плохо вписываются в формат табличных первичных и внешних ключей. Например, чтобы смоделировать друзей и отношения в социальной сети, вам понадобится таблица с сотнями строк в реляционной базе данных.
Напротив, в нереляционной базе данных эти взаимосвязи могут быть представлены одной строкой. В следующем примере показаны записи данных участника с четырьмя друзьями в нереляционной базе данных.
Реляционные и нереляционные базы данных: какие выбрать?
Сегодня хотим обсудить «вечную» тему нынешнего века – эффективное и надёжное хранение данных. По исследованиям некоторых учёных, в год человечество генерирует данных больше, чем вся цивилизация с древнейших времён и до начала нашего столетия.
Куда нам столько и что делать с этой информацией? Кроме того, при таких объёмах встаёт вопрос не только хранения, но и извлечения данных. Поэтому мы решили вспомнить, какие способы для этого существуют и какой из них выбрать. Итак, начнём.
Эпоха электричества ознаменовала появление нового класса машин – компьютеров, которые позволили обрабатывать и хранить большое количество информации, ранее недоступное человеку.
Существенной вехой в истории развития вычислительных машин является появление категории «файлов».

Если рассмотреть понятие файла, оно заключается в том, что это некоторая область на устройстве хранения информации, имеющая своё название, из которой можно считывать данные и в которую их можно записывать.
Шестидесятые годы XX века являются рубежом, с которого начинается использование компьютеров не только в качестве исполнителей счётных задач, но и для обработки документов.
Для реализации вышеозначенной задачи требуется ввести новое понятие, так называемую «базу данных», суть которой сводится к некоторой совокупности организованно хранящейся информации.
Структура базы данных предполагает также взаимодействие между составляющими её различными элементами. Именно потребность в необходимости оперирования файлами привела к появлению надстройки над операционной системой – системы управления базами данных.
В этой статье мы рассмотрим системы управления базами данных, а также узнаем, что же представляют собой реляционные и нереляционные базы и в чём заключаются их особенности.
Ниже мы собрали список
основных пунктов, чтобы вам было проще ориентироваться по статье:
- Программное обеспечение для работы с современными базами данных
- Основные функции программного обеспечения баз данных
- Преимущества и недостатки СУБД
- Реляционные базы данных
- Нереляционные базы данных
- Как выбрать тип базы?
Программное обеспечение для работы с современными базами данных
В специализированной программе, которая использует для своего функционирования файл или файлы, за полноту и достоверность содержащихся данных обычно отвечал один человек. С появлением же потребности в использовании базы данных многими пользователями и многими специализированными программами появилась необходимость в отделении собственно хранения данных от самих прикладных программ, одновременно с необходимостью ведения их c требующимися полнотой, внесением нужных изменений и безопасностью.
Именно с этого момента начинает работу специализированный посредник, который берёт на себя функцию взаимодействия между конкретной прикладной программой и базой данных. Этот посредник получил название «система управления базами данных», или сокращенно ― СУБД.
СУБД представляет собой специальную программу, имеющую основной своей функцией создание, изменение и ведение базы данных некоторой совокупностью пользователей через прикладные программы.
Основные функции программного обеспечения баз данных
- Создание изначальной структуры базы данных;
- СУБД создаёт структуру базы данных в виде диалога, то есть последовательно получает от пользователя требующиеся ей данные. После чего производится начальное создание базы данных;
- Возможность модифицирования данных пользователем. Дальнейшая работа с базой данных через СУБД позволяет пользователям вносить новые данные, стирать их, производить различные выборки. Такие возможности даёт специальный язык программирования, графический интерфейс пользователя;
- Независимость прикладных программ от базы данных. Это позволяет изменять в некоторых пределах логическое представление базы данных, не меняя сам способ хранения; в то же время это позволяет производить некоторые изменения в базе данных, не вызывая необходимости поменять представление данных;
- Логическое единство базы данных. СУБД не позволит ввести цифру вместо буквы, неправильную дату и т. д.;
- Защита от повреждений в случае неправильного функционирования или повреждения ЭВМ – современные СУБД имеют средства резервного восстановления базы;
- Разграничение доступа пользователей в зависимости от категории. Современные СУБД имеют средства контроля доступа, которые позволяют пользователям иметь доступ только к тем данным, к которым они имеют право;
- Обеспечение одновременной работы нескольких пользователей. СУБД предоставляет средства одновременной работы, которые защищают целостность базы с помощью различных блокировок;
- Управление хранением. Так как база данных располагается в памяти компьютера, при работе с ней происходит освобождение определённых блоков и заполнение других. СУБД производит рациональное управление местом хранения;
- Поддержка деятельности администратора. Так как в процессе работы СУБД может потребоваться ввод новых данных технического типа: новое разграничение доступа, изменение структуры и т. д. СУБД предоставляет удобные средства, которые позволяют администратору производить все эти действия.
Преимущества и недостатки СУБД
- отслеживание отсутствия избыточности и согласованности данных;
- использование данных многими пользователями;
- сохранение структуры данных, то есть их целостности;
- обеспечение безопасности;
- стандартизация;
- увеличение эффекта от использования системы управления данными с ростом масштаба (т. е. ярко выраженный эффект масштаба);
- доступ к большим данным и их постоянная готовность к работе;
- повышение производительности работы;
- облегчение обслуживания системы, так как нет критической зависимости от какого-либо конкретного типа данных.
Но, несмотря на все ярко выраженные преимущества пользования системами управления базами данных, этот процесс также содержит определённый ряд сложностей, которые встают на пути.

Среди них можно перечислить:
- общее большое усложнение всей системы;
- дороговизна;
- материальное обеспечение (аппаратное);
- большие материальные затраты при сбое системы.
Реляционные базы данных
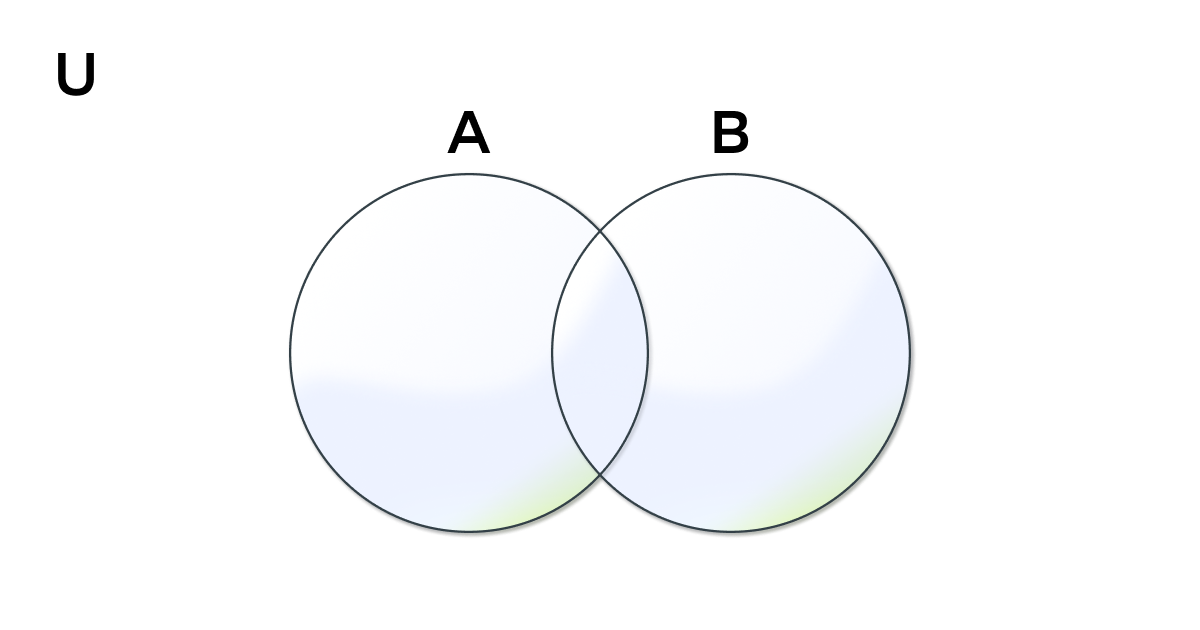
В последнее время большое распространение получила «реляционная модель», суть которой заключается в том, что основанная на математической теории множеств она рассматривает таблицы как отдельные множества, объединённые по определённому признаку, как показано на рисунке 1.
Для удобства представления и хранения система хранения данных в рамках реляционной модели обычно представляет собой совокупность таблиц, взаимосвязанных между собой определённым образом.
Таблица представляет собой плоскую двумерную сетку, которая содержит определённый тип или типы структурированных данных, например фильмы, группы крови, маршруты движения и т. д.
Если разбирать дальнейшее устройство любой таблицы, то она состоит из столбцов и строк.
Столбец таблицы представляет собой вертикальную область, выделенное свойство всех типологий, которые содержатся обычно в строках таблицы.
Строка таблицы представляет собой горизонтальную область, которая уникализирует типологию. Например, в строках таблицы могут содержаться фамилии, марки автомобилей, названия улиц и т. д.
Структурные элементы таблицы, из которых она состоит, взаимодействуют между собой, а также с другими структурными элементами других таблиц.
С ростом количества информации появилась необходимость в специальном языке, который бы оперировал данными и мог функционировать в абсолютно различающихся компьютерных системах таким образом, чтобы пользователи могли оперировать данными, составляя определённые запросы.
Отвечая на запросы времени, появился определённый язык, который получил название SQL – Structured Query Language (язык структурированных запросов), он был выпущен в 1986 году и к нынешнему времени фактически стал стандартом.
В качестве основных форм языка SQL можно назвать следующие:
- интерактивная;
- встроенная;
- динамическая;
- статическая.
Суть интерактивного SQL заключается в том, что пользователь базы данных может в интерактивном режиме использовать SQL-операторы.
Встроенный SQL позволяет интегрировать его операторы в код программы; в свою очередь, динамическая форма позволяет на лету генерировать операторы в процессе выполнения программ.
В отличие от перечисленных выше, статический представляет собой заранее определённые операторы в момент компиляции программы.
Если же говорить о достоинствах языка SQL, то среди них можно перечислить следующие:
- переносимость между различными платформами;
- стандартизированность;
- поддержка компанией IBM;
- поддержка компанией Microsoft;
- основан на реляционных принципах;
- высокоуровневая структура;
- может исполнять запросы интерактивно;
- может давать доступ к базам данных через программы;
- предоставляет все средства языка для удобного доступа к базам данных;
- поддержка различных архитектур;
- поддержка бизнес-приложений;
- наличие доступа к данным через сеть Интернет;
- интегрированность с языком Java.
Системы управления базами данных могут работать как в качестве серверной части, то есть реализовывать архитектуру «клиент-сервер», так и в виде настольной версии, то есть СУБД, работающей локально.
Серверная система управления базами данных занимается хранением и поддержкой, а также отвечает на поступающие от клиентов запросы.
Под клиентами подразумеваются любые компьютеры или приложения, которые обращаются к базе данных, используя специальный язык обращений.
Причём если мы говорим об архитектуре «клиент-сервер», то клиент может даже находиться в одной стране, а сервер – в другой. Здесь под клиентом понимается обычный компьютер, а под сервером – специализированная машина, достаточно мощная, чтобы хранить базы и обрабатывать множество запросов.
В качестве главного отличия любой настольной СУБД от серверной можно назвать то, что она работает локально и не может обрабатывать запросы, поступающие от других клиентов.
Если перечислить основные виды известных SQL-серверов, то среди них можно назвать: Microsoft SQL Server, Oracle, MySQL, Postgresql.
В свою очередь, системой, поддерживающей SQL и являющейся настольной, можно назвать Microsoft Access.
Нереляционные базы данных
Кроме традиционных баз (SQL), существует ещё другой способ хранения данных, получивший широкое распространение со второй половины двухтысячных годов, – нереляционные базы данных. Они отличаются от реляционных тем, что в них для хранения используется не система из строк и столбцов, а применяется модель, которая оптимизирована для хранения определённого типа содержимого. Например, данные могут храниться в виде документов JSON, графов, а также ключей-значений.
Кроме того, можно сказать, что нереляционные базы данных не используют язык запросов SQL, и вместо него запросы осуществляются с помощью иных языков и конструкций. Ниже рассмотрим, какие типы NoSQL баз данных бывают.
Такой тип оперирует набором данных объекта, которые называются документом. Они хранятся в полях, которые могут быть представлены различными форматами, среди которых можно назвать такие, как XML, JSON и т. д. Набор данных и их полнота зависят от целей конкретного применения.
Причём здесь важным моментом является то, что в отличие от реляционной модели хранения, где данные одного объекта могут быть распределены по разным таблицам, здесь они хранятся в одном документе, и этот тип хранения не требует, чтобы все документы имели одинаковую структуру, благодаря чему и достигается достаточно большая гибкость.
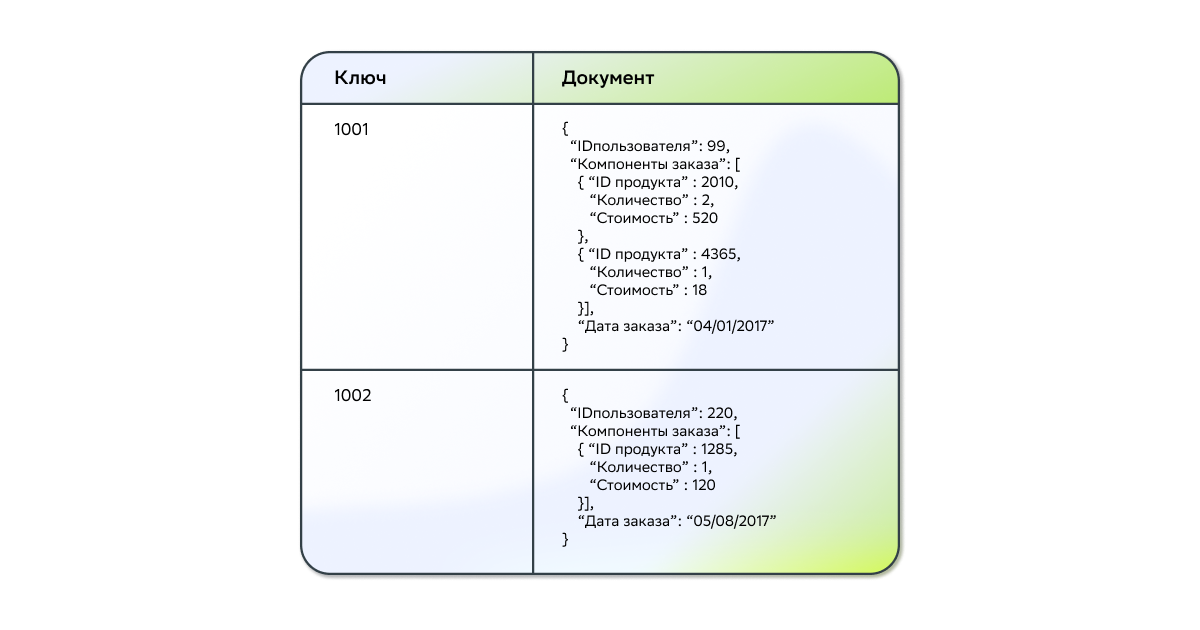
Для получения документов используется ключ документа, который представляет собой уникальную идентифицирующую сущность, благодаря которой можно получить доступ к конкретному документу.
Хранение данных в столбцах
Подобный тип хранения по своему виду очень сильно похож на реляционную базу данных – данные хранятся в столбцах, которые связаны и управляются как единое целое. В отличие от других типов хранения данных, при этой методике упорядочение данных происходит с помощью ключей, а не хэшей.
Хранение в виде «ключи-значения»
При таком способе хранения данные находятся в большой таблице, каждый набор данных обладает уникальным ключом. Подобный тип хранения можно использовать для применений, где используется поиск по ключам или диапазону ключей, но в то же время подобный тип хранения неудобен, если требуется осуществлять поиск и фильтрацию по значениям.
Хранилища содержимого графов
Данный тип хранилища представляет собой хранение данных, содержащихся в узлах, а также определяет связь между узлами. Подобные хранилища позволяют достаточно оперативно выполнять запросы, которые проходят через ряд узлов и рёбер, и производить анализ взаимосвязей между узлами.

Такие структуры позволяют производить поиск, например, «всех сотрудников, работающих в определённом отделе» либо «находящихся в подчинении определённого руководителя» и т. д.
Хранилища данных временных рядов
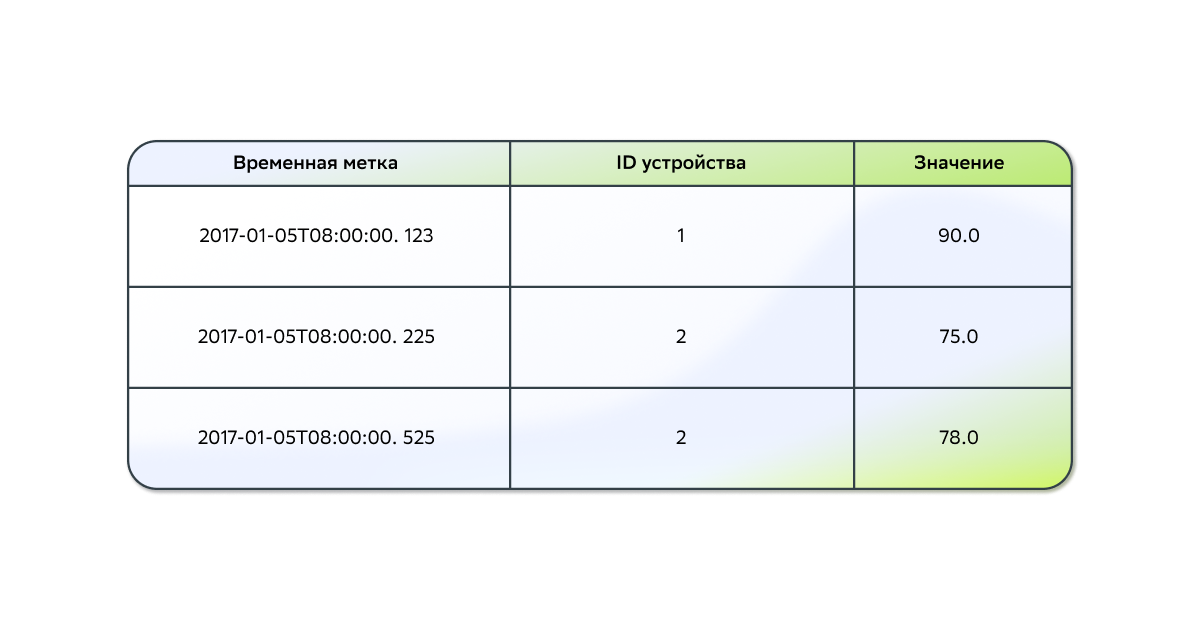
Этот тип хранилища используется для наборов значений, которые обладают небольшим весом и привязаны к определённым моментам времени. Обычно это данные телеметрии, например датчика или датчиков интернета вещей.
Подобного типа хранилища используются для сохранения и извлечения данных большого веса, в качестве которых могут выступать видеофайлы, изображения, файлы приложений и т. д. Само хранилище обладает, как правило, также достаточно большим объёмом, что позволяет ему хранить подобное содержимое.

Хранилище внешних индексов
Используется для индексированных данных других хранилищ, то есть подобный тип хранилища выступает в роли посредника, который ускоряет доступ к другим базам.
Как выбрать тип базы?
Как правило, реляционные базы выбирают для работы со сложными запросами и обработки рутинных задач. И здесь следует учесть вот что: SQL-базы масштабируются по вертикали, то есть с помощью увеличения нагрузки на отдельный конкретный сервер. В свою очередь, NoSQL-базы хорошо масштабируются по горизонтали за счёт увеличения количества серверов, что является весьма удобным при работе с большими объёмами данных, так называемыми Big Data.
Ещё одним интересным плюсом NoSQL является возможность хранения коллекций с различными атрибутами и полями, что позволяет за счёт отсутствия жёстких ограничений реализовывать поэтапную разработку. Также нереляционные базы хорошо справляются с задачами хранения недостаточно структурированных или же абсолютно неструктурированных данных.
Так как нереляционные базы, как правило, предназначены для доступа к ним с помощью конкретных шаблонов, они позволяют добиться более высоких показателей производительности, если сравнивать их с SQL-базами.
Среди некоторых из популярных нереляционных баз можно перечислить: MongoDB, Apache Cassandra, Couchbase.
Заключение
Компьютерная сфера вообще и технологии хранения данных в частности – это одна из тех сфер, которые претерпевают постоянные и очень быстрые изменения.
Сейчас, кроме реляционного способа хранения данных, появляются и развиваются и нереляционные способы, так называемые NoSQL. Потенциально данный способ при соответствующем подходе может дать большую производительность ввиду существенных отличий от реляционного подхода.
Нельзя дать однозначный ответ на вопрос, какой из типов баз является лучшим. Скорее следует руководствоваться комплексом нужных вам параметров: скорость доступа, тип данных, способ будущего масштабирования, наличие персонала, способного работать с этим типом баз и т. д.
В целом, для обеспечения эффективности могут быть выделены три основные составляющие:
- хранение данных должно происходить распределённо, то есть внутри сети, которая состоит из нескольких ЭВМ, несмотря на то, что сами файлы могут быть достаточно большими;
- необходимо создать такую схему хранения данных, которая обеспечит существенные преимущества по сравнению с традиционными реляционными базами данных, несмотря на то, что сами данные являются разреженными;
- схема обработки данных должна строиться так, чтобы они обрабатывались непосредственно на той машине, где и находятся. Это позволит избежать передачи огромного массива по сети и в конечном счёте поднимет производительность.
- хранение данных
- хранилища данных
- администрирование баз данных
Реляционные vs. нереляционные базы данных: отличия и преимущества
SQL или NoSQL — какую базу данных выбрать? В чем заключается их различие. Преимущества SQL и NoSQL. Сравнение и выводы.
24 Дек 2020 05:20  IT GIRL
 15
Post Views: 34 849
Реляционные vs. нереляционные базы данных: отличия и преимущества Блог 2020-12-24 ru Реляционные vs. нереляционные базы данных: отличия и преимущества
286 104
Boodet Online +7 (499) 649 09 90 123022 , Москва , ул. Рочдельская, дом 15, строение 15
286 104
Boodet Online +7 499 649 09 90 123022 , Москва , ул. Рочдельская, дом 15, строение 15
Поделиться
Поделиться
SQL vs NoSQL
Любые компьютерные вычисления связаны с обработкой данных. Они бывают структурированными и неструктурированными. Первые размещают в базах данных, где наравне с информацией хранится ее описание. Говоря о БД, часто можно встретить термины SQL и NoSQL. SQL — это методика обработки (язык, структура, действия), которая используется для того, чтобы проводить чтение и обработку реляционных и нереляционных (NoSQL) баз данных. Как это все работает и для чего нужно — объясняют специалисты Boodet.Online.
Понятие реляционных и нереляционных баз данных
Термин « реляционный » пришел из алгебры (теория множеств). В формате БД это значит, что данные реляционных баз хранятся в виде таблиц и строк. Нереляционные БД размещают информацию в коллекциях документов JSON. Реляционные БД используют язык SQL (структурированных запросов). Структура таких баз данных позволяет связывать информацию из разных таблиц с помощью внешних ключей (или индексов), которые используются для уникальной идентификации любого атомарного фрагмента данных в этой таблице. Другие таблицы могут ссылаться на этот внешний ключ, чтобы создать связь между частями данных и частью, на которую указывает внешний ключ. Зачем нужны нереляционные БД ? Их главное преимущество — высокий уровень безопасности и возможность обойти аппаратные ограничения (с помощью Sharding).
Различия SQL и NoSQL
SQL и NoSQL — это термины, которые описывают совершенно разные способы обработки данных. Чем они отличаются и почему это влияет на работу?
Язык
- ориентировать информацию на столбцы или документы;
- основывать ее на графике;
- организовывать в виде хранилища KeyValue;
- создавать документы без предварительного определения их структуры, использовать разный синтаксис;
- добавлять поля непосредственно в процессе обработки.
Структура
SQL основаны на таблицах, а NoSQL — на документах, парах ключ-значение, графовых БД, хранилищах с широкими столбцами.
Масштабируемость
В большинстве случаев базы данных SQL можно масштабировать по вертикали. Что это значит? Можно увеличить нагрузку на один сервер, увеличив таким образом ЦП, ОЗУ или объем накопителя.
В отличие от SQL базы данных NoSQL масштабируются по горизонтали. Это означает, что больший трафик обрабатывается путем разделения или добавления большего количества серверов. Это делает NoSQL удобнее при работе с большими или меняющимися наборами данных.
В каких случаях используют SQL?
SQL подойдет, если нужна обработка большого количества сложных запросов, или рутинного анализа данных. Выбирайте реляционную БД , если нужна надежная обработка транзакций и ссылочная целостность.
А в каких NoSQL?
Если объем данных большой, лучше использовать NoSQL . Отсутствие явных структурированных механизмов ускорит процесс обработки Big Data. А еще это безопаснее — такие БД сложнее взломать.
Выбирайте NoSQL , если:
- необходимо хранить массивы в объектах JSON;
- записи хранятся в коллекции с разными полями или атрибутами;
- необходимо горизонтальное масштабирование.
Самые распространенные реляционные базы данных
Для работы с реляционными БД лучше всего подойдут:
- MySQL;
- Oracle;
- Microsoft SQL Server.
MySQL
Бесплатный продукт с открытым исходным кодом от Oracle. Отличается стабильностью и хорошим тестированием обновлений до их внедрения. MySQL можно доработать под свои нужды или поискать готовые исправления в обширной библиотеке профильного сообщества.
MySQL работает с любыми ОС: Linux, Windows, Mac, BSD и Solaris. Дружит с Node.js, Ruby, C#, C++, Java, Perl, Python и PHP.
Базу данных MySQL можно реплицировать на несколько узлов, что уменьшает рабочую нагрузку при увеличении доступности приложения.
Oracle
Oracle Database часто используют крупные корпорации. Коммерческий вариант БД часто и грамотно обновляется, есть круглосуточная техническая поддержка.
Oracle применяет свой собственный диалект SQL (PL/SQL). Это дает возможность работать со встроенными функциями, процедурами и переменными. Так же, как и MySQL , работает с любыми операционными системами. Если проекту необходимо использовать реляционные БД для работы с Big Data, то Oracle станет хорошей альтернативой NoSQL благодаря особой организации СУБД — группировке объектов по схемам, которые являются подмножеством объектов.
Еще одно важное преимущество Oracle — возможность восстановления предыдущей версии БД. Помимо этого, есть индексация растровых изображений, секционирование, индексацию на основе функций и по обратному ключу, оптимизация приоритетных запросов.
Microsoft SQL Server
Microsoft SQL Server — это отличный вариант для малого и среднего бизнеса. Диалект T-SQL обрабатывает процедуры, встроенные функции и переменные. Есть важное ограничение: Microsoft SQL Server будет работать только с Linux или Windows. Простой интерфейс ускорит процесс миграции БД, если до этого вы пользовались другой системой.
Нереляционные базы данных
Согласно рейтингу Boodet.Online, самыми удобными системами для обработки нереляционных баз данных являются: MongoDB, Apache Cassandra и Google Cloud BigTable. У всех трех широкий функционал и высокий уровень гибкости.
MongoDB
MongoDB — это качественный бесплатный продукт, который чаще всего используют при работе с NoSQL . Решение позволяет менять схемы данных в процессе работы, масштабироваться по горизонтали. Интерфейс очень простой — в нем легко разберется любой сотрудник компании, не обязательно быть IT-профессионалом.
Почему мы поставили Mongo на первое место в списке лидеров обработки нереляционных баз данных ? Все дело в новой функции от разработчиков. Теперь в решении есть глобальная облачная БД, что дает возможность развернуть управляемую MongoDB через AWS, Azure, GCP.
Apache Cassandra
Apache Cassandra — это продукт с открытым исходным кодом, а значит, достаточно гибкий, адаптируемый практически для любых задач. Идентичность узлов упрощает масштабирование для наращивания архитектуры БД.
Apache Cassandra подойдет для масштабных проектов. Продукт обеспечивает высокую скорость чтения и записи. Даже если часть решения использует SQL, можно применить подобные SQL операторы: DDL, DML, SELECT. Для более высокого уровня безопасности есть резервное копирование и восстановление.
Apache Cassandra — это один из немногих инструментов обработки баз данных, который гарантирует безотказность работы (подробнее читайте в своем SLA).
Google Cloud BigTable
Неплохой продукт от Google, который гарантирует задержку обработки не более 10 мс. BigTable уделяют безотказности много внимания. Например, благодаря функции репликации базы данных более долговечны, доступны и устойчивы при зональных сбоях. Это отличный вариант для работы с Big Data в режиме реального времени (машинное зрение, AI) — можно изолировать рабочую нагрузку для приоритетной аналитики.
Так что же лучше?
Специалисты Boodet.Online работают с обоими вариантами баз данных. Основной критерий выбора: подходит ли приложение для решения конкретной задачи. Как мы определяем, что лучше для конкретного проекта:
- Если в БД есть предопределенная схема — используем SQL, если схема динамическая — NoSQL.
- Выбираем приоритетное направление масштабирования — по горизонтали или по вертикали.
- Определяем, что будет использоваться в задаче — неструктурированные данные или многострочные транзакции.
Выводы
Нельзя однозначно сказать, что лучше — SQL или NoSQL . Все зависит от конкретной задачи и типа данных. В некоторых случаях необходимо обработать оба типа БД — тогда рекомендуем выбирать гибридное решение, например, PostgreSQL (объектно-ориентированная СУБД).
Для подробной консультации и помощи в выборе СУБД для своего проекта обратитесь к специалистам Boodet.Online.