Можно ли восстановить исходники из data directory gitlab?

Сервер с gitlab не запускается. Бэкапов нет. Удалось достать с диска только папку /var/opt/gitlab В ней есть директория с репозиториями var/opt/gitlab/git-data/repositories. Структура папок в конкретном репозитории на картинке. Можно ли как то из этой директории получить исходники проектов?
Отслеживать
задан 19 авг 2020 в 17:05
59 5 5 бронзовых знаков
а покажите содержимое этого каталога (может внутренностей). Скорее всего там bare репозитории, а значит, их будет очень легко преобразовать в «нормальные» репозитории
19 авг 2020 в 18:13
Отредактируй вопрос и вставь туда эти данные. Ни черта не понятно же.
20 авг 2020 в 5:46
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
Так как там есть все необходимые файлы, похоже, что это исправный bare репозиторий (то есть, репозиторий без рабочего каталога, обычное дело на «сервере»). Но можно как всегда это конвертнуть в «нормальный вид».
- создайте каталог .git
- переместите туда все эти файлы и папки ( config , description , HEAD , objects и другие).
- запустите git config —local —bool core.bare false собственно для конвертации.
- запустите git reset —hard или ручками сделайте checkout для нужных веток.
странно, я там не вижу каталога branches, где хранятся ветки. Но если что то пойдет не так — можно будет создать.
ВНИМАНИЕ: это как раз тот случай, когда лучше не запускать никакие GUI утилиты до полного восстановления репозитория. Так как не видно каталога branches, для этих утилит может быть выглядеть как репозиторий с удаленными ветками и они могут радостно предложить Вам «почистит мусор» (у меня так было). Также не запускайте git gc ручками.
Также: в любом случае сделайте копию репозитория (или того, что от него осталось) и поместите в надежное место (например, на внешний диск).
4.8 Git на сервере — GitLab
GitWeb довольно-таки прост. Если вам нужен более современный, полнофункциональный Git-сервер, есть несколько решений с открытым исходным кодом, которые можно использовать. Так как GitLab это один из самых популярных, мы рассмотрим его установку и использование в качестве примера. Это немного сложнее, чем GitWeb, и скорее всего потребует больше обслуживания, но и функциональность гораздо богаче.
Установка
GitLab — это веб-приложение на основе базы данных, так что его установка немного сложней, чем у некоторых других серверов Git. К счастью, этот процесс хорошо документирован и поддерживается. GitLab настоятельно рекомендует установить GitLab на ваш сервер через официальный пакет Omnibus GitLab.
Другие варианты установки:
- GitLab Helm chart для использования с Kubernetes.
- Официальные образы GitLab для использования с Docker.
- Из исходных файлов.
- Облачный провайдер, такой как AWS, Google Cloud Platform, Azure, OpenShift или Digital Ocean.
Для получения дополнительной информации прочтите GitLab Community Edition (CE) readme.
Администрирование
Административный интерфейс GitLab доступен через веб. Просто направьте ваш браузер на имя или IP-адрес хоста, где установлен GitLab, и войдите как администратор. Имя пользователя по умолчанию admin@local.host , пароль по умолчанию 5iveL!fe (вас попросят изменить их при входе). Войдя, нажмите иконку «Административная зона» в меню справа и сверху.

Рисунок 50. Пункт «Административная зона» в меню GitLab
Пользователи
Пользователи в GitLab — это учётные записи, соответствующие людям. Пользовательские учётные записи не очень сложны; в основном это набор персональной информации, прикреплённый к имени. У каждого пользователя есть пространство имён, логически группирующее проекты данного пользователя. Если у пользователя jane есть проект project, адрес этого проекта будет http://server/jane/project .
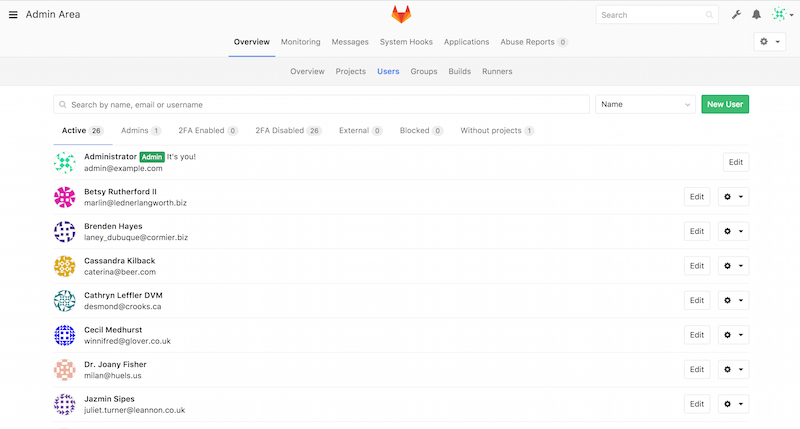
Рисунок 51. Экран управления пользователями GitLab
Удаление пользователя может быть выполнено двумя способами. «Блокирование» («Blocking») пользователя запрещает ему вход в GitLab, но все данные в его пространстве имен сохраняются, и коммиты, подписанные этим пользователем, будут указывать на его профиль.
«Разрушение» («Destroying») пользователя, с другой стороны, полностью удаляет его из базы данных и файловой системы. Все проекты и данные в его пространстве имен удаляются, как и все принадлежащие ему группы. Конечно, этим более постоянным и разрушительным действием пользуются реже.
Группы
Группы GitLab — это коллекция проектов с указанием того, как пользователи получают к ним доступ. Каждая группа имеет пространство имён проектов (так же как и пользователи), так что если в группе training есть проект materials, его адрес будет http://server/training/materials .
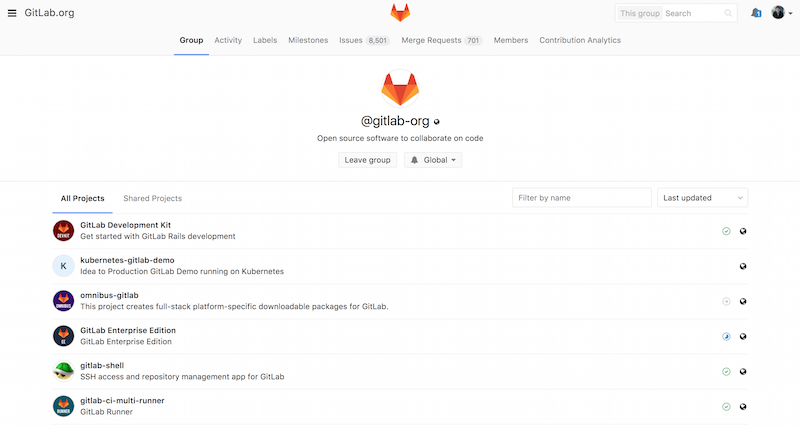
Рисунок 52. Экран управления группами GitLab
Каждая группа связана с пользователями, каждый из которых имеет уровень доступа к проектам группы и к самой группе. Он разнится от «Гостя» («Guest», только проблемы и чат) до «Владельца» («Owner», полный контроль над группой, её членами и проектами). Типы разрешений слишком обширны, чтобы перечислять их здесь, но на экране управления GitLab есть полезная ссылка с описанием.
Проекты
Проект GitLab примерно соответствует одному git-репозиторию. Каждый проект принадлежит одному пространству имён, групповому или пользовательскому. Если проект принадлежит пользователю, владелец контролирует, кто имеет доступ к проекту; если проект принадлежит группе, действуют групповые уровни доступа для пользователей.
Каждый проект также имеет уровень видимости, который контролирует, кто имеет доступ на чтение страниц проекта или репозитория. Если проект Приватный (Private), владелец должен явно дать доступ на чтение отдельным пользователям. Внутренний (Internal) проект виден любому вошедшему пользователю GitLab, а Публичный (Public) проект видим всем. Это относится как к доступу git fetch , так и к доступу к проекту через веб-интерфейс.
Хуки
GitLab включает поддержку хуков (перехватчиков, hooks) на уровне проектов и всей системы. В обоих случаях, когда происходит некоторое событие, сервер GitLab выполняет запрос HTTP POST с осмысленным JSON-содержанием. Это отличный способ соединить ваши git-репозитории и инсталляцию GitLab с автоматикой инфраструктуры разработки, такой как сервера непрерывной интеграции, комнаты чатов или инструменты деплоя.
Базовое использование
Первое, чего вы захотите от GitLab, это создать новый проект. Это достигается нажатием иконки «+» на панели инструментов. Будут запрошены имя проекта, пространство имён, которому он должен принадлежать, и уровень видимости. Большинство из этих настроек можно потом изменить через интерфейс настроек. Нажмите «Создать проект» («Create Project»), чтобы закончить.
Когда проект создан, вы, наверное, захотите соединить его с локальным git-репозиторием. Каждый проект может быть доступен через HTTPS или SSH, каждый из которых может быть использован для указания удалённого репозитория. Адреса (URL) видимы наверху домашней страницы проекта. Для существующего локального репозитория, следующая команда создаст удалённый репозиторий с именем gitlab и размещением на сервере:
$ git remote add gitlab https://server/namespace/project.gitЕсли у вас нет локального репозитория, можно просто сделать его:
$ git clone https://server/namespace/project.gitВеб-интерфейс даёт доступ к нескольким полезным видам самого репозитория. Домашняя страница каждого проекта показывает недавнюю активность, а ссылки наверху ведут на список файлов проекта и журнала коммитов.
Совместная работа
Самый простой метод совместной работы над проектом GitLab — это выдача другому пользователю прямого доступа на запись (push) в git-репозитории. Вы можете добавить пользователя в проект в разделе «Участники» («Members») настроек проекта, указав уровень доступа (уровни доступа кратко обсуждались в Группы). Получая уровень доступа «Разработчик» («Developer») или выше, пользователь может беспрепятственно отсылать свои коммиты и ветки непосредственно в репозиторий.
Другой, более разобщённый способ совместной работы — использование запросов на слияние (merge requests). Эта возможность позволяет любому пользователю, который видит проект, вносить свой вклад подконтрольным способом. Пользователи с прямым доступом могут просто создать ветку, отослать в неё коммиты и открыть запрос на слияние из их ветки обратно в master или любую другую ветку. Пользователи без доступа на запись могут «форкнуть» репозиторий («fork», создать собственную копию), отправить коммиты в эту копию и открыть запрос на слияние из их форка обратно в основной проект. Эта модель позволяет владельцу полностью контролировать, что попадает в репозиторий и когда, принимая помощь от недоверенных пользователей.
Запросы на слияние и проблемы (issues) это основные единицы долгоживущих дискуссий в GitLab. Каждый запрос на слияние допускает построчное обсуждение предлагаемого изменения (поддерживая облегчённое рецензирование кода), равно как и общее обсуждение. И те и другие могут присваиваться пользователям или организовываться в вехи (milestones).
Мы в основном сосредоточились на частях GitLab, связанных с git, но это — довольно зрелая система, и она предоставляет много других возможностей, помогающих вашей команде работать совместно, например вики-страницы для проектов и инструменты поддержки системы. Одно из преимуществ GitLab в том, что, однажды запустив и настроив сервер, вам редко придётся изменять конфигурацию или заходить на него по SSH; большинство административных и пользовательских действий можно выполнять через веб-браузер.
Структура директорий Gitlab
В доках gitlab указывается наличие директории /home/git, в которой располагается часть структуры проекта.
Однако, после установки gitlab директорий не появилось.
Связано ли это с тем, что в системе ужу есть пользователь git и /home/git — его домашняя директория?
kukuruku11
17.01.17 15:35:32 MSK
Omnibus или сырцы?
blackst0ne ★★★★★
( 17.01.17 16:03:22 MSK )
Ответ на: комментарий от blackst0ne 17.01.17 16:03:22 MSK
kukuruku11
( 17.01.17 16:39:05 MSK ) автор топика
Ответ на: комментарий от kukuruku11 17.01.17 16:39:05 MSK
pztrn ★★★★
( 17.01.17 17:24:42 MSK )
Ответ на: комментарий от pztrn 17.01.17 17:24:42 MSK
А репозитории проектов?
kukuruku11
( 17.01.17 17:33:55 MSK ) автор топика
Ответ на: комментарий от kukuruku11 17.01.17 17:33:55 MSK
по-моему их можно хранить в любой папке, задаваемой в конфиге. я вроде делал ~/.git вместо /home/git как в туториале, но это было много лет назад, давно не пользуюсь
anonymous
( 18.01.17 07:37:15 MSK )
Ответ на: комментарий от anonymous 18.01.17 07:37:15 MSK
да, так и есть. уже разобрался, репозитории хранятся по этому пути
/var/opt/gitlab/git-data/repositories изменить путь можно настройкой конфига
git_data_dirs 10.7 Git изнутри — Обслуживание репозитория и восстановление данных
Изредка вам потребуется делать «уборку» — сделать репозиторий более компактным, очистить импортированный репозиторий от лишних файлов или восстановить потерянные данные. Данный раздел охватывает некоторые из этих сценариев.
Обслуживание репозитория
Время от времени Git выполняет автоматическую сборку мусора. Чаще всего эта команда ничего не делает. Однако, если у вас накопилось слишком много «рыхлых» объектов (не в pack-файлах), или, наоборот, отдельных pack-файлов, Git запускает полноценный сборщик — git gc (здесь «gc» это сокращение от «garbage collect», что означает «сборка мусора»). Эта команда выполняет несколько действий: собирает все «рыхлые» объекты и упаковывает их в pack-файлы; объединяет несколько упакованных файлов в один большой; удаляет недостижимые объекты, хранящиеся дольше нескольких месяцев.
Сборку мусора можно запустить вручную следующим образом:
$ git gc --autoОпять же, как правило, эта команда ничего не делает. Нужно иметь примерно 7000 несжатых объектов или более 50 pack-файлов, чтобы запустился настоящий gc . Эти значения можно изменить с помощью параметров gc.auto и gc.autopacklimit соответственно.
Ещё одно действие, выполняемое gc — упаковка ссылок в единый файл. Предположим, репозиторий содержит следующие ветки и теги:
$ find .git/refs -type f .git/refs/heads/experiment .git/refs/heads/master .git/refs/tags/v1.0 .git/refs/tags/v1.1Если выполнить git gc , эти файлы будут удалены из каталога refs . Git перенесёт их в файл .git/packed-refs в угоду эффективности:
$ cat .git/packed-refs # pack-refs with: peeled fully-peeled cac0cab538b970a37ea1e769cbbde608743bc96d refs/heads/experiment ab1afef80fac8e34258ff41fc1b867c702daa24b refs/heads/master cac0cab538b970a37ea1e769cbbde608743bc96d refs/tags/v1.0 9585191f37f7b0fb9444f35a9bf50de191beadc2 refs/tags/v1.1 ^1a410efbd13591db07496601ebc7a059dd55cfe9При обновлении ссылки Git не будет редактировать этот файл, а добавит новый файл в refs/heads . Для получения хеша, соответствующего нужной ссылке, Git сначала проверит наличие файла ссылки в каталоге refs , а к файлу packed-refs обратится только в случае отсутствия оного. Так что, если вы не можете найти ссылку в каталоге refs , скорее всего она упакована в файле packed-refs .
Обратите внимание, последняя строка файла начинается с ^ . Это означает, что предыдущая строка является аннотированным тегом, а текущая строка — это коммит, на который указывает аннотированный тег.
Восстановление данных
В какой-то момент при работе с Git вы можете нечаянно потерять коммит. Как правило, такое случается, когда вы удаляете ветку, в которой находились некоторые наработки, а потом оказывается, что они всё-таки были нужными; либо вы выполнили git reset —hard , тем самым отказавшись от коммитов, которые затем понадобились. Как же в таком случае вернуть свои коммиты обратно?
Ниже приведён пример, в котором мы сбрасываем ветку master с потерей данных до более раннего состояния, а затем восстанавливаем потерянные коммиты. Для начала, давайте посмотрим, как сейчас выглядит история изменений:
$ git log --pretty=oneline ab1afef80fac8e34258ff41fc1b867c702daa24b Modify repo.rb a bit 484a59275031909e19aadb7c92262719cfcdf19a Create repo.rb 1a410efbd13591db07496601ebc7a059dd55cfe9 Third commit cac0cab538b970a37ea1e769cbbde608743bc96d Second commit fdf4fc3344e67ab068f836878b6c4951e3b15f3d First commitТеперь сбросим ветку master на третий коммит:
$ git reset --hard 1a410efbd13591db07496601ebc7a059dd55cfe9 HEAD is now at 1a410ef Third commit $ git log --pretty=oneline 1a410efbd13591db07496601ebc7a059dd55cfe9 Third commit cac0cab538b970a37ea1e769cbbde608743bc96d Second commit fdf4fc3344e67ab068f836878b6c4951e3b15f3d First commitИтак, теперь два последних коммита по-настоящему потеряны — они не достижимы ни из одной ветки. Необходимо найти SHA-1 хеш последнего коммита и создать ветку, указывающую на него. Сложность в том, чтобы узнать этот самый SHA-1, ведь вряд ли вы его запомнили, да?
Зачастую самый быстрый способ — использование команды git reflog . Дело в том, что во время вашей работы Git записывает все изменения HEAD. Каждый раз при переключении веток и коммитов изменений, добавляется запись в reflog. reflog также обновляется командой git update-ref — это, кстати, хорошая причина использовать именно эту команду, а не вручную записывать SHA-1 в ref-файлы, как было показано в Ссылки в Git. Вы можете посмотреть где находился указатель HEAD в любой момент времени, запустив git reflog :
$ git reflog 1a410ef HEAD@: reset: moving to 1a410ef ab1afef HEAD@: commit: Modify repo.rb a bit 484a592 HEAD@: commit: Create repo.rbЗдесь мы видим два коммита, на которые когда-то указывал HEAD, однако информации не так уж и много. Для получения информации в более удобном виде, можно воспользоваться командой git log -g , которая выведет лог записей из reflog в привычном формате:
$ git log -g commit 1a410efbd13591db07496601ebc7a059dd55cfe9 Reflog: HEAD@ (Scott Chacon ) Reflog message: updating HEAD Author: Scott Chacon Date: Fri May 22 18:22:37 2009 -0700 Third commit commit ab1afef80fac8e34258ff41fc1b867c702daa24b Reflog: HEAD@ (Scott Chacon ) Reflog message: updating HEAD Author: Scott Chacon Date: Fri May 22 18:15:24 2009 -0700 Modify repo.rb a bitПохоже, что последний коммит — это и есть тот, который мы потеряли; его можно восстановить, создав новую ветку, указывающую на него. Например, создадим новую ветку с именем recover-branch , указывающую на этот коммит ( ab1afef ):
$ git branch recover-branch ab1afef $ git log --pretty=oneline recover-branch ab1afef80fac8e34258ff41fc1b867c702daa24b Modify repo.rb a bit 484a59275031909e19aadb7c92262719cfcdf19a Create repo.rb 1a410efbd13591db07496601ebc7a059dd55cfe9 Third commit cac0cab538b970a37ea1e769cbbde608743bc96d Second commit fdf4fc3344e67ab068f836878b6c4951e3b15f3d First commitОтлично — теперь у нас есть ветка recover-branch , указывающая туда, куда ранее указывала ветка master , тем самым делая потерянные коммиты вновь доступными. Теперь предположим, что потерянные изменения отсутствуют в reflog — для симуляции такого состояния удалим восстановленную ветку и очистим reflog.
$ git branch -D recover-branch $ rm -Rf .git/logs/В этом случае два первых коммита недоступны ниоткуда. Так как данные reflog хранятся в каталоге .git/logs/ , которую мы только что удалили, то теперь у нас нет reflog. Как теперь восстановить коммиты? Один из вариантов — использование утилиты git fsck , проверяющую внутреннюю базу данных на целостность. Если выполнить её с ключом —full , будут показаны все объекты, недостижимые из других объектов:
$ git fsck --full Checking object directories: 100% (256/256), done. Checking objects: 100% (18/18), done. dangling blob d670460b4b4aece5915caf5c68d12f560a9fe3e4 dangling commit ab1afef80fac8e34258ff41fc1b867c702daa24b dangling tree aea790b9a58f6cf6f2804eeac9f0abbe9631e4c9 dangling blob 7108f7ecb345ee9d0084193f147cdad4d2998293В нашем случае потерянный коммит указан после слов «dangling commit» («висячий коммит»). Его можно восстановить аналогичным образом, создав новую ветку, указывающую на этот SHA-1.
Удаление объектов
Git — замечательный инструмент с кучей классных возможностей, но некоторые из них способны стать источником проблем; например, команда git clone загружает проект вместе со всей историей, включая все версии всех файлов. Это нормально, если в репозитории хранится только исходный код, так как Git хорошо оптимизирован под такой тип данных и может эффективно сжимать их. Однако, если когда-либо в проект был добавлен большой файл, каждый, кто потом захочет клонировать проект, будет вынужден скачивать этот файл, даже если он был удалён в следующем коммите. Он будет в базе всегда, просто потому, что он доступен в истории.
Это может стать большой проблемой при конвертации Subversion или Perforce репозиториев в Git. В этих системах вам не нужно загружать всю историю, поэтому добавление больших файлов не имеет там особых последствий. Если при импорте из другой системы или при каких-либо других обстоятельствах стало ясно, что ваш репозиторий намного больше, чем он должен быть, то как раз сейчас мы расскажем, как можно найти и удалить большие объекты.
Предупреждаем: дальнейшие действия переписывают историю изменений. Каждый коммит, начиная с самого раннего, из которого нужно удалить большой файл, будет переписан. Если сделать это непосредственно после импорта, пока никто ещё не работал с репозиторием, то всё окей, иначе придётся сообщить всем участникам о необходимости перебазирования их правок относительно ваших новых коммитов.
Для примера добавим большой файл в тестовый репозиторий, удалим его в следующем коммите, а потом найдём и удалим его полностью из базы. Сначала добавим большой файл в нашу историю:
$ curl https://www.kernel.org/pub/software/scm/git/git-2.1.0.tar.gz > git.tgz $ git add git.tgz $ git commit -m 'Add git tarball' [master 7b30847] Add git tarball 1 file changed, 0 insertions(+), 0 deletions(-) create mode 100644 git.tgzУпс, мы нечаянно. Нам лучше избавиться от этого файла:
$ git rm git.tgz rm 'git.tgz' $ git commit -m 'Oops - remove large tarball' [master dadf725] Oops - remove large tarball 1 file changed, 0 insertions(+), 0 deletions(-) delete mode 100644 git.tgzТеперь запустим сборщик мусора и посмотрим, сколько места сейчас используется:
$ git gc Counting objects: 17, done. Delta compression using up to 8 threads. Compressing objects: 100% (13/13), done. Writing objects: 100% (17/17), done. Total 17 (delta 1), reused 10 (delta 0)Чтобы быстро узнать, сколько места занято, можно воспользоваться командой count-objects :
$ git count-objects -v count: 7 size: 32 in-pack: 17 packs: 1 size-pack: 4868 prune-packable: 0 garbage: 0 size-garbage: 0Строка size-pack — это размер pack-файлов в килобайтах, то есть всего занято почти 5 MБ. Перед последним коммитом использовалось около 2 КБ — очевидно, удаление файла не удалило его из истории. Всякий раз, когда кто-либо захочет клонировать этот репозиторий, ему придётся скачивать все 5 МБ для того, чтобы заполучить этот крошечный проект, просто потому, что однажды вы имели неосторожность добавить большой файл. Давайте же исправим это!
Для начала найдём проблемный файл. В данном случае, мы уже знаем, что это за файл. Но если бы не знали, как можно было бы определить, какие файлы занимают много места? При вызове git gc все объекты упаковываются в один pack-файл, но, несмотря на это, определить самые крупные файлы можно, запустив служебную команду git verify-pack и отсортировав её вывод по третьей колонке, в которой записан размер файла. Так как нас интересуют самые крупный файлы, оставим три последние строки с помощью tail :
$ git verify-pack -v .git/objects/pack/pack-29…69.idx \ | sort -k 3 -n \ | tail -3 dadf7258d699da2c8d89b09ef6670edb7d5f91b4 commit 229 159 12 033b4468fa6b2a9547a70d88d1bbe8bf3f9ed0d5 blob 22044 5792 4977696 82c99a3e86bb1267b236a4b6eff7868d97489af1 blob 4975916 4976258 1438Большой объект внизу списка, его размер — 5 МБ. Для того чтобы узнать, что это за файл, воспользуемся командой rev-list , которая уже упоминалась в разделе Проверка формата сообщения коммита главы 8. Если передать ей ключ —objects , она выдаст хеши всех коммитов, а также хеши объектов и соответствующие им имена файлов. Воспользуемся этим для определения имени выбранного объекта:
$ git rev-list --objects --all | grep 82c99a3 82c99a3e86bb1267b236a4b6eff7868d97489af1 git.tgzТеперь необходимо удалить данный файл из всех деревьев в прошлом. Легко получить все коммиты, которые изменяли данный файл:
$ git log --oneline --branches -- git.tgz dadf725 Oops - remove large tarball 7b30847 Add git tarballДля полного удаления этого файла из истории необходимо переписать все коммиты, начиная с 7b30847 . Воспользуемся командой filter-branch , о которой мы писали в разделе Перезапись истории главы 7:
$ git filter-branch --index-filter \ 'git rm --ignore-unmatch --cached git.tgz' -- 7b30847^.. Rewrite 7b30847d080183a1ab7d18fb202473b3096e9f34 (1/2)rm 'git.tgz' Rewrite dadf7258d699da2c8d89b09ef6670edb7d5f91b4 (2/2) Ref 'refs/heads/master' was rewrittenОпция —index-filter похожа на —tree-filter , использовавшуюся в разделе Перезапись истории главы 7, за исключением того, что вместо передачи команды, модифицирующей файлы на диске, мы используем команду, изменяющую файлы в индексе.
Вместо удаления файла чем-то вроде rm file , мы используем git rm —cached , так как нам надо удалить файл из индекса, а не с диска. Причина, по которой мы делаем именно так — скорость: нет необходимости извлекать каждую ревизию на диск, чтобы применить фильтр, а это может очень сильно ускорить процесс. Если хотите, можете использовать и tree-filter для получения аналогичного результата. Опция —ignore-unmatch команды git rm отключает вывод сообщения об ошибке в случае отсутствия файлов, соответствующих шаблону. Ещё один момент: мы указали команде filter-branch переписывать историю, начиная с коммита 7b30847 , потому что мы знаем, что именно в нём впервые появилась проблема. По умолчанию перезапись начинается с самого первого коммита, что потребовало бы гораздо больше времени.
Теперь история не содержит ссылок на данный файл. Однако, в reflog и в новом наборе ссылок, добавленном Git в .git/refs/original после выполнения filter-branch , ссылки на него всё ещё присутствуют, поэтому необходимо их удалить, а затем переупаковать базу. Необходимо избавиться от всех возможных ссылок на старые коммиты перед переупаковкой:
$ rm -Rf .git/refs/original $ rm -Rf .git/logs/ $ git gc Counting objects: 15, done. Delta compression using up to 8 threads. Compressing objects: 100% (11/11), done. Writing objects: 100% (15/15), done. Total 15 (delta 1), reused 12 (delta 0)Проверим, сколько места удалось освободить:
$ git count-objects -v count: 11 size: 4904 in-pack: 15 packs: 1 size-pack: 8 prune-packable: 0 garbage: 0 size-garbage: 0Размер упакованного репозитория сократился до 8 КБ, что намного лучше, чем 5 МБ. Из значения поля size видно, что большой объект всё ещё хранится в одном из ваших «рыхлых» объектов, но, что самое главное, при любой последующей отправке данных наружу (а значит и при последующих клонированиях репозитория) он передаваться не будет. Если очень хочется, можно удалить его навсегда локально, выполнив git prune —expire :
$ git prune --expire now $ git count-objects -v count: 0 size: 0 in-pack: 15 packs: 1 size-pack: 8 prune-packable: 0 garbage: 0 size-garbage: 0