При архивации маленькие файлы увеличиваются в размере
Реализовываю многопоточный архиватор файл на .Net с помощью GzipStream (.Net 3.5.). Есть проблема со сжатием маленьких и плохо поддающихся сжатию файлов — после архивации увеличиваются в размерах. Так файл весом в 3 кб после архивации весит 124 кб. При переходе на Net 4.5.2. файл после архивации весит 23 кб(Подозреваю из-за того, что GzipStream в этой версии пользуется улучшенными алгоритмами для сжатия). Проблема видимо связана с тем, что при сжатии в файл пишутся метаданные, которые весят больше, чем содержимое файла. 2 вопроса: действительно ли проблема в метаданных, или есть что-то еще не учтенное; можно ли как-то обойти возникшую проблему, чтобы небольшие файлы не разрастались до таких размеров?
Отслеживать
задан 15 авг 2018 в 7:20
263 1 1 серебряный знак 10 10 бронзовых знаков
Посмотрите тут очень похожий вопрос — stackoverflow.com/questions/34894231/… Проблема не совсем в метаданных, скорее в алгоритме сжатия.
17 авг 2018 в 9:42
Покажите ваш код с использованием GzipStream
17 авг 2018 в 11:06
17 авг 2018 в 11:13
Попробуйте использовать LZMA2 формат. У него лучше обстоят дела с плохо сжимаемыми файлами и файлами малого размера.
17 авг 2018 в 15:40
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
GZIP обеспечивает сжатие без потерь, иными словами, исходные данные можно полностью восстановить при распаковке. Он основан на алгоритме DEFLATE, который использует комбинацию алгоритма LZ77 и алгоритма Хаффмана. источник
Сжатие выполняется даже в том случае, если сжатый файл превышает исходный по размеру. Самый неблагоприятный результат – увеличение на несколько байтов, используемых для заголовка файла gzip, плюс на 5 байтов на каждый блок из 32 КБ либо, для крупных файлов, увеличение на 0,015%. При сжатии и распаковке утилита gzip сохраняет данные о режиме и принадлежности, а также временные метки файлов. источник
LZ77 заменяет все вхождения ранее встречавшихся строк на «направления». Направления — это кортеж (длина, растояние). Растояние — как далеко назад на входе была строка и длина — склолько байт было сопоставлено. Минимальная длина 3, максимальная 258. Самая далекая дистанция — 32КБ. Вторым этапом все эти кортежи сжимаются алгоритмом Хаффмана
Т.е. если у вас размер файла в 3Кб то в зависимости от его структуры результат сжатия очень сложно предсказать, и то что добавит gzip к файлу, чтобы выполнить сжатие, вполне вероятно будет больше размера самого файла.
Обойти это используя gzip наверное никак невозможно это его особенность, может только объединив все мелкие файлы в один большой чтобы улучшить сжатие (tar).
При сохранении файла он стал zip почему
Ко мне обратился пользователь с проблемой: он не может найти у себя на компьютере Excel документ в который вносил изменения.
Разбор «полётов» показал шаги, которые он выполнял:
1. Excel документ был открыт из .zip архива (см. рисунок-1 и рисунок-2) и в него начал вносить изменения;
2. После завершения работы с документом, пользователь нажал Сохранить внесённые изменения в Excel (см. рисунок-3)
3. Далее он попытался закрыть .zip архив и программа его спросила о дополнительных действиях, на что он не обдуманно отказался от внесения изменений в архив (см. рисунок-4).
В итоге, работа за целый день в .zip архив не попала.
В подобных случаях при работе с документами, которые открыты из архива на локальном диске создаётся временная копия в папке Temp по следующему пути:
C:\Users\Имя_Пользователя\AppData\Local\Temp\Название_Временной_Папки\excel_документ.xlsx
Когда Excel документ закрывается, временная папка удаляется вместе с excel документом в который были внесены изменения.
Для восстановления удалённых файлов есть программа R-Studio, с помощью которой я принялся искать удалённые файлы. Однако, к моему большому удивлению, я не смог найти этот временный excel документ.
Я решил повторить шаги пользователя, чтобы убедиться: программа R-Studio должна видеть и восстанавливать временные документы, которые автоматически удаляются после сохранения. Как оказалось, я был прав — программа действительно увидела временный файл, созданный мною и который был автоматически удалён excel когда я закончил с ним работать. После чего мне удалось восстановить документ.
Но проблема заключается в том, что я не могу в папке Temp найти временный файл с которым работал пользователь и, как следствие, восстановить его.
Возможно, я не там ищу? Мне бы только знать где искать временный файл!
Заранее всем спасибо за ответы.
Файлы удалены: превышение дпустимого размера вложения [МОДЕРАТОР]
Прикрепленные файлы
- 4.png (84.35 КБ)
5 методов исправления проблемы «zip-файлы» недействителен
У вас zip-файл показывает ошибку при открытии? Окно открывается с сообщением о недействительном zip-файле? Вас расстраивает потеря данных? Тогда вот ваше решение для всех этих сообщений о недействительных файлах zip.
100% безопасность | Без вредоносных программ | Без рекламы
Дмитрий Соловьев
2022-05-09 10:31:30 • Обновлено: Восстановление файлов • Проверенные решения
Что делать, если я нажимаю, чтобы открыть свой zip-файл, и сталкиваюсь с ошибкой «zip-файл недействителен»?
Иногда из-за определенных вирусов в устройстве, проблем с безопасностью, связанных с MS Office, или если загружаемый файл поврежден, на экране появляется сообщение об ошибке, а именно zip-файл недействителен.
Файл в формате Zip представляет собой файл расширения, который представляет собой сжатую форму данных и широко используется для хранения информации. Как и все другие доступные форматы файлов, это набор из одной или нескольких папок с файлами, которые сжаты в одну, чтобы упростить транспортировку и сжатие. Формат Zip обычно используется для загрузки программного обеспечения. Заархивирование программного обеспечения позволяет экономить место на сервере, сокращая время загрузки файлов и упорядочивая информацию о сотнях или тысячах файлов в одном Zip-файле.
Теперь здесь вы узнаете о проблеме с недействительным zip-файлом и способе ее решения!
- Часть 1. Что вызывает ошибку недействительного zip-файла?
- Часть 2: Переустановка Клиента Сжатия
- Часть 3. Использование другого бесплатного ПО для сжатия
- Часть 4. Заархивируйте на диск, использующий NTFS
- Часть 5. Запустите CMD для исправления/восстановления поврежденных или недействительных ZIP-файлов
- Часть 6. Восстановление недействительных/поврежденных файлов .Zip с помощью Stellar File Repair
Отдельные файлы, также называемые «архивами», называются zip-файлами, поскольку они содержат сжатый один или несколько файлов. Это упрощает хранение информации в организованном порядке, что облегчает транспортировку, загрузку, совместное использование и хранение данных. ZIP-файлы делают все процессы более быстрыми и эффективными, что делает его самым популярным форматом, используемым для сжатия файлов, используемых в Windows, а самой популярной утилитой сжатия является WinZip.
- Данные сжимаются, поэтому используется меньше места
- Формат zip экономит время и эффективен
- Передача данных становится проще
- Всего одна загрузка дает вам доступ ко всей информации
- Связанные файлы могут быть сгруппированы вместе
- Большие файлы могут быть сохранены или преобразованы в менее объемные элементы путем сжатия данных
Часть 1. Что вызывает ошибку недействительного zip-файла?
Zip-файлы сталкиваются с ошибками по многим условиях. Давайте посмотрим, каковы причины этих ошибок, прежде чем мы углубимся в их решение:
- Вирус является основной причиной ошибок zip-файлов
- Файлы MS Office со средним или низким уровнем безопасности также могут вызывать ошибки zip-файла
- Низкая скорость загрузки также может привести к недопустимой ошибке zip-файла
- Инструмент компрессора неисправен, что вызывает ошибку
- Загруженный файл изначально поврежден, что приводит к ошибке
Когда отображается сообщение о недействительном zip-файле, вы теряете доступ к информации и не можете извлечь файлы из zip-папки. Это может быть огромной проблемой, но у каждой проблемы есть свое решение, и это то, что мы ищем!
Давайте посмотрим на различные методы, которые мы можем использовать для исправления ошибки недействительного zip-файла.
Часть 2: Переустановка Клиента Сжатия
По опыту других пользователей, первое, что приходит на ум при работе со сжатыми файлами, — это клиент сжатия, который может вызывать ошибку. Переустановка используемого программного обеспечения оказалась для них полезной и решила проблему.
Чтобы переустановить клиент сжатия, дабы избежать ошибки неверного zip-файла, выполните следующие действия:
Шаг 1: Сначала нажмите клавишу Windows + R, чтобы открыть окно запуска.

Шаг 2: Введите ´appwiz.cpl´ и нажмите enter, чтобы открыть программы и функции.
Шаг 3: Прокрутите список и удалите приложение для распаковки, которое показывает ошибку (WinZip, WinRar, 7zip и т. д.)
Шаг 4: После того, как оно будет удалено, используйте свой браузер, чтобы получить последнюю доступную версию клиентов декомпрессии, которая может быть:
Шаг 5: Теперь перезагрузите компьютер после установки и проверьте, можете ли вы снова извлечь файл.
Совет: если это ваш ноутбук/нотбук, попробуйте использовать Reimage Plus, программное обеспечение для сканирования репозиториев, а также замены и восстановления поврежденных и отсутствующих файлов.
Часть 3. Использование другого бесплатного ПО для сжатия
Это может показаться неправильным решением, но многие пользователи сообщили, что им удалось решить проблему с помощью другого бесплатного программного обеспечения для сжатия, такого как 7zip.
Можно использовать несколько сторонних решений, но наиболее удобным является 7zip. Чтобы получить краткое руководство по его установке и избежать ошибки неверного файла 7zip, вы всегда можете использовать:
Шаг 1: Посетите веб-сайт, чтобы получить установщик 7-zip в соответствии с вашей архитектурой Windows.
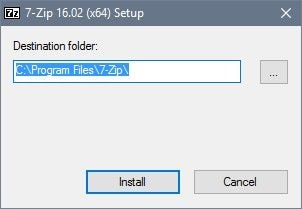
Шаг 2: Откройте установщик и следуйте инструкциям.
Шаг 3: После установки zip-файлы при щелчке правой кнопкой мыши отобразят дополнительное меню и предоставят вам те же функции, что и родной клиент.
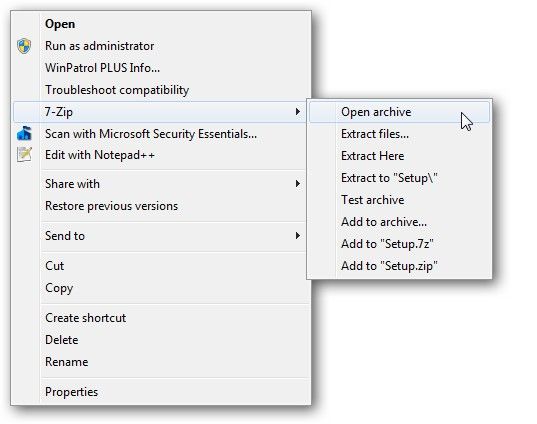
Часть 4. Заархивируйте на диск, использующий NTFS
NTFS можно эффективно использовать для сжатия файлов. Это самый простой метод, и нет необходимости сжимать файлы, архивировать или распаковывать каждый раз, когда файл нужен. Это автоматический процесс, который не влияет на производительность файла или программного обеспечения.
В Windows 10 вы можете использовать следующие шаги для сжатия файлов и папок с помощью NTFS:
Шаг 1: Открыть Файловый Менеджер
Шаг 2: Найдите папку, в которой вы хотите сохранить информацию

Шаг 3: Нажмите кнопку «Домой»
Шаг 4: Нажмите кнопку «Новой папки»
Шаг 5: Или же вы можете просто создать новую папку с помощью сочетаний клавиш: Ctrl + Shift + N
Шаг 6: Введите имя папки и нажмите enter
Шаг 7: Щелкните правой кнопкой мыши, чтобы выбрать параметр свойств
Шаг 8: Нажмите на вкладку «Общие»

Шаг 9: Затем нажмите кнопку «Дополнительно»
Шаг 10: В разделе «Сжать или зашифровать атрибуты» установите флажок «Сжать содержимое для экономии места на диске»

Шаг 11: Нажмите OK
Шаг 12: Затем нажмите кнопку «Применить», чтобы сохранить настройки
Шаг 13: В диалоговом окне подтверждения изменения атрибута выберите параметр, чтобы применить изменения ко всем

Шаг 14: Нажмите OK
Выполнив все шаги, вы только что создали папку, которая будет сжимать все сохраненные в ней файлы и занимать меньше места, чем обычно. Существующие файлы и будущие файлы будут иметь одинаковые результаты. Эти шаги можно использовать и для отдельного файла. Если вы видите знак с двумя стрелками в правом углу, то убедитесь, что настройки работают.
Чтобы проверить, сколько места вы сэкономили этим методом, щелкните папку правой кнопкой мыши и выберите свойства. Затем проверьте размер, который дает размер несжатого файла, а размер на диске дает размер элемента после сжатия. Если вы хотите отменить внесенные изменения, вам необходимо выполнить те же действия и очистить содержимое сжатия, чтобы сохранить параметр диска.
Часть 5. Запустите CMD для исправления/восстановления поврежденных или недействительных ZIP-файлов
Следующий метод также можно использовать для удаления ошибки недействительного zip-файла:
Шаг 1: Откройте командную строку от имени администратора.
- Для пользователей Windows 10/8.1: шелкните правой кнопкой контекстное меню Пуск>нажмите командную строку (администратор)
- Для пользователей Windows 7/8/Vista/XP: нажмите Пуск> Все программы>аксессуары>командная строка> запустить от имени администратора
Шаг 2. Измените каталоги на папку, в которой находится текущий поврежденный zip-файл.
Шаг 3: Введите: ¨C:\Program files\WinZip\wzzip¨-yf zipfile.zip> нажмите enter.
Вы также можете выявить поврежденные или недействительные файлы .zip, заменив имя файла на zipfile.zip.
Часть 6. Восстановление недействительных/поврежденных файлов .Zip с помощью Stellar File Repair
Это относительно простой метод для пользователей, которые предпочитают простые методы восстановления zip-файлов, отображающих ошибку недействительного zip-файла, с помощью Repairit File Repair
Он обрабатывает все виды повреждений zip-файлов, а файлы, защищенные паролем, также могут быть восстановлены и возвращены с помощью этого программного обеспечения. Это также облегчает восстановление файлов размером до 800 МБ, а также дает вам доступ к сохранению в сжатом формате.
Шаги по использованию Stellar File Repair
Этот инструмент не бесплатный, но предлагает 30-дневную гарантию возврата денег. Он отлично восстанавливает документы Word, презентации Powerpoint, а также электронные таблицы Excel и, конечно же, ZIP-архивы. Шаги по установке не перечислены, но после установки запустите инструмент и следуйте инструкциям, чтобы исправить ошибку недействительного zip-файла.
Шаг 1. Выберите вариант восстановления ZIP-файла.
Шаг 2: Найдите поврежденный ZIP-файл, и они будут перечислены для предварительного просмотра.
Шаг 3: Нажмите кнопку восстановления и дождитесь завершения процесса.
Шаг 4: Вы можете предварительно просмотреть файлы из меню слева после завершения процесса.
Шаг 5. Проверьте содержимое после восстановления файла.
Шаг 6: Нажмите «Сохранить», чтобы восстановить поврежденный файл в предпочтительном месте.
Это все об ошибке неверного zip-файла и о том, как ее исправить. Надеюсь, пост охватывает все ваши проблемы и предлагает решение!
Люди Также Спрашивают
Как исправить неверный Zip-файл?
- Используйте инструмент сжатия, такой как 7Zip, для обработки этого заархивированного файла
- Восстановите файл с помощью стороннего инструмента восстановления, такого как WinRAR
- Используйте антивирусный инструмент для обнаружения ошибок, вызывающих эту недействительность, чтобы заблокировать им доступ к вашим файлам
Почему мой Zip-файл недействителен?
Ваш Zip-файл недействителен из-за таких ошибок, как заражение вирусом или неполная загрузка из Интернета. Оба эти фактора могут привести к повреждению Zip-файла, что в свою очередь приведет к появлению сообщения об ошибке «Сжатая (заархивированная) папка недействительна».
Как восстановить Zip-файл?
- Удалите старый файл, который стал недоступным
- Откройте сайт, с которого вы хотите скачать файл, в браузере
- Найдите Zip-файл, снова загрузите его и сохраните в другом, более безопасном месте
Почему я не могу открыть Zip-файл?
- Неправильно сделанная компрессия
- Расширение файла, которое было изменено на формат, не поддерживается Windows
- Заражение вирусом
- Неполная загрузка файла
Zip – как не нужно создавать формат файлов
Zip появился 32 года назад. Можно подумать, что настолько зрелый формат должен быть отлично задокументирован. К сожалению, нет. Что же конкретно в нем не так, и каким образом его можно было бы оптимизировать? Подробно рассмотрим эти вопросы, опираясь на исходную документацию.
Вообще, есть у меня ощущение, что это касается многих форматов файлов. Они не прорабатываются, а скорее создаются разработчиками на ходу. Если в итоге такой формат становится популярен, то у пользователей возникает желание считывать и/или записывать соответствующие файлы. При этом им приходится либо делать реверс-инжиниринг, либо запрашивать спецификации. Даже если разработчик и пишет спецификацию, он зачастую не может вспомнить все допущения, которые делает его программа. В итоге они не записываются, и спецификация получается неполной. К таким форматам и относится Zip.
Соответствующая документация находится в APPNOTE.TXT , который доступен здесь.
Если коротко, то zip-файл состоит из записей, каждая запись начинается с некоторого 4-байтового маркера, который обычно имеет следующую структуру:
0x50, 0x4B, . ??Здесь 0x50 и 0x4B представляют буквы PK , означающие “Phil Katz”, собственно, имя создателя этого формата. Два байта ?? определяют тип записи. Вот примеры:
0x50 0x4b 0x03 0x04 // local file record 0x50 0x4b 0x01 0x02 // central directory file record 0x50 0x4b 0x05 0x06 // end of central directory recordЗаписи не следуют какому бы то ни было стандартному шаблону. Чтобы считать или даже пропустить запись, необходимо знать ее формат. Я имею ввиду, что есть несколько других форматов файлов, которые следуют определенному соглашению, например, когда каждый id записи сопровождается ее длиной. Поэтому, если вы видите id и не понимаете его, то просто считываете длину, пропускаете такое же количество байтов* и оказываетесь у следующего id . К примерам подобной схемы относится большинство форматов видео-контейнеров, jpg , tiff , файлы Photoshop, wav , да и многие другие.
* некоторые форматы требуют округления длины до ближайшего числа, кратного 4 или 16. Zip же этого не делает. Если вы видите id и не знаете, как этот тип содержимого записи структурирован, то понять, сколько байтов нужно пропустить, вам не удастся.
APPNOTE.TXT сообщает нам следующее:
4.1.9 ZIP-архивы МОГУТ быть потоковыми, разделенными на сегменты (на стационарных или съемных носителях) либо «самораспаковывающимися» (SFX). SFX-архивы ДОЛЖНЫ нести в себе код извлечения для целевой платформы.
4.3.1 ZIP-архив ДОЛЖЕН содержать end of central directory record . ZIP-архив, содержащий только end of central directory record , рассматривается как пустой. Файлы внутри ZIP-архива можно заменять, добавлять и удалять. ZIP-архив ДОЛЖЕН содержать только одну end of central directory record . Другие записи, определенные в этой спецификации, МОЖНО использовать при необходимости для поддержания требований хранилища к отдельным ZIP-архивам.
4.3.2 Каждому помещенному в ZIP-архив файлу ДОЛЖНА предшествовать запись local file header . Каждая запись local file header ДОЛЖНА сопровождаться соответствующей central directory record , расположенной внутри раздела центрального каталога ZIP-архива.
4.3.3 Файлы внутри ZIP-архива можно сохранять в произвольном порядке. ZIP-архив МОЖЕТ включать несколько томов или быть разделен на сегменты определенного пользователем размера. Все значения ДОЛЖНЫ храниться в порядке байтов от младшего к старшему, если для конкретного элемента данных этой документацией не установлено иное.
4.3.6 Общая структура формата .ZIP:
[local file header 1] [encryption header 1] [file data 1] [data descriptor 1] . . . [local file header n] [encryption header n] [file data n] [data descriptor n] [archive decryption header] [archive extra data record] [central directory header 1] . . . [central directory header n] [zip64 end of central directory record] [zip64 end of central directory locator] [end of central directory record]4.3.7 Local file header:
local file header signature 4 bytes (0x04034b50) version needed to extract 2 bytes general purpose bit flag 2 bytes compression method 2 bytes last mod file time 2 bytes last mod file date 2 bytes crc-32 4 bytes compressed size 4 bytes uncompressed size 4 bytes file name length 2 bytes extra field length 2 bytes file name (variable size) extra field (variable size)4.3.8 File data
Сразу после local header файла ДОЛЖНЫ идти сжатые или сохраненные данные этого файла. Если файл зашифрован, заголовок шифрования ДОЛЖЕН идти между local file header и file data . Последовательность [local file header][encryption header] [file data][data descriptor] повторяется для каждого файла в ZIP-архиве.
Файлы нулевой длины и другие типы файлов без содержимого НЕ ДОЛЖНЫ включать file data .
4.3.12 Структура центрального каталога:
[central directory header 1] . . . [central directory header n] [digital signature] File header:
central file header signature 4 bytes (0x02014b50) version made by 2 bytes version needed to extract 2 bytes general purpose bit flag 2 bytes compression method 2 bytes last mod file time 2 bytes last mod file date 2 bytes crc-32 4 bytes compressed size 4 bytes uncompressed size 4 bytes file name length 2 bytes extra field length 2 bytes file comment length 2 bytes disk number start 2 bytes internal file attributes 2 bytes external file attributes 4 bytes relative offset of local header 4 bytes file name (variable size) extra field (variable size) file comment (variable size)4.3.16 End of central directory record:
end of central dir signature 4 bytes (0x06054b50) number of this disk 2 bytes number of the disk with the start of the central directory 2 bytes total number of entries in the central directory on this disk 2 bytes total number of entries in the central directory 2 bytes size of the central directory 4 bytes offset of start of central directory with respect to the starting disk number 4 bytes .ZIP file comment length 2 bytes .ZIP file comment (variable size)Есть и другие детали, относящиеся к шифрованию, более крупным файлам, дополнительным данным, но для целей текущей статьи этого нам будет достаточно. Потребуется лишь уточнить процесс создания SFX-архивов.
Для этого можно вернуться к ZIP2EXE.exe , который сопровождал PKZIP в 1989 году, и посмотреть, что он делает. Однако проще будет заглянуть в Info-ZIP:
Как создать DOS (или другой не-нативный) SFX-архив под Unix?
Суть этой процедуры объяснена на странице мануала UnZipSFX. Сперва понадобится подходящий бинарный дистрибутив UnZip для целевой платформы (DOS, Windows, OS/2 и т.д.). В следующем примере мы предположим, что работаем с DOS. Затем нужно извлечь из дистрибутива модуль UnZipSFX и добавить его, как если бы он был нативным модулем Unix:
> unzip unz552x3.exe unzipsfx.exe // извлечение SFX-модуля для DOS > cat unzipsfx.exe yourzip.zip > yourDOSzip.exe // создание SFX-архива > zip -A yourDOSzip.exe // корректировка внутренних смещений > Вот и все. При этом вы по-прежнему можете тестировать, обновлять и удалять записи архива. Получился полностью функциональный файл zip.
Ну а теперь с учетом всего этого мы пройдемся по ряду проблем.
Как считывать zip-файл?
В спецификации по этому поводу ничего не сказано.
Есть два очевидных пути:
- Просканировать его с начала и при встрече id записи выполнять нужные действия.
- Просканировать его с конца. Найти end of central directory record и использовать ее для считывания всего центрального каталога, рассматривая только те элементы, на которые он ссылается.
Однако пункт 4.1.9 утверждает, что zip-архивы можно считывать потоком. Как такое возможно? Что, если есть некая local file record , на которую центральный каталог не ссылается? Валидна ли она? Неизвестно.
В 4.3.1 сказано:
Файлы внутри ZIP-архива МОЖНО заменять, добавлять и удалять.
Как вам? Это предполагает, что центральный каталог может ссылаться не на все файлы архива, иначе это утверждение о возможности добавления, замены и удаления файлов не имело бы смысла.
Если у меня есть file1.zip , содержащий файлы A , B , C , и я генерирую file2.zip , который содержит только A и B , то получается два независимых zip-файла. Нет никакого смысла писать в спецификации о возможности добавления, замены и удаления файлов, если только эта информация каким-то образом не влияет на структуру zip-файла.
Другими словами, если перед нами такая структура:
[local file A] [local file B] [local file C] [central directory file A] [central directory file C] [end of central directory]Тогда очевидно, что B удален, поскольку центральный каталог на него не ссылается. С другой стороны, если [local file B] отсутствует, тогда мы имеем просто независимый zip-архив, т.е. независимый от другого zip-архива, в котором B содержится. Нет необходимости даже упоминать об этой ситуации в спецификации.
Аналогичным образом, если перед нами:
[local file A (old)] [local file B] [local file C] [local file A (new)] [central directory file A(new)] [central directory file B] [central directory file C] [end of central directory]Тогда, согласно центральному каталогу, A (old) был заменен на A (new) . С другой стороны, если [local file A (old)] отсутствует, то мы имеем просто еще один независимый zip-архив.
Это может показаться бессмыслицей, но нужно помнить, что PKZIP происходит из эпохи дискет. Операции считывания содержимого всего zip-архива и записи нового zip-архива могут оказаться чрезвычайно медленными. В обоих случаях возможность удаления файла простым обновлением центрального каталога или добавления файла считыванием существующего центрального каталога с присоединением новых данных и последующей записью обновленного центрального каталога окажется весьма желаемой.
Это было особенно актуально в случаях, когда zip-архив занимал несколько дискет. В 1989 году подобная ситуация была не редкостью. Оказывалось гораздо удобнее обновлять README.TXT в zip-архиве без необходимости перезаписывать несколько дискет.
Представители PKWARE в обсуждении сказали следующее:
Изначально этот формат подразумевал прямую запись от начала к концу, поэтому central directory и end of central directory record могли записываться после того, как будут узнаны и записаны все включаемые в ZIP-архив файлы. При добавлении файлов изменения можно применять без перезаписывания всего файла. Именно так была реализована запись файлов .ZIP в оригинальной программе PKZIP. При считывании она сначала читает end of central directory record для обнаружения central directory , а затем ищет все файлы, к которым нужно обратиться.
Конечно же, «добавление» отличается от «удаления» и «замены». Наличие или отсутствие локальных файлов, на которые не ссылается центральный каталог, спецификацией не определяется. Это лишь подразумевается следующим упоминанием:
Файлы внутри ZIP-архива МОЖНО заменять, добавлять и удалять.
Если для центрального каталога допустимо не ссылаться на все локальные файлы, тогда считывание архива путем его прямого сканирования может провалиться. Если дополнительно не постараться, то вы либо получите файлы, которые не должны существовать, либо ошибки из-за попытки перезаписать существующие файлы.
Но это противоречит пункту 4.1.9, в котором говорится, что zip-архивы могут считываться в потоковом режиме. Если архивы допускают потоковое считывание, тогда оба вышеприведенных примера провалятся, потому что сначала в первом случае мы увидим файл B , а во втором файл A (old) , и лишь потом то, что центральный каталог на них не ссылается. Если же нам придется дожидаться чтения центрального каталога прежде, чем верно использовать любые из его записей, тогда функционально мы просто не сможем считывать zip-файл потоком.
Может ли SFX-компонент содержать какие-либо ID?
Следуя вышеприведенной инструкции по созданию SFX-компонента, мы просто подставляем исполняемый код в начало этого файла, а затем корректируем смещения в центральном каталоге.
Предположим, что у SFX-компонента следующий код:
switch (id)
Судя по этому коду, в SFX-компоненте, представляющем начало zip-файла, в двоичном виде появятся значения 0x06054b50 , 0x04034b50 , 0x02014b50 . Если считывать zip-архив прямым сканированием, то сканер может увидеть эти id и ошибочно принять их за записи zip.
Вот как можно представить SFX-компонент с находящимся в нем zip-файлом:
// данные для zip-файла, содержащие: // LICENSE.txt // README.txt // player.exe const unsigned char[] runtimeAndLicenseData = < 0x50, 0x4b, 0x03, 0x04, . . . >; int main()
Теперь внутри SFX-компонента находится zip-файл. Любой ридер, который считывает с начала, увидит этот внутренний zip-файл и даст сбой. Валиден ли данный zip-файл? Спецификация об этом молчит.
Я проверил. Оригинальный PKUNZIP.exe в DOS, Windows Explorer, MacOS Finder, Info-ZIP (UNZIP, включенный в MacOS и Linux), все четко считывают с конца и видят эти файлы уже после SFX-компонента. А вот Keka и 7z видят zip, вложенный в него.
Считать ли это сбоем или плохим zip-файлом?
APPNOTE.TXT ответа не дает. Я считаю, что здесь должна быть ясность, и что это является одним из незаявленных допущений. PKUNZIP сканирует с конца, поэтому такая схема работает, но как именно она работает, в документации не сказано. Проблема того, что данные в SFX-компоненте могут оказаться похожи на zip-файл, не освещается. Аналогичным образом, потоковое считывание скорее всего провалится, если еще не провалилась из-за недочетов, описанных ранее.
Вы можете решить, что это не такая уж проблема, но в сетевом архиве находятся сотни тысяч SFX zip-ов из 1990-х. Попытка считать такие файлы прямым сканером вполне может провалиться.
Может ли zip-комментарий содержать идентификаторы zip?
Если еще раз взглянуть на пункт 4.3.16, то мы увидим, что в конце zip-архива идет комментарий переменной длины. Поэтому при обратном сканировании мы, по сути, выполняем чтение с конца файла в поиске 0x50 0x4B 0x05 0x06 . Но что, если эта последовательность байтов находится в комментарии?
Уверен, что Фил Кац никогда об этом не задумывался. Он просто предположил, что люди будут помещать туда эквивалент README.txt . В таком случае там будут находиться только значения от 0x20 до 0x7F , возможно, с 0x0D (возврат каретки), 0x0A (перевод строки), 0x09 (табуляция) и 0x06 (звонок).
К сожалению, все эти значения в ID являются действительными кодами ASCII, даже utf-8. В начале статьи мы уже прошлись по 0x50 = P и 0x4B = K . Что же касается 0x06 и 0x05 , то первый в ASCII означает «звонок» (издает звук или вызывает мигание экрана), а второй «Запрос».
APPNOTE.TXT наверняка должен явно сообщать, если это невалидно. Пункт 4.3.1 косвенно указывает:
ZIP-архив ДОЛЖЕН содержать только одну end of central directory record .
Но что именно это значит? Значит ли это, что байты 0x50 0x4B 0x05 0x06 не могут появиться в комментарии или коде SFX? Значит ли это, что когда вы в первый раз видите их при обратном сканировании, то второе совпадение уже не ищете?
Если вы сканируете с начала и не сталкиваетесь ни с одной из перечисленных ранее проблем, то прямой сканер успешно это считает. С другой стороны, сам PKUNZIP бы не справился.
Что, если смещение до центрального каталога равно 1,347,093,766?
Это смещение 0x504b0506 , значит оно окажется заголовком end of central directory . Я думаю, что во времена создания формата zip файлы размером 1.3 Гб даже не предполагались, и, действительно, расширения требовались для обработки файлов больше 4 Гб. Но это лишь еще раз указывает на недостаточную продуманность структуры формата.
А что значит продуманная структура?
Этот вопрос определенно требует обсуждения, но, если рассмотреть возможность повторить разработку, то кое-что можно определить без сомнений.
1. Лучше, если записи будут иметь фиксированный формат, например id , сопровождаемый размером, чтобы можно было пропускать запись в случае непонимания.
2. Лучше, если последняя запись в конце файла будет просто записью offset-to-end-of-central-directory , как здесь:
0x504b0609 (id: some id is not in use) 0x04000000 (size of data of record) 0x. (relative offset to end-of-central-directory)Это исключит двусмысленность при обратном считывании.
2.a. Считать последние 12 байтов.
2.b. Проверить, являются ли первые 8 байтов следующими: 0x50 0x4b 0x06 0x09 0x04 0x00 0x00 0x00 . Если нет, сбой.
2.c. Считать смещение и перейти к end-of-central-directory .
Или, напротив, поместить комментарий в собственную запись и расположить перед central directory , указав смещение до него в end-of-central-directory-record .
Тогда, по крайней мере, исчезнет проблема сканирования комментария.
3. Внести ясность в том, какие данные могут появиться в компоненте SFX.
Если вам нужна поддержка прямого считывания, то будет логичным утвердить, что SFX-компонент не может содержать какие-либо записи.
Но обеспечить это сложно, разве что специально написать валидатор. Если вы будете просто проверять, исходя из того, может ли ваше приложение считывать zip-файл, то на сегодня для PKZIP, PKUNZIP, info-ZIP, Windows Explorer и MacOS содержимое SFX-компонента безразлично, поэтому для валидации они не годятся. Нужно явно указать в спецификации на необходимость применения именно обратного сканирования, либо же написать валидатор, который отвергает zip-файлы, не допускающие прямого сканирования, и также в спецификации указать причину.
4. Внести ясность в том, может ли central directory расходиться с записями локальных файлов.
5. Внести ясность в том, могут ли между записями появиться случайные данные.
Обратный сканер не волнует, что находится между записями. Его волнует лишь возможность найти центральный каталог, и считывает он только то, на что центральный каталог указывает. Это означает, что между записями могут быть любые случайные данные (по крайней мере между некоторыми).
Необходима ясность в том, нормально это или нет. Не нужно полагаться на скрытые схемы.
Что же делать? Как все исправить?
На мой взгляд все эти проблемы относятся к деталям реализации, которые не попали в APPNOTE.TXT . При этом на самом деле APPNOTE.TXT хочет сказать, что «валидный zip-файл – это тот, с которым может работать PKZIP, и который может правильно распаковать UNZIP”. Но вместо этого он определяет все таким образом, что в результате некоторые реализации могут создавать файлы, которые не могут прочесть другие реализации.
Конечно же, спустя всю 32-летнюю историю zip-файлов, мы уже этот формат не исправим. Но все же в PKWARE могли бы внести ясность по поводу рассмотренных пограничных случаев. Лично я бы добавил соответствующие разделы в APPNOTE.TXT .
4.3.1 ZIP-файл ДОЛЖЕН содержать end of central directory record . ZIP-файл, содержащий только end of central directory record считается пустым. Файлы в ZIP-архиве МОЖНО обновлять, добавлять и удалять. ZIP-файл ДОЛЖЕН содержать только одну end of central directory record . Другие записи, определенные в этой спецификации, МОЖНО использовать по необходимости для поддержания требований хранилища к отдельным ZIP-файлам.
End of central directory record должна находиться в конце файла, и последовательность байтов 0x50 0x4B 0x05 0x06 не должна встречаться в комментарии.
Сentral directory руководит содержимым zip-файла, и считать из него можно только те данные, на которые он указывает. Во-первых, причина в том, что содержимое SFX-компонента файла не определено и может содержать zip-записи, которые фактически к zip-файлу не относятся. Во-вторых, возможность добавлять, обновлять или удалять содержимое zip-файла опирается на доступную лишь central directory информацию о том, какие локальные файлы валидны.
Это один способ. Я верю, что в таком случае удалось бы считать сотни миллионов существующих zip-файлов.
С другой стороны, если в PKWARE заявляют, что файлов, имеющих подобные проблемы, не существует, тогда также сработает следующий вариант:
4.3.1 ZIP-архив ДОЛЖЕН содержать end of central directory record . ZIP-архив, содержащий только end of central directory record , считается пустым. Файлы в ZIP-архиве МОЖНО заменять, добавлять и удалять. Другие записи, определенные в этой спецификации, МОЖНО использовать по необходимости для поддержания требований хранилища к отдельным ZIP-архивам.
End of central directory record должна находиться в конце файла, и последовательность байтов 0x50 0x4B 0x05 0x06 не должна встречаться в комментарии.
Не может быть таких [local file records] , которые бы не содержались в central directory . Эта гарантия необходима, чтобы считывание файла в прямом и обратном направлении давало одинаковые результаты. Любой файл, не следующий этому правилу, является недействительным zip-архивом.
SFX-архив не должен содержать любую из последовательностей id записей, перечисленных в этом документе, так как они могут быть неверно поняты zip-сканерами прямого чтения. Любой файл, не следующий этому правилу, является недействительным zip-архивом.
Надеюсь, что файл APPNOTE.TXT все же обновят, чтобы различные zip-ридеры и zip-генераторы трактовали валидность файлов одинаково.
К сожалению, все говорит в пользу того, что PKWARE не хотят вносить в этом вопросе ясность. Их позиция состоит в том, что zip является неоднозначным форматом. Если вы хотите пользоваться прямым сканированием, то просто не делайте этого для файлов, которые его не поддерживают. Они по-прежнему остаются валидными zip-файлами, и то, что их нельзя таким образом считать, значения не имеет. Вы сами выбираете отказ от их поддержки.
Думаю, эту точку зрения можно понять. Ведь лишь несколько библиотек поддерживают все возможности zip, а может и ни одна. Тем не менее, было бы здорово знать, намеренно ли вы не обрабатываете какой-то файл, или же просто неверно его считываете, и по воле случая иногда получается.
Желание все это осветить возникло у меня в процессе написания JS-библиотеки для распаковки. Их уже существует очень много, но меня интересовали особые возможности, которых в найденных мной вариантах не было. В частности, мне нужно было, чтобы библиотека позволяла считывать из большого архива один файл максимально быстро. Это означало использование обратного сканирования, поиск смещения до нужного файла и его разархивирование. Надеюсь, что и другим моя библиотека пригодится.
P.S.
Вам может быть весьма интересна эта история ZIP (англ.):