Системы логирования: как определиться с выбором логгера
Программисты и администраторы регулярно обращаются к логам приложений и сервисов, читают их, ищут исключения, выясняют причину сбоя сервиса, проверяют потенциально опасные записи. При наличии одного сервера читать логи легче. А если таких серверов много и по ним разбросаны разные приложения и сервисы, то проблему анализа решают системы логирования.
Существует 2 типа систем логирования – открытая и проприетарная. Программный код первого типа в свободном доступе. Крупные организации делают ставку именно на этот вариант. Исходный код проприетарной системы скрыт. Для анализа и ликвидации технических ошибок необходимо купить этот продукт.

Популярные системы сбора логов
Для устранения технической ошибки программист выбирает удобный инструмент, приспособленный под требования бизнеса. Выбор системы логирования можно основывать на главных технических характеристиках:
- лицензия;
- поддерживаемые языки;
- дата последнего выпущенного обновления;
- совместимая операционная система;
- компьютер.
В обзор инструментов вошли известные представители сферы. Каждый отличается своими рабочими характеристиками.
LOGalyse
До недавнего времени этот продукт необходимо было покупать. Однако позже разработчики изменили исходный код на открытый.
Главный недостаток продукта – установка только на ОС Windows. Преимущества – гибкость и мощность. Продукт можно использовать на одной общей платформе для развертываний. При этом они будут объединять ведение разных журналов из нескольких источников. К ним относятся Postfix , а также Apache. При этом данные журналов выводятся в формат CSV, PDF и др.
Предложение нельзя назвать универсальным. Однако учитывая доступность, популярность LOGalyse среди пользователей продолжает расти.
Logstash
Этот вариант выбирают пользователи стека Elastic. Продукт имеет открытый ход. Систему логирования используют для конкретных целей с полной свободой развертывания.
Плюс Logstash – это сбор массива информации с отдельных платформ. Система определяет и проводит работу с собственным объемом данных, а также оценивает неструктурированные разделы журналов и т.д.
Logstash рекомендован к использованию программистам без опыта. Для крупных проектов существующего набора опций не хватит. Дополнительный недостаток – работа с ограниченным набором продуктов (Elastic).
LogPacker
LogPacker — система сбора и анализа логов, клиент-серверная архитектура, где при этом каждый клиент может функционировать как сервер и наоборот. Положительные стороны сервиса — быстрая интеграция с программами, функция сканирования, простая установка, кластеризация, экономный расход ресурсов и при этом — высокая скорость передачи данных. Функция двухуровневой агрегации экономит дисковое пространство, распределяет нагрузку между клиентом и сервером.
LogPacker гарантирует быструю доставку данных на все узлы, обеспечивая контроль соединения и выполняя резервное копирование. Агент может быть установлен на Unix, Windows, Android, iOS, а также на JavaScript сайта.
Есть бесплатная облегченная версия, но ее опции существенно ограничены (10 ГБ в месяц с 7-дневным хранением).
Logwatch
Инструмент положительно оценен логгерами, которые предпочитают работать, не связываясь с комплексным ведением журналов. Он подходит для нужд именно этих специалистов.
С помощью Logwatch программист может быстро и максимально эффективно просмотреть все файлы. После инсталляции продукт проанализирует данные всех журналов и создать подробный отчет. При этом тип этого электронного документа вы выбираете сами.
Небольшой недостаток – моральное устаревание. Однако сторонникам старой школы Logwatch понравится. При скачивании помните, что программу можно установить только при наличии Perl 5.6+.
Fluentd
Fluentd собирает данные из источников и записывает их в файлы, СУБД, NoSQL, IaaS, SaaS, Hadoop. Можно унифицировать инфраструктуру. Это продукт из категории «Управление журналами» технологического стека.
Среди плюсов – большая библиотека плагинов. Сервис позволяет собирать информацию практически из любой производственной системе, формировать собственный конвейер, и передавать его на комфортную аналитическую платформу. В его пользу говорит и то, что его услугами пользуются такие всемирно известные API компании как Twilio, Microsoft и т.д.
Graylog
Graylog — это мощный комплекс для управления журналами, который дает множество возможностей для анализа входящих журналов с разных серверов. Принцип работы Graylog очень похож на ELK. Помимо самого сервера Graylog, который состоит из сервера приложения и веб-интерфейса, также потребуется иметь MongoDB и Elasticsearch, чтобы весь стек был полностью работоспособен.
Он имеет дружественный графический интерфейс и поддерживает широкий спектр форматов данных. Предоставляет хорошие возможности для управления аутентификацией и разрешениями пользователей. Можно настроить его для получения уведомлений по электронной почте. Graylog использует старый добрый REST API.
Graylog не может читать файлы системного журнала, поэтому нужно отправлять сообщения непосредственно в систему. Интерфейс приборной панели недостаточно дружелюбен. Функционал отчетности довольно скудный.
Sentry
Сервис позволяет мониторить исключения и ошибки в различных приложениях. Пользователь может получить подробный отчет по каждому логу.
Плюсы – быстрый поиск, удобный механизм оповещения, а также интеллектуальная группировка сообщений о проделанной работе. Продукт располагается в свободном доступе.
Недостатки – найти подробную инструкцию по использованию всех возможностей Sentry достаточно сложно. Необходимые данные располагаются в сопутствующей технической документации.
ELK (ElasticSearch, Logstash, Kibana)
ELK – это комбинация из трех отдельных сервисов. Все они с открытым исходным кодом и разработаны одной и той же командой.
В комплекс входят следующие:
- Elasticsearch — очень мощная и масштабируемая поисковая инструмент, которая может хранить большие объемы данных и использоваться в качестве кластера.
- Logstash — этот компонент используется для получения данных из/в определенное место. Поставляется с широким спектром плагинов и большим сообществом пользователей.
- Kibana — это графический интерфейс, который ищет, анализирует и визуализирует большие объемы сложных данных из базы данных Elasticsearch. Процесс развертывания занимает не более 5 минут.
Одна из самых функциональных систем с открытым исходным кодом.
Octopussy
Непопулярный продукт на рынке. Однако все-таки стоит обратить на него внимание, если потребности не слишком высоки. В остальных случаях программист столкнется с вопросом формирования конвейеров, приемом данных, конвертацией и т.д.
Плюсы – скорость работы, отсутствие раздувания. Немаловажен и открытый программный код продукта.
Среди недостатков – неудобный интерфейс. Чтобы разобраться с навигацией и набором функций требуется время.
Syslog-ng
На первом этапе система только обрабатывала файлы системного журнала. При этом вся работа происходила в режиме реального времени. Благодаря усилиям разработчиков, продукт стал поддерживать другие форматы данных, в т.ч. неструктурированные, NoSQL, SQL.
Информация подается четко. Удобная структура позволит быстро получить необходимые данные.
Syslog-ng используется в качестве инструмента для формирования и классификации журналов промышленного уровня. Язык программирования – Си. Благодаря имеющейся расширяемости пишутся плагины на C, Java, Perl, Python и т.д.
Wazuh
Сервис располагается в свободном доступе. Продукт выполняет массу функций – мониторинг безопасности, обнаружение угроз, реагирование на возникающие инциденты и т.д.
Плюсы логгера – скорость работы, а также легкость управления, анализ журналов операционных систем и приложений. После этого достаточно передать данные центральному менеджеру. Он проведет анализ имеющихся ошибок, факты нарушения политики и неправильные настройки.
Недостатки – нет доступа к своей среде, в случае, когда потребитель использует SSH-доступ. Из-за этого наблюдается ограниченный набор функций. Еще один минус – обмен информацией происходит только через контрагентов Wazuh.
Flume
Сервис используется для работы с большим объемом данных. Благодаря его функциям можно объединить информацию.
Продукт обладает свободным исходным кодом, написанном на Java. В связи с этим пользователи отмечают отсутствие корпоративного плана.
Обратить внимание на логгера стоит также программистам, которые ищут отказоустойчивую распределенную платформу. Инструмент используется для загрузки информации, особенно когда работа происходит в тяжелых условиях.
Выбор системы анализа логов
При поиске комплекса учитывается масса факторов. Основные характеристики:
- Простота. Удобный интерфейс и простая навигация.
- Сбор «больших» логов. Подходит для работы с огромными массивами данных. Функций сервиса должно хватать для формирования, а также обработки информации.
- Масштабируемость. Система собирает логи с разных компонентов и предоставляет к ним доступ в одном месте.
Важна и поддержка клиента. Менеджеры помогают по вопросам управления и настроек.
Заключение
Краткий обзор самых известных логгеров предлагает разные системы для работы. При поиске предложения учитывайте количество данных, которые она будет обрабатывать, а также желаемую скорость анализа.
Логирование: что это и в чем его польза
Система логирования – один из важных моментов в процессе разработки программных продуктов, контроля над работой сервисов, веб-сайтов. Но часто ее недооценивают, не используют своевременно. А необходимость в ней понимают только тогда, когда проект уже находится на этапе сдачи и что-то в нем идет не так и остается только разводить руками. Чтобы этого не произошло, надо знать, что это, запись логов, зачем она нужна, когда и как ее применять на практике. К ней стоит обращаться IT-специалистам, чтобы разобраться, почему не работает или работает некорректно приложение или сайтов. Администраторы, основываясь на логах, смогут причины в сбое сервисов. Используя логирование, система безопасности сможет быстро установить вид взлома, оценить нанесенный ущерб, а в ряде случаев еще и выявить злоумышленника. Но, обо всем по порядку.
Проблемы, с которыми сталкиваются реальные приложения
Чтобы понять, для чего нужны лог файлы, следует знать, с какими проблемами могут столкнуться реальные программные продукты. Так, рассмотрим самый простой сайт. Он включает:
- систему передачи названия веб-сайта в ip-адрес сервера – DNS;
- интернет-сервер: программу, обрабатывающую входящие запросы, перенаправляющую их в код софта и получающую из него данные, необходимые пользователю;
- физический или виртуальный сервер и его инфраструктуру: аппаратное обеспечение, операционная система, обслуживающие программы;
- базу данных: внешнее хранилище, с которым будет работать код приложения, чтобы отправить или получить нужную информацию;
- программу: включает код самого приложения, а также миллионы строк библиотек, работает в рамках фреймворка со своими правилами обработки поступающих запросов;
- фронт-энд часть: код, выполняемый на пользовательском браузере, системы сборки и пр.
Это самая простая из возможных структур. Но большая часть современных сайтов имеет куда более сложное строение. Огромное количество дополнительных серверов, систем кеширования для ускорения доступа, внешние, в том числе облачные сервисы, очереди, асинхронные коды и многое другое. В результате написанный программистом код обрастает многослойной, разветвленной структурой. И что делать, если произошел сбой? Основная задача – найти, где это случилось и почему. Но в решении она очень сложная. И самое неприятное то, что проблемы могут быть выявлены не на этапе создания продукта, а уже тогда, когда он запушен в работу.
Аренда выделенного
сервера
Разместим оборудование
в собственном дата-центре
уровня TIER III.
Конфигуратор сервера
Подбор оборудования для решения Ваших задач и экономии бюджета IT
Зачем нужно логирование
И единственный способ эффективно решить ее – проанализировать лог. Осталось только понять, что значит логирование? Речь идет о записи специального текстового файла (лога) с полной информацией о работе программы, действиях пользователей. В результате получается некий журнал, каждая строчка в котором соответствует определенному действию. И если возникает любая непредвиденная ситуация, специалисту надо анализировать логи. Так он сможет узнать, что происходило и когда. Анализируя данные, программист выявит не только проблему, но и те факторы, которые спровоцировали ее появление, сможет понять, возникает ли она постоянно или только при определенных обстоятельствах.
Логи стоит записывать в процессе работы каждого компонента IT-инфраструктуры. Выгоду от его использования получит каждый специалист:
- администратор сможет понять почему произошел сбой устройства, ОС или «лег» сайт;
- Seo-специалисты получат наглядную картину о посещаемости, смогут оценить целевой трафик;
- разработчики, выполняя регулярно просмотр лога, выявят и устранят ошибки в продукте еще в процессе программирования, смогут при помощи простых интерфейсов отслеживать работу продукта в режиме реального времени;
- администраторы интернет-магазинов смогут держать под контролем процесс взаимодействия с заказами, платежными системами, видеть изменения, происходящие в них;
- представители системы безопасности компании смогут выявить факт посягательства на конфиденциальность информации и связанных с этим лиц.
Контроль над приложением необходимо будет продолжить даже после того, как оно пойдет в работу. Это позволит постоянно быть в курсе происходящего, мгновенно реагировать на чрезвычайные происшествия. То есть анализ логов – это одна из обязанностей в работе ИТ-специалистов. Это возможность быстро находить и проблемы, и их источники, устранять их, выявлять конфликты в конфигурационных файлах, следить за безопасностью. Поэтому специалисты не рекомендуют пренебрегать логированием и повсеместно использовать его администрировании бизнеса, при отладке программных продуктов, диагностике проблем как ПО, так и баз данных.
Знакомимся с типами логов
Чтобы процесс работы с логами был более простым и удобным, их разделяют на несколько типов:
- системные – связаны с событиями, происходящими в операционной системе;
- серверные – формируют список обращений к серверу;
- баз данных – фиксируют обращения к базам данных;
- почтовые – работают с входящими или исходящими письмами, находят ошибки, ввиду которых они не были отправлены или получены;
- авторизации и аутентификации – отвечают за все моменты, связанные с входом и выходом из системы, восстановлением доступа;
- приложений – отвечают за установленные софты.
Для каждого из них надо создавать отдельный журнал записи в особом формате. Так будет более удобно анализировать состояние продукта, находить источники проблем и инструменты для работы с ними.
Дополнительно предусмотрена классификация логов по степени их важности. Так, к группе Fatal/critical error будут относиться те, которые требуют как можно более быстрого выполнения. Ошибки, которые не будут влиять на работу пользователей стоит записывать в группу Not critical error. В файле Warning будут храниться предупреждающие строки, то есть то, на что стоит обратить внимание. Для записи информации о запросах баз данных, вызовах API или других серверов предусмотрена категория Initial information.
Знакомимся с уровнями логирования
Заниматься логированием необходимо во время разработки и последующей эксплуатации всех IT-систем. Но если так делать, подучим огромное количество файлов и разобраться в них будет крайне сложно. Даже в том случае, если классифицировать их по типам и степени важности. Чтобы не разводить хаос, систематизировать важную информацию, упростить ее последующее использование, предусмотрены уровни логирования. Всего выделяют 4 основных:
- Debug. Здесь будут записывать масштабными переходы состояний. Речь идет об обращении к базам данных, запуск и остановка сервиса, подтверждение успешной обработки информации.
- Warning. В этой папке будет находиться все то, что относится к внештатной ситуации, проблемах, требующих внимания. Корявые запросы, некорректные вызовы – все эти логи можно будет найти здесь.
- Error. Этот уровень предполагает сбор типичных ошибок.
- Fatal. Искать проблему серьезных сбоев в работе необходимо в этой папке. Логи, хранящиеся в ней, помогут найти проблему отказа в доступе к базе данных, отсутствии свободного места на жестком диске и пр.
- Trace. Предполагает пошаговую запись происходящих процессов. Сюда стоит заглянуть в том случае, если возникнут сложности с локализацией проблемы.
- Info. Общеознакомительный файл, содержащий информацию о работе сервиса, службы.
Как работать с каждым из этих уровней прописывается в соответствующие методологической документации и внутренних правилах компании. Она определяет последовательность действия специалистов при возникновении той или иной ситуации, порядок обработки каждого из уровней.
Основы грамотного логирования
Чтобы получить файлы логирования, которые будут удобными в последующей работе, следует грамотно подойти к процессу их создания:
- логировать все важные события, будь то запуск приложение, остановка или возобновление транзакций, успешная регистрация, ошибки и пр.;
- исключить часто повторяющиеся слова, что существенно упростит поиск нужной информации в будущем;
- добавлять к логам теги: переходя по ним вы сможете находить данные, даже если они находятся в разных категориях;
- установить для своей компании стандартизированный формат для создания файлов: унифицированное решение будет удобным и для разработчиков, и для пользователей;
- вводить каждое новое сообщение в новую строку;
- использовать только нужную информацию: лишние сведения будут только засорять дисплей;
- использовать типы и уровни логирования осознанно, ведь только так удастся правильно структурировать данные.
Задать вопросы специалистам компании «Xelent, получить профессиональную помощь в логировании, узнать условия сотрудничества можно по телефону или через форму обратной связи.
Популярные услуги
Аренда FTP сервера
Разработчики приложений часто сталкиваются с ситуаций, когда нужно создать backup файлов, но места для его хранения нет. Аренда FTP сервера в Xelent поможет решить эту проблему.
Аренда терминального сервера
Аренда терминального сервера – отличная альтернатива покупке дорогостоящего компьютерного оборудования. Клиент приобретает готовую систему на базе Windows, предназначенную для корпоративных пользователей. Работники компании получат облачный доступ к стандартным приложениям ОС и специализированным программам (1С: Бухгалтерия, PayDox и т.д.).
Отказоустойчивое облако Xelent
Каждый элемент в отказоустойчивом облаке подключен к двум независимым линиям питания. Система АВР позволяет корректно переключать нагрузку между основным и резервным питанием.
Правильный сбор логов
Есть у меня одна слабость — я люблю разные системы мониторинга. То есть для меня идеальна ситуация, когда можно посмотреть состояние каждого компонента системы в любой момент времени. С реалтаймом все более-менее понятно: можно агрегировать данные и выводить их на красивый дашборд. Сложнее обстоят дела с тем, что было в прошлом, когда нужно узнать разные события в определенный момент и связать их между собой.
Задачка на самом деле не такая уж тривиальная. Во-первых, нужно агрегировать логи с совершенно разных систем, которые зачастую не имеют ничего общего между собой. Во-вторых, нужно привязывать их к одной временной шкале, чтобы события можно было между собой коррелировать. И в-третьих, нужно эффективно устроить хранение и поиск по этому огромному массиву данных. Впрочем, как это обычно бывает, о сложной части уже позаботились до нас. Я пробую несколько разных вариантов и поэтому сделаю мини-обзор того, с чем уже успел поработать.
Онлайн-сервисы
Самый простой вариант, который на первых порах отлично работал для меня, — использовать облачный сервис. Подобные инструменты активно развиваются, предоставляют поддержку все большего количества технологических стеков и подстраиваются по специфику отдельных IaaS/PaaS’ов вроде AWS и Heroku.
Splunk
Про этот сервис писал в колонке и я, и недавно Алексей Синцов. Вообще говоря, это не просто агрегатор логов, а мощная система аналитики с многолетней историей. Поэтому задачка собрать логи и агрегировать их для дальнейшей обработки и поиска — для него плевое дело. Существует более 400 различных приложений, в том числе более ста в области IT Operations Management, которые позволяют собирать информацию с твоих серверов и приложений.
loggly
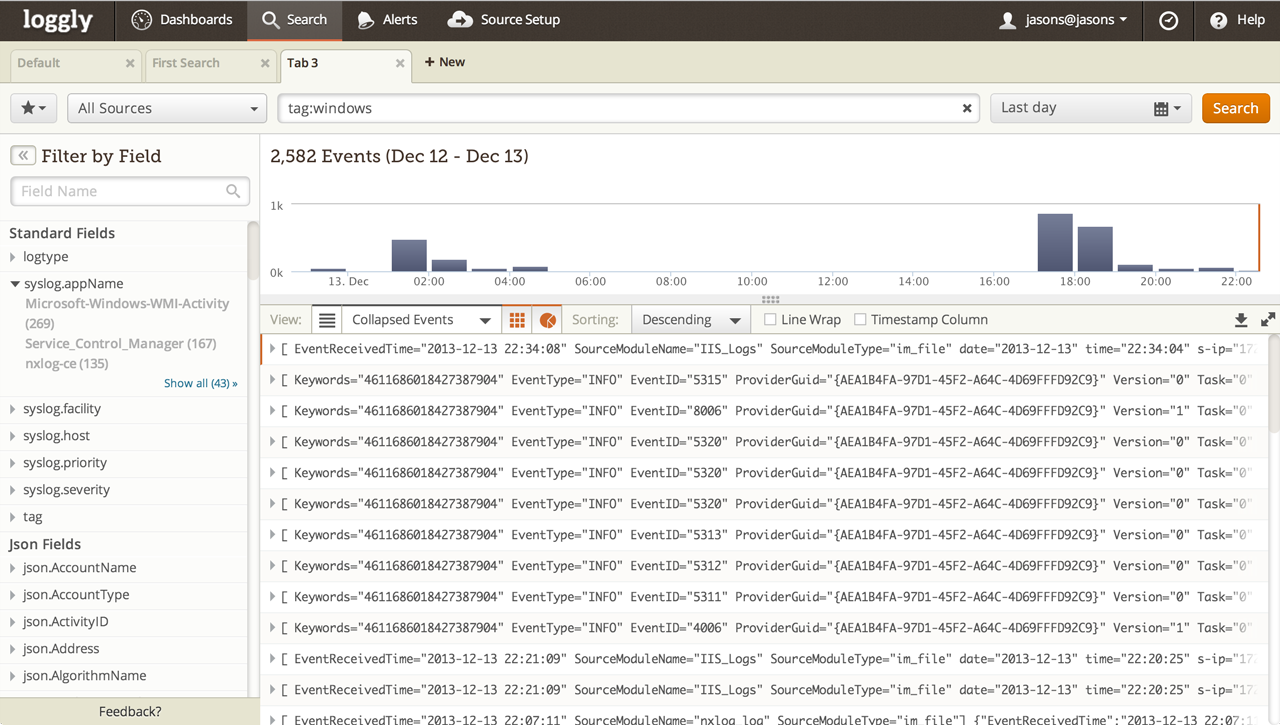
Этот сервис уже специально заточен для анализа журналов и позволяет агрегировать любые виды текстовых логов. Ruby, Java, Python, C/C++, JavaScript, PHP, Apache, Tomcat, MySQL, syslog-ng, rsyslog, nxlog, Snare, роутеры и свитчи — неважно. Бесплатно можно собирать до 200 Мб в день (что немало), а ближайший платный тариф начинается от 49 долларов. Работает очень здорово.
Рекомендуем почитать:
Xakep #293. MikroTik Nightmare
- Содержание выпуска
- Подписка на «Хакер» -60%
PaperTrail
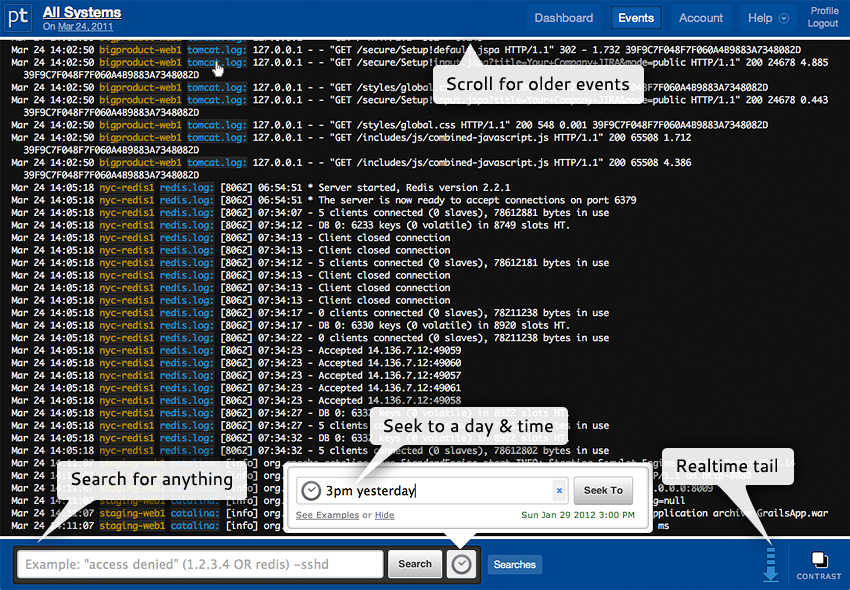
Отличный сервис, который агрегирует логи приложений, любые текстовые журналы, syslog и прочее. Что интересно: с агрегированными данными можно работать через браузер, командную строку или API. Поиск осуществляется простыми запросами вроде «3pm yesterday» (получить данные со всех систем в три часа ночи за вчерашний день). Все связанные события будут сгруппированы. Для любого условия можно сделать алерт, чтобы вовремя получить предупреждения (изменились настройки в конфигах). Для хранения логов можно использовать S3. В первый месяц дают 5 Гб бонусом, дальше бесплатно предоставляется только 100 Мб в месяц.
Logentries
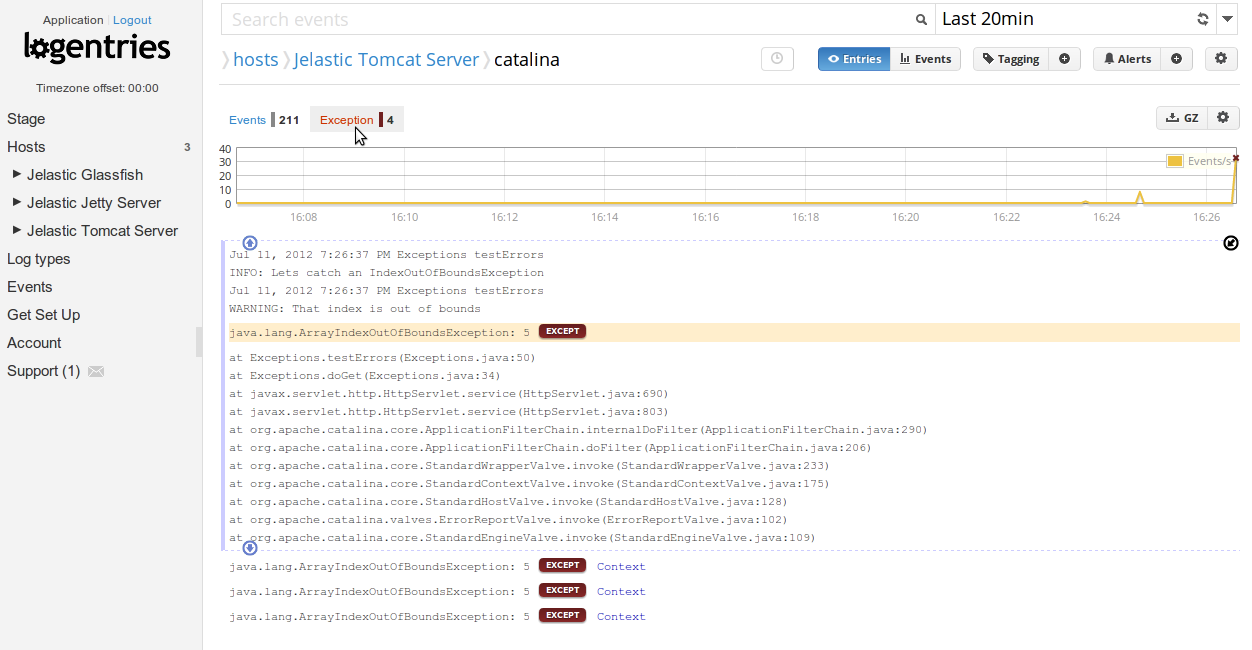
Еще один неплохой сервис для сбора данных, позволяющий собирать до гигабайта логов в месяц бесплатно. А возможности все те же: мощный поиск, tail в режиме реального времени (выводится все, что «прилетает» из логов на текущий момент), хранение данных в AWS, мониторинг PaaS, IaaS и популярных фреймворков, языков. На бесплатном тарифе можно хранить данные за семь дней.
NewRelic
Да, этот сервис не совсем для сбора логов. Но если стоит вопрос о мониторинге производительности серверов и приложений, то это один из лучших вариантов. Причем в большинстве случаев с ним можно работать бесплатно, чем мы долгое время и пользовались в редакции для мониторинга приложений и статуса серверов.
Развернуть все у себя
Мои эксперименты с онлайн-сервисами закончились, когда данных стало так много, что за их агрегацию пришлось бы платить трехзначные суммы. Впрочем, оказалось, что развернуть подобное решение можно и самому. Тут два основных варианта.
logstash
Это открытая система для сбора событий и логов, которая хорошо себя зарекомендовала в сообществе. Развернуть ее, конечно, несложно — но это уже и не готовый сервис из коробки. Поэтому будь готов к багам в скупой документации, глюкам модулей и подобному. Но со своей задачей logstash справляется: логи собираются, а поиск осуществляется через веб-интерфейс.
Fluentd
Если выбирать standalone-решение, то Fluentd мне понравился больше. В отличие от logstash, которая написана на JRuby и поэтому требует JVM (которую я не люблю), она реализована на CRuby и критические по производительности участки написаны на C. Система опять же открытая и позволяет собирать большие потоки логов, используя более 1500 различных плагинов. Она хорошо документирована и предельно понятна. Текущий вариант сборщика логов у меня развернут именно на Fluentd.
Впервые опубликовано в Хакер #03/182
Степа Ильин
Главный редактор «Хакера» с 2012 по начало 2014 года. Сейчас с командой единомышленников строит компанию Wallarm, разрабатывающую решения для защиты веб-приложений от хакерских атак и обнаружения в них уязвимостей.
Архитектура для сбора логов
Логи помогают понять, что происходит внутри приложения. Они особенно полезны для отладки проблем и мониторинга деятельности кластера. У большинства современных приложений имеется тот или иной механизм сбора логов. Контейнерные движки в этом смысле не исключение. Самый простой и наиболее распространенный метод сбора логов для контейнерных приложений задействует потоки stdout и stderr .
Однако встроенной функциональности контейнерного движка или среды исполнения обычно недостаточно для организации полноценного решения по сбору логов.
Например, может возникнуть необходимость просмотреть логи приложения при аварийном завершении работы Pod’а, его вытеснении (eviction) или «падении» узла.
В кластере у логов должно быть отдельное хранилище и жизненный цикл, не зависящий от узлов, Pod’ов или контейнеров. Эта концепция называется сбор логов на уровне кластера.
Архитектуры для сбора логов на уровне кластера требуют отдельного бэкенда для их хранения, анализа и выполнения запросов. Kubernetes не имеет собственного решения для хранения такого типа данных. Вместо этого существует множество продуктов для сбора логов, которые прекрасно с ним интегрируются. В последующих разделах описано, как обрабатывать логи и хранить их на узлах.
Основы сбора логов в Kubernetes
В примере ниже используется спецификация Pod с контейнером для отправки текста в стандартный поток вывода раз в секунду.
apiVersion: v1 kind: Pod metadata: name: counter spec: containers: - name: count image: busybox:1.28 args: [/bin/sh, -c, 'i=0; while true; do echo "$i: $(date)"; i=$((i+1)); sleep 1; done'] Запустить его можно с помощью следующей команды:
kubectl apply -f https://k8s.io/examples/debug/counter-pod.yaml Результат будет таким:
pod/counter created Получить логи можно с помощью команды kubectl logs , как показано ниже:
kubectl logs counter Результат будет таким:
0: Mon Jan 1 00:00:00 UTC 2001 1: Mon Jan 1 00:00:01 UTC 2001 2: Mon Jan 1 00:00:02 UTC 2001 . Команда kubectl logs —previous позволяет извлечь логи из предыдущего воплощения контейнера. Если в Pod’е несколько контейнеров, выбрать нужный для извлечения логов можно с помощью флага -c :
kubectl logs counter -c count Для получения дополнительной информации см. документацию по kubectl logs .
Сбор логов на уровне узла
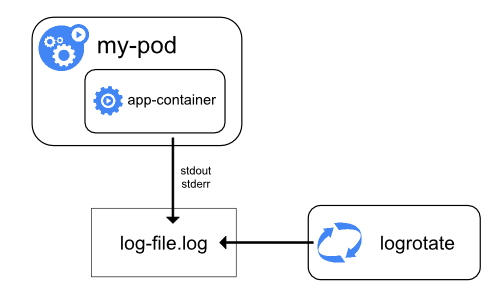
Среда исполнения для контейнера обрабатывает и перенаправляет любой вывод в потоки stdout и stderr приложения. Docker Engine, например, перенаправляет эти потоки драйверу журналирования, который в Kubernetes настроен на запись в файл в формате JSON.
Примечание: JSON-драйвер Docker для сбора логов рассматривает каждую строку как отдельное сообщение. В данном случае поддержка многострочных сообщений отсутствует. Обработка многострочных сообщений должна выполняться на уровне лог-агента или выше.
По умолчанию, если контейнер перезапускается, kubelet сохраняет один завершенный контейнер с его логами. Если Pod вытесняется с узла, все соответствующие контейнеры также вытесняются вместе с их логами.
Важным моментом при сборе логов на уровне узла является их ротация, чтобы логи не занимали все доступное место на узле. Kubernetes не отвечает за ротацию логов, но способен развернуть инструмент для решения этой проблемы. Например, в кластерах Kubernetes, развертываемых с помощью скрипта kube-up.sh , имеется инструмент logrotate , настроенный на ежечасный запуск. Также можно настроить среду исполнения контейнера на автоматическую ротацию логов приложения.
Подробную информацию о том, как kube-up.sh настраивает логирование для образа COS на GCP, можно найти в соответствующем скрипте configure-helper .
При использовании среды исполнения контейнера CRI kubelet отвечает за ротацию логов и управление структурой их директории. kubelet передает данные среде исполнения контейнера CRI, а та сохраняет логи контейнера в указанное место. С помощью параметров containerLogMaxSize и containerLogMaxFiles в конфигурационном файле kubelet’а можно настроить максимальный размер каждого лог-файла и максимальное число таких файлов для каждого контейнера соответственно.
При выполнении команды kubectl logs (как в примере из раздела про основы сбора логов) kubelet на узле обрабатывает запрос и считывает данные непосредственно из файла журнала. Затем он возвращает его содержимое.
Примечание: Если ротацию выполнила внешняя система или используется среда исполнения контейнера CRI, команде kubectl logs будет доступно содержимое только последнего лог-файла. Например, имеется файл размером 10 МБ, logrotate выполняет ротацию, и получается два файла: первый размером 10 МБ, второй — пустой. В этом случае kubectl logs вернет второй лог-файл (пустой).
Логи системных компонентов
Существует два типа системных компонентов: те, которые работают в контейнере, и те, которые работают за пределами контейнера. Например:
- планировщик Kubernetes и kube-proxy выполняются в контейнере;
- kubelet и среда исполнения контейнера работают за пределами контейнера.
На машинах с systemd среда исполнения и kubelet пишут в journald. Если systemd отсутствует, среда исполнения и kubelet пишут в файлы .log в директории /var/log . Системные компоненты внутри контейнеров всегда пишут в директорию /var/log , обходя механизм ведения логов по умолчанию. Они используют библиотеку для сбора логов klog . Правила сбора логов и рекомендации можно найти в соответствующей документации.
Как и логи контейнеров, логи системных компонентов в директории /var/log необходимо ротировать. В кластерах Kubernetes, созданных с помощью скрипта kube-up.sh , эти файлы настроены на ежедневную ротацию с помощью инструмента logrotate или при достижении 100 МБ.
Архитектуры для сбора логов на уровне кластера
Kubernetes не имеет собственного решения для сбора логов на уровне кластера, но есть общие подходы, которые можно рассмотреть. Вот некоторые из них:
- использовать агент на уровне узлов (запускается на каждом узле);
- внедрить в Pod с приложением специальный sidecar-контейнер для сбора логов;
- отправлять логи из приложения непосредственно в бэкенд.
Использование агента на уровне узлов
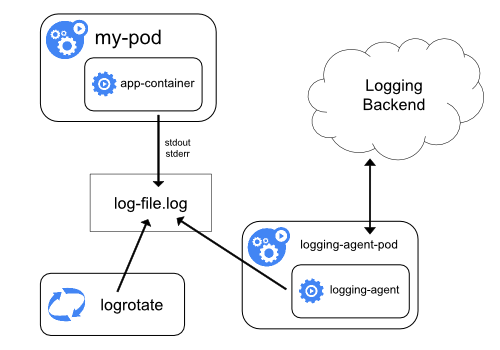
Сбор логов на уровне кластера можно реализовать, запустив node-level-агент на каждом узле. Лог-агент — это специальный инструмент, который предоставляет доступ к логам или передает их бэкенду. Как правило, лог-агент представляет собой контейнер с доступом к директории с файлами логов всех контейнеров приложений на этом узле.
Поскольку лог-агент должен работать на каждом узле, рекомендуется запускать его как DaemonSet .
Сбор логов на уровне узла предусматривает запуск одного агента на узел и не требует изменений в приложениях, работающих на узле.
Контейнеры пишут в stdout и stderr , но без согласованного формата. Агент на уровне узла собирает эти логи и направляет их на агрегацию.
Сбор логов с помощью sidecar-контейнера с лог-агентом
Sidecar-контейнер можно использовать одним из следующих способов:
- sidecar-контейнер транслирует логи приложений на свой собственный stdout ;
- в sidecar-контейнере работает агент, настроенный на сбор логов из контейнера приложения.
Транслирующий sidecar-контейнер
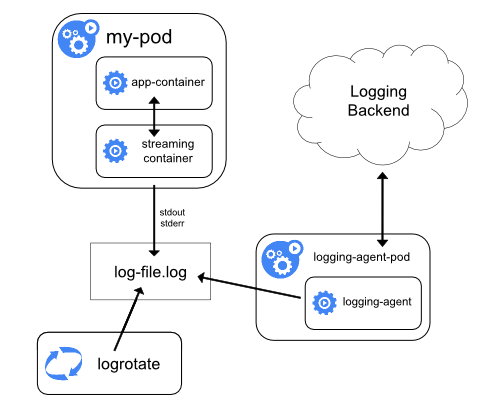
Настроив sidecar-контейнеры на вывод в их собственные потоки stdout и stderr , можно воспользоваться преимуществами kubelet и лог-агента, которые уже работают на каждом узле. Sidecar-контейнеры считывают логи из файла, сокета или journald. Затем каждый из них пишет логи в собственный поток stdout или stderr .
Такой подход позволяет разграничить потоки логов от разных частей приложения, некоторые из которых могут не поддерживать запись в stdout или stderr . Логика, управляющая перенаправлением логов, проста и не требует значительных ресурсов. Кроме того, поскольку stdout и stderr обрабатываются kubelet’ом, можно использовать встроенные инструменты вроде kubectl logs .
Предположим, к примеру, что в Pod’е работает один контейнер, который пишет логи в два разных файла в двух разных форматах. Вот пример конфигурации такого Pod’а:
apiVersion: v1 kind: Pod metadata: name: counter spec: containers: - name: count image: busybox:1.28 args: - /bin/sh - -c - > i=0; while true; do echo "$i: $(date)" >> /var/log/1.log; echo "$(date) INFO $i" >> /var/log/2.log; i=$((i+1)); sleep 1; done volumeMounts: - name: varlog mountPath: /var/log volumes: - name: varlog emptyDir: <> Не рекомендуется писать логи разных форматов в один и тот же поток, даже если удалось перенаправить оба компонента в stdout контейнера. Вместо этого можно создать два sidecar-контейнера. Каждый из них будет забирать определенный лог-файл с общего тома и перенаправлять логи в свой stdout .
Вот пример конфигурации Pod’а с двумя sidecar-контейнерами:
apiVersion: v1 kind: Pod metadata: name: counter spec: containers: - name: count image: busybox:1.28 args: - /bin/sh - -c - > i=0; while true; do echo "$i: $(date)" >> /var/log/1.log; echo "$(date) INFO $i" >> /var/log/2.log; i=$((i+1)); sleep 1; done volumeMounts: - name: varlog mountPath: /var/log - name: count-log-1 image: busybox:1.28 args: [/bin/sh, -c, 'tail -n+1 -F /var/log/1.log'] volumeMounts: - name: varlog mountPath: /var/log - name: count-log-2 image: busybox:1.28 args: [/bin/sh, -c, 'tail -n+1 -F /var/log/2.log'] volumeMounts: - name: varlog mountPath: /var/log volumes: - name: varlog emptyDir: <> Доступ к каждому потоку логов такого Pod’а можно получить отдельно, выполнив следующие команды:
kubectl logs counter count-log-1 Результат будет таким:
0: Mon Jan 1 00:00:00 UTC 2001 1: Mon Jan 1 00:00:01 UTC 2001 2: Mon Jan 1 00:00:02 UTC 2001 . kubectl logs counter count-log-2 Результат будет таким:
Mon Jan 1 00:00:00 UTC 2001 INFO 0 Mon Jan 1 00:00:01 UTC 2001 INFO 1 Mon Jan 1 00:00:02 UTC 2001 INFO 2 . Агент на уровне узла, установленный в кластере, подхватывает эти потоки логов автоматически без дополнительной настройки. При желании можно настроить агент на парсинг логов в зависимости от контейнера-источника.
Обратите внимание: несмотря на низкое использование процессора и памяти (порядка нескольких milliCPU для процессора и пары мегабайт памяти), запись логов в файл и их последующая потоковая передача в stdout может вдвое увеличить нагрузку на диск. Если приложение пишет в один файл, рекомендуется установить /dev/stdout в качестве адресата, нежели использовать подход с транслирующим контейнером.
Sidecar-контейнеры также можно использовать для ротации файлов логов, которые не могут быть ротированы самим приложением. В качестве примера можно привести небольшой контейнер, периодически запускающий logrotate . Однако рекомендуется использовать stdout и stderr напрямую, а управление политиками ротации и хранения оставить kubelet’у.
Sidecar-контейнер с лог-агентом
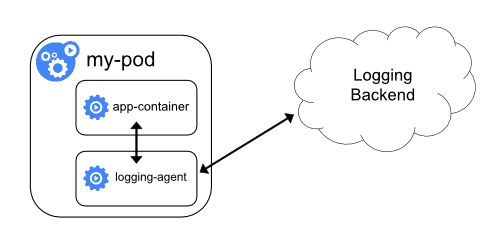
Если лог-агент на уровне узла недостаточно гибок для ваших потребностей, можно создать sidecar-контейнер с отдельным лог-агентом, специально настроенным на работу с приложением.
Примечание: Работа лог-агента в sidecar-контейнере может привести к значительному потреблению ресурсов. Более того, доступ к этим журналам с помощью kubectl logs будет невозможен, поскольку они не контролируются kubelet’ом.
Ниже приведены два файла конфигурации sidecar-контейнера с лог-агентом. Первый содержит ConfigMap для настройки fluentd.
apiVersion: v1 kind: ConfigMap metadata: name: fluentd-config data: fluentd.conf: | type tail format none path /var/log/1.log pos_file /var/log/1.log.pos tag count.format1 type tail format none path /var/log/2.log pos_file /var/log/2.log.pos tag count.format2 type google_cloud Примечание: За информацией о настройке fluentd обратитесь к его документации.
Второй файл описывает Pod с sidecar-контейнером, в котором работает fluentd. Pod монтирует том с конфигурацией fluentd.
apiVersion: v1 kind: Pod metadata: name: counter spec: containers: - name: count image: busybox:1.28 args: - /bin/sh - -c - > i=0; while true; do echo "$i: $(date)" >> /var/log/1.log; echo "$(date) INFO $i" >> /var/log/2.log; i=$((i+1)); sleep 1; done volumeMounts: - name: varlog mountPath: /var/log - name: count-agent image: registry.k8s.io/fluentd-gcp:1.30 env: - name: FLUENTD_ARGS value: -c /etc/fluentd-config/fluentd.conf volumeMounts: - name: varlog mountPath: /var/log - name: config-volume mountPath: /etc/fluentd-config volumes: - name: varlog emptyDir: <> - name: config-volume configMap: name: fluentd-config В приведенных выше примерах fluentd можно заменить на другой лог-агент, считывающий данные из любого источника в контейнере приложения.
Прямой доступ к логам из приложения
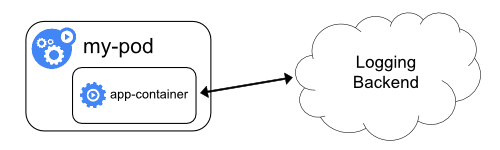
Сбор логов приложения на уровне кластера, при котором доступ к ним осуществляется напрямую, выходит за рамки Kubernetes.
Обратная связь
Эта страница была полезна?
Спасибо за обратную связь! Если у вас есть конкретный вопрос об использовании Kubernetes, спросите на Stack Overflow. Создайте issue в репозитории GitHub, если вы хотите сообщить о проблеме или предложить улучшение.