Варианты представления бинарного дерева с помощью массива и указателей
1 — Варианты представления бинарного дерева с помощью массива.
2 — Варианты представления бинарного дерева с помощью указателей.
Кто расскажет или даст ссылку на информацию?)
Лучшие ответы ( 1 )
94731 / 64177 / 26122
Регистрация: 12.04.2006
Сообщений: 116,782
Ответы с готовыми решениями:
Построение бинарного дерева из двумерного массива
Стыдно, если честно, об этом просить, но "возник стопор" и путных идей не приходит. Суть задачи: .
Переворот массива с помощью указателей
Здрасте! Учусь на программера недавно. Вот задали перевернуть массив рекурсивно с использованием.
Запись массива в виде бинарного дерева и вывод его на экран!
Задача: Зарандомить массив с 30 ел. от -100 до 100, создать бинарное дерево использую дан.
Запись бинарного дерева в файл и восстановление из него этого дерева
Задача такая: есть бинарное дерево. Каждый элемент дерева содержит 3 указателя — 1 указатель на.
1360 / 988 / 119
Регистрация: 30.07.2010
Сообщений: 5,297

Сообщение было отмечено SatanaXIII как решение
Решение
Тут лучше всего описано

342 / 306 / 36
Регистрация: 16.06.2009
Сообщений: 486
1 2 3 4 5 6
struct Tree { int data; //информационное поле; Tree* left; //указатель на левое поддерево; Tree* right; //указатель на правое поддерево; };
Алгоритмы и структуры данных для начинающих: двоичное дерево поиска
До сих пор мы рассматривали структуры данных, данные в которых располагаются линейно. В связном списке — от первого узла к единственному последнему. В динамическом массиве — в виде непрерывного блока.
В этой части мы рассмотрим совершенно новую структуру данных — дерево. А точнее, двоичное (бинарное) дерево поиска (binary search tree). Бинарное дерево поиска имеет структуру дерева, но элементы в нем расположены по определенным правилам.
Для начала мы рассмотрим обычное дерево.
Деревья
Дерево — это структура, в которой у каждого узла может быть ноль или более подузлов — «детей». Например, дерево может выглядеть так:
На данный момент этот блок не поддерживается, но мы не забыли о нём! Наша команда уже занята его разработкой, он будет доступен в ближайшее время.
Это дерево показывает структуру компании. Узлы представляют людей или подразделения, линии — связи и отношения. Дерево — это самый эффективный способ представления и хранения такой информации.
Дерево на картинке выше очень простое. Оно отражает только отношение родства категорий, но не накладывает никаких ограничений на свою структуру. У генерального директора может быть как один непосредственный подчиненный, так и несколько или ни одного. На рисунке отдел продаж находится левее отдела маркетинга, но порядок на самом деле не имеет значения. Единственное ограничение дерева — каждый узел может иметь не более одного родителя. Самый верхний узел (совет директоров, в нашем случае) родителя не имеет. Этот узел называется «корневым», или «корнем».
Вопросы о деревьях задают даже на собеседовании в Apple.
Двоичное дерево поиска
Двоичное дерево поиска похоже на дерево из примера выше, но строится по определенным правилам:
- У каждого узла не более двух детей.
- Любое значение меньше значения узла становится левым ребенком или ребенком левого ребенка.
- Любое значение больше или равное значению узла становится правым ребенком или ребенком правого ребенка.
Давайте посмотрим на дерево, построенное по этим правилам:
На данный момент этот блок не поддерживается, но мы не забыли о нём! Наша команда уже занята его разработкой, он будет доступен в ближайшее время.
Обратите внимание, как указанные ограничения влияют на структуру дерева. Каждое значение слева от корня (8) меньше восьми, каждое значение справа — больше либо равно корню. Это правило применимо к любому узлу дерева.
Учитывая это, давайте представим, как можно построить такое дерево. Поскольку вначале дерево было пустым, первое добавленное значение — восьмерка — стало его корнем.
Мы не знаем точно, в каком порядке добавлялись остальные значения, но можем представить один из возможных путей. Узлы добавляются методом Add , который принимает добавляемое значение.
BinaryTree tree = new BinaryTree(); tree.Add(8); tree.Add(4); tree.Add(2); tree.Add(3); tree.Add(10); tree.Add(6); tree.Add(7); Рассмотрим подробнее первые шаги.
В первую очередь добавляется 8. Это значение становится корнем дерева. Затем мы добавляем 4. Поскольку 4 меньше 8, мы кладем ее в левого ребенка, согласно правилу 2. Поскольку у узла с восьмеркой нет детей слева, 4 становится единственным левым ребенком.
После этого мы добавляем 2. 2 меньше 8, поэтому идем налево. Так как слева уже есть значение, сравниваем его со вставляемым. 2 меньше 4, а у четверки нет детей слева, поэтому 2 становится левым ребенком 4.
Затем мы добавляем тройку. Она идет левее 8 и 4. Но так как 3 больше, чем 2, она становится правым ребенком 2, согласно третьему правилу.
Последовательное сравнение вставляемого значения с потенциальным родителем продолжается до тех пор, пока не будет найдено место для вставки, и повторяется для каждого вставляемого значения до тех пор, пока не будет построено все дерево целиком.
Класс BinaryTreeNode
Класс BinaryTreeNode представляет один узел двоичного дерева. Он содержит ссылки на левое и правое поддеревья (если поддерева нет, ссылка имеет значение null ), данные узла и метод IComparable.CompareTo для сравнения узлов. Он пригодится для определения, в какое поддерево должен идти данный узел. Как видите, класс BinaryTreeNode очень простой:
class BinaryTreeNode : IComparable where TNode : IComparable < public BinaryTreeNode(TNode value) < Value = value; >public BinaryTreeNode Left < get; set; >public BinaryTreeNode Right < get; set; >public TNode Value < get; private set; >/// /// Сравнивает текущий узел с данным. /// /// Сравнение производится по полю Value. /// Метод возвращает 1, если значение текущего узла больше, /// чем переданного методу, -1, если меньше и 0, если они равны public int CompareTo(TNode other) < return Value.CompareTo(other); >> Класс BinaryTree
Класс BinaryTree предоставляет основные методы для манипуляций с данными: вставка элемента ( Add ), удаление ( Remove ), метод Contains для проверки, есть ли такое значение в дереве, несколько методов для обхода дерева различными способами, метод Count и Clear .
Кроме того, в классе есть ссылка на корневой узел дерева и поле с общим количеством узлов.
public class BinaryTree : IEnumerable where T : IComparable < private BinaryTreeNode _head; private int _count; public void Add(T value) < throw new NotImplementedException(); >public bool Contains(T value) < throw new NotImplementedException(); >public bool Remove(T value) < throw new NotImplementedException(); >public void PreOrderTraversal(Action action) < throw new NotImplementedException(); >public void PostOrderTraversal(Action action) < throw new NotImplementedException(); >public void InOrderTraversal(Action action) < throw new NotImplementedException(); >public IEnumerator GetEnumerator() < throw new NotImplementedException(); >System.Collections.IEnumerator System.Collections.IEnumerable.GetEnumerator() < throw new NotImplementedException(); >public void Clear() < throw new NotImplementedException(); >public int Count < get; >> Метод Add
- Поведение: Добавляет элемент в дерево на корректную позицию.
- Сложность: O(log n) в среднем; O(n) в худшем случае.
Добавление узла не представляет особой сложности. Оно становится еще проще, если решать эту задачу рекурсивно. Есть всего два случая, которые надо учесть:
- Дерево пустое.
- Дерево не пустое.
Если дерево пустое, мы просто создаем новый узел и добавляем его в дерево. Во втором случае мы сравниваем переданное значение со значением в узле, начиная от корня. Если добавляемое значение меньше значения рассматриваемого узла, повторяем ту же процедуру для левого поддерева. В противном случае — для правого.
public void Add(T value) < //Случай 1: Если дерево пустое, просто создаем корневой узел. if (_head == null) < _head = new BinaryTreeNode(value); >//Случай 2: Дерево не пустое => //ищем правильное место для вставки. else < AddTo(_head, value); >_count++; > //Рекурсивная ставка. private void AddTo(BinaryTreeNode node, T value) < //Случай 1: Вставляемое значение меньше значения узла if (value.CompareTo(node.Value) < 0) < //Если нет левого поддерева, добавляем значение в левого ребенка, if (node.Left == null) < node.Left = new BinaryTreeNode(value); >else < //в противном случае повторяем для левого поддерева. AddTo(node.Left, value); >> //Случай 2: Вставляемое значение больше или равно значению узла. else < //Если нет правого поддерева, добавляем значение в правого ребенка, if (node.Right == null) < node.Right = new BinaryTreeNode(value); >else < //в противном случае повторяем для правого поддерева. AddTo(node.Right, value); >> > Метод Remove
- Поведение: Удаляет первый узел с заданным значением.
- Сложность: O(log n) в среднем; O(n) в худшем случае.
Удаление узла из дерева — одна из тех операций, которые кажутся простыми, но на самом деле таят в себе немало подводных камней.
В целом, алгоритм удаления элемента выглядит так:
- Найти узел, который надо удалить.
- Удалить его.
Первый шаг достаточно простой. Мы рассмотрим поиск узла в методе Contains ниже. После того, как мы нашли узел, который необходимо удалить, у нас возможны три случая.
Случай 1: У удаляемого узла нет правого ребенка.
В этом случае мы просто перемещаем левого ребенка (при его наличии) на место удаляемого узла. В результате дерево будет выглядеть так:
Случай 2: У удаляемого узла есть только правый ребенок, у которого, в свою очередь нет левого ребенка.
В этом случае нам надо переместить правого ребенка удаляемого узла (6) на его место. После удаления дерево будет выглядеть так:
Случай 3: У удаляемого узла есть первый ребенок, у которого есть левый ребенок.
В этом случае место удаляемого узла занимает крайний левый ребенок правого ребенка удаляемого узла.
Давайте посмотрим, почему это так. Мы знаем о поддереве, начинающемся с удаляемого узла следующее:
- Все значения справа от него больше или равны значению самого узла.
- Наименьшее значение правого поддерева — крайнее левое.
Мы дожны поместить на место удаляемого узел со значением, меньшим или равным любому узлу справа от него. Для этого нам необходимо найти наименьшее значение в правом поддереве. Поэтому мы берем крайний левый узел правого поддерева.
После удаления узла дерево будет выглядеть так:
Теперь, когда мы знаем, как удалять узлы, посмотрим на код, который реализует этот алгоритм.
Отметим, что метод FindWithParent (см. метод Contains ) возвращает найденный узел и его родителя, поскольку мы должны заменить левого или правого ребенка родителя удаляемого узла.
Мы, конечно, можем избежать этого, если будем хранить ссылку на родителя в каждом узле, но это увеличит расход памяти и сложность всех алгоритмов, несмотря на то, что ссылка на родительский узел используется только в одном.
public bool Remove(T value) < BinaryTreeNode current, parent; // Находим удаляемый узел. current = FindWithParent(value, out parent); if (current == null) < return false; >_count--; //Случай 1: Если нет детей справа, //левый ребенок встает на место удаляемого. if (current.Right == null) < if (parent == null) < _head = current.Left; >else < int result = parent.CompareTo(current.Value); if (result >0) < //Если значение родителя больше текущего, //левый ребенок текущего узла становится левым ребенком родителя. parent.Left = current.Left; >else if (result < 0) < //Если значение родителя меньше текущего, // левый ребенок текущего узла становится правым ребенком родителя. parent.Right = current.Left; >> > //Случай 2: Если у правого ребенка нет детей слева //то он занимает место удаляемого узла. else if (current.Right.Left == null) < current.Right.Left = current.Left; if (parent == null) < _head = current.Right; >else < int result = parent.CompareTo(current.Value); if (result >0) < //Если значение родителя больше текущего, //правый ребенок текущего узла становится левым ребенком родителя. parent.Left = current.Right; >else if (result < 0) < //Если значение родителя меньше текущего, // правый ребенок текущего узла становится правым ребенком родителя. parent.Right = current.Right; >> > //Случай 3: Если у правого ребенка есть дети слева, //крайний левый ребенок //из правого поддерева заменяет удаляемый узел. else < //Найдем крайний левый узел. BinaryTreeNode leftmost = current.Right.Left; BinaryTreeNode leftmostParent = current.Right; while (leftmost.Left != null) < leftmostParent = leftmost; leftmost = leftmost.Left; >//Левое поддерево родителя становится правым поддеревом //крайнего левого узла. leftmostParent.Left = leftmost.Right; //Левый и правый ребенок текущего узла становится левым //и правым ребенком крайнего левого. leftmost. Left = current.Left; leftmost.Right = current.Right; if (parent == null) < _head = leftmost; >else < int result = parent.CompareTo(current.Value); if (result >0) < //Если значение родителя больше текущего, //крайний левый узел становится левым ребенком родителя. parent.Left = leftmost; >else if (result < 0) < //Если значение родителя меньше текущего, //крайний левый узел становится правым ребенком родителя. parent.Right = leftmost; >> > return true; > Метод Contains
- Поведение: Возвращает true если значение содержится в дереве. В противном случает возвращает false .
- Сложность: O(log n) в среднем; O(n) в худшем случае.
Метод Contains выполняется с помощью метода FindWithParent , который проходит по дереву, выполняя в каждом узле следующие шаги:
- Если текущий узел null , вернуть null .
- Если значение текущего узла равно искомому, вернуть текущий узел.
- Если искомое значение меньше значения текущего узла, установить левого ребенка текущим узлом и перейти к шагу 1.
- В противном случае, установить правого ребенка текущим узлом и перейти к шагу 1.
Поскольку Contains возвращает булево значение, оно определяется сравнением результата выполнения FindWithParent с null . Если FindWithParent вернул непустой узел, Contains возвращает true .
Метод FindWithParent также используется в методе Remove .
public bool Contains(T value) < //Поиск узла осуществляется другим методом. BinaryTreeNode parent; return FindWithParent(value, out parent) != null; >//Находит и возвращает первый узел с заданным значением. //Если значение не найдено, возвращает null. //Также возвращает родителя найденного узла (или null) //для использования в методе Remove. private BinaryTreeNode FindWithParent(T value, out BinaryTreeNode parent) < //Попробуем найти значение в дереве. BinaryTreeNode current = _head; parent = null; //До тех пор, пока не нашли. while (current != null) < int result = current.CompareTo(value); if (result >0) < //Если искомое значение меньше, идем налево. parent = current; current = current.Left; >else if (result < 0) < //Если искомое значение больше, идем направо. parent = current; current = current.Right; >else < //Если равны, то останавливаемся break; >> return current; > Метод Count
- Поведение: Возвращает количество узлов дерева или 0, если дерево пустое.
- Сложность: O(1)
Это поле инкрементируется методом Add и декрементируется методом Remove .
>public int Count < get < return _count; >> Study & Dev О программировании и не только
Структуры данных и алгоритмы. Теория. Деревья. Основные алгоритмы над деревьями
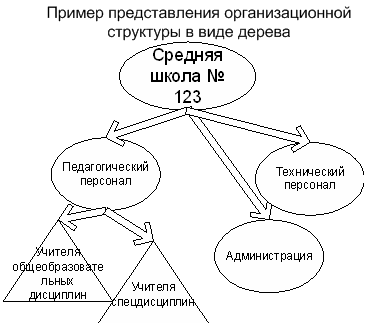
Дерево – это АТД (абстрактный тип данных) для хранения информационных элементов имеющих нелинейные отношения. За исключением элемента, который находится во главе дерева, каждый элемент имеет родителя, а также ноль или более дочерних элементов. Также говорят что дерево – это множество элементов, среди которых есть один выделенный который называется корнем, а остальные содержатся в N непересекающихся подмножествах, которые называются поддеревьями. Очевидно что дерево относится к классу динамических структур данных наряду с нам уже знакомыми стеком, очередями. С помощью дерева можно представить, например, следующую организационную структуру:
Наиболее известным классическим примером деревьев является генеалогическое дерево.
Также в качестве примера можно привести принятую в большинстве файловых систем организацию с помощью иерархически вложенных директорий и файлов. Наиболее ярко это проявляется в О.С. linux и unix, где файловую систему представляют в виде единого дерева, которое начинается с корневой директории обозначаемой “/”.
При дальнейшем обсуждении деревьев следует условиться о терминологии. Корень дерева (root) – первый его элемент (в приведенном выше изображении это “Средняя школа # 123”). Каждый элемент данных называют узлом (node), иногда листом (leaf). Фрагмент дерева называется поддеревом (subtree) или ветвью. Узел, не имеющий отходящих от него ветвей ли поддеревьев, называются терминальным или конечным узлом (terminal node). Высота дерева (height) – определяется количеством уровней, на которых располагаются его узлы. При работе с деревьями полезно изображать их на бумаге, однако при этом всегда следует помнить, что деревья – это метод логической организации информации в памяти компьютера, не физической.
Следует помнить, что большинство операций, которые выполняются над деревьями, являются рекурсивными, т.к. деревья имеют рекурсивную структуру – каждое дерево содержит множество поддеревьев.
О деревьях можно судить как об упорядоченных или не упорядоченных. Мы говорим, что дерево упорядочено, если каждому из элементов можно сопоставить порядковый номер: 1,2,3. На рисунках упорядоченные “братья-узлы” представляются слева направо.
Пример упорядоченного дерева: книга. Книга имеет древовидную структуру с делением на разделы, каждый из которых состоит из множества тем, а тема включает отдельные вопросы. Каждый из вопросов также можно разделить на элементарные части – абзацы, картинки, таблицы. Очевидно, что эти элементы имеют четкий порядок следования, нарушение которого приводит к потере смысла книги.
В информатике наиболее часто используются именно двоичные деревья — это деревья, каждый узел которого содержит не более чем два подчиненных ему (дочерних элемента). Бинарное дерево считается правильным, если каждый узел не содержит одного или содержит два дочерних элемента. Таким образом – генеалогическое дерево – это правильно двоичное дерево. В бинарных деревьях дочерние узлы именуют “правый” и “левый”.
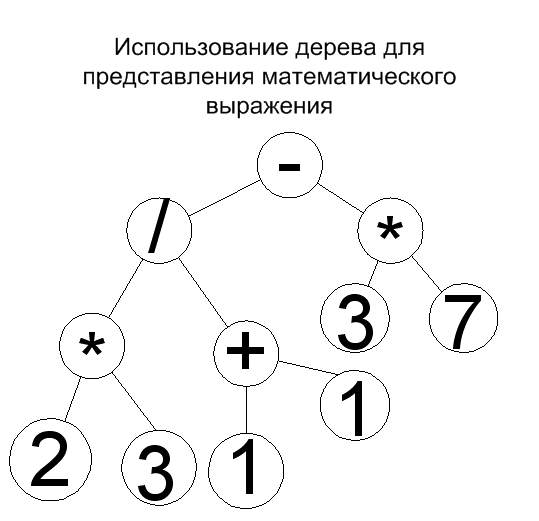
С помощью двоичного дерева можно легко представить арифметическое выражение с использованием бинарных операций.
Например, для выражения: (2*3)/(1+1)-(3*7) можно построить следующее дерево:
- 1+3*5-(17*(21-5))
- 2*3*(2-6)*(7-4)*(1-5)
- 8*1*(5/7)*((1+2)/(3-7))
Для каждого узла дерева можно определить понятие глубины. Допустим, V – узел дерева. Глубина узла выражается количество предков V, за исключением самого V. По определению глубина корня равна нулю.
- если узел –корень, то его глубина ноль;
- в противном случае глубина узла V равна 1 + глубина его родителя V`.
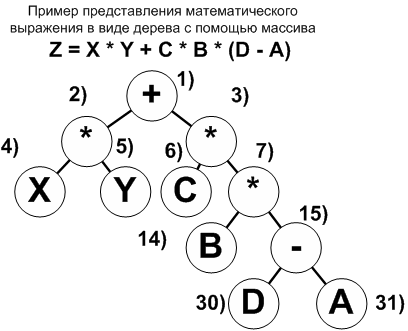
Способы представления деревьев: Представление дерева с помощью массива
- P(V) = 2*N — в случае если узел V находится слева от своего родительского узла V*.
- P(V)= 2*N + 1 – а эта формула применима в той ситуации, когда узел V находится правее чем родительский.
Очень важно, что если дерево не полное, то отсутствующим элементам назначаются номера и для них выделяется место в массиве, просто в ячейке с номером “8, 9, 13, 29” и других (согласно приведенному изображению дерева математического выражения) ничего не хранится.
Представление дерева с помощью ссылок
В случае множественного дерева (каждый узел может иметь произвольное количество потомков) возможно, воспользоваться подобным объявлением:
struct MultiNode {
DATA_TYPE data;
MultiNode * parent;
LIST_OF_NODES children;
В данном примере DATA_TYPE – тип данных соответствующий хранимому в дереве, например, если у нас дерево математического выражения, то это может быть число или знак арифметической операции. Если дерево служит для хранения генеалогической информации – то в качестве типа каждого узла может быть строка с именем человека, или даже произвольная структура или класс CHuman, описывающий кого-то из предков. Обратите внимание на другое, в структуре присутствует ссылка на узел дерева который является родительским, в общем случае это не требуется, однако при решении многих задач поиска и модификации дерева позволяет их упростить, благодаря подобной ссылке мы можем перемещаться по дереву не только в направлении от корня к нижележащим элементам, но и в обратном порядке.
Под LIST_OF_NODES подразумевается некий контейнер способный хранить внутри себя достаточное количество ссылок на поддеревья. В случае если количество не велико и относительно стабильно, то можно воспользоваться обычным массивом. В случае, когда количество элементом может варьироваться в произвольном диапазоне, то рекомендуется применять один из ранее изученных контейнеров: очередь, дек. Если вы используете средства STL, то можно объявить ссылку на множество поддеревьев так:
Vector MultiNode *> children;
List MultiNode *> children;
В случае использования частного случая – бинарного дерева, объявление узла выглядит проще:
struct BinNode {
DATA_TYPE data;
BinNode * parent;
BinNode * left , * right;
Алгоритмы формирования деревьев
До текущего момента все рассмотренные алгоритмы предполагали, что у нас есть построенное двоичное или мульти-дерево. Теперь мы рассмотрим схему формирования деревьев с упором именно на практические направления. Одним из важнейших направлений использования бинарных деревьев является оптимизация задач поиска. Когда мы рассматривали тему поиска, то из двух способов – линейных поиск (затраты порядка O(n)) и двоичного поиска (затраты порядка O(log n)) очевидным было применение именно второго подхода. Однако в этом случае нам было необходимо выполнить сортировку массива данных в противном случае алгоритм не работал. В случае использования двоичных деревьев можно создать такой алгоритм его формирования, что задача поиска в нем нужного элемента также будет составлять порядка O(log n).
Пример: предположим, что нашей программе на вход подается поток чисел (в общем случае не упорядоченный), если мы опишем узел дерева как
struct BinNode {
int data;
BinNode * left , * right;
И потребуем чтобы все узлы, находящиеся в правом поддереве были больше чем корневой элемент, а все узлы из левого поддерева были не более чем корневой элемент, то в таком случае для последовательности чисел: 6 1 3 7 2 9 4 5 2 будет построено следующее дерево:
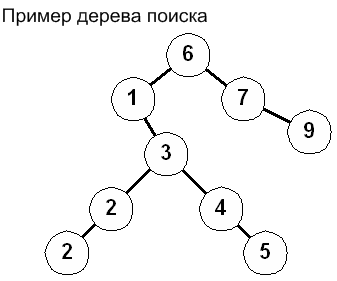
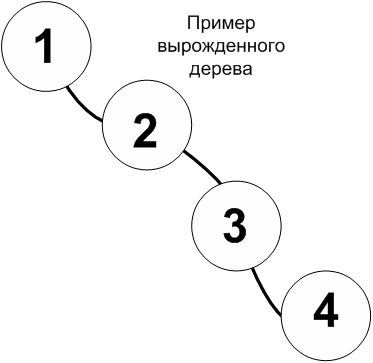
Деревья, для которых выполняется вышеописанное соотношение, называются деревьями поиска. В таком дереве, для того чтобы найти нужный элемент на каждом шаге пути необходимо принимать решение о выборе направления в зависимости от того, как соотносятся искомый элемент X и значение текущего узла Vi. Если Vi >= X то в таком случае поиск должен идти именно в левом поддереве, в противном случае в правом. Следует отметить, что получившееся двоичное дерево и соответственно эффективность операций поиска сильно зависит от степени упорядоченности поступающих наборов чисел. В случае если эти значения уже отсортированы, например: 1, 2, 3, 4 то получающееся дерево вырождается и начинает напоминать обычный линейный список.
В идеальном случае дерево должно быть сбалансированным. Напомню, что сбалансированным деревом является то, где количество узлов в правом и левом поддеревьях отличаются не более чем на 1. для повышения скорости работы алгоритма поиска в бинарном дереве также используют прием буфера (барьера). В этом случае все ветви будут заканчиваться не ссылкой на NULL, а ссылкой на этот буферный элемент. То, что у нас получилось можно увидеть на картинке:
BinNode * find (int data, BinNode * cur){
while (cur && cur->data != data)
if ( cur->data data)
cur = cur->left;
else
cur = cur->right;
return cur;
BinNode * find (int data, BinNode * cur){
GlobalBuffer->data = data;
while (cur->data != data)
if ( data cur->data)
cur = cur->left;
else
cur = cur->right;
return cur;
Замечания к приведенным алгоритмам
В примере 2 предполагается наличие глобальной переменной GlobalBuffer, которая и является ссылкой на вспомогательный (фиктивный) барьерный элемент. Отметьте, что значение информационной компоненты data для этого буферного элемента перед началом цикла устанавливается в data, что позволяет упростить поиск за счет уменьшения количества операций сравнения. Часто начинающие программисты пытаются реализовать подобный поиск с помощью рекурсии, аргументируя, что раз структура данных рекурсивна то и поиск тоже должен быть таковым. Напоминаю, что настоятельно рекомендуется избегать применения рекурсии везде где это возможно из-за непроизводительных затрат на вызов функции.
Очевидно, что деревья будут вряд ли применяться в задачах, структуры данных которых сформированы и не изменяются на протяжении работы программы. Также очевидно, что на практике деревья должны будут расти и уменьшаться. Рассмотрим пример использования дерева для решения задачи частотного анализа.
Пример: предположим, что есть файл, содержащий некоторый объем текста. Для каждого из слов (как вариант, буквы) содержащегося в файле необходимо выполнить подсчет частоты его встречи. Простейшее решение, которое приходит в голову, это воспользоваться структурой данных типа ХЕШ (ассоциативный массив) в этом случае в качестве ключа будет использоваться само слово, в качестве его значения будет количество повторений. Разумеется, что хеш будет легко эмулировать с помощью двух массивов. В случае если файл содержит достаточно большое количество разных слов, то узким местом данного алгоритма будет поиск позиции, в которой встречается нужное слово. В случае если слова поступают в не отсортированном виде, что вполне ожидаемо, то мы должны будем просматривать в среднем половину от заполненного массива слов пока не найдем искомый. Можно воспользоваться, например, алгоритмом сортировки (здесь наиболее естественно применять метод вставки), мы же рассмотрим применение поискового дерева. Слова в нем будут располагаться в алфавитном порядке, т.е. все слова левого поддерева должны находиться в словаре раньше, чем корневой элемент, соответственно все слова правого поддерева должны находиться в словаре позже, чем корневой элемент (не забывайте, что такое соотношение должно выполняться для всех поддеревьев). Каждый раз, когда на вход программе будет поступать очередное слово будет выполняться поиск его схема идентична той, которая была приведена в таблице выше, если операция поиска была неудачна (функция из примера 1 вернула NULL, а функция из примера 2 вернула ссылку на сам буферный элемент), то необходимо в соответствующую позицию вставить новое слово, и его счетчик количества повторений инициализировать 1. После завершения формирования дерева его можно распечатать. Фрагмент кода решающего данную задачу приводится ниже.
#include "string.h"
#include "stdio.h"
#include "assert.h"
struct BinNode {
char data [51]; // само слово
int count; // количество повторений слова
5.2. Бинарные деревья представление бинарных деревьев

Бинарное дерево определяется рекурсивно как имеющее левое поддерево, корень и правое поддерево. Левое и правое поддеревья сами являются бинарными деревьями. На рис.5.2.1 показан пример бинарного дерева. Рис.5.2.1. Бинарное дерево Такие деревья можно представить термами вида бд(Лд,к,Пд), где Лд — левое поддерево, К — корень, а Пд — правое поддерево. Для обозначения пустого бинарного дерева будем использовать атом nil.
Бинарное дерево на рис.5.2.1 имеет левое поддерево
бд(бд(nil,d,nil),b,бд(nil,е,nil)) правое поддерево бд(nil,c,nil) и записывается целиком как бд(бд(бд(nil,d,nil),b,бд(nil,e,nil)), а, бд(nil,c,nil)).
Представление множеств с помощью бинарных деревьев

Описание множеств в виде списков позволяет использовать для множеств целевое утверждение принадлежит, определенное ранее для списков. Однако для множеств, состоящих из большого числа элементов, списковые целевые утверждения становятся неэффективными. Рассмотрим, например, как целевое утверждение принадлежит (см. разд. 5.1.2) позволяет моделировать принадлежность множеству. Пусть L — список, описывающий множество из первых 1024 натуральных чисел. Тогда при ответе на запрос ?- принадлежит(3000,L). Прологу придется проверить все 1024 числа, прежде чем заключить, что такого числа нет: нет Представление множества бинарным деревом позволяет добиться лучшего результата. При этом бинарное дерево должно быть упорядочено таким образом, чтобы любой элемент в левом поддереве был меньше, чем значение корня, а любой элемент в правом поддереве — больше. Поскольку мы определили поддерево как бинарное дерево, такое упорядочение применяется по всем поддеревьям. На рис.5.2.2 приведен пример упорядоченного бинарного дерева. Дерево на рис.5.2.1 является неупорядоченным. Рис.5.2.2. Упорядоченное бинарное дерево Обратите внимание, что упорядочение приводит не к единственному варианту представления множества с помощью дерева. Например, на рис.5.2.3 изображено то же множество, что и на рис.5.2.2.
Будем называть линейным представление такого вида, как на рис.5.2.3, и сбалансированным — такое, как на рис.5.2.2.

Рис.5.2.3. Линейное представление Моделирование принадлежности множеству. Имея множество, описанное бинарным деревом, мы можем моделировать принадлежность множеству с помощью целевого утверждения принадлежит_дереву. При этом используется оператор @ , выражающий отношение «меньше, чем», и оператор @ >, выражающий отношение «больше, чем». /* Граничное условие: Х принадлежит /* дереву, если Х является корнем. принадлежит_дереву(Х,бд(Лд,Х,Пд)). /* Рекурсивные условия /* Х принадлежит дереву, если Х больше /* значения корня и находится в правом /* поддереве: принадлежит_дереву(Х,бд(Лд,Y,Пд)) :- X@Y, принадлежит_дереву(Х,Пд). /* Х принадлежит дереву, если Х меньше /* значения корня и находится в левом /* поддереве: принадлежит_дереву(Х,бд(Лд,Y,Пд)) :- X@Y, принадлежит_дереву(Х,Лд). Если множество из первых 1024 чисел описать с помощью сбалансированного бинарного дерева Т, то при ответе на запрос ?- принадлежит_дереву(3000,Т). Пролог сравнит число 3000 не более чем с 11 элементами множества, прежде чем ответит: нет Конечно, если Т имеет линейное представление, то потребуется сравнение 3000 с 1024 элементами множества. Построение бинарного дерева. Задача создания упорядоченного бинарного дерева при добавлении элемента Х к другому упорядоченному бинарному дереву формулируется следующим образом: Граничное условие: Добавление Х к nil дает бд(nil,Х,nil). Рекурсивные условия: При добавлении Х к бд(Лд,К,Пд) нужно рассмотреть два случая, чтобы быть уверенным, что результирующее дерево будет упорядоченным. 1. Х меньше, чем К. В этом случае нужно добавить Х к Лд, чтобы получить левое поддерево. Правое поддерево равно Пд, а значение корня результирующего дерева равно К. 2. Х больше, чем К. В таком случае нужно добавить Х к Пд, чтобы получить правое поддерево. Левое поддерево равно Лд, а значение корня — К. Такой формулировке задачи соответствует программа: /* Граничное условие: включ_бд(nil,Х,бд(nil,Х,nil)). /* Рекурсивные условия: /* (1) включ_бд(бд(Лд,К,Пд),Х,бд(Лднов,К,Пд)) :- Х@К, включ_бд(Лд,Х,Лднон). /*(2) включ_бд(бд(Лд,К,Пд),Х,бд(Лд,К,Пднов)) :- Х@К, включ_бд(Пд,Х,Пднов). На запрос ?- включ_бд(nil,d,Т1),включ_бд(Т1,а,Т2). будут получены значения T1=бд(nil,d,nil) T2=бд(бд(nil,a,nil),d,nil) Процедуру включ_бд() можно использовать для построения упорядоченного дерева из списка: /* Граничное условие: список_в_дерево([],nil). /* Рекурсивное условие: список_в_дерево([Н | Т],Бд) :- список_в_дерево(Т,Бд2), включ_бд(Н,Бд2,Бд). Заметим, что включ_бд не обеспечивает построения сбалансированного дерева. Однако существуют алгоритмы, гарантирующие такое построение [Horowitz E. Sahni S., 1976, р.442]. Создание отсортированного списка. Для построения отсортированного списка элементов воспользуемся упорядоченным бинарным деревом. Граничное условие: Пустое бинарное дерево (nil) приводит к пустому списку []. Рекурсивное условие: Отсортированный список для упорядоченного бинарного дерева бд(Лд,К,Пд), где Лд имеет отсортированный список СЛ, а Пд — отсортированный список СП, получается присоединением [К | СП] к СЛ. Рассмотрим, например, упорядоченное бинарное дерево бд(бд(бд(nil,alice,nil),fred,бд(nil,graham,nil)), jim,бд(nil,rау,nil))