Примеры применения Pandas в Python
Pandas — очень популярная библиотека Python для анализа данных. Она предоставляет множество функций и методов, ускоряющих подготовку данных и работу с ними. Поскольку библиотека популярна, вы легко найдете стати и руководства по ее применению. В этой статье мы рассмотрим практические примеры использования Pandas в Python.
Примечание редакции Pythonist: о том, что собой представляет Pandas, можно почитать в статье «Полное руководство по Pandas для начинающих».
Функции и методы, которые мы рассмотрим, чаще всего применяются в обычных процессах анализа данных. Работать будем с набором данных отпавших клиентов, доступным на Kaggle.
Начнем со считывания csv-файла в датафрейм Pandas.
import numpy as np import pandas as pd df = pd.read_csv("/content/churn.csv") df.shape # (10000,14) df.columns # Index(['RowNumber', 'CustomerId', 'Surname', 'CreditScore', 'Geography', 'Gender', 'Age', 'Tenure', 'Balance', 'NumOfProducts', 'HasCrCard','IsActiveMember','EstimatedSalary', 'Exited'], dtype='object')
1. Удаление столбцов
Функция drop используется для удаления столбцов и строк. Мы передаем в нее метки строк или столбцов, которые нужно удалить.
df.drop(['RowNumber', 'CustomerId', 'Surname', 'CreditScore'], axis=1, inplace=True) df.shape # (10000,10)
Параметр axis («ось») определяет, что именно мы удаляем: строки или столбцы. Для строк значение axis — 0, а для столбцов — 1. У нас axis=1 .
Параметр inplace определяет, нужно ли вносить изменения в существующий датафрейм или нужно вернуть его копию. По умолчанию значение inplace — False (возвращается копия). У нас inplace=True для внесения изменений на месте. Мы удаляем 4 столбца, поэтому число столбцов уменьшается до 10 (было 14).
2. Выборка определенных столбцов при чтении
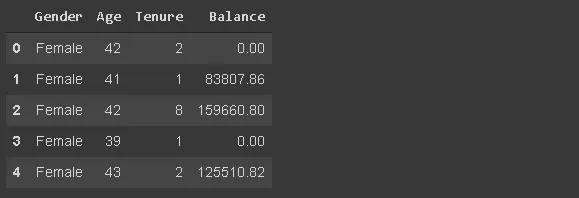
Мы можем прочитать не целый CSV-файл, а только определенные столбцы. Для этого нужно передать список нужных столбцов в параметр usecols при считывании файла. Если вы знаете, какие столбцы вас интересуют, лучше выбрать их заранее, а не удалять ненужные после считывания всего файла.
df_spec = pd.read_csv("/content/churn.csv", usecols=['Gender', 'Age', 'Tenure', 'Balance']) df_spec.head()
3. Чтение части датафрейма
Функция read_csv позволяет считывать часть csv-файла, определяя ее в строках. Применять эту функцию можно двумя способами. Первый вариант — указать нужное количество строк в параметре nrows .
df_partial = pd.read_csv("/content/churn.csv", nrows=5000) df_partial.shape # (5000,14)
Используя nrows , мы создаем датафрейм, содержащий первые 5000 строк csv-файла.
Второй вариант — использовать параметр skiprows . Если мы укажем skiprows=5000 , при считывании файла первые 5000 строк будут пропущены.
4. Случайная выборка
После создания датафрейма вы можете захотеть просмотреть небольшую выборку из него. Для определения размера выборки можно использовать следующие параметры:
- n — число строк в выборке
- frac — доля от всего датафрейма
df_sample = df.sample(n=1000) df_sample.shape # (1000,10) df_sample2 = df.sample(frac=0.1) df_sample2.shape # (1000,10)
5. Проверка пропущенных значений
Функция isna определяет пропущенные значения в датафрейме. Используя ее с функцией sum , можно увидеть количество недостающих значений по каждому столбцу.
df.isna().sum()
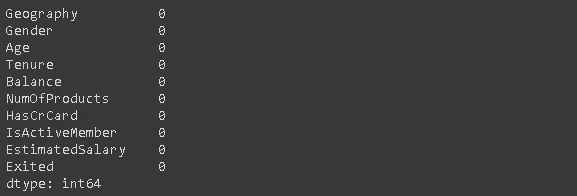
Здесь у нас нет пропущенных значений.
6. Добавление пропущенных значений при помощи loc и iloc
Методы loc и iloc служат для выборки строк и столбцов по индексу или меткам.
- loc — выборка по меткам
- iloc — выборка по индексу
Давайте сперва создадим переменную, содержащую 20 случайных индексов.
missing_index = np.random.randint(10000, size=20)
Эти индексы мы используем, чтобы заменить некоторые значения на np.nan (пропущенное значение). Мы применяем функцию loc и указываем метки столбцов — [‘Balance’,’Geography’] .
df.loc[missing_index, ['Balance','Geography']] = np.nan
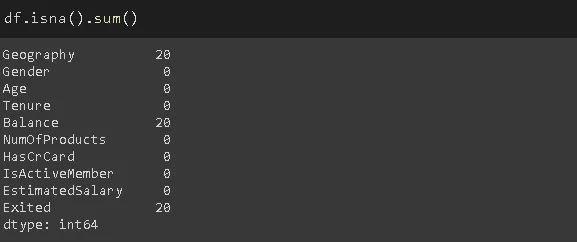
Теперь в столбцах Balance и Geography 20 пропущенных значений.
Давайте теперь применим iloc и индексы столбцов вместо меток.
df.iloc[missing_index, -1] = np.nan
-1 — это индекс последнего столбца (Exited).
Хотя мы использовали разные представления столбцов для loc и iloc , значения строк не изменились. Причина в том, что в качестве меток строк мы используем числовой индекс. То есть для строк метки и индексы одинаковы.
Количество пропущенных значений поменялось:
7. Заполнение отсутствующих значений
При помощи функции fillna можно заполнить недостающие значения. У этой функции много опций. Мы можем использовать конкретное значение, агрегатную функцию (например, среднее значение), предыдущее или следующее значение.
В этом примере мы выбрали в качестве заполнителя для пропущенных значений в столбце Geography наиболее часто встречающееся значение.
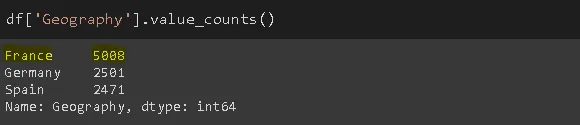
mode = df['Geography'].value_counts().index[0] df['Geography'].fillna(value=mode, inplace=True)
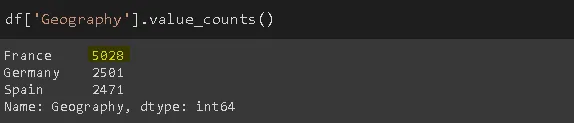
А для столбца Balance используем среднее значение:
avg = df['Balance'].mean() df['Balance'].fillna(value=avg, inplace=True)
При помощи параметра method можно заполнить пропущенное значение, основываясь на предыдущем или следующем значении в столбце (например, method=’ffill’ ). Это может быть очень полезным для последовательных данных.
8. Удаление пропущенных значений
Пропущенные значения можно не только заполнять, но и просто удалять. У нас есть такие пропуски значений в столбце Exited. При помощи следующего кода можно удалить строки, содержащие любые пропущенные значения.
df.dropna(axis=0, how='any', inplace=True)
Если задать параметр axis=1 , то удалены будут не строки, а столбцы с отсутствующими значениями. Можно также задать параметр thresh , чтобы указать, какое минимальное число непропущенных значений должно быть в столбце или строке. Например, thresh=5 означает, что строка должна иметь как минимум 5 значений. Строки с меньшим количеством значений будут удалены.
Теперь в нашем датафрейме нет пропущенных значений.
df.isna().sum().sum() # 0
9. Выборка строк на основе условий
В некоторых случаях нам нужно сосредоточиться на данных, отвечающих каким-то условиям. Например, можно выбрать отпавших клиентов, которые живут во Франции.
france_churn = df[(df.Geography == 'France') & (df.Exited == 1)] france_churn.Geography.value_counts() # France 808
10. Описание условий при помощи query
Функция query позволяет задавать условия более гибко. Например, при помощи строк:
df2 = df.query('80000 < Balance < 100000')
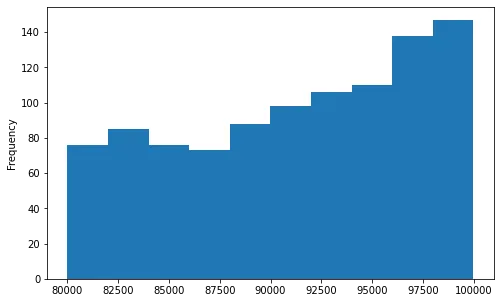
Давайте проверим результат, нарисовав диаграмму столбца Balance.
df2['Balance'].plot(kind='hist', figsize=(8,5))
В этой статье мы рассмотрели простые примеры использования Pandas в Python. Но Pandas предлагает куда больше возможностей, чем можно охватить в одном руководстве. Применяя эту библиотеку на практике, вы будете открывать для себя все новые и новые функции. Как и во многих других случаях, практика ведет к совершенству.
Как сбросить индекс в Pandas DataFrame(с примерами)
Вы можете использовать следующий синтаксис для сброса индекса в pandas DataFrame:
df.reset_index(drop= True , inplace= True ) Обратите внимание на следующие аргументы:
- drop : Указание True запрещает pandas сохранять исходный индекс в виде столбца в DataFrame.
- inplace : Указание True позволяет pandas заменить индекс в исходном DataFrame вместо создания копии DataFrame.
В следующих примерах показано, как использовать этот синтаксис на практике.
Пример 1: сбросить индекс и удалить старый индекс
Предположим, у нас есть следующие Pandas DataFrame:
import pandas as pd #define DataFrame df = pd.DataFrame(, index=[0, 4, 3, 5, 2, 1, 7, 6]) #view DataFrame print(df) points assists rebounds 0 25 5 11 4 12 7 8 3 15 7 10 5 14 9 6 2 19 12 6 1 23 9 5 7 25 9 9 6 29 4 12 В следующем коде показано, как сбросить индекс DataFrame и полностью удалить старый индекс:
#reset index df.reset_index(drop= True , inplace= True ) #view updated DataFrame print(df) points assists rebounds 0 25 5 11 1 12 7 8 2 15 7 10 3 14 9 6 4 19 12 6 5 23 9 5 6 25 9 9 7 29 4 12 Обратите внимание, что индекс был сброшен, и значения в индексе теперь находятся в диапазоне от 0 до 7.
Пример 2: сбросить индекс и сохранить старый индекс как столбец
Предположим, у нас есть следующие Pandas DataFrame:
import pandas as pd #define DataFrame df = pd.DataFrame(, index=['A', 'C', 'D', 'B', 'E', 'G', 'F', 'H']) #view DataFrame print(df) points assists rebounds A 25 5 11 C 12 7 8 D 15 7 10 B 14 9 6 E 19 12 6 G 23 9 5 F 25 9 9 H 29 4 12 В следующем коде показано, как сбросить индекс DataFrame и сохранить старый индекс в виде столбца в DataFrame:
#reset index and retain old index as a column df.reset_index(inplace= True ) #view updated DataFrame print(df) index points assists rebounds 0 A 25 5 11 1 C 12 7 8 2 D 15 7 10 3 B 14 9 6 4 E 19 12 6 5 G 23 9 5 6 F 25 9 9 7 H 29 4 12 Обратите внимание, что индекс был сброшен, и значения в индексе теперь находятся в диапазоне от 0 до 7.
Также обратите внимание, что старый индекс (с буквами) сохраняется как новый столбец в DataFrame под названием «индекс».
Дополнительные ресурсы
В следующих руководствах объясняется, как выполнять другие распространенные операции в pandas:
Моя шпаргалка по pandas
Один преподаватель как-то сказал мне, что если поискать аналог программиста в мире книг, то окажется, что программисты похожи не на учебники, а на оглавления учебников: они не помнят всего, но знают, как быстро найти то, что им нужно.
Возможность быстро находить описания функций позволяет программистам продуктивно работать, не теряя состояния потока. Поэтому я и создал представленную здесь шпаргалку по pandas и включил в неё то, чем пользуюсь каждый день, создавая веб-приложения и модели машинного обучения.
Нельзя сказать, что это — исчерпывающий список возможностей pandas , но сюда входят функции, которыми я пользуюсь чаще всего, примеры и мои пояснения по поводу ситуаций, в которых эти функции особенно полезны.
1. Подготовка к работе
Если вы хотите самостоятельно опробовать то, о чём тут пойдёт речь, загрузите набор данных Anime Recommendations Database с Kaggle. Распакуйте его и поместите в ту же папку, где находится ваш Jupyter Notebook (далее — блокнот).
Теперь выполните следующие команды.
import pandas as pd import numpy as np anime = pd.read_csv('anime-recommendations-database/anime.csv') rating = pd.read_csv('anime-recommendations-database/rating.csv') anime_modified = anime.set_index('name') После этого у вас должна появиться возможность воспроизвести то, что я покажу в следующих разделах этого материала.
2. Импорт данных
▍Загрузка CSV-данных
Здесь я хочу рассказать о преобразовании CSV-данных непосредственно в датафреймы (в объекты Dataframe). Иногда при загрузке данных формата CSV нужно указывать их кодировку (например, это может выглядеть как encoding='ISO-8859–1' ). Это — первое, что стоит попробовать сделать в том случае, если оказывается, что после загрузки данных датафрейм содержит нечитаемые символы.
anime = pd.read_csv('anime-recommendations-database/anime.csv') 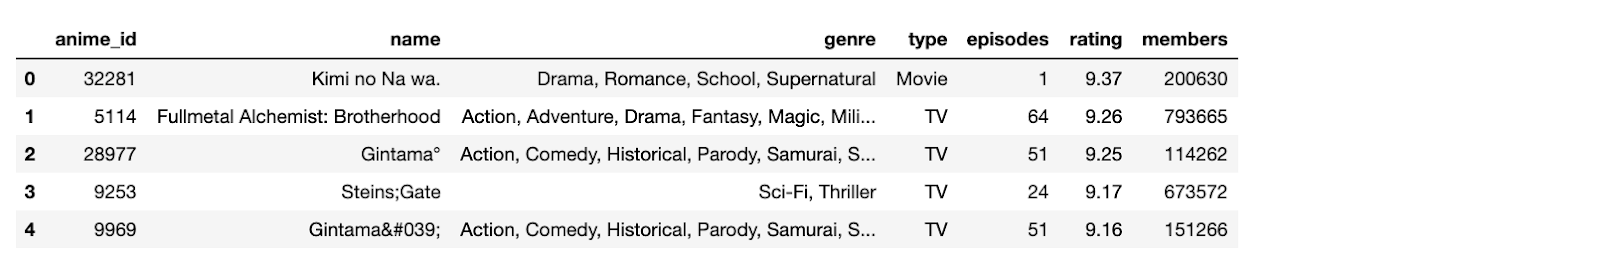
Загруженные CSV-данные
Существует похожая функция для загрузки данных из Excel-файлов — pd.read_excel .
▍Создание датафрейма из данных, введённых вручную
Это может пригодиться тогда, когда нужно вручную ввести в программу простые данные. Например — если нужно оценить изменения, претерпеваемые данными, проходящими через конвейер обработки данных.
df = pd.DataFrame([[1,'Bob', 'Builder'], [2,'Sally', 'Baker'], [3,'Scott', 'Candle Stick Maker']], columns=['id','name', 'occupation']) 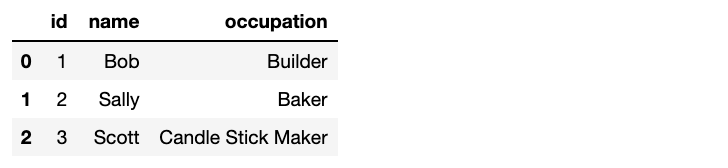
Данные, введённые вручную
▍Копирование датафрейма
Копирование датафреймов может пригодиться в ситуациях, когда требуется внести в данные изменения, но при этом надо и сохранить оригинал. Если датафреймы нужно копировать, то рекомендуется делать это сразу после их загрузки.
anime_copy = anime.copy(deep=True) 
Копия датафрейма
3. Экспорт данных
▍Экспорт в формат CSV
При экспорте данных они сохраняются в той же папке, где находится блокнот. Ниже показан пример сохранения первых 10 строк датафрейма, но то, что именно сохранять, зависит от конкретной задачи.
rating[:10].to_csv('saved_ratings.csv', index=False) Экспортировать данные в виде Excel-файлов можно с помощью функции df.to_excel .
4. Просмотр и исследование данных
▍Получение n записей из начала или конца датафрейма
Сначала поговорим о выводе первых n элементов датафрейма. Я часто вывожу некоторое количество элементов из начала датафрейма где-нибудь в блокноте. Это позволяет мне удобно обращаться к этим данным в том случае, если я забуду о том, что именно находится в датафрейме. Похожую роль играет и вывод нескольких последних элементов.
anime.head(3) rating.tail(1) 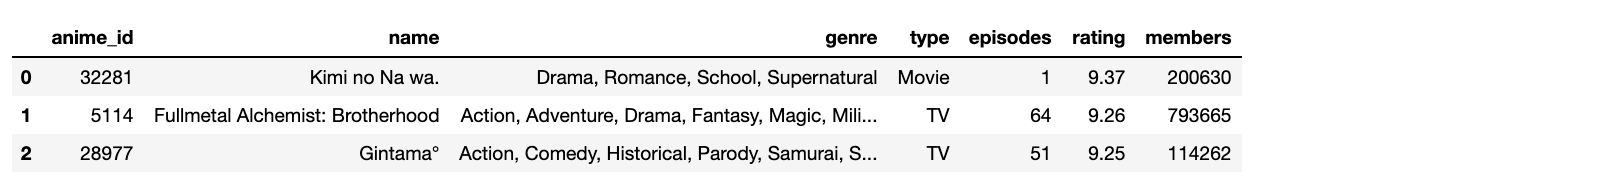
Данные из начала датафрейма

Данные из конца датафрейма
▍Подсчёт количества строк в датафрейме
Функция len(), которую я тут покажу, не входит в состав pandas . Но она хорошо подходит для подсчёта количества строк датафреймов. Результаты её работы можно сохранить в переменной и воспользоваться ими там, где они нужны.
len(df) #=> 3 ▍Подсчёт количества уникальных значений в столбце
Для подсчёта количества уникальных значений в столбце можно воспользоваться такой конструкцией:
len(ratings['user_id'].unique()) ▍Получение сведений о датафрейме
В сведения о датафрейме входит общая информация о нём вроде заголовка, количества значений, типов данных столбцов.
anime.info() 
Сведения о датафрейме
Есть ещё одна функция, похожая на df.info — df.dtypes . Она лишь выводит сведения о типах данных столбцов.
▍Вывод статистических сведений о датафрейме
Знание статистических сведений о датафрейме весьма полезно в ситуациях, когда он содержит множество числовых значений. Например, знание среднего, минимального и максимального значений столбца rating даёт нам некоторое понимание того, как, в целом, выглядит датафрейм. Вот соответствующая команда:
anime.describe() 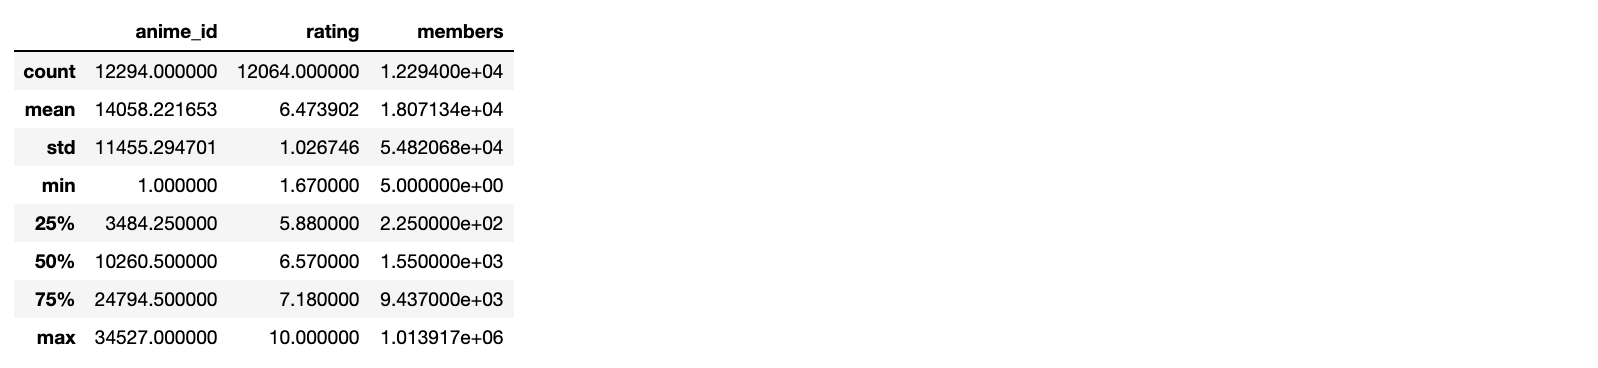
Статистические сведения о датафрейме
▍Подсчёт количества значений
Для того чтобы подсчитать количество значений в конкретном столбце, можно воспользоваться следующей конструкцией:
anime.type.value_counts() 
Подсчёт количества элементов в столбце
5. Извлечение информации из датафреймов
▍Создание списка или объекта Series на основе значений столбца
Это может пригодиться в тех случаях, когда требуется извлекать значения столбцов в переменные x и y для обучения модели. Здесь применимы следующие команды:
anime['genre'].tolist() anime['genre'] 
Результаты работы команды anime['genre'].tolist()

Результаты работы команды anime['genre']
▍Получение списка значений из индекса
Поговорим о получении списков значений из индекса. Обратите внимание на то, что я здесь использовал датафрейм anime_modified , так как его индексные значения выглядят интереснее.
anime_modified.index.tolist() 
Результаты выполнения команды
▍Получение списка значений столбцов
Вот команда, которая позволяет получить список значений столбцов:
anime.columns.tolist() 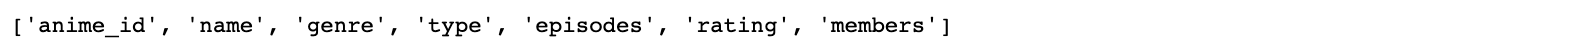
Результаты выполнения команды
6. Добавление данных в датафрейм и удаление их из него
▍Присоединение к датафрейму нового столбца с заданным значением
Иногда мне приходится добавлять в датафреймы новые столбцы. Например — в случаях, когда у меня есть тестовый и обучающий наборы в двух разных датафреймах, и мне, прежде чем их скомбинировать, нужно пометить их так, чтобы потом их можно было бы различить. Для этого используется такая конструкция:
anime['train set'] = True ▍Создание нового датафрейма из подмножества столбцов
Это может пригодиться в том случае, если требуется сохранить в новом датафрейме несколько столбцов огромного датафрейма, но при этом не хочется выписывать имена столбцов, которые нужно удалить.
anime[['name','episodes']] 
Результат выполнения команды
▍Удаление заданных столбцов
Этот приём может оказаться полезным в том случае, если из датафрейма нужно удалить лишь несколько столбцов. Если удалять нужно много столбцов, то эта задача может оказаться довольно-таки утомительной, поэтому тут я предпочитаю пользоваться возможностью, описанной в предыдущем разделе.
anime.drop(['anime_id', 'genre', 'members'], axis=1).head() 
Результаты выполнения команды
▍Добавление в датафрейм строки с суммой значений из других строк
Для демонстрации этого примера самостоятельно создадим небольшой датафрейм, с которым удобно работать. Самое интересное здесь — это конструкция df.sum(axis=0) , которая позволяет получать суммы значений из различных строк.
df = pd.DataFrame([[1,'Bob', 8000], [2,'Sally', 9000], [3,'Scott', 20]], columns=['id','name', 'power level']) df.append(df.sum(axis=0), ignore_index=True) 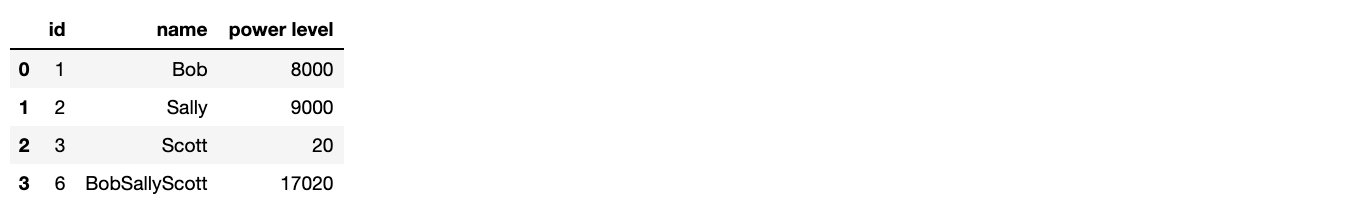
Результат выполнения команды
Команда вида df.sum(axis=1) позволяет суммировать значения в столбцах.
Похожий механизм применим и для расчёта средних значений. Например — df.mean(axis=0) .
7. Комбинирование датафреймов
▍Конкатенация двух датафреймов
Эта методика применима в ситуациях, когда имеются два датафрейма с одинаковыми столбцами, которые нужно скомбинировать.
В данном примере мы сначала разделяем датафрейм на две части, а потом снова объединяем эти части:
df1 = anime[0:2] df2 = anime[2:4] pd.concat([df1, df2], ignore_index=True) 
Датафрейм df1

Датафрейм df2

Датафрейм, объединяющий df1 и df2
▍Слияние датафреймов
Функция df.merge , которую мы тут рассмотрим, похожа на левое соединение SQL. Она применяется тогда, когда два датафрейма нужно объединить по некоему столбцу.
rating.merge(anime, left_on=’anime_id’, right_on=’anime_id’, suffixes=(‘_left’, ‘_right’)) 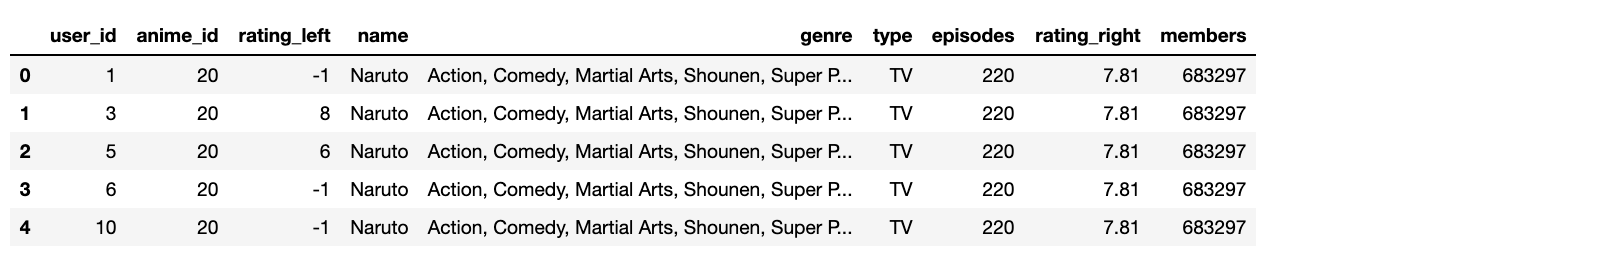
Результаты выполнения команды
8. Фильтрация
▍Получение строк с нужными индексными значениями
Индексными значениями датафрейма anime_modified являются названия аниме. Обратите внимание на то, как мы используем эти названия для выбора конкретных столбцов.
anime_modified.loc[['Haikyuu!! Second Season','Gintama']] 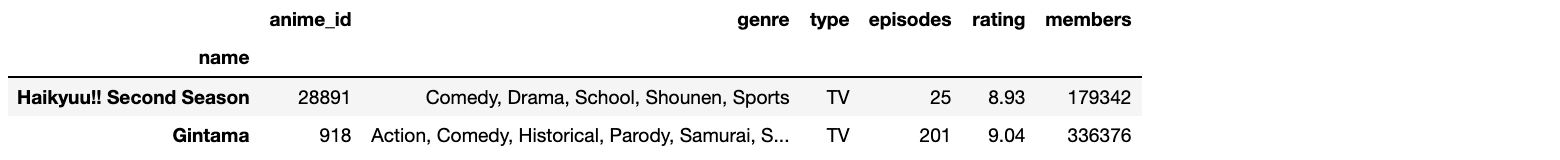
Результаты выполнения команды
▍Получение строк по числовым индексам
Эта методика отличается от той, которая описана в предыдущем разделе. При использовании функции df.iloc первой строке назначается индекс 0 , второй — индекс 1 , и так далее. Такие индексы назначаются строкам даже в том случае, если датафрейм был модифицирован и в его индексном столбце используются строковые значения.
Следующая конструкция позволяет выбрать три первых строки датафрейма:
anime_modified.iloc[0:3] 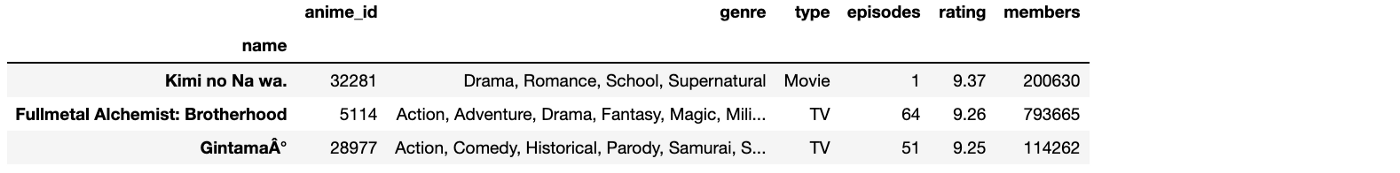
Результаты выполнения команды
▍Получение строк по заданным значениям столбцов
Для получения строк датафрейма в ситуации, когда имеется список значений столбцов, можно воспользоваться следующей командой:
anime[anime['type'].isin(['TV', 'Movie'])] 
Результаты выполнения команды
Если нас интересует единственное значение — можно воспользоваться такой конструкцией:
anime[anime[‘type’] == 'TV'] ▍Получение среза датафрейма
Эта техника напоминает получение среза списка. А именно, речь идёт о получении фрагмента датафрейма, содержащего строки, соответствующие заданной конфигурации индексов.
anime[1:3] 
Результаты выполнения команды
▍Фильтрация по значению
Из датафреймов можно выбирать строки, соответствующие заданному условию. Обратите внимание на то, что при использовании этого метода сохраняются существующие индексные значения.
anime[anime['rating'] > 8] 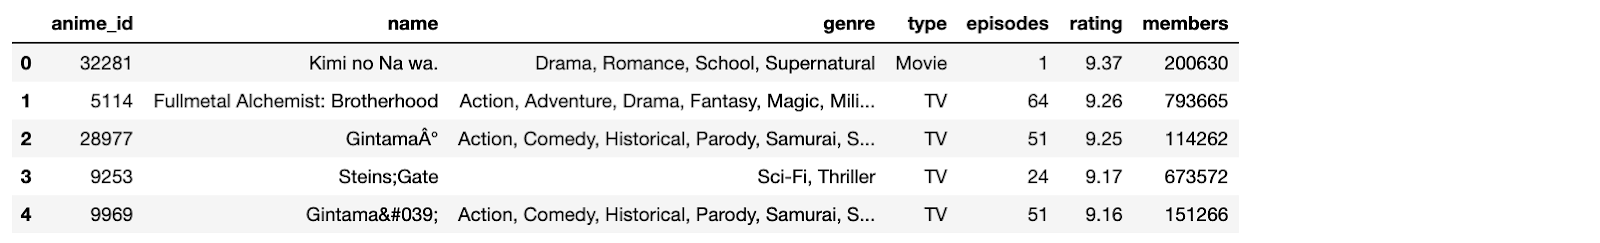
Результаты выполнения команды
9. Сортировка
Для сортировки датафреймов по значениям столбцов можно воспользоваться функцией df.sort_values :
anime.sort_values('rating', ascending=False) 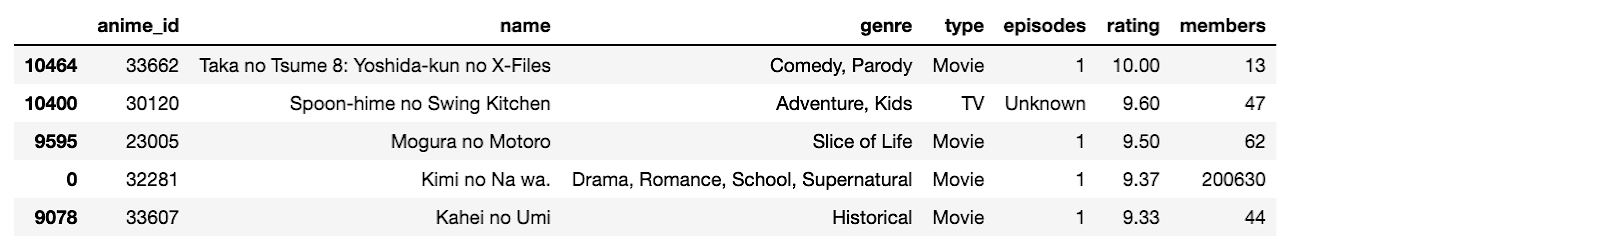
Результаты выполнения команды
10. Агрегирование
▍Функция df.groupby и подсчёт количества записей
Вот как подсчитать количество записей с различными значениями в столбцах:
anime.groupby('type').count() 
Результаты выполнения команды
▍Функция df.groupby и агрегирование столбцов различными способами
Обратите внимание на то, что здесь используется reset_index() . В противном случае столбец type становится индексным столбцом. В большинстве случаев я рекомендую делать то же самое.
anime.groupby(["type"]).agg(< "rating": "sum", "episodes": "count", "name": "last" >).reset_index() ▍Создание сводной таблицы
Для того чтобы извлечь из датафрейма некие данные, нет ничего лучше, чем сводная таблица. Обратите внимание на то, что здесь я серьёзно отфильтровал датафрейм, что ускорило создание сводной таблицы.
tmp_df = rating.copy() tmp_df.sort_values('user_id', ascending=True, inplace=True) tmp_df = tmp_df[tmp_df.user_id < 10] tmp_df = tmp_df[tmp_df.anime_id < 30] tmp_df = tmp_df[tmp_df.rating != -1] pd.pivot_table(tmp_df, values='rating', index=['user_id'], columns=['anime_id'], aggfunc=np.sum, fill_value=0) 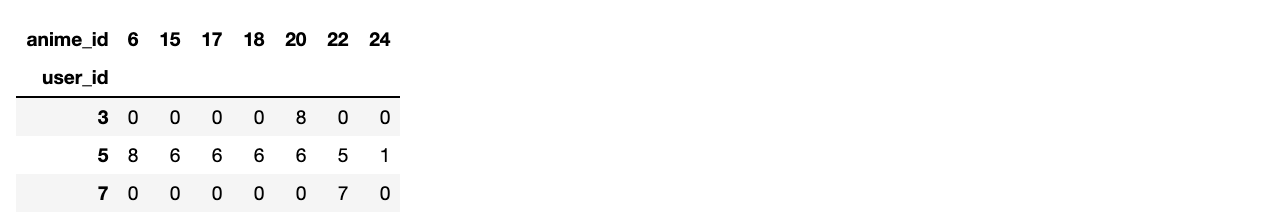
Результаты выполнения команды
11. Очистка данных
▍Запись в ячейки, содержащие значение NaN, какого-то другого значения
Здесь мы поговорим о записи значения 0 в ячейки, содержащие значение NaN . В этом примере мы создаём такую же сводную таблицу, как и ранее, но без использования fill_value=0 . А затем используем функцию fillna(0) для замены значений NaN на 0 .
pivot = pd.pivot_table(tmp_df, values='rating', index=['user_id'], columns=['anime_id'], aggfunc=np.sum) pivot.fillna(0) 
Таблица, содержащая значения NaN
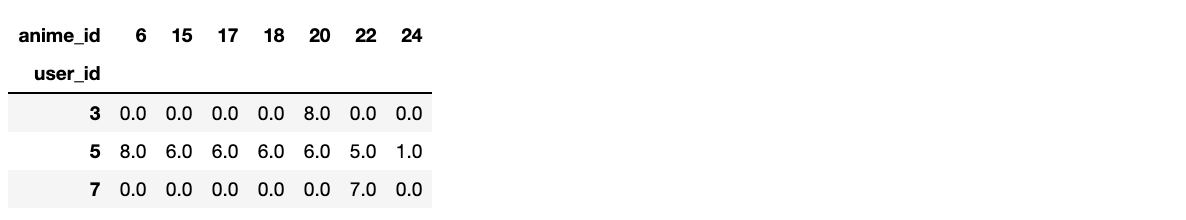
Результаты замены значений NaN на 0
12. Другие полезные возможности
▍Отбор случайных образцов из набора данных
Я использую функцию df.sample каждый раз, когда мне нужно получить небольшой случайный набор строк из большого датафрейма. Если используется параметр frac=1 , то функция позволяет получить аналог исходного датафрейма, строки которого будут перемешаны.
anime.sample(frac=0.25) 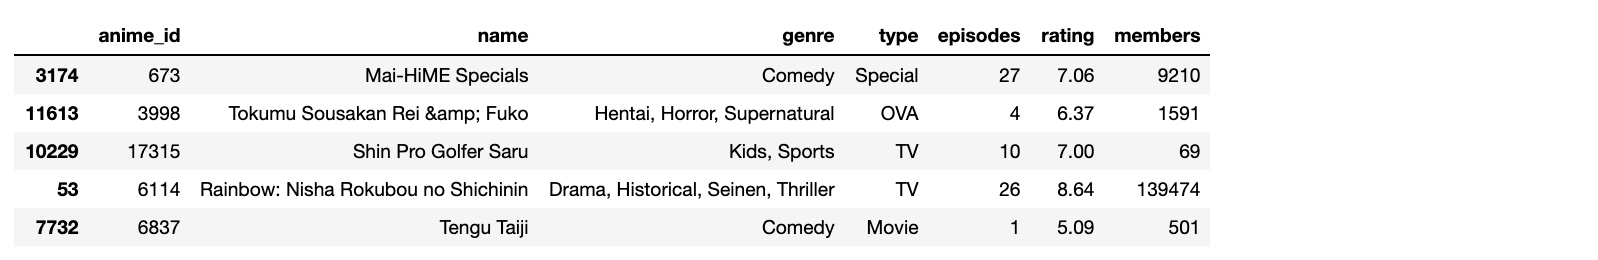
Результаты выполнения команды
▍Перебор строк датафрейма
Следующая конструкция позволяет перебирать строки датафрейма:
for idx,row in anime[:2].iterrows(): print(idx, row) 
Результаты выполнения команды
▍Борьба с ошибкой IOPub data rate exceeded
Если вы сталкиваетесь с ошибкой IOPub data rate exceeded — попробуйте, при запуске Jupyter Notebook, воспользоваться следующей командой:
jupyter notebook — NotebookApp.iopub_data_rate_limit=1.0e10 Итоги
Здесь я рассказал о некоторых полезных приёмах использования pandas в среде Jupyter Notebook. Надеюсь, моя шпаргалка вам пригодится.
Уважаемые читатели! Есть ли какие-нибудь возможности pandas , без которых вы не представляете своей повседневной работы?

- Блог компании RUVDS.com
- Веб-разработка
- Python
Предобработка данных на Python

Анализ данных является довольно сложным, увлекательным и часто требующим креативности от исполнителя процессом. Важным и первостепенным этапом проведение анализа является подготовка данных. Именно этому этапу, от которого зависит скорость, удобство, а также результат, и посвящен мой пост.
Публикация выполнена в виде инструкции с пошаговым прогрессом. Пороговый вход для понимания материала невысокий, но кое-что все же нужно знать:
- типы данных;
- вызов библиотек;
- конструктор для таблиц DataFrame;
- срезы данных.
Исходные данные:
На входе у нас есть Data Frame с данными о поле (м или ж), возрасте, контактной информацией, а также признаком. Для тех, кто не любит абстрагироваться, признак – это ответ на вопрос «Играете ли вы в компьютерные игры?» и он может принимать одно из двух значений (да или нет).
Шаг 1. Знакомство с данными
На первом этапе важно посмотреть, что за данные у нас на руках: какие столбцы, какие типы данных, какие они принимают значения.
Выведем первые строки методом head():
df.head()
Посмотрим сводную информацию методом info():
df.info()
Метод info() дает много информации, из которой мы узнаем, что в таблице 20 строк, 4 столбца, видим типы данных для каждого столбца и количество ненулевых значений.
Шаг 2. Переименование столбцов
Является необязательным шагом, но он делает дальнейшие действия более удобными, а внешний вид приятным. Обычной рекомендацией для названия столбцов является: применение латиницы в названии, нижний регистр, а также отсутствие пропусков в имени столбца (заменяется на символ «_»). Для переименования столбцов применим метод set_axis():
col_name = ['tag', 'gender', 'age', 'phone_num'] df.set_axis(col_name, axis = 'columns', inplace = True) 
Шаг 3. Пропуски данных
В зависимости от решаемых задач, пропущенные значения могут быть либо удалены методом dropna(). Может быть удален как столбец, в котором есть хоть одно пропущенное значение, так и строка.
- dropna() – удаление строк, где есть пропущенные значения.
- dropna(subset=[‘col1’, ‘col2’], inplace=True) – удаление строк, где есть пропущенные значения в определенных столбцах (subset).
- dropna(axis=’col1′, inplace=True) – для удаления столбцов с пропущенными значениями.
В зависимости от данных и решаемой задачи пропущенные значения могут быть заменены на характерные значения: среднее арифметическое или медиана. Также стоит отметить, что пропущенные значения могут «маскироваться» (например под None), для определения этого, можно сначала выполнить поиск уникальных значений методом unique().
Удалим все строки, в которых пропущено значение в столбце ‘tag’ методом dropna():
df.dropna(subset = ['tag'], inplace=True)Заменим пропущенный возраст ‘age’, на средний возраст, характерный для определенного пола с определенным признаком, но перед этим проверим какие уникальные значения принимаются в данном столбце. Затем применим метод replace() к значениям ‘None’ и заменим их на NaN:
df.age.unique()
df.age = df.age.replace('None', np.nan)Выведем на экран срез данных с пропущенными значениями в столбце ‘age’ применив метод isnull():
df[df['age'].isnull() == True]
Заменим пропущенные значения методом fillna() на средний возраст играющих в компьютерные игры мужчин (пропущенные значения соответствуют этим признакам):
mean_age = round(df[(df['tag'] == 'да') & (df['gender'] == 'м')]['age'].mean()) print(mean_age) 
df['age'] = df['age'].fillna(mean_age)Шаг 4. Дубликаты
Для нахождения дубликатов применяется метод duplicated(), совместно с методом sum() можно определить количество дубликатов.
Для удаления дубликатов используем методом следующую конструкцию:
drop_duplicates().reset_index(drop=True)Метод reset_index() необходим для изменения индексации, так как drop_duplicates() вместе со строками удаляет и их индексы.
Проверим наличие дубликатов:
df[df.duplicated() == True]
df.duplicated().sum()
Удалим дубликаты и проверим результат:
df = df.drop_duplicates().reset_index(drop=True) df.duplicated().sum() 
Шаг 5. Изменение типов данных
Проверим как сейчас выглядят наши данные. Для просмотра типа данных воспользуемся атрибутом dtypes:
df.head(2)
df.dtypes
Для того, чтобы они стали более «нарядными», нужно изменить тип данных в столбцах ‘age’ и ‘phone_num’ на int.
Для перевода значений формата string в числовой формат применяется метод библиотеки Pandas to_numeric(). От значения errors метода to_numeric(), зависят действия при работе с некорректным значением:
- errors=’raise’ — выдается ошибка, операция прерывается;
- errors=’coerce’ — некорректные значения заменяются на NaN;
- errors=’ignore’ — некорректные значения игнорируются, но остаются.
Применим метод to_numeric() к столбцу ‘phone_num’:
df['phone_num'] = pd.to_numeric(df['phone_num'], errors='coerce') df.dtypes 
Для того, чтобы перевести данные в нужный тип, применяется метод astype():
df['phone_num'] = df['phone_num'].astype('int64')При вызове метода была получена ошибка:

Она возникает, когда в столбце есть данные, принимающие значения NaN. Решением может быть или замена NaN на 0, или на NA. Заменим на NA и поменяем типы данных в нужных столбцах:
df['phone_num'] = df['phone_num'].fillna(pd.NA) df['phone_num'] = df['phone_num'].astype('Int64') df['age'] = df['age'].astype('Int64') Посмотрим на достигнутый результат:
df.info()
df.head(2)
Можно считать задачу решенной, данные подготовлены к дальнейшему анализу.
Заключение
На этом пост подошел к концу, вспомним чему мы научились:
- Знакомиться с общей информацией, находящейся в таблице.
- Переименовывать столбцы.
- Работать с пропусками.
- Находить и удалять дубликаты.
- Менять тип данных.