Обнаружение новизны изображений с помощью Python и библиотеки scikit-learn
В этой статье я расскажу, как с помощью библиотек scikit-learn, opencv, numpy, imutilsс выявить новизну входных изображений. Многие программы требуют наличия возможности решить, принадлежит ли новый объект тому же распределению, что и существующие объекты (это промежуточный результат), или его следует рассматривать как новизну. Часто эта возможность используется для очистки реальных наборов данных.
Для начала установим необходимые библиотеки:
pip install numpy pip install opencv-contrib-python pip install imutils pip install scikit-learnВыявлять новинки будем методом «Обнаружения новинок», используя модуль Isolation Forests.

Одним из эффективных способов обнаружения новизны в наборе данных является использование случайных лесов. Алгоритм изолирует наблюдения, случайным образом выбирая признак, а затем случайным образом выбирая значение разделения между максимальным и минимальным значениями выбранного признака. Стратегия показана выше.
Рассмотрим работу алгоритма на конкретном примере. Пусть перед нами стоит задача – определить изображено ли картинке море.
Обучим модель на датасете фотографий моря.
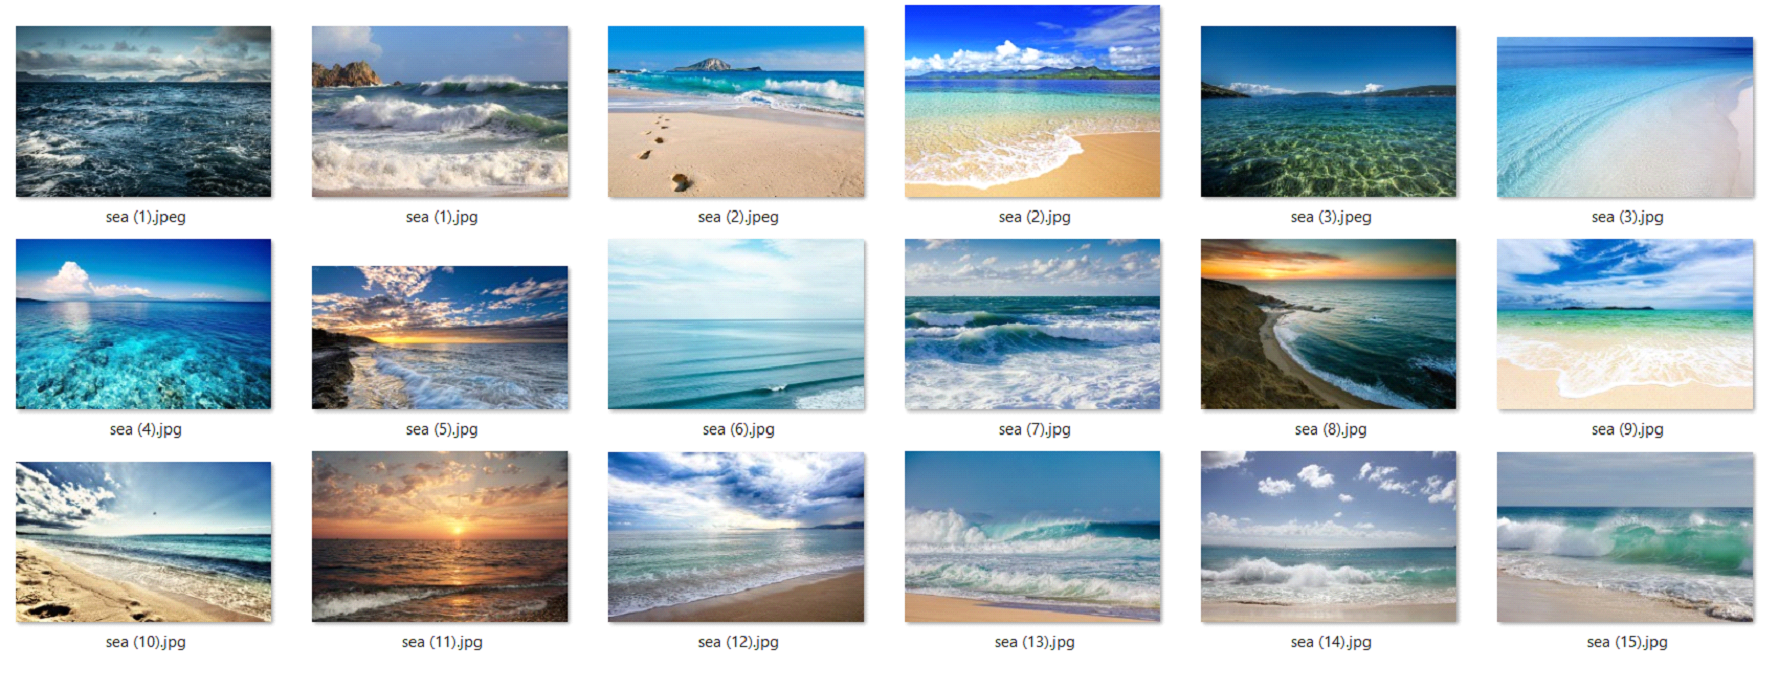
При представлении нового входного изображения наш алгоритм обнаружения новизны должен решить, вписывается ли новое изображение в «многообразие моря» или оно является новинкой, и вернуть либо 1, либо -1. Если возвращается 1, то делаем вывод «Да, это море», иначе «Нет, не похоже на море»
Для оценки нашего алгоритма обнаружения новинок используем 3 тестовых изображения:

Для начала реализуем модуль для извлечения цветовой гистограммы с помощью OpenCV, это необходимо для того, чтобы представить изображение в график пикселей:
from imutils import paths import numpy as np import cv2 def histogram_image(image, bins=(4, 6, 3)): # вычислияем 3D-цветовую гистограмму по изображению и нормализуем ее histogram = cv2.calcHist([image], [0, 1, 2], None, bins, [0, 180, 0, 256, 0, 256]) histogram = cv2.normalize(histogram, histogram).flatten() # Возращаем гистограмму return histogramЗатем загружаем датасет:
def loading_dataset(path_dataset, bins): # пути ко всем изображениям в нашем каталоге набора данных, затем # инициализируйте наши списки изображений path_s_image = list(paths.list_images(path_dataset)) data = [] # цикл по каждому патчу for path in path_s_image: image = cv2.imread(path) image = cv2.cvtColor(image, cv2.COLOR_BGR2HSV) features = quantify_image(image, bins) data.append(features) return np.array(data)Создаем файл Python для обучения модели на загруженном датасете и запускаем выполнение:
from function import loading_dataset from sklearn.ensemble import IsolationForest import pickle print("[ИНФО] подготовка набора данных") data = loading_dataset('sea/', bins=(3, 3, 3)) # обучаем модель print("[INFO] модель обнаружения") model = IsolationForest(n_estimators=100, contamination=0.01, random_state=42) model.fit(data) f = open('detect_anomaly.model', "wb") f.write(pickle.dumps(model)) f.close() Создаем файл test_anomaly для тестирования модели:
from function import histogram_image import pickle import cv2 print("[ИНФО] загрузка модели новизны") model = pickle.loads(open("detect_anomaly.model", "rb").read()) # Загрузка изображения,и конвертация в гистограмму image = cv2.imread('examples\cities.jpg') hsv = cv2.cvtColor(image, cv2.COLOR_BGR2HSV) features = histogram_image(hsv, bins=(3, 3, 3)) preds = model.predict([features])[0] label = "new" if preds == -1 else "normal" color = (0, 0, 255) if preds == -1 else (0, 255, 0) # рисуем фотографию cv2.putText(image, label, (10, 25), cv2.FONT_HERSHEY_SIMPLEX, 0.7, color, 2) # отображаем на экране cv2.imshow("Output", image) cv2.waitKey(0)Тестируем модель на трех фотографиях – город, море и шоссе.
Тест 1. В модель загружаем фото города.
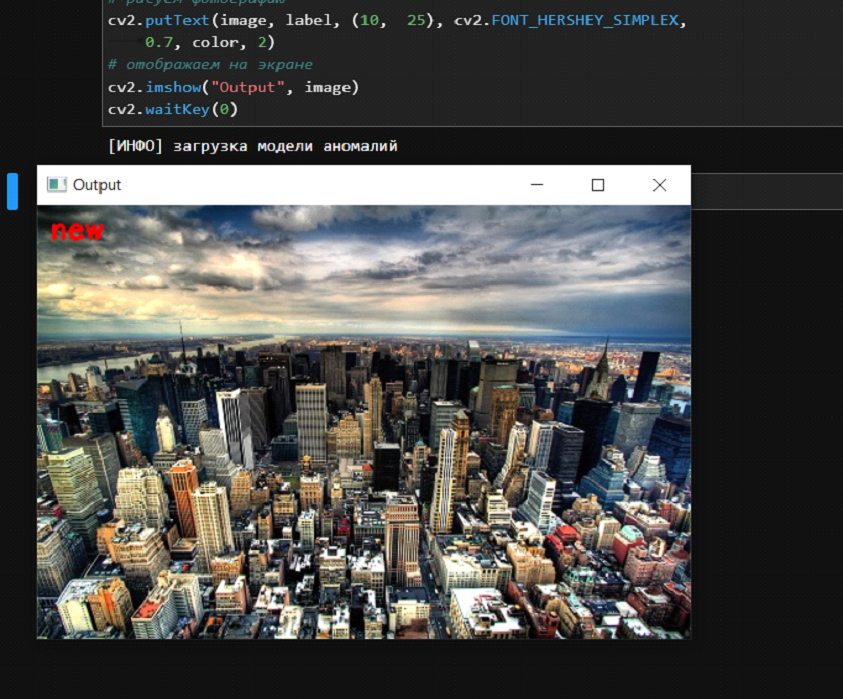
По результату отработки алгоритма видим, что фотографию города модель пометила как новинку.
Тест 2. В модель загружаем фото моря.

Фотографию моря модель пометила как нормальное. То есть на картинки изображено море.
Тест 3. В модель загружаем фото шоссе.
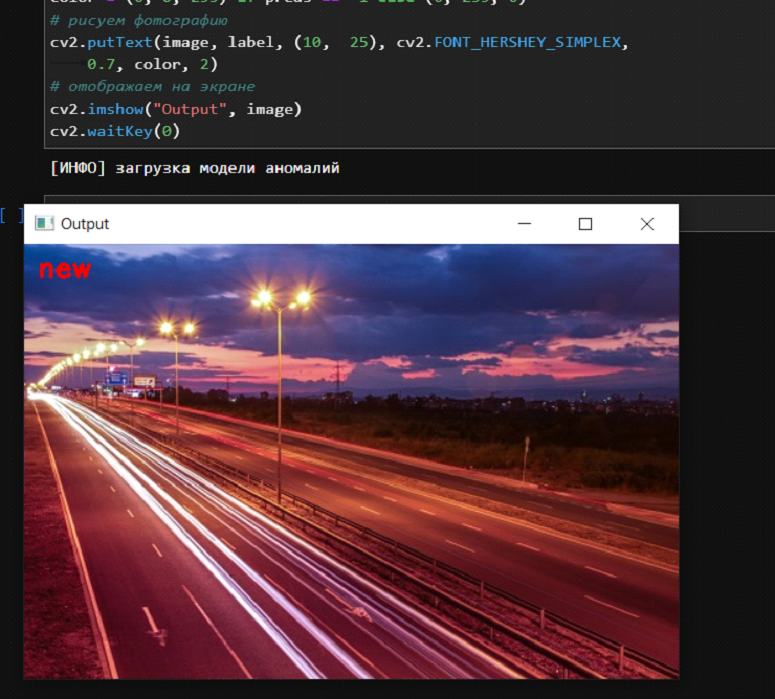
Фотографию шоссе модель пометила как новинку.
В результате, наша обученная модель прошла три из трех тестов, и определила все фотографии верно. Две из которых были новинками и одно фото не являлось новинкой.
Сканер документов на основе технологии машинного зрения
В последнее время, когда я работал с OpenCV, мне пришла в голову идея написать фреймворк для преобразования изображений. Такое приложение будет полезно каждый день и с ним будет просто работать. Потом как-то меня попросили оцифровать чек за топливо как основание для оформления претензии. Я делал такое и раньше, брал для этого одно из множества приложений, которые можно скачать с Playstore, но в этот раз у меня в голове поселился вопрос “почему я не делаю это своими силами?”. Ведь в целом, это всего лишь захват области документа с фотографии или изображения. Ну и ну!
Я сразу же увидел идею для нового проекта: сделать свой собственный сканер документов. И раз в OpenCV есть все эти функции по обработке изображений, то я решил взять его в качестве инструмента. Так я и приступил к созданию своего собственного сканера документов при помощи машинного зрения, OpenCV и Python.
Давайте перейдём к делу без долгих предисловий. Для начала я составил список основных этапов обработки. Вот они:
- “Прочитать” фотографию или изображение: если размеры изображения большие, вы можете выбрать уменьшить его в масштабе, чтобы обработать быстро или же изменить размер прямо в текущем окне.
- Идентифицировать границы: чтобы сделать это, нам может понадобиться конвертировать изображение в серое для уменьшения цветового шума. Чтобы убрать любой высокочастотный шум, мы слегка размоем изображение. Это поможет дальше определить контуры.
- Найти границы документа в изображении: это выявит нужную нам область в изображении. На этом этапе мы сможем увидеть контур своего документа.
- Идентифицировать и получить границы документа: в этой части больше всего программирования, а мы будем соотносить каждую пару координат с ближайшим углом и рассчитаем размеры документа.
- Применить перспективное преобразование: чтобы получить полную картинку сверху донизу, так сказать, обзор документа “с высоты птичьего полёта”, мы будем переводить полученную интересующую нас область в нужную перспективу.
- Финальные шаги: мы подготовим изображение к итоговому выводу для пользователя. Этого шага может и не быть, вам решать, как вы хотите видеть свой документ. А может вы выберете применить любое преобразование, как, например, черно-белое или увеличение контраста.
Давайте перейдём к практике по каждому пункту. Я добавил куски кода и снэпшоты изображений в ходе обработки, чтобы проиллюстрировать то, что происходит с документом в процессе. Программирую в этом случае на Python.
Шаг 1: чтение фотографии или изображения
# импортирование необходимых библиотек
import numpy as np
import cv2
import imutils# параметр для сканируемого изображения
args_image = “fuel_bill_to_scan.jpg”# прочитать изображение
image = cv2.imread(args_image)
orig = image.copy()# показать исходное изображение
cv2.imshow(“Original Image”, image)
cv2.waitKey(0) # press 0 to close all cv2 windows
cv2.destroyAllWindows()
Первый шаг. В нём мы импортируем необходимые библиотеки и определяем аргумент исходного изображения со ссылкой на место, где оно лежит, чтобы отсканировать его и обработать. После этого мы читаем изображение при помощи функции imread OpenCV и делаем бэкап-копию на случай, если оно понадобится позже.
Мы отображаем обработанное изображение при помощи команды imshow. Если вы не знакомы с ней, imshow открывает всплывающее окно, которое показывает превью изображения, а функция waitKey будет держать его в таком положении, пока вы не нажмёте ключевую клавишу (в примере это 0). Как только вы закроете превью, нажмите кнопку 0 на клавиатуре и открывшийся попап исчезнет, а ваша сессия Python станет активной.
Шаг 2: идентификация краёв
# конвертация изображения в градации серого. Это уберёт цветовой шум
grayImage = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)# размытие картинки, чтобы убрать высокочастотный шум
# это помогает определить контур в сером изображении
grayImageBlur = cv2.blur(grayImage,(3,3))# теперь производим определение границы по методу Canny
edgedImage = cv2.Canny(grayImageBlur, 100, 300, 3)# показать серое изображение с определенными границами
cv2.imshow("gray", grayImage)
cv2.imshow("grayBlur", grayImageBlur)
cv2.imshow("Edge Detected Image", edgedImage)
cv2.waitKey(0) # нажать 0, чтобы закрыть все окна cv2
cv2.destroyAllWindows()
Мы конвертировали цветное изображение в серое, чтобы уменьшить любой цветовой шум. Чтобы освежить знания: у цветного изображения глубина 3 (по единице на каждый цвет из RGB), в то время как у серого цвета глубина 1. Затем мы применяем функцию blur, чтобы размыть изображение с фильтром (3,3). Размытие уменьшает любой высокочастотный шум и упрощает определение контуров.
Теперь применим алгоритм определения границ Canny, чтобы найти контуры на размытом изображении. Это один из самых популярных алгоритмов для определения широкого диапазона границ в изображениях. John F. Canny разработал его в 1986-м и этот метод еще называют оптимальным детектором.
Помните, что в коде выше я использовал настройки, которые подходят только для моего случая. Если эти значения не сработают на вашем изображении, то поиграйте с настройками и оставьте те из них, которые приводят к наилучшему результату в вашем примере.
Шаг 3: определение границ области на изображении
# найти контуры на обрезанном изображении, рационально организовать область
# оставить только большие варианты
allContours = cv2.findContours(edgedImage.copy(), cv2.RETR_LIST, cv2.CHAIN_APPROX_SIMPLE)
allContours = imutils.grab_contours(allContours)# сортировка контуров области по уменьшению и сохранение топ-1
allContours = sorted(allContours, key=cv2.contourArea, reverse=True)[:1]# aппроксимация контура
perimeter = cv2.arcLength(allContours[0], True)
ROIdimensions = cv2.approxPolyDP(allContours[0], 0.02*perimeter, True)# показать контуры на изображении
cv2.drawContours(image, [ROIdimensions], -1, (0,255,0), 2)
cv2.imshow(“Contour Outline”, image)
cv2.waitKey(0)
cv2.destroyAllWindows()
Теперь мы займёмся поиском контуров в нашем обрезанном изображении. Оставляем контур с максимальной областью и отбрасываем остальные варианты. Рассматривая изображение с границами, отображенными в предыдущем шаге, мы можем чётко увидеть, что границы документа очерчивают максимальную целостную область. Вместо множества итераций по каждому контуру и сохранению экстремумов, мы просто проверяем область и сохраняем ту, у которой максимальная площадь. Это экономит нам много ресурсов. Если мы заранее знаем количество углов в нашем документе, тогда мы можем использовать такой метод проверки и рассчитывать на хорошие результаты.
Тут мы использовали парочку функций CV2, таких как findContours — для получения всех контуров в обрезанном изображении, contourArea — для получения области, замкнутой контуром координат и arcLength. Мы сохранили координаты контуров, чтобы пользоваться ими дальше для обрезки необходимой нам области документа с изображения.
Шаг 4: идентификация и получение границ документа
# изменение массива координат
ROIdimensions = ROIdimensions.reshape(4,2)# список удержания координат ROI
rect = np.zeros((4,2), dtype=”float32")# наименьшая сумма будет у верхнего левого угла,
# наибольшая — у нижнего правого угла
s = np.sum(ROIdimensions, axis=1)
rect[0] = ROIdimensions[np.argmin(s)]
rect[2] = ROIdimensions[np.argmax(s)]# верх-право будет с минимальной разницей
# низ-лево будет иметь максимальную разницу
diff = np.diff(ROIdimensions, axis=1)
rect[1] = ROIdimensions[np.argmin(diff)]
rect[3] = ROIdimensions[np.argmax(diff)]# верх-лево, верх-право, низ-право, низ-лево
(tl, tr, br, bl) = rect# вычислить ширину ROI
widthA = np.sqrt((tl[0] — tr[0])**2 + (tl[1] — tr[1])**2 )
widthB = np.sqrt((bl[0] — br[0])**2 + (bl[1] — br[1])**2 )
maxWidth = max(int(widthA), int(widthB))# вычислить высоту ROI
heightA = np.sqrt((tl[0] — bl[0])**2 + (tl[1] — bl[1])**2 )
heightB = np.sqrt((tr[0] — br[0])**2 + (tr[1] — br[1])**2 )
maxHeight = max(int(heightA), int(heightB))
Из всего процесса сканирования эта часть больше всего насыщена программированием. И теперь у нас есть координаты 4 углов документа, мы будем соотносить координаты с углами, а затем расположим их в определённом порядке.
Поясню основы: изображение состоит из пикселей разного значения (интенсивность цвета). Для цветных изображений у нас будет 3 пикселя значения для точки, а для серого изображения у нас будет один пиксель. Итак, размер изображения — это матрица с первым элементом высоты, вторым — ширины и третьим — глубины цвета, которая обычно равна 3 для цветного изображения и 1 для серого. Итак, мы можем сказать, что для серого изображения у нас будет только два измерения — высота и ширина.
Теперь, с этой базой, каждый из 4-х углов изображения может быть идентифицирован с его пиксельными координатами как точка на плоскости X-Y. Пиксели изображения начинаются сверху слева. Принимая, что h представляет высоту, а w — ширину, форма изображения будет определяться (h, w, d), где d — это глубина, на которую можно не обращать внимания в случае с серым изображением (h,w).
- Верхний левый угол изображения будет иметь координаты (0,0), значит, мы можем сказать, что высота и ширина будут наименьшими среди данных 4-х пар координат.
- Верхний правый угол изображения будет иметь минимальное значение высоты, но максимальное по ширине. В идеале это будет (0,w).
- Нижний левый угловой пиксель изображения будет находиться по диагонали напротив верхнего правого. Он должен быть (h,0), т.е. иметь максимальное значение высоты, но минимальное по ширине.
- Нижний правый угол изображения будет иметь максимальное значение по высоте и ширине одновременно.
Применяя описанные параметры 4 углов, мы можем сделать вывод, что верхний левый угол будет иметь наименьшую сумму, в то время как нижняя правая точка будет иметь максимальную сумму среди 4-х точек с координатами. Верхняя правая точка будет иметь минимальную разницу, в то время как нижний левый угол будет иметь наибольшую разницу среди 4 точек с координатами.
Применяя это рассуждение, мы можем определить, какие координаты к какому из углов ближе. Мы создали список и захватили контур, т.е. координаты ROI (Region of Interest — области интереса) для того, чтобы первая запись в списке была о верхней левой точке, вторая — о правой верхней, третья — о правой нижней и 4-я — о нижней слева. В принципе, направление по часовой стрелке и начинается с левого верхнего угла.
Мы рассчитали ширину и высоту изображения во многом так, как мы вычисляем расстояние между 2 точками на плоскости X-Y. Тут нужна базовая статистика. Для остального вы можете найти идеи решения в приведённом фрагменте кода и том, как он имплементирован.
Шаг 5: применить перспективное преобразование
# набор итоговых точек для обзора всего документа
# размер нового изображения
dst = np.array([
[0,0],
[maxWidth-1, 0],
[maxWidth-1, maxHeight-1],
[0, maxHeight-1]], dtype="float32")# вычислить матрицу перспективного преобразования и применить её
transformMatrix = cv2.getPerspectiveTransform(rect, dst)# преобразовать ROI
scan = cv2.warpPerspective(orig, transformMatrix, (maxWidth, maxHeight))# давайте посмотрим на свёрнутый документ
cv2.imshow("Scaned",scan)
cv2.waitKey(0)
cv2.destroyAllWindows()
Ну а теперь у нас есть размеры нашей ROI, и мы собираем набор итоговых точек, чтобы получить обзор с высоты птичьего-полёта, т.е. вид всего изображения сверху. Снова, давайте определим точки в том же порядке, что и раньше, т.е. верх-лево, верх-право, низ-право, низ-лево. Здесь важен порядок, и он должен быть совместим с порядком того, в каких координатах ROI сохранена наша область. Причина в том, что мы будем извлекать ROI из изображения и преобразовывать её по новым размерам.
Применив функцию getPerspectiveTransform, мы рассчитали матрицу, которая будет преобразовывать нашу ROI в итоговые размеры, т.е. целостное изображение нашего документа и ничего больше. Для этого нам нужны координаты ROI и итоговой матрицы. Далее мы извлекли площадь ROI из изображения и применили эту трансформацию на полученной области, чтобы получить вид всего нашего документа целиком. Тут мы применили функцию warpPerspective. Вывод: это и есть изображение всего документа.
Шаг 6: финальные шаги
Мы получили наш документ, фактически отсканированным и вырезанным из исходного изображения. И даже несмотря на то, что документ был сфотографирован под углом, мы смогли получить правильную перспективу, применив матрицу преобразования на выделенной области. Итоговый результат на самом деле выглядит хорошо.
И в конце мы можем подготовить изображение для отображения результата. Обратите внимание, цвет документа такой же, как на исходной картинке. В этом шаге мы применим некоторые действия по пост-обработке, чтобы улучшить внешний вид нашего отсканированного документа. Многие люди могут захотеть, чтобы их скан был черно-белым или предпочтут увеличить итоговый контраст в случае с документом. Мы можем также усилить цвет в финальном отсканированном изображении. В финале мы и делаем всё это.
# конвертация в серый
scanGray = cv2.cvtColor(scan, cv2.COLOR_BGR2GRAY)# показать финальное серое изображение
cv2.imshow("scanGray", scanGray)
cv2.waitKey(0)
cv2.destroyAllWindows()# ------------------------------# конвертация в черно-белое с высоким контрастом для документов
from skimage.filters import threshold_local
# увеличить контраст в случае с документом
T = threshold_local(scanGray, 9, offset=8, method="gaussian")
scanBW = (scanGray > T).astype("uint8") * 255# показать финальное изображение с высоким контрастом
cv2.imshow("scanBW", scanBW)
cv2.waitKey(0)
cv2.destroyAllWindows()
Заключение
И наконец, мы закончили со сканированием документа и преобразованием для оптимизации его внешнего вида. Этот код можно поместить в веб-интерфейс с помощью flask. Flask — это один из часто используемых и лучших фреймворков для веб-приложений, написанных на Python. Мы можем дальше запускать наш код “на лету” или “по требованию” при помощи docker. Такая программа всего лишь основа для создания приложения. Например, этот код можно генерализировать и создать из него мобильное или веб-приложение. Я очень хочу вдохновить вас на создание своего собственного приложения сканирования вместо использования тех, что доступны в интернете.
Одна важная вещь, которую я хотел бы подчеркнуть ещё раз, что для разных параметров функций, я пользовался теми значениями, что подходили лучше всего в моём случае. Я пришёл к этим значениям после того, как испробовал различные комбинации. В случае, если вы будете переиспользовать мой подход и саму программу, вам следует проверить, какая комбинация работает лучше именно для вас. Более того, если мы планируем всё это действительно запускать, т.е. зарелизим приложение или сканер документов, тогда постарайтесь сфотографировать документ ровно (держите телефон параллельно поверхности) вместо того, чтобы снимать под углом. Так вы получите лучшие результаты.
Я надеюсь, вам понравилась моя статья, а знания пригодятся для вашей собственной разработки приложения по сканированию изображений.
- Распознавание лиц с помощью OpenCV
- Все модели машинного обучения за 6 минут
- Анализ аудиоданных с помощью глубокого обучения и Python (часть 1)
Распознавание лиц при помощи Python и OpenCV
В этой статье мы разберемся, что такое распознавание лиц и чем оно отличается от определения лиц на изображении. Мы кратко рассмотрим теорию распознавания лиц, а затем перейдем к написанию кода. В конце этой статьи вы сможете создать свою собственную программу распознавания лиц на изображениях, а также в прямом эфире с веб-камеры.
Что такое обнаружение лиц?
Одной из основных задач компьютерного зрения является автоматическое обнаружение объекта без вмешательства человека. Например, определение человеческих лиц на изображении.
Лица людей отличаются друг от друга. Но в целом можно сказать, что всем им присущи определенные общие черты.
Существует много алгоритмов обнаружения лиц. Одним из старейших является алгоритм Виолы-Джонса. Он был предложен в 2001 году и применяется по сей день. Чуть позже мы тоже им воспользуемся. После прочтения данной статьи вы можете изучить его более подробно.
Обнаружение лиц обычно является первым шагом для решения более сложных задач, таких как распознавание лиц или верификация пользователя по лицу. Но оно может иметь и другие полезные применения.
Вероятно самым успешным использованием обнаружения лиц является фотосъемка. Когда вы фотографируете своих друзей, встроенный в вашу цифровую камеру алгоритм распознавания лиц определяет, где находятся их лица, и соответствующим образом регулирует фокус.
Что такое распознавание лиц?
Итак, в создании алгоритмов обнаружения лиц мы (люди) преуспели. А можно ли также распознавать, чьи это лица?
Распознавание лиц — это метод идентификации или подтверждения личности человека по его лицу. Существуют различные алгоритмы распознавания лиц, но их точность может различаться. Здесь мы собираемся описать распознавание лиц при помощи глубокого обучения.
Итак, давайте разберемся, как мы распознаем лица при помощи глубокого обучения. Для начала мы производим преобразование, или, иными словами, эмбеддинг (embedding), изображения лица в числовой вектор. Это также называется глубоким метрическим обучением.
Для облегчения понимания давайте разобьем весь процесс на три простых шага:
Обнаружение лиц
Наша первая задача — это обнаружение лиц на изображении или в видеопотоке. Далее, когда мы знаем точное местоположение или координаты лица, мы берем это лицо для дальнейшей обработки.
Извлечение признаков
Вырезав лицо из изображения, мы должны извлечь из него характерные черты. Для этого мы будем использовать процедуру под названием эмбеддинг.
Нейронная сеть принимает на вход изображение, а на выходе возвращает числовой вектор, характеризующий основные признаки данного лица. (Более подробно об этом рассказано, например, в нашей серии статей про сверточные нейронные сети — прим. переводчика). В машинном обучении данный вектор как раз и называется эмбеддингом.
Теперь давайте разберемся, как это помогает в распознавании лиц разных людей.
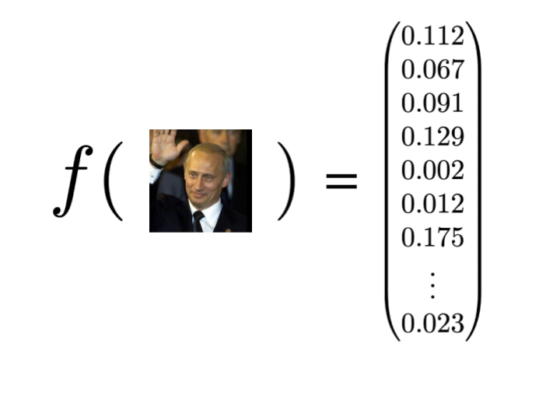
Во время обучения нейронная сеть учится выдавать близкие векторы для лиц, которые выглядят похожими друг на друга.
Например, если у вас есть несколько изображений вашего лица в разные моменты времени, то естественно, что некоторые черты лица могут меняться, но все же незначительно. Таким образом, векторы этих изображений будут очень близки в векторном пространстве. Чтобы получить общее представление об этом, взгляните на график:
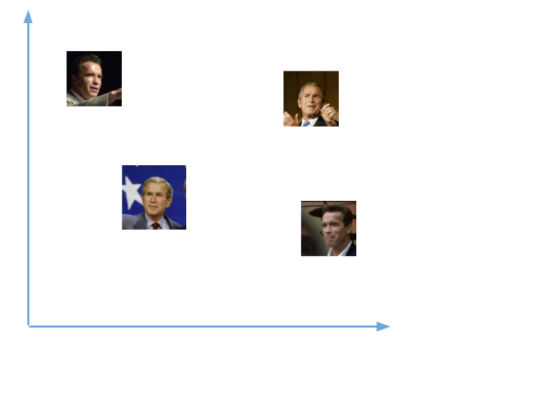
Чтобы определять лица одного и того же человека, сеть будет учиться выводить векторы, находящиеся рядом в векторном пространстве. После обучения эти векторы трансформируются следующим образом:
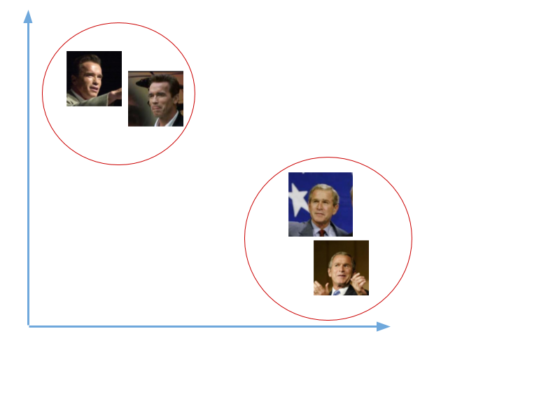
Здесь мы не будем заниматься обучением подобной сети. Это требует значительных вычислительных мощностей и большого объема размеченных данных. Вместо этого мы используем уже предобученную Дэвисом Кингом нейронную сеть. Она обучалась приблизительно на 3000000 изображений. Эта сеть выдает вектор длиной 128 чисел, который и определяет основные черты лица.
Познакомившись с принципами работы подобных сетей, давайте посмотрим, как мы будем использовать такую сеть для наших собственных данных.
Мы передадим все наши изображения в эту предобученную сеть, получим соответствующие вектора (эмбеддинги) и затем сохраним их в файл для следующего шага.
Сравнение лиц
Теперь, когда у нас есть вектор (эмбеддинг) для каждого лица из нашей базы данных, нам нужно научиться распознавать лица из новых изображений. Таким образом, нам нужно, как и раньше, вычислить вектор для нового лица, а затем сравнить его с уже имеющимися векторами. Мы сможем распознать лицо, если оно похоже на одно из лиц, уже имеющихся в нашей базе данных. Это означает, что их вектора будут расположены вблизи друг от друга, как показано на примере ниже:
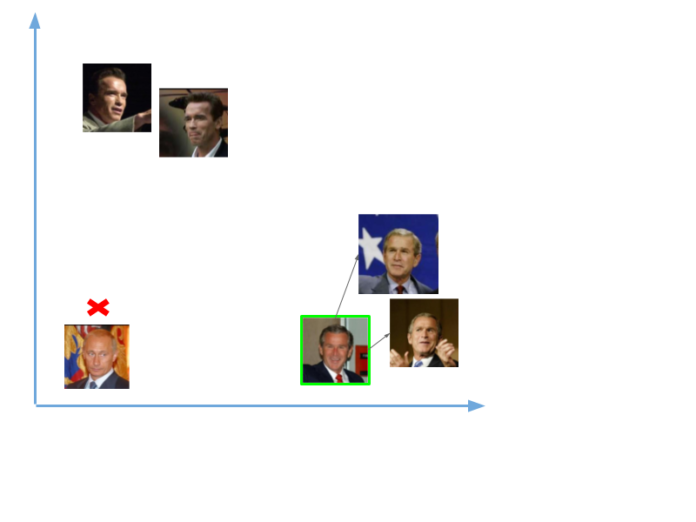
Итак, мы передали в сеть две фотографии, одна Владимира Путина, другая Джорджа Буша. Для изображений Буша у нас были вектора (эмбеддинги), а для Путина ничего не было. Таким образом, когда мы сравнили эмбеддинг нового изображения Буша, он был близок с уже имеющимися векторам,и и мы распознали его. А вот изображений Путина в нашей базе не было, поэтому распознать его не удалось.
Что такое OpenCV?
В области искусственного интеллекта задачи компьютерного зрения — одни из самых интересных и сложных.
Компьютерное зрение работает как мост между компьютерным программным обеспечением и визуальной картиной вокруг нас. Оно дает ПО возможность понимать и изучать все видимое в окружающей среде.
Например, на основе цвета, размера и формы плода мы определяем разновидность определенного фрукта. Эта задача может быть очень проста для человеческого разума, однако в контексте компьютерного зрения все выглядит иначе.
Сначала мы собираем данные, затем выполняем определенные действия по их обработке, а потом многократно обучаем модель, как ей распознавать сорт фрукта по размеру, форме и цвету его плода.
В настоящее время существуют различные пакеты для выполнения задач машинного обучения, глубокого обучения и компьютерного зрения. И безусловно, модуль, отвечающий за компьютерное зрение, проработан лучше других.
OpenCV — это библиотека с открытым программным кодом. Она поддерживает различные языки программирования, например R и Python. Работать она может на многих платформах, в частности — на Windows, Linux и MacOS.
Основные преимущества OpenCV :
- имеет открытый программный код и абсолютно бесплатна
- написана на C/C++ и в сравнении с другими библиотеками работает быстрее
- не требует много памяти и хорошо работает при небольшом объеме RAM
- поддерживает большинство операционных систем, в том числе Windows, Linux и MacOS.
Установка
Здесь мы будем рассматривать установку OpenCV только для Python. Мы можем установить ее при помощи менеджеров pip или conda (в случае, если у нас установлен пакет Anaconda).
1. При помощи pip
При помощи pip процесс установки может быть выполнен с использованием следующей команды:
pip install opencv-python
2. Anaconda
Если вы используете Anaconda, то выполните следующую команду в окружении Anaconda:
conda install -c conda-forge opencv
Распознавание лиц с использованием Python
В этой части мы реализуем распознавание лиц при помощи Python и OpenCV. Для начала посмотрим, какие библиотеки нам потребуются и как их установить:
- OpenCV
- dlib
- Face_recognition
OpenCV — это библиотека обработки изображений и видео, которая используется для их анализа. Ее применяют для обнаружения лиц, считывания номерных знаков, редактирования фотографий, расширенного роботизированного зрения, оптического распознавания символов и многого другого.
Библиотека dlib , поддерживая Дэвисом Кингом, содержит реализацию глубокого метрического обучения. Мы ее будем использовать для конструирования векторов (эмбеддингов) изображений, играющих ключевую роль в процессе распознавания лиц.
Библиотека face_recognition , созданная Адамом Гейтгеем, включает в себя функции распознавания лиц dlib и является по сути надстройкой над ней. С ней очень легко работать, и мы будем ее использовать в нашем коде. Имейте ввиду, что ее нужно устанавливать после библиотеки dlib .
Для установки OpenCV наберите в командной строке:
pip install opencv-python
Мы перепробовали множество способов установки dlib под WIndows и простейший способ это сделать — при помощи Anaconda. Поэтому для начала установите Anaconda (вот здесь подробно рассказано, как это делается). Затем введите в терминале следующую команду:
conda install -c conda-forge dlib
Далее, для установки библиотеки face_recognition наберите в командной строке следующее:
pip install face_recognition
Теперь, когда все необходимые модули установлены, приступим к написанию кода. Нам нужно будет создать три файла.
Первый файл будет принимать датасет с изображениями и выдавать эмбеддинг для каждого лица. Эти эмбеддинги будут записываться во второй файл. В третьем файле мы будем сравнивать лица с уже существующими изображениями. А затем мы сделаем тоже самое в стриме с веб-камеры.
Извлечение признаков лица
Для начала вам нужно достать датасет с лицами или создать свой собственный. Главное, убедитесь, что все изображения находятся в папках, причем в каждой папке должны быть фотографии одного и того же человека.
Затем разместите датасет в вашей рабочей директории, то есть там, где выбудете создавать собственные файлы.
from imutils import paths import face_recognition import pickle import cv2 import os # в директории Images хранятся папки со всеми изображениями imagePaths = list(paths.list_images('Images')) knownEncodings = [] knownNames = [] # перебираем все папки с изображениями for (i, imagePath) in enumerate(imagePaths): # извлекаем имя человека из названия папки name = imagePath.split(os.path.sep)[-2] # загружаем изображение и конвертируем его из BGR (OpenCV ordering) # в dlib ordering (RGB) image = cv2.imread(imagePath) rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB) #используем библиотеку Face_recognition для обнаружения лиц boxes = face_recognition.face_locations(rgb,model='hog') # вычисляем эмбеддинги для каждого лица encodings = face_recognition.face_encodings(rgb, boxes) # loop over the encodings for encoding in encodings: knownEncodings.append(encoding) knownNames.append(name) # сохраним эмбеддинги вместе с их именами в формате словаря data = # для сохранения данных в файл используем метод pickle f = open("face_enc", "wb") f.write(pickle.dumps(data)) f.close()
Сейчас мы сохранили все эмбеддинги в файл под названием face_enc . Теперь мы можем их использовать для распознавания лиц на изображениях или во время видеострима с веб-камеры.
Распознавание лиц во время прямой трансляции веб-камеры
Вот код для распознавания лиц из прямой трансляции веб-камеры:
import face_recognition import imutils import pickle import time import cv2 import os # find path of xml file containing haarcascade file cascPathface = os.path.dirname( cv2.__file__) + "/data/haarcascade_frontalface_alt2.xml" # load the harcaascade in the cascade classifier faceCascade = cv2.CascadeClassifier(cascPathface) # load the known faces and embeddings saved in last file data = pickle.loads(open('face_enc', "rb").read()) print("Streaming started") video_capture = cv2.VideoCapture(0) # loop over frames from the video file stream while True: # grab the frame from the threaded video stream ret, frame = video_capture.read() gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY) faces = faceCascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(60, 60), flags=cv2.CASCADE_SCALE_IMAGE) # convert the input frame from BGR to RGB rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB) # the facial embeddings for face in input encodings = face_recognition.face_encodings(rgb) names = [] # loop over the facial embeddings incase # we have multiple embeddings for multiple fcaes for encoding in encodings: # Compare encodings with encodings in data["encodings"] # Matches contain array with boolean values and True for the embeddings it matches closely # and False for rest matches = face_recognition.compare_faces(data["encodings"], encoding) # set name =inknown if no encoding matches name = "Unknown" # check to see if we have found a match if True in matches: #Find positions at which we get True and store them matchedIdxs = [i for (i, b) in enumerate(matches) if b] counts = <> # loop over the matched indexes and maintain a count for # each recognized face face for i in matchedIdxs: # Check the names at respective indexes we stored in matchedIdxs name = data["names"][i] # increase count for the name we got counts[name] = counts.get(name, 0) + 1 # set name which has highest count name = max(counts, key=counts.get) # update the list of names names.append(name) # loop over the recognized faces for ((x, y, w, h), name) in zip(faces, names): # rescale the face coordinates # draw the predicted face name on the image cv2.rectangle(frame, (x, y), (x + w, y + h), (0, 255, 0), 2) cv2.putText(frame, name, (x, y), cv2.FONT_HERSHEY_SIMPLEX, 0.75, (0, 255, 0), 2) cv2.imshow("Frame", frame) if cv2.waitKey(1) & 0xFF == ord('q'): break video_capture.release() cv2.destroyAllWindows()
В данном примере для обнаружения лиц использовался метод cv2.CascadeClassifier() из библиотеки OpenCV. Но вы с таким же успехом можете пользоваться и методом face_recognition.face_locations() , как мы уже делали в предыдущем примере.
Распознавание лиц на изображениях
Код для обнаружения и распознавания лиц на изображениях почти аналогичен тому, что вы видели выше. Убедитесь в этом сами:
import face_recognition import imutils import pickle import time import cv2 import os # find path of xml file containing haarcascade file cascPathface = os.path.dirname( cv2.__file__) + "/data/haarcascade_frontalface_alt2.xml" # load the harcaascade in the cascade classifier faceCascade = cv2.CascadeClassifier(cascPathface) # load the known faces and embeddings saved in last file data = pickle.loads(open('face_enc', "rb").read()) # Find path to the image you want to detect face and pass it here image = cv2.imread(Path-to-img) rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB) # convert image to Greyscale for haarcascade gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY) faces = faceCascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(60, 60), flags=cv2.CASCADE_SCALE_IMAGE) # the facial embeddings for face in input encodings = face_recognition.face_encodings(rgb) names = [] # loop over the facial embeddings incase # we have multiple embeddings for multiple fcaes for encoding in encodings: # Compare encodings with encodings in data["encodings"] # Matches contain array with boolean values and True for the embeddings it matches closely # and False for rest matches = face_recognition.compare_faces(data["encodings"], encoding) # set name =inknown if no encoding matches name = "Unknown" # check to see if we have found a match if True in matches: # Find positions at which we get True and store them matchedIdxs = [i for (i, b) in enumerate(matches) if b] counts = <> # loop over the matched indexes and maintain a count for # each recognized face face for i in matchedIdxs: # Check the names at respective indexes we stored in matchedIdxs name = data["names"][i] # increase count for the name we got counts[name] = counts.get(name, 0) + 1 # set name which has highest count name = max(counts, key=counts.get) # update the list of names names.append(name) # loop over the recognized faces for ((x, y, w, h), name) in zip(faces, names): # rescale the face coordinates # draw the predicted face name on the image cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2) cv2.putText(image, name, (x, y), cv2.FONT_HERSHEY_SIMPLEX, 0.75, (0, 255, 0), 2) cv2.imshow("Frame", image) cv2.waitKey(0)
Результат:

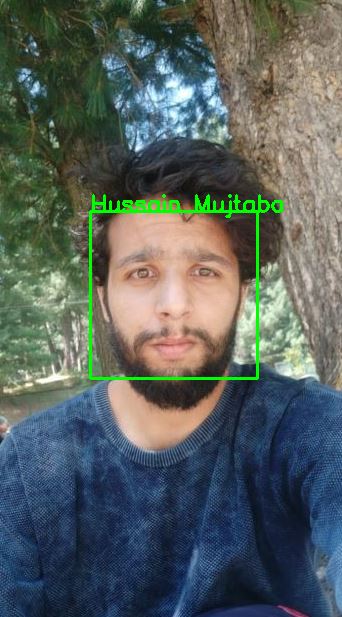
На этом наша статья подошла к концу. Мы надеемся, что вы получили общее представление о задачах распознавания лиц и способах их решения.
Автоматическое слежение за цветными объектами

В первом проекте было рассмотрено, как собрать механизм поворота/наклона и управлять им с помощью Raspberry Pi. Во втором было реализовано управление по локальной сети. В этом проекте с помощью системы компьютерного зрения реализуем автоматическое слежение за цветными предметами.
Кроме деталей, используемых ранее (Raspberry Pi 3 Модель B, модуль камеры и 2 сервопривода) нам понадобится ещё светодиод и резистор 221 Ом.
Для создания системы компьютерного зрения будет использоваться библиотека OpenCV. Это мой первый опыт работы с OpenCV, и я остался очень доволен этой библиотекой. OpenCV бесплатна для академического и коммерческого использования. Она имеет интерфейсы для C++, C, Python, Java и многих других языков, так же поддерживается работа на Windows, Linux, Mac OS, iOS и Android. В этом проекте для работы будет использоваться Python. OpenCV хорошо оптимизирован и позволяет создавать приложения компьютерного зрения для систем реального времени.
Установка пакета OpenCV
Я использую Raspberry Pi V3, с ОС Raspbian (Stretch), поэтому лучший способ установить OpenCV — это следовать прекрасному руководству, разработанному Адрианом Роузброком «Установка OpenCV 3 и Python на Raspberry Pi» . Я попробовал несколько разных руководств, чтобы установить OpenCV и руководство Адриана на мой взгляд самое лучшее.
После установки всего необходимого, у Вас будет виртуальная среда OpenCV, готовая для проведения наших экспериментов. Давайте перейдем в нашу виртуальную среду и проверим, что OpenCV 3 правильно установлена. Адриан рекомендует запускать команду «source» при каждом новом запуске терминала, чтобы убедиться, что системные переменные установлены правильно.
Далее запустим виртуальную среду:
Если всё установлено и настроено правильно, в терминале в начале строки будет написано «(cv)», примерно так:
Адриан обращает внимание, что виртуальная среда cv Python полностью независима и отделена от версии Python по умолчанию, включенной в сборку Raspbian Stretch. Таким образом, любые пакеты Python в глобальном каталоге не будут доступны для виртуальной среды cv. Аналогично, любые пакеты cv Python, не будут доступны для глобальной установки Python.
Теперь запустим интерпретатор Python:
и убедимся, что используется версию 3.5 (или выше).
В интерпретаторе (появится «>>>») импортируем модуль cv2:
Если сообщения об ошибках не появляются, OpenCV правильно установлен в вашей виртуальной среде PYTHON.
Вы также можете проверить установленную версию OpenCV:
Вид терминала после выполнения вышеописанных команд:

Тестирование камеры
После установки OpenCV, давайте проверим работоспособность камеры. Если на данный момент вы не подключили и не настроили камеру, посмотрите в предыдущем проекте, как это сделать.
В среде разработки введите следующий (или скачайте файл simpleCamTest.py из репозитория GitHub):
import numpy as np import cv2 cap = cv2.VideoCapture(0) while(True): ret, frame = cap.read() frame = cv2.flip(frame, -1) # Flip camera vertically gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY) cv2.imshow('frame', frame) cv2.imshow('gray', gray) if cv2.waitKey(1) & 0xFF == ord('q'): break cap.release() cv2.destroyAllWindows()
Приведенный выше код будет получать с камеры видеопоток, отображая его одновременно в цвете и в градациях серого.
Обратите внимание, что в коде сделан поворот изображения с камеры. Если Вы иначе закрепили камеру и поворот не нужен, закомментируйте или удалите в коде строку «flip»:
frame = cv2.flip(frame, -1) # Flip camera vertically
Для запуска этого скрипта, выполним команду:

Для прерывания выполнения скрипта, нажмите Ctrl+C.
Определение цвета в Python с OpenCV
Для нахождения нужного объекта в кадре с камеры в данном случае будет использоваться информация о цвете. Поэтому нам нужно понимать, как OpenCV интерпретирует цвета.
OpenCV может работать с изображениями в различных цветовых пространствах. Это BGR, RGB, RGBA, BGRA, HSV, HLS, XYZ, LAB, Gray, YUV и т.д.
В модели RGB цвет каждого пикселя формируется комбинацией трёх базовых цветов: красный (red), зелёный (green) и синий (blue). Отличия между моделью RGB и BGR заключается только в порядке цветовых компонент. На данный момент очень часто для хранения и работы с изображениями используют не BGR, а RGB. Будьте внимательны, т.к. в OpenCV по умолчанию используется BGR. Так исторически сложилось — на ранних этапах разработки OpenCV, в видеокартах, камерах и программном обеспечении очень популярным был именно BGR.
В BGR для кодирования каждой компоненты используется один байт, т.е. значение может принимать значения в диапазоне от 0 до 255 (или от 0 до FF в шестнадцатеричном формате). Например, чистый синий пиксель на экране вашего компьютера будет иметь значение B 255, значение G 0 и значение R 0.

Цветовая модель HSV (Hue, Saturation, Value — тон, насыщенность, значение) является альтернативным представлением цветовой модели RGB, разработанной в 1970-х годах исследователями компьютерной графики для большего соответствия тому, как человечек воспринимает цвета.

Для нахождения и отслеживания цветных предметов с помощью OpenCV, мы будем использовать цветовую модель HSV. К примеру, нужно отследить желтый объект:

Что бы определиться, какой цвет в программе нужно искать, можно открыть изображение в какой-нибудь графической программе (графический редактор, видеоредактор и т.д.). Я использовал PowerPoint. В данном случае для указанного пикселя следующие значения цветовых компонент:
Синий — 71
Зеленый — 234
Красный — 213
Полученные значения цвета в модели BGR (71, 234, 213) нужно преобразовать в HSV, с указанием верхней и нижней границ диапазона. Для этого будем использовать следующий код (файл bgr_hsv_converter.py):
import sys import numpy as np import cv2 blue = sys.argv[1] green = sys.argv[2] red = sys.argv[3] color = np.uint8([[[blue, green, red]]]) hsv_color = cv2.cvtColor(color, cv2.COLOR_BGR2HSV) hue = hsv_color[0][0][0] print("Lower bound is :"), print("[" + str(hue-10) + ", 100, 100]\n") print("Upper bound is :"), print("[" + str(hue + 10) + ", 255, 255]")
Для выполнения введите команду ниже, имеющую в качестве параметров значения BGR, найденные ранее:
python bgr_hsv_converter.py 71 234 213
Программа выведет верхнюю и нижнюю границы цвета нашего объекта:

С цветом разобрались, теперь сделаем что бы OpenCV создал маску для нужного цветового диапазона. Скрипт colorDetection.py :
import cv2 import numpy as np # Read the picure - The 1 means we want the image in BGR img = cv2.imread('yellow_object.JPG', 1) # resize imag to 20% in each axis img = cv2.resize(img, (0,0), fx=0.2, fy=0.2) # convert BGR image to a HSV image hsv = cv2.cvtColor(img, cv2.COLOR_BGR2HSV) # NumPy to create arrays to hold lower and upper range # The “dtype = np.uint8” means that data type is an 8 bit integer lower_range = np.array([24, 100, 100], dtype=np.uint8) upper_range = np.array([44, 255, 255], dtype=np.uint8) # create a mask for image mask = cv2.inRange(hsv, lower_range, upper_range) # display both the mask and the image side-by-side cv2.imshow('mask',mask) cv2.imshow('image', img) # wait to user to press [ ESC ] while(1): k = cv2.waitKey(0) if(k == 27): break cv2.destroyAllWindows()
Для выполнения этого демонстрационного скрипта нужно что бы в папке был файл с изображением, в моем случае это файл «yellow_object.JPG». Исли у Вас другое имя файла, переименуйте его или в коде замените на нужное. Запускаем скрипт:
На экране появится два изображения:

Это исходное изображение и полученная маска.
Отслеживание движения объекта
Теперь, когда мы знаем, как получить маску для объекта, перейдём к отслеживать его движения. Для этого я адаптировал код «отслеживание мяча» Адриана Роузброка. Перед использованием моего кода, убедитесь, что у Вас установлена библиотека imutils. Это коллекция удобных функций OpenCV, созданная Адрианом, которая значительно упрощает выполнение нескольких основных задач (таких как изменение размера или отображение). Если её нет, для установки в среде Virtual Python введите команду:
pip install imutils
Затем загрузите код ball_tracking.py с моего GitHub и выполните его с помощью команды:
В результате Вы увидите нечто похожее:
По сути, это тот же код, что и у Адриана, за исключением переворачивания изображения вот такой строкой кода:
frame = imutils.rotate(frame, angle=180)
Также обратите внимание, что использовались границы маски, которые мы получили на предыдущем шаге.
Тестирование GPIO
Теперь, когда мы познакомились с основами OpenCV, давайте установим светодиод на наш RPi и начнем взаимодействовать с нашими GPIO. Этот светодиод мы будем использовать для индикации, когда в кадре с камеры будут обнаружен объект нужного цвета.
Схема подключения светодиода очень проста:

Катод светодиода подключаем к GPIO 21, а анод к GND через резистор 220Ом.
Давайте проверим наш светодиод в нашей виртуальной среде cv Python.
Помните, что возможно, что RPi.GPIO не установлен в вашей виртуальной среде cv Python. Если нужно установить (не забудьт, что для cv Python в консоли вначале строки отображается «cv»), выполните следующую команду:
pip install RPi.GPIO
Для управления светодиодом будет использоваться скрипт GPIO_LED_test.py :
import sys import time import RPi.GPIO as GPIO # initialize GPIO and variables redLed = int(sys.argv[1]) freq = int(sys.argv[2]) GPIO.setmode(GPIO.BCM) GPIO.setup(redLed, GPIO.OUT) GPIO.setwarnings(False) print("\n [INFO] Blinking LED (5 times) connected at GPIO at every second(s)".format(redLed, freq)) for i in range(5): GPIO.output(redLed, GPIO.LOW) time.sleep(freq) GPIO.output(redLed, GPIO.HIGH) time.sleep(freq) # do a bit of cleanup print("\n [INFO] Exiting Program and cleanup stuff \n") GPIO.cleanup()
Этот скрипт получает в качестве аргумента номер GPIO и частоту, с которой светодиод должен мигать. Светодиод будет мигать 5 раз, после чего программа завершиться. Обратите внимание, что перед завершением мы освободим GPIO.
python LED_simple_test.py 21 1

Теперь сделаем что бы при обнаружении объекта загорался светодиод. «Создаём» в скрипте светодиод:
import RPi.GPIO as GPIO redLed = 21 GPIO.setmode(GPIO.BCM) GPIO.setwarnings(False) GPIO.setup(redLed, GPIO.OUT)
Инициализируем (делаем изначально выключенным):
GPIO.output(redLed, GPIO.LOW) ledOn = False
Теперь внутри цикла, где отрисовывается круг, когда объект найден, включаем светодиод:
GPIO.output(redLed, GPIO.HIGH) ledOn = True
Полный код получившегося скрипта можно скачать по ссылке: object_detection_LED.py .
Здесь результат. Обратите внимание, что светодиод (левый нижний угол) загорается при каждом обнаружении объекта:
Поэкспериментируем с объектами разного цвета и формы:
На данном этапе используется только светодиод, теперь задействуем механизм поворота/наклона, чтобы поворачивать камеру в сторону обнаруженного объекта.

Если у Вас ещё не собран или не настроен механизм поворота/наклона, сделайте это как описано в прошлых проектах (см. ссылки в самом начале).
Для теста работоспособности в cv Python запустим скрипт angleServoCtrl.py :
python angleServoCtrl.py 17 45
Приведенная выше команда установит сервопривод, подключенный к GPIO 17 под углом 45 градусов.
Определение координат объекта
Чтобы в кадре объект находился примерно по центру, нам при его обнаружении нужно знать его координаты.
За основу возьмем скрипт «object_detect_LED», использованный ранее, и изменим его, чтобы вывести координаты найденного объекта. В итоге получится такой скрипт objectDetectCoord.py .
В той части где, где происходило обнаружение объекта и отрисовка вокруг него круга с красной точкой внутри, добавлен вызов функции, которая выводит координаты объекта:
if radius > 10: # draw the circle and centroid on the frame, # then update the list of tracked points cv2.circle(frame, (int(x), int(y)), int(radius), (0, 255, 255), 2) cv2.circle(frame, center, 5, (0, 0, 255), -1) # print center of circle coordinates mapObjectPosition(int(x), int(y)) # if the led is not already on, turn the LED on if not ledOn: GPIO.output(redLed, GPIO.HIGH) ledOn = True
Функция вывода координат:
def mapObjectPosition (x, y): print ("[INFO] Object Center coordenates at X0 = and Y0 = ".format(x, y))
При выполнении скрипта, в терминале будут выводиться координаты центра найденного объекта:

Теперь эти координаты мы будем использовать для управления сервоприводами.

Давайте будем считать, что наш объект находится в центре, если координаты найденного центра объекта находятся в диапазонах:
Когда полученные координаты будут выходить за пределы этого диапазона, мы будем соответствующим образом управлять механизмом поворота/наклона, чтобы компенсировать это отклонение. Для этого добавим функцию «mapServoPosition (x, y)»:
def mapServoPosition (x, y): global panAngle global tiltAngle if (x 220): panAngle += 10 if panAngle > 140: panAngle = 140 positionServo (panServo, panAngle) if (x > 280): panAngle -= 10 if panAngle 40: panAngle = 40 positionServo (panServo, panAngle) if (y 160): tiltAngle += 10 if tiltAngle > 140: tiltAngle = 140 positionServo (tiltServo, tiltAngle) if (y > 210): tiltAngle -= 10 if tiltAngle 40: tiltAngle = 40 positionServo (tiltServo, tiltAngle)
Обратите внимание, что «x» и «y», используемые в качестве параметров в этой функции, это координаты центра найденного объекта. На основе этих координат определяем какой сервопривод и на какой угол нужно установить, затем вызываем функцию «positionServo (panServo, panAngle)».
Например, предположим, что текущий угол наклона примерно равен 120 градусам, а y=50. Это означает, что объект где-то в верхней части изображения. Чтобы это скомпенсировать, нам нужно уменьшить угол наклона (допустим, до 100 градусов), чтобы центр объекта оказался в центре изображения с камеры. Для наглядности:

Обратите внимание, что изображение с камеры не зеркальное. Это означает, что, если Вы провернёте камеру влево, то объект на изображении переместиться вправо.
Функцию «positionServo(servo, angle)» можно реализовать так:
def positionServo (servo, angle): os.system("python angleServoCtrl.py " + str(servo) + " " + str(angle)) print("[INFO] Positioning servo at GPIO to degrees\n".format(servo, angle))
Обратите внимание, что скрипт angleServoCtrl.py должен находиться в том же каталоге, что и objectDetectTrack.py. Полный код можно скачать с моего GitHub: objectDetectTrack.py
Ниже приведен пример работы нашего проекта:
Все файлы проекта Вы можете скачать из моего репозитория на GitHub: OpenCV-Object-Face-Tracking . В этом репозитории некоторые файлы от следующего проекта, над которым работаю:
Автор: Marcelo Rovai
Перевод и адаптация: RobotoTehnika.ru