Текстовые константы и шаблоны, модуль string
Многие функции, ранее реализованные в модуле string , были перенесены в методы объектов str . Модуль string сохраняет несколько полезных констант и классов для работы с объектами str .
Пользовательское форматирование строки.
Класс string.Formatter в модуле string позволяет создавать и настраивать собственное поведение форматирования строк, используя ту же реализацию, что и встроенный метод str.format() .
В большинстве случаев встроенный метод str.format() класса str представляет собой более удобный интерфейс для функций форматирования переменных, но класс Formatter модуля string предоставляется способ создания подклассов для случаев, когда требуются изменения в способе форматирования.
Шаблонные строки.
Шаблоны строк предназначены в качестве альтернативы встроенному синтаксису замены переменных при форматировании строк. При интерполяции строки по шаблону string.Template переменные идентифицируются с помощью префикса $ , например, $var. В качестве альтернативы, если необходимо выделить их из окружающего текста, они также могут быть обернуты фигурными скобками, например $.
import string values = 'one': 'Привет', 'two': 'коп'> t = string.Template(""" Просто переменная: $one Экранируем префикс: $$ Переменная в тексте: квадро$ тер. """) print(t.substitute(values)) # Просто переменная: Привет # Экранируем знак доллара: $ # Переменная в тексте: квадрокоптер.
Ключевым отличием шаблонов от строковых подстановок (интерполяции) и форматирования с помощью метода format() является то, что тип аргументов не принимается во внимание. Значения преобразуются в строки, а строки вставляются в результат. В шаблонах недоступны параметры форматирования переменных. Например, невозможно контролировать количество цифр, используемых для представления значения с плавающей запятой.
Преимуществом является то, что использование метода safe_substitute() позволяет избежать исключений, если не все значения, необходимые шаблону, предоставляются в качестве аргументов.
import string values = 'var': 'foo'> t = string.Template("$var is here but $missing is not provided") try: print('substitute():', t.substitute(values)) except KeyError as err: print('ERROR:', str(err)) print('safe_substitute():', t.safe_substitute(values)) # ERROR: 'missing' # safe_substitute(): foo is here but $missing is not provided
Так как в словаре values отсутствует значение для переменной шаблона $missing , то вызывается исключение KeyError при использовании метода шаблона substitute(). Метод safe_substitute() , вместо того, чтобы вызвать ошибку ловит ее и оставляет выражение переменной в тексте.
Расширенное использование шаблонов.
Синтаксис по умолчанию для string.Template можно изменить, заменив их шаблонами на основе регулярных выражений, которые будут использоваться для поиска имен переменных в теле шаблона. Простой способ сделать это-изменить разделитель delimiter и атрибут класса idpattern .
import string class MyTemplate(string.Template): delimiter = '%' idpattern = '[a-z]+_[a-z]+' template_text = ''' Delimiter : %% Replaced : %with_underscore Ignored : %notunderscored ''' d = 'with_underscore': 'replaced', 'notunderscored': 'not replaced'> t = MyTemplate(template_text) print(t.safe_substitute(d)) # Delimiter : % # Replaced : replaced # Ignored : %notunderscored
В примере правила подстановки изменены таким образом, что разделителем является % вместо $ , а имена переменных должны содержать символ подчеркивания. Из примера видно, что шаблон %notunderscored — без подчеркивания ничем не заменяется.
Для еще более сложных изменений можно переопределить атрибут pattern и задать совершенно новое регулярное выражение. Атрибут pattern должен содержать четыре именованные группы: escaped — для захвата экранированного разделителя, именованную переменную named , фигурную версию имени переменной braced и недопустимые шаблоны разделителя invalid . (Подробнее смотрите описание класса string.Template(template) )
Стандартный атрибут pattern можно получить следующим способом:
import string t = string.Template('$var') print(t.pattern.pattern) # \$(?: # (?P\$) | # (?P[_a-z][_a-z0-9]*) | # <(?P[_a-z][_a-z0-9]*)> | # (?P) # )
Определим новый шаблон для использования > в качестве синтаксиса переменной.
import re import string # Переопределяем delimiter и pattern class NewTemplate(string.Template): delimiter = ' pattern = r''' \ <\<(?: (?P\ <\<) | (?P[_a-z][_a-z0-9]*)\>\> | (?P[_a-z][_a-z0-9]*)\>\> | (?P) ) ''' t = NewTemplate('''Привет >!''') print(t.safe_substitute(var='Мир')) # Привет Мир!
- КРАТКИЙ ОБЗОР МАТЕРИАЛА.
- Строковые константы модуля string
- Метод string.capwords() модуля string
- Класс Formatter() модуля string
- Класс Template() модуля string
- Создание отчетов с использованием string.Template
7. Строки
К этому момент мы уже встречали пять типов данных: int , float , bool , NoneType и str . Тип str — строка — качественно отличается от четырех других тем, что состоит из меньших элементов — символов.
Типы, включающие меньшие элементы, называются составными типами данных. В разных ситуациях можно либо обращаться с составным типом данных как с чем-то цельным, либо работать с его отдельными частями. Эта двоякость полезна.
Оператор [] выбирает единственный символ из строки:
>>> fruit = "banana" >>> letter = fruit[1] >>> print letter
Выражение fruit[1] выбирает символ номер 1 из строки fruit . Результат присваивается переменной letter . Отобразив letter , вы, вероятно, удивитесь:
Ведь первая буква в строке "banana" не a ! Но программисты часто ведут счет, начиная с 0. Буква номер 0 в строке "banana" — буква b . Буква номер 1 — a , номер 2 — n , и так далее.
Если вам нужна буква номер 0, просто поместите 0, или любое выражение, дающее 0, в квадратные скобки:
>>> letter = fruit[0] >>> print letter b
Выражение в скобках называется индекс. Индекс указывает на элемент упорядоченного набора, в данном случае, набора символов строки. Индекс может быть произвольным целочисленным выражением.
7.2. Длина
Функция len (англ.: длина) возвращает количество символов в строке:
>>> fruit = "banana" >>> len(fruit) 6
Возможно, для получения последнего символа в строке вы захотите сделать так:
length = len(fruit) last = fruit[length] # Ошибка!
Это не работает! Вы получите ошибку выполнения IndexError: string index out of range . Причина в том, что в строке "banana" нет символа с индексом 6. Так как мы начинаем счет с 0, шесть символов пронумерованы от 0 до 5. Для того, чтобы получить последний символ, нужно из length вычесть 1:
length = len(fruit) last = fruit[length-1]
Кроме того, можно использовать отрицательные индексы, которые позволяют вести счет от конца строки. Выражение fruit[-1] дает последний символ строки, fruit[-2] дает второй символ от конца строки, и так далее.
7.3. Обход и цикл for 
Часто программе требуется обрабатывать строку по одному символу за раз. Начав с начала строки, программа выбирает очередной символ и что-то с ним делает, и так до тех пор, пока строка не закончится. Такой прием обработки называется обходом. Вот как можно запрограммировать обход с помощью предложения while :
index = 0 while index len(fruit): letter = fruit[index] print letter index += 1
Этот цикл обходит строку и выводит каждую букву в отдельной строке. Условие цикла здесь index < len(fruit) , так что, когда index становится равным длине строки, условие становится ложным и тело цикла больше не выполняется. Последний обработанный символ имеет индекс len(fruit)-1 , и является последним символом в строке.
Обход элементов последовательности настолько часто используется, что Python предлагает для этого другой, более простой синтаксис — цикл for :
for char in fruit: print char
В каждой итерации переменной char присваивается очередной символ строки. Цикл продолжается до тех пор, пока строка не закончится.
Следующий пример показывает, как с помощью конкатенации и цикла for сгенерировать последовательность в алфавитном порядке. Например, Роберт МакКлоски в своей книге дал такие имена утятам: Jack, Kack, Lack, Mack, Nack, Ouack, Pack и Quack. Следующий цикл выводит имена утят в алфавитном порядке:
prefixes = "JKLMNOPQ" suffix = "ack" for letter in prefixes: print letter + suffix
Эта программа выводит:
Jack Kack Lack Mack Nack Oack Pack Qack
Конечно, это не совсем то, что нужно, поскольку Ouack и Quack написаны неправильно. Вам предстоит исправить это в одном из упражнений к этой главе.
7.4. Срезы строк
Подстроку строки будем называть срезом. Получение среза строки похоже на получение одного символа:
>>> s = "Peter, Paul, and Mary" >>> print s[0:5] Peter >>> print s[7:11] Paul >>> print s[17:21] Mary
Оператор [n:m] возвращает часть строки, начиная с символа с индексом n по символ с индексом m , включая первый, но исключая последний. Это поведение может показаться странным на первый взгляд; но представьте, что индексы указывают на места между символами, как на следующей диаграмме:
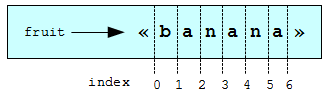
Если в операторе среза опустить первый индекс (перед двоеточием), то началом среза будет начало строки (индекс 0). Если опустить второй индекс, то срез включит все символы до конца строки. Таким образом:
>>> fruit = "banana" >>> fruit[:3] 'ban' >>> fruit[3:] 'ana'
А как вы думаете, что дает срез s[:] ?
7.5. Сравнение строк
Операторы сравнения работают со строками. Вот как можно узнать, равны ли две строки:
if word == "banana": print "Yes, we have no bananas!"
С помощью других операторов сравнения можно располагать слова в алфавитном порядке:
if word "banana": print "Your word, " + word + ", comes before banana." elif word > "banana": print "Your word, " + word + ", comes after banana." else: print "Yes, we have no bananas!"
Знайте, однако, что Python обращается с большими и маленькими буквами не так, как это делают люди. Все большие буквы (буквы верхнего регистра) предшествуют всем маленьким буквам (буквам нижнего регистра). В результате:
Your word, Zebra, comes before banana.
Стандартное решение этой задачи — преобразовать строки к единому виду, например, в нижний регистр, и только потом сравнивать. (А вот заставить программу понимать, что зебры — не фрукты, является более сложной задачей.)
7.6. Строки неизменяемы
Возможно, вы захотите изменить символ в строке, используя оператор [] в левой части предложения присваивания. Например:
greeting = "Hello, world!" greeting[0] = 'J' # Ошибка! print greeting
Вместо вывода Jello, world! этот код выдаст сообщение об ошибке выполнения TypeError: 'str' object doesn't support item assignment .
Строки в Python неизменяемы. Это значит, вы не можете изменить существующую строку. Если вам необходимо изменить существующую строку, то придется создать новую строку на основе имеющейся:
greeting = "Hello, world!" newGreeting = 'J' + greeting[1:] print newGreeting
Здесь конкатенируются первая буква и срез строки greeting . Это никак не влияет на первоначальную строку.
7.7. Оператор in 
Оператор in проверяет, является ли одна строка частью другой строки (ее подстрокой):
>>> 'p' in 'apple' True >>> 'i' in 'apple' False >>> 'ap' in 'apple' True >>> 'pa' in 'apple' False
Заметьте, что строка является подстрокой самой себя:
>>> 'a' in 'a' True >>> 'apple' in 'apple' True
Комбинируя оператор in с конкатенацией строк, напишем функцию, удаляющую из строки все гласные:
def remove_vowels(s): vowels = "aeiouAEIOU" s_without_vowels = "" for letter in s: if letter not in vowels: s_without_vowels += letter return s_without_vowels
Напишите доктесты для этой функции, чтобы убедиться, что она работает как задумано.
7.8. Функция find 
Что делает следующая функция?
def find(strng, ch): index = 0 while index len(strng): if strng[index] == ch: return index index += 1 return -1
В некотором смысле, find является противоположностью оператора [] . Вместо того, чтобы по индексу извлекать символ, эта функция по символу находит индекс, под которым этот символ присутствует в строке. Если символ не найден, функция возвращает -1 .
Это первый случай, когда мы видим предложение return в теле цикла. Если strng[index] == ch , функция немедленно возвращает значение и завершается, прекращая выполнение цикла.
Если искомого символа в строке нет, то цикл завершится, как обычно, после чего программа завершится, возвращая -1 .
Этот прием иногда называют эврика-обходом. Ведь как только мы нашли то, что ищем, мы можем закричать “Эврика!”, и больше не искать.
7.9. Счетчик в цикле
Следующая программа подсчитывает, сколько раз в строке встречается буква a . Это еще один пример использования приема счетчик, с которым мы познакомились в главе 6:
fruit = "banana" count = 0 for char in fruit: if char == 'a': count += 1 print count
7.10. Необязательные параметры
Для того, чтобы найти в строке второе или третье вхождение некоторого символа, можно изменить функцию find , добавив третий параметр для указания позиции начала поиска:
def find2(strng, ch, start): index = start while index len(strng): if strng[index] == ch: return index index += 1 return -1
Вызов find2('banana', 'a', 2) теперь возвращает 3 , позицию первого вхождения ‘a’ в строке ‘banana’ после позиции 2. А что вернет вызов find2('banana', 'n', 3) ? Если вы ответили 4, значит, вы поняли, как работает find2 .
Но можно пойти дальше, и объединить find и find2 с помощью необязательного параметра:
def find(strng, ch, start=0): index = start while index len(strng): if strng[index] == ch: return index index += 1 return -1
Вызов find('banana', 'a', 2) теперь ведет себя так же, как find2 , и, в то же время, при вызове find('banana', 'a') параметр start получит значение по умолчанию 0 .
Добавив еще один необязательный параметр к find , получим возможность искать как в прямом направлении, так и в обратном:
def find(strng, ch, start=0, step=1): index = start while 0 index len(strng): if strng[index] == ch: return index index += step return -1
Передав значение -1 для step , мы заставим функцию искать от конца к началу. Обратите внимание, что в условии цикла теперь нужно поверять достижение index как нижней, так и верхней границы строки.
7.11. Модуль string 
Модуль string содержит полезные функции для работы со строками. Как обычно, для того, чтобы использовать модуль, мы должны его импортировать:
>>> import string
Чтобы посмотреть, что содержится в модуле, воспользуйтесь функцией dir с именем модуля в качестве аргумента.
>>> dir(string)
Вы получите список элементов модуля string :
['Template', '_TemplateMetaclass', '__builtins__', '__doc__', '__file__', '__name__', '_float', '_idmap', '_idmapL', '_int', '_long', '_multimap', '_re', 'ascii_letters', 'ascii_lowercase', 'ascii_uppercase', 'atof', 'atof_error', 'atoi', 'atoi_error', 'atol', 'atol_error', 'capitalize', 'capwords', 'center', 'count', 'digits', 'expandtabs', 'find', 'hexdigits', 'index', 'index_error', 'join', 'joinfields', 'letters', 'ljust', 'lower', 'lowercase', 'lstrip', 'maketrans', 'octdigits', 'printable', 'punctuation', 'replace', 'rfind', 'rindex', 'rjust', 'rsplit', 'rstrip', 'split', 'splitfields', 'strip', 'swapcase', 'translate', 'upper', 'uppercase', 'whitespace', 'zfill']
Чтобы побольше узнать о любом из элементов списка, можно воспользоваться функцией type . Укажите имя модуля и имя элемента, используя точечную нотацию.
>>> type(string.digits) >>> type(string.find)
Поскольку string.digits (англ.: цифры) является строкой, мы можем вывести ее и посмотреть, что она содержит:
>>> print string.digits 0123456789
Как и следовало ожидать, она содержит все десятичные цифры.
Функция string.find делает, в основном, то же самое, что и функция, которую мы написали. Чтобы узнать о ней больше, мы можем вывести ее документирующую строку __doc__ , которая содержит документацию по этой функции:
>>> print string.find.__doc__ find(s, sub [,start [,end]]) -> in Return the lowest index in s where substring sub is found, such that sub is contained within s[start,end]. Optional arguments start and end are interpreted as in slice notation. Return -1 on failure.
Параметры, указанные в документации в квадратных скобках, являются необязательными. Заметьте, что функцию string.find можно использовать почти так же, как нашу собственную find :
>>> fruit = "banana" >>> index = string.find(fruit, "a") >>> print index 1
Этот пример демонстрирует одно из преимуществ модулей: они помогают избежать конфликта между именами встроенных функций и функций, определенных пользователем. Используя точечную нотацию, мы можем указать, какая именно функция find нам нужна.
На самом деле, string.find является функцией более общего применения, чем наша. Она может искать подстроки, а не только отдельные символы:
>>> string.find("banana", "na") 2
Как и наша функция, она принимает дополнительный аргумент, задающий индекс для начала поиска:
>>> string.find("banana", "na", 3) 4
Однако, в отличие от нашей функции, ее второй необязательный параметр задает индекс для завершения поиска:
>>> string.find("bob", "b", 1, 2) -1
В этом примере поиск не удался, поскольку буква b не встречается между индексами 1 и 2 (последний исключается).
7.12. Классификация символов
Часто бывает нужно исследовать символ и выяснить, например, к какому регистру он принадлежит, является он буквой или цифрой. Модуль string предоставляет несколько констант, которые полезны для этих целей. С одной из них, string.digits , мы уже встречались.
Строка string.lowercase содержит все латинские символы, которые система относит к нижнему регистру. Аналогично, string.uppercase содержит все латинские символы верхнего регистра. Выполните следующее и посмотрите, что вы получите:
print string.lowercase print string.uppercase print string.digits
С помощью этих констант и функции find можно классифицировать символы. Например, если find(lowercase, ch) возвращает число, отличное от -1 , значит, ch является символом нижнего регистра:
def is_lower(ch): return string.find(string.lowercase, ch) != -1
Как вариант, можно воспользоваться оператором in :
def is_lower(ch): return ch in string.lowercase
Той же цели можно достичь с помощью операторов сравнения:
def is_lower(ch): return 'a' ch 'z'
Если ch больше или равен a и меньше или равен z, то он является символом нижнего регистра.
Еще одна константа, определенная в модуле string , может удивить вас, если вывести ее на экран:
>>> print string.whitespace
Пробельные символы перемещают курсор, ничего не отображая. Они создают пустое пространство между видимыми символами. Константа string.whitespace содержит все пробельные символы, включая пробел, табуляцию ( \t ) и перевод строки ( \n ).
В модуле string содержится много других полезных функций. Но эта книга — не справочник. Если вам нужно больше узнать о возможностях модулей Python, обратитесь к справочнику Python Library Reference. Так же, как и другая документация, справочник по библиотеке Python доступен на сайте Python http://www.python.org.
7.13. Форматирование строк
Наиболее выразительный и мощный способ форматирования строк в Python — использование оператора форматирования строки % вместе с операндами для форматирования. Чтобы посмотреть, как это работает, начнем с нескольких примеров:
>>> "His name is %s." % "Arthur" 'His name is Arthur.' >>> name = "Alice" >>> age = 10 >>> "I am %s and I am %d years old." % (name, age) 'I am Alice and I am 10 years old.' >>> n1 = 4 >>> n2 = 5 >>> "2**10 = %d and %d * %d = %f" % (2**10, n1, n2, n1 * n2) '2**10 = 1024 and 4 * 5 = 20.000000' >>>
Операция форматирования строки записывается так:
Левый операнд формат — строка, содержащая, помимо прочего, спецификации преобразования, которые начинаются с символа % . Справа от оператора форматирования % записывается в скобках последовательность значений, разделенных запятыми. Каждое значение в этой последовательности соответствует спецификации преобразования в форматируемой строке слева от оператора % . Скобки необязательны, если последовательность включает только одно значение.
В первом из приведенных выше примеров только одна спецификация преобразования, %s , обозначающая строку. Ей соответствует единственное значение "Arthur" , не заключенное в скобки.
Во втором примере имеются переменные name со строковым значением "Alice" и age с целочисленным значением 10 . Они соответствуют двум спецификациям преобразования, %s и %d . Во второй спецификации d обозначает десятичное целое число.
В третьем примере переменные n1 и n2 имеют целочисленные значения 4 и 5 , соответственно. В форматируемой строке имеются четыре спецификации преобразования: три %d и одна %f . Спецификация преобразования %f показывает, что соответствующее значение должно быть представлено как число с плавающей точкой. Четыре значения, соответствующие четырем спецификациям преобразования, следующие: 2**10 , n1 , n2 , and n1 * n2 .
В этой книге нам будет достаточно форматных преобразований s , d и f . Полный их список можно найти в справочнике по библиотеке Python в разделе String Formatting Operations.
Следующий пример демонстрирует реальную пользу от форматирования строк:
i = 1 print "i\ti**2\ti**3\ti**5\ti**10\ti**20" while i 10: print i, '\t', i**2, '\t', i**3, '\t', i**5, '\t', i**10, '\t', i**20 i += 1
Программа печатает таблицу степеней чисел от 1 до 10. В этом варианте программы для выравнивания столбцов значений используется символ табуляции ( \t ). Это перестает работать, как только число в столбце становится достаточно длинным и достигает следующей позиции табуляции:
i i**2 i**3 i**5 i**10 i**20 1 1 1 1 1 1 2 4 8 32 1024 1048576 3 9 27 243 59049 3486784401 4 16 64 1024 1048576 1099511627776 5 25 125 3125 9765625 95367431640625 6 36 216 7776 60466176 3656158440062976 7 49 343 16807 282475249 79792266297612001 8 64 512 32768 1073741824 1152921504606846976 9 81 729 59049 3486784401 12157665459056928801 10 100 1000 100000 10000000000 100000000000000000000
Также обратите внимание на то, что первый столбец получается намного шире, чем требуется. Лучшим решением в данном случае было бы независимо устанавливать ширину каждого столбца. Форматирование строк предоставляет такую возможность:
i = 1 print "%-4s%-5s%-6s%-8s%-13s%-15s" % \ ('i', 'i**2', 'i**3', 'i**5', 'i**10', 'i**20') while i 10: print "%-4d%-5d%-6d%-8d%-13d%-15d" % (i, i**2, i**3, i**5, i**10, i**20) i += 1
Эта версия программы выводит следующее:
i i**2 i**3 i**5 i**10 i**20 1 1 1 1 1 1 2 4 8 32 1024 1048576 3 9 27 243 59049 3486784401 4 16 64 1024 1048576 1099511627776 5 25 125 3125 9765625 95367431640625 6 36 216 7776 60466176 3656158440062976 7 49 343 16807 282475249 79792266297612001 8 64 512 32768 1073741824 1152921504606846976 9 81 729 59049 3486784401 12157665459056928801 10 100 1000 100000 10000000000 100000000000000000000
Знак - после % в спецификации преобразования обозначает выравнивание по левому краю, а число обозначает минимальную длину. Так, %-13d обозначает десятичное число длиной не менее 13 символов, выровненное по левому краю.
7.14. Глоссарий
документирующая строка Строковое значение, расположенное сразу после заголовка функции или модуля (и, как мы увидим дальше, после заголовка класса или метода). Документирующие строки, или докстроки, предоставляют удобный способ документировать код. Докстроки также используются модулем doctest для автоматического тестирования. значение по умолчанию Значение, которое получит необязательный параметр, если при вызове функции для него не передан аргумент. индекс Переменная или значение, используемое для доступа к элементу некоторого упорядоченного набора, например, к символу в строке. неизменяемый тип данных Неизменяемым является составной тип данных, элементам которого нельзя присвоить новые значения. необязательный параметр Параметр, для которого вы заголовке функции указано значение по умолчанию. Параметр получит значение по умолчанию, если при вызове функции не будет передан аргумент для него. обход Перебор всех элементов некоторого множества, с выполнением над каждым некоторой операции. пробельные символы Символы, которые перемещают курсор, не выводя видимые символы. Строка string.whitespace содержит все пробельные символы. составной тип данных: Тип данных, включающий компоненты, которые сами относятся к некоторому типу данных и могут использоваться как самостоятельные значения. срез Часть строки (подстрока), заданная диапазоном индексов. Вообще, в Python можно получить подпоследовательность любой последовательности (не только строки) с помощью оператора среза последовательность[start:stop] . точечная нотация Использование оператора . (точка), например, для доступа к функции внутри модуля.
7.15. Упражнения
- Измените следующий код:
prefixes = "JKLMNOPQ" suffix = "ack" for letter in prefixes: print letter + suffix
fruit = "banana" count = 0 for char in fruit: if char == 'a': count += 1 print count
def reverse(s): """ >>> reverse('happy') 'yppah' >>> reverse('Python') 'nohtyP' >>> reverse("") '' >>> reverse("P") 'P' """ if __name__ == '__main__': import doctest doctest.testmod()
def mirror(s): """ >>> mirror("good") 'gooddoog' >>> mirror("yes") 'yessey' >>> mirror('Python') 'PythonnohtyP' >>> mirror("") '' >>> mirror("a") 'aa' """
def remove_letter(letter, strng): """ >>> remove_letter('a', 'apple') 'pple' >>> remove_letter('a', 'banana') 'bnn' >>> remove_letter('z', 'banana') 'banana' >>> remove_letter('i', 'Mississippi') 'Msssspp' """
def is_palindrome(s): """ >>> is_palindrome('abba') True >>> is_palindrome('abab') False >>> is_palindrome('tenet') True >>> is_palindrome('banana') False >>> is_palindrome('straw warts') True """ def count(sub, s): """ >>> count('is', 'Mississippi') 2 >>> count('an', 'banana') 2 >>> count('ana', 'banana') 2 >>> count('nana', 'banana') 1 >>> count('nanan', 'banana') 0 """ def remove(sub, s): """ >>> remove('an', 'banana') 'bana' >>> remove('cyc', 'bicycle') 'bile' >>> remove('iss', 'Mississippi') 'Missippi' >>> remove('egg', 'bicycle') 'bicycle' """ def remove_all(sub, s): """ >>> remove_all('an', 'banana') 'ba' >>> remove_all('cyc', 'bicycle') 'bile' >>> remove_all('iss', 'Mississippi') 'Mippi' >>> remove_all('eggs', 'bicycle') 'bicycle' """
- "%s %d %f" % (5, 5, 5)
- "%-.2f" % 3
- "%-10.2f%-10.2f" % (7, 1.0/2)
- print " $%5.2f\n $%5.2f\n $%5.2f" % (3, 4.5, 11.2)
- "%s %s %s %s" % ('this', 'that', 'something')
- "%s %s %s" % ('yes', 'no', 'up', 'down')
- "%d %f %f" % (3, 3, 'three')
Просмотр
© Copyright 2009, 2012, Джеффри Элкнер, Аллен Б. Дауни, Крис Мейерс, Андрей Трофимов. При создании использован Sphinx 1.1.3.
Модуль string
До того как у строк появились методы, для операций над строками применялся модуль string. Приведенный пример демонстрирует, как вместо функции из string использовать метод (кстати, последнее более эффективно):
В версии Python 3.0 функции, которые доступны через методы, более не будут дублироваться в модуле string.
В Python 2.4 появилась альтернатива использованию операции форматирования: класс Template. Пример:
>>> tpl = string.Template("$a + $b = $")
>>> del c # удаляется имя c
>>> print tpl.substitute(vars(), c=a+b)
Traceback (most recent call last):
File "/home/rnd/tmp/Python–2.4b2/Lib/string.py", line 172, in substitute
return self.pattern.sub(convert, self.template)
File "/home/rnd/tmp/Python–2.4b2/Lib/string.py", line 162, in convert
Объект–шаблон имеет два основных метода: substitute() и safe_substitute(). Значения для подстановки в шаблон берутся из словаря (vars() содержит словарь со значениями переменных) или из именованных фактических параметров. Если есть неоднозначность в задании ключа, можно использовать фигурные скобки при написании ключа в шаблоне.
Основы
В Python ключевое слово import применяется для того, чтобы сделать код в одном модуле доступным для работы в другом. Импорт в Python важен для эффективного структурирования кода. Правильное применение импорта повысит вашу продуктивность: вы сможете повторно использовать код и при этом продолжать осуществлять поддержку своих проектов.
В статье представлен подробный обзор инструкции import в Python и того, как она работает. Здесь мощная система импорта. Вам предстоит узнать, как эту мощь задействовать, а также изучить ряд понятий, лежащих в основе системы импорта в Python. Их изложение в статье построено главным образом на примерах (в помощь вам будут несколько примеров кода).
В этой статье вы узнаете, как:
- Работать с модулями, пакетами и пакетами пространств имён.
- Импортировать ресурсы и файлы данных внутри ваших пакетов.
- Динамически импортировать модули во время выполнения.
- Настраивать систему импорта в Python.
На протяжении всей статьи даются примеры: вы сможете поэкспериментировать с тем, как организован импорт в Python, чтобы работать наиболее эффективно. Хотя в статье показан весь код, имеется также возможность скачать его по ссылке ниже:
Базовый импорт Python
Код в Python организован в виде модулей и пакетов. В этой части статьи мы объясним, чем они отличаются друг от друга и как с ними можно работать.
Чуть дальше вы узнаете о нескольких продвинутых и менее известных примерах применения системы импорта в Python. Но начнём с основ — импортирования модулей и пакетов.
Модули
В Python.org glossary даётся следующее определение модуля:
Объект, который служит организационной единицей кода в Python. Модули имеют пространство имён, в котором содержатся произвольные объекты Python. Модули загружаются в Python посредством импортирования. (Источник)
На практике модуль соответствует, как правило, одному файлу с расширением .py . В этом файле содержится код на Python.
Модули обладают сверхспособностью импортироваться и повторно использоваться в другом коде. Рассмотрим следующий пример:
import math
math.pi
В первой строке import math вы импортируете код в модуль math и делаете его доступным для использования. Во второй строке вы получаете доступ к переменной в модуле math . Модуль math является частью стандартной библиотеки Python, поэтому он всегда доступен для импорта, когда вы работаете с Python.
Обратите внимание, что пишется не просто pi , а math.pi .
math — это не только модуль, а ещё и пространство имён, в котором содержатся все атрибуты этого модуля. Пространства имён важны для читаемости и структурированности кода.
Содержимое пространства имён можно посмотреть с помощью dir() :
>>> import math
>>> dir()
['__annotations__', '__builtins__', . 'math']>>> dir(math)
['__doc__', . 'nan', 'pi', 'pow', . ]
Если не указывать при этом никаких аргументов, т.е. напечатать просто dir() , то можно увидеть, что находится в глобальном пространстве имён. Посмотреть содержимое пространства имён math можно, указав его в качестве аргумента вот так: dir(math) .
Вы уже видели самый простой способ импортирования. Есть и другие, которые позволяют импортировать отдельные части модуля и переименовывать его в процессе импортирования.
Вот код, который импортирует из модуля math только переменную pi :
>>> from math import pi
>>> pi
3.141592653589793>>> math.pi
NameError: name 'math' is not defined
Обратите внимание, что pi помещается в глобальное пространство имён, а не в пространство имён math .
А вот как в процессе импортирования переименовываются модули и атрибуты:
>>> import math as m
>>> m.pi
3.141592653589793>>> from math import pi as PI
>>> PI
3.141592653589793
Пакеты
Пакет представляет собой следующий после модуля уровень в организационной иерархии кода. В Python.org glossary даётся следующее определение пакета:
Это модуль Python, который может содержать подмодули или (рекурсивно) подпакеты. Строго говоря, пакет — это модуль Python с атрибутом __path__ . (Источник.)
То есть пакет — это тоже модуль. Пользователю обычно не приходится задумываться о том, что у него импортируется: модуль или пакет.
На практике пакет — это, как правило, каталог файлов, внутри которого находятся файлы Python и другие каталоги. Чтобы создать пакет Python самостоятельно, создайте каталог, а внутри него — файл с именем __init__.py . В __init__.py файле находится содержимое этого пакета-модуля. И он может быть пустым.
Обратите внимание: каталоги без файла __init__.py Python всё равно считает пакетами. Но это уже будут не обычные пакеты, а то, что можно назвать пакетами пространства имён. Подробнее о них чуть дальше в статье.
Вообще подмодули и подпакеты нельзя импортировать вместе с пакетом. Это можно сделать с помощью __init__.py , включив любой или все подмодули и подпакеты, если захотите. В качестве примера создадим пакет для Hello world на разных языках. Пакет будет состоять из следующих каталогов и файлов:
world/
│
├── africa/
│ ├── __init__.py
│ └── zimbabwe.py
│
├── europe/
│ ├── __init__.py
│ ├── greece.py
│ ├── norway.py
│ └── spain.py
│
└── __init__.py
Для файла каждой страны выводится соответствующее приветствие, а файлы __init__.py выборочно импортируют некоторые подпакеты и подмодули. Вот точное содержимое этих файлов:
# world/africa/__init__.py ( пустой файл )# world/africa/zimbabwe.py
print("Shona: Mhoroyi vhanu vese")
print("Ndebele: Sabona mhlaba")# world/europe/__init__.py
from . import greece
from . import norway# world/europe/greece.py
print("Greek: Γειά σας Κόσμε")# world/europe/norway.py
print("Norwegian: Hei verden")# world/europe/spain.py
print("Castellano: Hola mundo")# world/__init__.py
from . import africa
Обратите внимание: world/__init__.py импортирует только africa , а не europe ; world/africa/__init__.py ничего не импортирует; world/europe/__init__.py импортирует greece и norway , а не spain . Модуль каждой страны при импортировании выводит приветствие.
Разберёмся, как ведут себя подпакеты и подмодули в пакете world :
>>> import world
>>> world
>>> # П одпакет africa автоматически импортирован
>>> world.africa
>>> # П одпакет europe не импортирован
>>> world.europe
AttributeError: module 'world' has no attribute 'europe'
При импортировании europe модули europe.greece и europe.norway тоже импортируются. Это происходит потому, что модули этих стран выводят приветствие при импортировании:
>>> # Импортирование europe явным образом
>>> from world import europe
Greek: Γειά σας Κόσμε
Norwegian: Hei verden>>> # Подмодуль greece автоматически импортирован
>>> europe.greece
>>> # world импортируется, поэтому europe также находится в пространстве имён world
>>> world.europe.norway
>>> # Подмодуль spain не импортирован
>>> europe.spain
AttributeError: module 'world.europe' has no attribute 'spain'>>> # Импортирование spain непосредственно внутри пространства имён world
>>> import world.europe.spain
Castellano: Hola mundo>>> # Обратите внимание: spain также доступен непосредственно внутри пространства имён europe
>>> europe.spain
>>> # Импортирование norway не выполняет повторного импорта (не выводит приветствие), но добавляет
>>> # norway в глобальное пространство имён
>>> from world.europe import norway
>>> norway
Файл world/africa/__init__.py пуст. Это означает, что импортирование пакета world.africa создаёт пространство имён, но этим и ограничивается:
>>> # Да, africa импортирована, но zimbabwe — нет
>>> world.africa.zimbabwe
AttributeError: module 'world.africa' has no attribute 'zimbabwe'>>> # Импортирование zimbabwe непосредственно в глобальное пространство имён
>>> from world.africa import zimbabwe
Shona: Mhoroyi vhanu vese
Ndebele: Sabona mhlaba>>> # Подмодуль zimbabwe теперь доступен
>>> zimbabwe
>>> # Обратите внимание: до zimbabwe можно добраться и через подпакет africa
>>> world.africa.zimbabwe
Не забывайте: при импорте модуля загружается его содержимое и одновременно создаётся пространство имён с этим содержимым. Последние несколько примеров показывают, что один и тот же модуль может быть частью разных пространств имён.
Технические нюансы: пространство имён модуля реализовано в виде словаря Python и доступно в атрибуте .__dict__ :
>>> import math
>>> math.__dict__["pi"]
3.141592653589793
Но вам не придётся часто взаимодействовать с .__dict__ напрямую.
Глобальное пространство имён в Python тоже является словарём. Доступ к нему можно получить через globals() .
Импортировать подпакеты и подмодули в файле __init__.py — это обычное дело. Так они становятся более доступными для пользователей. Вот вам пример того, как это происходит в популярном пакете запросов.
Абсолютный и относительный импорт
Напомним исходный код world/__init__.py предыдущего примера:
from . import africa
Чуть ранее мы уже разбирали операторы типа from. import , такие как from math import pi . Что же означает точка ( . ) в from . import africa ?
Точка указывает на текущий пакет, а сам оператор — это пример относительного импорта. Можно прочитать этот
from . import africa
так: «из текущего пакета импортируется подпакет africa ».
Существует эквивалентный ему оператор абсолютного импорта, в котором прямо указывается название этого текущего пакета:
from world import africa
На самом деле, все импорты в world можно было бы сделать в виде таких вот абсолютных импортов с указанием названия текущего пакета.
Относительные импорты должны иметь такую from. import форму, причём обозначение места, откуда вы импортируете, должно начинаться с точки.
В руководстве по стилю PEP 8 рекомендуется в основном абсолютный импорт. Однако относительный импорт в качестве альтернативы абсолютному тоже имеет право на существование при организации иерархии пакетов.
Путь импорта в Python
А как Python находит модули и пакеты, которые импортирует? Более подробно о специфике системы импорта в Python расскажем чуть дальше в статье. А пока нам достаточно просто знать, что Python ищет модули и пакеты в своём пути импорта. Это такой список адресов, по которым выполняется поиск модулей для импорта.
Примечание: когда вы вводите import чего-то (что надо импортировать) , Python будет искать это что-то в нескольких разных местах, прежде чем переходить к поиску пути импорта.
Так, он заглянет в кэш модулей и проверит, не было ли это что-то уже импортировано, а также проведёт поиск среди встроенных модулей.
Подробнее о том, как организован импорт в Python, расскажем чуть дальше в статье.
Путь импорта в Python можно просмотреть, выведя на экран sys.path . В этом списке будет три различных типа адресов:
- Каталог текущего скрипта или текущий каталог, если скрипта нет (например, когда Python работает в интерактивном режиме).
- Содержимое переменной окружения PYTHONPATH .
- Другие каталоги, зависящие от конкретной системы.
Поиск Python, как правило, стартует в начале списка адресов и проходит по всем адресам до первого совпадения с искомым модулем. Каталог скрипта или текущий каталог всегда идёт первым в этом списке. Поэтому можно организовать каталоги так, чтобы скрипты находили ваши самодельные модули и пакеты. При этом надо внимательно следить за тем, из какого каталога вы запускаете Python.
Стоит следить и за тем, чтобы не создавались модули, которые затеняют или скрывают другие важные модули. В качестве примера предположим, что вы определяете следующий модуль math :
# math.pydef double(number):
return 2 * number
Всё пока идёт как надо:
>>> import math
>>> math.double(3.14)
6.28
Вот только модуль этот затеняет модуль math , который входит в состав стандартной библиотеки. Это приводит к тому, что наш предыдущий пример поиска значения π больше не работает:
>>> import math
>>> math.pi
Traceback (most recent call last):
File "", line 1, in
AttributeError: module 'math' has no attribute 'pi'>>> math
Вместо того, чтобы искать модуль math в стандартной библиотеке, Python теперь ищет ваш новый модуль math для pi .
Во избежание подобных проблем надо быть осторожным с названиями модулей и пакетов. Имена модулей и пакетов верхнего уровня должны быть уникальными. Если math определяется как подмодуль внутри пакета, то он не будет затенять встроенный модуль.
Структурируем импорт
Несмотря на то, что мы можем организовать импорт, используя текущий каталог, переменную окружения PYTHONPATH и даже sys.path , этот процесс часто оказывается неконтролируемым и подверженным ошибкам. Типичный пример даёт нам следующее приложение:
structure/
│
├── files.py
└── structure.py
Приложение воссоздаст данную файловую структуру с каталогами и пустыми файлами. Файл structure.py содержит основной скрипт, а files.py — это библиотечный модуль с функциями для работы с файлами. Вот что выводит приложение, запускаемое в данном случае в каталоге structure :
$ python structure.py .
Create file: /home/gahjelle/structure/001/structure.py
Create file: /home/gahjelle/structure/001/files.py
Create file: /home/gahjelle/structure/001/__pycache__/files.cpython-38.pyc
Два файла исходного кода плюс автоматически созданный файл .pyc повторно создаются внутри нового каталога с именем 001 .
Обратимся теперь к исходному коду. Основная функциональность приложения определяется в structure.py :
# structure/structure.py# Импорты стандартной библиотеки
import pathlib
import sys# Локальные импорты
import filesdef main():
# Считывание пути из командной строки
try:
root = pathlib.Path(sys.argv[1]).resolve()
except IndexError:
print("Need one argument: the root of the original file tree")
raise SystemExit() # Воссоздание файловой структуры
new_root = files.unique_path(pathlib.Path.cwd(), "")
for path in root.rglob("*"):
if path.is_file() and new_root not in path.parents:
rel_path = path.relative_to(root)
files.add_empty_file(new_root / rel_path)if __name__ == "__main__":
main()
В строках с 12 по 16 читается корневой путь из командной строки. Точкой здесь обозначается текущий каталог. Этот путь — root файловой иерархии, которую вы воссоздадите.
Вся работа происходит в строках с 19 по 23. Сначала создаётся уникальный путь new_root , который будет корневым каталогом новой файловой иерархии. Затем в цикле проходятся все пути ниже исходного root , и они воссоздаются в виде пустых файлов внутри новой файловой иерархии.
В строке 26 вызывается main() . О проверке условия if в строке 25 подробнее узнаем дальше в статье. А пока нам достаточно знать, что специальная переменная __name__ внутри скриптов имеет значение __main__ , а внутри импортируемых модулей получает имя модуля.
Обратите внимание: в строке 8 импортируются файлы . В этом библиотечном модуле содержатся две служебные функции:
# structure/files.py

def unique_path(directory, name_pattern):
"""Find a path name that does not already exist"""
counter = 0
while True:
counter += 1
path = directory / name_pattern.format(counter)
if not path.exists():
return path

def add_empty_file(path):
"""Create an empty file at the given path"""
print(f"Create file: ")
path.parent.mkdir(parents=True, exist_ok=True)
path.touch()
unique_path() работает со счётчиком для обнаружения пути, которого уже не существует. В приложении он нужен, чтобы найти уникальный подкаталог, который будет использоваться в качестве new_root вновь созданной файловой иерархии. add_empty_file() обеспечивает создание всех необходимых каталогов до того, как с помощью .touch() будет создан пустой файл.
Ещё раз взглянем на импорт файлов :
# Локальные импорты
import files
Выглядит он совершенно невинно. Однако по мере роста проекта эта строка станет источником некоторых проблем. Даже если импорт файлов происходит из проекта structure , этот импорт абсолютный: он не начинается с точки. А это означает, что файлы должны быть найдены в пути импорта, чтобы импорт состоялся.
К счастью, каталог с текущим скриптом всегда находится в пути импорта Python. Так что, пока проект не набрал обороты, импорт работает нормально. Но дальше возможны варианты.
Например, кто-то захочет импортировать скрипт в Jupyter Notebook и запускать его оттуда. Или иметь доступ к библиотеке файлов в другом проекте. Могут даже с помощью PyInstaller создавать исполняемые файлы, чтобы упростить их дальнейшее распространение. К сожалению, любой из этих сценариев может вызвать проблемы с импортом файлов.
Каким образом? Вот вам пример. Возьмём руководство по PyInstaller и создадим точку входа в приложение. Добавим дополнительный каталог за пределами каталога приложения:
structure/
│
├── structure/
│ ├── files.py
│ └── structure.py
│
└── cli.py
В этом внешнем каталоге создадим скрипт точки входа cli.py :
# cli.pyfrom structure.structure import mainif __name__ == "__main__":
main()
Этот скрипт импортирует из исходного скрипта main() и запускает его. Обратите внимание: когда импортируется structure , main() не запускается из-за проверки условия if в строке 25 внутри structure.py . То есть нужно запускать main() явным образом.
По идее, это должно быть аналогично прямому запуску приложения:
$ python cli.py structure
Traceback (most recent call last):
File "cli.py", line 1, in
from structure.structure import main
File "/home/gahjelle/structure/structure/structure.py", line 8, in
import files
ModuleNotFoundError: No module named 'files'
Почему же запуск не удался? При импорте файлов неожиданно возникает ошибка.
Проблема в том, что при запуске приложения с cli.py поменялся адрес текущего скрипта, а это, в свою очередь, меняет путь импорта. Файлы больше не находятся в пути импорта, поэтому их абсолютный импорт невозможен.
Одно из возможных решений — поменять путь импорта Python. Вот так:
# Локальные импорты
sys.path.insert(0, str(pathlib.Path(__file__).parent))
import files
Здесь в пути импорта есть папка со structure.py и files.py . Поэтому это решение работает. Но такой подход неидеален, ведь путь импорта может стать очень неаккуратным и трудным для понимания.
Фактически происходит воссоздание функции ранних версий Python, называемой неявным относительным импортом. Она была удалена из языка в руководстве по стилю PEP 328 со следующим обоснованием:
В Python 2.4 и более ранних версиях при чтении модуля, расположенного внутри пакета, неясно: относится ли import foo к модулю верхнего уровня или к другому модулю внутри пакета. По мере расширения библиотеки Python всё больше и больше имеющихся внутренних модулей пакета вдруг случайно затеняют модули стандартной библиотеки. Внутри пакетов эта проблема усугубляется из-за невозможности указать, какой модуль имеется в виду. (Источник.)
Другое решение — использовать вместо этого относительный импорт. Меняем импорт в structure.py :
# Локальные импорты
from . import files
Теперь приложение можно запустить через скрипт точки входа:
$ python cli.py structure
Create file: /home/gahjelle/structure/001/structure.py
Create file: /home/gahjelle/structure/001/files.py
Create file: /home/gahjelle/structure/001/__pycache__/structure.cpython-38.pyc
Create file: /home/gahjelle/structure/001/__pycache__/files.cpython-38.pyc
Но вызвать напрямую приложение больше не получится:
$ python structure.py .
Traceback (most recent call last):
File "structure.py", line 8, in
from . import files
ImportError: cannot import name 'files' from '__main__' (structure.py)
Проблема в том, что относительный импорт разрешается в скриптах иначе, чем импортируемые модули. Конечно, можно вернуться и восстановить абсолютный импорт, а затем выполнить непосредственный запуск скрипта или даже попытаться провернуть акробатический трюк с try. except и реализовать абсолютный или относительный импорт файлов (в зависимости от того, что сработает).
Есть даже официально санкционированный хакерский приём, позволяющий работать с относительным импортом в скриптах. Вот только в большинстве случаев при этом придётся менять sys.path . Цитируя Реймонда Хеттинджера, можно сказать:
И действительно, лучшее (и более стабильное) решение — поэкспериментировать с системой управления пакетами и импорта Python, устанавливая проект в качестве локального пакета с помощью pip .
Создание и установка локального пакета
При установке пакета из PyPI этот пакет становится доступным для всех скриптов в вашей среде. Но пакеты можно установить и с локального компьютера, и они точно так же будут доступны.
Создание локального пакета не приводит к большому расходу вычислительных ресурсов. Сначала создаём минимальный набор файлов setup.cfg и setup.py во внешнем каталоге structure :
# setup.cfg[metadata]
name = local_structure
version = 0.1.0[options]
packages = structure# setup.pyimport setuptoolssetuptools.setup()
Теоретически name и version могут быть любыми. Надо лишь учесть, что они задействованы pip при обращении к пакету, поэтому стоит выбрать для него значения, легко узнаваемые и выделяющие его из массы других пакетов.
Рекомендуется давать всем таким локальным пакетам общий префикс, например local_ или ваше имя пользователя. В пакетах должен находиться каталог или каталоги, содержащие исходный код. Теперь можно установить пакет локально с помощью pip :
$ python -m pip install -e .
Эта команда установит пакет в вашу систему. structure после этого будет находиться в пути импорта Python. То есть можно будет выполнить её в любом месте, не беспокоясь о каталоге скрипта, относительном импорте или других сложностях. -e означает editable (редактируемый). Это важная опция, позволяющая менять исходный код пакета без его переустановки.
Примечание: такой установочный файл отлично подходит для самостоятельной работы с проектами. Если же вы планируете поделиться кодом ещё с кем-то, то стоит добавить в установочный файл кое-какую дополнительную информацию.
Теперь, когда structure в системе установлена, можно использовать следующую инструкцию импорта:
# Локальные импорты
from structure import files
Она будет работать независимо от того, чем закончится вызов приложения.
Совет: старайтесь разделять в коде скрипты и библиотеки. Вот хорошее практическое правило:
- Скрипт предназначен для запуска.
- Библиотека предназначена для импорта.
Возможно, у вас есть код, который вы хотите запускать самостоятельно и импортировать из других скриптов. На этот случай стоит провести рефакторинг кода, чтобы разделить общую часть на библиотечный модуль.
Разделять скрипты и библиотеки — неплохая идея, тем не менее в Python все файлы можно запускать и импортировать. Ближе к завершению статьи подробнее расскажем о том, как создавать модули, которые хорошо справляются и с тем, и с другим.
Пакеты пространства имён
Модули и пакеты в Python очень тесно связаны с файлами и каталогами. Это отличает Python от многих других языков программирования, в которых пакеты — это не более чем пространства имён без обязательной привязки к тому, как организован исходный код. Для примера можете ознакомиться с обсуждением на PEP 402.
Пакеты пространства имён доступны в Python с версии 3.3. Они в меньшей степени зависят от имеющейся здесь файловой иерархии. Так, пакеты пространств имён могут быть разделены на несколько каталогов. Пакет пространства имён создаётся автоматически, если у вас есть каталог, содержащий файл .py , но нет __init__.py . Подробное объяснение смотрите в PEP 420.
Замечание: справедливости ради стоит отметить, что пакеты неявных пространств имён появились в Python 3.3. В более ранних версиях Python пакеты пространств имён можно было создавать вручную несколькими различными несовместимыми способами. Все эти ранние подходы обобщены и в упрощённом виде представлены в PEP 420.
Для лучшего понимания пакетов пространства имён попробуем реализовать один из них. В качестве поясняющего примера рассмотрим такую задачу. Дано: объект Song . Требуется преобразовать его в одно из строковых представлений. То есть нужно сериализовать объекты Song .
А конкретнее — нужно реализовать код, который работает примерно так:
>>> song = Song(song_id="1", title="The Same River", artist="Riverside")
>>> song.serialize()
''
Предположим, нам повезло наткнуться на стороннюю реализацию нескольких форматов, в которые нужно сериализовать объекты, и она организована как пакет пространства имён:
third_party/
│
└── serializers/
├── json.py
└── xml.py
В файле json.py содержится код, который может сериализовать объект в формат JSON:
# third_party/serializers/json.pyimport jsonclass JsonSerializer:
def __init__(self):
self._current_object = None def start_object(self, object_name, object_id):
self._current_object = dict(id=object_id) def add_property(self, name, value):
self._current_object[name] = value def __str__(self):
return json.dumps(self._current_object)
Этого несколько ограниченного интерфейса сериализатора будет достаточно, чтобы продемонстрировать, как работают пакеты пространства имён.
В файле xml.py содержится аналогичный XmlSerializer , который может преобразовать объект в XML:
# third_party/serializers/xml.pyimport xml.etree.ElementTree as etclass XmlSerializer:
def __init__(self):
self._element = None def start_object(self, object_name, object_id):
self._element = et.Element(object_name, attrib=) def add_property(self, name, value):
prop = et.SubElement(self._element, name)
prop.text = value def __str__(self):
return et.tostring(self._element, encoding="unicode")
Обратите внимание, что оба этих класса реализуют один и тот же интерфейс с помощью методов .start_object() , .add_property() и .__str__() .
Затем создаём класс Song , который может применять эти сериализаторы:
# song.pyclass Song:
def __init__(self, song_id, title, artist):
self.song_id = song_id
self.title = title
self.artist = artist def serialize(self, serializer):
serializer.start_object("song", self.song_id)
serializer.add_property("title", self.title)
serializer.add_property("artist", self.artist) return str(serializer)
Song (песня) определяется по идентификатору, названию и исполнителю. Обратите внимание, что .serialize() не нужно знать, в какой формат происходит преобразование, потому что он использует общий интерфейс, определённый ранее.
Установив пакет сторонних serializers , можно работать с ним так:
>>> from serializers.json import JsonSerializer
>>> from serializers.xml import XmlSerializer
>>> from song import Song
>>> song = Song(song_id="1", title="The Same River", artist="Riverside")>>> song.serialize(JsonSerializer())
''>>> song.serialize(XmlSerializer())
'' Riverside
Для разных объектов сериализатора, вызывая .serialize() получаем разные представления песни.
Примечание: при запуске кода можно получить ModuleNotFoundError или ImportError . Всё потому, что serializers нет в пути импорта Python. Но скоро мы увидим, как решить эту проблему.
Пока все идёт хорошо. Но теперь песни нужно преобразовать и в представление YAML, которое не поддерживается сторонней библиотекой. Тут-то в дело и вступают пакеты пространства имён: можем добавить в пакет serializers собственный YamlSerializer , не прибегая к сторонней библиотеке.
Сначала создаём каталог в локальной файловой системе под названием serializers . Важно, чтобы имя каталога совпадало с именем настраиваемого пакета пространства имён:
local/
│
└── serializers/
└── yaml.py
В файле yaml.py определяем собственный YamlSerializer . Делаем это с помощью пакета PyYAML , который должен быть установлен из PyPI:
$ python -m pip install PyYAML
Форматы YAML и JSON очень похожи, поэтому здесь можно повторно использовать большую часть реализации JsonSerializer :
# local/serializers/yaml.pyimport yaml
from serializers.json import JsonSerializerclass YamlSerializer(JsonSerializer):
def __str__(self):
return yaml.dump(self._current_object)
Смотрите: YamlSerializer здесь основан на JsonSerializer , который импортируется из этих самых serializers . А раз json и yaml являются частью одного и того же пакета пространства имён, то мы можем даже использовать относительный импорт: from .json import JsonSerializer .
Поэтому, продолжая этот пример, мы теперь можем преобразовать песню в YAML:
>>> from serializers.yaml import YamlSerializer
>>> song.serialize(YamlSerializer())
"artist: Riverside\nid: '1'\ntitle: The Same River\n"
Подобно обычным модулям и пакетам, пакеты пространства имён должны находиться в пути импорта Python. Если бы мы делали, как в предыдущих примерах, то могли бы столкнуться с проблемами: Python не находил бы serializers . В реальном коде мы бы использовали pip для установки сторонней библиотеки, так что они автоматически оказывались бы в нашем пути.
Примечание: в исходном примере выбор сериализатора делался более динамично. Позже мы увидим, как использовать пакеты пространств имён в соответствующем шаблоне «фабричный метод».
И нужно позаботиться о том, чтобы локальная библиотека была доступна так же, как и обычный пакет. Как мы уже убедились, это можно сделать либо запустив Python из соответствующего каталога, либо опять-таки используя pip для установки локальной библиотеки.
В этом примере мы тестируем, как можно интегрировать фейковый сторонний пакет с нашим локальным пакетом. Будь сторонний third_party реальным пакетом, то мы бы загрузили его из PyPI с помощью pip . А так мы можем сымитировать его, установив third_party локально, как уже было сделано ранее в примере со structure .
Или же можно поколдовать с путём импорта. Поместите каталоги third_party и local в одну папку, а затем настройте путь Python вот так:
>>> import sys
>>> sys.path.extend(["third_party", "local"])>>> from serializers import json, xml, yaml
>>> json
>>> yaml
Теперь можно использовать все сериализаторы, не беспокоясь о том, где они определены: в стороннем пакете или локально.
Руководство по стилю импорта
В руководстве по стилю Python PEP 8 есть ряд рекомендаций, касающихся импорта. Как всегда, в Python важное значение придаётся читаемости и лёгкости сопровождения кода. Вот несколько общих практических правил относительно того, какого стиля надо придерживаться при оформлении импорта:
- Находится в верхней части файла.
- Прописывается в отдельных строках.
- Организуется в группы: сначала идут импорты стандартной библиотеки, затем сторонние импорты, а после — импорты локальных приложений или библиотек.
- Внутри каждой группы импорты располагаются в алфавитном порядке.
- Предпочтение отдаётся абсолютному импорту над относительным.
- Импорты со спецсимволами типа звёздочки ( from module import * ) стараются не использовать.
Инструменты isort и reorder-python-imports отлично подходят для реализации этих рекомендаций в последовательном стиле импорта. Вот пример раздела импорта внутри пакета Real Python feed reader package:
# Импорты стандартной библиотеки
import sys
from typing import Dict, List# Сторонние импорты
import feedparser
import html2text# Импорты ленты новостей
from reader import URL
Обратите внимание на чёткую организацию по группам. Сразу позволяет обозначить зависимости этого модуля, которые должны быть установлены: feedparser и html2text . Обычно подразумевается, что стандартная библиотека доступна. Разделение импортов внутри пакета даёт некоторое представление о внутренних зависимостях кода.
Бывают случаи, когда имеет смысл немного отойти от этих правил. Мы уже видели, что относительный импорт может быть альтернативой при организации иерархии пакетов. В конце статьи мы увидим, как в некоторых случаях можно переместить импорт в определение функции, чтобы прервать циклы импорта.
Импорт в Python. Ресурсы и динамический импорт
Иногда наш код зависит от файлов данных или других ресурсов. В небольших скриптах это не проблема — мы можем указать путь к файлу данных и продолжить работу!
Однако, если файл ресурсов важен для нашего пакета и хочется поделиться им с другими пользователями, возникает несколько проблем:
- У нас не будет контроля над путём к ресурсу, так как это будет зависеть от настроек пользователя, а также от того, как пакет распространяется и устанавливается. Можно попробовать узнать путь к ресурсу с помощью атрибутов пакета __file__ или __path__ , но такой способ не всегда может сработать так, как мы ожидаем.
- Пакет может находиться внутри ZIP-файла или старого файла .eggfile, и в этом случае ресурс даже не будет физическим файлом в компьютере пользователя.
Было предпринято несколько попыток решить эти проблемы, в том числе с помощью setuptools.pkg_resources . Однако с появлением в стандартной библиотеке Python 3.7 importlib.resources теперь есть один стандартный способ работы с ресурсными файлами.
Представляем importlib.resources
importlib.resources предоставляет доступ к ресурсам внутри пакетов. В этом контексте ресурс — это любой файл, находящийся в импортируемом пакете. Файл может соответствовать, а может и не соответствовать физическому файлу в файловой системе.
Здесь есть несколько преимуществ: при повторном использовании системы импорта получаем более последовательный способ работы с файлами внутри пакетов плюс более лёгкий доступ к ресурсным файлам в других пакетах. Вот что об этом сказано в документации:
Если вы можете импортировать пакет, то можете иметь доступ к ресурсам внутри этого пакета. (Источник.)
importlib.resources стали частью стандартной библиотеки в Python 3.7. А для более старых версий Python имеется бэкпорт importlib_resources . Чтобы задействовать бэкпорт, надо установить его из PyPI:
$ python -m pip install importlib_resources
Бэкпорт совместим с Python 2.7, а также Python 3.4 и более поздними версиями.
При работе с importlib.resources есть одно условие: ресурсные файлы должны быть доступны внутри обычного пакета. Пакеты пространства имён не поддерживаются. На практике это означает, что файл должен находиться в каталоге, содержащем файл __init__.py .
В качестве первого примера предположим, что у нас в пакете есть такие ресурсы:
books/
│
├── __init__.py
├── alice_in_wonderland.png
└── alice_in_wonderland.txt
__init__.py — это просто пустой файл, необходимый для указания на то, что books (книги) — это обычный пакет.
Затем можем использовать open_text() и open_binary() для открытия текстовых и бинарных файлов соответственно:
>>> from importlib import resources
>>> with resources.open_text("books", "alice_in_wonderland.txt") as fid:
. alice = fid.readlines()
.
>>> print("".join(alice[:7]))
ГЛАВА I, в которой Алиса чуть не провалилась сквозь землю

Алиса сидела со старшей сестрой на берегу и маялась: делать ей было совершенно нечего, а сидеть без дела, сами знаете, дело нелёгкое; раз-другой она, правда, сунула нос в книгу, которую сестра читала, но там не оказалось ни картинок, ни стишков. «А что толку в книге, — подумала Алиса, — без картинок и стишков?».

>>> with resources.open_binary("books", "alice_in_wonderland.png") as fid:
. cover = fid.read()
.
>>> cover[:8] # С игнатура файла PNG
b'\x89PNG\r\n\x1a\n'
open_text() и open_binary() эквивалентны встроенному open() с параметром mode , имеющим значения rt и rb соответственно. Также доступны в виде read_text() и read_binary() удобные функции для чтения текстовых или двоичных файлов. Ещё больше узнать можно в официальной документации.
Примечание: чтобы полностью перейти на бэкпорт для старых версий Python, импортируем importlib.resources :
try:
from importlib import resources
except ImportError:
import importlib_resources as resources
Больше узнать об этом можно в разделе «Полезные советы» этой статьи. Далее в этой части статьи покажем несколько сложных примеров работы с ресурсными файлами на практике.
Файлы данных
В качестве более полного примера работы с файлами данных рассмотрим, как можно реализовать программу викторины, основанную на демографических данных Организации Объединенных Наций. Сначала создаём пакет data и загружаем WPP2019_TotalPopulationBySex.csv с веб-сайта ООН:
data/
│
├── __init__.py
└── WPP2019_TotalPopulationBySex.csv
Откроем файл CSV и посмотрим на данные:
LocID,Location,VarID,Variant,Time,PopMale,PopFemale,PopTotal,PopDensity
4,Afghanistan,2,Medium,1950,4099.243,3652.874,7752.117,11.874
4,Afghanistan,2,Medium,1951,4134.756,3705.395,7840.151,12.009
4,Afghanistan,2,Medium,1952,4174.45,3761.546,7935.996,12.156
4,Afghanistan,2,Medium,1953,4218.336,3821.348,8039.684,12.315
.
В каждой строке мы видим данные о населении страны за определённый год и вариант, указывающий на соответствующий прогнозный сценарий. В файле содержатся прогнозы численности населения по странам мира до 2100 года.
Следующая функция считывает этот файл и выдаёт общую численность населения той или иной страны за конкретный year (год) и variant (вариант):
import csv
from importlib import resourcesdef read_population_file(year, variant="Medium"):
population = <> print(f"Reading population data for , scenario")
with resources.open_text(
"data", "WPP2019_TotalPopulationBySex.csv"
) as fid:
rows = csv.DictReader(fid) # Считывание данных, отбор данных по заданному году
for row in rows:
if row["Time"] == year and row["Variant"] == variant:
pop = round(float(row["PopTotal"]) * 1000)
population[row["Location"]] = pop return population
Выделенные жирным шрифтом строки показывают применение importlib.resources для открытия файла данных. Функция возвращает словарь с численностью населения:
>>> population = read_population_file("2020")
Reading population data for 2020, Medium scenario
#Считывание данных по численности населения на 2020 год, средний сценарий>>> population["Norway"]
5421242
Имея такой словарь с данными по численности населения, можно сделать много чего интересного, например анализ и визуализации. Ну а мы создадим игру-викторину, в которой участников просят определить, какая страна в наборе имеет самую большую численность населения. Вот как будет выглядеть эта игра:
$ python population_quiz.pyВопрос 1:
1. Тунис
2. Джибути
3. БелизКакая страна имеет наибольшую численность населения ? 1
Верно, больше всего населения имеет Тунис (11 818 618)Вопрос 2:
1. Мозамбик
2. Гана
3. ВенгрияКакая страна имеет наибольшую численность населения ? 2
Ответ неверный, в Мозамбике (31 255 435) численность населения выше, чем в Гане (31 072 945).
Вдаваться в подробности этой реализации не будем, так как они совершенно не имеют отношения к предмету рассмотрения нашей статьи. Однако полный исходный код мы можем показать.
Исходный код демографической викторины:
Демографическая викторина состоит из двух функций: одна считывает данные по численности населения (как мы это делали чуть выше), а другая запускает саму викторину:
# population_quiz.pyimport csv
import randomtry:
from importlib import resources
except ImportError:
import importlib_resources as resourcesdef read_population_file(year, variant="Medium"):
"""Read population data for the given year and variant""" (Считываются данные о численности населения по конкретному году и варианту)
population = <> print(f"Reading population data for , scenario")
with resources.open_text(
"data", "WPP2019_TotalPopulationBySex.csv"
) as fid:
rows = csv.DictReader(fid) # Считывание данных, отбор данных по заданному году
for row in rows:
if (
int(row["LocID"]) < 900
and row["Time"] == year
and row["Variant"] == variant
):
pop = round(float(row["PopTotal"]) * 1000)
population[row["Location"]] = pop return populationdef run_quiz(population, num_questions, num_countries):
"""Run a quiz about the population of countries""" # Запускается демографическая викторина
num_correct = 0
for q_num in range(num_questions):
print(f"\n\nQuestion :")
countries = random.sample(population.keys(), num_countries)
print("\n".join(f". " for i, a in enumerate(countries, start=1))) # Получение данных от пользователя
while True:
guess_str = input("\nWhich country has the largest population? ")
try:
guess_idx = int(guess_str) - 1
guess = countries[guess_idx]
except (ValueError, IndexError):
print(f"Please answer between 1 and ")
else:
break # Проверка ответа
correct = max(countries, key=lambda k: population[k])
if guess == correct:
num_correct += 1
print(f"Yes, is most populous ()")
else:
print(
f"No, () is more populous "
f"than ()"
) return num_correctdef main():
"""Read population data and run quiz""" # Считывание данных по численности населения и запуск викторины
population = read_population_file("2020")
num_correct = run_quiz(population, num_questions=10, num_countries=3)
print(f"\nYou answered questions correctly")if __name__ == "__main__":
main()
Обратите внимание: здесь в строке 24 мы проверяем, что LocID меньше 900 . LocID , равный 900 и выше, указывает не на страновые данные, а на данные по миру, частям света, такие как World , Asia и т.д.
Пример: значки и Tkinter
При создании графических пользовательских интерфейсов (ГПИ) часто требуется включать ресурсные файлы, такие как значки. На следующем примере научимся делать это с помощью importlib.resources . В итоге приложение будет выглядеть довольно просто, но со вкусом благодаря оригинальному значку и оформлению кнопки Goodbye:
В примере используется пакет ГПИ Tkinter, доступный в стандартной библиотеке. Он основан на оконной системе Tk, изначально разработанной для языка программирования Tcl. Существует множество других пакетов ГПИ, доступных для Python. Если вы используете один из них, то должны уметь добавлять значки в своё приложение с помощью идей, подобных тем, что представлены здесь.
В Tkinter изображения обрабатываются классом PhotoImage . Чтобы создать PhotoImage , передаём путь к файлу изображения.
При распространении пакета вовсе не гарантируется, что ресурсные файлы будут существовать в файловой системе как физические файлы. importlib.resources решает эту проблему с помощью path() . Эта функция вернёт путь к ресурсному файлу, создав при необходимости временный файл.
Чтобы убедиться, что все временные файлы очищены правильно, задействуем path() в качестве менеджера контекста, используя ключевое слово with :
>>> from importlib import resources
>>> with resources.path("hello_gui.gui_resources", "logo.png") as path:
. print(path)
.
/home/gahjelle/hello_gui/gui_resources/logo.png
Для полного примера предположим, что у нас есть следующая файловая иерархия:
hello_gui/
│
├── gui_resources/
│ ├── __init__.py
│ ├── hand.png
│ └── logo.png
│
└── __main__.py
Хотите попробовать пример самостоятельно? Скачайте эти файлы вместе с остальным исходным кодом, приведённым в этой статье, перейдя по ссылке ниже:
Получить исходный код: Нажмите здесь и получите исходный код, используемый для изучения системы импорта Python в этой статье.
Код хранится в файле со специальным именем __main__.py . Это имя указывает на то, файл является точкой входа для пакета. Благодаря файлу __main__.py наш пакет может выполняться с python -m :
$ python -m hello_gui
ГПИ определяется в классе Hello . Обратите внимание, что для получения пути к файлам изображений используется importlib.resources :
# hello_gui/__main__.pyimport tkinter as tk
from tkinter import ttktry:
from importlib import resourcesexcept ImportError:
import importlib_resources as resourcesclass Hello(tk.Tk):
def __init__(self, *args, **kwargs):
super().__init__(*args, **kwargs)
self.wm_title("Hello") # Изображение считывается, ссылка на него сохраняется и устанавливается в качестве значка
with resources.path("hello_gui.gui_resources", "logo.png") as path:
self._icon = tk.PhotoImage(file=path)
self.iconphoto(True, self._icon) # Изображение считывается, создаётся кнопка, а ссылка на изображение сохраняется
with resources.path("hello_gui.gui_resources", "hand.png") as path:
hand = tk.PhotoImage(file=path)
button = ttk.Button(
self,
image=hand,
text="Goodbye",
command=self.quit,
compound=tk.LEFT, # Add the image to the left of the text
)
button._image = hand
button.pack(side=tk.TOP, padx=10, pady=10)if __name__ == "__main__":
hello = Hello()
hello.mainloop()
Официальная документация содержит хороший список ресурсов, с которого можно начать изучение. Ещё один отличный ресурс — это «Руководство по TkDocs», которое показывает, как использовать Tk в других языках.
Примечание: единственное, что может вызывать неудобство при работе с изображениями в Tkinter, так это то, что здесь нужно следить за тем, чтобы изображения не удалялись механизмом автоматического управления памятью. Из-за того, как Python и Tk взаимодействуют, сборщик мусора в Python (по крайней мере, в CPython) не регистрирует, что .iconphoto() и Button используют изображения.
Чтобы убедиться, что изображения сохраняются, нужно вручную добавлять ссылку на них. В нашем коде это было сделано в строках 18 и 31.
Динамический импорт
Одна из отличительных особенностей Python в том, что это очень динамичный язык. Можно много чего сделать с программой Python во время её выполнения (хотя иногда делать этого не стоит), например добавлять атрибуты к классу, переопределять методы или изменять строку документации модуля. Мы можем изменить print() так, чтобы он ничего не делал:
>>> print("Hello dynamic world!")
Hello dynamic world!>>> # Переопределяем встроенный print()
>>> print = lambda *args, **kwargs: None>>> print("Hush, everybody!")
>>> # Ничего не выводится
На самом деле, мы не переопределяем print() . Мы определяем другой print() , который затеняет встроенный print() . Для возвращения к исходному print() удаляем наш пользовательский print() с помощью del print . Так можно затенить любой объект Python, встроенный в интерпретатор.
Обратите внимание: в приведенном выше примере мы переопределяем print() с помощью лямбда-функции. Также можно было бы использовать определение обычной функции:
>>> def print(*args, **kwargs):
. pass
В этой части статьи мы ещё узнаем, как выполнять динамический импорт в Python. Освоив его, вы избавитесь от необходимости решать, что импортировать во время выполнения программы.
importlib
До сих пор мы использовали ключевое слово import для явного импорта модулей и пакетов в Python. Однако весь механизм импорта доступен в пакете importlib , что позволяет нам выполнять импорт более динамично. Следующий скрипт запрашивает у пользователя имя модуля, импортирует этот модуль и выводит строку его документации:
# docreader.pyimport importlibmodule_name = input("Name of module? ")
module = importlib.import_module(module_name)
print(module.__doc__)
import_module() возвращает объект модуля, который можно привязать к любой переменной. После чего мы можем обращаться с этой переменной как с обычным импортируемым модулем. Этот скрипт можно использовать вот так:
$ python docreader.py
Name of module? math
Этот модуль всегда доступен. Он предоставляет доступ к математическим функциям, определяемым стандартом С.$ python docreader.py
Name of module? csv
CSV-парсинг и запись. .Этот модуль предоставляет классы, которые помогают в чтении и записи
файлов Comma Separated Value (CSV), т.е. файлов со значениями, разделёнными запятыми. Кроме того, он реализует интерфейс,
описанный в PEP 305. Хотя парсинг многих CSV файлов очень прост,
этот формат формально не определяется стабильной спецификацией и
едва уловим. Настолько, что парсинг строк CSV-файла с чем-то
вроде line.split(",") обречен на неудачу. Модуль поддерживает три
базовые API: чтение, запись и регистрацию диалектов. .[. ]
В каждом случае модуль импортируется динамически с помощью import_module() .
Фабричный метод с пакетами пространства имён
Вернёмся к примеру с сериализаторами. Благодаря serializers , реализованным в качестве пакета пространства имён, у нас появилась возможность добавлять пользовательские сериализаторы. Сериализаторы создаются с помощью фабрики сериализаторов. Попробуем сделать это, использовав importlib .
Добавим в наш локальный пакет пространства имён serializers следующий код:
# local/serializers/factory.pyimport importlibdef get_serializer(format):
try:
module = importlib.import_module(f"serializers.")
serializer = getattr(module, f"Serializer")
except (ImportError, AttributeError):
raise ValueError(f"Unknown format ") from None return serializer()def serialize(serializable, format):
serializer = get_serializer(format)
serializable.serialize(serializer)
return str(serializer)
Фабрика get_serializer() может создать сериализаторы динамически на основе параметра format , а затем serialize() может применить сериализатор к любому объекту, реализующему метод .serialize() .
Фабрика делает строгие предположения об именовании модуля и класса, которые содержат конкретные сериализаторы. Далее в статье мы узнаем об архитектуре плагинов, которая придаёт больше гибкости.
А пока воссоздадим предыдущий пример вот таким образом:
>>> from serializers import factory
>>> from song import Song
>>> song = Song(song_id="1", title="The Same River", artist="Riverside")>>> factory.serialize(song, "json")
''>>> factory.serialize(song, "yaml")
"artist: Riverside, id: '1', title: The Same River\n">>> factory.serialize(song, "toml")
ValueError: Unknown format 'toml'
В этом случае нам больше не нужно выполнять явный импорт каждого сериализатора. Имя сериализатора указываем со строкой. Строка может быть даже выбрана пользователем во время выполнения.
Обратите внимание: в обычном пакете мы бы, наверное, реализовали get_serializer() и serialize() в файле __init__.py . Так мы могли бы просто импортировать serializers , а затем вызвать serializers.serialize() .
Но пакеты пространства имён не могут использовать __init__.py , поэтому нужно реализовать эти функции в отдельном модуле.
Последний пример показывает, что мы получаем соответствующее сообщение об ошибке, если пытаемся сериализоваться в формат, который не был реализован.
Пакет плагинов
Рассмотрим ещё один пример использования динамического импорта. Мы можем использовать следующий модуль для настройки гибкой архитектуры плагинов в коде. Это похоже на то, что было в предыдущем примере, в котором мы могли подключить сериализаторы для различных форматов, добавив новые модули.
Эскпериментальное средство визуализации Glue — это одно из приложений, эффективно использующих плагины. Оно сходу может читать множество различных форматов данных. Если всё-таки нужный формат данных не поддерживается, можно написать собственный пользовательский загрузчик данных.
Просто добавляется функция, которая декорируется и помещается в специальное место, чтобы Glue было легче её найти. И никакую часть исходного кода Glue менять не надо. Все детали смотрите в документации.
Мы можем настроить аналогичную архитектуру плагина для использования в своих проектах. В этой архитектуре два уровня:
- Пакет плагинов — это набор связанных плагинов, соответствующих пакету Python.
- Плагин — это пользовательское поведение, доступное в модуле Python.
Модуль plugins , который предоставляет архитектуру плагина, имеет следующие функции:
# plugins.pydef register(func):
"""Decorator for registering a new plugin""" (Декоратор для регистрации нового плагина)def names(package):
"""List all plugins in one package""" (Приводит список всех плагинов в одном пакете)def get(package, plugin):
"""Get a given plugin""" (Получает данный плагин)def call(package, plugin, *args, **kwargs):
"""Call the given plugin""" (Вызывает этот плагин)def _import(package, plugin):
"""Import the given plugin file from a package""" (Импортирует файл этого плагина из пакета)def _import_all(package):
"""Import all plugins in a package""" (Импортирует все плагины в пакете)def names_factory(package):
"""Create a names() function for one package""" (Создаёт функцию names() для одного пакета)def get_factory(package):
"""Create a get() function for one package""" (Создаёт функцию get() для одного пакета)def call_factory(package):
"""Create a call() function for one package""" (Создаёт функцию call() для одного пакета)
Фабричные функции используются для удобного добавления функциональности в пакеты плагинов. Вскоре увидим примеры того, как это происходит.
Рассматривать код во всех деталях не будем: это выходит за рамки статьи. Если вам интересно, можем показать реализацию ниже.
В следующем коде показана реализация plugins.py , описанная выше:
# plugins.pyimport functools
import importlib
from collections import namedtuple
from importlib import resources# Базовая структура для хранения информации об одном плагине
Plugin = namedtuple("Plugin", ("name", "func"))# Словарь с информацией обо всех зарегистрированных плагинах
_PLUGINS = <>def register(func):
"""Decorator for registering a new plugin"""
package, _, plugin = func.__module__.rpartition(".")
pkg_info = _PLUGINS.setdefault(package, <>)
pkg_info[plugin] = Plugin(name=plugin, func=func)
return funcdef names(package):
"""List all plugins in one package"""
_import_all(package)
return sorted(_PLUGINS[package])def get(package, plugin):
"""Get a given plugin"""
_import(package, plugin)
return _PLUGINS[package][plugin].funcdef call(package, plugin, *args, **kwargs):
"""Call the given plugin"""
plugin_func = get(package, plugin)
return plugin_func(*args, **kwargs)def _import(package, plugin):
"""Import the given plugin file from a package"""
importlib.import_module(f".")def _import_all(package):
"""Import all plugins in a package"""
files = resources.contents(package)
plugins = [f[:-3] for f in files if f.endswith(".py") and f[0] != "_"]
for plugin in plugins:
_import(package, plugin)def names_factory(package):
"""Create a names() function for one package"""
return functools.partial(names, package)def get_factory(package):
"""Create a get() function for one package"""
return functools.partial(get, package)def call_factory(package):
"""Create a call() function for one package"""
return functools.partial(call, package)
Эта реализация немного упрощена. Так, она не выполняет явной обработки ошибок. Более полная реализация доступна по ссылке на проект PyPlugs.
_import() использует importlib.import_module() для динамической загрузки плагинов. А _import_all() использует importlib.resources.contents() для перечисления всех доступных плагинов в данном пакете.
Рассмотрим несколько примеров использования плагинов. Первый пример — это пакет greeter , который можно использовать для добавления различных приветствий в приложение. Полная архитектура плагинов здесь определённо избыточна, но она показывает, как работают плагины. Представьте, что у вас такой пакет greeter :
greeter/
│
├── __init__.py
├── hello.py
├── howdy.py
└── yo.py
Каждый модуль greeter определяет функцию, которая принимает один аргумент name . Посмотрите, как с помощью декоратора @register все они регистрируются в качестве плагинов:
# greeter/hello.py
import plugins@plugins.register
def greet(name):
print(f"Hello , how are you today?")# greeter/howdy.py
import plugins@plugins.register
def greet(name):
print(f"Howdy good , honored to meet you!")# greeter/yo.py
import plugins@plugins.register
def greet(name):
print(f"Yo , good times!")
Обратите внимание: для упрощения обнаружения и импорта плагинов имя каждого плагина содержит не имя функции, а имя модуля, в котором он находится. Поэтому на каждый файл может быть только один плагин.
В завершение настройки greeter как пакета плагинов можно использовать фабричные функции в plugins для добавления функциональности в сам пакет greeter :
# greeter/__init__.pyimport pluginsgreetings = plugins.names_factory(__package__)
greet = plugins.call_factory(__package__)
Теперь мы можем использовать greetings() и greet() вот так:
>>> import greeter
>>> greeter.greetings()
['hello', 'howdy', 'yo']>>> greeter.greet(plugin="howdy", name="Guido")
Howdy good Guido, honored to meet you!
Заметьте, что greetings() автоматически обнаруживает все плагины, доступные в пакете.
Мы также можем более динамически выбирать, какой плагин вызывать. В следующем примере выбираем плагин случайным образом. Плагин также можно выбрать на основе конфигурационного файла или пользовательских данных:
>>> import greeter
>>> import random>>> greeting = random.choice(greeter.greetings())
>>> greeter.greet(greeting, name="Frida")
Hello Frida, how are you today?>>> greeting = random.choice(greeter.greetings())
>>> greeter.greet(greeting, name="Frida")
Yo Frida, good times!
Для обнаружения и вызова различных плагинов их нужно импортировать. Остановимся ненадолго на том, как plugins работают с импортом. Всё самое главное происходит в следующих двух функциях внутри plugins.py :
import importlib
import pathlib
from importlib import resourcesdef _import(package, plugin):
"""Import the given plugin file from a package""" (Импортирует файл этого плагина из пакета)
importlib.import_module(f".")def _import_all(package):
"""Import all plugins in a package""" (Импортирует все плагины в пакете)
files = resources.contents(package)
plugins = [f[:-3] for f in files if f.endswith(".py") and f[0] != "_"]
for plugin in plugins:
_import(package, plugin)
_import() внешне кажется простым. Для импорта модуля он использует importlib . Но здесь происходит ещё кое-что:
- Система импорта Python гарантирует, что каждый плагин импортируется только один раз.
- Декораторы @register , определённые внутри каждого модуля plugin, регистрируют каждый импортированный плагин.
- В полной реализации для работы с отсутствующими плагинами будет обработка ошибок.
_import_all() обнаруживает все плагины в пакете. Вот как это работает:
- contents() из importlib.resources выводит список всех файлов внутри пакета.
- Результаты фильтруются для поиска потенциальных плагинов.
- Каждый файл Python, не начинающийся с подчеркивания, импортируется.
- Плагины в любом из файлов обнаруживаются и регистрируются.
Завершим эту часть статьи финальной версией пакета пространства имён. Одной из нерешённых проблем было то, что фабрика get_serializer() делала строгие предположения об именовании классов сериализатора. С помощью плагинов можно сделать их более гибкими.
Первым делом добавляем строку, регистрирующую каждый из сериализаторов. Вот пример того, как это делается в сериализаторе yaml :
# local/serializers/yaml.pyimport plugins
import yaml
from serializers.json import JsonSerializer@plugins.register
class YamlSerializer(JsonSerializer):
def __str__(self):
return yaml.dump(self._current_object)
Затем обновляем get_serializers() для использования plugins :
# local/serializers/factory.pyimport pluginsget_serializer = plugins.call_factory(__package__)def serialize(serializable, format):
serializer = get_serializer(format)
serializable.serialize(serializer)
return str(serializer)
Мы реализуем get_serializer() с помощью call_factory() , так как это автоматически инстанцирует каждый сериализатор. При таком рефакторинге сериализаторы работают точно так же, как и раньше. Но теперь у нас больше гибкости в именовании классов сериализаторов.
Ещё больше об использовании плагинов можно узнать в PyPlugs на PyPI и презентации Плагины: добавление гибкости приложениям из PyCon 2019.
- Продвинутый Python: 9 важнейших аспектов при определении классов
- Как автоматизировать электронную почту с помощью Python
- Контейнеризация в Python. Часть 1