Data scientist: программист-исследователь
Ежедневно через серверы компании Mail.Ru Group проходят сотни терабайт данных. Эту информацию нужно уметь анализировать и строить на её основе различные модели и прогнозы. Этим занимаются специалисты по анализу данных и машинному обучению.
Реальный герой
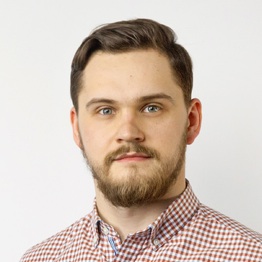
Николай Анохин
программист-исследователь Mail.Ru Group, специалист в области машинного обучения и обработки больших данных.
Что такое Data Science
Термин Data Science получил известность только в 2010-х годах. С 2012 года профессия Data Scientist не раз отмечалась как одна из самых привлекательных (англ. sexy) и перспективных.
Wikipedia
Есть такой пример: люди, которые покупают хлеб и масло, с высокой вероятностью купят и сыр. Чтобы убедиться в этом наверняка, следует проанализировать поведение большого количества покупателей. Знание этой закономерности позволяет мерчендайзерам в супермаркетах класть такие продукты недалеко друг от друга. Это очевидный пример, но существует и множество других, не столь очевидных закономерностей, которые можно выделить, анализируя данные.
Мы живём в мире колоссальных объёмов информации, и для её анализа используются специализированные алгоритмы, например, алгоритмы машинного обучения. Машинное обучение — это специальная область информатики, которая изучает методы автоматического извлечения новых, ранее неизвестных закономерностей из известных данных.
Сегодня технологии машинного обучения и обработки больших данных используются во многих сферах нашей жизни, а в будущем могут стать основным средством автоматизации всех рутинных задач и незаменимыми помощниками в принятии решений.
Специалист по анализу данных и машинному обучению занимается обработкой огромного количества информации, и, как правило, его рабочее место — это не один компьютер, а целый кластер из серверов.
В Mail.Ru Group в одном из таких кластеров находится порядка 80 серверов, каждый из которых имеет сотни гигабайт оперативной памяти и несколько десятков процессоров, так что суммарный объем данных жестких дисков этого кластера составляет 1,5 петабайт.
Петабайт (ПБ, ПБайт) — единица измерения количества информации, равная 10 15 байт (1024 терабайт). Это намного больше, чем память компьютеров, с которыми мы имеем дело в повседневной жизни.
Где используется Data Science
- Автоматическая диагностика заболеваний
- Автоматический перевод текстов
- Помощь в принятии решений о выдаче кредитов
- Автопилоты и системы автомобильной навигации
- Персональные рекомендации музыки, фильмов и книг
Как Data Science используется в Mail.Ru Group
Таргетинг рекламы
Рекламу, которую пользователи видят на сайтах, выбирают специальные алгоритмы, анализирующие поведение людей в интернете: какие страницы они посещают, что делают в соцсетях, что читают и смотрят. Всё это нужно для того, чтобы узнать их интересы и определить различные характеристики (такие как уровень дохода и социальное положение) и в конечном итоге предложить им рекламу, которая их заинтересует.
Категоризация новостей
Категоризация новостей — это когда темы автоматически определяются из текста новости и странице с новостью присваивается категория (спорт, финансы и т.д). Новость появляется в соответствующем разделе агрегатора.
Фильтрация спама
Пользователи отмечают некоторые письма как спам. На основании этой информации строится модель, которая потом используется для автоматического определения спама во всех новых письмах, которые получают пользователи.
Оптимизация поисковой выдачи
Машинное обучение используется для того, чтобы под конкретный поисковый запрос и пользователя найти наиболее интересные страницы и правильно разместить их в поисковой выдаче. Идеальная ситуация — когда страница, которую пользователь ищет, оказывается первой в результатах.
«Остаётся только доучить программирование». Как стать Data Scientist
Сергей Ширкин, преподаватель образовательного портала GeekBrains, рассказывает про профессию Data Scientist: чем занимается, насколько востребован и что должен уметь исследователь данных.

Объясню на примере. Раньше я работал в финансах, основная задача в этой сфере — определение кредитоспособности заемщика. То есть клиент приходит за кредитом, а банк должен за короткое время сделать вывод, стоит ли его выдавать. Раньше все приходилось делать вручную: специалист просматривал историю, анкетные данные и пытался понять, давать все-таки кредит человеку или нет. С помощью Data Science решить такую задачу можно значительно быстрее и точнее.
На основе данных про кредитную историю, поведение клиента, его транзакции и платежеспособность модель вычисляет вероятность того, что кредит будет погашен. После этого высчитывается скоринговый балл и затем на основе этих выводов специалист в банке решает, насколько можно этому человеку доверять. Модели машинного обучения могут ускорять такой вывод и делать его за доли секунды.
С каким бэкграундом приходят в Data Science
Я пришел в Data Science с академическим бэкграундом, еще в университете я начал строить модели машинного обучения. В то время это занятие не было особенно популярно, такие знания в основном применялись в науке. В бизнесе такой подход активно внедряется последние 5-10 лет.
Data Scientist на русский язык можно дословно перевести как «исследователь данных». Но чаще встречается перевод «математик-программист» либо «аналитик данных». Люди именно с такими специальностями становятся дата-сайентистами в первую очередь.
Есть еще несколько очень близких к Data Scientist профессий — это Data Engineer и аналитик. В первом случае, чтобы попасть в Data Science, человеку нужно подтянуть математику. Во втором — программирование и машинное обучение.
Кроме этого, человек может прийти в Data Science из академической сферы, например, раньше он строил модели для науки, а потом начал заниматься этим в компании. У специалиста также может быть бэкграунд программиста, тогда ему нужно добавить знаний по математике и машинному обучению.
Иногда люди приходят из предметной сферы. Например, человек работает в маркетинге и хорошо знает предметную область, ему остается только доучить все, что связано с программированием, математикой, машинным обучением. Этот путь, конечно, самый сложный, потому что фактически человек не был связан с ИТ и ему приходится все учить с нуля. Но если он добавит к своим компетенциям знания по Data Science, то будет в своей предметной сфере очень востребованным.
В каких сферах может работать Data Scientist
- ИТ
- финансы
- медицина
- бизнес
- наука
- производство
- страхование
- транспорт
- биоинженерия
- маркетинг
Какими скилами нужно обладать
Дата-сайентист должен обладать такими же навыками, как и программист: усидчивостью, внимательностью, хорошо развитой логикой. Но кроме этого, профессия предполагает частое общение с людьми из разных сфер: с программистами, проджект и продакт менеджерами, специалистами из отделов маркетинга или продаж. Круг общения получается абсолютно разный и нужно уметь донести мысли о полученных выводах в процессе исследований и перевести их на язык других профессий. Важно уметь изъясняться не математическими формулами, а понятно рассказывать про результаты свой работы и их влияние на деятельность компании.
Как проходит стандартный рабочий день
Рабочий день проходит по-разному. Какое-то время уходит на исследования, анализ данных, задач, моделей. Еще часть — непосредственно на сам кодинг. Если Data Scientist внедряет модели, то нужно их запрограммировать, чтобы они надежно работали. Также во время рабочего дня бывают обсуждения результатов работы и задач с командой, различные совещания, написание писем, общение с сотрудниками отдела.
Главная задача дата-сайентиста не столько написать программу, сколько придумать различные идеи для модели, понять, какие признаки использовать, чтобы она хорошо работала. Затем тестово их запустить, проверить и обсудить с коллегами.
В какой команде работает Data Scientist
Команда у дата-сайентиста бывает совершенно разной, здесь все зависит от компании. Во-первых, нужно взаимодействовать с людьми, которые работают с данными, например, с Data Engineer. Иногда приходится общаться с администратором баз данных. Кроме того, Data Scientist может работать в команде со специалистами своей же профессии, например, над какой-то объемной задачей, которую они делят между собой. Также в команде могут быть бизнес-аналитики, проджект и продакт менеджеры. Иногда к работе подключаются программисты, чтобы внедрить модель, которую сделал дата-сайентист или, например, помочь запрограммировать интерфейс приложения.
Освойте Data Science с нуля и получите востребованную профессию. Мы поможем!
После учебы вы сможете работать по специальностям
- Data Scientist
- Data Analyst
- Machine Learning Engineer
- Computer Vision-специалист
- NLP-специалист
Насколько эта профессия востребована на рынке
Дата-сайентисты нужны. Постоянно есть вакансии. Особенности в том, что компании ищут разных специалистов под свои задачи. Например, если компания занимается созданием приложения для обработки изображений, то в таком случае Data Scientist может участвовать в создании программы и работать не только с табличными данными, но и с изображениями, с текстами. Если компания создает разговорный чат-бот, соответственно, там нужны другие скилы у специалиста.
Когда специалист разносторонний и хорошо работает как с табличными данными, так и с изображениями или текстом, то ему проще найти работу. Сейчас есть тенденция: в основном компании стараются найти уже хорошо подготовленных специалистов, то есть мидлов или синьоров, но, тем не менее, запрос на джуниоров тоже есть.
Как развиваться в профессии
Практически каждому, кто хочет стать дата-сайентистом, потребуется пройти онлайн-курсы по машинному обучению. Такие курсы важно проходить периодически, вне зависимости от квалификации. Обучение необязательно должно идти по нарастающей сложности, это могут быть курсы, которые просто позволят узнать, что нового появилось в машинном обучении. Особенно это касается нейронных сетей, потому что сейчас в компьютерном зрении, в обработке естественного языка изменения происходят буквально каждый месяц. Следить за сферой и новыми направлениями также помогают подписки на тематические Telegram и Youtube-каналы. Кроме этого, можно принимать участие в соревнованиях по машинному обучению, следить за соревнованиями от различных компаний (можно на сайте kaggle.com). Постоянно появляется новая литература, подкасты.
Рекомендации
Тelegram-каналы:
- Small Data Science for Russian Adventures
- Machinelearning
- Artificial Intelligence && Deep Learning
Youtube-каналы:
- Data Science Guy
- Флесс
- Компьютерные науки
- ФКН ВШЭ
Книги:
- «Распознавание образов и машинное обучение» Бишоп К. М.
- «Глубокое обучение» Бенджио Иошуа, Гудфеллоу Ян
- «Введение в машинное обучение с помощью Python» Андреас Мюллер, Сара Гвидо
Сложности и плюсы профессии
На самом деле в работе дата-сайентиста сложного очень много. Во-первых, часто приходится работать со сложными моделями, в которых нужно досконально разобраться. Во-вторых, сложности могут быть связаны именно с бизнес-составляющей работы. Моделей можно создавать очень много, но важно подобрать такие методы оценки результата, которые были бы полезны для бизнеса. Бывают сложности с самими данными, где-то они могут быть искажены либо же неполны. Это бывает очень сложно заметить, а еще сложнее исправить.
Самое увлекательное в этой работе — это ее исследовательский характер. Это похоже на науку, здесь можно пробовать различные модели, рабочие методы. Кроме того, Data Science и машинное обучение открывает двери практически в любую сферу. Например, человек может поработать в финансах, после этого перейти в маркетинг или медицину. При этом совершенно необязательно иметь профильное для этих сфер образование, на первом месте все-таки остается математика и машинное обучение.
Программист-исследователь (Python, Data Science, Machine Learning)
Почта Mail.Ru — это проект с ежемесячной аудиторией 44,1 млн пользователей. Он входит в топ-5 мировых почтовых сервисов по дневной аудитории.
Сейчас в одном из направлений подразделения — группе Антиспама — открыта вакансия программиста-исследователя.
Задача команды — обеспечивать безопасность почтовых ящиков пользователей. Мы имеем дело с Big Data и High Load, а ключевой сервис написан на С++ и Lua. Особое внимание уделяем машинному обучению и датамайнингу, для этого есть Hadoop Cluster, Kafka, Pig. Среди прочего решаем инфраструктурные задачи и пишем в основном на Python и немного на Java.
Обязанности:
- участие в проектах по обработке больших объемов данных с применением аналитики, data mining и машинного обучения.
Требования:
- аналитическое мышление;
- знание теории вероятности и математической статистики;
- навыки программирования, знание Python;
- способность работать с большими объемами информации, умение ее структурировать и анализировать;
- умение выдвигать гипотезы и предлагать способы их проверки;
- знание основ методов анализа данных и машинного обучения;
- практический опыт применения алгоритмов машинного обучения.
Будет плюсом:
- опыт использования специализированных data mining toolkits (scikit learn, vowpal wabbit, xgboost и т.п.);
- знание и опыт работы с реляционными СУБД, NoSQL-базами данных;
- стек технологий Hadoop (MapReduce, HBase, Pig, Spark);
- опыт работы c командной строкой Unix.
Бонусы
- комфортно работаем: просторные опенспейсы, звукопоглощающие панели, несколько десятков переговорных, дополнительные мониторы, мощное железо и макбуки, если нужно;
- вкусно кормят: в офисе есть ресторан с завтраками и обедами, а на каждом этаже есть 2 кухни, где всегда есть фрукты и ягоды, чай, кофе, кола и, конечно, печеньки;
- приятно отдыхаем: большая лаунж-зона, массажные кресла, бар со свежевыжатыми соками, качели, уголки с пледами и подушками, где можно отдохнуть, игровые приставки, кинотеатр;
- заботимся о здоровье: с первых дней работы мы даём отличную программу ДМС, включающую стоматологию и даже массаж;
- занимаемся спортом: бесплатный фитнес-зал в офисе (со всеми тренажерами и, конечно, душевыми), теннисные столы и даже футбольное поле;
- легко добираемся: мы находимся в пяти минутах ходьбы от м. «Аэропорт». Для тех, кто предпочитает добираться на работу на машине, у нас есть 5-этажная подземная парковка. И да, на ней есть места;
- профессионально развиваемся: в нашем офисе регулярно проходят семинары, тренинги, мероприятия для разработчиков ― Moscow.pm, CocoaHeadsMoscow, UX-среда и др. Конечно, мы отправляем сотрудников и на внешние профессиональные мероприятия.
Дополнительные инструкции
Мы будем рады вашему отклику и, при обоюдном интересе, предложим условия и проекты, от которых не захочется отказываться.
Кто такой Data Scientist в Big Data: профессиональные компетенции исследователя данных

В этом выпуске мы продолжаем введение в Data Science для чайников, разбирая профессии Big Data, и рассказываем, кто такой Data Scientist: что необходимо знать ученому по данным и чем исследователь отличается от аналитика.
Что делает ученый по данным
Как и Data Analyst, исследователь данных тоже работает с информационными массивами путем выполнения следующих операций:
- поиск закономерностей в информационных наборах;
- подготовка данных к моделированию (выборка, очистка, генерация признаков, интеграция, форматирование);
- моделирование и визуализация данных;
- разработка и тестирование гипотез по улучшению бизнес-метрик через построение моделей машинного обучения (Machine Learning).
Data Scientist, в большинстве случаев, ориентирован на предиктивную аналитику, тогда как аналитик данных чаще всего рассматривает информацию пост-фактум. Тем не менее, основная цель исследователя данных созвучна главной рабочей цели аналитика Big Data – извлечение из информационных массивов сведений, полезных для бизнеса с точки зрения принятия оптимальных управленческих решений.

Профессиональные компетенции исследователя данных: что должен знать Data Scientist
Чтобы решать вышеописанные задачи, ученый по данным должен быть компетентным в следующих областях знаний:
- информационные технологии – методы и средства интеллектуального анализа данных (Data Mining): алгоритмы и структуры данных, машинное обучение и другие разделы искусственного интеллекта (искусственные нейронные сети, генетические алгоритмы, deep learning), языки программирования (R, Python, Julia, Haskell), среды статистического анализа (R-Studio, MatLab, Jupyter Notebook);
- математика (статистика, теория вероятностей, дискретная математика);
- знание предметной области – отраслевая или корпоративная специфика.
Отметим, что, в отличие от аналитика данных, Data Scientist концентрируется на технических сторонах исследования информации, уделяя меньшее внимание системному анализу и бизнес-процессам.

Чем отличается аналитик Big Data от исследователя данных
На первый взгляд может показаться, что Data Scientist ничем не отличается от Data Analyst, ведь их рабочие обязанности и профессиональные компетенции частично пересекаются. Однако, это не совсем взаимозаменяемые специальности. При значительном сходстве, отличия между ними также весьма существенные:
- по инструментарию — аналитик чаще всего работает с ETL-хранилищами и витринами данных, тогда как исследователь взаимодействует с Big Data системами хранения и обработки информации (стек Apache Hadoop, NoSQL-базы данных и т.д.), а также статистическими пакетами (R-studio, Matlab и пр.);
- по методам исследований –Data Analyst чаще использует методы системного анализа и бизнес-аналитики, тогда как Data Scientist, в основном, работает с математическими средствами Computer Science (модели и алгоритмы машинного обучения, а также другие разделы искусственного интеллекта);
- по зарплате – на рынке труда Data Scientist стоит чуть выше, чем Data Analyst (100-200 т.р. против 80-150 т.р., по данным рекрутингового портала HeadHunter в августе 2019 г.). Возможно, это связано с более высоким порогом входа в профессию: исследователь по данным обладает навыками программирования, тогда как Data Analyst, в основном, работает с уже готовыми SQL/ETL-средствами.
На практике в некоторых компаниях всю работу по данным, включая бизнес-аналитику и построение моделей Machine Learning выполняет один и тот же человек. Однако, в связи с популярностью T-модели компетенций ИТ-специалиста, при наличии широкого круга профессиональных знаний и умений предполагается экспертная концентрация в узкой предметной области. Поэтому сегодня все больше компаний стремятся разделять обязанности Data Analyst и Data Scientist, а также инженера по данным (Data Engineer) и администратора Big Data, о чем мы расскажем в следующих статьях.

В области Big Data ученому по данным пригодятся практические знания по облачным вычислениям и инструментам машинного обучения. Эти и другие вопросы по исследованию данных мы рассматриваем на наших курсах обучения и повышения квалификации ИТ-специалистов в лицензированном учебном центре для руководителей, аналитиков, архитекторов, инженеров и исследователей Big Data в Москве:
- PYML: Машинное обучение на Python
- DPREP: Подготовка данных для Data Mining
- DSML: Машинное обучение в R
- DSAV: Анализ данных и визуализация в R
- AZURE: Машинное обучение на Microsoft Azure