Валидация (Validation)
В анализе данных термин валидация (от лат. validus – здоровый, крепкий, сильный) может использоваться в двух значениях.
- Валидация данных — процесс проверки того, что перед анализом данных была выполнена их очистка и предобработка, в результате которых был обеспечен достаточный уровень качества данных. Процесс валидации может применяться не только к собственно данным, но и к системам их ввода и регистрации.
- Валидация моделей — проверка правильности работы (предсказательной способности, точности) аналитической модели, построенной на основе машинного обучения. Проводится на независимом (т.е. не использовавшемся для обучения и тестирования) валидационном множестве после обучения и тестирования модели.
Валидация
Валидация — это проверка значений, указанных пользователем, и отображение найденных ошибок.
Описанное здесь поведение валидаций и отображение ошибок реализовано в библиотеке «React UI Validations», по возможности используйте эту библиотеку в продукте.
Принципы
- Ограничьте выбор заведомо неверных значений в списке: блокируйте эти значения или не показывайте в списке.
- Ограничьте ввод неподходящих символов. Если в поле нужно вводить только цифры, и это очевидно пользователю, игнорируйте ввод букв вместо того, чтобы показать ошибку. Используйте маски в полях, где у значений известен формат.
- Пишите подсказки для заполнения формы. Например, плейсхолдер в полях ввода.
Валидация на только что открытой пустой форме запрещена. Исключение — черновики, когда пользователь уже заполнял эту форму, через какое-то время вернулся к ней, а она заполнена с ошибками.
Виды валидации
Существует три вида валидаций: мгновенная, по потере фокуса и по отправке формы.
Чем раньше интерфейс сообщает об ошибке, тем лучше — пользователю проще вернуться и исправить ошибку.
Самый быстрый способ сообщить об ошибке — мгновенная валидация. Но она возможна только в тех случаях, когда в процессе ввода понятно, что значение некорректное. Обычно такие ошибки связаны с неправильной раскладкой клавиатуры (кириллица вместо латиницы) или вводом букв в цифровое поле (ИНН, КПП и др.) Для этих случаев мы используем поля с масками: ввод неподходящих символов в них заблокирован. Поэтому в наших интерфейсах есть только два вида валидации:
- по потере фокуса — основной вид валидации
- по отправке формы — для тех случаев, когда валидация по потере фокуса невозможна.
Валидация по потере фокуса
Когда использовать
Этот вид валидации подходит для большинства случаев.
Как работает
Не валидируйте поля на пустоту по потере фокуса — не показывайте ошибку если поле не заполнено, возможно пользователь вернется и заполнит поле чуть позже. Показывать ошибку в таких случаях можно только после отправки формы.
Валидация срабатывает сразу после потери фокуса, если значение в поле заполнено. Если найдена ошибка, поле подсвечивается красным. Фокус в это поле автоматически не возвращается:

Текст ошибки появляется в тултипе, когда поле получает наведение или фокус:
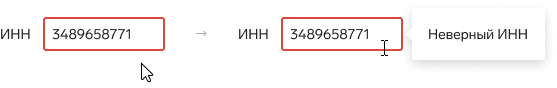
Поле с ошибкой должно остаться подсвеченным, если оно получило фокус, его значение не исправляли, а затем оно потеряло фокус.
Красная подсветка снимается с поля, как только пользователь начал исправлять ошибочное значение.
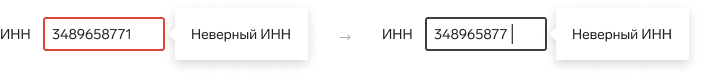
Валидация при отправке формы
Когда использовать
Используйте этот вид валидации, когда нельзя проверить поля по потере фокуса. Например, для проверки заполнения обязательных полей.
Как работает
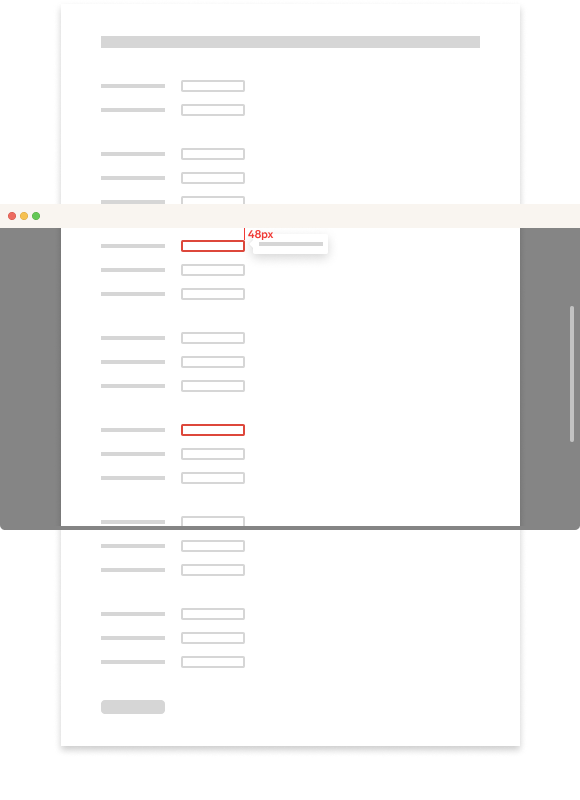
Проверка происходит после того, как пользователь нажал кнопку отправки данных: все поля с ошибками на форме подсвечиваются, страница прокручивается к первому полю с ошибкой, фокус перемещается в это поле, курсор встает в конец строки, рядом с полем появляется тултип с подсказкой.
При прокрутке к первому полю от верхней границы окна до ошибочного поля остается отступ 48px — шесть модулей.
Блокирование кнопки отправки
В небольших формах вместо проверки заполнения обязательных полей можно блокировать кнопку отправки формы. Используйте это поведение, когда очевидно, почему кнопка отправки формы неактивна. Например, на форме входа:
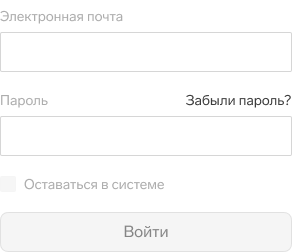
Как только заполнены все обязательные поля — кнопка становится активной. Если после этого пользователь стер значение в одном из полей — кнопка снова должна стать не активной.
Сообщения об ошибках
Об ошибках можно сообщать двумя способами:
- Красным текстом около поля, обычно под полем или справа от него:
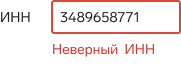
- Текстом в тултипе:
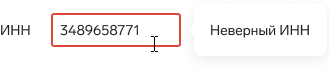
Из этих двух способов мы рекомендуем использовать тултипы. Они идут отдельным слоем, поэтому не раздвигают форму и легко размещаются, даже если поля на форме расположены плотно.
Тултипы
Как работают
Тултип с подсказкой появляется в двух случаях:
- При наведении на поле с ошибкой.
- Когда поле с ошибкой получает фокус.
Если значение в поле с ошибкой было изменено, потеряло фокус, а потом заново оказалось в фокусе — тултип с текстом старой ошибки уже не возникает. Это правило одинаково работает для всех типов валидаций: и по потере фокуса, и при отправке формы.
Тултип исчезает, когда:
- Курсор вышел из области поля с ошибкой.
- Поле с ошибкой потеряло фокус.
Тултип по наведению перекрывает тултип по фокусу.
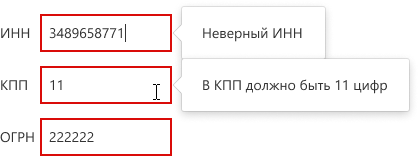
Тултип может появляться сверху или справа от контрола с ошибкой, так чтобы он не перекрывал полезную информацию:
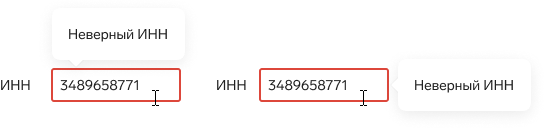
Единообразие поведения и внешнего вида
Показывайте тултипы справа от полей. Eсли в этом случае они перекрывают важное содержимое на странице, выводите тултипы сверху. Придерживайтесь единообразия, но помните, что контент важнее него.
Красные тексты на странице
Как работают
Красный текст ошибки появляется сразу, как только произошла валидация и ошибочное поле подсветилось.
Как только пользователь начал исправлять значение, красная подсветка поля исчезает.
Текст ошибки пропадает по потере фокуса и больше не появляется, если поле заново получает фокус. Это правило одинаково работает для всех типов валидаций: и по потере фокуса, и при отправке формы.
Выводите текст ошибки справа, если на форме есть место, а само сообщение короткое. Так форму не придется раздвигать, чтобы показать ошибку.
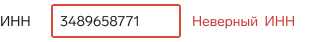
Если справа от поля нет места для текста, раздвигайте форму и выводите сообщение под полем.
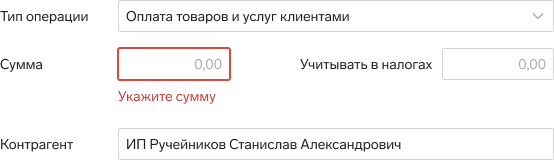
На более сложных формах выводите сообщение об ошибке в тултипе.
Валидация зависимых полей
Зависимые поля — это поля, значение которых зависит друг от друга.
Ошибки, которые связаны с нарушением зависимости полей, мы показываем после отправки формы. Например, ИНН и КПП. Если пользователь указал ИНН из 10 цифр, а поле с КПП оставил пустым, после отправки формы пустое поле с КПП будет подсвечено.
ИНН может быть двух видов:
- 10-значный у юридических лиц
- 12-значный у ИП.
Если пользователь указал ИНН из 12 цифр, значит организация — индивидуальный предприниматель, и у нее нет КПП, значит поле КПП заполнять не нужно. И наоборот, если заполнено КПП, а ИНН указан 12-значный, возможно неверно указан ИНН.
Подсветка зависимых полей пропадает, как только пользователь начал исправлять значение в одном из этих полей.
Если при заполнении зависимого поля нарушен формат значения, сообщайте о такой ошибке при потере фокуса. Например, пользователь ввел 3 цифры в поле ИНН и убрал фокус. Такое поле должно подсветиться сразу же.
Пример
Есть форма из 5 полей:
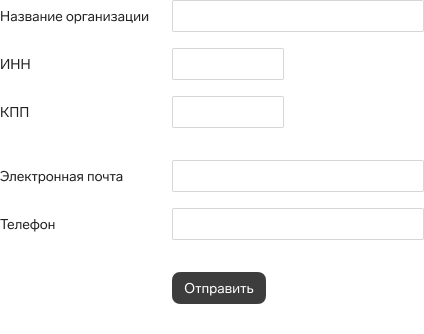
- Название организации — простое текстовое, обязательное
- ИНН — 10 или 12 цифр, проверка контрольной суммы по потере фокуса, обязательное
- КПП — 9 цифр с проверкой контрольной суммы по потере фокуса, обязательное, если ИНН состоит из 10 цифр
- Электронная почта — адрес почты, проверка по потере фокуса по маске a@a.aa, необязательное
- Телефон — международный формат, проверка по потере фокуса по маске +00000000000, обязательное
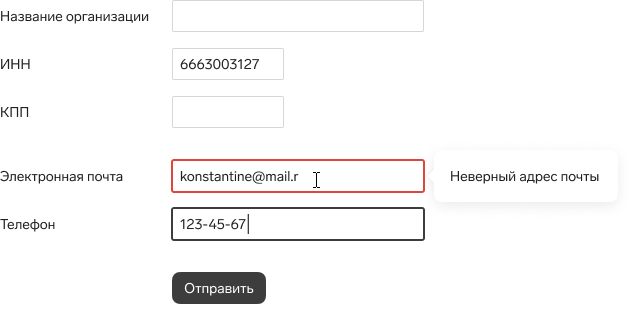
Пользователь пропустил поле с названием организации, заполнил ИНН значением из 10 цифр, перешел в поле почты, указал некорректный адрес, перешел в поле с телефоном и указал некорректный номер, но из поля пока не ушел:
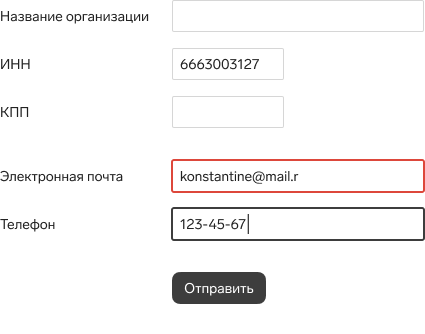
Пользователь навел курсор на поле с почтой, появился тултип. Но исправлять значение пользователь не стал:
Пользователь нажал кнопку «Отправить» — фокус перешел в поле «Название организации», так как оно обязательное и незаполненное:
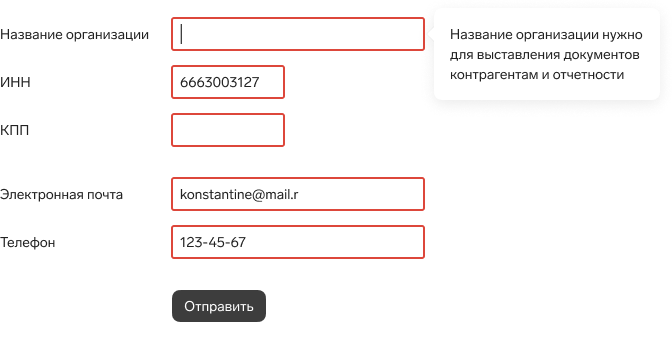
Поле с телефоном также подсветилось красным, так как заполнено некорректно. ИНН и КПП подсветились, так как ИНН состоит из 10 цифр, значит должен быть заполнен и КПП — валидация зависимых полей произошла только после отправки формы.
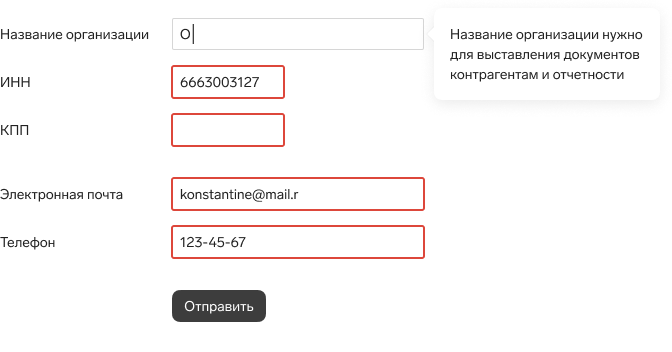
Пользователь начинает вводить название организации, подсветка поля гаснет, а текст подсказки остается:
Заполнил название организации, перешел в поле ИНН:
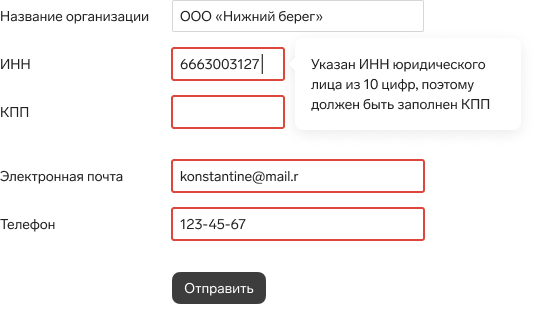
Понял, что ИНН правильный, и нужно заполнить КПП:
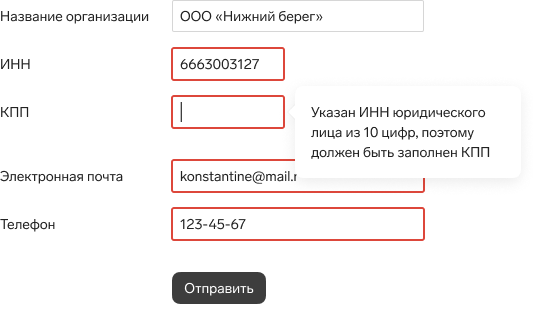
Начал заполнять поле КПП. Красная рамка у ИНН и КПП исчезла — пользователь изменил значение в одном из зависимых полей:
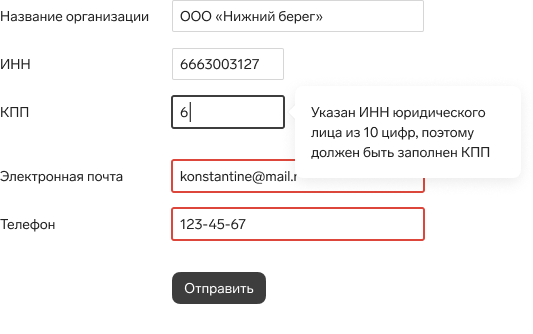
Заполнил КПП, перешел в следующее поле:
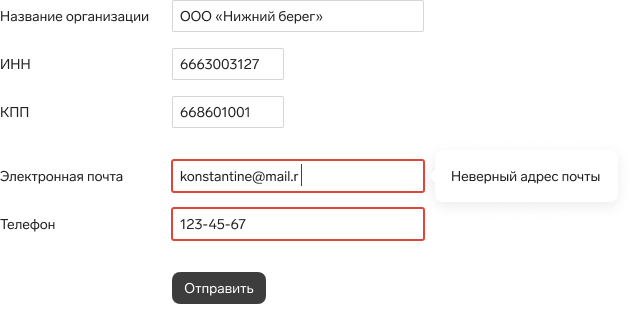
Исправил почту, перешел в следующее поле:
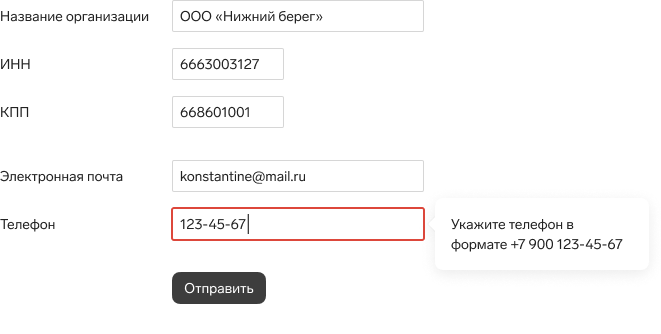
Исправил телефон, кликнул за пределами поля:
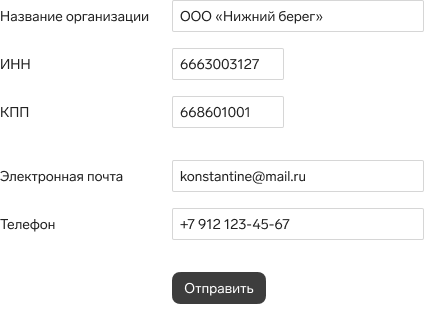
Теперь по нажатию кнопки «Отправить» все будет хорошо.
Реализованный пример этой формы можно посмотреть в библиотеке валидаций.
Валидация данных
Привет, Хабр! В преддверии старта курса «Архитектор сетей» предлагаем прочитать перевод полезной статьи.
Оптимизация модели данных и удаление повторений — это, конечно, здорово, но каким образом мы можем убедиться, что работаем с валидной моделью данных?
На этот вопрос легко ответить в рамках традиционной реализации IPAM/CMDB с использованием внутренней базы данных и пользовательской логики обработки данных, предлагающей REST API, графический интерфейс или и то, и другое. Пользовательская логика обработки данных проверяет данные перед их вводом в базу данных, и, таким образом мы получаем гарантию того, что база данных содержит синтаксически и семантически допустимые данные.
В более простом решении, использующем текстовые файлы для хранения сетевой модели данных (также известной как источник истины или source-of-truth), сложно выполнить тщательную проверку каждой транзакции, тем более, если для изменения этих файлов вы используете текстовый редактор. В этих случаях вам нужно писать собственный конвейер валидации, используя инструменты, которые проверяют:
- синтаксис текстового файла;
- соответствие схеме модели данных;
- ссылочную целостность.
Используя нашу последнюю модель данных с per-link префиксами, которые хранятся как куча Ansible host_vars файлов и network.yml файл, конвейер валидации должен проверить что:
- Все файлы соответствуют синтаксису YAML (чтобы сделать это, вы можете использовать такие инструменты как yamllint );
- Факты о хостах содержат значения hostname и bgp_as для каждого хоста;
- Сетевая модель данных содержит значение links , которое представляет из себя массив core и edge ссылок;
- Core ссылки содержат prefix и как минимум два других значения;
- Edge ссылки содержат одно значение, которое является словарем (или объектом, если вы предпочитаете терминологию JSON) с одним значением.
Для выполнения этих тестов вы можете написать небольшую программу на любом языке программирования или же использовать языки моделирования данных (также называемые схемами), такие как YANG, JSON Schema или XML Schema, которые наложат большинство необходимых проверочных ограничений. Поскольку файлы YAML легко преобразовать в JSON, мы будем использовать jsonschema .
Зачастую проверить ссылочную целостность с помощью языка моделирования данных бывает сложно. Для этого вам, возможно, придется написать свое собственное программное решение, но, по крайней мере, вы можете спихнуть скучную рутину проверки структур и форматов данных на стороннее решение.
Валидация данных хоста
Первым этапом в нашей логике валидации модели данных будет проверка фактов хоста Ansible. Эти факты часто расползаются по нескольким файлам и каталогам или генерируются «на лету» с помощью внешнего скрипта или плагина Ansible. Таким образом, лучший способ получить их — передать задачу программе ansible-inventory , которая создает JSON структуру данных в соответствии с требованиями внешнего инвентарного скрипта (external inventory script).
$ ansible-inventory -i ../hosts --list < "_meta": < "hostvars": < "S1": < "bgp_as": 65001, "description": "Unexpected", "hostname": "S1" >, "S2": < "bgp_as": 65002, "hostname": "S2" >> >, "all": < "children": [ "ungrouped" ] >, . Из полученной JSON структуры данных нам нужно извлечь только переменные хоста, и jq идеально подходит для этой работы:
$ ansible-inventory -i ../hosts --list|jq ._meta.hostvars < "S1": < "bgp_as": 65001, "description": "Unexpected", "hostname": "S1" >, "S2": < "bgp_as": 65002, "hostname": "S2" >>Если мы хотим использовать утилиту командной строки jsonschema , нам необходимо сохранить результаты в текстовом файле, а затем вызвать утилиту jsonschema с именем текстового файла и файла JSON Schema, в соответствии с которым следует проверить данные.
$ jsonschema -i /tmp/hosts.json hosts.schema.json : Additional properties are not allowed ('description' was unexpected)Валидация сетевой модели данных
Для проверки network.yml файла мы будем использовать аналогичный подход:
- Convert YAML file into JSON format with yq
- Преобразуем YAML файл в формат JSON с помощью yq
- Run jsonschema on the resulting JSON file
- Запустим jsonschema на полученном JSON файле
yq /tmp/$$.network.json jsonschema -i /tmp/$$.network.json network.schema.jsonКак упоминалось выше, JSON Schema позволяет нам проверять грамматику модели данных, а ссылочную целостность — нет. Например:
- Мы не можем проверить, валидны ли имена хостов, указанные для core или edge ссылок.
- Хотя мы можем проверить формат имени интерфейса, у нас нет средств, позволяющих проверить, обладают ли устройства интерфейсами, которые мы хотим использовать, без подключения к сетевым устройствам или извлечения данных из системы управления сетью.
Пару слов о JSON Schema
Языки моделирования данных не для слабонервных, и JSON Schema не исключение. Замысловатая подача спецификации тоже не особо облегчает жизнь (мне было интереснее читать стандарты ISO или IEEE). К счастью, онлайн-книга Разбираемся с JSON Schema довольно хорошо объясняет все тонкости.
Просто чтобы вы прочувствовали, что такое JSON Schema: вот документ JSON, описывающий ожидаемую структуру данных переменных хоста, полученный из инвентаря Ansible:
< "$schema": "http://json-schema.org/draft-07/schema#", "$id": "https://www.ipSpace.net/hosts.schema.json", "title": "Ansible inventory data", "definitions": < . >, "type": "object", "patternProperties": < ".*" : < "$ref" : "#/definitions/router" >>, "minProperties": 1 >Вот что можно сказать об этой схеме:
- Она описывает инвентарные данные Ansible (Ansible inventory data);
- Она содержит определения дополнительных схем (см. ниже).
- Элемент верхнего уровня — это объект (словарь) с некоторыми свойствами (мы знаем, что это инвентарные имена хостов), и каждое свойство должно соответствовать схеме router
- Минимальное количество свойств — одно (хотя бы один хост в файле инвентаризации).
Определение схемы router находится в свойстве definitions :
"router" : < "type" : "object", "properties": < "bgp_as": < "type": "number", "minimum": 1, "maximum": 65535 >, "hostname": < "type": "string" >>, "required": [ "bgp_as","hostname" ], "additionalProperties": false >Согласно этой схеме роутер (если быть точнее, факты хоста Ansible, описывающие роутер) — это объект со следующими свойствами:
- Числовым свойством bgpas , которое должно быть от 1 до 65535;
- Строковым свойством hostname
- Оба свойства являются обязательными, и в объекте не должно быть других свойств.
Закатываем рукава
JSON схемы хоста и сети, а также исходный код скрипта проверки доступны на GitHub. Не стесняйтесь клонировать репозиторий, менять host_vars файлы или сетевую модель данных и запускать скрипт проверки в своих целях.
Вам также может захотеться исследовать JSON Schema побольше, в частности:
- выяснить, что делает JSON схема network ;
- добавить необязательное свойство description в модель данных роутера;
- скорректировать валидацию свойства bgp_as , чтобы разрешить 4-байтовые AS номера в точечной нотации.
Вам понадобятся следующие инструменты:
Больше о валидации данных
Мы рассматриваем валидацию данных и конвейеры CI/CD более подробно в части Validation, Error Handling and Unit Tests нашего онлайн-курса Building Network Automation Solutions.
Дополнительная информация
- Код из этой статьи опубликован на GitHub.
- Чтобы узнать больше об использовании моделей данных в решениях для автоматизации сети, ознакомьтесь с модулем 3 нашего онлайн-курса Building Network Automation Solutions.
Далее в программе
- Data Model Hierarchy
- Иерархия моделей данных
Подробнее о курсе «Архитектор сетей». Посмотреть запись открытого урока на тему «Overlay. Что это такое и зачем необходимо» можно здесь.
- json schema
- json
- валидация данных
- архитектура сетей
Валидация данных: Что это такое, важность, типы, плюсы и минусы

Бизнесмены полагаются на высококачественные данные для принятия важных стратегических решений. Конечные пользователи теряют доверие к данным, когда они неточны и неполны, что ограничивает их использование.
Предприятия используют проверку данных для повышения качества данных, обеспечивая их правильность и полноту. Валидация данных — это набор методов и процессов, которые команды по работе с данными используют для поддержания высокого качества своих данных.
Теперь давайте обсудим, почему предприятия и команды по работе с данными должны проверять свои данные. Мы также поговорим о ее типах, плюсах и минусах.
Что такое проверка данных?
Проверка данных — это процесс проверки данных на соответствие требованиям путем сравнения их с набором правил, которые уже установлены или определены. Эта процедура подразумевает выполнение серии проверок, известных как процедуры проверки. Простые проверки гарантируют, что дата рождения содержит только цифры, а более сложные проверки включают структурированные условные проверки.
Проверка данных позволяет убедиться в том, что данные чистые, точные и пригодные для использования. Импортировать, сохранять или использовать следует только проверенные данные; в противном случае программы могут перестать работать, результаты могут быть ошибочными (например, если модели обучаются на плохих данных), или могут возникнуть другие потенциально катастрофические проблемы.
Важность проверки данных
Проверка данных поможет вам быстрее найти ошибки, так что вам не придется играть в кошки-мышки, чтобы их обнаружить. Это также может сэкономить вам время при очистке некачественных данных. Кроме того, валидация данных очень важна во многих отношениях. В этом разделе мы обсудим некоторые из наиболее важных аспектов:
- Аналитики могут ограничить количество неточных данных в своем хранилище путем валидации данных. Организации должны совместно работать над валидацией данных, чтобы получить максимальную отдачу от этого процесса.
- Валидация точности, ясности и специфичности данных необходима для устранения любых проблем проекта. Без проверки данных вы рискуете принимать решения на основе неточных, нерепрезентативных данных.
- Валидация данных используется в процессе ETL (извлечение, перевод и загрузка) и в хранилищах данных. Она позволяет аналитику лучше понять масштаб конфликтов данных.
- Также важно тестировать модель данных. Если модель данных настроена и структурирована правильно, можно использовать файлы данных в различных программах и приложениях.
- Валидирование данных также может выполняться для любых данных, включая данные, содержащиеся в одном приложении, таком как MS Excel, или простые данные, смешанные вместе в одном хранилище данных.
Типы валидации данных
Валидирование данных бывает разных форм. Большинство процессов валидации данных выполняют одну или несколько проверок перед сохранением данных в базе данных. Вот некоторые распространенные типы проверок валидации данных:
- Проверка типа данных
Проверка типа данных позволяет убедиться, что тип введенных данных правильный. Например, поле может принимать только числовые данные. В этом случае система должна отклонить любые данные, содержащие другие символы, например буквы или специальные символы.
Проверка кода гарантирует, что значение поля взято из допустимого списка или правильно отформатировано. Например, легче понять, является ли почтовый индекс правильным, если сравнить его со списком правильных кодов.
- Проверка диапазона
Проверка диапазона используется для проверки данных, которые должны находиться в определенном диапазоне. Существует определенная нижняя и верхняя граница для разумных значений. Например, ученику начальной школы, скорее всего, от 10 до 14 лет. Компьютер можно настроить так, чтобы он принимал только числа от 10 до 14.
- Проверка формата
Многие типы данных имеют уже заданный формат. Столбцы дат, которые хранятся в фиксированном формате, например ГГГГ-ММ-ДД или ДД-ММ-ГГГГ, являются распространенным примером. Процесс проверки данных, который проверяет правильность формата дат, помогает сохранить согласованность данных и времени.
- Проверка согласованности
Проверка согласованности — это тип логической проверки, которая позволяет убедиться, что введенные данные имеют смысл. Одним из примеров является проверка того, что дата доставки находится после даты отгрузки.
- Проверка уникальности
Адреса электронной почты и идентификаторы — два примера данных, которые естественным образом являются уникальными. Эти поля должны иметь только одну запись в базе данных. Проверка уникальности гарантирует, что элемент не будет помещен в базу данных более одного раза.
Плюсы и минусы валидации данных
С помощью тестирования валидных данных предприятия могут убедиться в правильности и достоверности своих баз данных и принимать более эффективные решения. Если вы принимаете решение о валидации данных для своего бизнеса, вот плюсы и минусы каждого из них:
Проверка точности данных
Валидация данных делает большую часть тяжелой работы по обеспечению целостности данных. Валидация не изменит и не улучшит ваши данные, но при правильной настройке она гарантирует, что они служат по назначению.
Помогает управлять несколькими источниками данных
Валидация данных становится все более важной по мере увеличения количества источников данных. Предположим, вы импортируете данные о клиентах из разных каналов; вам необходимо одновременно проверить все эти данные на соответствие одной и той же стратегии отслеживания. В противном случае между наборами данных могут возникнуть конфликты и ошибки.
Экономия времени
Валидация данных требует времени, но после ее проведения вам не придется ничего менять, пока не изменятся ваши исходные данные или требования.
Сложность
Валидировать данные сложно при наличии нескольких сложных источников данных. Многие корпоративные платформы, такие как Segment, включают мощные инструменты валидации для больших приложений с несколькими источниками данных, которые могут помочь в этой ситуации.
Ошибки валидации данных
При валидации могут возникать ошибки; не все программы валидации совершенны. Почти наверняка будут ошибки валидации, которые необходимо исправить.
Изменяющиеся потребности
Одна из самых больших проблем с валидацией данных заключается в том, что после внесения определенных изменений их необходимо повторно валидировать. Модели схем и документация по отображению должны обновляться по мере появления типов данных и вводимых данных.
Вывод
Из вышеприведенной статьи мы узнали о валидации данных, ее важности, типах, плюсах и минусах. Валидация данных — важный шаг в управлении ими, и она часто выполняется как часть очистки данных. Цель проверки данных — обеспечить их высокое качество, чтобы им можно было доверять и уверенно использовать.
может помочь вам в процессе проверки данных. предлагает различные функции проверки данных, включая настройку типов данных, диапазонов, шаблонов и обязательных полей для вопросов опроса.
Эти функции помогают пользователям обеспечить достоверность, точность и последовательность данных, полученных в ходе опросов, и гарантировать, что на них можно положиться при принятии решений и анализе. Свяжитесь с или попросите бесплатную демонстрацию, чтобы узнать больше.
Ключевые слова: