Сохранить копию сайта в веб архив Internet archive Wayback Machine
В интернете существует очень интересный и полезный проект — веб архив, полностью — Internet archive Wayback Machine.
В веб архиве, расположенным по адресу: http://archive.org/web/, сохраняется прошлое сайтов в виде полноценных и работающих страниц, со всеми ссылками, изображениями, видео. В общем можно увидеть, какой был сайт в прошлом на дату формирования копии.
Боты архив-машины самостоятельно сканируют сайты и формируют их копии, каков их алгоритм — не известно. Поэтому в архиве можно найти много копий своего сайта со всеми страницами или всего одну, да и то искажённую.
Предположить, в каком виде загрузится и отобразится тот или иной сайт — невозможно. Но как правило, машина периодически сохраняет полноценные копии всего сайта и даже может выдать страницы, которых у вас не было никогда.
Если вы не хотите отдавать судьбу своего сайта в руки ботов ресурса, то можно самостоятельно занести страницу в архив, и в случае непредвиденных случайностей, найти и восстановить её.
Как увидеть архив своего сайта
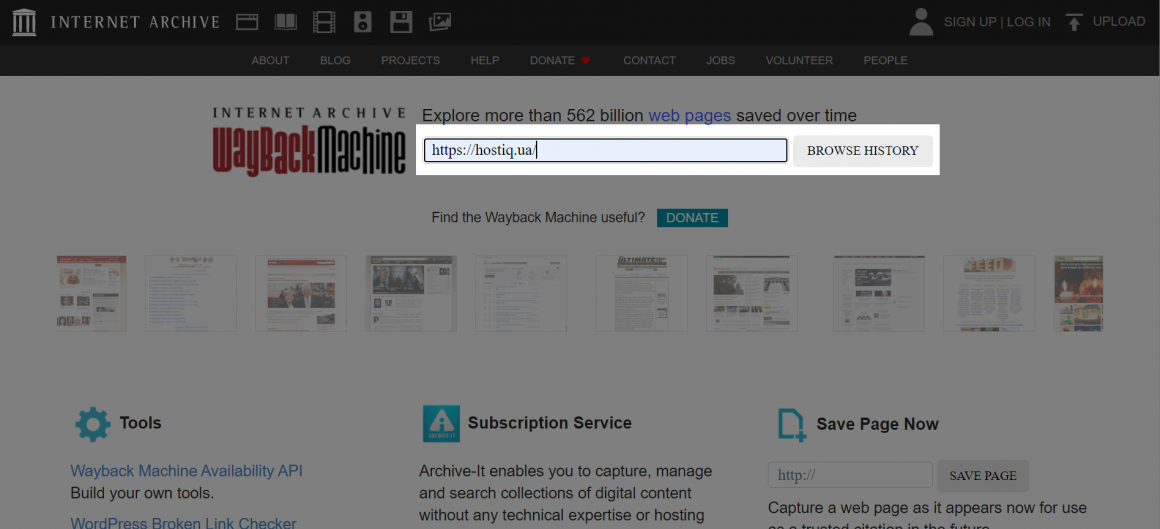
Откройте Internet archive и в строке поиска введите адрес сайта, далее нажмите « browse history »

Здесь будет показано, сколько копий, в каком году и в каком месяце сохранено в архиве.
Выбрав дату и нажав на эти кнопки, можно увидеть копию сайта на тот момент времени.

Как занести сайт в архив
Для этого откройте главную страницу Internet archive Wayback Machine: http:// archive.org/web/.
Далее в рубрике Save Page Now введите адрес архивируемой страницы и нажмите «SAVE PAGE». Через несколько секунд копия буде сохранена.
Как запретить архивировать мой сайт
Что за дело, кто без моего спроса меня сосчитал? Если вы так думаете, то можно запретить веб-машине сохранять копии вашего сайта
Для этого в файле robots.txt нужно прописать запрещающую директиву для ботов wayback machine.
Чтобы позволить архивировать сайт снова, уберите эти строки из файла robots.txt и лучше сразу добавьте главную станицу в архив. Иначе изменений можно дожидаться долго, обновления в системе происходят редко.
Что такое веб-архив и как его использовать
Веб-архив сайтов или Web Archive — это сервис, который собирает и хранит копии сайтов. Это своего рода машина времени интернета, которая позволяет отследить развитие веб-ресурса с начала его создания, просмотреть уже несуществующий сайт, а также восстановить его даже при отсутствии резервной копии.
В этой статье вы найдете обзор базовых возможностей веб-архива сайтов и детальные инструкции по использованию сервиса.
Из статьи вы узнаете
- Что такое Web Archive и зачем он нужен
- Как пользоваться веб-архивом
- Как сохранить текущую версию сайта в веб-архиве
- Как запретить добавление сайта в веб-архив
- Как восстановить сайт из веб-архива
- Что запомнить о веб-архиве
Что такое Web Archive и зачем он нужен

Архив интернета — это некоммерческая библиотека книг, программного обеспечения, сайтов, аудио- и видеозаписей. Наиболее популярный проект — Wayback Machine, также известный как веб-архив сайтов.
Это бесплатный сервис, где собраны архивные копии веб-ресурсов за разные даты. Копии появляются при сохранении вручную, а также когда веб-краулеры посещают сайт.
Веб-краулер, он же паук или бот — это программа, которая посещает сайты, оценивает содержимое, а затем переносит их в базу поисковых систем или веб-архива, как в нашем случае.
С помощью интернет-архива можно узнать, как выглядел сайт раньше: месяц или несколько лет назад.
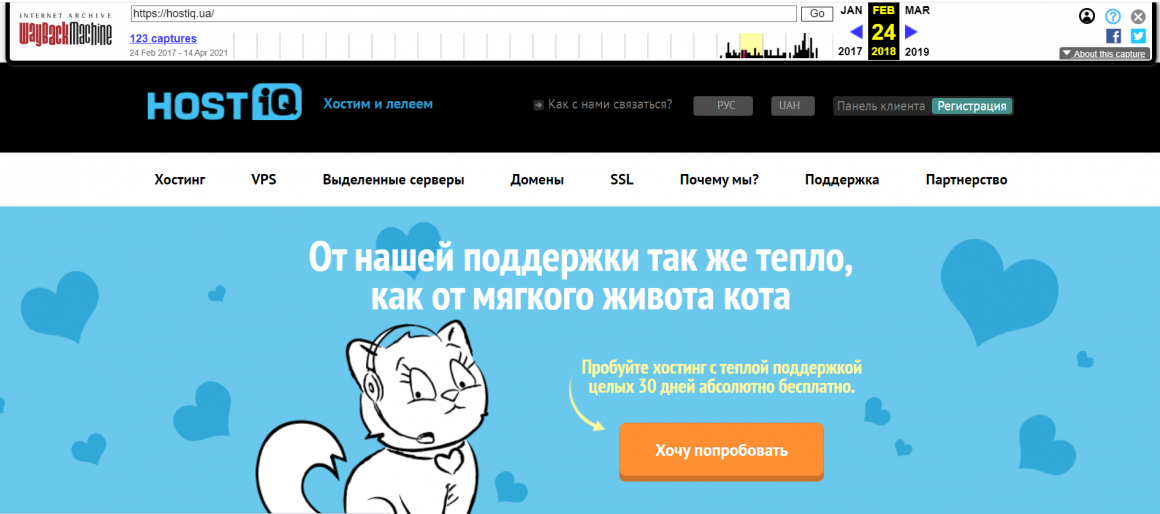
Именно это и было изначальной целью проекта. Однако за последнее время функций у машины времени сайтов стало больше.
Веб-архив сайтов используют, чтобы:
- просмотреть, как сайт выглядел раньше;
- восстановить сайт, даже если у вас нет резервной копии;
- проанализировать изменения ресурса в определенный период;
- найти уникальную информацию, которую удалили;
- проверить репутацию доменного имени перед регистрацией — если ранее его использовали для размещения сомнительного контента, могут возникнуть трудности и сейчас.
Статья по теме:
Как пользоваться веб-архивом
Интерфейс веб-архива сайтов интуитивный в использовании.
Перейдите на страницу машины времени сайтов, укажите URL-адрес и нажмите «BROWSE HISTORY»:
По умолчанию веб-архив подгружает секцию «Calendar», где можно посмотреть старые версии нужного сайта:
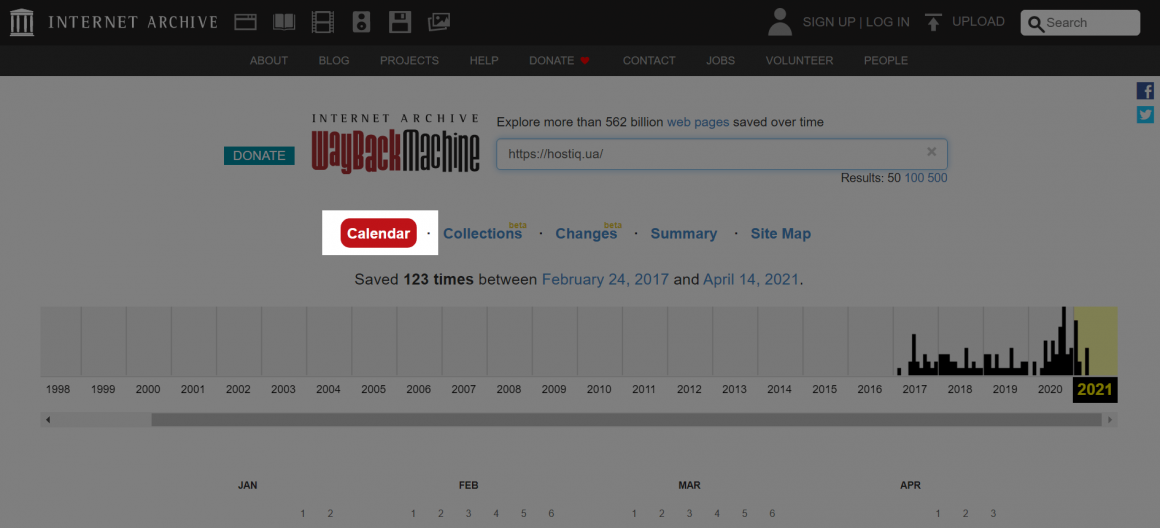
После обработки запроса вы сразу же увидите общую информацию о веб-странице: количество сгенерированных архивов и шкалу времени, начиная с первой копии по текущий момент:
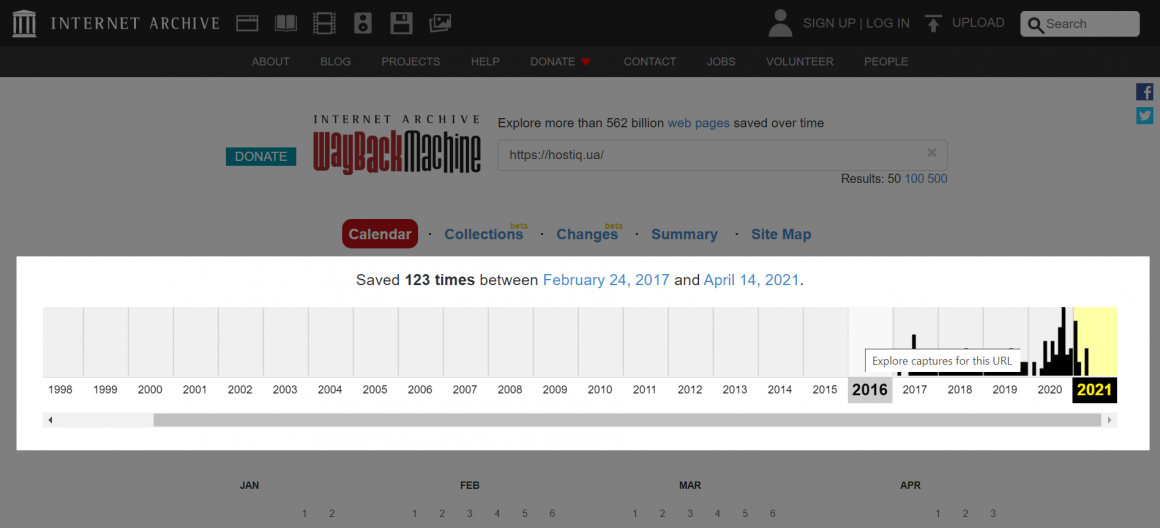
Выберите год на шкале времени. Ниже вы увидите календарь, где цветными маркерами обозначены даты, когда веб-краулеры интернет-архива сканировали страницу:
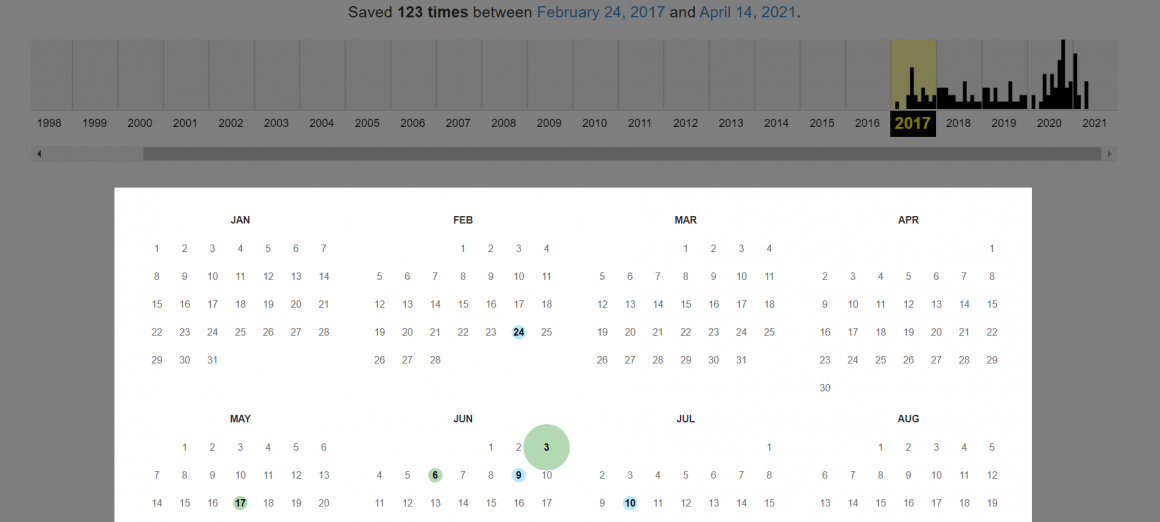
Маркеры отмечены одним из четырех цветов:
- Синий значит, что веб-краулер получил в ответ код со статусом 200 OK, то есть сайт стабильно работал.
- Зеленый соответствует коду 3хх — в тот момент создания копии на сайте был настроен редирект.
- Оранжевый и красный цвета значат, что веб-ресурс был недоступен, и веб-краулер получил код ошибки 4хх и 5хх.
Диаметр круга зависит от количества обращений робота веб-архива к странице в этот день. Чем больше круг, тем больше копий за этот день создал веб-краулер.
Попробуйте хостинг с кучей плюшек: автоустановщиком 330 движков, конструктором сайтов и теплой поддержкой 24/7!
Выбрав дату, наведите курсор на нее и нажмите на время сохранения:
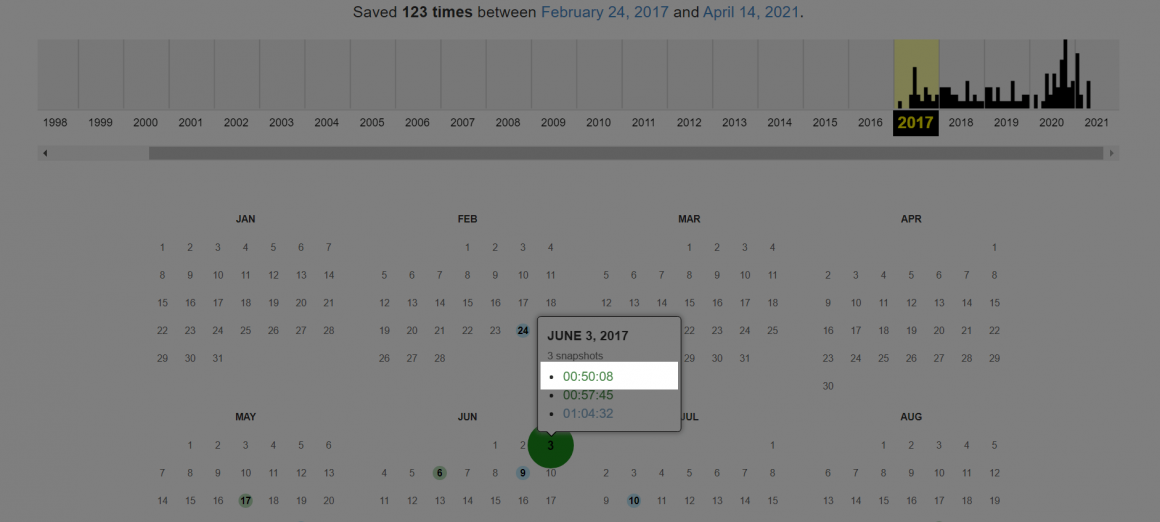
Вы увидите желаемую версию веб-страницы.
Бывают ситуации, когда в интернет-архиве нет старых версий ресурса: правообладатель потребовал удалить принадлежащий ему контент или сайт закрыт из-за нарушения закона о защите интеллектуальной собственности. Дополнительно, на сайте могут быть настройки, которые ограничивают работу веб-краулеров. Таким образом, боты его не сканируют.
Иногда нужный ресурс доступен, но в копии нет картинок или части контента. Это происходит, если сайт был не полностью заархивирован Wayback Machine. В таком случае попробуйте открыть версию сайта за другой день.
Дополнительную информацию о сайте можно найти в секциях «Summary» и «Site Map»:
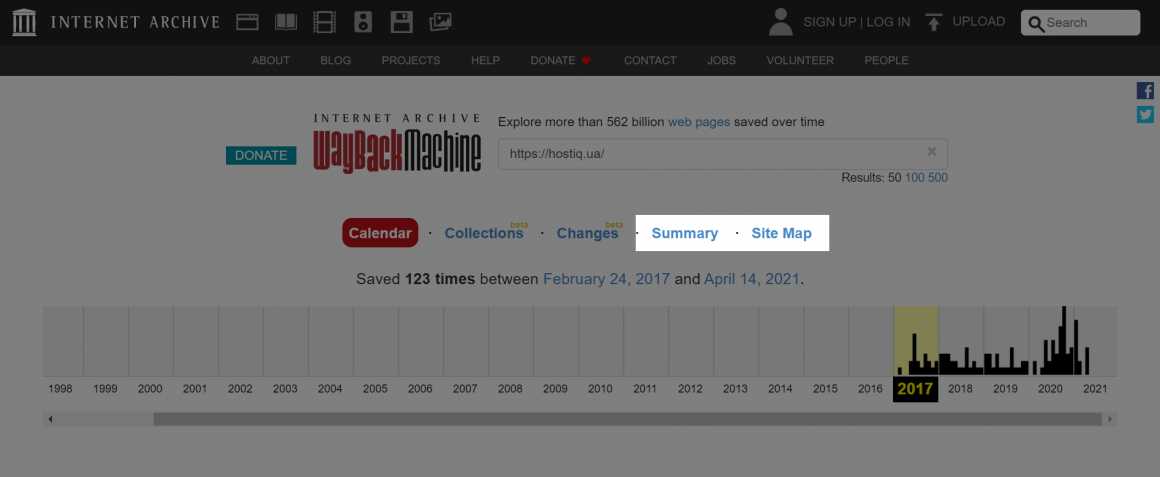
В секции «Summary» собрана статистика по типу файлов, например HTML, CSS, PNG, на вашем сайте.
Функционал секции «Site Map» группирует все архивы нужного ресурса по годам, а затем строит визуальную карту сайта — радиальную диаграмму. Центральный круг — это «корень» сайта, его главная страница. Следующие кольца — остальные страницы. При наведении курсора на кольца и ячейки обратите внимание, что URL-адреса вверху меняются. Вы можете выбрать страницу, чтобы перейти к архиву этого URL-адреса.
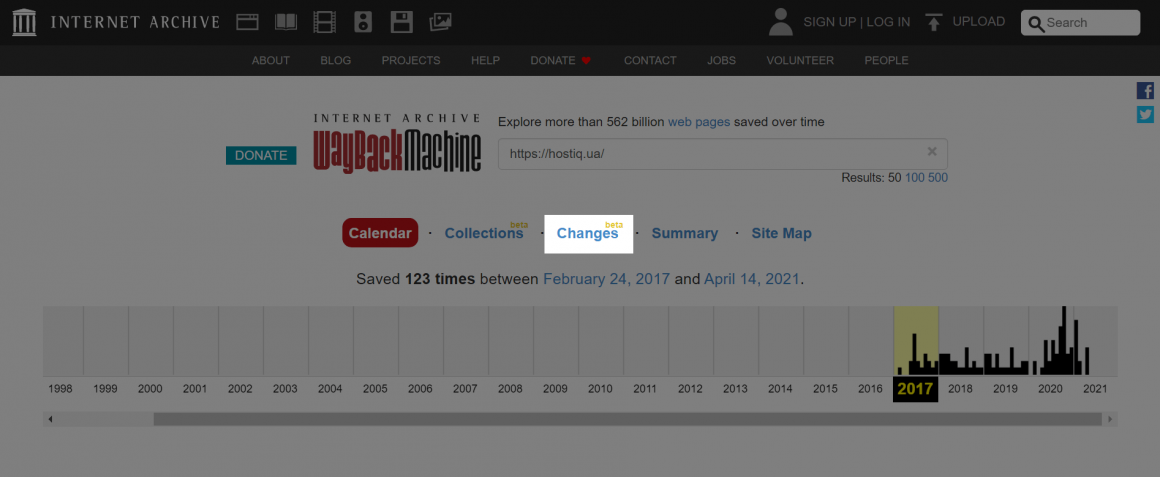
Чтобы выявить и отобразить изменения в содержимом архивов, используйте секцию «Changes»:
Выберите две даты и нажмите кнопку «Compare»:
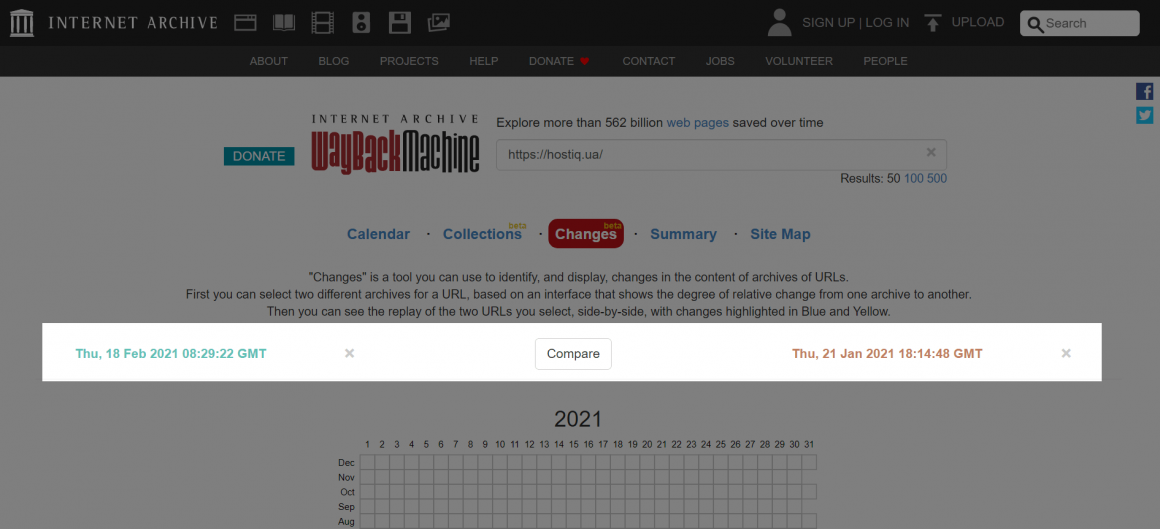
На новой странице появятся две версии сайта. Удаленный контент окрашен в желтый цвет. Синий указывает на добавление содержимого.
Как сохранить текущую версию сайта в веб-архиве
Копии сайтов попадают в веб-архив благодаря веб-краулерам, которые их сканируют. Однако это не единственный способ. Просканировать сайт можно самостоятельно.
Чтобы создать копию одного URL-адреса, найдите опцию «Save page now» на главной странице Wayback Machine, введите ссылку и нажмите «Save page»:
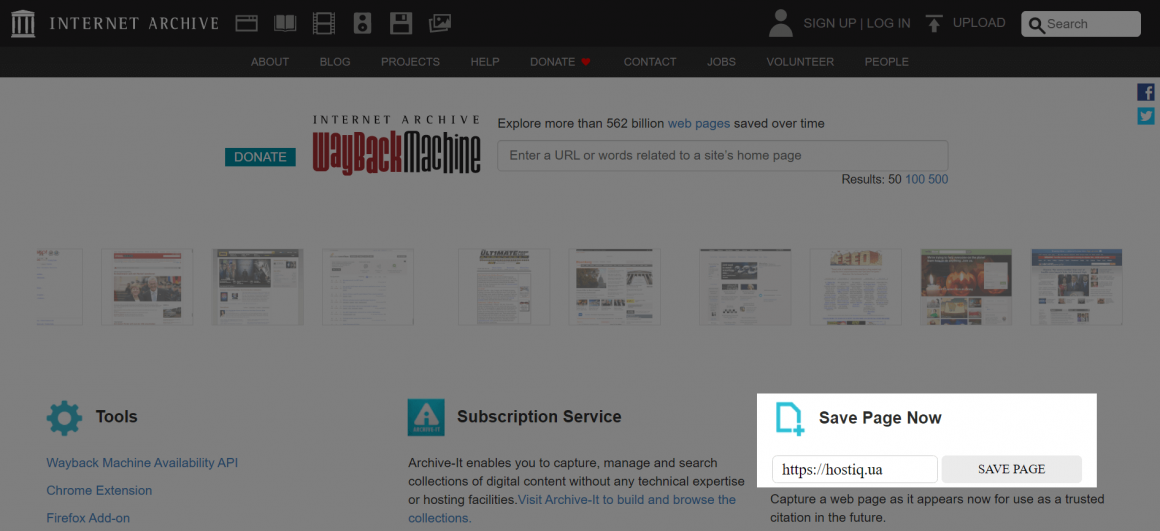
Таким образом, в веб-архив сайтов добавится текущая версия заданного URL-адреса.
Повторяйте это действие перед важными изменениями на сайте и после них. В случае поломки или утери данных вы всегда сможете восстановить сайт через веб-архив.
Создавать копию всего сайта постранично трудоемко. Интернет-архив предоставляет платный сервис, который архивирует сайт в несколько кликов — Archive It.
Wayback Machine Downloader — Скачиваем сайты бесплатно
Однажды потребовалось скачать сайт с web.archive.org. Archivarix.com и r-tools.org не нужны, так как это тот же Wayback Machine Downloader, только платные и работают только через веб-морду. В 2023 году.
Некоторые читатели попытались обвинить меня в предвзятости, мотивируя тем, что Архиварикс — лучший инструмент для восстановления сайтов. Всё аргументы были в сторону cms Архиварикса. И те о том, что она удобная. Поднять отдельный фронтенд для редактирования html-файлов — топ, консоль — слишком сложно.
Кстати, в чём разница между java и javascript? �� �� ��
Наверное случайная опечатка висит так много лет.
Рекомендую пойти чуть более сложным, но более гибким способом.
Если вам нужно слить большой сайт с Вебархива, есть терминал и 5 минут на настройку — можно обойтись без сторонних сервисов + бесплатно.
Wayback Machine Downloader
Чтобы скачивать сайты с Вебархива бесплатно воспользуемся бесплатной консольной утилитой Wayback Machine Downloader. Я ставил под macOS, мануал будет под неё же.
Установка Wayback Machine Downloader
Открываем терминал и вводим команду:
sudo gem install wayback_machine_downloaderКак скачать сайт с Вебархива бесплатно
После установки Wayback Machine Downloader вводите команду:
wayback_machine_downloader http://example.comГде http://example.com — сайт, который нужно скачать.
Параметры для скачивания
- -d, —directory PATH: Категория для сохранения загруженных файлов. По умолчанию это ~/websites/ плюс имя домена;
- -s, —all-timestamps: Скачать все снимки для данного сайта;
- -f, —from TIMESTAMP: Скачать только файлы в указанный момент времени или после него (например 20060716231334);
- -t, —to TIMESTAMP: Скачать только файлы в указанной временной метке или до нее (например 20100916231334);
- -e, —exact-url: Загружать только указанный url, а не полный сайт;
- -o, —only ONLY_FILTER: Ограничить загрузку только теми адресами, которые соответствуют данному фильтру. (используйте нотацию //, чтобы фильтр рассматривался как regex);
- -x, —exclude EXCLUDE_FILTER: Пропустить загрузку ссылок, соответствующих этому фильтру (используйте // обозначения для фильтра, чтобы он рассматривался как регекс);
- -a, —all: Скачивать файлы ошибок (40x и 50x) и перенаправления (30x);
- -c, —concurrency NUMBER: Во сколько потоков скачивать сайт (по умолчани работает в 1 поток);
- -p, —maximum-snapshot NUMBER: Максимальное количество снапшотов (по умолчанию 100);
- -l, —list: Вывести список адресов файлов в формате JSON с архивными метками времени, ничего не скачивая;
- -v, —version: Показать версию Wayback Machine Downloader.
Вопросы в файлах
Всё идеально, только у файлов в заголовке иногда сохраняются get-запросы. Был style.css, стал style.css?ver=666, а у вас в консоли ошибки. Для исправления запустите эту команду, находясь в директории со слитым сайтом.
find . -type f -name '*\?*' -exec sh -c 'mv "$0" "$"' <> \;У меня не работает/ошибки, что делать?
Не знаю. И по почте не проконсультирую, даже не ждите ответа.
Как скачать сайт с web archive org
Как скачать с web archive org
Страницы: 1
Как скачать с web archive org
Сообщений: 92 Регистрация: Май 2014
28 Июля 2021 14:47
Добрый день! Можете подсказать как можно скачать фотки с сайта из web archive org.
Сообщений: 317 Регистрация: Июн 2010
28 Июля 2021 16:29
Кликаем правой кнопкой мышки, выбираем пункт сохранить как, сохраняем и получаем один файл .html и папку где все фотографии с этой страницы.